

Kimi K3.1 Pro kostet über die Kimi API 2 $ pro Million Eingabetokens und 10 $ pro Million Ausgabetokens, mit gecachten Eingaben für 0,20 $. Die Highspeed-Version kostet mit 4 $ / 20 $ genau das Doppelte. Wenn Sie lieber einen Festpreis zahlen, ist es in den Kimi-Tarifen von $19 pro Monat (Plus) bis $199 (Ultra) enthalten, wobei Highspeed ab dem Pro-Tarif für $39 verfügbar ist.
Laut Preisschild ist es ein Drittel günstiger als Kimi K3. Die Rechnung erzählt eine andere Geschichte: K3.1 Pro denkt und schreibt viel, sodass eine durchschnittliche Agentenaufgabe bei Artificial Analysis $2.11 gegenüber $2.00 für K3 kostet. Sie zahlen ungefähr dasselbe für ein deutlich besseres Modell, nicht weniger für dasselbe. Gegenüber Claude sparen Sie tatsächlich, mit weniger als der Hälfte der Kosten pro Aufgabe von Sonnet 5.5 oder Opus 5.5 bei maximalem Denkaufwand.
Zwei Stolperfallen bestimmen die meisten Rechnungen: Ausgabe- und Reasoning-Tokens machen den Großteil der Kosten aus, und die Abotarife haben ein rollierendes 5-Stunden-Limit, das frühe Käufer in weniger als einer Stunde erreichten. Wenn Sie eigentlich eine KI wollen, die Support-Tickets beantwortet: Ich habe bei eesel jahrelang KI in laufenden Helpdesk-Warteschlangen betrieben, und die Tokenrechnung ist dabei der kleine Posten. SE Ranking bearbeitet etwa 4,650 Konversationen pro Monat über drei Produkte hinweg in Zendesk, ohne jemals ein Modell auszuwählen.
Wie viel kostet Kimi K3.1 Pro über die API?
Kimi K3.1 Pro kostet laut der Preisseite der Kimi API 2,00 $ für Eingaben, 0,20 $ für gecachte Eingaben und 10,00 $ für Ausgaben pro Million Tokens. Moonshot hat es am 23. Oktober 2026 ohne Aktionspreis veröffentlicht. Das sieht also nach dem regulären Preis aus und nicht nach einem Einführungsrabatt.
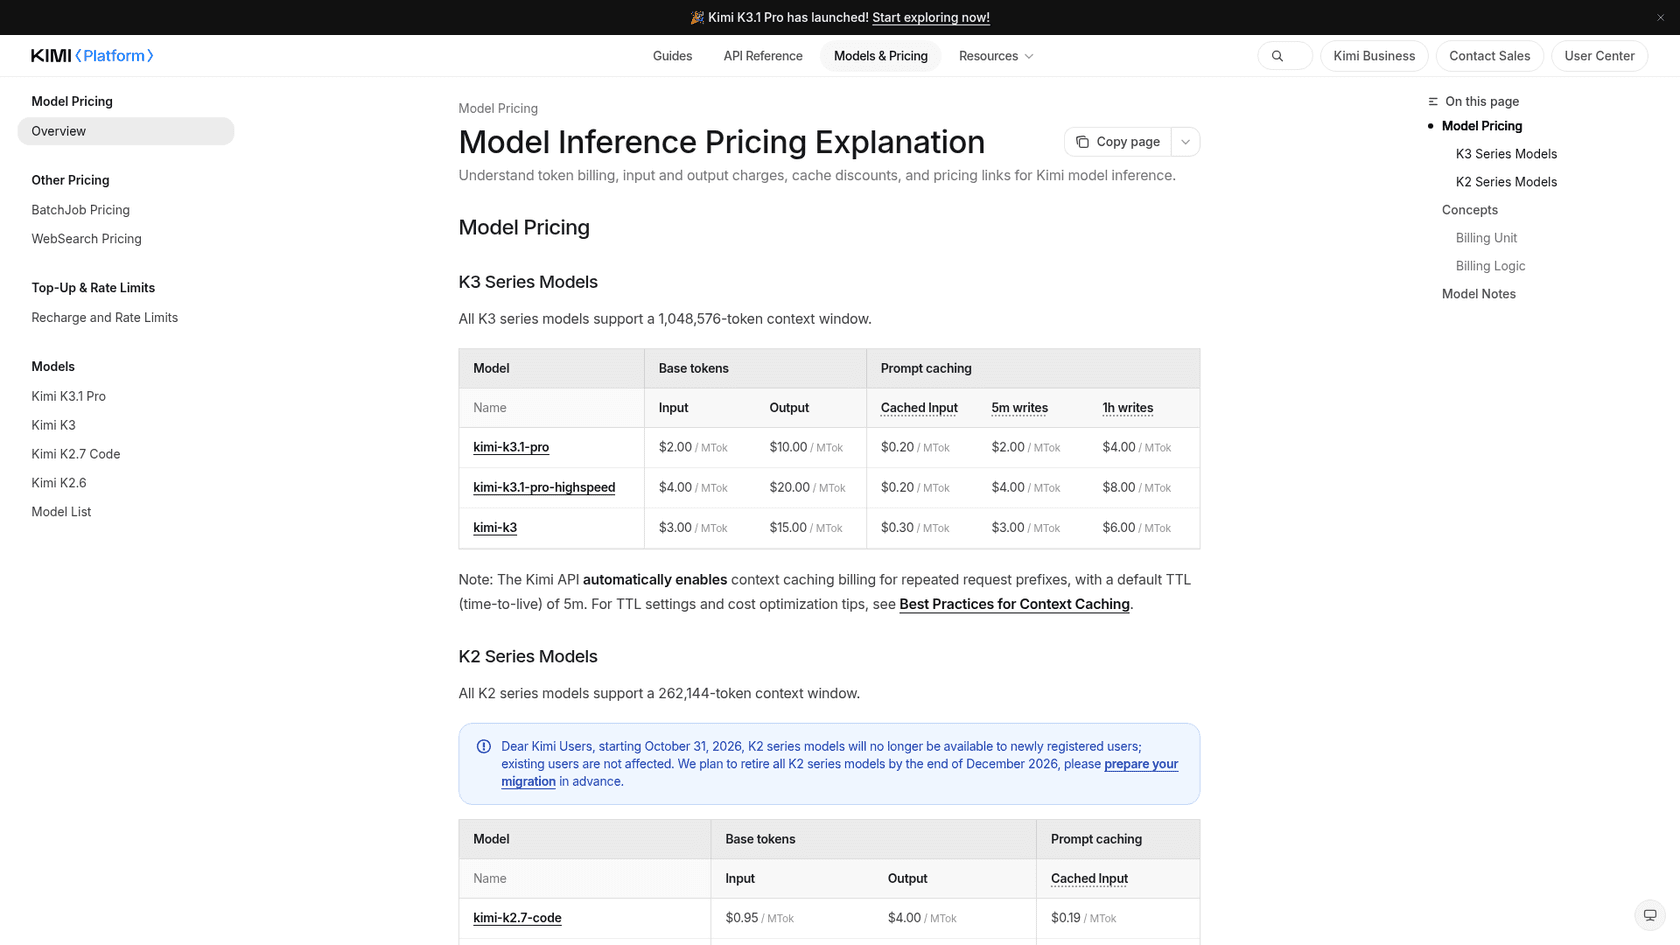
Hier ist die vollständige Preisliste der K3-Serie, pro Million Tokens:
| Modell-ID | Eingabe (Cache Miss) | Gecachte Eingabe (Cache Hit) | Ausgabe | Cache-Schreibvorgang, 5 Min. | Cache-Schreibvorgang, 1 Stunde |
|---|---|---|---|---|---|
kimi-k3.1-pro | $2.00 | $0.20 | $10.00 | $2.00 | $4.00 |
kimi-k3.1-pro-highspeed | $4.00 | $0.20 | $20.00 | $4.00 | $8.00 |
kimi-k3 | $3.00 | $0.30 | $15.00 | $3.00 | $6.00 |
Ein paar Punkte auf dieser Liste verdienen einen genaueren Blick:
- Kein Aufpreis für langen Kontext. Beide K3.1 Pro-Modelle unterstützen einen Kontext von
1,048,576Tokens, und laut dem K3.1 Pro-Schnellstart gilt "uses flat pay-as-you-go pricing", ohne Staffelung nach Kontextlänge. Das ist besonders wichtig, wenn Sie ganze Codebasen einspeisen. - Der Cache-Hit-Preis verdoppelt sich bei Highspeed nicht. Alles andere verdoppelt sich, aber gecachte Eingaben bleiben bei
$0.20. Wenn Ihre Anfragen also einen langen Prompt wiederverwenden, kostet Highspeed in der Praxis weniger als das 2-Fache. - K3 ist weiterhin zum alten Preis erhältlich.
kimi-k3bleibt bei 3 $ / 15 $, und die Dokumentation bezeichnet es inzwischen als "previous-generation flagship". Mir fällt kein neues Projekt ein, bei dem es sinnvoll wäre, bei K3 zu bleiben, es sei denn, Sie brauchen seine offenen Modellgewichte schon heute.
Was zählt als abrechenbarer Token?
Jeder eingehende und jeder ausgehende Token, einschließlich Reasoning. K3.1 Pro ist ein Reasoning-Modell, dessen Denkfunktion immer aktiv ist, und reasoning_effort ist laut Moonshots API-Schlüssel-Leitfaden standardmäßig auf max gesetzt. Diese Denktokens werden zum Ausgabepreis von $10 abgerechnet, obwohl Sie sie in der Antwort nie zu sehen bekommen.
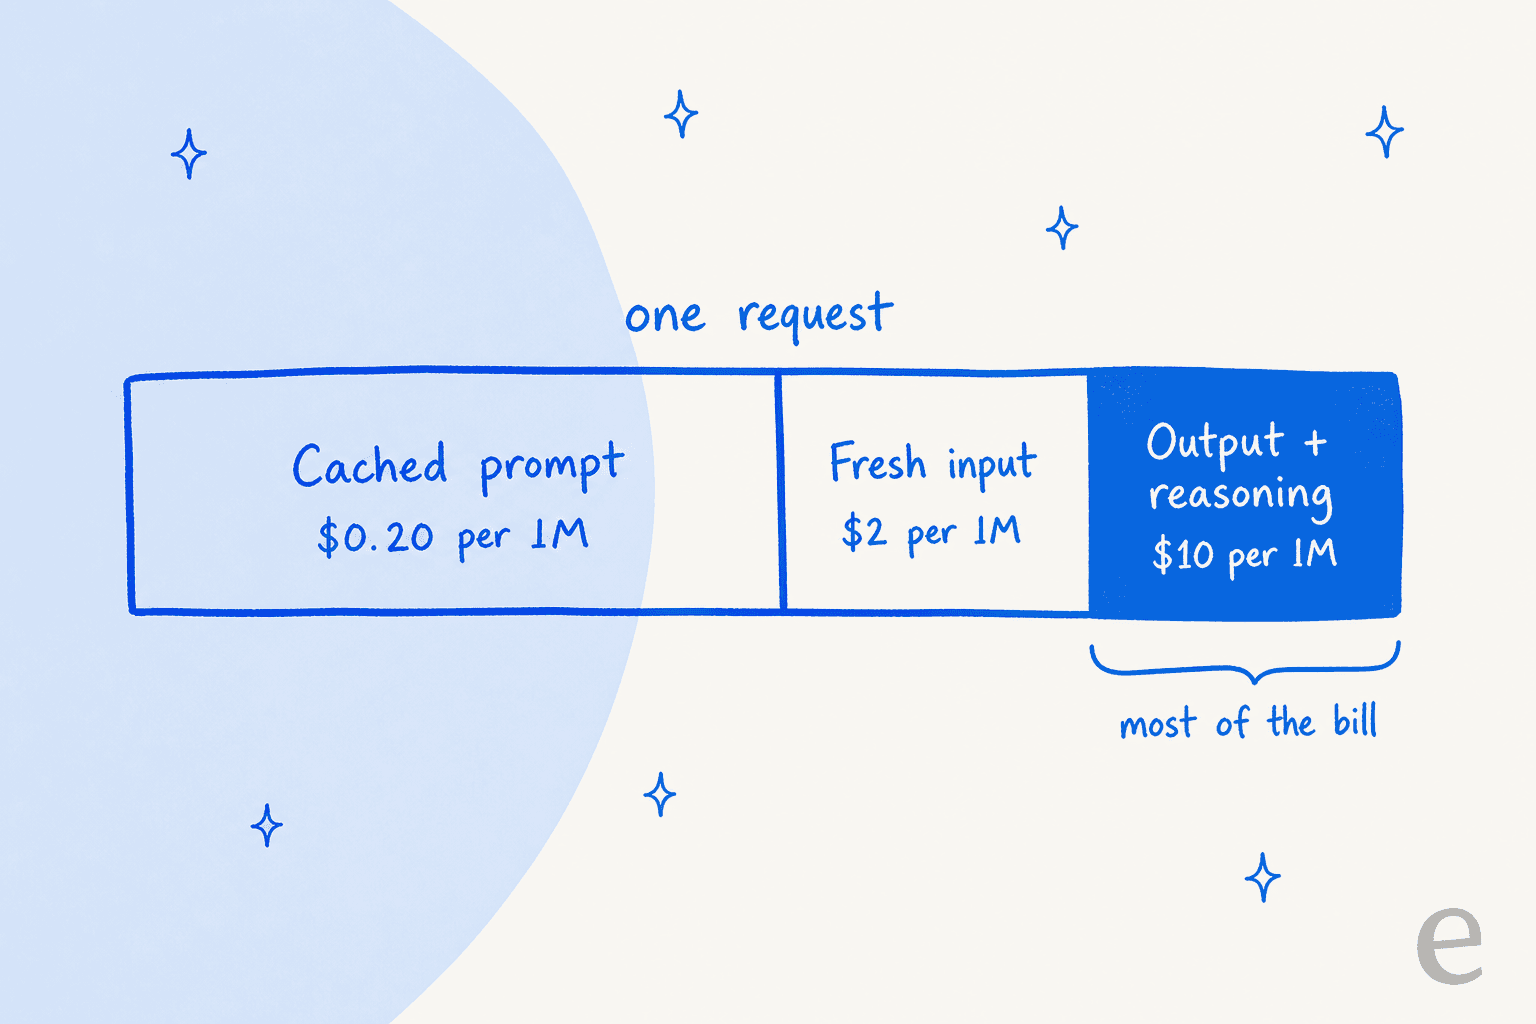
Das ist der mit Abstand größte Hebel für Ihre Rechnung. Bei den Benchmark-Durchläufen von Artificial Analysis erzeugte eine durchschnittliche Aufgabe 55,195 Ausgabetokens, davon 34,883 für Reasoning (AA-Modellseite). Bei 10 $ pro Million sind das etwa 55 Cent für die Ausgabe pro Aufgabe, noch bevor Sie einen einzigen Eingabetoken mitzählen.
Wie funktioniert Kimis Prompt-Caching?
Wiederholte Prompt-Präfixe werden automatisch gecacht, mit einer standardmäßigen Gültigkeitsdauer von 5 Minuten. Ein Cache Hit kostet $0.20, also 90 % weniger als eine neue Eingabe. Das Schreiben in den Cache wird separat abgerechnet, abhängig davon, wie lange Sie ihn vorhalten: $2.00 pro Million für die 5-Minuten-Stufe und $4.00 für die 1-Stunden-Stufe, die Sie über prompt_cache_options.ttl auswählen (Schnellstart).
Zwei Details führen häufig zu Problemen. Teilweise gefüllte Cache-Blöcke werden als Cache Misses abgerechnet. Ein Prompt, der sich nahe am Anfang ändert, verliert daher den Großteil seines Rabatts. Die 1-Stunden-Stufe lohnt sich außerdem nur, wenn zu wenige Anfragen eingehen, um einen 5-Minuten-Cache aktiv zu halten. Für einen stark ausgelasteten Agenten ist die Standardeinstellung deshalb meist die günstigere Wahl.
Die Ratenlimits hängen von Ihrer Aufladung ab
K3.1 Pro wird nach einer erfolgreichen Aufladung von mindestens $1 freigeschaltet, und die Summe Ihrer Aufladungen bestimmt Ihre Ratenlimit-Stufe (Aufladung und Ratenlimits):
| Stufe | Aufladungen insgesamt | Gleichzeitige Anfragen | Anfragen/Min. | Tokens/Min. | Tokens/Tag |
|---|---|---|---|---|---|
| Tier0 | $1 | 1 | 3 | 500,000 | 1,500,000 |
| Tier1 | $10 | 15 | 100 | 2,000,000 | Unbegrenzt |
| Tier2 | $20 | 40 | 100 | 3,000,000 | Unbegrenzt |
| Tier3 | $100 | 50 | 200 | 3,000,000 | Unbegrenzt |
| Tier4 | $1,000 | 60 | 200 | 4,000,000 | Unbegrenzt |
| Tier5 | $3,000 | 100 | 300 | 5,000,000 | Unbegrenzt |
Die $1-Stufe ist eher eine Probefahrt als eine Lösung für den Produktivbetrieb. Bei 1,500,000 Tokens pro Tag würden weniger als 30 durchschnittliche Agentenaufgaben alles aufbrauchen, aber sobald Sie $10 einzahlen, entfällt die tägliche Obergrenze. Wenn Sie schon einmal mit OpenAI-Ratenlimits zu kämpfen hatten, wird Ihnen diese Staffelung bekannt vorkommen, nur sind die Schwellenwerte deutlich niedriger.
Noch kein Batch-Rabatt
Kimis Batch API berechnet 60 % des regulären Preises, unterstützt aber nur kimi-k2.7-code und kimi-k2.6. K3.1 Pro steht nicht auf dieser Liste. Diese K2-Modelle sind ab dem 31. Oktober 2026 für neue Nutzer gesperrt und werden bis Ende Dezember eingestellt. Das bedeutet, dass über Nacht laufende Jobs, die sich auf die Preise von Kimi K2.7 Code verlassen haben, bald die vollen K3.1-Preise zahlen werden.
Was kostet Kimi K3.1 Pro pro Aufgabe?
Bei Artificial Analysis kostet eine durchschnittliche Aufgabe im Intelligence Index mit K3.1 Pro $2.11, und der gesamte Index-Durchlauf kostete $3,117 (AA-Modellseite). An dieser Zahl würde ich mich orientieren, denn sie enthält bereits das lange Reasoning, das der Preis pro Token verbirgt.
AA stuft K3.1 Pro als "very verbose" ein. Für den Index-Durchlauf verbrauchte es etwa 150M Ausgabetokens, gegenüber einem Median von 87M bei Modellen in seiner Preisgruppe. Der Rabatt von einem Drittel auf dem Preisschild schrumpft also ziemlich schnell, sobald das Modell anfängt zu denken.
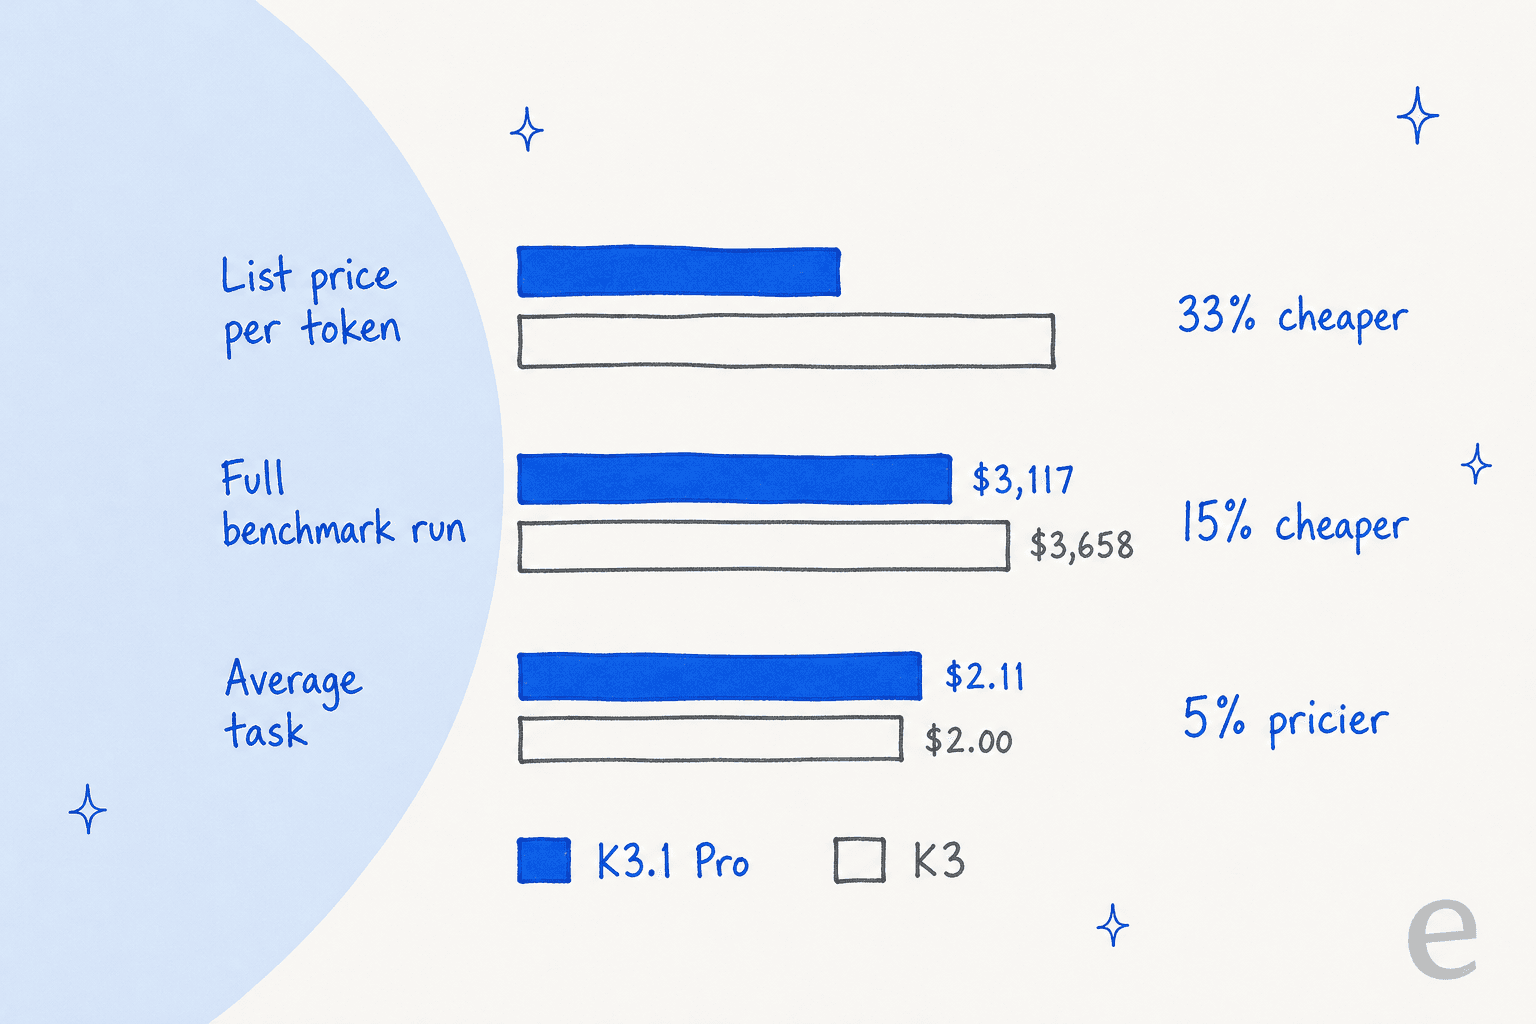
Die drei Zahlen widersprechen sich nicht, sie messen nur unterschiedliche Dinge. Beim vollständigen Durchlauf fallen die großen Aufgaben stärker ins Gewicht, und dort zeigen sich die Effizienzgewinne von K3.1 Pro. Die Zahl für die durchschnittliche Aufgabe ist ein ungewichteter Mittelwert, bei dem die zusätzlichen Ausgaben bei kleinen Aufgaben den Wert leicht über K3 heben. So oder so lautet die ehrliche Zusammenfassung: Sie bekommen für ungefähr dasselbe Geld ein um 11.5 Punkte intelligenteres Modell, nicht dasselbe Modell für ein Drittel weniger.
Nathan Lambert, Forscher bei Ai2, brachte es bereits am Veröffentlichungstag auf den Punkt:
"K3.1 is also cheaper than K3 per token, but some benchmarks in the blog show it uses meaningfully more tokens per answer, so it may be about the same price."
Wie es im Vergleich mit anderen Spitzenmodellen abschneidet
So schneidet es gegenüber den Modellen ab, die Interessenten ebenfalls in Betracht ziehen, alles von derselben Artificial Analysis-Seite:
| Modell | Listenpreis (Eingabe / Ausgabe) | Intelligence Index | Kosten pro Aufgabe | Kosten für den Index-Durchlauf | Ausgabegeschwindigkeit |
|---|---|---|---|---|---|
| Claude Opus 5.5 (Max) | $4 / $20 | 57.6 | $5.98 | $8,708 | 98.1 t/s |
| Claude Sonnet 5.5 (Max) | $2 / $10 | 56.0 | $5.46 | $7,260 | 141.3 t/s |
| Kimi K3.1 Pro | $2 / $10 | 55.1 | $2.11 | $3,117 | 49.7 t/s |
| Claude Fable 5.1 (Max) | $10 / $50 | 53.4 | $7.63 | $13,129 | 69.8 t/s |
| GPT-6 Astra (Max) | $10 / $50 | 52.7 | $3.26 | $5,324 | 66.7 t/s |
| Gemini 4 Argon (High) | $2 / $10 | 52.6 | $1.62 | $2,101 | 79.7 t/s |
| GPT-6.1 Sol (Max) | $2 / $10 | 51.8 | $0.72 | $1,082 | 65.9 t/s |
| DeepSeek V4.1 Flash 1017 (Max) | $0.30 / $1.20 | 45.1 | $0.26 | $445 | 169.3 t/s |
| Kimi K3 (Max) | $3 / $15 | 43.6 | $2.00 | $3,658 | 54.5 t/s |
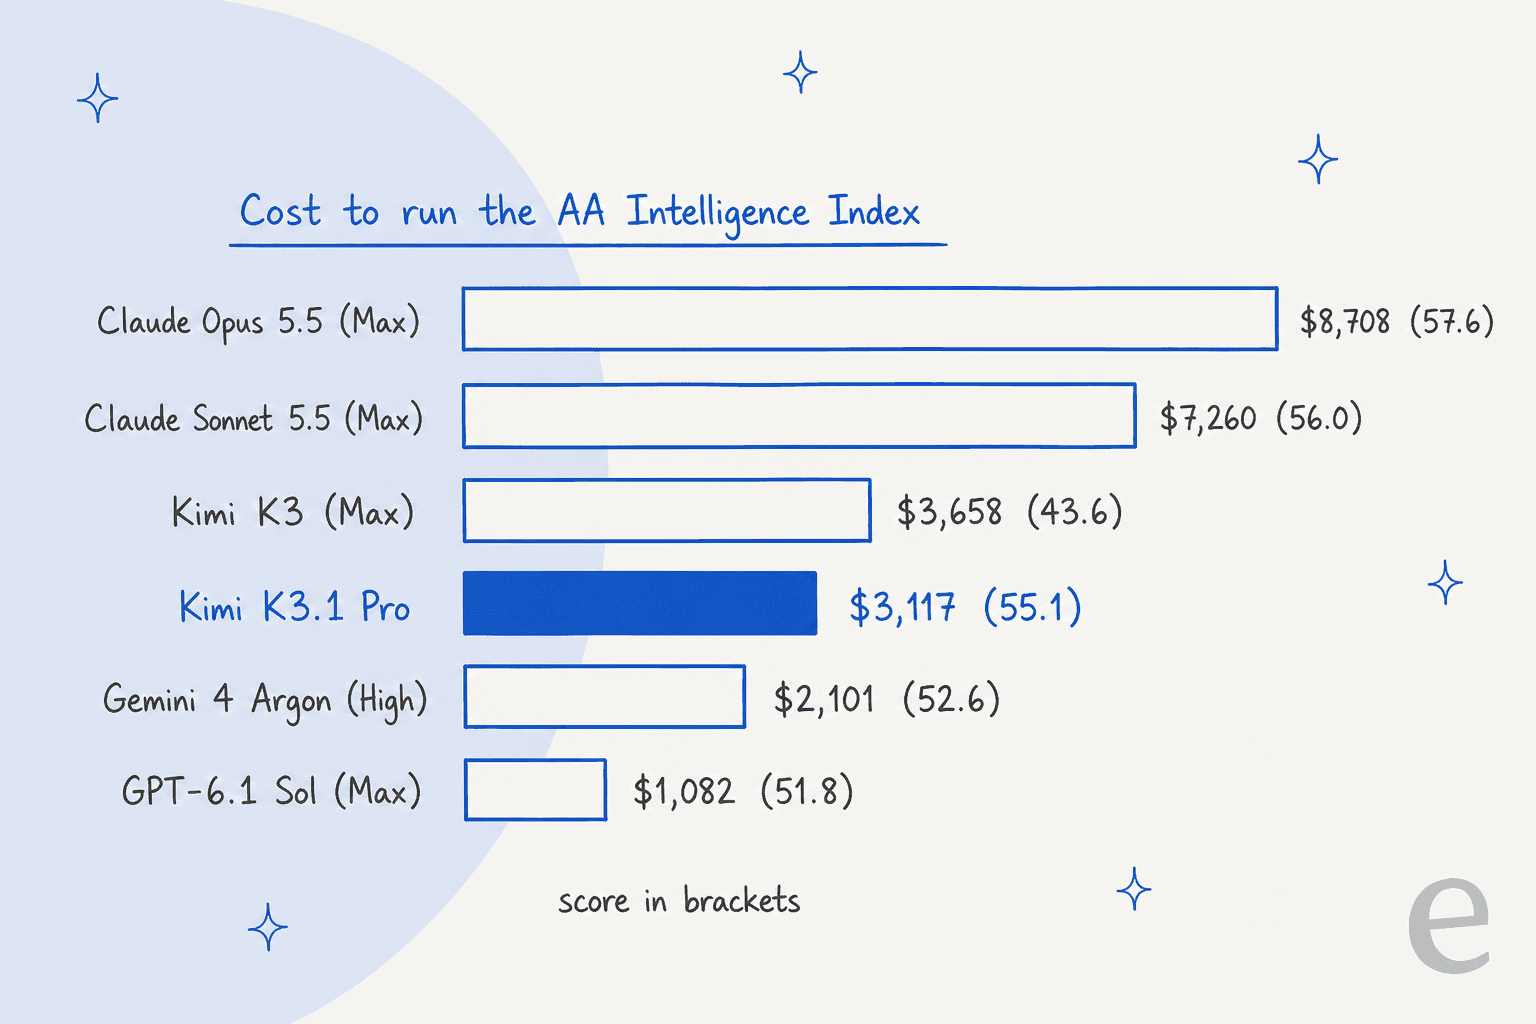
Meine Einschätzung zu dieser Tabelle:
- Gegenüber Claude ist es die klare Preis-Leistungs-Wahl. Es hat denselben Listenpreis wie Sonnet 5.5, aber Sonnet verbrauchte bei maximalem Denkaufwand
416MAusgabetokens für den Index, während K3.1 Pro bei deutlich weniger als der Hälfte der Kosten pro Aufgabe bis auf einen Punkt herankommt. - Gegenüber den günstigeren 2 $ / 10 $-Modellen ist es kein Schnäppchen. GPT-6.1 Sol und Gemini 4 Argon erledigen eine durchschnittliche Aufgabe für
$0.72und$1.62und liegen im Index etwa 3 beziehungsweise 2.5 Punkte niedriger. Wenn Ihnen die Kosten pro Auftrag wichtiger sind als die letzten paar Punkte, liegen diese Modelle vorne. - Geschwindigkeit ist der versteckte Preis. Mit
49.7Tokens pro Sekunde belegt es Platz#165von 182 Modellen. Eine durchschnittliche Index-Aufgabe dauerte etwa 17 Minuten. Das steht auf keiner Rechnung, ist für die Person, die darauf wartet, aber sehr spürbar.
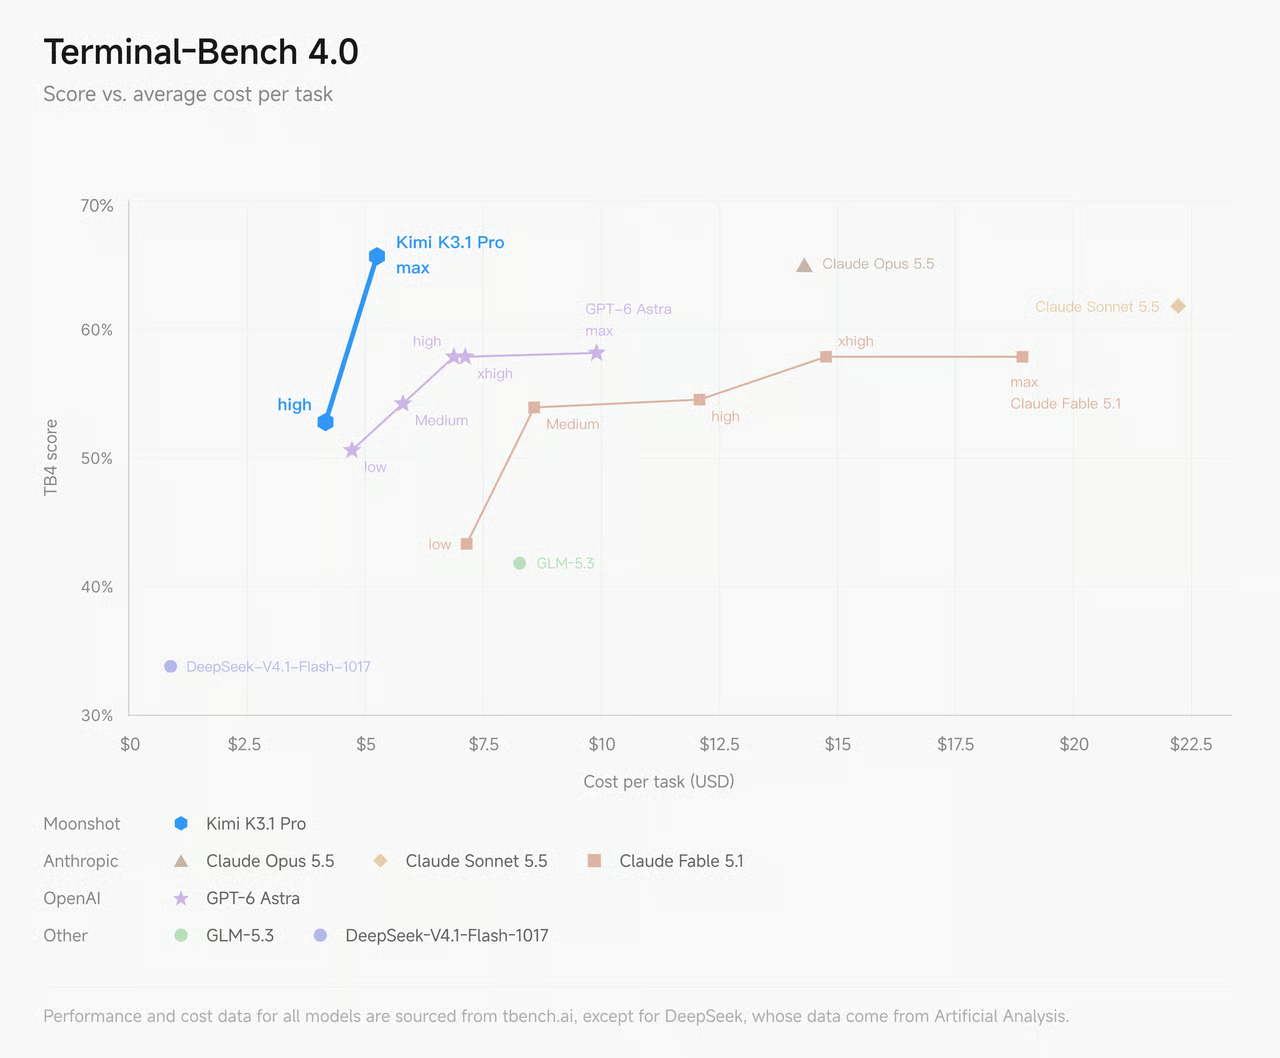
Moonshots eigenes Diagramm zeigt den Vergleich mit Claude auf Terminal-Bench, wo K3.1 Pro bei ungefähr 5 $ pro Aufgabe liegt, gegenüber etwa 14 $ für Opus 5.5:
Ein unabhängiger Tester beobachtete bei einem kleineren Auftrag einen ähnlichen Abstand:
"Kimi K3.1 Pro ties Sonnet 5.5 at 93, for $0.68 and 11 min vs Sonnet's $1.61 and 14 min."

Ist Kimi K3.1 Pro Highspeed den doppelten Preis wert?
Nur wenn eine Person auf die Antwort wartet. Highspeed ist dasselbe Modell, bereitgestellt mit "about 2-3× the speed" zum exakt doppelten Eingabe- und Ausgabepreis (API-Schlüssel-Leitfaden). Die Qualität ist identisch. Sie kaufen also Zeit, nicht mehr Intelligenz.
Für über Nacht laufende Jobs und Hintergrundagenten oder alles, bei dem niemand auf den Cursor schaut, ist das reguläre K3.1 Pro die offensichtliche Wahl. Für Live-Chat oder kurze Coding-Schleifen fühlen sich die 49.7 Tokens pro Sekunde des Basismodells durchaus langsam an, und Highspeed schafft Abhilfe. Allerdings waren nicht alle von dem Upgrade beeindruckt:
"I'll wait for the openweight... btw double the price for 67 TPS... Hardly 'nitro'."
Es gibt noch keine unabhängige Geschwindigkeitsmessung für Highspeed, Artificial Analysis führt es nicht auf. Deshalb würde ich Moonshots Angabe von 2-3x als Behauptung behandeln, bis jemand einen Benchmark durchführt.
Wie viel kosten die Kimi-Tarife, die K3.1 Pro enthalten?
Kimis Mitgliedschaftstarife reichen von $19 bis $199 pro Monat und enthalten K3.1 Pro in der Kimi-App und Kimi Work sowie Kimi Code, Moonshots Coding-Agenten. Die folgenden Preise stammen von der Kimi Code-Seite:
| Tarif | Monatlich | Jährliche Abrechnung (pro Monat) | Jährliche Abrechnung (gesamt) | Zugriff auf K3.1 Pro |
|---|---|---|---|---|
| Plus | $19 | $15 | $180 | Standard |
| Pro | $39 | $31 | $372 | Standard und Highspeed |
| Max | $99 | $79 | $948 | Standard und Highspeed |
| Ultra | $199 | $159 | $1,908 | Standard und Highspeed |
Bei Highspeed innerhalb eines Tarifs gilt "2× credit usage". Kimi hat seine Tarife kürzlich auch umbenannt, laut seiner Seite zu den Vorteilen von Kimi Code "with pricing unchanged", und bestehende Abonnenten können die alten Namen behalten (Moderato, Allegretto und so weiter). Bei den neuen Tarifen entfällt das wöchentliche Kimi Code-Limit, das rollierende 5-Stunden-Fenster bleibt aber bestehen, ebenso wie ein monatliches Guthabenkontingent, das Kimi und Kimi Code gemeinsam nutzen.
In China wird dieselbe Staffelung in Yuan angeboten, von einem Go-Tarif für ¥49 (ohne Kimi Code) bis zu ¥1.399 pro Monat für Ultra, laut Kimis Hilfeseite zu Mitgliedschaftspreisen.
Was passiert, wenn Sie das Limit erreichen?
Sie können Extra Usage kaufen, eine nutzungsbasierte Aufladung, die Kimi und Kimi Code gemeinsam nutzen, mit einem Mindestbetrag von ¥25 pro Aufladung. Kimi beschreibt den Preis als "close to the official API pricing". Im Grunde ist es also die API mit einem anderen Bezahlvorgang.
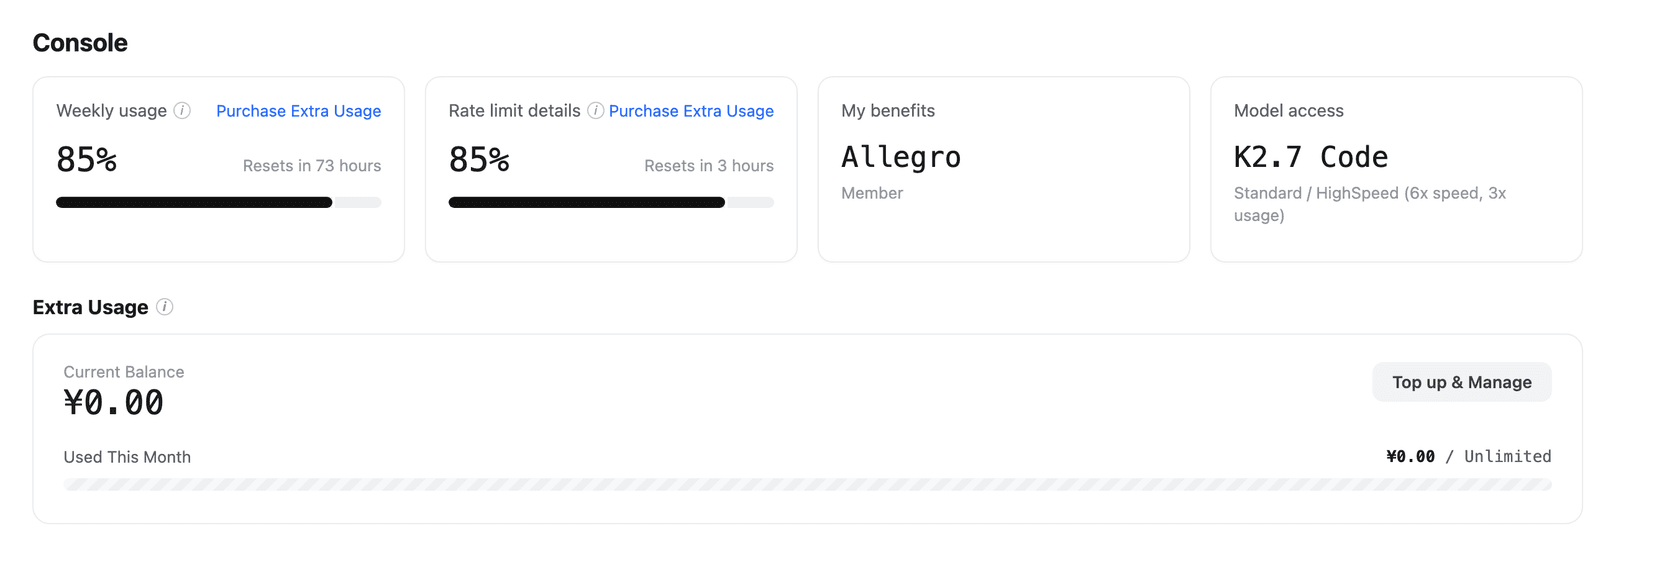
Das ist wichtig, denn das 5-Stunden-Limit ist bisher der lauteste Kritikpunkt an K3.1 Pro. Im Veröffentlichungsthread auf Hacker News mit 674 Kommentaren wurde das Kontingent häufiger angesprochen als die Modellqualität:
"If you are expecting any sort of usable limits on their subscription plan I suggest adjusting your expectations. I subscribed to $99 a month plan and within 47 minutes with one session (not asking for swarms or anything) was limited by 5-hour quota."
Fairerweise muss man Moonshot zugutehalten, dass die Standardeinstellung max einen großen Anteil daran hat. Ein anderer Nutzer im selben Thread berichtete, 8 Stunden lang mit 22 % seines wöchentlichen Kontingents gearbeitet zu haben, indem er K3.1 Pro mit einem leichteren Modell für Unteragenten kombinierte. Die Tarife funktionieren durchaus, sie reichen nur vom ersten Tag an nicht so weit wie manche konkurrierenden Coding-Tarife.
Sollten Sie die API oder einen Kimi-Tarif nutzen?
Entscheiden Sie danach, wer das Modell aufruft. Wenn Ihre App oder Ihr Agent es aufruft, nutzen Sie die API: Sie zahlen pro Token, und nach einer Aufladung von $10 gibt es keine tägliche Obergrenze. Wenn Sie selbst es über Kimi Code oder die Kimi-App aufrufen, ist ein Tarif fast immer günstiger, solange Sie mit dem 5-Stunden-Fenster leben können.
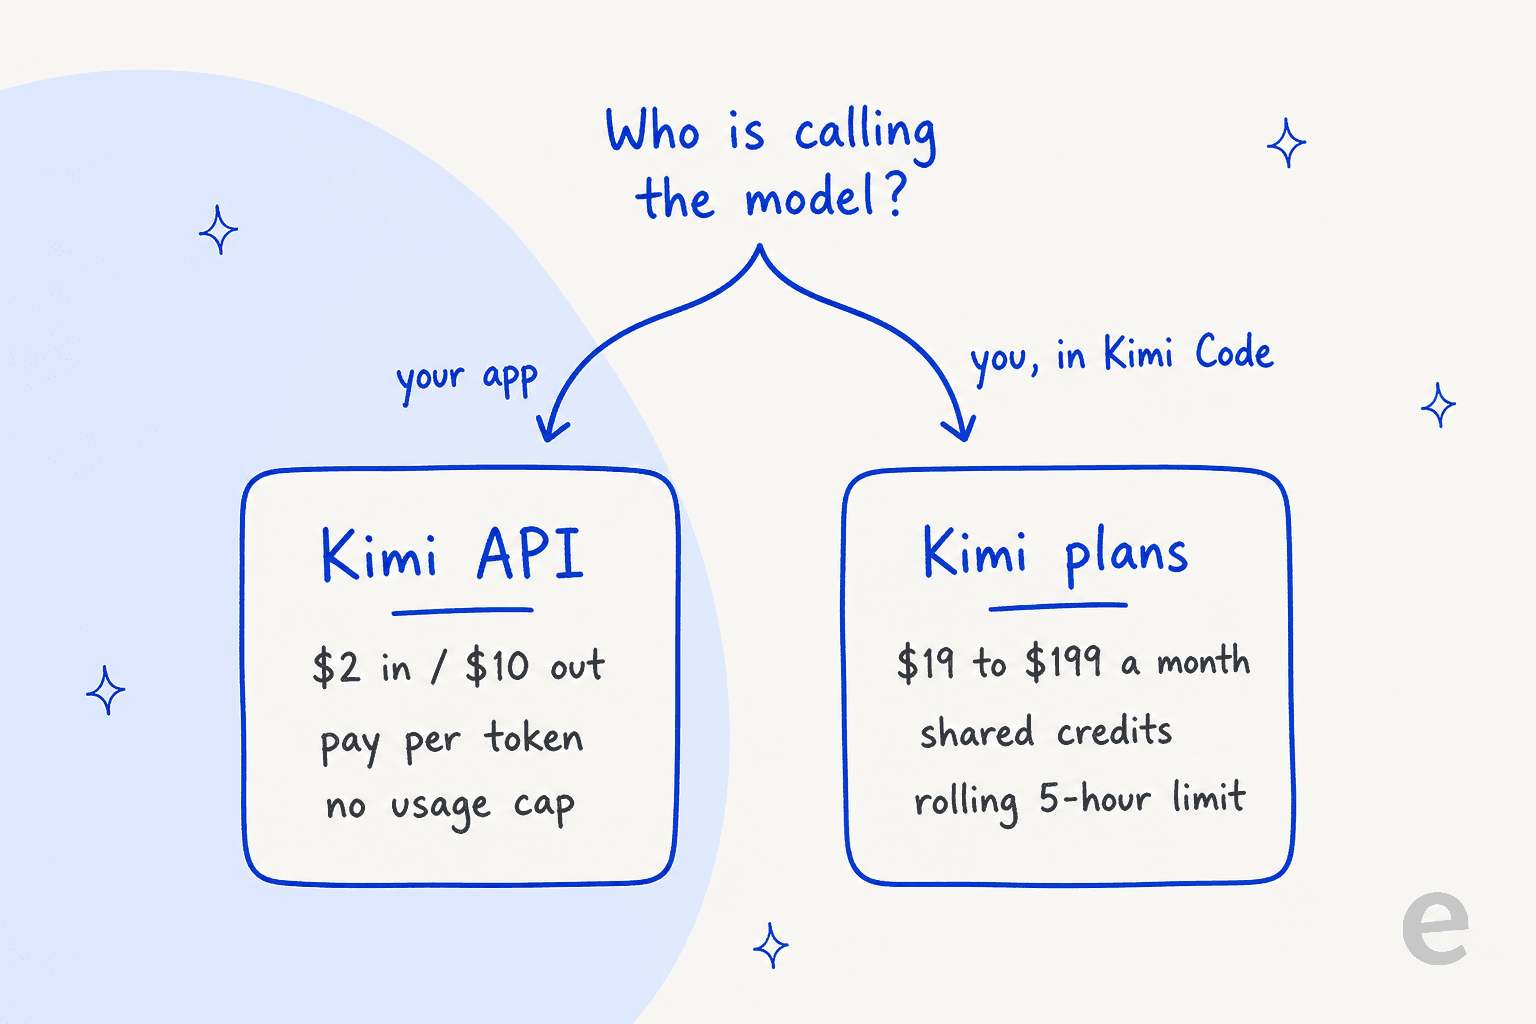
Die Rechnung zeigt, warum. Ein Entwickler, der an jedem Arbeitstag 20 Agentenaufgaben zum Durchschnittspreis von Artificial Analysis von $2.11 pro Aufgabe ausführt, würde über die API etwa $928 pro Monat ausgeben (20 × 22 × $2.11). Der Max-Tarif für $99 ist dagegen ein echtes Schnäppchen. Genau deshalb rationiert Moonshot ihn mit dem rollierenden Limit. Wenn Sie Coding-Tarife vergleichen, decken meine Aufschlüsselung der Claude Code-Preise und meine Liste der KI-Coding-Assistenten die andere Seite ab.
Wie viel würde Kimi K3.1 Pro für mein Arbeitsvolumen kosten?
Geben Sie Ihre eigenen Zahlen ein. Der folgende Rechner verwendet die offiziellen Preise der Kimi API und geht davon aus, dass Ihr gecachter Anteil aktiv bleibt (keine Gebühren für Cache-Schreibvorgänge). Betrachten Sie das Ergebnis deshalb besser als Untergrenze.
Damit Sie ein Gefühl für typische Größenordnungen bekommen, sehen Sie hier, was drei gängige Arbeitslasten mit dem regulären K3.1 Pro zu den offiziellen Preisen kosten:
| Arbeitslast | Pro Anfrage | Monatliches Volumen | K3.1 Pro | Highspeed | Kimi K3 |
|---|---|---|---|---|---|
| Support-Antworten | 6.000 gecachte + 2.000 neue Eingabetokens, 1.500 Ausgabetokens | 10,000 | $202 | $392 | $303 |
| Fragen und Antworten zu langen Dokumenten | 200.000 neue Eingabetokens, 3.000 Ausgabetokens | 500 | $215 | $430 | $323 |
| Agentenbasiertes Coding | Durchschnittliche AA-Aufgabe ($2.11) | 440 | ~$928 | nicht verfügbar | ~$880 |
Das Muster gilt für alle drei: Bei wiederholten Prompts kümmert sich das Eingabe-Caching um sich selbst, und auf der Ausgabeseite sollten Sie nach Einsparmöglichkeiten suchen. Als Erstes würde ich reasoning_effort vom Standardwert max auf high oder low senken. Bei K3 maß AA mit der niedrigen Einstellung $1.15 pro Aufgabe gegenüber $2.00 bei maximalem Denkaufwand, allerdings mit deutlichen Einbußen beim Ergebnis. Testen Sie das daher an Ihren eigenen Aufgaben, bevor Sie sich darauf festlegen. Wenn Sie die Ausgaben über mehrere Modelle hinweg verfolgen, hilft ein LLM-Tracking-Tool, einen außer Kontrolle geratenen Agenten zu entdecken, bevor die Rechnung es tut.
Ist Kimi K3.1 Pro seinen Preis wert?
Für agentenbasiertes Coding und lange, mehrstufige Arbeiten: ja. Es gehört zu den Modellen mit den höchsten Bewertungen, die Sie kaufen können, und kostet pro Aufgabe bei maximalem Denkaufwand deutlich weniger als die Hälfte von Claude. Die Modellgewichte sind außerdem "by Nov 4" versprochen, was weitere Hosting-Anbieter bringen dürfte. Nur zur Einordnung: Kimi K3 wird bei Artificial Analysis von 20 Anbietern bereitgestellt, gegenüber derzeit 5 für K3.1 Pro.
In drei Fällen ist es das schwächere Angebot:
- Sie wollen den günstigsten erledigten Auftrag. GPT-6.1 Sol und Gemini 4 Argon erledigen die durchschnittliche Aufgabe für weniger Geld. Rein preislich spielt DeepSeek V4.1 Flash mit
$0.26pro Aufgabe in einer anderen Liga. - Eine Person wartet auf jede Antwort. Bei 50 Tokens pro Sekunde werden Sie letztlich bei Highspeed landen, wodurch der Preisvorteil gegenüber Sonnet 5.5 kleiner wird.
- Sie wollen dauerhaft mit einem Kimi-Tarif arbeiten. Das 5-Stunden-Fenster ist bei maximalem Denkaufwand knapp. Planen Sie etwas Extra Usage ein oder warten Sie ein paar Wochen, um zu sehen, ob Moonshot es lockert.
Wenn Sie es mit dem breiteren Feld vergleichen, sind meine Liste der Kimi K3-Alternativen und mein Beitrag zu den Preisen von Qwen 3.8 Max weiterhin relevant.
Für den Blick auf offene Modelle habe ich Qwen 3.8 Max und K3 direkt miteinander verglichen. Die vollständige Analyse des Modells finden Sie in meinem Beitrag zu Kimi K3.1 Pro.
Was der Preis eines Modells einem Support-Team nicht verrät
Viele Menschen, die Preise für Modelle wie dieses vergleichen, fragen sich eigentlich, ob sie darauf einen Support-Agenten aufbauen sollten. Als jemand, der an den Integrationen von eesel arbeitet, würde ich sagen: Der Preis pro Token ist der einfache Teil. Im Support-Beispiel oben kaufen Ihnen $202 pro Monat Tokens, keinen Agenten. Sie müssten weiterhin Ihren Helpdesk anbinden, Ihr Hilfecenter und frühere Tickets synchronisieren, die Übergaberegeln schreiben und alles testen, bevor ein Kunde eine Antwort sieht. In diesen Aufbau fließen die meiste Zeit und das größte Risiko. Deshalb wird jede eesel-Einführung zuerst mit den eigenen historischen Tickets eines Teams simuliert.
Mit eesel entfällt dieser Aufbau vollständig. Sie stellen einen einsatzbereiten KI-Helpdesk-Kollegen ein, der sich in Ihre bestehende Warteschlange in Zendesk, Freshdesk oder Gorgias einfügt und aus Ihren Dokumenten und früheren Tickets lernt. Anschließend folgt er Übergaberegeln, die Sie in einfachem Englisch schreiben. Die Abrechnung erfolgt über feste Guthabentarife statt pro Token. Ihre Rechnung schwankt also nicht, wenn ein Modell beschließt, intensiver nachzudenken. Wenn Sie sehen möchten, wie die Gesamtkosten im Vergleich aussehen, rechnet mein Leitfaden zu den Kosten pro Lösung die Zahlen durch, und der Beitrag zum besten KI-Modell für den Support vergleicht die Modelle dahinter.

SE Ranking zeigt gut, wie das im Produktivbetrieb aussieht. Das Unternehmen betreut drei Produkte (SE Ranking, Planable und SE Visible) mit einem einzigen Zendesk-Team und einem eesel-Agenten pro Produkt. Jeder Agent durchsucht etwa 16,800 Seiten mit Hilfecenter- und Website-Inhalten, antwortet im Live-Chat in der Sprache des Kunden und übergibt Rückerstattungen, Testverlängerungen und Tier-2-Fragen samt Details an eine Person. Zwischen dem 8. August und dem 8. September 2026 bearbeitete das System etwa 4,650 Konversationen. Nichts davon hing davon ab, welches Modell in dieser Woche eine Rangliste anführte.
Wenn Ihnen Kimis terminalorientierter Ansatz gefällt, bringt die eesel CLI dasselbe in den Support. Sie können mit eesel activity die jüngsten Arbeiten Ihres KI-Kollegen prüfen und mit eesel approvals ausstehende Aktionen genehmigen oder ablehnen. Außerdem können Sie mit eesel instructions seine dauerhaft geltenden Regeln bearbeiten. Die Ausgabe erfolgt als JSON, und Schreibbefehle unterstützen --dry-run, sodass Skripte und Coding-Agenten wie Claude Code sie sicher steuern können.
Es gibt auch einen MCP-Server, und den übergreifenden Ansatz behandle ich in meinem Leitfaden zur KI-Agenten-CLI.
Testen Sie eesel
Wenn Sie die Preise von Kimi K3.1 Pro prüfen, um damit Ihren Support zu betreiben, testen Sie die Variante, bei der jemand anderes den Aufbau bereits erledigt hat. eesel stellt Ihrem Helpdesk in wenigen Minuten einen einsatzbereiten KI-Kollegen zur Seite, trainiert ihn mit Ihren bisherigen Tickets und lässt Sie ihn anhand der Warteschlange der letzten Woche testen, bevor er jemandem antwortet. Testen Sie eesel kostenlos oder vergleichen Sie zunächst die Angebote in meiner Liste der besten KI-Kollegen.
Häufig gestellte Fragen
Wie viel kostet Kimi K3.1 Pro?
Über die Kimi API kostet Kimi K3.1 Pro 2 $ pro Million Input-Tokens, 0,20 $ pro Million gecachter Input-Tokens und 10 $ pro Million Output-Tokens. Im gesamten Kontextfenster von 1M Tokens gibt es keinen Aufpreis für langen Kontext. Mein Überblick zu Kimi K3.1 Pro behandelt das Modell selbst.
Wie viel kostet Kimi K3.1 Pro Highspeed?
Kimi K3.1 Pro Highspeed kostet 4 $ für Input und 20 $ für Output pro Million Tokens, genau doppelt so viel wie das Standardmodell, bei etwa 2- bis 3-facher Geschwindigkeit. Gecachter Input bleibt bei 0,20 $. Bei den Endkundentarifen von Kimi erfordert Highspeed den Tarif Pro oder höher und verbraucht Credits doppelt so schnell.
Ist Kimi K3.1 Pro günstiger als Kimi K3?
Pro Token ja: K3.1 Pro kostet 2 $/10 $ gegenüber 3 $/15 $ bei den Preisen von Kimi K3, also ein Drittel weniger. Pro Aufgabe sind die Kosten nahezu gleich, weil K3.1 Pro mehr schreibt. Artificial Analysis beziffert sie auf 2,11 $ pro durchschnittlicher Aufgabe gegenüber 2,00 $ für K3, bei einem um 11.5 Punkte höheren Ergebnis.
Welchen Kimi-Tarif brauche ich für Kimi K3.1 Pro?
Das Standardmodell von Kimi K3.1 Pro ist ab dem Tarif Plus (19 $/Monat) verfügbar, und Highspeed erfordert Pro (39 $/Monat) oder höher. Kimi Code teilt sich dasselbe Kontingent mit dem Rest der Mitgliedschaft. Vergleichen Sie dies mit den Preisen von Claude Code, wenn Sie einen Tarif fürs Programmieren auswählen.
Gibt es für Kimi K3.1 Pro einen kostenlosen Tarif oder einen Batch-Rabatt?
Nein. Die API wird nach einer Aufladung von mindestens 1 $ freigeschaltet, und der Rabatt von 60 % für die Batch API gilt derzeit nur für ältere K2-Modelle. Wenn Sie eine kostenlose Möglichkeit zum Experimentieren suchen, finden Sie in meiner Übersicht über kostenlose KI-APIs die aktuellen Optionen.
Ist Kimi K3.1 Pro günstiger als Claude?
Der Listenpreis entspricht mit 2 $/10 $ den Preisen von Claude Sonnet 5.5 und beträgt die Hälfte der Preise von Claude Opus 5.5. Pro Aufgabe ist es bei maximalem Denkaufwand deutlich günstiger als beide: 2,11 $ gegenüber 5,46 $ für Sonnet 5.5 und 5,98 $ für Opus 5.5 bei Artificial Analysis.
Was kostet Kimi K3.1 Pro für einen Kundensupport-Bot?
Bei 10.000 Antworten pro Monat mit jeweils einem gecachten Prompt von 6.000 Tokens, 2.000 neuen Input-Tokens und 1.500 Output-Tokens ergeben sich mit den Preisen von Kimi K3.1 Pro Token-Kosten von etwa 202 $ pro Monat. Die Helpdesk-Anbindung, Tests und Übergaberegeln kommen noch hinzu. Ein einsatzbereiter Kollege für den KI-Kundensupport wie eesel bringt diese Ebene bereits mit.