

Die ähnlichste Alternative zu Kimi K3.1 Pro ist Claude Sonnet 5.5: dieselben 2 $/10 $ pro Million Tokens, etwa die dreifache Ausgabegeschwindigkeit und ein nahezu identisches Benchmark-Ergebnis. Gemini 4 Argon liegt ebenfalls bei 2 $/10 $, allerdings nur bis zum 30. November 2026, danach verdoppelt sich der Preis.
Wenn Ihre Rechnung das Problem ist, sind Gemini 3.8 Flash (etwa $15 pro 1.000 typische Anfragen gegenüber Kimis $40) und DeepSeek V4.1 Flash (etwa $2.70 außerhalb der Spitzenzeiten) die günstigeren Optionen. Wenn Sie offene Modellgewichte suchen, die Sie schon heute herunterladen können: DeepSeek V4.1 Flash und MiMo-V2.6-Pro stehen beide unter MIT-Lizenz.
Die Überraschung ist Claude Opus 5.5: der doppelte Listenpreis, aber bei der Reasoning-Stufe High günstiger pro erledigter Aufgabe (1,82 $ gegenüber 2,11 $ bei Artificial Analysis). Und wenn das Modell Support-Tickets beantworten soll, müssen Sie sich möglicherweise gar nicht für eines entscheiden: Ein KI-Helpdesk-Teammitglied wie eesel läuft bereits auf führenden Modellen und wird zuerst anhand Ihrer vergangenen Tickets getestet.
Warum über Kimi K3.1 Pro hinausblicken?
Kimi K3.1 Pro ist ein sehr gutes Modell, und das möchte ich gleich zu Beginn sagen. Es erreicht 55.1 im Artificial Analysis Intelligence Index, belegt Platz #4 von 215 und kostet in der Kimi API 2 $ für die Eingabe und 10 $ für die Ausgabe pro Million Tokens. Auf Terminal-Bench 4.0 erzielte es mit 67,2 % das höchste Ergebnis aller Modelle auf dieser Seite.
Warum suchen die Leute also schon eine Woche nach der Veröffentlichung nach Alternativen? Nach dem, was ich in den Diskussionen zur Veröffentlichung und aus den Zahlen herausgelesen habe, tauchen vier Gründe immer wieder auf:
- Es ist langsam. Artificial Analysis maß 49.7 Ausgabe-Tokens pro Sekunde gegenüber einem Median vergleichbarer Modelle von 83.1, womit es bei der Geschwindigkeit auf Platz #165 von 182 liegt. Wer auf eine Chat-Antwort wartet, merkt das.
- Es schreibt viel. Für den Durchlauf des Index benötigte es 148M Ausgabe-Tokens, gegenüber einem Median vergleichbarer Modelle von etwa 87M. Dadurch macht sich der günstige Token-Preis auf der Rechnung weniger bemerkbar. Seine durchschnittlichen Kosten pro Index-Aufgabe liegen bei
$2.11, etwas über den$2.00von Kimi K3. - Die Modellgewichte sind noch nicht verfügbar. Laut Moonshots K3.1 Pro-Schnellstartanleitung sollen sie bis zum 4. November veröffentlicht werden. An dem Tag, an dem ich nachgesehen habe, gab es auf Hugging Face kein K3.1 Pro-Repository.
- Weniger Bezugsmöglichkeiten. Kimis Batch API deckt K3.1 Pro nicht ab, und bei den Endkundentarifen sind die 5-Stunden-Limits schnell erreicht, wie ein Käufer es ausdrückte:
"If you are expecting any sort of usable limits on their subscription plan I suggest adjusting your expectations. I subscribed to $99 a month plan and within 47 minutes with one session (not asking for swarms or anything) was limited by 5-hour quota."

Keiner dieser Punkte ist für sich genommen ein Ausschlusskriterium. Aber jeder weist auf eine andere Alternative hin. Deshalb habe ich diese Liste nach Ihrem Wechselgrund sortiert, nicht nach einer einzigen Rangliste. Mein Testbericht zu Kimi K3.1 Pro enthält die vollständige Bewertung, falls Sie noch überlegen, ob Sie überhaupt wechseln sollten.
Wie habe ich sie verglichen?
Ich entwickle KI-Agenten bei eesel, wo unser Team seit Jahren führende Modelle in echten Support-Warteschlangen einsetzt. Die Erkenntnis, die hängen geblieben ist: Der Preis pro Token sagt fast nichts über die Rechnung aus. Entscheidend sind die Kosten pro erfolgreich erledigter Aufgabe, also die Gesamtausgaben für eine Reihe realer Aufgaben geteilt durch die Anzahl der korrekt erledigten Aufgaben. Ein Modell, dessen Listenpreis halb so hoch ist, das aber doppelt so viele Tokens schreibt oder bei jeder vierten Aufgabe scheitert, ist nicht günstiger.
Deshalb habe ich mir für jede Alternative drei Zahlen angesehen:
- Listenpreis, ausschließlich von der Preisseite oder aus der Dokumentation des Anbieters.
- Kosten pro 1.000 Anfragen für einen typischen Aufruf mit 10.000 Eingabe-Tokens und 2.000 Ausgabe-Tokens, ohne Caching. Das ist eine Untergrenze, weil Reasoning-Modelle in der Regel weit mehr als 2.000 Tokens schreiben.
- Kosten pro Aufgabe und Ergebnis im Artificial Analysis Intelligence Index, der jedes Modell dieselben 10 Evaluierungen durchlaufen lässt. Er ist die beste öffentlich verfügbare Annäherung an die Kosten pro erfolgreich erledigter Aufgabe.
Ich habe die sieben Optionen in drei Kategorien eingeteilt, so wie die meisten Käufer an die Sache herangehen: ein Herausforderer derselben Klasse zu ungefähr Kimis Preis, ein günstigeres Modell für hohe Volumen und offene Modellgewichte, die Sie selbst hosten können.
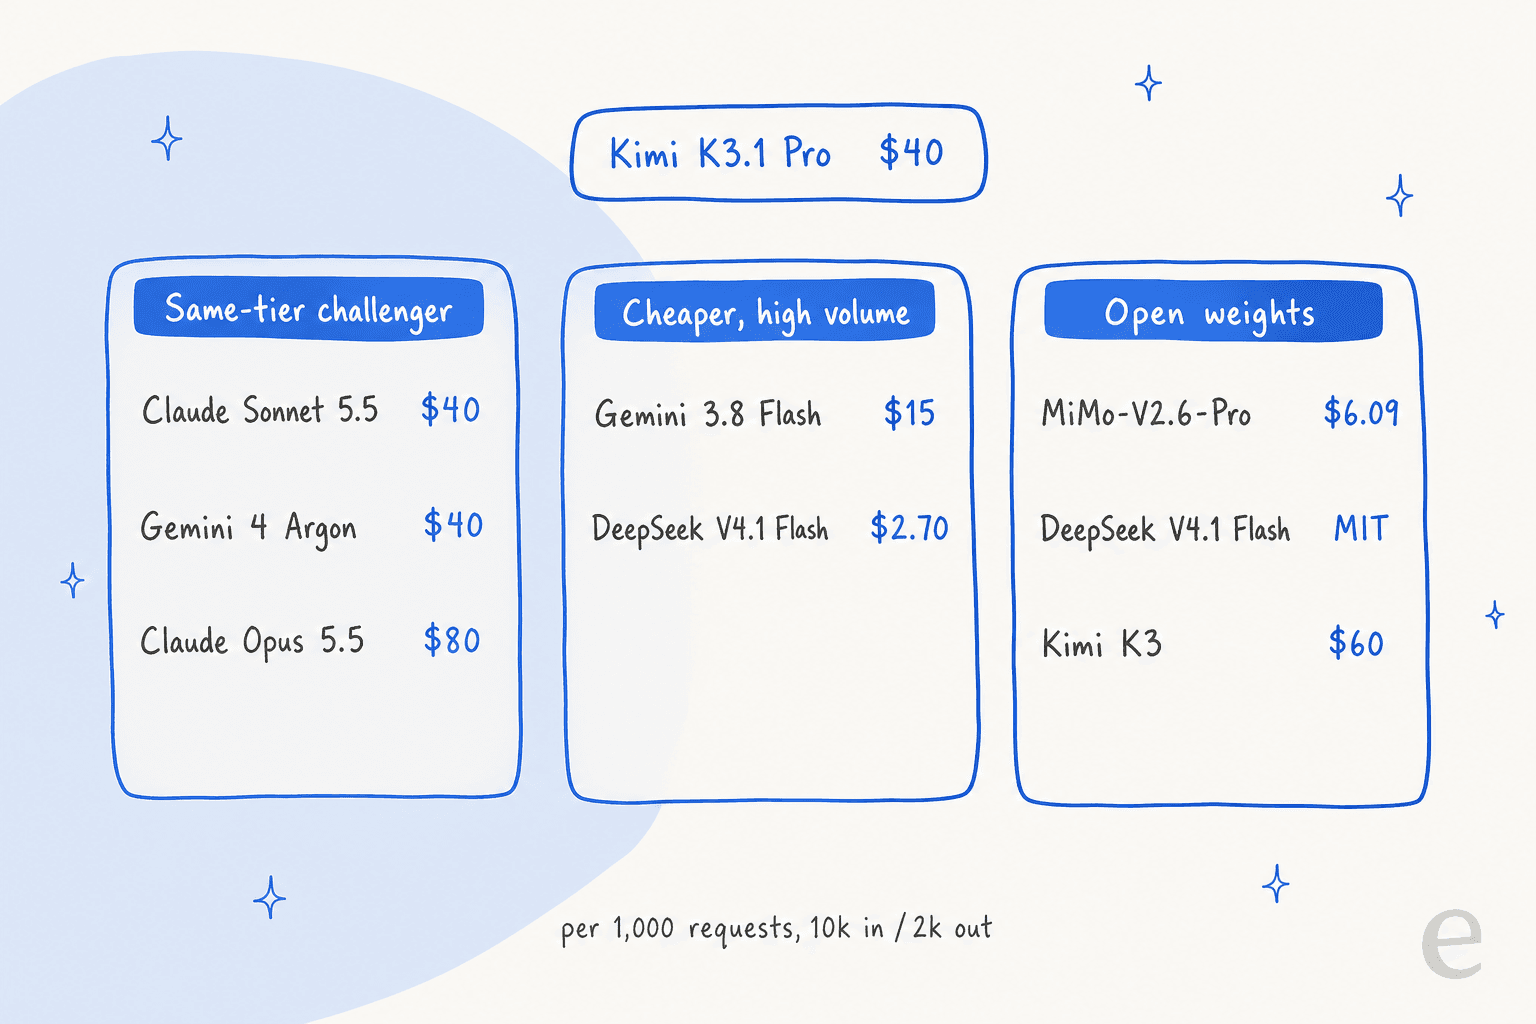
Kimi K3.1 Pro-Alternativen auf einen Blick
Alle folgenden Preise stammen von der jeweiligen Anbieterseite. Die Spalten zu Benchmark, Geschwindigkeit und Kosten pro Aufgabe stammen von Artificial Analysis, jeweils auf der in Klammern angegebenen Reasoning-Stufe.
| Modell | Kategorie | Eingabe / Ausgabe pro 1M | Gecachte Eingabe pro 1M | Kontext | Max. Ausgabe | Pro 1.000 Anfragen (10k Eingabe / 2k Ausgabe) | AA Intelligence Index | AA-Kosten pro Aufgabe | Ausgabegeschwindigkeit (t/s) | Modellgewichte |
|---|---|---|---|---|---|---|---|---|---|---|
| Kimi K3.1 Pro (Referenz) | k. A. | 2 $ / 10 $ | 0,20 $ | 1M | Standardmäßig 131K, bis zu 1M | 40 $ | 55.1 | 2,11 $ | 49.7 | Bis zum 4. November zugesagt |
| Claude Sonnet 5.5 | Gleiche Klasse | 2 $ / 10 $ | 0,10 $ | 1M | 128K | 40 $ | 56.0 (Max), 51.9 (Xhigh) | 5,46 $ (Max), 2,01 $ (Xhigh) | 141.3 (Max) | Geschlossen |
| Gemini 4 Argon | Gleiche Klasse | 2 $ / 10 $ bis 30. November, danach 4 $ / 20 $ | 0,10 $, danach 0,20 $ | 1M | Standardmäßig 65K, bis zu 1M | 40 $, danach 80 $ | 52.6 (High) | 1,62 $ (High) | 79.7 (High) | Geschlossen |
| Claude Opus 5.5 | Gleiche Klasse, Premium | 4 $ / 20 $ | 0,20 $ | 1M | 128K | 80 $ | 57.6 (Max), 53.6 (High) | 5,98 $ (Max), 1,82 $ (High) | 98.1 (Max) | Geschlossen |
| Gemini 3.8 Flash | Günstiger | 0,75 $ / 3,75 $ bis 31. Dezember, danach 1,50 $ / 7,50 $ | 0,075 $, danach 0,15 $ | 1M | 65K | 15 $, danach 30 $ | 41 (High) | k. A. | 133.7 (High) | Geschlossen |
| DeepSeek V4.1 Flash | Günstiger, offen | 0,15 $ / 0,60 $ außerhalb der Spitzenzeiten, 0,30 $ / 1,20 $ zu Spitzenzeiten | 0,003 $ außerhalb der Spitzenzeiten | 1M | 384K | 2,70 $ außerhalb der Spitzenzeiten, 5,40 $ zu Spitzenzeiten | 45.1 (Max) | 0,26 $ (Max) | 169.3 (Max) | MIT |
| MiMo-V2.6-Pro | Offene Modellgewichte | 0,435 $ / 0,87 $ | 0,0036 $ | 1M | Nicht angegeben | 6,09 $ | 46.3 | Etwa 0,14 $ | 54.7 | MIT |
| Kimi K3 | Offen, gleiche Familie | 3 $ / 15 $ | 0,30 $ | 1M | Standardmäßig 131K, bis zu 1M | 60 $ | 43.6 (Max) | 2,00 $ (Max) | 54.5 (Max) | Kimi K3-Lizenz |
Zwei Dinge fallen auf. Erstens ist die gleiche Klasse dicht besetzt: Drei Modelle liegen wie Kimi bei 40 $ pro 1.000 Anfragen, zumindest vorerst. Zweitens bringt die Spalte mit den Kosten pro Aufgabe die Reihenfolge durcheinander. Opus 5.5 auf High und Gemini 4 Argon auf High erledigen eine durchschnittliche Aufgabe beide günstiger als Kimi K3.1 Pro, obwohl Opus pro Token doppelt so viel kostet.
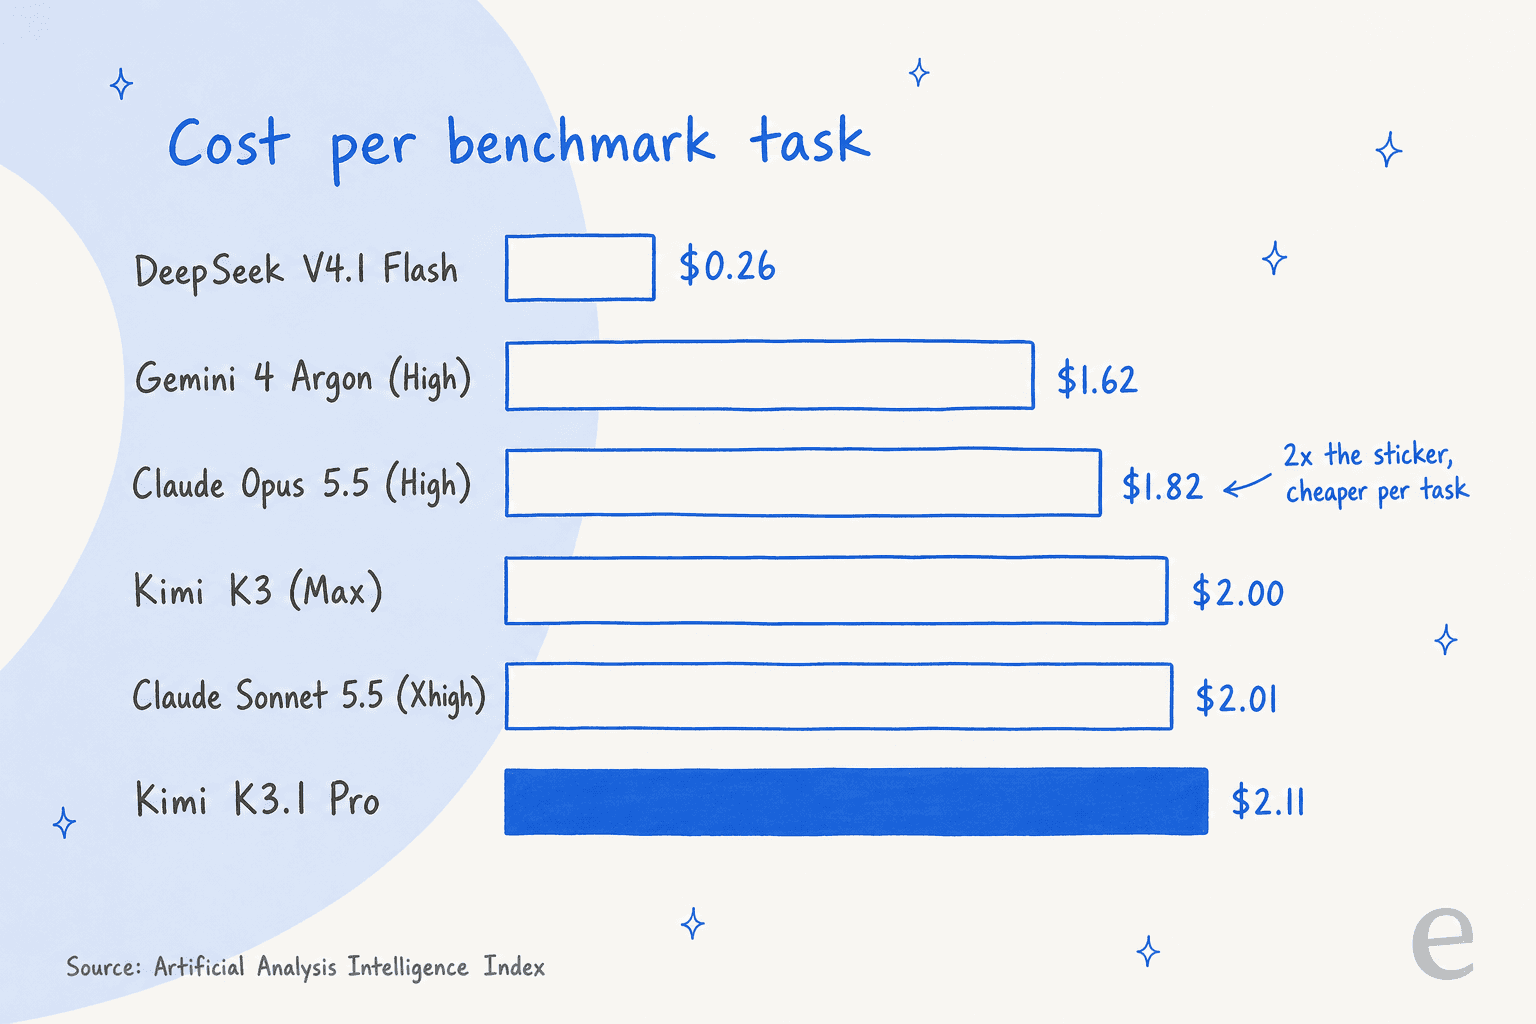
Eine Einschränkung zu diesem Diagramm: Kimi K3.1 Pro lief standardmäßig mit maximalem Reasoning-Aufwand, während Opus und Argon auf High liefen. Genau darum geht es aber. Der Reasoning-Aufwand ist eine Einstellung, die Sie anpassen können, und die günstigste gute Antwort kommt oft von einem stärkeren Modell auf einer niedrigeren Stufe.
Welche Alternative passt zu Ihrem Produkt?
Wählen Sie die Aufgabe, die Ihr Produkt erfüllt, und die Karte zeigt, womit ich den Vergleichstest beginnen würde.
Wählen Sie eine Aufgabe aus, um das Modell zu sehen, das ich zuerst gegen Kimi K3.1 Pro testen würde, samt Kosten pro 1.000 Anfragen mit 10k Eingabe- und 2k Ausgabe-Tokens.
1. Claude Sonnet 5.5
Am besten geeignet für: Teams, die Kimis Preis mit schnellerer, gleichmäßigerer Ausgabe möchten. Herausforderer derselben Klasse.
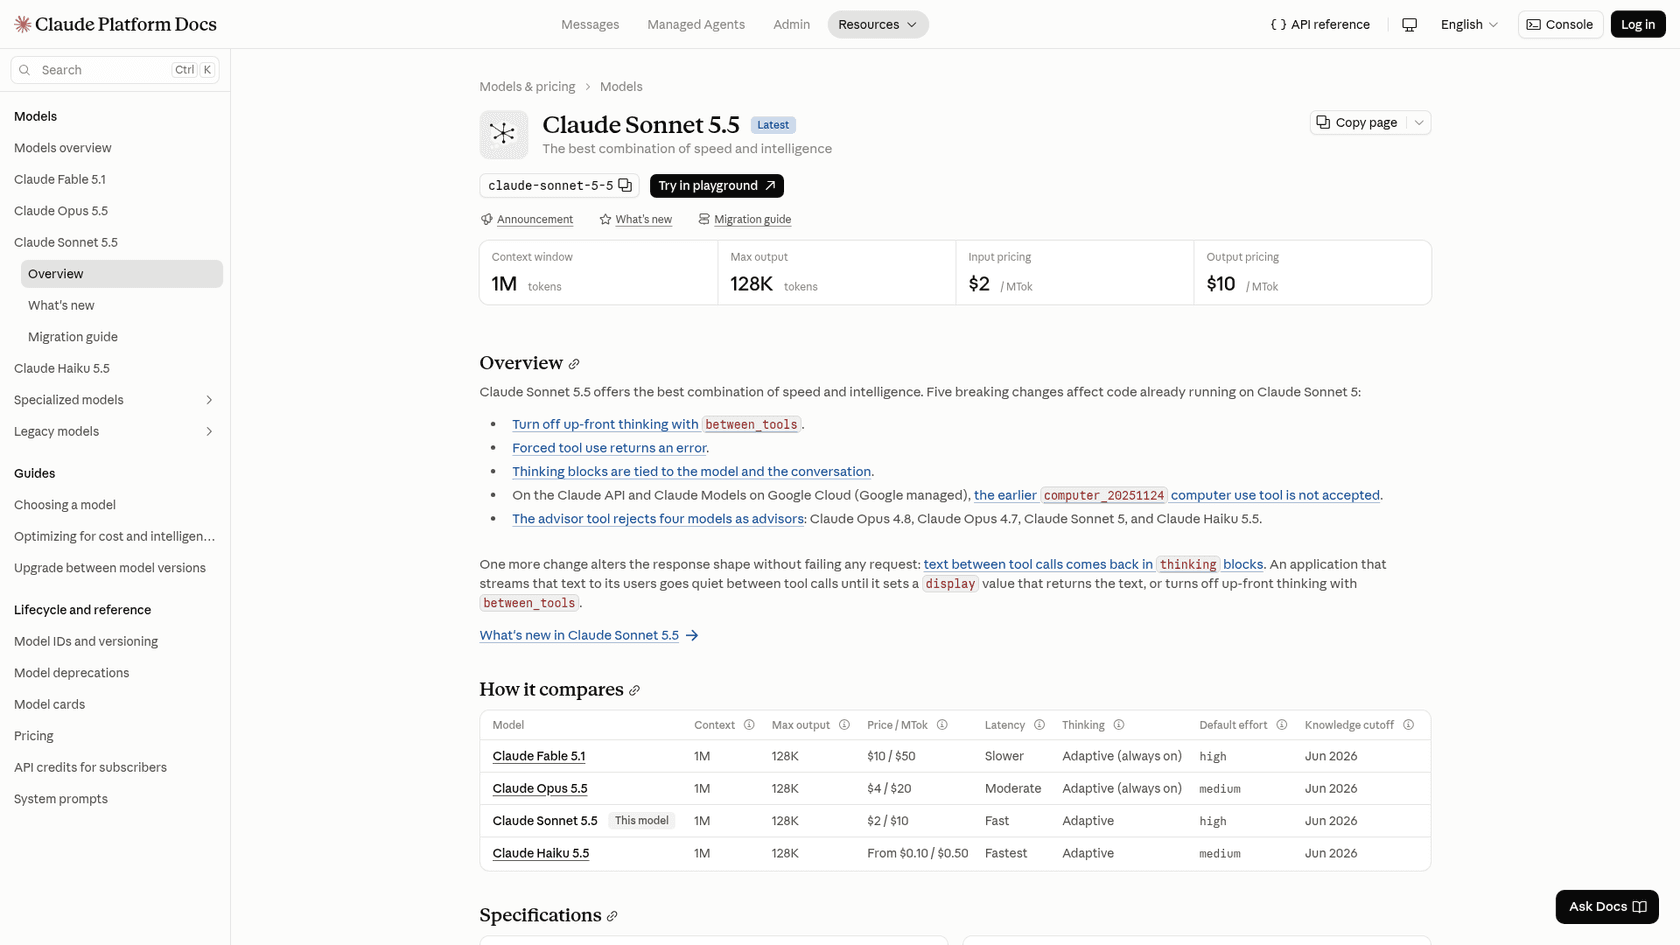
Claude Sonnet 5.5 ist auf dieser Liste der direkteste Ersatz. Anthropic setzt den Listenpreis laut seiner Modellübersicht exakt auf den von Kimi K3.1 Pro: 2 $ für Eingabe und 10 $ für Ausgabe pro Million Tokens, mit einem 1M-Kontextfenster und 128K maximaler Ausgabe.
Warum es Kimi K3.1 Pro vorziehen?
- Geschwindigkeit. Artificial Analysis maß bei maximalem Reasoning-Aufwand 141.3 Tokens pro Sekunde, gegenüber Kimis 49.7.
- Ein etwas höheres Ergebnis. 56.0 im Intelligence Index auf Max, gegenüber 55.1.
- Günstigere Cache-Lesezugriffe. Auf Anthropics Preisseite kosten eine Million gecachte Eingabe-Tokens bei Sonnet 5.5 0,10 $, halb so viel wie Kimis 0,20 $. Bei einem Support-Bot mit einem langen, stabilen System-Prompt summiert sich das.
- Batch. Sonnet 5.5 kostet über Anthropics Batch API 1 $ / 5 $. Kimis Batch API deckt K3.1 Pro nicht ab.
Ein Kommentator in der Diskussion zur Veröffentlichung von K3.1 ließ beide Modelle auf seinem eigenen Benchmark laufen und stellte bei der Qualität einen Gleichstand fest:
"Kimi K3.1 Pro ties Sonnet 5.5 at 93, for $0.68 and 11 min vs Sonnet's $1.61 and 14 min."
Wo es Schwächen hat
Sonnet 5.5 schreibt bei maximalem Reasoning-Aufwand viel. Es benötigte 416M Ausgabe-Tokens für den Durchlauf des Index, sodass seine Kosten pro Aufgabe auf Max bei $5.46 liegen, mehr als doppelt so hoch wie bei Kimi. Auf Xhigh sinkt das Ergebnis auf 51.9 und die Kosten auf $2.01. Außerdem wurden fünf Dinge geändert, die bestehenden Code inkompatibel machen: Erzwungene Tool-Nutzung gibt einen Fehler zurück, und Thinking lässt sich laut der Übersichtsseite nicht mehr auf die bisherige Weise deaktivieren. Wenn Ihr Support-Bot darauf angewiesen ist, einen Tool-Aufruf zu erzwingen, prüfen Sie das zuerst.
Preise
| Posten | Preis pro 1M Tokens |
|---|---|
| Eingabe | 2 $ |
| Ausgabe | 10 $ |
| Cache-Lesezugriff | 0,10 $ |
| Cache-Schreibzugriff für 5 Minuten | 2,50 $ |
| Cache-Schreibzugriff für 1 Stunde | 4 $ |
| Batch-Eingabe / -Ausgabe | 1 $ / 5 $ |
Die vollständige Aufschlüsselung finden Sie in meinem Preisleitfaden zu Sonnet 5.5.
Meine Einschätzung
Wählen Sie Sonnet 5.5, wenn Kimis Geschwindigkeit Ihr Wechselgrund ist, und betreiben Sie es unterhalb des maximalen Reasoning-Aufwands. Verzichten Sie darauf, wenn Ihre Arbeitslast aus langen Agentenläufen mit maximalem Reasoning-Aufwand besteht, bei denen Kimis geringere Token-Anzahl auf der Rechnung gewinnt. Der Testbericht zu Sonnet 5.5 behandelt die Abwägung beim Reasoning-Aufwand im Detail.
2. Gemini 4 Argon
Am besten geeignet für: Aufgaben mit langem Kontext und hohen Genauigkeitsanforderungen zu Kimis Preis, wenn Sie vor Dezember wechseln. Herausforderer derselben Klasse.
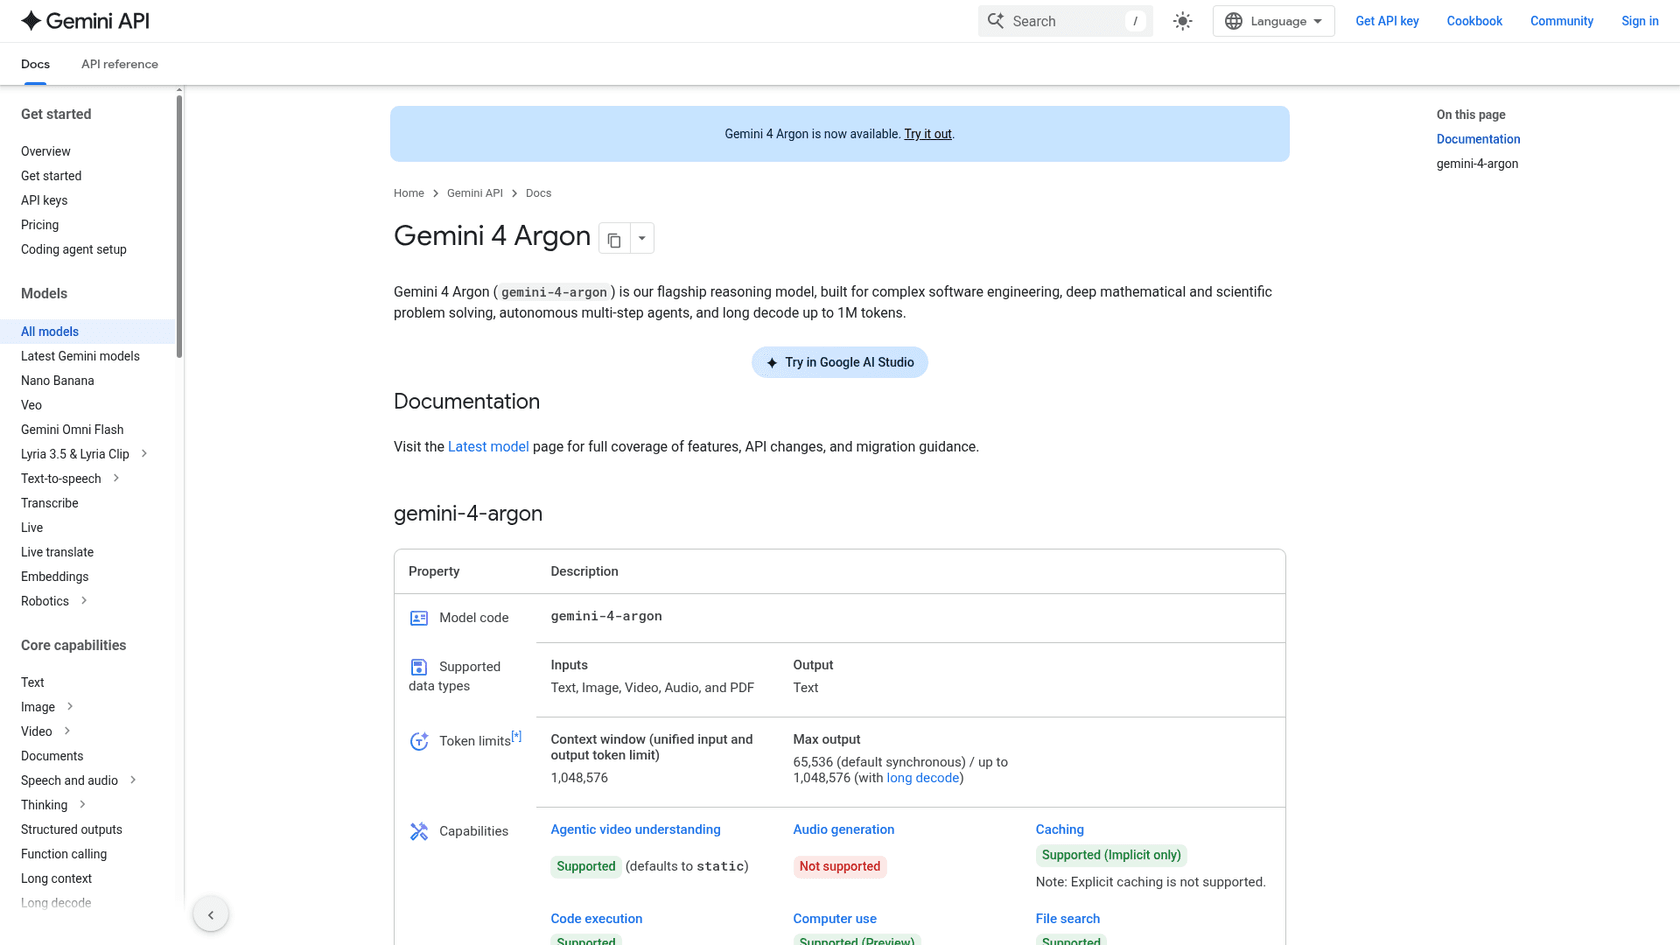
Gemini 4 Argon ist Googles Flaggschiff-Reasoning-Modell und jetzt über die Gemini API verfügbar. In den nächsten Wochen kostet es exakt so viel wie Kimi K3.1 Pro, was es zum unkompliziertesten Vergleichstest innerhalb derselben Klasse macht.
Warum es Kimi K3.1 Pro vorziehen?
- Weniger erfundene Antworten. Artificial Analysis beziffert seine Halluzinationsrate auf 15,1 %, gegenüber 43,9 % bei Kimi K3.1 Pro. Bei allem mit direktem Kundenkontakt wäre das für mich die wichtigste Zahl.
- Günstiger pro Aufgabe. Auf der Reasoning-Stufe High lag es im Schnitt bei
$1.62pro Index-Aufgabe und einem Ergebnis von 52.6. - Lange Ausgabe. Seine Modellseite nennt standardmäßig 65.536 Ausgabe-Tokens und bis zu 1.048.576 mit Long Decode.
- Ihre Daten bleiben vom Training ausgeschlossen. Laut Googles Preisseite wird die Nutzung im kostenpflichtigen Tarif nicht zur Verbesserung seiner Produkte verwendet.
Wo es Schwächen hat
Der Preis ist ein Aktionsangebot. Google nennt 2 $ / 10 $ bis zum 30. November 2026 und 4 $ / 20 $ ab dem 1. Dezember, womit es beim Listenpreis von Opus 5.5 liegt. Explizites Caching wird nicht unterstützt, nur implizites Caching, und es gibt keinen kostenlosen Tarif. Sein Index-Ergebnis von 52.6 auf High liegt 2.5 Punkte unter Kimis Ergebnis.
Preise
| Posten | Bis 30. November 2026 | Ab 1. Dezember 2026 |
|---|---|---|
| Eingabe pro 1M | 2 $ | 4 $ |
| Ausgabe pro 1M (inkl. Thinking) | 10 $ | 20 $ |
| Gecachte Eingabe pro 1M | 0,10 $ | 0,20 $ |
| Batch-Eingabe / -Ausgabe pro 1M | 1 $ / 5 $ | 2 $ / 10 $ |
| Such-Grounding | 5.000 kostenlos pro Monat, danach 14 $ pro 1.000 | Unverändert |
Mehr Details finden Sie in meinem Beitrag zu den Preisen von Gemini 4 Argon.
Meine Einschätzung
Wählen Sie Argon, wenn falsche Antworten Ihr größtes Risiko sind, und kalkulieren Sie mit dem Dezemberpreis, damit Sie keine Überraschung erleben. Verzichten Sie darauf, wenn Sie für das nächste Jahr einen festen Preis benötigen. Der Testbericht zu Gemini 4 Argon zeigt ausführlicher, wo es vorne liegt und wo es hinterherhinkt.
3. Claude Opus 5.5
Am besten geeignet für: die schwierigsten Coding- und Agentenaufgaben, bei denen ein fehlgeschlagener Durchlauf mehr kostet als die Tokens. Premium-Herausforderer derselben Klasse.
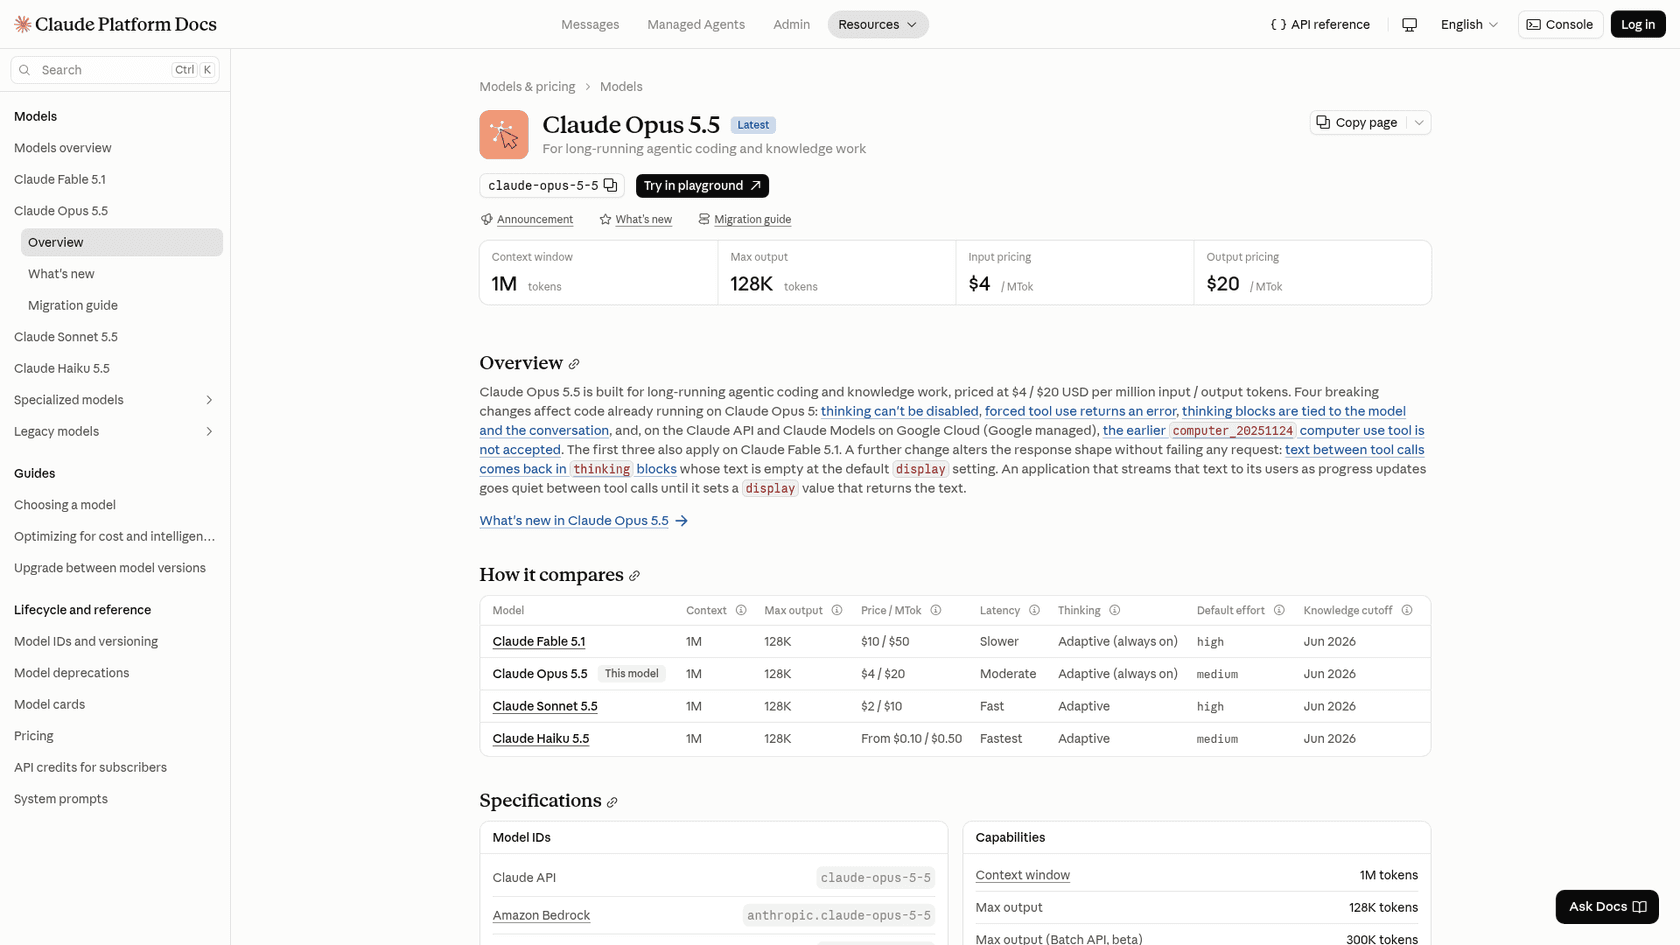
Claude Opus 5.5 ist das Modell, an dem sich Kimi K3.1 Pro misst. Anthropics eigene Modellübersicht empfiehlt Entwicklern inzwischen, bei den meisten Arbeitslasten damit zu beginnen, und seine standardmäßige Reasoning-Stufe ist medium.
Warum es Kimi K3.1 Pro vorziehen?
- Das höchste Ergebnis hier. 57.6 im Intelligence Index auf Max, der Spitzenwert im Vergleich von Artificial Analysis.
- Günstiger pro Aufgabe auf High. 53.6 für
$1.82pro Aufgabe, weniger als Kimis$2.11. - Auch tägliche Nutzer sehen es weiterhin vorn. Auf X verglich ein Tester beide anhand von 180 per Code erzeugten Bildern:
"I feel Opus still nails the subtle details better, like in the tractor example below. But I wonder if it matters when you can run Kimi 3x before it costs the same as one Opus?"
Wo es Schwächen hat
Auf Max ist Opus die teuerste Option: $5.98 pro Aufgabe und 8.708 $ für den vollständigen Index-Durchlauf, gegenüber Kimis 3.117 $. Seine Halluzinationsrate auf Max liegt bei Artificial Analysis bei 58,6 %, höher als Kimis 43,9 %. Und nach Kimis eigenen Zahlen zur Veröffentlichung liegt es auf Terminal-Bench 4.0 weniger als einen Punkt entfernt (65,7 % gegenüber 66,4 %).
Preise
| Posten | Preis pro 1M Tokens |
|---|---|
| Eingabe | 4 $ |
| Ausgabe | 20 $ |
| Cache-Lesezugriff | 0,20 $ |
| Cache-Schreibzugriff für 5 Minuten | 5 $ |
| Cache-Schreibzugriff für 1 Stunde | 8 $ |
| Batch-Eingabe / -Ausgabe | 2 $ / 10 $ |
| Eingabe / Ausgabe im Fast mode | 8 $ / 40 $ |
Alle Angaben stammen von Anthropics Preisseite. Der Beitrag zu den Preisen von Opus 5.5 rechnet reale Rechnungen durch.
Meine Einschätzung
Wählen Sie Opus 5.5 auf High, wenn die Qualität pro Durchlauf der begrenzende Faktor ist und Sie den Reasoning-Aufwand selbst einstellen können. Verzichten Sie darauf, wenn Ihr Anfragevolumen hoch ist und die Aufgaben einfach sind, denn dann bezahlen Sie für Reasoning, das Sie nicht nutzen. Mein Testbericht zu Opus 5.5 geht jede Reasoning-Stufe durch.
4. Gemini 3.8 Flash
Am besten geeignet für: hohes API-Anfragevolumen, bei dem die Antwort nicht innerhalb von zwei Sekunden eintreffen muss. Kategorie: günstiger.
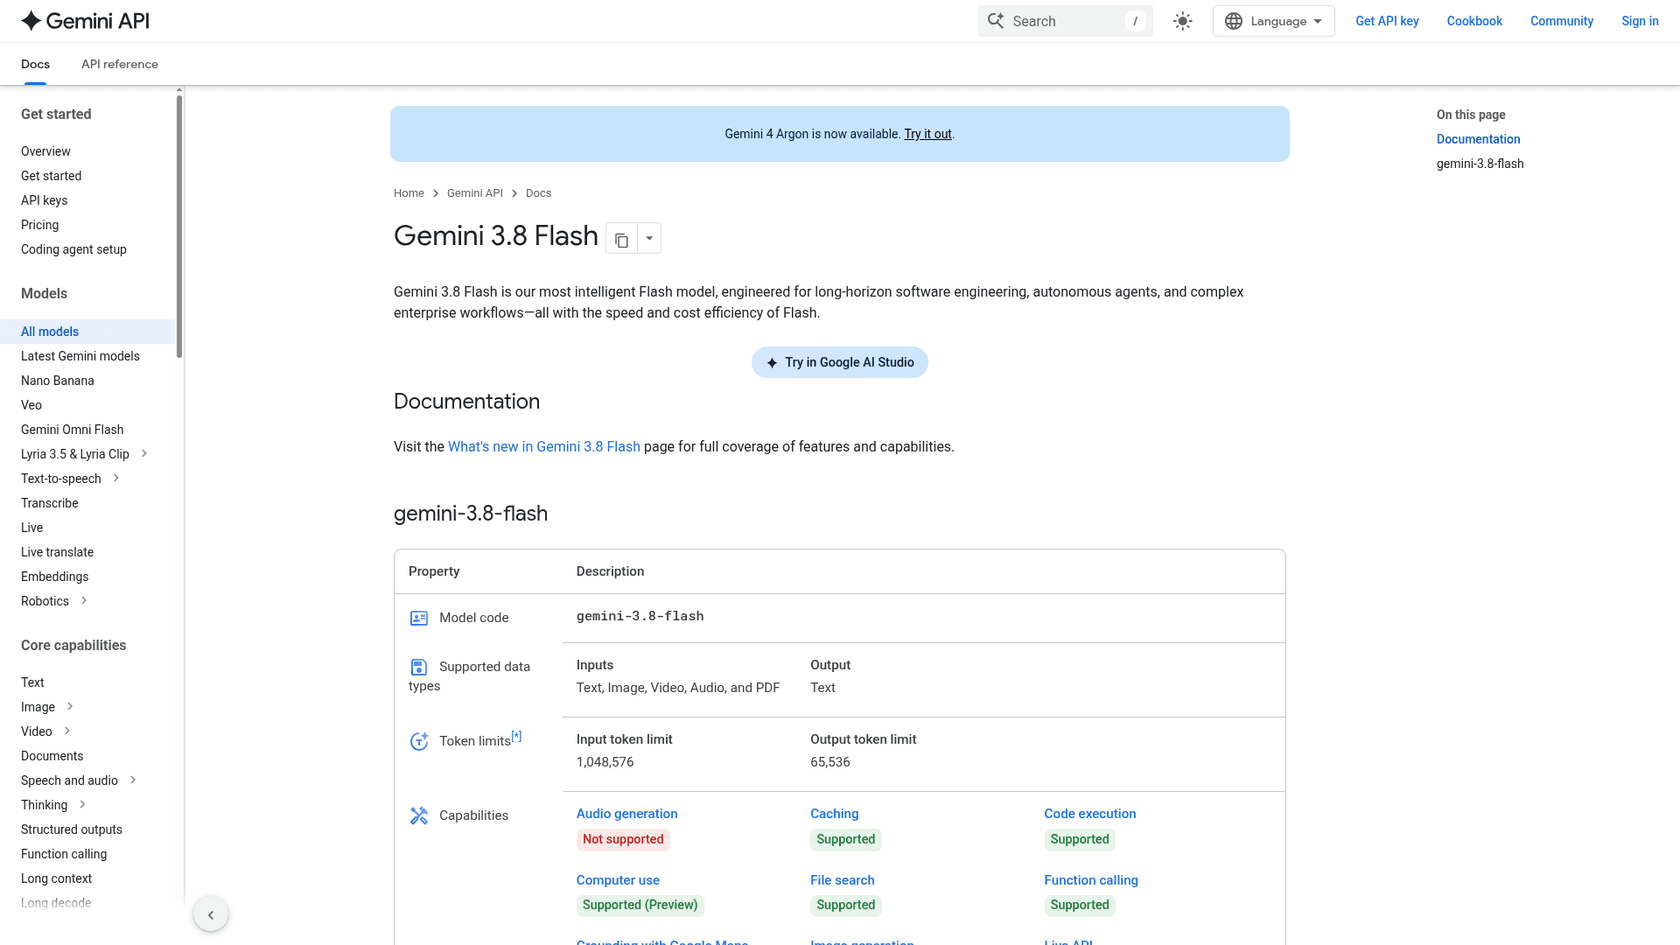
Gemini 3.8 Flash ist hier das günstigste geschlossene Modell. Auf der Preisseite der Gemini API kostet es bis zum 31. Dezember 2026 0,75 $ für Eingabe und 3,75 $ für Ausgabe pro Million Tokens, einschließlich Thinking-Tokens.
Warum es Kimi K3.1 Pro vorziehen?
- Etwa ein Drittel der Rechnung. Rund
$15pro 1.000 typische Anfragen gegenüber Kimis$40. - Schnelle Ausgabe. 133.7 Tokens pro Sekunde bei Artificial Analysis.
- Ein kostenloser Tarif zum Testen und Batch zum halben kostenpflichtigen Preis.
- Vielfältige Eingaben. Text, Bild, Video, Audio und PDF als Eingabe, laut seiner Modellseite.
Wo es Schwächen hat
Bei der Intelligenz ist es ein Schritt zurück: 41 im Intelligence Index auf High, gegenüber Kimis 55.1. Artificial Analysis maß außerdem eine Wartezeit von 28,78 Sekunden bis zum ersten Token, weit über dem Median von 3,90 Sekunden in seiner Preisklasse. Wer auf ein Chat-Fenster starrt, wird das also bemerken. Und am 1. Januar 2027 verdoppelt sich der Preis auf 1,50 $ / 7,50 $.
Preise
| Posten | Bis 31. Dezember 2026 | Ab 1. Januar 2027 |
|---|---|---|
| Eingabe pro 1M | 0,75 $ | 1,50 $ |
| Ausgabe pro 1M (inkl. Thinking) | 3,75 $ | 7,50 $ |
| Gecachte Eingabe pro 1M | 0,075 $ | 0,15 $ |
| Batch-Eingabe / -Ausgabe pro 1M | 0,375 $ / 1,875 $ | 0,75 $ / 3,75 $ |
| Kostenloser Tarif | Ja | Ja |
Mein Beitrag zu den Preisen von Gemini 3.8 Flash enthält durchgerechnete Beispiele.
Meine Einschätzung
Wählen Sie 3.8 Flash für Hintergrundaufgaben: Tagging, Zusammenfassungen, Agentenläufe über Nacht. Verzichten Sie bei Live-Chats darauf, bis Sie die Wartezeit auf das erste Token selbst gemessen haben. Der Testbericht zu Gemini 3.8 Flash behandelt das Latenzproblem.
5. DeepSeek V4.1 Flash
Am besten geeignet für: die niedrigste Rechnung auf dieser Liste, mit offenen Modellgewichten als Absicherung. Kategorie: günstiger und offene Modellgewichte.
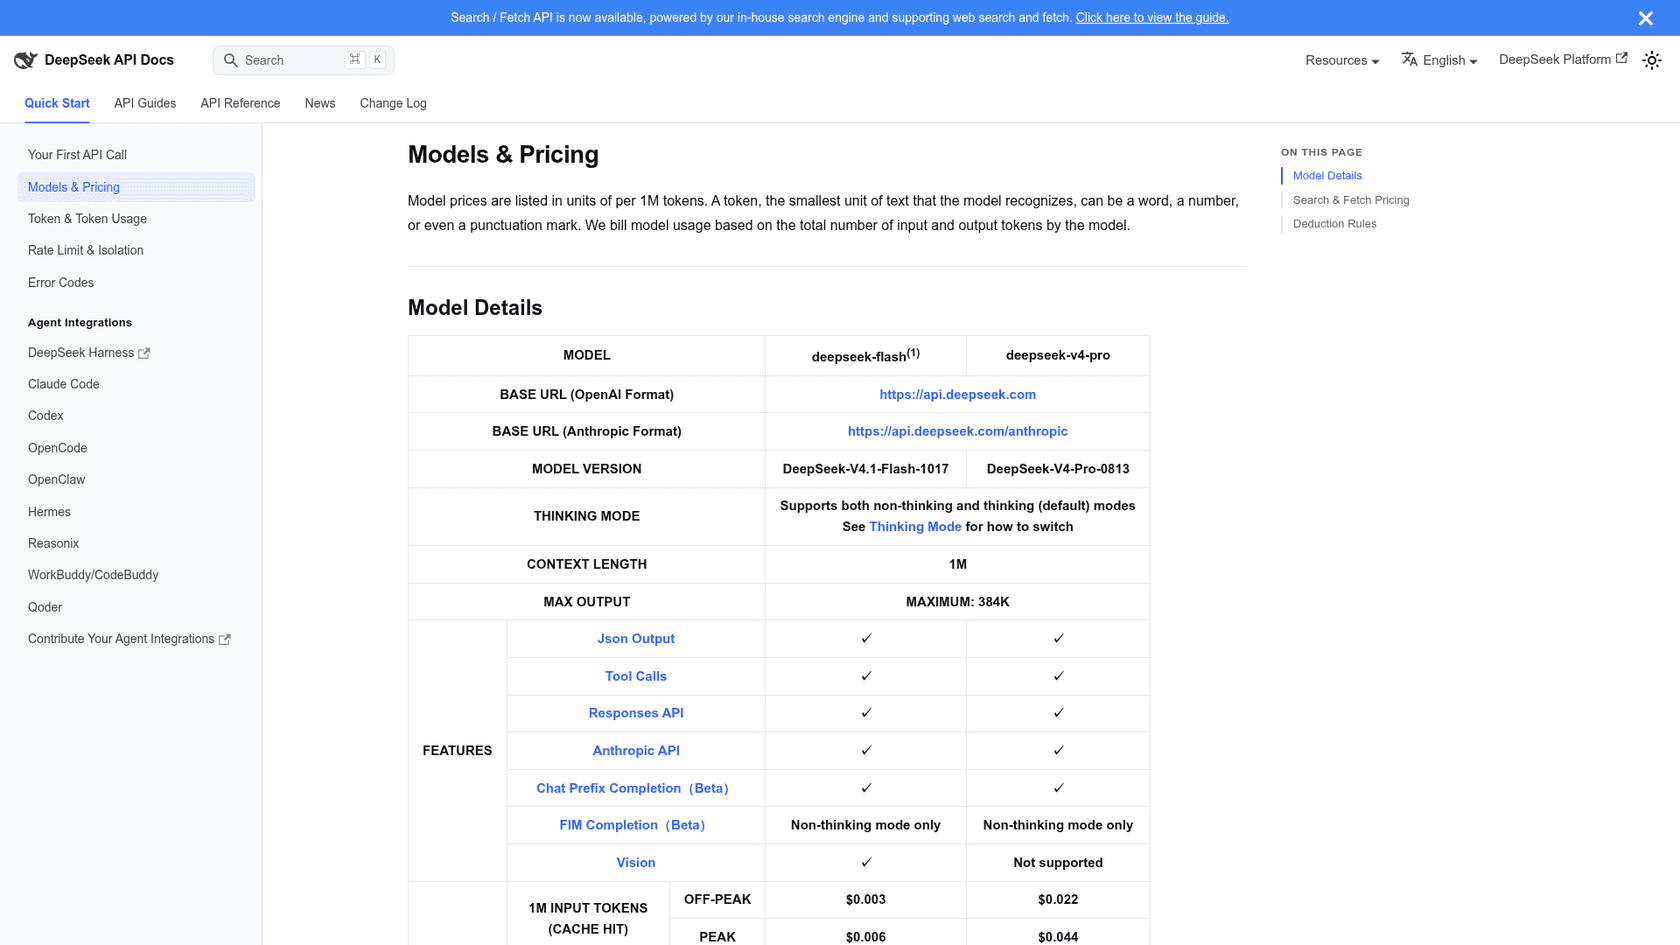
DeepSeek V4.1 Flash bildet die Preisuntergrenze dieser Gruppe. Auf DeepSeeks Seite zu Modellen und Preisen kostet das Modell deepseek-flash (inzwischen Build 1017) außerhalb der Spitzenzeiten 0,15 $ für Eingabe und 0,60 $ für Ausgabe pro Million Tokens.
Warum es Kimi K3.1 Pro vorziehen?
- Etwa 15x günstiger pro Anfrage. Rund
$2.70pro 1.000 typische Anfragen außerhalb der Spitzenzeiten, gegenüber$40. - Etwa 8x günstiger pro Aufgabe.
$0.26pro Artificial Analysis-Aufgabe, gegenüber$2.11, bei einem Ergebnis von 45.1. - Schnell. 169.3 Tokens pro Sekunde, das schnellste Modell hier.
- Offene Modellgewichte schon jetzt. Unter MIT-Lizenz auf Hugging Face, etwa 763B Parameter.
Auf dem realen Bugfixing-Benchmark eines Testers landete es sogar vorne:
"So I tested Kimi K3.1 Pro on real work. 2 repos. 105 replanted bugs. Find and fix what you can. The results: DeepSeek V4.1 Flash 1017 (max): 42.7 Muse Wonder Full 1.0 (max): 42 Opus 5.5 (max): 41.7 Kimi K3.1 Pro (max): 36 Muse Spark 1.3 (max): 32.2 I'm sorry. Considering the cost, I see no reason to use this model."
Wo es Schwächen hat
Sein Index-Ergebnis liegt 10 Punkte unter Kimis Ergebnis. Die günstigen Aufgaben sind also zum Teil deshalb günstig, weil die Antworten einfacher ausfallen. Zu Spitzenzeiten verdoppeln sich die Preise (werktags von 01:00 bis 04:00 und von 06:00 bis 10:00 UTC). Und was Kundendaten betrifft: DeepSeeks API-Bedingungen enthalten weder eine veröffentlichte Vereinbarung zur Auftragsverarbeitung noch eine Option ohne Datenspeicherung. Lassen Sie das also rechtlich prüfen, bevor Sie Support-Tickets darüber verarbeiten.
Preise
| Posten | Außerhalb der Spitzenzeiten pro 1M | Zu Spitzenzeiten pro 1M |
|---|---|---|
| Eingabe, Cache-Treffer | 0,003 $ | 0,006 $ |
| Eingabe, Cache-Fehltreffer | 0,15 $ | 0,30 $ |
| Ausgabe | 0,60 $ | 1,20 $ |
| Search oder Fetch API | 0,75 $ pro 1.000 Anfragen | Unverändert |
Mehr dazu finden Sie in meinem Preisleitfaden zu DeepSeek V4.1 Flash und im Testbericht zum 1017-Update.
Meine Einschätzung
Wählen Sie DeepSeek V4.1 Flash für Aufgaben mit hohem Volumen, bei denen ein Modell mit 45 Punkten gut genug ist, und leiten Sie die schwierigen Aufgaben an ein anderes Modell weiter. Verzichten Sie bei regulierten Kundendaten darauf, sofern Sie die Modellgewichte nicht selbst hosten.
6. MiMo-V2.6-Pro
Am besten geeignet für: offene Modellgewichte von einem zweiten Anbieter zu einem sehr niedrigen API-Preis. Kategorie: offene Modellgewichte.
MiMo-V2.6-Pro ist Xiaomis Modell mit einer Billion Parametern, das im September mit Modellgewichten unter MIT-Lizenz veröffentlicht wurde. Xiaomis Beitrag zur Veröffentlichung bezeichnet es als das zum Veröffentlichungszeitpunkt leistungsfähigste verfügbare Open-Source-Modell, mit 46 Punkten im Artificial Analysis Index.
Warum es Kimi K3.1 Pro vorziehen?
- Etwa ein Sechstel des Preises pro Anfrage. 0,435 $ für Eingabe und 0,87 $ für Ausgabe pro Million Tokens laut Xiaomis internationaler Preisübersicht, also etwa
$6.09pro 1.000 typische Anfragen. - Eine winzige Rechnung für den gesamten Index. Artificial Analysis gab etwa
$207aus, um seinen gesamten Index mit MiMo-V2.6-Pro durchlaufen zu lassen, gegenüber$3,117bei Kimi K3.1 Pro. - Modellgewichte, die Sie heute herunterladen können, unter MIT-Lizenz, auf Hugging Face.
- Eine Batch API zum halben Preis, die Kimi für K3.1 Pro nicht anbietet.
Wo es Schwächen hat
Es erreicht 46.3, neun Punkte weniger als Kimi. Es ist genauso langsam (54.7 Tokens pro Sekunde), mit einer Wartezeit von 3,29 Sekunden bis zum ersten Token. Xiaomi bietet einen UltraSpeed-Modus mit bis zu 20x schnellerer Ausgabe an, allerdings zum 10x höheren Preis (4,35 $ / 8,70 $). Und bei etwa 1.02T Parametern bedeutet Selbsthosting weiterhin einen Multi-GPU-Cluster.
Preise
| Posten | Echtzeit pro 1M | Batch pro 1M |
|---|---|---|
| Eingabe, Cache-Treffer | 0,0036 $ | 0,0018 $ |
| Eingabe, Cache-Fehltreffer | 0,435 $ | 0,2175 $ |
| Ausgabe | 0,87 $ | 0,435 $ |
| UltraSpeed-Eingabe / -Ausgabe | 4,35 $ / 8,70 $ | Nicht angeboten |
Mehr dazu finden Sie in meiner Preisaufschlüsselung zu MiMo V2.6.
Meine Einschätzung
Wählen Sie MiMo-V2.6-Pro, wenn Sie offene Modellgewichte und eine günstige gehostete API vom selben Anbieter möchten und Ihre Aufgaben kein Reasoning auf Kimi-Niveau benötigen. Verzichten Sie bei allem Latenzkritischen darauf, es sei denn, Sie bezahlen für UltraSpeed. Der Testbericht zu MiMo V2.6 enthält die Benchmarks.
7. Kimi K3
Am besten geeignet für: bei Moonshot bleiben und dabei Modellgewichte nutzen, die bereits öffentlich sind. Offene Modellgewichte, gleiche Familie.
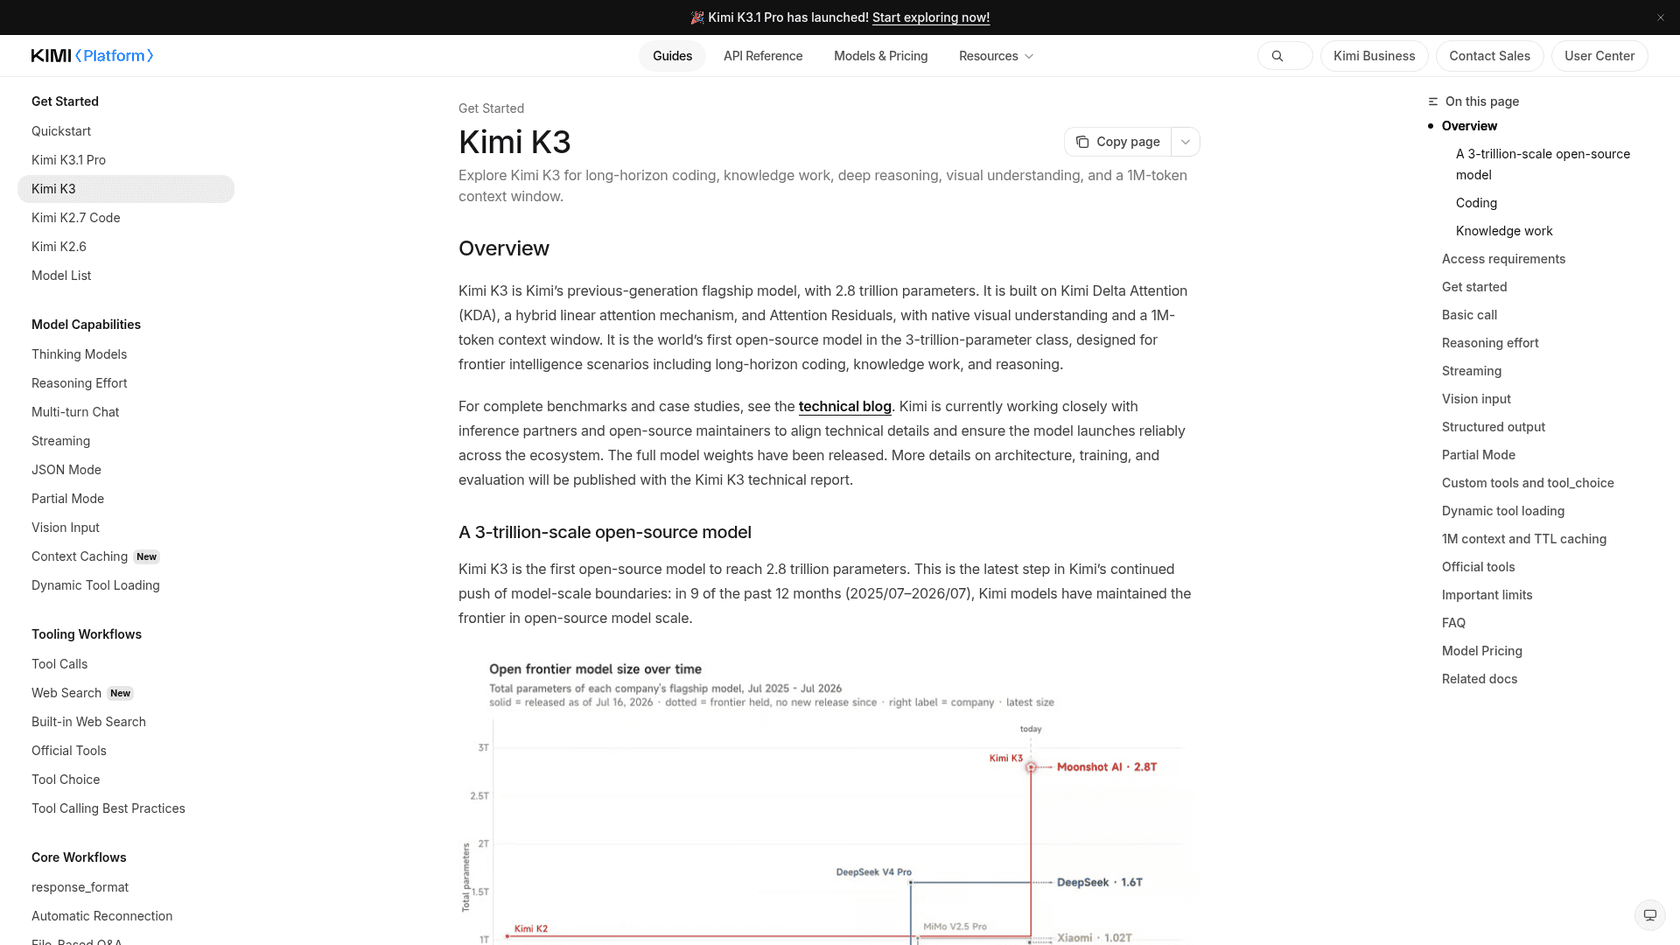
Kimi K3 ist das Basismodell von K3.1 Pro. Moonshots Schnellstartanleitung bezeichnet es inzwischen als "previous-generation flagship", und seine Modellgewichte sind bereits auf Hugging Face verfügbar.
Warum es Kimi K3.1 Pro vorziehen?
- Modellgewichte heute, nicht erst bis zum 4. November. Etwa 2.78T Parameter im öffentlichen Repository.
- Gleiche API, gleiche Tools. Wenn Sie auf der Kimi API aufgebaut haben, besteht die gesamte Migration darin, die Modell-ID zu wechseln.
- Gleiche Kosten pro Aufgabe.
$2.00pro Artificial Analysis-Aufgabe, gegenüber$2.11bei K3.1 Pro.
Wo es Schwächen hat
Ehrlich gesagt gibt es kaum einen Grund, es für neue gehostete Anwendungen zu wählen. Es kostet mehr pro Token (3 $ / 15 $), erreicht 43.6 gegenüber 55.1 und schaffte auf Terminal-Bench 4.0 nur 12,6 % gegenüber den 67,2 % von K3.1 Pro. Seine Lizenz enthält außerdem zusätzliche Bedingungen für sehr große Produkte und Unternehmen, die Modelle hosten. Wenn Sie nur die Modellgewichte von K3.1 Pro benötigen, ist es wahrscheinlich besser, eine oder zwei Wochen zu warten.
Preise
| Posten | Preis pro 1M Tokens |
|---|---|
| Eingabe, Cache-Fehltreffer | 3 $ |
| Eingabe, Cache-Treffer | 0,30 $ |
| Ausgabe | 15 $ |
| Cache-Schreibzugriff für 5 Minuten | 3 $ |
| Cache-Schreibzugriff für 1 Stunde | 6 $ |
Von der Preisseite von Kimi. Mein Beitrag zu den Preisen von Kimi K3 enthält die Preisentwicklung.
Meine Einschätzung
Wählen Sie K3 nur, wenn Sie noch diese Woche offene Kimi-Modellgewichte benötigen. Bleiben Sie ansonsten bei K3.1 Pro oder wählen Sie eine der sechs Optionen oben. Der Testbericht zu Kimi K3 und mein Vergleich von DeepSeek und Kimi K3 gehen ausführlicher darauf ein.
Was kosten 1.000 Anfragen bei den einzelnen Modellen?
Hier ist dieselbe typische Anfrage, 10.000 Eingabe-Tokens und 2.000 Ausgabe-Tokens ohne Caching, berechnet zum Listenpreis des jeweiligen Anbieters. Das ist die Zahl, mit der die meisten Kostenschätzungen beginnen.
| Modell | Eingabe / Ausgabe pro 1M | Kosten pro Anfrage | Kosten pro 1.000 Anfragen |
|---|---|---|---|
| DeepSeek V4.1 Flash (außerhalb der Spitzenzeiten) | 0,15 $ / 0,60 $ | 0,0027 $ | 2,70 $ |
| DeepSeek V4.1 Flash (zu Spitzenzeiten) | 0,30 $ / 1,20 $ | 0,0054 $ | 5,40 $ |
| MiMo-V2.6-Pro | 0,435 $ / 0,87 $ | 0,0061 $ | 6,09 $ |
| Gemini 3.8 Flash (bis 31. Dezember) | 0,75 $ / 3,75 $ | 0,015 $ | 15 $ |
| Gemini 3.8 Flash (ab 1. Januar 2027) | 1,50 $ / 7,50 $ | 0,030 $ | 30 $ |
| Kimi K3.1 Pro | 2 $ / 10 $ | 0,040 $ | 40 $ |
| Claude Sonnet 5.5 | 2 $ / 10 $ | 0,040 $ | 40 $ |
| Gemini 4 Argon (bis 30. November) | 2 $ / 10 $ | 0,040 $ | 40 $ |
| Kimi K3 | 3 $ / 15 $ | 0,060 $ | 60 $ |
| Claude Opus 5.5 | 4 $ / 20 $ | 0,080 $ | 80 $ |
| Gemini 4 Argon (ab 1. Dezember) | 4 $ / 20 $ | 0,080 $ | 80 $ |
| Kimi K3.1 Pro Highspeed | 4 $ / 20 $ | 0,080 $ | 80 $ |
Nun die Warnung. Reasoning-Modelle hören selten bei 2.000 Ausgabe-Tokens auf. Im Artificial Analysis Index schrieb Kimi K3.1 Pro 55.195 Ausgabe-Tokens pro Aufgabe, größtenteils für Reasoning. Deshalb ist die Spalte mit den Kosten pro Aufgabe in der Übersichtstabelle wichtiger als diese hier, und deshalb sollten Sie diese Rechnung vor dem Wechsel mit Ihren eigenen Anfragen wiederholen.
So würde ich vorgehen: Nehmen Sie 100 reale Anfragen aus Ihrem Produkt, lassen Sie sie durch zwei oder drei dieser Modelle laufen und bewerten Sie die Antworten. Teilen Sie dann die Ausgaben für jedes Modell durch die Anzahl der Antworten, die Sie tatsächlich ausliefern würden. Das sind Ihre Kosten pro erfolgreich erledigter Aufgabe, und es ist die einzige Zahl, die die Entscheidung klärt. Mein Preisleitfaden zu Kimi K3.1 Pro geht dieselbe Rechnung nur für Kimi durch.
Sollte ein Support-Team überhaupt ein Modell auswählen?
Wenn Ihr Produkt ein Support-Bot ist, setzt diese ganze Liste eine Ebene zu tief an. Ein Modell ist Infrastruktur. Was Ihren Kunden antwortet, ist alles, was darum herum gebaut wurde: welche vergangenen Tickets es liest, welchen Regeln es folgt, wann es an einen Menschen übergibt und wie Sie es vor dem Livegang prüfen.
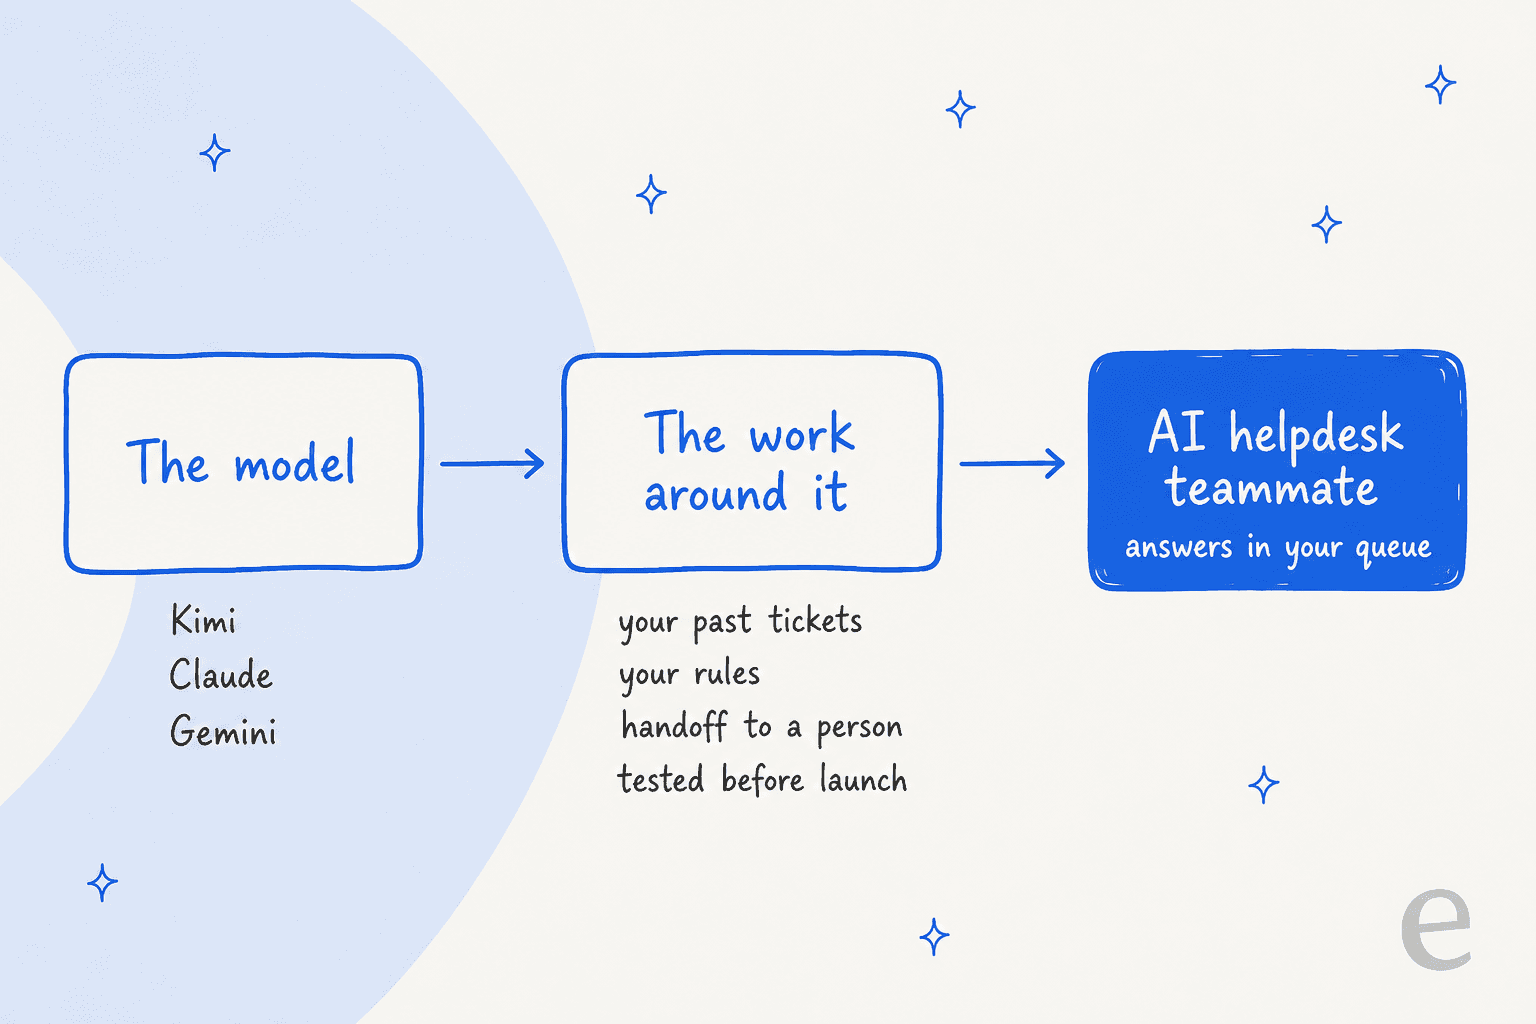
Das ist der Teil, mit dem ich mich bei eesel täglich beschäftige. Ich habe erlebt, wie ein selbstsicheres Modell in einer echten Warteschlange flüssige, aber falsche Antworten gab. Deshalb spielt mittlerweile jede eesel-Einführung zunächst Hunderte vergangene Tickets erneut durch und bewertet die Entwürfe anhand dessen, was das Team tatsächlich gesendet hat. Die Modellwahl ist weiterhin wichtig. Sie ist nur nicht die Entscheidung, von der der Erfolg oder Misserfolg eines Support-Bots abhängt.
Qontro, ein ERP-Unternehmen aus Neuseeland, ist ein gutes Beispiel. Es verband Freshdesk im Juli 2026 mit eesel und lud etwa 9.800 vergangene Tickets und Hilfeartikel. Zwischen dem 8. August und dem 8. September entwarf eesel Antworten für etwa 190 Tickets und führte dabei rund 400 Wissenssuchen durch. Ausfälle, Datenverlust und Abrechnung gehen direkt an einen Menschen. Das Team vergleicht jeden Entwurf mit der tatsächlich gesendeten Antwort und nutzt die Lücken, um das Hilfecenter zu verbessern. Niemand bei Qontro musste dafür einen Modellvergleich durchführen.
Für Entwickler, die lieber im Terminal bleiben, steuert die eesel CLI dasselbe Teammitglied. npx @eesel/cli init chat-bubble --site https://your-site.com richtet einen Agenten mit einer Website-Chatblase ein, der Ihre Seiten liest, und mit eesel chat können Sie ihn über die Kommandozeile testen. Jeder Befehl gibt JSON aus, sodass ein Coding-Agent wie Claude Code oder Cursor die Einrichtung für Sie übernehmen kann. Mein Beitrag über KI-Agenten-CLIs erklärt, warum das wichtig ist.
Testen Sie eesel für Ihre Support-Warteschlange
Wenn Sie Kimi K3.1 Pro oder eines dieser Modelle zur Beantwortung von Kundentickets in Betracht gezogen haben, probieren Sie zuerst den anderen Weg. eesel ist ein KI-Helpdesk-Teammitglied, das sich in Ihren bestehenden Helpdesk einfügt, aus Ihren vergangenen Tickets und Ihrem Hilfecenter lernt und anhand Ihres bisherigen Verlaufs getestet wird, bevor es jemandem antwortet. Es funktioniert mit Freshdesk, Zendesk und anderen, und der kostenlose Tarif enthält 100 Credits, wobei ein Ticket oder Chat einem Credit entspricht (siehe Preise).
Testen Sie eesel kostenlos, oder lesen Sie, wie Teams es im SaaS-Support einsetzen. Für einen breiteren Blick auf die Kategorie vergleicht meine Übersicht der besten KI-Helpdesk-Software die wichtigsten Optionen.
Häufig gestellte Fragen
Was ist die beste Alternative zu Kimi K3.1 Pro?
Für die meisten Teams ist es Claude Sonnet 5.5: dieselben 2 $ für Eingabe und 10 $ für Ausgabe pro Million Tokens, etwa die dreifache Ausgabegeschwindigkeit bei Artificial Analysis und ein etwas höherer Indexwert bei maximalem Denkaufwand. Wenn die Kosten pro abgeschlossener Aufgabe wichtiger sind als der Listenpreis, testen Sie Claude Opus 5.5 mit hohem Denkaufwand. Artificial Analysis hat dafür 1,82 $ pro Aufgabe gemessen, gegenüber 2,11 $ für Kimi K3.1 Pro. Der vollständige Testbericht zu Sonnet 5.5 enthält die Details.
Gibt es eine günstigere Alternative zu Kimi K3.1 Pro?
Ja. DeepSeek V4.1 Flash kostet außerhalb der Spitzenzeiten 0,15 $ für Eingabe und 0,60 $ für Ausgabe pro Million Tokens. Das entspricht etwa 2,70 $ pro 1.000 Anfragen mit jeweils 10.000 Eingabe- und 2.000 Ausgabe-Tokens, gegenüber 40 $ für Kimi K3.1 Pro. Gemini 3.8 Flash kostet bis zum 31. Dezember 2026 etwa 15 $ für dieselben 1.000 Anfragen. Lesen Sie den Preisleitfaden zu DeepSeek V4.1 Flash und die Preisaufschlüsselung zu Kimi K3.1 Pro.
Welche Alternativen zu Kimi K3.1 Pro haben offene Modellgewichte?
DeepSeek V4.1 Flash und MiMo-V2.6-Pro stellen beide Modellgewichte unter MIT-Lizenz auf Hugging Face bereit, und das ältere Kimi K3 hat offene Modellgewichte unter einer eigenen Lizenz. Laut Moonshot werden die Modellgewichte von Kimi K3.1 Pro bis zum 4. November 2026 veröffentlicht, aber als ich nachgesehen habe, waren sie nicht auf Hugging Face verfügbar. Meine Übersicht zu MiMo V2.6 behandelt die Option von Xiaomi.
Ist Claude Sonnet 5.5 besser als Kimi K3.1 Pro?
Bei maximalem Denkaufwand erreicht Sonnet 5.5 im Artificial Analysis Intelligence Index 56,0 Punkte gegenüber 55,1 für Kimi K3.1 Pro, zum selben Listenpreis, und gibt etwa 141 Tokens pro Sekunde aus, gegenüber 50. Kimi ist bei maximalem Denkaufwand pro abgeschlossener Aufgabe günstiger (2,11 $ gegenüber 5,46 $), weil Sonnet mehr Tokens schreibt. Mein Testbericht zu Kimi K3.1 Pro und mein Beitrag zu den Preisen von Sonnet 5.5 gehen näher darauf ein.
Wie vergleiche ich Alternativen zu Kimi K3.1 Pro hinsichtlich der Kosten?
Vergleichen Sie die Kosten pro erfolgreich abgeschlossener Aufgabe, nicht den Preis pro Token. Nehmen Sie die Gesamtausgaben für einen Testdurchlauf mit Ihren eigenen Aufgaben und teilen Sie sie durch die Anzahl der Aufgaben, die das jeweilige Modell korrekt abgeschlossen hat. Ein Modell mit einem niedrigeren Listenpreis kann trotzdem schlechter abschneiden, wenn es mehr Tokens schreibt oder häufiger scheitert. Deshalb führe ich die Kosten pro Aufgabe von Artificial Analysis neben den Preisen pro Token auf. Der Leitfaden zu den Kosten von KI im Kundenservice zeigt denselben Ansatz für den Support.
Welche Alternative zu Kimi K3.1 Pro eignet sich am besten für den Kundensupport?
Bei einem Support-Bot sind Geschwindigkeit und falsche Antworten wichtiger als Spitzenwerte in Benchmarks. Gemini 4 Argon hatte bei Artificial Analysis die niedrigste Halluzinationsrate in dieser Gruppe (15,1 %), und Claude Sonnet 5.5 ist schnell. Wenn Sie den Bot gar nicht selbst bauen möchten: Ein KI-Helpdesk-Agent wie eesel basiert bereits auf führenden Modellen und lernt aus Ihren bisherigen Tickets.
Sollte ich auf die offenen Modellgewichte von Kimi K3.1 Pro warten?
Nur, wenn Sie das Modell selbst hosten möchten. Das Modell hat insgesamt 2,8 Billionen Parameter, daher benötigen Sie für den eigenen Betrieb einen großen GPU-Cluster. Wenn Sie es über eine API aufrufen, ändern die Modellgewichte für Sie wenig; der Preis für die gehostete Version liegt bereits bei 2 $ für Eingabe und 10 $ für Ausgabe pro Million Tokens. Die Übersicht zu Kimi K3.1 Pro verfolgt die Veröffentlichung.