

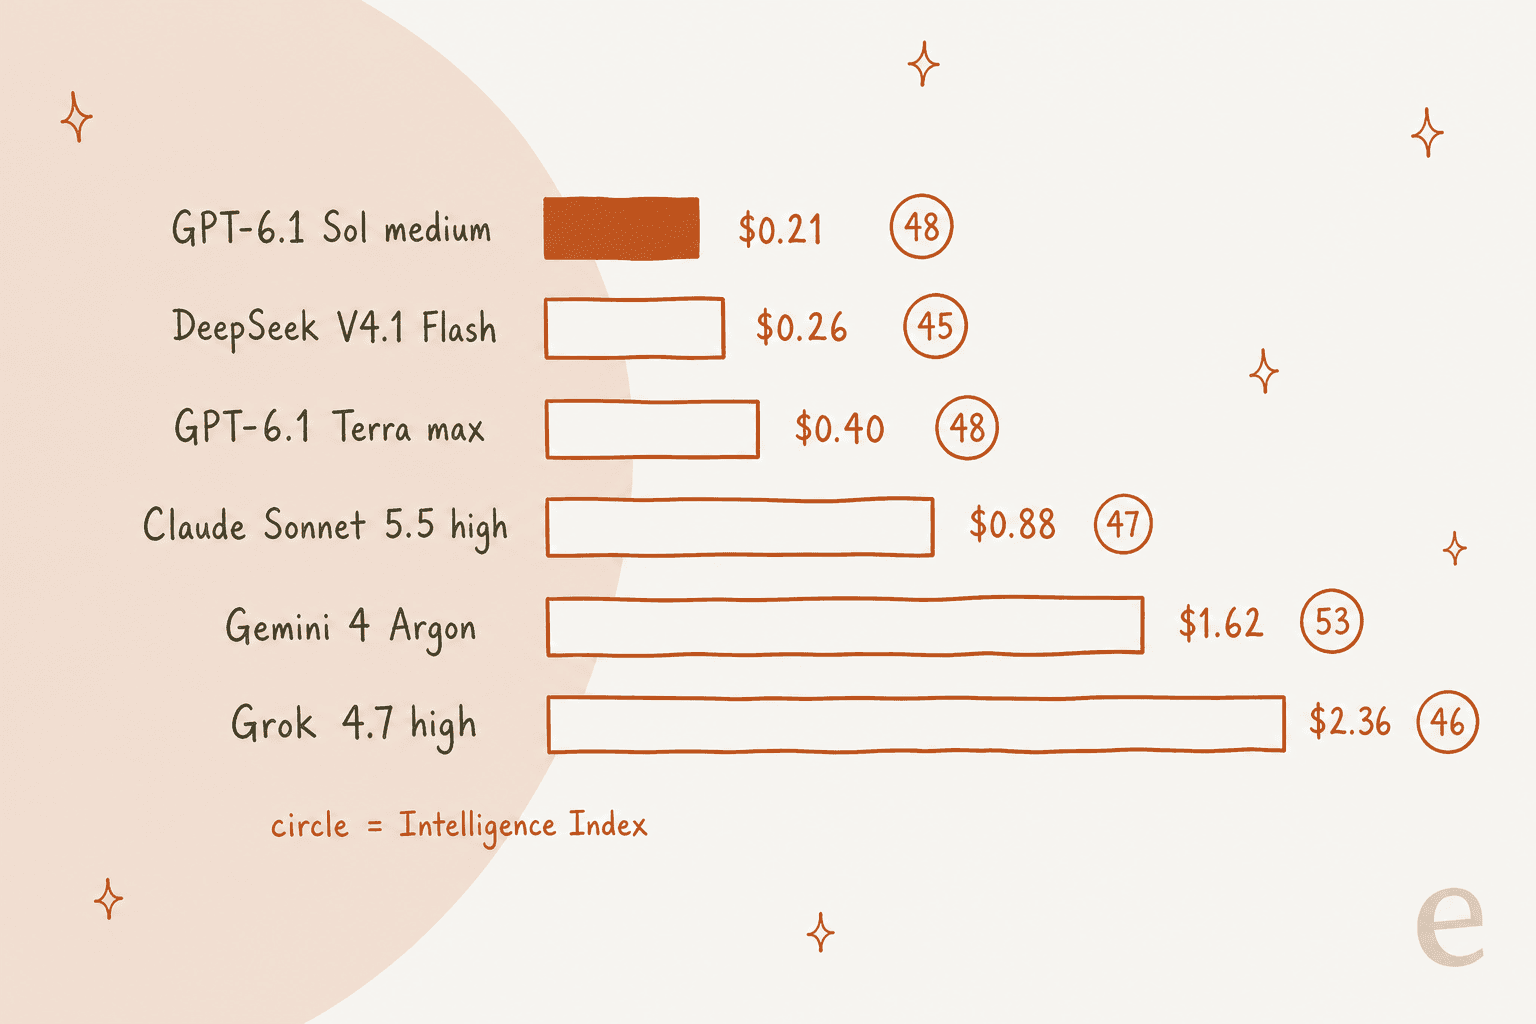
Die beste Alternative zu GPT-6.1 Terra ist für die meisten Teams GPT-6.1 Sol mit mittlerem Aufwand, was sich falsch anfühlt, weil Sol pro Token doppelt so viel kostet. Pro Aufgabe dreht sich das um: Artificial Analysis bewertet Sol medium mit 47.8 für $0.21 pro Aufgabe, während Terra auf max 48.1 für $0.40 erreicht. Wenn Sie Terra gerade auf maximalen Aufwand stellen wollten, wechseln Sie stattdessen das Modell.
Wenn Sie weg von OpenAI wollen: Claude Sonnet 5.5 für Coding und Agenten ($2/$10), DeepSeek V4.1 Flash für die niedrigste Rechnung ($0.15/$0.60 off-peak, offene Gewichte) und Gemini 4 Argon für das anspruchsvollste Reasoning, zu einem Aktionspreis, der sich am 1. Dezember verdoppelt. In einem Monat mit 1 Million Anfragen reicht die Rechnung zu Listenpreisen von $480 bei DeepSeek bis $7,000 bei Sol oder Sonnet, gegenüber $3,500 bei Terra.
Wenn das Modell für eine Support-Warteschlange gedacht ist, spielt das Modell weniger eine Rolle, als man denkt. In meinem Test von GPT-6.1 Terra löste Terra 15 von 16 Tickets richtig, Sol 16, und der eine Fehler war eine Eskalationsregel, keine Frage der Intelligenz. Diese Regel liegt in der Schicht, die eesel übernimmt, so wie Koffer.ch es auf Freshdesk betreibt, wobei jede Antwort ein Entwurf ist.
Warum überhaupt über GPT-6.1 Terra hinausschauen?
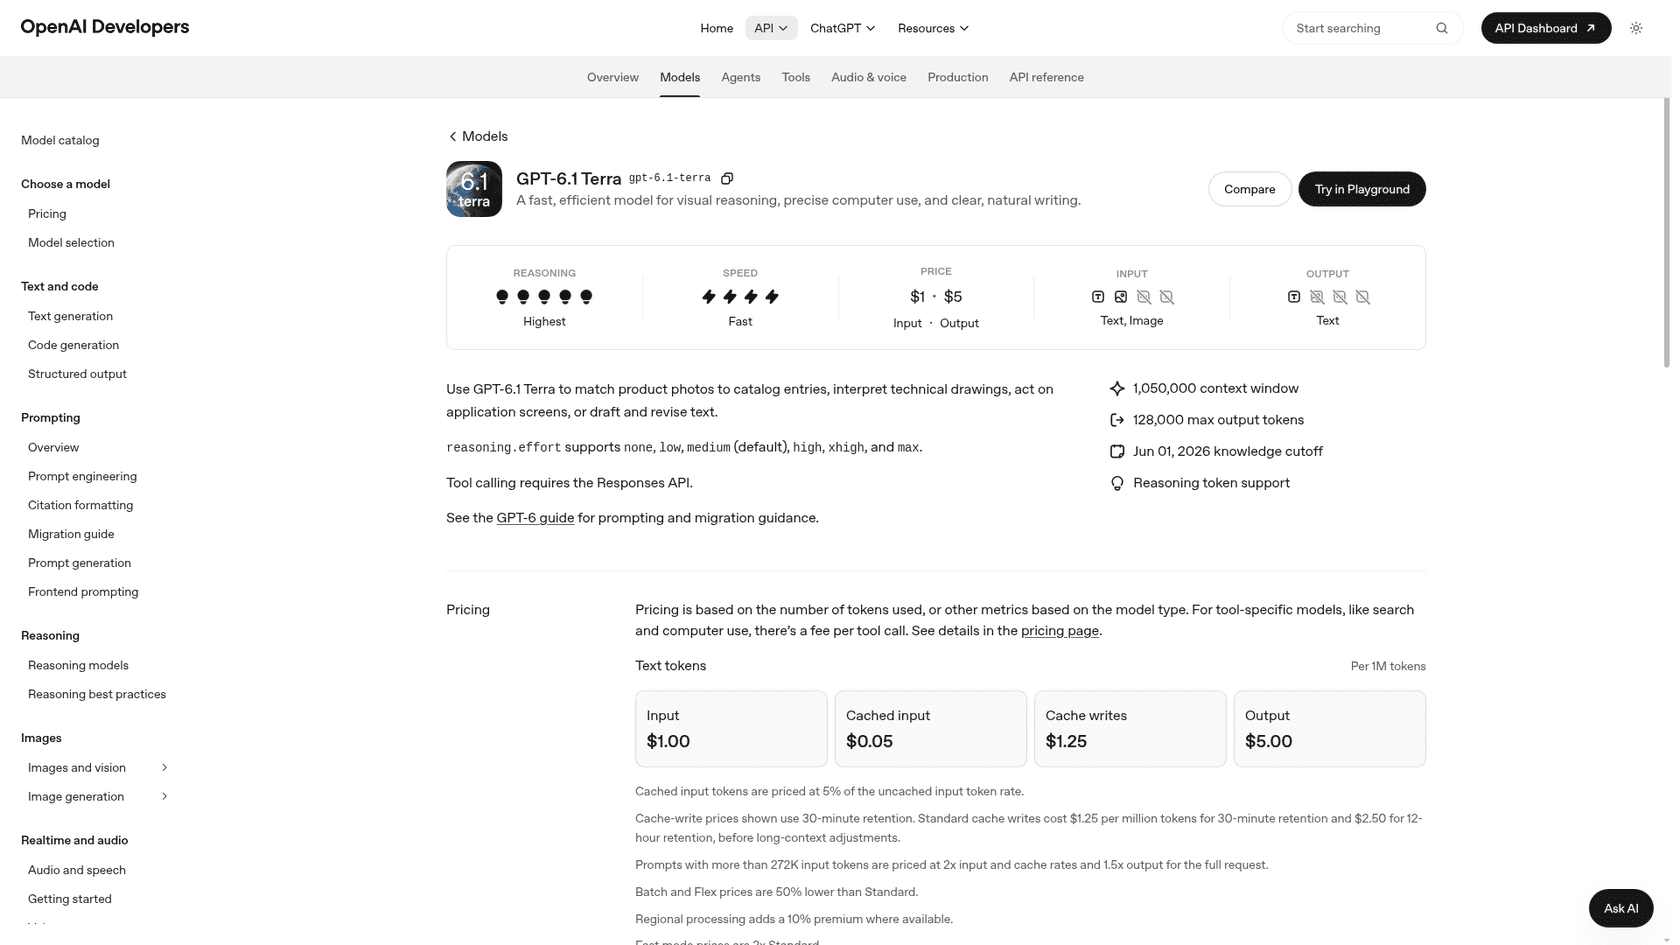
Vorweg: Terra ist ein gutes Modell. GPT-6.1 Terra erschien am 26. Oktober 2026 zu $1 pro Million Eingabe-Token und $5 pro Million Ausgabe-Token. Es hat ein Kontextfenster von 1,050,000 Token sowie eine Reasoning-Stufe none, die Sol und Astra nicht haben. Bei meinen eigenen Support-Tickets war es das schnellste Modell, das ich probiert habe, mit 2.5s bis 3.1s pro Ticket.
Trotzdem suchen Leute nach etwas anderem, und es läuft meist auf diese Punkte hinaus:
- Es wird teuer, wenn man es hochdreht. Terras Intelligence Index steigt von
36.2bei niedrigem Aufwand auf48.1bei max. Die Kosten pro Aufgabe steigen dabei von$0.05auf$0.40und die Zeit pro Aufgabe von29sauf384s, laut Artificial Analysis. Wer es ganz nach oben schiebt, zahlt Sol-Preise für etwas, das nicht Sol ist. - Coding und Terminal-Arbeit hinken den größeren Modellen hinterher. Terminal-Bench 4.0 kam im Hacker-News-Launch-Thread immer wieder zur Sprache. Ein Kommentator sah Terra auf max bei 50 %, Claude Opus 5.5 bei 70 %.
- Abhängigkeit von einem Anbieter. Wenn Ihr ganzes Produkt auf einem einzigen OpenAI-Modell läuft, wird deren Preisänderung oder Ausfall auch zu Ihrem.
Ein skeptischer Kommentar bringt Punkt 1 ziemlich gut auf den Punkt:
"Terra XHigh more expensive than Sol Low and still does worse."

Und hier ist der Satz, den Sie beim Lesen jeder Tabelle unten im Kopf behalten sollten:
"Per token, yes. But per task it's not even necessarily the case depending on how much thinking is needed."
Wie ich ausgewählt und bepreist habe
Ich baue die KI-Agenten, die in den Helpdesks von eesel-Kunden arbeiten, und ich habe den Terra-Test mit 80 Tickets für meinen Test durchgeführt. Jahre mit Live-Warteschlangen haben mir beigebracht, dass der Token-Preis die falsche Messgröße ist. Halber Preis bei doppelt so vielen Wiederholungen spart im Betrieb nichts. Deshalb habe ich jede Empfehlung unten nach diesen Kriterien beurteilt:
- Listenpreis pro 1 Mio. Token, am 28. Oktober 2026 von der Preisseite des jeweiligen Anbieters abgerufen.
- Kosten pro Aufgabe und Intelligence Index von Artificial Analysis. Dort läuft für jedes Modell dieselbe Testsuite, und es wird protokolliert, was jedes Modell tatsächlich verbraucht hat.
- Eine Monatsrechnung für einen Beispielkunden: Stellen Sie sich ein Produkt vor, das 1 Million Anfragen im Monat sendet, jede mit 2.000 Eingabe-Token und 300 Ausgabe-Token. Das ergibt 2 Milliarden Eingabe- und 300 Millionen Ausgabe-Token, ohne Caching und ohne Denk-Token.
Ich habe ChatGPT diese Frage auch so gestellt, wie ein Käufer es tun würde. Die Shortlist lautete Sonnet 5.5, Gemini 3.6 Flash, DeepSeek V4.1 Flash, Gemini 4 Argon und Grok 4.7. Die meisten davon sind geblieben. Gemini 3.6 Flash habe ich gegen 3.8 Flash getauscht (gleicher Preis, neueres Modell) und Sol sowie Haiku 5.5 ergänzt, die ChatGPT ausgelassen hat.
Alternativen zu GPT-6.1 Terra im Vergleich
| Modell | Eingabe / Ausgabe pro 1 Mio. | Gecachte Eingabe | Kontext | AA Intelligence Index | AA Kosten pro Aufgabe | Zeit bis zum ersten Token | Offene Gewichte | Monatsrechnung (Beispielkunde) |
|---|---|---|---|---|---|---|---|---|
| GPT-6.1 Terra (Basis) | $1 / $5 | $0.05 | 1.05M | 48.1 (max) | $0.40 | 1.3s (low) | Nein | $3,500 |
| GPT-6.1 Sol | $2 / $10 | $0.10 | 1.05M | 47.8 (medium) | $0.21 | 4.4s | Nein | $7,000 |
| Claude Sonnet 5.5 | $2 / $10 | $0.10 | 1M | 46.8 (high) | $0.88 | 3.1s (medium) | Nein | $7,000 |
| DeepSeek V4.1 Flash | $0.15 / $0.60 off-peak | $0.003 | 1M | 45.1 (max) | $0.26 | 1.2s | Ja | $480 (off-peak) |
| Gemini 3.8 Flash | $0.75 / $3.75 bis 31. Dez. | $0.075 | 1M | 40.9 (high) | $3.49 | 28.3s (high) | Nein | $2,625 |
| Gemini 4 Argon | $2 / $10 bis 30. Nov. | $0.10 | 1M | 52.6 (high) | $1.62 | 48.2s | Nein | $7,000 |
| Grok 4.7 | $2 / $6 | k. A. | 500K | 46.3 (high) | $2.36 | 5.4s (low) | Nein | $5,800 |
| Claude Haiku 5.5 | $0.10 / $0.50 bis 100K Prompt | $0.01 | 1M | 37.8 (high) | $0.08 | 26.7s (high) | Nein | $350 |
Zwei Dinge fallen auf. DeepSeek V4.1 Flash kostet pro Rechnung etwa 7x weniger als Terra und liegt beim Index innerhalb von 3 Punkten. Dann Gemini 3.8 Flash: günstig pro Token, aber pro Aufgabe eines der teuersten, weil es vor der Antwort viel denkt. Index, Kosten pro Aufgabe und Zeiten bis zum ersten Token stammen alle von den Modellseiten von Artificial Analysis, beim jeweils in Klammern genannten Aufwand.
1. GPT-6.1 Sol
Am besten für: Teams, die bereits die OpenAI-API nutzen und besseres Urteilsvermögen brauchen, ohne eine Zeile Integrationscode zu ändern.
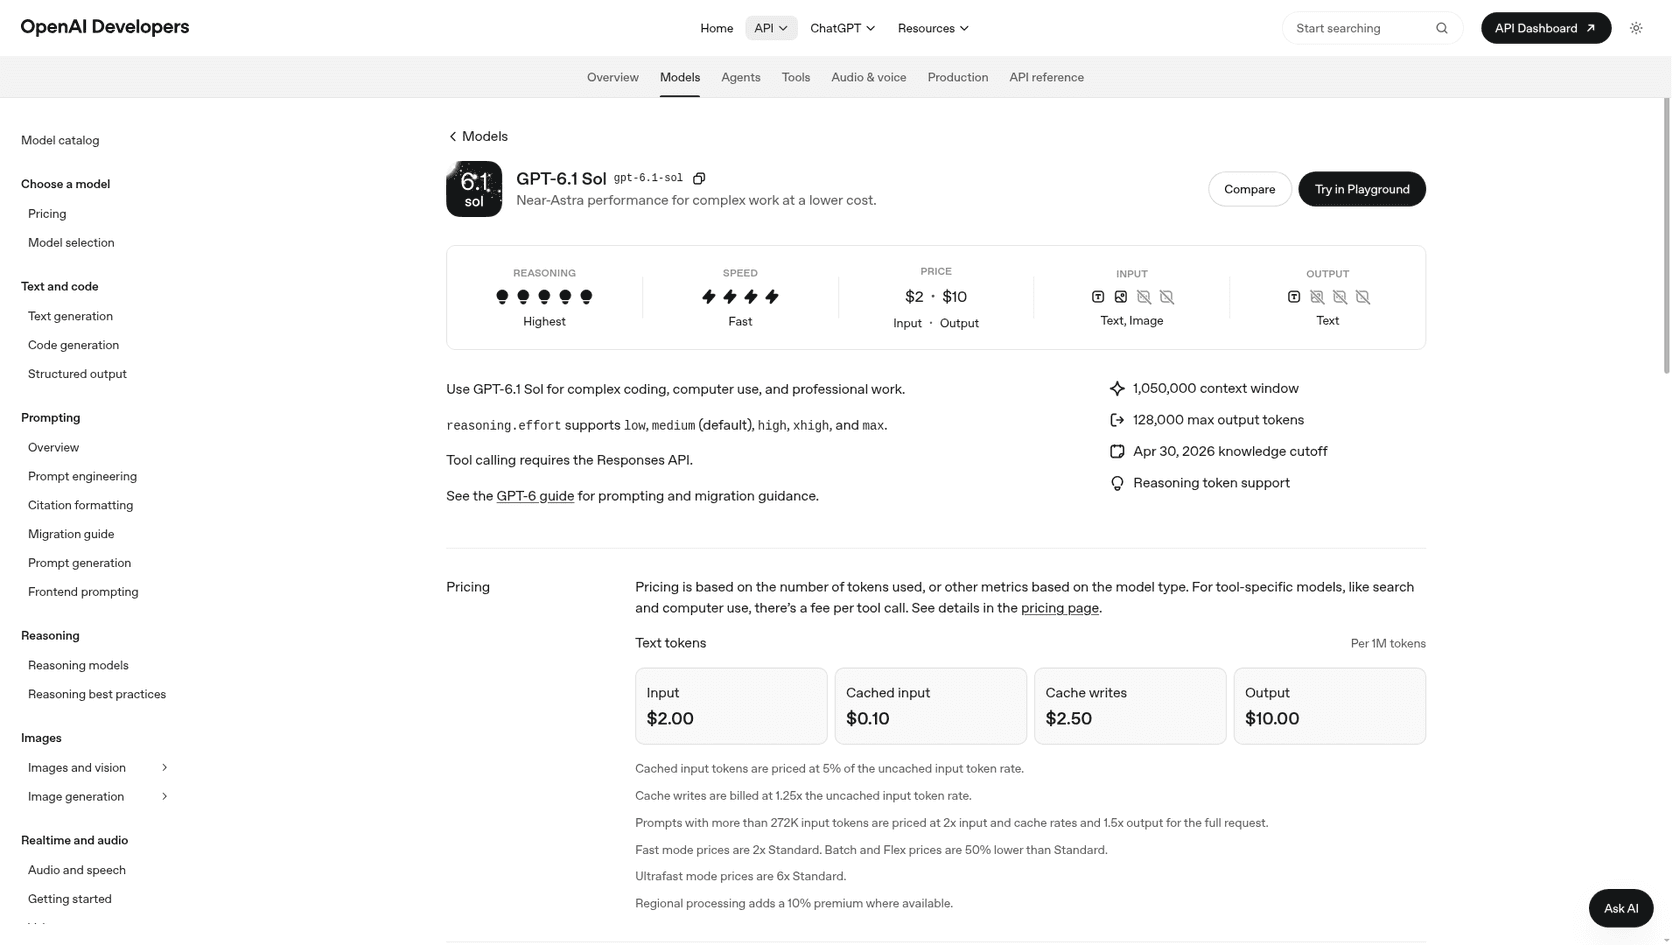
Stellen Sie sich Sol als Terras größeres Geschwister vor. Es steht eine Stufe höher auf OpenAIs Leiter, zwischen Terra und GPT-6 Astra. API, Tools und die Generation gpt-6.1 sind alle gleich, der Wechsel besteht also nur darin, den Modellnamen zu ändern.
Vorteile
- Sol mit mittlerem Aufwand entspricht Terra auf max im Artificial-Analysis-Index, bei etwa halben Kosten pro Aufgabe (
$0.21vs.$0.40). - In meinem Support-Test war sein Urteilsvermögen das beste: 16 von 16. Es war außerdem das einzige Setup, das eine spanische Adressänderung eskalierte, die es nicht durchführen konnte.
- AA beziffert seine Halluzinationsrate bei hohem Aufwand auf
49%, gegenüber38%bei Terra auf max. Bei Fakten ist es also nicht das sorgfältigere Modell. Seine Stärke sind Entscheidungen in Randfällen.
Nachteile
- Es ist langsamer. AA misst bei medium etwa
54Ausgabe-Token pro Sekunde gegenüber91bei Terra und ein erstes Token nach4.4sgegenüber1.3sbei Terra auf low. - Kurze, einfache Anfragen kosten bei Sol mehr. Mein Test kam auf
$1.62pro 1.000 Tickets, verglichen mit$0.75bei Terra auf low. - Es gibt keine Stufe
none, also keinen schnellen Pfad ganz ohne Denken.
Preise: $2 Eingabe, $0.10 gecacht, $10 Ausgabe pro 1 Mio. Token auf der OpenAI-Preisseite. Batch halbiert das auf $1/$5.
Meine Einschätzung: Lassen Sie die einfachen 80 % auf Terra mit low und leiten Sie alles, was hohen Aufwand bräuchte, an Sol mit medium weiter. Der Upgrade-Pfad von Terra ist nicht Terra auf max, sondern Sol. Die vollständigen Zahlen finden Sie im Test von GPT-6.1 Sol.
2. Claude Sonnet 5.5
Am besten für: Coding-Tools, Terminal-Agenten und mehrstufige Tool-Nutzung.
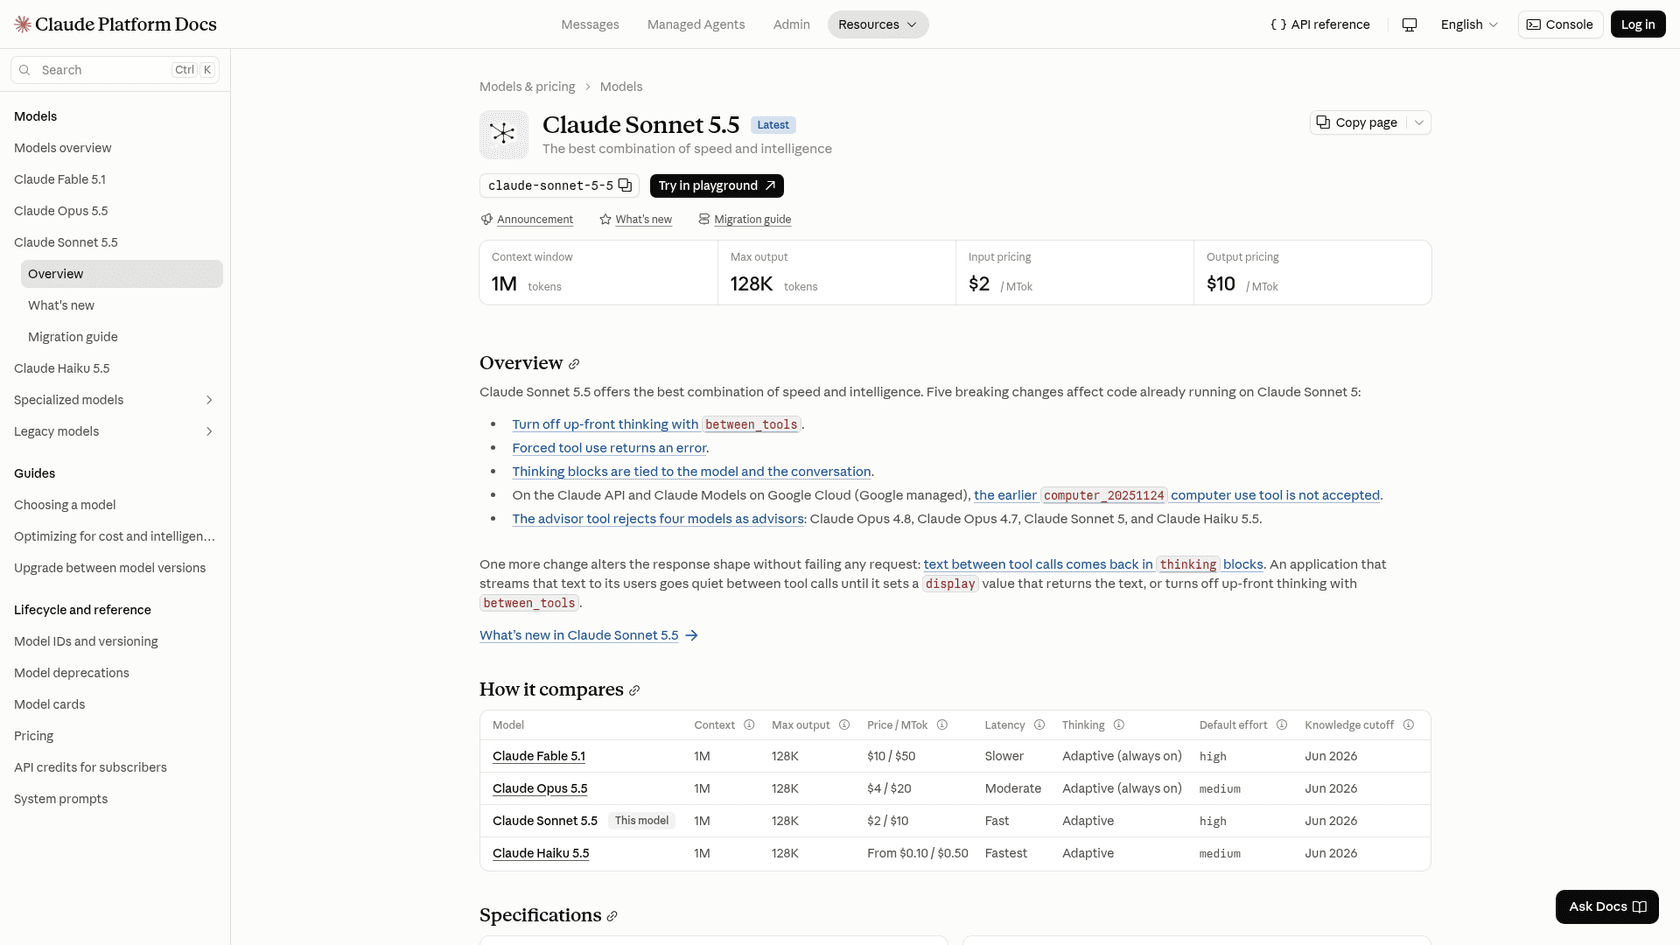
Das ist Anthropics Mittelklassemodell, erschienen am 28. September 2026. ChatGPT nannte es die "best first alternative to test", und für Agentenarbeit würde ich sagen, das stimmt.
Vorteile
- Die besten Coding-Werte in seiner Preisklasse. Anthropic meldet
70.6%bei Terminal-Bench 4.0, vor Opus 5.5 mit66.4%, und80.1%bei OSWorld 2.1 für Computernutzung. - Es kostet wie Sol
$2/$10und bietet ein Kontextfenster von 1M und 128K Ausgabe. - Schnelles erstes Token bei mittlerem Aufwand (
3.1sbei AA) und etwa107Ausgabe-Token pro Sekunde.
Nachteile
- Bei hohem Aufwand kostet es laut AA
$0.88pro Aufgabe. Das ist mehr als das 4-Fache von Sol medium, bei niedrigerem Index. - Bei AA liegt seine Halluzinationsrate bei hohem Aufwand bei
65%, der höchste Wert unter den hier genannten geschlossenen Modellen. - Die Migration ist nicht schmerzfrei:
thinking: disabledund ein erzwungenestool_choiceliefern bei Sonnet 5.5 beide einen 400-Fehler, Code für ältere Claude-Modelle braucht also Anpassungen.
Preise: $2 Eingabe, $10 Ausgabe, $0.10 für Cache-Treffer, laut Claude-Preisseite. Batch kostet $1/$5.
Meine Einschätzung: Wenn Ihr Produkt Code schreibt oder ausführt oder lange einen Browser steuert, nehmen Sie Sonnet 5.5. Kurze Textaufgaben wie Entwürfe und Extraktion bringen auf Terra oder Sol mehr pro Dollar. Der Test von Claude Sonnet 5.5 und der Vergleich Sol vs. Opus 5.5 gehen tiefer.
3. DeepSeek V4.1 Flash
Am besten für: Chat mit hohem Volumen, Extraktion und RAG, wo die Token-Rechnung die Hauptbeschränkung ist, oder wo Sie Gewichte wollen, die Sie selbst hosten können.
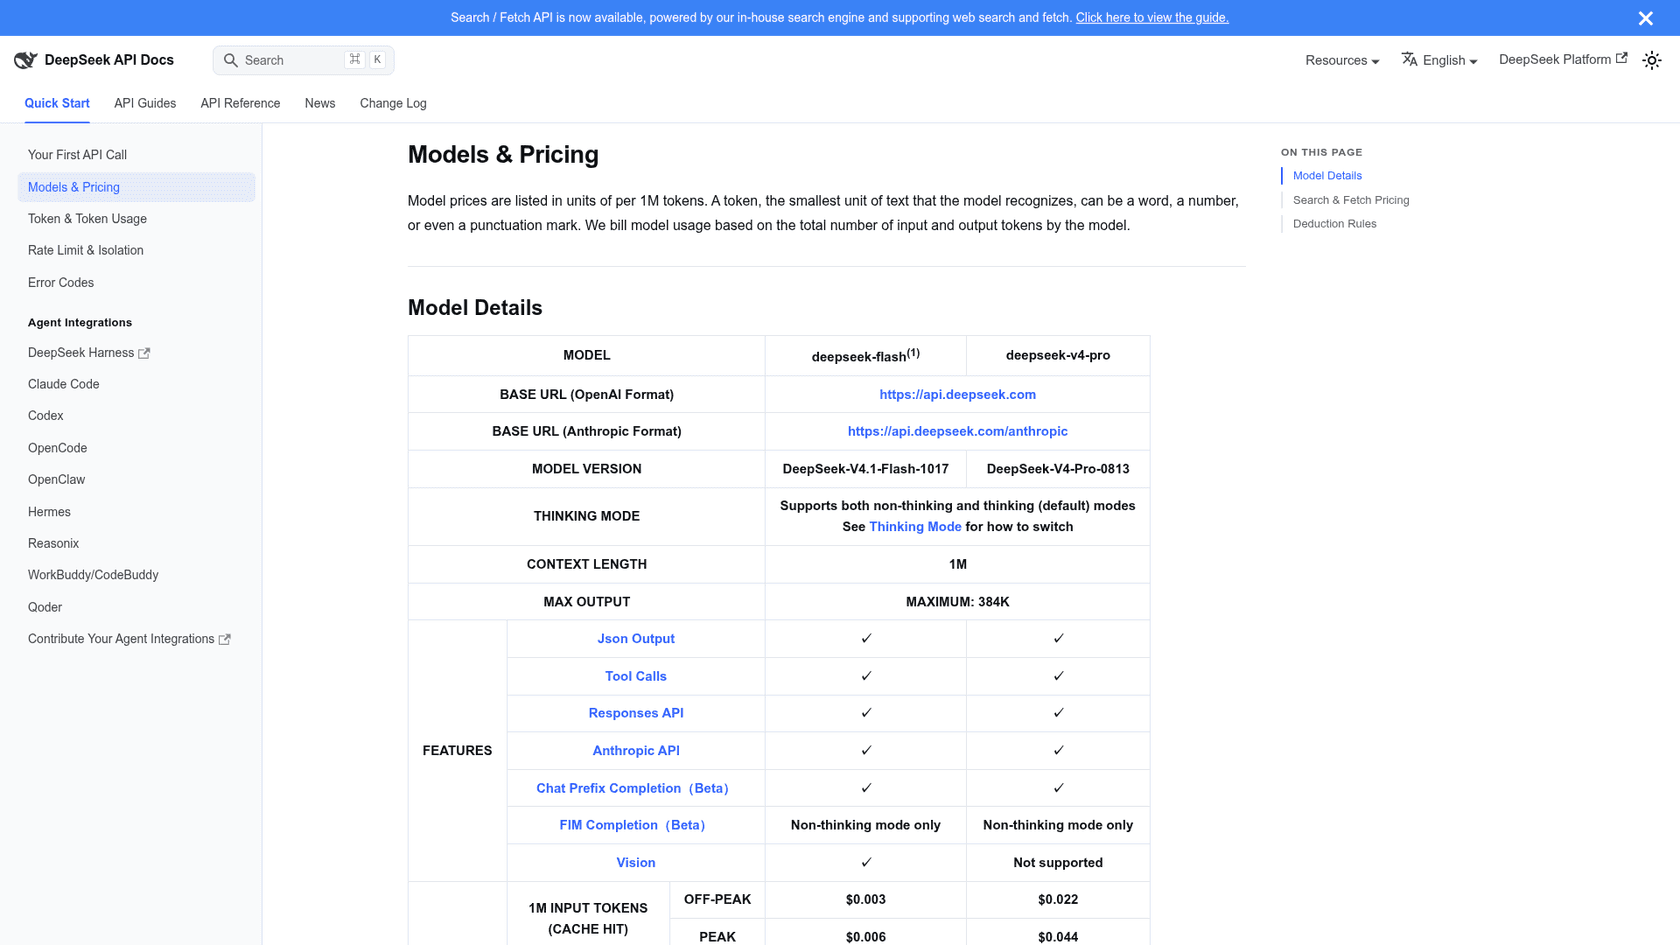
In der API heißt es jetzt schlicht deepseek-flash, und der Checkpoint DeepSeek-V4.1-Flash-1017 bedient es. Ältere Namen wie deepseek-v4-flash funktionieren weiter und werden zum Flash-Preis abgerechnet, laut den DeepSeek-Preisdokumenten.
Vorteile
- Von den Modellen hier mit über 45 Punkten hat dieses die niedrigste Rechnung. Der Beispielkunde zahlt off-peak
$480im Monat, verglichen mit$3,500bei Terra. - Cache-Treffer kosten off-peak
$0.003pro 1 Mio. Token, wiederholte System-Prompts kosten also fast nichts. - Die Gewichte sind offen, Sie können also selbst hosten, wenn Datenresidenz wichtig ist. Es liest auch Bilder, unterstützt Tool-Aufrufe und spricht sowohl das OpenAI- als auch das Anthropic-API-Format.
- Es hat hier das schnellste erste Token,
1.2slaut Artificial Analysis.
Nachteile
- Der Peak-Preis verdoppelt alles auf
$0.30/$1.20. Die Peak-Zeiten sind werktags 01:00 bis 04:00 und 06:00 bis 10:00 UTC, was genau auf den europäischen Arbeitsmorgen fällt. - Die Halluzinationsrate von AA für den Checkpoint 1017 auf max liegt bei
67%, halten Sie es also an Ihren eigenen Dokumenten verankert. - Serverseitige Search- und Fetch-Aufrufe werden ab dem 1. November 2026 mit
$0.75pro 1.000 Anfragen abgerechnet.
Preise: $0.15 Eingabe (Cache-Miss), $0.003 Cache-Treffer, $0.60 Ausgabe off-peak; $0.30, $0.006 und $1.20 im Peak.
Meine Einschätzung: Bei überwiegend einfachem Traffic, und wenn ein anderer Anbieter für Sie in Ordnung ist, ist DeepSeek der günstigste Wechsel, den man ernsthaft in Betracht ziehen sollte. Ein HN-Kommentator brachte die Aufteilung schlicht auf den Punkt:
"If all I want is coding at a cheaper price, then deepseek is a good model for that."
Der Test von DeepSeek V4.1 Flash 1017 und die DeepSeek-API-Anleitung führen durch die Einrichtung.
4. Gemini 3.8 Flash
Am besten für: multimodale Batch-Jobs (PDFs, Video, Audio), bei denen niemand auf die Antwort wartet.
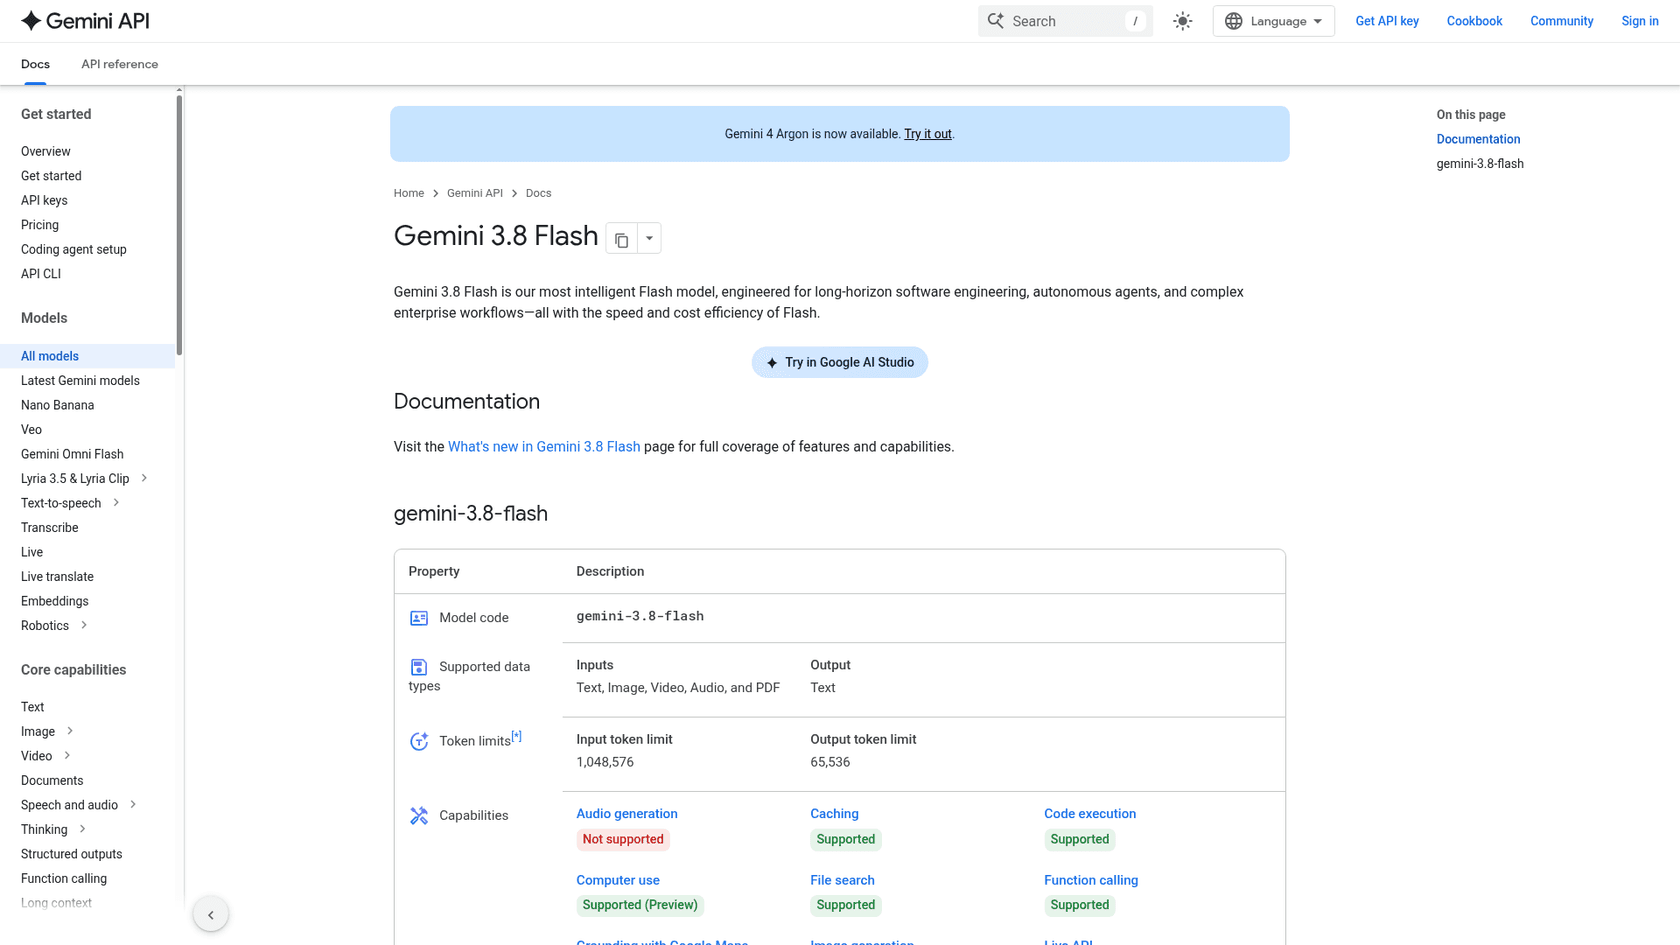
ChatGPTs Empfehlung für diesen Platz war Gemini 3.6 Flash. Auf der Gemini-Preisseite kosten 3.6 Flash und 3.8 Flash aber genau dasselbe, und Google nennt 3.6 inzwischen sein "previous generation Flash model". Wenn Sie Googles Flash-Stufe testen, testen Sie also 3.8.
Vorteile
- Bis Ende 2026 pro Token günstiger als Terra:
$0.75Eingabe und$3.75Ausgabe, womit der Beispielkunde bei$2,625liegt. - Es akzeptiert Text, Bild, Video, Audio und PDF als Eingabe, mehr als jedes andere Modell hier.
- Es gibt eine kostenlose Stufe zum Testen, die Terra nicht bietet.
Nachteile
- Am 1. Januar 2027 verdoppelt sich der Preis auf
$1.50/$7.50und liegt damit pro Token über Terra. - Es denkt viel. AA beziffert es bei hohem Aufwand auf
$3.49pro Aufgabe und28.3sbis zum ersten Token, was es für ein Chatfenster, auf das jemand starrt, ungeeignet macht. - Googles eigene Launch-Hinweise sagen, 3.8 Flash könne mehr Token verbrauchen, um die Leistung zu maximieren. Der Test von Gemini 3.8 Flash enthält die Details.
Preise: $0.75/$3.75 bis 31. Dezember 2026, danach $1.50/$7.50. Batch und Flex kosten die Hälfte.
Meine Einschätzung: Es eignet sich gut für nächtliche Dokumentenverarbeitung, die nach Token abgerechnet wird. Für alles Interaktive oder alles, was im Januar noch läuft, rechnen Sie zuerst die Kosten pro Aufgabe aus.
5. Gemini 4 Argon
Am besten für: anspruchsvollstes Reasoning, Recherche und lange autonome Agenten, wo sich eine richtige Antwort lohnt.
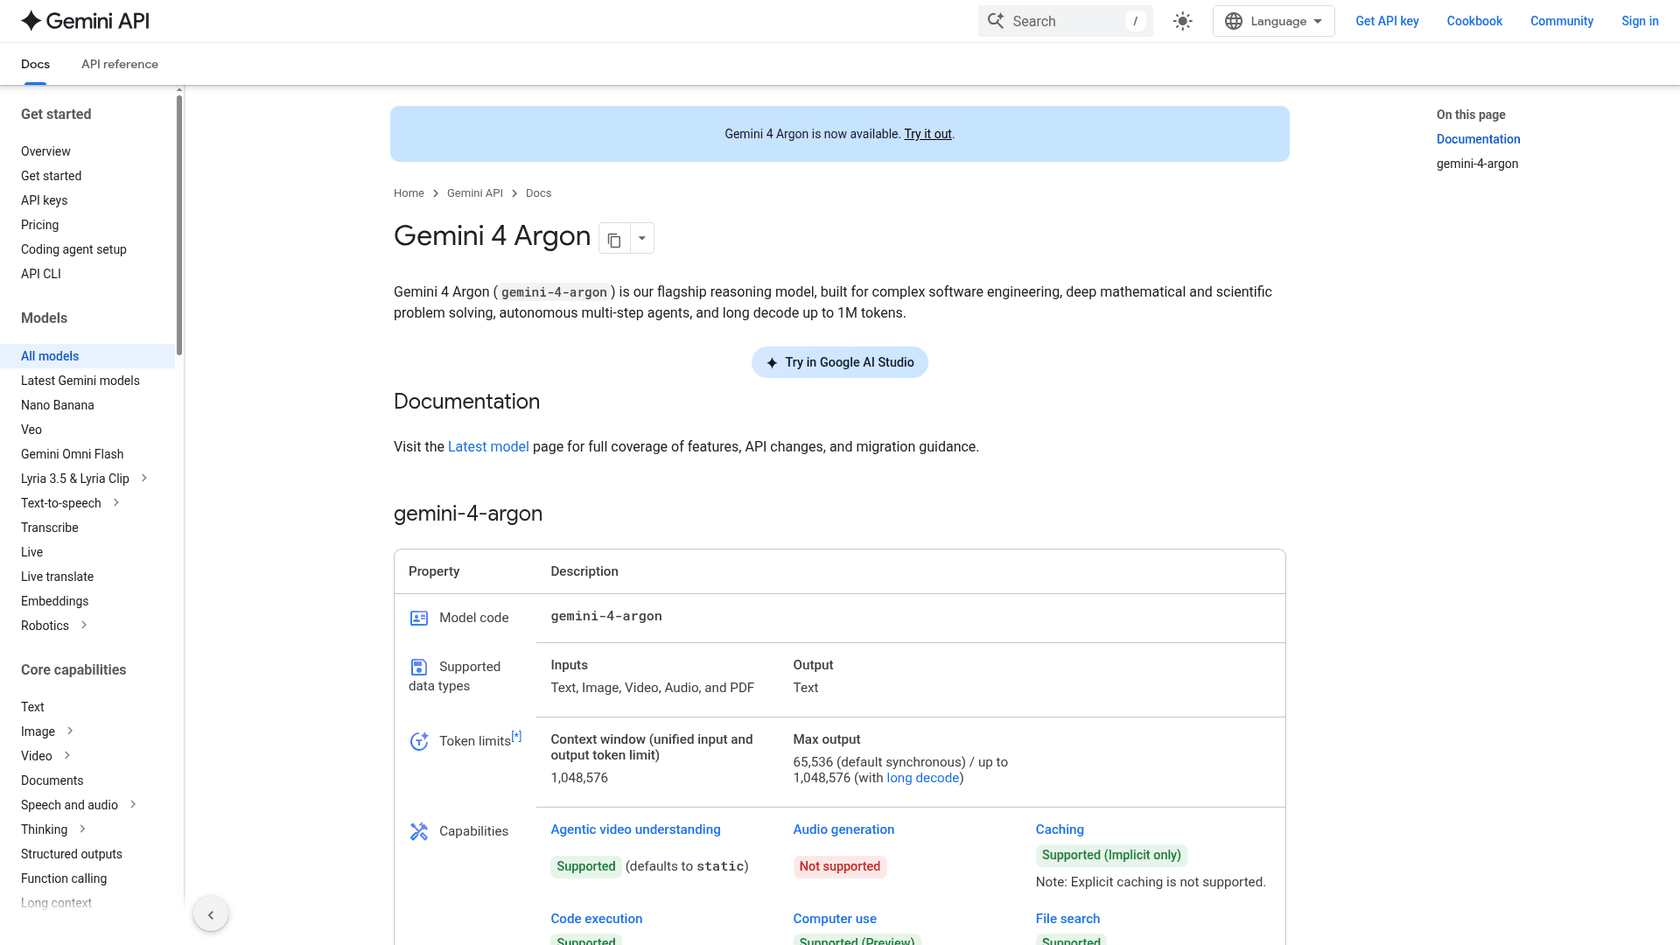
Das ist Googles Flaggschiff, veröffentlicht am 30. September 2026, und nichts auf dieser Liste erreicht mehr Punkte.
Vorteile
- Höchster Intelligence Index hier mit
52.6, mehr als 4 Punkte vor Terra auf max, laut Artificial Analysis. - Seine AA-Halluzinationsrate von
15%ist die niedrigste dieser Liste, gegenüber38%bei Terra auf max. Wenn falsche Fakten Ihr größtes Risiko sind, ist Argon das sicherste Modell hier. - 1M Kontext und lange Ausgaben.
Nachteile
- Der Preis von
$2/$10ist nur ein Einführungspreis, der am 30. November endet. Ab dem 1. Dezember steigt er auf$4/$20, was die Rechnung des Beispielkunden von$7,000auf$14,000verdoppelt. - Es ist langsam, mit
48.2sbis zum ersten Token und etwa80Token pro Sekunde bei AA. - Es gibt keine kostenlose Stufe, und Caching ist nur implizit.
Preise: $2/$10 bis 30. November 2026, danach $4/$20, laut Gemini-Preisseite. Der Leitfaden zu den Gemini-4-Argon-Preisen schlüsselt die Aktion auf.
Meine Einschätzung: Behandeln Sie Argon als teuren Spezialisten, an den Ihr Router eskaliert, nicht als Terra-Ersatz für den Alltagsverkehr. Und planen Sie mit dem Dezember-Preis statt mit dem Aktionspreis. Der Test von Gemini 4 Argon bietet mehr.
6. Grok 4.7
Am besten für: einen vierten unabhängigen Anbieter in Ihrem Vergleichstest, besonders für lange, ausgabelastige Antworten.
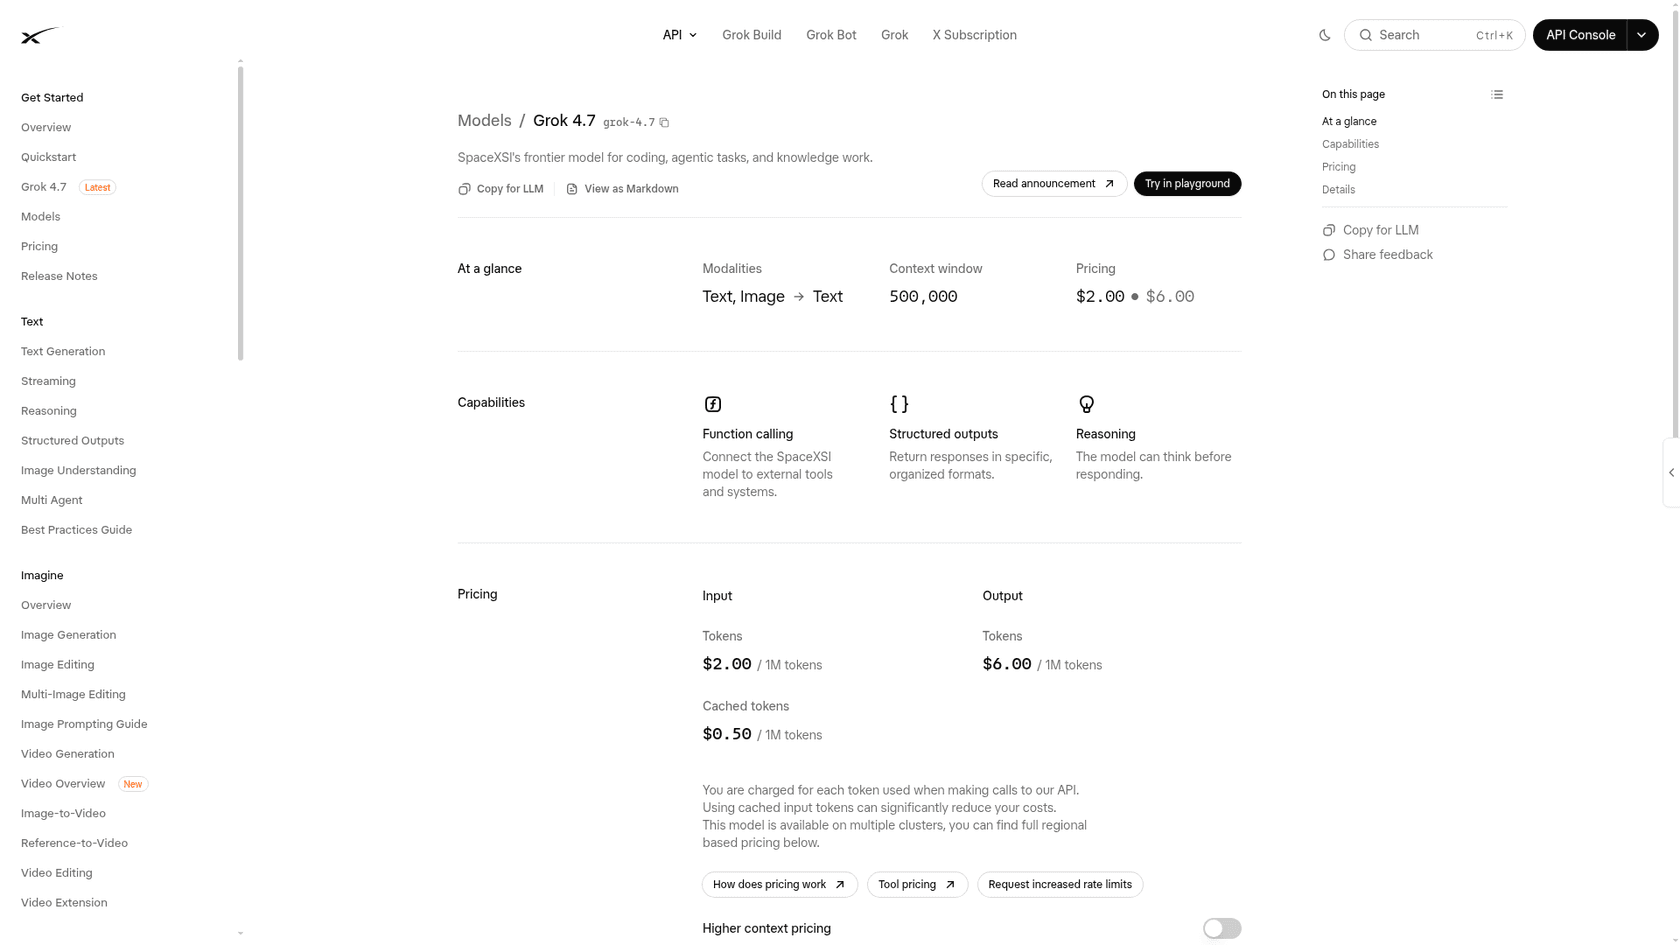
Das ist xAIs Flaggschiff, auf der Modellseite beschrieben als "our flagship model for code and everything else".
Vorteile
- Die Ausgabe ist für ein Frontier-Modell günstig:
$6pro 1 Mio. gegenüber$10bei Sol und Sonnet, was den Beispielkunden auf$5,800bringt. - Die AA-Halluzinationsrate bei hohem Aufwand liegt bei
32%und damit unter Terra auf max. - Reasoning ist konfigurierbar, und es gibt serverseitige Web- und X-Suchtools.
Nachteile
- Mit 500K Token hat es nur halb so viel Kontext wie alles andere hier.
- Es ist pro Aufgabe teuer. AA beziffert es bei hohem Aufwand auf
$2.36für einen Index von46.3, das schlechteste Verhältnis dieser Liste. - Das erste Token braucht bei hohem Aufwand
45.7s, wobei niedriger Aufwand das auf5.4ssenkt.
Preise: $2 Eingabe, $6 Ausgabe pro 1 Mio. laut xAI-Dokumentation.
Meine Einschätzung: Es verdient einen Platz in einem Vergleichstest, damit Sie sich nicht nur auf die drei Großen verlassen. Nach diesen Zahlen würde ich es aber nicht Sol oder Sonnet vorziehen. Der Test von Grok 4.7 geht auf den Rest ein.
7. Claude Haiku 5.5
Am besten für: Tagging, Routing und Klassifizierung in riesigem Volumen, wo nichts direkt an einen Kunden geht.
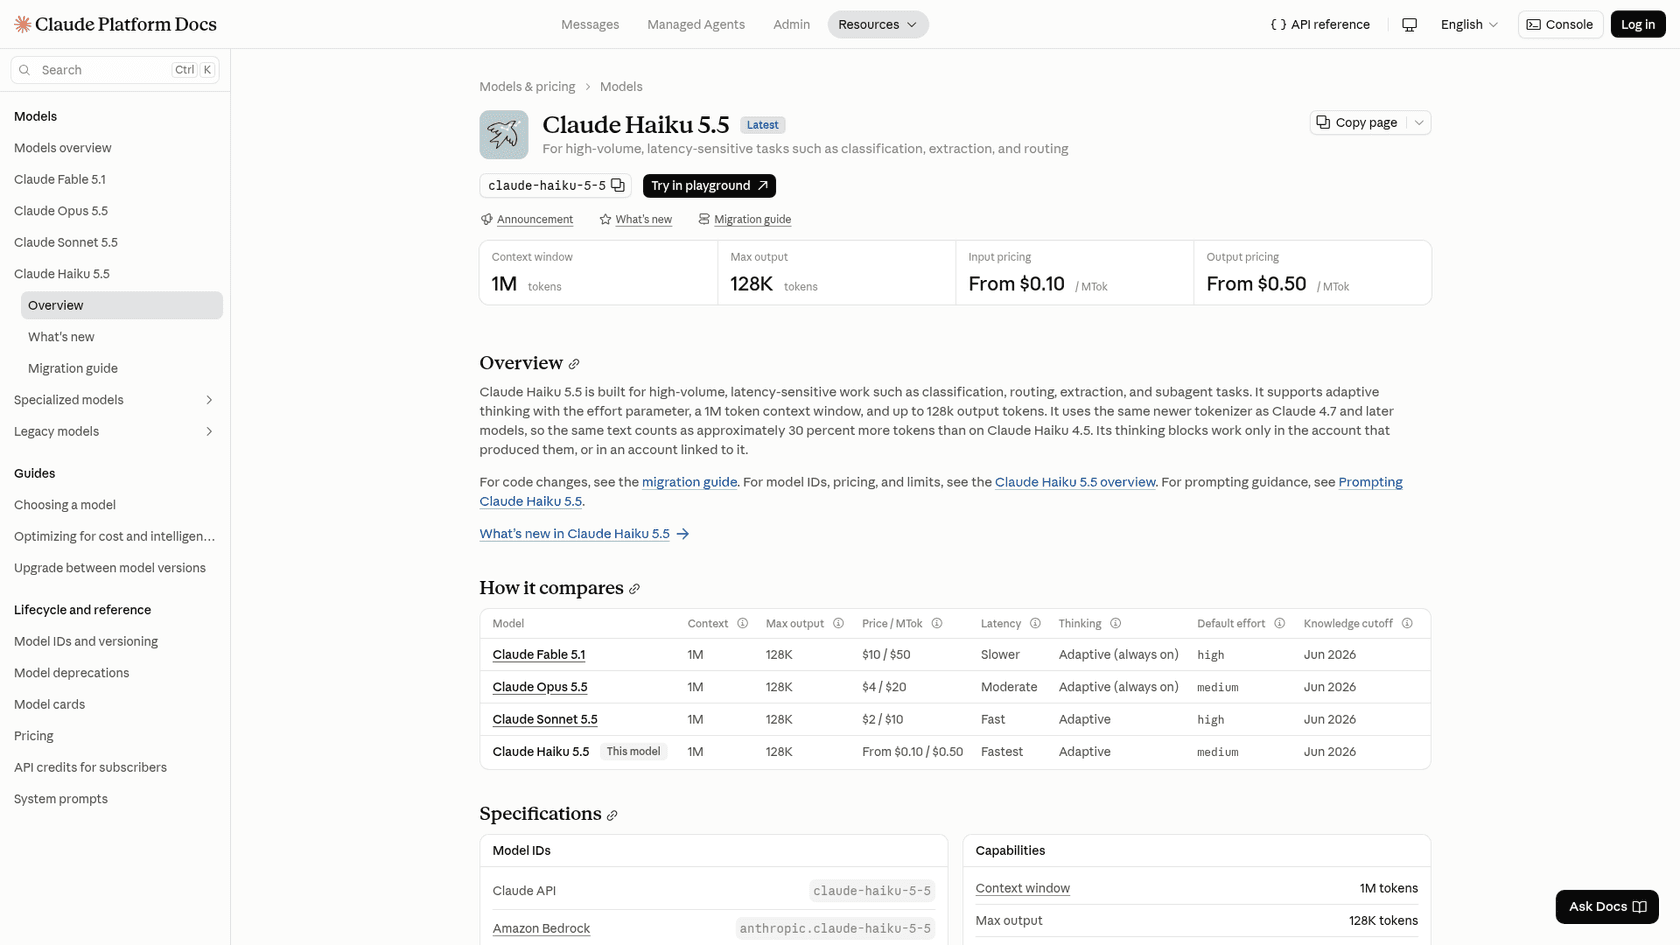
Wenn Terra mehr Modell ist, als die Aufgabe braucht, gehen Sie eine Stufe nach unten statt zur Seite. Claude Haiku 5.5 ist Anthropics kleines Modell, erschienen am 7. Oktober 2026, und liegt beim selben Preis von $0.10/$0.50 wie GPT-6 Luna.
Vorteile
- Der Beispielkunde zahlt
$350im Monat, ein Zehntel der Terra-Rechnung. - AA bewertet es bei hohem Aufwand mit
37.8für$0.08pro Aufgabe, vor Lunas32.9. - Es läuft mit etwa
185Ausgabe-Token pro Sekunde bei AA.
Nachteile
- Sobald ein Prompt über 100.000 Token liegt, zahlen Sie das 5-Fache:
$0.50Eingabe und$2.50Ausgabe. Ein HN-Nutzer nannte es ein Modell "destroyed by Anthropics crazy decision to price it x5 after 100k context" (rockdoe). - Es liegt beim Index
10Punkte unter Terra, betrachten Sie es also als eine Stufe darunter und nicht als Ersatz.
Preise: $0.10/$0.50 bis zu Prompts von 100K Token, $0.50/$2.50 darüber, laut Claude-Preisseite.
Meine Einschätzung: Haiku 5.5 oder Luna sind ein guter, günstiger erster Durchlauf in einem Router. Halten Sie die Prompts nur unter 100K. Der Test von Claude Haiku 5.5 enthält seine Benchmarks.
Welche Alternative zu GPT-6.1 Terra passt zu Ihrem Produkt?
Gehen Sie von der Aufgabe aus, nicht von der Rangliste. Ein Modell kann einen Screenshot gut lesen und trotzdem auf den falschen Button klicken. Ein anderes kann in Mathe brillant sein und sich in einem Chatfenster trotzdem langsam anfühlen.
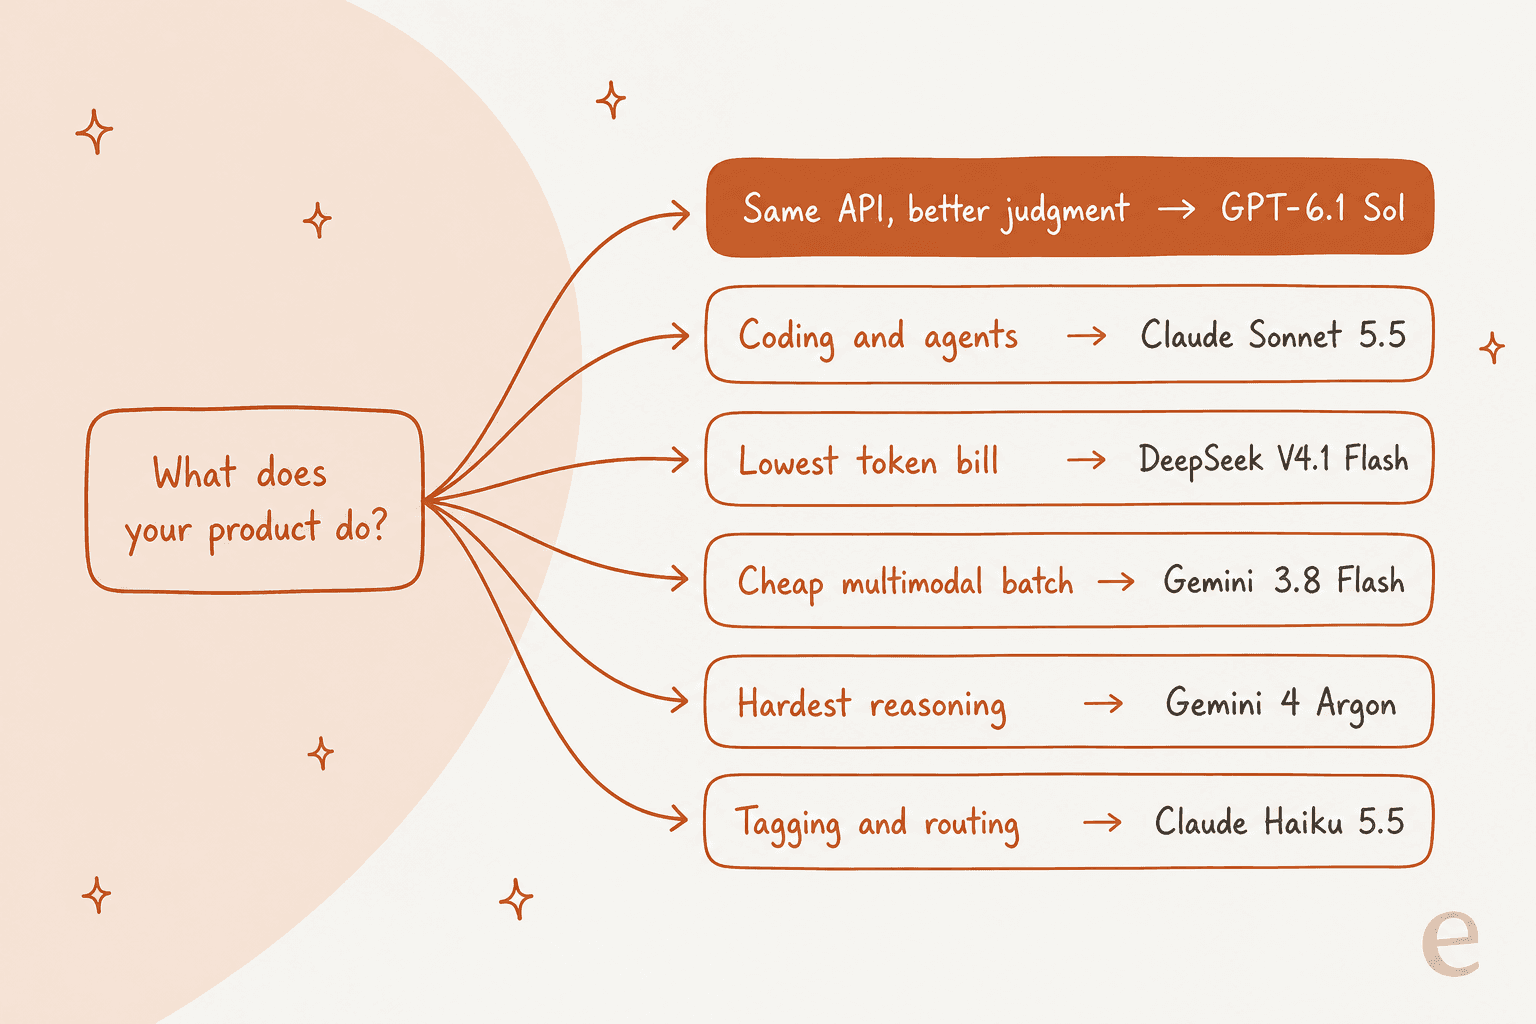
| Wenn Ihr Produkt hauptsächlich... | Zuerst testen | Warum |
|---|---|---|
| Kundenorientierte Entwürfe und Chat | Terra auf low, Sol auf medium | Schnelles erstes Token, gutes Schreiben und Sol für Randfälle |
| Coding oder Terminal-Agenten | Claude Sonnet 5.5 | 70.6% bei Terminal-Bench 4.0 laut Anthropic |
| Extraktion oder RAG mit hohem Volumen | DeepSeek V4.1 Flash | $0.15/$0.60 off-peak und offene Gewichte |
| PDF-, Video- oder Audioverarbeitung über Nacht | Gemini 3.8 Flash | Breiteste Eingabetypen, bis 2027 günstig |
| Recherche und anspruchsvollstes Reasoning | Gemini 4 Argon | Höchster AA-Index, niedrigste Halluzinationsrate |
| Tagging und Routing | Claude Haiku 5.5 oder GPT-6 Luna | $0.10/$0.50 |
| Selbst gehostet oder an Datenresidenz gebunden | DeepSeek V4.1 Flash oder Qwen 3.8 | Gewichte, die Sie selbst betreiben können |
Wenn hier nichts passt, sind zwei weitere erwähnenswert. Kimi K3.1 Pro erreichte bei AA 55.1, läuft aber langsam, mit etwa 46 Token pro Sekunde. Mistral Large 4 befindet sich noch in der Vorschau.
So führen Sie einen Modellvergleich durch, bevor Sie wechseln
Eine Rangliste zeigt, wie ein Modell bei einem fremden Test abschneidet. Sie brauchen aber, wie es bei Ihrem abschneidet. So würde ich vorgehen, mit derselben Form wie die Auswertung in meinem Terra-Test:
- Ziehen Sie 100 bis 500 echte Anfragen. Anonymisieren Sie sie und lassen Sie die hässlichen drin: Tippfehler, zwei Fragen in einer, Tool-Timeouts, eine Prompt-Injection.
- Wählen Sie drei Herausforderer. Nehmen Sie Terra als Basis und ergänzen Sie die zwei oder drei Zeilen aus der Tabelle oben, die zu Ihrer Aufgabe passen.
- Messen Sie, was Nutzer spüren. Erfolgsquote, erfundene Fakten, Latenz
p50undp95, Genauigkeit der Tool-Aufrufe, Wiederholungen und Kosten pro erfolgreicher Aufgabe. - Bewerten Sie zunächst von Hand. Lesen Sie beim ersten Durchlauf jede Ausgabe selbst. Sobald Sie dem Bewertungsraster vertrauen, automatisieren Sie es; die OpenAI-Agent-Evals helfen dabei.
- Testen Sie einen Router, nicht nur einzelne Modelle. Schicken Sie alles an ein günstiges Standardmodell und eskalieren Sie dann die schwierigen oder unsicheren Fälle.
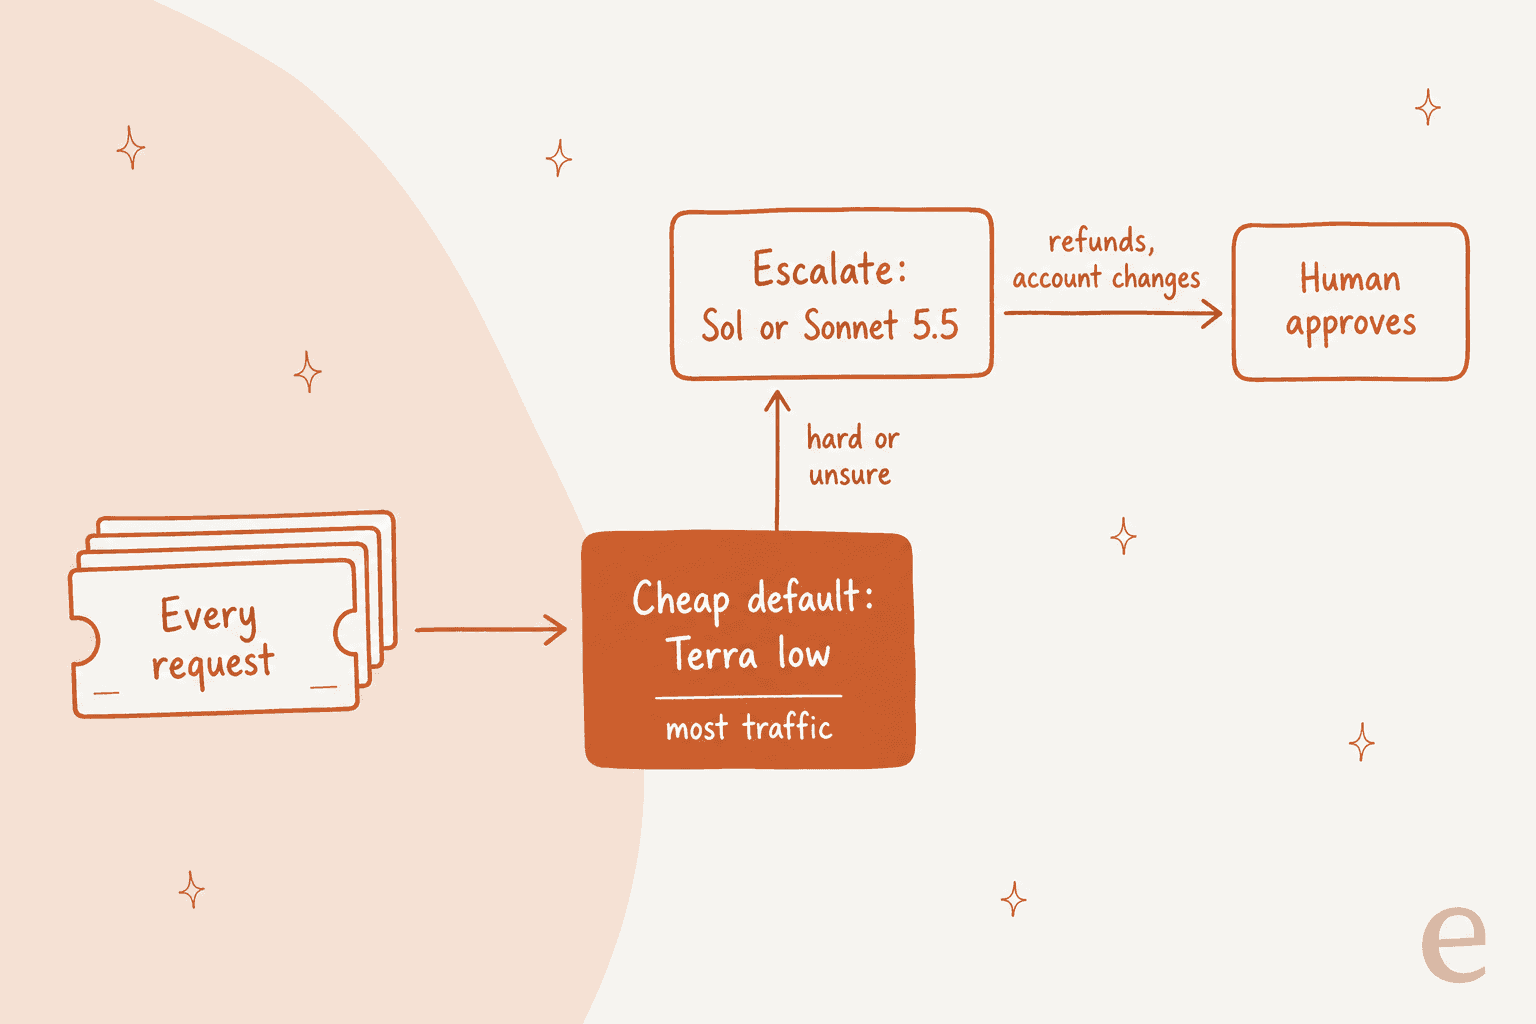
Der größte Teil der Einsparungen kommt vom Routing. OpenAI hat Terras Stufen none und low genau für diesen schnellen Pfad gebaut, und HN-Nutzer kehrten immer wieder zu einer Frage dazu zurück:
"Is a high effort terra above a low effort Sol? Are larger models mostly always better regardless of effort?"
Nach den AA-Daten lautet die Antwort oft nein, und Messen ist der einzige Weg, es für Ihre eigene Last zu wissen. Caching hilft außerdem bei jeder Option. Terras gecachte Eingabe kostet $0.05, ein Rabatt von 95 %, und der Leitfaden zu den OpenAI-API-Preisen behandelt Batch und Rate Limits, bevor Sie skalieren.
Wenn das Modell für eine Support-Warteschlange gedacht ist
Viele der Teams, die Terra-Alternativen vergleichen, bauen eigentlich einen Support-Bot. Ich setze seit Jahren KI-Agenten auf Live-Helpdesk-Warteschlangen und sehe immer wieder dasselbe: Das Modell ist selten die Schwachstelle; die Regeln darum herum sind es. In meinem Terra-Test mit 80 Durchläufen löste kein Modell weniger als 15 von 16 Tickets richtig. Der einzige echte Fehler war Terra auf none, das einem spanischsprachigen Kunden sagte "we've noted the new address", obwohl es keine Möglichkeit hatte, sie zu ändern.
Das ist ein Eskalationsproblem. Sie lösen es in der Schicht, die entscheidet, wann übergeben wird, nicht indem Sie für ein größeres Modell zahlen. Was KI-Halluzinationen verhindert, ist, Antworten in Ihrem Help Center und Ihren früheren Tickets zu verankern, egal welches Modell die Worte schreibt. Und neben einem falschen Versprechen an einen zahlenden Kunden ist die Token-Rechnung ein kleiner Teil der Kosten für KI im Kundenservice.
SamCart zeigt, wie diese Schicht in der Praxis aussieht. Ein eesel-Agent bearbeitet die Freshdesk-Tickets, ein weiterer den Website-Chat, beide antworten aus etwa 280 Help-Center-Artikeln, in einem Tarif für 8.000 Interaktionen im Monat. Koffer.ch, ein Schweizer Koffergeschäft, behält jede Antwort als Entwurf auf Deutsch, Französisch, Englisch oder Italienisch auf Freshdesk. Genau bei einem solchen Setup erledigt ein günstigeres Modell die Aufgabe problemlos.
Möchten Sie es lieber per Code steuern? Die eesel CLI führt dasselbe Teammitglied aus, das Sie im Dashboard einrichten würden. Testen Sie eine Antwort mit eesel chat und sehen Sie mit eesel activity, was der Agent getan hat; jede Änderung lässt sich mit --dry-run vorab ansehen. Jeder Befehl gibt JSON zurück. Jeder Workspace ist außerdem ein MCP-Server, sodass ein Coding-Agent auf Terra oder Sonnet Ihr Support-Teammitglied als Tool aufrufen kann.
eesel ausprobieren
Terra, Sol und Sonnet sind Motoren. Wenn Sie Support-Automatisierung bauen, ist eesel das KI-Helpdesk-Teammitglied, das diese Aufgabe bereits auf ihnen erledigt. Es schließt sich dem Helpdesk an, den Sie schon betreiben, sei es Zendesk, Freshdesk, Gorgias oder ein anderer. Es lernt aus Ihren früheren Tickets und Makros ebenso wie aus Ihrem Help Center und befolgt die Eskalationsregeln, die Sie festlegen. Bevor es jemandem live antwortet, läuft eine Simulation an Ihren echten früheren Tickets, sodass Sie seine Antworten mit dem vergleichen können, was Ihr Team tatsächlich gesendet hat.

Die Preise sind ein fester monatlicher Credit-Tarif, bei dem ein Ticket oder Chat einem Credit entspricht. Er beginnt bei $299 im Monat für 500 Credits, mit allen Funktionen und unbegrenzten Plätzen. Weil es keine Gebühr pro Token gibt, bleibt Ihre Rechnung gleich, wenn ein günstigeres Modell wie Terra erscheint. Starten Sie im kostenlosen Tarif und testen Sie eesel an einem Ausschnitt Ihrer Warteschlange.