Gemini 4 Argon Preise auf einen Blick
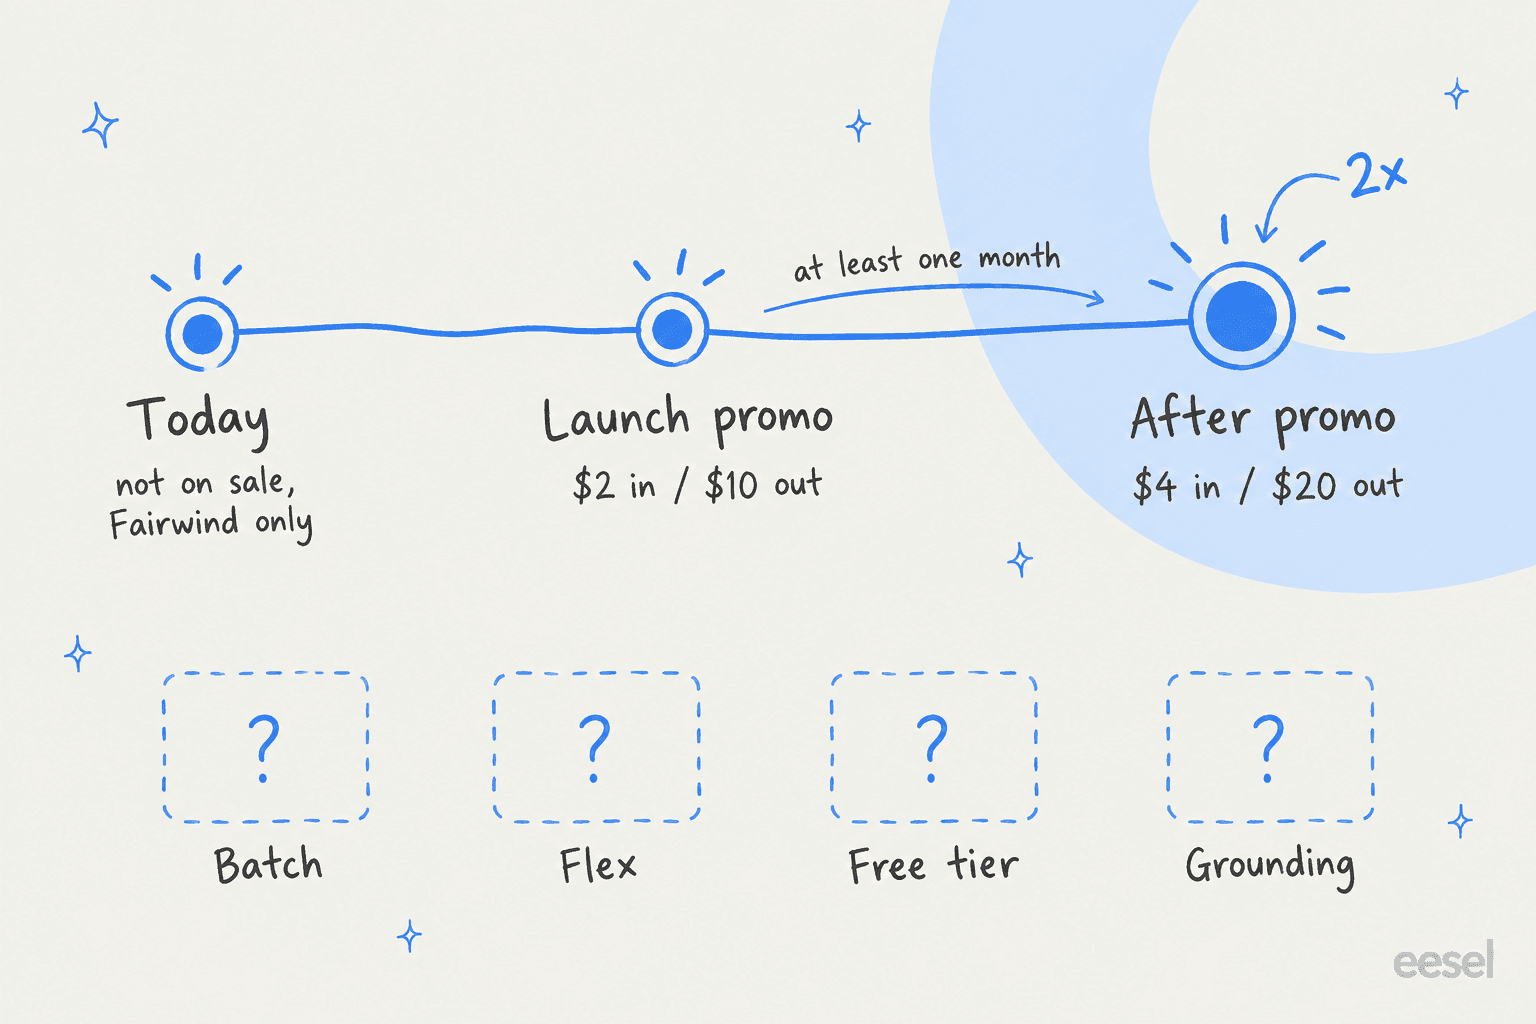
Google hat Argon am 30. September 2026 angekündigt. Der gesamte Preis steht in einer einzigen Zeile des Launch-Beitrags plus einer Fußnote. Hier ist alles, was Google bisher veröffentlicht hat, in einer Tabelle:
| Einführungspreis | Nach der Aktion | |
|---|---|---|
| Input, pro 1 Mio. Tokens | $2,00 | $4,00 |
| Gecachter Input, pro 1 Mio. Tokens | $0,10 (95 % Rabatt) | $0,20 (95 % Rabatt) |
| Output, pro 1 Mio. Tokens (inkl. Thinking) | $10,00 | $20,00 |
| Aufschlag für langen Kontext | Nicht veröffentlicht | Nicht veröffentlicht |
| Batch / Flex / Priority | Nicht veröffentlicht | Nicht veröffentlicht |
| Free Tier | Nicht veröffentlicht | Nicht veröffentlicht |
| Kontextfenster / max. Output | 1 Mio. / 1 Mio. Tokens | 1 Mio. / 1 Mio. Tokens |
| Wer kaufen kann | Noch niemand | Zuerst zahlende API-Kunden |
Die Fußnote selbst lautet: "After the introductory period expires, the price of $4 per 1M input tokens and $20 per 1M output tokens will apply." Der Cache-Preis von $0,20 nach der Aktion stammt aus meiner eigenen Rechnung auf Basis von Googles „95 % off input token price“ und passt zu der Zahl in der Kostenaufschlüsselung von Artificial Analysis. Artificial Analysis beschreibt den Rabatt als 50-%-Aktion „für mindestens einen Monat“ und merkt außerdem an, dass der Cache-Rabatt gegenüber Gemini 3.8 Flash von 90 % gestiegen ist.
Wenn Sie die Spezifikationen hinter dem Preis wollen (Benchmarks, Sicherheit und wer zum Fairwind Program gehört), finden Sie sie in meiner Gemini-4-Argon-Übersicht. Hier bleibe ich beim Geld.
Kann man es überhaupt schon bezahlen?
Nein. Das sollten Sie wissen, bevor Sie irgendeine Zahl in eine Tabelle eintragen. Argon wird "rolling out to a set of trusted cyber defenders" über Googles Fairwind Program. Zahlende API-Kunden und Abonnenten von Google AI Ultra sind als Nächste dran, und Google hat für keine der beiden Gruppen ein Datum genannt.
Ich habe es am 1. Oktober 2026 noch einmal geprüft. Ein generateContent-Aufruf an gemini-4-argon mit meinem Gemini-API-Schlüssel gab 404 NOT_FOUND zurück, und in der Modellliste war nirgends ein Argon zu sehen. Die Preisseite der Gemini Developer API endet weiterhin bei 3.8 Flash und 3.1 Pro:
Auf der Verbraucherseite sieht es nicht näher aus. Die Gemini-Abo-Seite führt Google AI Plus mit $4,99 im Monat, Google AI Pro mit $19,99 und Ultra mit $99,99 (5-faches Pro-Limit) oder $199,99 (20-fach) auf, und das beste dort genannte Modell ist weiter 3.1 Pro. Wenn Sie als Privatperson Zugang wollen, ist Ultra die einzige Stufe, die Google genannt hat. Trotzdem verspricht nichts auf dieser Seite Argon schon irgendjemandem.
Wie Gemini 4 Argon beim Preis pro Token abschneidet
Allein nach Preisliste landet Argon an einer seltsamen Stelle: Der Aktionspreis ist der Preis von GPT-6.1 Sol, und der Normalpreis ist der von Claude Opus 5.5. Unten stehen die veröffentlichten API-Preise für jedes Modell in Googles Vergleichstabelle sowie für die günstigeren Modelle, mit denen es oft verglichen wird. Die vollständigen Leitfäden zu OpenAI-API-Preisen und Anthropic-API-Preisen enthalten den Rest:
| Modell | Input / 1 Mio. | Gecachter Input / 1 Mio. | Output / 1 Mio. | Quelle |
|---|---|---|---|---|
| Gemini 4 Argon (Aktion) | $2,00 | $0,10 | $10,00 | |
| Gemini 4 Argon (Standard) | $4,00 | $0,20 | $20,00 | |
| GPT-6.1 Sol | $2,00 | $0,10 | $10,00 | OpenAI |
| GPT-6 Astra | $10,00 | $1,00 | $50,00 | OpenAI |
| Claude Opus 5.5 | $4,00 | $0,20 | $20,00 | Anthropic |
| Claude Fable 5.1 | $10,00 | $0,25 | $50,00 | Anthropic |
| Claude Sonnet 5.5 | $2,00 | $0,20 | $10,00 | Anthropic |
| Gemini 3.8 Flash | $0,75 | $0,075 | $3,75 |
Ein paar Dinge fallen auf. Erstens stimmt die Reaktion auf Hacker News ("5x cheaper than Astra") pro Token, und genau diesen Vergleich soll man laut Google anstellen. Neben GPT-6 Astra und Claude Fable 5.1 kostet Argon in der Aktion nur ein Fünftel.
Zweitens schrumpft der Abstand schnell. Zum Normalpreis liegt Argon immer noch bei 40 % des Token-Preises von Astra, aber es ist exakt gleichauf mit Opus 5.5, das im Artificial-Analysis-Index bei maximalem Aufwand etwa 5 Punkte höher liegt. Auch Gemini 3.8 Flash hat seine eigene Uhr: Laut Googles Preisseite verdoppelt sich der Preis von $0,75/$3,75 am 1. Januar 2027 auf $1,50/$7,50. Wer also ein reines Google-Budget für nächstes Jahr plant, muss bei beiden Zeilen mit steigenden Preisen rechnen.
Ein kleineres Detail ist wichtig, wenn Sie mit langen Dokumenten arbeiten. Gemini 3.1 Pro berechnet $4/$18, sobald ein Prompt über 200K Tokens geht, und OpenAI berechnet Prompts über 272K mit dem doppelten Input-Preis. Für Argon hat Google keinen Aufschlag für langen Kontext veröffentlicht. Vielleicht ist das ein echtes Feature, vielleicht steht es nur noch nicht da. Prüfen Sie die endgültige Preisliste, bevor Sie sich darauf verlassen.
Die Zahl, die zählt: Kosten pro Aufgabe
Ein Preis pro Token sagt Ihnen, was ein Wort kostet. Er sagt nichts darüber, wie viele Wörter das Modell verbraucht, und Argon verbraucht reichlich. Artificial Analysis hat seinen gesamten Index mit Argon durchlaufen lassen und 62K Output-Tokens pro Aufgabe gemessen, gegenüber 27K bei GPT-6 Astra. Über den ganzen Index erzeugte es 110 Mio. Tokens, während das mittlere Modell 82 Mio. braucht.
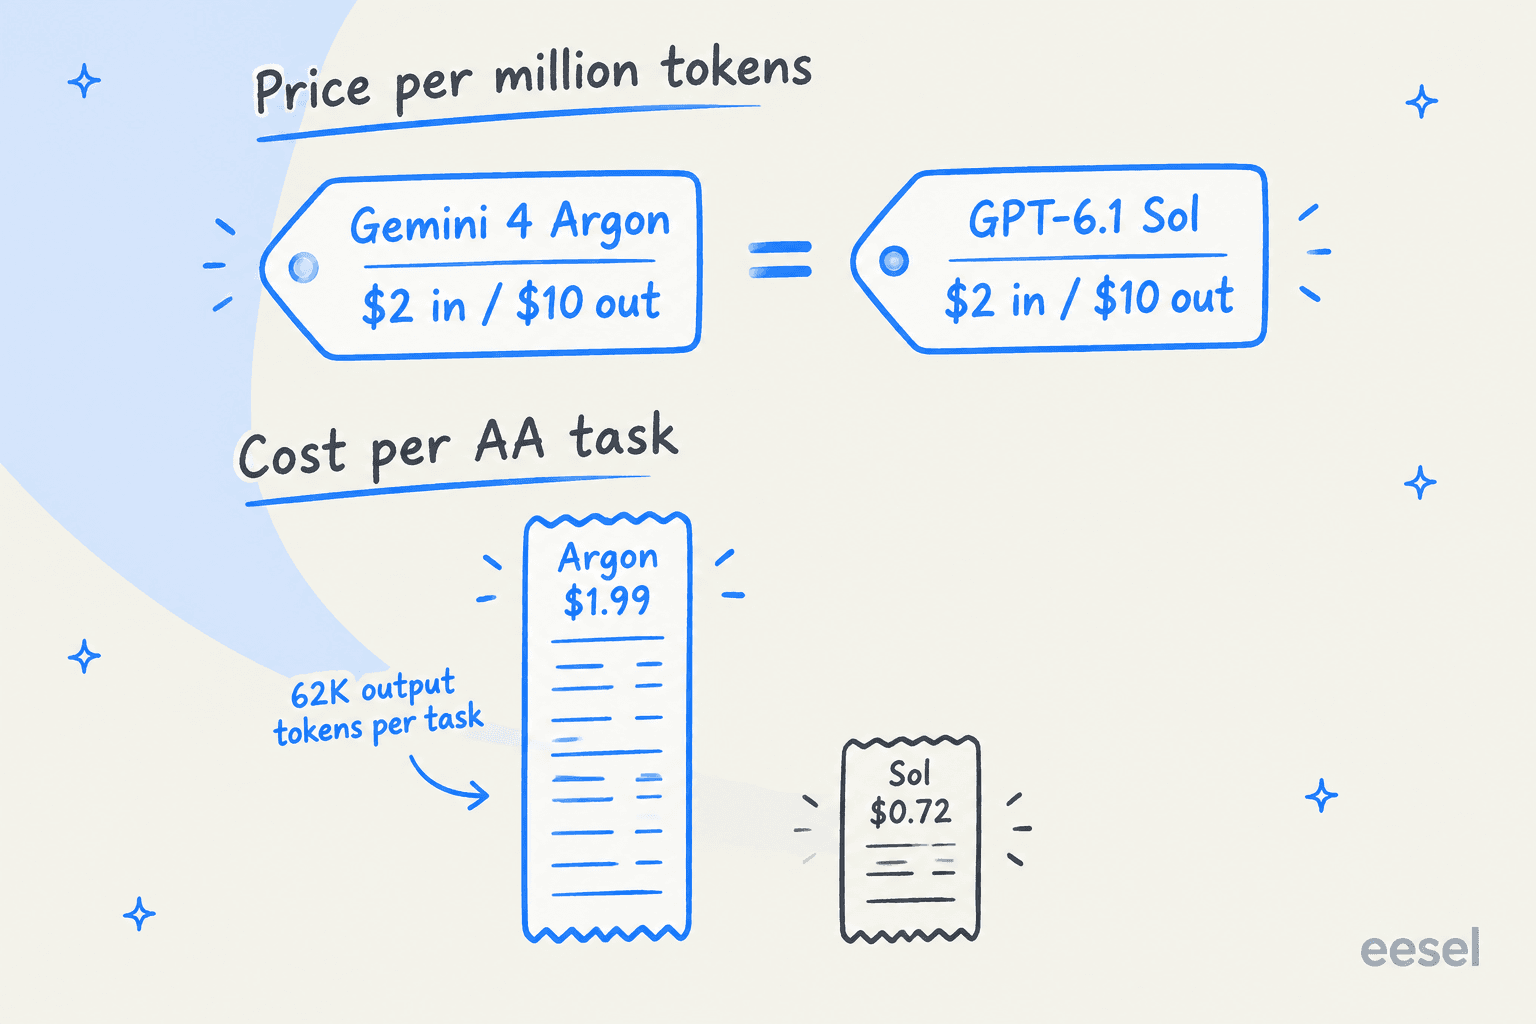
So entstehen aus einer Preisliste sehr unterschiedliche Rechnungen. Das hat Artificial Analysis pro Index-Aufgabe gemessen:
| Modell und Einstellung | AA Intelligence Index | Kosten pro Aufgabe |
|---|---|---|
| GPT-6.1 Sol (max) | 52 | $0,72 |
| Claude Opus 5.5 (high) | 54 | $1,82 |
| Gemini 4 Argon (high), Aktionspreis | 53 | $1,99 |
| GPT-6 Astra (max) | 53 | $3,26 |
| Gemini 4 Argon (high), Normalpreis | 53 | $3,98 |
Die Zeilen zu Sol, Astra und Argon stammen aus dem Artikel von Artificial Analysis; die Zeile für Opus 5.5 high ist die Zahl, die ein Hacker-News-Kommentator am Launch-Tag aus derselben AA-Grafik gezogen hat. Meine Lesart: Argon und Sol zahlen identische Preise pro Token, also liegt der Faktor 2,7 fast ausschließlich daran, dass Argon mehr schreibt.
Artificial Analysis hat außerdem ein Wasserfalldiagramm veröffentlicht, das zeigt, woraus sich Argons Kosten zusammensetzen. Es beginnt bei Gemini 3.1 Pro Preview mit $0,67 pro Aufgabe:
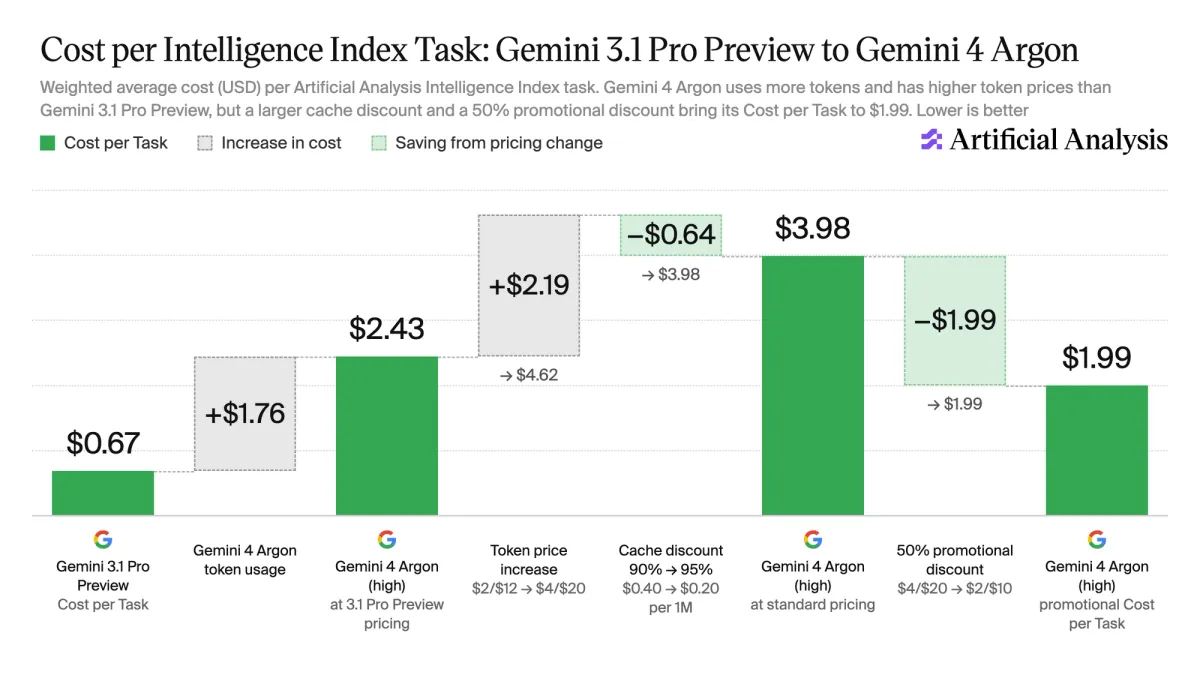
Der erste Balken ist der, den ich einer Finanzleitung zeigen würde. Selbst zu den alten Preisen von 3.1 Pro würden die zusätzlichen Tokens allein eine Aufgabe von $0,67 auf $2,43 treiben. Danach verdeckt die Aktion den größten Teil der Preiserhöhung. Ohne die Aktion kostet eine Aufgabe etwa das 6-Fache des vorherigen Pro-Modells.
Ein Hacker-News-Kommentator ahnte das, noch bevor die AA-Zahlen draußen waren:
"watch it somehow use 20x more tokens tho"

Es ist nicht das 20-Fache, eher das 2,3-Fache von Astras Output. Der Instinkt war trotzdem richtig, und er deckt sich mit dem, was ich bei Gemini 3.8 Flash gesehen habe, das im Index ebenfalls ausführlich war.
Rechenbeispiele: Was Argon bei echten Arbeitslasten kostet
Listenpreise werden verständlicher, wenn man ein paar konkrete Läufe danebenlegt. Jedes Beispiel unten nutzt Googles veröffentlichte Preise und für alle Modelle dieselben Token-Zahlen. Das schmeichelt Argon ein wenig, da es tendenziell mehr schreibt.
1. Ein aufwendiger Agent-Lauf. Stellen Sie sich einen Agenten vor, der 200K Tokens Kontext liest und 60K Output-Tokens schreibt, nahe an Argons Durchschnitt von 62K. Zum Aktionspreis sind das $0,40 Input plus $0,60 Output, also $1,00 pro Lauf. Cachen Sie den Kontext, sinkt die Input-Seite auf $0,02 und der Lauf kostet $0,62. Bei 1.000 Läufen im Monat steigen Sie mit dem Ende der Aktion von $620 auf $1.240.
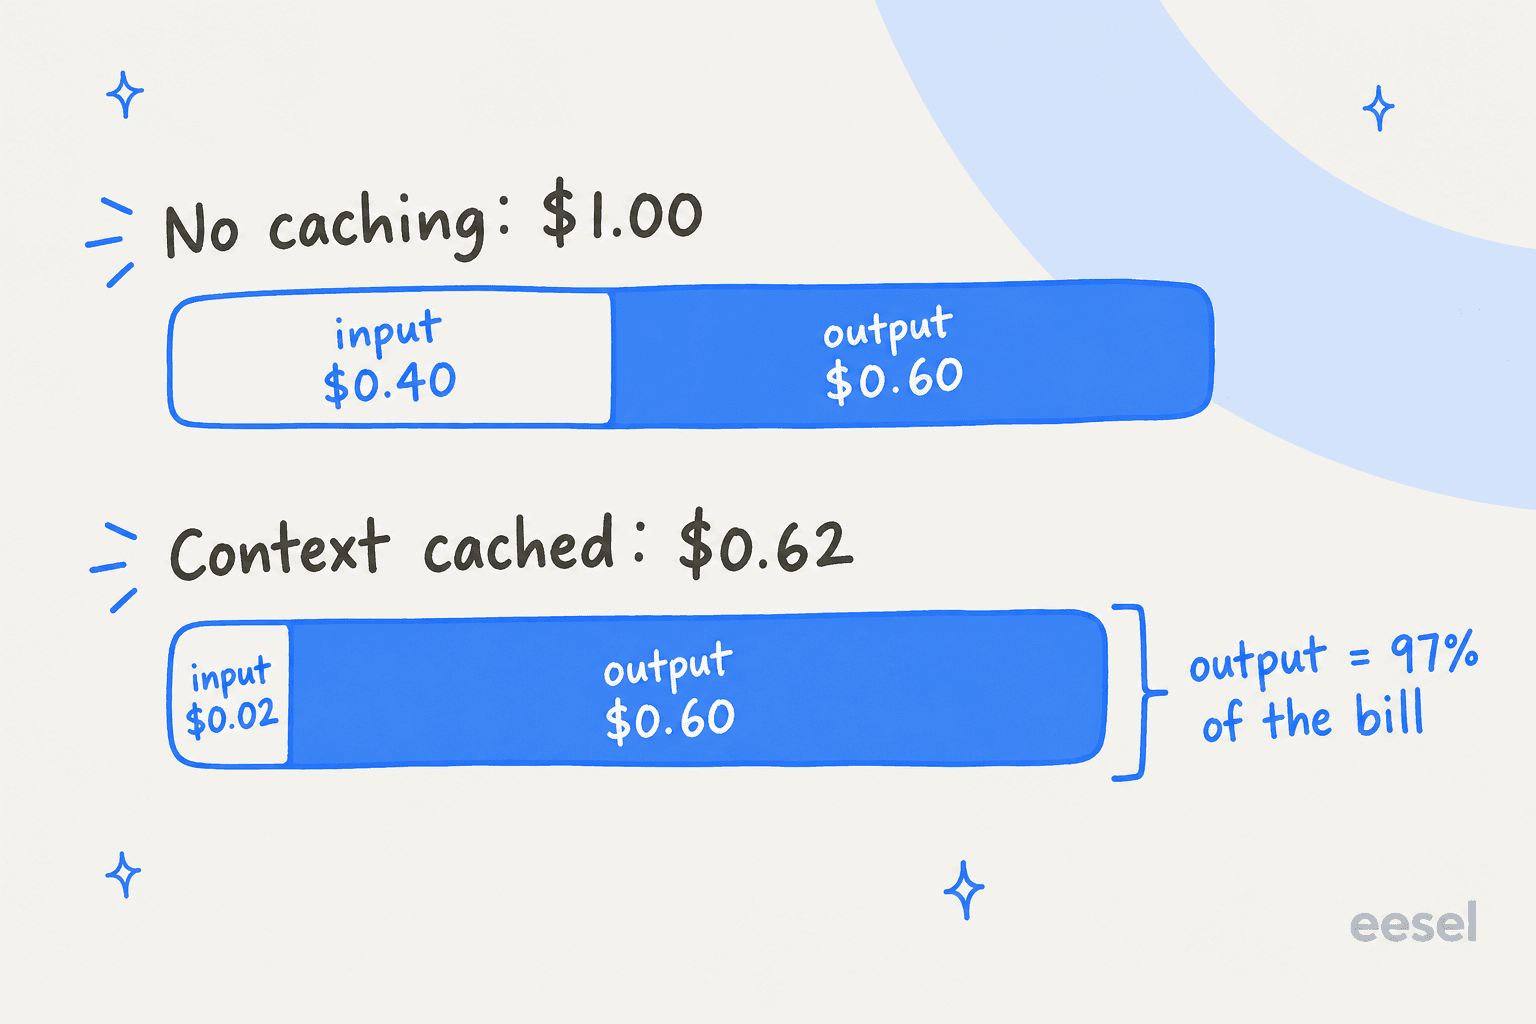
Das ist das übliche Muster bei Agent-Arbeit: Sobald Caching greift, macht der Output etwa 97 % der Rechnung aus. Der 95-%-Cache-Rabatt ist großzügig, betrifft aber nur den Teil der Rechnung, der ohnehin klein war. Um Argon günstiger zu machen, sollten Sie kürzere Outputs anstreben, nicht mehr Caching.
2. Eine Prüfung langer Dokumente. Stellen Sie sich vor, Sie senden 500-mal im Monat ein Vertragspaket mit 800K Tokens und bekommen eine Zusammenfassung mit 10K Tokens zurück. Argon in der Aktion: $1,60 + $0,10 = $1,70 pro Lauf, $850 im Monat. Zum Normalpreis $1.700. Zu den Preisen von Gemini 3.1 Pro über 200K kostet derselbe Lauf $3,38, und GPT-6.1 Sols Preis über 272K ergibt $3,35. Bleibt Argon also ohne Aufschlag für langen Kontext, ist es hier im Vergleich zum Feld am günstigsten, selbst zum vollen Preis.
3. Ein Support-Ticket. Dieses Beispiel kann ich mit einem echten Test untermauern. Anfang der Woche habe ich für meinen GPT-6.1-Sol-Test 15 Support-Tickets durch GPT-6.1 Sol laufen lassen. Im Schnitt brauchte jedes etwa 545 Input-Tokens und 70 Output-Tokens, und der Durchlauf kostete rund $1,80 pro 1.000 Tickets. Argon in der Aktion hat exakt dieselbe Preisliste, dieselben Tokens kosten also dieselben $1,80. Schreibt Argon das 2,7-Fache an Output, wie die AA-Lücke nahelegt, landen Sie bei etwa $3 pro 1.000 Tickets. Nach der Aktion verdoppeln sich beide Zahlen. Zum Vergleich: GPT-6 Astra kam im selben Test auf $9,09 pro 1.000.
Argon selbst konnte ich nicht testen, da die API 404 zurückgibt. Behandeln Sie das dritte Beispiel also als Umrechnung und nicht als Testergebnis. Sobald der bezahlte Zugang öffnet, lasse ich dieselben Tickets noch einmal laufen.
Gemini 4 Argon Kostenrechner
Tragen Sie Ihre eigenen Token-Zahlen ein. Die Voreinstellungen entsprechen den drei Beispielen oben. Die Preise stammen aus den veröffentlichten Preislisten von Google, OpenAI und Anthropic, für Prompts unter 200K Tokens.
Ein paar Hinweise zum Ausprobieren. Setzen Sie die Output-Tokens hoch, dann gleicht Argon in der Aktion Sol aus und halbiert Opus 5.5, aber setzen Sie den Haken bei 2,3x, verschwindet der größte Teil dieses Vorsprungs. Beim Preset für lange Dokumente bringt der fehlende veröffentlichte Aufschlag für Argon mehr für die Rechnung als jeder Rabatt.
Die versteckten Kosten und offenen Fragen
Die Preisliste ist kurz, daher ist ein größerer Teil der echten Kosten noch unbekannt. Das würde ich im Blick behalten, bevor Sie ein Budget festlegen:
- Das Ende der Aktion. "Mindestens ein Monat" laut Artificial Analysis, kein Datum von Google. Jede Prognose über Ende Oktober hinaus sollte $4/$20 verwenden.
- Ausführlichkeit. 62K Output-Tokens pro AA-Aufgabe. Ihre Arbeitslast kann anders aussehen, aber die Rechnung steckt im Output, also messen Sie zuerst das.
- Fehlende Stufen. Noch kein Preis für Batch, Flex oder Priority. Bei Gemini 3.8 Flash sind Batch und Flex 50 % günstiger und Priority das 1,8-Fache, Offline-Jobs könnten also deutlich billiger werden, sobald Google die Preise veröffentlicht.
- Grounding. Google Search Grounding ist bei Gemini 3.x 5.000 Anfragen im Monat kostenlos, danach $14 pro 1.000. Für Argon gibt es noch keinen veröffentlichten Preis.
- Cache-Speicher. Gemini 3.8 Flash berechnet zusätzlich zu den Cache-Lesezugriffen einen Preis pro Million Tokens und Stunde für den Cache-Speicher. Auch Argons Speicherpreis ist nicht draußen, und bei einem Kontext von 1 Mio. Tokens kann sich das summieren.
Der Hacker-News-Thread kam schnell auf die Aktion. Jemand lobte den Output-Preis von $10, und die Antwort war kurz:
"That is a promotional price. The regular price is double that."
Andere gingen direkt zu den Kosten pro Aufgabe, und das halte ich für den besseren Instinkt:
"It's also more token hungry than similar models, so does it really make a big difference in the end?"
Ist Gemini 4 Argon den Preis wert?
Für manche Arbeitslasten ja, selbst bei $4/$20. Die Arbeit mit langen Dokumenten ist der klarste Fall: Argon führt Googles Tabelle beim Retrieval in 256K bis 1M Kontext an (84,2 % gegenüber den 60ern und niedrigen 70ern der Konkurrenz) und hat keinen veröffentlichten Aufschlag für langen Kontext, sodass eine Pipeline für Verträge oder Unterlagen ein besseres Modell und zugleich eine günstigere Rechnung bekommt als mit 3.1 Pro. Auch für Rechts- und Finanz-Agenten gibt es ein Argument, denn Argon liegt beim Legal Agent Benchmark von Harvey etwa um das 3-Fache vorn.
Für allgemeine Agent-Arbeit und Coding würde ich auf echte Zahlen warten. Zu Aktionspreisen zahlen Sie pro Aufgabe das 2,7-Fache von GPT-6.1 Sol, um einen Punkt mehr im AA-Index zu bekommen. Zu Normalpreisen zahlen Sie die Preisliste von Opus 5.5 für ein Modell, das in Googles eigener Tabelle bei Terminal-Bench 4.0 9 Punkte hinter Opus 5.5 liegt. Wenn Sie heute ein günstigeres Frontier-Modell brauchen, zeigen die Übersichten zu GPT-6.1-Sol-Alternativen und Gemini-Alternativen, was heute zu haben ist.
Im Kundensupport spielt Argons Preis kaum eine Rolle. Bei ein paar Dollar pro 1.000 Tickets ist das Modell der kleinste Posten in einer Aufschlüsselung der Kosten im KI-Kundenservice. Argons Halluzinationsrate von 15 % bei AA-Omniscience gegenüber 51 % bei GPT-6 Astra ist die interessantere Zahl für den Support. Doch selbst die hilft nur, wenn der Agent drumherum das richtige Wissen liest und übergibt, wenn er die Antwort nicht kennt. Der Leitfaden zu KI-Halluzinationen im Support behandelt diesen Teil.
Was das für ein Support-Team bedeutet
Ich habe bei eesel lange damit verbracht, KI auf Live-Support-Warteschlangen zu setzen, und der Modellpreis hat fast nie entschieden, ob ein Rollout funktioniert. Entscheidend ist alles um das Modell herum: das Help Center und die vergangenen Tickets, aus denen es lernt, wie es sich mit Zendesk verbindet oder mit Freshdesk und ob es an echten Tickets getestet wurde, bevor es je einen Kunden berührt. Die Kosten pro Lösung bestehen größtenteils aus Menschen und Prozessen, nicht aus Tokens.
Wo eine Aktion wie die von Argon einen Unterschied macht, ist die Planbarkeit. Wenn Sie Ihren eigenen Bot auf Basis roher Tokens bauen, besitzen Sie jetzt eine Rechnung, die sich an einem Tag verdoppelt, den niemand angekündigt hat, und Sie verfolgen zusätzlich, welches Modell diesen Monat das beste ist. Für ein Engineering-Team mit Agenten ist das in Ordnung. Für eine Support-Leitung, die eine Zahl für das Budget des nächsten Quartals braucht, passt es schlecht.

eesel ausprobieren
Wenn Sie Gemini 4 Argon bepreisen, weil Sie wollen, dass KI Tickets beantwortet, können Sie sich die Token-Rechnerei sparen. Argon ist Infrastruktur; eesel ist der Mitarbeiter. Das KI-Helpdesk-Teammitglied von eesel lernt aus Ihren vergangenen Tickets und Ihrem Help Center und schließt sich an den Helpdesk an, den Sie bereits nutzen. Außerdem führt es eine Simulation mit Ihren echten vergangenen Tickets aus, damit Sie seine Antworten prüfen können, bevor es einem Kunden antwortet.
Die Preise sind ein fester monatlicher Credit-Tarif, bei dem ein Ticket oder Chat einem Credit entspricht. Alle Funktionen und unbegrenzte Seats sind enthalten, und es gibt einen kostenlosen Tarif mit 100 Credits und ohne Karte. Wenn die Aktion eines Modells unter Ihnen endet, bleibt Ihre Rechnung gleich. Testen Sie eesel an einem Teil Ihrer Warteschlange und sehen Sie, wie es mit Ihren eigenen Tickets umgeht.
Häufig gestellte Fragen
Wie viel kostet Gemini 4 Argon?
Wann endet der Aktionspreis für Gemini 4 Argon?
Kann ich Gemini 4 Argon heute schon bezahlen?
gemini-4-argon einen 404-Fehler zurück, und das Modell steht nicht auf Googles API-Preisseite. Es wird zuerst an Cyber-Verteidiger ausgerollt, dann an zahlende API-Kunden und Abonnenten von Google AI Ultra, ohne Termin.Ist Gemini 4 Argon günstiger als GPT-6.1 Sol?
Ist Gemini 4 Argon günstiger als Claude Opus 5.5?
Gibt es für Gemini 4 Argon Batch- oder Free-Tier-Preise?
Was würde Gemini 4 Argon im Kundensupport kosten?


Article by
Kira
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.