Was Gemini 3.8 Flash TTS eigentlich ist
Gemini 3.8 Flash TTS (gemini-3.8-flash-tts) ist Googles aktuelles Text-zu-Sprache-Modell, und anders als viele der kursierenden Audio-Modelle ist es stabil statt Preview. Die ID trägt kein -preview-Suffix, und Google führt es als empfohlenen Ersatz für das ältere gemini-3.1-flash-tts-preview auf. Es nimmt Text entgegen und erzeugt Audio, nichts weiter — genau das, was man von einem dedizierten Sprachmodell erwartet.
Das Leistungsspektrum ist großzügig. Du bekommst 30 vorgefertigte Studio-Stimmen (Zephyr, Puck, Kore, Fenrir und Co.), jeweils mit einem Deskriptor wie Bright oder Firm, plus eine Extended Voice Library mit Hunderten weiteren, die du per client.voices.list() abrufen kannst. Es spricht 130 Sprachen mit automatischer Spracherkennung, und du kannst Stil, Akzent, Tempo und Tonfall mit natürlichsprachlichen Prompts steuern oder Inline-Tags wie <laugh> und <sigh> für punktuelle stimmliche Ereignisse einfügen. Außerdem gibt es Voice Design (eine Persona aus einer Textbeschreibung erstellen) und Voice Cloning aus einem Referenzclip.
Das eine Detail, das in der Praxis zuschlägt: Multi-Speaker ist auf zwei Sprecher pro Anfrage begrenzt. Ein Podcast mit drei Personen oder eine Gruppenszene bedeutet, jeden Redebeitrag einzeln zu synthetisieren und das Audio selbst zusammenzuschneiden. Der Output liegt standardmäßig als 24-kHz-Mono-WAV vor, mulaw und alaw stehen für Telefonie zur Verfügung. Das Ganze läuft neben dem reinen Textmodell Gemini 3.8 Flash, und beide werden völlig unterschiedlich abgerechnet — genau dort entsteht die meiste Verwirrung.
Gemini 3.8 Flash TTS Preise: die vollständige Tabelle
Hier sind alle Tarifstufen, in USD pro 1 Mio. Token, zu den Einführungspreisen von 2026. Der Satz für 2027 steht in Klammern, denn wie gleich erklärt wird, verdoppelt sich alles.
| Stufe | Text-Input / 1 Mio. | Audio-Output / 1 Mio. | Hinweise |
|---|---|---|---|
| Standard | 0,50 $ (1,00 $) | 9,00 $ (18,00 $) | Der Standardsatz |
| Batch | 0,25 $ (0,50 $) | 4,50 $ (9,00 $) | ~50 % Rabatt, asynchrone Jobs |
| Flex | 0,25 $ (0,50 $) | 4,50 $ (9,00 $) | Gleicher Satz, günstigeres Caching |
| Priority | 0,90 $ (1,80 $) | 16,20 $ (32,40 $) | ~1,8x, latenzkritisch |
| Free | Kostenlos | Kostenlos | Standard/Priority über AI Studio |
All das stammt direkt von Googles Gemini-API-Preisseite. Context Caching wird unterstützt und startet bei 0,125 $ pro 1 Mio. Input-Caching-Token auf der Standardstufe, zuzüglich einer Speichergebühr von 0,50 $ pro 1 Mio. pro Stunde. Die Audio-Output-Zahl ist die entscheidende, weil sie sich mit der Menge der erzeugten Sprache skaliert. Der Text-Input ist im Vergleich fast ein Rundungsfehler.
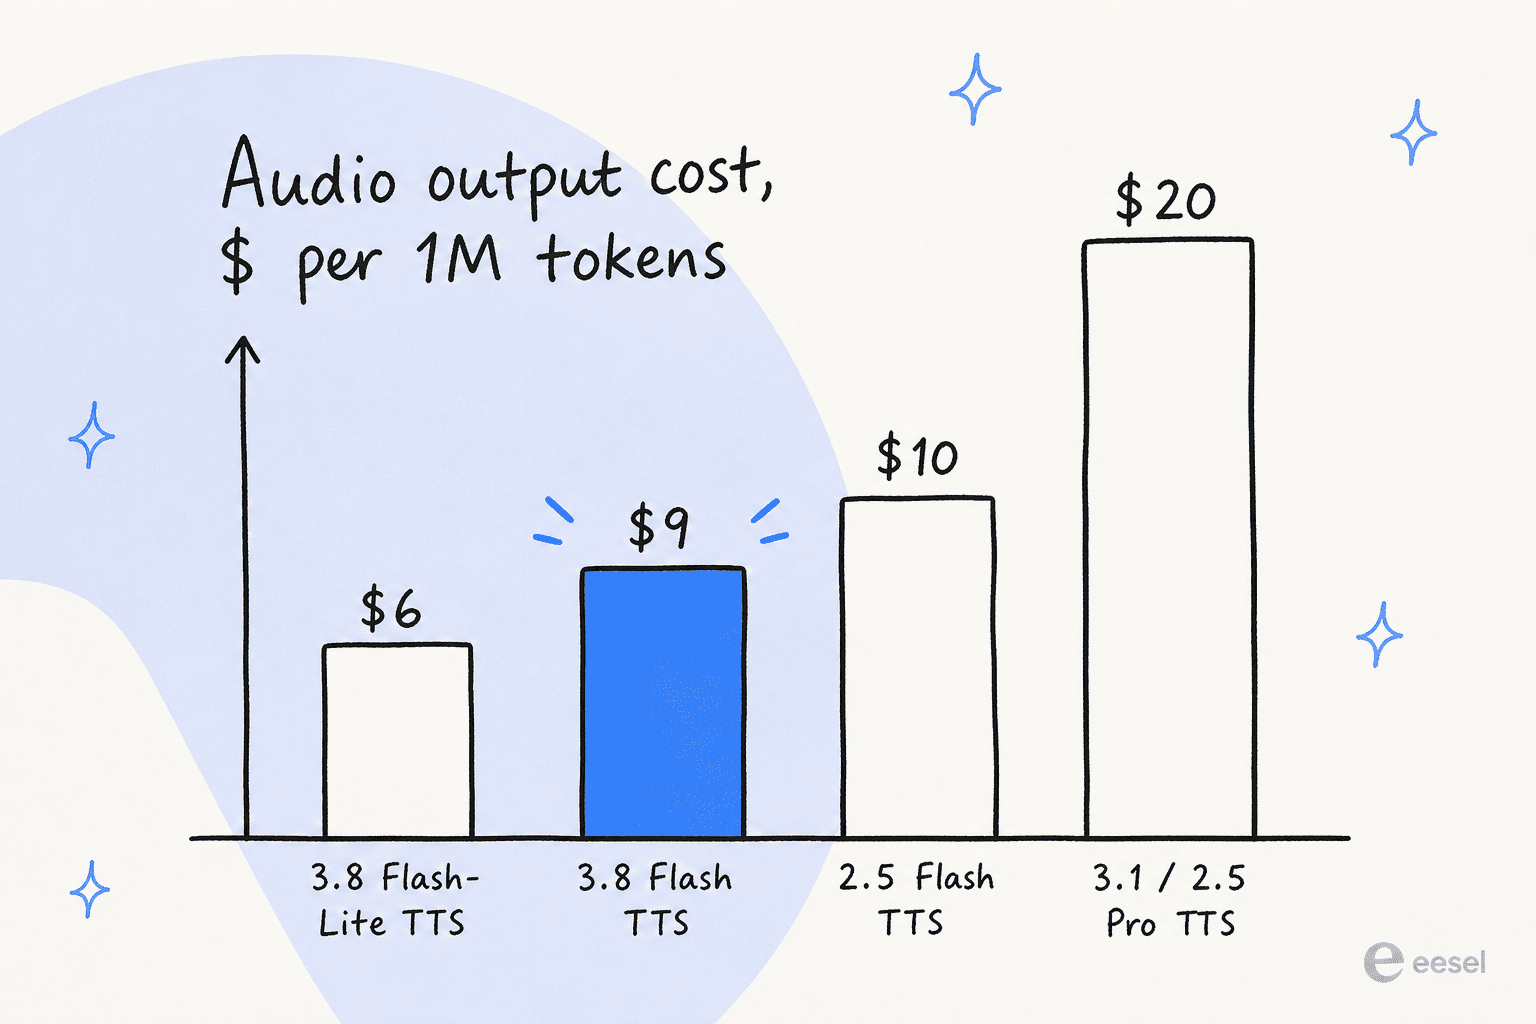
Interessant ist, wo sich die 9,00 $ in Googles eigenem Angebot einordnen. Das Modell ist günstiger als das abgelöste Gemini 2.5 Flash TTS (10 $ Audio-Output) und weniger als halb so teuer wie die Preview-Modelle 2.5 Pro und 3.1 Flash TTS (20 $ Audio-Output). Es gibt außerdem ein günstigeres Geschwistermodell, Flash-Lite TTS, für 6 $ Audio-Output, wenn du mit 101 statt 130 Sprachen leben kannst.
Was das konkret kostet
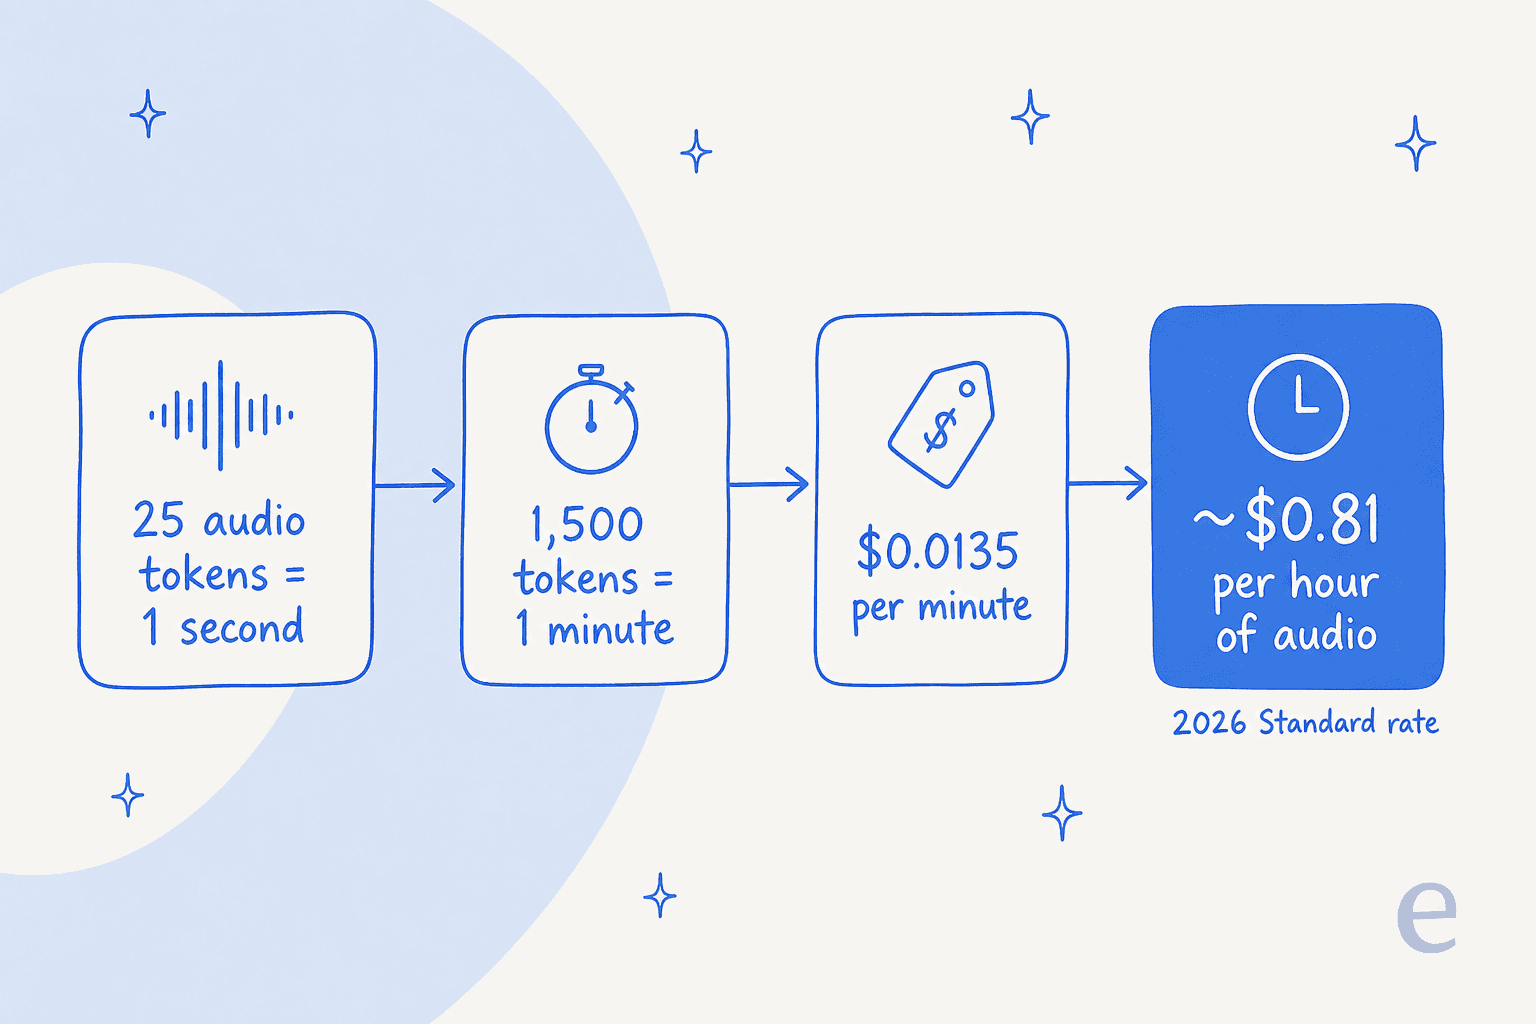
Preise pro Token sind schwer greifbar, also rechnen wir sie in echtes Geld um. Audio wird mit 25 Token pro Sekunde abgerechnet, das ergibt 1.500 Token pro Minute und 90.000 Token pro Stunde. Beim Standardsatz 2026 von 9,00 $ pro 1 Mio. kostet eine Stunde generierte Sprache rund 0,81 $. Rechnet man den eingespeisten Text dazu (eine volle Stunde Erzähltext sind nur rund 12.000 Input-Token), kommt kaum ein Cent hinzu.
Ein paar Beispielrechnungen zum Standardsatz:
- Eine 30-minütige Podcast-Folge: rund 0,41 $ an Audiokosten.
- Ein 8-stündiges Hörbuch: rund 6,48 $.
- 10.000 Support-IVR-Ansagen mit je 15 Sekunden: 3,75 Mio. Audio-Token, also rund 33,75 $.
Führst du eines davon als nächtlichen Batch-Job aus, halbierst du das, womit das Hörbuch näher an 3,24 $ liegt. Bei hohem Volumen und nicht-interaktiver Generierung ist Batch die naheliegende Wahl. Der einzige Ort, an dem der reine Preis nicht die ganze Geschichte erzählt, ist alles, worauf ein Mensch in Echtzeit wartet — dort zahlst du den Priority-Satz und trägst eine Latenz, die du nicht vollständig kontrollieren kannst.
Der Haken: Preise verdoppeln sich am 1. Januar 2027
Das ist der Teil für den Klebezettel. Die Werte 0,50 $ und 9,00 $ sind einführende Aktionspreise. Am 1. Januar 2027 steigt der Standard-Text-Input auf 1,00 $ pro 1 Mio. und der Audio-Output auf 18,00 $ pro 1 Mio. Jede andere Stufe verdoppelt sich im Gleichschritt: Batch- und Flex-Audio-Output auf 9,00 $, Priority-Audio-Output auf 32,40 $.
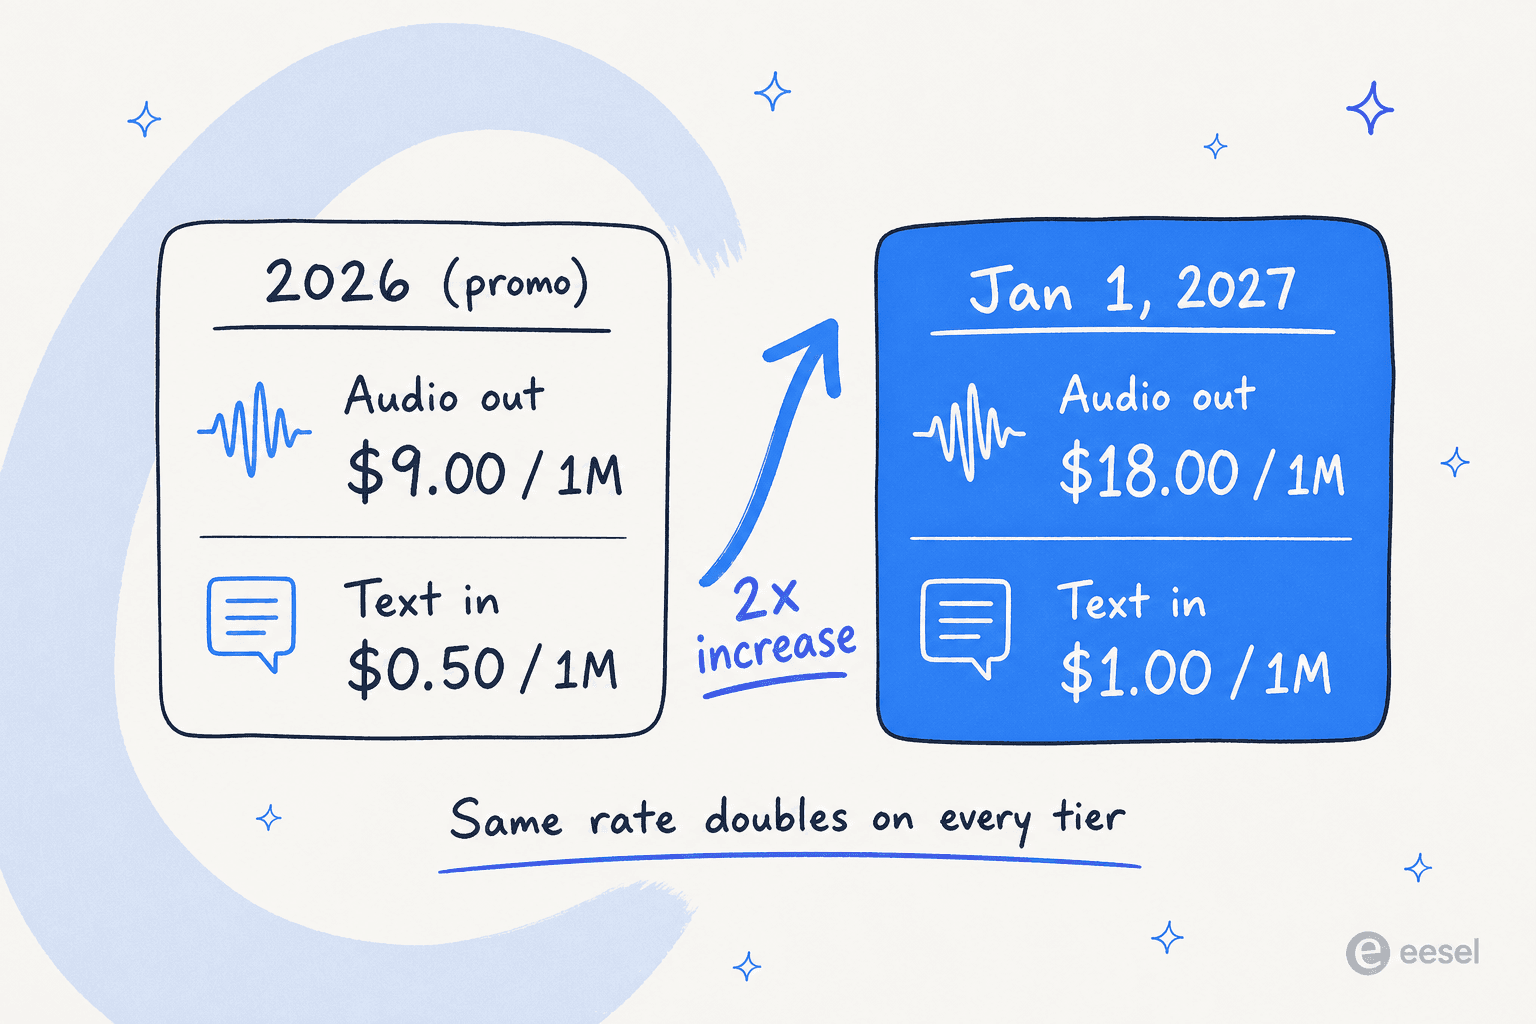
Aus der 0,81-$-Audiostunde werden 2027 also rund 1,62 $, und das 8-stündige Hörbuch steigt von 6,48 $ auf 12,96 $. Es ist derselbe Schritt, den Google schon bei den Textmodellen gemacht hat, und fair, solange man ihn kommen sieht. Wenn du über dieses Jahr hinaus budgetierst, verdopple die Zahlen aus diesem Beitrag und plane von dort aus. Das ist auch ein Anstoß, jetzt Caching- und Batch-Ersparnisse zu sichern, wo es geht.
Der Vergleich mit ElevenLabs, OpenAI und dem Rest
Sprachmodelle zu vergleichen ist wirklich knifflig, weil die Anbieter nicht gleich abrechnen. Amazon, Azure und Deepgram berechnen pro Zeichen Eingabetext. OpenAI und Google berechnen pro Audio-Output-Token, was sich mit der Länge der generierten Sprache skaliert, nicht mit dem Skript. ElevenLabs verkauft Abo-Credits. Um alle auf eine Achse zu bringen, habe ich alles auf geschätzte Kosten pro Stunde Sprache umgerechnet, mit Amazons eigenem Richtwert, dass 1 Mio. Zeichen rund 23 Stunden Audio entsprechen. Die Pro-Stunde-Werte sind Schätzungen, keine Vertragskonditionen, weil sie sich mit dem Sprechtempo verschieben.
| Anbieter | Flaggschiff-Modell | Nativer Preis | ~ $/Stunde Audio | Kostenlose Stufe |
|---|---|---|---|---|
| Gemini 3.8 Flash TTS | gemini-3.8-flash-tts | 9 $ / 1 Mio. Audio-Token | ~0,81 $ | Kostenlos in AI Studio |
| Amazon Polly (Neural) | Neural | 16 $ / 1 Mio. Zeichen | ~0,70 $ | 1 Mio. Zeichen/Monat (12 Monate) |
| Azure AI Speech | Neural / HD Flash | 15 $ / 1 Mio. Zeichen | ~0,65 $ | 0,5 Mio. Zeichen/Monat |
| OpenAI | gpt-4o-mini-tts | 12 $ / 1 Mio. Audio-Token | ~0,90 $ | Keine |
| Amazon Polly (Generative) | Generative | 30 $ / 1 Mio. Zeichen | ~1,30 $ | 100k Zeichen/Monat |
| Deepgram | Aura-2 | 30 $ / 1 Mio. Zeichen | ~1,30 $ | 200 $ Guthaben |
| ElevenLabs | Eleven v3 / Flash | ~5c/min (Business) | ~3,00 $ | 10k Credits/Monat |
Das Überraschendste dabei: Gemini 3.8 Flash TTS ist wie eine handelsübliche neuronale Stimme bepreist, obwohl es eines der ausdrucksstärkeren generativen Modelle ist. Die günstigeren Zeilen von Amazon und Azure sind ihre älteren neuronalen Stimmen; ihre generative Qualitätsstufe (Polly Generative) liegt bei 1,30 $ pro Stunde, und Deepgrams Flaggschiff landet an derselben Stelle. ElevenLabs, weiterhin der Referenzpunkt für Sprachqualität, kostet pro Stunde etwa das Vierfache. Wenn Kosten pro Stunde dein entscheidendes Kriterium sind und du ausdrucksstarken Output willst, ist Gemini gerade kaum zu schlagen — zumindest bis der Reset 2027 den Preis auf rund 1,62 $ anhebt.
Für die OpenAI-Seite dieses Vergleichs gehen meine Beiträge zur OpenAI Realtime API und den gpt-realtime-mini Preisen tiefer darauf ein, wo tokenbasierte Sprachabrechnung sinnvoll ist.
Ist die Stimme überhaupt gut?
Der Preis zählt nur, wenn der Output brauchbar ist, und hier werden die ersten Reaktionen gemischter. Der Rollout sorgte für etwas Unmut bei der Qualität. Ein Entwickler auf Hacker News brachte es unverblümt auf den Punkt:
"I don't know, I guess their roll out is a bit sloppy. It's a bit of a shame, though, since the voices which are available all sound like generic Gemini voices to me. Nothing stands out."

Das ist die Meinung einer einzelnen Person, und Stimmpräferenz ist subjektiv, aber es passt zu einem Muster: Googles TTS ist günstig und breit aufgestellt, während ElevenLabs beim Test "klingt diese bestimmte Stimme herausragend" für viele Menschen weiterhin gewinnt. Manche Nutzer bleiben vorerst bei dem, was sie kennen:
"For on the go, I've been using ElevenReader. Technically not free but their free tier has been plenty for me."
Die ehrliche Einschätzung lautet also: Wenn du günstige, mehrsprachige, gut genug klingende Erzählung im großen Maßstab brauchst, ist Gemini 3.8 Flash TTS ein hervorragendes Angebot. Wenn eine einzelne, unverwechselbare, markenprägende Stimme das Produkt ist, teste sie sorgfältig gegen ElevenLabs, und geh nicht davon aus, dass die Preislücke automatisch zu deinen Gunsten für Qualität steht.
Wo ein günstiges Sprachmodell passt — und wo nicht
Hier die Neurahmung, mit der ich einen Käufer entlassen würde. Ein TTS-Modell ist Infrastruktur. Es ist eine fantastische, günstige Möglichkeit, einer App eine Stimme zu geben: eine Hörbuch-Pipeline, ein Erzähler im Produkt, eine Barrierefreiheits-Ebene, IVR-Ansagen. Dafür sind 0,81 $ pro Stunde ein wirklich guter Deal.
Aber sobald der Anwendungsfall Kundenservice ist, ist das Modell der einfache 10-Prozent-Teil des Problems. Der harte Teil ist alles darum herum: die richtige Antwort aus deiner Wissensdatenbank ziehen, die Tools aufrufen, die ein Ticket wirklich lösen, und vor dem ersten Kundenkontakt an deinem echten Verlauf getestet werden. Das ist der Unterschied zwischen Infrastruktur und einem Mitarbeiter. Gemini TTS ist Ersteres. Es kennt deine Rückerstattungsrichtlinie nicht und kann kein Ticket priorisieren, und all das selbst zusammenzubauen ist ein Projekt, kein API-Aufruf.
Das ist der Rahmen, in dem wir täglich arbeiten. Wir setzen KI seit Jahren auf lebende Support-Warteschlangen, und was eine Demo von einem echten Rollout unterscheidet, ist nie das Modell, sondern immer die Verrohrung und das Testen. Deshalb ist ein KI-Helpdesk-Agent ein ganz anderer Kauf als ein Sprach-Endpunkt, auch wenn bei beiden "KI" draufsteht. Wenn du generell die Rechnung Mensch gegen Automatisierung abwägst, ist unsere Analyse zu den Kosten von KI-Agent vs. menschlichem Agenten ein besserer Ausgangspunkt als ein Preis pro Token.
eesel testen
eesel ist eine KI-Mitarbeiter-Plattform, und im aktuellen Angebot ist ein einsatzbereiter KI-Helpdesk-Agent, der sich deiner bestehenden Support-Warteschlange anschließt. Während Gemini TTS ein Modell ist, um das du selbst herumbauen musst, kommt eesel bereits mit dem Wissen, sich mit deinem Helpdesk zu verbinden, aus deinen vergangenen Tickets zu lernen und gegen echte historische Gespräche simuliert zu werden, damit du seine Lösungsquote kennst, bevor es live geht.

Wenn du lieber im Terminal arbeitest, steuert die eesel CLI denselben Mitarbeiter und Workspace programmatisch. Du kannst sie manuell bedienen, in Skripte einbauen oder einen Coding-Agenten wie Claude Code oder Cursor sie headless ausführen lassen — die KI, die du kaufst, ist so sowohl im Dashboard als auch über die API verfügbar, genau wie du auf ein Modell wie Gemini TTS zugreifen würdest. Du kannst eesel kostenlos testen und es zuerst mit deinen eigenen Tickets simulieren.
Häufig gestellte Fragen
Wie viel kostet Gemini 3.8 Flash TTS?
Gibt es eine kostenlose Stufe für Gemini 3.8 Flash TTS?
Wie schneiden die Gemini 3.8 Flash TTS Preise im Vergleich zu ElevenLabs ab?
Warum verdoppelt sich der Gemini 3.8 Flash TTS Preis im Januar 2027?
Ist Gemini 3.8 Flash TTS gut genug für Sprachsupport im Kundenservice?


Article by
Rama Adi Nugraha
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.