

Mercury 3 kostet $0.10 pro Million Input-Tokens und $0.35 pro Million Output zum Launch, gecachter Input liegt bei $0.01. Das sind 50% Rabatt auf den echten Listenpreis von $0.20 / $0.70 / $0.02, und Inception hat nicht gesagt, wann der Rabatt endet. Neue Accounts erhalten 100 Millionen Gratis-Tokens.
Zum Launch-Preis ist es bei jeder Aufgabe, die ich berechnet habe, das günstigste Modell seiner Klasse. Zum Listenpreis kostet es bei kurzen Prompts etwa das 1,6- bis 1,8-Fache von GPT-6 Luna und Claude Haiku 5.5, weil der Output mit $0.70 gegenüber deren $0.50 zu Buche schlägt. Zum Listenpreis gewinnt es nur bei langen Prompts: Es schlägt Haiku 5.5 ab 100K Tokens und liegt ab 272K ungefähr gleichauf mit Luna, weil Mercury 3 bis 1M denselben Preis berechnet. Plane mit dem Listenpreis und sieh den Rabatt als Bonus.
Wenn du Mercury 3 für einen Support-Bot einpreist, denk daran, dass die Tokens der kleine Posten sind. Ein Monat mit 10.000 Tickets kostet auf Mercury 3 deutlich unter $100 an Tokens, aber Wochen an Entwicklungsarbeit für alles drumherum. Genau diese Lücke füllt der KI-Helpdesk-Teammate von eesel, zu einem festen Monatspreis pro Ticket, mit fertiger Integration und fertigem Testing.
Warum ich pro Aufgabe gerechnet habe, nicht pro Token
Ich baue beruflich Integrationen und APIs, und das Erste, was ich bei jedem neuen Modell mache, ist, das usage-Objekt zu lesen, das es zurückschickt. Ein Preis pro Million Tokens ist nur das Preisschild. Was du tatsächlich zahlst, hängt davon ab, wie viele Tokens ein Job verbraucht, wie viele davon gecacht sind und wie viele Reasoning-Tokens du nie siehst. Deshalb habe ich Mercury 3 für diesen Beitrag so bepreist, wie ich es vor dem Einbau tun würde: pro Aufgabe, zum Launch- und zum Listenpreis, gegen die Modelle, die es jagt.
Es gibt noch einen zweiten Grund für diese Sichtweise. eesel lässt seit Jahren KI-Modelle auf echten Support-Queues laufen, und die Token-Rechnung war bei diesen Rollouts nie der teure Teil. Teuer ist alles rund um das Modell. Darauf komme ich am Ende mit echten Zahlen eines unserer Kunden zurück.
Wenn du zuerst die Geschichte zu Geschwindigkeit und Benchmarks willst, erklärt meine Mercury 3 Übersicht, was das Modell ist und wie schnell es läuft. In diesem Beitrag geht es nur ums Geld.
Was kostet Mercury 3?
Hier ist Inceptions eigene Preisliste von der Modellseite und den Modell-Docs, geprüft am 20. Oktober 2026.
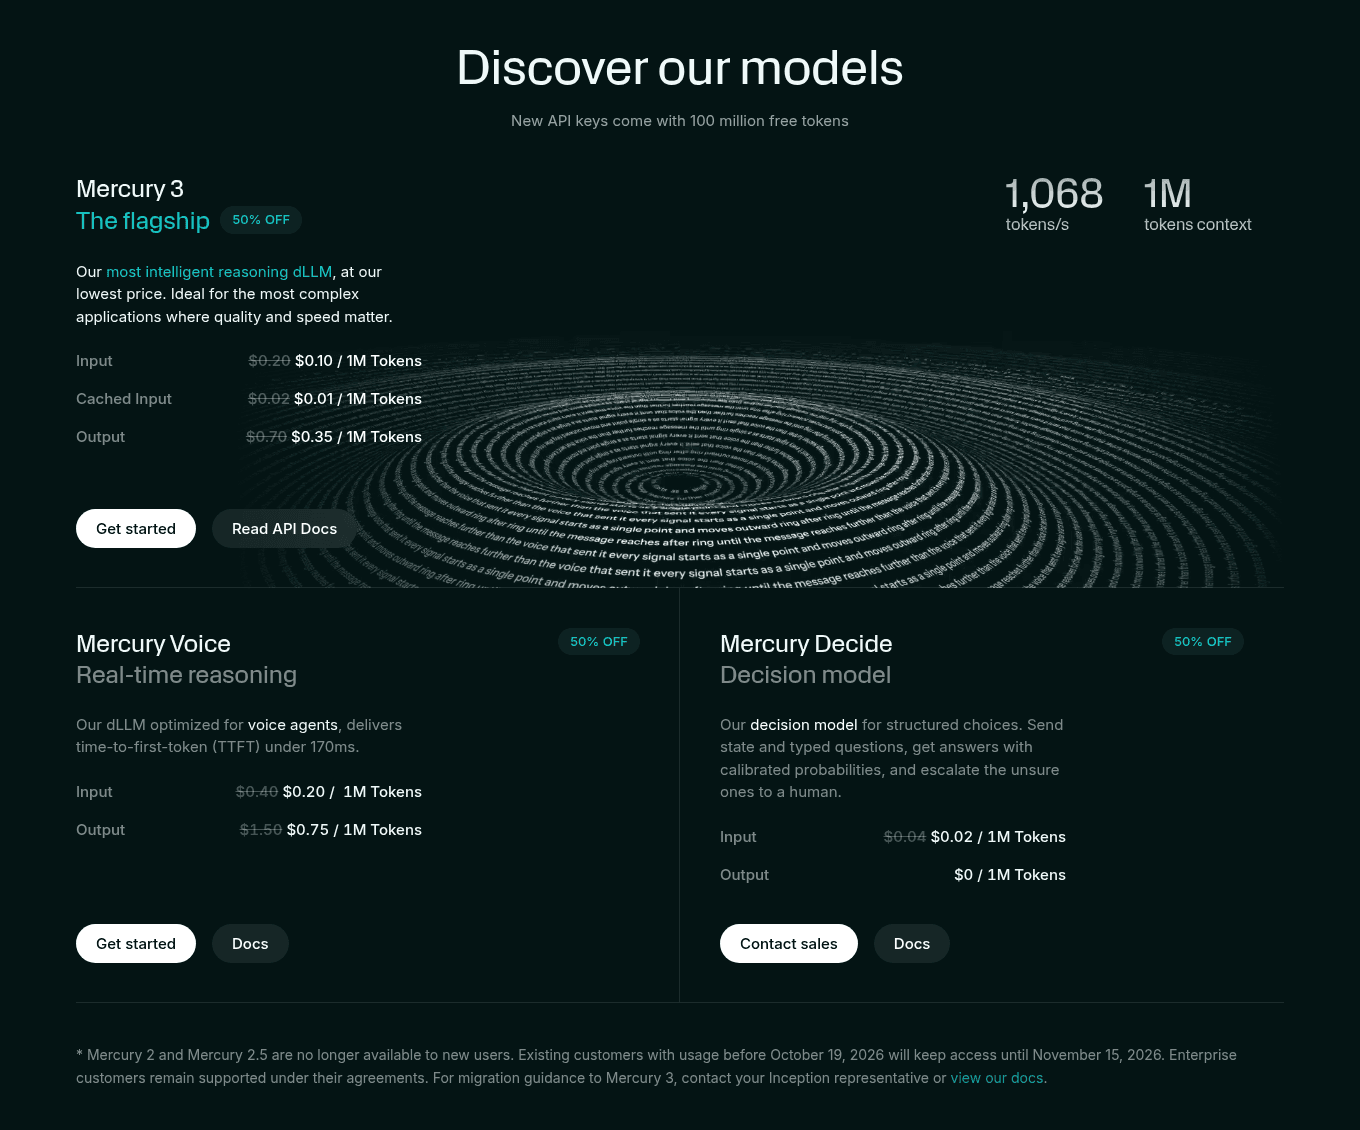
| Modell | Input (Liste → Launch) | Gecachter Input | Output (Liste → Launch) | Kontext | Max. Output |
|---|---|---|---|---|---|
| Mercury 3 | $0.20 → $0.10 | $0.02 → $0.01 | $0.70 → $0.35 | 1M | 131,072 |
| Mercury Voice | $0.40 → $0.20 | $0.04 → $0.02 | $1.50 → $0.75 | 128K | 50,000 |
| Mercury Decide | $0.04 → $0.02 | $0 | $0 (nicht berechnet) | k. A. | k. A. |
| Mercury Edit 2 | $0.25 | $0.025 | $0.75 | 32K | 8,192 |
| Mercury 2.5 (läuft aus) | $0.20 | $0.02 | $0.75 | 260K | 65,536 |
| Mercury 2 (läuft aus) | $0.25 | $0.025 | $0.75 | 128K | 50,000 |
Alle Preise gelten pro Million Tokens. Ein paar Dinge, die die Tabelle nicht von selbst sagt:
- Abgerechnet werden einfache Tokens. Inceptions FAQ sagt, dass Reasoning-Tokens in den Completion-Tokens mitgezählt und zum Output-Preis berechnet werden, und gecachte Tokens eine Teilmenge der Prompt-Tokens sind, die zum Cache-Preis berechnet wird. Es gibt keine Gebühr pro Anfrage.
- Der Reasoning-Aufwand wird pro Anfrage gesetzt. Mercury 3 akzeptiert
instant,low,mediumoderhigh, und laut den Reasoning-Docs ist der Standardlow, wenn du nichts setzt. Inceptions eigene Benchmarks liefen alle mit medium. Wenn du deren Einstellungen übernimmst, erwarte also mehr Output-Tokens als beim Standard. - Mercury Voice gibt es laut Docs nur für Enterprise über die API, und Mercury Decide ist ein eigener Endpoint für Klassifikation, der nur Input berechnet.
Die drei Zugangspläne
Zusätzlich zu den Token-Preisen verkauft Inception den Zugang in drei Plänen. Sie ändern deine Rate Limits und den Support, nicht deinen Token-Preis.
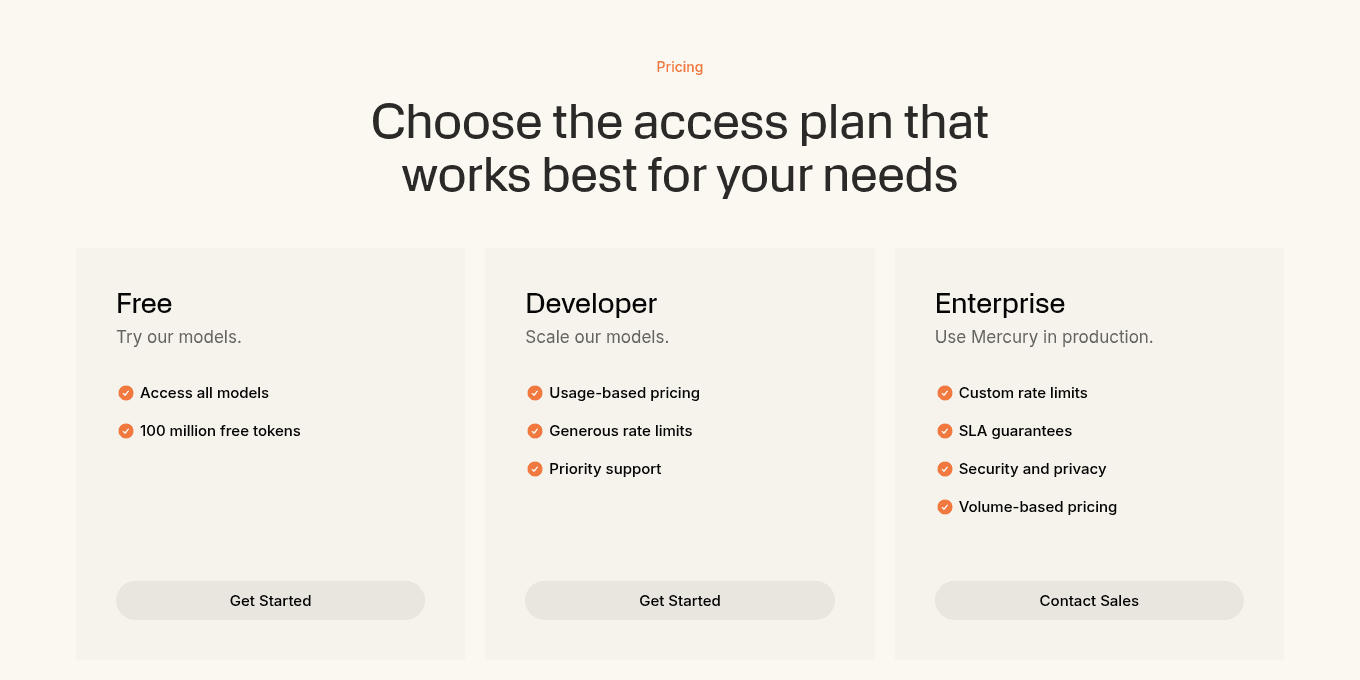
| Plan | Was du zahlst | Anfragen pro Minute | Input-Tokens pro Minute | Output-Tokens pro Minute |
|---|---|---|---|---|
| Free | 100M Gratis-Tokens, einmalig | 1,000 | 1,000,000 | 100,000 |
| Developer (Pay as you go) | Nutzungsbasiert, Preisliste oben | 3,000 | 3,000,000 | 300,000 |
| Enterprise | Mengenbasierte Preise | Individuell | Individuell | Individuell |
Die Limits stammen von Inceptions Rate-Limits-Seite. Das Gratis-Guthaben ist laut FAQ eine einmalige Zuteilung für alle Modelle, kein monatliches Kontingent. Wenn es knapp wird, hinterlegst du unter Billing eine Karte und machst zu den nutzungsbasierten Preisen weiter.
Was der 50%-Launch-Rabatt wirklich bedeutet
Der Rabatt ist die wichtigste Preisinformation zu Mercury 3 und zugleich die am wenigsten präzise. Sowohl die Modellseite als auch die Docs sagen, Mercury 3 sei "50% off at launch". Keine von beiden nennt ein Enddatum, ein Token-Limit oder eine Vorlaufzeit.
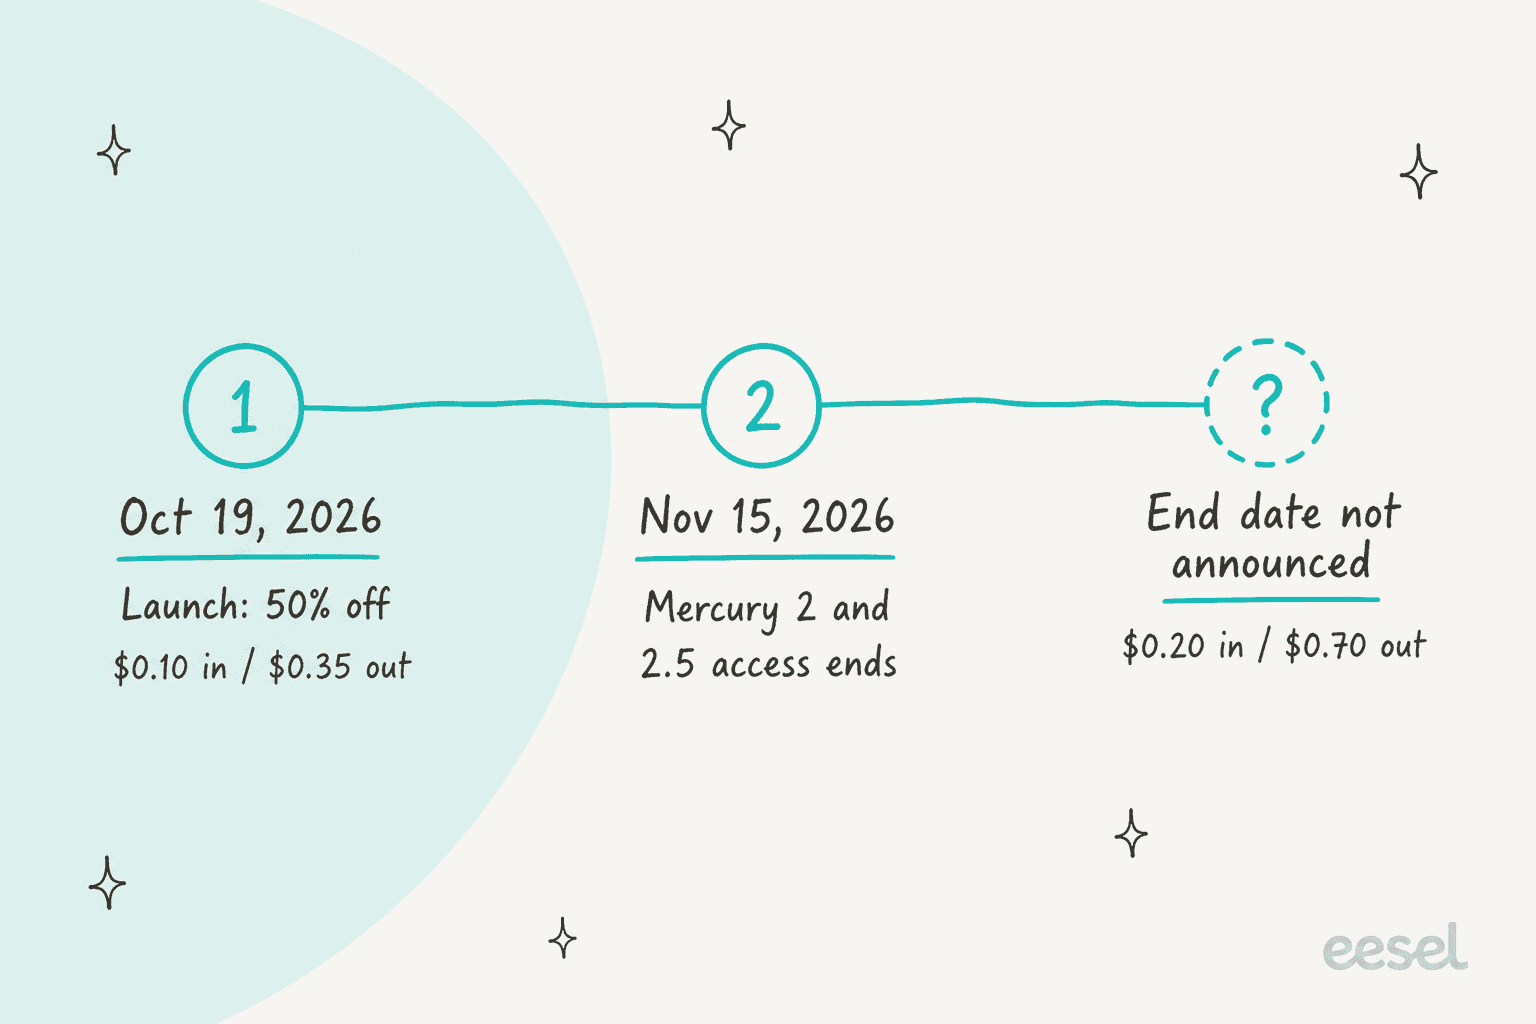
Das ist für diese Klasse ungewöhnlich. Googles Gemini-Preisseite führt für Gemini 3.8 Flash ebenfalls eine Aktion, datiert aber beide Enden: $0.75 Input und $3.75 Output bis zum 31. Dezember 2026, danach $1.50 und $7.50 ab dem 1. Januar 2027. Bei Mercury 3 kennst du den Preis danach, aber nicht das Datum, also hat jedes Budget, das auf $0.35 Output aufbaut, ein Loch. Frühe Nutzer haben das bemerkt:
"I'm going to start using this instead of Haiku/GPT-Luna for tasks that require speed. I'm wondering if it'll still be useful once the discount is lifted?"

Daneben gibt es zwei gute Nachrichten. Erstens sagte Inceptions Mitgründer im selben Thread, das Modell "runs in our API at reasonable costs", was seine Erklärung für die Launch-Preise ist. Ein anderer Kommentator widersprach, Preise könnten "can always be set at a loss", und es gibt dazu keine öffentlichen Daten in die eine oder andere Richtung.
Zweitens: Wenn du bereits Mercury-Kunde bist, ist der Listenpreis immer noch eine kleine Ersparnis. Mercury 2.5 kostet heute $0.20 Input und $0.75 Output, Mercury 3 zum vollen Output-Preis von $0.70 ist also günstiger als das Modell, das es ersetzt, bei fast vierfachem Kontext. Mercury-2-Nutzer sparen auch beim Input. Bestandskunden behalten den Zugang zu Mercury 2 und 2.5 bis zum 15. November 2026, die Migration hat also eine Frist, auch wenn der Rabatt keine hat.
Mercury 3 vs. GPT-6 Luna, Haiku 5.5, DeepSeek und Gemini Flash
Inception positioniert Mercury 3 gegen GPT-6 Luna und Claude Haiku 5.5. Ich habe DeepSeek V4.1 Flash ergänzt, mit dem Hacker-News-Tester es verglichen haben, und Gemini 3.8 Flash als Option von Google. Jeder Preis unten stammt von der Seite des jeweiligen Anbieters.
| Modell | Input | Gecachter Input | Output | Regel für lange Prompts | Quelle |
|---|---|---|---|---|---|
| Mercury 3 (Launch) | $0.10 | $0.01 | $0.35 | Flach bis 1M | Inception |
| Mercury 3 (Liste) | $0.20 | $0.02 | $0.70 | Flach bis 1M | Inception |
| GPT-6 Luna | $0.10 | $0.01 | $0.50 | Über 272K: 2x Input, 1,5x Output | OpenAI |
| Claude Haiku 5.5 | $0.10 | $0.01 | $0.50 | Über 100K: $0.50 / $2.50 | Anthropic |
| DeepSeek V4.1 Flash | $0.15 | $0.003 | $0.60 | Flach bis 1M; Stoßzeiten 2x | DeepSeek |
| Gemini 3.8 Flash | $0.75 | $0.075 | $3.75 | Aktion bis 31. Dez. 2026, danach 2x |
Pro Million Tokens, Standard-Tarif. Bei DeepSeek sind die Zahlen die der Nebenzeiten; in den Stoßzeiten (werktags 01:00 bis 04:00 und 06:00 bis 10:00 UTC) kostet es das Doppelte.
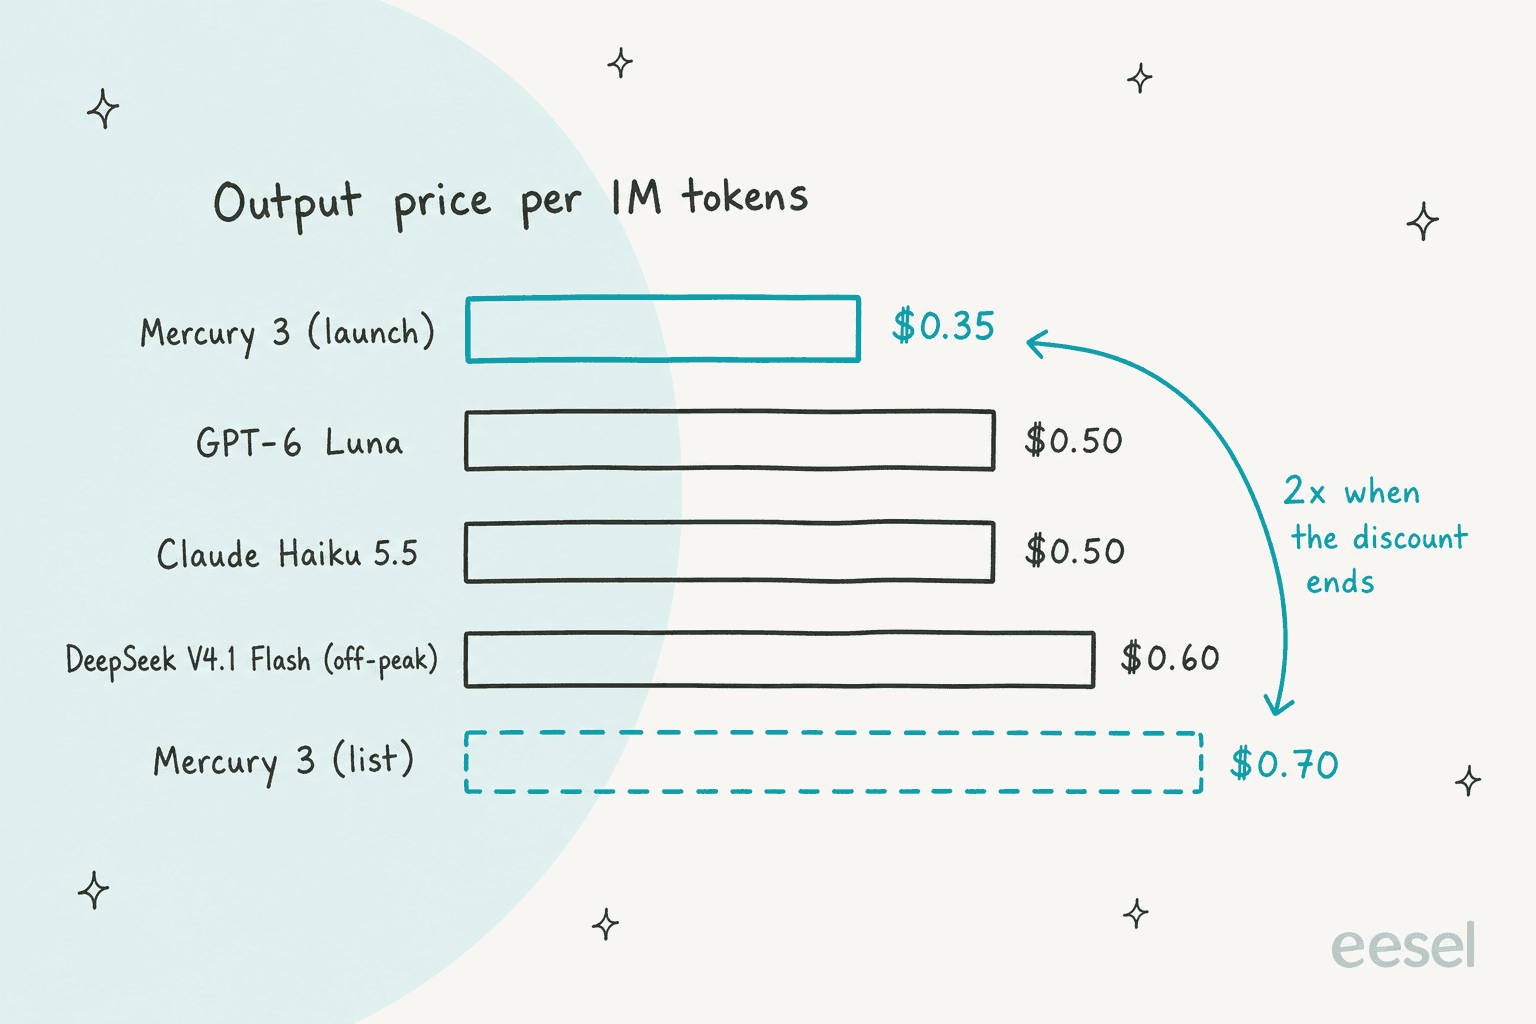
Wenn du die Output-Spalte liest, ist die Geschichte einfach. Zum Launch hat Mercury 3 den günstigsten Output-Token dieser Gruppe. Zum Listenpreis hat es den teuersten Output der vier Budget-Modelle, und Gemini 3.8 Flash liegt ohnehin in einer höheren Preisklasse.
Beim Input gibt es zum Launch mit $0.10 ein Unentschieden mit Luna und Haiku, zum Listenpreis dann das Doppelte. Beim gecachten Input spielt DeepSeek mit $0.003 in einer eigenen Liga, mehr als dreimal günstiger als der Cache-Preis aller anderen.
Die Spalte, die die meisten Vergleiche überspringen, ist die Regel für lange Prompts. Haiku 5.5 berechnet eine ganze Anfrage mit $0.50 Input und $2.50 Output, sobald der Prompt 100.000 Tokens überschreitet, Cache-Lesezugriffe eingeschlossen. Luna wechselt ab 272K auf 2x Input und 1,5x Output. Mercury 3 berechnet über das gesamte 1M-Fenster denselben Preis, was ein früher Tester sofort bemerkte:
"If these benchmarks hold up it is a no-brainer against Haiku 5.5 and GPT-6 Luna, especially considering that Haiku 5.5 becomes 5x more expensive past 100k context, and this model goes up to 1M for the same price. (Note: the price increases 2x after a period post launch but is still way lower than Haiku is priced for >100k requests)"
Meine Aufschlüsselungen zu den GPT-6 Luna Preisen und den Haiku 5.5 Preisen behandeln diese Schwellen im Detail, und der Beitrag zu den V4.1 Flash Preisen erklärt DeepSeeks Regeln für Stoßzeiten.
Mercury 3 Kostenrechner
Preise pro Million Tokens lassen sich schwer greifen. Wähle unten einen Job oder gib eigene Token-Zahlen ein, und der Rechner bepreist einen Monat bei jedem Modell zum Standardpreis des Anbieters. Schalte DeepSeek zwischen Nebenzeiten und Stoßzeiten um, um zu sehen, wie viel die Uhrzeit dort ausmacht.
Wähle einen Job oder gib eigene Token-Zahlen ein, um einen Monat Mercury 3 zum Launch- und Listenpreis mit GPT-6 Luna, Claude Haiku 5.5, DeepSeek V4.1 Flash und Gemini 3.8 Flash zu vergleichen.
Was eine echte Aufgabe auf Mercury 3 kostet
Hier sind die vier Voreinstellungen des Rechners als Tabelle, damit du das Muster ohne Klicken siehst. Jede geht von Standardpreisen, DeepSeek in Nebenzeiten und ohne Gratis-Guthaben aus.
| Job (pro Monat) | Form einer Aufgabe | Mercury 3 Launch | Mercury 3 Liste | GPT-6 Luna | Haiku 5.5 | DeepSeek V4.1 Flash | Gemini 3.8 Flash |
|---|---|---|---|---|---|---|---|
| 20,000 Support-Antworten | 1 Aufruf, 6,000 Input (70% gecacht), 400 Output | $7.24 | $14.48 | $8.44 | $8.44 | $10.45 | $63.30 |
| 10,000 Agent-Aufgaben | 12 Aufrufe, 8,000 Input (85% gecacht), 600 Output | $47.76 | $95.52 | $58.56 | $58.56 | $67.25 | $439.20 |
| 1,000 lange Dokumente | 1 Aufruf, 200,000 Input, 2,000 Output | $20.70 | $41.40 | $21.00 | $105.00 | $31.20 | $157.50 |
| 500,000 Klassifikationen | 1 Aufruf, 1,500 Input, 150 Output | $101.25 | $202.50 | $112.50 | $112.50 | $157.50 | $843.75 |
Drei Dinge fallen auf.
Erstens ist jede Zahl klein. Zehntausend Agent-Aufgaben mit 12 Schritten kosten auf Mercury 3 selbst zum Listenpreis weniger als $100 im Monat. Für die meisten Teams, die das lesen, ist die Modellrechnung nicht die Entscheidung. Geschwindigkeit, Qualität und die Arbeit rund um das Modell sind es.
Zweitens verändert der Listenpreis die Rangfolge. Zum Launch gewinnt Mercury 3 jede Zeile. Zum Listenpreis verliert es gegen Luna und Haiku 5.5 bei Support-Antworten, Agent-Aufgaben und Klassifikation, und zwar um etwa das 1,6- bis 1,8-Fache. Bei langen Dokumenten schlägt es Haiku 5.5, dessen Tarif über 100K greift ($41.40 gegenüber $105), kostet aber immer noch etwa das Doppelte von Lunas $21. Geht der Prompt über 272K, schließt Lunas Long-Context-Tarif diese Lücke zum Gleichstand.
Drittens macht Output den Großteil der Rechnung aus, sobald Caching greift. In der Zeile der Agent-Aufgaben zum Listenpreis verteilt sich das Geld so:
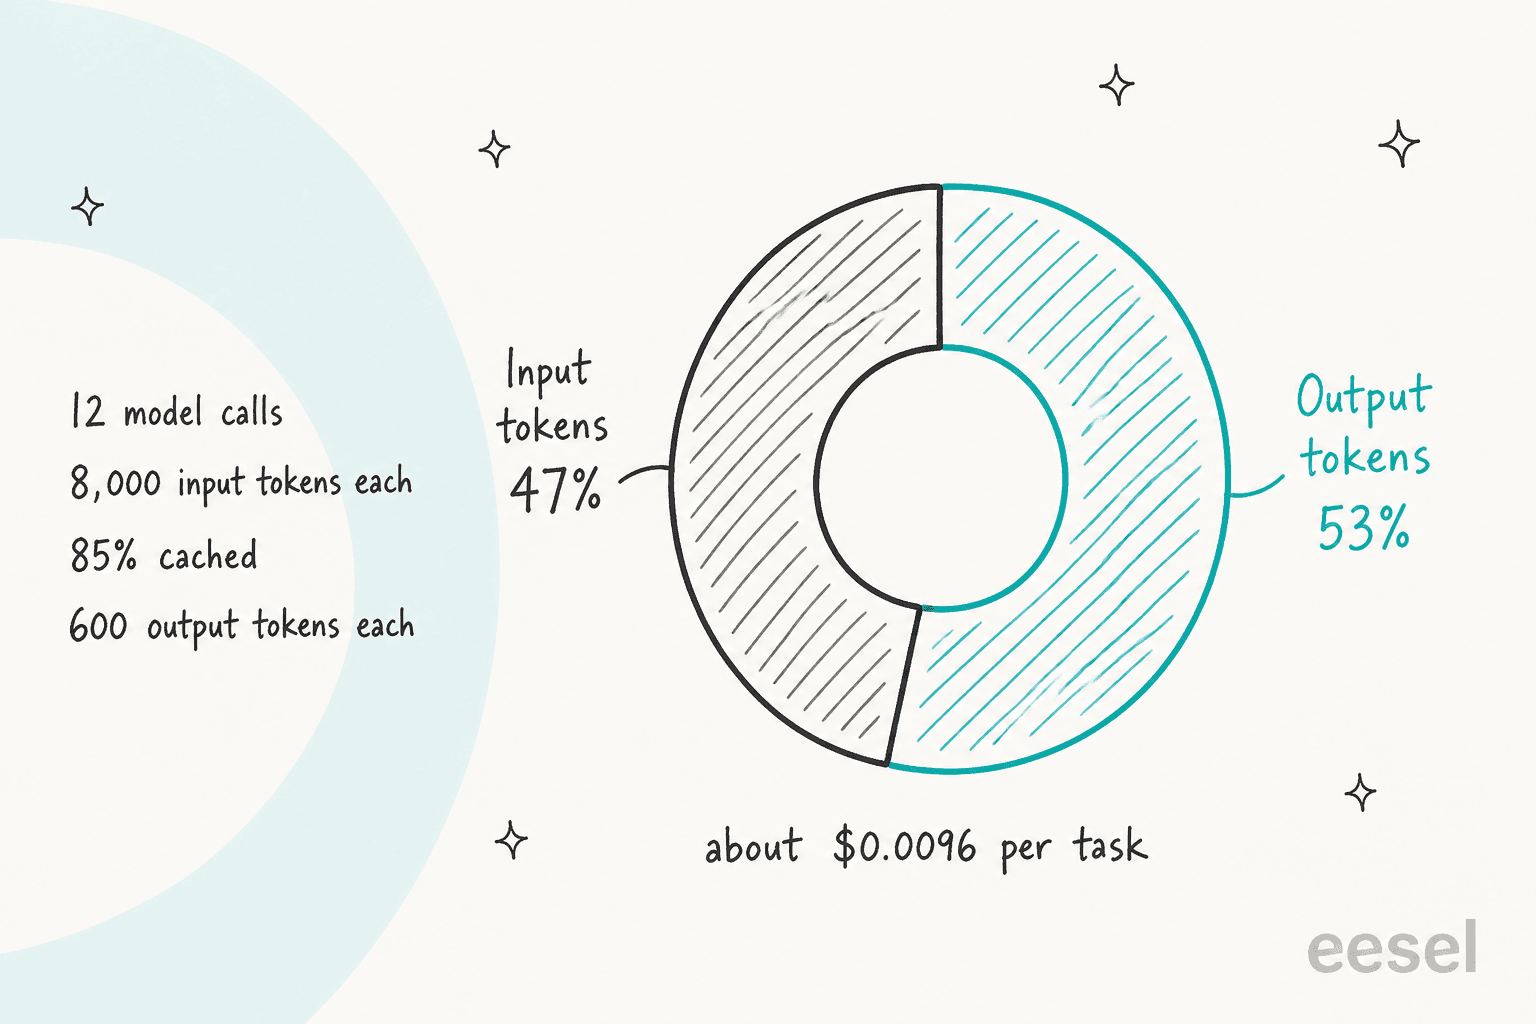
Da 85% des Inputs zu einem Zehntel des Preises gecacht sind, wiegen die 600 Output-Tokens pro Aufruf schwerer als 8.000 Input-Tokens. Da Reasoning-Tokens als Output abgerechnet werden, ist der gewählte Reasoning-Aufwand der wichtigste Kostenregler. Der Wechsel vom Standard low zu medium oder high fügt jedem Aufruf Denk-Tokens hinzu. Teste, ob instant oder low die Qualität bei deinem Job hält, bevor du für mehr zahlst.
Eine weitere Zeile aus dieser Tabelle verdient eine eigene Anmerkung. Wenn dein Job Klassifikation ist, ist Mercury 3 das falsche Inception-Modell zum Bepreisen. Mercury Decide berechnet nur Input, mit $0.02 pro Million zum Launch und $0.04 zum Listenpreis, und nimmt nichts für Output. Dieselben 500.000 Klassifikationen würden zum Launch etwa $15 kosten, gegenüber $101.25 auf Mercury 3. Mein Guide zur KI-Ticket-Klassifikation zeigt, wann ein Klassifikator für diese Aufgabe besser ist als ein Chat-Modell.
Die Abrechnungsdetails, die deine Rechnung bewegen
Jenseits der Preisliste verändern fünf Details, was du tatsächlich zahlst. Keines ist versteckt, aber sie verteilen sich auf vier verschiedene Seiten.
Caching läuft automatisch, ohne Schreibgebühr
Inception cacht wiederholte Prompt-Präfixe von selbst, ohne Request-Parameter. Gecachte Tokens werden mit einem Zehntel des Input-Preises berechnet, und die Preisliste hat keinen Aufschlag für Cache-Schreibvorgänge. Das ist einfacher als bei OpenAI und Anthropic, die beide einen separaten Cache-Schreibpreis führen ($0.125 pro Million für Luna und für Haiku 5.5s 5-Minuten-Schreibvorgänge). Der Preis dafür ist fehlende Kontrolle: Laut FAQ dokumentiert Inception nicht, wie lange ein Präfix gecacht bleibt, und du kannst Einträge weder fixieren noch einsehen.
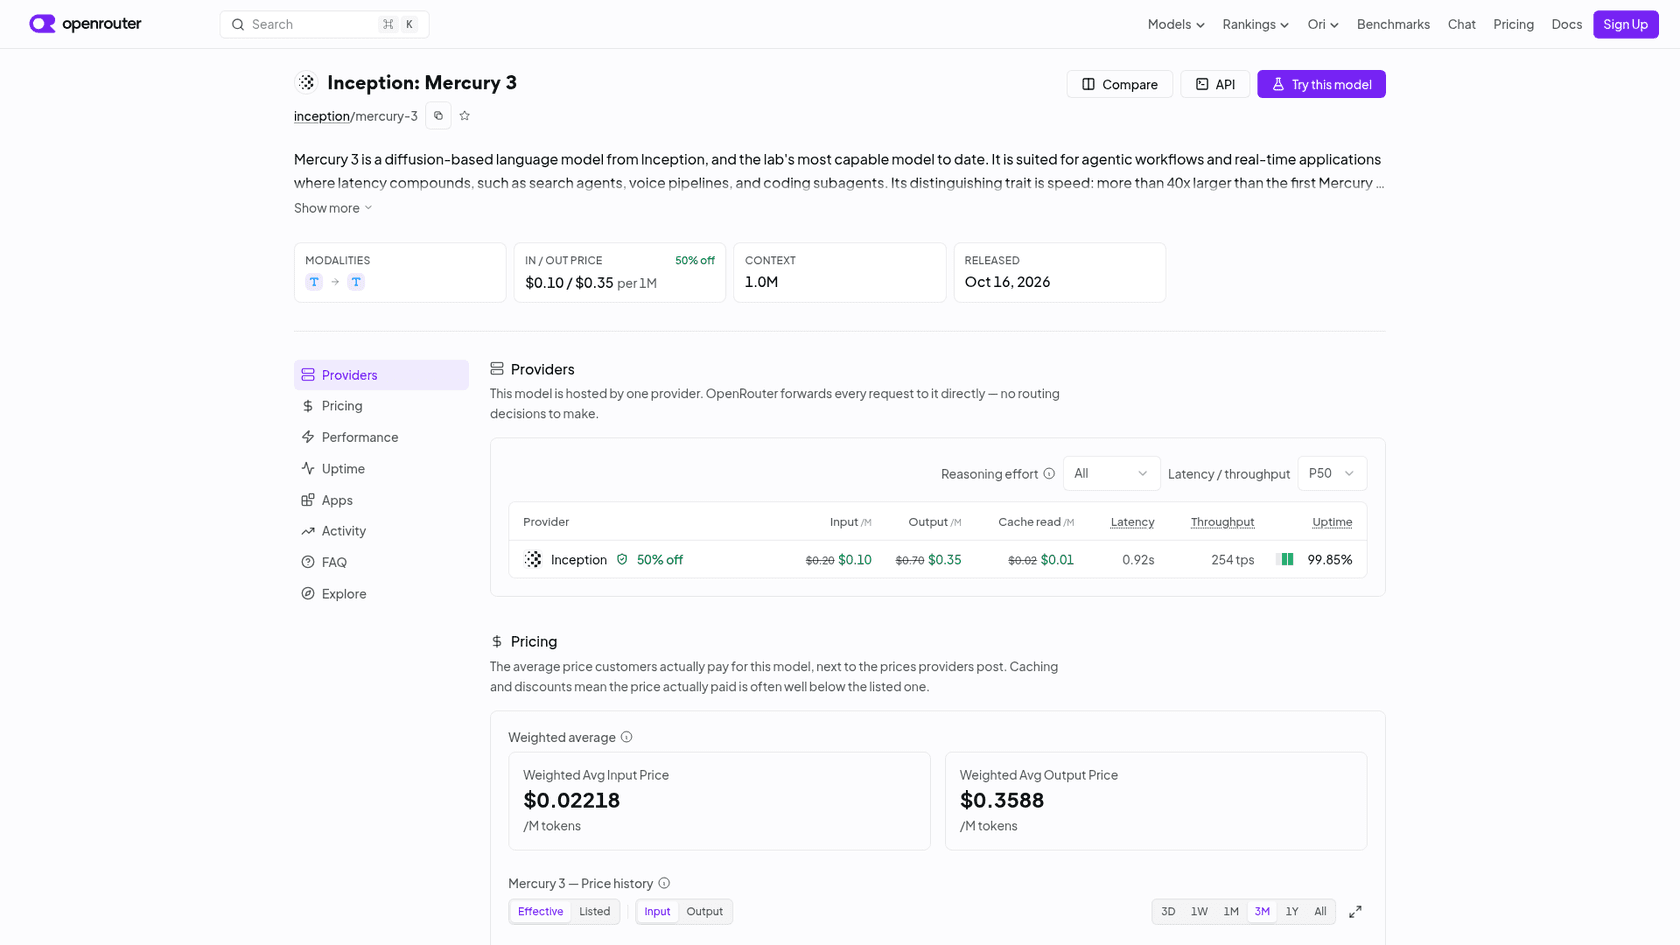
Die Wirkung in der Praxis ist groß. OpenRouter veröffentlicht, was Mercury-3-Nutzer tatsächlich zahlen, und am 20. Oktober 2026 lag der gewichtete durchschnittliche Input-Preis bei $0.0222 pro Million, gegenüber gelisteten $0.10, bei einer Cache-Trefferquote von 86,6% über den gesamten Traffic. Wenn deine App einen langen System-Prompt wiederverwendet, plane deinen Input näher am Cache-Preis als am Listenpreis.
OpenRouter kostet dasselbe
OpenRouters Mercury 3 Seite listet einen Anbieter, Inception, mit denselben Launch-Preisen von $0.10 / $0.35 / $0.01. Der Weg über OpenRouter spart oder kostet dich beim Token-Preis also nichts. Inception nennt außerdem Baseten und Vercel als Launch-Partner, aber keiner von beiden veröffentlicht einen Mercury 3 Preis; bei Baseten musst du dich melden. Wenn du bereits offene Modelle über Together AI oder Fireworks einkaufst, bedenke, dass Mercury 3 keine öffentlichen Gewichte hat und daher nur von Inception und den genannten Partnern verkauft wird.
Die Gratis-Tokens reichen weiter, als sie klingen
100 Millionen Tokens sind bei dieser Größenordnung viel. Bei der Form der Support-Antwort oben, etwa 6.400 Tokens pro Antwort, sind das grob 15.600 Antworten, wenn jeder Token auf das Guthaben angerechnet wird. Bei der Form der Agent-Aufgabe mit 12 Aufrufen, etwa 103.000 Tokens pro Aufgabe, sind es unter 1.000 Aufgaben. Das reicht für eine echte Evaluation mit deinem eigenen Traffic, und genau so würde ich es einsetzen.
Rate Limits können vor dem Preis zuschlagen
Der Free-Plan erlaubt 100.000 Output-Tokens pro Minute. Ein einzelner Request, der mit Inceptions angegebenen 1.068 Tokens pro Sekunde streamt, erzeugt etwa 64.000 Tokens pro Minute, also können zwei Streams mit voller Geschwindigkeit das Output-Limit des Free-Plans erreichen. Pay as you go verdreifacht das auf 300.000. In der Praxis maß OpenRouter einen Wochendurchschnitt von 203 Tokens pro Sekunde, du hast also mehr Spielraum, aber wenn du eine parallele Agent-Flotte planst, schau in die Limit-Tabelle, bevor du in die Preistabelle schaust.
Es gibt keinen Batch-Rabatt
OpenAI und Anthropic bieten beide halbpreisige Batch-Verarbeitung für Luna und Haiku 5.5, und Google hat Batch- und Flex-Tarife. Inceptions Preisliste hat keinen Batch-Tarif. Für nächtliche Jobs, bei denen die Latenz egal ist, unterbietet Luna im Batch mit $0.05 Input und $0.25 Output sogar den Launch-Preis von Mercury 3, also sind Batch-taugliche Workloads der eine Fall, in dem ich Mercury 3 allein aus Kostengründen auslassen würde. Mein Guide zu den OpenAI API Preisen erklärt, wie der Batch-Tarif funktioniert.
Ist die Geschwindigkeit den Listenpreis wert?
Das ist die eigentliche Frage hinter dem Rabatt. Wäre Mercury 3 nur günstig, würde das Ende der Aktion auch das Argument dafür beenden. Das Argument, das den Listenpreis überlebt, ist die Geschwindigkeit.
Inception nennt 1.068 Tokens pro Sekunde; OpenRouters gemessener Wochendurchschnitt lag bei 203, gegenüber rund 130, die Inception für Luna angibt. Der Unterschied zählt am meisten in Agent-Schleifen, in denen Aufrufe direkt hintereinander laufen und sich jede Sekunde Generierung aufsummiert. Meine Mercury 3 Übersicht enthält einen Rechner für diese Wartezeit. Für die Preisfrage ist die nützliche Sichtweise diese: Zum Listenpreis zahlst du grob das 1,6- bis 1,8-Fache von Lunas Token-Rechnung, um die Generierungszeit bei langen Ketten zu verkürzen. Für Claude Code Subagents, Browser-Agents und Voice-Pipelines lohnt sich das oft. Für einen Hintergrundjob, auf den niemand wartet, nicht.
Wenn Geschwindigkeit dein Grund ist, lohnt sich auch der Blick auf den Hardware-Weg. Groq verkauft schnelle Inferenz auf offenen Modellen, behandelt in meinem Beitrag zu Groq 3 LPX. Und wenn du verstehen willst, warum Diffusionsmodelle überhaupt schnell sind, geht mein Erklärer zu diffusionsbasierten KI-Modellen darauf ein.
Wann Mercury 3 die günstige Wahl ist und wann nicht
So würde ich entscheiden, mit dem Listenpreis im Kopf.
- Lange Prompts, ab 100K Tokens. Mercury 3 schlägt zum Listenpreis hier Haiku 5.5 klar. Gegenüber Luna kostet es zwischen 100K und 272K etwa das Doppelte, ab 272K liegt es ungefähr gleichauf. Wenn deine Aufrufe mehrere hunderttausend Tokens an Dokumenten oder Verlauf tragen, ist es bei beiden Preisen eine starke Wahl.
- Agent-Schleifen, bei denen Geschwindigkeit zählt. Zahle den Aufpreis zum Listenpreis. Lass vorher den Rechner mit deinen echten Token-Zahlen noch einmal laufen.
- Hochvolumige, kurze, latenztolerante Aufrufe. Zum Listenpreis sind Luna und Haiku 5.5 günstiger, und DeepSeek V4.1 Flash in Nebenzeiten liegt nah dran. Genieße den Launch-Preis, solange er gilt, aber baue dein Budget auf den Alternativen auf.
- Batch- oder Nachtjobs. Nutze einen Anbieter mit Batch-Tarif. Luna im Batch kostet die Hälfte von Lunas Standardpreis.
- Klassifikation und Routing. Bepreise Mercury Decide, nicht Mercury 3, oder ein kleines Modell. Meine Übersicht zu kleinen Sprachmodellen zeigt Optionen, die du selbst hosten kannst.
- Alles, was Vision oder offene Gewichte braucht. Mercury 3 ist nur Text mit geschlossenen Gewichten. DeepSeek V4.1 Flash unterstützt Vision, und Gemini 3.8 Flash nimmt ebenfalls Bilder. Wenn du ein offenes Diffusionsmodell willst, schau dir DiffusionGemma an.
Wenn du weitere Modelle der Budget-Klasse vergleichst, nutzen meine Aufschlüsselungen zu den Gemini 3.8 Flash Preisen, den Gemini 3.5 Flash-Lite Preisen und den Kimi K3 Preisen dieselbe Methode pro Aufgabe.
Die Token-Rechnung vs. die Gesamtkosten eines KI-Agenten
Der Großteil der Kosten, ein Modell auf einen echten Job zu setzen, liegt außerhalb der Preisliste, und im Support sehe ich das am deutlichsten. Ein Monat mit 10.000 Tickets kostet selbst zum Listenpreis unter $100 an Mercury 3 Tokens. Damit diese Tokens aber Tickets beantworten, baust du die Helpdesk-Anbindung, das Retrieval über dein Help Center und vergangene Tickets, Regeln für die Übergabe, eine Möglichkeit, gegen echte Konversationen zu testen, und das Monitoring, um schlechte Antworten zu erwischen. Das sind Wochen an Entwicklung, plus Pflege, sobald sich dein Helpdesk oder deine Richtlinien ändern.
Dieser Zielkonflikt ist uns aus unseren eigenen Sales-Gesprächen vertraut. Ein Engineering Lead bei einem Krypto-Hardware-Unternehmen mit einer Confluence-Wissensdatenbank mit über 300 Artikeln brachte es auf den Punkt, als er sich für Kaufen statt Selbstbauen entschied:
"We could try to write our own LLM application but we didn't want to invest our time into that. We wanted something that we would not have to maintain."
Schau dir an, was einer unserer Kunden betreibt, um die Größenordnung zu sehen. smava, eine Berliner Kreditvergleichsplattform, bearbeitet etwa 27.000 Zendesk-Tickets im Monat über zwei Marken mit drei eesel-Agents: einer kategorisiert jedes Ticket, einer entwirft die Antwort aus etwa 820 Makros und Help-Center-Artikeln, und pro Marke einer, der kundenfertige Antworten für Tickets ohne zugewiesenen Berater vorbereitet. Mitarbeitende genehmigen jeden Entwurf, und ein Ticket mit Anhängen geht mit einer Notiz an einen Menschen. Jede dieser Regeln ist Arbeit, die eine Token-Rechnung nicht enthält.
SE Ranking ist eine andere Form desselben Punkts: etwa 4.650 Konversationen im Monat über drei Produkte, mit einem eesel-Agent pro Produkt, die aus rund 16.800 Seiten Wissen antworten. Keines der Teams musste an Tokens, Caching oder Reasoning-Aufwand denken. Meine Guides zu KI- vs. menschlichen Agent-Kosten und Chatbot-Kosten rechnen beide Wege komplett durch.
eesel ausprobieren
Mercury 3 ist Infrastruktur, und zum Launch ist es sehr preiswerte Infrastruktur. eesel ist der Mitarbeiter. Wenn du ein Modell bepreist, weil du willst, dass KI Support-Tickets beantwortet, steigt der KI-Helpdesk-Teammate in die Queue ein, die du bereits betreibst, auf Zendesk und den anderen großen Helpdesks, lernt aus deinen vergangenen Tickets und Dokumenten und spielt sich gegen deine historischen Konversationen ab, bevor er einem einzigen Kunden antwortet.

Die Preisgestaltung funktioniert so, wie ein Support-Lead denkt: Pläne starten bei $299 im Monat für 500 Credits, ein Ticket oder ein Chat ist ein Credit, egal wie lange er dauert, und die kostenlose Testphase gibt dir 100 Credits ohne Karte. Vergleiche das auf der Preisseite mit einem Token-basierten Eigenbau.
Wenn du es lieber so bedienen willst, wie du eine Modell-API bedienen würdest: Die eesel CLI steuert denselben Teammate aus einem Terminal, und jeder Befehl gibt JSON zurück, das ein Skript oder ein Coding-Agent wie Claude Code lesen kann. Mein Guide zur KI-Agent-CLI zeigt, wie das aussieht. Probiere eesel an den Tickets des letzten Monats aus und sieh selbst die Kosten pro beantwortetem Ticket. Und wenn du hier bist, weil du Inhalte schreibst, nicht Tickets, hat das Team auch einen KI-Blog-Writer.