

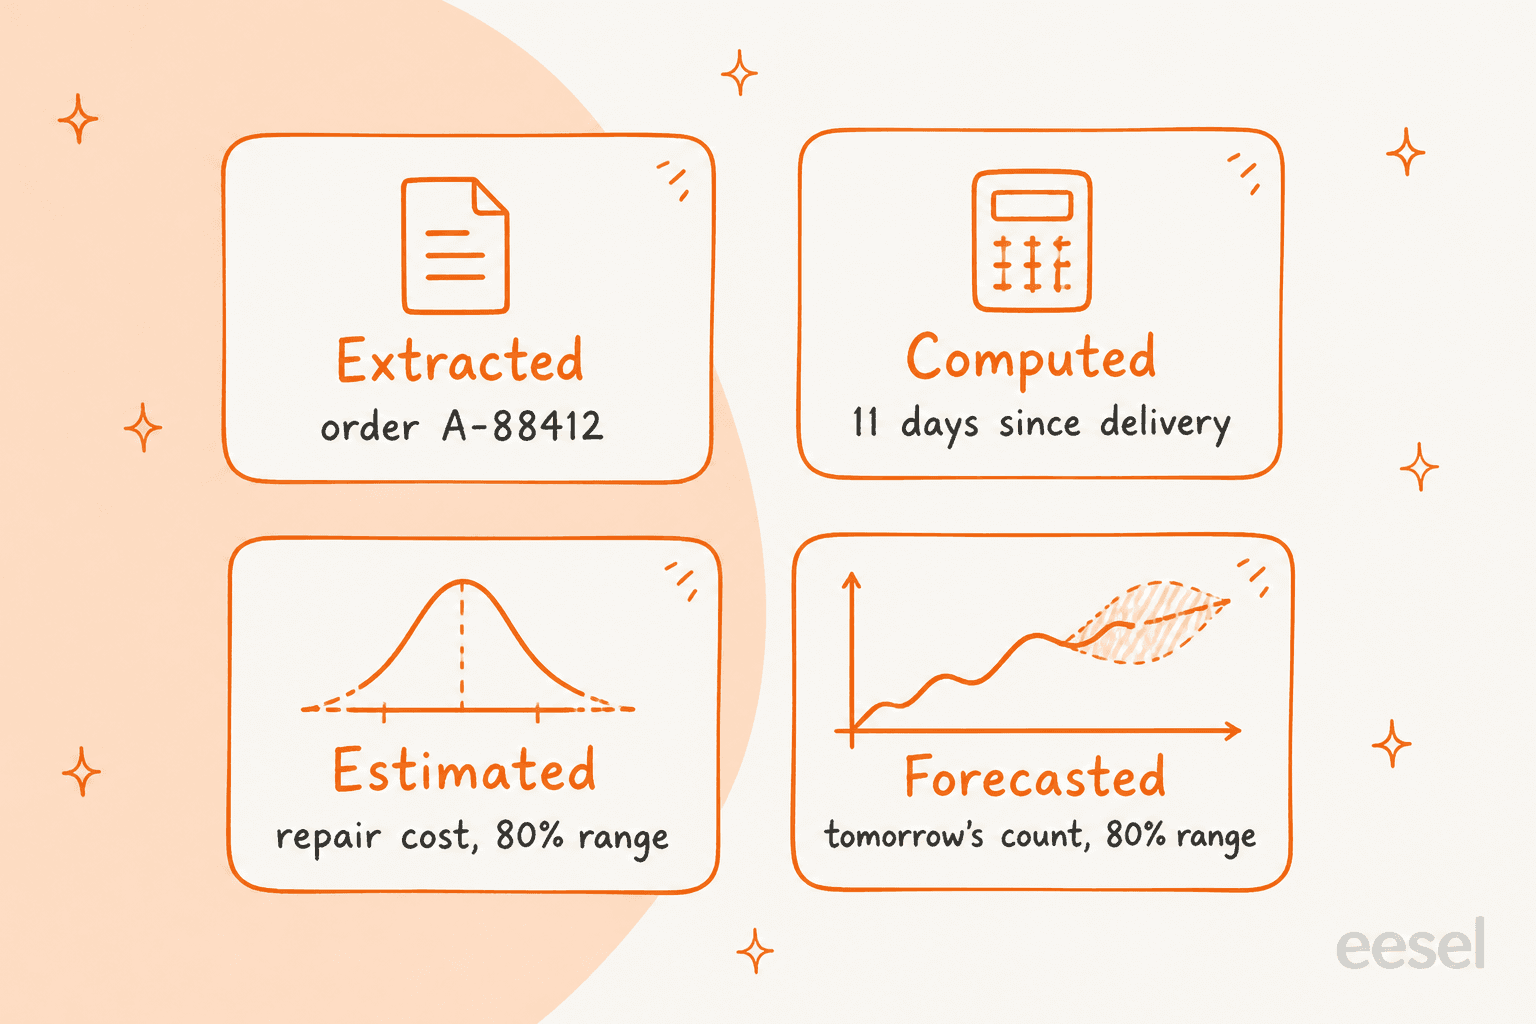
Cloudflare Clairic ist ein neues Extraktionsmodell, das Cloudflare am 19. Oktober 2026 als Vorschau auf Workers AI veröffentlicht hat. Sie geben unordentliche Eingaben hinein (eine E-Mail, ein Belegfoto, eine CSV) plus eine Liste typisierter Felder, und es liefert pro Feld einen typisierten Wert mit Konfidenzwert, in einem Durchlauf und ohne Text zu generieren. Es kann einen Wert herauskopieren (eine Bestellnummer), ausrechnen (Tage seit der Lieferung), mit einem 80-%-Bereich schätzen (Reparaturkosten) oder die nächsten Schritte einer Reihe prognostizieren.
Es kostet 0,10 $ pro Million Eingabetoken, ohne Ausgabegebühr, und offene Gewichte sind „bald“ versprochen. In Cloudflares Demo mit der beschädigten Bestellung erledigte Clairic die Extraktion in 0,46 Sekunden, wo GLM-5.3 16,1 brauchte, und die komplette Pipeline aus Clairic, Clef und LLM kostete 49 % weniger als ein LLM für jeden Schritt.
Für Support-Teams ist Clairic ein sehr guter Parser und nicht mehr. Es macht aus „Bestellung A-88412 kam zerbrochen an“ Felder, denen Ihr Code vertrauen kann. Es sucht die Bestellung nicht heraus, antwortet nicht und erstattet nichts. Wenn Sie das Lesen und die Arbeit danach wollen, erledigt eesels KI-Helpdesk-Teammitglied beides direkt in Ihrem Helpdesk. So kommt Rúngne dazu, dass jedes Gorgias-Ticket bestätigt, getaggt und als Entwurf vorbereitet ist, bevor ein Mensch es öffnet.
Was ist Cloudflare Clairic?
Ich bearbeite jeden Tag die Support-Warteschlange von eesel, und der langsame Teil der meisten Tickets ist nicht das Schreiben der Antwort. Es ist das Abtippen. Die Bestellnummer aus Absatz zwei, das Lieferdatum aus der Tracking-Mail, die Summe von einem unscharfen Belegfoto. Cloudflare Clairic ist ein Modell, das genau für dieses Abtippen gebaut wurde, und es ist das Praktischste, was bisher aus der „System One“-Welle kam.
Clairic erschien am 19. Oktober 2026 im Cloudflare-Blog, geschrieben von Alex Reneau, Michelle Chen und Kevin Flansburg vom Workers-AI-Team. Es läuft auf Workers AI als @cf/cloudflare/clairic, ist als Vorschau markiert, und Cloudflare sagt, die Gewichte sollen später veröffentlicht werden.
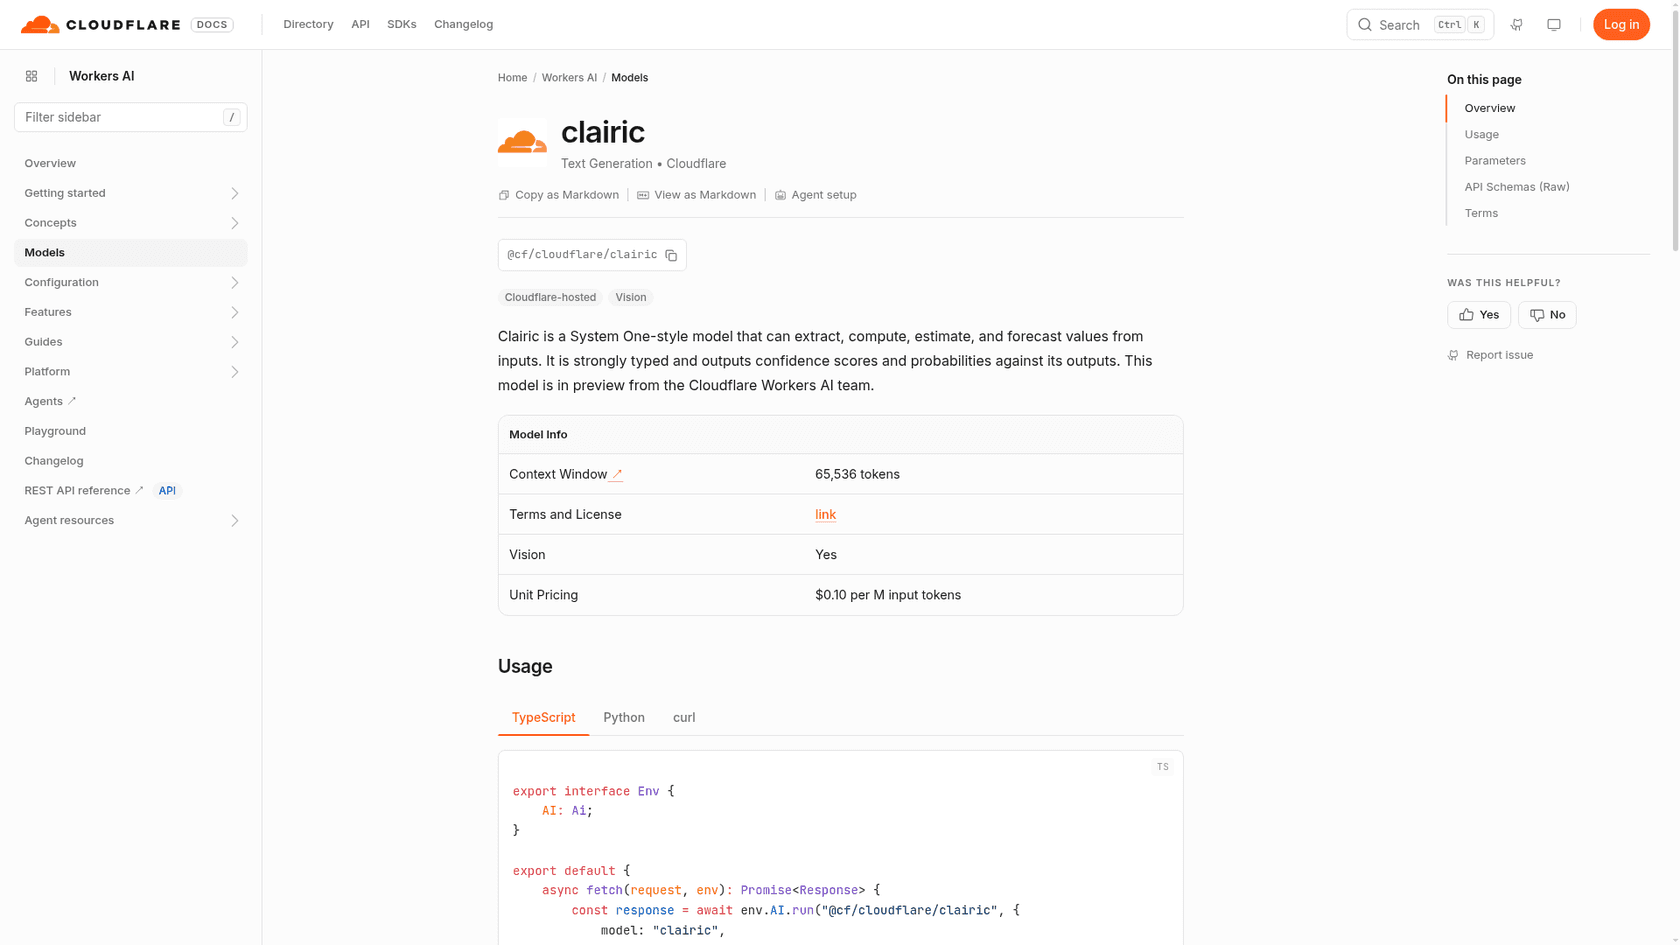
Die Modellkarte ist kurz. Ein Kontextfenster von 65.536 Token, Vision-Unterstützung (bis zu vier Bilder pro Anfrage) und eine einzige Preiszeile. Der Name ist laut Cloudflare eine Mischung aus „clerical“ (Büroarbeit), „clairvoyance“ (Hellsehen) und Cloudflare AI Regression model, was gut zusammenfasst, was es tut: langweilige Dateneingabe plus ein bisschen Vorhersage. Es krönt ein arbeitsreiches paar Wochen für Cloudflares KI-Team, nach dem Agenten-Browser Kitesurf und einer Websuch-API.
Warum hat Cloudflare ein Extraktionsmodell gebaut?
Einen Monat vor Clairic stellte TypeSafe Jev vor und mit ihm die Idee der System-One-Modelle, entlehnt aus Daniel Kahnemans schnellem und langsamem Denken. Cloudflare zog am 1. Oktober mit Clef nach, seinem eigenen Entscheidungsmodell. Beide beantworten Fragen, bei denen Sie die möglichen Antworten vorab auflisten können: Ist das dringend, welches Team ist zuständig, Erstattung oder Reparatur.
Cloudflares Punkt: Bei vielen strukturierten Ausgaben, die an Frontier-LLMs gehen, lassen sich die Antworten nicht vorab auflisten. Wie hoch ist die Rechnungssumme? Wann wurde geliefert? Wie viele Tage Verspätung sind das? Ein Entscheidungsmodell hilft hier nicht, weil es keine feste Optionsmenge gibt, auf die man Wahrscheinlichkeiten verteilen könnte. Clairic ist das erste Modell der zweiten Klasse, die Cloudflare System-One-Extraktionsmodelle nennt.
So ordnet Cloudflare die drei Klassen ein, verdichtet aus dem Launch-Beitrag:
| System One: extrahieren | System One: entscheiden | System Two | |
|---|---|---|---|
| Beispielmodelle | Clairic | Jev, Clef | GPT, Claude, Gemini, DeepSeek |
| Wie es läuft | Ein paralleler Durchlauf | Ein paralleler Durchlauf | Ein Token nach dem anderen |
| Ausgabe | Typisierte Werte: Textstellen, Zahlen, Daten, Listen, Verteilungen | Eine Ihrer aufgelisteten Optionen, mit Wahrscheinlichkeiten | Freitext |
| Was es beantwortet | Wie hoch ist der Betrag? Wann ist es passiert? Wie viel wird es sein? | Welche Kategorie? Welche Aktion? | Warum ist es passiert? Wie beheben wir es? |
| Immer eine gültige Antwort? | Ja, ein Wert seines Typs oder null | Ja, eine Ihrer Optionen | Nein, Text muss geparst und geprüft werden |
Der Satz aus Cloudflares Beitrag, auf den ich immer wieder zurückkomme: Extraktionsmodelle machen aus Rohdaten typisierte Werte, Entscheidungsmodelle machen aus Werten Entscheidungen, und LLMs machen aus Entscheidungen Worte. Das ist eine saubere Art, einen Support-Workflow aufzuteilen, und es entspricht eher der Arbeit eines guten Agenten an einem Ticket als „alles an ein großes Modell schicken und hoffen“.
Wie funktioniert Cloudflare Clairic?
Eine Anfrage hat zwei Teile. Der state ist der Text, der gelesen werden soll (plus bis zu vier PNG-, JPEG- oder WebP-Bilder, inline gesendet). Die fields-Map ist Ihr Schema: Jedes Feld bekommt einen Namen, einen Typ und optionale instructions in Alltagssprache. Clairic liest alles in einem Vorwärtsdurchlauf und beantwortet alle Felder auf einmal, sodass dreißig Felder ungefähr so viel kosten wie drei.
Es gibt keine Obergrenze für Felder. Laut Modelldokumentation werden Felder, die nicht neben dem State in einen 8.192-Token-Durchlauf passen, auf parallele Durchläufe verteilt, die jeweils die ganze Eingabe sehen, und dann zusammengeführt.
| Feldtyp | Was Sie zurückbekommen |
|---|---|
text | Eine exakte Textstelle der Eingabe, mit ihren Zeichenpositionen |
number | Eine gelesene oder berechnete Zahl, unter Beachtung von integer und decimals |
date, time, datetime | Echte Kalenderdaten und gültige Uhrzeiten, im ISO-Format |
duration | Eine Zeitspanne in der gewählten Einheit |
list | Alle passenden Texte, Zahlen oder Daten, in Reihenfolge der Eingabe |
estimate | Eine Verteilung innerhalb Ihrer min und max, auf Ihrem step-Raster, linear oder logarithmisch |
forecast | Eine Schätzung pro zukünftigem Schritt einer Reihe, bis zu 64 Schritte |
Jede Einzelwert-Antwort kommt mit p_null (der Wahrscheinlichkeit, dass die Eingabe den Wert nicht enthält) und einem confidence-Wert. Schätzungen und Prognosen kommen mit einem Median und einem 80-%-Intervall, p10 bis p90, und mit options.include_quantiles können Sie alle 99 Perzentile anfordern. Wenn ein Feld vom heutigen Datum abhängt, sagt der Changelog-Eintrag, setzen Sie reference_date oder fügen Sie dem State eine Zeile wie „Today: 2026-10-19“ hinzu.
Extrahierte und berechnete Werte
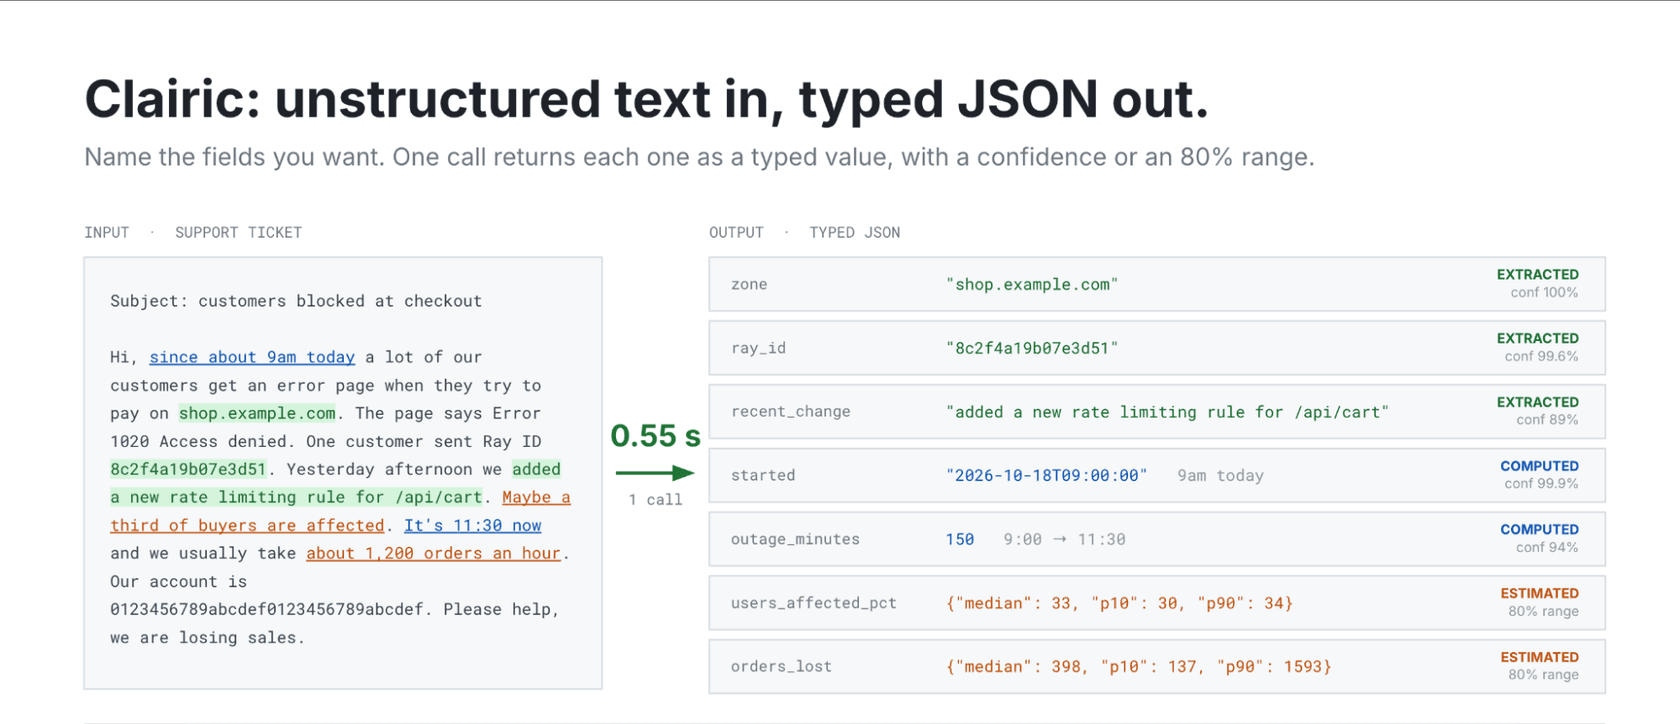
Cloudflares Hauptbeispiel ist eine Support-E-Mail, weshalb es mir auffiel. Ein Kunde schreibt, dass Bestellung A-88412 am 28. September mit einem gesprungenen Display und einer verbeulten Ecke ankam, dass er 649,00 $ plus 52,10 $ Steuer bezahlt hat und dass heute der 9. Oktober ist. Clairic soll sechs Felder liefern, und die Antworten zeigen die ganze Idee auf einen Schlag:
order_idkommt als"A-88412"zurück, mit seiner Textstelle in der E-Mail und einer Konfidenz von 0,999957.amount_paidkommt als701.1zurück, eine Zahl, die nirgends steht. Clairic hat Preis und Steuer addiert.days_since_deliverykommt als11zurück, berechnet aus zwei Daten im Text.damagekommt als Liste zurück,["cracked screen", "dented corner"], mit beiden Textstellen, damit Sie sie hervorheben können.tracking_numberkommt alsnullzurück, weil die E-Mail keine enthält. Derguessdes Modells war „$52.10“, mit einer Konfidenz von 0,416 und einemp_nullvon 1.
Der letzte Punkt sollte Support-Leute interessieren. Ein LLM, das nach einer Sendungsnummer gefragt wird, liefert manchmal eine plausibel aussehende Zeichenfolge. Clairic liefert null und sagt, was es geraten hätte, sodass Ihr Code den Kunden fragen kann, statt beim Paketdienst nach einer Nummer zu suchen, die es nicht gibt. Es ist derselbe Instinkt wie bei der Halluzinationsvermeidung in einem Support-Bot, nur im Ausgabeformat eingebaut.
Cloudflare ließ außerdem das Foto eines echten, leicht schiefen Belegs durchlaufen. Clairic las Bestellnummer, Zeitstempel, Menge, Stückpreis, Zwischensumme, Steuer und Trinkgeld und gab für den Rabatt null zurück, weil keiner aufgedruckt war. Die Konfidenz war bei den schwierigeren Stellen niedriger (0,78 bei der Bestellnummer, 0,83 beim Zeitstempel) und bei den sauberen über 0,99, also genau das Verhalten, das man will.
Geschätzte Werte
Manche Werte stehen gar nicht in der Eingabe, aber die Eingabe enthält Hinweise darauf. Cloudflares Beispiel ist ein Hauspreis: fünf Vergleichsverkäufe und ein Zielobjekt, mit einem Feld sale_price vom Typ estimate zwischen 50.000 $ und 5.000.000 $ auf logarithmischer Skala. Clairic gab einen Median von 415.000 $ und einen 80-%-Bereich von 370.000 $ bis 470.000 $ zurück.
Die Breite dieses Bereichs ist der nützliche Teil. Cloudflares Leitfaden zu Extraktionsmodellen sagt, ein schmales Intervall zeigt, dass die Eingabe die Schätzung stützt, ein breites, dass sie es nicht tut. Im Support entspricht das der Reparaturkostenschätzung im Beispiel der beschädigten Bestellung, und sie lässt den nächsten Schritt „Reparatur“ oder „Erstattung“ entscheiden, ohne dass ein Mensch raten muss.
Prognostizierte Werte
Ein forecast-Feld nimmt einen Verlauf als Klartext und liefert eine Schätzung pro zukünftigem Schritt, jeweils mit einem 80-%-Intervall. Cloudflare testete es an der täglichen Zahl der Personen, die an US-Flughafenkontrollen abgefertigt werden, und fragte 21 Tage in Folge jeden Morgen nach der Zahl für den nächsten Tag.
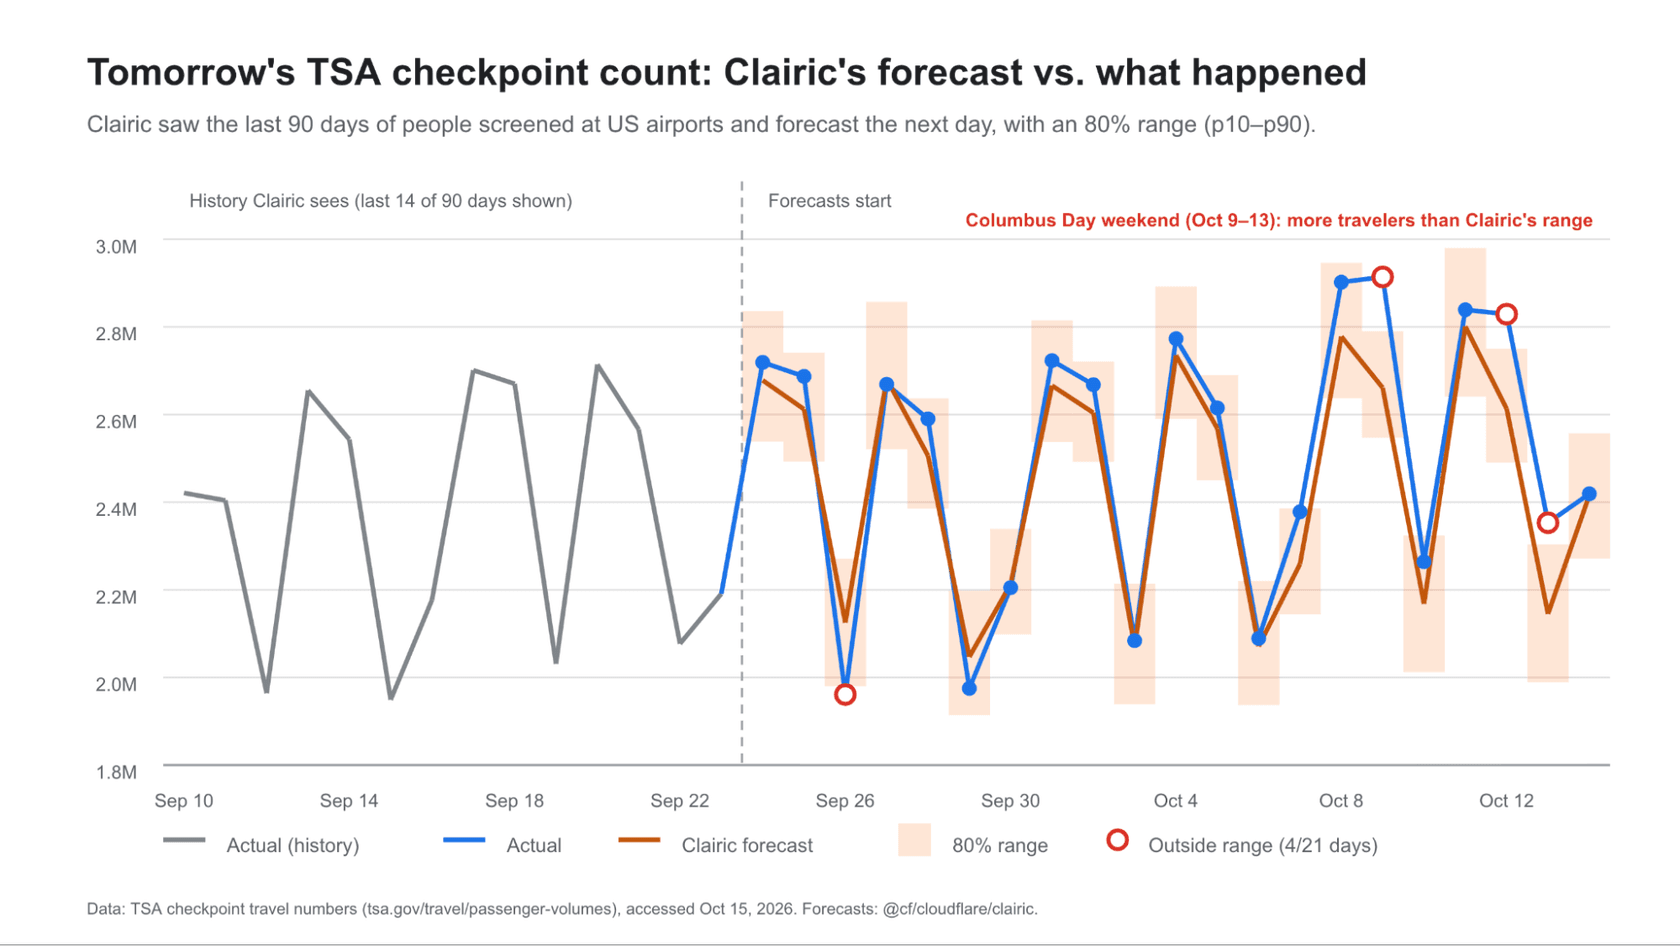
Die Prognosen lagen im Schnitt 3,3 % daneben, und 17 von 21 tatsächlichen Zahlen landeten im 80-%-Intervall, was ungefähr dem entspricht, was ein 80-%-Intervall leisten soll. Drei der vier Ausreißer fielen auf das Columbus-Day-Wochenende, weil Clairic Muster in der Reihe liest und Feiertage nicht kennt, die die Reihe nicht zeigt. Cloudflare sagt offen, dass dies kein eigenes Zeitreihenmodell ersetzt, daher würde ich darauf keinen Feiertagsdienstplan aufbauen. Dafür ist eine richtige Personalbedarfsprognose für den Support weiterhin das Werkzeug.
Clairic vs. Clef vs. ein LLM: Was ist der Unterschied?
Am besten sieht man, wo Clairic hinpasst, an der Pipeline, die Cloudflare für den Launch gebaut hat. Dieselbe E-Mail zur beschädigten Bestellung läuft durch zwei Setups. Im einen extrahiert Clairic die Fakten, Clef entscheidet anhand einer schriftlichen Richtlinie zwischen Erstattung und kostenloser Reparatur, und GLM-5.3 schreibt die Antwort. Im anderen macht GLM-5.3 alle drei Schritte.
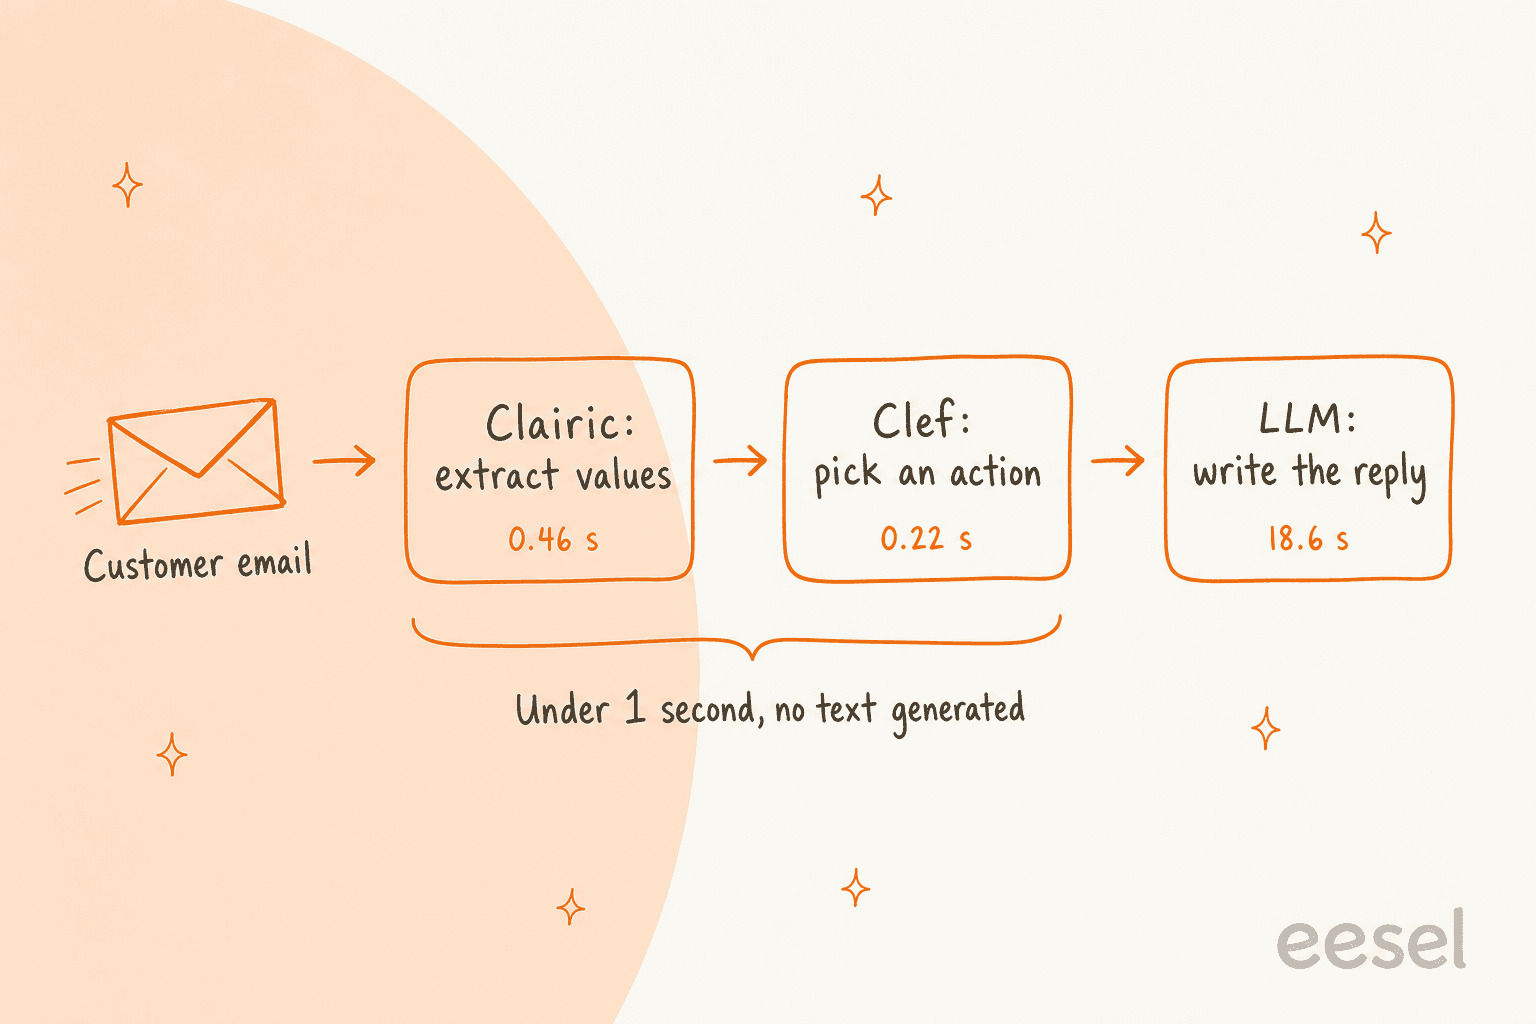
| Clairic, dann Clef, dann GLM-5.3 | GLM-5.3 für jeden Schritt | |
|---|---|---|
| Gesamtlatenz | 19,3 s | 61,7 s |
| 1. Extrahieren | Clairic: 0,46 s | GLM-5.3: 16,1 s |
| 2. Entscheiden | Clef: 0,22 s | GLM-5.3: 21,9 s |
| 3. Antworten | GLM-5.3: 18,6 s | GLM-5.3: 16,4 s |
| Kosten pro Million Fälle | 6.032 $ | 11.740 $ |
Das ist 3,2-mal schneller und 49 % günstiger, und fast die gesamte verbleibende Zeit und alle Kosten entfallen auf den einen Schritt, der Text schreibt. Beide Pipelines trafen in jedem Lauf Fakten und Entscheidung richtig, es ist also keine Geschichte vom Versagen des LLM. Der Unterschied, auf den Cloudflare hinweist, ist Konsistenz: Clairics Reparaturschätzung war in jedem Lauf identisch, während die von GLM-5.3 als 250 $, 250 $ und 220 $ zurückkam. Cloudflare merkt außerdem an, dass Gemma 4 und Qwen in der reinen LLM-Variante die Reparaturkosten gar nicht liefern konnten.
In diesem Design steckt auch ein Sicherheitsaspekt. Clef entscheidet anhand einer Fünf-Zeilen-Zusammenfassung typisierter Werte statt der rohen E-Mail, und das LLM sieht die E-Mail überhaupt nie. Eine Kundennachricht, die das Modell zu einer Erstattung überreden will, hat es durch typisierte Felder viel schwerer, was für alle relevant ist, die an KI-gestützte Erstattungsautomatisierung denken.
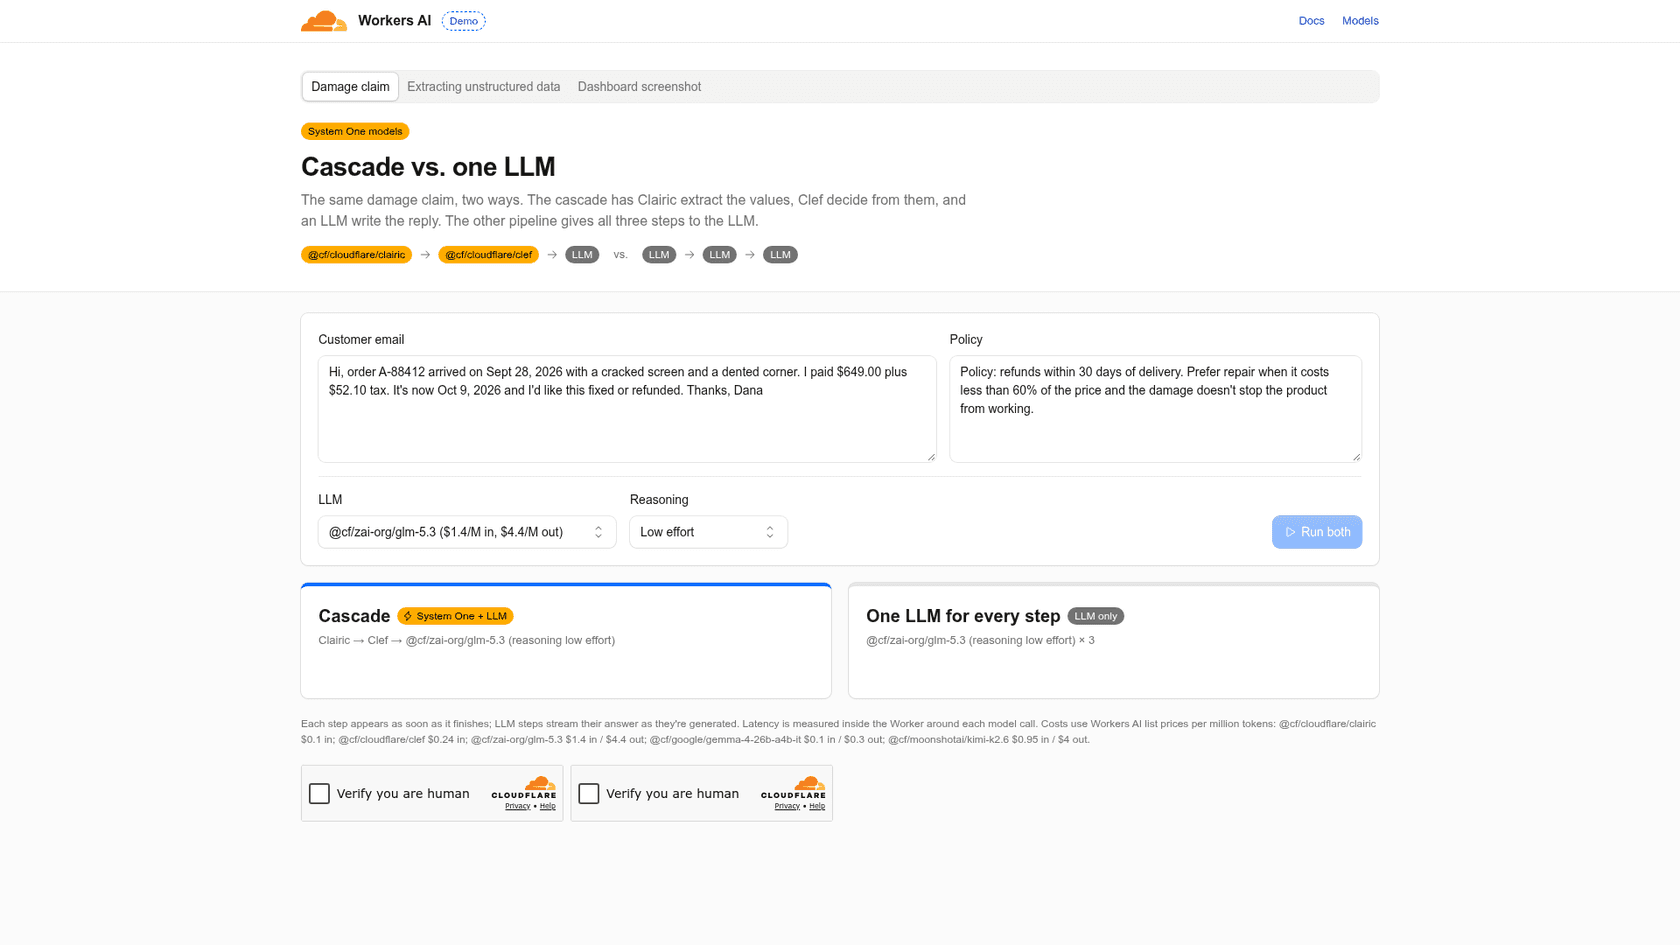
Sie können den Vergleich selbst in Cloudflares Live-Pipeline-Demo laufen lassen, mit Ihrer eigenen E-Mail und Richtlinie.
Was kostet Cloudflare Clairic?
Clairic wird wie jedes andere Workers-AI-Modell in Neurons abgerechnet, und die Workers-AI-Preisseite führt es neben seinen Geschwistern auf. Weil es keine Token erzeugt, gibt es nur einen Eingabepreis.
| Modell | Preis pro M Eingabetoken | Neurons pro M Eingabetoken | Ausgabepreis |
|---|---|---|---|
Clairic (@cf/cloudflare/clairic) | 0,100 $ | 9.091 | Keiner |
Clef (@cf/cloudflare/clef) | 0,240 $ | 21.818 | Keiner |
Clef-omni (@cf/cloudflare/clef-omni) | 0,150 $ | 13.636 | Keiner |
Clef-flash (@cf/cloudflare/clef-flash) | 0,038 $ | 3.455 | Keiner |
Workers AI selbst kostet 0,011 $ pro 1.000 Neurons, und jedes Konto erhält täglich 10.000 kostenlose Neurons, zurückgesetzt um 00:00 UTC. Wer über das kostenlose Kontingent hinausgeht, braucht den Workers-Paid-Tarif.
Konkret: Das Rechnungsbeispiel auf der Modellseite verbrauchte 655 Eingabetoken (61 für den Rechnungstext, 472 für das Sechs-Felder-Schema, der Rest Overhead) über drei Durchläufe. Bei 0,10 $ pro Million sind das etwa 0,000066 $ pro Aufruf, also rund 6,55 $ für 100.000 Rechnungen. Die kostenlosen 10.000 Neurons entsprechen etwa 1,1 Millionen Clairic-Eingabetoken pro Tag, bei diesem Beispiel kosten also rund 1.680 Aufrufe am Tag nichts. Beachten Sie, dass das Schema größer war als das Dokument. Lange instructions bei jedem Feld sind es, die Ihre Token-Rechnung wachsen lassen, halten Sie sie also kurz.
Zum Vergleich mit dem LLM, das Sie heute vielleicht nutzen: Der Clef-Preisleitfaden hat einen Rechner für die Entscheidungsseite, und die Aufschlüsselung der KI-Support-Kosten zeigt, was der ganze Stack pro Ticket kostet.
Wo liegen Clairics Grenzen aktuell?
Dies ist eine Vorschau, und Cloudflare ist ungewöhnlich direkt darüber, was noch nicht funktioniert. Aus dem Launch-Beitrag und dem Changelog:
- Rechnen hört bei zwei Schritten auf. Summen, Differenzen, Umrechnungen und Datumsrechnung sind zuverlässig. Lange Ketten abhängiger Schritte und Summen über viele Tabellenzeilen nicht. Cloudflares Rat: Clairic die Eingaben ziehen lassen und die Mathematik Ihrem Code überlassen.
- Schätzungen brauchen Belege. Fragen Sie nach einem Wert, zu dem die Eingabe keine Hinweise gibt, bekommen Sie ein breites Intervall.
- Kalibrierung ist gemessen, nicht garantiert. Intervalle sind auf Kalibrierung trainiert und sind es bei den meisten zurückgehaltenen Datensätzen, können bei ungewohnten Daten aber zu eng ausfallen.
- Prognosen sind einfach. Prognosen für den nächsten Schritt folgen den jüngsten Mustern, längere Horizonte flachen zum Durchschnitt ab, und Feiertage, die die Reihe nicht zeigt, werden verpasst.
- Wohlgeformt ist nicht korrekt. Die Typen garantieren die Form. Nutzen Sie
confidence,p_nullund die Intervalle, um zu entscheiden, was automatisiert wird und was zur Prüfung geht.
Es gibt auch praktische Grenzen. Bilder sind auf vier pro Anfrage, 4 MiB je Bild und 8 MiB insgesamt begrenzt, und Remote-URLs werden nicht akzeptiert, Sie senden also die Bytes inline. Clairic ist unter Text Generation geführt, und die Seite zu den Workers-AI-Limits setzt den Standard für diesen Aufgabentyp auf 300 Anfragen pro Minute.
Die eine Lücke, die am Starttag auffiel, sind Benchmarks. Cloudflare veröffentlichte Praxisbeispiele und den Pipeline-Vergleich, aber noch keine Werte aus Standard-Extraktions-Benchmarks:
"It's interesting that they haven't published any benchmarks yet."

Andere im selben Thread interessierten sich mehr dafür, wohin es als Nächstes gehen könnte:
"Seems like it might excel at NER and intent-slot tasks, too."
Das sehe ich genauso. Bis Cloudflare Zahlen veröffentlicht, ist der ehrliche Weg, Clairic zu beurteilen, es an ein paar hundert eigenen Tickets laufen zu lassen und die Felder mit dem zu vergleichen, was Ihr Team tatsächlich eingetragen hat.
Wo passt Clairic in eine Support-Warteschlange?
Im Support verdient sich das Modell meiner Meinung nach seinen Platz. Ein Großteil dessen, was ein Agent in der ersten Minute eines Tickets tut, ist Extraktion: Bestellnummer finden, Lieferdatum prüfen, klären, ob es noch innerhalb der Rückgabefrist liegt, notieren, was beschädigt ist. In einem Demo-Gespräch Anfang des Jahres sagte ein B2B-Telematik-Team auf Zendesk meinen Kollegen im Vertrieb, die zwei Dinge, die es zuerst wollte, seien Tagging aus einer festen Tag-Liste und das automatische Ausfüllen von Ticketfeldern. Clairic ist ein sauberer Weg, Letzteres selbst zu bauen.
So würde ich gängige Support-Aufgaben auf die drei Modellklassen verteilen. Wählen Sie eine Aufgabe, um zu sehen, welche passt:
Welche Modellklasse übernimmt diese Support-Aufgabe?
Extraktion (Clairic), Entscheidung (Clef) oder Generierung (ein LLM)
Tippen Sie oben auf eine Aufgabe.
text-Feld. Liefert die exakte Textstelle mit Zeichenpositionen, oder null mit einem p_null-Wert, falls der Kunde keine angegeben hat, sodass Sie nachfragen können, statt zu raten.duration-Feld. Ein berechneter Wert aus zwei Daten. Fügen Sie das heutige Datum zum State hinzu oder setzen Sie reference_date, sonst hat die Rechnung keinen Bezugspunkt.estimate-Feld. Liefert einen Median und einen 80-%-Bereich innerhalb der von Ihnen gesetzten Grenzen. Ein breiter Bereich ist Ihr Signal, dass die Eingabe noch keine Zahl hergibt.forecast-Feld, mit Vorsicht. Gut für eine grobe Zahl zum nächsten Schritt. Cloudflare sagt, es verpasst Ereignisse, die der Verlauf nicht zeigt, wie Feiertage, planen Sie also keine Spitzenwoche darauf.Was Clairic Ihnen bietet und ein LLM-Aufruf im JSON-Modus oder mit Function Calling nicht, ist ein eingebauter Weg zu entscheiden, was man glauben kann. Jede Antwort trägt eine Konfidenz und eine Wahrscheinlichkeit, dass der Wert fehlt, was sich sauber auf drei Spuren abbilden lässt:
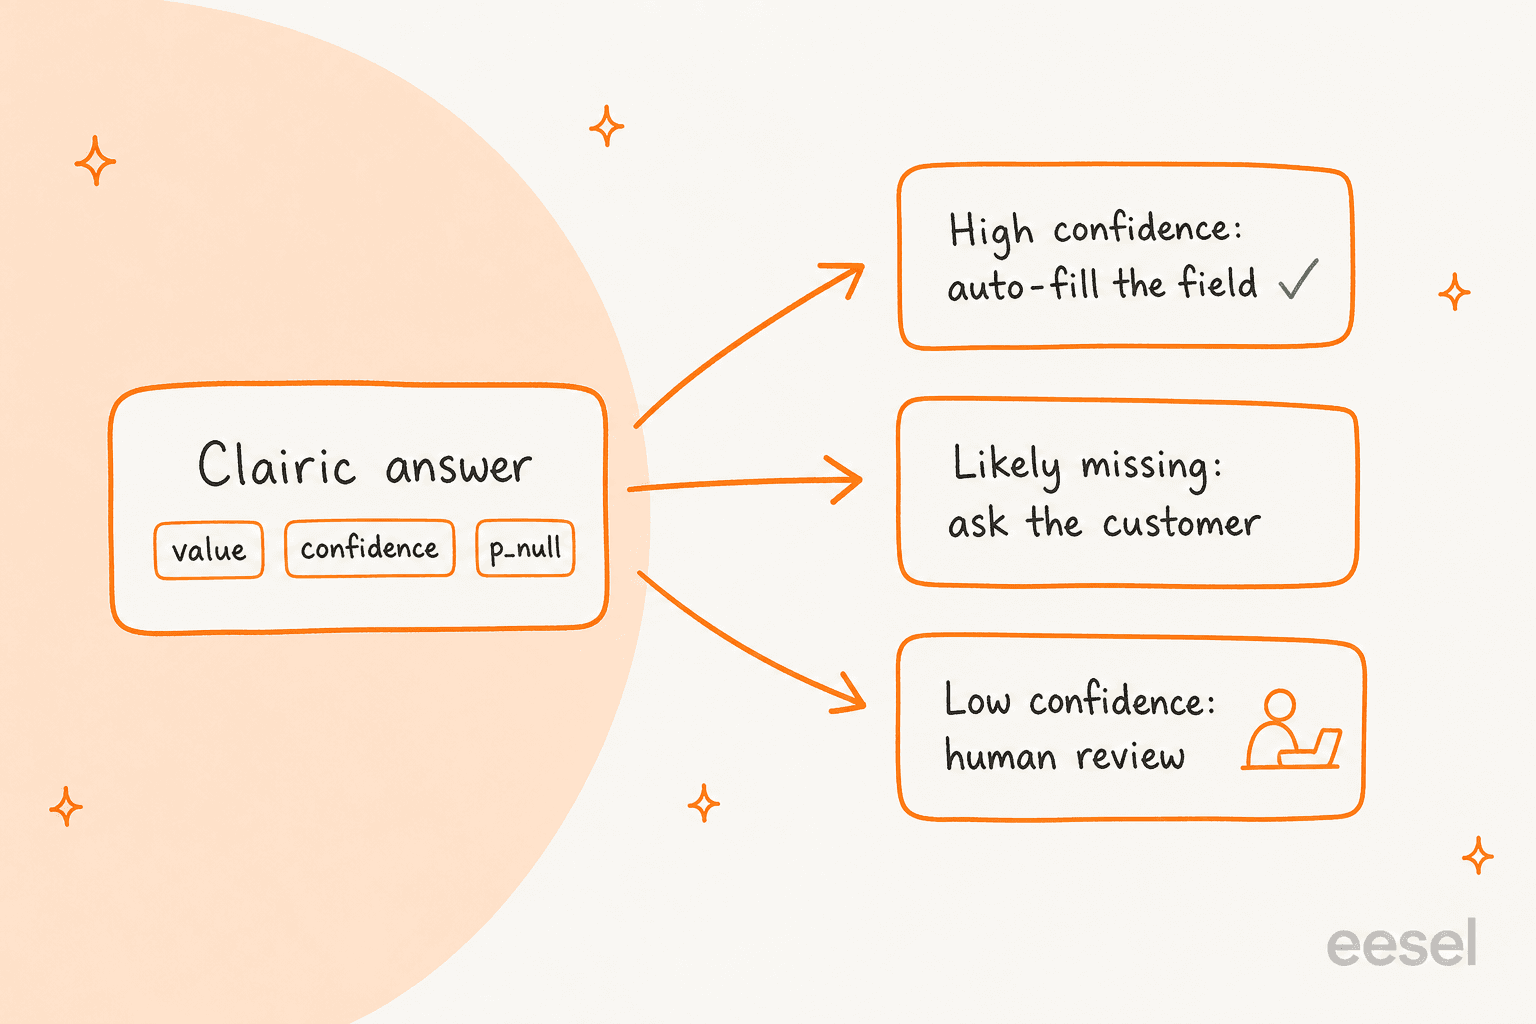
Das ist dieselbe Logik, die die meisten Helpdesks bereits für die Ticket-Klassifizierung nutzen, und sie passt hinter Tools, die Sie vielleicht schon betreiben. Zendesks eigene Entitätsextraktion macht eine Version davon im Helpdesk, und die Advanced-AI-Variante ergänzt eigene Entitäten. Clairic ist die Selbstbau-Option: mehr Kontrolle über Schema und Schwellenwerte, und mehr Code, den Sie besitzen.
Was Clairic nicht tut, ist die Arbeit. Es öffnet kein Shopify, um die Bestellung zu prüfen, wendet Ihre Erstattungsfreigabe-Matrix nicht an, schreibt nicht ins Ticket zurück und weiß nicht, wann ein beschädigter Artikel einen Menschen braucht. Jemand muss den Worker schreiben, der all das erledigt, die Eskalation regeln und alles am Laufen halten, wenn sich die Helpdesk-API ändert. Für ein Team mit Entwicklern, die einen schnellen, günstigen Parser in ihrer eigenen Ticket-Triage-Pipeline wollen, ist das ein fairer Tausch. Für ein Support-Team, das die Warteschlange diese Woche erledigt haben will, ist es eine Komponente, keine Antwort.
Wer sollte Cloudflare Clairic nutzen?
Ich würde Clairic in drei Situationen wählen:
- Sie laufen bereits auf Workers. Der Aufruf ist eine
env.AI.run()-Zeile neben Ihrem bestehenden Code, und die kostenlosen täglichen Neurons decken viel Extraktion mit geringem Volumen ab. - Sie parsen immer wieder dieselben Formen. Rechnungen, Belege, Bestell-E-Mails, Versandbenachrichtigungen. Feste Felder, hohes Volumen, und eine typisierte Antwort schlägt es, LLM-JSON bei jedem Aufruf neu zu validieren.
- Sie müssen wissen, wann sich das Modell unsicher ist. Die Werte
confidenceundp_nullliefern Ihnen kostenlos ein Routing-Signal, und das ist der größte Teil der Arbeit bei einer sicheren Automatisierung.
Ich würde warten, wenn Sie es auf eigener Hardware brauchen (noch keine Gewichte), wenn Sie vor einem Launch-Review geprüfte Genauigkeitszahlen brauchen (noch keine Benchmarks) oder wenn die Aufgabe vor allem mehrstufige Mathematik über große Tabellen ist (Cloudflare selbst sagt, das gehöre in den Code). Und wenn Sie eigentlich weniger Tickets in der Warteschlange wollen statt saubererer Felder, bringt Sie ein fertiger KI-Helpdesk-Agent ohne Eigenbau dorthin.
eesel für das Ticket nach der Extraktion
Clairic ist Infrastruktur. eesel ist der Mitarbeiter. eesel ist eine Plattform für KI-Teammitglieder, und das Teammitglied, das hier zählt, ist das KI-Helpdesk-Teammitglied. Es tritt Ihrer Zendesk-, Freshdesk-, Gorgias- oder Front-Warteschlange bei, lernt aus Ihren früheren Tickets und Ihrem Help Center und erledigt das Lesen, das Clairic leistet, als Teil der Ticketbearbeitung: die Bestellung finden, die Daten prüfen, erkennen, was beschädigt ist. Dann handelt es. Es taggt, entwirft, antwortet oder übergibt, und alles, was Sie als „vorher fragen“ markieren, wartet auf die Freigabe durch einen Menschen.
Rúngne, eine norwegische Kletterbekleidungsmarke auf Gorgias und Shopify, betreibt drei eesel-Agenten: einen, der jedes Ticket bestätigt und taggt, einen, der Bestellung, Tracking und Bestand in Shopify nachschlägt und einen Entwurf hinterlässt, und einen, der einfache Fragen direkt beantwortet. Zwischen dem 8. August und dem 8. September 2026 kamen so etwa 2.100 bearbeitete Tickets, 580 für das Team hinterlassene Entwürfe und 150 Bestellabfragen zusammen. Beschädigte Artikel, verlorene Pakete und Stornierungen gehen direkt an Menschen, dieselbe Grenze würde ich bei jeder extraktionsgetriebenen Automatisierung ziehen. Dokument 24 macht die leichtere Variante auf Zendesk: Jede erste Nachricht bekommt einen Produkt-Tag und einen dänischen Entwurf als interne Notiz.

Wenn Sie Clairic wegen der Programmierbarkeit reizt, sehen Sie sich die eesel CLI an. Es ist dasselbe Teammitglied wie im Dashboard, gesteuert über ein Terminal, und jeder Befehl gibt JSON aus, sodass ein Skript oder ein Coding-Agent wie Claude Code, Cursor oder Codex die ganze Einrichtung übernehmen kann. Für einen Extraktions-Workflow sieht das so aus:
npx @eesel/cli initstartet einen Workspace ohne Konto (Node 18.17 oder neuer), undeesel loginbehält ihn.eesel integrations connect <platform>verbindet Zendesk, Freshdesk oder Gorgias, undeesel integrations <platform> actionslistet jede Aktion auf, die das Teammitglied dort ausführen kann, mit ihrer Freigabeeinstellung.eesel instructionsenthält die dauerhaften Regeln in Alltagssprache, etwa „Fülle das Feld Bestellnummer aus; gibt es keine, frage danach.“eesel approvals listundeesel approvals approve <id>räumen zurückgehaltene Aktionen per Skript ab, und--dry-runzeigt den genauen Aufruf, den ein Schreibvorgang ausführen würde, bevor er passiert.eesel activityzeigt, was das Teammitglied getan hat, das Neueste zuerst, das ist Ihr Prüfpfad.
Der Workspace ist auch ein MCP-Server (eesel mcp token gibt die claude mcp add-Zeile aus), und der Beitrag meines Kollegen zur KI-Agent-CLI geht tiefer darauf ein, den Support aus einem Terminal zu betreiben.
Die Preiseinheit ist anders, weil sie etwas anderes kauft. Die eesel-Preise beginnen mit 100 kostenlosen Credits, danach folgen feste Monatspläne ab 299 $ für 500 Credits, wobei ein Credit ein ganzes Ticket oder einen Chat abdeckt, egal wie viele Abfragen und Aktionen es braucht. Wenn Sie die Extraktionsschicht selbst bauen wollen, ist Clairic eine schnelle, günstige und ehrliche Komponente. Wenn Sie Bestell-E-Mails diese Woche in Ihrem Helpdesk gelesen, nachgeschlagen und beantwortet haben wollen, testen Sie eesel an Ihrer eigenen Warteschlange und lesen Sie die Entwürfe, bevor Sie etwas bezahlen.
Häufig gestellte Fragen
Was ist Cloudflare Clairic?
Cloudflare Clairic ist ein Extraktionsmodell, das Cloudflare am 19. Oktober 2026 als Vorschau auf Workers AI veröffentlicht hat, als @cf/cloudflare/clairic. Sie senden Text (plus bis zu vier Bilder) und eine Liste typisierter Felder, und es liefert pro Feld einen typisierten Wert mit Konfidenzwert. Es steht neben den Entscheidungsmodellen wie Clef in dem, was Cloudflare System-One-Modelle nennt.
Worin unterscheidet sich Cloudflare Clairic von Clef?
Clef wählt aus Optionen, die Sie vorgeben, und liefert für jede eine Wahrscheinlichkeit. Es beantwortet also „welches Team?“ oder „Erstattung oder Reparatur?“. Clairic antwortet mit Werten, die sich nicht vorab auflisten lassen, etwa einer Bestellnummer, einem Datum, einer Summe oder geschätzten Reparaturkosten. Cloudflares eigene Demo verkettet beide: Clairic extrahiert, Cloudflare Clef entscheidet, ein LLM schreibt die Antwort.
Was kostet Cloudflare Clairic?
Clairic kostet 0,10 $ pro Million Eingabetoken und es gibt keine Gebühr für Ausgabetoken, weil es keine Token erzeugt. Abgerechnet wird in Workers-AI-Neurons (9.091 pro Million Eingabetoken), und jedes Konto erhält täglich 10.000 kostenlose Neurons. Das ganze Workers-AI-Bild finden Sie im Clef-Preisleitfaden.
Ist Cloudflare Clairic Open Source?
Noch nicht. Zum Start ist Clairic eine gehostete Vorschau, nur auf Workers AI, und Cloudflare will das Modell bald mit offenen Gewichten veröffentlichen. Wenn Sie heute etwas brauchen, das Sie selbst hosten können, sind kleine Sprachmodelle auf Hugging Face der übliche Weg.
Kann Cloudflare Clairic halluzinieren?
Es kann falsch liegen, aber keine fehlerhaft geformte Antwort erfinden. Jeder Wert kommt im angefragten Typ zurück oder als null, und Textantworten sind Ausschnitte Ihrer Eingabe mit Zeichenpositionen. Cloudflares Dokumentation betont, dass wohlgeformt nicht dasselbe wie korrekt ist. Nutzen Sie die Werte confidence und p_null so, wie Sie anderswo Konfidenzschwellen einsetzen.
Kann ich Cloudflare Clairic für Kunden-Support-Tickets nutzen?
Ja, Cloudflares eigene Launch-Beispiele sind eine E-Mail zu einer beschädigten Bestellung und ein Ticket zu einem Checkout-Ausfall. Clairic zieht Bestellnummer, Daten, Beträge und Schadensliste aus der Nachricht, sodass Ihr Code oder ein Modell wie Clef darauf reagieren kann. Es antwortet nicht und greift nicht auf Ihr Helpdesk zu. Genau da kommt ein KI-Helpdesk-Agent wie eesel ins Spiel.
Wie rufe ich Cloudflare Clairic auf?
Aus einem Worker rufen Sie env.AI.run("@cf/cloudflare/clairic", { model: "clairic", state, fields }) auf. Von überall sonst senden Sie denselben Body per POST an /accounts/{account_id}/ai/run/@cf/cloudflare/clairic mit einem API-Token. Wenn Sie es in einen Support-Stack einbauen, behandelt der Beitrag meines Kollegen zur KI-Helpdesk-API die Technik drumherum.
Ist Cloudflare Clairic gut bei Prognosen?
Für eine schnelle Zahl zum nächsten Schritt: ja. In Cloudflares 21-Tage-TSA-Test lagen die Prognosen im Schnitt 3,3 % daneben. Cloudflare nennt die Prognosefunktion aber einfach und sagt, sie ersetze kein mit Ihren Daten trainiertes Zeitreihenmodell. Für die Personalplanung eines Support-Teams ist eine richtige Personalbedarfsprognose weiterhin das bessere Werkzeug.