Was TypeSafe Jev wirklich ist
TypeSafe AI ist ein Labor aus San Francisco, das zwei Jahre im Stealth-Modus verbrachte, bevor es Jev am 15. September 2026 auslieferte. Die Formulierung auf der Homepage ist bewusst provokant: LLMs „produzieren Wörter für Menschen“, während „Jev typisierte Entscheidungen produziert und eher wie Code ist“. Der Launch-Post hat einen prägnanteren Einzeiler und nennt Jev „einen Function Call mit Frontier-Intelligenz: unstrukturierter Zustand rein, typisierte probabilistische Entscheidungen raus“.
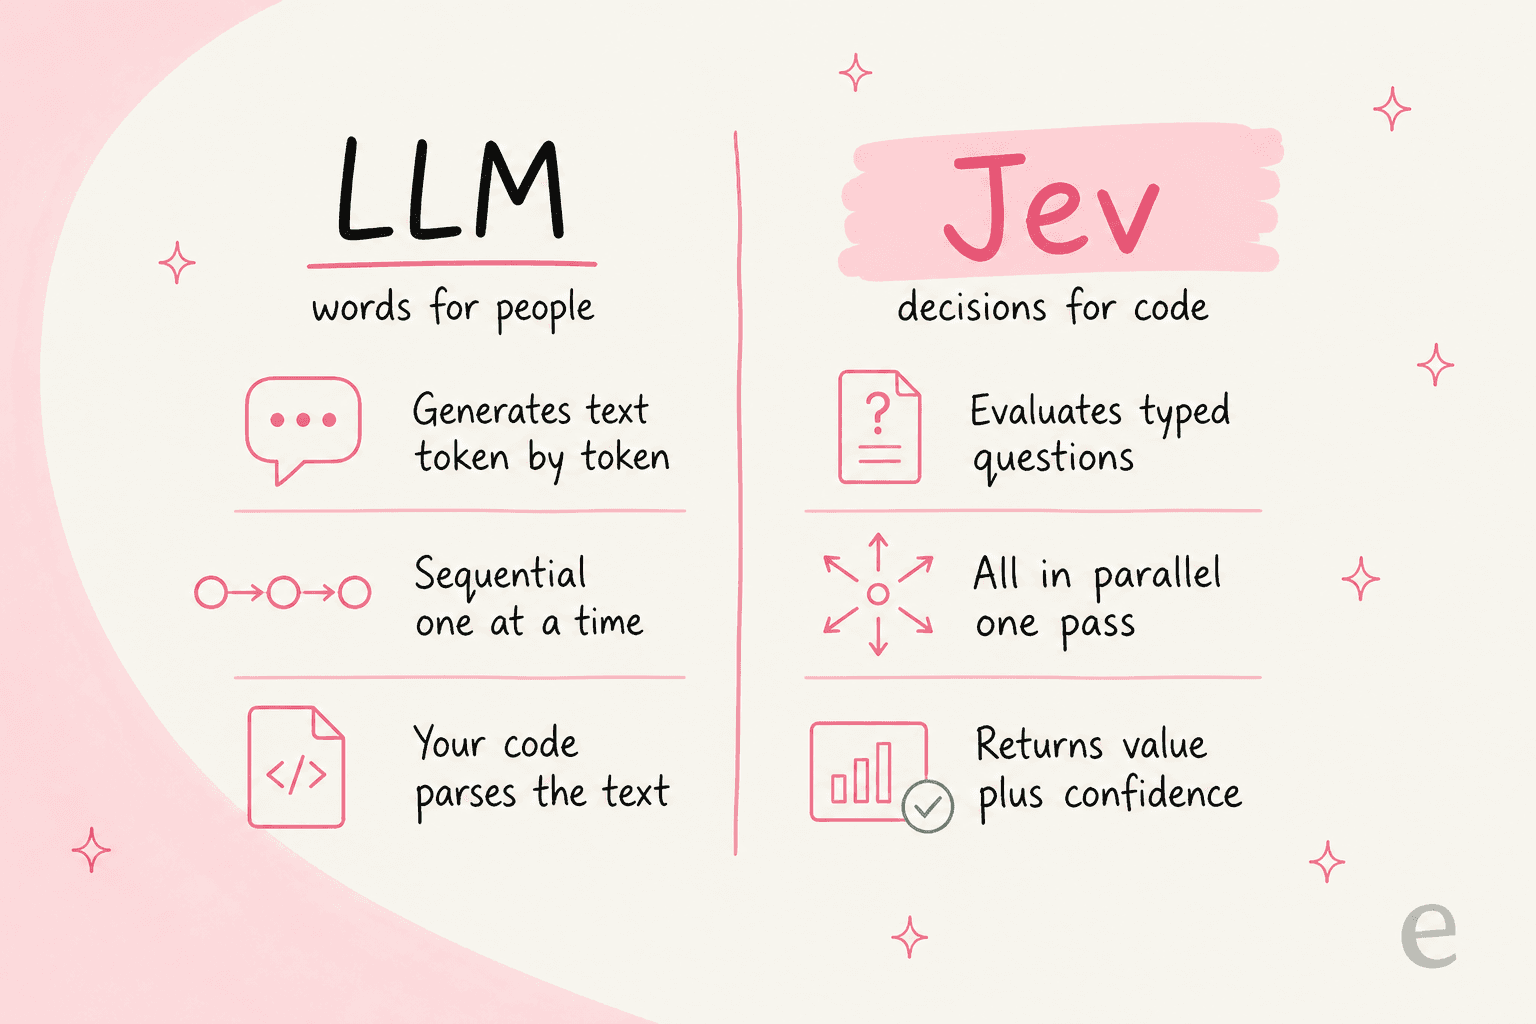
Der Name verrät die ganze Philosophie. „System One“ spielt auf Daniel Kahnemans schnelles, intuitives System-1-Denken an, und „Jev“ ist nach dem Ökonomen William Stanley Jevons benannt, dessen Paradoxon besagt, dass jeder Preisverfall einer Ressource ihre Nutzung um ein Vielfaches steigert. TypeSafe wettet darauf, dass billige, schnelle, typisierte Entscheidungen überall dort zum Einsatz kommen, wo ein langsamer generativer Aufruf heute noch zu teuer ist.
Das Unternehmen sagt außerdem, es habe „die entgegengesetzte Forschungsrichtung“ zu Chat eingeschlagen. Statt mehr RLHF trainierte es mit einem neuen Ziel namens Reinforcement Learning for Calibrated Decisions (RLCD), mit einer neuen Architektur und einem neuen Sampler. Der Pitch lässt sich in drei Worten zusammenfassen: Entscheidungen statt Strings, kalibrierte Konfidenz, eher wie Code. Ihr Slogan „Build Prod, Not God“ verrät, an wen sie sich richten.
So funktioniert es: Zustand plus Fragen, parallel ausgewertet
Das ist der Teil, bei dem bei mir der Groschen fiel, und es lohnt sich, ihn zu verstehen, bevor man sich mit den einzelnen Behauptungen befasst. Die Docs beschreiben den Missstand, den Jev beseitigen soll:
"you are coercing a text-generation system into outputting structured decisions, then parsing the results back into something your code can depend on."
Jeder, der schon einmal ein LLM-Feature ausgeliefert hat, kennt genau diesen Schmerz. Jevs Modell ist anders: Sie schicken einen Zustand (einen String oder ein strukturiertes Objekt) plus eine Reihe typisierter Fragen, und es wertet jede Frage gegen diesen Zustand aus, parallel, in einem einzigen Durchgang. Ihr Code verzweigt, sortiert und routet dann anhand der zurückkommenden typisierten Antworten.
Es gibt nur drei Primitive, und sie decken genau die Formen ab, die man tatsächlich braucht:
| Fragetyp | Was sie fragt | Was sie zurückgibt |
|---|---|---|
| Noul | Ist diese Aussage wahr? | eine einzelne Wahrscheinlichkeit, 0 bis 1 |
| Choice | Eine Option aus einer Liste wählen | die Wahl, Wahrscheinlichkeiten pro Option und eine Konfidenz |
| Score | Den Zustand anhand einer Rubrik bewerten | ein numerischer Score, Wahrscheinlichkeiten pro Stufe und eine Konfidenz |
Die Design-Entscheidung, die mir am besten gefällt: Weil jede Frage unabhängig gegen denselben Zustand ausgewertet wird, verändert das Hinzufügen weiterer Fragen die Latenz kaum und erzeugt niemals Context-Rot. TypeSafes Kompositions-Leitfaden rät dazu, jede Frage atomar zu halten – „die Art von Urteil, das eine sachkundige Person in wenigen Sekunden fällen könnte“ – und das Schwierige im Code statt in einem einzigen riesigen Prompt zu komponieren. Statt „bewerte dieses Startup-Pitch“ fragen Sie separat nach Marktgröße, Machbarkeit und Differenzierung und kombinieren die Werte dann mit Ihrer eigenen Formel.
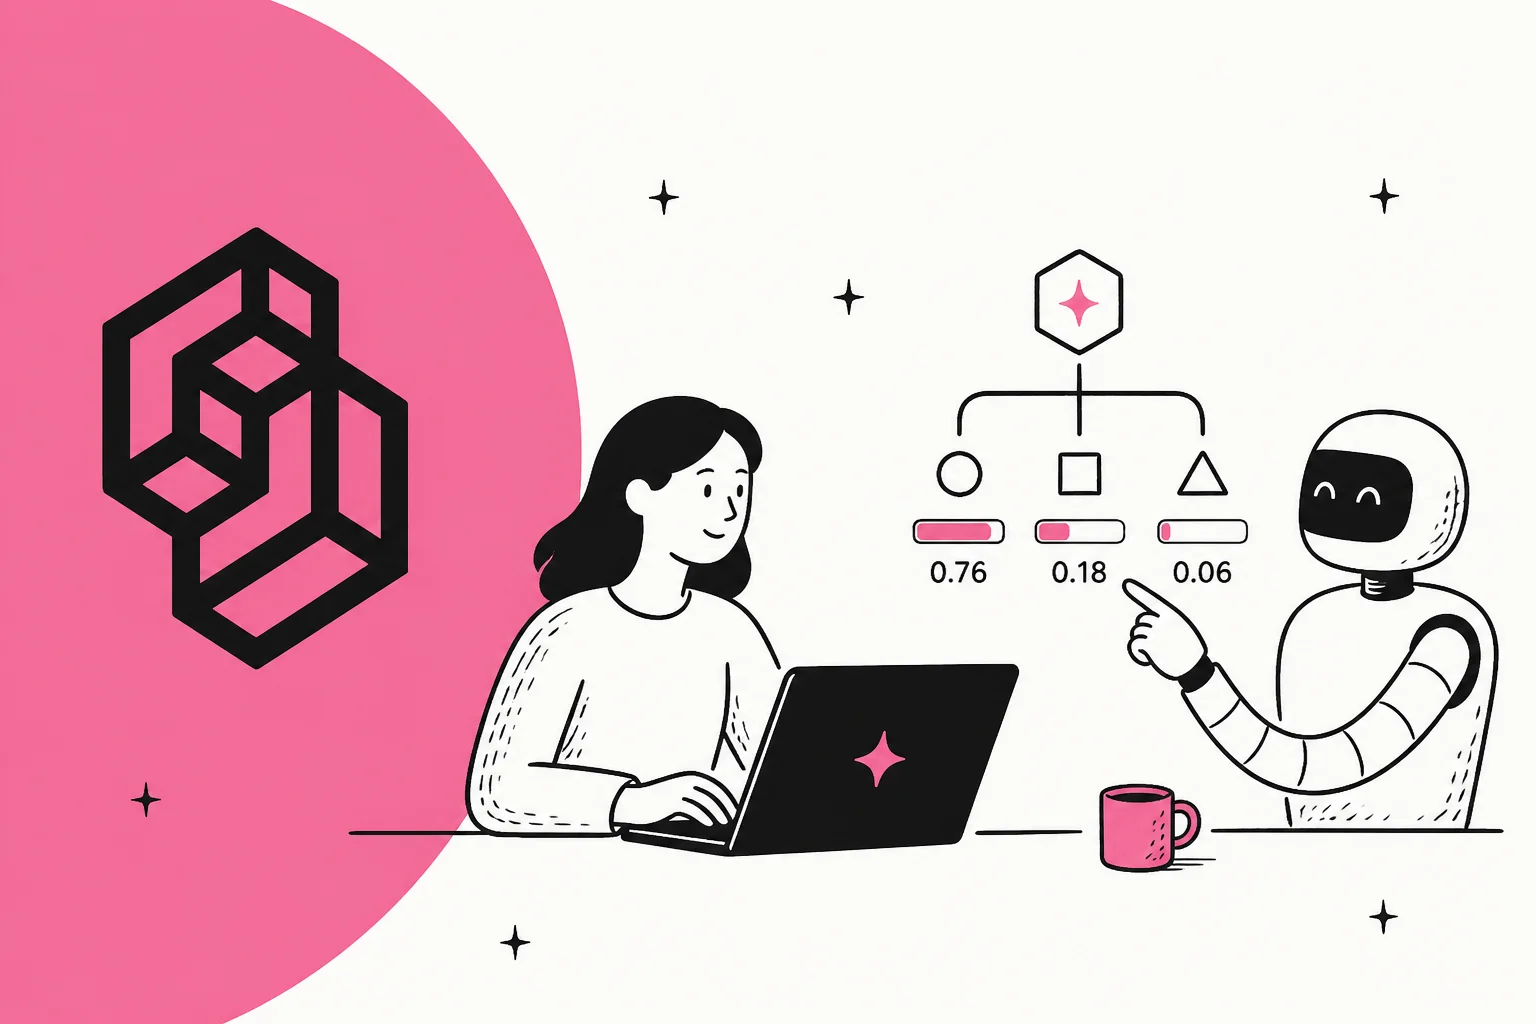
Die Cloudflare-Modellseite macht das mit einem Support-Beispiel greifbar, das ehrlich gesagt liest wie unsere eigene Produktspezifikation. Schicken Sie den Zustand "Help! My payouts have been failing for 3 days." mit drei Fragen, und Sie erhalten zurück:
is_urgent(Noul):0.95department(Choice):"billing", Konfidenz0.8, Wahrscheinlichkeiten {billing 0.87, technical 0.13}frustration(Score):1.04auf einer Skala von Calm/Frustrated/Very angry, Konfidenz0.94
Das ist Ticket-Triage in einem einzigen Aufruf. Es ist auch das klarste Bild davon, was Jev ist: ein sehr schneller Klassifikator mit kalibrierten Wahrscheinlichkeiten, kein Ding, das redet.
Die Behauptungen im Einzelcheck
TypeSafes Marketing ist mutig, also gehe ich die Hauptbehauptungen der Reihe nach durch und trenne, was standhält, von dem, was übertrieben ist.
Geschwindigkeit: schnell, für die Aufgaben, für die es gemacht ist
TypeSafe behauptet 70–500 ms End-to-End gegenüber 3–329 Sekunden bei Frontier-LLMs, gerahmt als 40x bis 200x schneller. Der einzelne parallele Durchgang ist ein echter architektonischer Grund für die Geschwindigkeit, und die externen Belege sind ermutigend. Vercels CEO berichtete davon aus der Produktion:
"Jev is up to 18x faster (p95) and more accurate. It's coming to @vercel AI Gateway and likely new default."
Der faire Einwand, der auf Hacker News wiederholt vorgebracht wurde: Der Vergleich ist kein Äpfel-mit-Äpfel-Vergleich. Ein generatives Modell, das alle Typnamen, das Schema und Fließtext produziert, leistet mehr Arbeit als ein Modell, das nur eine eingeschränkte Entscheidung ausgibt. Die Geschwindigkeit ist echt; der Multiplikator hängt davon ab, womit man vergleicht.
Preis: günstig, mit einem ehrlichen Sternchen
Bei 0,042 $ pro Million Input-Tokens mit kostenlosem Output ist Jev wie Infrastruktur bepreist, nicht wie ein Frontier-Modell. TypeSafe behauptet, das sei ein 238-mal niedrigerer Input-Preis als Claude Fable 5.1. Anerkennung, wo sie zusteht: Sie adressieren die Subventionsfrage direkt, statt ihr auszuweichen.
"We can't prove it isn't subsidized; we'll need the long-term to prove the sustainability of our pricing (which we expect to go down, not up)."
Bevor Sie damit planen, sollten Sie wissen: Es gibt keine Preisseite (jede /pricing-URL liefert derzeit einen 404), keine veröffentlichten Plan-Stufen oder Rate-Limits, und der Zugang ist hinter einer Warteliste verriegelt. Das ist ein Launch-Preis für ein Early-Access-Produkt, behandeln Sie ihn also als richtungsweisend. Wenn Sie Kosten modellieren, zeigt unser Leitfaden zu Qwen-Preisen, wie schnell sich Launch-Zahlen ändern. Dieselbe Lektion zieht sich durch unsere Aufschlüsselung zu Gemini-3-Preisen, und falls die Warteliste ein Hindernis ist, hat unsere Liste der Qwen-Alternativen schon heute offene Optionen.
„Kann nicht halluzinieren“: halb wahr und überzogen
Das ist die Aussage, die die meiste Kritik bekam, und wie ich finde zu Recht. Jev kann keinen Typfehler machen, weil die Ausgabe mathematisch auf Ihr Schema beschränkt ist. Dieser Teil ist echt und nützlich. Aber das Marketing rutscht von „keine Typfehler“ zu „kann nicht halluzinieren“, und die Spitze des Hacker-News-Threads wollte das nicht durchgehen lassen:
"if it puts a high confidence value on a wrong answer, thats still hallucinating, no?"

Die Verteidiger hatten eine vernünftige Antwort: Ein kalibrierter Konfidenzwert bedeutet, dass Sie eine 0.1 sehen und sie ignorieren können – das ist etwas anderes als ein Modell, das selbstbewusst falschliegt. Ein anderer Kommentator legte den Maßstab fest, an dem die Behauptung gemessen werden sollte:
"What we would want to see is a confidence value that is in line with the actual correctness. If the value is 0.9 for 1000 different answers, then approximately 900 of those answers should be correct."
Das ist der richtige Test, und genau dafür soll RLCD optimieren. Meine Einschätzung: kalibrierte Konfidenz ist ein echtes Sicherheitsmerkmal, das ich mir von mehr Modellen wünschen würde. „Kann nicht halluzinieren“ ist ein stärkeres Versprechen, als das Modell tatsächlich hält, und TypeSafe stünde auf sichererem Boden mit „type-safe mit kalibrierter Konfidenz“.
Der Benchmark: ein Chart, das genaues Lesen lohnt
TypeSafes eigene Workflow-Evals werben plakativ mit „193,6x schneller, 444,6x günstiger“, was der Blog selbst einräumt, am oberen Ende der Real-World-Gewinne liege. Das Chart darunter ist ehrlicher als die Überschrift und das mit Abstand nützlichste, was sie veröffentlicht haben.
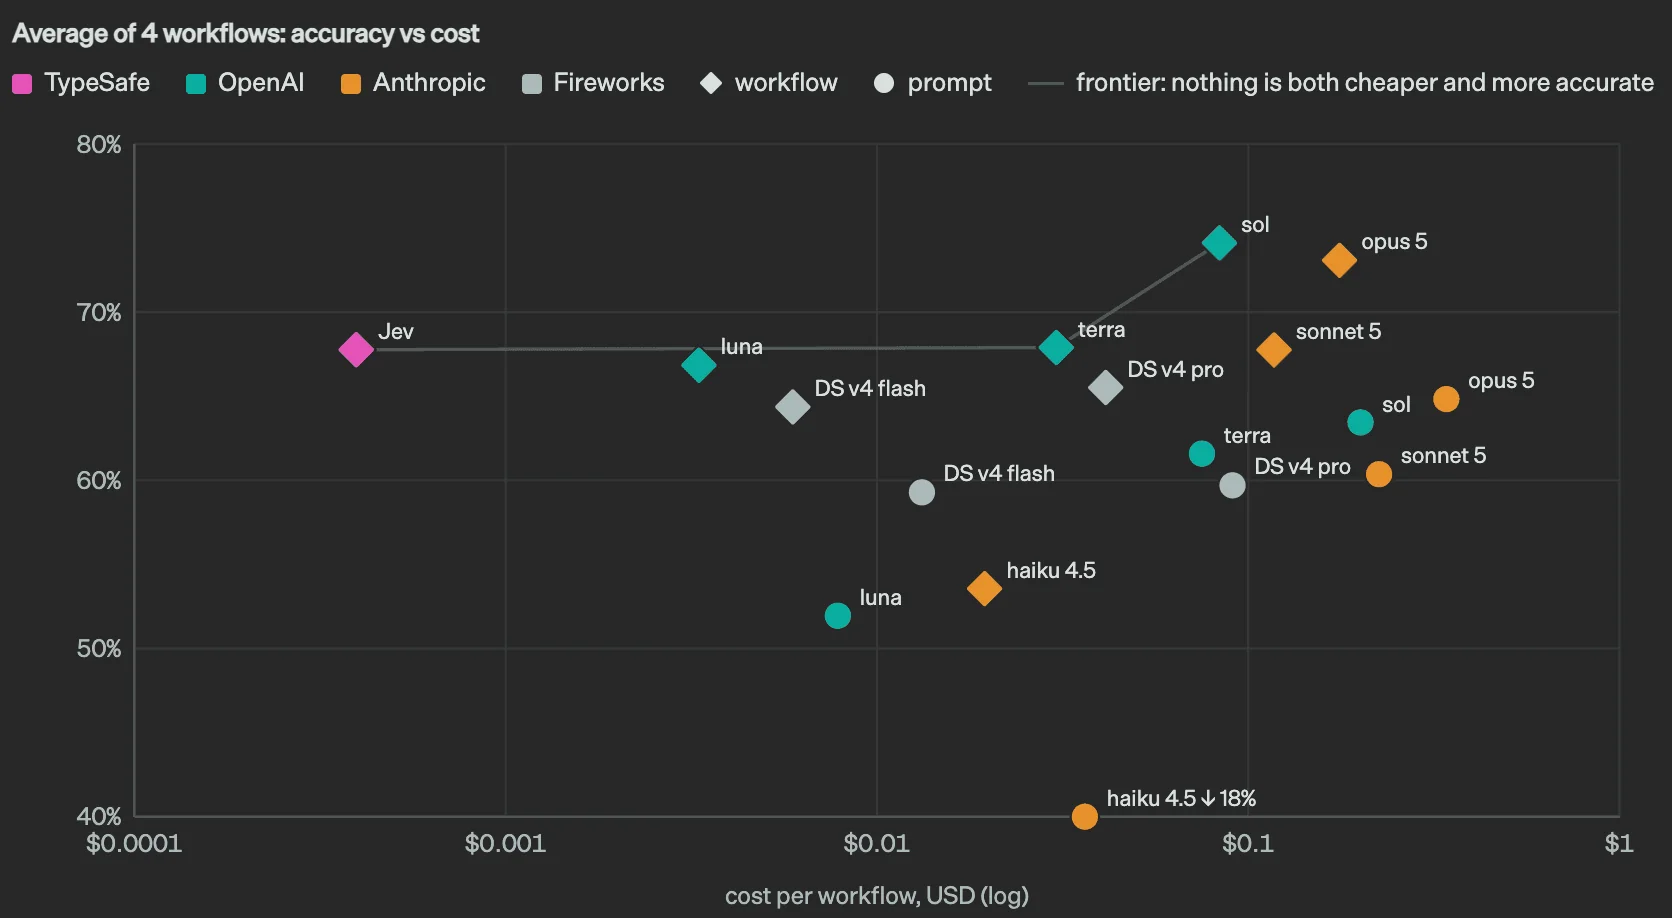
Liest man es genau, wird die eigentliche Aussage klar: Jev liegt auf der Effizienzgrenze bei ungefähr der Genauigkeit eines Mid-Tier-Reasoning-Modells, zu einem Bruchteil der Kosten pro Workflow. Es ist nicht der genaueste Punkt im Chart. Es ist der günstigste Punkt, der noch konkurrenzfähig ist – und das ist bei hochvolumiger Entscheidungsarbeit oft das, worauf es ankommt. Die abgewogene Einschätzung eines Top-Kommentators bringt es gut auf den Punkt:
"Seems like a more accurate title would be "Jev: Trading general purpose generation for fast typed inference"."
Was Entwickler tatsächlich damit bauen
Die Reaktionen auf X haben mich am meisten überzeugt, dass hier wirklich etwas dran ist, weil es Demos waren, keine bloßen Meinungen. Die beiden größten Posts drehten sich beide darum, Agenten-Kontext zu komprimieren. Ein Entwickler nutzte Jev für sofortige Kompaktierung:
"in 2026, why is compaction still a summarization prompt? Jev can make it instant by scoring every tool call and dropping what's irrelevant"
Ein anderer verdrahtete es mit Claude als Prüfer für Tool-Aufrufe und berichtete, dass eine Session in etwa einer Sekunde „von fast 1 Mio. auf 86.000 Tokens“ schrumpfte. Genau das ist die Art von Aufgabe, für die Jev gut ist: ein schnelles, günstiges, hochvolumiges Urteil, für das ein großes Modell massiv überqualifiziert war. Es ist derselbe Instinkt, der hinter guten Agent-Assist-Tools steckt – kleine Prüfungen, die kein Frontier-Gehirn brauchen.
Es ist nicht ungeteilte Liebe, und die Gegenstimmen sind es wert, gehört zu werden. Entwickler Theo Brownes unverblümte „Please don't do this“-Antwort brachte eine echte Sorge auf den Punkt: dass Leute nach einem System-One-Klassifikator greifen, wo eigentlich das Reasoning eines allgemeinen Modells zählte. Beides stimmt gleichzeitig. Jev ist hervorragend für die enge Entscheidung, sei es Bug-Report-Triage oder eine Eskalations-Entscheidung, und falsch für die offene Frage. Die Disziplin besteht darin, zu wissen, was was ist.
Wo ein typisiertes Entscheidungsmodell passt – und wo nicht
Hier ist die ehrliche Grenze, denn ein Test, der sagt „nutzt es für alles“, ist nutzlos.
Jev passt, wenn die Aufgabe eine Entscheidung ist, die Ihr Code verarbeitet: Routing und Triage, Dringlichkeits- und Stimmungsbewertung, Spam- und Missbrauchs-Flags, Ticket-Tagging oder die Prüfung eines Tool-Aufrufs, bevor er ausgeführt wird. Überall dort, wo Sie sonst ein LLM zu JSON zwingen würden, ist ein typisiertes Entscheidungsmodell das sauberere Primitiv, und die kalibrierte Konfidenz gibt Ihnen einen echten Hebel dafür, wann automatisch gehandelt und wann eskaliert wird.
Es passt nicht, wenn die Ausgabe selbst der Punkt ist. Jev schreibt nicht die Antwort, erklärt nicht sein Reasoning, führt keine Konversation und behandelt nicht den Long Tail einer wirklich neuartigen Frage. Es hat außerdem ein 32.000-Token-Kontextfenster und, als Produkt in der Launch-Woche, eine Early-Access-Warteliste statt offener Verfügbarkeit. Für die Antwort selbst brauchen Sie weiterhin ein allgemeines Modell, wie wir es in unserem Rundup zum besten KI-Chatbot-Builder vergleichen, und wenn Sie ein kleineres Team sind, unseren Leitfaden zu KI-Agenten für kleine Unternehmen.
Das nützlichste mentale Modell, bei dem ich gelandet bin: Jev ist der schnelle Reflex, nicht das Abwägen. TypeSafes eigenes Security-Workflow-Diagramm zeigt das Muster gut: eine Pipeline aus kleinen Bool-, Score- und Choice-Fragen, wobei Ihr Code dazwischen die Aktion wählt.
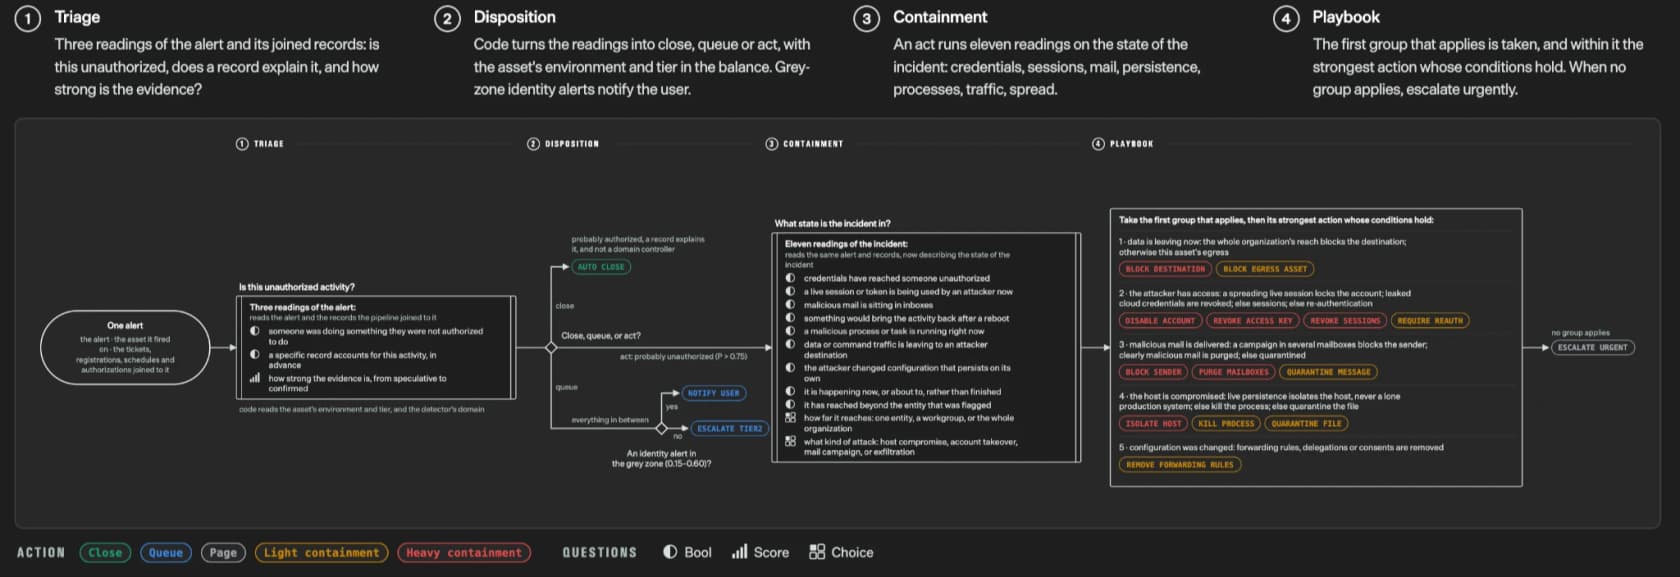
Damit die Entscheidung schneller fällt, hier der Ablauf, den ich tatsächlich durchgehen würde:
Jev auf einen Blick
| Modell | Jev (jev-1.13.0), das erste öffentliche System-One-Modell |
| Was es zurückgibt | typisierte Entscheidungen (Noul / Choice / Score) mit kalibrierter Konfidenz |
| Latenz | 70–500 ms End-to-End, ein paralleler Durchgang |
| Preis | 0,042 $ / MTok Input, Output kostenlos (Launch-Preis, keine Stufen) |
| Kontextfenster | 32.000 Tokens |
| Zugang | Early-Access-Warteliste, plus typesafe/jev auf Cloudflare Workers AI |
| Am besten für | hochvolumige strukturierte Entscheidungen, Prüfung von Tool-Aufrufen, Kompaktierung |
| Nicht für | Antworten schreiben, Reasoning in Fließtext, offene Konversation |
Was das bedeutet, wenn Sie ein Support-Team leiten
Jevs eigene Vorzeige-Demo ist ein Support-Ticket, und das ist kein Zufall – Triage ist die Lehrbuchaufgabe für System One. Ich habe genug Zeit in Live-Warteschlangen verbracht, um die Falle zu kennen: Eine großartige Triage-Entscheidung ist nur der erste Zoll der Customer-Service-Automatisierung. Das ist eine Unterscheidung als Entwickler, zu der ich immer wieder zurückkomme. Bei der Klassifizierung ist KI bereits zuverlässig; bei der generierten Antwort, und der Kosten-Rechnung Mensch-vs-Agent, rutscht sie noch aus.
Genau diese Kluft sahen wir in einem Test, den ich für eine Consumer-Goods-Marke mitbetreut habe, über 284 Chats und eine Cross-Validierung mit 100 Tickets. Die typisierten Entscheidungen waren exzellent: 93 % Triage-Genauigkeit und 100 % Spam-Erkennung ohne Falschpositive. Die entworfenen Antworten hatten weiterhin eine Fehlerquote von 7 % bei Fakten, und nur 12 % waren sauber genug, um unverändert versendet zu werden.
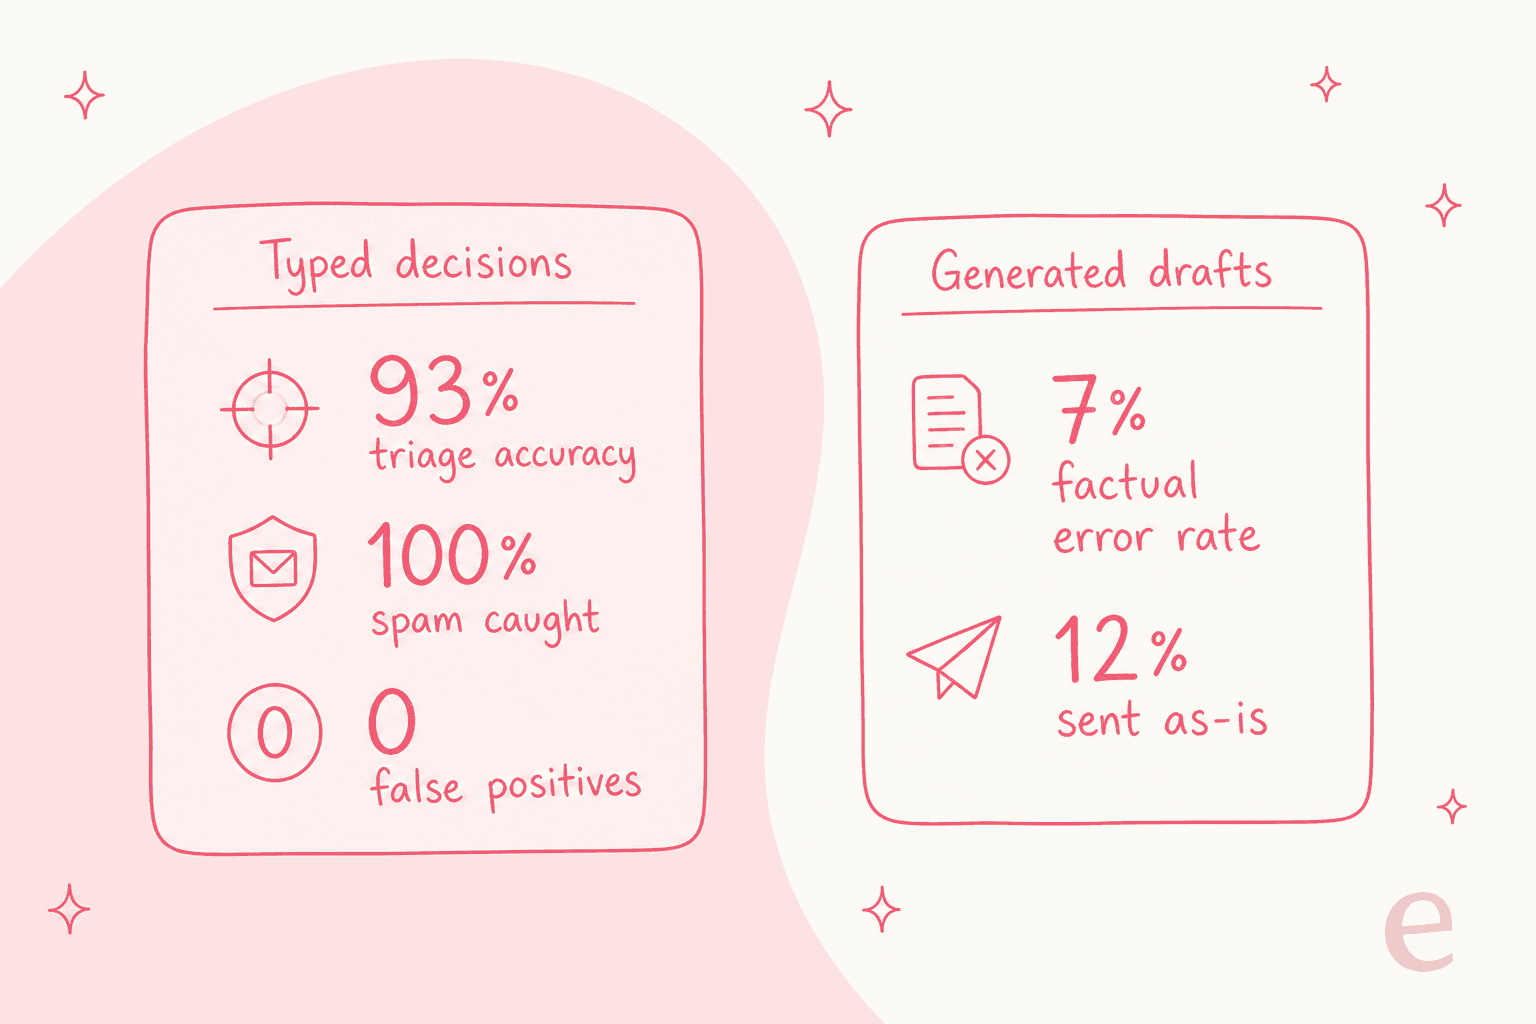
Das ist der ganze Grund, warum ein Modell wie Jev spannend ist – und auch der Grund, warum es nicht die Ziellinie ist. Ein typisiertes Entscheidungsmodell ist Infrastruktur. Der Support-Job obendrauf – die Verbindung zum Helpdesk, das Lesen Ihrer Wissensdatenbank, das Entwerfen der Antwort, das Ausführen der Aktion, das Wissen, wann eskaliert werden muss, und der Nachweis, dass es funktioniert, bevor es live geht – ist die Aufgabe eines Mitarbeiters.
Genau auf dieser Linie bewegt sich eesel. Wo Jev ein schneller Baustein ist, ist eesels KI-Helpdesk-Teamkollege die sofort einsatzbereite Neueinstellung: Er dockt an die wichtigsten Helpdesk-Integrationen an (Zendesk, Freshdesk, Gorgias, Front, Help Scout, HubSpot) und triagiert, entwirft und löst dann auf Ihrer Live-Warteschlange.
Entscheidend ist: Er simuliert an vergangenen Tickets, bevor er auch nur einem einzigen Kunden antwortet, sodass Sie die Genauigkeit an Ihren eigenen Daten sehen statt an einem Launch-Chart. Er rechnet pro bearbeitetem Ticket ab, nicht pro Sitzplatz, sodass sich die Ökonomie an der tatsächlichen Arbeit orientiert.
Und für die Entwickler, an die sich dieser Beitrag eigentlich richtet: eesel ist nicht nur ein Dashboard. Derselbe Teamkollege lässt sich über die eesel-CLI (npx @eesel/cli) steuern: Eine Person kann ihn vom Terminal aus ausführen, Skripte können ihn in CI mit einem API-Token automatisieren, und Coding-Agenten wie Claude Code, Codex und Cursor können ihn direkt bedienen. Sie können eine Integration verbinden, die Standardanweisungen bearbeiten, Human-in-the-Loop-Aktionen auflisten und freigeben und das Aktivitätsprotokoll Lauf für Lauf lesen, alles als JSON, mit --dry-run, um einen Schreibvorgang vorab zu prüfen, bevor er ausgelöst wird. Jeder Workspace ist außerdem ein MCP-Server, sodass derselbe Agent, den Sie auf Jev ansetzen würden, auch auf Ihren Support-Teamkollegen zeigen kann. Die Riege endet auch nicht beim Support; es gibt einen Teamkollegen als KI-Blog-Autor für Content. Wenn Ihnen Jev gefällt, weil es Intelligenz wie Code behandelt, ist das derselbe Grund, einen Teamkollegen vom Terminal aus zu bedienen.
Mein Fazit
Jev ist einer der interessanteren Modell-Launches des Jahres, genau weil es nicht einem besseren Chatbot hinterherjagt. Es ist ein echtes, nützliches Primitiv: schnelle, günstige, typsichere Entscheidungen mit kalibrierter Konfidenz und ein klares mentales Modell, um sie im Code zu komponieren. Geschwindigkeit und Preis halten für das, wofür sie gedacht sind, die „kann nicht halluzinieren“-Behauptung ist überzogen, und die Benchmark-Überschrift ist lauter als die (immer noch gute) Realität darunter.
Wenn Sie Entwickler sind und agentische Systeme verdrahten, setzen Sie sich auf die Warteliste und nutzen Sie es genau dort, wo es stark ist: die hochvolumigen Entscheidungen, die Sie bisher einem großen Modell aufgezwungen haben. Für das größere Bild davon, wie diese Systeme in der Produktion aussehen, sind unsere Rundups zu KI-Agenten-Beispielen und den besten KI-Teamkollegen eine gute nächste Lektüre.
Verwechseln Sie nur nicht den Reflex mit dem gesamten Nervensystem. Die Entscheidung ist der leichte Zoll; der End-to-End-Job ist immer noch die Meile.
Häufig gestellte Fragen
Was ist TypeSafe Jev?
Jev ist TypeSafe AIs erstes System-One-Modell, gestartet am 15. September 2026. Statt wie ein Chatbot Text zu generieren, bewertet es typisierte Fragen gegen einen Zustand und liefert strukturierte Entscheidungen mit Konfidenzwerten zurück. Es ist eher ein schneller Klassifikator als ein allgemeines LLM – genau darum geht es in diesem TypeSafe-Jev-Test.
Ist Jev ein LLM?
Nein, und TypeSafe betont das ausdrücklich. Jev denkt nicht in Fließtext und schreibt keine Erklärungen. Es liefert einen typisierten Wert plus eine Wahrscheinlichkeit zurück, und alles Komplexere wird in separate Fragen aufgeteilt und in Ihrem eigenen Code wieder zusammengeführt. Wenn Sie konversationelle Antworten brauchen, ist ein allgemeines Modell oder ein Support-KI-Agent das richtige Werkzeug.
Kann Jev wirklich nicht halluzinieren?
Es kann keinen Typfehler machen, weil die Ausgabe auf Ihr Schema beschränkt ist. Es kann bei einem Urteil aber trotzdem selbstbewusst falschliegen – genau das haben Hacker-News-Kommentatoren am stärksten kritisiert. Die ehrliche Einschätzung: ein kalibrierter Konfidenzwert ist ein echtes Sicherheitsmerkmal, aber „kann nicht halluzinieren“ verspricht mehr, als das Modell tatsächlich garantiert.
Was kostet Jev?
TypeSafe berechnet Input mit 0,042 $ pro Million Tokens und führt Output-Tokens als kostenlos. Es gibt noch keine eigene Preisseite und keine Plan-Stufen, und der Zugang läuft über eine Early-Access-Warteliste. Bei Cloudflare Workers AI läuft die Abrechnung über das Cloudflare-Dashboard.
Was kann man mit einem System-One-Modell bauen?
Strukturierte Entscheidungen, die Ihr Code direkt weiterverarbeitet: Ticket-Klassifizierung, Routing, Dringlichkeits- und Stimmungsbewertung, die Prüfung von Tool-Aufrufen und Kontext-Kompaktierung. Es passt überall dort gut, wo Sie bisher ein LLM zu JSON gezwungen und das Ergebnis wieder herausgeparst haben. Für den kompletten Support-Job, der auf diesen Entscheidungen aufbaut, siehe die besten KI-Agenten für den Kundenservice.
Ist Jev für den Support besser als GPT oder Claude?
Unterschiedliche Aufgaben. Jev ist für die enge Entscheidung schneller und günstiger (ist das dringend? welche Warteschlange?), während ein Modell wie das beste LLM für Support-Anwendungsfälle weiterhin die Antwort schreibt. Die meisten Produktivsysteme nutzen beides – oder übergeben den gesamten Workflow an einen Teamkollegen, der die Teile bereits miteinander verdrahtet.
Wie erhalte ich Zugang zu TypeSafe Jev?
Melden Sie sich für den Early Access unter console.typesafe.ai an, nutzen Sie es über die Modell-ID typesafe/jev von Cloudflare Workers AI, oder umhüllen Sie ein bestehendes LLM mit TypeSafes Open-Source-System-One-Adapter. Alle Details stehen in den Docs.


Article by
Rama Adi Nugraha
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.