Was Claude Mythos 5.1 wirklich ist
Anthropic veröffentlichte Claude Mythos 5.1 am 1. September 2026 mit der Modell-ID claude-mythos-5-1. Es ist ein Frontier-Modell für verifizierte Sicherheits- und Life-Sciences-Arbeit, und Anthropic hat erklärt, dass Claude Security selbst jetzt darauf läuft.
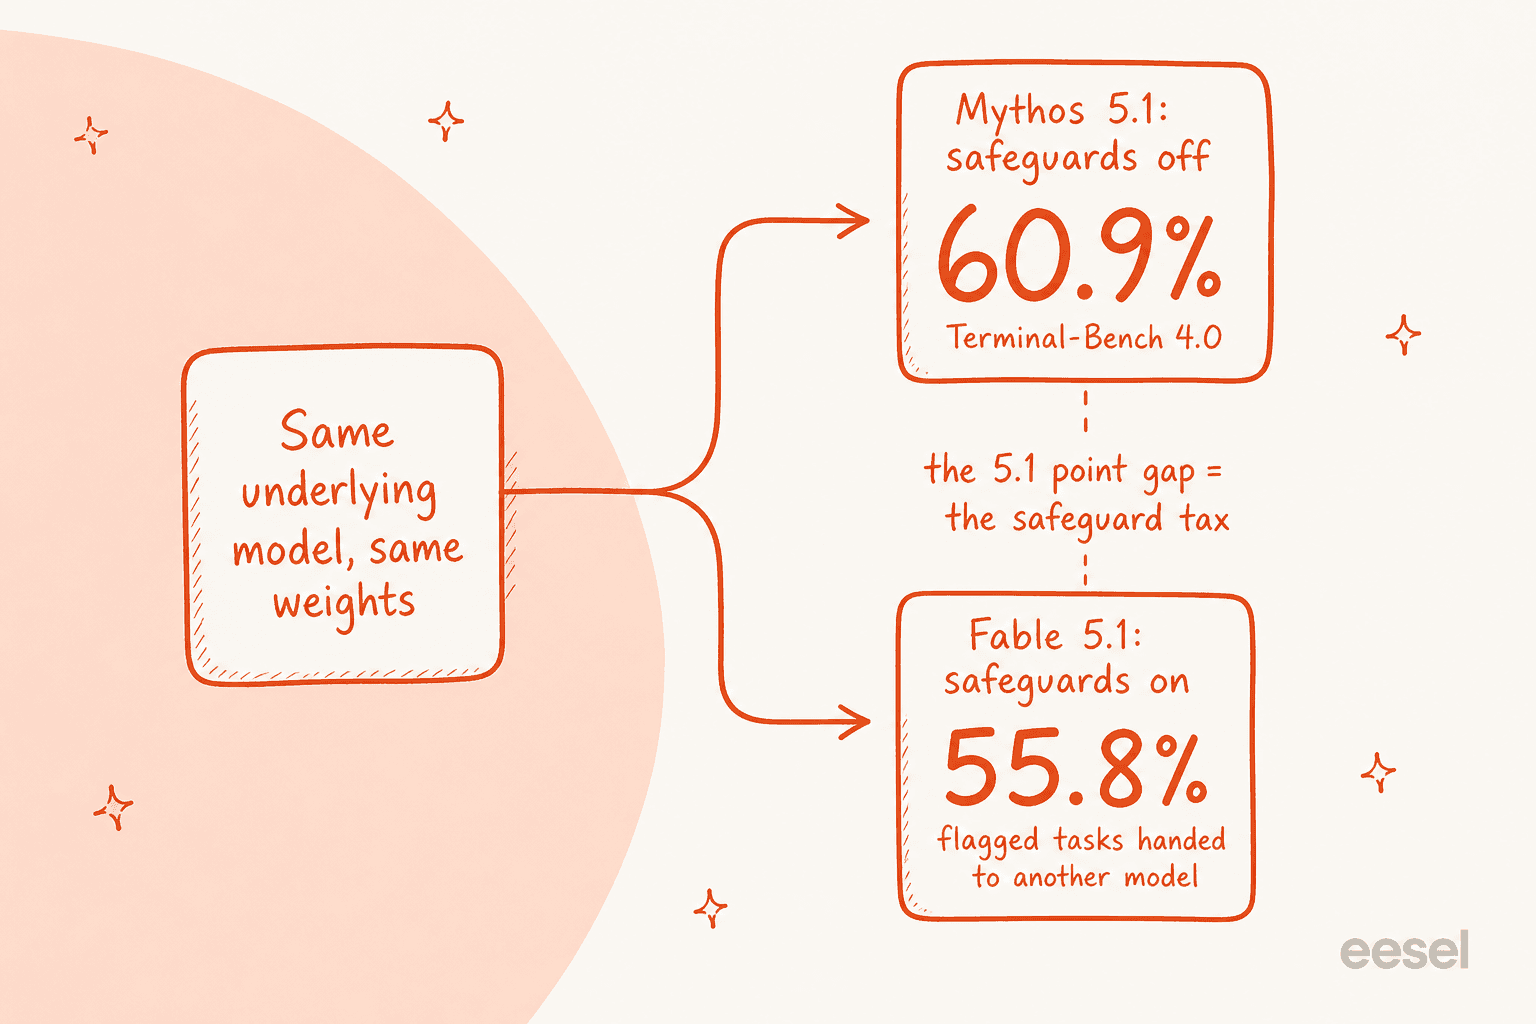
Das Wichtigste, bevor man über Benchmarks spricht: Mythos 5.1 und Fable 5.1 sind dieselben Gewichte. Der einzige Unterschied ist die Sicherheitsschicht. Fable 5.1 ist die Version, die mit aktivierten Produktions-Sicherheitsmechanismen benchmarkt und ausgeliefert wird, und wenn ein Sicherheitsmechanismus greift, wird die Aufgabe an ein anderes Modell weitergegeben (Cyber-Aufgaben gehen an Opus 4.8, Biologie an Opus 5). Mythos ist dasselbe Modell, gemessen mit ausgeschalteten Sicherheitsmechanismen. Diese Beziehung ist die ganze Geschichte, deshalb komme ich immer wieder darauf zurück.
Mythos 5.1 vs. Fable 5.1: Die Lücke ist eine Sicherheitssteuer
Hier ist die Zahl, die alle aus dem Zusammenhang gerissen zitieren. Bei Terminal-Bench 4.0 erzielt Mythos 5.1 60,9 % und Fable 5.1 55,8 %. Es sieht so aus, als wäre Mythos das schlauere Modell. Das ist es nicht. Der niedrigere Wert von Fable entsteht dadurch, dass Sicherheitsmechanismen eine Aufgabe abfangen und weiterleiten, und eine so unterbrochene Aufgabe kann glatt null Punkte bekommen. Die Lücke von 5,1 Punkten sind die Kosten der Sicherheitsmechanismen, kein Unterschied im zugrunde liegenden Gehirn.
Das hat beim Launch viele Leser aufs Glatteis geführt. Wie es ein Kommentator auf Hacker News formulierte:
"Warte, es ist also buchstäblich dasselbe Modell, das nur höher punktet, weil man den Sicherheitsgurt ausgeschaltet hat? Das ist kein neues Modell, das ist eine Benchmark-Fußnote."

Anthropic selbst erwartet, dass sich die Lücke verkleinert, sobald die Sicherheitsmechanismen präziser werden – ein stilles Eingeständnis, dass die Differenz an der Sicherheitsschicht liegt und nicht an der Modellqualität. Wer Mythos und Fable also anhand der reinen Fähigkeiten vergleicht, sollte aufhören: Sie sind gleich. Wo Fable seine Existenz rechtfertigt, ist die Sicherheitsarbeit selbst. Es kann jetzt Softwareschwachstellen im Quellcode identifizieren, löst pro Claude-Code-Sitzung rund 60 % weniger Cyber-Sicherheitseingriffe aus, und die Biologie-Sicherheitsmechanismen schlagen bei harmlosen Anfragen 85 % seltener an. Pen-Testing, Exploit-Erstellung und das Scannen von Binärdateien auf Schwachstellen laufen weiterhin über Opus. Beide Modelle stehen neben dem Rest der Reihe – wer die Familienübersicht will, findet in den Beiträgen zu Claude Opus 5 und Claude Sonnet 5 die darunterliegenden Stufen.
Zur Einordnung: So schlägt sich Fable 5.1 (in der Praxis der Ersatz für Mythos) im Vergleich zum Feld anhand der veröffentlichten Werte:
| Benchmark | Fable 5.1 | Fable 5 | Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|
| Terminal-Bench-Science 0.1 | 52.6 | 24.7 | 29.0 | 22.4 |
| GDPval-AA v2 | 1853 | 1723 | 1824 | 1711 |
| AutomationBench | 31.4 | 17.1 | 26.9 | 19.6 |
| CursorBench 3.2.0 | 73.4 | 70.5 | 70.0 | 67.2 |
| HLE with tools | 65.0 | 63.8 | 63.6 | - |
Der Sprung bei Terminal-Bench-Science, von 24,7 auf 52,6, ist der Wert, den ich einem Käufer tatsächlich hervorheben würde. Für einen direkten Vergleich mit der OpenAI-Seite gehen die Beiträge zu GPT-5.6 Sol und GPT-5.6 vs. Claude tiefer, als eine einzelne Zeile es könnte.
Die eigentliche Schlagzeile ist der Cache-Read für 0,25 $
Wenn man nur eine Zahl aus diesem Test mitnimmt, dann diese. Fable 5.1 und Mythos 5.1 bepreisen einen Cache-Hit mit 0,25 $ pro Million Token, das sind 0,025x der Basis-Input-Rate. Jedes andere Claude-Modell verlangt 0,1x, also 1,00 $. Das ist ein Modell zum doppelten Basispreis von Opus 5, das einen Cache-Read zum halben Preis von Opus 5 (0,50 $) anbietet.
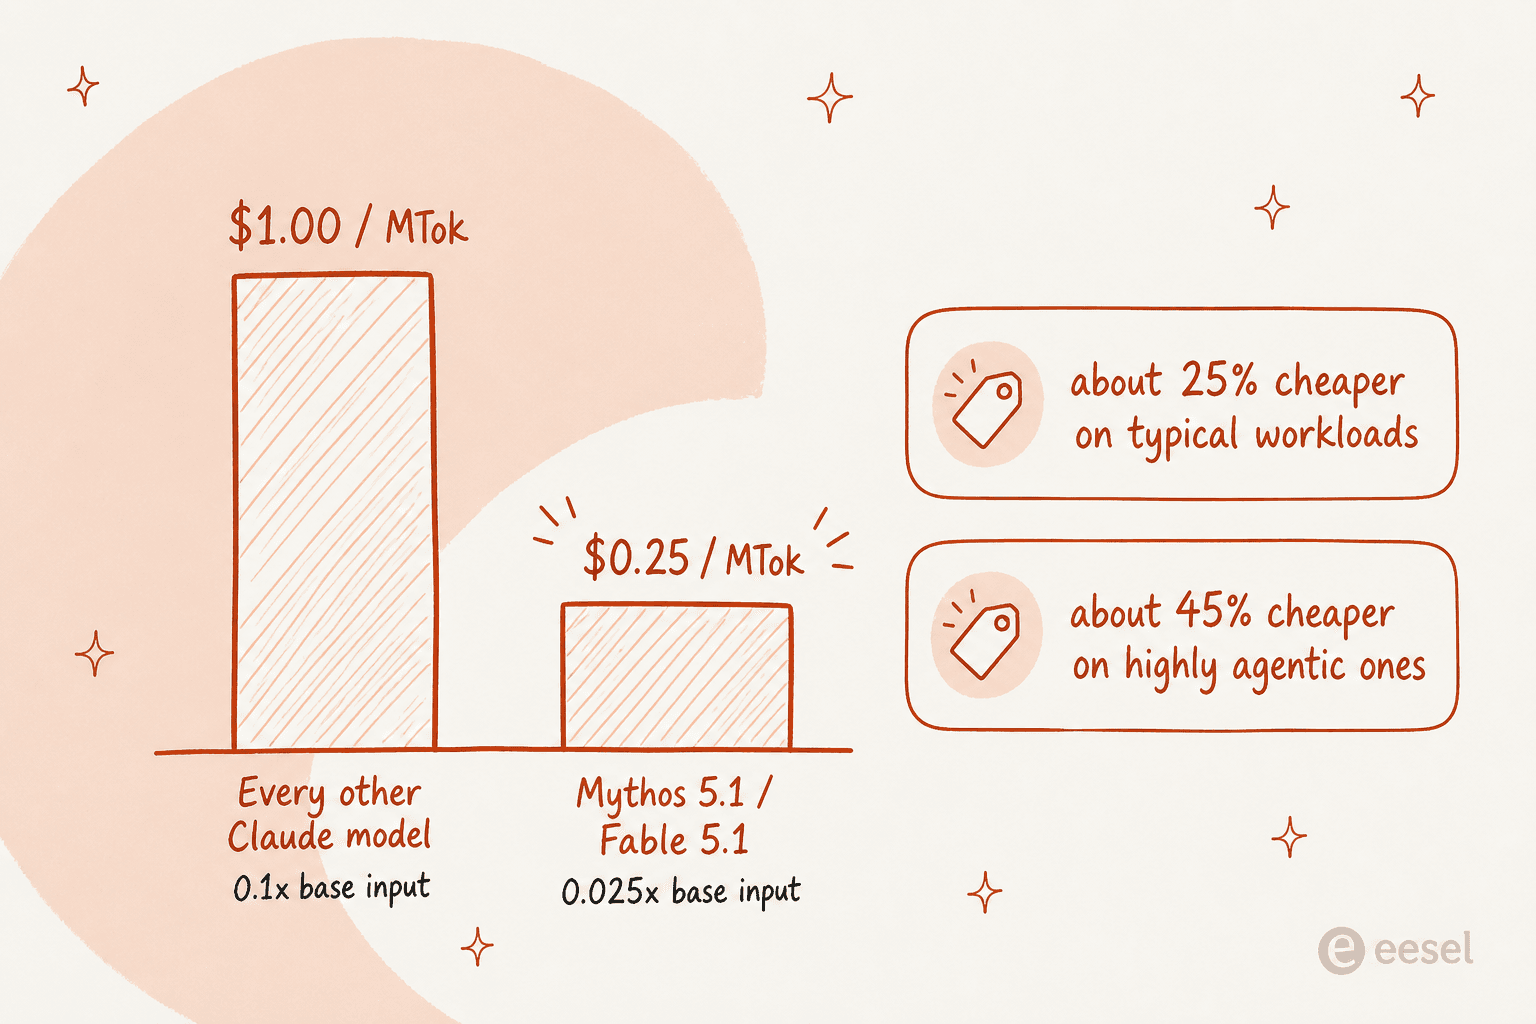
Anthropic hat den Effekt über vier Wochen Nutzung im August 2026 gemessen: rund 25 % günstiger bei typischen Workloads und rund 45 % günstiger bei stark agentischen. Die Basisrate (10 $ Input / 50 $ Output) bleibt unverändert, Batch kostet 5 $ / 25 $, das Fünf-Minuten-Cache-Write kostet 12,50 $, und das Ein-Stunden-Write kostet 20 $. Wer Long-Context-Agenten betreibt, die bei jedem Turn dieselbe Wissensdatenbank erneut einlesen, für den ist das die Zahl, die die Rechnung wirklich bewegt – viel mehr als die Basisrate. Ein Hacker-News-Kommentator hat das laut durchgerechnet:
"Der 0,025x-Cache-Read ist verrückt. Bei einer Trefferquote von 95 % liegen die effektiven Input-Kosten praktisch beim Cache-Preis, man zahlt also Cent-Beträge, um einen riesigen Kontext warmzuhalten."
Wie sich die Cache-Ökonomie in einem echten Agenten-Stack auswirkt, dazu sind der Anthropic-API-Pricing-Guide und die Aufschlüsselung zu Claude-Code-Pricing die Beiträge, die ich als Nächstes lesen würde.
Wer Claude Mythos 5.1 wirklich nutzen kann
Hier wird der Test praktisch – und ein bisschen ernüchternd. Mythos 5.1 ist nichts, das man einfach mit einem API-Key aktiviert. Der Zugang ist heute auf die USA beschränkt und läuft über eines von drei Toren: das Cyber Verification Program (Anthropic sagt, der Mythos-Zugang komme "in naher Zukunft", ist also noch nicht live), eine Life-Sciences-Program-Beta nur auf Einladung, die zusammen mit der US-Regierung aufgebaut wurde, oder ein direktes Gespräch mit dem eigenen Anthropic-, AWS- oder GCP-Account-Team. Zusätzlich setzt die Nutzung von Mythos 5.1 standardmäßig die Zustimmung zu einer 30-tägigen Datenspeicherung voraus.
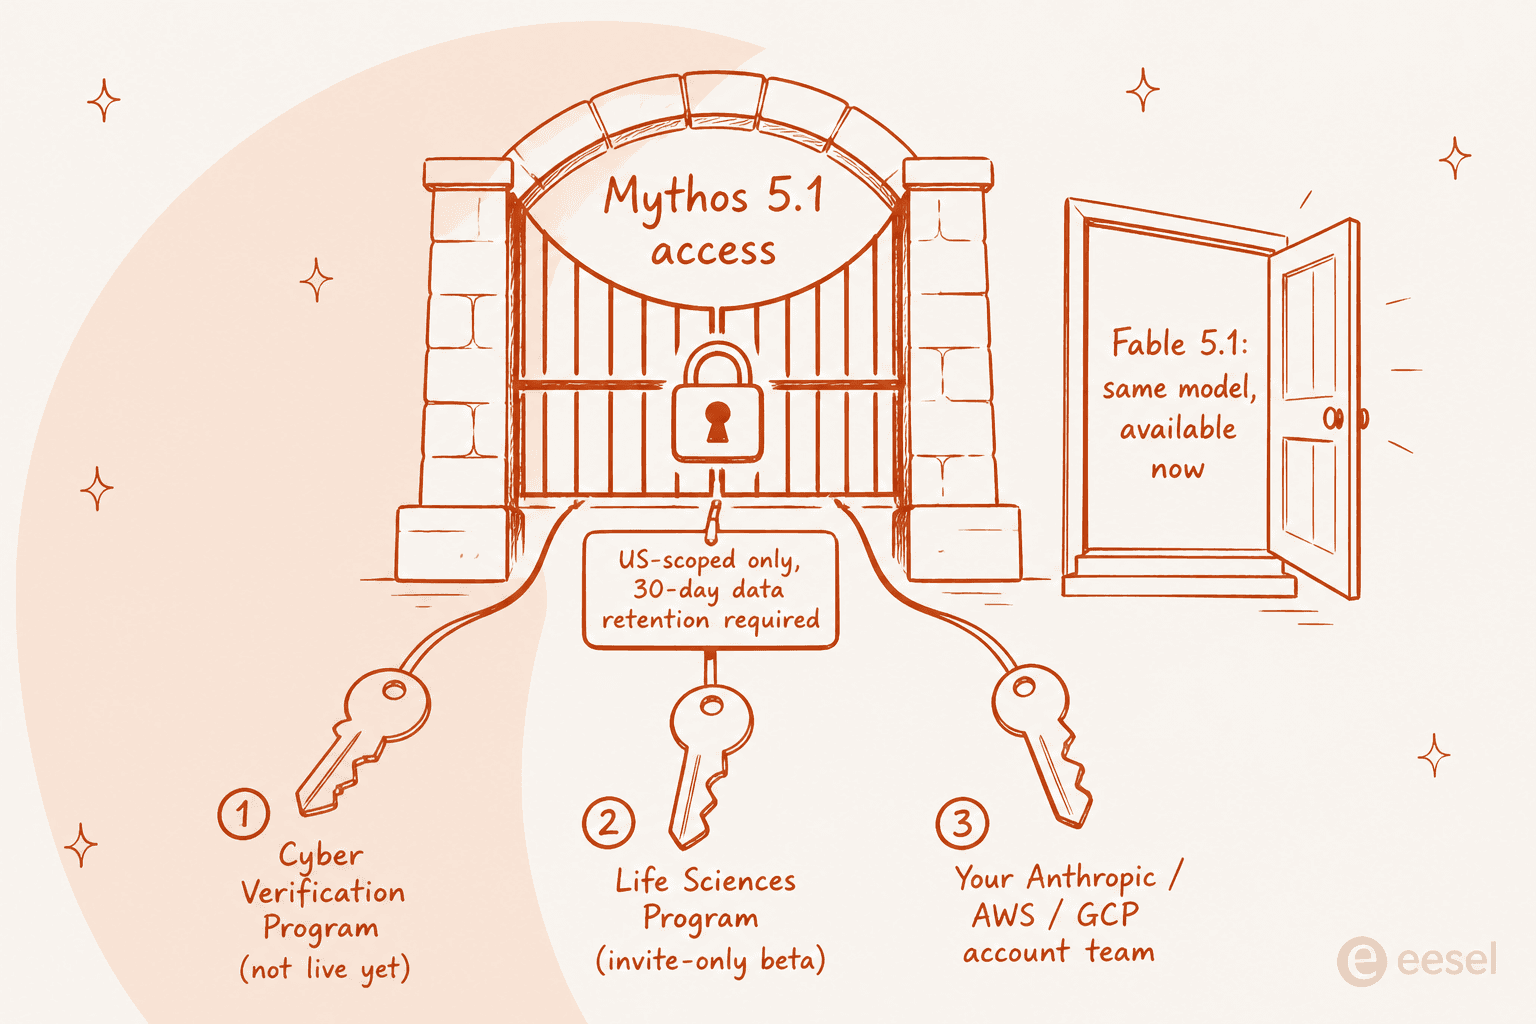
Die ehrliche Antwort auf "Sollte ich Mythos 5.1 nutzen?" lautet also: Für fast alle steht das gar nicht zur Debatte, und die Version, die man nutzen kann, Fable 5.1, ist dasselbe Modell. Das ist kein Makel des Modells, sondern ein Grund, die eigene Bewertung auf das Schwestermodell zu richten, das man tatsächlich einsetzen kann. Wer heute ein Claude-Modell für einen echten Workload auswählt, findet in den Guides zu Claude-Alternativen und dem besten KI-Modell für Support-Tickets die pragmatischeren Lektüren.
Das Datenblatt
Für Käufer, die alle Zahlen an einem Ort wollen: So ist Mythos 5.1 (und damit auch Fable 5.1) ausgestattet:
| Spezifikation | Wert |
|---|---|
| Kontextfenster | 1M Token |
| Maximaler Output | 128K Token |
| Thinking | Adaptiv, immer aktiv; Standard-Effort high |
| Wissensstand | Juni 2026 |
| Latenz | Langsamer |
| Modalität | Text + Bilder zu Text |
| Plattformen | Claude API, Amazon Bedrock, Google Cloud, Microsoft Foundry |
| Abschaltung | Nicht vor dem 1. September 2027 |
Zwei Änderungen für Entwickler sind vor dem Bauen wichtig. Es gibt drei Breaking-API-Changes, die beide Modelle betreffen: erzwungene Tool-Nutzung liefert jetzt einen Fehler, Thinking-Blöcke sind an das Modell gebunden, das sie erzeugt hat, und neue API-Accounts, die ab dem Launch-Tag erstellt wurden, können früheren Kontext nicht mehr bearbeiten, ohne das Thinking-Transkript zu verlieren – ein Anti-Distillation-Schritt. Dazu kommt eine EU-AI-Act-Besonderheit: Modelle, die nach dem 2. August 2026 veröffentlicht wurden, tragen ein unsichtbares Text-Wasserzeichen, mit einer Erkennungs-API in privater Preview. Genau dieses Wasserzeichen hat in der Launch-Diskussion die meisten Wellen geschlagen. Wer ein Claude-Modell in den eigenen Stack einbindet, findet in den Hinweisen zu Claude-Code-Modellauswahl und im Beitrag zu Claude Managed Agents die praktischen Folgeschritte.
Was ich tatsächlich einsetzen würde
Hier ist meine Einschätzung, nachdem ich mich mit dem Launch beschäftigt habe. Mythos 5.1 ist ein großartiges Modell, das man wahrscheinlich nicht nutzen kann, verpackt um eine wirklich großartige Preisänderung, die man nutzen kann. Der richtige Zug ist nicht, der Einladung nachzujagen. Er ist, Fable 5.1 einzusetzen, den Cache-Read für 0,25 $ einzustreichen und die ganze Mythos-gegen-Fable-Rahmung als die Sicherheits-Fußnote zu behandeln, die sie ist.
Und dahinter steckt ein größerer Punkt: "Das Modell ist der leichte Teil." Ein Frontier-Modell, ob Mythos oder Fable, ist Infrastruktur. Es ist kein Support-Agent, kein Researcher und von sich aus kein Teammate. Einen rohen Claude-API-Key neben das eigene Helpdesk zu legen, ergibt einen sehr klugen Textgenerator, der die Rückgaberichtlinie nicht kennt, die letzten 10.000 Tickets nicht sehen kann und keine Möglichkeit hat, getestet zu werden, bevor er mit einem Kunden spricht. Diese Lücke zu schließen ist die eigentliche Arbeit, und es ist dieselbe Arbeit, egal ob darunter Mythos, Fable oder Opus 5 läuft.
eesel für den Teil ausprobieren, den das Modell nicht übernimmt
Wenn der Grund, warum du einen Claude-Mythos-5.1-Test liest, ist, dass du eine klügere KI auf deiner Support-Warteschlange willst, hier die ehrliche Übergabe: Das Modell ist nicht der Flaschenhals, die Verkabelung darum herum ist es. Genau dafür ist eesel da.
Man kann es sich wie eine Neueinstellung vorstellen. eesel ist eine Plattform für KI-Teammates, und der KI-Helpdesk-Teammate steigt in die bestehende Warteschlange ein, bereits trainiert auf vergangene Tickets, das Help Center und Makros, sodass die rohe Intelligenz des Modells auf den tatsächlichen Firmenkontext gerichtet ist statt auf das offene Web. Bevor er je einen echten Kunden beantwortet, lässt sich er gegen die historischen Tickets simulieren, um genau zu sehen, was er gesagt hätte – die eine Gewohnheit, die mein Team schon öfter davor bewahrt hat, eine selbstbewusst falsche Antwort zu versenden, als ich zählen kann. Er verbindet sich in Minuten mit dem Helpdesk, egal ob das Zendesk, Freshdesk, Front, Gorgias oder Help Scout ist.
Und weil ein gutes Stück der Leser eines Modelltests Entwickler sind, sei gesagt: eesel ist nicht nur ein Dashboard. Es gibt eine echte eesel-CLI plus einen MCP-Server, sodass man denselben Teammate vom Terminal aus bedienen, in eigene Workflows einbinden oder von einem Coding-Agenten wie Claude Code steuern lassen kann. Es ist derselbe Teammate, ob man klickt oder headless laufen lässt. eesel lässt sich kostenlos ausprobieren, und wer es lieber erst an den eigenen Tickets sehen möchte, kann eine Demo buchen.
Häufig gestellte Fragen
Was ist Claude Mythos 5.1?
Claude Mythos 5.1 ist Anthropics Frontier-Modell, das am 1. September 2026 veröffentlicht wurde und ohne die Produktions-Sicherheitsmechanismen benchmarkt wird. Es teilt sich dieselben zugrunde liegenden Gewichte wie Fable 5.1, die Version mit aktivierten Sicherheitsmechanismen, die die meisten Menschen tatsächlich nutzen. Den vollständigen Claude-Mythos-Erklärartikel gibt es für den Hintergrund zur ganzen Modellfamilie.
Wie unterscheidet sich Claude Mythos 5.1 von Fable 5.1?
Es handelt sich um dasselbe Modell mit einer anderen Sicherheitsschicht. In meinem Claude-Mythos-5.1-Test ist der einzige messbare Unterschied, dass Fable markierte Aufgaben an ein anderes Modell abgibt, was einige Benchmark-Punkte kostet. Einen tieferen Blick auf das Schwestermodell gibt es im Claude-Fable-5.1-Test.
Wie viel kostet Claude Mythos 5.1?
Die Basispreise liegen bei 10 $ pro Million Input-Token und 50 $ pro Million Output-Token, genau wie bei Fable 5.1. Die eigentliche Neuigkeit ist der Cache-Read für 0,25 $ pro Million Token. Die Aufschlüsselung zu Claude Fable 5.1 Pricing und der umfassendere Claude-Pricing-Guide decken den Rest ab.
Kann jeder Claude Mythos 5.1 nutzen?
Noch nicht. Der Zugang ist auf die USA beschränkt und läuft über das Cyber Verification Program, das Life Sciences Program oder das eigene Anthropic-, AWS- oder GCP-Account-Team, und die Nutzung setzt die Zustimmung zu einer 30-tägigen Datenspeicherung voraus. Wer noch heute ein Claude-Modell einsetzen will, findet in den Guides zu Claude-Alternativen und dem besten KI-Modell für Support-Tickets passende Optionen.
Ist Claude Mythos 5.1 gut für den Kundensupport?
Das Modell ist stark, aber ein rohes Modell ist Infrastruktur, kein Support-Agent. Um ein Claude-Modell auf die eigene Warteschlange zu setzen, braucht es weiterhin Retrieval, Guardrails und Tests – genau das übernehmen die Anbindung von Claude an das Helpdesk und KI-Kundenservice-Software wie eesel für einen.


Article by
Kurnia Kharisma Agung Samiadjie
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.