Was Fable 5.1 wirklich ist
Lassen Sie mich präzise sein, was da gelauncht wurde, denn die Namensgebung wird schnell verwirrend. Claude Fable 5.1 ist der Nachfolger von Fable 5 und die Spitze von Anthropics Modellreihe. Die API-Modell-ID lautet claude-fable-5-1. Es gibt außerdem ein Mythos 5.1, dasselbe zugrunde liegende Modell mit leichteren Schutzmechanismen, das nur ausgewählten Teilnehmern des Project Glasswing (Cyberverteidiger und Biowissenschaftler) zur Verfügung steht. Wenn Sie eine Benchmark-Zahl sehen, handelt es sich um Fable 5.1, sofern Mythos nicht explizit genannt wird.
Die Spezifikationen sind Spitzenklasse: ein 1-Millionen-Token-Kontextfenster zu einheitlichen Preisen pro Token über das gesamte Fenster hinweg, 128k maximale Ausgabe und adaptives Denken, das immer aktiv und über einen effort-Parameter (Standard: hoch) einstellbar ist. Anthropic positioniert es für "anspruchsvolles Reasoning und langfristige agentische Arbeit", und der eigene Hinweis des Unternehmens ist aufschlussreich: für die meisten Aufgaben mit Opus 5 beginnen und erst zu Fable 5.1 greifen, wenn Opus 5 bei hohem Aufwand noch nicht ausreicht. Das ist eine ungewöhnlich ehrliche Empfehlung, und genau zu diesem Rahmen kehrte ich beim Testen immer wieder zurück.
Als Entwickler, der die meiste Zeit damit verbringt, Modelle in ein echtes Produkt einzubinden, interessiert mich nicht die Bestenliste, sondern ob das Modell einen langen, unübersichtlichen Multi-Tool-Lauf durchhält, ohne dass ich es ständig beaufsichtigen muss. Genau darauf zielt Fable 5.1 ab.
Die eine Zahl, die sich bewegt hat: der Preis
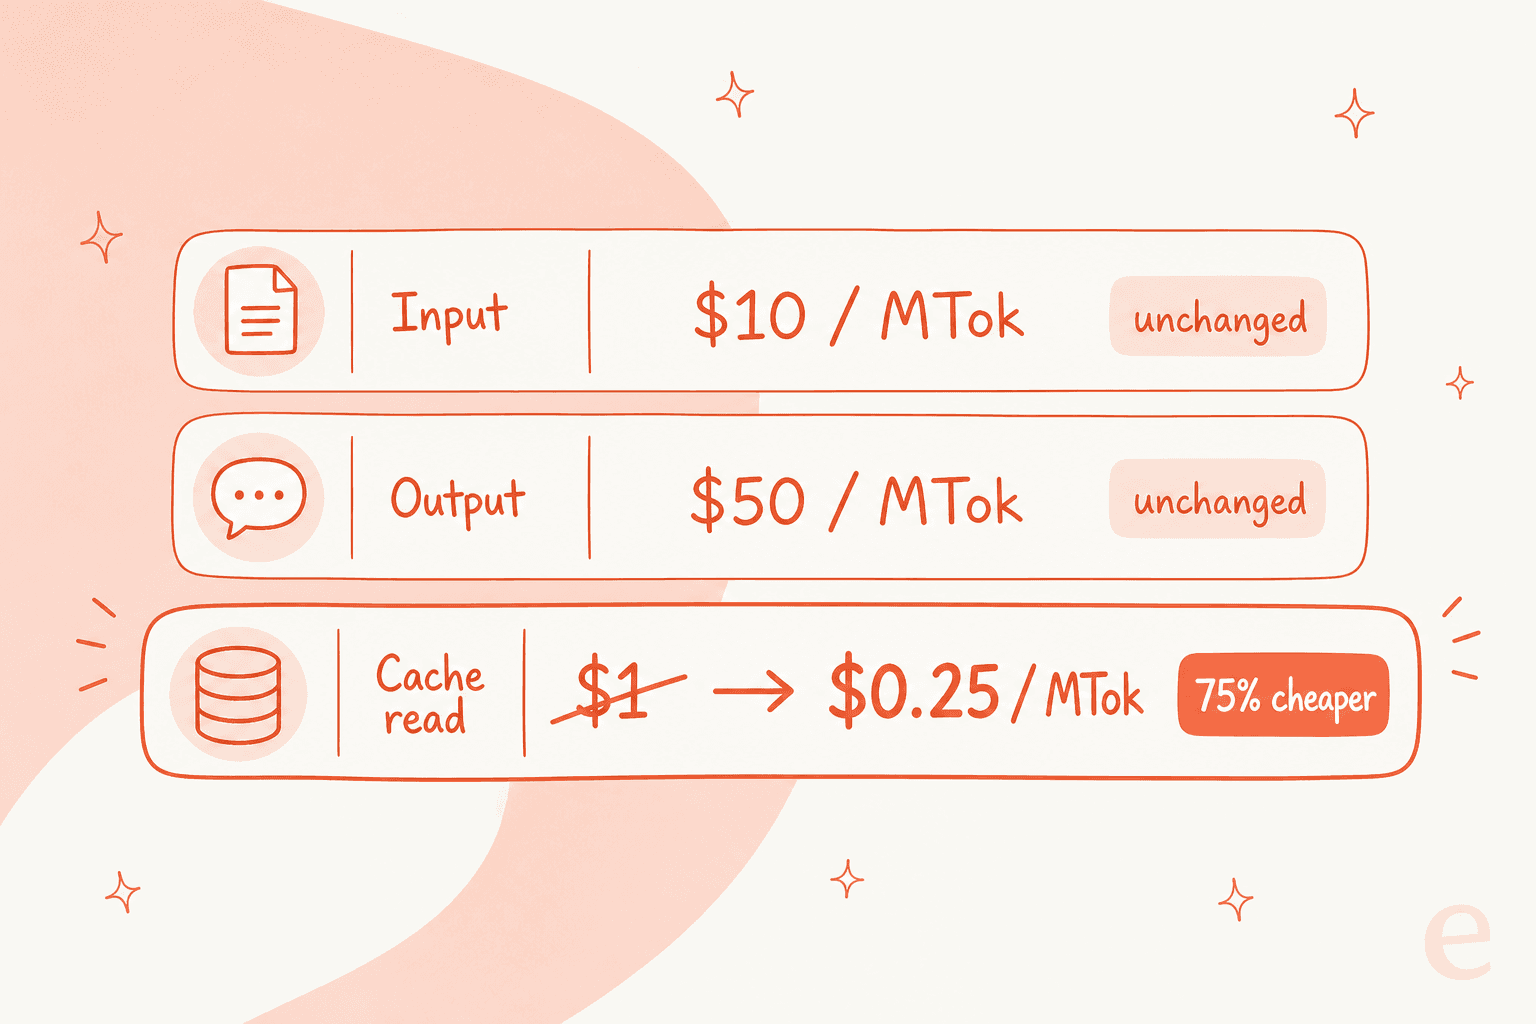
Hier die Preise, denn ein Test, der nur "ab $10" sagt, macht seinen Job nicht richtig.
| Meter | Fable 5.1 | Fable 5 | Änderung |
|---|---|---|---|
| Input (pro MTok) | $10 | $10 | unverändert |
| Output (pro MTok) | $50 | $50 | unverändert |
| Cache-Read (pro MTok) | $0,25 | $1,00 | 75% günstiger |
| Cache-Write, 5-Min (pro MTok) | $12,50 | $12,50 | unverändert |
| Cache-Write, 1-Std (pro MTok) | $20 | $20 | unverändert |
| Batch Input / Output (pro MTok) | $5 / $25 | $5 / $25 | unverändert |
Die Senkung bei Cache-Reads ist die ganze Geschichte bei den Kosten. Anthropic schätzt dass sie die Kosten eines typischen Workloads um rund 25% und die eines stark agentischen um bis zu 45% senkt, da agentische Läufe bei jeder Runde denselben zwischengespeicherten Kontext neu lesen. Zum Vergleich: Fable 5.1s Cache-Read zu $0,25 ist pro Token sogar günstiger als der von Opus 5 mit $0,50, obwohl Opus 5s Basis-Input nur halb so teuer ist. Bei einem cache-lastigen Workload verschiebt sich die Rechnung stärker zugunsten von Fable, als es die Headline-Preise vermuten lassen.
Zwei Vorbehalte, die man vor der Budgetplanung kennen sollte. Nur-US-Inferenz wird mit einem Multiplikator von 1,1x berechnet, und Fable 5.1 ist nicht in der kostenlosen Stufe verfügbar, Sie brauchen Pro, Max, Team oder Enterprise. Der Launch löste auch den erwartbaren Seitenhieb anderer Modelle aus, als ein X-Account darauf hinwies, dass "Fable 5.1 6x mehr kostet als GPT-5.6 Sol". Das stimmt beim Listenpreis, ist aber der falsche Vergleich, wenn Ihr Job ein langer agentischer Lauf ist, bei dem Token-Effizienz und Erfolgsquote über die tatsächliche Rechnung entscheiden.
Die Benchmarks, und wie sehr man ihnen trauen sollte
Auf dem Papier räumt Fable 5.1 ab. Anthropic berichtet, dass es bei jedem veröffentlichten Test führt, und die beiden größten Sprünge gegenüber Fable 5 sind einen genaueren Blick wert.
| Benchmark | Fable 5.1 | Fable 5 | Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|
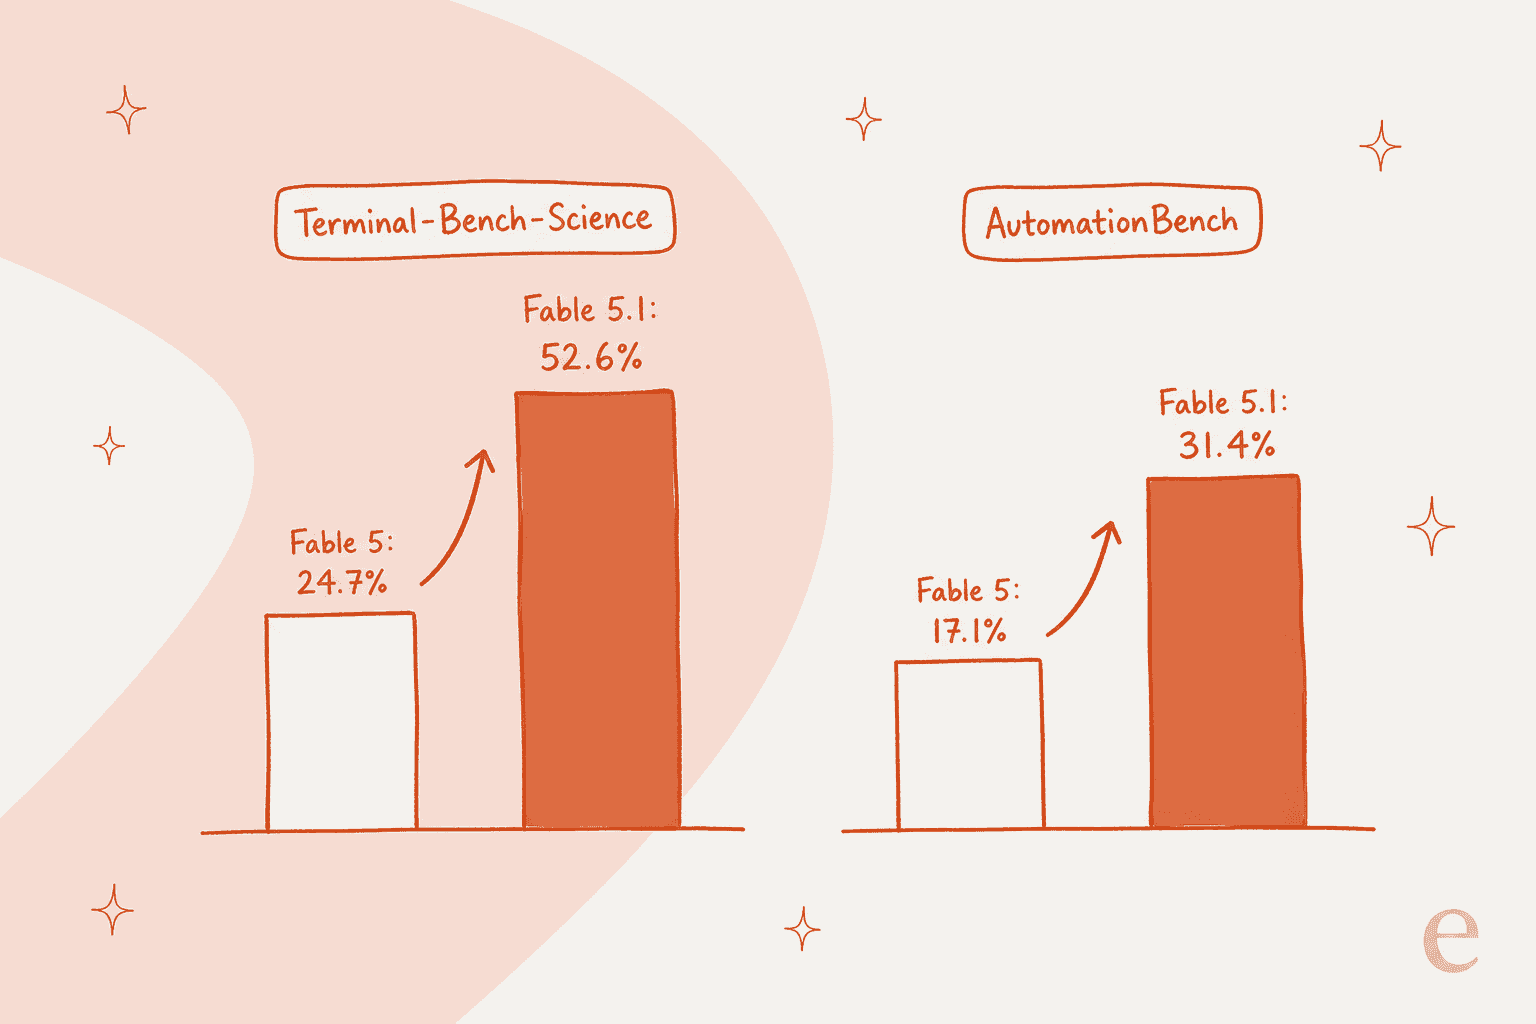
| Terminal-Bench-Science (agentische Wissenschaft) | 52,6% | 24,7% | 29,0% | 22,4% |
| Terminal-Bench 4.0 (agentisches Coding) | 55,8% | 42,0% | 52,3% | 37,3% |
| GDPval-AA v2 (Wissensarbeit, Elo) | 1853 | 1723 | 1824 | 1711 |
| AutomationBench (Geschäftsabläufe) | 31,4% | 17,1% | 26,9% | 19,6% |
| CursorBench 3.2.0 (agentisches Coding) | 73,4% | 70,5% | 70,0% | 67,2% |
| Humanity's Last Exam (mit Tools) | 65,0% | 63,8% | 63,6% | - |
| OSWorld 2.0 partial (Computer-Nutzung) | 77,9% | 72,9% | 75,4% | - |
Der Terminal-Bench-Science-Sprung von 24,7% auf 52,6% ist der Blickfang: agentische wissenschaftliche Forschung hat sich mehr als verdoppelt. Die fast verdoppelte AutomationBench-Zahl ist für den durchschnittlichen Käufer wichtiger, da sie als Stellvertreter für unübersichtliche Geschäftsabläufe dient.
Nun zum ehrlichen Teil, den die Marketingseite größtenteils verschweigt. All diese Fable-5.1-Zahlen wurden mit aktivierten Produktions-Schutzmechanismen erzielt, und Anthropic merkt an, dass Fable 5.1 dort, wo diese Mechanismen eingriffen, null Punkte auf diesen Aufgaben erzielte – die tatsächliche Fähigkeitsobergrenze (angenähert durch das schutzärmere Mythos 5.1, das 60,9% bei Terminal-Bench 4.0 erreicht) also höher liegt. Und es gibt einen Standardfehler von etwa 3,5 bis 4,5 Punkten beim Wissenschafts-Benchmark. Benchmarks sind hier ein Richtwert, kein Maßstab.
Die Skepsis der Community ist gesund, und ich teile sie:
"Wie ist es möglich, dass alle Modelle von xAI, OpenAI, Anthropic, Qwen usw. bei jedem Release alle Benchmarks gewinnen? Morgen werden alle oben genannten (außer natürlich Anthropic) ihre Versionsnummern erhöhen und auf HN alle Benchmarks gewinnen."

Deshalb lege ich mehr Gewicht auf die von Anthropic offengelegten Kunden-Läufe als auf die Bestenliste. Ramp berichtete von einem einzigen unbeaufsichtigten 38-Stunden-Lauf, der ein fehlerhaftes ML-Ergebnis als Label-Artefakt diagnostizierte und sechs Experimente über Nacht anstieß. Millennium gab an, die Ursache eines Eins-zu-einer-Million-Absturzes gefunden zu haben, den kein Ingenieur und kein Modell in vier bis fünf Jahren geknackt hatte. Browserbase erreichte 82% der Aufgaben auf ihrem schwierigsten Browser-Agent-Benchmark gegenüber 74% bei Opus 5 und 57% bei Fable 5, bei geringerem Token-Verbrauch. Das sind die Art von langfristigen Ergebnissen, die eine Benchmark-Zeile nicht einfangen kann.
Was es wirklich gut kann
Drei Dinge fielen auf, und nur eines davon steht auf einer Bestenliste.
Das Schreiben ist die Überraschung. Jahrelang war die größte Beschwerde über Claude, dass sich der Text wie ein Compliance-Memo liest. Fable 5.1 ist die erste Version, bei der sich das umkehrt, und die Reaktion war immediate:
"Als leidenschaftlicher Claude-Code-Nutzer, der wegen schwer lesbarem Text bei Opus 5 zu GPT 5.6 Sol gewechselt ist, macht mich das glücklich. Ich liebe euer Produkt, aber die aktuellen Modelle sind sehr schwer zu bedienen, wenn man viel zwischen Kontexten wechseln muss. Kürze ist entscheidend."
Glean sagte, dass ihre Bewerter die Antworten von Fable 5.1 bei alltäglichem Wissen und Textentwürfen mit etwa 2:1 gegenüber Fable 5 bevorzugten, und Canva nannte die Schreiben "das Herausragende". Wenn Sie beruflich schreiben, ist das die Verbesserung, die mehr zählt als jeder Coding-Score.
Coding hält auch über lange Sitzungen durch. Das ist das Versprechen, und es hält größtenteils. SpaceXAI (Cursor) nannte es das leistungsfähigste Modell, das sie je auf CursorBench 3.2 ausgeführt haben, besonders bei der Überprüfung der eigenen Arbeit, und Red Hat gab an, damit die Ursache jedes getesteten fehlerhaften Builds gefunden zu haben. Die One-Shot-Demos überfluteten X am Launch-Tag, was zwar unterhaltsam ist, aber weniger beweist als die unspektakuläre Arbeit (die Ursache eines Build-Fehlers zu finden, ist der eigentliche Test).
Agentische Läufe bleiben auf Kurs. Every fasste den Effizienzaspekt so zusammen: "Fable-Intelligenz, Opus-Preis, Sonnet-Geschwindigkeit", und maß dabei etwa die doppelte Geschwindigkeit von Opus 5 bei etwa halb so vielen Tokens. Ein Entwickler brachte die praktische Version auf den Punkt:
"ein Prompt, 43 Minuten, $2,96 – claude fable 5.1 hat eine 1.660-zeilige Welt geschrieben"
Wo es hakt
Ein fairer Test benennt auch die Grenzen, und Fable 5.1 hat zwei echte.
Ablehnungen sind weiterhin der größte Schmerzpunkt. Das kam am Launch-Tag immer wieder auf, und es ist nicht die übliche Klage "die KI ist zu vorsichtig", sondern Entwickler, die keine legitime Sicherheitsarbeit an ihrem eigenen Code durchführen können:
"Fable ist nutzlos. Ich: "Finde die Sicherheitsprobleme in meinem eigenen Code. Das ist Code, den ich besitze. Ich mache das mit Genehmigung des CEO/CTO unserer Firma." Fable: "ja, nein.""
Anthropics eigene Darstellung ist, dass die Cyber-Schutzmechanismen jetzt präziser sind, wobei Claude-Code-Nutzer rund 60% weniger Eingriffe pro Sitzung erleben sollen als bei Fable 5, und Fable 5.1 kann Schwachstellen nun defensiv erkennen. Aber Penetrationstests, die Erstellung von Exploits und Binärscans werden weiterhin an Opus-Modelle weitergeleitet, und die Fehlalarme beim eigenen Code sind real. Ein Tester brachte das Vertrauensproblem auf den Punkt: Es "scheint immer noch völlig unfähig zu sein, seine eigenen Leitplanken zu verstehen, und wird sich selbst dazu bringen, sie auszulösen."
Das Wasserzeichen ist ein Vertrauensbrennpunkt. Fable 5.1 versieht jeden Output mit einem statistischen Text-Wasserzeichen, für die Einhaltung des EU AI Act. Es fügt keine zusätzlichen Tokens oder versteckten Zeichen hinzu und kodiert nicht, wer Sie sind, aber es bedeutet, dass Anthropic vom Modell erzeugten Text identifizieren kann, und manche Nutzer sind darüber unwohl:
"Achtung: Die Claude-Fingerprinting-Funktion (Wasserzeichen) ist jetzt mit Fable 5.1 live. Das bedeutet, Anthropic kann von diesem Modell generierten Text identifizieren."

Wenn Herkunftsnachweise für Ihre Organisation wichtig sind, ist das ein Feature. Wenn Sie auf nicht nachweisbaren Output gesetzt haben, ist es ein Ausschlusskriterium. So oder so, wissen Sie jetzt, dass es existiert. Es gibt außerdem einige breaking API changes gegenüber Fable 5 die einen Blick wert sind, wenn Sie auf der API aufbauen: erzwungene Tool-Nutzung entfällt (ein tool_choice von any oder tool liefert jetzt einen 400er), Denk-Blöcke sind modellgebunden, und paralleles Tool-Calling ist variabler.
Wer wirklich danach greifen sollte
Das ehrliche Fazit, nach Anwendertyp:
- Sie führen lange, autonome Agenten-Jobs aus. Ja. Das ist genau das Heimspielfeld dieses Modells, und die Senkung bei Cache-Reads macht stundenlange Läufe erst erschwinglich. Greifen Sie zu.
- Sie schreiben oder leisten intensive Wissensarbeit. Klares Ja bei der Qualität. Der Sprung bei der Textqualität ist real, und die Deck-/Tabellenkalkulationsergebnisse sind die besten, die Anthropic je ausgeliefert hat.
- Sie erledigen alltägliches Coding und Chat. Wahrscheinlich nicht, zumindest nicht standardmäßig. Opus 5 ist günstiger, und Anthropic selbst sagt, man solle dort anfangen. Wechseln Sie zu Fable 5.1, wenn Opus 5 bei hohem Aufwand ins Stocken gerät.
- Sie betreiben Sicherheitsforschung. Testen Sie die Ablehnungen zuerst an Ihrem echten Workflow. Die Präzision hat sich verbessert, aber die Fehlalarme beim eigenen Code sind eine aktuelle Beschwerde.
- Sie wollen einfach einen Support-Agenten oder einen Content-Autor, der funktioniert. Sie kaufen auf der falschen Ebene ein, dazu gleich mehr.
Ein Modell ist kein Teammitglied
Hier ist die Neurahmung, die ich Ihnen mitgeben möchte, denn genau hier gehen die meisten Fragen "welches Modell soll ich kaufen" schief. Fable 5.1 ist ein spektakulärer Motor. Es ist kein Mitarbeiter. Es hat keine Ahnung, was Ihr Produkt macht, kann Ihr Help Center oder Ihre letzten 10.000 Tickets nicht sehen, hat keine Integrationen und keine Möglichkeit, gegen Ihre eigene Historie getestet zu werden, bevor es einen echten Kunden berührt. Rohen Modellzugang zu kaufen, um ein Support- oder Content-Problem zu lösen, ist, als würde man die klügste Person der Welt einstellen und ihr dann null Kontext, null Tools und null Einarbeitung geben.
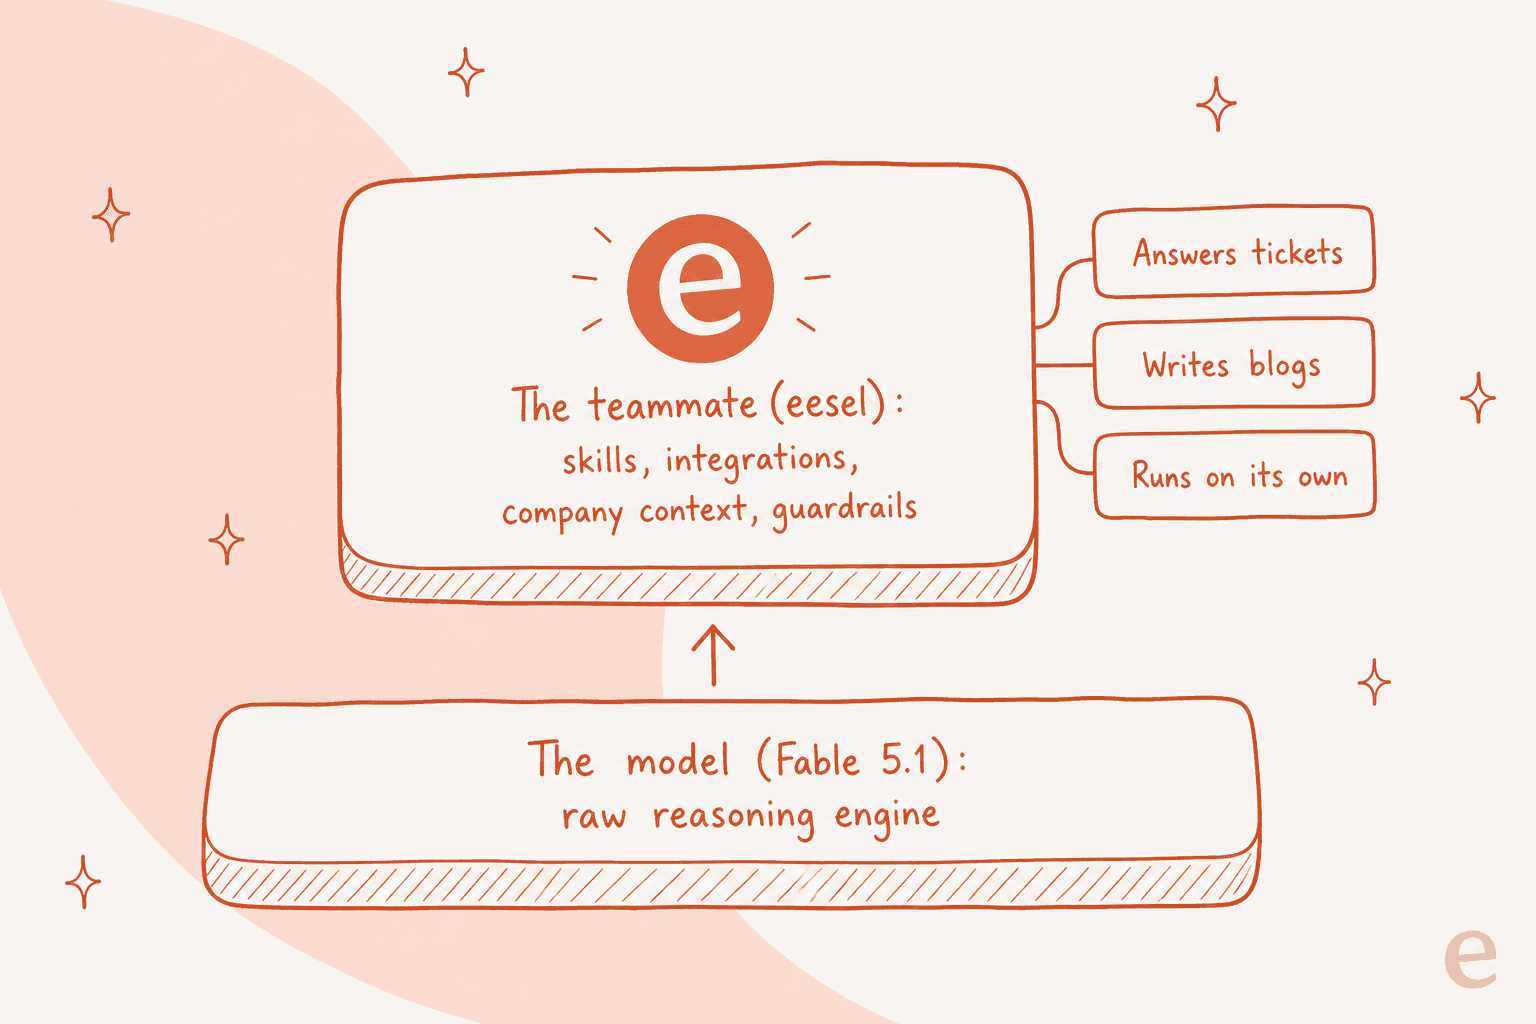
Diese Lücke zwischen "rohem Modell" und "fertigem Teammitglied" ist der ganze Grund, warum eesel existiert. Die Idee ist einfach: Man stellt kein Modell ein, man stellt ein einsatzbereites Teammitglied für einen bestimmten Job ein. Das aktuelle Angebot umfasst ein KI-Helpdesk-Teammitglied, das Ihrer bestehenden Support-Warteschlange beitritt, sowie einen KI-Blog-Autor, und jedes bringt bereits die Fähigkeiten, Integrationen und den Firmenkontext mit, die seine Rolle braucht, angetrieben von einem Spitzenmodell darunter.
Und weil es durchgängig agentenfreundlich ist, sind Sie nicht an ein Dashboard gebunden. Die eesel-CLI lässt eine Person dasselbe Teammitglied vom Terminal aus steuern, lässt Skripte es automatisieren und lässt Coding-Agenten wie Claude Code oder Cursor es programmatisch bedienen, mit MCP und Webhooks daneben. Wenn Ihnen gefallen hat, was Fable 5.1 innerhalb von Claude Code leistet, so richten Sie dieselbe Energie stattdessen auf Ihren Support-Arbeitsbereich statt auf ein neues Repo.
eesel ausprobieren
Wenn Sie hier gelandet sind, weil Sie herausfinden wollen, mit welchem Modell Sie Ihren Kundensupport betreiben sollen, ist die bessere Frage, welches Teammitglied Sie einstellen sollten. eesel ist eine KI-Teamplattform: Das KI-Helpdesk-Teammitglied bindet sich in wenigen Minuten in Tools wie Zendesk, Freshdesk oder Gorgias ein, lernt aus Ihren vergangenen Tickets und Ihrem Help Center und lässt Sie es entscheidend an vergangenen Tickets simulieren, bevor es je einem Kunden antwortet, sodass Sie die Lösungsrate und die Antworten im Voraus sehen, statt einfach einen Schalter umzulegen und zu hoffen.
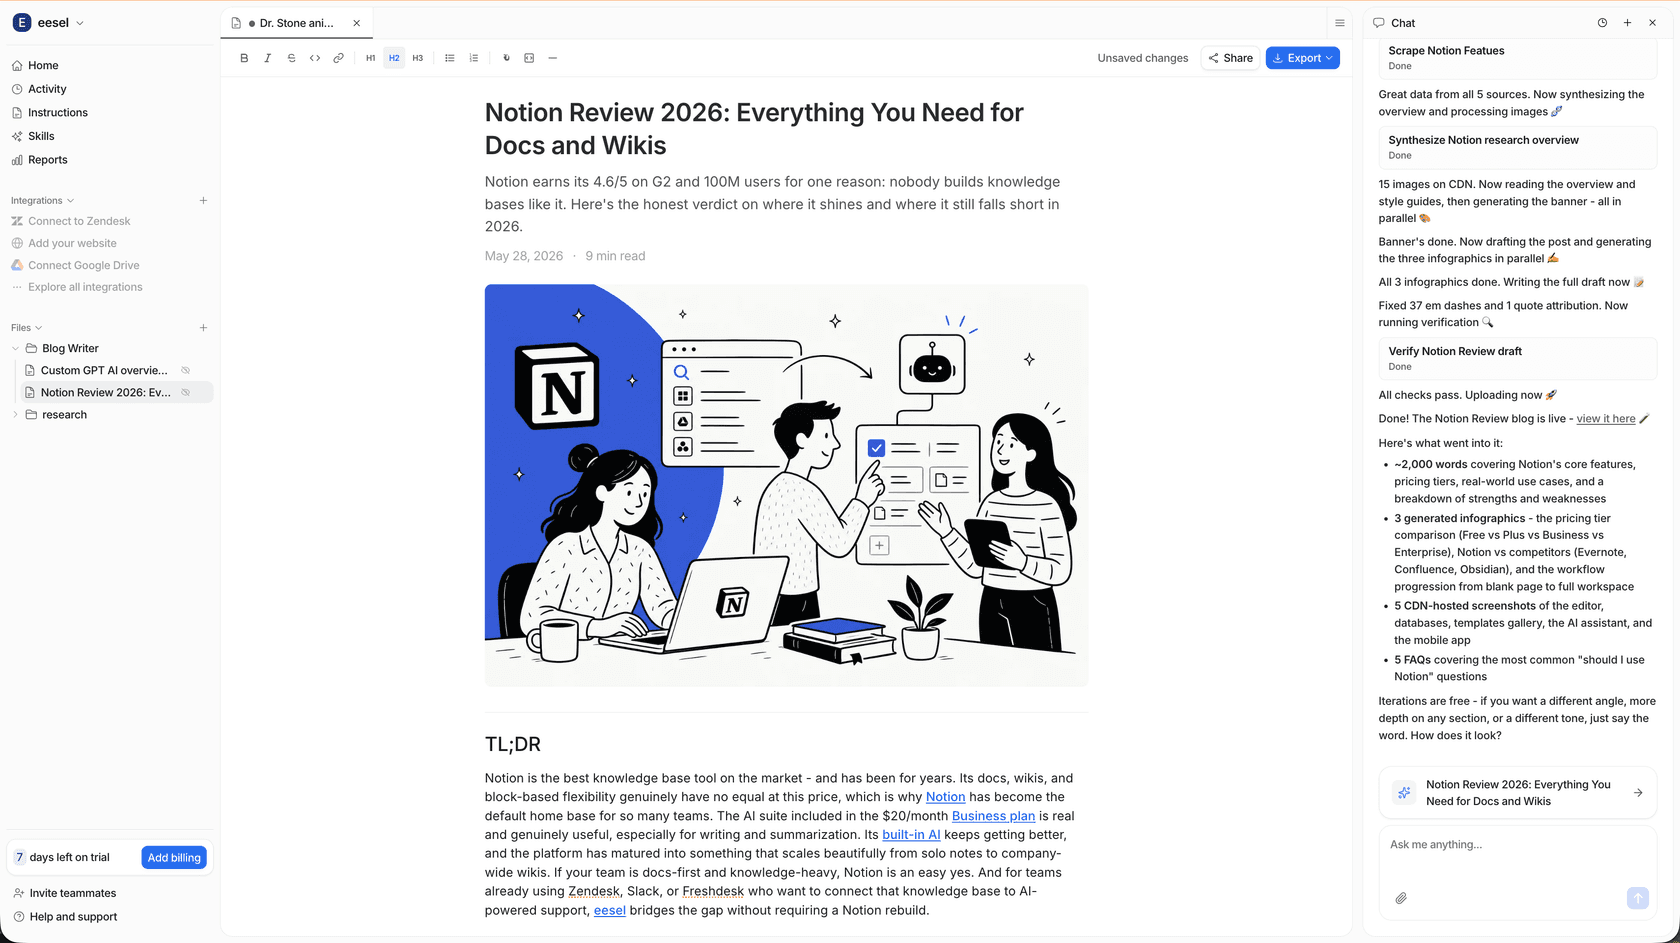
Dieser Schritt, vor dem Launch zu simulieren, ist genau das, was ein rohes Modell wie Fable 5.1 Ihnen nicht bieten kann, und deshalb ist die Wahl des Modells der leichte Teil, während die Wahl des Teammitglieds den Ausgang tatsächlich entscheidet. Sie können eesel kostenlos testen.
Häufig gestellte Fragen
Wie viel kostet Claude Fable 5.1?
Ist Claude Fable 5.1 besser als Opus 5?
Was hat sich bei Claude Fable 5.1 gegenüber Fable 5 geändert?
Lehnt Claude Fable 5.1 zu viel ab?
Brauche ich Fable 5.1, um einen KI-Support-Agenten zu betreiben?


Article by
Rama Adi Nugraha
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.