Kannst du Claude Mythos 5.1 überhaupt bekommen?
Fang hier an, denn für die meisten Leser ist das die ganze Frage.
Claude-Mythos-5.1-Zugangscheck
Wähle die Beschreibung, die am besten zu deinem Team passt. Jede Antwort stammt direkt von Anthropics eigenen Zugangsseiten, Stand September 2026.
Wer bist du?
Vielleicht, aber noch nicht heute
Das Cyber Verification Program ist der Weg. Es gewährt bereits reduzierte Cyber-Schutzmaßnahmen für Modelle der Opus- und Sonnet-Klasse, und Anthropic sagt, dass der Zugang zur Mythos-Klasse in naher Zukunft dazukommt. Bewerbungen laufen über das CVP-Portal.
Heute nutzen: Fable 5.1. Es identifiziert jetzt Software-Schwachstellen im Quellcode, und Claude-Code-Nutzer sehen rund 60 % weniger Cyber-Schutzmaßnahmen-Eingriffe pro Sitzung als bei Fable 5.
Nur auf Einladung
Das Life Sciences Verification Program ist eine nur auf Einladung laufende Beta, gemeinsam mit der US-Regierung aufgebaut, die Biologie-Schutzmaßnahmen für professionelle F&E lockert. Die ersten Teilnehmer sind eingeschrieben; eine breitere Einschreibung ist angekündigt, aber noch ohne Termin.
Heute nutzen: Fable 5.1, dessen Biologie-Schutzmaßnahmen jetzt bei harmlosen elementaren Biologie- und Medizinfragen 85 % seltener greifen. Life-Science-Anfragen auf Forschungsniveau werden weiterhin an Opus weitergeleitet.
Frag dein Account-Team
Claude Mythos 5.1 ist auf der Claude API, Amazon Bedrock, Google Cloud und Microsoft Foundry gelistet, und die Dokumentation sagt, dass du den Zugang über dein Anthropic-, AWS- oder Google-Cloud-Account-Team anfragen sollst. Die Verfügbarkeit ist weiterhin auf eine bestimmte Gruppe von US-Organisationen beschränkt.
Heute nutzen: Fable 5.1 auf derselben Plattform, wobei Enterprise Frontier Safeguards diesen Herbst schrittweise kommen und berechtigten Kunden in der Zwischenzeit Null-Datenaufbewahrung zur Verfügung steht.
Nein, und das wird sich wohl nicht bald ändern
Es gibt keinen Self-Service-Weg zu Mythos 5.1. Beide Programme sind organisationsbezogen, geprüft und auf die USA beschränkt. Weder eine Kreditkarte noch eine Nutzungsstufe bringt dich hinein.
Heute nutzen: Fable 5.1 für die Obergrenze, oder Opus 5 zu 5 $ Input und 25 $ Output – womit Anthropics eigene Dokumentation den meisten Workloads zum Einstieg rät.
Nein, und das willst du auch nicht
Mythos 5.1s zusätzlicher Spielraum liegt in Cybersicherheit und Biologie. Keins von beidem taucht in einer Rückerstattungsanfrage oder einem WISMO-Ticket auf. Es ist zudem das langsamste und teuerste Modell der Familie – in einer Warteschlange, in der Latenz das ist, was der Kunde spürt.
Heute nutzen: Sonnet 5 oder Opus 5 hinter einer Schicht, die dein Produkt tatsächlich kennt. Die Lücke bei einer Support-Warteschlange ist Grounding und Testing, nicht die reine Modellstufe.
Was Claude Mythos 5.1 tatsächlich ist
Claude Mythos 5.1 ist Anthropics Frontier-Modell der Mythos-Klasse, veröffentlicht am 1. September 2026 mit der Modell-ID claude-mythos-5-1. Sein Status in der Dokumentation lautet „Active (invite only)", und eine Abschaltung ist frühestens für den 1. September 2027 zugesichert.
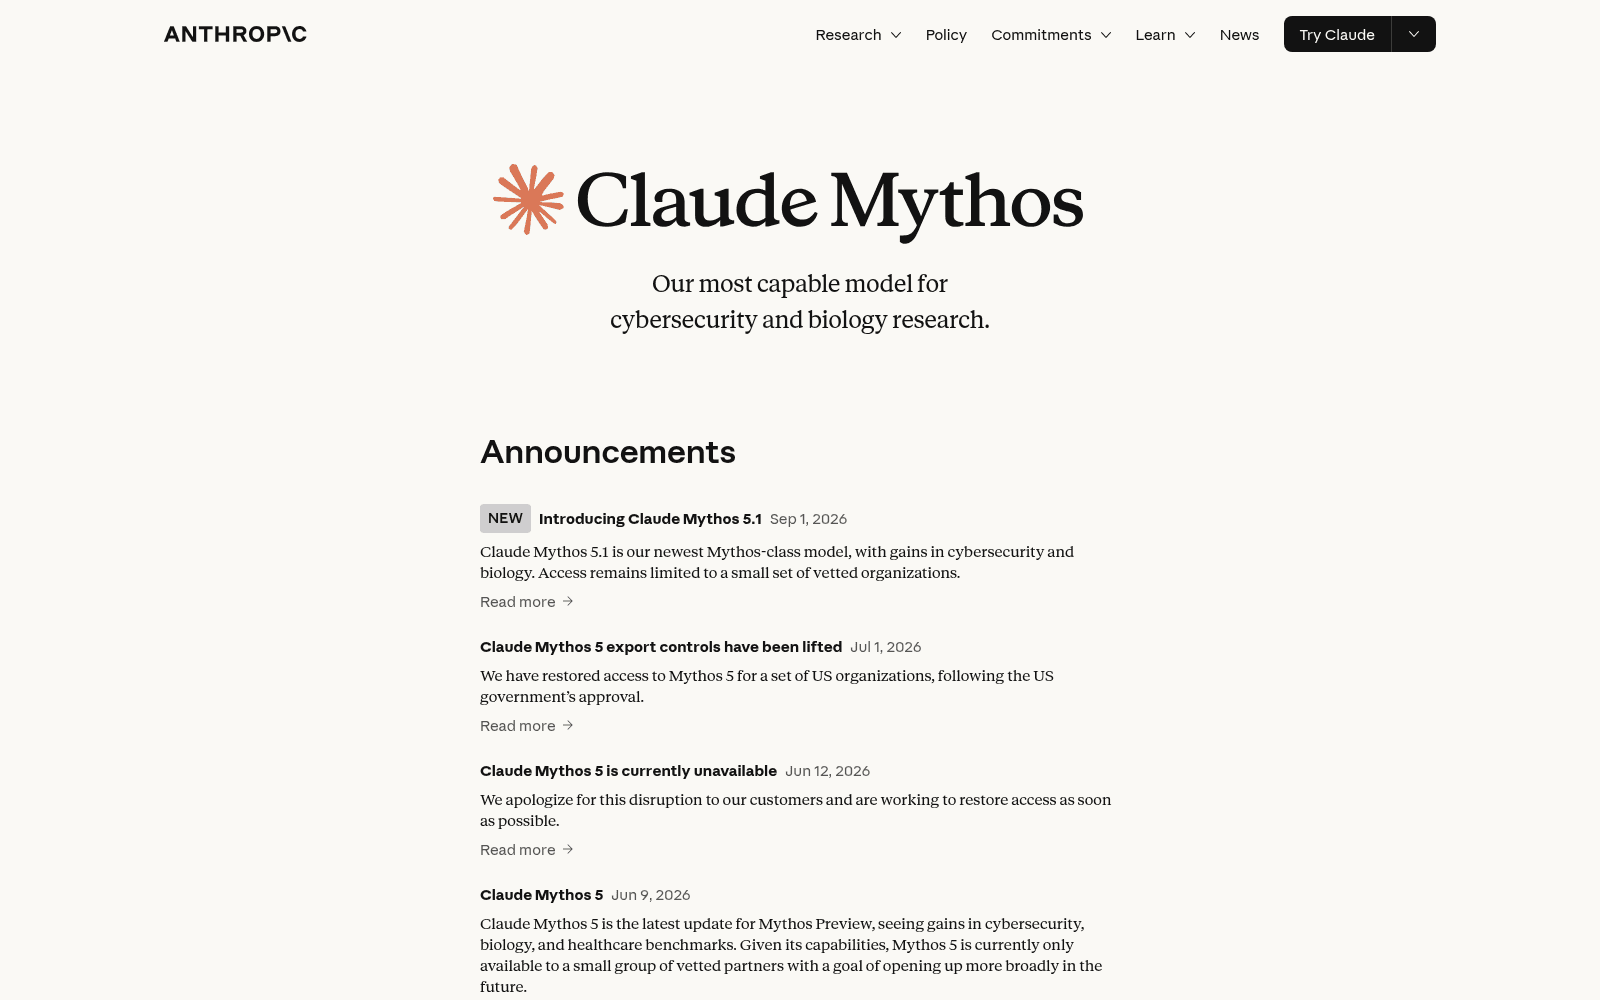
Die Mythos-Reihe begann mit Claude Mythos Preview, dem unveröffentlichten Modell, mit dem Anthropic im April 2026 Project Glasswing startete. Mythos 5 folgte am 9. Juni, wurde am 12. Juni nicht mehr verfügbar gemacht und erhielt am 1. Juli nach Genehmigung der US-Regierung die Aufhebung seiner Exportkontrollen. Mythos 5.1 ist der dritte Eintrag dieser Reihe und der erste, der zusammen mit einem allgemein verfügbaren Zwilling erscheint.
Hier ist das Datenblatt, entnommen der Modellseite und nicht dem Marketingtext.
| Spezifikation | Claude Mythos 5.1 |
|---|---|
| Modell-ID | claude-mythos-5-1 |
| Veröffentlicht | 1. September 2026 |
| Status | Aktiv, nur auf Einladung |
| Kontextfenster | 1 Mio. Token |
| Max. Output | 128K Token |
| Thinking | Adaptiv, immer aktiv |
| Standard-Effort | high |
| Wissensstand | Juni 2026 |
| Vergleichslatenz | Langsamer |
| Input / Output | Text und Bilder, zu Text |
| Input-Preis | $10 / MTok |
| Output-Preis | $50 / MTok |
| Cache-Read | $0.25 / MTok |
| Plattformen | Claude API, Bedrock, Google Cloud, Microsoft Foundry |
| Abschaltung | Nicht vor dem 1. September 2027 |
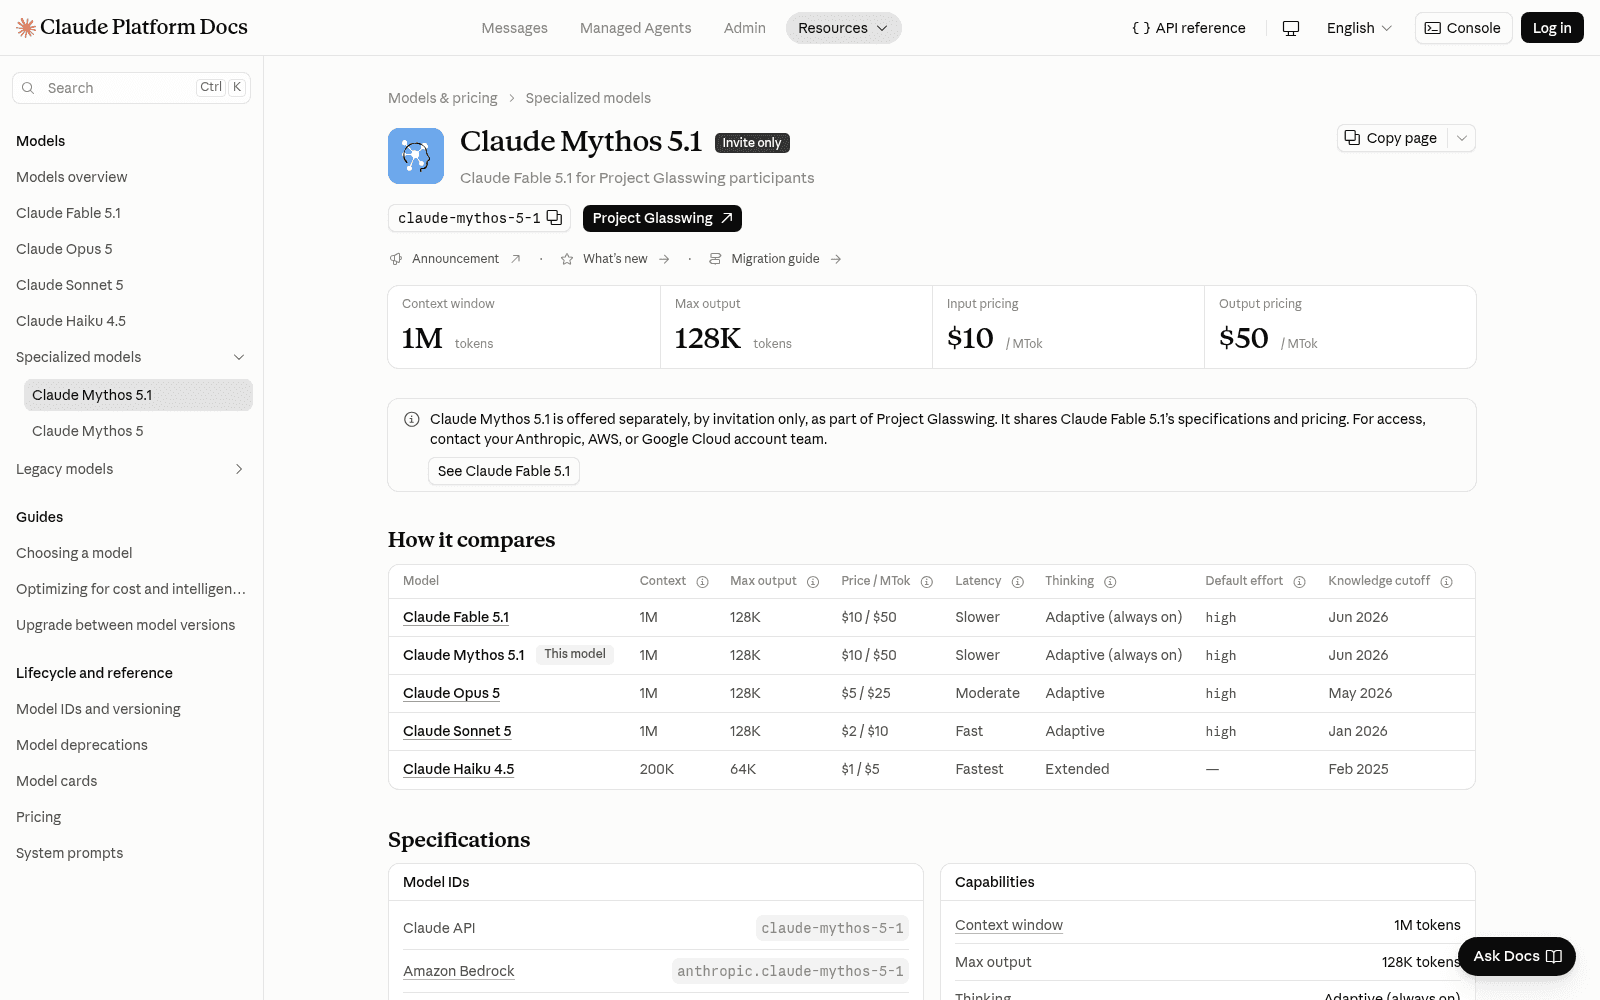
Eine Zeile, die man zweimal lesen sollte: Die Nutzung von Mythos 5.1 erfordert standardmäßig die Zustimmung zu einer 30-tägigen Datenaufbewahrung für die Sicherheitsüberwachung. Das ist eine reale Beschaffungstatsache, und sie ist das Spiegelbild der Null-Aufbewahrungs-Geschichte, die Anthropic auf der Fable-Seite erzählt.
Mythos 5.1 und Fable 5.1 sind ein Modell mit zwei Schlössern
Das ist der Teil, der fast alle verwirrt, einschließlich des Hacker-News-Threads am Launch-Tag:
"Claude Mythos 5.1 is identical to Fable 5.1, but it offers more permissive safeguards for vetted individuals and organizations"
Then why does it have separate datapoints for Terminal Bench, and score higher? Something doesn't add up here??

Es passt tatsächlich zusammen, und die Antwort ist mechanisch statt mysteriös. Anthropic bewertet Fable 5.1 mit aktivierten Produktions-Schutzmaßnahmen. Wenn diese Schutzmaßnahmen bei einer Benchmark-Aufgabe greifen, scheitert die Aufgabe nicht einfach; sie wird an ein anderes Modell übergeben. Cybersicherheitsaufgaben wurden von Opus 4.8 erledigt, Biologieaufgaben von Opus 5, und bei OSWorld 2.0 erzielten die betroffenen Aufgaben eine glatte Null. Die veröffentlichte Fable-5.1-Zahl ist also die Zahl für das gesamte abgesicherte System, nicht für die Gewichte.
Mythos 5.1 sind dieselben Gewichte mit gelockerten Cyber- und Biologie-Klassifikatoren. Das ist die gesamte Differenz.
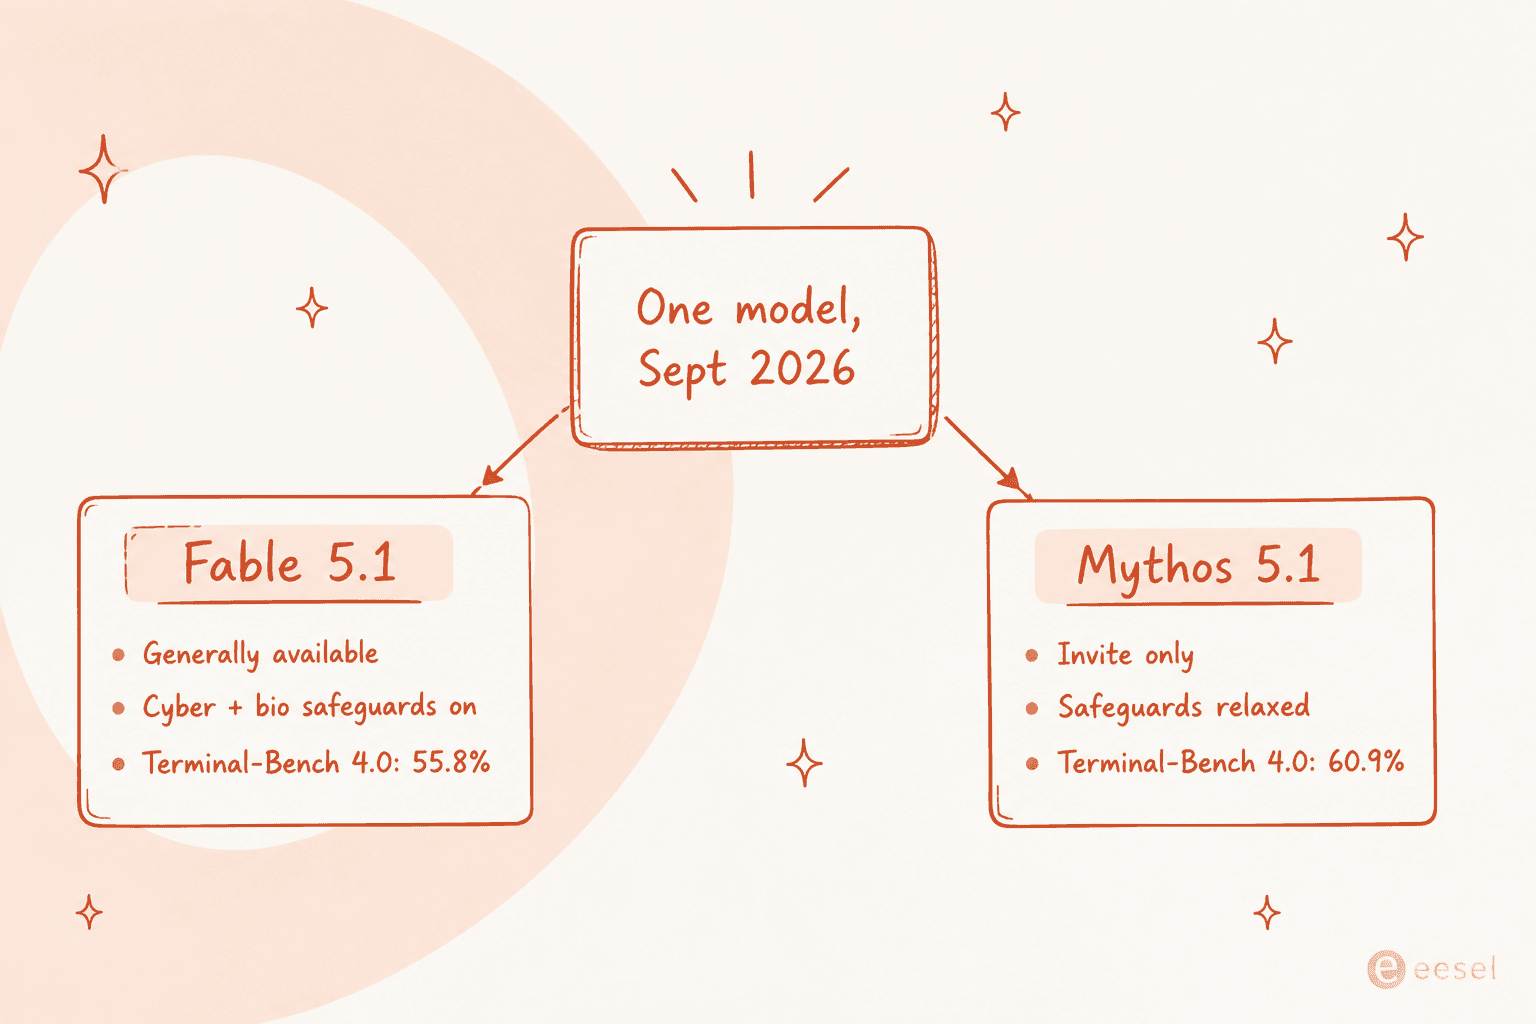
Anthropic sagt ausdrücklich, dass es davon ausgeht, dass sich die Lücke verkleinert. Der Launch-Post merkt an, dass der Terminal-Bench-Unterschied die früheren, weniger präzisen Cyber-Schutzmaßnahmen widerspiegelt, und dass der Unterschied zwischen den beiden Modellen mit den am selben Tag ausgelieferten Fable-5.1-Verbesserungen deutlich kleiner ausfallen sollte.
Was sich auf der Fable-Seite tatsächlich geändert hat, ist es wert zu wissen, selbst wenn du Mythos nie anfasst:
- Fable 5.1 kann jetzt genutzt werden, um Software-Schwachstellen im Quellcode zu identifizieren – das haben die vorherigen Schutzmaßnahmen blockiert.
- Claude-Code-Nutzer sollten rund 60 % weniger Cyber-Schutzmaßnahmen-Eingriffe pro Sitzung sehen.
- Biologie-Schutzmaßnahmen greifen bei harmlosen elementaren Biologie- und Medizinfragen 85 % seltener als die, die mit Fable 5 eingeführt wurden.
- Dual-Use-Arbeiten werden weiterhin an Opus-Modelle weitergeleitet: Penetrationstests, Exploit-Erstellung und binärbasiertes Schwachstellen-Scanning.
Der letzte Punkt ist die ehrliche Grenze. Fable 5.1 liest deinen Quellcode und sagt dir, wo der Bug ist. Es schreibt dir nicht den Exploit.
Die Benchmarks, und die eine, die zählt
Anthropic hat die Zahlen von Fable 5.1 und Mythos 5.1 Seite an Seite mit Fable 5, Opus 5 und GPT-5.6 Sol veröffentlicht. Die Werte unten sind Fable 5.1, sofern die Zeile nichts anderes angibt.
| Benchmark | Fable 5.1 | Fable 5 | Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|
| Terminal-Bench-Science 0.1 | 52.6% | 24.7% | 29.0% | 22.4% |
| Terminal-Bench 4.0 | 55.8% (60.9% Mythos 5.1) | 42.0% | 52.3% | 37.3% |
| GDPval-AA v2 | 1853 | 1723 | 1824 | 1711 |
| OSWorld 2.0 (strict) | 41.7% | 36.1% | 39.6% | not published |
| Humanity's Last Exam (tools) | 65.0% | 63.8% | 63.6% | not published |
| AutomationBench | 31.4% | 17.1% | 26.9% | 19.6% |
| CursorBench 3.2.0 | 73.4% | 70.5% | 70.0% | 67.2% |
Der Ausreißer ist Terminal-Bench-Science, das sich gegenüber Fable 5 mehr als verdoppelt hat. Alles andere ist ein kleinerer Schritt, und der Launch-Thread bemerkte das:
The price reduction comes from the cache read pricing falling from $1/M to $0.25/M, which means that Fable 5.1 now costs half of Opus's cache read costs ($0.5/M).
Diese Lesart ist bei den Coding-Zeilen fair und bei der Science-Zeile weniger fair, wo ein Sprung um 27,9 Punkte kein Rundungsartefakt ist. Anthropic vermerkt in einer Fußnote einen Standardfehler von 3,5 bis 4,5 Punkten pro Modell bei diesem Benchmark, was die Lücke trotzdem deutlich außerhalb des Rauschens belässt.
Die Science-Demos dahinter sind der Teil, den ich tatsächlich als Screenshot festhalten würde. Mythos 5.1 entwarf Protein-Binder, die die besten Einträge in Adaptyv Bios Wettbewerben bei der Bindungsaffinität für drei Zielproteine um das 10-Fache übertrafen, mit einer Trefferquote von fast 50 % über 12 Zielproteine, wo 10 bis 15 % üblich sind. Es schrieb außerdem GPU-Kernel, die sieben Open-Source-Genomik- und Proteinmodelle bei identischen Ergebnissen um bis zu das 2,5-Fache beschleunigten und die geschätzten GPU-Kosten bei genomweiten Analysen um 30 bis 60 % senkten. Getrennt davon erstellte Fable 5.1 aus 30 Jahre alten Magellan-Radardaten eine neue hochauflösende Höhenkarte für ein Drittel der Venus.
Nichts davon ist ein Support-Anwendungsfall. All das ist der Grund, warum das Modell hinter einer Tür sitzt.
Preise: Die Cache-Read-Kürzung ist die eigentliche Neuigkeit
Mythos 5.1 und Fable 5.1 haben dieselbe Preistabelle. Input kostet 10 $ pro Million Token, Output 50 $ pro Million. Das ist unverändert gegenüber Fable 5.
Was sich geändert hat, ist die Cache-Read-Zeile, und zwar deutlich.
| Messgröße | Fable 5 / Mythos 5 | Fable 5.1 / Mythos 5.1 |
|---|---|---|
| Basis-Input | $10 / MTok | $10 / MTok |
| Output | $50 / MTok | $50 / MTok |
| 5-Minuten-Cache-Write | $12.50 / MTok | $12.50 / MTok |
| 1-Stunden-Cache-Write | $20 / MTok | $20 / MTok |
| Cache-Read | $1.00 / MTok | $0.25 / MTok |
| Batch-Input / -Output | $5 / $25 | $5 / $25 |
Jedes andere Claude-Modell berechnet einen Cache-Treffer mit dem 0,1-Fachen des Basis-Inputs. Fable 5.1 und Mythos 5.1 berechnen ihn mit dem 0,025-Fachen, und Anthropics Dokumentation weist in einer Fußnote darauf hin, dass dies die einzige Ausnahme in der Modellfamilie ist. Es ist außerdem, wie der Thread oben anmerkte, halb so teuer wie ein Cache-Read bei Opus 5 – bei einem Modell, das den doppelten Basispreis hat.
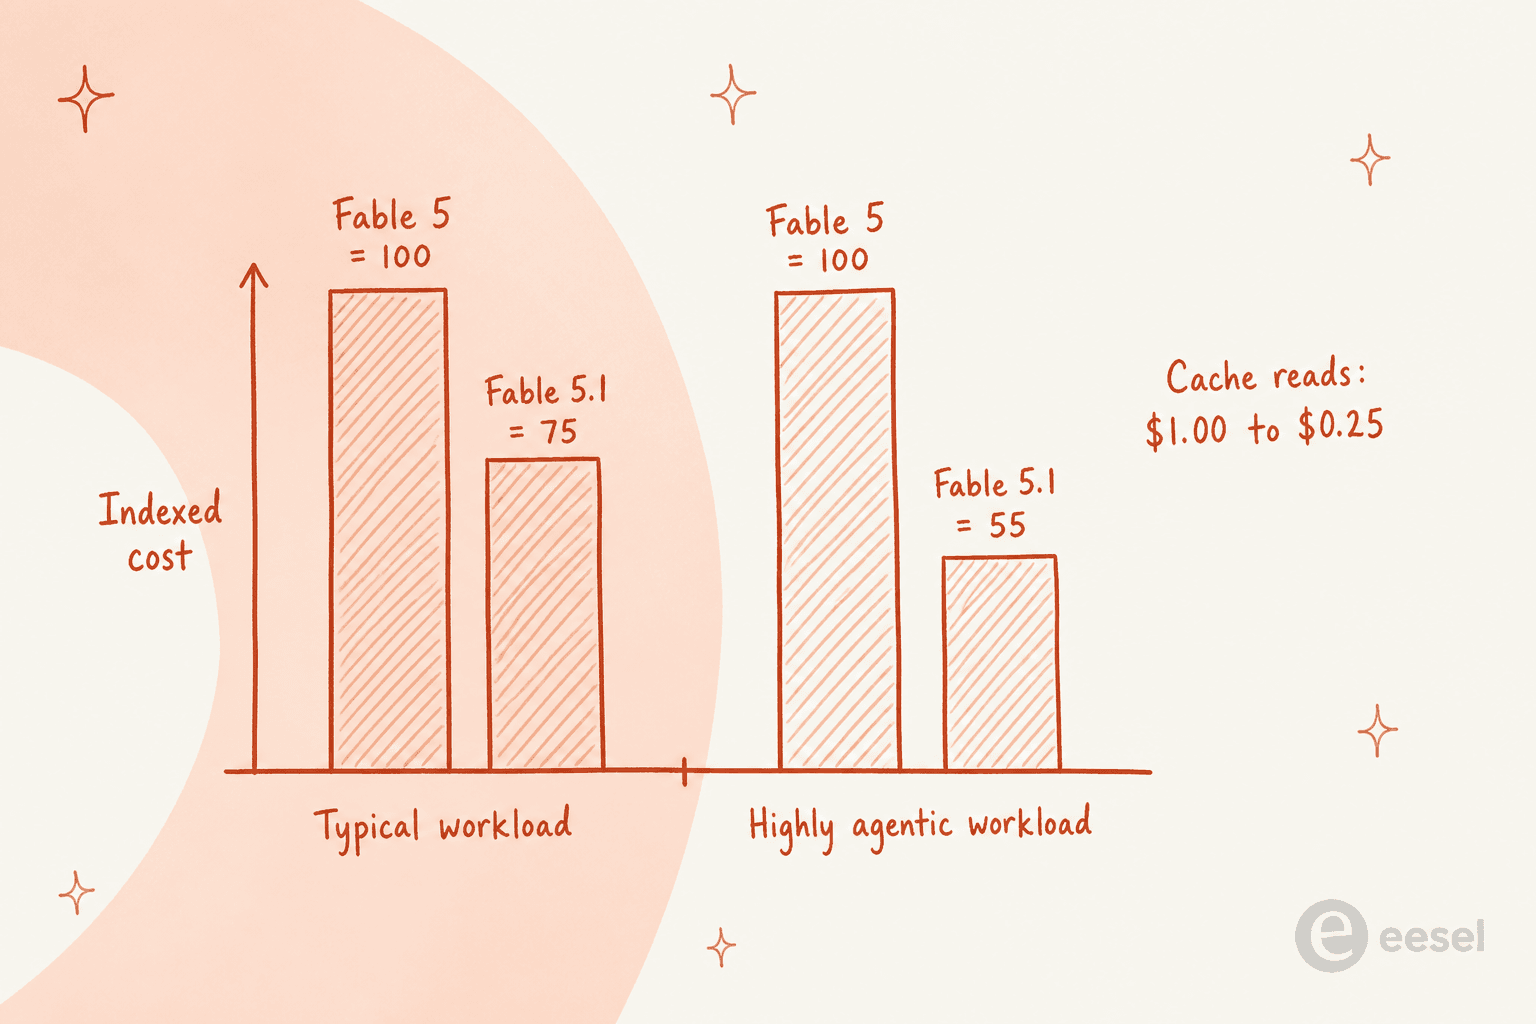
Anthropic hat das über vier Wochen realer Nutzung im August 2026 bei Standard-Effort gemessen. Typische Workloads über Claude Enterprise, Claude Code und die API hinweg werden rund 25 % günstiger. Kontextlastige, toolintensive agentische Arbeit, bei der Cache-Reads den Großteil der Rechnung ausmachen, wird rund 45 % günstiger.
Die praktische Konsequenz ist eine Planungsänderung, nicht nur eine kleinere Rechnung:
"Cache reads now cost 75% less, or $0.25 per million tokens." For me, at a typical 95% cache hit rate, I think my optimal context window size before autocompaction goes from ~200K to ~400K tokens. Great for longer horizon tasks.
Das ist der ganze Sinn der Änderung. Bei einem langen agentischen Durchlauf wird das Transkript bei jedem Turn erneut gelesen, sodass sich der Cache-Read-Zähler aufsummiert. Wenn du Kontext aggressiv komprimiert hast, um die Rechnung niedrig zu halten, hat sich die Rechnung dafür gerade verschoben. Die breitere Preistabelle der Modellfamilie steht in meiner Aufschlüsselung der Anthropic-API-Preise, und die Abo-Seite in den Claude-Preisen.
Eines ändert die Preissenkung nicht: Langer Kontext wird weiterhin pauschal abgerechnet. Claude 4.6 und spätere Modelle rechnen das gesamte 1-Mio.-Fenster zum Standardtarif ab, sodass eine Anfrage mit 900.000 Token pro Token genauso viel kostet wie eine mit 9.000 Token.
Wie der Zugang wirklich funktioniert
Zwei Programme, beide geprüft, beide heute auf die USA beschränkt.
Cyber Verification Program. Das CVP bietet derzeit reduzierte Cyber-Schutzmaßnahmen für bestimmte Modelle der Opus- und Sonnet-Klasse für defensive Sicherheitsarbeit. Anthropic sagt, dass der Zugang zur Mythos-Klasse in naher Zukunft dazukommt – das ist ein Versprechen, kein Datum. Bewerbungen laufen über Anthropics Programs-Portal.
Life Sciences Verification Program. Das LSVP ist eine nur auf Einladung laufende Beta, gemeinsam mit der US-Regierung entwickelt, die Biologie-Schutzmaßnahmen für professionelle Forschung und Entwicklung lockert, während alle anderen Schutzmaßnahmen bestehen bleiben. Die ersten Teilnehmer sind eingeschrieben, und Anthropic sagt, es plane eine Ausweitung auf die breitere Life-Science-Community.
Bestehende Unternehmenskunden haben eine dritte Tür: Die Dokumentation sagt dir, dein Anthropic-, AWS- oder Google-Cloud-Account-Team zu kontaktieren. Und Claude Security, Anthropics Produkt zum Scannen von Codebases, läuft jetzt auf Mythos 5.1 – der einzige Weg, das Modell zu nutzen, ohne direkt dazu eingeladen zu sein.
Der Grund für all das steckt in der Glasswing-Ankündigung vom April 2026. Mythos Preview fand Tausende Zero-Day-Schwachstellen in praktisch jedem großen Betriebssystem und Browser, darunter einen 27 Jahre alten Remote-Absturz in OpenBSD und einen 16 Jahre alten Fehler in FFmpeg, den automatisiertes Testing fünf Millionen Mal getroffen hatte, ohne ihn zu entdecken. Anthropic sagte 100 Mio. $ an Nutzungsguthaben und 4 Mio. $ an Spenden zu und holte zwölf Launch-Partner sowie 40 weitere Infrastruktur-Organisationen an Bord, was sich bis Juni auf rund 150 Organisationen in über fünfzehn Ländern ausweitete.
Auf der Sicherheitsseite lautet Anthropics eigene Einschätzung, dass Mythos 5.1 die stärksten Cyber-Fähigkeiten aller bisher veröffentlichten Modelle besitzt, weiterhin in der niedrigeren Risikokategorie seines Frontier Compliance Framework liegt und die nächste Risikostufe in der Responsible Scaling Policy nicht erreicht. Es wird mit denselben Biologie-Schutzmaßnahmen wie Mythos 5 ausgeliefert.
Drei Änderungen, die irgendjemandes Integration brechen werden
Es lohnt sich, das zu erwähnen, selbst wenn Mythos selbst außer Reichweite ist, denn diese Änderungen betreffen auch Fable 5.1.
- Erzwungene Tool-Nutzung liefert einen Fehler. Wenn dein Code
tool_choiceaufanyoder ein benanntes Tool setzt, schlägt dieser Aufruf jetzt fehl. Das ist die Änderung, bei der am ehesten jemand alarmiert wird. - Thinking-Blöcke sind an das Modell gebunden, das sie erzeugt hat. Frühere Modelle können Thinking-Blöcke von Fable 5.1 oder Mythos 5.1 nicht lesen, und das Bearbeiten eines früheren Turns macht sie ungültig.
- Anti-Distillation verändert das Bearbeiten mehrerer Turns. Neue API-Konten, die ab dem Launch-Tag erstellt wurden, können den vorherigen Kontext von Claude nicht mehr manuell bearbeiten und dabei das Transkript seines vorherigen Thinkings erhalten. Bestehende Konten sind vorerst nicht betroffen, aber die Änderung gilt für alle bei zukünftigen Modell-Releases.
Es gibt außerdem eine Compliance-Änderung mit langer Nachwirkung. Um den Code of Practice zur Transparenz KI-generierter Inhalte des EU AI Act zu erfüllen, tragen Modelle, die nach dem 2. August 2026 veröffentlicht wurden, ein Text-Wasserzeichen, mit einer Erkennungs-API in privater Vorschau für Regulierungsbehörden, Forscher und verpflichtete Unternehmen. Anthropic sagt, es sei ohne die Erkennungs-API unsichtbar und enthalte keine Informationen über den Nutzer oder seine Gespräche. Das sorgte im Launch-Thread für die meiste Aufregung von allem – gut zu wissen, wenn deine Content-Pipeline eine Meinung zur Herkunft hat. Meine Notizen zu KI-Inhalten und E-E-A-T behandeln die Publishing-Seite davon.
Was du stattdessen einsetzen solltest, nach Aufgabe
Fast alle, die das hier lesen, wählen zwischen Modellen, die sie tatsächlich aufrufen können. So würde ich es aufteilen.
- Frontier-Obergrenze, heute verfügbar. Fable 5.1. Dieselben Gewichte wie Mythos 5.1, derselbe Preis, keine Warteliste. Hintergrund dazu in was Claude Fable 5 ist und dem Fable-5-Relaunch.
- Standard-Arbeitspferd. Opus 5 zu 5 $ Input und 25 $ Output. Anthropics eigene Dokumentation sagt weiterhin, die meisten Workloads hier zu starten und nur nach oben zu wechseln, wenn deine Evals nicht ausreichen. Das Opus-5-Review enthält mein Urteil, und die Opus-5-Preise die Tabellen.
- Latenzempfindliche Arbeit. Sonnet 5 zu 2 $ Input und 10 $ Output, mit demselben 1-Mio.-Fenster. Die Sonnet-5-Preise und das Sonnet-5-Review gehen tiefer ins Detail.
- Coding-Agenten. Das Effort-Level beeinflusst deine Rechnung stärker als die Modellstufe. Claude Code Modellauswahl und Claude Code Preise sind die beiden, die man lesen sollte.
- Lang laufende Orchestrierung. Claude Managed Agents berechnet Sitzungslaufzeit zusätzlich zu den Token, was die Cache-Read-Kürzung nicht berührt.
- Das gesamte Feld abwägen. Claude-Alternativen und Opus-5-Alternativen, falls du nicht an Anthropic gebunden bist, sowie GPT-5.6 gegen Claude für den direkten Vergleich.
Wenn die Aufgabe Kundengespräche statt Code oder Forschung sind, ist die Frage der Modellstufe fast irrelevant. Meine Übersicht zum besten Modell für Support-Tickets geht den eigentlichen Trade-off durch, und eigene KI-Modelle behandelt, wann sich ein eigenes Training lohnt.
Was ein Frontier-Modell in einer Support-Warteschlange nicht behebt
Ich möchte hier vorsichtig sein, denn die Ergebnisse von Mythos 5.1 sind real, und die Wissenschaft ist schwer zu bestreiten. Aber es gibt ein Fehlermuster, das ich oft genug beobachtet habe, um es zu benennen.
Ein Team liest einen Launch-Post, upgradet das Modell hinter seinem Support-Bot und erwartet, dass sich die Lösungsquote bewegt. Das tut sie nicht. Was die Lösungsquote bewegt, ist, ob das Modell das richtige Wissen sehen kann, ob es weiß, wann es aufhören und übergeben soll, und ob es jemand gegen echte Tickets getestet hat, bevor ein Kunde es zu sehen bekam. Keins davon sind Probleme der Modellstufe.
Die Vertrauens-Hälfte davon ist die, die Geld kostet. Wie eine CX-Leiterin einer DTC-Nahrungsergänzungsmarke es in einem Sales-Call ausdrückte:
"The AI will never be able to answer 100% of the questions... I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
Das ist ein Scoping- und Kontrollproblem, und ein Terminal-Bench-Score von 60,9 % hat dazu nichts zu sagen. Ebenso wenig der Weg, alles selbst zu bauen, wo viele Teams nach einem Launch wie diesem landen. Karel von GENERAL BYTES brachte den Trade-off klar auf den Punkt:
"We could try to write our own LLM application but we didn't want to invest our time into that. We wanted something that we would not have to maintain."
Der API-Key ist der billige Teil. Das Retrieval, die Berechtigungsgrenzen, die Eskalationsregeln, das Evaluierungs-Framework und die Wartung all dieser vier Dinge, während sich dein Produkt ändert, sind der teure Teil. Diese Arbeit wird nicht billiger, nur weil Cache-Reads es wurden.
Wo eesel ins Bild passt
eesel verkauft KI-Teammitglieder, kein Modell. Das KI-Helpdesk-Teammitglied reiht sich in die Warteschlange ein, die du bereits betreibst, liest das Help Center und die vergangenen Tickets, die du bereits hast, und antwortet innerhalb des Umfangs, den du festlegst. Der KI-Blog-Autor erledigt denselben Job für Content. Beide kommen mit den Integrationen und dem Firmenkontext für ihre Rolle – genau die Schicht, die ein rohes Frontier-Modell nicht mitbringt.

Das Konkrete, worauf ich angesichts des Themas dieses Posts hinweisen würde: Bevor ein eesel-Teammitglied auch nur einem einzigen echten Kunden antwortet, läuft es gegen deine eigenen historischen Tickets, sodass du sehen kannst, was es geantwortet hätte. Das ist der Testlauf, den niemand von einem Modell-Launch bekommt, und das ist der Unterschied zwischen dem Ausliefern eines Upgrades und dem Ausliefern einer Vermutung. Es verbindet sich in Minuten mit Zendesk, Freshdesk, Gorgias, Front, Help Scout und HubSpot, und es ist kostenlos zum Ausprobieren.
Mythos 5.1 für eine Support-Warteschlange hinterherzujagen bedeutet, genau die eine Variable zu optimieren, die nie die Beschränkung war. Claude mit deinem Helpdesk zu verbinden ist ein nützlicherer Nachmittag, und Claude für den Support zu nutzen ist die ehrliche Version dessen, was dir das bringt.
Mein Urteil zu Claude Mythos 5.1
Es ist das leistungsfähigste Modell, das Anthropic ausgeliefert hat, es ist nicht für dich verfügbar, und die Version, die für dich verfügbar ist, ist dasselbe Modell. Das ist eine ungewöhnliche Sache, die man schreiben kann, und es ist die nützlichste einzelne Tatsache in diesem Beitrag.
Wenn du Cyberverteidiger oder Life-Science-Forscher bist, bewirb dich, denn die wissenschaftlichen Ergebnisse rechtfertigen den Papierkram. Wenn du sonst jemand bist, ist der Launch, der zählt, der Cache-Read-Preis von Fable 5.1, der kontextlastige agentische Arbeit still und leise rund 45 % günstiger gemacht hat. Das wird diesem Quartal mehr Produktionssysteme verändern als ein gesperrtes Modell es je könnte.
Häufig gestellte Fragen
Was ist Claude Mythos 5.1?
claude-mythos-5-1. Es ist dasselbe zugrunde liegende Modell wie Fable 5.1, jedoch mit gelockerten Cybersicherheits- und Biologie-Schutzmaßnahmen ausgeliefert, und wird nur auf Einladung über Project Glasswing angeboten. Der frühere Claude-Mythos-Erklärartikel beschreibt, wie die Modellfamilie begann.Was kostet Claude Mythos 5.1?
Wie bekomme ich Zugang zu Claude Mythos 5.1?
Was ist der Unterschied zwischen Claude Mythos 5.1 und Claude Fable 5.1?
Ist Claude Mythos 5.1 auf Bedrock oder Google Cloud verfügbar?
claude-mythos-5-1. Auf der Plattform gelistet zu sein ist nicht dasselbe wie es aufrufen zu können, da weiterhin eine Einladung nötig ist.Was sollte ich stattdessen anstelle von Claude Mythos 5.1 verwenden?
Hat Claude Mythos 5.1 ein 1-Mio.-Kontextfenster?
high. Anthropic berechnet das gesamte Fenster zum Standardtarif, sodass eine Anfrage mit 900.000 Token pro Token genauso viel kostet wie eine mit 9.000 Token. Claude Code Kontextgröße erklärt, was das im Alltag bedeutet.Ist es sicher, Claude Mythos 5.1 auf Kundendaten anzuwenden?


Article by
Alicia Kirana Utomo
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.