Was ist Claude Fable 5.1?
Ich baue die KI-Agenten bei eesel, deshalb ist ein neues Spitzenmodell für mich kein abstraktes Benchmark-Rennen, sondern der Motor, auf dem meine Teamkollegen laufen. Als Anthropic Fable 5.1 am 1. September 2026 veröffentlichte, habe ich als Erstes gelesen, was sich unter dem Marketing tatsächlich geändert hat, und da steckt eine echte Geschichte drin, die über "unser neues Modell führt die Charts an" hinausgeht.
Claude Fable 5.1 ist Anthropics leistungsfähigstes allgemein verfügbares Modell, auf der Produktseite als das weltweit fortschrittlichste Modell für Coding und Wissensarbeit positioniert. Es ist der Nachfolger von Fable 5 und steht ganz oben in der Claude-5-Familie, über Claude Opus 5. Die API-Modell-ID lautet claude-fable-5-1.
Ein paar Eckdaten, die man vorab festhalten sollte:
- Kontextfenster: ein 1M-Token-Fenster, sowohl als Standard als auch als Maximum, mit einheitlichem Preis pro Token über das gesamte Fenster (kein Long-Context-Aufschlag).
- Maximale Ausgabe: 128k Tokens.
- Thinking: Adaptives Thinking ist immer aktiv, und Sie steuern dessen Tiefe über einen
effort-Parameter, der standardmäßig auf hoch steht. - Verfügbarkeit: die API, Amazon Bedrock, Google Cloud Vertex AI und Microsoft Foundry, außerdem Pro-, Max-, Team- und Enterprise-Pläne. Es ist nicht in der kostenlosen Stufe verfügbar.
Es gibt außerdem Claude Mythos 5.1, dasselbe zugrunde liegende Modell mit weniger strengen Schutzmechanismen, nur für Teilnehmer von Project Glasswing verfügbar (geprüfte Cyberverteidiger und Biowissenschaftler). Für fast alle anderen ist Fable 5.1 das Modell, das Sie tatsächlich aufrufen werden.
Ein ehrlicher Hinweis, versteckt in Anthropics eigener Anleitung: Man rät dazu, bei den meisten Workloads mit Opus 5 zu beginnen und erst zu Fable 5.1 zu greifen, wenn Opus 5 mit höherem Effort immer noch nicht ausreicht, oder für die ambitioniertesten lang laufenden Projekte. Das ist ein erfrischendes Stück "überzahlen Sie nicht für unser Flaggschiff", und es sollte prägen, wie Sie über dieses Modell denken. Es ist ein Spezialwerkzeug, nicht die Standardwahl.
Was sich gegenüber Fable 5 tatsächlich geändert hat
Das ist der Teil, den ich wirklich clever finde, und es ist keine Benchmark-Zahl. Fable 5.1 behält jede Basisrate von Fable 5 identisch bei und macht dann leise genau den einen Zähler, der agentische Rechnungen dominiert, um 75% günstiger.
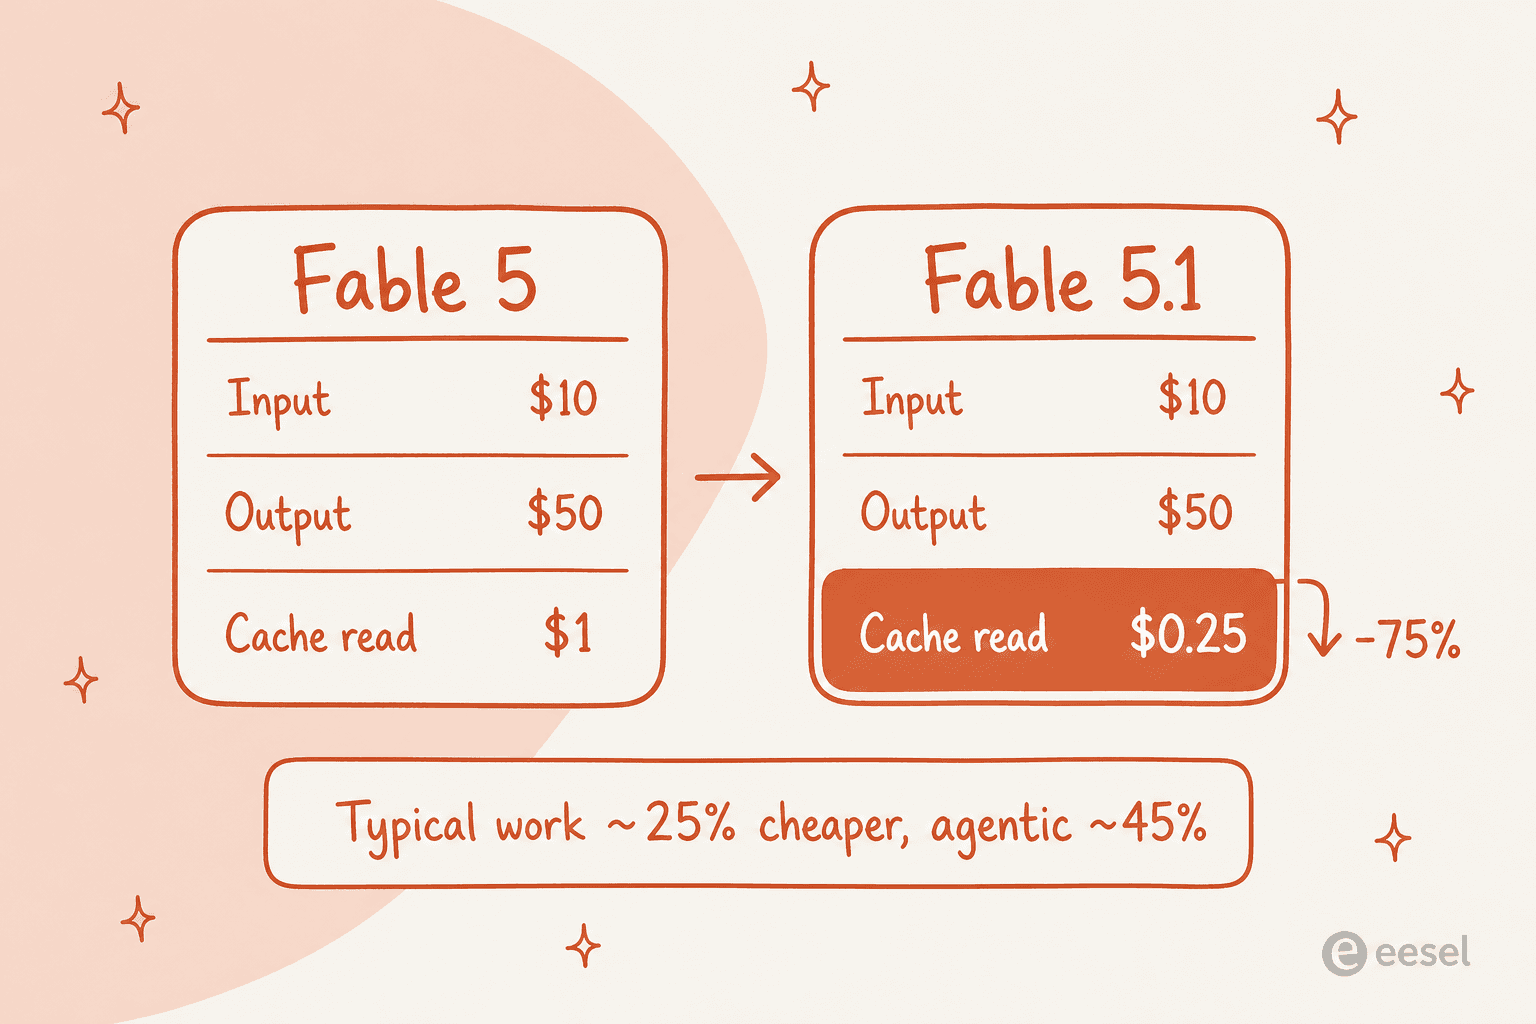
Cache-Reads sind von 1 $ auf 0,25 $ pro Million Tokens gesunken. Wenn Sie noch nie einen Agent-Loop betrieben haben, der ins Gewicht fällt, klingt das nach einem Rundungsfehler. Ist es nicht. Eine lange agentische Session liest bei jedem einzelnen Schritt denselben gecachten Präfix erneut (Ihren System-Prompt, Ihre Codebasis, Ihren Ticket-Verlauf), sodass sich Cache-Reads weit schneller anhäufen als frischer Input. Anthropic hat vier Wochen echter Nutzung vom August 2026 gemessen und beziffert die effektive Ersparnis auf rund 25% bei typischen Workloads und bis zu 45% bei stark agentischen.
Der Entwickler Lance Martin brachte den Wertaspekt am Launch-Tag pointiert auf den Punkt:
"Fable 5.1 at low effort is often competitive with Opus and Sonnet on $ / task while scoring higher. on CursorBench 3.2.0, Fable 5.1 at low effort is at parity w/ Fable 5 at high effort at a third of the cost."
Über den Preis hinaus konzentrieren sich die Fähigkeits-Gewinne laut Docs auf sechs Bereiche: agentisches Coding über mehrstündige Sessions, Wissensarbeit (Dokumente, Tabellen, Präsentationen), mehrstufige Recherche, Vision bei dichten PDFs und Diagrammen, Reasoning über das gesamte 1M-Fenster und Computer-Nutzung. Die mehrsprachige Leistung liegt auf Höhe von Fable 5, ist also kein Gewinnbereich, und es ist gut, dass Anthropic das offen sagt, statt zu suggerieren, alles sei besser geworden.
Zwei weitere Änderungen sind für alle relevant, die darauf aufbauen:
- Ein Text-Wasserzeichen (neu). Jede Textausgabe trägt jetzt Anthropics statistisches Text-Wasserzeichen zur Einhaltung des EU AI Act. Es fügt keine zusätzlichen Tokens oder versteckten Zeichen hinzu, macht die Ausgabe aber als Claude-generiert erkennbar.
- Breaking API-Änderungen. Erzwungene Tool-Nutzung ist weg (ein
tool_choicevonanyodertoolliefert jetzt einen 400er-Fehler), Thinking-Blöcke sind modellgebunden, und das Bearbeiten früherer Turns macht Thinking ungültig. Wenn Sie Ihre eigene agentische Coding-CLI oder Tool-Loop verdrahten, lesen Sie vor dem Upgrade die Migrationshinweise.
Claude Fable 5.1: die Preise
Fassen wir die komplette Preistabelle an einem Ort zusammen. Alle Preise sind pro Million Tokens (MTok), in USD, aus den Plattform-Preisdokumenten.
| Kennzahl | Claude Fable 5.1 | Claude Fable 5 (vorher) |
|---|---|---|
| Basis-Input | $10 | $10 |
| Output | $50 | $50 |
| Cache-Reads | $0.25 | $1 |
| 5-Min.-Cache-Writes | $12.50 | $12.50 |
| 1-Std.-Cache-Writes | $20 | $20 |
| Batch (Input / Output) | $5 / $25 | $5 / $25 |
Die einzige Zeile, die sich bewegt hat, sind die Cache-Reads. Alles andere ist identisch zu Fable 5. Es gibt außerdem eine reine US-Inferenz zum 1,1-fachen Preis für Workloads, die in den USA bleiben müssen.
Wo steht Fable 5.1 damit im Vergleich zum Rest der aktuellen Modellreihe?
| Modell | Input | Cache-Read | Output |
|---|---|---|---|
| Claude Fable 5.1 | $10 | $0.25 | $50 |
| Claude Opus 5 | $5 | $0.50 | $25 |
| Claude Sonnet 5 | $2 | $0.20 | $10 |
Fable 5.1 ist bei Basis-Input und -Output weiterhin das teuerste aktuelle Claude-Modell, 2x Opus 5 und 5x Sonnet 5. Aber sein Cache-Read zu 0,25 $ ist pro Token tatsächlich günstiger als bei Opus 5 mit 0,50 $. Genau das ist der Sinn der Änderung: Sie macht ein Flaggschiff-Modell wirtschaftlich für die wiederholten Re-Reads, die agentische Arbeit ausmachen.
Ein Rechenbeispiel. Angenommen, ein Agent liest bei jedem von 1.000 Tool-Aufrufen in einer langen Session denselben gecachten Kontext von 150k Tokens erneut. Das sind 150 Mio. Cache-Read-Tokens. Bei Fable 5 kostet das 150 $; bei Fable 5.1 kostet dieselbe Arbeit 37,50 $. Multipliziert über eine ganze Flotte von Agenten, die den ganzen Tag laufen, sieht der Trick "gleiches Modell, günstigerer Cache" nicht mehr nach Rundungsfehler aus.
Ein Vorbehalt aus der Community: Selbst auf den obersten Verbraucher-Plänen berichten Nutzer, dass sie bei Fable-Klasse-Modellen schnell an Nutzungsgrenzen stoßen, was ein separates Thema zur Token-Preistabelle ist. Für die genauen Pro-, Max- und Team-Abopreise prüfen Sie direkt claude.com/pricing sowie unsere Aufschlüsselung zu Claude-Pro-Preisen für die Verbraucherperspektive.
Wenn Sie anbieterübergreifend vergleichen, nutzen unsere Leitfäden zu Gemini-Preisen, GPT-5.3-Codex-Preisen und Gemini im Überblick dieselbe Perspektive.
Was Claude Fable 5.1 tatsächlich kann
Anthropic berichtet, dass Fable 5.1 jeden gelisteten Benchmark anführt. Hier die Werte, die etwas aussagen, allesamt mit aktivierten Produktions-Schutzmechanismen erstellt (mehr zu diesem Vorbehalt weiter unten).
| Benchmark (was gemessen wird) | Fable 5.1 | Fable 5 | Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|
| Terminal-Bench-Science 0.1 (agentische Recherche) | 52.6% | 24.7% | 29.0% | 22.4% |
| Terminal-Bench 4.0 (agentisches Coding) | 55.8% | 42.0% | 52.3% | 37.3% |
| AutomationBench (Geschäftsprozesse) | 31.4% | 17.1% | 26.9% | 19.6% |
| OSWorld 2.0, partiell (Computer-Nutzung) | 77.9% | 72.9% | 75.4% | - |
| Humanity's Last Exam, mit Tools | 65.0% | 63.8% | 63.6% | - |
| CursorBench 3.2.0 (agentisches Coding) | 73.4% | 70.5% | 70.0% | 67.2% |
Die auffälligsten Sprünge sind Terminal-Bench-Science (von 24.7% auf 52.6%, mehr als verdoppelt) und AutomationBench (von 17.1% auf 31.4%). Beide zeigen in dieselbe Richtung: Dieses Modell ist deutlich besser in langer, selbstgesteuerter Arbeit geworden.
Jetzt der ehrliche Teil, denn Benchmark-Tabellen am Launch-Tag verdienen immer eine Prise Skepsis. Ein Hacker-News-Kommentator hat den stillen Teil laut ausgesprochen:
"There are hundreds of benchmarks. You just need to pick a favorable dozen on release day."

Fair. Was mich mehr überzeugt hat als die Tabelle, waren die echten, überprüfbaren Langzeit-Läufe aus der Ankündigung. Ramp ließ es 38 Stunden unbeaufsichtigt an einem Machine-Learning-Problem laufen, wo es ein früheres Ergebnis als Label-Artefakt diagnostizierte, korrigierte und sechs parallele Über-Nacht-Experimente startete. Millennium berichtete, dass es die Ursache eines Ein-zu-einer-Million-Läufe-Absturzes fand, den weder Ingenieur noch Modell in vier bis fünf Jahren geknackt hatten. Und auf Browserbases härtestem Browser-Agenten-Benchmark schloss es 82% der Aufgaben ab gegenüber 74% bei Opus 5 und 57% bei Fable 5, mit weniger Tokens. Das ist die Art von Ergebnis, die ein Benchmark-Wert nicht ganz vermitteln kann.
Praktiker, die es testeten, bestätigten die Coding-Geschichte:
"I've tested Claude Fable 5.1 over the last week. Everyone should try this model... this model is delight to work with and has the depth of the Fable models. I really trust this model"
Wenn Sie es direkt mit anderen Coding-Modellen vergleichen wollen, sind unsere Übersichten zu den besten KI-Coding-Assistenten, den Top-KI-Agenten und den GPT-5.3-Codex-Alternativen ein guter Ausgangspunkt, um Erwartungen zu kalibrieren.
Wie die Effort-Einstellung funktioniert
Das nützlichste Konzept, um Fable 5.1 in der Praxis zu verstehen, ist keine Benchmark-Zahl, sondern der effort-Regler.
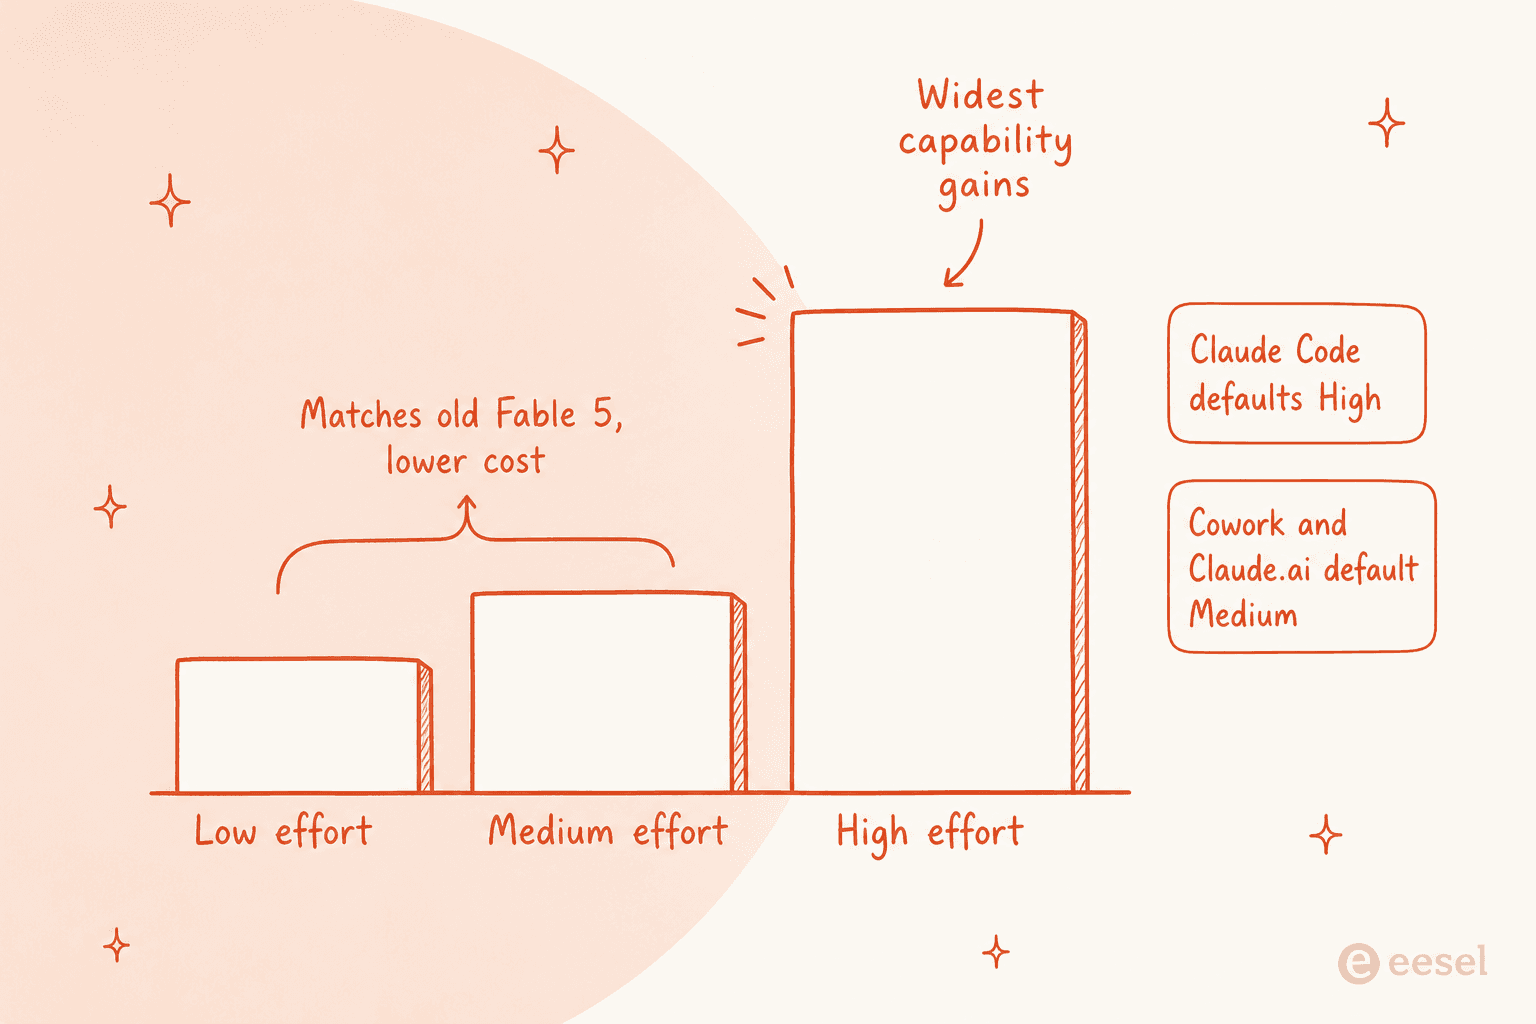
Adaptives Thinking ist immer aktiv, und effort steuert, wie viel davon Sie bekommen. Anthropics erklärtes Designziel ist, dass Fable 5.1 bei niedrigem oder mittlerem Effort Fable 5 zu deutlich geringeren Kosten erreicht oder übertrifft; der Abstand zu Fable 5 ist bei hohem Effort am größten. Die Standardwerte unterscheiden sich je nach Oberfläche: hoch in Claude Code, mittel in Claude Cowork und auf Claude.ai. Dasselbe Modell kann also je nach diesem einen Parameter ein Budget-Arbeitspferd oder ein Spezialist mit maximaler Tiefe sein, und genau das lässt die günstigeren Cache-Reads richtig zur Geltung kommen.
Für alle ist das aber kein klarer Gewinn. Ein Entwickler, der in weniger verbreiteten Sprachen arbeitet, widersprach:
"I write a lot of Rust and Lean, Fable 5 is in my experience better at both. Cost/performance is a different story."
Das ist eine nützliche Erinnerung: "führt jeden Benchmark an" ist ein Durchschnitt, und Ihr Workload könnte in dem Bereich liegen, in dem das vorherige Modell bei der reinen Qualität noch gewinnt. Testen Sie an Ihren eigenen Aufgaben, bevor Sie migrieren, genau wie bei jeder Entscheidung zur LLM-Optimierung.
Der Haken: Schutzmechanismen und Vertrauen
Ich versuche, jedem Tool, über das ich schreibe, gerecht zu werden, und das gilt in beide Richtungen: Die größte wiederkehrende Beschwerde über Fable 5.1 am Launch-Tag betraf nicht die Fähigkeiten, sondern Ablehnungen.
Anthropic hat die Schutzmechanismen tatsächlich präziser gemacht. Claude-Code-Nutzer können mit rund 60% weniger Cyber-Schutzmechanismus-Eingriffen pro Session gegenüber Fable 5 rechnen, und Bio-Schutzmechanismen greifen bei harmlosen Grundschulfragen jetzt 85% seltener. Wenn eine Anfrage doch markiert wird, wird sie zu einem Opus-Modell umgeleitet, und Ihnen werden keine Fable-Preise berechnet. Das sind echte, messbare Verbesserungen.
Aber Entwickler stoßen weiterhin auf Fehlalarme, manchmal im eigenen Code:
"Fable is useless. Me: 'Find my security problems in my own code. This is code I own. I'm doing this under authorization of the CEO/CTO of our company.' Fable: 'yeah, no.'"
"The main issue was that Fable was unpredictable and prone to false positives by the safeguards... it still seems completely unable to understand its own guardrails and will readily reason itself into triggering them."
Zusammen mit dem neuen Wasserzeichen und den modellgebundenen Thinking-Blöcken gibt es eine echte Strömung von Menschen, die das Gefühl haben, dass das Modell ihnen gegenüber misstrauischer wird, je fähiger es wird. Ob sich dieser Tausch lohnt, hängt ganz von Ihrer Arbeit ab; ein defensives Security-Team spürt es deutlich stärker als jemand, der Dokumente entwirft. Es ist eine Tatsache, die man abwägen sollte, kein Deal-Breaker für die meisten.
Wo Fable 5.1 passt, wenn Sie Support leiten oder Content schreiben
Hier ist der Perspektivwechsel, für den ich plädiere, und es ist das, was uns über drei Jahre KI im echten Support-Betrieb bei eesel gelehrt haben: Sie stellen kein Modell ein, Sie stellen einen Teamkollegen ein, der eines nutzt.
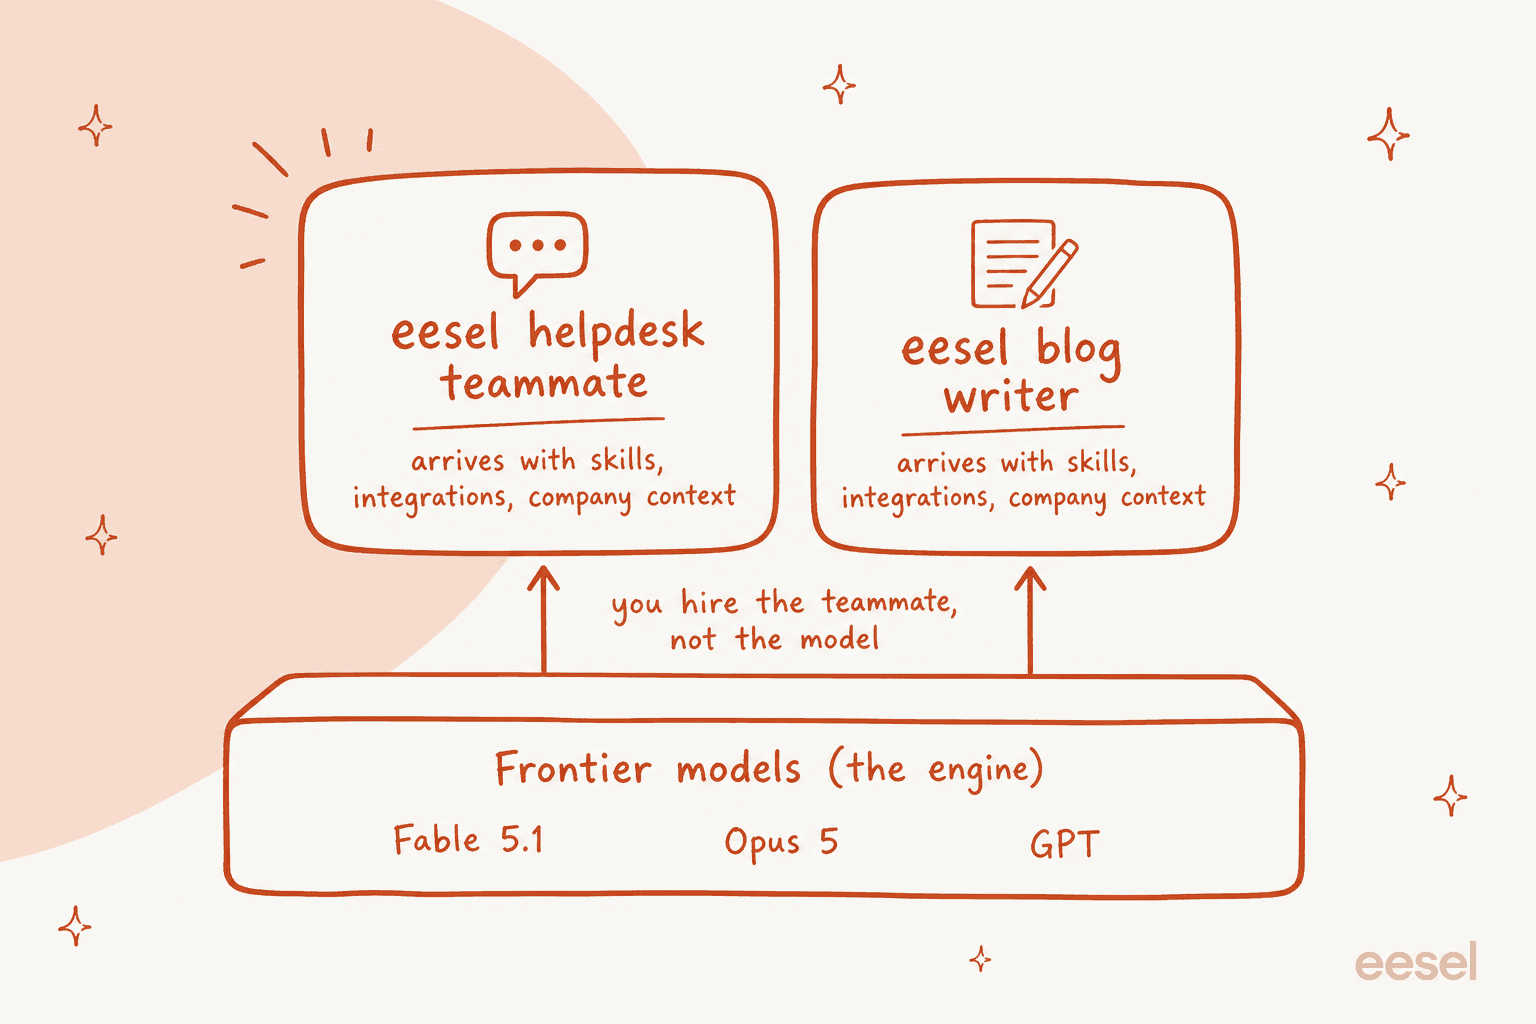
Fable 5.1 ist Infrastruktur, der rohe Motor. Ein Support-Manager will keinen Tool-Loop schreiben, keine Suche über vergangene Tickets verdrahten, keine Ablehnungen behandeln und kein Token-Budget verwalten, er will gelöste Tickets. Genau in dieser Lücke zwischen einem Spitzenmodell und einer fertigen Lösung lebt ein Produkt wie eesel. Unser KI-Helpdesk-Agent läuft auf Spitzenmodellen wie diesem, kommt aber bereits trainiert auf Ihr Help Center und vergangene Tickets, eingebunden in den Helpdesk, den Sie bereits nutzen.

Und weil wir gesehen haben, wie selbstsichere Bots ruhig falsche Antworten geben, wird jedes eesel-Rollout zunächst an Ihren historischen Tickets simuliert, bevor es einen echten Kunden berührt, sodass Sie sehen, wie es tatsächlich abschneiden wird. Das ist etwas ganz anderes, als claude-fable-5-1 selbst aufzurufen. Wenn Sie Optionen abwägen, führen unsere Leitfäden zum besten KI-Kundenservice und zur KI für Kundenservice-Automatisierung durch, worauf zu achten ist, und der Bau eines individuellen Support-GPT zeigt den DIY-Weg, falls Sie lieber roh vorgehen möchten.
Wenn Sie zuerst die Kategorie kartieren wollen, legen unsere Leitfäden zur besten KI-Helpdesk-Software, zu KI-Kundenservice-Chatbots und zu einem KI-Copilot für Support die Landschaft dar.
Die Content-Seite hat dieselbe Form. Fable 5.1s Schreiben hat sich wirklich verbessert, Canva nannte "das Herausragende ist das Schreiben" und Glean-Gutachter bevorzugten seine Antworten in etwa 2 zu 1 gegenüber Fable 5. Aber besserer Prosa-Stil von einem rohen Modell erledigt trotzdem keine Keyword-Recherche, platziert keine internen Links und zieht keine echten Quellen.
Dieses Gerüst ist die eigentliche Aufgabe, weshalb ein KI-Blog-Autor ein bloßes Chatfenster für Publishing-Arbeit schlägt, und weshalb unsere Übersicht zu KI-Blog-Schreib-Tools existiert.
Zum Workflow selbst haben wir uns mit KI-Blog-Automatisierung, Long-Form-KI-Schreiben und den echten KI-Blog-Autor-Kosten beschäftigt.
eesel für Support und Content testen
eesel ist eine KI-Teamkollegen-Plattform: Statt eines rohen Modells stellen Sie einsatzbereite Teamkollegen für bestimmte Aufgaben ein. Der KI-Helpdesk-Teamkollege übernimmt Ihre Support-Warteschlange, und der KI-Blog-Autor recherchiert und entwirft SEO-Content, beide laufen auf Spitzenmodellen wie Fable 5.1, kommen aber mit den Fähigkeiten, Integrationen und dem Unternehmenskontext für die jeweilige Rolle.
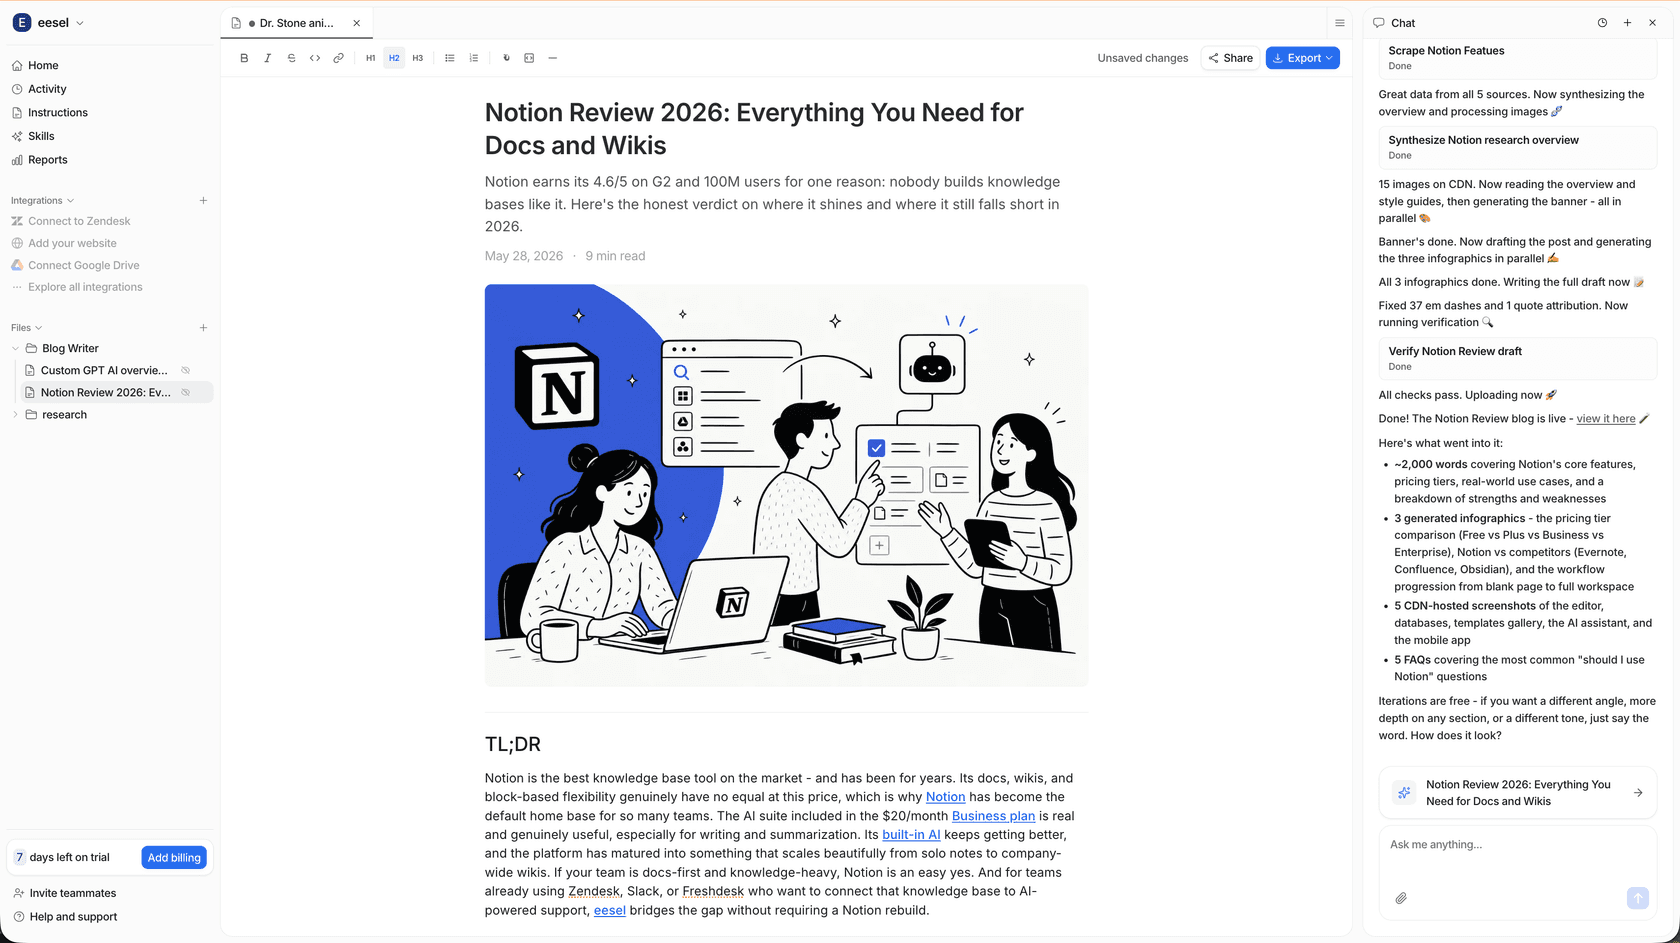
Der Unterschied zum eigenen Verdrahten eines Modells ist, dass eesel in Minuten auf den Tools live geht, die Sie bereits nutzen, mit Ihrem bestehenden Wissen trainiert und Sie einen Teamkollegen an echten vergangenen Daten simulieren lässt, bevor es live geht. Sie können eesel kostenlos testen, ohne Kreditkarte und ohne Verkaufsgespräch, und sehen, wie es Ihre eigenen Tickets beantwortet oder Ihre eigenen Beiträge entwirft, bevor Sie sich festlegen.
Fable 5.1 ist ein bemerkenswerter Motor. Die meisten Teams wollen einfach die fertige Arbeit, die er möglich macht, und genau das bauen wir.
Häufig gestellte Fragen
Wie viel kostet Claude Fable 5.1?
Was ist der Unterschied zwischen Claude Fable 5.1 und Fable 5?
Ist Claude Fable 5.1 besser als Claude Opus 5?
Kann ich Claude Fable 5.1 für den Kundensupport nutzen?
Versieht Claude Fable 5.1 seine Texte mit einem Wasserzeichen?


Article by
Alicia Kirana Utomo
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.