TypeSafe Jev Alternativen: 8 Wege zu schnellen, typisierten KI-Entscheidungen

Alicia Kirana Utomo

Katelin Teen
Zuletzt bearbeitet September 21, 2026
Was zählt eigentlich als TypeSafe Jev Alternative?
Jevs Pitch ist eng und spezifisch: Schicke ihm unstrukturierten Zustand plus typisierte Fragen, bekomme schnell typisierte Entscheidungen mit kalibrierten Wahrscheinlichkeiten zurück. Auf Hacker News erreichte der Launch 1.929 Punkte, und der schärfste Kommentar brachte die ganze Sache klar auf den Punkt:
"Seems like a more accurate title would be 'Jev: Trading general purpose generation for fast typed inference'... Jev can only generate structured output, right?"

Diese Umformulierung ist die richtige Linse, um Alternativen zu vergleichen. Alles, was die Ausgabe eines Modells in eine garantierte Form bringt, konkurriert mit Jev im typisierten Teil. Der Teil, der wirklich schwer zu kopieren ist, ist der kalibrierte, generierungsfreie Teil – deshalb gliedert sich die Liste danach, wie nah jede Option daran herankommt.
Ich habe die acht Optionen in die drei oben genannten Familien gruppiert. Hier ist die ganze Übersicht auf einen Blick, bevor ich Tool für Tool durchgehe.
| Tool | Typ | Was es liefert | Schema-Garantie | Konfidenzwert | Hosting | Preise | Am besten für |
|---|---|---|---|---|---|---|---|
| eesel | Support-Teamkollege | Ein gelöstes Ticket, nicht nur eine Entscheidung | Aktionen auf deinem Helpdesk | Simuliert an vergangenen Tickets | SaaS (SOC 2, DSGVO) | Nutzungsbasiert, ~$0,40/Ticket | Support end-to-end betreiben |
| TypeSafe Jev | System-One-Modell | Typisierte Entscheidung + Wahrscheinlichkeit | Ja, nativ | Ja, RLCD-kalibriert | API + Cloudflare | ~$0,042/MTok Input, Output kostenlos | Schnelle, enge Entscheidungen im großen Maßstab |
| OpenAI Structured Outputs | Verwaltete API-Funktion | JSON, das deinem Schema entspricht | Ja, JSON Schema | Über Logits (grob) | OpenAI API | Normale Modell-Token-Rate | Teams, die bereits auf OpenAI setzen |
| Gemini structured output | Verwaltete API-Funktion | JSON, das deinem Schema entspricht | Ja, JSON Schema | Über Logits (grob) | Google API | Normale Modell-Token-Rate | Günstige Klassifizierung auf Flash-Lite |
| Cloudflare Workers AI | Modell-Gateway | JSON-Modus / Function Calls | Ja, je nach Modell | Modellabhängig | Edge + Serverless | Nutzungsbasiert (Neurons), kostenlose Stufe | Edge-Apps, und Jev selbst betreiben |
| BAML | Schema-DSL + Bibliothek | Typisierte Objekte von jedem LLM | Ja, beim Parsen | Modellabhängig | Self-Host / OSS | Kostenlos (Open Source) | Beste DX für Prompt-zu-Typ |
| Instructor | Bibliothek (Pydantic) | Validierte typisierte Objekte | Ja, mit Retries | Über Logits (grob) | Self-Host / OSS | Kostenlos (Open Source) | Python-Extraktion, schneller Start |
| Outlines | Generierungs-Bibliothek | Struktur wird beim Decoding erzwungen | Ja, beim Decoding | Modellabhängig | Self-Host / OSS | Kostenlos (OSS) + gehostete API | Lokale Modelle, strikte Grammatiken |
| Hugging Face AutoTrain | Trainierter Klassifikator | Klassenlabel + Wahrscheinlichkeit | Fester Label-Satz | Ja, Softmax | HF Hub / Self-Host | Rechenkosten | Enge, hochvolumige Klassifizierung |
Eine Anmerkung zum Ton, bevor es losgeht: Keines dieser Tools ist schlecht, einige sind sogar exzellent. Wo ich eine Grenze aufzeige, ist das eine Aussage über den Umfang, kein Seitenhieb. Gehen wir sie durch.
1. eesel: die Teamkollegen-Schicht, kein Entscheidungs-Primitiv
Ich bin ehrlich: Das ist eine andere Art von Antwort. Viele, die nach einem typisierten Entscheidungsmodell suchen, wollen eigentlich ein Support- oder Ops-Problem lösen und haben zu einem Primitiv gegriffen, weil es das glänzende neue Ding war. Wenn das auf dich zutrifft, lautet die ehrliche Empfehlung: Überspringe das Primitiv.

Was es ist. eesel ist eine Plattform für KI-Teamkollegen. Kunden stellen einsatzbereite Teamkollegen für eine bestimmte Aufgabe ein, und das aktuelle Line-up umfasst einen KI-Helpdesk-Teamkollegen und einen KI-Blog-Autor. Der Helpdesk-Teamkollege steigt in deine bestehende Warteschlange ein, liest dein Helpcenter und vergangene Tickets und trifft dieselben Triage-, Routing- und Eskalationsentscheidungen wie ein Entscheidungsmodell – dann entwirft er Antworten und löst Tickets.
Wo es passt. Wenn die Entscheidung Mittel zum Zweck ist und der Zweck ein gelöstes Ticket ist. Jev liefert dir „dringend, Billing, 0,94". eesel nimmt dieses Urteil und antwortet tatsächlich, taggt, routet und schließt – verdrahtet in deinen KI-Kundenservice-Workflow. Es verhält sich weniger wie ein Decoding-Trick und mehr wie ein KI-Agent mit geladenem Kontext, und es sitzt in deiner Kundenservice-Software statt daneben.
Worauf zu achten ist. eesel ist keine universelle Entscheidungs-API. Wenn du ein rohes Primitiv suchst, das du in ein unabhängiges Produkt einbetten willst, brauchst du eines der Tools weiter unten, keinen Teamkollegen.
Wenn du im Terminal lebst: eesel liefert auch eine öffentliche CLI plus einen MCP-Server, sodass sich derselbe Teamkollege und Workspace aus Skripten und von Coding-Agenten wie Claude Code, Codex und Cursor steuern lassen. Es ist derselbe Agent wie im Dashboard, kein separates Spielzeug – wichtig, wenn dein Instinkt bei Jev war, alles zu skripten. Sieh, wie es sich mit einer Claude Code MCP-Integration vergleicht.
Preise. Nutzungsbasiert bei rund $0,40 pro gelöstem Ticket, ohne KI-Aufpreis pro Sitzplatz. Du kannst vor dem Livegang an deinen historischen Tickets simulieren – der Kalibrierungsschritt, den jedes andere Tool auf dieser Seite auslässt.
2. OpenAI Structured Outputs
Wenn dein Stack bereits auf OpenAI läuft, ist das die reibungsloseste Jev-Alternative, weil es eine Funktion ist, kein neuer Anbieter.
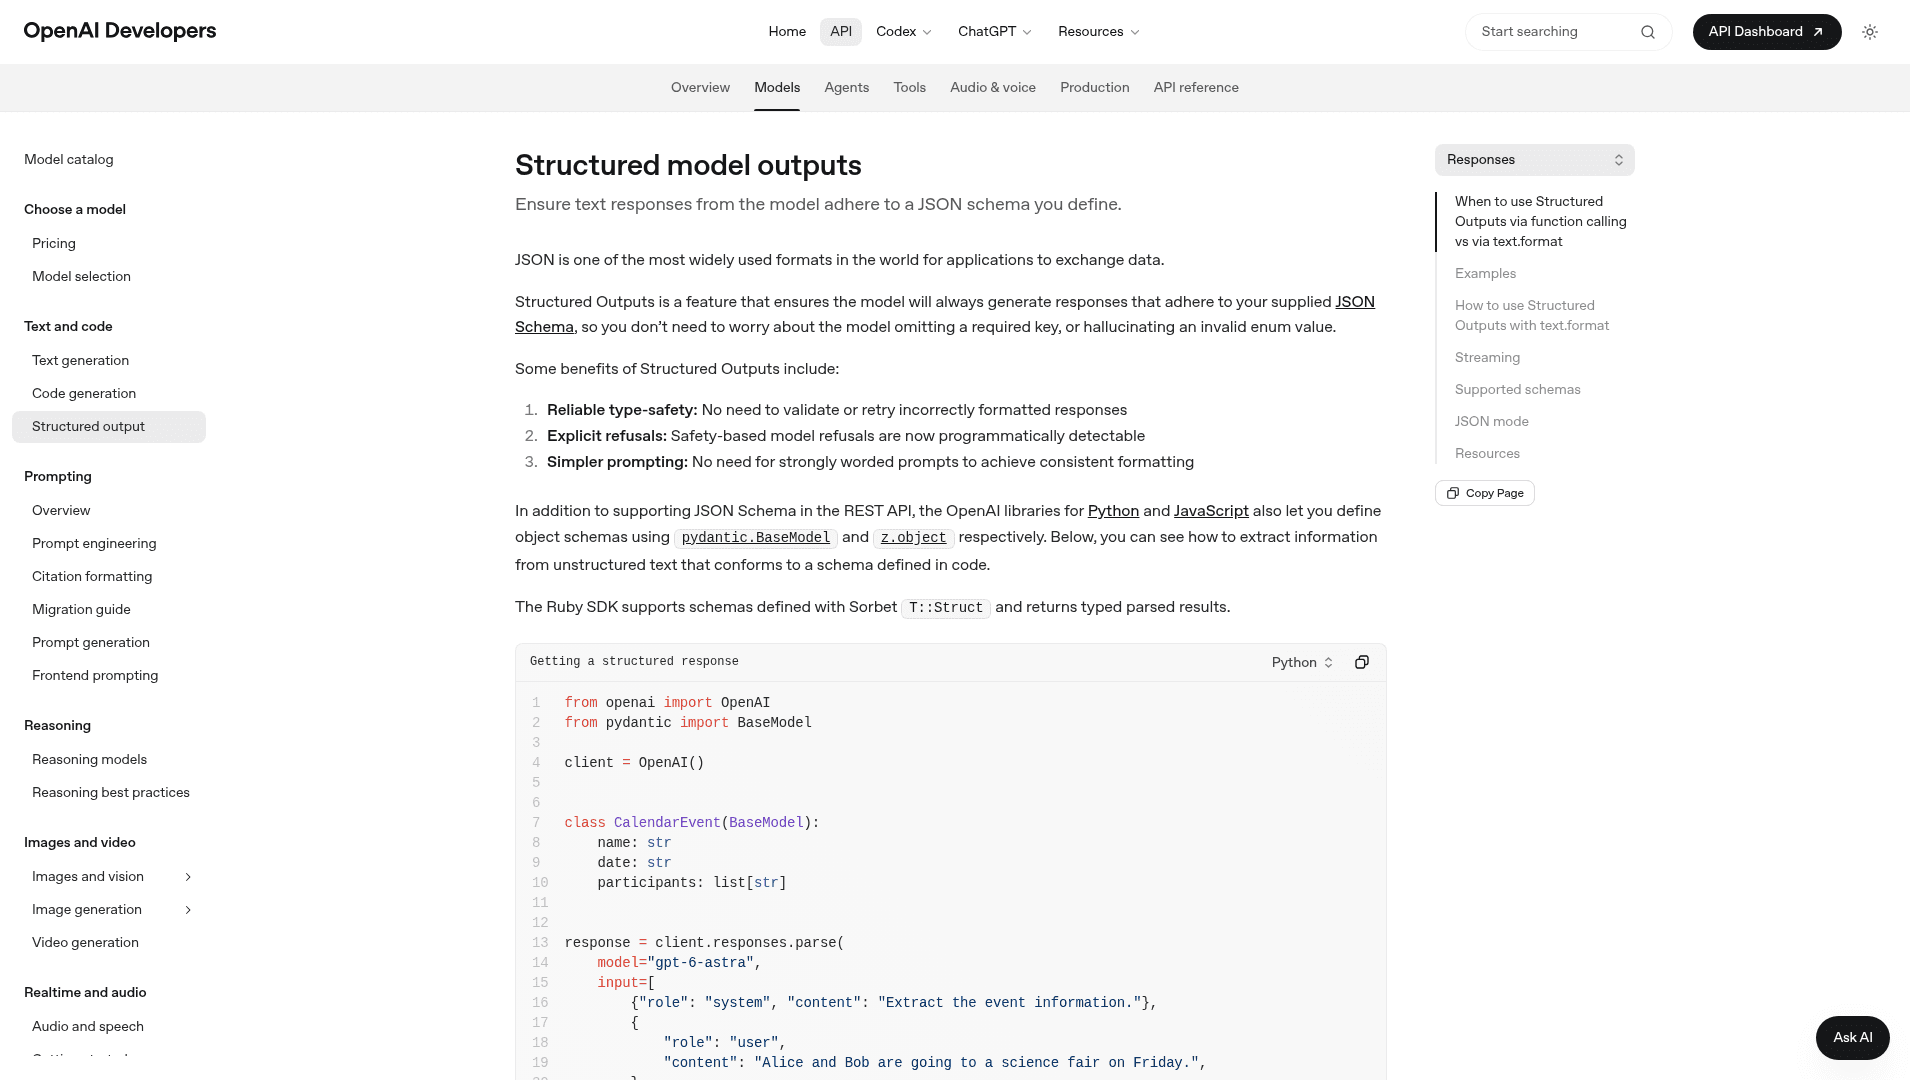
Was es ist. Structured Outputs sorgt dafür, dass ein Modell immer Antworten liefert, die einem von dir definierten JSON Schema entsprechen, sodass es keinen erforderlichen Key auslässt oder einen ungültigen Enum-Wert erfindet. Es macht außerdem Safety-Refusals programmatisch erkennbar und akzeptiert Schemas, die mit pydantic.BaseModel oder z.object definiert sind.
Wo es passt. Datenextraktion, Ticket-Klassifizierung und Routing, wenn du das volle Reasoning des Modells hinter der Entscheidung willst und mit der Generierungslatenz leben kannst. Es ist ein solides Rückgrat für eine selbstgebaute Ticket-Automatisierungs-Pipeline.
Worauf zu achten ist. Das ist eine Einschränkung eines generativen Modells, du zahlst also weiterhin für die Token-Generierung und wartest darauf. Es liefert dir eine gültige Form, keinen kalibrierten Konfidenzwert – willst du gezielt die Kalibrierung, für die Jev trainiert ist, musst du sie selbst aus Logits ableiten.
Preise. Kostenlose Funktion; du zahlst die normale Token-Rate des Modells, das du aufrufst.
3. Gemini structured output
Googles Version, und die, zu der ich greife, wenn die Aufgabe günstige, hochvolumige Klassifizierung ist.
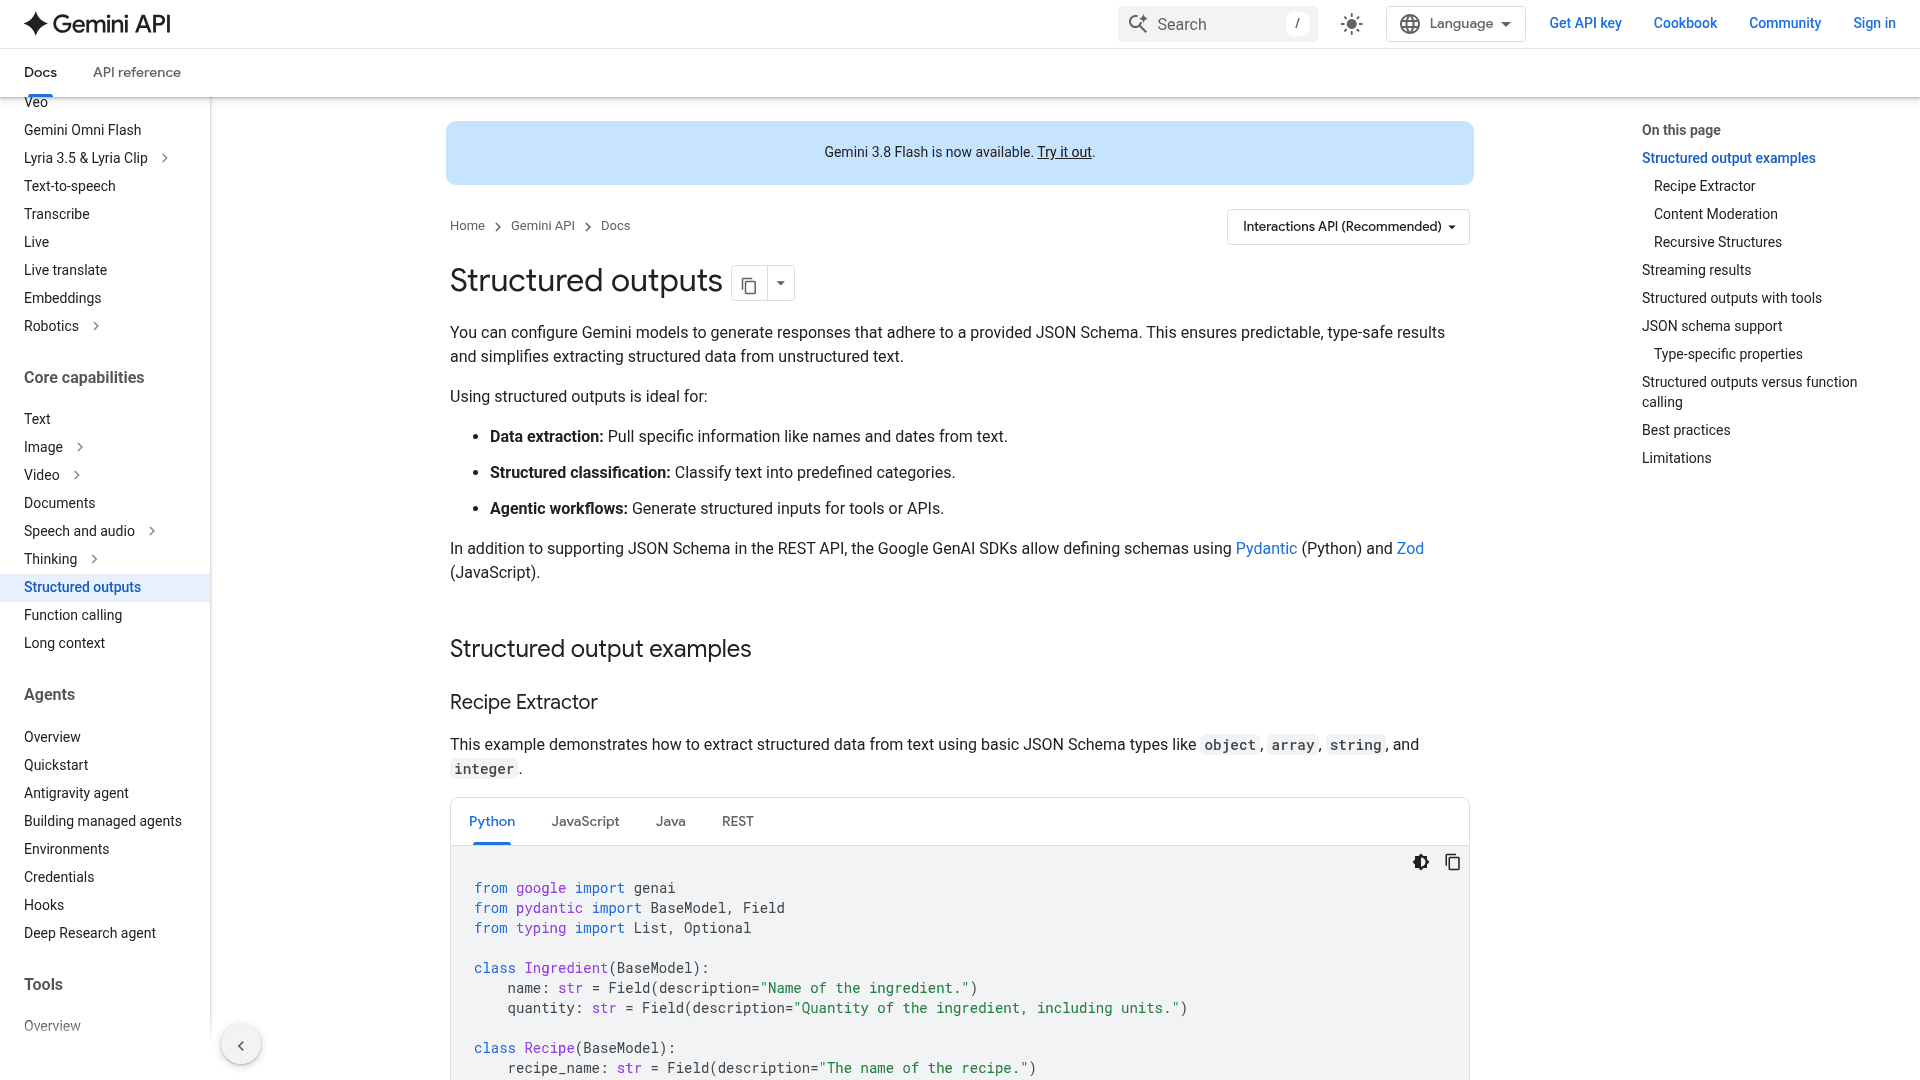
Was es ist. Gemini structured output konfiguriert Gemini-Modelle so, dass sie Antworten generieren, die einem JSON Schema entsprechen, und die Doku nennt drei ideale Anwendungsfälle namentlich: Datenextraktion, strukturierte Klassifizierung und das Erzeugen strukturierter Eingaben für agentische Workflows. Es unterstützt Pydantic- und Zod-Schemas.
Wo es passt. Klassifizierung und Extraktion im großen Volumen, einschließlich der Art von Support-Ticket-Automatisierung, die früher eine handgetunte Regel-Engine brauchte. Auf der günstigsten Stufe (Flash-Lite) kommen die Kosten pro Aufruf in die Nähe von Jev-Terrain – das ist hier der eigentliche Konkurrenzvorteil.
Worauf zu achten ist. Derselbe Grundvorbehalt wie bei OpenAI: Es ist Generierung mit Schema-Klammer, keine zweckgebaute Entscheidungs-Engine – Latenz und Konfidenz verhalten sich wie bei einem LLM, nicht wie bei Jev.
Preise. Kostenlose Funktion; du zahlst Gemini-Token-Raten, und die richtige Modellstufe zu wählen ist der Punkt, an dem die Kosten entstehen.
4. Cloudflare Workers AI
Der interessante Twist: Das ist sowohl eine Alternative zu Jev als auch der Ort, an dem Jev tatsächlich läuft.
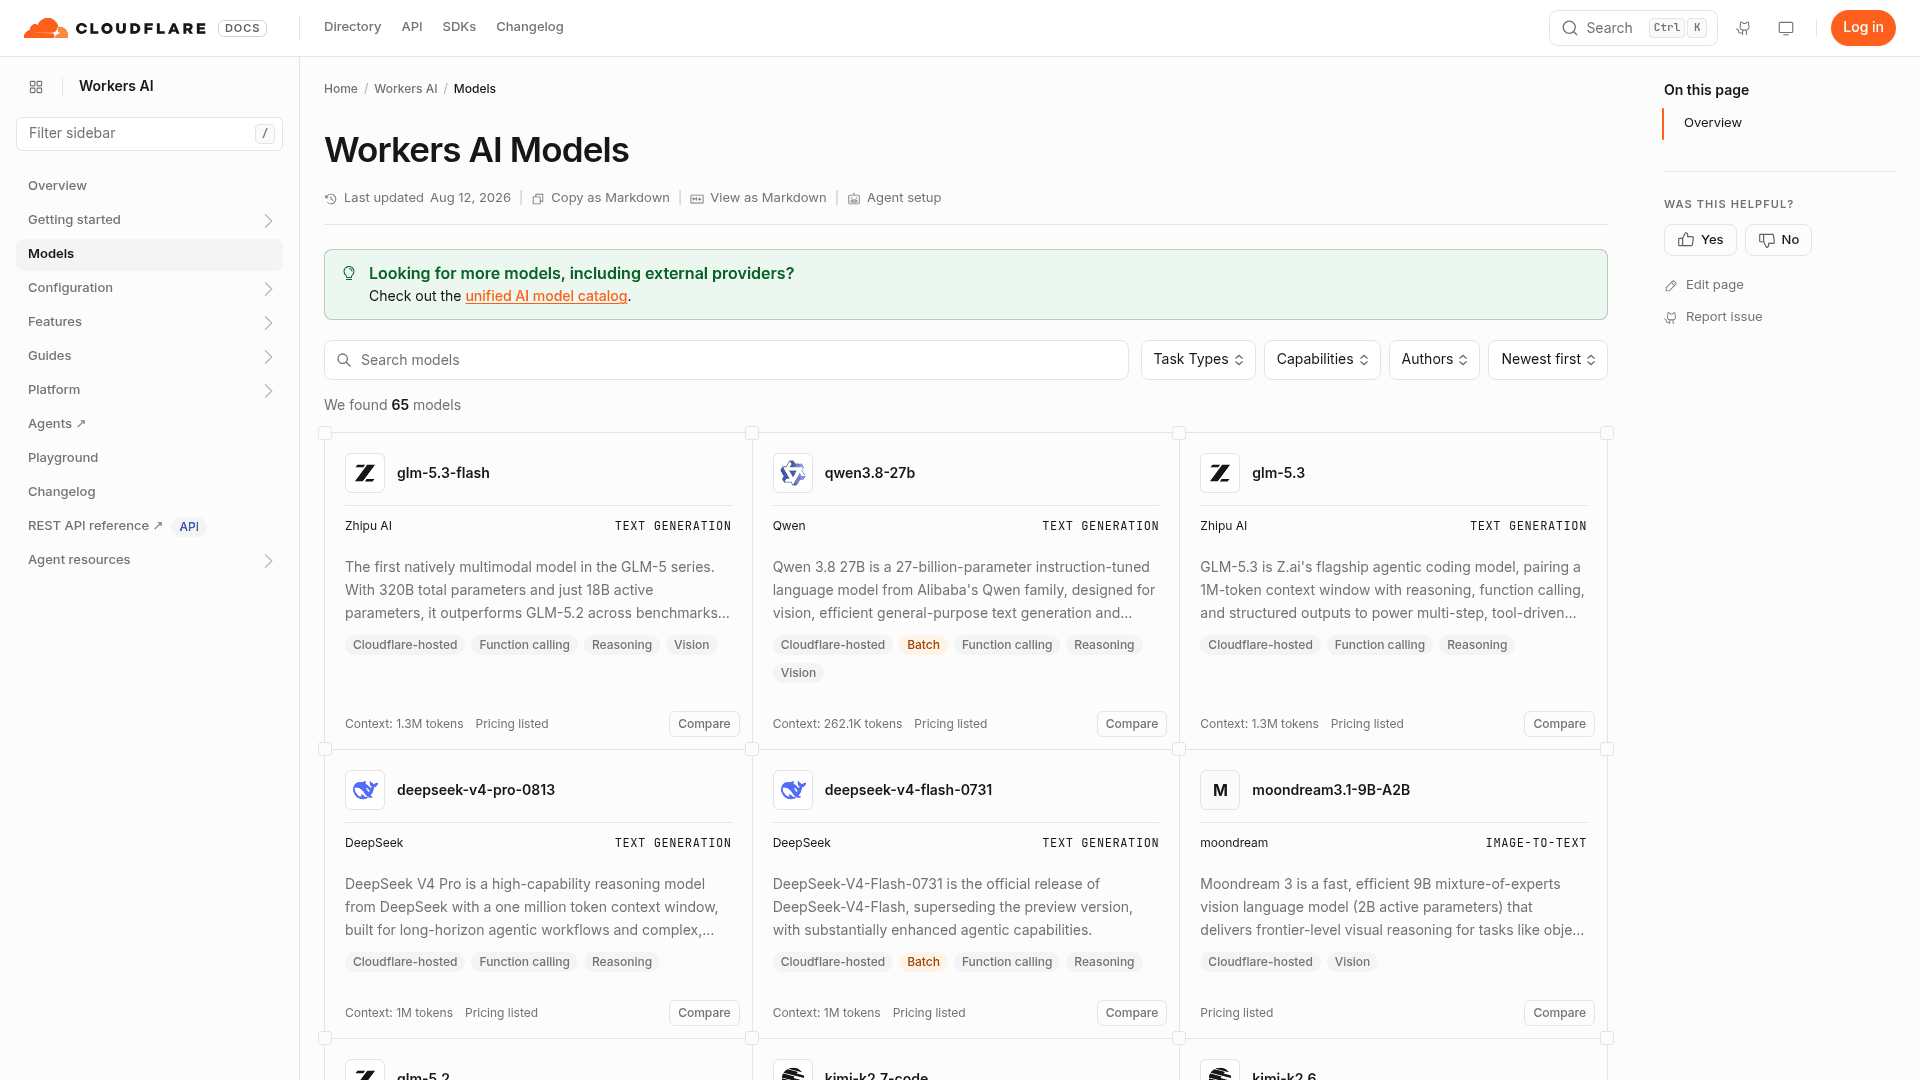
Was es ist. Workers AI ist Cloudflares serverloses Modell-Gateway mit einem Katalog von über 65 Modellen, viele mit Tags für Function Calling und Structured Outputs, die am Edge laufen. Jev ist hier ebenfalls gelistet, unter der Modell-ID typesafe/jev.
Wo es passt. Edge-Apps, die ein kleines, schnelles Modell nahe am Nutzer wollen, und Teams, die eine einzige Abrechnungsfläche für sowohl ein allgemeines Modell als auch Jev-artige Entscheidungen wollen.
Worauf zu achten ist. Die Structured-Output-Garantie hängt vom konkreten gewählten Modell ab, nicht von Workers AI selbst. Behandle es als Verteilungsschicht und wähle das Modell nach seinen Stärken.
Preise. Nutzungsbasiert (abgerechnet in „Neurons") mit einem kostenlosen Tageskontingent, und die Abrechnung für Jev auf Cloudflare läuft über das Cloudflare-Dashboard.
5. BAML
Die beste Developer Experience unter den Bibliotheks-Optionen, und die, die ich einem Team geben würde, das Prompt-Gefummel hasst.
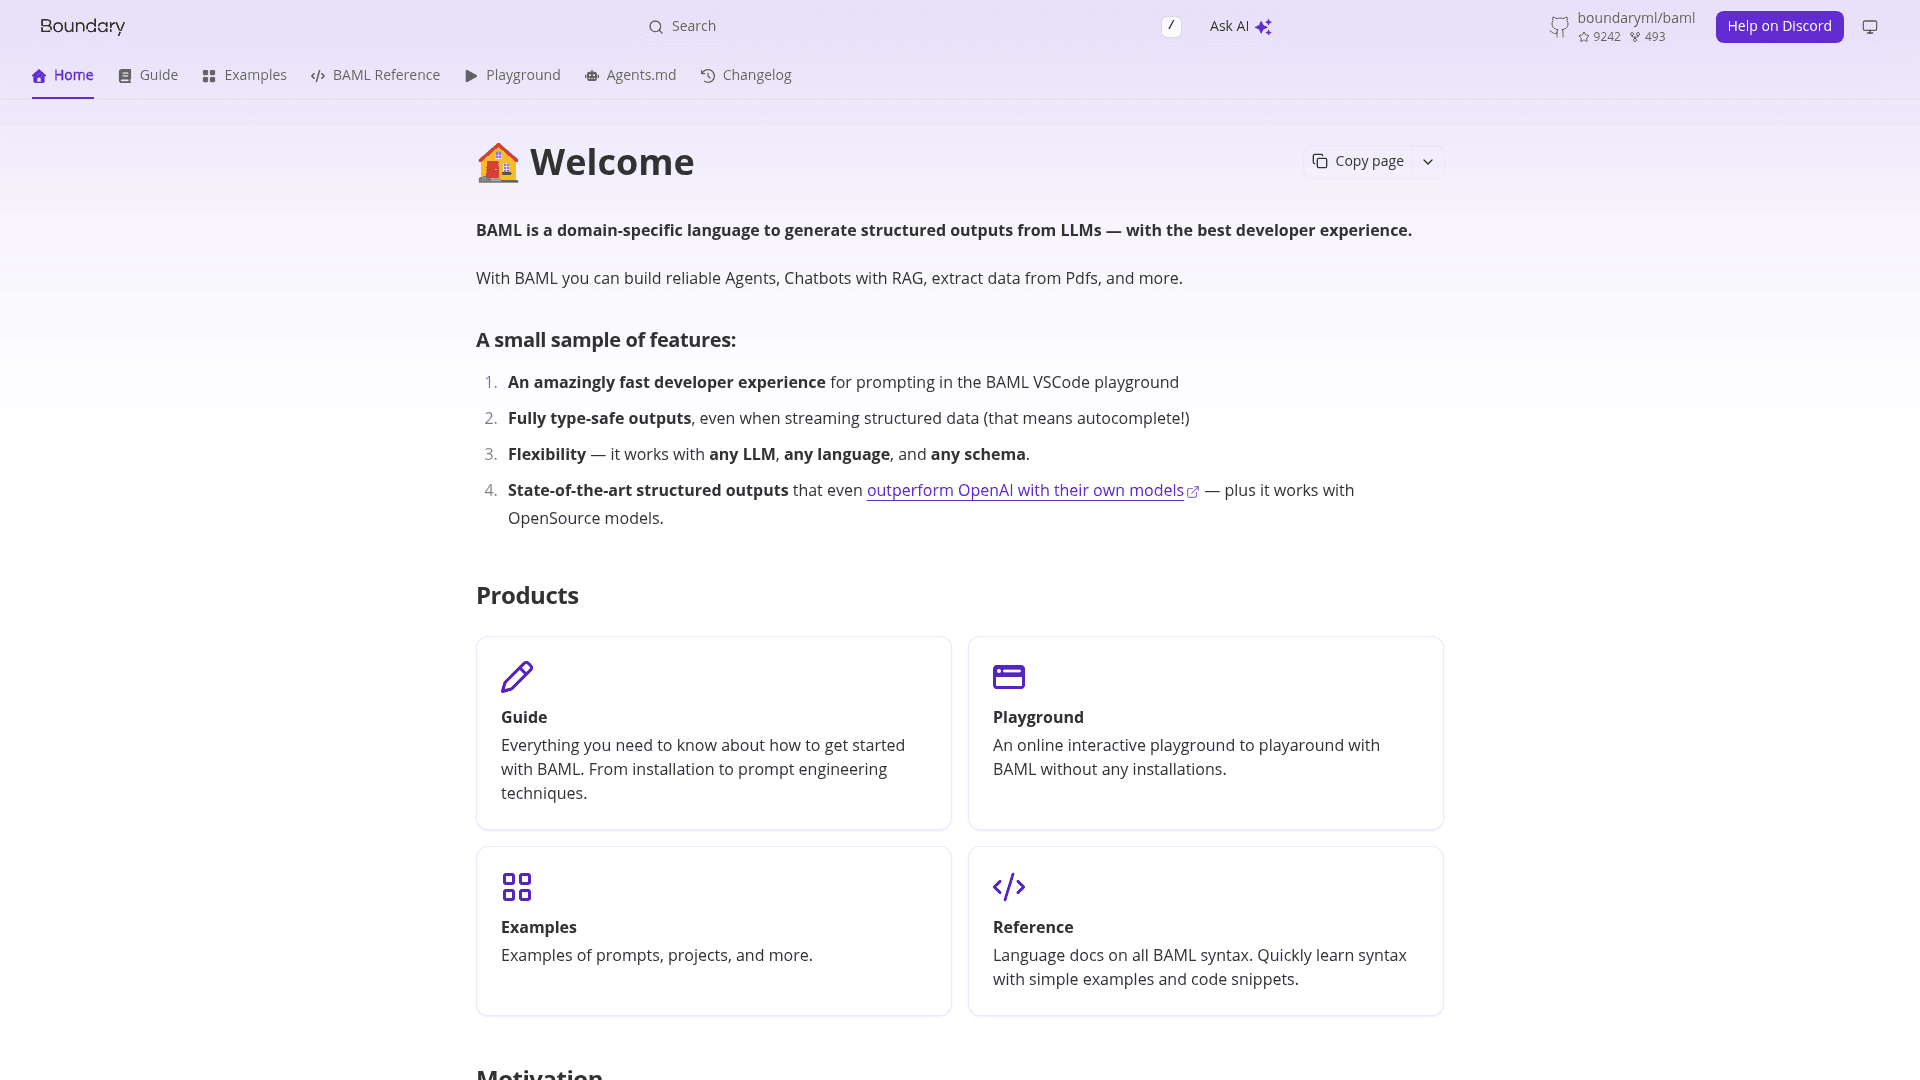
Was es ist. BAML ist eine domänenspezifische Sprache zum Generieren strukturierter Ausgaben von LLMs. Es liefert vollständig typsichere Ausgaben (auch beim Streaming), einen interaktiven VSCode-Playground und funktioniert mit jedem LLM, jeder Sprache und jedem Schema. Es hat rund 9.200 GitHub-Stars.
Wo es passt. Teams, die Prompt-zu-typisiertem-Objekt mit echter Autovervollständigung und einer engen Edit-Schleife wollen, egal welches Modell sie wählen. Wenn du deinen eigenen KI-Helpdesk-Agenten baust, ist BAML die Schicht, die die Ausgabe des Modells ehrlich zu deinen Typen hält.
Worauf zu achten ist. BAML gibt dir Typsicherheit beim Parsen, aber das Konfidenzverhalten wird vom zugrunde liegenden Modell übernommen – es ist also keine kalibrierte Entscheidungs-Engine, wie Jev es für sich beansprucht.
Preise. Kostenlos und Open Source.
6. Instructor
Die am weitesten verbreitete Bibliothek in diesem Bereich, und der schnellste Weg, typisierte Extraktion in Python zum Laufen zu bringen.
Was es ist. Instructor extrahiert strukturierte Daten aus jedem LLM mit Typsicherheit, Validierung und automatischen Retries. Es baut auf Pydantic auf, liegt bei v1.17.0, hat etwa 14.000 Stars, 3 Millionen monatliche Downloads, über 100 Contributor und über 15 unterstützte Anbieter, darunter Ollama und DeepSeek. Es läuft in Python, TypeScript, Go, Ruby, Elixir und Rust.
Wo es passt. Schnelle, schema-first Extraktion, bei der du Validierung und Retries willst, ohne ein Agent-Framework mitzuschleppen.
Worauf zu achten ist. Instructors eigene Doku ist erfrischend ehrlich, dass es für Extraktion gedacht ist; für schwerere Agent-Runtimes verweist sie auf PydanticAI. Und wie jede Bibliothek hier standardisiert es die Form der Ausgabe, nicht die Wahrheit der Antwort.
Preise. Kostenlos, MIT-lizenziert.
7. Outlines
Die Option, zu der du greifst, wenn du eigene Modelle betreibst und Struktur auf Token-Ebene erzwingen willst.
Was es ist. Outlines garantiert strukturierte Ausgaben während der Generierung, direkt von jedem LLM, statt schlechte Ausgaben im Nachhinein zu parsen oder mit Regex zu reparieren. Es funktioniert mit OpenAI, Ollama und vLLM, unterstützt JSON Schema, reguläre Ausdrücke und kontextfreie Grammatiken, liegt bei v1.3.0 mit rund 15.900 Stars, und lässt sich mit einer gehosteten Dottxt-API kombinieren für 100 % schema-konforme Generierung, ohne eigene Modelle zu betreiben.
Wo es passt. Lokale und selbst gehostete Modelle, und Fälle, in denen du eine strikte Grammatik brauchst, nicht nur JSON.
Worauf zu achten ist. Struktur beim Decoding zu erzwingen ist mächtig, aber low-level; du bist näher an der Hardware als bei einer verwalteten Funktion – je nach Team ist das genau der Punkt oder eine Last.
Preise. Open Source und kostenlos; die gehostete Dottxt-API ist die kostenpflichtige Option.
8. Hugging Face AutoTrain
Wenn deine Entscheidung wirklich eng und hochvolumig ist, ist die langfristig günstigste Antwort vielleicht ein Modell, das du selbst trainierst und besitzt.
Was es ist. AutoTrain ist Hugging Faces No-Code-Weg, Modelle durch das Hochladen von Daten zu trainieren, zu evaluieren und zu deployen. Die Aufgabenliste umfasst Text Classification und Token Classification, und die resultierenden Modelle liegen einsatzbereit auf dem Hugging Face Hub.
Wo es passt. Ein fester, klar definierter Label-Satz, für den du Trainingsdaten hast, etwa das Taggen von Tickets nach Grund-Code oder Routing nach Queue. Das ist die Option, auf die HN-Kommentatoren immer wieder verwiesen und argumentierten, Jev sei nah an einem kleinen Klassifikator, den man nachbauen könnte:
"It's a heavily constrained, tiny model that can only produce a probability score or a yes/no answer over pre-defined selections... I suspect someone will be able to recreate this within a week."
Worauf zu achten ist. Du besitzt den gesamten Lebenszyklus: Labeling, Training, Drift, Redeploys. Ein trainierter Klassifikator liefert dir eine saubere Softmax-Wahrscheinlichkeit, kennt aber nur die Klassen, die du ihm beigebracht hast, und das erneute Training liegt bei dir.
Preise. Du zahlst für Rechenzeit; es gibt keine Lizenz pro Entscheidung.
Welche solltest du wirklich wählen?
So würde ich einen Teamkollegen durch die Entscheidung führen.
Das, was dir jedes einzelne davon noch schuldet
Egal welches Tool du wählst: Achte auf die Lücke zwischen einer gültigen Antwort und einer richtigen. Das war der meistdiskutierte Punkt im Jev-Launch-Thread, und er gilt für alle acht Alternativen:
"if it puts a high confidence value on a wrong answer, thats still hallucinating, no?"
Die nützliche Umformulierung aus demselben Thread: Ein Konfidenzwert ist nur etwas wert, wenn er kalibriert ist:
"What we would want to see is a confidence value that is in line with the actual correctness. If the value is 0.9 for 1000 different answers, then approximately 900 of those answers should be correct."
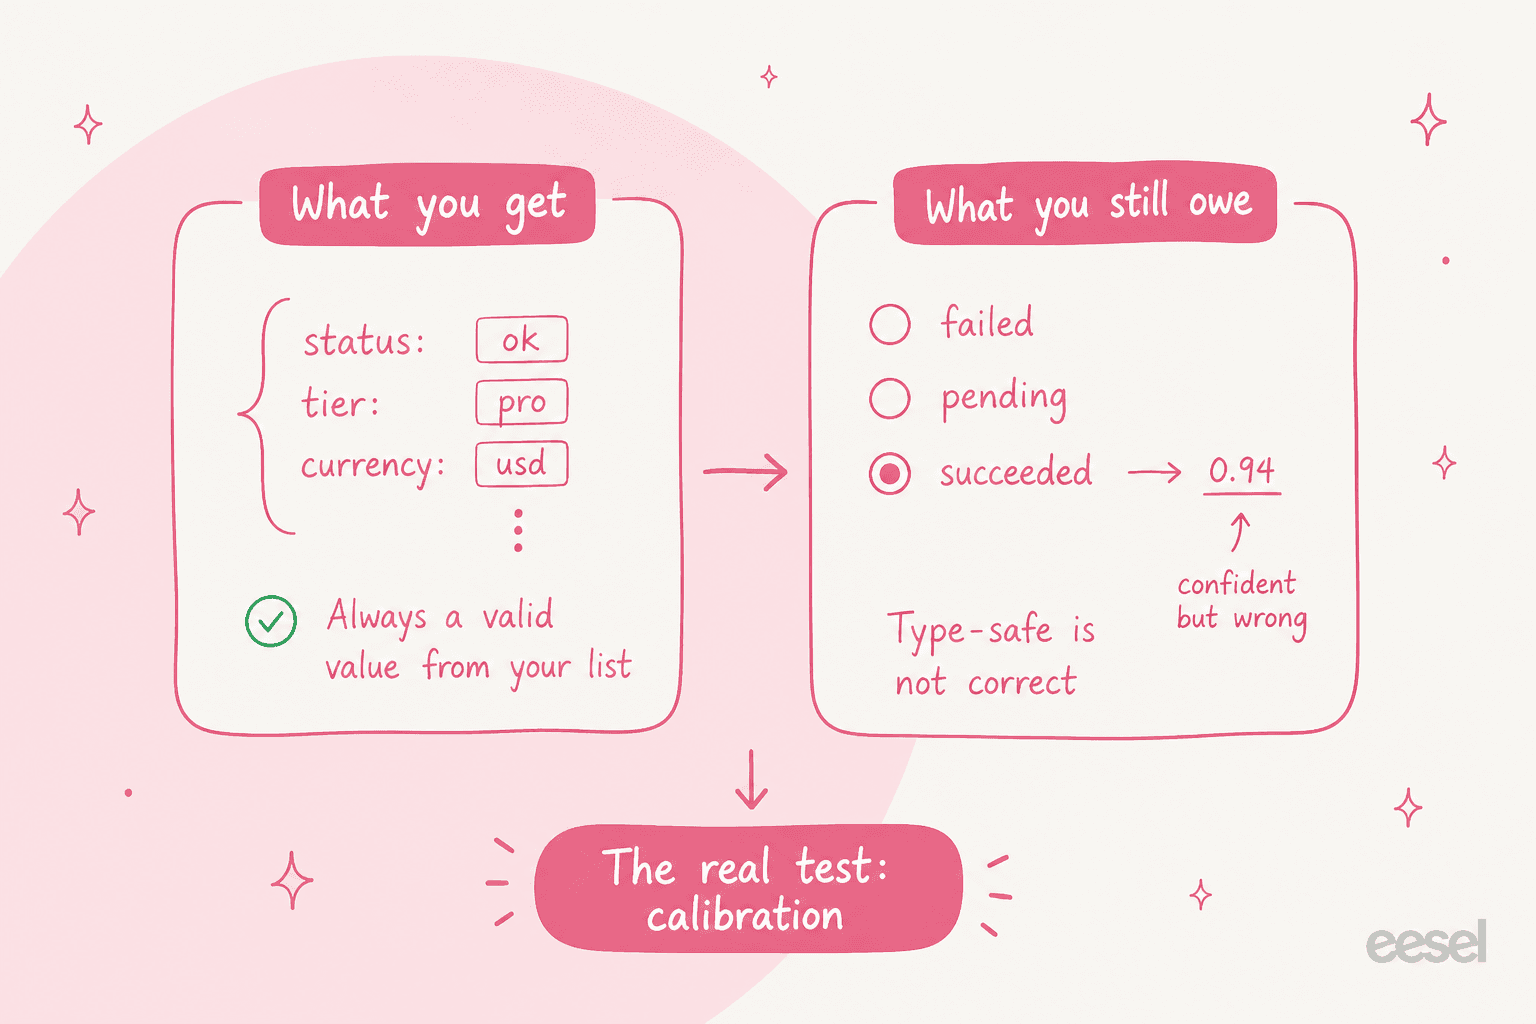
Deshalb vertraue ich auf der Support-Seite keiner Entscheidungsschicht, bevor sie nicht gegen die eigenen vergangenen Tickets eines Teams gelaufen ist – dieselbe Disziplin, die ich bei der Wahl eines LLMs für Support oder bei der Shortlist der besten KI-Support-Agenten anwenden würde. Ein Modell, das bei einem Routing-Aufruf 0,94 erreicht, ist bedeutungslos, bis du geprüft hast, dass 0,94-Konfidenz-Aufrufe an deinen Daten tatsächlich zu 94 % richtig liegen. Die Begeisterung ist trotzdem real, und wo sie landet, sind die Leute offen darüber:
"After much fumbling around with prompts and evals, this is exactly how I am using LLMs in production, to narrowly make choices and return structured data... I think this is going to quickly become the new standard approach for agentic systems."
Und in Produktion ist die Geschwindigkeit kein Hype. Vercels CEO berichtete echte Zahlen:
"Jev is up to 18x faster (p95) and more accurate. It's coming to Vercel AI Gateway and likely new default."
Wo eesel bei alledem passt
Jedes Tool auf dieser Seite ist Infrastruktur. Sie geben deinem Code eine typisierte Entscheidung, und dann muss dein Code etwas damit tun. Das ist die richtige Form, wenn du ein Produkt baust. Es ist die falsche Form, wenn dein Job das Betreiben einer Support-Warteschlange ist und du gehofft hast, ein Entscheidungsmodell würde das übernehmen.
eesel ist der Mitarbeiter, nicht das Primitiv. Der KI-Helpdesk-Teamkollege liest dein Helpcenter und vergangene Tickets, trifft dieselben Triage- und Routing-Entscheidungen wie Jev, und entwirft, taggt, routet und löst dann innerhalb deines bestehenden KI-Helpdesks. Du kannst ihn auf deine Historie ansetzen und den Rollout simulieren, bevor er auch nur einem einzigen echten Kunden antwortet – Kalibrierung ist also ein Schritt, den du gehst, keine Behauptung, der du vertraust. Und wenn dein Instinkt ist, alles zu skripten: Derselbe Teamkollege ist über die eesel CLI und MCP steuerbar.
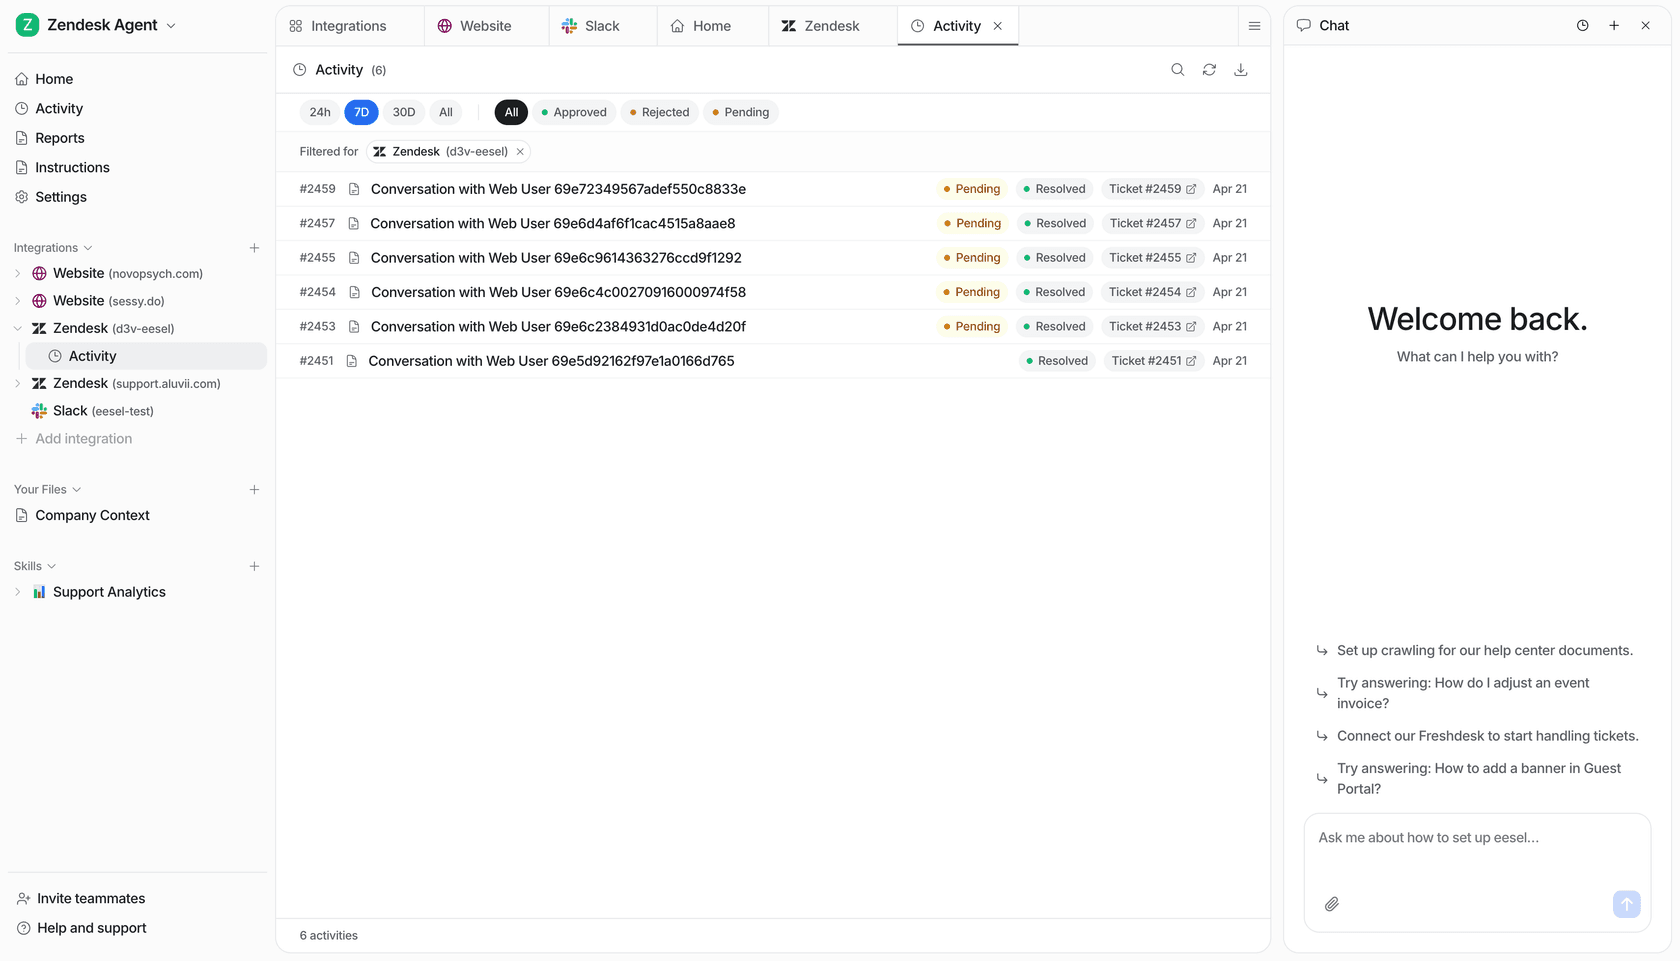
Wenn du zwischen Jev oder einer seiner Alternativen abwägst, weil du schnellere, zuverlässigere Support-Entscheidungen willst, ist der kürzeste Weg, die Schicht zu testen, die diese Entscheidungen bereits in gelöste Tickets verwandelt – so wie ein KI-Copilot neben deinen Agenten mitschreibt. Probiere eesel kostenlos aus, oder buche eine Demo und sieh es an deinen eigenen Tickets laufen.
Häufig gestellte Fragen
Häufig gestellte Fragen
Was sind die besten TypeSafe Jev Alternativen?
Die nächsten TypeSafe Jev Alternativen sind verwaltete Structured-Output-Funktionen wie OpenAI Structured Outputs und Gemini structured output, Open-Source-Bibliotheken wie BAML, Instructor und Outlines, sowie ein trainierter Klassifikator über Hugging Face AutoTrain. Wenn du die Entscheidung und die Aktion auf einem Helpdesk willst, ist ein KI-Agent für den Kundenservice die Schicht über all diesen.
Gibt es eine kostenlose Alternative zu TypeSafe Jev?
Ja. Instructor (MIT) und Outlines (Apache-2.0) sind kostenlose Open-Source-Bibliotheken, und structured outputs bei OpenAI und Gemini sind eine kostenlose Funktion zusätzlich zur normalen Token-Preisgestaltung. Du zahlst weiterhin für das zugrunde liegende Modell, „kostenlos" bezieht sich also auf die Schema-Schicht, nicht auf die Inferenz.
Was ist der Unterschied zwischen Jev und OpenAI Structured Outputs?
Jev ist ein zweckgebautes System-One-Modell, das die Textgenerierung überspringt und in einem parallelen Durchgang eine typisierte Entscheidung plus einen kalibrierten Konfidenzwert liefert. OpenAI Structured Outputs ist eine Einschränkung, die einem normalen generativen Modell übergestülpt wird – du zahlst also weiterhin Generierungslatenz und -kosten, bekommst dafür aber die volle Reasoning-Leistung eines Frontier-LLMs. Jev tauscht dieses Reasoning gegen Geschwindigkeit ein.
Wie viel kosten TypeSafe Jev Alternativen?
Das hängt vom Typ ab. Die Open-Source-Bibliotheken sind kostenlos, du zahlst nur die Token-Rate des zugrunde liegenden Modells. Verwaltete Funktionen wie Gemini structured output kosten die normale Gemini-Token-Preisgestaltung (Flash-Lite ist die günstigste Stufe). Ein trainierter Klassifikator auf Hugging Face kostet Rechenzeit. Zum Vergleich: Jev selbst gibt für Input $0,042 pro Million Tokens an, bei kostenlosem Output.
Können diese Alternativen den Kundenservice wie Jev übernehmen?
Keine von ihnen übernimmt den Support von allein, und Jev auch nicht. Sie alle liefern eine Entscheidung, auf die dein eigener Code reagieren muss. Um aus „dieses Ticket ist dringend, an Billing weiterleiten" ein gelöstes Ticket zu machen, brauchst du eine Schicht, die auch deine Ticket-Klassifizierung liest, die Antwort entwirft und die Aktion ausführt. Das ist die Aufgabe eines KI-Helpdesk-Agenten, nicht eines Entscheidungs-Primitivs.
Geben alle TypeSafe Jev Alternativen Konfidenzwerte an?
Nicht auf die gleiche Weise. Jev wird mit RLCD (Reinforcement Learning for Calibrated Decisions) trainiert, sodass seine Wahrscheinlichkeiten die tatsächliche Genauigkeit widerspiegeln sollen. LLM-basierte Optionen legen Token-Logits offen, die du als groben Konfidenzwert lesen kannst, und ein trainierter Klassifikator liefert dir eine Softmax-Wahrscheinlichkeit. Der ehrliche Test für alle ist die Kalibrierung an deinen eigenen Daten, nicht die Zahl selbst.
Welche TypeSafe Jev Alternative eignet sich am besten für Klassifizierung?
Für enge, hochvolumige Klassifizierung ist ein fein abgestimmter Hugging-Face-Klassifikator pro Aufruf am günstigsten, während Gemini structured output auf Flash-Lite am schnellsten aufgesetzt ist. Für support-spezifische Arbeit wie Triage und Routing spart ein KI-Kundenservice-Workflow, der die Klassifizierung bereits mit Aktionen verdrahtet, den Klebe-Code.


Article by
Alicia Kirana Utomo
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.