8 beste Gemini 3.8 Flash Alternativen 2026

Rama Adi Nugraha

Katelin Teen
Zuletzt bearbeitet September 8, 2026
Warum überhaupt über Gemini 3.8 Flash hinausschauen?
Gemini 3.8 Flash ist ein gutes Modell. Es rangiert #3 von 196 bei der Ausgabegeschwindigkeit mit 302 Tokens/Sekunde und erreicht 59 Punkte im Intelligence Index von Artificial Analysis, deutlich über dem Median. Für einen nächtlichen Batch-Job, der sich durch einen großen Rückstand arbeitet, ist es preislich schwer zu schlagen.
Der Haken ist, was diese „härtere Arbeit" kostet. Googles eigene Launch-Notiz ist ungewöhnlich offen darüber:
„Diese Leistungssteigerungen resultieren aus einer grundlegenden Design-Entscheidung: 3.8 Flash arbeitet härter. Bei komplexen Aufgaben zeigt es größere Sorgfalt, führt zusätzliche Reasoning-Schritte aus und ruft Tools iterativ auf. Manchmal nutzt das Modell mehr Tokens, um die Leistung zu maximieren, besonders bei höheren Aufwandsstufen."
Dann der Satz, der deine Entscheidung zum Upgrade eigentlich fällen sollte: Google empfiehlt Entwicklern, denen Compute-Effizienz wichtig ist, sich „weiterhin auf Gemini 3.7 Flash zu verlassen, das für Effizienz-orientierte Workloads voll unterstützt bleibt." Ein Anbieter, der dir sagt, sein vorheriges Modell sei immer noch die richtige Wahl, ist selten genug, um es ernst zu nehmen.
Zwei Zahlen machen daraus einen echten Grund, sich umzuschauen. Erstens misst Artificial Analysis 13,3 Sekunden bis zum ersten Token gegenüber einem Klassen-Median von etwa 3 Sekunden. Durchsatz ist nicht dasselbe wie Reaktionsfähigkeit, und 13 Sekunden Totzeit sind ein Dealbreaker für ein Chat-Widget oder eine Support-Antwort. Zweitens verbraucht es 120 Mio. Output-Tokens, um den AA Index durchzuführen, gegenüber einem Median von 71 Mio., was AA selbst als „sehr wortreich" markiert. Wortreichere Ausgabe bedeutet eine höhere Rechnung bei genau der Output-Rate, die sich im Januar 2027 verdoppelt.
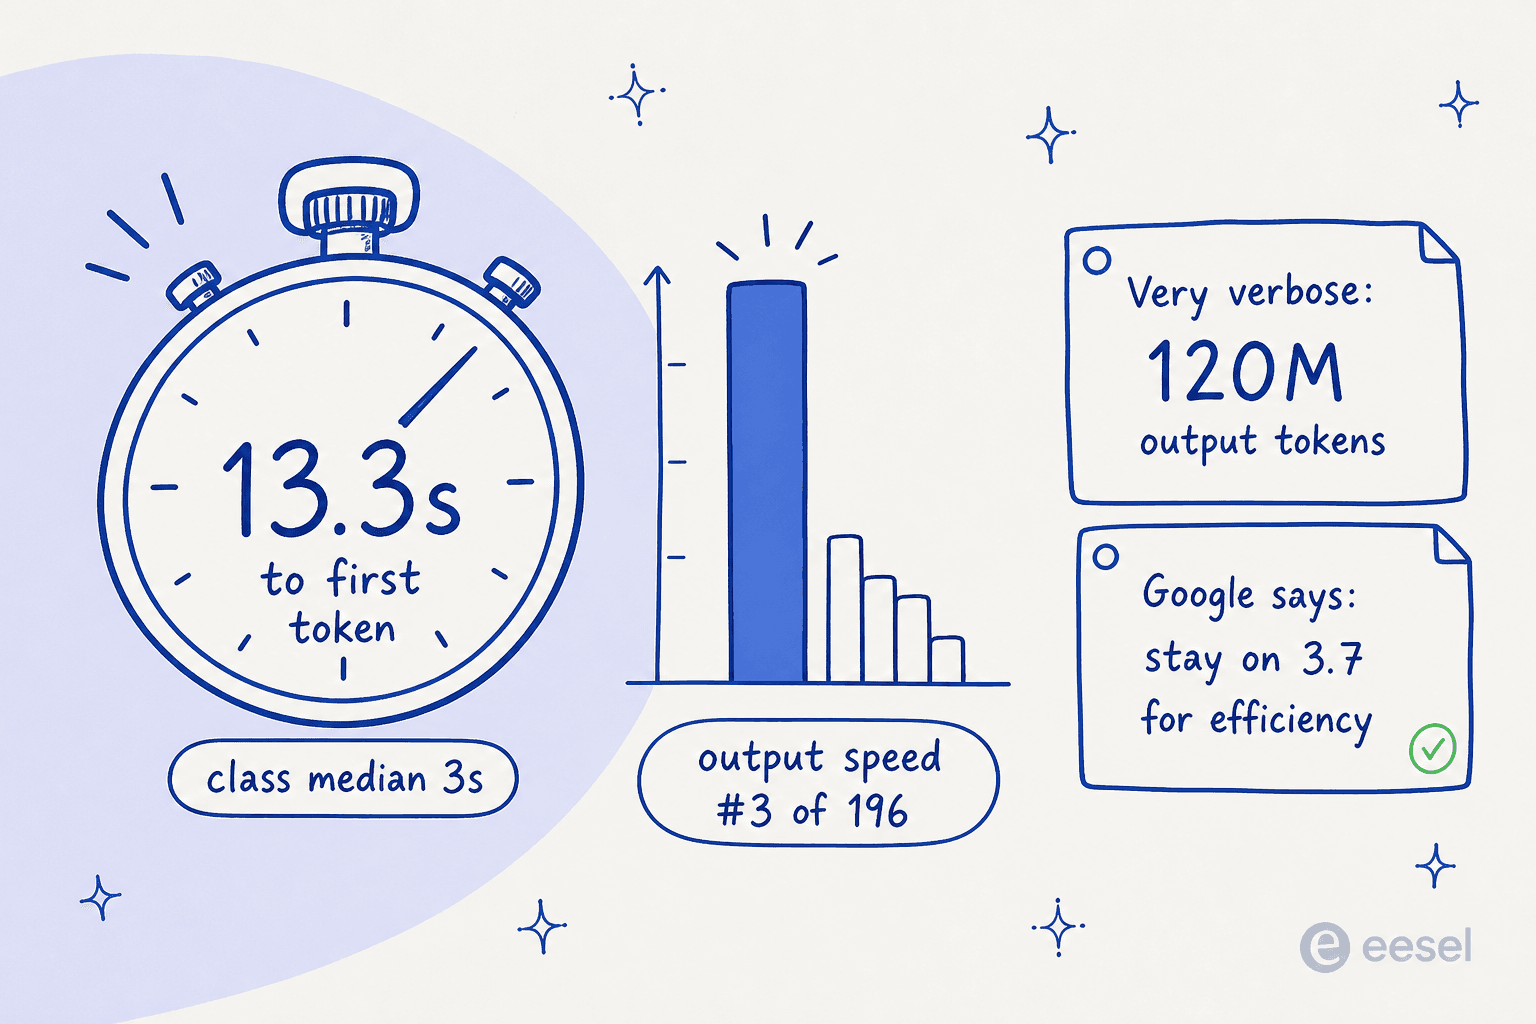
Es geht hier also nicht darum, dass „3.8 Flash schlecht ist." Es geht darum, dass „schnell und günstig" eine Latenz-Mauer und eine Token-Aufblähungs-Steuer verbirgt, und für viele Workloads ist ein anderes Modell, manchmal Googles eigenes älteres, der bessere Tausch.
Wie ich diese Alternativen ausgewählt habe
Ich habe die Liste auf Modelle beschränkt, die tatsächlich im selben Job wie Flash stehen: schnelle, erschwingliche Arbeitspferde mit hohem Volumen, zu denen du greifen würdest, um einen Agenten, einen Klassifizierer oder einen Coding-Assistenten zu betreiben, nicht $30-pro-Million-Flaggschiffe. Für jedes habe ich vier Dinge abgewogen:
- Echte Kosten pro Aufgabe, nicht nur der Listenpreis. Ein Modell, das halb so teuer pro Token ist, aber doppelt so wortreich, ist nicht günstiger. Ausführlichkeit ist der Ort, an dem sich viele „Budget"-Modelle das Geld leise zurückholen.
- Latenz, mit der du leben kannst. Zeit bis zum ersten Token ist wichtiger als der Spitzendurchsatz, sobald ein Mensch am anderen Ende ist.
- Offen vs. geschlossen. Mehrere davon liefern Open Weights, die du selbst hosten kannst, was die Datenresidenz- und Kostenrechnung komplett verändert.
- Was echte Nutzer berichten, aus Hacker-News- und Reddit-Threads, nicht aus den Benchmark-Posts vom Launch-Tag.
Die Preise unten sind pro 1 Mio. Tokens, Standard-Tarif, wie auf der jeweiligen Preisseite des Anbieters aufgeführt. Reasoning- und Thinking-Tokens werden bei jedem Modell hier zur Output-Rate abgerechnet, daher entscheidet meist die Output-Spalte über deine Rechnung.
Gemini 3.8 Flash Alternativen auf einen Blick
| Modell | Am besten für | Input / Output ($/1M) | Open Weights | Kontext | Der Haupthaken |
|---|---|---|---|---|---|
| Gemini 3.7 Flash | Effizienz-orientiert, gleicher Preis | $0.75 / $3.75 | Nein | 1M | Verdoppelt sich Jan 2027; minimal entfernt |
| OpenAI GPT-5.6 (Terra) | Schlankerer Frontier-Ersatz | $2.00 / $12.00 | Nein | 400K | Long-Context-Tarif kostet 2x |
| DeepSeek V4 Flash | Niedrigste echte Kosten | $0.22 / $0.66 (außerhalb Spitzenzeiten) | Ja (MIT) | 1M | Spitzenzeit-Aufschlag; halluziniert; nur Text |
| Kimi K3 | Open-Weight-Reasoning | $3.00 / $15.00 | Ja | 1M | Teuer pro Token; kann Denken nicht abschalten |
| Qwen 3.8 Flash-Next | Langer Kontext, offene Vorschau | ~$0.03-$0.20 in / $0.13-$0.80 out | Ja | 1M | Untertrainierte Vorschau; einziger Anbieter |
| Claude Haiku 4.5 | Zuverlässigkeit + Sicherheit | $1.00 / $5.00 | Nein | 200K | Teurer als das Budget-Paket |
| GLM 5.3 Flash | Günstigstes Multimodal | $0.075 / $0.25 (Promo) | Ja | 200K | Promo endet; kleineres Ökosystem |
| Gemini 3.5 Flash-Lite | Hochvolumige OCR / Klassifizierung | $0.30 / $2.50 | Nein | 1M | Schwächer bei komplexem Reasoning |
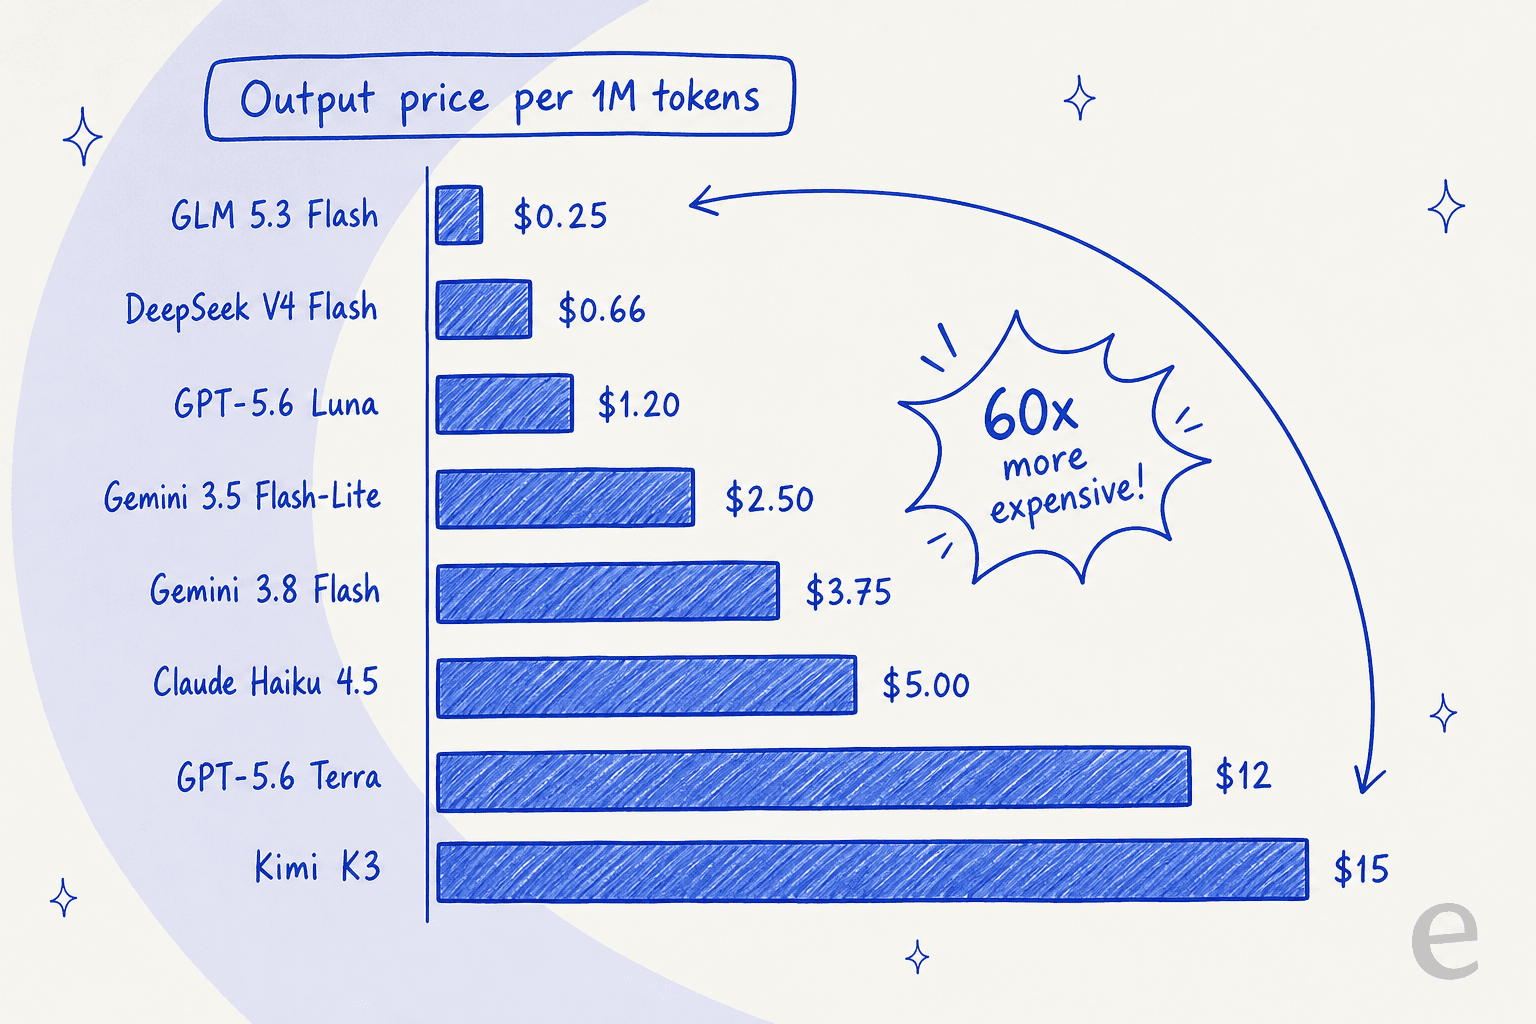
Die Spanne in der Output-Spalte ist die ganze Geschichte: von $0,25 bis $15 pro Million, eine 60-fache Lücke für Modelle, die alle ungefähr in derselben „schnell und günstig"-Kategorie liegen.
1. Gemini 3.7 Flash
Am besten für: Teams, die alles wollen, wofür Flash gut ist, minus den zusätzlichen Token-Verbrauch, zum gleichen Preis.
Die ehrlichste Alternative zu Gemini 3.8 Flash ist das Modell, auf dem es aufgebaut wurde, und Google ist derjenige, der dir das sagt. Weil 3.8 einfach weitertrainiertes 3.7 Flash ist, werden sie identisch abgerechnet, und der einzige echte Unterschied ist, dass 3.8 mehr Arbeit leistet (und mehr Tokens verbraucht) pro Aufgabe. Wenn du nicht die letzten paar Punkte bei einem harten Reasoning-Benchmark jagst, gibt dir 3.7 Flash die gleiche Geschwindigkeit und eine kleinere Rechnung.
Entwickler, die es als günstigen und unermüdlichen Prüfer nutzen, bewerten es hoch:
"I've been using 3.7 Flash to audit the work of Opus High, and Flash finds lots of subtle and insidious defects even while all the unit tests are green... it is blazing fast in Antigravity CLI. Easily 10x faster than Opus."

Vorteile: identischer Preis wie 3.8 Flash, weniger Token-Aufblähung, ein volles 1M-Token-Kontextfenster und dieselbe breite multimodale Eingabe (Text, Bild, Audio, Video, PDF).
Nachteile: Der Einführungspreis verdoppelt sich am 1. Januar 2027 auf $1,50/$7,50, genau wie bei 3.8. Und 3.7 hat die minimal-Denkstufe fallengelassen, sodass die günstigste Untergrenze für OCR und Ticket-Klassifizierung verschwunden ist; low ist jetzt die neue Untergrenze.
Preise: $0,75 Input / $3,75 Output pro 1 Mio. bis Ende 2026.
Fazit: Wenn du sowieso schon zu 3.8 Flash greifst, teste 3.7 Flash zuerst an deinen eigenen Prompts. Neun von zehn Mal erledigt es die Aufgabe für weniger, genau deshalb empfiehlt Google es weiterhin.
2. OpenAI GPT-5.6
Am besten für: Teams, die ein Nicht-Google-Frontier-Modell wollen, das mit weniger Tokens zur Antwort kommt.
GPT-5.6 kommt in drei Varianten, und die Stufe, die tatsächlich mit Flash konkurriert, ist Terra, nicht das günstigere Luna. Der Grund, es gegenüber Gemini in Betracht zu ziehen, ist Effizienz: GPT-Modelle erreichen tendenziell dieselbe Antwort mit deutlich weniger Output, was eine höhere Listenrate bei jeder Output-intensiven Aufgabe ausgleicht. Ein Entwickler brachte den Tausch auf den Punkt:
"Sol high is almost the same speed if you take into account drastically lower token use. Look at the artificial analysis speed vs token use. Gemini is 7x faster but 5x more tokens."
Das ist die ganze GPT-vs-Gemini-Flash-Entscheidung in einem Satz. Rohe Tokens/Sekunde begünstigt Gemini; Tokens pro abgeschlossener Aufgabe begünstigt oft OpenAI. Wenn deine Rechnung vom Output dominiert wird, rechne bei beiden nach. Für die vollständige Übersicht der Stufen schlüsselt unsere OpenAI-Modellliste sie auf.
Vorteile: echtes Frontier-Reasoning, ein riesiges Tooling-Ökosystem, und weniger Wortreichtum als Gemini Flash bei vergleichbaren Aufgaben. Luna ($0,20/$1,20) ist eine echte Budget-Untergrenze, wenn du nach unten tauschen willst.
Nachteile: OpenAI verlangt eine Long-Context-Stufe, die die Rate über das kurze Kontextfenster hinaus verdoppelt, dieselbe 200K-artige Klippe, die xAI nutzt. Gemini und Anthropic tun das nicht. Achte auch auf deine Rate Limits, wenn du hohes Volumen fährst.
Preise: Terra $2,00 Input / $12,00 Output; Luna $0,20 / $1,20; Sol $5,00 / $30,00 pro 1 Mio. (kurzer Kontext).
Fazit: die stärkste Rundum-Alternative, wenn du nicht an Google gebunden bist, besonders wenn dein Workload output-intensiv ist und die Token-Zahl, nicht der Preis pro Token, dich umbringt.
3. DeepSeek V4 Flash
Am besten für: die niedrigsten echten Kosten pro Token unter allen gehosteten Modellen hier, und jeden, der Open Weights will.
DeepSeek V4 Flash ist der Preisbrecher. Ein Mixture-of-Experts-Modell mit 284B gesamt / 13B aktiv und MIT-lizenzierten Gewichten (~167GB, läuft zuhause für unter $10k), listet für $0,22 Input / $0,66 Output außerhalb der Spitzenzeiten, ein Bruchteil von Gemini Flash. Und es hält sich bei echter Arbeit, nicht nur bei den Kosten:
"I benched DS4 flash and Pro vs opus 4.8 xhigh on 16 work-related tasks a month ago across 4 days. Opus 4.8 came out as a winner by 1 task only [...] But flash performed as well or better (as in being more thorough) in 13 out if 16."
Es gibt zwei ehrliche Haken. DeepSeek hat im August 2026 die Preise geändert und fährt jetzt einen Spitzen-/Nebenzeit-Aufschlag, mit Spitzenzeiten von 01:00-04:00 und 06:00-10:00 UTC, sodass eine US- oder EU-Warteschlange meist außerhalb der Spitzenzeit abgerechnet wird, aber ein Batch-Job, der in die chinesischen Geschäftszeiten fällt, zahlt doppelt. Und es halluziniert mehr, als dir gefallen würde:
"DeepSeek V4 hallucinates like crazy and often forgets explicitly mentioned parts of the context."
Noch etwas Wichtiges: Flash ist reiner Text, ohne dokumentierte Bildeingabe, also entscheidet das die Sache, wenn dein Workload Screenshots betrifft. Und bei den Daten schweigen DeepSeeks kostenpflichtige API-Bedingungen zur Trainingsnutzung, statt schützend zu sein, und Daten liegen in der VR China unter chinesischem Recht, also ist es kein Drop-in für regulierte Kundendaten.
Vorteile: die niedrigsten echten Kosten pro Token hier, MIT Open Weights, ein starkes Tool-Nutzungsprofil und vollständig sichtbarer Reasoning-Text, den du steuern kannst.
Nachteile: der Spitzenzeit-Aufschlag, eine echte Halluzinationsrate, keine Bildeingabe und Datenresidenz in der VR China.
Preise: $0,22 Input / $0,66 Output pro 1 Mio. außerhalb der Spitzenzeiten (doppelt zur Spitzenzeit). Die Pro-Stufe kostet mehr.
Fazit: das beste reine Kosten-Spiel auf dieser Liste, und stärker, als „günstig heißt schwach" vermuten lässt. Kombiniere es mit Retrieval und intensivem Testing, um die Halluzinationen im Griff zu behalten, genau wie bei jedem RAG-gestützten Setup.
4. Kimi K3
Am besten für: Open-Weight-Reasoning, das mit den Flaggschiffen konkurriert, wenn du die Kosten pro Token verkraften kannst.
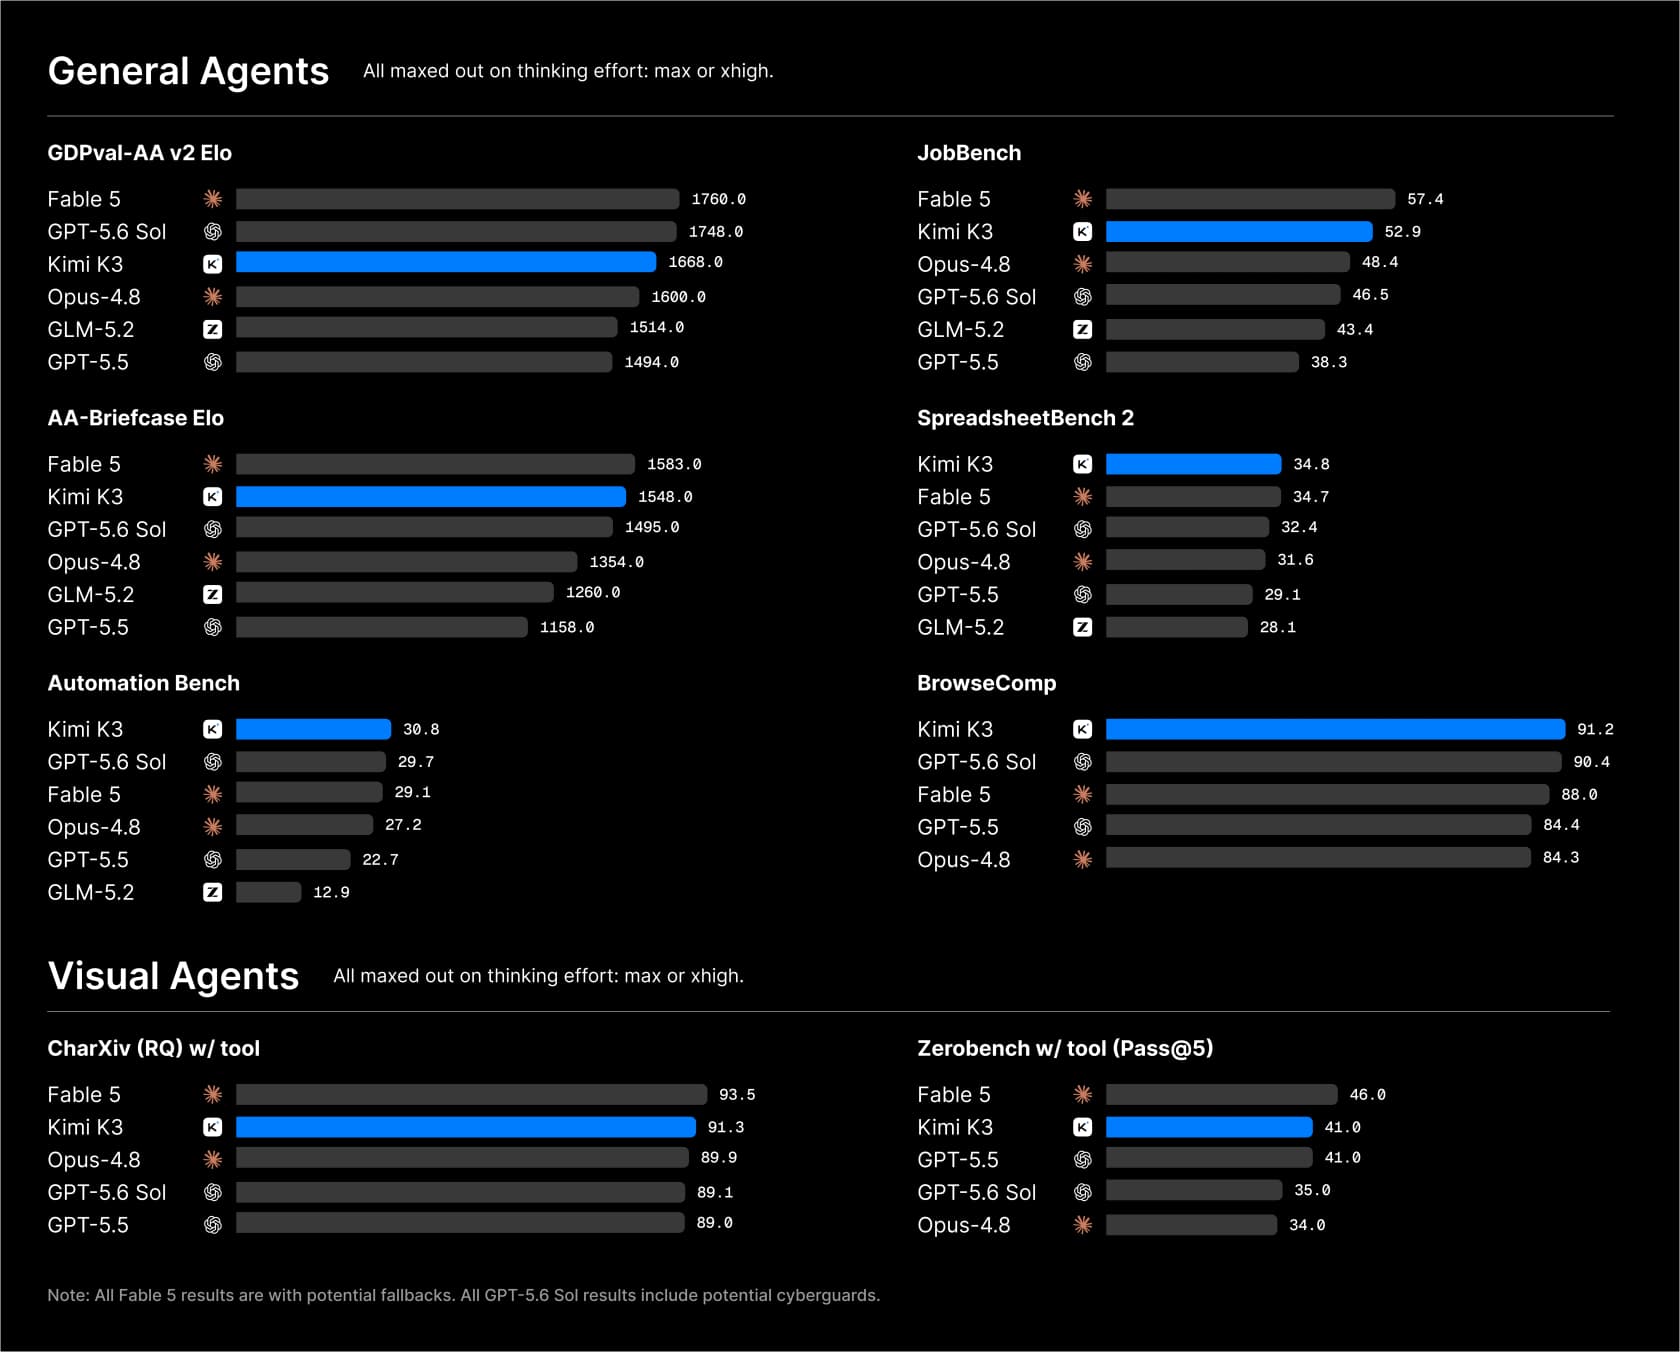
Kimi K3 von Moonshot AI ist das Reasoning-Schwergewicht der Open-Weight-Welt: 2,8T gesamt / 104B aktive Parameter, ein 1M-Token-Kontext, native Vision und Open Weights, die pünktlich erschienen sind. Bei Artificial Analysis landet es bei einem Intelligence Index von 57, Top-5-Territorium, und es führt mehrere Agenten-Benchmarks wie BrowseComp klar an.
Das Problem ist der Preis und das Denken. Bei $3 Input / $15 Output liegt es in Claude Sonnets Bereich, etwa 50x der Output-Rate von DeepSeek Flash, und es kann das Reasoning nicht abschalten. Es gibt eine low-Einstellung, aber das ist eine Latenzkontrolle, keine Kostenstufe, und sie schneidet schlechter ab als DeepSeek Flash, während sie 8x mehr kostet. Nutzer spüren die Langsamkeit:
"Faster iterations are way better for me, I hate waiting for 5-10 minutes on small changes. I tried to use recent versions of Kimi and GLM, but they use too much thinking for no reason and are pretty slow because of it."
Vorteile: Flaggschiff-Reasoning, native Bild- und Videoeingabe, ein 1M-Token-Fenster und Open Weights mit bereits verfügbaren Community-Quants.
Nachteile: teuer pro Token, keine Möglichkeit, das Reasoning abzuschalten, und langsamer, als man von einem „Flash"-Konkurrenten erwarten würde (es ist auch keiner; es ist ein Frontier-Modell). Öffentliche Bild-URLs werden ebenfalls nicht akzeptiert, nur Base64 oder eine hochgeladene Datei-ID.
Preise: $3,00 Input / $15,00 Output pro 1 Mio. ($0,30 Cache-Hit-Input).
Fazit: die Wahl, wenn du echtes Reasoning brauchst und die Option zum Self-Hosting willst, nicht wenn du günstig und schnell brauchst. Wenn dein Maßstab „so gut wie ein Flaggschiff, aber ich besitze die Gewichte" ist, erfüllt K3 ihn; wenn dein Maßstab „Flash bei den Kosten ersetzen" ist, tut es das nicht. Vollständige Aufschlüsselung in unserem Kimi K3 Review.
5. Qwen 3.8 Flash-Next
Am besten für: Long-Context-, High-Cache-Workloads, bei denen Durchsatz im großen Maßstab wichtig ist, auf Open Weights.
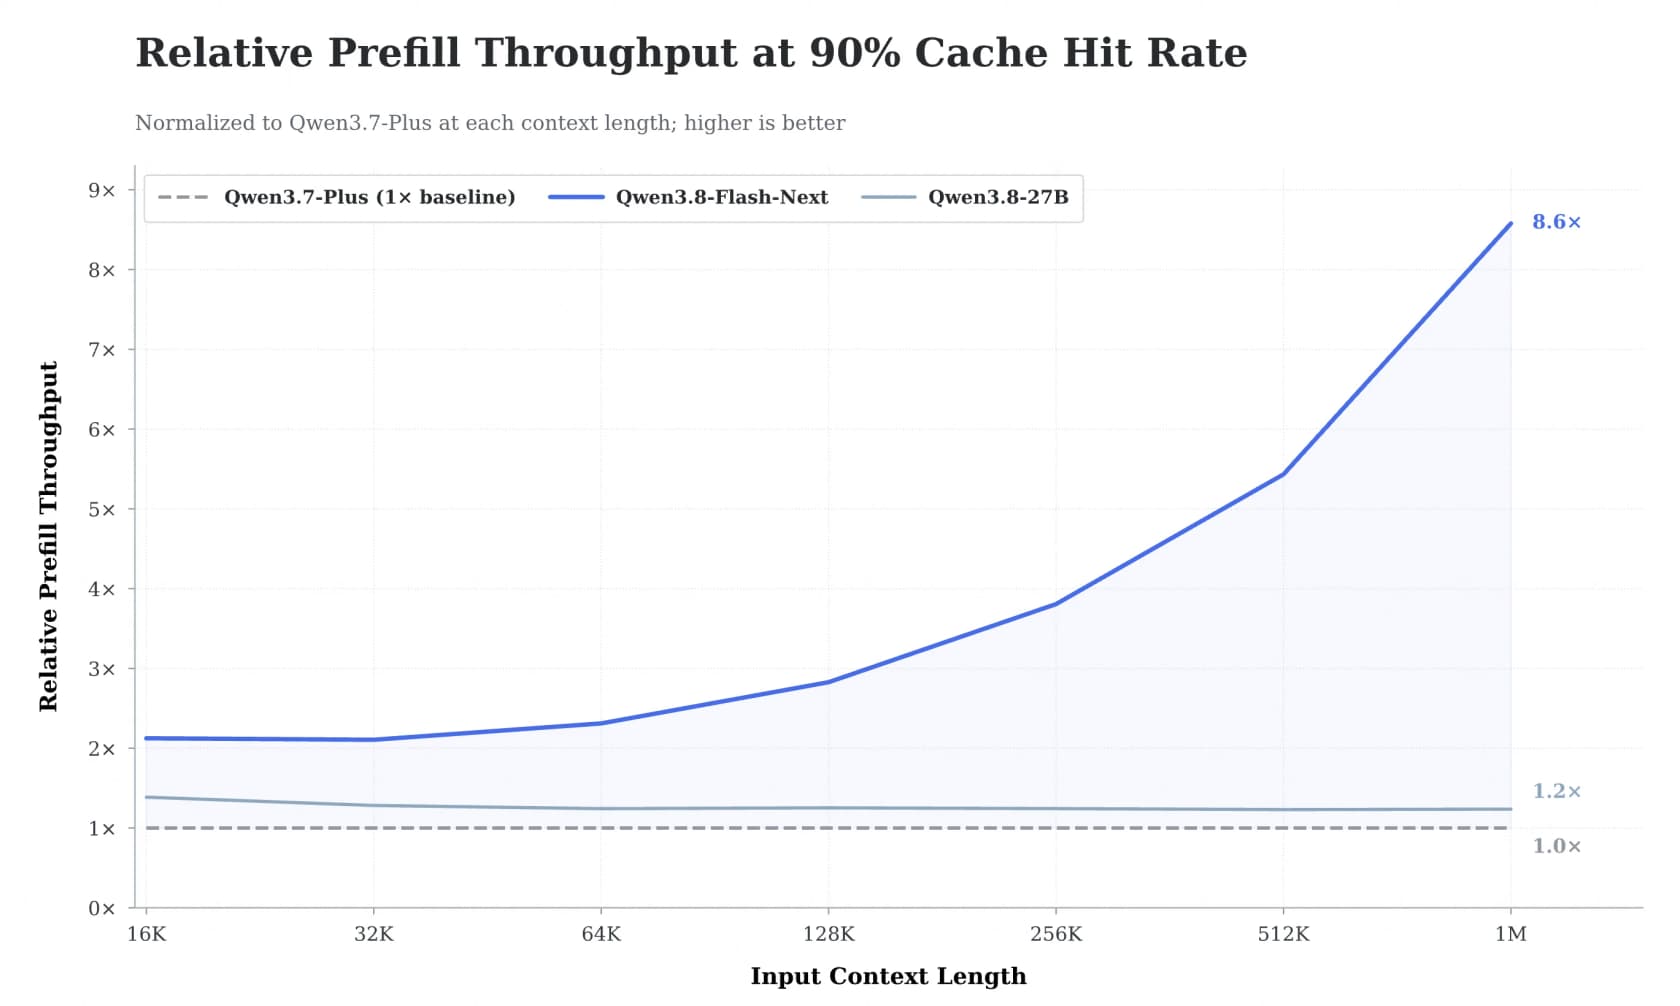
Alibabas Qwen 3.8 Flash-Next ist die interessanteste Kuriosität hier. Es ist eine Vorschau auf Qwens nächste Architektur, und sein Kunststück ist der Prefill-Durchsatz: mit Qwen Sparse Attention erreicht es den 8,6-fachen Durchsatz von Qwen3.7-Plus bei einem 1M-Token-Kontext. Für einen schweren Long-Context-Workload mit hoher Cache-Trefferquote ist diese Skalierung real und schwer zu erreichen. Es liefert Open Weights und bepreist in Stufen, von etwa $0,03/$0,13 pro 1 Mio. bei kurzen Prompts bis zu $0,20/$0,80 beim größten.
Der Haken ist, was „Vorschau" bedeutet. Es ist absichtlich unfertig:
"This model is a preview of Qwen's upcoming Qwen4 architecture... They said the model is intentionally under-trained since it is mainly for R&D purposes of proving the new architecture."
Zusätzlich hat Simon Willison es getestet und bevorzugte am Ende ein kleineres dichtes Modell, was er auf das nötige niedrige Bit-Quant zurückführte, um es unterzubringen, und die gehostete API hat derzeit nur einen einzigen Anbieter, also gibt es kein Failover. Artificial Analysis markiert es auch als „sehr wortreich", 200 Mio. Output-Tokens, um seinen Index abzuschließen, gegenüber einem Median von 110 Mio.
Vorteile: außergewöhnlicher Long-Context-Durchsatz, Open Weights, sehr günstig bei kurzen Prompts, und eine Vorschau darauf, wohin Qwen sich entwickelt. Unser Qwen-Preisleitfaden hat die vollständige Preisstufentabelle.
Nachteile: absichtlich untertrainiert, ein Qualitätsverlust durch Quantisierung, Hosting bei nur einem Anbieter, und wortreicher Output, der die Rechnung aufbläht.
Preise: gestuft, etwa $0,03-$0,20 Input / $0,13-$0,80 Output pro 1 Mio. je nach Prompt-Größe.
Fazit: eine Vorschau auf Forschungsniveau, kein Produktions-Standard. Greife danach, wenn Long-Context-Durchsatz dein Bottleneck ist und du selbst hosten kannst; andernfalls warte auf die fertige Qwen4-Linie. Mehr Optionen in unserer Qwen-Alternativen-Übersicht.
6. Claude Haiku 4.5
Am besten für: Teams, die einen etwas höheren Preis für Zuverlässigkeit und eine sauberere Sicherheitsbilanz in Kauf nehmen.
Claude Haiku 4.5 ist Anthropics schnelles, kleines Modell, und es ist das, zu dem ich greife, wenn die Priorität ein Modell ist, das sich vorhersehbar verhält, statt das absolut günstigste Token. Bei $1 Input / $5 Output kostet es mehr als das Budget-Paket, aber es kommt mit Anthropics Flatrate-Preisgestaltung (kein Long-Context-Aufschlag), einem starken Profil beim Befolgen von Anweisungen und der Tooling-Reife des breiteren Claude-Ökosystems.
Es ist hier wichtig, weil sich zwei Sicherheitsmetriken bei Gemini 3.8 Flash tatsächlich verschlechtert haben: mehrsprachige Sicherheit und unbegründete Verweigerungen bewegten sich beide gegenüber 3.7 in die falsche Richtung, und Google merkte an, dass sich die Sicherheit für Nicht-Englisch „leicht verschlechtert" habe. Wenn du ein mehrsprachiges oder ein reguliertes Publikum bedienst, ist ein Modell mit einer stabileren Sicherheitsbilanz die Prämie wert.
Vorteile: Flatrate-Preise ohne Kontext-Klippe, zuverlässiges Befolgen von Anweisungen, ein ausgereiftes Ökosystem und eine starke Sicherheitshaltung. Gut geeignet für alle, die bereits auf Claude aufbauen.
Nachteile: teurer als DeepSeek Flash, GLM oder die Gemini-Flash-Linie, geschlossene Gewichte, und ein kleineres 200K-Kontextfenster als die 1M-Token-Modelle hier.
Preise: $1,00 Input / $5,00 Output pro 1 Mio.
Fazit: die Wahl „die Zuverlässigkeits-Prämie lohnt sich". Wenn du schon einmal von einem günstigen Modell verbrannt wurdest, das vor Kunden halluziniert hat, kauft Haiku 4.5 viel Seelenfrieden zurück. Sieh, wie es sich in unserem Claude-Alternativen-Leitfaden schlägt.
7. GLM 5.3 Flash
Am besten für: das günstigste echte multimodale Modell hier.
Z.ais GLM 5.3 Flash ist das erste native multimodale Modell der GLM-5-Serie, und in seinem Launch-Angebot ist es das günstigste kostenpflichtige Modell hier: $0,075 Input / $0,25 Output pro 1 Mio. (Listenpreis $0,15/$0,50). Es liefert Open Weights und nimmt, anders als DeepSeek Flash, tatsächlich Bilder entgegen. Frühe Tester bewerten das Preis-Leistungs-Verhältnis hoch:
"Noticeably cheaper even than Gemini Flash 3.7, while being only slightly worse performing. That's actually really impressive."

Es gibt auch einen GLM Coding Plan ($18/$80/$168 pro Monat), der innerhalb von Claude Code, Cursor, Cline und über 20 weiteren Agenten-Tools funktioniert, was es zu einem sehr günstigen Coding-Backend macht, wenn du in einer IDE lebst.
Vorteile: produktionsreife Qualität zu einem Kampfpreis, native multimodale Eingabe, Open Weights und ein dediziertes Coding-Abonnement. Die kostenlosen GLM-4.7-Flash- und 4.5-Flash-Stufen sind ein netter Einstieg.
Nachteile: der 50%-Launch-Rabatt endet, danach verdoppelt sich die Rate auf $0,15/$0,50 (immer noch günstig). Das Ökosystem ist kleiner als das von OpenAI oder Google, und das Flaggschiff-Reasoning-Modell GLM-5.3 ist eine separate, teurere SKU.
Preise: $0,075 Input / $0,25 Output pro 1 Mio. im Angebot; $0,15/$0,50 Listenpreis.
Fazit: der Wertmeister für multimodale Arbeit. Wenn DeepSeek Flashs Nur-Text-Beschränkung es für dich ausschließt, ist GLM 5.3 Flash der günstigste Weg, Bildeingabe zu behalten, ohne Gemini-Flash-Preise zu zahlen.
8. Gemini 3.5 Flash-Lite
Am besten für: hochvolumige Klassifizierung, Tagging und OCR, wo volles Flash Überkapazität ist.
Manchmal ist die richtige Alternative zu Gemini 3.8 Flash ein kleineres Gemini. Gemini 3.5 Flash-Lite ist Googles Budget-, High-Throughput-Modell: $0,30 Input / $2,50 Output, ein 1M-Token-Kontext und multimodale Eingabe. Es ist die Antwort, wenn du viel günstige, gut abgegrenzte Arbeit machst, Felder extrahierst, Tickets taggst, OCR ausführst, wo du keinen Schwergewichts-Reasoner brauchst, der 120 Mio. Tokens verbraucht, um darüber nachzudenken.
Es ist auch das Modell, das die günstige Untergrenze behalten hat, die 3.7 und 3.8 Flash aufgegeben haben. Flash-Lite unterstützt weiterhin die ultra-niedrigen Denkeinstellungen, die die Klassifizierungs-Ökonomie funktionieren lassen, genau der Workload, der teurer wurde, als die neueren Flash-Modelle minimal fallen ließen.
Vorteile: günstiger als volles Flash, ein riesiger 1M-Token-Kontext, starker Durchsatz (~490 Tokens/Sekunde), multimodale Eingabe, und es bleibt innerhalb des Google/Vertex-Ökosystems, das du vielleicht schon nutzt.
Nachteile: schwächer bei hartem Reasoning und agentischen Aufgaben als die vollen Flash-Modelle, kein Computer-Use, und dasselbe Einführungspreis-dann-höher-Muster über die gesamte Gemini-3.x-Linie.
Preise: $0,30 Input / $2,50 Output pro 1 Mio. (Standard).
Fazit: das richtige Downgrade, kein Kompromiss. Für hochvolumige, wenig komplexe Aufgaben erledigt Flash-Lite die Arbeit für ein Drittel des Preises und hält dich auf Google-Infrastruktur.
Die Ebene, auf der du eigentlich einkaufst
Hier ist das, worauf ich immer wieder zurückkomme, weil ich das beruflich baue. Wenn du ein schnelles, günstiges Modell auswählst, um einen Kundensupport-Agenten zu betreiben, ist der Vergleich von Flash gegen DeepSeek gegen GLM die falsche Frage. Das Modell ist der Motor. Es ist nicht das Auto.
Eine reine Modell-API gibt dir einen Text-Ein-, Text-Aus-Endpunkt. Um das in etwas zu verwandeln, das Tickets löst, musst du immer noch deine Wissensdatenbank einbinden, Retrieval aufbauen, damit es aufhört zu halluzinieren, Eskalationsregeln schreiben, es an echten Fällen testen, bevor es einen Kunden berührt, und es für immer überwachen und neu trainieren. Das sind Wochen an Engineering, und du besitzt alles davon, einschließlich des Austauschs des Modells alle sechs Wochen, wenn das nächste Flash erscheint.
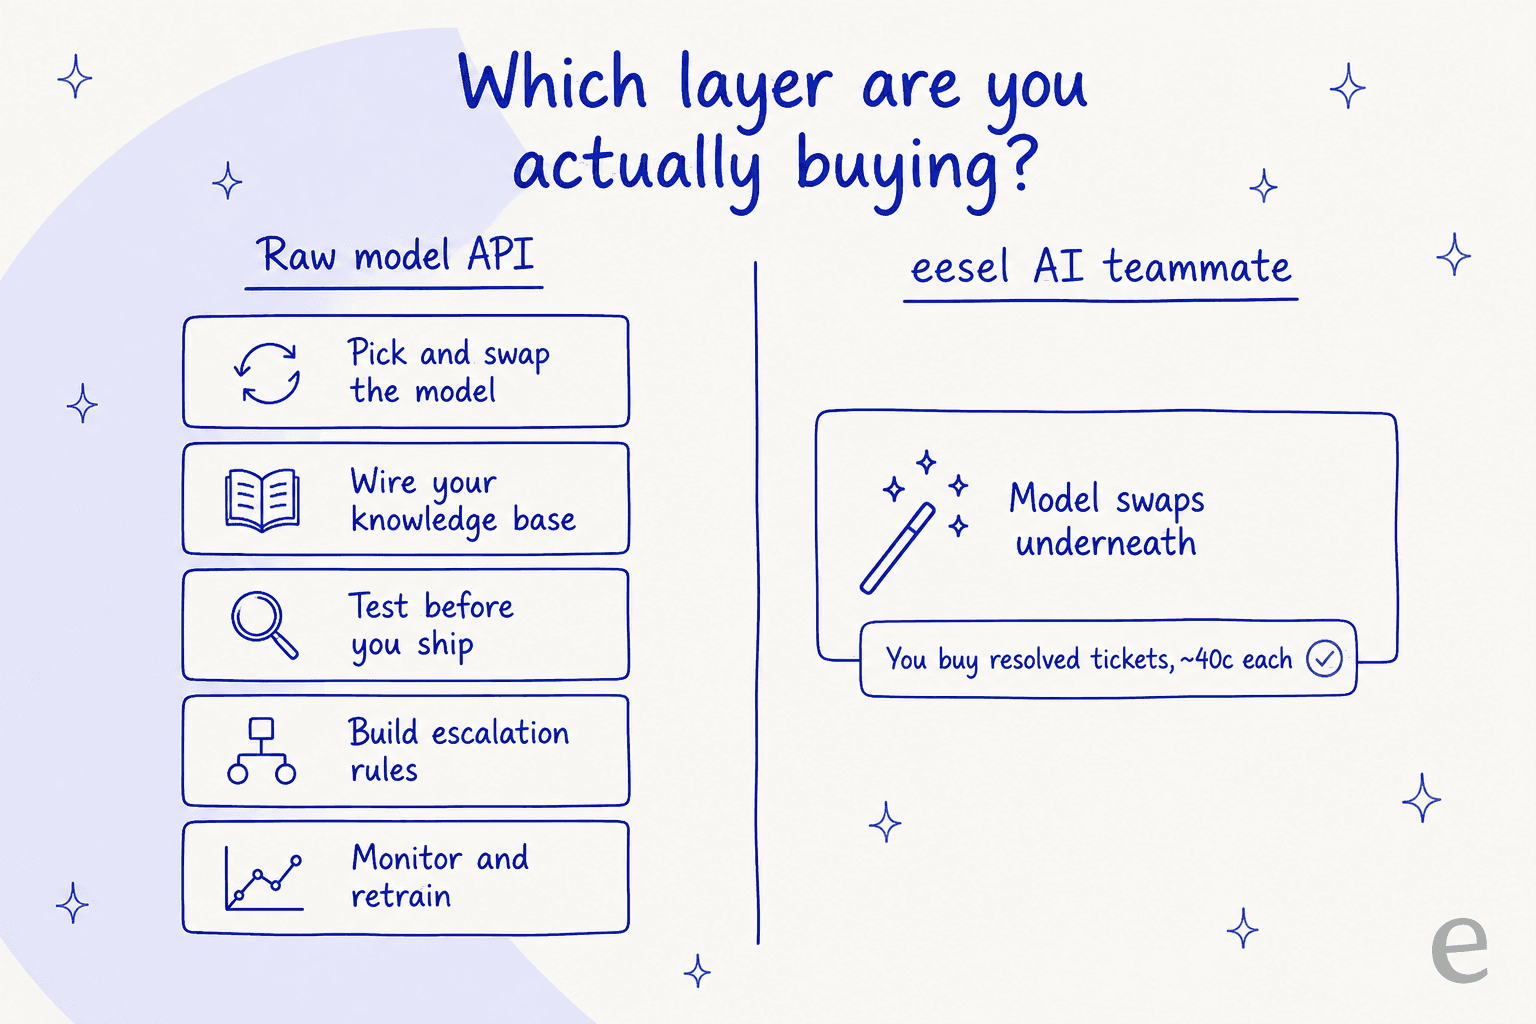
Das ist die Unterscheidung, die es sich zu merken lohnt: ein Modell ist Infrastruktur; ein Kollege ist der Angestellte. Wenn dein Ziel ein funktionierender KI-Coding-Assistent oder eine Forschungspipeline ist, dann ja, wähle das beste Modell und baue. Aber wenn dein Ziel „Support-Tickets gut beantworten" ist, ist der schnellere und günstigere Weg, den fertigen Kollegen zu kaufen und jemand anderen sich darüber Gedanken machen zu lassen, welches Flash diesen Monat gewinnt.
Probiere eesel für Kundensupport
Wenn du hier gelandet bist, weil du ein schnelles, günstiges Modell willst, um Support zu übernehmen, ist eesel die Ebene über dem Modell, die tatsächlich die Arbeit macht. Es ist eine KI-Kollegen-Plattform, und der einsatzbereite Kollege dafür ist der KI-Helpdesk-Agent: Er tritt deiner bestehenden Warteschlange bei, trainiert auf deinen vergangenen Tickets und deiner Wissensdatenbank und beginnt, Konversationen zu lösen, ohne Modell-Fummelei.
Zwei Dinge machen ihn perfekt für dieses genaue Problem. Erstens ist er von Design her modellagnostisch, sodass die Frage „ist Gemini 3.8 Flash oder DeepSeek Flash besser?" zu eesels Problem wird, nicht zu deinem; wir wählen und tauschen das zugrunde liegende Modell aus, während sie sich verbessern. Zweitens, und das ist die Narbe, die dir jedes dieser schnellen Modelle beibringt, simuliert eesel jedes Rollout gegen deine historischen Tickets, bevor es live geht, sodass du die echte Lösungsrate siehst und die selbstsicheren, aber falschen Antworten abfängst, bevor ein Kunde es tut. Möchtest du es lieber von einem Terminal oder einem Skript aus steuern? Es gibt eine vollständige eesel CLI, damit Coding-Agenten und CI-Pipelines denselben Kollegen bedienen können. Die Abrechnung ist nutzungsbasiert bei etwa 40 Cent pro gelöstem Ticket, sodass du für Ergebnisse zahlst, nicht für Tokens. Es ist kostenlos zum Ausprobieren.
Häufig gestellte Fragen
Was ist die beste Gemini 3.8 Flash Alternative für niedrige Kosten?
Ist Gemini 3.7 Flash eine gute Alternative zu Gemini 3.8 Flash?
Wie viel kostet Gemini 3.8 Flash im Vergleich zu Alternativen?
Welche Gemini 3.8 Flash Alternative ist am besten für den Kundensupport?
Gibt es Open-Weight-Alternativen zu Gemini 3.8 Flash?


Article by
Rama Adi Nugraha
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.