Die tatsächlichen TypeSafe-Jev-Preise
Hier ist jede veröffentlichte Zahl an einem Ort. TypeSafe hat keine eigene Preisseite, und jede URL-Variante, die ich ausprobiert habe (typesafe.ai/pricing, docs.typesafe.ai/pricing, typesafe.ai/docs/pricing), liefert einen 404-Fehler. Die Zahlen unten stammen direkt von der Startseite und dem Launch-Beitrag.
| Posten | Jev | Anmerkungen |
|---|---|---|
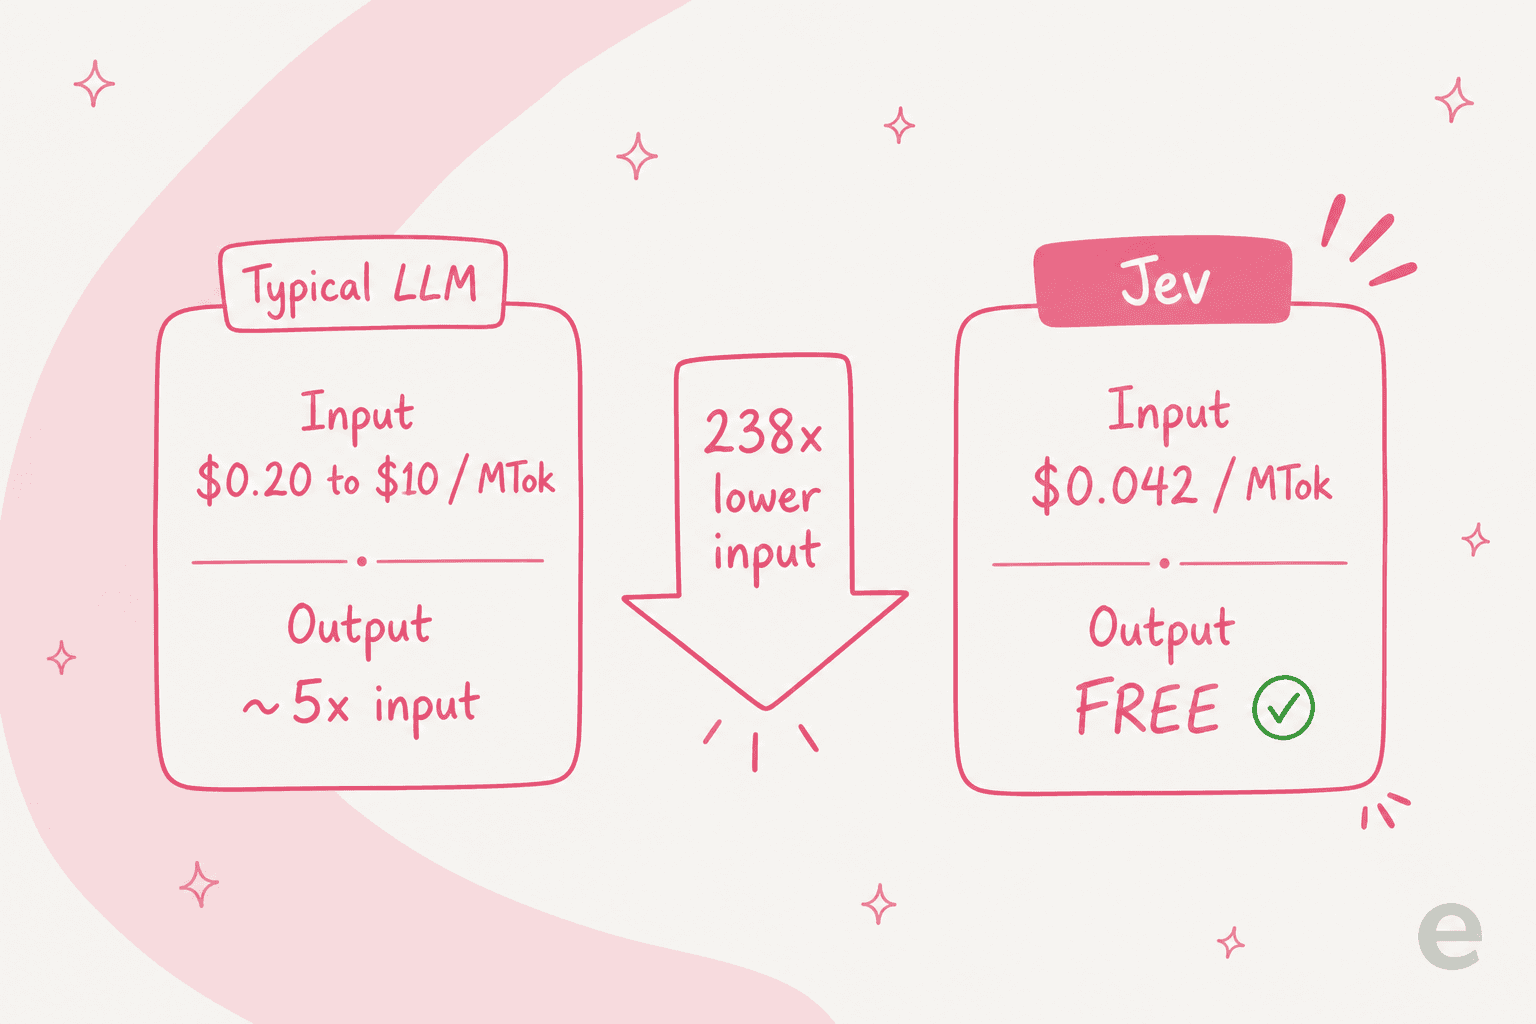
| Input-Tokens | 0,042 $ / MTok | 42 $ pro Milliarde Input-Tokens |
| Output-Tokens | Kostenlos | TypeSafe nennt es "zu billig, um es abzurechnen" |
| Vergleichsanspruch | 238-fach niedrigerer Input | Gegenüber Claude Fable 5.1 Input-Preisen |
| Plan-Stufen | Keine veröffentlicht | Keine benannten Pläne oder Stufentabellen |
| Kostenlose Stufe | Nicht angegeben | Zugang über Early-Access-Warteliste |
| Rate-Limits | Nicht veröffentlicht | Eine Launch-Demo lief mit ~10 Anfragen/Sek. für ~7 $/Stunde |
| Kontextfenster | 32.000 Tokens | Modellversion jev-1.13.0 |
| Cloudflare | Abrechnung im Dashboard | Modell-ID typesafe/jev |
Der illustrative Vergleich auf der Startseite setzt einen einzelnen Jev-Aufruf bei 0,000081 $, gegenüber 0,013880 $ für ein LLM, das dieselbe Art von Arbeit erledigt. Das ist die Zahl, die TypeSafe als Screenshot verbreitet sehen möchte, und für einen reinen Entscheidungsaufruf ist sie fair.
Warum der kostenlose Output wichtig ist
Bei den meisten LLM-Preismodellen ist der Output die teurere Hälfte, oft etwa das 5-Fache des Input-Satzes. Das liegt daran, dass der Wert eines Chatbots der Absatz ist, den er schreibt, und Absätze sind viele Tokens. Jev dreht das um. Ein System-One-Modell erzeugt keinen Fließtext, es liefert eine typisierte Entscheidung plus einen Konfidenzwert, sodass die Output-Nutzlast eine Handvoll Bytes umfasst. Sie auf null zu bepreisen kostet TypeSafe fast nichts und entfernt die beängstigendste Zeile aus Ihrer Rechnung.
Die praktische Lesart: Wenn Ihr Workload wirklich aus einem Strom kleiner typisierter Fragen besteht, "ist_dringend", "welche Abteilung", "wie frustriert ist dieser Kunde", dann läuft Jevs Zähler fast ausschließlich über den Input-Zustand, den Sie senden, und dieser Zustand ist meist klein. Das ist dieselbe Form wie die Ticket-Triage-Arbeit, die Cloudflare selbst als eigenes Jev-Beispiel verwendet, was kein Zufall ist.
Modellieren Sie Ihre eigene Rechnung
Zahlen auf einer Startseite sind das eine, Ihr tatsächliches monatliches Volumen ist etwas anderes. Geben Sie ein, wie viele Entscheidungen Sie pro Monat treffen und wie groß der durchschnittliche Input ist, und dies vergleicht Jev mit einem typischen LLM in TypeSafes eigener genannter Spanne. Die LLM-Sätze sind editierbar, weil "typisch" davon abhängt, welches Modell Sie verwenden.
Eine Warnung zum Lesen dieses Multiplikators: Es ist ein Tokenkosten-Vergleich nur für den Entscheidungsschritt. Es ist keine Gesamtbetriebskosten-Zahl, denn ein echter Support-Flow tut mehr als nur entscheiden.
Was der Preis nicht enthält
Hier verdient sich ein Preisbeitrag seinen Wert. Der 0,042-$-Satz ist real und niedrig, aber er kauft Ihnen nur eine schmale Sache. Hier ist, was außerhalb des Zählers liegt:
- Generierung. Jev kann die Antwort nicht schreiben. Es liefert eine Entscheidung, keinen Satz. Wenn Ihr Support-Workflow eine verfasste Antwort braucht, zahlen Sie für diese Hälfte weiterhin ein LLM.
- Orchestrierung. Sie müssen die Schleife bauen, die den Zustand sendet, die Entscheidung ausliest und danach handelt. Die Tokenkosten sind trivial, das Engineering nicht.
- Aktionen. "Das eskalieren" zu entscheiden ist quasi kostenlos. Das tatsächliche Eskalieren, Taggen, Erstatten oder Weiterleiten des Tickets ist Ihre Integrationsarbeit.
- Ein vorhersehbarer Sitzplatz- oder Resolution-Preis. Es gibt keinen Plan, keine SLA-Stufe, keinen veröffentlichten Rabatt für Committed Use. Für ein Team, das ein Budget gegen menschliche Kosten planen muss, ist "ein Input-Satz und eine Warteliste" dünn.
Nichts davon macht Jev zu einem schlechten Angebot. Es macht es zu einer Komponente. Das richtige mentale Modell ist, dass Jev die Entscheidungs-Primitive bepreist, und der Rest Ihres Kundenservice-Automatisierungs-Budgets liegt anderswo.
Ist es subventioniert? TypeSafe sagt: vielleicht
Günstige KI-Preise werfen immer die Frage "verbrennen sie VC-Geld?" auf, und TypeSafe beantwortet sie direkt. Aus dem Launch-Beitrag:
"We make our pricing transparent. We can't prove it isn't subsidized; we'll need the long-term to prove the sustainability of our pricing (which we expect to go down, not up)."
Das ist ehrlicher als die meisten Launch-Texte. Der Gegenbeweis ist technisch: Auf Hacker News hat ein Kommentator den Preis in eine Größenschätzung zurückgerechnet.
"At 0.042-per-million price they have, Astra estimates the model to be 3bn parameters."

Ein Modell mit ~3 Milliarden Parametern ist günstig zu betreiben, sodass ein niedriger nachhaltiger Preis plausibel statt fantastisch ist. Der Top-Kommentar im Thread widersprach der Darstellung dennoch, mit dem Argument, die Geschwindigkeits- und Kostenvergleiche würden Jev schmeicheln, weil es die Generierung komplett überspringt:
"Seems like a more accurate title would be 'Jev: Trading general purpose generation for fast typed inference'... the speed comparison seems misleading?"
Die Preis-Begeisterung auf X war ebenfalls real, und das von einem namentlich genannten Betreiber. Vercels CEO berichtete, es schlage GPT Luna bei einem Produktions-Reviewer:
"Jev is up to 18x faster (p95) and more accurate. It's coming to @vercel AI Gateway and likely new default."
Liest man das zusammen, lautet das Preis-Fazit: Der Satz ist echt und niedrig, das "238-fach" ist ein Best-Case-Einzelaufruf-Vergleich, und der ehrliche Einsatzbereich sind Entscheidungen, nicht alles.
Wo das ein Support-Team zurücklässt
Wenn Sie einen Helpdesk betreiben, ist die interessante Frage nicht "wie günstig sind die Tokens", sondern "was kostet die fertige Automatisierung und was leistet sie". Ein Tier-1-Deflection-Flow, der triagiert, entwirft und löst, braucht Generierung und Aktionen zusätzlich zur Entscheidung. Jev kann das schnelle, günstige Triage-Gehirn darin sein, aber es ist nicht der KI-Agent selbst.
Das ist die Trennlinie, auf die ich immer wieder zurückkomme: Jev ist Infrastruktur, eine Entscheidungs-Primitive, mit der Sie bauen. eesel ist der Mitarbeiter. Unser KI-Helpdesk-Teammitglied tritt Ihrer bestehenden Warteschlange bei, trifft den Triage-Route-Eskalations-Aufruf und schreibt die Antwort und führt die Aktion aus, und simuliert dann das Ganze an Ihren historischen Tickets, bevor es live geht. Wir berechnen pro Lösung, nicht pro Token, sodass die Zahl auf der Rechnung der tatsächlich geleisteten Arbeit entspricht, nicht der Anzahl der Ja/Nein-Aufrufe, die im Hintergrund passiert sind. Es ist eines von wenigen einsatzbereiten KI-Teammitgliedern, kein rohes Modell, das Sie selbst zusammensetzen.

Und wenn Sie im Terminal leben: Dasselbe Teammitglied lässt sich über die eesel-CLI steuern. Das ist kein zweites, angeflanschtes Produkt, sondern derselbe eesel-Workspace und -Agent, nur zum Skripten freigelegt: Eine Person kann ihn von Hand ausführen, ein Cron-Job kann ihn automatisieren, und ein Coding-Agent wie Claude Code oder Cursor kann ihn über die CLI und eesels MCP-Server steuern. Wenn der Grund, aus dem Sie Jev kalkuliert haben, also war, ein Entscheidungsmodell in eine agentische Pipeline von der Kommandozeile aus einzubinden, können Sie dieselbe Pipeline stattdessen auf ein Teammitglied richten, das Ihr Help Center bereits kennt und auf dem Ticket handeln kann, nicht nur es bewerten.
Möchten Sie die fertigen Kosten sehen, nicht die Tokenkosten? eesel läuft auf Ihren eigenen Tickets in einer kostenlosen Testversion, sodass Sie beobachten können, was eine Lösung wirklich kostet, bevor Sie sich festlegen.
Das Fazit zu den TypeSafe-Jev-Preisen
Jev kostet 0,042 $ pro Million Input-Tokens bei kostenlosem Output, und für einen reinen Entscheidungs-Workload ist das eine sehr niedrige Zahl. Sie ist durch einen echten Vorbehalt begrenzt: keine Plan-Stufen, keine öffentliche Gratisstufe, eine Warteliste für den Zugang und ein Preis, von dem das Unternehmen selbst zugibt, dass es ihn noch nicht als nachhaltig beweisen kann. Modellieren Sie es als günstige Entscheidungs-Primitive, nicht als Drop-in-Ersatz für das LLM, das Ihre Antworten schreibt, und die Geschichte der TypeSafe-Jev-Preise ist leicht zu durchdenken. Ob Sie Ihren gesamten Support-Stack darauf aufbauen sollten, ist eine andere Frage, und eine, die es wert ist, mit dem vollständigen Test daneben geöffnet zu beantworten.
Häufig gestellte Fragen
Wie viel kostet TypeSafe Jev?
TypeSafe bepreist Jev mit 0,042 $ pro Million Input-Tokens bei kostenlosem Output, was das Unternehmen als 238-fach niedrigeren Input-Preis gegenüber Claude Fable 5.1 darstellt. Es gibt noch keine veröffentlichte Plan-Stufen-Tabelle, sodass dieser eine Input-Satz derzeit praktisch die gesamte TypeSafe-Jev-Preisgestaltung ausmacht.
Gibt es eine kostenlose Stufe für TypeSafe Jev?
Keine Self-Service-Gratisstufe. Der Zugang erfolgt über eine Early-Access-Warteliste statt über eine öffentliche Anmeldung mit Gratis-Guthaben. Output-Tokens sind kostenlos, sobald Sie zugelassen sind, aber der Input-Satz gilt weiterhin, und TypeSafe hat kein monatliches Freikontingent veröffentlicht. Wenn Sie KI für Ihre eigene Ticket-Klassifizierung schon heute testen möchten, bietet eesel eine echte kostenlose Testversion.
Warum ist der Jev-Output kostenlos?
Ein System-One-Modell erzeugt keinen langen Text. Sein Output ist eine typisierte Entscheidung, eine Wahrscheinlichkeit und ein Konfidenzwert, sodass die Output-Nutzlast im Vergleich zur Antwort eines Chatbots winzig ist. TypeSafe nennt den Output-Satz "zu billig, um es abzurechnen" und bepreist nur den Input-Zustand, den Sie senden. Das ist eine echte Lücke in den meisten LLM-Preismodellen, wo der Output meist die teurere Hälfte ist.
Wie schneidet die Jev-Preisgestaltung im Vergleich zu LLM-Preisen ab?
Nach TypeSafes eigener Darstellung kosten Frontier-LLMs 0,20 $ bis 10 $ pro Million Input-Tokens, bei einem Output-Satz von etwa dem 5-Fachen des Input-Satzes. Jev berechnet 0,042 $ für Input und nichts für Output. Für eine Klassifizier- oder Routing-Aufgabe ist das eine große Lücke, aber sie gilt nur, wenn die Aufgabe eine typisierte Entscheidung ist, keine Textgenerierung. Ein umfassenderes Frontier-Beispiel finden Sie unter Google-Gemini-3-Preise.
Ist die TypeSafe-Jev-Preisgestaltung subventioniert?
TypeSafe ist hier ungewöhnlich direkt. Im Launch-Beitrag heißt es, man könne nicht beweisen, dass der Preis nicht subventioniert sei, und man erwarte, dass sich die Nachhaltigkeit der Preisgestaltung erst langfristig zeigen werde, wobei man mit sinkenden statt steigenden Preisen rechne. Community-Schätzungen auf Hacker News gehen von einem Modell mit rund 3 Milliarden Parametern aus, was niedrige Betriebskosten plausibel macht.
Wo kann ich Jev kaufen oder darauf zugreifen?
Zwei Wege. Direkt über die TypeSafe-Konsole ab der Warteliste, oder über Cloudflare Workers AI mit der Modell-ID typesafe/jev, wobei die Abrechnung im Cloudflare-Dashboard erfolgt.
Bedeutet die günstige Jev-Preisgestaltung, dass ich mein Support-LLM damit ersetzen kann?
Nur für die Entscheidungsschritte. Jev kann ein Ticket günstig triagieren, bewerten und weiterleiten, aber es kann die Antwort nicht schreiben. Ein produktiver Support-Flow braucht weiterhin Generierung, Aktionen und Eskalation. Das übernimmt ein Teammitglied wie eesel oberhalb des reinen Modells, und eesel berechnet pro Lösung statt pro Token.


Article by
Kurnia Kharisma Agung Samiadjie
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.