Der Preis, direkt vorweg
Hier ist die komplette Claude Mythos 5.1 Preistabelle. Jede Zahl unten gilt bis auf den Cent genauso für Fable 5.1, ein Punkt, auf den ich noch zurückkomme.
| Meter | Preis (pro Million Tokens) | Anmerkungen |
|---|---|---|
| Basis-Input | $10,00 | Unverändert gegenüber Fable 5 |
| Basis-Output | $50,00 | Unverändert gegenüber Fable 5 |
| Batch-Input | $5,00 | 50 % Rabatt, Message Batches API |
| Batch-Output | $25,00 | 50 % Rabatt |
| Cache-Write (5 Minuten) | $12,50 | 1,25x Basis-Input |
| Cache-Write (1 Stunde) | $20,00 | 2x Basis-Input |
| Cache-Read | $0,25 | 2,5 % des Basis-Inputs, die Hauptänderung |
Die Spezifikationen hinter diesen Zahlen lohnen sich zu nennen, damit du eine Rechnung abschätzen kannst: 1M-Token-Kontext, 128K maximaler Output, adaptives Thinking, das immer aktiv ist, eine standardmäßige high-Effort-Einstellung und ein Wissensstand von Juni 2026. Mythos 5.1 läuft auf der Claude API, Amazon Bedrock, Google Cloud und Microsoft Foundry, und diese Plattformen setzen ihre eigenen regionalen Raten obendrauf.
Beachte, was nicht hier steht: keine Pro-Platz-Gebühr, kein monatliches Minimum, keine Plan-Stufen. Das ist rohes Modell-Pricing, pro Token abgerechnet, deine tatsächlichen Kosten sind also eine Funktion davon, wie viel Text hineingeht, wie viel herauskommt und wie viel vom Input du aus dem Cache bedienen kannst. Diese letzte Variable ist das ganze Spiel bei diesem Release.
Der Cache-Read ist die eigentliche Neuigkeit
Jedes andere aktuelle Claude-Modell bepreist einen Cache-Treffer mit 10 % seiner Basis-Input-Rate. Mythos 5.1 und Fable 5.1 bepreisen ihn mit 2,5 %. Bei einem $10-Input-Modell sind das $0,25 pro Million Tokens statt $1,00.
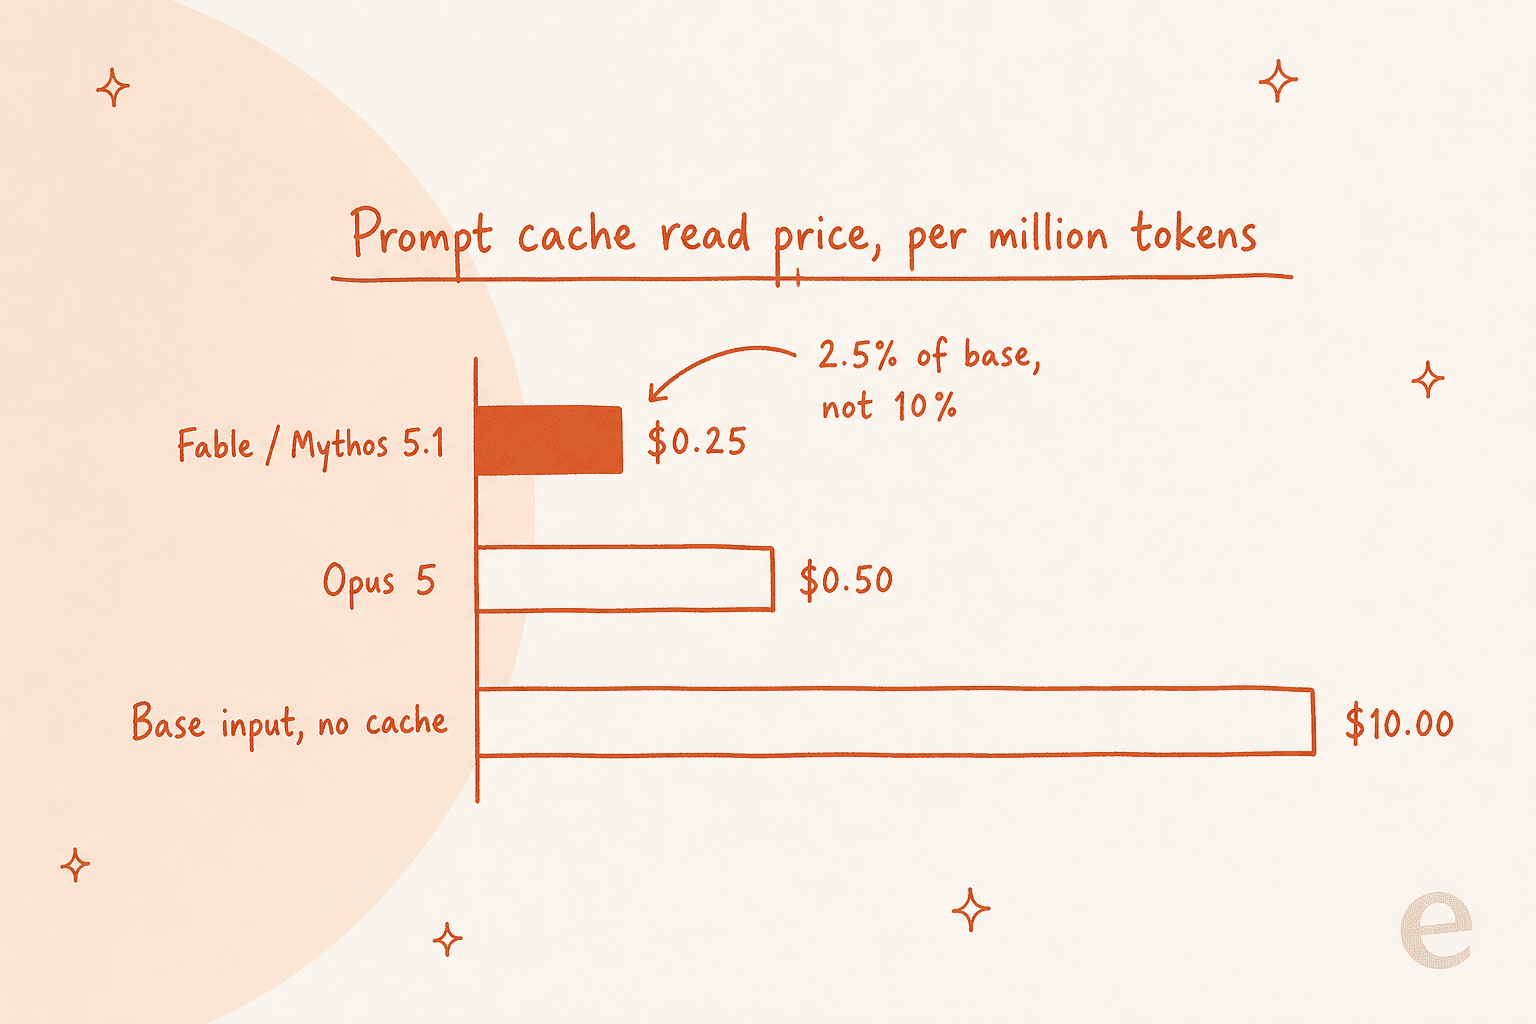
Die Zahl, bei der die Leute zweimal hinschauen: ein Mythos-5.1-Cache-Read kostet die Hälfte eines Opus-5-Cache-Reads ($0,25 gegenüber $0,50), obwohl Mythos pro Basis-Input-Token doppelt so viel kostet. Anthropic sagt damit im Kern: Der teure Teil ist das Nachdenken über neue Tokens, und das erneute Lesen bereits verarbeiteter Tokens sollte fast kostenlos sein.
Das ist wichtig wegen wo die Tokens in einem echten Agenten landen. Eine Coding-CLI oder ein langlaufender Support-Agent sendet bei jeder Runde sein gesamtes Transkript erneut. Runde 20 könnte eine Million Tokens Kontext mitführen, fast alles davon ein Cache-Treffer. Wenn der Cache-Read um das Vierfache fällt, fällt der dominierende Posten dieser Art von Rechnung mit ihm. Wie Simon Willison es auf Hacker News formulierte:
"Bit of a discount if you're using caching... This should impact any long-running agent since subsequent calls can benefit from cached reads for previous transcripts."

Anthropic hat nach der Auswertung von vier Wochen Nutzung im August 2026 reale Zahlen genannt: etwa 25 % günstiger für typische Arbeitslasten und bis zu rund 45 % günstiger für stark agentische. Die Aufteilung hängt vollständig davon ab, wie cache-intensiv die Arbeit ist.
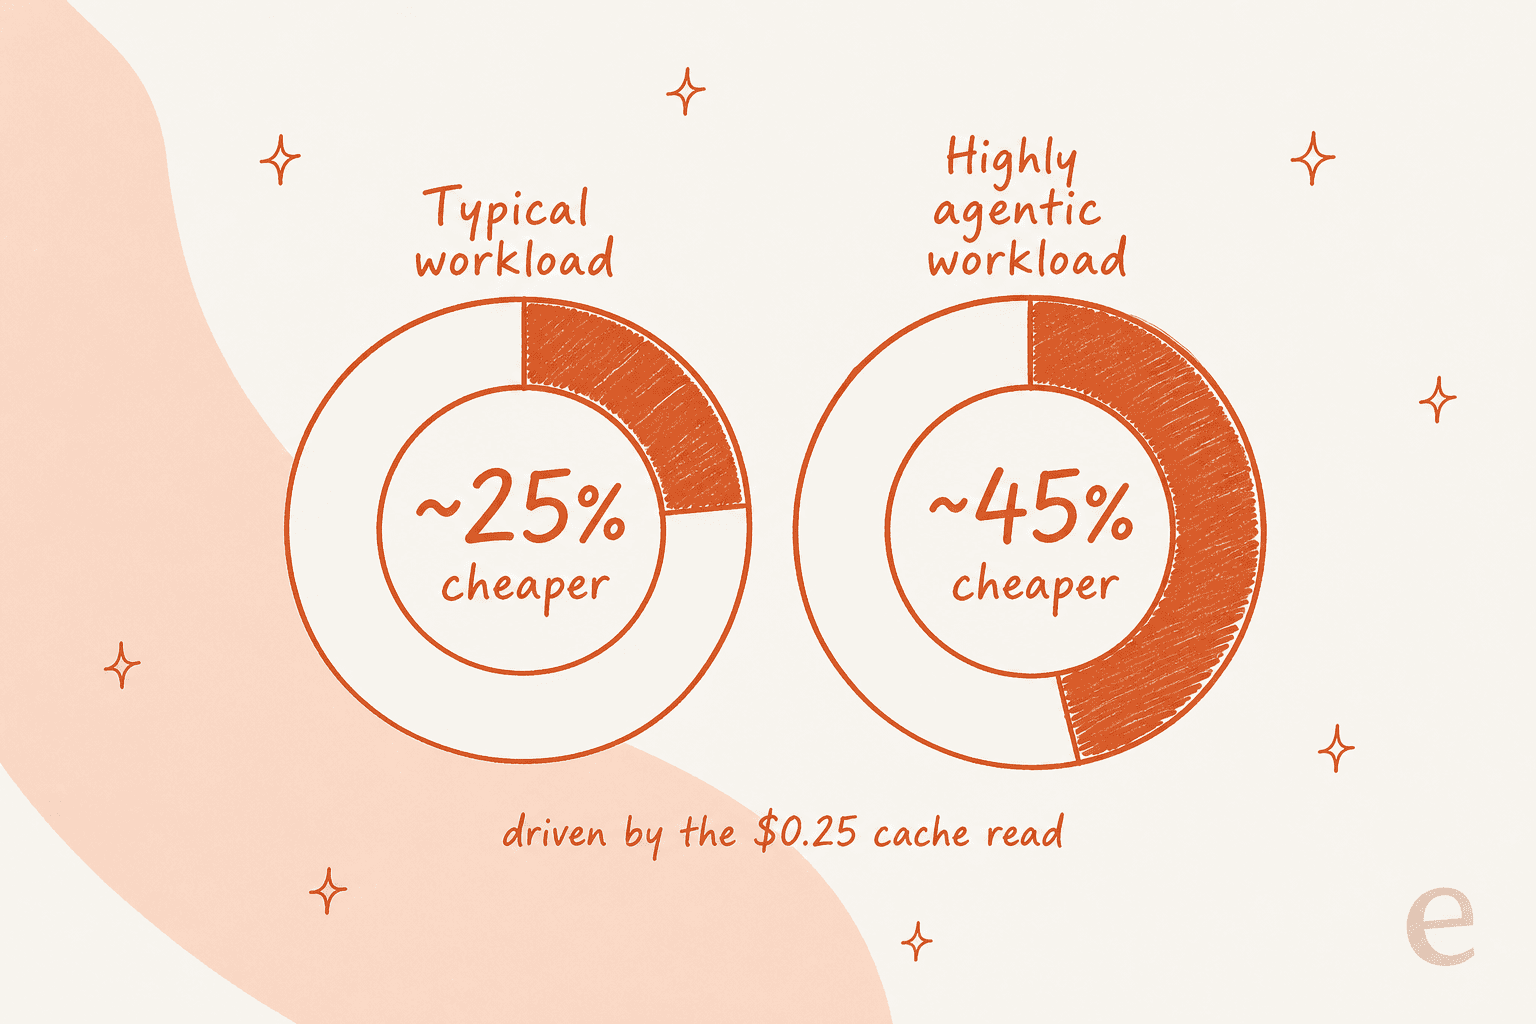
Hier das ehrliche Gegengewicht, denn ein Preis-Beitrag schuldet dir auch die Skeptiker. Der günstigere Cache-Read greift nur, wenn Cache-Reads einen großen Anteil deiner Ausgaben ausmachen. Output-Tokens kosten weiterhin $50 pro Million und haben sich nicht verändert. Ein Hacker-News-Kommentator, fastball, rechnete ein 20-Runden-Beispiel durch: eine Konversation, die bei 1M Tokens Kontext endet, kam auf $72,00 bei Fable 5 und $64,88 bei Fable 5.1, weil die $50 an Output-Tokens auf beiden identisch waren. Günstiger, aber nicht die 25 %, die man erwarten könnte, wenn man nur die Schlagzeile überfliegt. Und ein anderer Nutzer wurde deutlicher: "This is just cache reads. In real usage it costs 15% more than Fable 5." Die Lehre daraus: Rechne deinen eigenen Token-Mix durch, statt anzunehmen, die Top-Line-Prozentzahl gelte für dich.
Um das einfach zu machen, gib deine eigenen Zahlen ein:
Mythos und Fable kosten dasselbe, weil sie dasselbe Modell sind
Das ist die Tatsache, die die ganze Preisfrage neu einordnet. Mythos 5.1 und Fable 5.1 sind dasselbe zugrunde liegende Modell mit denselben Gewichten. Der einzige Unterschied ist die Sicherheitsschicht: Fable 5.1 wird mit aktivierten Produktions-Sicherheitsmechanismen benchmarkt, und wenn ein Sicherheitsmechanismus greift, übergibt er die Aufgabe an ein anderes Modell. Mythos 5.1 läuft ohne diesen Eingriff.
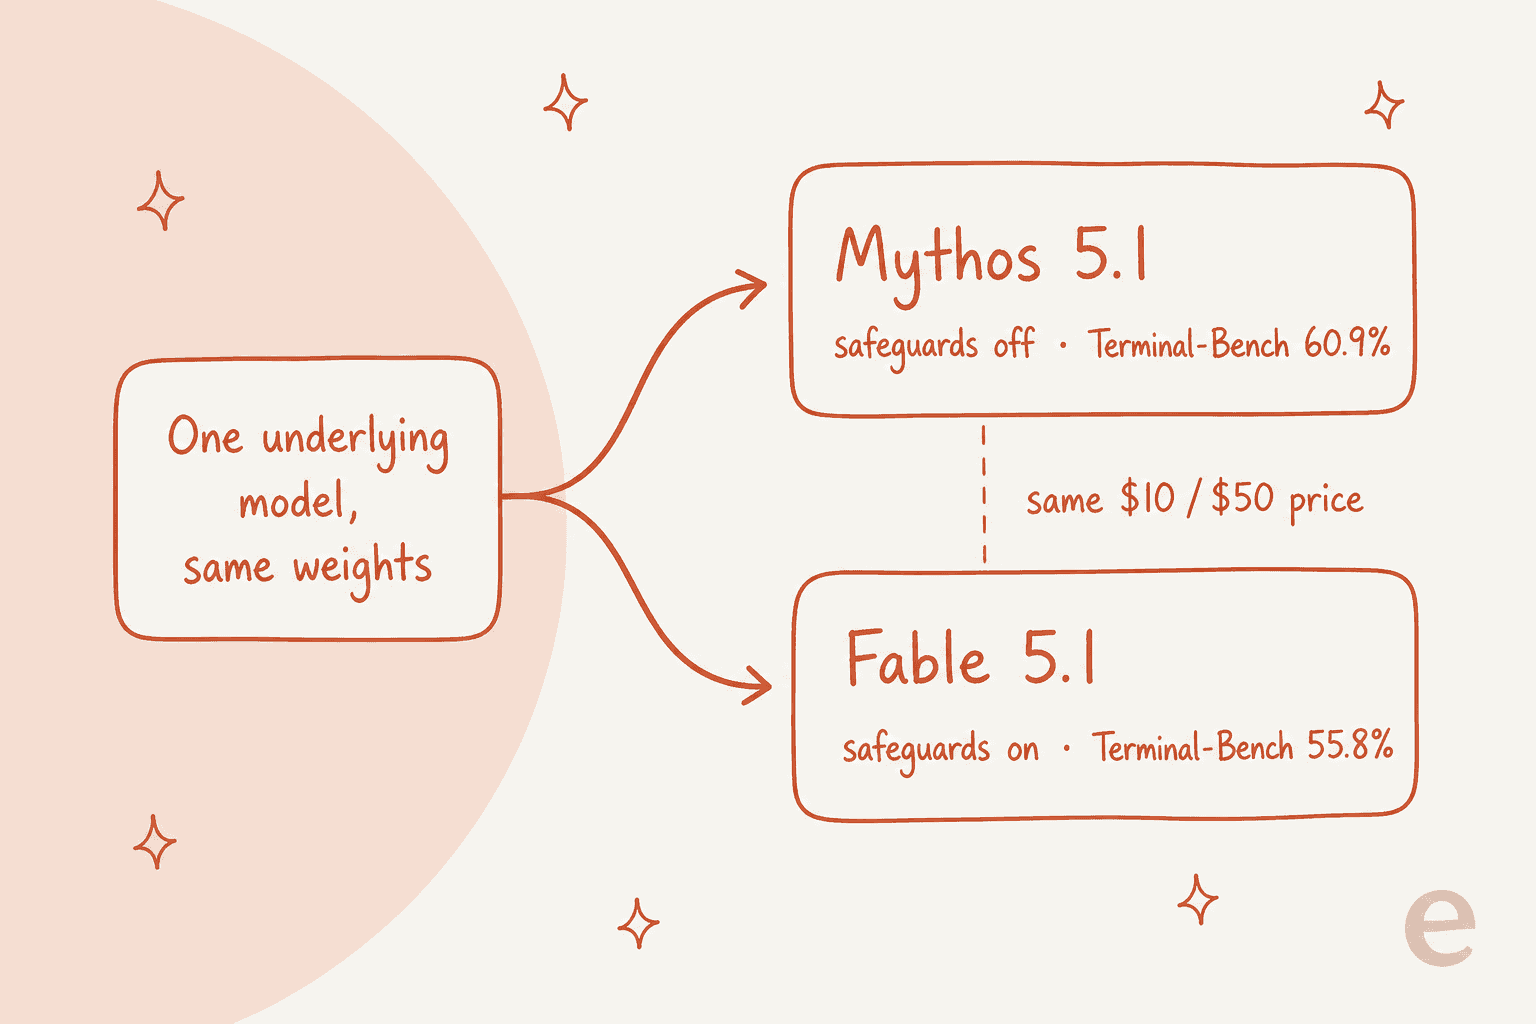
Wenn du also siehst, dass Mythos 5.1 mit 60,9 % auf Terminal-Bench 4.0 gegen die 55,8 % von Fable 5.1 abschneidet, ist diese Lücke kein schlaueres Modell. Es ist die Steuer, die die Sicherheitsmechanismen erheben, wenn sie eingreifen und eine Aufgabe umleiten. Anthropic erwartet, dass die Lücke schrumpft, sobald die Sicherheitsmechanismen präziser werden. Sie identisch zu bepreisen ist der ehrliche Schritt, denn du zahlst in beiden Fällen für dieselben Gewichte.
Das erklärt auch, warum die Basisrate trotz Point-Release nicht gefallen ist. Auf Hacker News las GodelNumbering den Cache-Read-Schnitt eher als Nachfragesignal als als Großzügigkeit:
"This gives a lot of credit to the theory that Anthropic did not get much bite on Fable at its original pricing, which in turn likely places a ceiling on LLM pricing in general."
Ob diese Lesart richtig ist oder nicht, für einen Käufer ist die praktische Erkenntnis klar: Du wählst nicht zwischen zwei Preispunkten. Du wählst zwischen zwei Sicherheitskonfigurationen bei einem Preispunkt.
Der Preis, den du planen solltest, ist der von Fable, weil du Mythos nicht nutzen kannst
Hier ist der Teil, den die meisten Preis-Beiträge auslassen. Eine Zahl auf einer Preistabelle ist nur real, wenn du das Modell auch aufrufen kannst. Bei Mythos 5.1 können das die meisten Teams nicht.
Der Zugang ist heute auf die USA beschränkt und läuft über eine von drei Türen: Anthropics Cyber Verification Program (bei dem Mythos-Zugang "in naher Zukunft" versprochen, aber noch nicht live ist), das Life Sciences Verification Program (eine Invite-only-Beta, die mit der US-Regierung aufgebaut wurde) oder ein direktes Gespräch mit deinem Anthropic-, AWS- oder Google-Cloud-Account-Team. Zusätzlich erfordert die Nutzung von Mythos 5.1 standardmäßig die Zustimmung zu einer 30-tägigen Datenspeicherung, was in einer Beschaffungsprüfung eine eigene Zeile ist.
Für alle anderen ist das Modell, das du tatsächlich produktiv einsetzen kannst, Fable 5.1, verfügbar auf der Claude API, Bedrock, Google Cloud und Foundry ohne Verifizierungssperre. Und da es dieselben Gewichte sind, ist "welches bietet den besseren Wert" die falsche Frage. Du kaufst Fable 5.1, du planst mit dem Fable-5.1-Preis, und die Tatsache, dass beide Preistabellen identisch sind, bedeutet, dass du nichts verlierst, wenn du keinen Mythos-Zugang hast. Die Mythos-Preistabelle liest sich am besten als Bestätigung dessen, was du für Fable zahlen wirst, nicht als eigenständiges Angebot zum Vergleichen.
Drei API-Änderungen, die deine Rechnung und deinen Workflow betreffen
Preisgestaltung ist nicht nur die Rate pro Token, sondern auch, was deine Integration tun muss, um diese Rate zu erreichen. Drei breaking API-Änderungen kommen mit dieser Generation und gelten auch für Fable 5.1, berücksichtige sie also bei jeder Migration:
- Erzwungene Tool-Nutzung liefert jetzt einen Fehler. Wenn dein Agent darauf angewiesen war, einen bestimmten Tool-Call zu erzwingen, bricht dieses Muster, und du musst den Tool-Use-Flow überarbeiten.
- Thinking-Blöcke sind an das Modell gebunden, das sie erzeugt hat. Du kannst ein Thinking-Transkript nicht mehr frei von einem anderen Modell abspielen.
- Neue API-Accounts können früheren Kontext nicht bearbeiten, während das Thinking-Transkript erhalten bleibt. Das ist eine Anti-Distillation-Maßnahme und verändert, wie du lange Agenten-Loops strukturieren kannst.
Keine dieser Änderungen verändert den Listenpreis, aber sie können die Entwicklungszeit verändern, was die echten Gesamtbetriebskosten jeder Modell-Migration ausmacht. Kalkuliere den Umbau ein, nicht nur die Tokens.
Wie es sich gegen den Rest der Modellreihe schlägt
Stellst du Mythos 5.1 neben die Modelle, gegen die du es realistisch abwägen würdest, ist das Bild weniger "Premium-Stufe, Premium-Preis", als es die Basisrate nahelegt, sobald Caching ins Spiel kommt.
| Modell | Input / Output (pro M) | Cache-Read (pro M) | Kontext |
|---|---|---|---|
| Mythos 5.1 / Fable 5.1 | $10 / $50 | $0,25 | 1M |
| Opus 5 | $5 / $25 | $0,50 | 1M |
| Sonnet 5 | $2 / $10 | $0,20 | 1M |
| Haiku 4.5 | $1 / $5 | $0,10 | 200K |
Opus 5 kostet an der Basis nur die Hälfte, aber sein Cache-Read ist doppelt so teuer. Bei einer Arbeitslast, die überwiegend aus Cache-Treffern besteht, verkleinert sich die effektive Lücke zwischen Opus 5 und Mythos/Fable 5.1 deutlich, was genau der Fall ist, für den Anthropic optimiert. Bei einer Arbeitslast, die überwiegend aus frischem Input und Output besteht, bleibt Opus 5 klar günstiger. Es gibt keine einzige "günstigeres Modell"-Antwort, weshalb der Rechner oben mehr zählt als jedes Leaderboard.
Es lohnt sich, den Elefanten im Raum zu benennen, so wie es der Hacker-News-Thread tat: günstigere Open-Source- und chinesische Modelle bepreisen Cache-Reads inzwischen im einstelligen Cent-Bereich, und mehrere Kommentatoren argumentierten, dass das eine Obergrenze für das setzt, was Frontier-Labs verlangen können. Die Mythos-5.1-Preise sind eine Reaktion auf diesen Druck, keine Immunität davor.
Probiere eesel aus
Wenn du eine Modell-Preisseite liest, versuchst du normalerweise, eine nachgelagerte Frage zu beantworten: Was wird es tatsächlich kosten, Support-Tickets zu lösen oder Content zu schreiben. Das ist eine andere Frage als "was ist die Rate pro Token", und es ist die, die eesel beantworten soll.
Das Modell ist Infrastruktur. eesel ist die Mitarbeiterin, die du darauf einstellst. Du provisionierst kein Mythos oder Fable, zählst keine Cache-Reads und reservierst keine Kapazität. Du holst dir einen einsatzbereiten KI-Teammate für eine bestimmte Aufgabe, und heute besteht das Aufgebot aus einem KI-Helpdesk-Teammate, der sich in deine bestehende Support-Warteschlange einreiht, und einem KI-Blog-Autor. Jeder kommt mit den Fähigkeiten, Integrationen und dem Unternehmenskontext für seine Rolle, und der Preis richtet sich nach gelöstem Ergebnis, nicht nach Token, sodass eine Rechnung, die du vorhersagen kannst, die Token-Mathematik auf dieser Seite ersetzt.
Und weil Entwickler fragen: eesel lässt sich über die eesel CLI steuern, sodass derselbe Teammate, den du im Dashboard konfigurierst, aus einem Terminal bedient, in Skripten automatisiert oder von einem Coding-Agenten wie Claude Code, Codex oder Cursor gesteuert werden kann. Wenn dein Interesse an den Mythos-5.1-Preisen eigentlich darauf abzielte, ein Modell in einen Support- oder Content-Workflow einzubinden, ist das die Schicht, die aus einem rohen Modell tatsächlich erledigte Arbeit macht. Es ist kostenlos zum Testen.
Häufig gestellte Fragen
Wie viel kostet Claude Mythos 5.1?
Warum kostet Claude Mythos 5.1 genauso viel wie Fable 5.1?
Was kostet der Claude Mythos 5.1 Cache-Read?
Kann ich Claude Mythos 5.1 tatsächlich nutzen?
Lohnen sich die Claude Mythos 5.1 Preise gegenüber Opus 5?


Article by
Kurnia Kharisma Agung Samiadjie
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.