Warum überhaupt über Fable 5.1 hinausblicken
Lass mich zuerst fair zum Platzhirsch sein, denn Fable 5.1 ist ein starkes Modell. Es startete am 1. September 2026, steht an der Spitze der Claude-5-Familie und führt nach Anthropics eigenen Evals jeden veröffentlichten Benchmark an, mit den größten Sprüngen bei langfristiger agentischer und wissenschaftlicher Arbeit. Es bietet ein 1M-Token-Kontextfenster mit einheitlicher Preisgestaltung pro Token über das gesamte Fenster, 128k maximale Ausgabe und adaptives Denken, das immer aktiv ist. Der einzige Preisschritt im Jahr 2026 war ein guter: Cache-Reads fielen um 75 %, von 1 $ auf 0,25 $ pro Million Tokens, was typische Kosten um etwa 25 % senkt und stark agentische Fälle um bis zu 45 %.
Warum schaut sich also überhaupt jemand um? Ein paar konkrete Gründe kamen immer wieder auf.
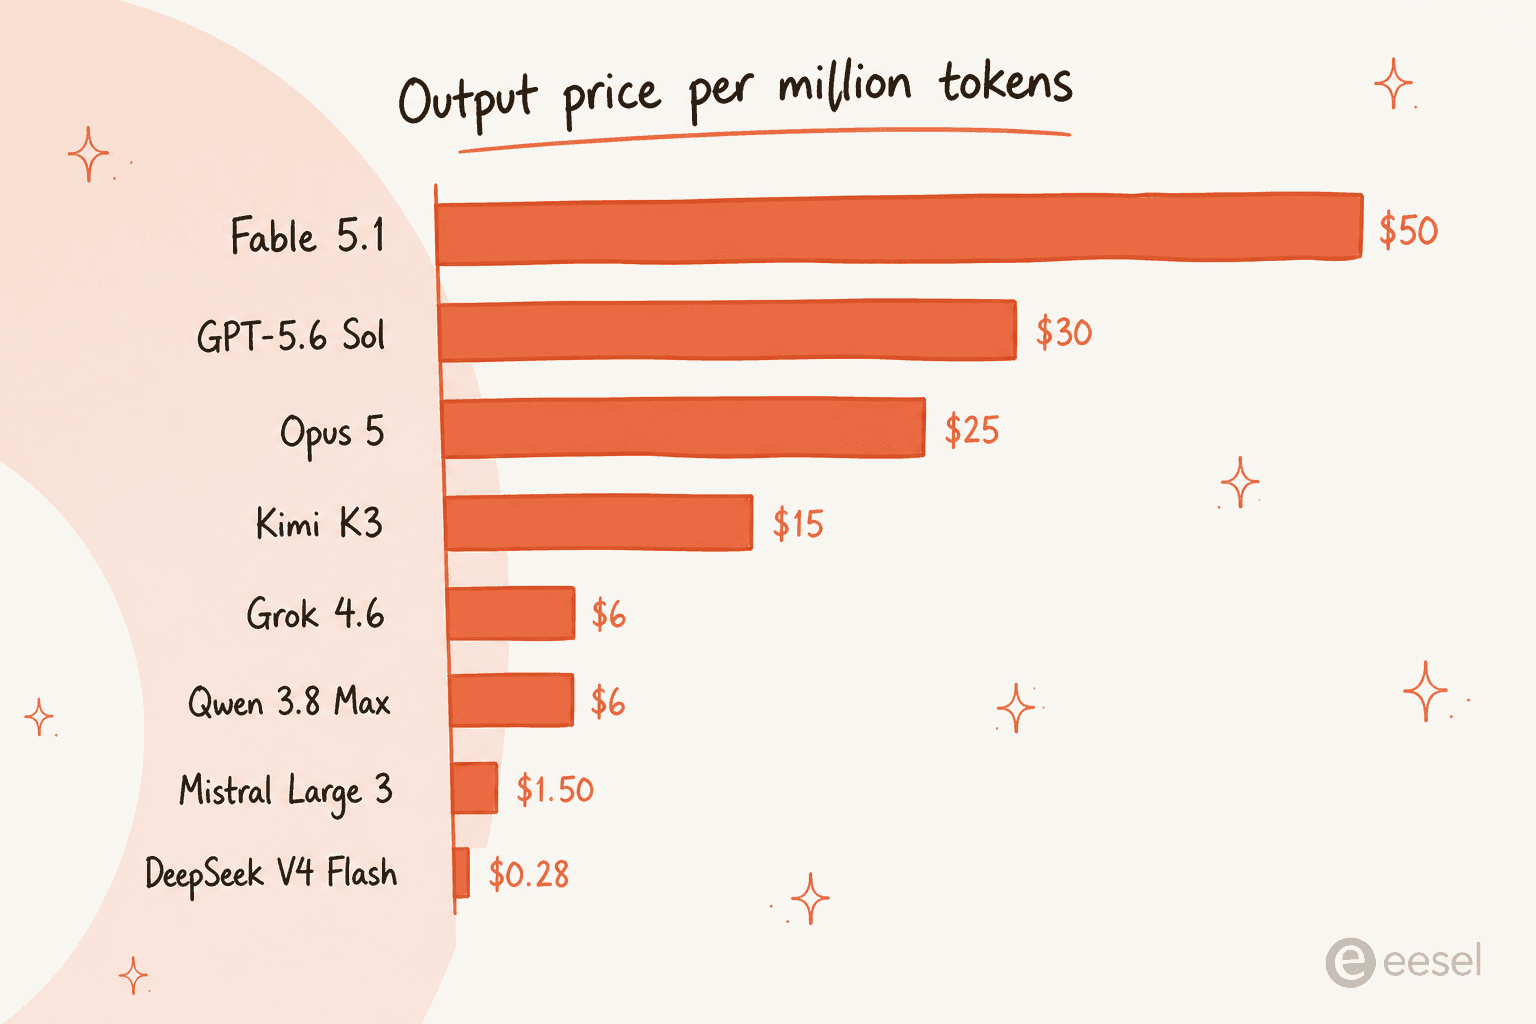
- Preis. Die Basisrate liegt weiterhin bei 10 $/50 $, dem höchsten Preisschild in dieser Übersicht. Wenn deine Arbeitslast nicht die lange, unübersichtliche Multi-Tool-Art ist, für die Fable gebaut ist, zahlst du für Spielraum, den du nicht nutzen wirst.
- Verweigerungen. Mehrere Entwickler auf Hacker News berichteten von falsch-positiven Verweigerungen, unter anderem beim Sicherheits-Review ihres eigenen Codes. Anthropic sagt, Claude-Code-Nutzer sollten etwa 60 % weniger Cyber-Sicherheitseingriffe sehen als bei Fable 5, aber es ist eine echte, aktuelle Beschwerde.
- Das Wasserzeichen. Jede Fable-5.1-Ausgabe trägt ein statistisches Text-Wasserzeichen zur Einhaltung des EU-KI-Gesetzes. Das ist für die meisten Menschen in Ordnung und für manche ein Vertrauensproblem, und es sorgte beim Launch für die meiste Aufregung.
- Du brauchst vielleicht kein rohes Modell. Das ist der große Punkt, und ich komme darauf zurück. Wenn das Endziel ein Support-Agent oder ein Content-Autor ist, bedeutet der Kauf eines Frontier-Modells, dass du den Mitarbeiter trotzdem um es herum bauen musst.
Als Ingenieur, der die meiste Zeit damit verbringt, Modelle bei eesel in ein echtes Produkt zu verdrahten, fällt mir immer wieder auf, dass die Frage "welches Modell" meist einer übersprungenen Frage "welche Ebene" nachgeordnet ist. Mehr dazu nach der Liste.
Wie ich diese Alternativen ausgewählt habe
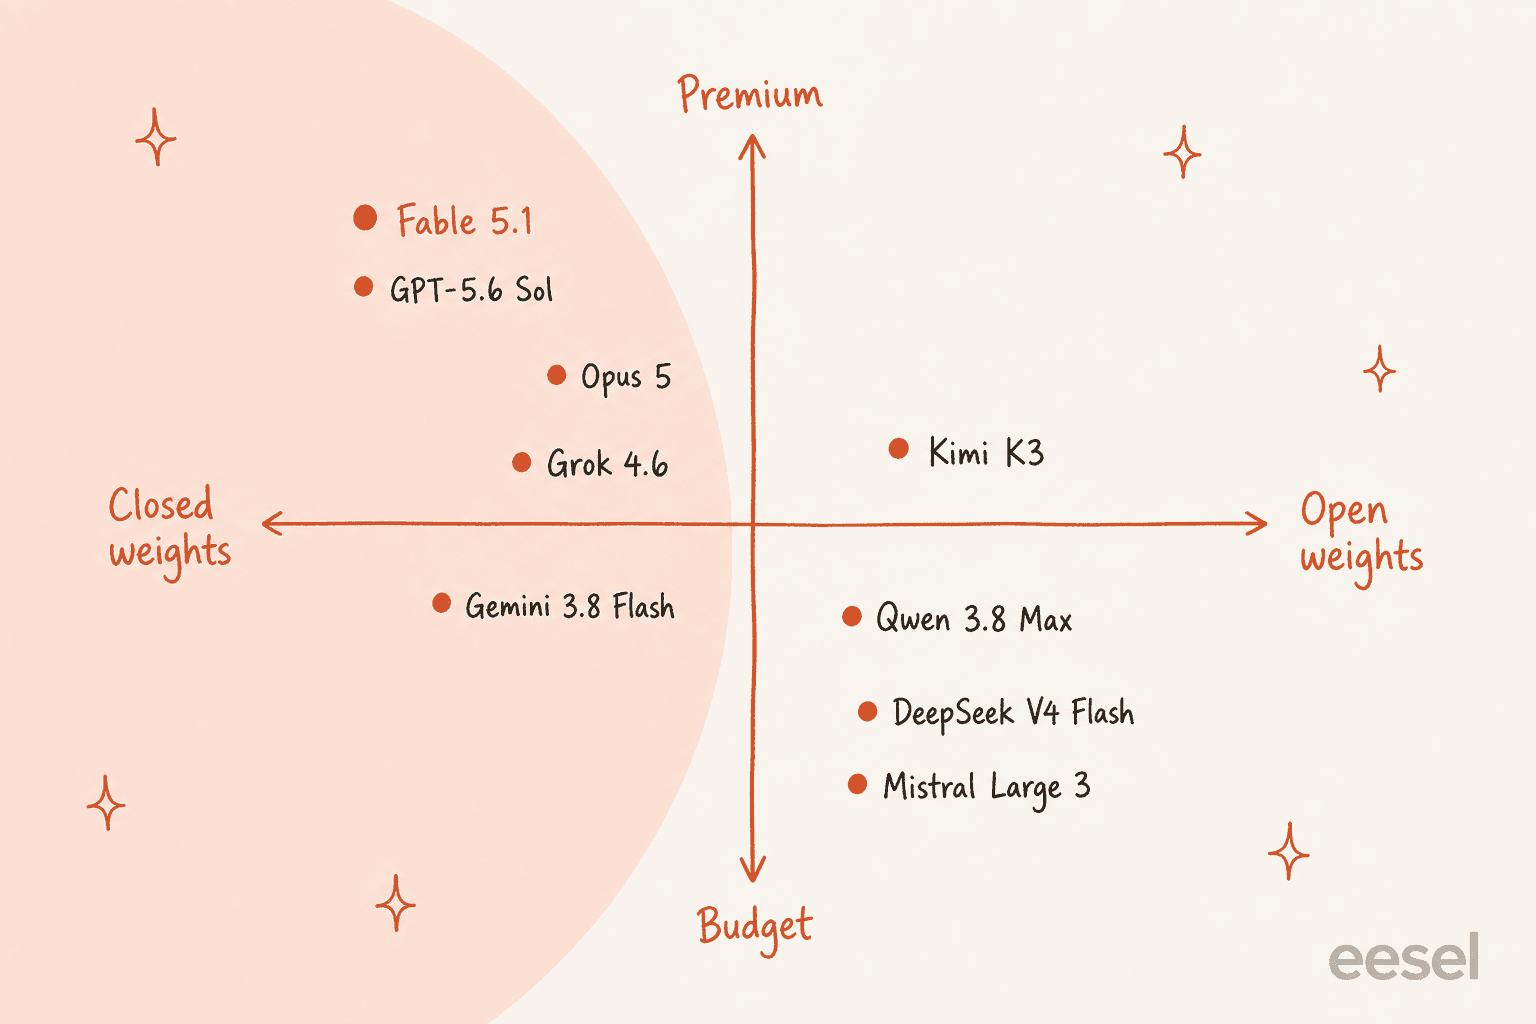
Es gibt kein einziges "bestes" Modell, daher ist diese Liste nach der Aufgabe organisiert, die du tatsächlich erledigst. Ich habe für jede Option vier Dinge abgewogen: die echten veröffentlichten Preise (Basisraten, nicht das Marketing-"ab"), unabhängige Bewertungen, wo vorhanden (hauptsächlich der Artificial Analysis Intelligence Index, der modellagnostisch ist), ob die Gewichte offen sind, und den ehrlichen Kompromiss, den das Leaderboard verschweigt. Jedes Modell hier ist eine echte, allgemein verfügbare Option, die du heute nutzen kannst, keine Vorschau.
Eine Anmerkung zu den Zahlen: Die Preise sind pro Million Tokens (MTok), Input und Output getrennt aufgeführt, weil bei generativer Arbeit das Geld beim Output ausgegeben wird. Ich habe jede Zahl auf die primäre Seite des jeweiligen Anbieters zurückgeführt.
Die 8 besten Claude Fable 5.1 Alternativen im Jahr 2026
Hier die Kurzliste auf einen Blick, dann die Details zu jedem Modell.
| Modell | Am besten für | Preis (ein/aus, $/MTok) | Kontext | Offene Gewichte? | vs. Fable 5.1 |
|---|---|---|---|---|---|
| Claude Opus 5 | Der Standard-Ersatz | 5 $ / 25 $ | 1M | Nein | Halber Preis, Anthropics empfohlener Startpunkt |
| OpenAI GPT-5.6 Sol | OpenAI-native Stacks | 5 $ / 30 $ (kurzer Kontext) | 400k | Nein | Günstigere Basis, aber Long-Context-Tier über 200k doppelt so teuer |
| Google Gemini 3.8 Flash | Günstige Hochdurchsatz-Batches | 0,75 $ / 3,75 $ | 1M | Nein | Deutlich günstiger, aber 13,3s Time-to-First-Token und Verdopplung im Januar 2027 |
| Kimi K3 | Open-Weight-Flaggschiff | 3 $ / 15 $ | 1M | Ja | Fast Spitzenwert, selbst hostbar, halber Ausgabepreis von Fable |
| Qwen 3.8 Max | Mehrsprachigkeit + starke menschliche Präferenz | 2 $ / 6 $ | 1M | Basis-Gewichte | Top 5 auf LMArena Text, ein Fünftel der Ausgabekosten |
| DeepSeek V4 Flash | Die Budget-Wahl | 0,14 $ / 0,28 $ | 128k | Ja (MIT) | ~180x günstigerer Output, MIT-lizenziert |
| xAI Grok 4.6 | Echtzeit + X-Daten | 2 $ / 6 $ (kurzer Kontext) | 500k | Nein | Günstigere Basis, aber Gebühren pro Aufruf und 200k-Klippe |
| Mistral Large 3 | EU-Datenresidenz, günstig | 0,50 $ / 1,50 $ | 256k | Ja | Europäischer Anbieter, niedrigster Premium-Tier-Ausgabepreis hier |
1. Claude Opus 5
Am besten für: alle, die ein Claude in Fable-Klasse ohne die Fable-Klasse-Rechnung wollen.
Die ehrlichste Alternative zu Fable 5.1 ist das Modell direkt darunter in Anthropics eigener Produktpalette. Opus 5 startete am 24. Juli 2026, läuft für 5 $/25 $ pro Million Tokens, und Anthropics Empfehlung ist ungewöhnlich direkt: Starte bei den meisten Aufgaben mit Opus 5 und greife erst zu Fable 5.1, wenn Opus 5 bei höherem Aufwand immer noch nicht ausreicht. Das ist der Anbieter, der dir sagt, dass das günstigere Modell der Standard ist.
Es teilt Fables beste strukturelle Eigenschaften: ein 1M-Token-Fenster mit einheitlicher Preisgestaltung, keinen Long-Context-Aufschlag und Cache-Reads für 0,50 $ (immer noch günstig, wenn auch nicht Fables 0,25 $). Im unabhängigen Artificial Analysis Intelligence Index steht es ganz oben, nur eine Haaresbreite hinter den neuesten Releases.
Der Haken, den man kennen sollte: Community-Tests fanden, dass Opus 5 bei gleichem Aufwand tendenziell etwa doppelt so viele Ausgabe-Tokens verbraucht wie der vorherige Opus, sodass die Kosten pro Aufgabe trotz niedrigerem Preisschild steigen können, und seine Halluzinationsrate stieg in einem unabhängigen Test merklich gegenüber älteren Claudes. Es ist brillant und ein bisschen geschwätzig. Für Teams, die bereits auf Claude setzen und einen echten Kostenschritt nach unten wollen, ohne die Familie zu verlassen, ist es aber der naheliegende Schritt.
Unsere Einschätzung: die Standardwahl. Wenn du "nur zur Sicherheit" auf Fable 5.1 bist, probiere zuerst Opus 5, du wirst den Unterschied bei alltäglicher Arbeit wahrscheinlich nie bemerken.
2. OpenAI GPT-5.6 Sol
Am besten für: Teams, deren Stack bereits auf OpenAI aufgebaut ist.
GPT-5.6 Sol ist OpenAIs High-Reasoning-Flaggschiff und das natürliche anbieterübergreifende Pendant zu Fable. Die Basisrate liegt bei 5 $ ein / 30 $ aus für die Kurzkontext-Stufe, was Fable beim Input unterbietet und beim Output nahe herankommt. OpenAI bietet in derselben Familie auch günstigere Geschwister: GPT-5.6 Terra für 2 $/12 $ und Luna für 0,20 $/1,20 $, sodass du die Kosten innerhalb einer API herunterregeln kannst.
Hier ist der Kompromiss, den Anthropic nicht hat: OpenAI verlangt eine Long-Context-Stufe. Überschreitest du 200k Tokens, wird Sol auf 10 $/45 $ neu bepreist, und das gilt für die gesamte Anfrage, nicht nur für den Überlauf. Ein agentischer Lauf mit großem Prompt kann also unbemerkt doppelt so viel wie das Preisschild kosten. Fable und Opus rechnen ihr gesamtes Fenster einheitlich ab, was für langkontextlastige Arbeit ein echter Vorteil ist.
Unsere Einschätzung: die richtige Wahl, wenn du OpenAI-nativ bist und deine Prompts unter 200k bleiben. Wenn deine Arbeit stark auf langen Kontext setzt, rechne die Klippe vorher durch.
3. Google Gemini 3.8 Flash
Am besten für: günstige Hochdurchsatz-Batch-Jobs, bei denen niemand auf die Antwort wartet.
Gemini 3.8 Flash ist die Preisgeschichte dieser Liste. Mit 0,75 $ ein / 3,75 $ aus ist es um mehr als eine Größenordnung günstiger als Fable, bietet ein 1M-Token-Fenster und erreicht einen respektablen Wert von 59 im Artificial Analysis Index. Für nächtliche Anreicherung, Klassifikation oder Massengenerierung ist diese Kombination schwer zu schlagen.
Zwei ehrliche Vorbehalte. Erstens die Reaktionsfähigkeit: Artificial Analysis misst eine Time-to-First-Token von 13,3 Sekunden gegenüber einem Klassenmedian von 2,99 Sekunden. Der Durchsatz ist ausgezeichnet (Top drei bei der Ausgabegeschwindigkeit), aber das Modell startet langsam, was es für alles ausschließt, worauf ein Mensch wartet, wie eine Live-Chat-Antwort, und für einen Batch-Agenten kein Problem ist. Zweitens verdoppelt sich der Preis: Die Rate von 0,75 $/3,75 $ gilt bis zum 31. Dezember 2026, dann steigt sie am 1. Januar 2027 auf 1,50 $/7,50 $. Google selbst schlägt sogar vor, für effizienzorientierte Workloads auf dem älteren 3.7 Flash zu bleiben, da 3.8 "möglicherweise mehr Tokens verwendet, um die Leistung zu maximieren".
Unsere Einschätzung: die Value-Wahl für offline, hochvolumige Arbeit. Setz es nicht hinter ein Chat-Widget, und merk dir den Preiswechsel im Januar vor.
4. Kimi K3 (Moonshot AI)
Am besten für: Teams, die einen Spitzenwert mit offenen Gewichten wollen, die sie tatsächlich herunterladen können.
Kimi K3 ist Moonshot AIs Flaggschiff, ein Mixture-of-Experts-Modell mit 2,8 Billionen Parametern (104B aktiv) und einem 1M-Token-Kontextfenster. Es läuft für 3 $ ein / 15 $ aus, sein Output liegt also unter einem Drittel von Fables, und es steht auf Platz 4 des Artificial Analysis Intelligence Index, vor den vorherigen Claude- und GPT-Generationen. Das Unterscheidungsmerkmal ist, dass Moonshot die offenen Gewichte pünktlich veröffentlicht hat, sodass du es selbst hosten kannst.
Eine Eigenheit, mit der man planen sollte: Reasoning lässt sich nicht ausschalten. K3 bietet reasoning_effort-Stufen (niedrig, hoch und der Standard-Maximalwert), aber selbst die niedrige Einstellung denkt immer noch nach, und alle Stufen werden zum gleichen Satz abgerechnet, sodass der Regler die Latenz steuert, nicht die Kosten. Das macht es für einfache, nicht-reasoning-Aufrufe, bei denen ein günstigeres Modell reichen würde, teurer als es die Überschrift vermuten lässt.
Unsere Einschätzung: das stärkste Open-Weight-Flaggschiff für Teams, die aus Compliance- oder Kontrollgründen selbst hosten müssen. Wenn du nur eine gehostete API willst und dir Gewichte egal sind, unterbieten Qwen und DeepSeek es.
5. Qwen 3.8 Max (Alibaba)
Am besten für: mehrsprachige Arbeit und alle, die blinder menschlicher Präferenz mehr vertrauen als automatisierten Scores.
Qwen 3.8 Max wurde am 2. August 2026 allgemein verfügbar. Es ist ein MoE-Modell mit 2,4 Billionen Parametern (95B aktiv) und einem 1M-Token-Fenster, mit einem Preis von 2 $ ein / 6 $ aus und einem impliziten Cache-Read von 0,25 $. Das ist etwa ein Fünftel von Fables Ausgabekosten für ein Modell, das nahe der Spitze der Human-Preference-Boards rangiert.
Die interessante Wendung ist, dass automatisierte und menschliche Rankings bei Qwen nicht übereinstimmen. Auf LMArena ist es Text #5 und Vision #2, das heißt Menschen mögen seine Antworten; im automatisierten Intelligence Index landet es im Mittelfeld bei etwa 58. Keines ist falsch, sie messen unterschiedliche Dinge, also verlass dich nicht auf ein einzelnes Zahlen-Urteil. Alibaba veröffentlicht zudem ein kleineres Geschwistermodell mit einer großzügigen Lizenz, obwohl das gehostete Max Vision, Tools und einen längeren Standard-Kontext hinzufügt, die die offene Basisversion nicht bietet.
Unsere Einschätzung: eine starke, günstige Wahl für mehrsprachige und kundenorientierte Texte, wo sich sein Human-Preference-Vorteil zeigt. Für agentische Tool-Nutzung solltest du an deinen eigenen Aufgaben prüfen statt am Leaderboard.
6. DeepSeek V4 Flash
Am besten für: die Budget-Linie, wenn die Kosten pro Token der begrenzende Faktor sind.
Wenn der Preis die ganze Entscheidung ist, beendet DeepSeek V4 Flash die Diskussion. Mit 0,14 $ ein / 0,28 $ aus ist sein Output etwa 180-mal günstiger als Fables, und es erscheint unter einer MIT-Lizenz, der großzügigsten aller Modelle hier. Es wurde am 31. Juli 2026 neu nachtrainiert, und dieser frische Build schlägt DeepSeeks eigenes teureres V4 Pro tatsächlich in jedem agentischen Benchmark, den das Unternehmen veröffentlicht.
Es wird Fable beim schwersten Langzeit-Reasoning oder beim tiefen Erinnern über einen riesigen Kontext nicht schlagen, und sein Fenster (128k) ist kleiner als das der 1M-Token-Modelle oben. Aber im Artificial Analysis Index erreicht es einen echten Score bei etwa 0,03 $ pro Aufgabe, eine Zahl, die eine ganze Klasse von "zu teuer zum Betreiben"-Ideen wieder machbar macht.
Unsere Einschätzung: der Standard, wenn du etwas im großen Maßstab betreibst und die Frontier-Stufe Overkill ist. Prototype damit, bevor du davon ausgehst, dass du ein Modell mit 50 $ Output brauchst.
7. xAI Grok 4.6
Am besten für: Produkte, die von Echtzeit- und X-Daten leben.
Grok 4.6 läuft für 2 $ ein / 6 $ aus für seine 500k-Token-Kurzkontext-Stufe, günstiger als Fable über alle Tokens hinweg, mit starker Tool-Nutzung und nativem Zugriff auf Echtzeit-X-Daten, die kein anderes Modell hier hat.
Lies aber den Zähler, bevor du dich festlegst. Wie OpenAI verlangt xAI eine Long-Context-Stufe: Überschreitest du 200k Tokens, wird jedes Token in der Anfrage mit 4 $/12 $ abgerechnet. Und Grok fügt Gebühren pro Aufruf hinzu, die die Token-Rate verschleiert, Web- und X-Suche kosten 5 $ pro 1.000 Aufrufe, Dateisuche 10 $ pro 1.000, sodass ein Agent, der viel sucht, mehr kostet, als das Preisschild vermuten lässt. Ein Beschaffungshaken: Wenn du cloud-gebunden bist, bieten Azure und Bedrock maximal Grok 4.3, sodass du 4.6 dort überhaupt nicht kaufen kannst.
Unsere Einschätzung: lohnt sich, wenn Echtzeit- oder X-Daten das eigentliche Feature sind. Wenn nicht, machen die Tool-Call-Zähler ein schlichtes Frontier-Modell einfacher zu budgetieren.
8. Mistral Large 3
Am besten für: europäische Datenresidenz und eine niedrige Premium-Tier-Rechnung.
Mistral Large 3 ist der europäische Kandidat und das günstigste "Flaggschiff-Klasse"-Modell dieser Liste mit 0,50 $ ein / 1,50 $ aus. Für Teams, die aus Datenresidenz- oder Regulierungsgründen einen in der EU ansässigen Anbieter brauchen, ist es oft die einzige frontier-ähnliche Option, die die Beschaffung passiert, und es bietet zudem offene Gewichte.
Der Kompromiss ist eindeutig: Es konkurriert nicht um die Spitze der Intelligence-Ranglisten wie Fable, Opus 5 oder GPT-5.6 Sol. Bei den schwersten agentischen und Reasoning-Aufgaben liegt es einen Schritt zurück, und sein 256k-Kontext ist kleiner als bei den 1M-Token-Modellen. Aber für viel praktische Generierung und Extraktion ist es bei diesem Preis und mit EU-Hosting ein sehr vernünftiger Boden. Mistrals Verbraucher-Assistent, jetzt unter der Marke Vibe, läuft auf denselben Modellen, falls du eine Chat-Oberfläche willst.
Unsere Einschätzung: die pragmatische EU-Wahl. Wähle es wegen Residenz und Kosten, nicht um einen Benchmark zu gewinnen.
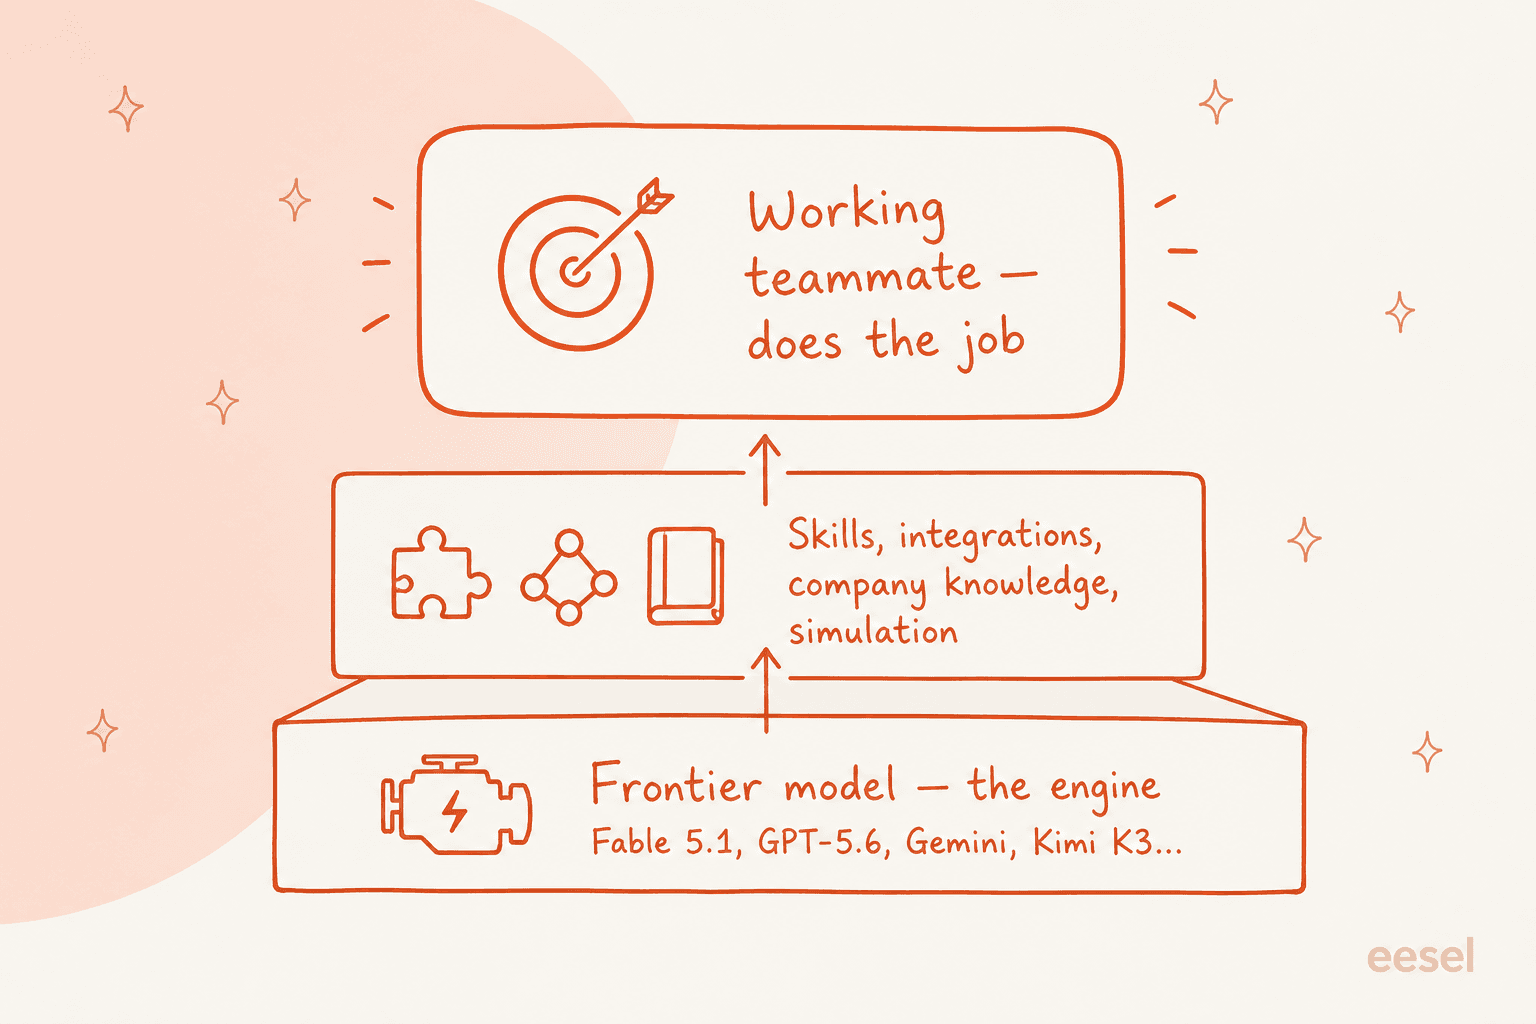
Die Umformulierung: ein Modell ist ein Motor, kein Mitarbeiter
Hier ist die Sache, die jede "bestes Modell"-Liste verschweigt. Die Wahl zwischen Fable 5.1 und diesen acht ist nur dann die richtige Frage, wenn das Modell selbst das ist, was du ausliefern willst. Für die meisten Teams ist das nicht der Fall. Du willst keine Tokens, du willst gelöste Tickets oder geschriebene Beiträge.
Ein rohes Frontier-Modell ist Infrastruktur. Es kommt an, ohne etwas über dein Produkt zu wissen, mit nichts verbunden, sich an nichts zwischen Aufrufen erinnernd. Um es in einen Support-Agenten zu verwandeln, musst du trotzdem Retrieval über dein Help Center aufbauen, es in dein Helpdesk einbinden, die Guardrails schreiben, die Eskalationslogik hinzufügen und, wenn du vorsichtig bist, einen Weg finden, es zu testen, bevor es mit einem echten Kunden spricht. Das sind Monate an Arbeit, und die Modellwahl ist nur ein kleiner Teil davon.
Hier habe ich mir einige Narben verdient. Ich baue die Integrationen und APIs bei eesel, und wir haben die letzten drei-plus Jahre damit verbracht, KI-Agenten in lebende Support-Warteschlangen über Tausende echter Tickets zu bringen. Die Lektion, die geblieben ist: Das Modell ist selten das, was kaputtgeht. Was kaputtgeht, ist ein selbstbewusst klingender Bot, der eine falsche Antwort gibt, weil ihn niemand zuerst gegen die Realität getestet hat, genau deshalb wird jeder Rollout jetzt an den historischen Tickets eines Unternehmens simuliert, bevor er in die Nähe eines Kunden kommt. Keine Menge an "Ist Fable besser als Opus" beantwortet das.
Bevor du also eine Woche damit verbringst, Modelle zu benchmarken, frag, welche Ebene du eigentlich kaufst. Wenn du eine Plattform baust und das Modell ist dein Produkt, ist diese Liste für dich, wähle nach der Aufgabe. Wenn du einen Mitarbeiter willst, kauf den Mitarbeiter.
Probier eesel aus
Wenn die Aufgabe, die du wirklich erledigen willst, Support oder Content ist, ist eesel die Ebene, die über all diesen Modellen sitzt. eesel ist eine KI-Teammate-Plattform: Statt dir ein Modell und eine leere Leinwand zu geben, stellst du einen einsatzbereiten Teammate für eine definierte Aufgabe ein. Das aktuelle Aufgebot ist ein KI-Helpdesk-Teammate, der deiner bestehenden Support-Warteschlange beitritt, und ein KI-Blog-Autor, jeder kommt mit den Skills, Integrationen und dem Unternehmenskontext, die seine Rolle braucht.
Der Teil, der für eine Modell-Übersicht zählt: eesel ist darunter modellagnostisch, sodass du die Fähigkeit eines Frontier-Modells bekommst, ohne selbst eines auswählen, bepreisen oder verdrahten zu müssen, und ohne diese Arbeit jedes Mal zu wiederholen, wenn ein neues Fable oder Opus erscheint. Bevor er ein einziges echtes Ticket beantwortet, kannst du den Teammate an deinen vergangenen Tickets simulieren, um genau zu sehen, wie er sie gehandhabt hätte, der Testschritt, den die meisten rohen Modell-Builds überspringen und später bereuen.
Und wenn du im Terminal lebst, steuert die eesel CLI denselben Teammate und Workspace programmatisch. Sie ist darauf ausgelegt, agentenfreundlich zu sein: Eine Person kann sie von Hand ausführen, Skripte können sie automatisieren, und Coding-Agenten wie Claude Code, Codex und Cursor können sie direkt bedienen, sodass du Anweisungen verwalten, Simulationen starten, den Agenten auslösen und seine Aktivität lesen kannst, ohne jemals das Dashboard zu öffnen. Es ist derselbe Teammate, freigelegt als eine Oberfläche, die eine Automatisierung oder eine KI steuern kann. Es auszuprobieren ist kostenlos, und du kannst sehen, wie es auf deinen eigenen Daten funktioniert, bevor du dich verpflichtest.
Welche Alternative du wirklich wählen solltest
Zum Abschluss die Kurzversion nach Aufgabe:
- In der Claude-Familie bleiben, weniger ausgeben: Opus 5. Es ist Anthropics eigener Standard.
- OpenAI- oder Google-native: GPT-5.6 Sol (auf die 200k-Klippe achten) oder Gemini 3.8 Flash (nur Batch, Preis verdoppelt sich im Januar).
- Offene Gewichte: Kimi K3 für ein selbst hostbares Flaggschiff, Qwen 3.8 Max für Mehrsprachigkeit, DeepSeek V4 Flash für den Budget-Boden.
- Echtzeit oder EU: Grok 4.6 für X-Daten, Mistral Large 3 für europäische Residenz.
- Du wolltest einen Mitarbeiter, kein Modell: eesel.
Die Modelle werden sich weiter gegenseitig überholen, und die Preisschilder werden weiter driften. Was sich nicht ändert, ist die Ebenen-Frage: Entscheide zuerst, ob du einen Motor oder einen Mitarbeiter kaufst, und der Rest der Wahl wird viel kleiner.
Häufig gestellte Fragen
Was ist die beste Claude Fable 5.1 Alternative?
Wie viel kostet Claude Fable 5.1 im Vergleich zu den Alternativen?
Gibt es eine günstigere Alternative zu Claude Fable 5.1, die trotzdem leistungsfähig ist?
Gibt es Open-Weight-Alternativen zu Claude Fable 5.1?
Brauche ich Claude Fable 5.1, um einen KI-Support-Agenten zu bauen?


Article by
Rama Adi Nugraha
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.