Warum Leute über GPT-6 Astra hinausschauen
Lass mich zuerst fair zu GPT-6 Astra sein, denn es ist ein wirklich beeindruckendes Modell. Es bringt ein 1.050.000-Token-Kontextfenster, eine gehostete Shell, Apply-Patch, Computernutzung und MCP-Unterstützung von Haus aus mit, laut der OpenAI-Modellseite. Bei agentischen Benchmarks ist der Sprung real: OpenAI berichtet, dass Terminal-Bench 4.0 von Sols 37,3% auf 57,9% klettert, und es ist das erste Modell, das OpenAI im Rahmen seines Preparedness Framework für Cybersicherheit als „kritisch" eingestuft hat. Wenn du autonome Coding-Agenten oder lang laufende Tool-Use-Pipelines baust, ist das eine große Sache.
Hier ist der Haken, und das ist der Grund, warum du das hier liest. OpenAI hat Astra bepreist mit $10 pro Million Input-Token und $50 pro Million Output, 2,5x so viel wie die $4/$20, die GPT-5.6 Sol gekostet hat. Für dieses Geld würde man einen entsprechenden Intelligenz-Sprung erwarten. Den bekommt man nicht. Der unabhängige Artificial-Analysis-Intelligence-Index setzt Astra bei 61,2 gegenüber Sols 60,9, was innerhalb der Messtoleranz liegt. Die schärfste Einschätzung auf Hacker News war, dass sich das „eher wie 5.7 als wie 6" anfühlt, und die Zahl bestätigt das (wir sind dem in unserem GPT-6-Astra-Test nachgegangen).

Es gibt noch ein paar weitere Gründe, warum Teams sich umschauen:
- Es ist nicht in der kostenlosen Stufe. Astra ist nur für Plus/Pro/Business/Enterprise und über die API verfügbar, und bei Enterprise ist es standardmäßig pro Workspace deaktiviert. (Wenn du die breitere OpenAI-Modellpalette im Blick hast: Astra sitzt ganz oben.)
- Die Überwachbarkeit ist gesunken. OpenAI notiert offen im System Card, dass das Modell seine eigene Gedankenkette beeinflussen kann, weshalb sie ein Fehlausrichtungs-Monitoring hinzugefügt haben, das legitime Tool-Nutzung pausieren kann.
- Lange Prompts kosten mehr. Anfragen über 272K Token werden mit 2x Input und 1,5x Output berechnet, sodass Astras Kontextfenster nicht so flach bepreist ist, wie es bei manchen Konkurrenten der Fall ist.
Nichts davon macht Astra schlecht. Es macht es zu einem Spezialisten, für den du Flaggschiff-Preise zahlst. Schauen wir uns also an, was es sonst noch gibt.
GPT-6-Astra-Alternativen im Überblick
Hier ist das gesamte Feld nebeneinander. Preise sind pro Million Token auf der Standard-API jedes Anbieters, und die Intelligenz-Scores stammen aus dem Artificial-Analysis-Index (sie bewegen sich von Woche zu Woche, also behandle sie als Richtwert, nicht als Evangelium).
| Modell | Input / Output ($/M) | Kontext | Intelligenz-Index (ca.) | Offene Gewichte? | Am besten für |
|---|---|---|---|---|---|
| GPT-6 Astra | $10 / $50 | 1,05M | ~61 | Nein | Autonome Agenten, Coding, Cyber |
| Claude Fable 5.1 | $10 / $50 | 1M | ~66 | Nein | Höchste gemessene Leistungsfähigkeit |
| Claude Opus 5 | $5 / $25 | 1M | ~61 | Nein | Naheliegendster Tausch, halber Output-Preis |
| Claude Sonnet 5 | $2 / $10 | 1M | ~53 | Nein | Value bei hoher Produktionslast |
| Gemini 3.8 Flash | $0.75 / $3.75 | 1M | ~59 | Nein | Günstigste gehostete Option, Batch-Jobs |
| Kimi K3 | $3 / $15 | 1M | ~57 | Ja | Open-Weights-Leistungsfähigkeit |
| Qwen 3.8 Max | $2 / $6 | 1M | ~58 | Teilweise | Offene Basis + starke menschliche Präferenz |
| DeepSeek V4 Flash | ~$0.22-0.44 / $0.66-1.32 | 1M | ~50 | Ja (MIT) | Günstigste pro Aufgabe, Self-Hosting |
| Grok 4.6 | $2 / $6 | 500K | ~54 | Nein | Schnell, xAI-native Workflows |
Ein kurzes Wort dazu, wie ich diese Tabelle lesen würde. Listenpreis und Kosten pro Aufgabe sind nicht dasselbe. Ein Modell, das doppelt so viele Output-Token verbrennt, um eine Aufgabe zu erledigen, kann teurer werden als ein „teureres" Modell, das es in einem Durchgang schafft. Nutze die Tabelle also, um eine Vorauswahl zu treffen, und lass dann deine echten Prompts durch zwei oder drei Finalisten laufen, um die tatsächliche Rechnung zu messen. Das beste KI-Modell für Support-Tickets ist selten das mit der größten Benchmark-Zahl, und welches LLM gewinnt hängt meist von deinen Daten ab.

1. Claude Opus 5
Am besten für: Teams, die Astra-Leistungsfähigkeit ohne die Astra-Rechnung wollen.
Claude Opus 5 ist der natürlichste 1:1-Tausch auf dieser Liste. Es entspricht Astras 1M-Kontextfenster, und Anthropic berechnet das gesamte Fenster zu Standardraten ohne Long-Context-Aufschlag, sodass eine 900K-Token-Anfrage pro Token genauso viel kostet wie eine 9K-Token-Anfrage. Im Artificial-Analysis-Index steht es direkt neben Astra (beide bei etwa 61), und zeitweise hielt es sogar den ersten Platz allein.
Die interessante Eigenart ist der Effort-Regler. Opus 5 hat Denken standardmäßig aktiviert und lässt dich den Reasoning-Effort bis auf max hochdrehen, wo viel von seiner Qualität herkommt – aber auch, wo die Kosten hingehen. Der Community-Konsens ist, dass Opus 5 bei gleichem Effort ungefähr doppelt so viele Output-Token verbraucht wie Opus 4.8, sodass die Kosten pro Aufgabe gestiegen sind, obwohl der Listenpreis gleich blieb.

Hier ist eine echte Entwicklereinschätzung nach dem Wechsel:
"Opus 5 matched Fable 5 on my agent tasks, and it was faster and cheaper to run."

- Vorteile: halber Output-Preis von Astra, flache 1M-Kontext-Preisgestaltung, Spitzen-Reasoning, eigenes Rate-Limit-Kontingent.
- Nachteile: Denken ist standardmäßig aktiviert und lässt sich oberhalb von
highEffort nicht abschalten, und der Token-Verbrauch pro Aufgabe kann schnell steigen. - Preise: $5 Input / $25 Output pro Million; Fast-Modus $10/$50; Batch 50% günstiger; Cache-Reads $0.50.
Fazit: Wenn du Astra verlässt, weil dich das Preis-Leistungs-Verhältnis geärgert hat, fang hier an. Du bekommst im Wesentlichen die gleiche Intelligenz-Stufe zum halben Output-Preis. Behalte den Effort-Regler im Auge, denn eine max-Effort-Gewohnheit kann die Ersparnis unbemerkt wieder auffressen.
2. Claude Fable 5.1
Am besten für: das leistungsfähigste Modell, das du zu Astras Preis kaufen kannst.
Wenn Astras Problem ist, dass es Flaggschiff-Geld für einen flachen Score verlangt, ist Claude Fable 5.1 die pointierte Antwort: Es kostet genau die gleichen $10/$50 und führt den Intelligenz-Index mit etwa 65,7 an, mehrere Punkte vor Astra. Es steht in Anthropics eigener Modellpalette über Opus 5 und führt jeden Eval an, den Anthropic zum Launch veröffentlicht hat, einschließlich Terminal-Bench-Science, wo es den vorherigen Score mehr als verdoppelte.
Zwei Details machen es zu einem wirklich anderen Kauf als Astra. Erstens sind Cache-Reads um 75% auf $0.25 pro Million gefallen, günstiger pro Token als Opus 5s $0.50, was sich bei agentischen Workloads, die einen großen System-Prompt immer wieder lesen, schnell summiert. Zweitens versieht Fable 5.1 seinen Output jetzt mit einem statistischen Text-Wasserzeichen, um dem EU AI Act zu entsprechen, was manche Teams für Herkunftsnachweise mögen und andere seltsam finden. Gut zu wissen, bevor du dich festlegst.
- Vorteile: höchste gemessene Intelligenz auf der Liste zum Preis von Astra, sehr günstige Cache-Reads, flache 1M-Kontext-Preisgestaltung, starke Prosa und starkes Coding.
- Nachteile: gleicher $50/M-Output wie Astra (das ist nicht die günstige Wahl), einige gemeldete False-Positive-Ablehnungen bei eigenem sicherheitsnahem Code, und das Output-Wasserzeichen wird nicht jedem gefallen.
- Preise: $10 Input / $50 Output; Cache-Read $0.25; Batch $5/$25; nicht in einer kostenlosen Stufe.
Fazit: Wenn du sowieso Astra-Preise gezahlt hättest, gibt dir Fable 5.1 mehr gemessene Leistungsfähigkeit zum identischen Preis. Es ist die „gleiches Geld, mehr Modell"-Alternative.
3. Claude Sonnet 5
Am besten für: Produktionsarbeit mit hohem Volumen, bei der Wert pro Aufgabe wichtiger ist als Spitzenleistung.
Nicht jede Aufgabe braucht ein Flaggschiff. Claude Sonnet 5 ist das Arbeitspferd der Claude-5-Familie zu $2/$10 pro Million, einem Fünftel von Astras Output-Preis, und Anthropic hat im August 2026 bestätigt, dass das der dauerhafte Standardpreis ist, keine auslaufende Aktion. Es erreicht etwa 53 im Intelligenz-Index, was niedriger ist als bei den Flaggschiffen, aber völlig ausreichend für Klassifikation, Routing, Zusammenfassung und den langen Schwanz an Routine-Generierung.
Der Haken, den man im Auge behalten sollte, sind die Turns pro Aufgabe. Günstiger pro Token bedeutet nicht immer günstiger pro Job, weil ein kleineres Modell manchmal mehr Hin und Her braucht, um das gleiche Ergebnis zu erzielen. Bei einer gut umrissenen Aufgabe ist Sonnet 5 aber eines der besten Value-pro-Token-Modelle, das du auf Produktions-Traffic loslassen kannst.
- Vorteile: ein Bruchteil von Astras Preis, 1M Kontext zu flacher Preisgestaltung, schnell, wirklich gut bei Alltagsaufgaben.
- Nachteile: kein Frontier-Reasoner, kann bei mehrdeutiger Arbeit zusätzliche Turns verbrennen.
- Preise: $2 Input / $10 Output pro Million; Cache-Read $0.20; Batch 50% günstiger.
Fazit: das Modell, zu dem ich bei den 80% des Traffics greifen würde, der kein Flaggschiff braucht. Kombiniere es mit Opus 5 oder Fable 5.1 für die schwierigen 20%, und du hast eine Kostenstruktur, die Astra nicht erreichen kann.
4. Google Gemini 3.8 Flash
Am besten für: günstige Batch-Jobs mit hohem Durchsatz, bei denen niemand auf die Antwort wartet.
Gemini 3.8 Flash ist das günstigste gehostete Modell hier, das noch in der halbwegs frontier-tauglichen Diskussion mitspielt, zu $0.75 Input / $3.75 Output bis Ende 2026 (es verdoppelt sich am 1. Januar 2027 auf $1.50/$7.50, also plane das ein). Es erreicht etwa 59 im Intelligenz-Index und hat eine kostenlose Stufe, die Astra nicht hat.
Ein ehrlicher Vorbehalt, den die meisten Berichte auslassen: Artificial Analysis misst die Time-to-first-Token mit 13,30 Sekunden gegenüber einem Klassenmedian von etwa 3 Sekunden, obwohl sein roher Durchsatz unter den Top-Modellen im Test rangiert. Durchsatz ist nicht Reaktionsfähigkeit. Das macht es hervorragend für nächtliche Batch-Pipelines und disqualifiziert es für alles, worauf ein Mensch aktiv wartet, wie eine Live-Chat-Antwort. Google selbst empfiehlt sogar, bei effizienzorientierten Workloads auf dem älteren 3.7 Flash zu bleiben, da 3.8 „härter arbeitet" und mehr Token verbrauchen kann.
- Vorteile: günstigste gehostete Option, kostenlose Stufe, riesiger multimodaler Input (Text, Bild, Audio, Video, PDF), sehr hoher Durchsatz.
- Nachteile: langsame Time-to-first-Token, Preis verdoppelt sich im Januar 2027, und zwei Sicherheitsmetriken sind gegenüber 3.7 leicht zurückgegangen.
- Preise: $0.75 / $3.75 pro Million bis 31. Dez. 2026, danach $1.50 / $7.50; Batch und Flex 50% günstiger.
Fazit: ein hervorragendes Batch- und Offline-Verarbeitungsmodell zu einem Preis, den die Flaggschiffe nicht erreichen können. Setze es nur nicht vor einen Kunden, der auf einen Tipp-Indikator schaut.
5. Kimi K3
Am besten für: Teams, die starke Leistungsfähigkeit mit offenen Gewichten zum Selbst-Hosten wollen.
Kimi K3 ist Moonshot AIs Flaggschiff, ein Mixture-of-Experts-Modell mit 2,8 Billionen Parametern und 104B aktiven, und seine offenen Gewichte sind pünktlich erschienen zum versprochenen Termin, was nicht jedem Labor gelingt. Es erreicht etwa 57 im Intelligenz-Index, schlägt damit ältere Flaggschiffe wie Opus 4.8, und hat native Vision (akzeptiert allerdings nur Base64 oder Datei-IDs, keine öffentlichen Bild-URLs).
Die Preisgestaltung ist die Überraschung: Zu $3/$15 pro Million liegt es in der gleichen Preisklasse wie Claude Sonnet, nicht die Rock-Bottom-Wahl, die einen die K2-Ära erwarten ließ. Reasoning ist immer aktiviert und kann bei keiner Effort-Stufe abgeschaltet werden, es ist also ein Latenz-Regler, keine Kostenstufe. Wenn dein Grund für K3 Self-Hosting ist, sind die offenen Gewichte der ganze Sinn der Sache; wenn du nur die gehostete API nutzen wirst, ist die Value-Rechnung gegenüber Sonnet 5 weniger eindeutig.
- Vorteile: wirklich offene Gewichte, starke Benchmarks, native Vision, 1M Kontext.
- Nachteile: gehosteter Preis ist Mid-Tier, nicht Budget, Reasoning kann nicht deaktiviert werden, öffentliche Bild-URLs werden nicht akzeptiert.
- Preise: $3 Input / $0.30 Cache-Hit / $15 Output pro Million.
Fazit: die beste Wahl auf dieser Liste, wenn offene Gewichte ein Muss sind und du sie auch wirklich betreibst. Als reine gehostete API gewinnt meist Sonnet 5 beim Value.
6. Qwen 3.8 Max
Am besten für: einen starken Allrounder mit freizügiger offener Basis und Top-5-Werten bei menschlicher Präferenz.
Alibabas Qwen 3.8 Max ist im August 2026 allgemein verfügbar geworden, ein 2,4T-Parameter-MoE mit 95B aktiven, bepreist zu $2 Input / $6 Output pro Million. Es erreicht etwa 58 im Intelligenz-Index, und auf LMArenas Human-Preference-Ranglisten ist es wirklich stark, top 5 bei Text und top 2 bei Vision, sodass der automatisierte Index und blinde menschliche Stimmen leicht in unterschiedliche Richtungen zeigen. Wenn sie nicht übereinstimmen, würde ich keiner Zahl allein trauen und testen.

Bei der Frage nach offenen Gewichten ist es ein „teilweises" Ja. Das schwere Qwen3.8-2.4T-A95B-Checkpoint erschien unter einer eingeschränkten Qwen-Lizenz, während ein freizügiges Apache-2.0-27B-Modell dasjenige ist, das du tatsächlich frei weiterverwenden kannst. Das gehostete Max ist auch nicht funktionsgleich mit der offenen Basis, da es Vision-Input, einen Non-Thinking-Modus und eingebaute Werkzeuge hinzufügt.
- Vorteile: niedriger gehosteter Preis, Top-Rankings bei menschlicher Präferenz, 1M Kontext, ein freizügiges kleineres offenes Modell.
- Nachteile: die großen Gewichte stehen unter einer eingeschränkten Lizenz, gehostete und offene Version unterscheiden sich, und die Datenresidenz liegt bei der Erst-API in China.
- Preise: $2 Input / $6 Output pro Million; implizites Cache-Read $0.25.
Fazit: ein wirklich starker, günstiger Allrounder, besonders wenn dir menschliche Präferenz-Qualität wichtiger ist als Benchmark-Scores. Lies die Lizenz sorgfältig, bevor du planst, das große Modell selbst zu hosten.
7. DeepSeek V4 Flash
Am besten für: Workloads mit hohem Volumen, bei denen die Kosten pro Aufgabe alles entscheiden.
Wenn deine Priorität ist, so wenig wie möglich pro Token auszugeben, kommt nichts hier an DeepSeek V4 Flash heran. Laut der Live-Preiskarte liegt es bei ungefähr $0.22-$0.44 pro Million Input und $0.66-$1.32 Output, je nachdem ob Stoßzeit oder Nebenzeit. Weil DeepSeeks Stoßzeit-Fenster (01:00-04:00 und 06:00-10:00 UTC) auf chinesische Geschäftszeiten fällt, wird eine US- oder EU-Warteschlange meist zum günstigeren Nebenzeit-Tarif abgerechnet, eine echte (wenn auch fragile) Eigenart, die man kennen sollte.

Zwei Dinge, die dich ehrlich halten sollten. Erstens: „Günstig" und „gut" sind unterschiedliche Läufe der gleichen Gewichte: DeepSeeks eigene Zahlen zeigen eine große Lücke zwischen Non-Thinking- und Max-Effort-Qualität, und Reasoning-Token werden zum Output-Tarif berechnet, sodass die sparsame Konfiguration nicht diejenige ist, die die Charts anführt. Zweitens: Bei Kundendaten schweigen sich die Bezahl-API-Bedingungen eher zur Trainingsnutzung aus, statt sie explizit auszuschließen, es gibt keine veröffentlichte Zero-Retention-Option, und Daten liegen in der VR China unter chinesischem Recht. Es ist also ein fantastischer Kostenmotor für unsensible Arbeit mit hohem Volumen, aber kein direkter Ersatz für regulierte Kundendaten.
- Vorteile: mit Abstand am günstigsten, MIT-lizenzierte offene Gewichte (~167GB), 1M Kontext, 384K maximaler Output.
- Nachteile: Budget-Konfiguration hinkt bei der Qualität hinterher, verbraucht viele Token, nur Text (keine dokumentierte Bild-Eingabe) und Datenumgang-Bedingungen, die für sensible Daten ungeeignet sind.
- Preise: Nebenzeit / Stoßzeit, pro Million: Input ~$0.22 / $0.44, Output ~$0.66 / $1.32; Cache-Hit-Input ein Bruchteil eines Cents.
Fazit: der Value-Champion mit großem Abstand. Nutze es für Massen-Klassifikation, -Extraktion und -Zusammenfassung bei unsensiblen Daten. Halte Kunden-PII von der Erst-API fern, bis die Bedingungen und die Datenresidenz zu deinen Anforderungen passen.
8. Grok 4.6
Am besten für: Teams, die bereits im xAI-Ökosystem sind und schnelle Antworten sowie ein großes Kontextfenster wollen.
Grok 4.6 rundet die Liste ab, zu $2 Input / $6 Output pro Million für Prompts unter 200K Token, mit einem 500K-Kontextfenster. Es ist schnell, und wenn du bereits auf xAI aufbaust oder Live-X/Web-Suche eingebunden haben willst, ist es eine sinnvolle Wahl. Eine Sache stellt die Preiskarte klar: Long-Context-Anfragen (Prompts bei oder über 200K) bepreisen die gesamte Anfrage neu zu $4/$12, nicht nur den Überhang, sodass ein großer Prompt mehr kostet, als der Listenpreis vermuten lässt.
Grok misst auch Dinge jenseits von Token: Websuche, X-Suche und Code-Ausführung kosten $5 pro 1.000 Aufrufe, und Datei-Anhang-Suche kostet $10 pro 1.000. OpenRouters gemessene effektive Preise sind hier die schärfste Realitätsprüfung und zeigen einen Input-Durchschnitt deutlich unter dem $2-Listenpreis dank einer Cache-Trefferquote von ~90%, während der Output leicht über dem Listenpreis liegt, weil ein Teil des Traffics in die Long-Context-Stufe fällt. Wenn dich das Einkaufswesen auf einen Cloud-Marktplatz zwingt: Azure und Bedrock bieten nur ältere Grok-Generationen an, 4.6 bekommst du dort also nicht.
- Vorteile: schnell, 500K Kontext, native Live-Suche, effektiver Preis oft unter Listenpreis dank gutem Caching.
- Nachteile: Long-Context-Anfragen bepreisen den gesamten Prompt neu, zusätzliche Aufruf-Zähler für Suche und Werkzeuge, kein Batch-Rabatt bei 4.6.
- Preise: $2 / $6 pro Million (≤200K); $4 / $12 für Prompts ≥200K; Werkzeug-/Suchzähler zusätzlich.
Fazit: ein solides, schnelles Modell mit einem echten Vorteil, wenn du eingebaute Suche willst oder bereits in xAIs Welt bist. Die Long-Context-Neupreisgestaltung und die Aufruf-Zähler bedeuten, dass du deine tatsächliche Nutzung modellieren solltest, bevor du annimmst, es sei die günstige Option.
Der Teil, den jeder Modellvergleich übersieht: Ein Modell ist kein Teammitglied
Hier ist das, was mir jemand gesagt haben sollte, bevor ich eine Woche mit Benchmarking verbracht habe. Wenn du ein Modell auswählst, um Support-Tickets zu beantworten, Blogbeiträge zu schreiben oder irgendeinen echten Geschäftsprozess auszuführen, ist das Modell nur der Motor. Es ist rohe Intelligenz ohne jede Ahnung, wie deine Rückerstattungsrichtlinie aussieht, welche Zendesk-Ansicht es sich anschauen soll, oder wann es aufhören und einen Menschen fragen sollte.
Jedes Modell auf dieser Liste, Astra eingeschlossen, hat die gleiche Lücke. Die Artificial-Analysis-Wissens-Scores liegen deutlich unter 50 von 100, was auf hübsche Weise sagt, dass kein Modell hier dein Geschäft kennt. Um ein Modell zu etwas zu machen, das tatsächlich einen Job erledigt, musst du es in dein Help Center und deine vergangenen Tickets einbetten, es mit deinen Werkzeugen verbinden und Leitplanken, Tests und Freigaben darum herum aufbauen. Das ist die Arbeit hinter jeder echten KI für Kundenservice, und es ist die gleiche Arbeit, egal welches Modell dein Benchmark gewinnt.

Hier dreht sich auch das Preisgespräch um. $50 pro Million Output-Token weh tun am meisten, wenn du sie für die routinemäßigen 80% der Tickets ausgibst, die jedes Mid-Tier-Modell erledigen könnte. Die klügere Struktur ist, etwas anderes entscheiden zu lassen, wann eine schwierige Frage tatsächlich ein Flaggschiff braucht, und für das Ergebnis zu zahlen statt für die Token. Das ist der Unterschied zwischen dem Mieten eines Motors und dem Einstellen eines KI-Teammitglieds, und es verändert auch die Kosten im Vergleich zu einem menschlichen Agenten.
Probier eesel aus
Der Grund, warum ich immer wieder zum „Motor vs. Teammitglied"-Framing zurückkomme, ist, dass genau das unser Produkt ist. eesel ist eine KI-Teammitglied-Plattform: Statt dir ein rohes Modell und einen API-Schlüssel zu geben, stellst du ein einsatzbereites Teammitglied für einen bestimmten Job ein, wie das KI-Helpdesk-Teammitglied, das deiner Support-Warteschlange beitritt, oder den KI-Blog-Autor. Jedes kommt bereits mit dem Wissen, wie es das Modell, deine Integrationen und deinen Firmenkontext nutzt, sodass nicht du derjenige bist, der um 2 Uhr morgens GPT-6 Astra mit Zendesk verklebt.

Zwei Dinge sind wichtig für alle, die Modellkosten vergleichen. Erstens rechnet eesel pro Ticket ab zu $0.40, nicht pro Token, sodass du von genau dem Preiskrieg isoliert bist, um den es in diesem Beitrag geht; egal ob das beste Modell Astra, Opus 5 oder nächsten Monat etwas Günstigeres ist, deine Kosten pro gelöstem Gespräch schwanken nicht. Zweitens, weil Astra im Grunde eine Agenten-und-API-Geschichte ist, lohnt es sich zu wissen, dass eesel dasselbe Teammitglied auch über eine echte Kommandozeilen-Schnittstelle und einen MCP-Server verfügbar macht: Du kannst es vom Terminal aus steuern, es in CI skripten oder es über MCP verbinden mit einem Coding-Agenten wie Claude Code und es headless betreiben. Die Doku sagt wörtlich, dass alles, was du im Dashboard machen kannst, du auch vom Terminal aus machen kannst.
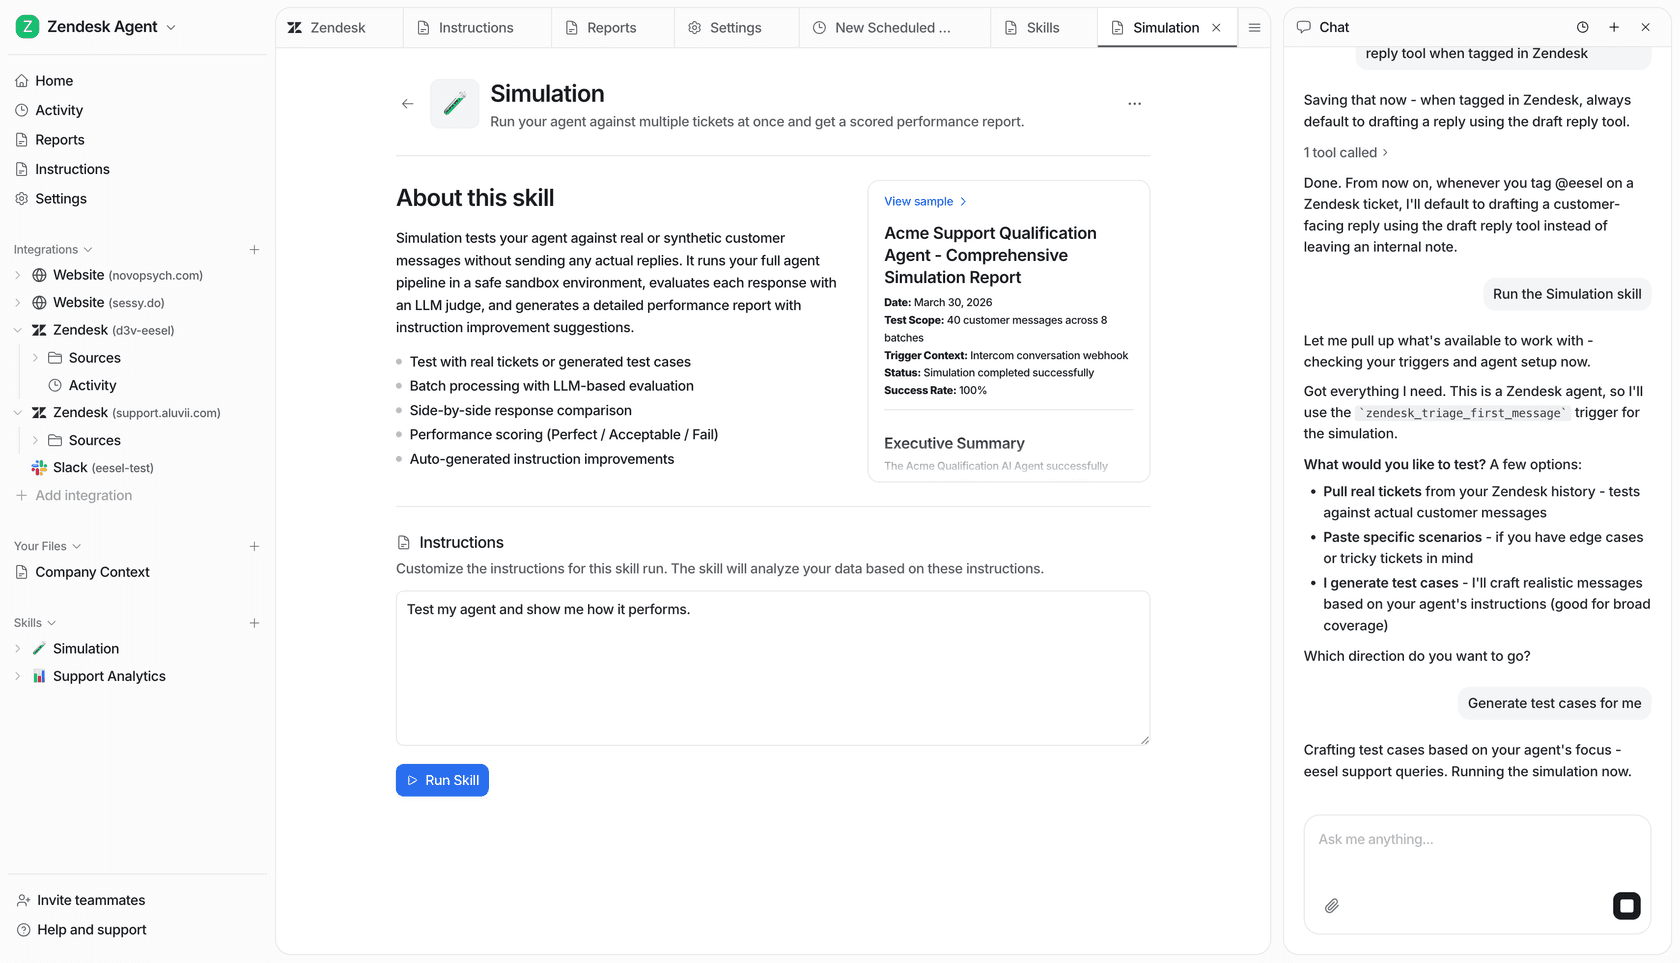
Bevor du live gehst, kann eesel das Teammitglied simulieren anhand deiner vergangenen Tickets und seine Antworten mit dem vergleichen, was dein Team tatsächlich geschickt hat, sodass du die Lücken in einem sicheren Testlauf findest statt vor einem Kunden. Du kannst mit $50 kostenloser Nutzung ohne Kreditkarte starten. Wenn du abwägst, auf welches Modell du deinen Support aufbauen sollst, ist das die Ebene, die die Modellwahl viel weniger wichtig macht. Probier eesel aus kostenlos.
Häufig gestellte Fragen
Was ist die beste GPT-6-Astra-Alternative?
Wie viel kostet GPT-6 Astra im Vergleich zu Alternativen?
Gibt es eine günstigere Alternative zu GPT-6 Astra für den Kundensupport?
Welche GPT-6-Astra-Alternativen haben offene Gewichte?
Was passiert, wenn ich einfach warte, bis der Preis fällt, statt zu wechseln?


Article by
Rama Adi Nugraha
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.