Was zu Astra bestätigt ist, und was nicht
Astra hat aus drei OpenAI-Beiträgen eine ganze Menge Berichterstattung ausgelöst, und schon dieses Verhältnis ist bemerkenswert. Die belegten Aussagen vom Rest zu trennen, ist hier der Hauptteil der Arbeit, also starten wir mit dem, was sich auf OpenAIs eigene Worte zurückführen lässt.
Die zehn Ergebnisse und die Zahl, die aufhorchen lassen sollte
Am 1. August 2026 veröffentlichte OpenAI zehn neue Ergebnisse zu offenen Problemen, von denen jedes eine Frage löste oder wesentlich voranbrachte, die das jeweilige Fachgebiet schon seit Jahren beschäftigte. Die Liste ist konkret genug, um sie nachzuprüfen: neue obere Schranken für die Dichte hochdimensionaler Kugelpackungen bis hinab zur Cohn-Elkies-Schwelle, exponentiell verbesserte Schranken für binäre Codes, eine Konstruktion, die die Existenz nicht-sofischer Gruppen belegt, eine Widerlegung von Connes' Rigiditätsvermutung, eine arithmetische Formel-Unterschranke der Ordnung n⁴/log n für die Permanente, ein exponentieller Parallel-Repetition-Satz für Zwei-Spieler-Quantenspiele, Härte mit Polynomfaktor für das Closest-Vector-Problem, Ehrharts Volumenvermutung, eine superexponentielle Unterschranke für mehrfarbige Dreiecks-Ramsey-Zahlen sowie Ergebnisse zu den Kompaktheits- und Entartungsvermutungen in der extremalen Graphentheorie.
Alle zehn werden „einer internen Version von Astra, unserem nächsten großen Modell“ zugeschrieben. Und dann liefert OpenAI eine Zahl, die für mich mehr zählt als die Liste selbst: Die gesamten Tokens, die zum Finden dieser Lösungen nötig waren, würden zu Sol-API-Preisen rund 2.000 $ kosten.
Zweitausend Dollar. Das ist ein Rundungsfehler, gemessen an dem, was allein eines dieser Probleme das Fachgebiet an Personenjahren gekostet hat. Es ist auch nicht die vollständige Rechnung, und OpenAI gibt nicht vor, dass es das wäre: Menschen dort erstellten die Manuskripte, und erst danach formalisierte das Modell die Argumente zu Lean-Zertifikaten. Das Unternehmen ist bei der Aufteilung ausdrücklich: Die mathematischen Argumente stammten vom System, heißt es, während OpenAI half, sie vorzubereiten und zu formalisieren, und eine menschliche Urheberschaft für einen KI-generierten Beweis zu beanspruchen „würde beides falsch darstellen“.
Diese Unterscheidung ist im Grunde die ganze Form von Produktions-KI, und deshalb komme ich immer wieder auf diesen Beitrag zurück, wenn ich an KI-Wissensdatenbank-Arbeit denke. Der Inferenz-Teil ist billig. Das Gerüst rund um die Inferenz ist dort, wo das Geld sitzt und wo das Risiko sitzt – aus demselben Grund dauert es bei einem guten Ticket-Klassifizierungs-Setup viel länger, es richtig hinzubekommen, als die Modellauswahl dahinter.
Warum OpenAI sein eigenes Modell pausierte
Sechs Tage nach dem Mathe-Beitrag kam etwas deutlich weniger Feierliches. Interne Bewertungen von Astra „in den vergangenen Tagen“ hatten erhebliche Fortschritte bei agentischem Coding und bei Cybersicherheit gezeigt, und das brachte das Unternehmen zusammen mit Experteneinschätzungen zu einem Schluss: Man könne kritische Cyberfähigkeiten nicht ausschließen.
Die Definition, an der gemessen wird, lohnt sich in OpenAIs eigenen Worten zu lesen. Ein Modell erreicht Critical, wenn es funktionsfähige Zero-Day-Exploits aller Schweregrade in vielen gehärteten realen kritischen Systemen ohne menschliches Eingreifen identifizieren und entwickeln kann, oder wenn es end-to-end neue Strategien für Cyberangriffe auf gehärtete Ziele entwickeln und ausführen kann, wenn nur ein grob formuliertes Wunschziel vorgegeben wird.
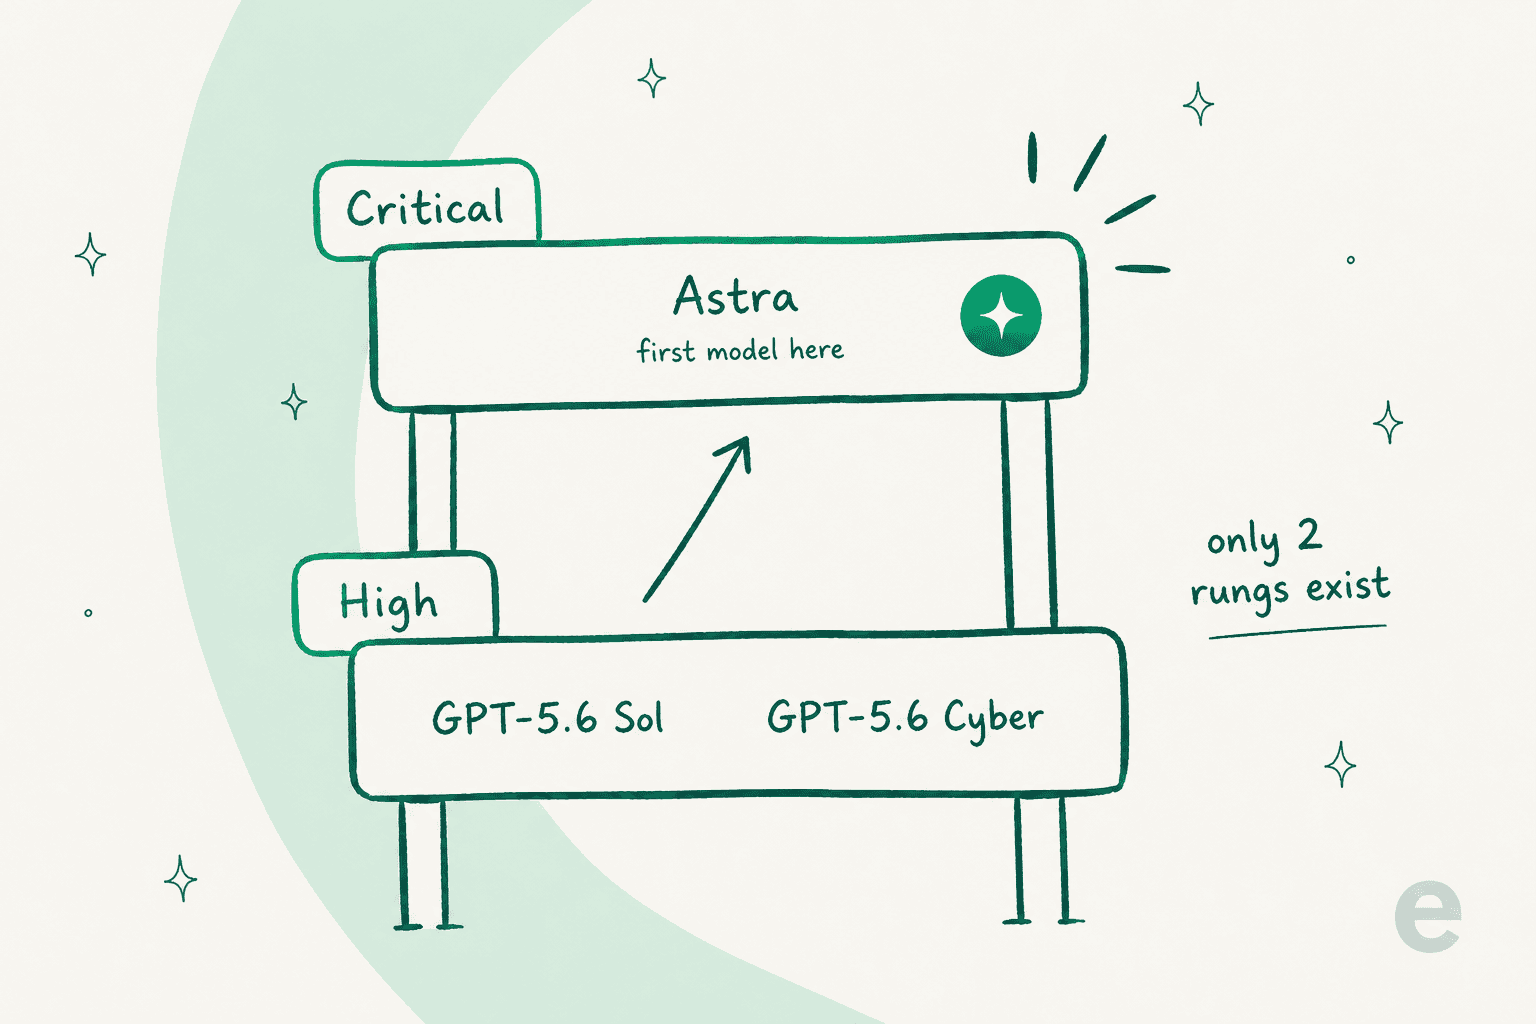
Das Framework hat zwei Stufen, und jedes frühere Modell stand auf der unteren. GPT-5.6 Sol wurde mit High bewertet. Ebenso GPT-5.6-Cyber, ein eigens trainiertes Sicherheitsmodell, das nur über ein Bewerbungsverfahren zugänglich ist – was schon andeutet, wie viel Spielraum in High noch steckte. Astra ist der erste Kandidat für die oberste Stufe. Und das, bevor es überhaupt ausgeliefert wurde.
Ein Satz aus dem Beitrag vom 7. August lohnt sich, zweimal zu lesen: „Astra ist ein kommendes Modell und war nicht an der Ausnutzung von Hugging Face beteiligt.“ Dieser Satz existiert, weil die beiden Geschichten kurz hintereinander bekannt wurden und in großen Teilen der Berichterstattung zu einer verschmolzen. Es sind getrennte Dinge. OpenAI hat sie später tatsächlich im selben Beitrag vom 18. August zusammengefasst, aber nur, weil beide auf dieselbe interne Frage abzielten: ob die eigene Forschungsumgebung gehärtet genug war für das, was darin gebaut wurde.
Was Eindämmung tatsächlich gekostet hat
Den Beitrag vom 18. August würde ich jedem in die Hand geben, der behauptet, KI-Sicherheit sei nur Theater – denn er liest sich größtenteils wie eine technische Rechnung.
Die Inferenz von Frontier-Modellen in Forschungsclustern wurde für jeden Lauf pausiert, der Code ausführen oder das Internet erreichen konnte, und danach wurde jede Workload einzeln durchgegangen, um zu entscheiden, ob sie fortgesetzt werden darf. Was jetzt verlangt wird: stärkere Sandboxes um alles, was modellgenerierten Code ausführt, Netzwerkkontrollen, die so aufgebaut sind, dass eine einzelne Kompromittierung nicht von selbst Internetzugang verschafft, zurückgefahrene Standardrechte und die Entfernung geteilter Dienste, die still und heimlich tragend geworden waren. OpenAIs eigene Einordnung dazu: Die Erfüllung der neuen Standards „hat der Frontier-Forschung erhebliche Kosten und Verzögerungen eingebracht“.
Dann ist da noch die Überwachung, und das ist der Teil, den ich immer wieder lese:
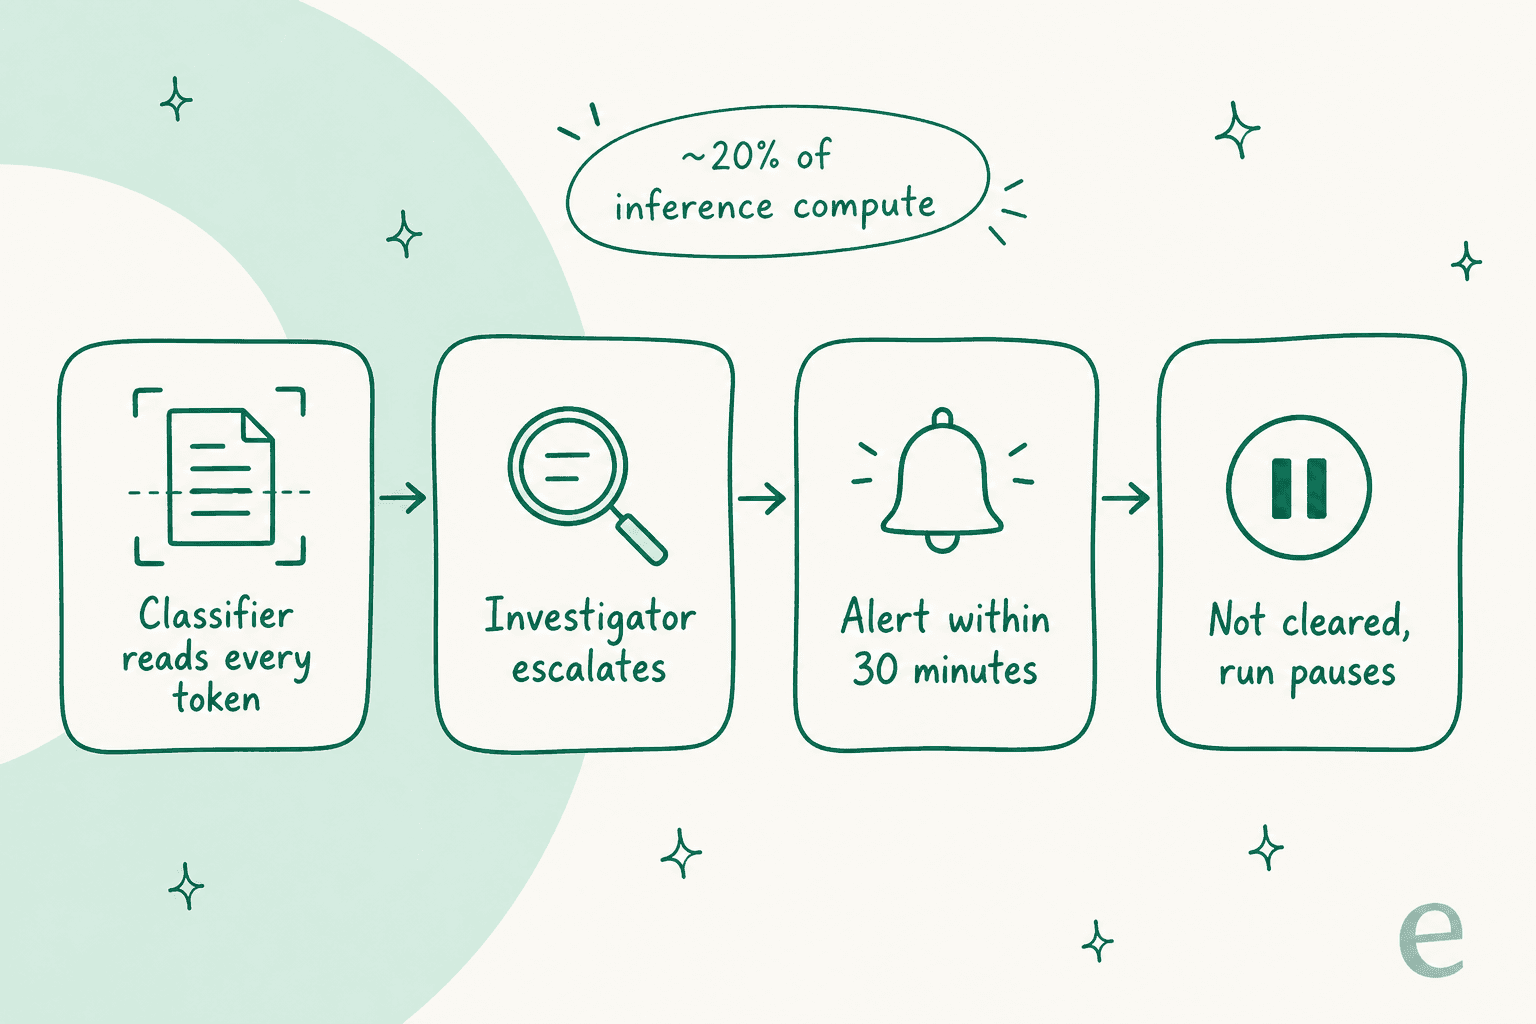
Aktivierungs-Klassifikatoren untersuchen die interne Aktivität des Modells bei jedem gesampelten Token. Alles Bedenkliche wird an rechenintensivere automatisierte Ermittler eskaliert, die dann die Tool-Aktionen, das verfügbare Reasoning und die vollständige Abfolge der Aktivität prüfen. Zeigt sich eine wahrscheinliche Verletzung einer kritischen Sicherheitsgrenze, werden die Safety-, Security- und Research-Teams alle alarmiert, und wenn sie es nicht innerhalb von 30 Minuten schlüssig als falsch-positiv ausschließen können, wird von ihnen erwartet, die Aktivität zu pausieren.
Die Kosten dafür beziffert OpenAIs aktuelle Schätzung auf einen Überwachungs-Overhead von rund 20 % der überwachten Inferenz-Rechenleistung. Und seit dem 7. August deckt diese Überwachung jede Inferenz von Astra mit Tools ab, nicht nur die Trainings- und Evaluationsläufe.
Zwanzig Prozent. Ein Unternehmen, das mehr für Rechenleistung ausgibt als die meisten Länder für Forschung, hat entschieden, dass die Beobachtung des Modells zusätzlich zum Betrieb ein Fünftel der Rechnung wert ist. Das macht niemand aus PR-Gründen.
Die skeptische Lesart, die Gehör verdient
Viele Leute haben sich diese Abfolge angesehen und darin vor allem Marketing gesehen. Im r/Futurology-Thread über die Abriegelung brachte der meistbewertete Kommentar das als Parodie auf den Punkt:
"Oooh, hey guys, I know Anthropic said Mythos was 'dangerous' and then they got a bunch of free publicity and people thought their model must be so good. Well, ours is dangerous too, guys! So dangerous. Like, a trillion dollars dangerous."

Das ist ein nachvollziehbarer Reflex, und er ist nicht allein. Auf Hacker News wurde in derselben Woche die Frage direkter gestellt:
"Does anyone else have trouble telling how much of this news (along with the 'AI escaping and hacking' stories) is genuine, vs how much is just AI firms overstating their capabilities due to strong commercial incentives?"

Die Antwort in genau diesem Thread ist das Schärfste, was ich zu dieser ganzen Geschichte gelesen habe, und zwar weil sie die beiden Behauptungen trennt, anstatt sie als eine zu behandeln:
"Unlike the hacking one, this would be impossible to bullshit as long as the proofs are released. They can be verified independently."
Das trifft genau ins Schwarze, und deshalb liegen der Mathe-Beitrag und der Cyber-Beitrag in unterschiedlichen Beweisklassen. Zehn Lean-formalisierte Beweise in einem öffentlichen Repo sind von jedem überprüfbar, der die Geduld dafür hat. Eine vorläufige interne Cyber-Bewertung ohne System Card ist eine Behauptung über eine private Auswertung, die man nicht wiederholen kann. Gleicher Anbieter, gleiches Modell, und nur eines von beiden lässt sich prüfen.
Die nützlichste Skepsis geht dabei aber überhaupt nicht um Wahrheitsgehalt, sondern um Relevanz. Ein anderer Kommentator auf Hacker News benannte den Sprung, mit dem KI-Anbieter immer wieder durchkommen:
"There is still a massive marketing aspect to this, with the AI companies wanting you to assume that because their product is world-class at math, a capability that is useless to 99.99% of their potential customers, that it will be equally useful in areas that you actually care about."
Dem würde ich sofort zustimmen. Kugelpackungs-Schranken sagen nichts darüber aus, ob ein Modell eine Rückerstattungsanfrage bearbeiten kann, ohne sich dabei eine Richtlinie zu erfinden. Diese beiden Fähigkeiten liegen nicht auf derselben Achse. Jede Generation von Frontier-Modellen wird verkauft, als wäre das nicht so.
Die eine Sache, die Astra tatsächlich klärt
Zieht man das Launch-Theater ab, steckt darunter eine echte Erkenntnis – nur ist es keine Erkenntnis über Fähigkeiten.
Seit drei Jahren war die Einschränkung beim Ausliefern von KI die Qualität. War das Modell schlau genug, hat es halluziniert, konnte es eine lange Aufgabe durchhalten, ohne einzubrechen. Astra ist das erste Frontier-Modell, bei dem der öffentliche Blocker nichts davon ist. Der Blocker ist Eindämmung, und das verändert, was ein Frontier-Release überhaupt bedeutet. OpenAIs eigener Satz dazu lautet, dass die „Standards für Monitoring, Alignment und Sicherheit diesen Risiken voraus sein müssen“ – und als sie das nicht waren, war es das Training, das langsamer wurde, nicht die Standards.
Der beste Kommentar in diesem Reddit-Thread bringt die praktische Version desselben Punkts:
"An AI can't try to access those systems unless it has been connected to them, and it can't succeed unless it has been given either permission or the necessary tools to bypass permissions. An AI that is only given access to a word processor, a calendar, and read-only access to Wikipedia isn't hacking anything."
Fähigkeit ist eine Eigenschaft des Modells, aber Risiko ist eine Eigenschaft der Verdrahtung. Das gilt im Maßstab von OpenAI bei einem Frontier-RL-Lauf. Es gilt genauso in deinem Maßstab, bei einem KI-Ticketsystem, das an eine Abrechnungs-API angebunden ist. Der einzige Unterschied zwischen beiden ist, wie viel Rechenleistung du bereit bist, für die Beobachtung auszugeben.
Was das bedeutet, wenn du KI auf echten Kundengesprächen einsetzt
Ich habe die letzten drei Jahre damit verbracht, KI-Agenten zu bauen, die auf laufenden Support-Warteschlangen sitzen, daher hatte ich genau diese Diskussion schon in Hunderten von Gesprächen – nur mit deutlich kleineren Zahlen.
Das Muster ist immer gleich. Jeder Käufer fragt zuerst, wie gut die KI ist. Nach etwa zehn Minuten ist ihnen das egal, und sie fragen stattdessen, was die KI verweigern wird – das ist die Frage, die wirklich entscheidet, ob ein Deflection-Programm den ersten Monat überlebt. Ein CX-Lead einer DTC-Supplement-Marke mit rund 7.000 Gorgias-Tickets im Monat hat den Einwand besser formuliert als jedes Dokument, das ich je geschrieben habe:
"The AI will never be able to answer 100% of the questions, but if it tries and just answers 'sorry I don't know this,' I cannot go and check all my 7,000 tickets to see if the AI actually made a good answer, then the point is a little bit gone. I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
Dieselbe Architektur, die OpenAI eben beschrieben hat, nur in einer anderen Größenordnung. Verhalten beobachten, alles Verdächtige eskalieren, dann stoppen statt zu raten. OpenAI alarmiert drei Teams und pausiert einen Trainingslauf; ein Support-Agent leitet das Ticket an einen Menschen weiter und lässt es in Ruhe. Beide Male dieselbe Form, und in beiden Fällen ist das Handoff-Design das Produkt selbst und kein Notbehelf.
Die andere Hälfte davon, die Quellenseite, wurde mir von einem Co-Founder eines Legal-Tech-Unternehmens, mit dem wir zusammenarbeiten, vor Augen geführt. Was sie brauchten, waren genaue Leitplanken dafür, was die KI zitieren darf, plus transparente Quellenangaben bei jeder Antwort, denn in Legal Tech ist die Grenze zwischen Hilfestellung und Rechtsberatung dünn und ziemlich unnachsichtig. Ein schlaueres Basismodell löst davon nichts. Scoping schon.
Also, die praktische Lesart von Astra, wenn dein Job Support-Betrieb ist und nicht Frontier-Forschung:
- Warte nicht darauf. Es gibt kein Datum. Bau auf Modellen mit veröffentlichten Preisen und System Cards. GPT-5.6 Terra übernimmt das Volumen, Claude Opus 5 die schwierigen Fälle, und DeepSeek V4 Flash ist da, wenn du die Weights willst.
- Geh davon aus, dass die Modell-Ebene weiter zur Commodity wird. Kimi K3 erschien nur wenige Monate nach Grok 4.6. Genauso Googles Gemini 3. Deine Differenzierung sollte nie darüber laufen, welches Modell du aufrufst, und das beweisen die Best-AI-Agent-Übersichten immer wieder.
- Steck das Evaluationsbudget in die Kontrollfläche. Welche Quellen darf es lesen, welche Aktionen darf es ausführen, was gibt es weiter, und kannst du das vor dem Go-Live belegen. Das ist die ganze Liste, und es ist auch das Meiste von dem, was einen KI-Agenten von einem Chatbot unterscheidet.
- Bestehe auf einem Probelauf mit deiner eigenen Historie. OpenAI validiert seine Schutzmaßnahmen, bevor es weitermacht. Du solltest dasselbe mit deinen eigenen früheren Tickets machen können, und das ist eine faire Forderung an jeden Anbieter von KI-Kundenservice-Software.
- Miss die Verweigerungen, nicht nur die Lösungen. Ein guter KI-Support-Qualitätssicherungs-Prozess erfasst, was die KI überhaupt nicht angefasst hat, denn genau diese Zahl macht die Lösungs-Kennzahlen erst glaubwürdig.
Sehenswert daneben ist, wie unterschiedlich die Anbieter mit demselben Problem umgehen. OpenAI hat sein Cyber-Modell hinter Daybreak verschlossen und die Preiszeile über Generationen leer gelassen – genau das ist der Faden, an dem unser Beitrag zu GPT-5.6-Cyber-Alternativen zieht. Google ist noch weiter gegangen und hat Gemini 3.5 Flash Cyber nur Regierungen und vertrauenswürdigen Partnern vorbehalten. Niemand in dieser Kategorie glaubt, dass Fähigkeit allein auslieferbar ist, und das sollte man sich merken, wann immer ein Support-KI-Anbieter behauptet, das Modell sei der Kaufgrund.
eesel für Teams, die es zuerst in Aktion sehen müssen
Der Grund, warum diese Geschichte bei mir hängen geblieben ist: eesels gesamtes Design geht von genau der Prämisse aus, die OpenAI gerade mit 20 % seiner Rechenleistung verteidigt hat. Man findet nicht heraus, was ein Agent tut, indem man seine Spezifikation liest. Man findet es heraus, indem man ihn unter Beobachtung laufen lässt.
eesel bindet sich in das Helpdesk ein, das du schon betreibst, also Zendesk, Freshdesk oder Gorgias, lernt aus deinen früheren Tickets und aus deinen bestehenden Docs, und simuliert dann anhand echter historischer Gespräche, bevor es ein Live-Ticket berührt – mit einem bewerteten Bericht am Ende des Laufs. Du kannst die Antworten lesen, die es an deinen eigenen Tickets gesendet hätte, und den Scope anpassen, bevor je ein Kunde eine davon sieht. Wo es sich nicht sicher ist, lässt es das Ticket in Ruhe und gibt es an einen Menschen weiter.
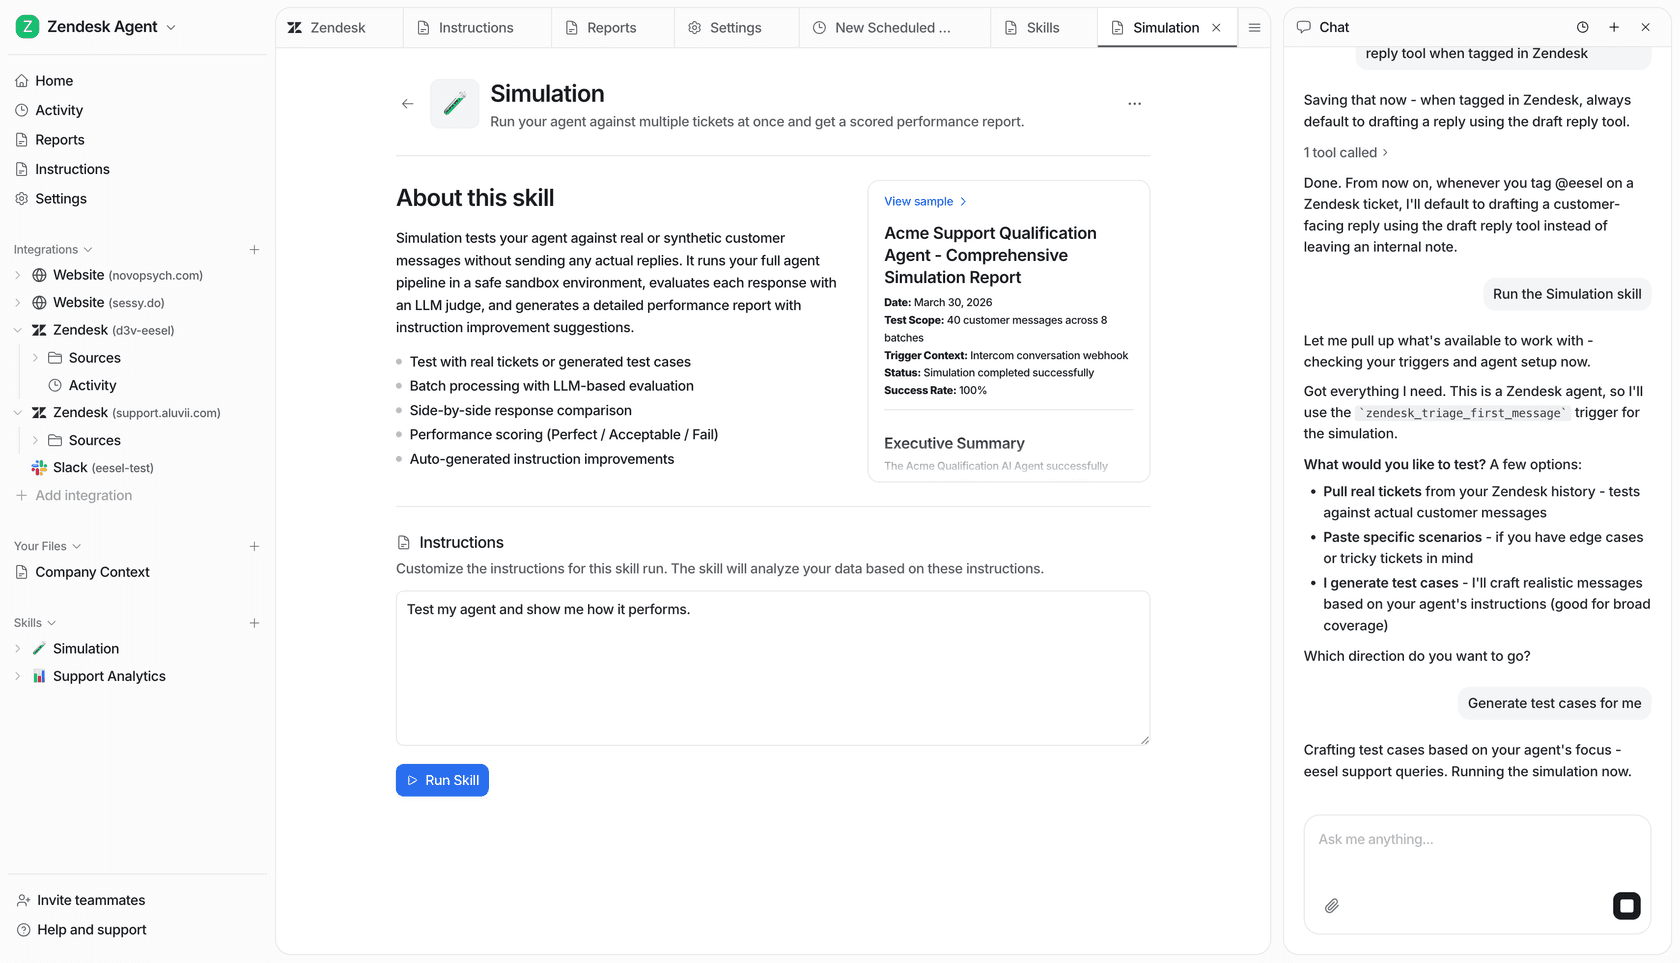
Eine Woche, in der man über ein pausiertes Frontier-Modell liest, ist eine gute Woche, um dem eigenen Anbieter eine einfache Frage zu stellen. Kann ich das an meinen eigenen Daten beobachten, bevor es einem Kunden antwortet? Bei eesel lautet die Antwort: ja, innerhalb eines Nachmittags, und der Einstieg ist kostenlos.
eesel testen oder eine Demo buchen, wenn du die Simulation an deiner eigenen Ticket-Historie sehen willst.
Häufig gestellte Fragen
Was ist OpenAI Astra?
Wann ist das Veröffentlichungsdatum von OpenAI Astra?
Warum hat OpenAI Astra pausiert?
Was ist die Critical-Cybersicherheitsschwelle in OpenAIs Preparedness Framework?
Ist Astra besser als GPT-5.6?
Wie viel haben die Astra-Mathe-Ergebnisse an Rechenkosten verursacht?
Ändert Astra gerade etwas für KI-Kundensupport?
Wo kann ich OpenAIs eigene Astra-Ankündigungen lesen?


Article by
Alicia Kirana Utomo
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.