8 beste Claude Opus 5.5-Alternativen 2026 (günstiger, schneller, offen)

Kurnia Kharisma Agung Samiadjie

Katelin Teen
Zuletzt bearbeitet September 23, 2026
Warum Leute an Claude Opus 5.5 vorbeischauen
Zuerst der faire Teil. Opus 5.5 verdient sich seinen Ruf. Es ist gebaut für langlaufendes agentisches Coding und Wissensarbeit, kommt ohne viel Händchenhalten mit Mehrdeutigkeit klar und steht mit einem Score von 58 auf Platz eins des Artificial Analysis Intelligence Index. Anthropic hat den Preis sogar von Opus 5's $5/$25 auf $4/$20 gesenkt, ein echtes, unaufgefordertes Zugeständnis an die Käufer. Wenn du bereits tief in Claude Code steckst und die Arbeit wirklich schwer ist, ist Bleiben eine vertretbare Entscheidung.
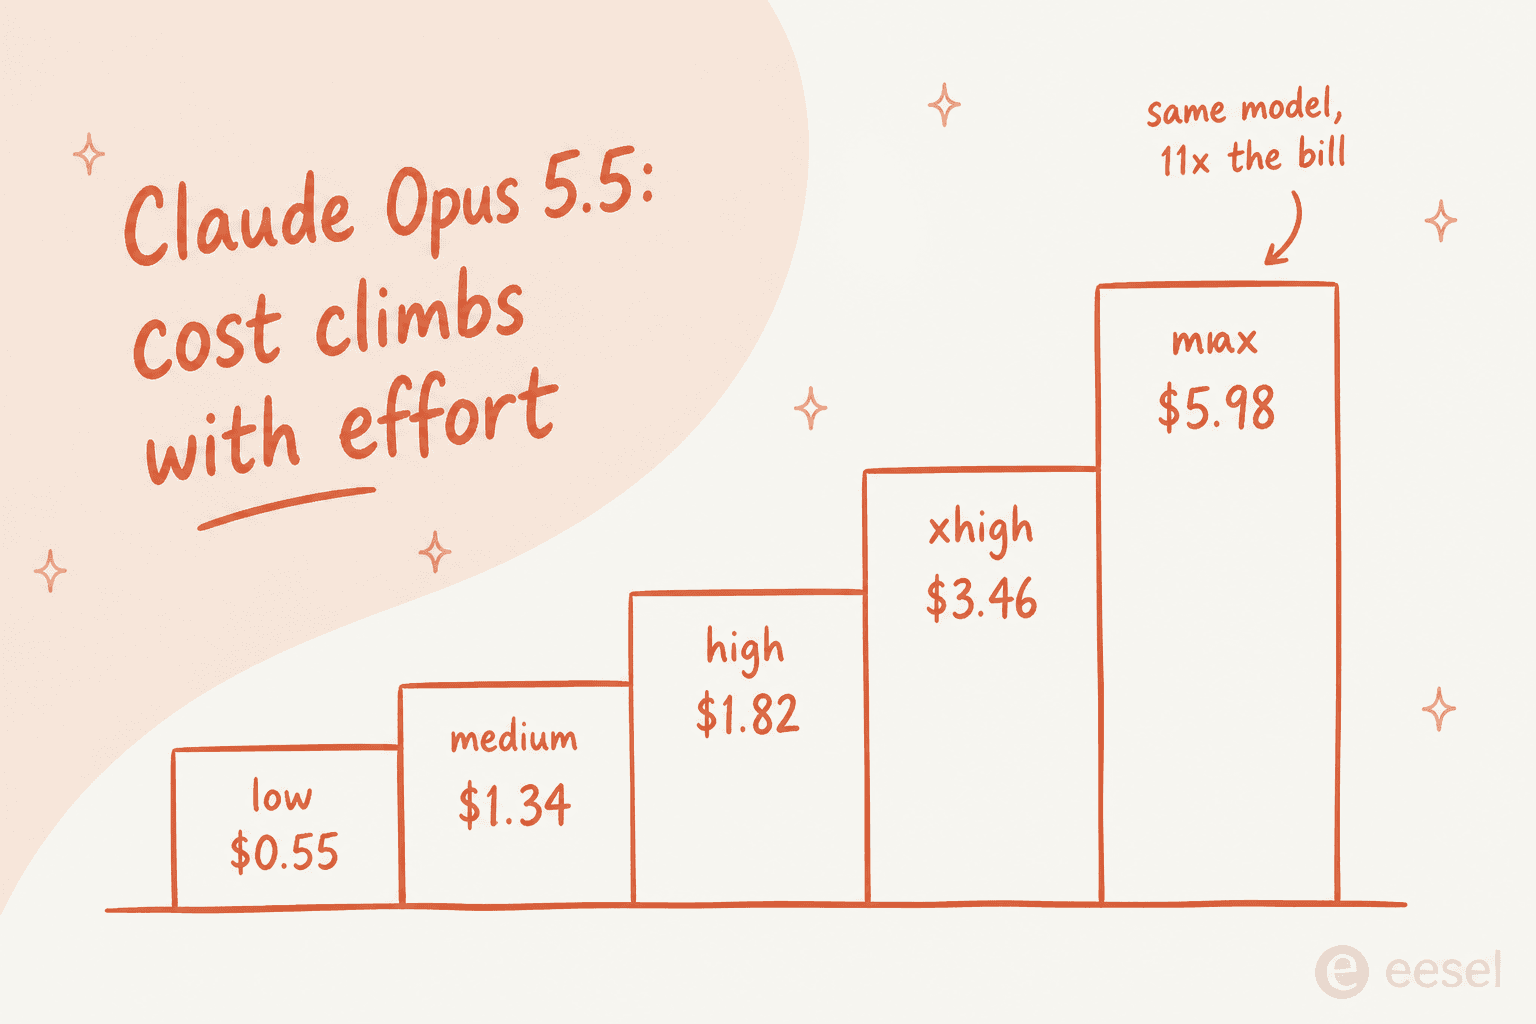
Ich verbringe die letzten Jahre damit, KI auf live Kundensupport-Warteschlangen loszulassen, und was mich an Frontier-Modellen am meisten überrascht hat, war nicht die Qualität, sondern dass die Rechnung viel stärker am Aufwands-Regler hängt als am Listenpreis. Opus 5.5 ist ein perfektes Beispiel. Der Preis pro Token liegt im Mittelfeld, aber die Kosten pro Aufgabe schwanken zwischen etwa $0.55 bei niedrigem Aufwand und $5.98 bei maximalem, weil es bei hohem Aufwand länger denkt und mehr Token ausgibt.
Die Gründe, warum Leute sich umsehen, sind meist einer von vier:
- Kosten pro abgeschlossener Aufgabe. Ein Modell, das ein paar Punkte niedriger abschneidet, aber nur ein Fünftel pro Aufgabe kostet, ist für die meisten Workloads der bessere Kauf.
- Geschwindigkeit. Opus ist bedächtig. Bei allem, worauf ein Mensch wartet, wie eine Chat-Antwort, zählt Latenz mehr als ein Benchmark.
- Offene Gewichte. Manche Teams müssen aus Gründen des Datenschutzes, der Souveränität oder der Kostenkontrolle selbst hosten.
- Multimodale Breite oder Kontext. Audio, Video oder ein wirklich riesiges Kontextfenster können das entscheidende Merkmal sein.
Hier ist, wie sich die acht Alternativen, die ich tatsächlich in Betracht ziehen würde, gegeneinander schlagen, bevor wir zu jeder einzelnen kommen.
Die Claude Opus 5.5-Alternativen im Überblick
| Modell | Am besten für | Preis /1M (in / out) | Kontext | Offene Gewichte | Native Bildverarbeitung |
|---|---|---|---|---|---|
| Claude Opus 5.5 (Platzhirsch) | Schwerstes agentisches Coding | $4 / $20 | ~1M | Nein | Ja |
| GPT-6 Sol | Frontier-Qualität, günstiger pro Aufgabe | $2 / $10 | 1,05M | Nein | Ja |
| Gemini 3.8 Flash | Günstig multimodal in großem Maßstab | $0.75 / $3.75 | 1M | Nein | Ja (+ Audio/Video/PDF) |
| Grok 4.7 | Agenten-Loops mit hohem Volumen | $2 / $6 | 500K | Nein | Ja |
| Qwen 3.8 Max | Multimodaler Mehrwert, offene Basis | $2 / $6 | 1M | Nur Basis | Ja |
| Kimi K3 | Offene Gewichte mit Bildverarbeitung | $3 / $15 | 1M | Ja | Ja |
| DeepSeek V4 Flash | Die Kostenuntergrenze | ~$0.22 / $0.66 | 1M | Ja (MIT) | Nein |
| GPT-6 Luna | Am günstigsten im großen Maßstab | $0.10 / $0.50 | 1,05M | Nein | Ja |
| Claude Sonnet 5 | In der Claude-Familie bleiben | $2 / $10 | ~1M | Nein | Ja |
Preise sind Standard-Listenraten für kurzen Kontext pro Million Token, Stand September 2026. DeepSeeks Zahl ist die Off-Peak-Rate für Cache-Miss-Input und die Standard-Output-Rate. Die Rate von Gemini 3.8 Flash ist bis zum 31. Dezember 2026 ein Aktionspreis und verdoppelt sich danach.
Kurz zur Auswahlmethode. Das ist eine Shortlist, kein Katalog, daher habe ich drei Dinge gewichtet: einen echten, nachprüfbaren Preis (pro Token und, wo Artificial Analysis ihn gemessen hat, pro Aufgabe), wie sich das Modell tatsächlich im Vergleich zu seinem Marketing verhält, und ob es eine Lücke füllt, die Opus 5.5 offenlässt. Alles, was nur "Opus, aber etwas schlechter zum gleichen Preis" war, hat es nicht geschafft.
1. GPT-6 Sol: der engste Frontier-Rivale, zu einem Fünftel der Kosten
Am besten für: Teams, die nahezu Frontier-Qualität wollen, sich aber die Kosten pro Aufgabe von Opus 5.5 nicht leisten können.
GPT-6 Sol startete am 23. September 2026, einen Tag nach Opus 5.5, und ist der direkteste Vergleich auf dieser Liste. Es hat ein 1.050.000-Token-Kontextfenster, native Bildeingabe und das vollständige OpenAI Responses-Toolset inklusive Websuche, Code-Interpreter, gehosteter Shell, Computer-Nutzung und MCP.
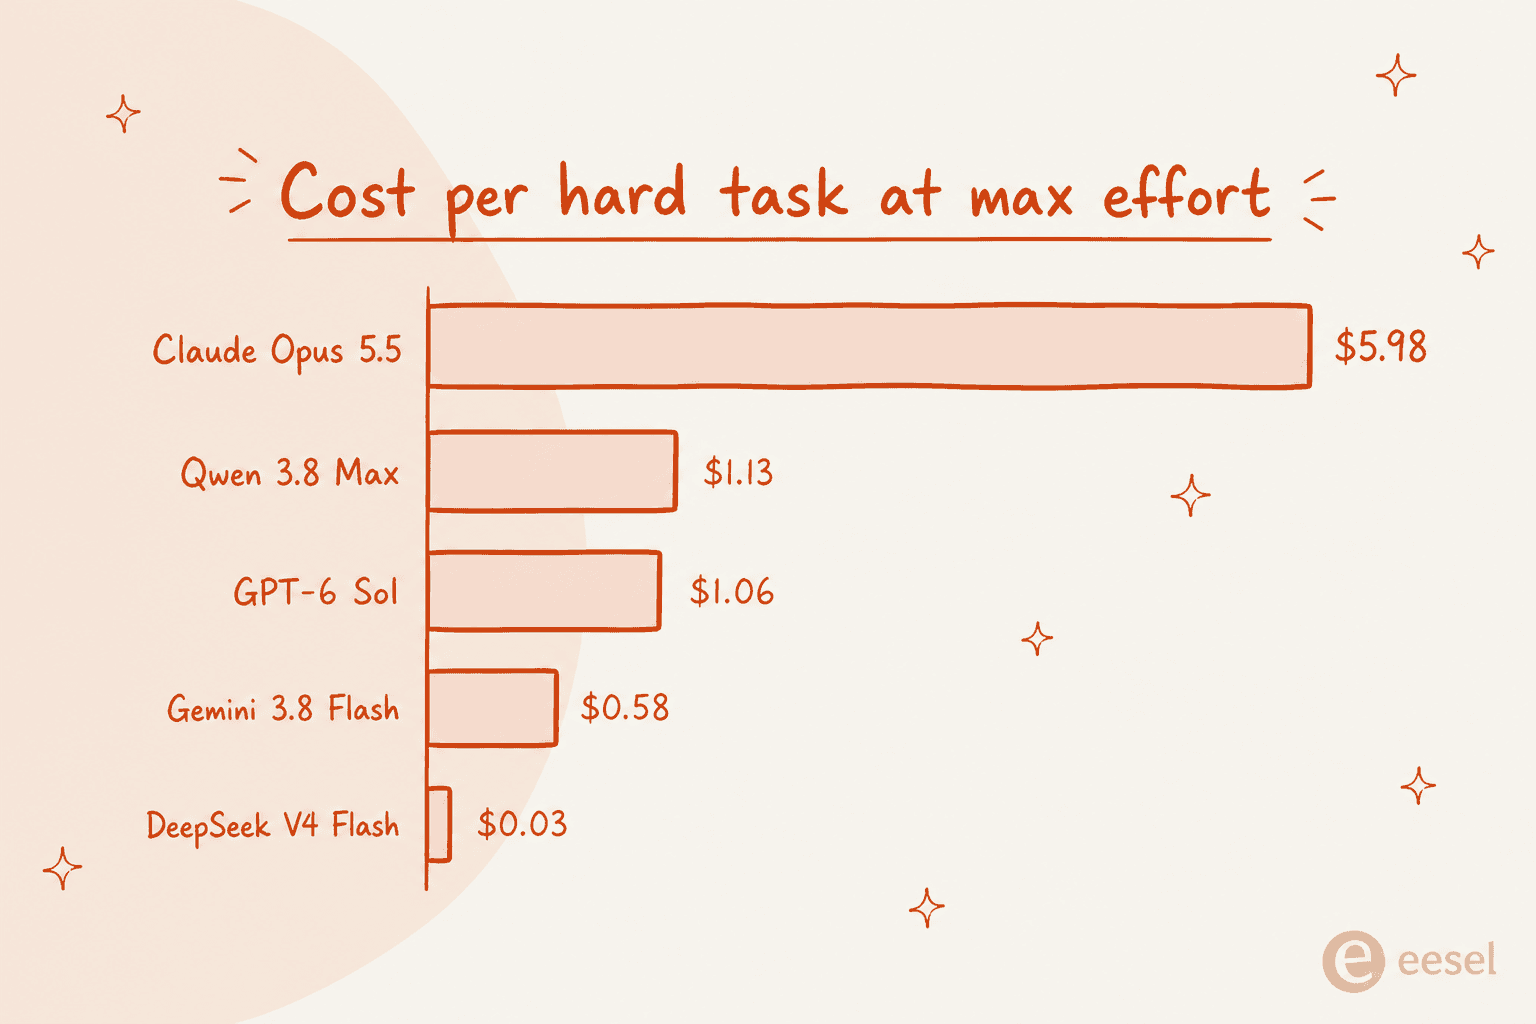
Bei roher Intelligenz gewinnt Opus: Artificial Analysis bewertet Sol mit 48 auf seinem Intelligence Index gegenüber Opus 5.5's 58. Aber schau dir an, was jeder Punkt kostet. Sol kostet $2/$10 pro Million Token, halb so viel wie Opus, und schließt bei maximalem Aufwand eine schwere Aufgabe für etwa $1.06 ab gegenüber Opus' $5.98, teilweise weil es weit weniger Output-Token ausgibt. Das ist die schärfste Zahl in diesem ganzen Beitrag.
Es gibt eine echte Debatte darüber, ob diese Lücke es wert ist, und die Community ist geteilter Meinung. Hier ist ein erfahrener Tester im Launch-Thread:
My initial takeaway is that GPT-6 is mostly a lower cost win, for Luna. GPT-6 Max is an upgrade on intelligence too, but its mostly a cost play (which is great, not complaining). I personally am preferring Opus 5.5 at medium over GPT-6 Sol Max, in very very early tests. Similar price range, more capability.

Vorteile: rund 5x günstiger pro Aufgabe bei maximalem Aufwand, klarere Standardprosa, ein riesiges Kontextfenster und eine echte Verbesserung bei der Faktentreue (OpenAI berichtet von etwa der Hälfte der Fehler des vorherigen Sol; die Halluzinationsrate bei maximalem Aufwand fiel bei Artificial Analysis von 92 % auf 60 %).
Nachteile: eine niedrigere Reasoning-Obergrenze als Opus 5.5, und es ist nicht in ChatGPTs kostenlosem Tarif verfügbar, sodass beiläufiger Zugang einen kostenpflichtigen Plan bedeutet.
Fazit: für die meisten Workloads beim Aufbau eines Agenten ist Sol der klügere Kauf. Du gibst einen Teil der Spitzen-Reasoning-Leistung auf und bekommst das meiste davon in Geschwindigkeit und Budget zurück. Wenn du viele Aufgaben laufen lässt und die Rechnung im Blick behältst, fang hier an.
2. Gemini 3.8 Flash: die günstige, wirklich multimodale Option
Am besten für: Jobs mit hohem Durchsatz, die Audio-, Video- oder PDF-Eingabe bei knappem Budget brauchen.
Gemini 3.8 Flash ist Googles dritte Flash-Veröffentlichung in sechs Wochen, und es tut etwas Ungewöhnliches: Es übertrifft Opus 5.5 auf dem Artificial Analysis Intelligence Index (59 zu 58), während es nur einen Bruchteil kostet, bei $0.75/$3.75 pro Million Token bis Ende 2026. Es ist außerdem das einzige Modell hier, das nativ Bild, Audio, Video und PDF aufnimmt, mit einem 1M-Token-Eingabefenster.
Die ehrlichen Vorbehalte zählen jedoch. Die Zeit bis zum ersten Token beträgt 13,30s gegenüber einem Klassenmedian von nahe 3s, also ist es disqualifiziert für alles, worauf ein Mensch live wartet, und perfekt für einen nächtlichen Batch-Lauf. Es ist außerdem geschwätzig, und Google selbst schreibt im Launch-Post, dass Workloads mit Effizienzpriorität bei 3.7 Flash bleiben sollten. Beim Preis und der multimodalen Reichweite ist es ausgezeichnet, bei der Reaktionsfähigkeit nicht.
Vorteile: Intelligence-Index-Score auf Frontier-Niveau, die breitesten Eingabetypen auf der Liste, sehr günstig, und ein kostenloser Tarif zum Testen.
Nachteile: langsames erstes Token, geschwätziger Output, der den Preisvorteil aufzehrt, und eine bereits terminierte Preisverdopplung auf $1.50/$7.50 am 1. Januar 2027.
Fazit: wenn dein Workload asynchron und multimodal ist, ist das wohl das beste Preis-Leistungs-Verhältnis auf dieser Seite. Stell es nur nicht hinter ein Live-Chat-Widget, wo die 13s-Verzögerung beim ersten Token auffallen würde. Für den Unterschied zwischen einem asynchronen und einem Echtzeit-Agenten ist unser Beitrag über KI-Agenten versus regelbasierte Chatbots ein nützlicher Rahmen.
3. Grok 4.7: bepreist, um in Agenten-Loops zu leben
Am besten für: hochvolumiges, mehrstündiges agentisches Coding, bei dem sich die Kosten pro Token summieren.
Grok 4.7 erschien am 21. September 2026, aufgebaut auf einem größeren Basismodell als 4.6 mit einem längeren Reinforcement-Learning-Lauf, der auf mehrstündige Aufgaben ausgerichtet ist. Es kostet $2/$6 pro Million Token unter einem 200K-Prompt, die günstigste Output-Rate jedes Frontier-Modells hier, und hat ein 500K-Kontextfenster plus eine neue Context-Compaction-API für lange Sitzungen.
Die Benchmark-Geschichte lautet "frontier-nah zu Preisen von letztem Jahr". Auf xAI's eigener Tabelle erzielt Grok 4.7 einen Terminal-Bench-4.0-Wert von 37.6 (fast doppelt so viel wie 4.6's 20.3), EEBench 64.0, und einen Harvey-Legal-Agent-Score von 19.6, der tatsächlich sowohl Sol als auch Opus-Klasse-Modelle schlägt. Es gewinnt allerdings nicht überall. Bei HealthBench Professional erzielt es 56.7, hinter sowohl GPT-6 Sol als auch Anthropics Top-Tier.
Vorteile: die niedrige Output-Rate macht es gut geeignet für Loops, die Token verbrennen, ein echter Sprung bei Coding- und Terminal-Benchmarks, und der stärkste xAI-Sicherheits-Stack bisher.
Nachteile: ein 500K-Kontextfenster, das halb so groß ist wie das der 1M-Token-Konkurrenten, der Long-Context-Aufschlag ($4/$12) gilt für jedes Token in der Anfrage, sobald 200K überschritten werden, und es verliert gegen die Frontier bei Health- und einigen Reasoning-Evals.
Fazit: wenn du einen Coding-Agenten verdrahtest, der stundenlang läuft, und dir der Preis pro Token mehr am Herzen liegt als die letzten paar Reasoning-Punkte, ist Grok 4.7 eine starke, ehrliche Wahl. Es gibt auch eine xAI CLI, wenn du es vom Terminal aus steuern willst.
4. Qwen 3.8 Max: Intelligence Index auf Frontier-Niveau, halber Preis
Am besten für: Teams, die einen Intelligence-Score der Opus-Klasse mit einer herunterladbaren Basis als Rückfallebene wollen.
Qwen 3.8 Max wurde am 2. August 2026 allgemein verfügbar und ist im Stillen eines der besser bewerteten Frontier-Modelle. Es ist ein Mixture-of-Experts-Modell mit 2,4T Gesamt- / 95B aktiven Parametern und 1M-Token-Kontext, bepreist mit $2/$6 pro Million Token auf Alibabas Cloud. Auf dem Artificial-Analysis-Board rangiert es jetzt auf Platz sechs mit einem Intelligence Index von 58,08, praktisch auf dem Niveau von Opus 5.5's Spitzenwert, für einen Bruchteil der Kosten.
Die Nuance ist, dass automatisierte Indizes und menschliche Präferenz hier auseinandergehen. Auf LMArena ist Qwen 3.8 Max bei der blinden Präferenz stark: Text #5, WebDev #4 und Vision #2. Aber der zusammengesetzte Index und die menschlichen Stimmen zeigen leicht unterschiedlich, daher würde ich hier nie ein Einzelzahl-Urteil fällen. Beachte auch, dass die offenen Basis-Gewichte existieren, aber nicht funktionsgleich mit dem gehosteten Max sind, das Vision, einen Nicht-Denk-Modus und integrierte Tools hinzufügt.
Vorteile: Intelligence Index auf Frontier-Niveau für $2/$6, ausgezeichnete multimodale LMArena-Platzierungen, und eine offene Basis für Teams, die eine Self-Hosting-Option wollen.
Nachteile: die offenen Gewichte tragen eine Nicht-Apache-Lizenz und es fehlen die Funktionen des gehosteten Modells, und die Lücke zwischen automatisiertem und menschlichem Score bedeutet, dass du auf deinen eigenen Aufgaben testen solltest.
Fazit: eine unterschätzte Wahl. Wenn du etwas willst, das nahe an Opus 5.5 für weniger Geld benchmarkt, und du bereit bist, deine eigenen Evals durchzuführen statt einem Score zu vertrauen, verdient Qwen 3.8 Max einen Platz auf deiner Shortlist.
5. Kimi K3: offene Gewichte, die wirklich sehen
Am besten für: Teams, die ein wirklich offenes, bildverarbeitungsfähiges Frontier-Modell wollen.
Kimi K3 ist Moonshot AI's Flaggschiff, ein Mixture-of-Experts-Modell mit 2,8T Gesamt- / 104B aktiven Parametern, 1M-Token-Kontext und nativer Bildverarbeitung (Bild und Video). Entscheidend ist, dass die offenen Gewichte pünktlich am 27. Juli 2026 erschienen, und der Safetensors-Index bestätigt die 2,8T-Parameterzahl unabhängig von der Pressemitteilung. Auf dem Artificial Analysis Intelligence Index landet es bei 57, in der gleichen Nachbarschaft wie Opus 5.5.
Die Preisgestaltung liegt bei $3/$15 pro Million Token, was der Claude-Sonnet-Preisklasse entspricht statt der Billig-Kategorie. Eine Eigenheit, die man kennen sollte: Reasoning lässt sich nicht abschalten. Die reasoning_effort-Steuerung hat jetzt die Stufen low und high, aber sie sind eine Latenzsteuerung, keine Kostenstufe, da jede Stufe gleich abgerechnet wird. Eine öffentliche Bild-URL wird auch nicht akzeptiert; du übergibst base64 oder eine Datei-ID.
Vorteile: wirklich offene Gewichte mit Bildverarbeitung, ein Intelligence-Score nahe der Frontier, und starke agentische und BrowseComp-Ergebnisse.
Nachteile: bepreist wie Sonnet statt wie die günstigen offenen Modelle, Reasoning, das sich nicht abschalten lässt, und Bildverarbeitung, die base64 statt URLs braucht.
Fazit: die Wahl, wenn "offene Gewichte" und "verarbeitet Bilder" beide zutreffen müssen. Wenn du nur eines davon brauchst, ist DeepSeek günstiger und Qwen benchmarkt höher, also ist Kimi K3 eine spezifische Wahl statt eines Standards.
6. DeepSeek V4: die Kostenuntergrenze, mit einem Sternchen
Am besten für: die absolut niedrigsten Kosten pro Token, und Teams, die MIT-lizenzierte Gewichte wollen.
DeepSeek V4 Flash ist der günstigste Weg, ein leistungsfähiges Modell auf dieser Liste zu betreiben, Punkt. Es ist ein Mixture-of-Experts-Modell mit 284B Gesamt- / 13B aktiven Parametern, 1M-Token-Kontext und MIT-offenen Gewichten, und auf Artificial Analysis erzielt es einen Intelligence Index von 50 für rund $0.03 pro Aufgabe bei maximalem Aufwand, das ist kein Tippfehler.
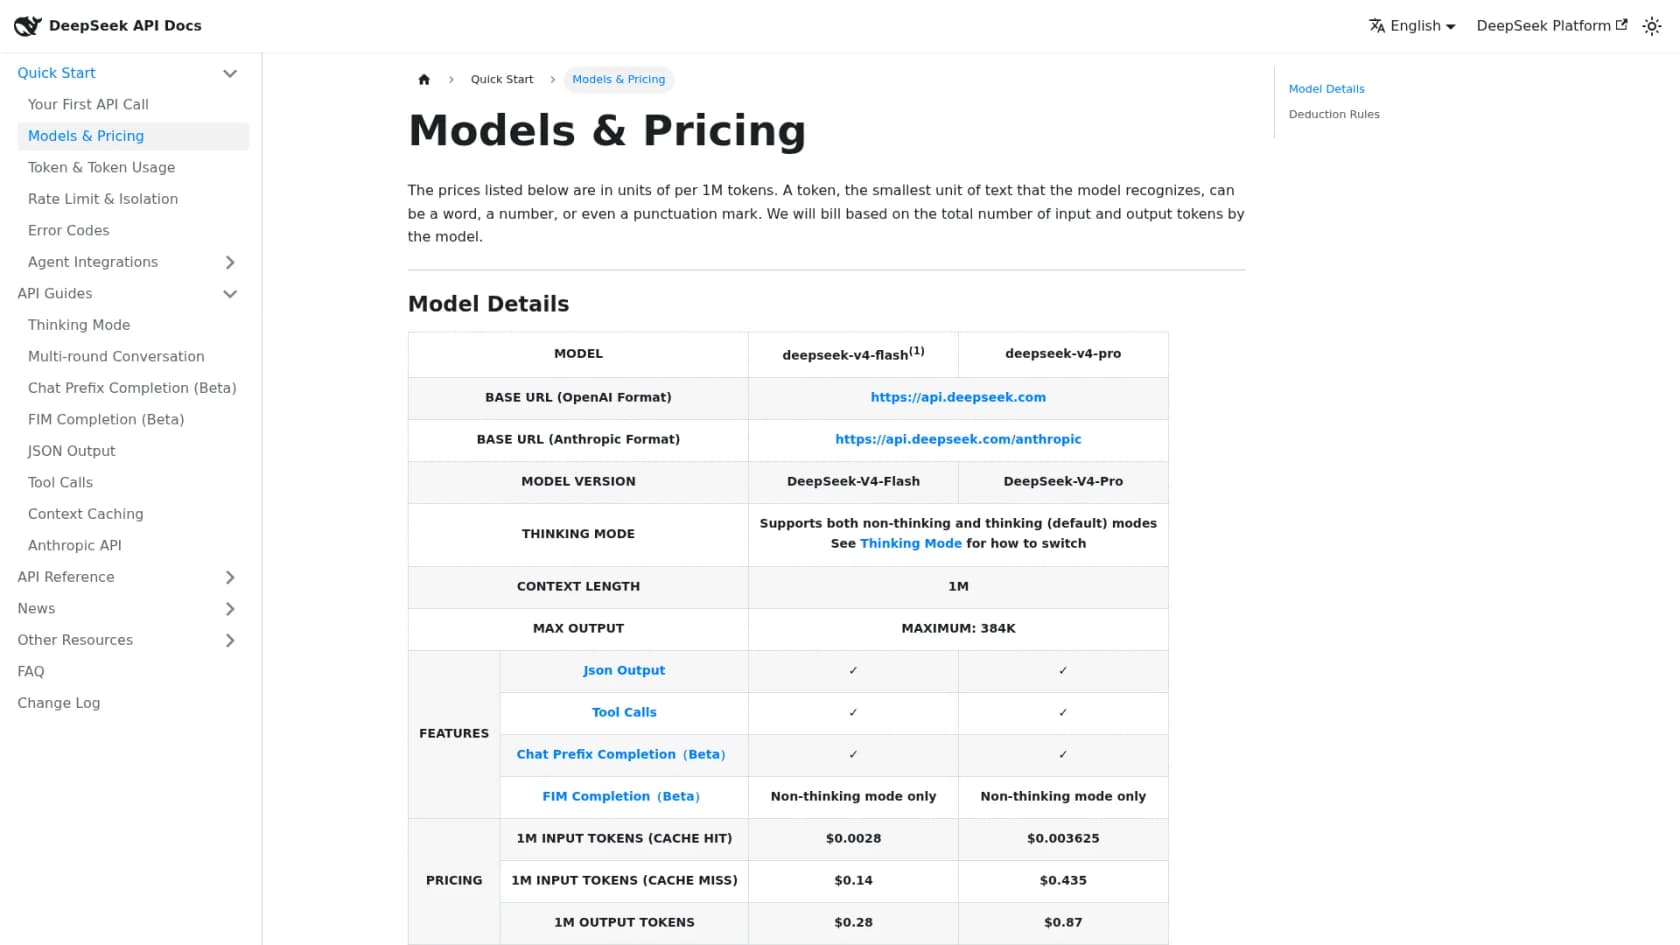
Die Sternchen sind real und sollten offen genannt werden. Die Preisgestaltung hat einen Peak/Off-Peak-Aufschlag: Cache-Miss-Input kostet $0.22/$0.44 und Output $0.66/$1.32 pro Million (Off-Peak / Peak), wobei Peak den chinesischen Geschäftszeiten entspricht, sodass eine US- oder EU-Warteschlange meist off-peak abgerechnet wird. Das Modell ist reiner Text ohne dokumentierte Bildeingabe. Und seine Daten liegen unter PRC-Recht in der VR China, während die Nutzungsbedingungen der kostenpflichtigen API zum Training schweigen, statt es ausdrücklich zu erlauben. Diese Kombination macht es zu einer schlechten Drop-in-Lösung für regulierte Kundendaten, auch wenn es ein fantastischer Motor für Code und interne Tools ist. Ein Entwickler hat den praktischen Fall unverblümt formuliert:
I have been using DeepSeek since forever and it's so good I was able to write a compiler and native desktop applications with it. I use it as a coding assistant in my IDE so the results end up at the same quality I would write by hand.
Vorteile: die niedrigsten Kosten pro Aufgabe überhaupt, MIT-lizenzierte offene Gewichte, und ein 1M-Token-Kontext.
Nachteile: reiner Text, geschwätzig mit hoher Halluzinationsrate, eine anfällige Peak-Pricing-Eigenheit, und PRC-Datenresidenz, die es für sensible Kundendaten ausschließt.
Fazit: der Preis-Leistungs-Champion für Code und interne Arbeit, wo die Daten nicht sensibel sind. Kombiniere es mit unserem Leitfaden zu KI-Halluzinationen, bevor du es auf irgendetwas Kundenkontakt-Relevantes ansetzt.
7. GPT-6 Luna: der günstigste Weg zu skalieren
Am besten für: hochvolumige Arbeit mit geringerem Risiko, bei der ein paar Punkte Intelligenz das Ergebnis nicht verändern.
GPT-6 Luna ist OpenAIs Budget-Tarif und ist mit $0.10/$0.50 pro Million Token aggressiv günstig, ein glatter 50%-Rabatt gegenüber GPT-5.6 Luna. Es teilt Sols 1.050.000-Token-Kontext und native Bildeingabe, und ist das einzige GPT-6-Modell, das in ChatGPTs Free- und Go-Tarif ($8) verfügbar ist. OpenAIs eigene Formulierung lautet "mit Sol bauen, mit Luna skalieren", und der Markt scheint zuzustimmen; das vorherige Luna war bereits das meistgenutzte Modell auf OpenRouter.
6-luna is at the pareto for most of the tasks! I dont know how they make money here but its insane value from a closed source model.
Der ehrliche Gegenpunkt ist, dass "günstigster pro Token" und "günstigster pro Aufgabe" nicht dasselbe sind. Bei stark gecachten Coding-Workflows finden manche Entwickler, dass offene Modelle wie DeepSeek wegen des Cache-Read-Unterschieds am Ende noch günstiger sind, also rechne selbst nach, wenn Caching deine Nutzung dominiert.
Vorteile: die günstigste Option der geschlossenen Frontier-Familie, ein großes Kontextfenster, und kostenloser Zugang zum Testen.
Nachteile: die niedrigste Reasoning-Obergrenze der GPT-6-Linie, und eine Pro-Aufgabe-Rechnung, die bei cache-lastigen Jobs gegen offene Modelle verlieren kann.
Fazit: das richtige Werkzeug für Volumen, Klassifizierung, Übersetzung und einfache Agentenschritte. Es ist nicht das Modell, dem du deine schwerste Reasoning-Aufgabe übergibst, aber ein hervorragendes Arbeitspferd und ein großartiger Standard für die langweiligen 80 %.
8. Claude Sonnet 5: in der Familie bleiben, halben Preis zahlen
Am besten für: Teams, die Claudes Tooling und Ökosystem mögen, aber nicht bei jedem Aufruf Opus brauchen.
Wenn der Grund, warum du bei Opus 5.5 bist, das Claude-Ökosystem ist, ist Claude Sonnet 5 die naheliegende hauseigene Alternative. Es kostet $2/$10 pro Million Token, genau die Hälfte von Opus, und Anthropic positioniert es als die beste Balance aus Geschwindigkeit und Intelligenz. Du behältst die gleiche API, die gleiche Claude-Code-Integration und das gleiche Tool-Ökosystem; du hörst nur auf, Opus-Preise für Aufgaben zu zahlen, die kein Opus-Reasoning brauchen.
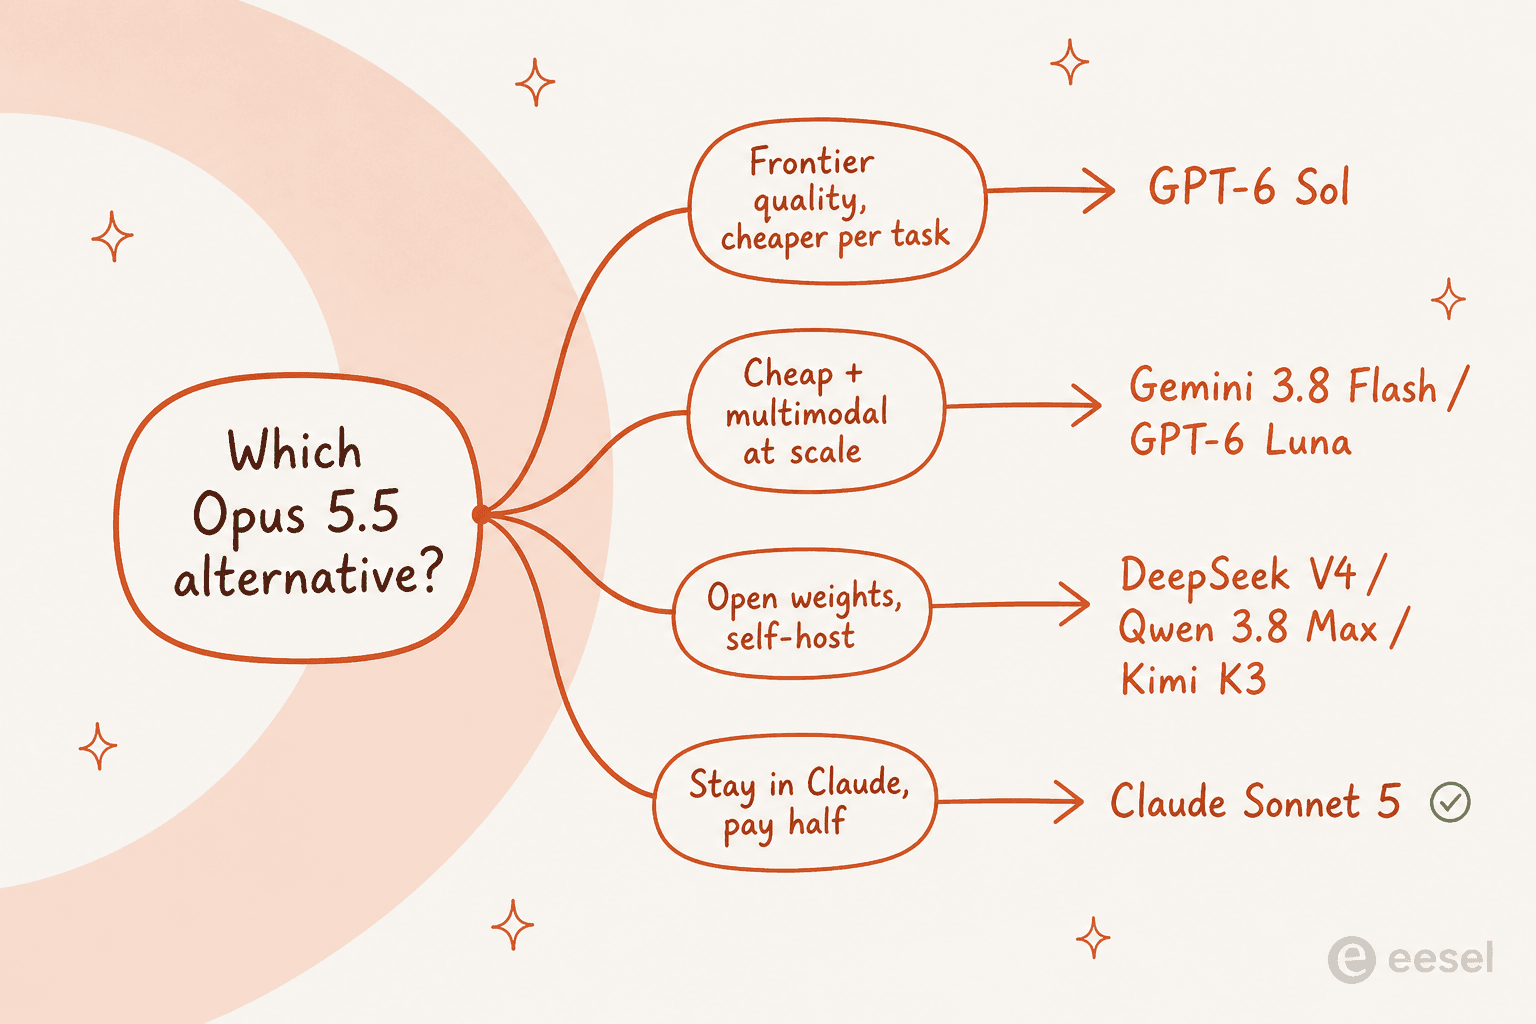
Das sinnvollste Muster, das ich gesehen habe, ist ein Zwei-Modell-Setup: leite die schwierigen, mehrdeutigen Aufgaben an Opus 5.5 und alles andere an Sonnet 5. Das erfasst das meiste von Opus' Obergrenze bei den Aufgaben, die sie brauchen, und senkt die Rechnung bei denen, die es nicht tun.
Vorteile: halber Preis von Opus, kein Ökosystemwechsel, und Anthropics geschwindigkeitsoptimierte Stufe.
Nachteile: eine niedrigere Reasoning-Obergrenze als Opus 5.5, und du bleibst trotzdem in der Preisgestaltung eines Anbieters.
Fazit: die reibungsloseste Alternative auf dieser Liste. Wenn du mit Claude zufrieden bist und einfach weniger ausgeben willst, ist das die Änderung, die du vornimmst, bevor du woanders suchst.
Wie ich tatsächlich wählen würde
Nimm die Bestenliste weg, und die Entscheidung läuft auf ein paar ehrliche Fragen hinaus. Es gibt keinen einzelnen Gewinner, denn "am besten" hängt von der Form deines Workloads ab.
- Willst du das Nächstliegende zu Opus für viel weniger? GPT-6 Sol. Nahezu Frontier-Qualität, etwa ein Fünftel der Kosten pro Aufgabe.
- Läufst du asynchrone, multimodale Jobs in großem Maßstab? Gemini 3.8 Flash für Reichweite und Preis, oder GPT-6 Luna für die günstigste Rate pro Token.
- Brauchst du offene Gewichte? DeepSeek V4 für die Kostenuntergrenze, Qwen 3.8 Max für den höchsten Benchmark, Kimi K3, wenn du auch Bildverarbeitung brauchst.
- Zufrieden mit Claude? Sonnet 5 zum halben Preis, idealerweise parallel zu Opus für die schwierigen Aufgaben geleitet.
Und darunter liegt ein leiserer Punkt, zu dem erfahrene Entwickler immer wieder kommen. Die Benchmarks sind ein Startschuss, kein Urteil:
Only hands-on experience matters in the end, and these days it's very easy to switch models.
Dieser letzte Halbsatz, "very easy to switch models", ist die eigentliche Geschichte von 2026. Was zu der Frage führt, die die meisten dieser Vergleiche auslassen.
Probiere eesel: das Teammitglied, das auf jedem dieser Modelle läuft
Hier ist, was jeder Modell-gegen-Modell-Beitrag still voraussetzt: dass es deine Aufgabe ist, ein Modell auszuwählen, dessen API zu verdrahten, Prompt-Engineering zu betreiben, es mit deinen Tools zu verbinden, und das Ganze davon abzuhalten, bei echten Kunden zu halluzinieren. Für die meisten Teams ist das nicht die Aufgabe. Die Aufgabe ist eine höhere Lösungsquote, oder veröffentlichte Beiträge. Das Modell ist nur der Motor.
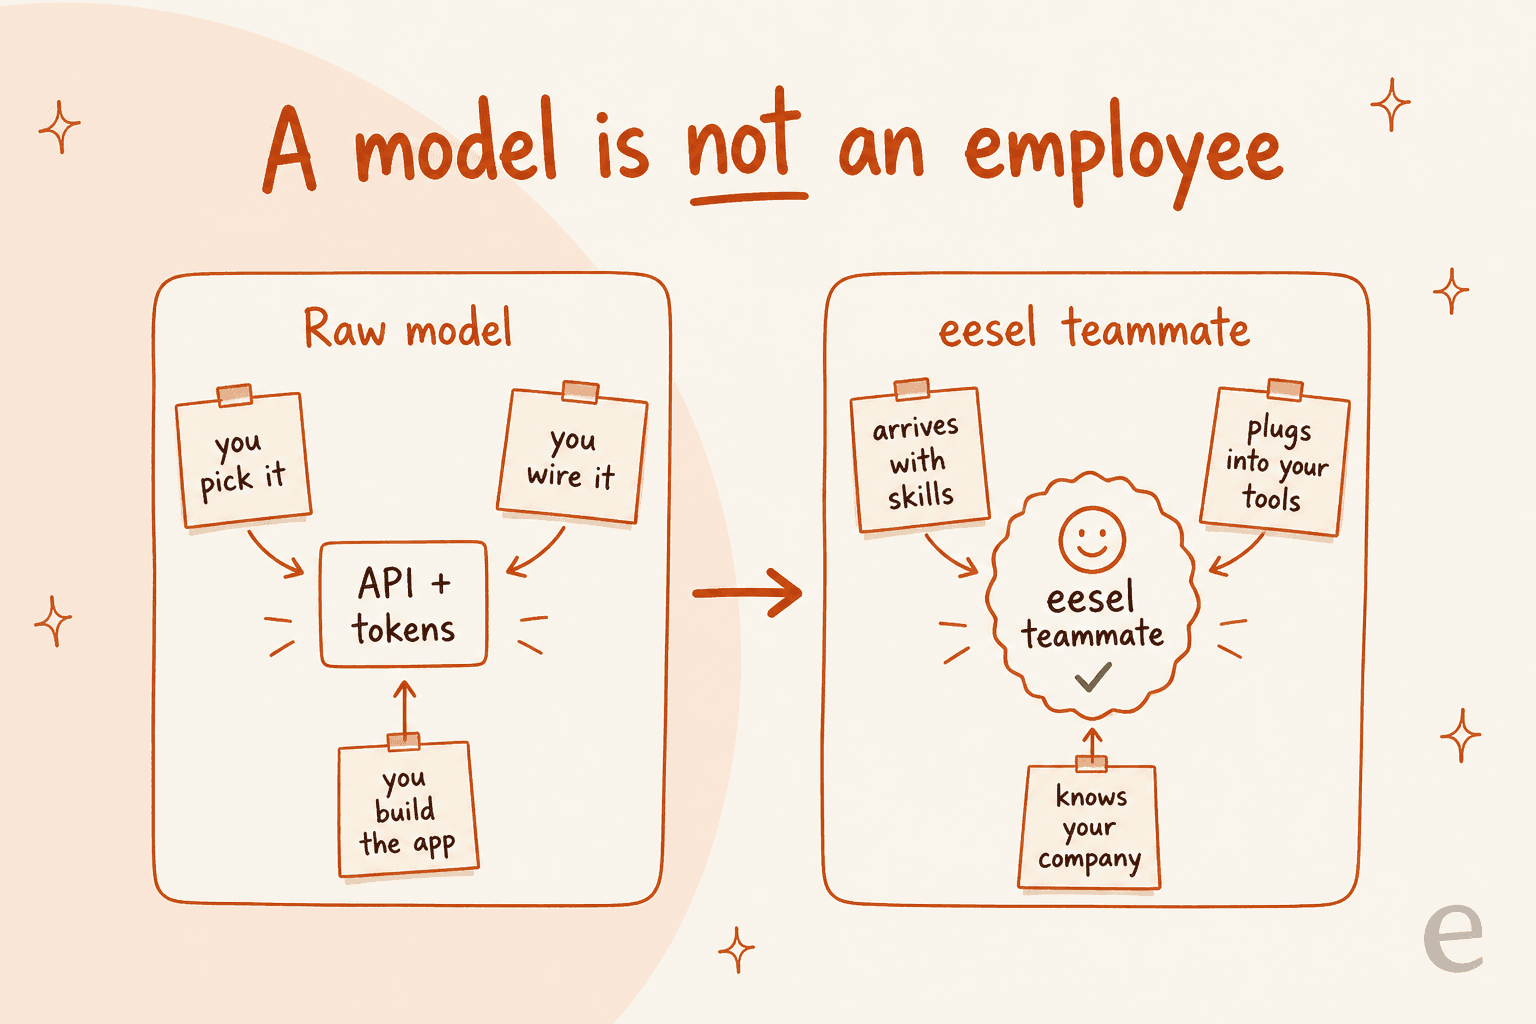
So würde ich eesel einordnen. Es ist eine KI-Teammitglied-Plattform, und du stellst einsatzbereite Teammitglieder für bestimmte Aufgaben ein. Das aktuelle Angebot ist ein KI-Helpdesk-Teammitglied, das sich in deine bestehende Support-Warteschlange einklinkt, und ein KI-Blog-Autor, der recherchierte Beiträge entwirft. Jedes kommt bereits mit dem Wissen, wie es seine Aufgabe erledigt, ist in deine Tools eingebunden und im Kontext deines Unternehmens verankert, sodass nicht du zwischen Opus 5.5 und Sol wählen und einen Prompt betreuen musst. Da das Modell unter dem Teammitglied sitzt, ist ein günstigeres oder besseres Modell, das nächsten Monat erscheint, ein kostenloses Upgrade, kein Umbau.

Wenn du die Art Mensch bist, die einen Modell-Alternativen-Beitrag liest, wird dir das hier gefallen: das Ganze lässt sich vom Terminal aus steuern. Die eesel CLI (npx @eesel/cli) lässt dich Integrationen verbinden, die Standardanweisungen des Agenten bearbeiten, einen Rollout gegen deine historischen Tickets simulieren, Aktionen genehmigen und das Aktivitätsprotokoll jedes Laufs lesen, alles als JSON, mit einem --dry-run-Flag, das den genauen Aufruf ausgibt, den ein Schreibvorgang machen würde, bevor er gesendet wird. Jeder Workspace ist außerdem ein MCP-Server, sodass Coding-Agenten wie Claude Code, Codex und Cursor dasselbe Teammitglied bedienen können. Es ist dasselbe Produkt wie das Dashboard, nur für Menschen und Agenten zugänglich gemacht, die im Terminal leben. Du kannst eesel kostenlos testen.
Häufig gestellte Fragen
Was ist die beste Claude Opus 5.5-Alternative?
Wie viel kostet Claude Opus 5.5, und sind die Alternativen günstiger?
Gibt es Open-Source-Alternativen zu Claude Opus 5.5?
Welche Claude Opus 5.5-Alternative eignet sich am besten für Coding-Agenten?
Muss ich mich auf ein Modell festlegen, um einen KI-Support-Agenten zu bauen?


Article by
Kurnia Kharisma Agung Samiadjie
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.