Was Claude Opus 5.5 eigentlich ist
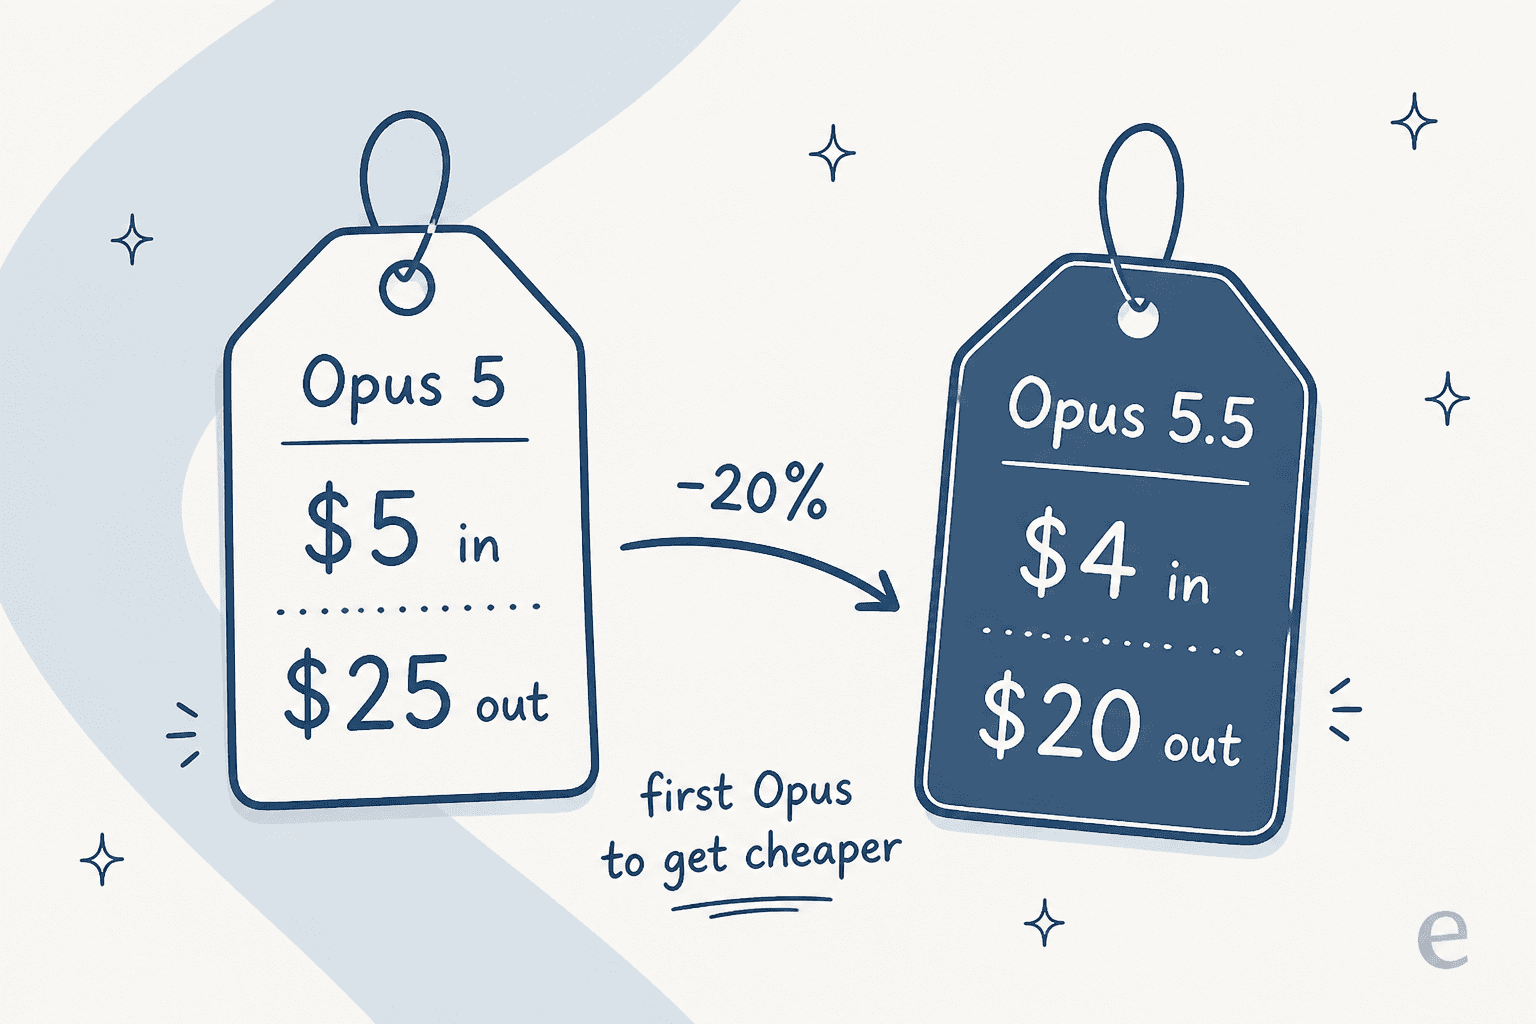
Anthropic hat Claude Opus 5.5 am 22. September 2026 veröffentlicht, und man versteht es am besten als Effizienz-Update von Opus 5, nicht als komplett neues Modell. Die Schlagzeile ist die Umkehr: Jedes bisherige Opus startete zum Premiumpreis, und dies ist das erste, das günstiger startet als das Modell, das es ersetzt.
Der Preis wechselte von Opus 5s $5/$25 auf $4/$20 pro Million Tokens, ein flacher Nachlass von 20%. Das klingt klein, bis man sich erinnert, wofür Opus normalerweise gedacht ist: lange, tokenintensive, autonome Arbeit, bei der die Output-Seite der Rechnung dominiert. Ein 20%-Nachlass auf den $20-Output-Satz ist genau dort, wo die meisten Teams es spüren.
Neben dem Preis hat sich unter der Haube noch einiges verändert. Der Standard-Effort sank von high auf medium, Thinking ist immer aktiv, und Anthropic rät nun, für die meisten Aufgaben mit Opus 5.5 zu starten, statt Opus als Premium-Tier für den Notfall zu behandeln. Es hat ein 1M-Token-Kontextfenster, bis zu 128K Output-Tokens (300K bei Batch), native Bildverarbeitung und einen Wissensstand von Juni 2026. Es ist der Standard in Claude Max, das stärkste Modell in Claude Pro, und es treibt Claude Code für agentisches Programmieren an.
Das Effort-Rad ist der ganze Test
Ich baue KI-Agenten bei eesel, also bedeutet jeder Frontier-Launch dieselbe Routine: meine Evals erneut laufen lassen, Kosten pro abgeschlossener Aufgabe anschauen, entscheiden, was sich ändert. Was mich an Opus 5.5 am meisten überrascht hat, war nicht die Qualität, sondern wie stark die Effort-Einstellung alles andere an der Nutzung dominiert.
So funktioniert der Mechanismus: Opus 5.5 bietet eine Effort-Steuerung mit fünf Stufen: low, medium (der neue Standard), high, very high und max. Höherer Effort lässt das Modell nicht einfach vage „härter arbeiten", sondern länger nachdenken und deutlich mehr Tokens ausgeben, bevor es antwortet. Bei maximalem Effort bei einer schweren Aufgabe hat es rund 119k Output-Tokens verbraucht, gegenüber einem viel schlankeren Durchlauf bei niedrigem Effort. Da Output mit $20 pro Million abgerechnet wird, ist das Effort-Rad im Grunde ein Kosten-Rad, das ein Qualitäts-Label trägt.
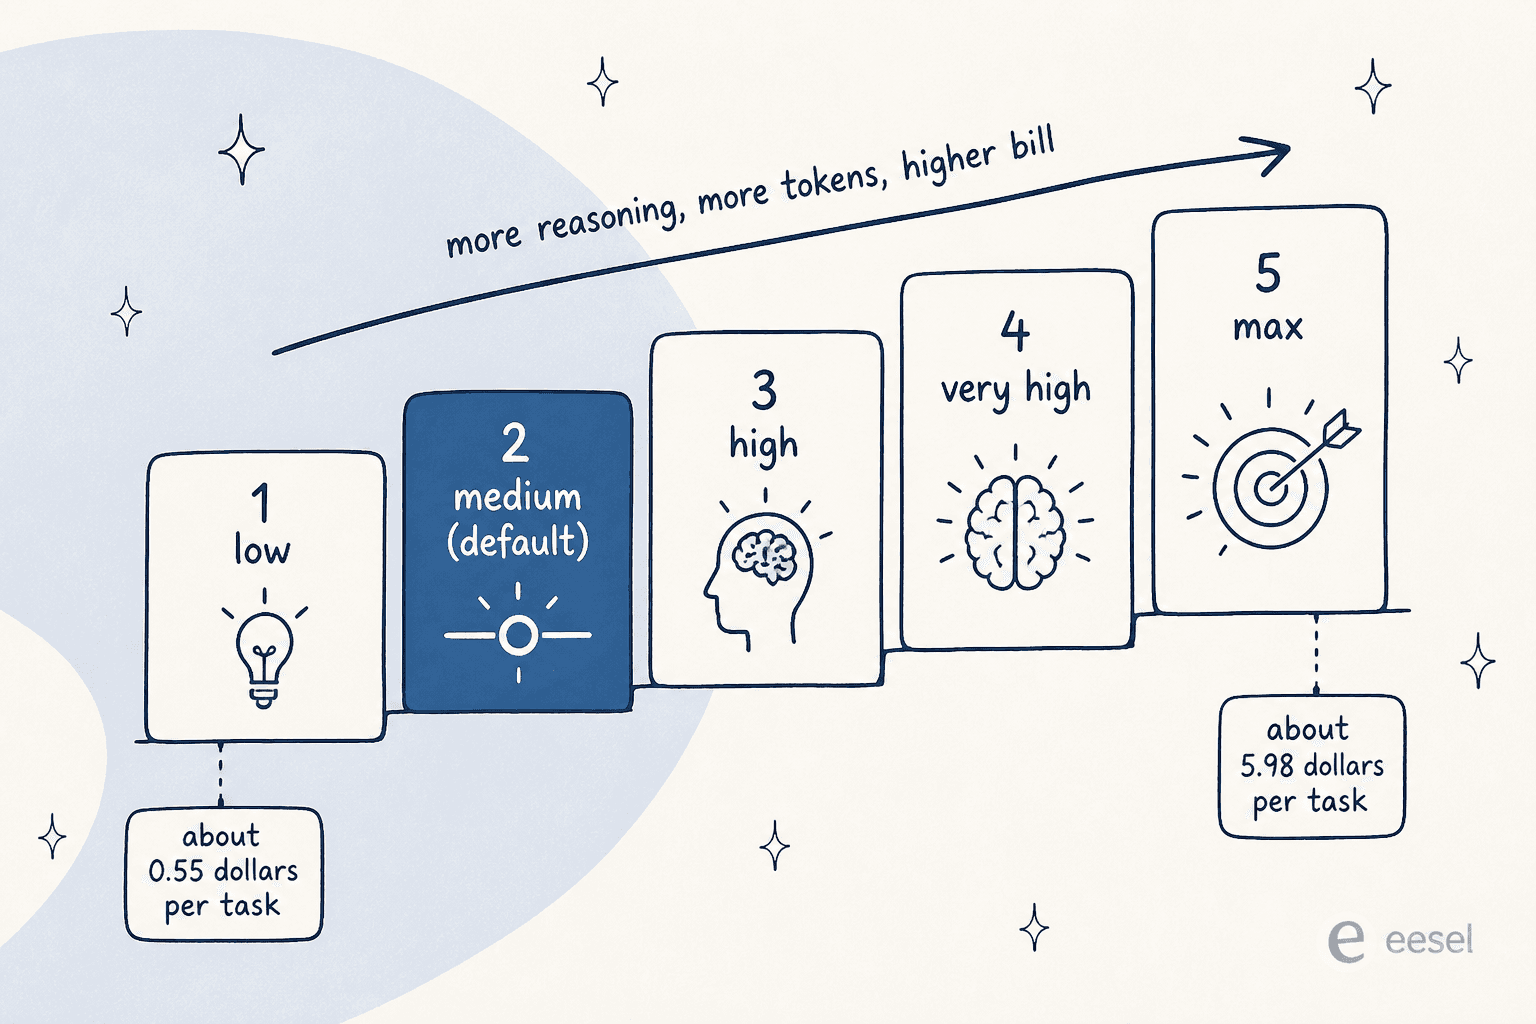
Deshalb ist der Preis pro Token fast eine Ablenkung. Nach Artificial Analysis' eigener Messung kostet dieselbe schwere Aufgabe bei niedrigem Effort etwa $0,55, bei mittlerem Effort etwa $1,34 und bei maximalem Effort etwa $5,98. Die Intelligenz, für die man bezahlt, steigt mit: Der Low-Effort-Durchlauf erreicht 42 Punkte im Intelligence Index, medium erreicht 51, und erst bei max wird die Schlagzeile von 58 erreicht. Die eigentliche Frage beim Einsatz von Opus 5.5 ist also nicht „kann ich mir das leisten", sondern „welches ist die niedrigste Effort-Stufe, die für diese Aufgabe noch ausreicht". Meist ist das medium.
Das ist auch der größte Stolperstein für alle, die von Opus 5 kommen, wo der Standard-Effort high war. Wer dieselbe Arbeitslast ohne Anpassung der Einstellung auf Opus 5.5 überträgt, kann tatsächlich eine niedrigere Rechnung pro Aufgabe bekommen, weil der Standard nun eine Stufe niedriger liegt. Das ist ein wirklich durchdachter Standardwert, bedeutet aber, dass man die Kosten nicht allein vom Listenpreis ableiten kann.
Die Benchmarks: Es gewinnt fast jede Reihe
Lässt man den Preis für einen Moment außen vor, ist Opus 5.5 bei reiner Leistungsfähigkeit der klare Spitzenreiter. Im Artificial-Analysis-Intelligence-Index liegt es mit 58 Punkten auf Platz eins, vor dem gesamten Frontier-Feld. Und es ist kein Zufallstreffer bei nur einem Benchmark: Es führt bei GDPval-AA (1846), bei AutomationBench und bei den Long-Horizon-Coding-Evals, die für Agenten am wichtigsten sind.
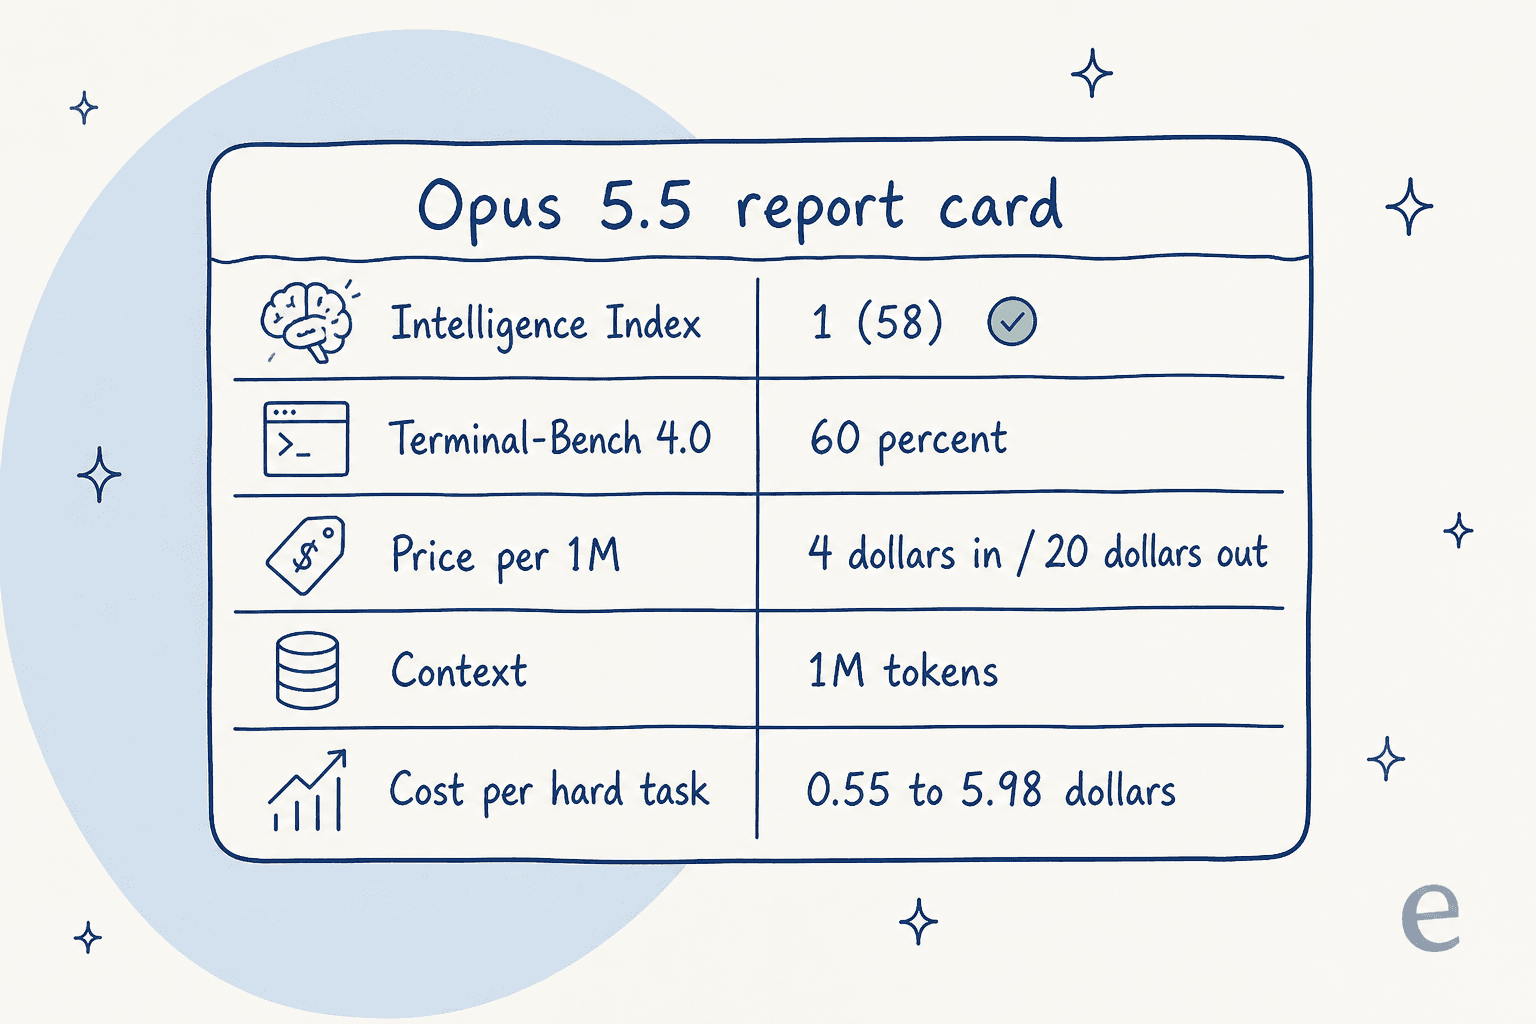
Am deutlichsten zieht die Coding-Story davon. Im Terminal-Bench 4.0, ausgeführt über Artificial Analysis' Testumgebung bei maximalem Effort, erreichte Opus 5.5 60% gegenüber 44% bei seinem preislich nächsten Rivalen. Das ist die Art von Vorsprung, die sich in weniger Sackgassen bei einem langen agentischen Coding-Durchlauf zeigt, genau die Arbeitslast, auf die Anthropic es abgestimmt hat. Wer harte, autonome, mehrstufige Engineering-Arbeit macht, hat hier das Modell, das Aufgaben abschließt, an denen andere Modelle ins Stocken geraten.
Ein Vorbehalt sei angemerkt: Der Spitzenwert ist eine Max-Effort-Zahl, und maximaler Effort ist die $5,98-pro-Aufgabe-Einstellung. Die Benchmarks, die Opus 5.5 krönen, messen es an seiner teuersten Einstellung. Das ist fair, jedes Modell wird an seiner Obergrenze gemessen, aber es bedeutet, dass der Leaderboard-Sieg und die alltägliche Erfahrung nicht dasselbe sind, außer man zahlt immer für max.
Was Claude Opus 5.5 wirklich kostet
Hier die vollständige Preistabelle, denn „ab"-Preise verschleiern genau die Teile, die bei tokenintensiver Arbeit zubeißen.
| Position | Satz |
|---|---|
| Input (pro 1M Tokens) | $4 |
| Output (pro 1M Tokens) | $20 |
| Cache-Read (pro 1M Tokens) | $0,20 |
| Aufpreis für lange Kontexte | Keiner |
| Kontextfenster | 1M Tokens |
| Max. Output | 128K Tokens (300K bei Batch) |
| Kosten pro schwerer Aufgabe (AA) | $0,55 (low) bis $5,98 (max) |
Zwei Zeilen verdienen einen zweiten Blick. Erstens gibt es keinen Aufpreis für lange Kontexte, was Opus 5.5 von Konkurrenten unterscheidet, die ihren Input-Satz ab einer Schwelle verdoppeln; bei Jobs mit riesigem Kontext schließt diese flache Preisgestaltung leise die Lücke pro Token. Zweitens bedeuten Cache-Reads für $0,20 pro Million, dass bei einer Arbeitslast aus einem großen, stabilen System-Prompt plus kurzen Fragen ein großer Teil der Input-Rechnung günstig ist.
Ein kurzes Rechenbeispiel: Angenommen, ihr fahrt 1.000 schwere Agenten-Aufgaben im Monat. Bei mittlerem Effort ($1,34 je Aufgabe) sind das etwa $1.340. Schiebt man dieselben 1.000 Aufgaben für die letzten Punkte Intelligenz auf maximalen Effort, landet man bei rund $5.980. Dieser 4x-Ausschlag ist eine Konfigurationsentscheidung, kein Tarifwechsel, und es sind die Kosten pro Aufgabe, die ich vor jedem hochvolumigen Einsatz von Opus 5.5 an die Tafel schreiben würde. Die vollständige Aufschlüsselung mit Batch und regionalen Sätzen findet ihr in meinem Leitfaden zu Opus 5.5 Preisen, und der umfassendere Vergleich OpenAI API vs. Anthropic API zeigt, wie es sich gegen die andere Frontier-Plattform schlägt.
Wo Opus 5.5 seinen Preis verdient, und wo nicht
Lasst mich konkret werden bei der Frage der Eignung, denn „es ist das beste Modell" stimmt und hilft trotzdem nicht weiter.
Es verdient seinen Preis, wenn die Aufgabe schwierig, lang und teuer ist, wenn sie schiefgeht. Ein mehrstündiger Coding-Agent, der eine echte Codebasis refaktoriert, eine Recherche-Aufgabe, die einen riesigen Kontext halten und über ihn hinweg denken muss, ein mehrdeutiges Problem, bei dem ein günstigeres Modell sich im Kreis dreht. In diesen Fällen kaufen die zusätzlichen Tokens ein fertiges Ergebnis statt einer plausibel aussehenden Sackgasse, und die Rechnung ist günstig im Vergleich zu den Ingenieurstunden, die sie spart.
Es ist das falsche Werkzeug, wenn die Aufgabe klar definiert und hochvolumig ist: Klassifizierung, kurze Antworten, Übersetzung, einfache Nachschlagevorgänge, die alltäglichen 80% der meisten Produktions-Workloads. Opus-Preise und Opus-Latenz für Arbeit zu zahlen, die ein Mittelklasse-Modell locker schafft, ist Geld und Geschwindigkeit, die man nicht zurückbekommt. Opus ist bewusst bedächtig, weshalb bei allem, worauf ein Mensch live wartet, etwa eine Chat-Antwort, die Reaktionsgeschwindigkeit mehr zählt als die letzten Punkte im Intelligence Index. Das ist das Argument für ein Zwei-Modell-Setup: die wirklich schwierigen Aufgaben an Opus 5.5 leiten und alles andere an Sonnet 5, oder zu einer der günstigeren Optionen aus meiner Übersicht der Opus-5.5-Alternativen greifen.
Das ehrliche Fazit in einem Satz: Opus 5.5 ist das beste Modell, und „bestes Modell" ist selten dieselbe Frage wie „richtiges Modell für diese Aufgabe".
Was die Leute wirklich sagen
Die Reaktionen im Launch-Thread deckten sich mit meinen eigenen Tests: echter Respekt vor der Leistungsfähigkeit, und eine wiederkehrende Erinnerung, dass das Label auf dem Effort-Rad wichtiger ist als das Leaderboard. Ein erfahrener Tester, der es mit der Frontier-Konkurrenz verglich, die am nächsten Tag erschien, kam zu diesem Schluss:
My initial takeaway is that GPT-6 is mostly a lower cost win, for Luna. GPT-6 Max is an upgrade on intelligence too, but its mostly a cost play (which is great, not complaining). I personally am preferring Opus 5.5 at medium over GPT-6 Sol Max, in very very early tests. Similar price range, more capability.

Dieses „at medium" leistet eine Menge Arbeit, und genau darum geht es in diesem Test. Das andere Thema, das es wert ist, hervorgehoben zu werden, ist, wie wenig ein einzelner Benchmark 2026 eure Wahl entscheiden sollte:
Only hands-on experience matters in the end, and these days it's very easy to switch models.
Dieser letzte Nebensatz, „very easy to switch models", ist die eigentliche Geschichte des Jahres, und er führt direkt zu der Frage, die die meisten Modell-Tests auslassen.
eesel ausprobieren: das Teammitglied, das mit jedem Modell läuft
Jeder Modell-Test geht stillschweigend davon aus, dass die Aufgabe der Leserin darin besteht, ein Modell auszuwählen, dessen API zu verdrahten, Prompt-Engineering zu betreiben, es mit den eigenen Tools zu verbinden und es davon abzuhalten, bei echten Kunden zu halluzinieren. Für die meisten Teams ist das nicht die Aufgabe. Die Aufgabe ist eine höhere Lösungsrate oder veröffentlichte Beiträge. Ein Frontier-Modell wie Opus 5.5 ist Infrastruktur; es ist der Motor, nicht die Mitarbeiterin.

So würde ich eesel einordnen. Es ist eine KI-Teammitglieder-Plattform, und man stellt einsatzbereite Teammitglieder für konkrete Aufgaben ein. Die aktuelle Besetzung umfasst ein KI-Helpdesk-Teammitglied, das eurer bestehenden Support-Warteschlange beitritt, und eine KI-Blog-Autorin, die recherchierte Beiträge entwirft. Jedes kommt bereits mit Wissen über seine Aufgabe, ist an eure Tools angebunden und im Kontext eures Unternehmens verankert, sodass nicht ihr zwischen Effort-Stufen wählen und einen Prompt betreuen müsst. Da das Modell unter dem Teammitglied liegt, ist ein günstigeres oder klügeres Modell, das nächsten Monat erscheint, ein kostenloses Upgrade statt eines Umbaus, und das KI-Helpdesk-Teammitglied wird pro gelöstem Ticket statt pro Token abgerechnet, sodass die Effort-Rad-Rechnung von oben nicht mehr euer Problem ist.
Wenn ihr zu den Menschen gehört, die einen Modell-Test bis zum Ende lesen, wird euch das hier gefallen: Das Ganze lässt sich vom Terminal aus steuern. Die eesel CLI (npx @eesel/cli) verbindet Integrationen, bearbeitet die Standardanweisungen des Agenten, simuliert einen Rollout gegen eure historischen Tickets, genehmigt Aktionen und liest das Aktivitätsprotokoll jedes Durchlaufs, alles als JSON, mit einem --dry-run-Flag, das den genauen Aufruf ausgibt, den ein Schreibvorgang machen würde, bevor er gesendet wird. Jeder Workspace ist zudem ein MCP-Server, sodass Coding-Agenten wie Claude Code, Codex und Cursor dasselbe Teammitglied bedienen können. Es ist dasselbe Produkt wie das Dashboard, nur offengelegt für Menschen und Agenten, die im Terminal leben. Ihr könnt eesel kostenlos testen.
Häufig gestellte Fragen
Lohnt sich Claude Opus 5.5 im Jahr 2026?
Wie viel kostet Claude Opus 5.5?
Was ist das Effort-Rad bei Claude Opus 5.5?
Ist Claude Opus 5.5 gut zum Programmieren?
Brauche ich Claude Opus 5.5, um einen KI-Support-Agenten zu bauen?


Article by
Alicia Kirana Utomo
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.