Was TypeSafe Jev wirklich ist
TypeSafe ist ein KI-Labor aus San Francisco, das zwei Jahre im Stealth-Modus verbrachte, bevor es Jev launchte. Die Darstellung ist bewusst provokant: Auf der TypeSafe-Homepage „produzieren LLMs Wörter für Menschen“, während „Jev typisierte Entscheidungen produziert und eher wie Code ist: zuverlässig, schnell, in sich konsistent und type-safe“. Der Launch-Post nennt Jev „einen Function Call mit Frontier-Intelligenz: unstrukturierter Zustand rein, typisierte probabilistische Entscheidungen raus“.
Der Name ist ein zweiteiliger Insider-Scherz. „System One“ entlehnt sich Daniel Kahnemans Schnelles Denken, langsames Denken: der Unterscheidung, die er trifft, zwischen dem schnellen, intuitiven System-1-Denken und dem langsamen, bewussten System-2-Denken. Chat-Modelle jagen System 2 hinterher. Jev ist für System 1 gebaut: das spontane Urteil, das eine sachkundige Person in ein paar Sekunden fällt. „Jev“ wiederum ist nach dem Ökonomen William Stanley Jevons benannt, dessen Paradoxon TypeSafe als seine These zitiert: Jeder Rückgang der Intelligenzkosten um eine Größenordnung erschließt eine Größenordnung mehr Anwendungsfälle.
Die Prämisse hinter dem Ganzen ist, dass RLHF, die Technik, die Chatbots angenehm im Gespräch macht, sie gleichzeitig unzuverlässig für die maschinelle Weiterverarbeitung macht. TypeSafes Pitch lautet, man habe „die entgegengesetzte Forschungsrichtung eingeschlagen“ und eine neue Modellklasse mit einem neuen Algorithmus trainiert, den man Reinforcement Learning for Calibrated Decisions (RLCD) nennt.
So funktioniert Jev: Zustand rein, typisierte Entscheidungen raus
Der Kernablauf ist eine Anfrage zu einer Antwort. Sie schicken einen Zustand (entweder einen einfachen String oder ein strukturiertes Objekt) plus eine Reihe typisierter Fragen. Jev wertet jede Frage parallel gegen denselben Zustand aus und liefert typisierte Antworten mit Wahrscheinlichkeiten und Konfidenz zurück. Ihr Code verzweigt, sortiert und routet anschließend anhand dieser Antworten.
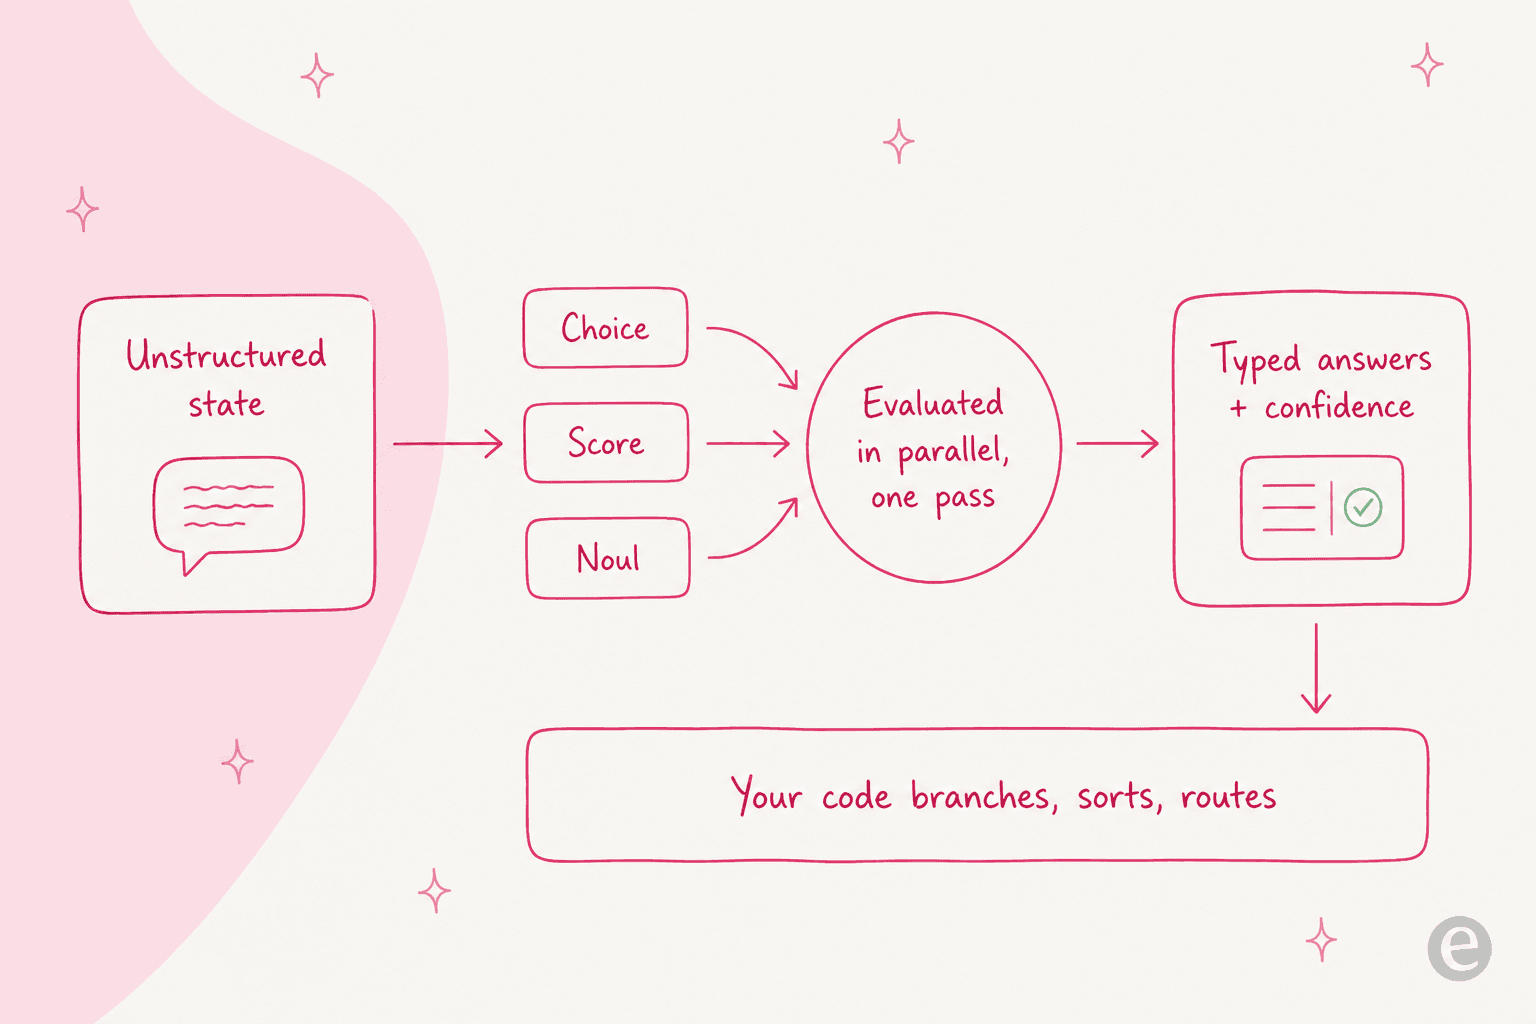
Die wichtigste Design-Entscheidung: Jede Frage wird unabhängig und isoliert gegen denselben Zustand ausgewertet. TypeSafe sagt, dass zusätzliche Fragen die Antwortzeit kaum verändern, und weil jede für sich bewertet wird, entsteht nicht der „Context-Rot“, der sich einschleicht, wenn man ein Dutzend Anweisungen in einen einzigen Prompt zwängt.
TypeSafes Rat lautet, jede Frage atomar zu halten. Statt zu fragen „bewerte dieses Startup-Pitch“, stellen Sie jede Dimension separat (Marktgröße, technische Machbarkeit, Differenzierung) und kombinieren die Werte mit Ihrer eigenen Formel. Wenn sich Prioritäten verschieben, ändern Sie einen Koeffizienten im Code, statt einen Prompt neu zu schreiben. Wenn Sie schon einmal gegen einen Mega-Prompt gekämpft haben, um ihn zur Räson zu bringen, wird Ihnen dieser Zerlegungsinstinkt vertraut vorkommen – es ist dieselbe Logik hinter guter KI-Workflow-Automatisierung.
Die drei Primitive: Noul, Choice und Score
Jev bietet genau drei Fragetypen, und Sie können alle drei in einem einzigen API-Aufruf mischen.
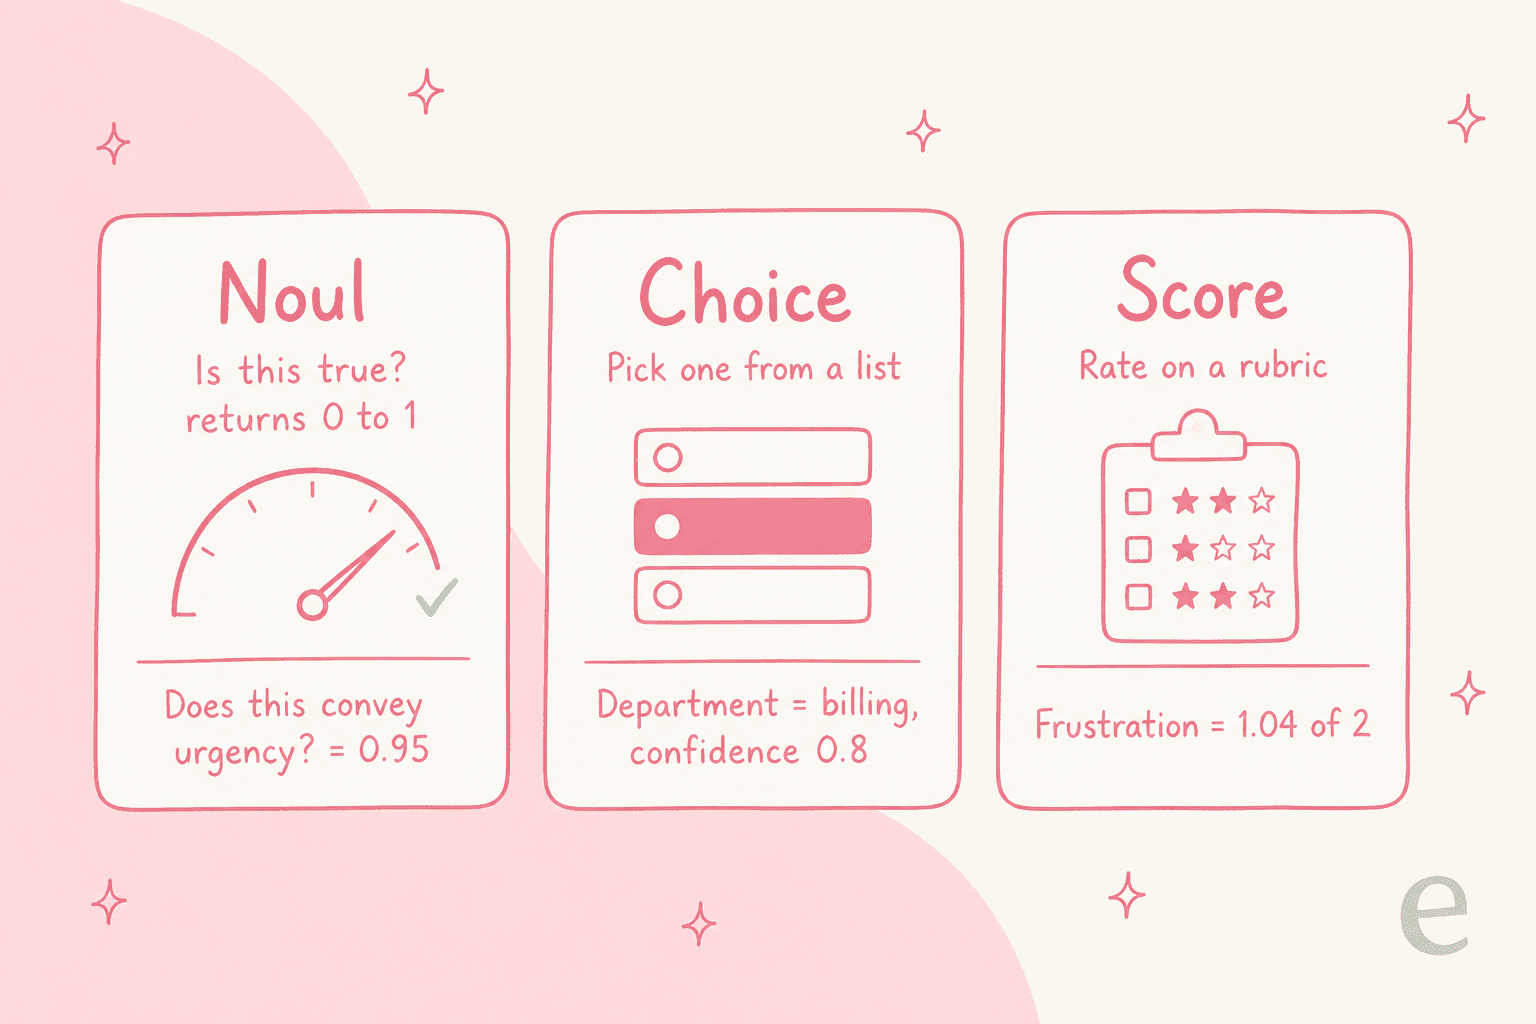
- Noul beantwortet „ist diese Aussage wahr?“ und liefert eine einzelne Wahrscheinlichkeit von 0 bis 1.
- Choice wählt eine Option aus einer von Ihnen definierten Liste und liefert die Wahl, Wahrscheinlichkeiten pro Option und einen Konfidenzwert.
- Score bewertet den Zustand anhand einer von Ihnen definierten Rubrik und liefert einen numerischen Wert (er kann auch zwischen Stufen liegen, etwa 1,04 von 2), Wahrscheinlichkeiten pro Stufe und Konfidenz.
Das ausgearbeitete Beispiel, das Cloudflare veröffentlicht, ist bezeichnenderweise ein Support-Ticket. Füttern Sie Jev mit der Nachricht „Help! My payouts have been failing for 3 days“ und drei gemischten Fragen, und es liefert is_urgent (Noul) mit 0,95, department (Choice) als billing mit 0,8 Konfidenz, und frustration (Score) mit 1,04 auf einer Skala von ruhig bis sehr wütend, alles in einem Aufruf. Das ist Triage, Routing und Stimmungsanalyse in einer einzigen Anfrage, genau die Art von Entscheidung, die ein Schritt zur KI-Ticket-Triage braucht.
Wo Jev sich von einem normalen LLM unterscheidet
Wenn Sie nur ein mentales Modell mitnehmen, dann dieses: Ein LLM schreibt, Jev entscheidet.
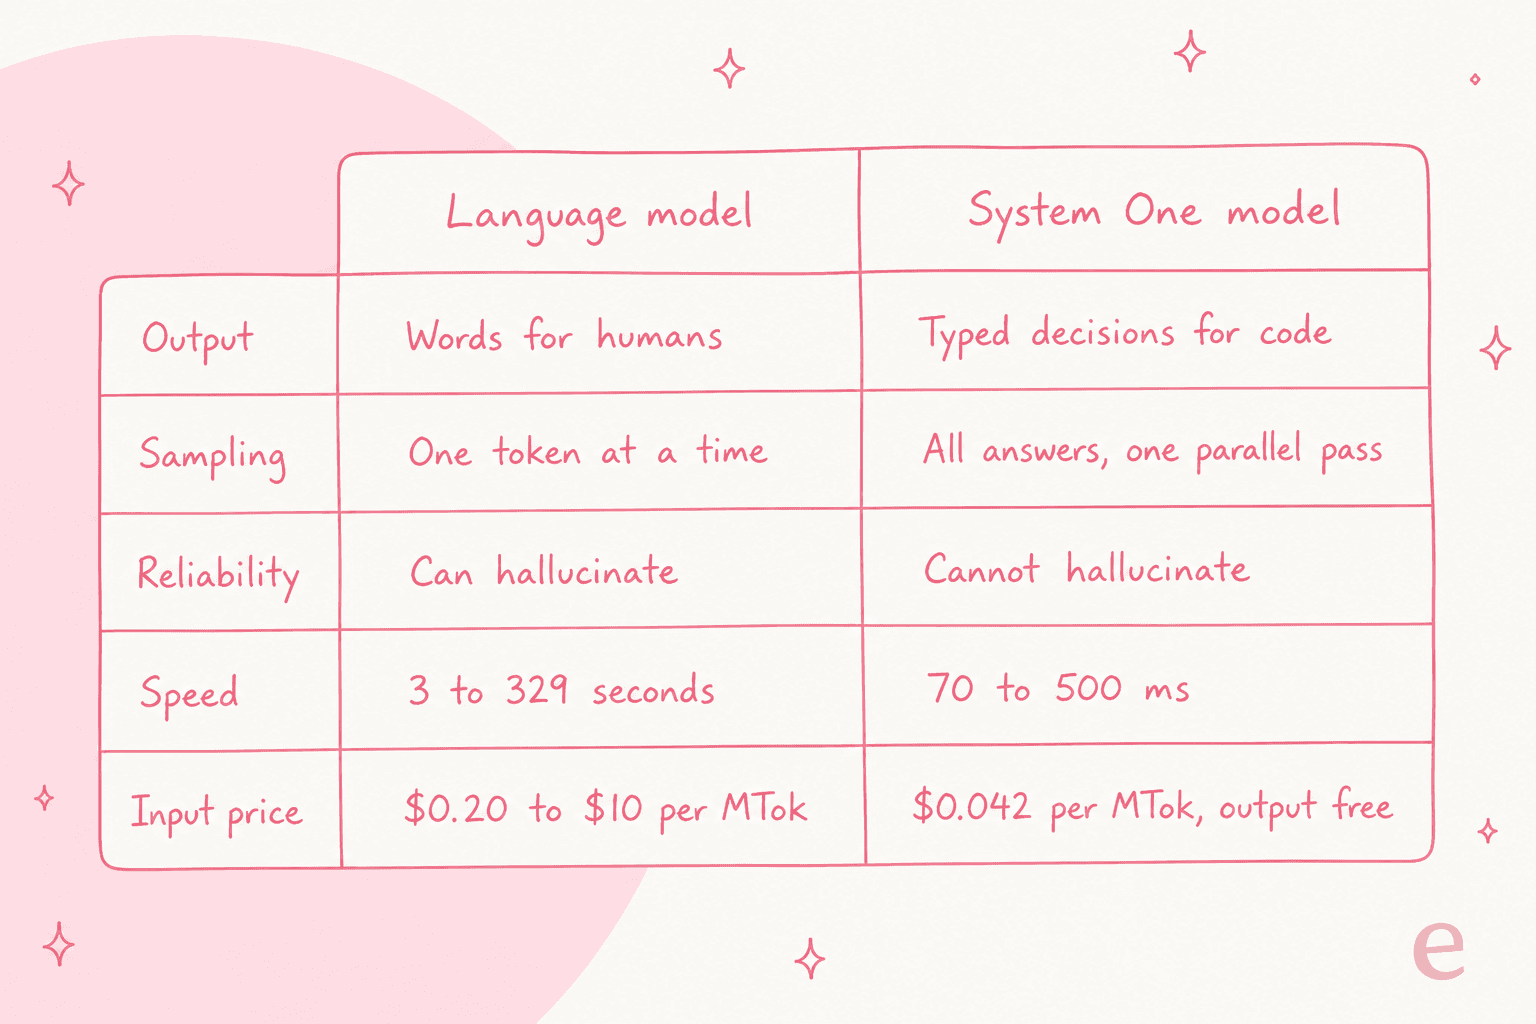
Ein Sprachmodell samplet der Reihe nach ein Token nach dem anderen, bis es einen String erzeugt hat, den ein Mensch liest. Jev generiert alle seine Ausgaben in einem einzigen parallelen Durchgang und produziert überhaupt keinen freien Text. Deshalb ist es schnell, und deshalb ist der Vergleich auch nicht ganz fair – ein Punkt, auf den ich noch zurückkomme. Der praktische Nutzen für Entwickler: Jev passt überall dort, wo Sie derzeit ein LLM dazu zwingen, einen JSON-Blob auszugeben, den Sie anschließend parsen und hoffen, dass er gültig ist. Das ist dieselbe Frage nach „welche Ebene wähle ich hier eigentlich“, die auch bei AgentKit vs. der Anthropic API auftaucht.
Die Zahlen, die TypeSafe behauptet
TypeSafe ist bei Zahlen nicht zurückhaltend, hier sind sie also mit den dazugehörigen Einschränkungen.
| Behauptung | Jev | TypeSafes angegebene Baseline |
|---|---|---|
| End-to-End-Latenz | 70 ms bis 500 ms | 3 bis 329 Sekunden bei Frontier-LLMs |
| Geschwindigkeitsfaktor | 40x bis 200x schneller | bei System-One-artigen Anfragen |
| Workflow-Schlagzeile | 193,6x schneller, 444,6x günstiger | „am oberen Ende der Real-World-Gewinne“ |
| Input-Preis | 0,042 $ / MTok, Output kostenlos | 238x niedriger als Claude Fable 5.1 |
| Kontextfenster | 32.000 Tokens | Modellversion jev-1.13.0 |
Jev läuft bereits live auf Cloudflare Workers AI als typesafe/jev, und TypeSafe öffnet den Early Access über eine Warteliste. Es gibt noch keine eigenständige Preisseite; die 0,042-$-Zahl stammt von der Homepage und dem Launch-Post. Zum Thema Nachhaltigkeit ist TypeSafe in seinem Launch-Post erfrischend offen: "We can't prove it isn't subsidized; we'll need the long-term to prove the sustainability of our pricing (which we expect to go down, not up)."
Der glaubwürdigste externe Datenpunkt kam vom CEO von Vercel, der Jev in ein echtes Produkt integriert hat:
"We're seeing extraordinary results from @typesafeai. Default mode in 𝚏𝚡 is auto, with a safety reviewer analyzing every command. That reviewer runs on GPT Luna today. Jev is up to 18x faster (p95) and more accurate."
Eine 18-fache Beschleunigung bei einem echten Sicherheits-Review-Schritt ist eine deutlich fundiertere Aussage als die 200x-Marketingzahl, und sie zeigt, wo Jev wirklich glänzt: als schneller Prüfer, der einem langsameren System vorgeschaltet ist.
Was „kann nicht halluzinieren“ wirklich bedeutet
Das ist die Behauptung, die den Launch-Thread auf Hacker News zum Kochen brachte (1.929 Punkte, 508 Kommentare), und es lohnt sich, hier genauer hinzuschauen, weil das die Sache ist, bei der die meisten Leute danebenliegen werden.
Jev kann keinen Typfehler machen und keine Option zurückgeben, die nicht in Ihrer Liste stand. In diesem mechanischen Sinn „kann es nicht halluzinieren“. Aber eine typisierte Antwort kann trotzdem selbstbewusst falsch sein, und mehrere Kommentatoren brachten das treffend auf den Punkt:
"if it puts a high confidence value on a wrong answer, thats still hallucinating, no?"

Die Verteidigung lautet, dass Jev Ihnen immer einen Konfidenzwert mitliefert, sodass Sie bei den sicheren Antworten handeln und die wackeligen an einen Menschen weiterleiten können:
"they mean they produce a confidence value for every result, so you could see for example it has 0.1 confidence, and you can disregard the result."
Der eigentliche Test ist Kalibrierung, nicht der „kann nicht halluzinieren“-Slogan. Wie ein Kommentator es formulierte: Wenn das Modell bei tausend Antworten 0,9 sagt, sollten etwa 900 davon richtig sein. RLCD soll angeblich genau darauf optimiert sein. Solange es keine unabhängigen Kalibrierungszahlen gibt, behandeln Sie „kann nicht halluzinieren“ als „liefert kein fehlerhaftes Format“, nicht als „liegt immer richtig“. Für alle, die KI bei echten Kundenfragen einsetzen, ist genau diese Unterscheidung entscheidend, und deshalb setzen wir bei der Vermeidung von KI-Halluzinationen im Support so stark auf Grounding und Tests.
Wer hinter Jev steckt
TypeSafe hat einen Stammbaum, den man nicht einfach wegwischen kann. Gründer und CEO Diogo Almeida hat RLHF und InstructGPT bei OpenAI mit erfunden, die Forschungslinie, die zu ChatGPT führte, und war zuvor bei Google Brain. Ihm zur Seite stehen COO Sasha Sheng (ex-Meta/FAIR) und CTO Erik Gafni, mit einem Team, das von OpenAI, Google Brain, Meta, Stripe, Airbnb und Docker kommt.
Das Unternehmen sagt, es sei "von erstklassigen Investoren unterstützt", hat aber auf seinen eigenen Seiten keine Finanzierungssumme veröffentlicht, weshalb ich hier keine Zahl nenne. Der Slogan "Build Prod, Not God" verrät die Haltung: Dieses Team optimiert dafür, zuverlässige Produktionsbausteine auszuliefern, statt AGI zu jagen.
Sollten Sie Jev tatsächlich einsetzen?
Hier ist meine Einschätzung, nachdem ich die Docs, die Demos und die Kritik durchgegangen bin.
Greifen Sie zu Jev, wenn die Aufgabe eine enge, klar abgegrenzte Entscheidung ist, die Ihr Code weiterverarbeitet: Routing, Moderation, Intent-Erkennung, Bewertung, Extraktions-Gates oder ein schneller Sicherheitscheck vor einem größeren Modell. Die überzeugendste Entwickler-Meinung auf Hacker News kam von jemandem, der genau das schon von Hand gemacht hatte:
"this is exactly how I am using LLMs in production, to narrowly make choices and return structured data... Jev's focus on structured I/O and confidence scores are game changing. If this does at all what it claims, I think this is going to quickly become the new standard approach for agentic systems."
Greifen Sie nicht zu Jev, wenn Sie Generierung, Erklärung oder mehrstufiges Schlussfolgern brauchen. Der meistgevotete Kommentar im gesamten Thread traf die ehrliche Einordnung:
"Seems like a more accurate title would be 'Jev: Trading general purpose generation for fast typed inference.'"
Und die lautstärksten Skeptiker, darunter Entwickler Theo Browne, argumentierten, die viralen Demos würden es in Aufgaben drängen, die eigentlich ein einfacher Klassifikator oder eine Regel übernehmen sollte. Das ist eine faire Warnung: Ein derart schnelles Tool lädt zur Überbenutzung ein. Die Leitlinie lautet: Jev ist ein Baustein. Es liefert Ihnen eine großartige Entscheidung; die Pipeline, die Eskalationslogik, die Deflection-Strategie und jede Aktion, die nach der Entscheidung folgt, gehören weiterhin Ihnen.
eesel ausprobieren
Wenn Sie Support leiten, lautet die ehrliche Übersetzung von all dem: Jev ist ein brillanter Motor, kein Auto. Es sagt Ihnen in 114 Millisekunden, dass ein Ticket dringend ist, in den Bereich Billing gehört und von einem frustrierten Kunden kommt. Es öffnet das Ticket nicht, entwirft keine in Ihrem Help Center verankerte Antwort, erstattet keine Rückerstattung und übergibt nicht an einen Menschen, wenn es sich unsicher ist. Das muss jemand anders bauen.
eesel ist genau dieser fertige Teamkollege. Es ist ein KI-Support-Teamkollege, den Sie in Ihren Helpdesk einbinden, und er trifft bereits die Triage-, Routing- und Eskalationsentscheidungen, die Jev als Bausteine bereitstellt, und handelt dann Ende-zu-Ende danach. Er schließt sich Ihrer bestehenden Kundenservice-Warteschlange an, lernt aus Ihren vergangenen Tickets und Ihrem Help Center, und Sie können ihn gegen historische Tickets simulieren, bevor er jemals einen echten Kunden berührt.

Und wenn Ihnen die Entwickler-Ergonomie von Jev gefallen hat, wird Ihnen das hier gefallen: eesel ist nicht nur ein Dashboard. Die eesel-CLI (npx @eesel/cli) bedient denselben Teamkollegen und Workspace über ein Terminal. Ein Mensch kann eesel chat, eesel activity oder eesel approvals von Hand ausführen; Skripte können es in CI automatisieren; und Coding-Agenten wie Claude Code, Codex und Cursor können es steuern, da jeder Befehl JSON ausgibt und --dry-run den genauen Aufruf zeigt, bevor er ausgeführt wird. Jeder Workspace ist außerdem ein MCP-Server. Jev liefert Ihnen die Entscheidung; eesel liefert Ihnen den Teamkollegen, der danach handelt, und lässt Ihre Agenten ihn bedienen. Sie können eesel kostenlos ausprobieren.
Häufig gestellte Fragen
Was ist TypeSafe Jev?
TypeSafe Jev ist das erste öffentlich verfügbare System-One-Modell: Statt Text zu generieren, bewertet es typisierte Fragen gegen einen Zustand und liefert typisierte Entscheidungen mit Wahrscheinlichkeiten und einem Konfidenzwert zurück. Es ist für die engen, strukturierten Urteile gebaut, die Software direkt weiterverarbeitet, wie Tier-1-Triage und Routing.
Was kostet TypeSafe Jev?
TypeSafe bepreist Jev mit 0,042 $ pro Million Input-Tokens bei kostenlosem Output, was das Unternehmen als 238-mal niedrigeren Input-Preis im Vergleich zu Claude Fable 5.1 darstellt. Es gibt noch keine veröffentlichte Tabelle mit Preis-Stufen, und der Zugang läuft über eine Early-Access-Warteliste.
Kann Jev wirklich nicht halluzinieren?
Es kann keinen Typfehler erzeugen oder eine Option erfinden, die nicht in der von Ihnen vorgegebenen Liste steht, aber eine selbstbewusst falsche typisierte Antwort bleibt möglich – ein Punkt, der auf Hacker News diskutiert wurde. Der eigentliche Test ist die Kalibrierung. Wenn Sie fundierte Antworten in einer Support-Warteschlange wollen, gilt dieselbe Disziplin, die in unserem Leitfaden zur Vermeidung von KI-Halluzinationen beschrieben ist.
Ist Jev ein Ersatz für ein LLM?
Nein. Jev trifft schnelle typisierte Entscheidungen, es schreibt keinen Text, denkt nicht Schritt für Schritt und führt keine Unterhaltung. Viele Teams kombinieren es mit einem LLM und nutzen Jev für den Klassifizierungs- und Routing-Schritt, ähnlich wie eine Aufteilung zwischen regelbasiertem System und KI-Agent in der Praxis funktioniert.
Wie unterscheidet sich Jev von einem normalen KI-Kundenservice-Agenten?
Jev ist Infrastruktur: ein Entscheidungsbaustein, den Sie in Ihren eigenen Code einbinden. Ein Produkt für KI-Kundenservice wie eesel ist der fertige Teamkollege, der diese Entscheidungen trifft und die Aktion direkt in Ihrem Helpdesk ausführt. Sie können ihn sogar über ein Terminal mit der eesel-CLI steuern.


Article by
Alicia Kirana Utomo
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.