Was Grok 4.7 wirklich ist
Grok 4.7 ist xAIs Spitzenmodell für Coding, agentenbasierte Aufgaben und Wissensarbeit. Auf der API wird es als grok-4.7 bereitgestellt, mit einem 500k-Kontextfenster, Text- und Bild-Input sowie reinem Text-Output ohne Ausgabelimit, laut den xAI-Release-Notes. Der Reasoning-Aufwand lässt sich zwischen niedrig, mittel, hoch (Standard) und xhigh einstellen, sodass Sie pro Anfrage festlegen können, wie stark das Modell nachdenkt.
Unter der Haube nutzt Grok 4.7 laut xAI ein neues, größeres Basismodell als Grok 4.6. Ich möchte hier präzise sein, denn ein Großteil der Berichterstattung hat eine exakte Parameteranzahl genannt: xAIs eigenes Material beschreibt es als größeres Basismodell, ohne eine Zahl zu veröffentlichen, sodass die kursierende konkrete Zahl nichts ist, was das Unternehmen tatsächlich angegeben hat. Was xAI wirklich behauptet, ist die Form der Veränderung, und diese Form ist der interessante Teil.
Das Training war auf schwierige Probleme ausgerichtet, die viele Stunden zur Fertigstellung benötigen, und wurde dann über einen längeren Lauf verstärkt. xAI trainierte das Modell außerdem darauf, sein Grok-Bot-Harness nativ zu verstehen, also das Gerüst, das dem Modell erlaubt, zu chatten, Tools aufzurufen und sich durch eine Aufgabe zu arbeiten. Vereinfacht gesagt haben sie weniger darauf optimiert, eine einzelne Frage gut zu beantworten, und mehr darauf, sich durch einen langen, mehrstufigen Job zu arbeiten, ohne den Faden zu verlieren.
Was sich gegenüber Grok 4.6 geändert hat
Der klare Weg, den Sprung zu erkennen, besteht darin, die beiden Modelle bei den von xAI veröffentlichten Benchmarks nebeneinanderzustellen. Die Fortschritte sind nicht einheitlich, und wo sie sich häufen, verrät, worum es bei diesem Release wirklich geht.
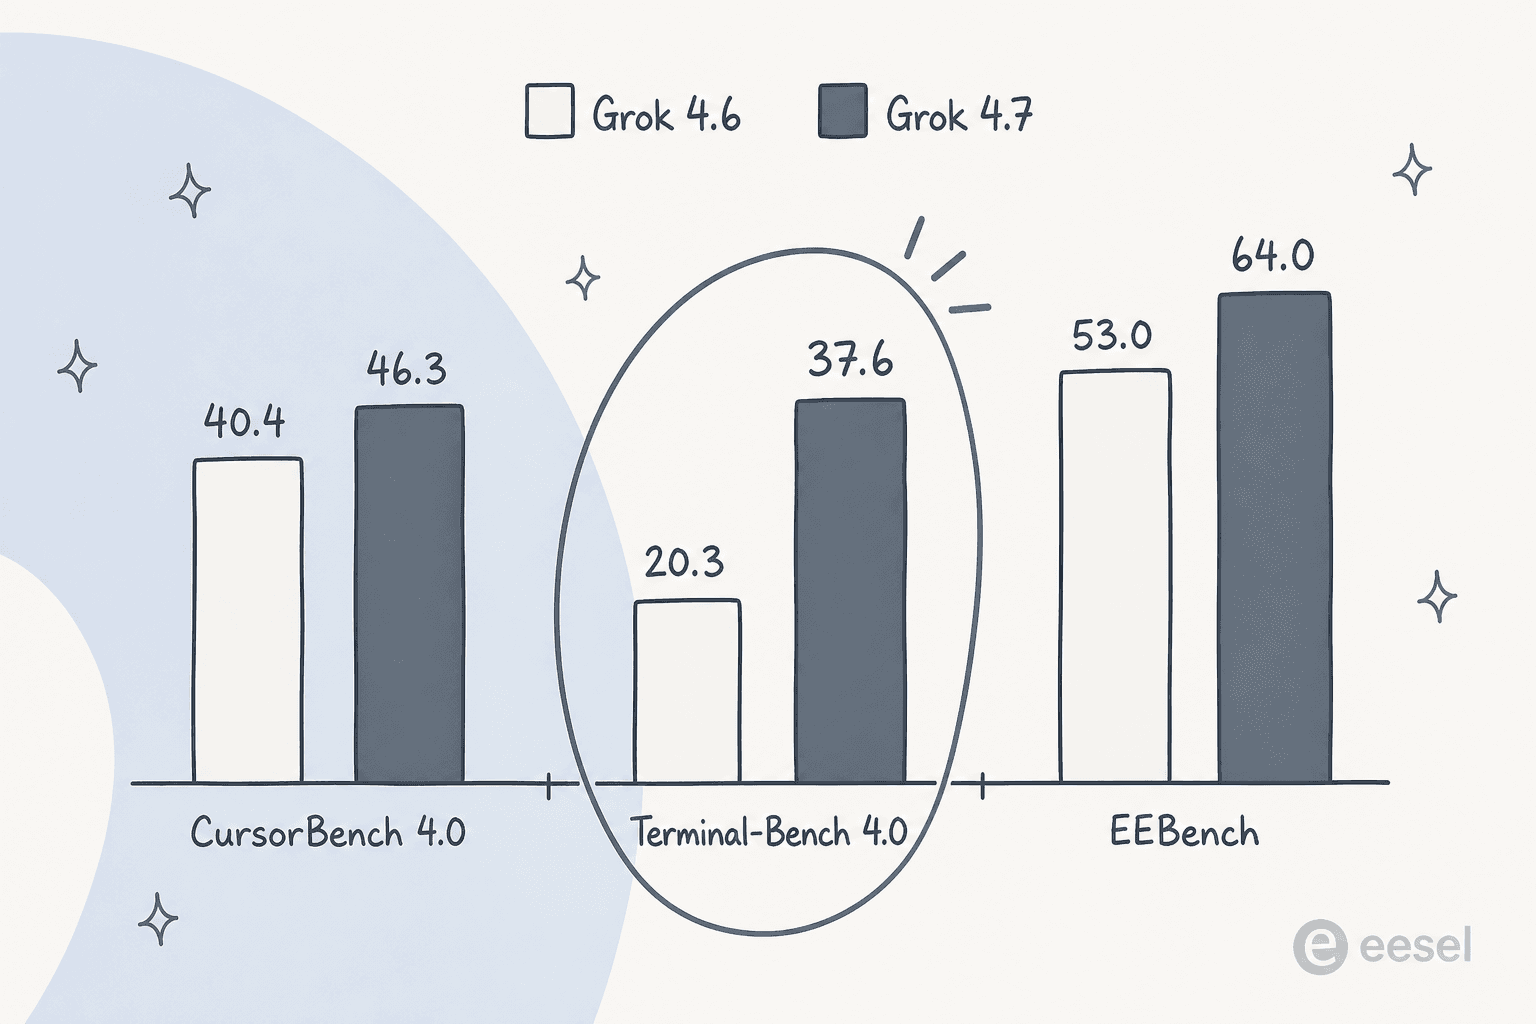
Der größte einzelne Sprung zeigt sich bei Terminal-Bench 4.0, das mehrstündige Arbeit an einem echten Terminal misst: Grok 4.6 erzielte 20,3 %, und Grok 4.7 verdoppelt diesen Wert nahezu auf 37,6 %. Das ist genau die Art von langfristiger Aufgabe, für die der längere RL-Lauf gebaut wurde, und hier zahlt sich das Release aus. Coding und Engineering folgen derselben Geschichte: CursorBench 4.0 steigt von 40,4 % auf 46,3 %, und EEBench (Elektrotechnik) springt von 53,0 % auf 64,0 %.
Hier die ausführlichere Tabelle, mit GPT-5.6 Sol und Fable 5.1 daneben, damit die Zahlen einen Kontext haben. Alle Grok-4.7-Werte sind bei xHigh-Aufwand, Grok 4.6 bei High.
| Benchmark | Grok 4.7 | Grok 4.6 | GPT-5.6 Sol | Fable 5.1 |
|---|---|---|---|---|
| Input-Preis / 1M | $2 | $2 | $4 | $10 |
| Output-Preis / 1M | $6 | $6 | $20 | $50 |
| CursorBench 4.0 (Coding) | 46,3 % | 40,4 % | 41,7 % | 51,8 % |
| DeepSWE v1.1 | 71,0 %* | 65,2 % | 72,7 % | 70,0 % |
| Terminal-Bench 4.0 | 37,6 % | 20,3 % | 37,3 % | 57,9 % |
| EEBench (Elektrotechnik) | 64,0 % | 53,0 % | 39,4 % | 56,4 % |
| AA Briefcase v1.1 (Elo) | 1.657 | 1.546 | 1.487 | 1.678 |
| Harvey Legal Agent | 19,6 % | 15,8 % | 2,5 % | 6,7 % |
| HealthBench Professional | 56,7 % | 48,5 % | 60,5 % | 62,1 % |
*Grok 4.7s DeepSWE-Wert wird bei hohem Aufwand gemessen. Zahlen aus xAIs Grok-4.7-Ankündigung.
Zwei ehrliche Vorbehalte, bevor das jemand als klaren Durchmarsch liest. Fable 5.1 führt weiterhin bei CursorBench, Terminal-Bench und klinischem Reasoning, wenn Sie also nur den Spitzenwert im Blick haben und Kosten keine Rolle spielen, liegt es vorn. Und bei HealthBench Professional schlagen sowohl GPT-5.6 Sol (60,5 %) als auch Fable 5.1 (62,1 %) Grok 4.7s 56,7 %. Grok 4.7s Geschichte lautet nicht "das Beste in allem". Sie lautet "sehr nah am Besten, zu einem Bruchteil des Preises".
Grok-4.7-Preise und die Fast-Steuer
Bei den Preisen wird dieses Modell interessant, daher lohnt es sich, das genau auszubuchstabieren, statt nur mit einer "ab"-Zahl zu winken.
| Stufe | Input / 1M | Gecachter Input / 1M | Output / 1M |
|---|---|---|---|
grok-4.7, Prompt unter 200.000 Token | $2,00 | $0,50 | $6,00 |
grok-4.7, Prompt ab 200.000 Token | $4,00 | $1,00 | $12,00 |
| Grok 4.7 Fast (nur Cursor und Grok Build) | 2x die obigen Raten | 2x | 2x |
Die erste Falle ist die Long-Context-Stufe. Sobald eine Anfrage 200.000 Prompt-Token überschreitet, gelten die höheren Raten für jedes Token der gesamten Anfrage, nicht nur für den Überschuss über 200.000 hinaus. Ein Prompt mit 210.000 Token wird also vollständig zu $4 / $12 abgerechnet, nicht größtenteils zu $2 / $6. Für lange Agenten-Schleifen, die langsam Kontext anhäufen, ist diese Klippe real, und deshalb hat xAI eine Context-Compaction-API veröffentlicht, um Unterhaltungen zu verkleinern, bevor sie kippen.
Der zweite Punkt ist die Fast-Variante. Grok 4.7 Fast ist dasselbe Modell, bereitgestellt mit doppelter Ausgabegeschwindigkeit für den doppelten Token-Preis, und nur innerhalb von Cursor und Grok Build verfügbar, nicht über die öffentliche API. Es ist ein Latenz-gegen-Geld-Tausch, nützlich, wenn Sie zusehen, wie Code zurückgestreamt wird, und jede Sekunde zählt, und verzichtbar bei Batch- oder Hintergrundarbeit, bei der Geschwindigkeit keine Rolle spielt.
Dann gibt es die Zähler, die die meisten Artikel übersehen. Auf der API listet xAIs Preisseite Tool-Aufrufe separat auf: Websuche, X-Suche und Codeausführung kosten 5 $ pro 1.000 Aufrufe, die Suche in Dateianhängen 10 $ pro 1.000, und die RAG-artige Collections-Suche 2,50 $ pro 1.000. Priority Processing verdoppelt alle Token-Raten. Keiner dieser Posten sprengt die Bank, aber wenn Sie die Kosten eines Agenten modellieren, der ständig sucht und ausführt, ist der Token-Preis nicht die ganze Rechnung.
Das Fazit: Grok 4.7 ist so bepreist, dass es sich für den Einsatz mit hohem Volumen lohnt. Das ist eine bewusste Positionierung, und es ist der klarste Grund, es einem teureren Spitzenmodell für alles vorzuziehen, was in einer Schleife läuft.
Wo Grok 4.7 im Vergleich zu GPT-5.6 Sol und Fable 5.1 steht
Wenn Sie Leistungsfähigkeit gegen Kosten auftragen, landet Grok 4.7 in einer Ecke, die zunehmend voll wird, aber weiterhin wertvoll ist: starke Werte, niedriger Preis.
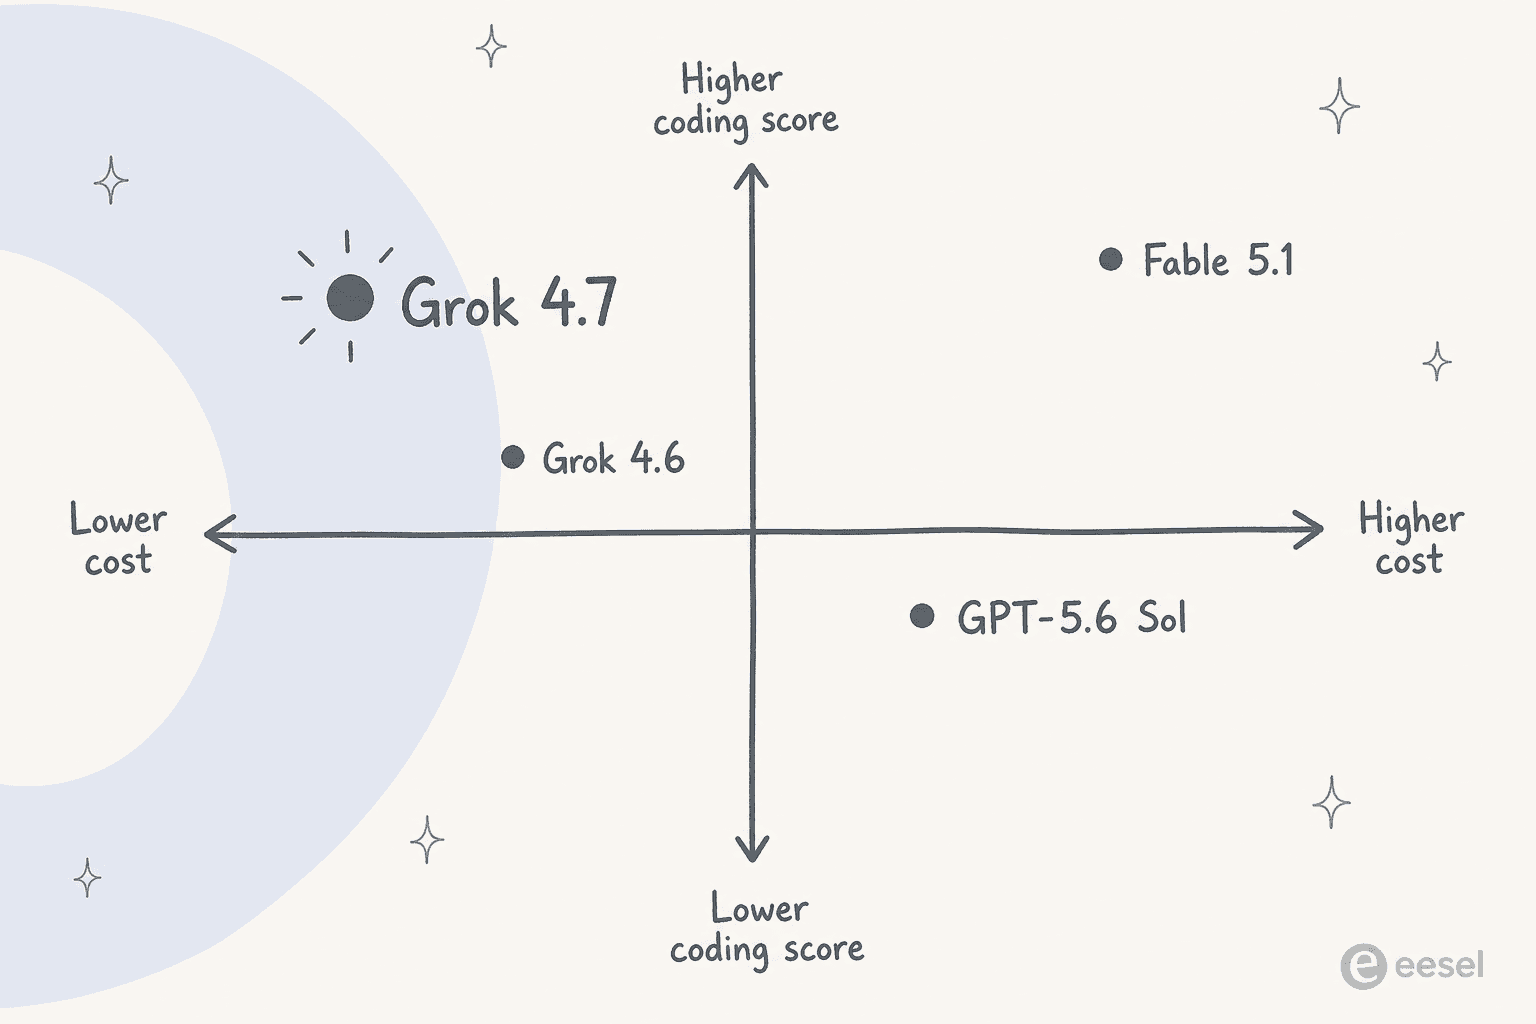
Gegenüber GPT-5.6 Sol ist Grok 4.7 bei den meisten agentenbasierten und technischen Aufgaben das bessere Geschäft: Es schlägt Sol bei CursorBench, EEBench, Terminal-Bench, Harveys Legal-Benchmark und AA Briefcase, zum halben Input-Preis und weniger als einem Drittel des Output-Preises. Sol behält einen echten Vorsprung bei klinischem Reasoning und einen knappen bei DeepSWE, es ist also kein klarer Sieg, aber der Preisunterschied macht Grok 4.7 zur Standardwahl für kostensensible Agenten-Arbeit.
Gegenüber Fable 5.1 lautet die ehrliche Einschätzung, dass Fable weiterhin das stärkere Modell bei reinem Coding und langfristiger Terminal-Arbeit ist, und sein GDPval-Elo für professionelles Wissen von 1.735 liegt vor Grok 4.7s 1.695. Aber Fable verlangt 10 $ / 50 $ pro Million Token, fünf- bis achtmal Groks Raten. Die Frage ist also nicht "welches ist klüger" (oft Fable), sondern "wie viel sind Sie bereit, pro zusätzlichem Punkt zu zahlen". Für viele Produktions-Workloads ist Grok 4.7 die Antwort, die die Rechnung im Rahmen hält.
Sicherheit und Cybersicherheit
xAI hat in diesem Zyklus echtes Gewicht auf Sicherheit gelegt, und das ist einer der konkreteren Teile des Releases. Grok 4.7 wurde mit einem komplett neuen Sicherheits-Stack gebaut, und xAI nennt es das stärkste Modell, das es je auf Ablehnungen und Jailbreak-Resistenz getestet hat.
Die Details machen diese Behauptung überprüfbar. Bei HackerBench v0.3, xAIs Benchmark für riskante Cyber-Aufgaben, lässt Grok 4.7 nur 3,3 % der riskanten Dual-Use-Prompts durch, während es laut xAI selten legitime Sicherheitsarbeit blockiert. Es führt außerdem LatchBios Biosicherheits-Benchmark mit 62,4 % an. Der Anspruch ist ein Modell, das für echte Sicherheits- und Forschungsarbeit nützlich bleibt, ohne ein leichtes Werkzeug für die gefährliche Version derselben Aufgabe zu sein, und xAI hat begonnen, ausgewählten Cybersicherheits-Partnern exklusiven Zugang zu den Red-Team-Fähigkeiten des Modells für Verteidigungsforschung zu gewähren. Die Benchmarks stammen vom Anbieter selbst, betrachten Sie sie also als Ausgangspunkt, aber die Richtung ist klar.
Für wen sich Grok 4.7 wirklich eignet
Nachdem ich mich mit den Zahlen beschäftigt habe, hier mein Fazit. Grok 4.7 ist eine starke Wahl, wenn Sie Code schreiben, Agenten bauen oder etwas auf der API ausliefern, bei dem sich Token-Kosten summieren. Die Kombination aus Spitzen-naher Leistung und Grok-4.6-Preisen ist der ganze Grund, sich dafür zu interessieren, und die Fortschritte bei langfristigen Aufgaben bedeuten, dass es sich bei Jobs, die eine Weile laufen, besser hält als 4.6.
Echte Nutzer bestätigen den "ständig laufen lassen"-Ansatz. Ein intensiver Grok-Abonnent beschrieb, wie er es in alltägliche Aufgaben einband und dabei nie ans Limit stieß:
"Ich lasse einen Grok-Bot alle 15 Minuten meine E-Mails überwachen und Dinge für mich ablegen. Ich habe einen weiteren Bot, der nach Blutbild-Ergebnissen sucht... und ich komme nie auch nur annähernd an mein Kontingent."

Wo ich die Erwartungen dämpfen würde, ist bei tiefem, kniffligem Code. Spitzenmodelle werden alle besser darin, ein Skript in einem Rutsch zu schreiben, und das ist real, aber es ist nicht dasselbe wie eine große Codebasis zu tragen. Wie es ein Entwickler im selben Thread formulierte:
"Die Modelle werden immer besser darin, alles auf einen Schlag hinzubekommen. Das ist in vielen Situationen nützlich, etwa für kleine einmalige Skripte... Für die eigentliche Code-Arbeit hilft es mir aber nicht viel."
Das ist eine faire Einschätzung für jedes Modell dieser Klasse, Grok 4.7 eingeschlossen. Nutzen Sie es für die Masse an mittelschwerer Arbeit, bei der sich der Preis auszahlt, und greifen Sie zum teuersten Modell nur für die Aufgaben, die wirklich die letzten paar Punkte brauchen.
Ein Spitzenmodell ist der Motor, nicht die Fachkraft
Hier ist die Neurahmung, die ich im TL;DR versprochen habe, denn es ist das, was die meisten "welches Modell sollte ich nutzen"-Artikel auslassen.
Grok 4.7 ist Infrastruktur. Es ist ein brillanter Motor, den Sie pro Token mieten, und er kommt an, ohne irgendetwas über Ihr Unternehmen, Ihre Tickets, Ihren Ton oder Ihre Tools zu wissen. Um daraus etwas zu machen, das eine echte Aufgabe erledigt, muss jemand das Harness bauen: das Wissen anbinden, die Integrationen verdrahten, die Leitplanken schreiben, die Eskalation handhaben und alles am Laufen halten. Das ist ein echtes Projekt, kein Konfigurations-Schalter.
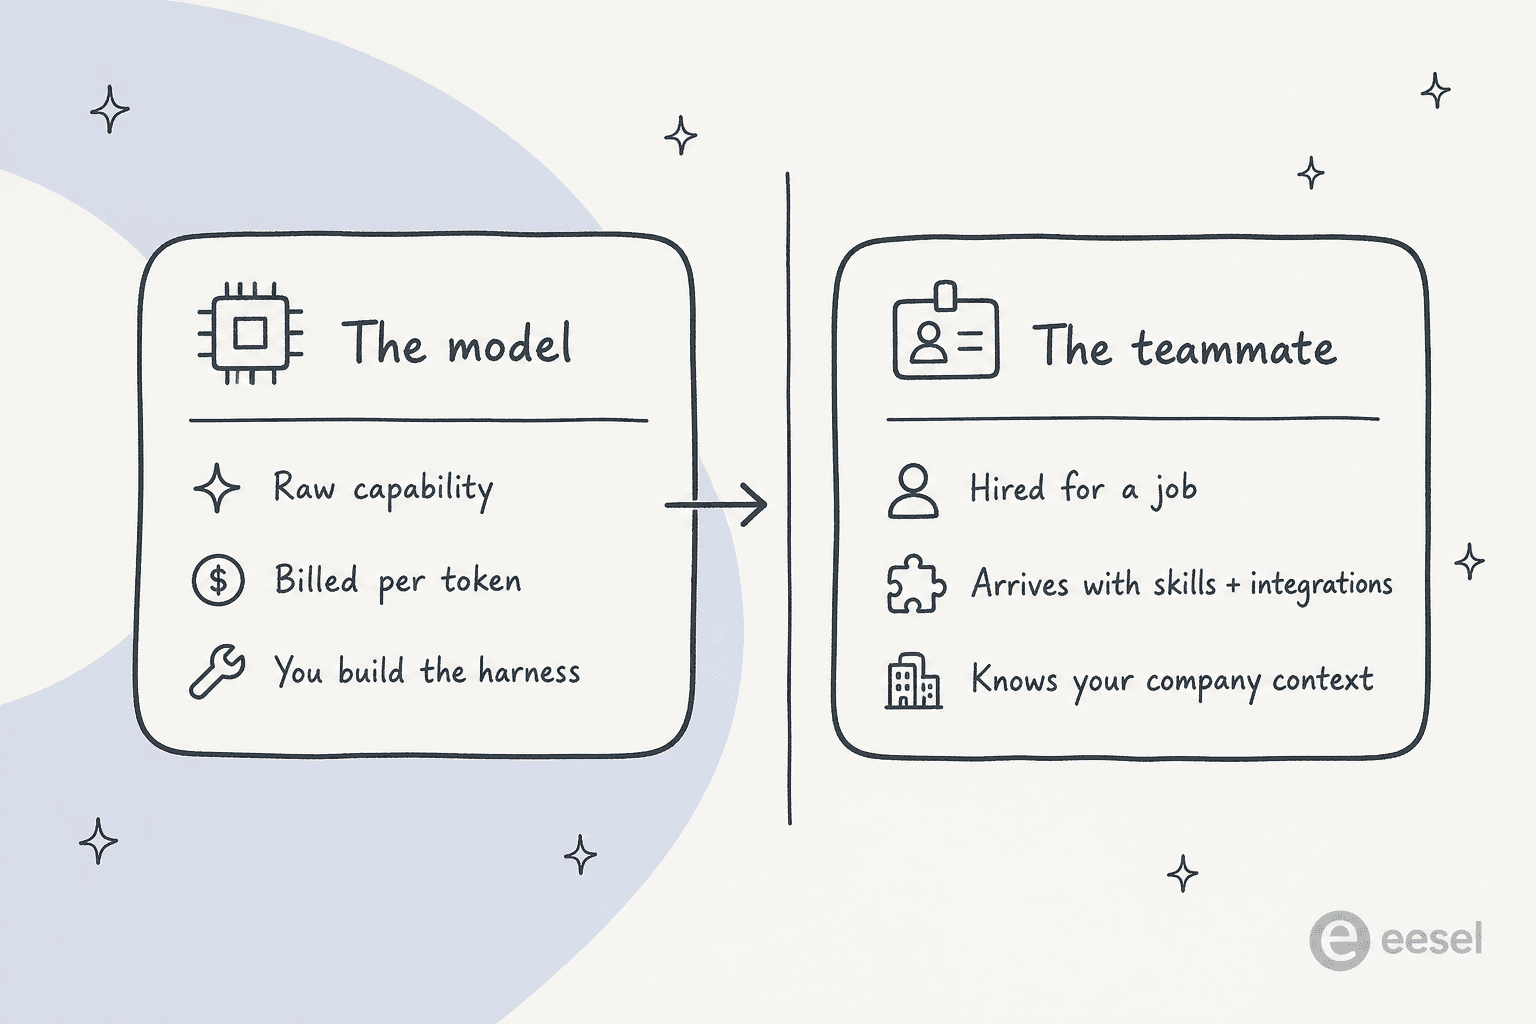
Diese Lücke ist die ganze Idee hinter eesel. Statt Ihnen ein Modell und ein leeres Harness zu geben, ist eesel eine AI-Teammitglied-Plattform, auf der Sie einsatzbereite Teammitglieder für eine bestimmte Aufgabe einstellen. Das aktuelle Line-up ist ein AI-Helpdesk-Teammitglied, das sich Ihrer Support-Warteschlange anschließt, und ein AI-Blog-Autor, der recherchiert und Langform-Artikel entwirft. Jedes kommt bereits mit den Fähigkeiten, Integrationen und dem Unternehmenskontext, die seine Rolle braucht, und läuft dabei im Hintergrund auf Spitzenmodellen, sodass Sie die Leistungsfähigkeit bekommen, ohne die Infrastruktur selbst zu betreiben.
Und wenn Ihnen Grok 4.7 gefallen hat, weil Sie im Terminal leben, trifft eesel Sie auch dort. Die eesel-CLI bedient dasselbe Teammitglied und denselben Workspace wie das Dashboard, aber von der Kommandozeile aus: Eine Person kann sie ausführen, Skripte können sie automatisieren, und Coding-Agenten wie Claude Code, Codex und Cursor können sie steuern. Sie können die Anweisungen eines Teammitglieds prüfen, eine Testnachricht senden, das JSON-Ergebnis und die Aktivität zurücklesen und eine begrenzte Änderung vorschlagen, die ein Owner genehmigt, alles ohne Ihre Shell zu verlassen. Es ist dasselbe "den Agenten programmatisch steuern"-Muster, das eine rohe Modell-API attraktiv macht, gerichtet auf ein Teammitglied, das den Job bereits kennt. Sie können eesel testen kostenlos.
Häufig gestellte Fragen
Was ist Grok 4.7?
Grok 4.7 ist xAIs Spitzenmodell für Coding, agentenbasierte Aufgaben und Wissensarbeit, veröffentlicht am 21. September 2026. Es läuft auf einem neuen, größeren Basismodell als Grok 4.6, behält das 500k-Kontextfenster bei und wird über die xAI-API als grok-4.7 bereitgestellt. Es ist dieselbe Art von rohem Modell-Engine, auf der ein Produkt wie ein AI-Teammitglied aufbaut.
Wie viel kostet Grok 4.7?
Grok 4.7 kostet 2 $ pro Million Input-Token, 0,50 $ für gecachten Input und 6 $ Output unterhalb von 200.000 Prompt-Token, was sich auf 4 $ / 1 $ / 12 $ verdoppelt, sobald eine Anfrage die 200.000-Token-Grenze überschreitet, laut der xAI-Preisseite. Das entspricht genau Grok 4.6, sodass das Upgrade mehr Leistung bietet, ohne den Preis zu erhöhen.
Was ist der Unterschied zwischen Grok 4.7 und Grok 4.6?
Grok 4.7 nutzt ein größeres Basismodell und einen längeren Reinforcement-Learning-Lauf, der auf mehrstündige Aufgaben ausgerichtet ist, und erzielt die größten Fortschritte bei lang laufenden agentenbasierten Benchmarks wie Terminal-Bench 4.0. Beide teilen sich das 500k-Kontextfenster und dieselben Token-Preise.
Ist Grok 4.7 gut für Coding?
Ja, Coding ist seine herausragende Stärke. Es erzielt 46,3 % auf CursorBench 4.0 und liegt bei jedem von xAI veröffentlichten Software-Benchmark vor Grok 4.6, und es wird innerhalb von Cursor und Grok Build bereitgestellt. Für tiefergehende Code-Arbeit kombinieren Teams es oft weiterhin mit einem teureren Modell für die schwierigsten Aufgaben.
Wie greife ich auf Grok 4.7 zu?
Sie können Grok 4.7 über die xAI-API als grok-4.7 aufrufen, es kostenlos in Grok Build nutzen oder innerhalb von Cursor erreichen. Wenn Sie diese Intelligenz lieber eine definierte Aufgabe erledigen lassen möchten, statt rohe Token zu verbrauchen, bündelt eine AI-Teammitglied-Plattform wie eesel ein Spitzenmodell mit den Fähigkeiten, Integrationen und dem Unternehmenskontext für eine echte Rolle.
Ist Grok 4.7 besser als GPT-5.6 Sol oder Fable 5.1?
Das hängt davon ab, was Ihnen wichtiger ist. Grok 4.7 schlägt GPT-5.6 Sol bei den meisten Coding- und agentenbasierten Benchmarks zu einem Bruchteil des Preises, während Fable 5.1 bei Spitzen-Coding und Terminal-Arbeit weiterhin führend ist, aber fünf- bis achtmal so viel pro Token kostet. Für kostensensible Arbeit mit hohem Volumen ist Grok 4.7 in der Regel die bessere Wahl.
Was ist Grok 4.7 Fast?
Grok 4.7 Fast ist dasselbe Modell, das mit doppelter Ausgabegeschwindigkeit für den doppelten Token-Preis bereitgestellt wird, nur innerhalb von Cursor und Grok Build verfügbar, nicht über die öffentliche API. Es lohnt sich, wenn niedrige Latenz wichtig ist, etwa beim Zusehen, wie Code zurückgestreamt wird, und ist bei Batch- oder Hintergrundaufgaben verzichtbar.


Article by
Alicia Kirana Utomo
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.