Warum Leute nach einer Grok 4.7 Alternative suchen
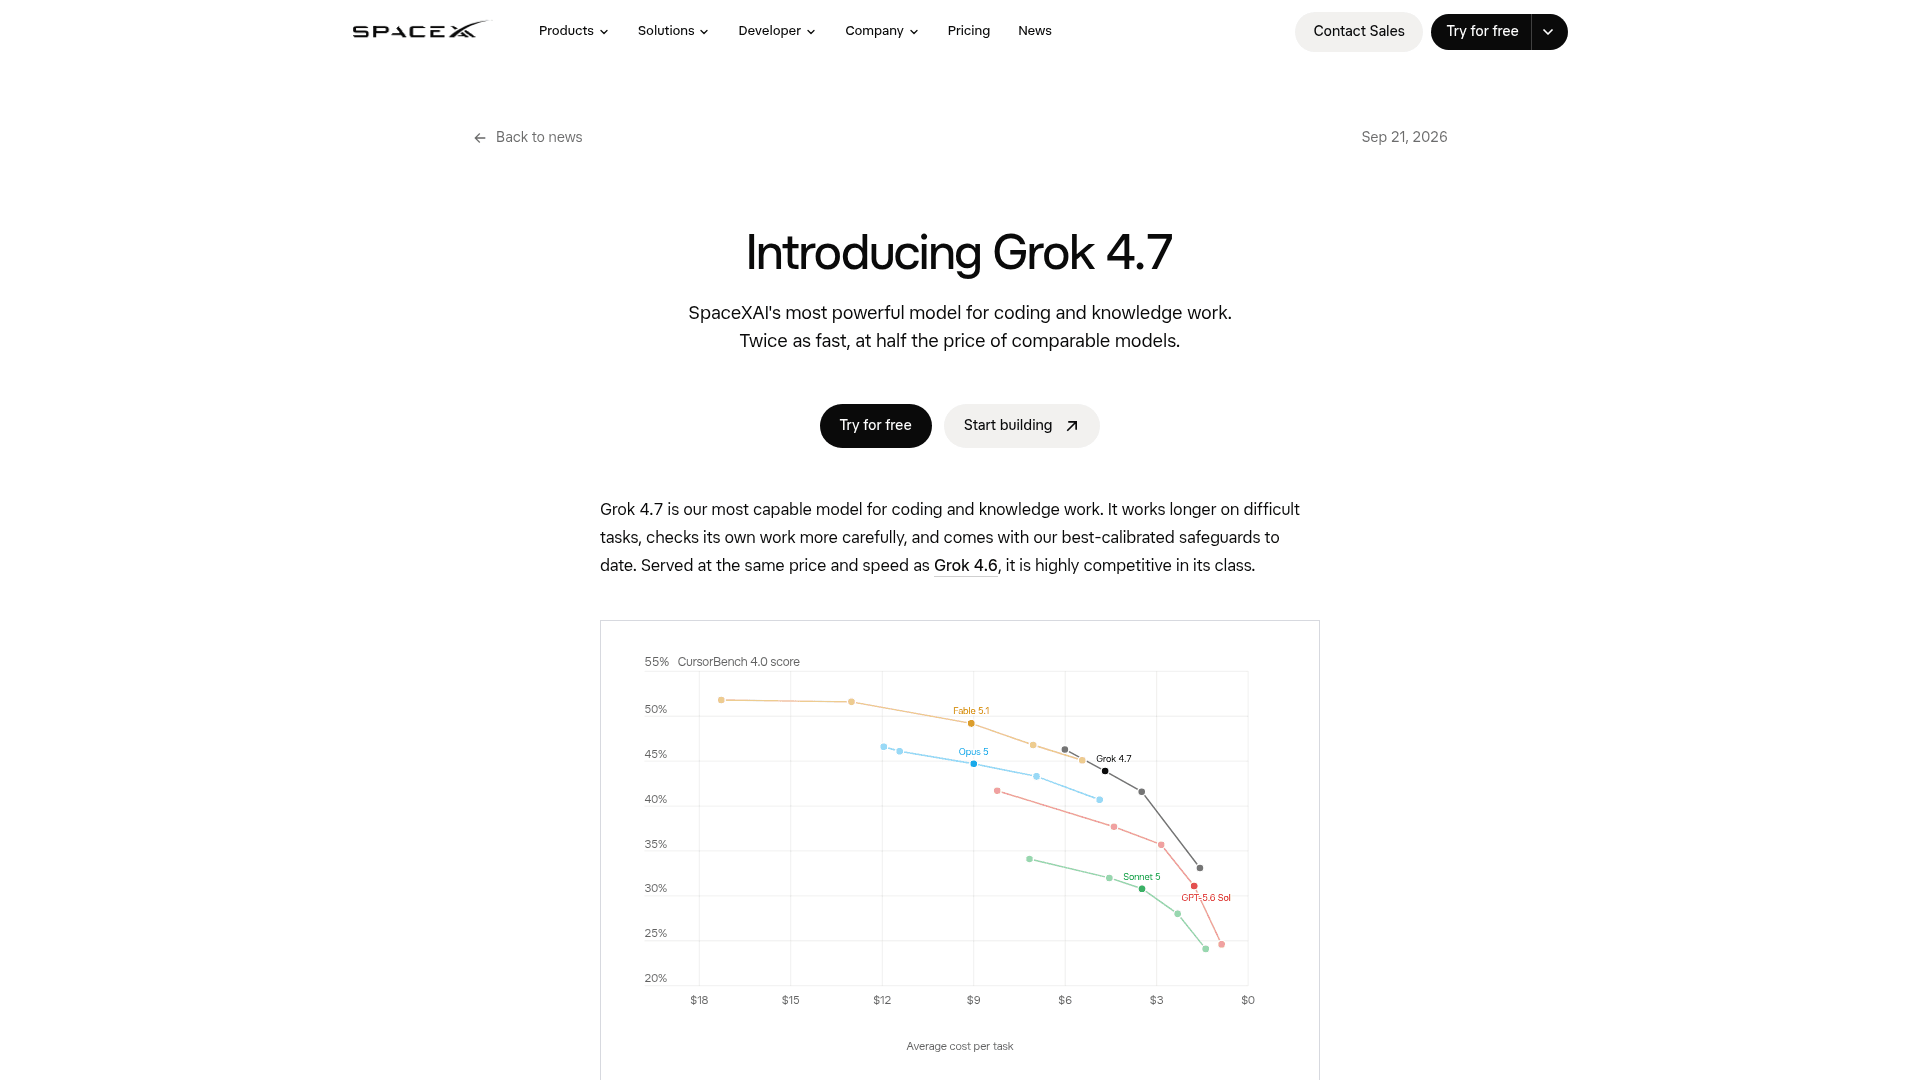
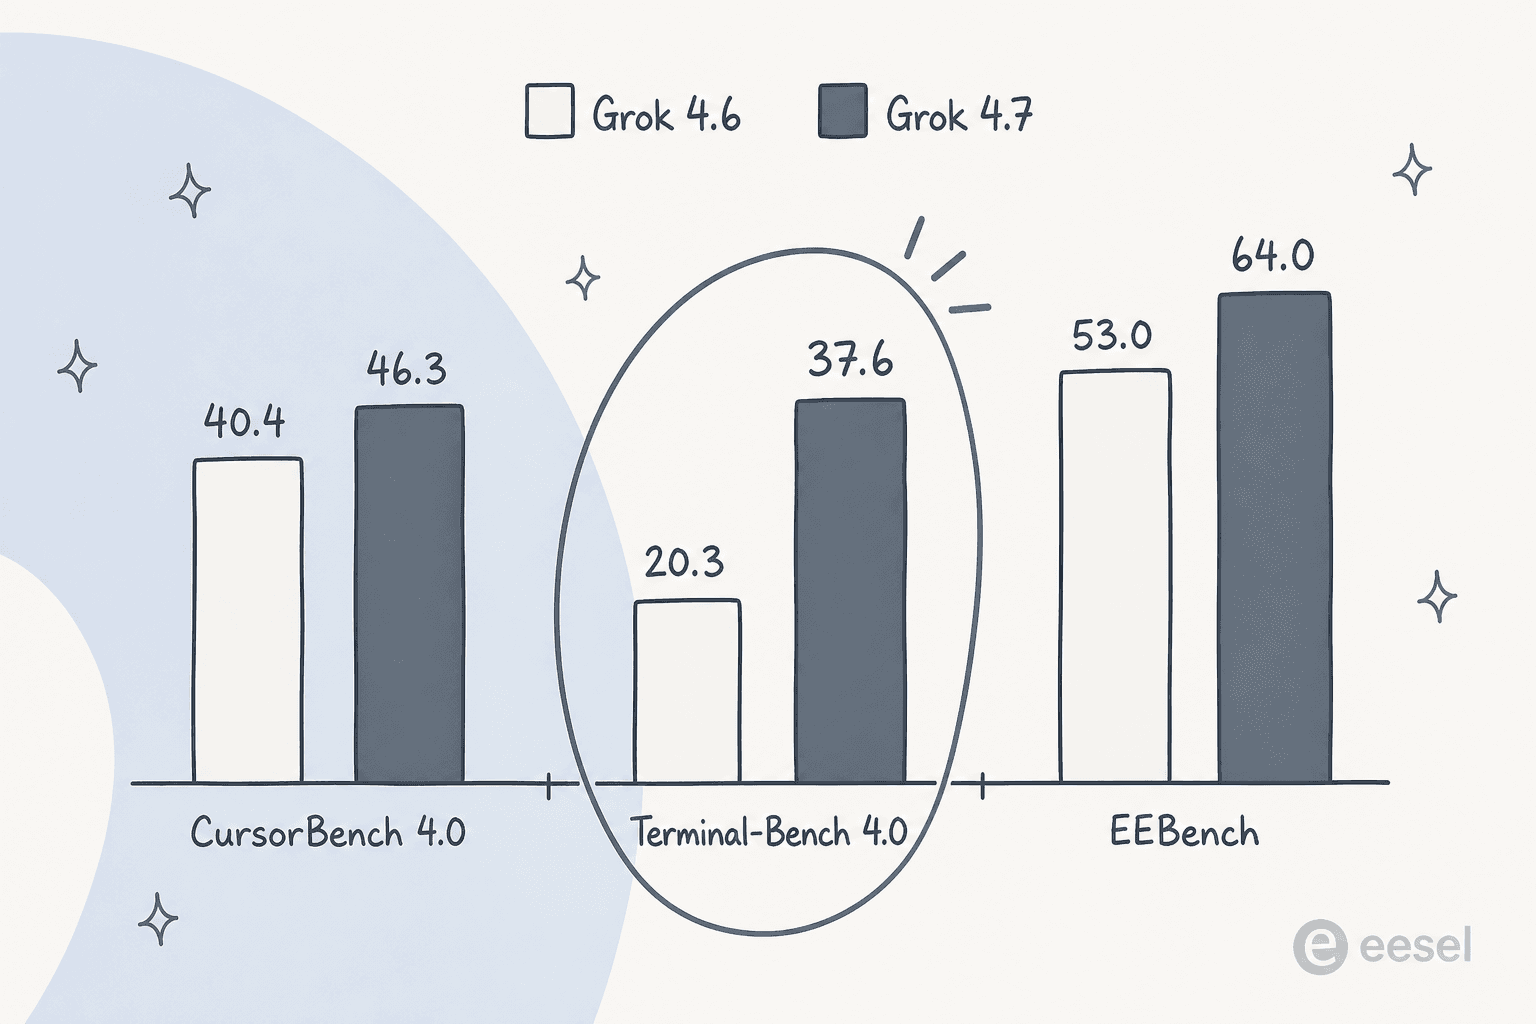
Grok 4.7 ist eine starke Standardwahl, daher sind die Gründe, anderswo zu suchen, meist spezifisch. Der häufigste Grund, den ich höre, ist die 200k-Token-Preisklippe: Sobald eine Anfrage 200k Prompt-Tokens überschreitet, berechnet Grok 4.7 jeden Token dieser Anfrage mit 4 $ / 12 $ statt 2 $ / 6 $, laut der Seite xAI Preise. Wenn Ihre Arbeitslast aus langen Dokumenten oder großen Codebasen besteht, verändert diese Verdopplung die Rechnung, und manche Alternativen berechnen sie überhaupt nicht.
Die anderen Gründe sind Richtlinien und Fähigkeiten. Grok ist geschlossen, wenn Sie also offene Gewichte brauchen, fällt es raus. Es nimmt Text und Bild als Eingabe und gibt Text aus, wenn Sie also natives Audio- oder Videoverständnis brauchen, schauen Sie sich Gemini an. Und ein paar Teams wollen einfach die absolute Spitze der Intelligenz-Charts, wo Claude immer noch lebt. Grok 4.6 Nutzer können auch den Grok 4.6 Test für den Kontext der vorherigen Generation lesen.
Wie ich diese verglichen habe
Ich habe mich an Primärquellen gehalten: die eigenen Modell- und Preisseiten jedes Anbieters, plus die von den Herstellern veröffentlichten Benchmark-Tabellen. Die Preise sind die aktuellen Zahlen auf den Doku-Seiten, Stand September 2026. Falls eine Aktion ausläuft (Geminis läuft am 1. Januar 2027 aus), habe ich das gekennzeichnet. Wo ich Intelligenz-Ranglisten zitiere, stammen sie aus den eigenen Diagrammen der Hersteller und aus dem unabhängigen Artificial Analysis Index, nicht aus einer Drittanbieter-Liste, die eine andere Liste umschreibt.
Zwei Dinge habe ich stark gewichtet, weil Käufer sie übersehen: die 200k-Preisklippe, und ob die „günstige" Zahl die Zahl ist, die Sie tatsächlich zahlen. Ein Modell, das pro Token günstig, aber pro Aufgabe redselig ist, ist nicht günstig. Ich habe das dort vermerkt, wo es zutrifft.
Die besten Grok 4.7 Alternativen auf einen Blick
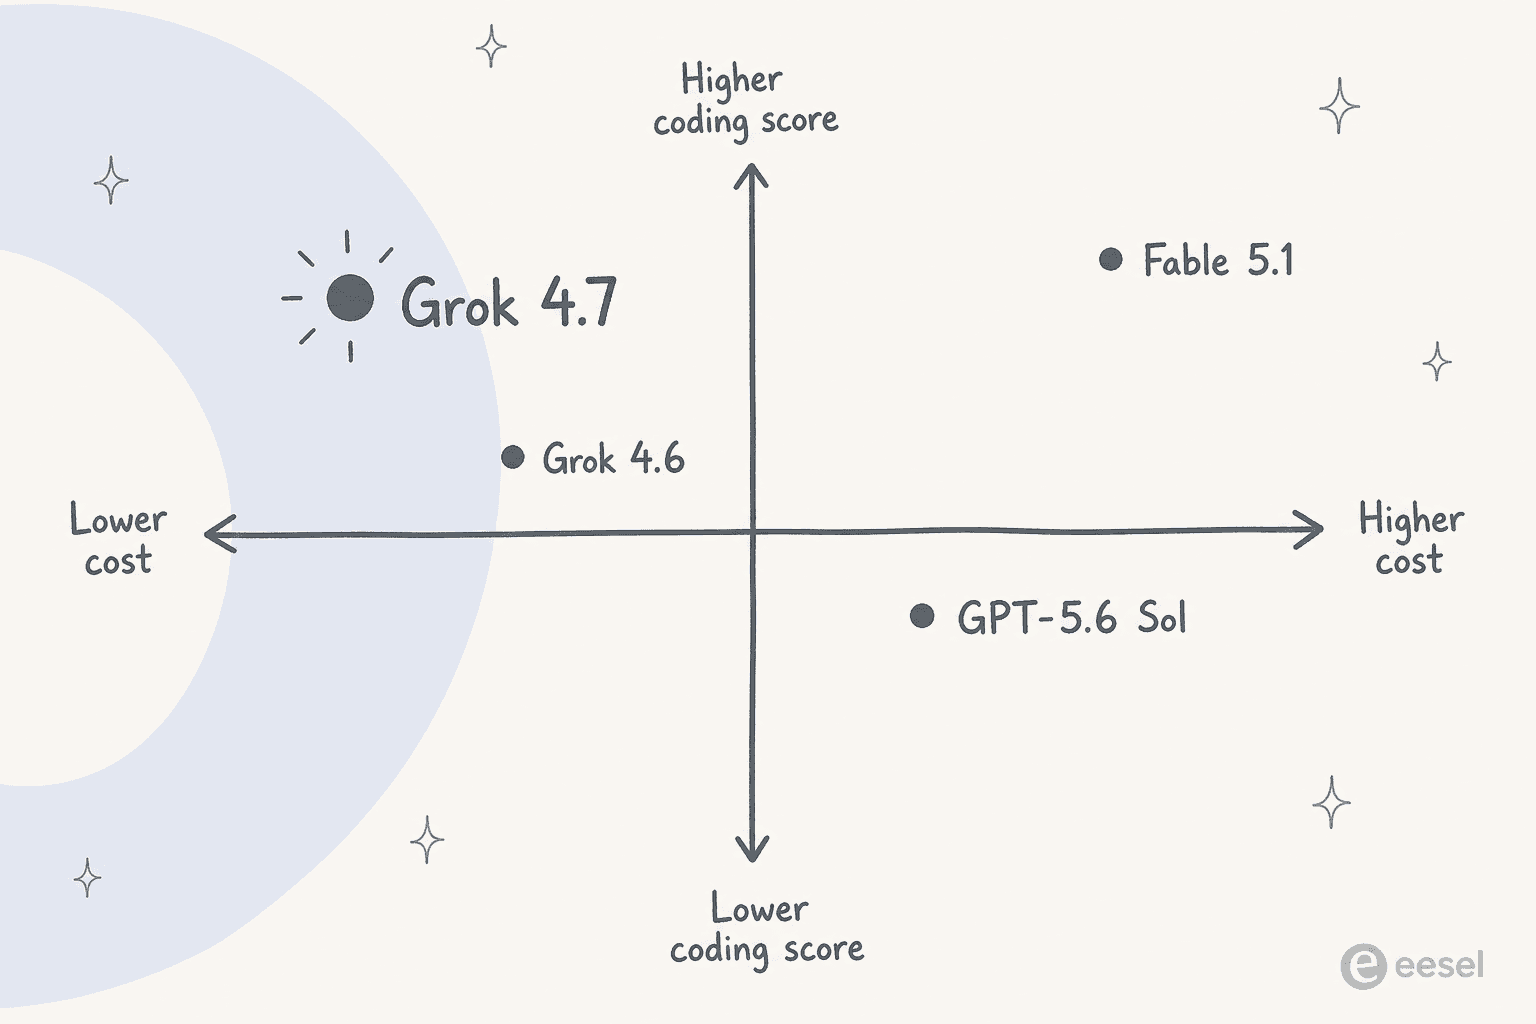
Hier ist das gesamte Feld auf einem Bildschirm. Preise sind pro Million Tokens, aus den aktuellen Doku-Seiten jedes Anbieters.
| Modell | Hersteller | Input / Output | Kontext | 200k-Klippe | Offene Gewichte | Native Bildverarbeitung | Am besten für |
|---|---|---|---|---|---|---|---|
| Grok 4.7 | xAI | 2 $ / 6 $ | 500k | Ja (2x) | Nein | Bild | Günstiges Frontier-Coding |
| Claude Fable 5.1 | Anthropic | 10 $ / 50 $ | 1M | Nein (pauschal) | Nein | Bild | Maximale Intelligenz |
| Claude Opus 5.5 | Anthropic | 4 $ / 20 $ | 1M | Nein (pauschal) | Nein | Bild | Langes agentisches Coding |
| GPT-6 Sol | OpenAI | 2 $ / 10 $ | Groß | Ja (2x) | Nein | Bild | Ökosystem + Balance |
| Gemini 3.8 Flash | 0,75 $ / 3,75 $ | 1M | Nein (pauschal) | Nein | Bild, Audio, Video | Multimodal + günstig | |
| DeepSeek V4.1 Flash | DeepSeek | ~0,22 $ / 0,66 $ | 1M | Nein | Ja (MIT) | Nein | Am günstigsten, selbst hosten |
| Kimi K3 | Moonshot | 3 $ / 15 $ | 1M | Nein | Ja | Bild, Video | Offenes Frontier-Modell |
| Qwen 3.8 Max | Alibaba | 2 $ / 6 $ | 1M | Nein | Nur Basis | Bild, Video | Groks Preis, offene Basis |
Ein Hinweis zur Fairness vor der Liste: Geminis 0,75 $ / 3,75 $ ist der Aktionspreis bis zum 31. Dezember 2026, danach verdoppelt er sich. DeepSeeks Off-Peak-Satz verdoppelt sich in etwa während der chinesischen Geschäftszeiten. Und Qwen 3.8 Max' offene Basis ist nicht funktionsgleich mit der gehosteten Version. Details stehen bei jedem Eintrag.
1. Claude (Fable 5.1 und Opus 5.5)
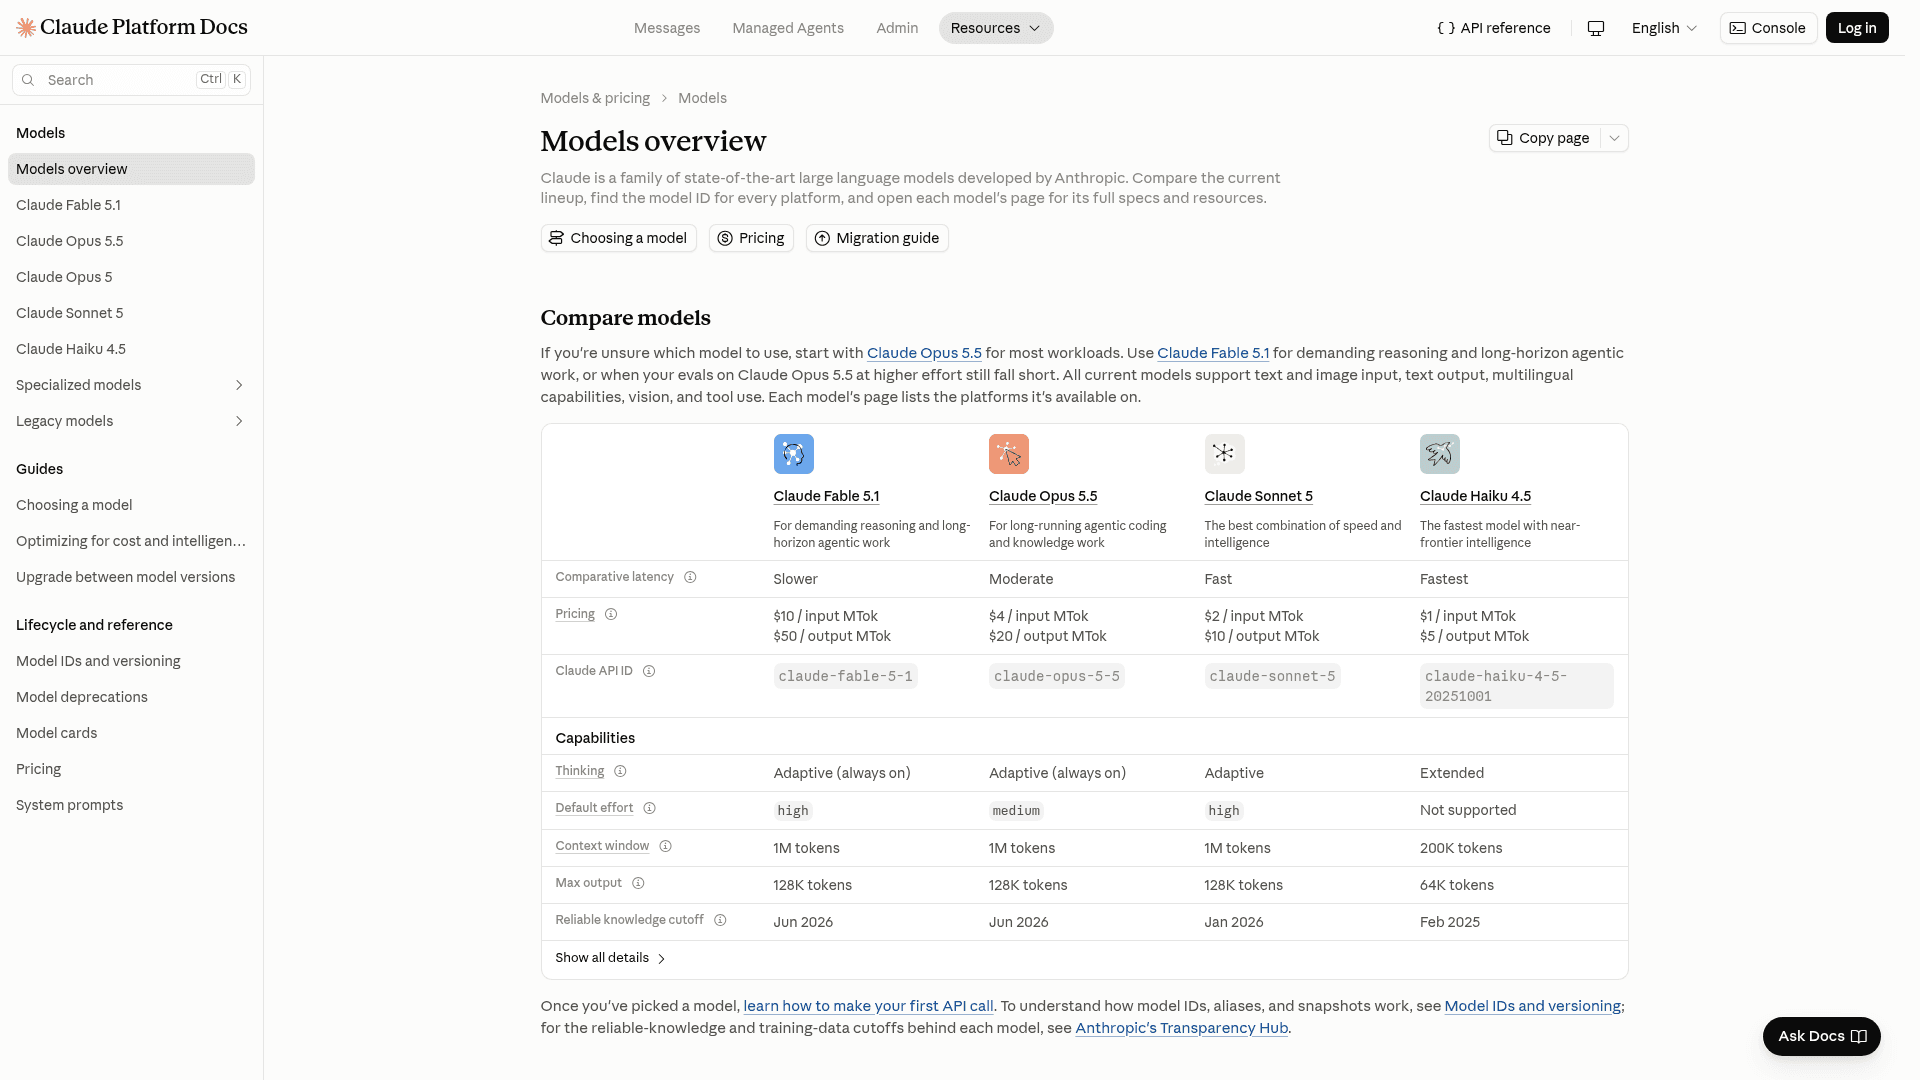
Wenn Grok 4.7s Pitch „frontier-nah für wenig Geld" ist, dann ist Claudes Pitch „tatsächlich die Frontier". Anthropics Fable 5.1 ist das Modell, das es auf den meisten öffentlichen Ranglisten zu schlagen gilt, und Opus 5.5 liegt knapp darunter als das Arbeitspferd für langes agentisches Coding.
Highlights. Fable 5.1 schlägt Grok 4.7 bei CursorBench, Terminal-Bench und dem AA Briefcase-Ranking, und es führt den GDPval-Index für professionelle Arbeit an. Beide Claude-Modelle haben ein 1M-Kontextfenster ohne 200k-Preisklippe, sodass lange Dokumentarbeit zu einem einzigen pauschalen Satz berechnet wird. Fables Cache-Lesevorgänge sind mit 0,25 $ pro Million ungewöhnlich günstig, was wiederholte agentische Aufrufe weit weniger schmerzhaft macht, als der Listenpreis vermuten lässt.
Vorteile. Höchste gemessene Intelligenz in diesem Überblick. Pauschale Preise über das gesamte Kontextfenster. Starke, gut dokumentierte Tool-Nutzung und ein ausgereiftes SDK.
Nachteile. Es ist teuer. Fable 5.1 kostet etwa das Fünffache von Groks Satz, und selbst Opus 5.5 kostet doppelt so viel. Community-Berichte weisen auch darauf hin, dass Fables Sicherheitsmechanismen bei eigenem Sicherheitscode falsch auslösen können, und es trägt jetzt ein statistisches Text-Wasserzeichen auf der Ausgabe.
Preise. Fable 5.1 kostet 10 $ / 50 $; Opus 5.5 kostet 4 $ / 20 $; Sonnet 5, das günstigere Geschwistermodell, kostet 2 $ / 10 $. Alle drei haben 1M Kontext und pauschale Preise.
Mein Fazit. Wählen Sie Claude, wenn die letzten paar Punkte an Fähigkeit den Preis wert sind, oder wenn Sie bei Grok bei hohem Aufwand bereits an eine Decke gestoßen sind. Der Claude Opus 5 Beitrag behandelt die Kompromisse beim Aufwandsregler.
2. GPT-6 Sol
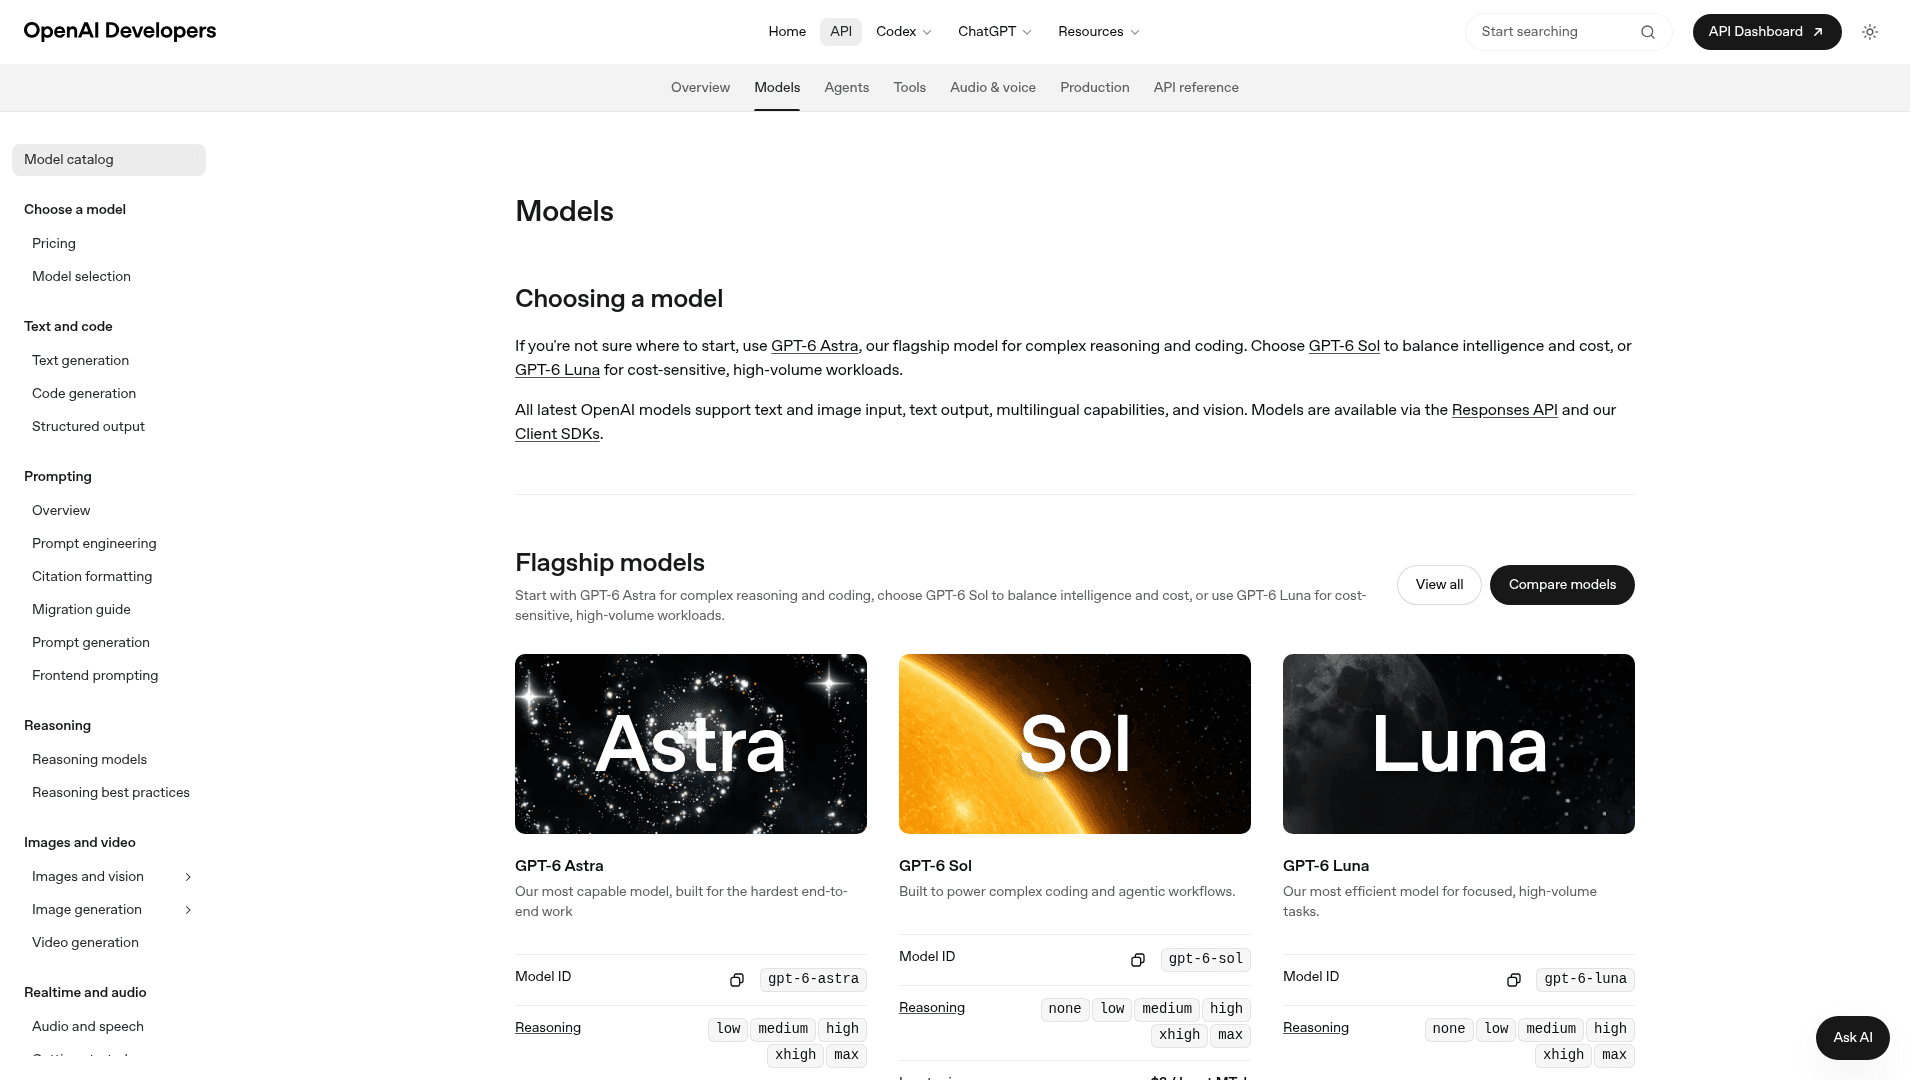
OpenAIs GPT-6 Sol ist das Modell, das xAI am härtesten jagt, und es ist der nächstliegende 1:1-Ersatz: ein mittelpreisiges geschlossenes Modell, gebaut, in OpenAIs eigenen Worten, „um komplexe Coding- und agentische Workflows zu ermöglichen." Es wurde am 22. September 2026 gestartet, am selben Tag wie Claude Opus 5.5.
Highlights. Das Ökosystem. Sol ist in mehr Tools, SDKs und nachgelagerte Produkte integriert als jedes andere Modell hier, was oft der eigentliche Grund ist, warum Teams es wählen. Es ist pro Aufgabe deutlich günstiger als die klügsten Claude-Modelle, weil es weniger Output-Tokens braucht, um eine Aufgabe abzuschließen, obwohl sein Output-Satz pro Token höher ist als Groks.
Vorteile. Riesige Tooling- und Integrationsfläche. Liegt sinnvoll in der Mitte bei Preis und Intelligenz. Konfigurierbares Reasoning von keinem bis maximal.
Nachteile. Es trägt dieselbe 200k-Preisklippe wie Grok, die sich bei langen Anfragen verdoppelt. Im Artificial-Analysis-Intelligenzindex liegt sein Wert bei maximalem Aufwand hinter den besten Claude-Modellen. Und es ist beim Output ein Fünftel teurer als Grok 4.7 zum Kurzkontext-Satz.
Preise. 2 $ / 10 $ für die Flaggschiff-Sol-Stufe, mit der Verdopplung bei langem Kontext oberhalb der Klippe. Die günstigeren Geschwistermodelle sind Terra und Luna; die ältere GPT-5.6 Generation ist auch noch verfügbar.
Mein Fazit. Die sichere Standardwahl, wenn Ihr Stack bereits OpenAI spricht. Wenn Sie kostenbewusst sind und neu anfangen, unterbieten Grok 4.7 oder Qwen es beim Output-Preis.
3. Gemini 3.8 Flash
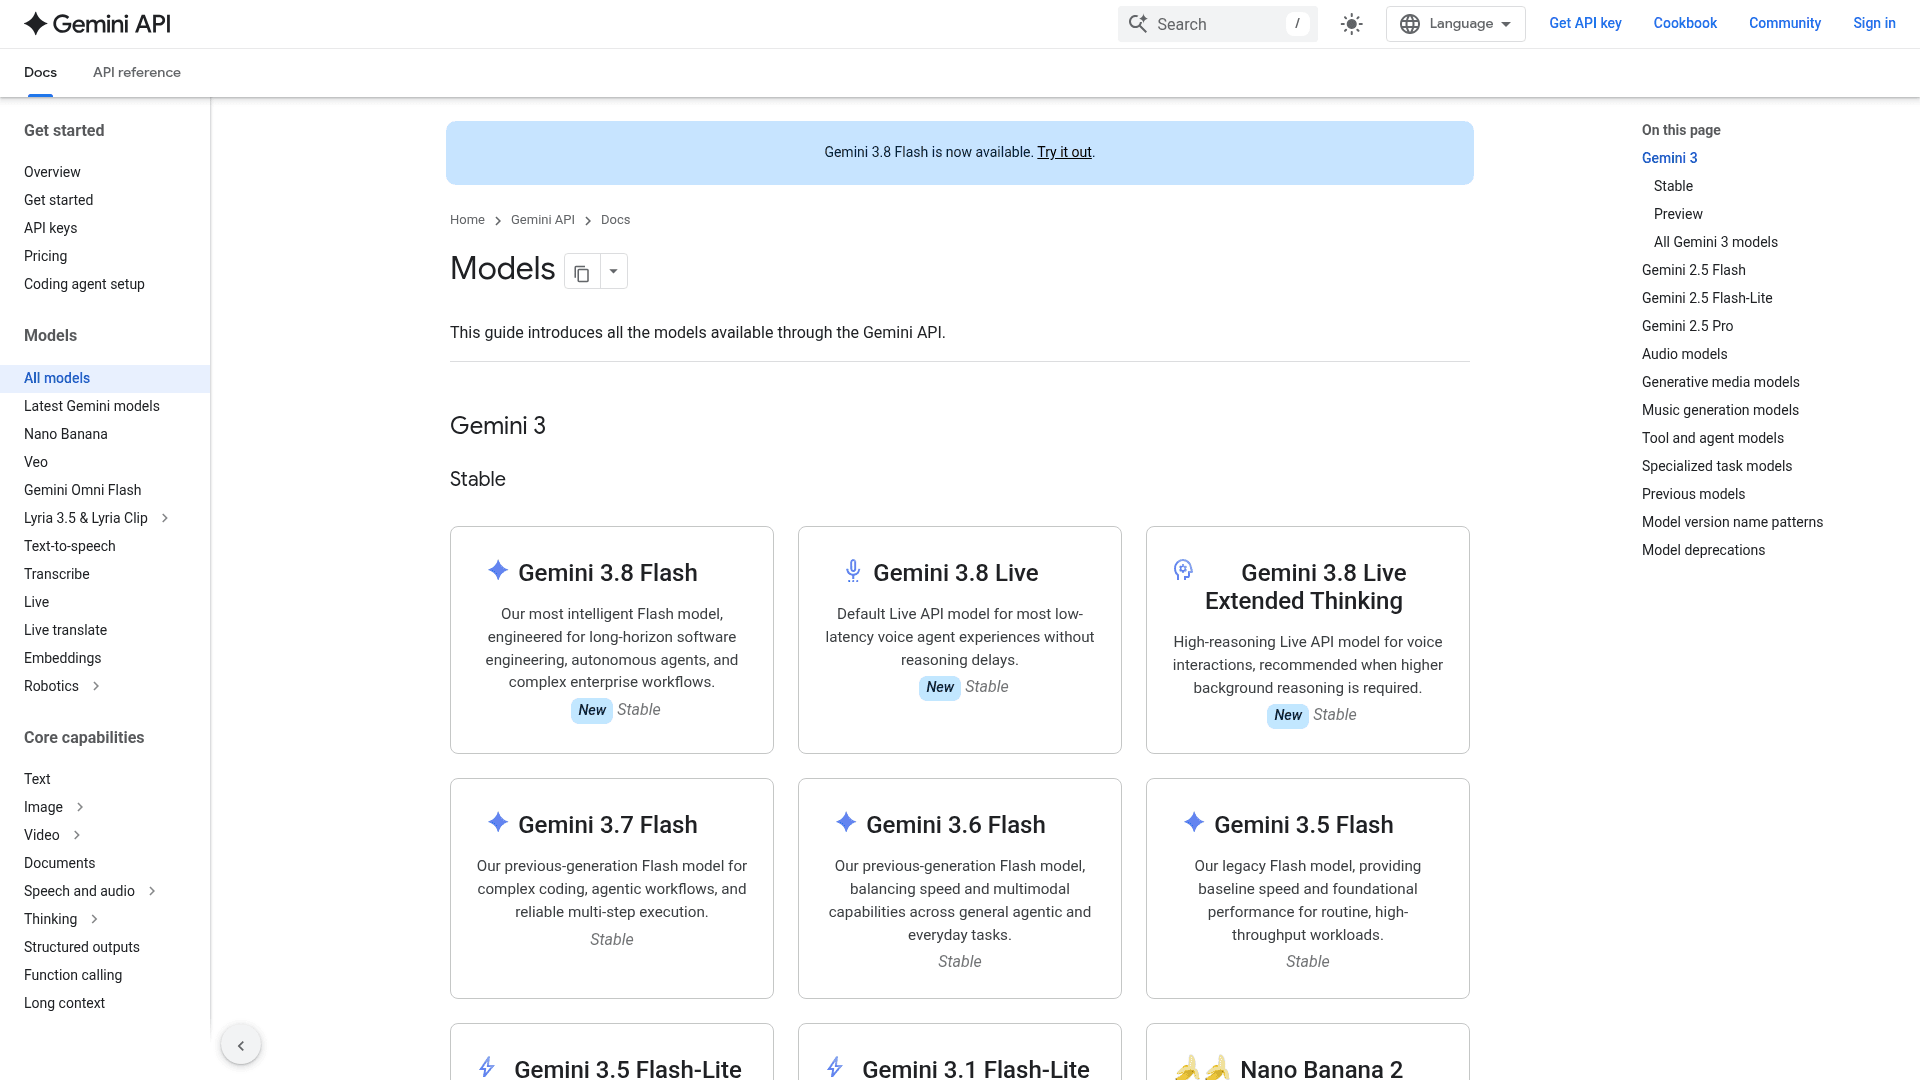
Googles Gemini 3.8 Flash ist die multimodale und günstige Ecke dieses Feldes. Es ist das einzige Modell hier, das Audio und Video nativ als Eingabe nimmt, und sein Listenpreis unterbietet alles außer DeepSeek.
Highlights. Native Text-, Bild-, Audio-, Video- und PDF-Eingabe, alles über eine API. Ein 1M-Token-Kontextfenster ohne Preisklippe. Und bei 0,75 $ / 3,75 $ ist es ein Bruchteil von Groks Kosten, mit einer kostenlosen Stufe zum Einstieg.
Vorteile. Beste multimodale Abdeckung in diesem Überblick. Sehr günstig für die gebotene Intelligenz; es schneidet im Artificial-Analysis-Index gut ab. Bindet sich direkt an die Google-Search-Grounding an.
Nachteile. Die Reaktionsgeschwindigkeit ist der Haken. Artificial Analysis misst eine Zeit bis zum ersten Token von 13,3 Sekunden gegenüber einem Klassenmedian von nahe 3 Sekunden, was es für alles disqualifiziert, worauf ein Mensch live wartet, obwohl es für Batch-Arbeit über Nacht in Ordnung ist. Es ist auch redselig, sodass der günstige Satz pro Token sich pro Aufgabe aufblähen kann. Und der Aktionspreis verdoppelt sich am 1. Januar 2027 auf 1,50 $ / 7,50 $. Google selbst empfiehlt, für effizienzorientierte Workloads bei 3.7 Flash zu bleiben.
Preise. 0,75 $ / 3,75 $ bis zum 31. Dezember 2026, danach 1,50 $ / 7,50 $. Batch und Flex kosten die Hälfte.
Mein Fazit. Die Wahl, wenn Ihre Eingaben multimodal sind oder Ihre Aufgaben gebündelt und preissensibel sind. Meiden Sie es für alles Latenz-Kritische wie ein Chat-Widget.
4. DeepSeek V4.1 Flash
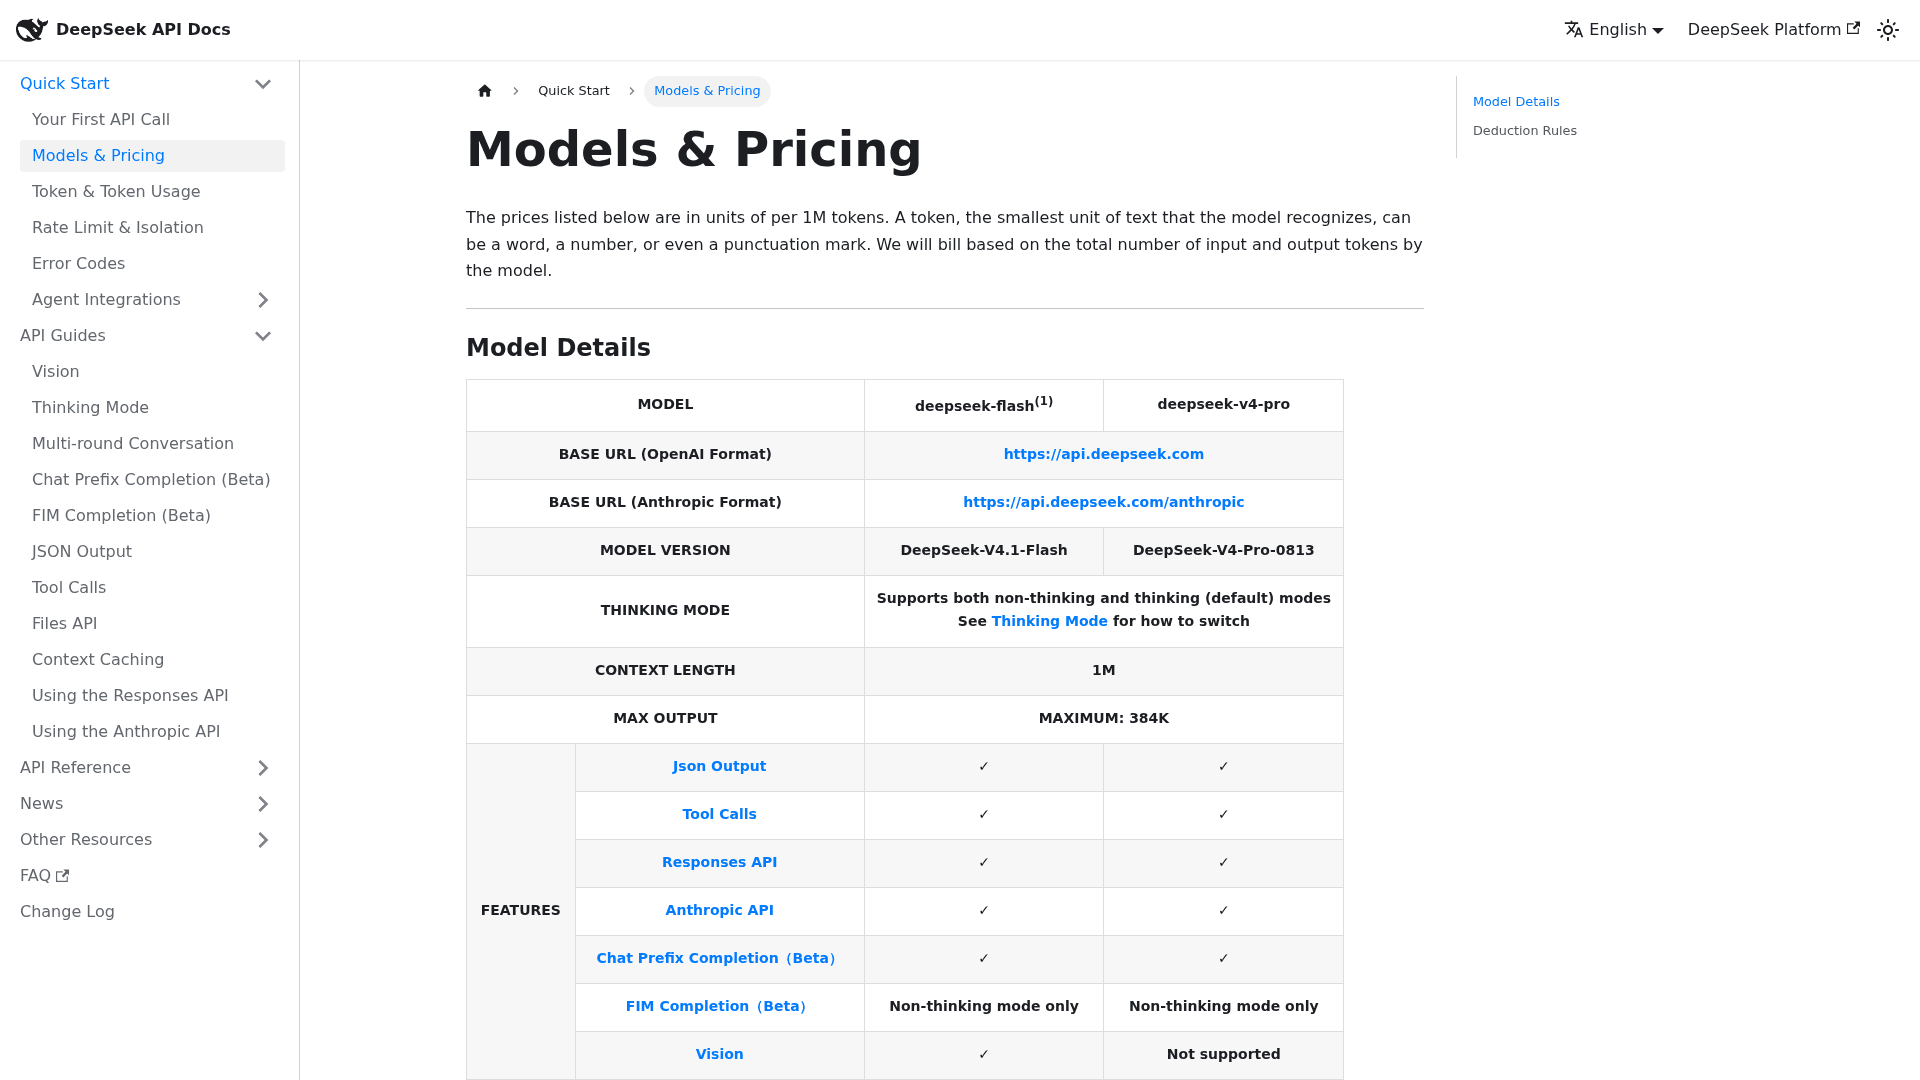
DeepSeek V4.1 Flash ist die günstige und offene Antwort auf Grok. Es wird unter einer MIT-Lizenz veröffentlicht, sodass Sie die Gewichte herunterladen und selbst betreiben können, und der gehostete Satz ist der günstigste jedes glaubwürdigen Modells hier.
Highlights. Der Preis. Off-Peak läuft es bei etwa 0,22 $ Input und 0,66 $ Output pro Million, ein Bruchteil von Grok 4.7. MIT-offene Gewichte bedeuten überhaupt keine Pro-Token-Rechnung, wenn Sie selbst hosten, und es behält ein 1M-Kontextfenster mit maximal 384k Output.
Vorteile. Günstigste glaubwürdige Option, gehostet oder selbst gehostet. Echt offene Lizenz, ungewöhnlich auf diesem Fähigkeitsniveau. Sowohl Anthropic-Format- als auch OpenAI-Format-API-Endpunkte.
Nachteile. Die günstige Konfiguration und die gute Konfiguration sind unterschiedliche Durchläufe derselben Gewichte; unabhängige Bewertungen setzen es bei maximalem Aufwand bei etwa 50 gegenüber 29 ohne Reasoning an, und Reasoning-Tokens werden zum Output-Satz berechnet. Es ist nur Text, ohne dokumentierte Bildeingabe. Der Off-Peak-Satz verdoppelt sich in etwa während der chinesischen Geschäftszeiten. Und die Bedingungen der gehosteten API schweigen zur Trainingsnutzung, und die Daten liegen in der VR China, sodass es kein direkter Ersatz für regulierte Kundendaten ist.
Preise. Etwa 0,22 $ / 0,66 $ Off-Peak, mit Verdopplung zur Spitzenzeit (01:00 bis 04:00 und 06:00 bis 10:00 UTC). Pro ist eine Stufe darüber.
Mein Fazit. Der klare Gewinner bei den reinen Kosten, besonders selbst gehostet. Lesen Sie das Kleingedruckte zur Datenresidenz, bevor Sie irgendetwas Sensibles senden.
5. Kimi K3
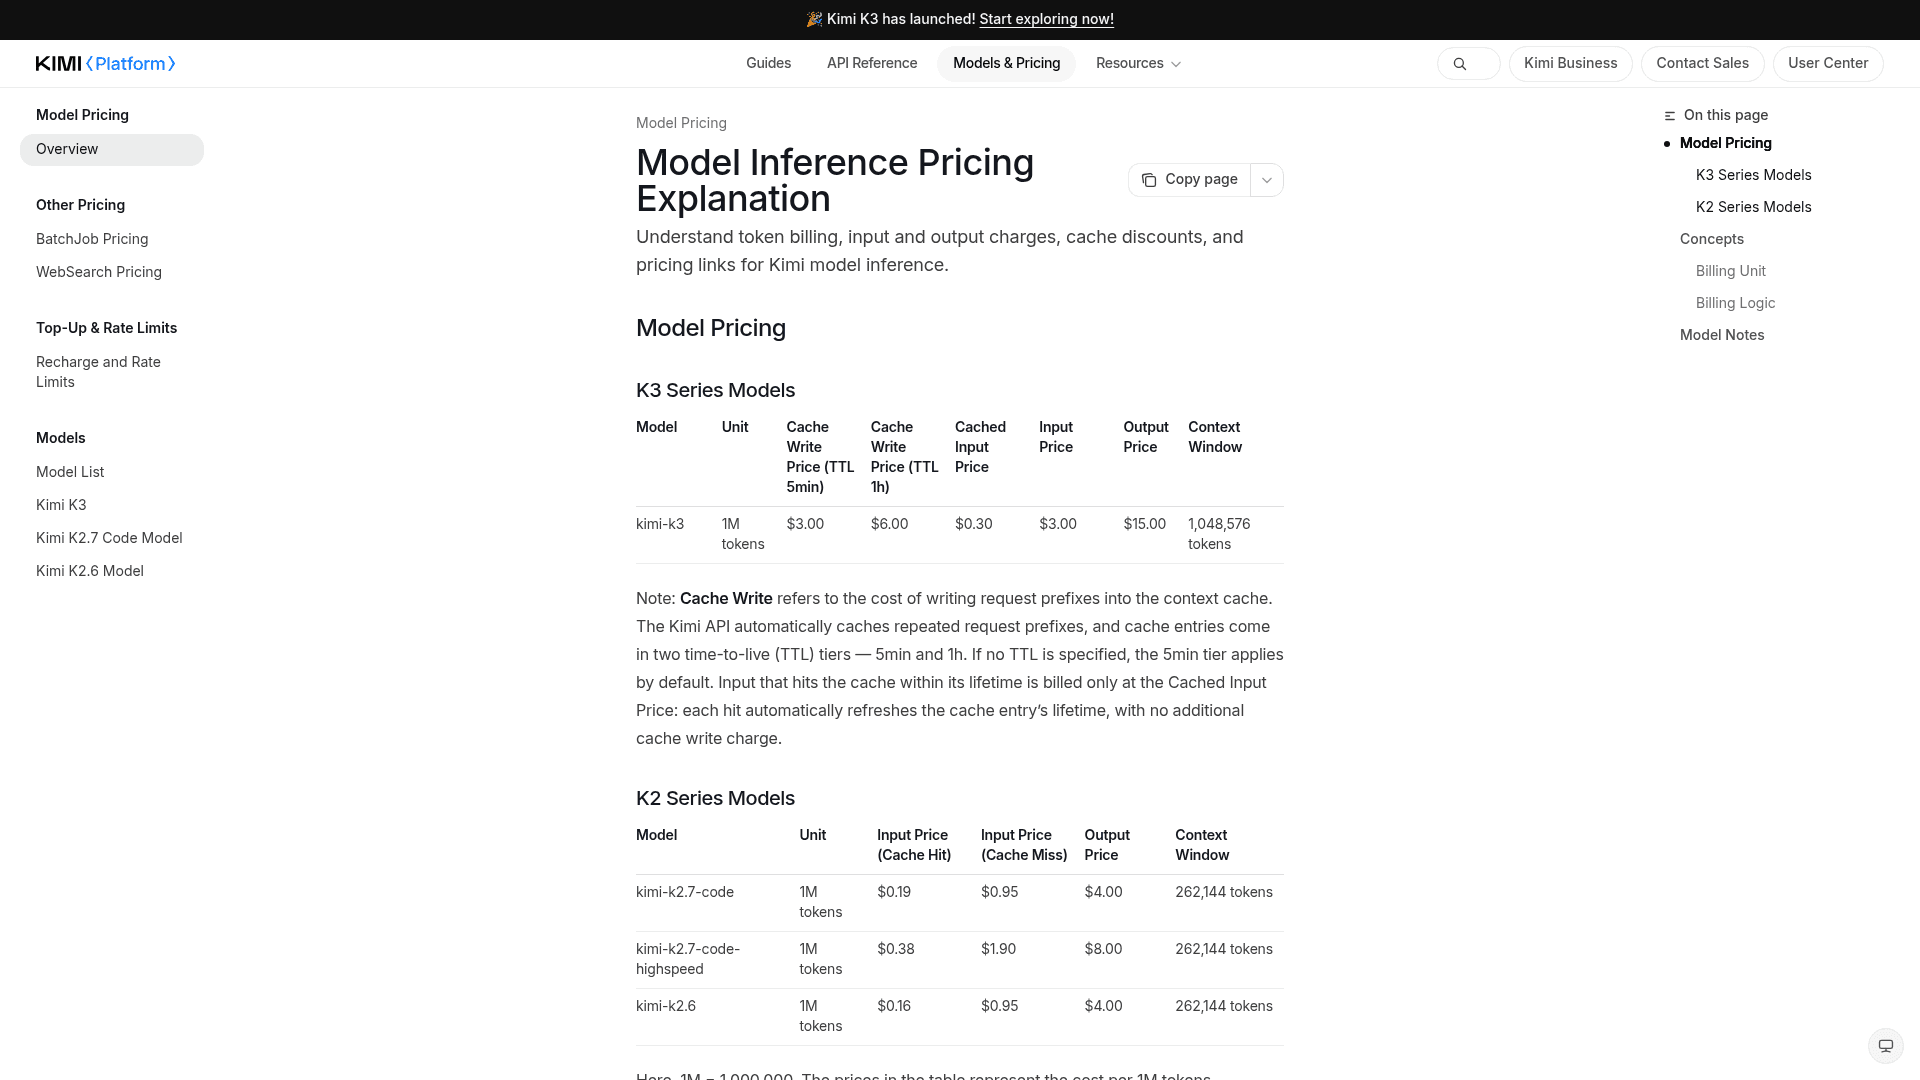
Moonshots Kimi K3 ist das Modell mit offenen Gewichten, das bei unabhängigen Benchmarks am höchsten abschneidet. Es ist ein Mixture-of-Experts-Modell mit 2,8 Billionen Parametern und 104 Milliarden aktiven, und Moonshot hat die Gewichte planmäßig auf Hugging Face veröffentlicht.
Highlights. Es liegt bei etwa 57 im Artificial-Analysis-Intelligenzindex, vor den meisten offenen Modellen und nur hinter der geschlossenen Frontier. Native Bildverarbeitung, ein 1M-Token-Kontext und eine wirklich offene Gewichte-Veröffentlichung machen es zum fähigsten Modell hier, das Sie tatsächlich selbst hosten können.
Vorteile. Stärkste Intelligenz mit offenen Gewichten in diesem Überblick. Echter 1M-Kontext mit konfigurierbarem Reasoning-Aufwand. Die Gewichte sind öffentlich, mit bereits verfügbaren Community-Quantisierungen.
Nachteile. Die gehostete API ist nicht günstig: 3 $ / 15 $ bringt es in Claude Sonnets Preisklasse, nicht in die Budget-Stufe. Reasoning lässt sich nicht abschalten, nur beschleunigen, es gibt also keinen ultragünstigen Modus. Und öffentliche Bild-URLs werden nicht akzeptiert; Sie übergeben Base64 oder eine Datei-ID.
Preise. 3 $ Input, 15 $ Output, 0,30 $ gecacht, bei einem Kontext von 1.048.576 Tokens.
Mein Fazit. Die Wahl, wenn Sie frontier-nahe Qualität und offene Gewichte zusammen wollen und den höheren gehosteten Satz verkraften können oder es selbst betreiben.
6. Qwen 3.8 Max
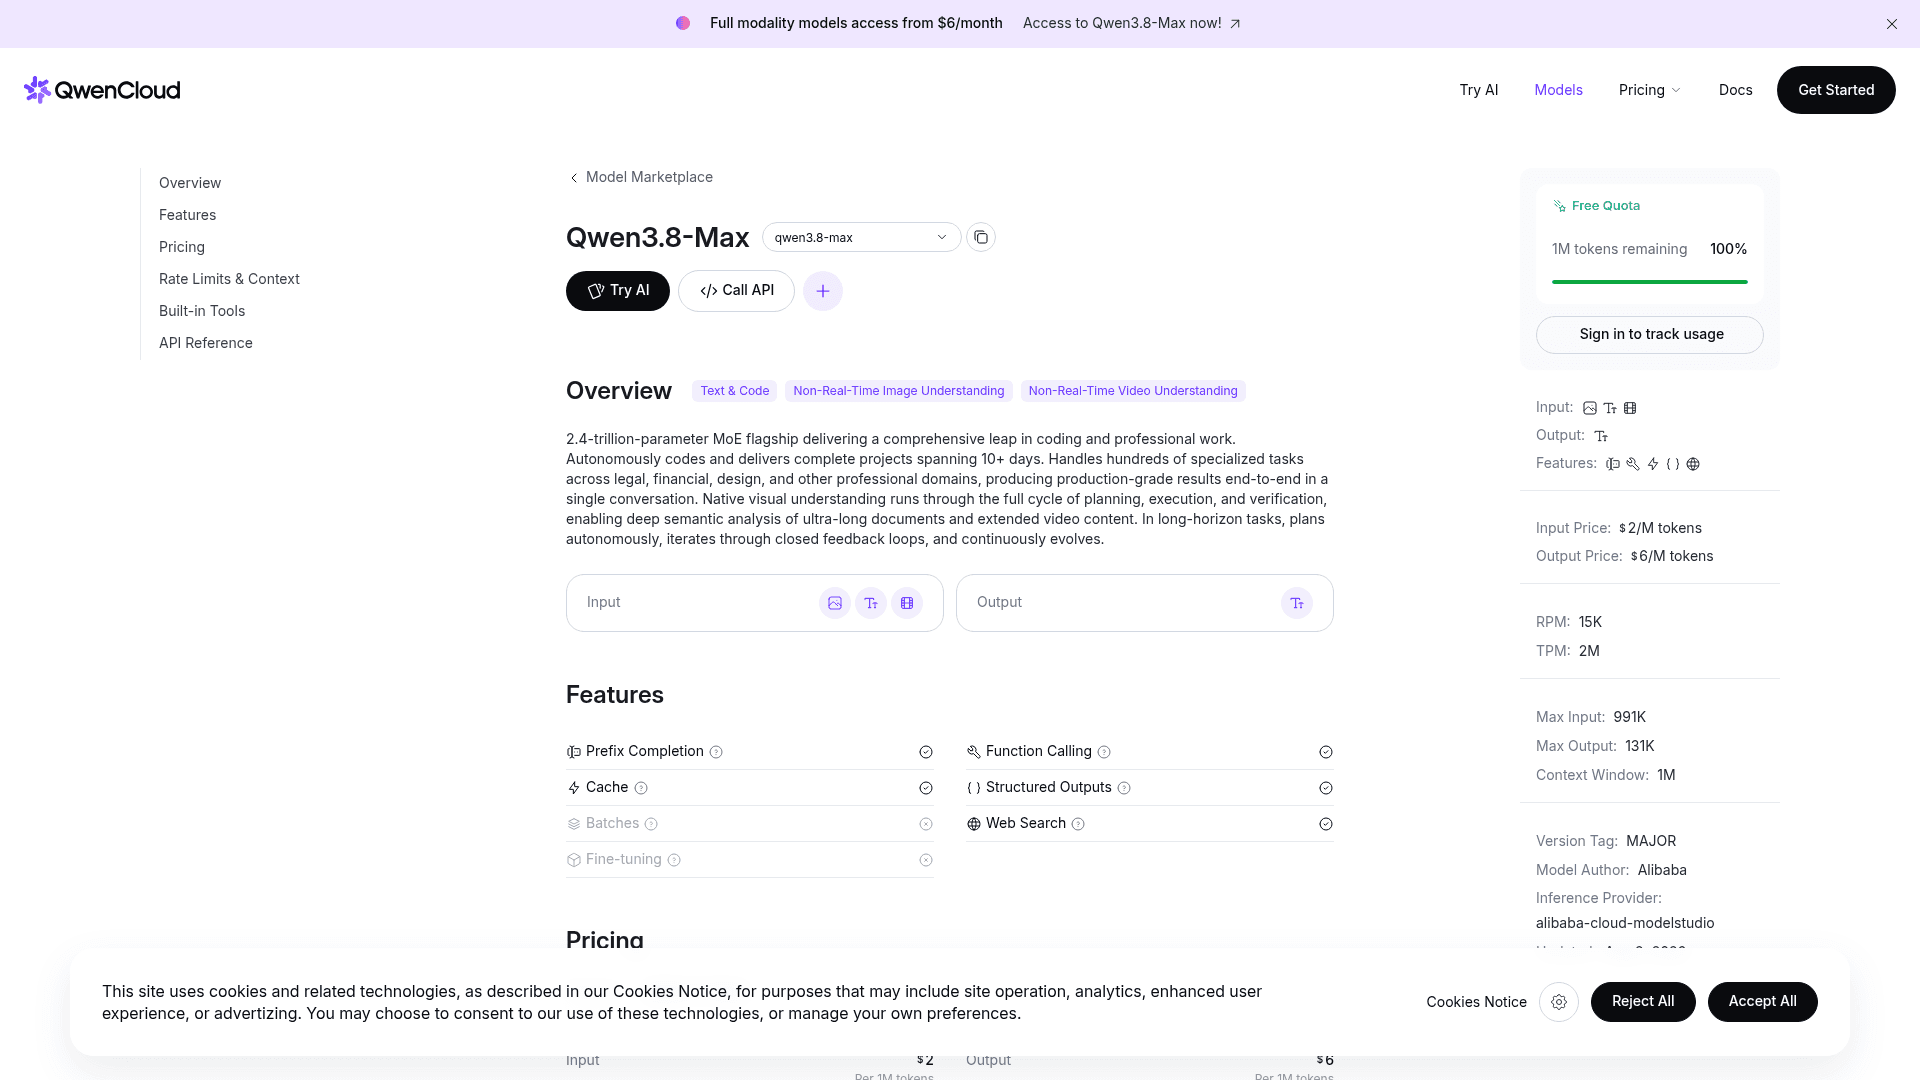
Alibabas Qwen 3.8 Max ist die direkteste Preisentsprechung: Es verlangt genau dasselbe 2 $ / 6 $ wie Grok 4.7, bei einem größeren pauschalen Kontextfenster und mit einem offenen Basismodell darunter.
Highlights. Derselbe Satz wie Grok, keine 200k-Klippe, und ein starkes unabhängiges Ranking (etwa Rang 6, Index ~58 bei Artificial Analysis). Es ist ein MoE-Modell mit 2,4 Billionen Parametern mit nativem Bild- und Videoverständnis und eingebauten Tools, und Alibaba hat auch ein offenes Basismodell veröffentlicht.
Vorteile. Entspricht Groks Preis bei pauschaler Abrechnung über ein 1M-Kontextfenster. Native multimodale Eingabe. Eine offene Basis für Teams, die einen Teil des Stacks selbst hosten wollen.
Nachteile. Die offene Basis ist nicht funktionsgleich mit dem gehosteten Max: Bildverarbeitung, Nicht-Denkmodus und eingebaute Tools gibt es nur gehostet. Der eigene mitgelieferte Coding-Harness deckelt den Output weit unter der 131k-Obergrenze, sodass das Output-Limit für die meisten Nutzer theoretisch bleibt. Und die Lizenz für den großen offenen Checkpoint ist eine benutzerdefinierte Qwen-Lizenz, nicht Apache.
Preise. 2 $ / 6 $ pro Million, implizites Cache-Lesen bei etwa 0,25 $, bei 1M Kontext mit maximal 131k Output.
Mein Fazit. Wenn Ihnen Groks Preis gefällt, Sie aber pauschale Long-Context-Abrechnung und eine multimodale Option wollen, ist Qwen der nächstliegende Ersatz auf dieser Liste.
7. eesel: Wenn Sie einen Teamkollegen wollen, kein Modell

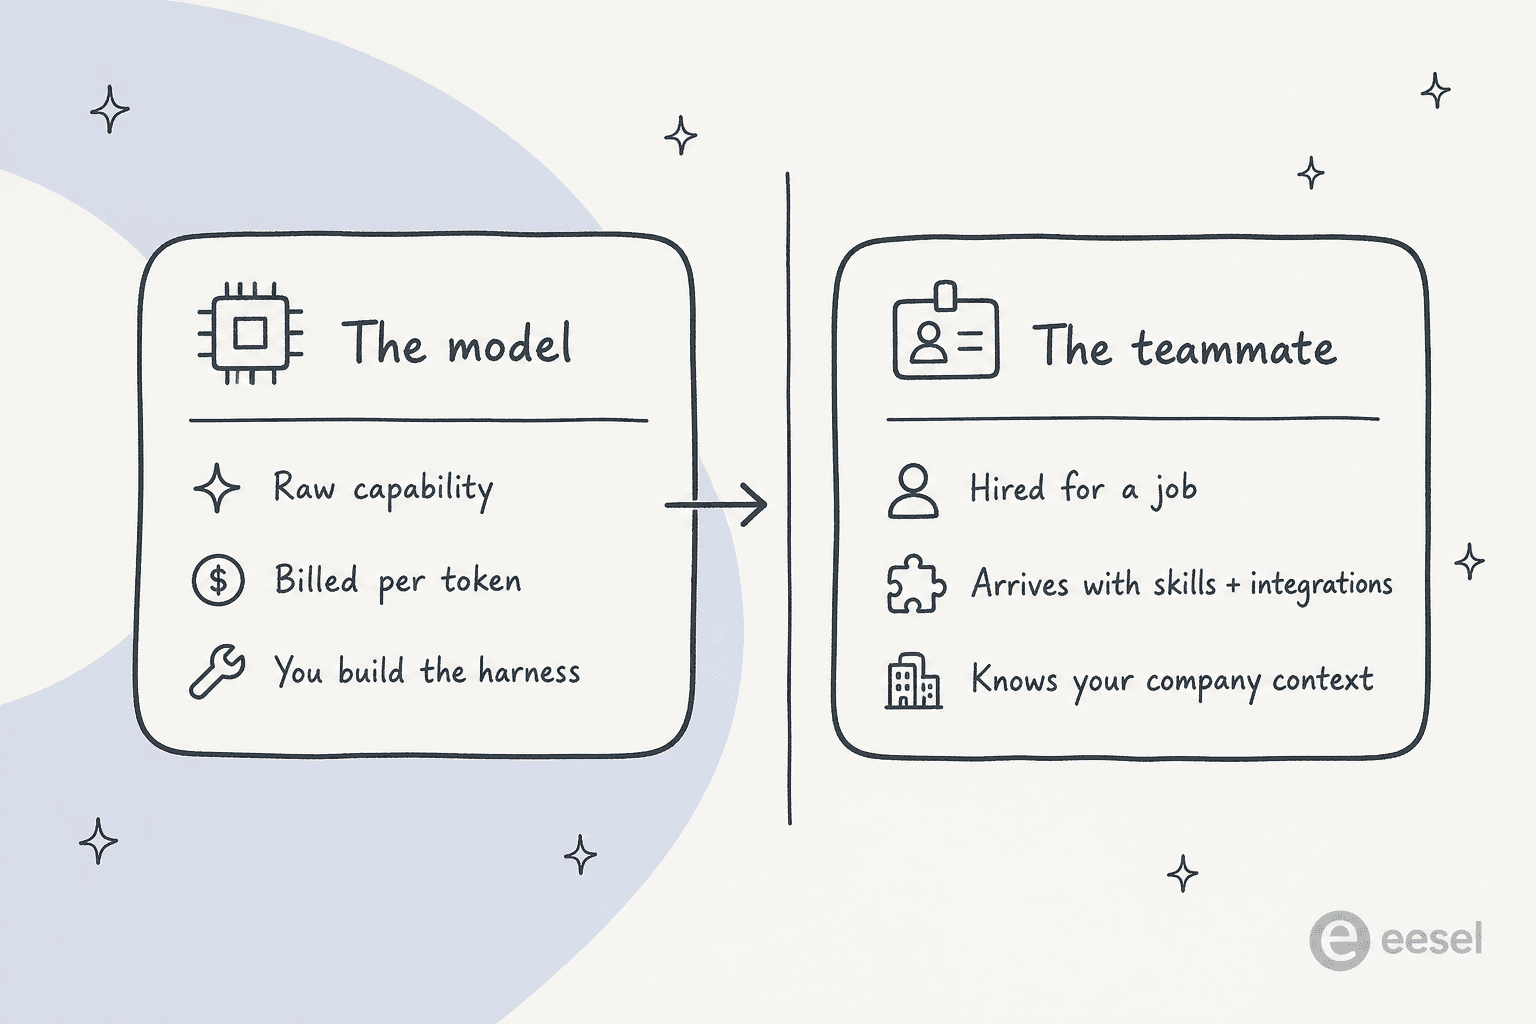
Hier kommt der ehrliche Teil. Jedes Modell oben ist eine Engine. Keines davon löst allein ein Support-Ticket, verfasst eine Antwort für das Hilfezentrum oder schreibt einen Blogbeitrag, der veröffentlicht wird. Sie kaufen kein Modell, um eine Aufgabe zu erledigen; Sie kaufen ein Modell, um etwas zu bauen, das eine Aufgabe erledigt, und dieser zweite Schritt ist da, wo die meisten Kosten und Risiken tatsächlich liegen.
Einer unserer Kunden, Karel von GENERAL BYTES, hat die Build-oder-Buy-Entscheidung klar auf den Punkt gebracht:
„Wir hätten versuchen können, unsere eigene LLM-Anwendung zu schreiben, aber wir wollten unsere Zeit nicht darin investieren. Wir wollten etwas, das wir nicht warten müssen."
Karel, GENERAL BYTES
Das ist die Lücke, die eesel füllt. eesel ist eine KI-Teamkollegen-Plattform: Statt Tokens zu mieten und den Rest selbst zusammenzubauen, stellen Sie einen einsatzbereiten Teamkollegen für eine definierte Aufgabe ein. Die aktuelle Besetzung besteht aus einem KI-Helpdesk-Teamkollegen und einem KI-Blog-Autor. Jeder kommt bereits verdrahtet mit den Integrationen, Fähigkeiten und Firmenkontext, den seine Rolle braucht, und läuft dabei unter der Haube auf Frontier-Modellen wie denen in diesem Überblick.
Für Entwickler, die die Kommandozeile mögen, ist dieser Teamkollege skriptfähig. Die eesel CLI lässt Sie denselben Teamkollegen und Workspace von einem Terminal aus bedienen, in Skripte einbinden oder von einem Coding-Agenten wie Claude Code, Codex oder Cursor aus steuern. Der Instinkt „Ich will programmatischen Zugriff auf ein Modell", der Leute zur xAI-API führt, wird also eine Ebene höher bedient: Sie bekommen programmatischen Zugriff auf einen Teamkollegen, der bereits Ihren Kontext hat, keinen nackten Completion-Endpunkt, um den Sie noch ein Produkt bauen müssen.
Der Teil, der mir am wichtigsten ist, nachdem ich diese Infrastruktur seit Jahren baue, ist, dass Sie einen Rollout simulieren können, gegen Ihre eigenen historischen Tickets, bevor er je einen Kunden berührt. Ein Benchmark-Wert kann Ihnen nicht sagen, ob ein Modell bei Ihren Daten selbstbewusst eine falsche Antwort geben wird. Eine Simulation über Ihre echten vergangenen Tickets kann das. Das ist der Unterschied zwischen einem Modell auswählen und eines ausliefern.
Welche Grok 4.7 Alternative sollten Sie wählen?
Wählen Sie die Priorität, die Ihnen am wichtigsten ist, und lesen Sie die Empfehlung.
Das Fazit
Grok 4.7 ist bei der Preis-Leistung schwer zu schlagen, daher ist die gewinnende Alternative die, die Ihrer tatsächlichen Priorität entspricht. Claude für Intelligenz, DeepSeek oder Gemini für Kosten, Kimi K3 oder Qwen für offene Gewichte, GPT-6 Sol für das Ökosystem. Wenn Sie zwischen Grok 4.5 Generationen wählen, behandelt der Grok 4.6 Beitrag die älteren.
Aber wenn Sie eigentlich eine erledigte Aufgabe brauchen, Tickets lösen oder Content ausliefern, ist keines davon für sich allein die Antwort. Das ist der Unterschied zwischen dem Mieten einer Engine und dem Einstellen eines Teamkollegen.
Modelle zu vergleichen ist der einfache Teil
Jedes Modell in diesem Überblick verkauft Ihnen Intelligenz pro Token. Der schwierige Teil ist, daraus etwas zu machen, das zuverlässig eine echte Aufgabe an Ihren Daten erledigt. eesel verpackt ein Frontier-Modell in einen KI-Teamkollegen, der bereits Ihren Helpdesk und Ihre Dokumente kennt, und lässt Sie ihn an Ihren eigenen vergangenen Tickets simulieren, bevor er live geht, sodass Sie keine Kundeninteraktion auf einen Benchmark-Wert verwetten.
Testen Sie eesel kostenlos, oder buchen Sie eine Demo, um es an Ihren eigenen Daten laufen zu sehen.

Häufig gestellte Fragen
Was ist die beste Grok 4.7 Alternative?
Das hängt davon ab, was Ihnen wichtig ist. Für maximale Intelligenz führt Claudes Fable 5.1 die meisten Ranglisten an. Für ein günstigeres geschlossenes Modell mit einem riesigen Ökosystem ist GPT-6 Sol die sichere Wahl. Für ein Modell mit offenen Gewichten, das Sie selbst hosten können, ist DeepSeek V4.1 Flash die günstigste der glaubwürdigen Grok 4.7 Alternativen. Qwen 3.8 Max entspricht genau Groks Satz von 2 $ / 6 $.
Gibt es eine günstigere Alternative zu Grok 4.7?
Ja. Grok 4.7 kostet 2 $ pro Million Input-Tokens und 6 $ Output, aber DeepSeek V4.1 Flash läuft außerhalb der Spitzenzeiten für etwa 0,22 $ / 0,66 $ und hat offene Gewichte, und Gemini 3.8 Flash listet 0,75 $ / 3,75 $ bis Ende 2026. Beide sind deutlich günstiger als Grok 4.7, mit den üblichen Kompromissen bei der Intelligenz und, bei DeepSeek, bei der Datenresidenz.
Was ist die beste Alternative mit offenen Gewichten zu Grok 4.7?
Grok 4.7 ist geschlossen. Wenn Sie offene Gewichte benötigen, die Sie selbst hosten können, sind die stärksten Optionen Kimi K3 (2,8 Billionen Parameter, MoE), Qwen 3.8 Max' offene Basis und DeepSeek V4.1 Flash unter einer MIT-Lizenz. DeepSeek ist am günstigsten zu betreiben; Kimi K3 erzielt von den dreien die höchste Punktzahl in unabhängigen Benchmarks.
Ist Grok 4.7 oder Claude besser?
Bei der reinen Intelligenz gewinnt Claude. Fable 5.1 übertrifft Grok 4.7 bei CursorBench, Terminal-Bench und dem AA Briefcase-Ranking. Aber Grok 4.7 kostet etwa ein Fünftel von Fable 5.1, sodass die eigentliche Frage ist, ob Sie für die letzten paar Punkte an Fähigkeit bezahlen wollen. Der Grok 4.7 Test behandelt den direkten Vergleich im Detail.
Wie viel kostet Grok 4.7 im Vergleich zu Alternativen?
Grok 4.7 kostet 2 $ / 6 $ pro Million Tokens unterhalb von 200k, genau wie Qwen 3.8 Max. GPT-6 Sol kostet 2 $ / 10 $, Claude Opus 5.5 kostet 4 $ / 20 $, und Fable 5.1 kostet 10 $ / 50 $. Das günstige Ende bilden DeepSeek und Gemini Flash. Die vollständigen Zahlen finden Sie im Leitfaden Grok 4.7 Preise und im Überblick xAI Preise.
Vermeiden manche Grok 4.7 Alternativen die 200k-Preisklippe?
Ja. Grok 4.7 verdoppelt seinen Satz, sobald eine Anfrage 200k Prompt-Tokens überschreitet, und GPT-6 Sol tut dasselbe. Claude und Gemini berechnen über ihr gesamtes Kontextfenster hinweg einen einzigen pauschalen Satz, sodass sie bei langen Dokumenten oder großen Codebasen am Ende günstiger sein können, als es der Listenpreis vermuten lässt.
Was ist die beste Grok 4.7 Alternative für den Kundensupport?
Keines dieser Modelle ist für sich genommen ein Support-Tool; es sind Engines. Wenn die Aufgabe darin besteht, Tickets zu lösen, verpackt eine Plattform wie KI für den Kundenservice von eesel ein Frontier-Modell mit Ihrem Helpdesk, Ihrer Wissensdatenbank und einem Support-Automatisierungs-Workflow, sodass Sie einen Teamkollegen einstellen, statt Tokens zu mieten.


Article by
Kurnia Kharisma Agung Samiadjie
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.