Grok 4.7 Preise auf einen Blick
Hier ist die Preistafel, direkt aus der Quelle statt einer "ab"-Zahl.
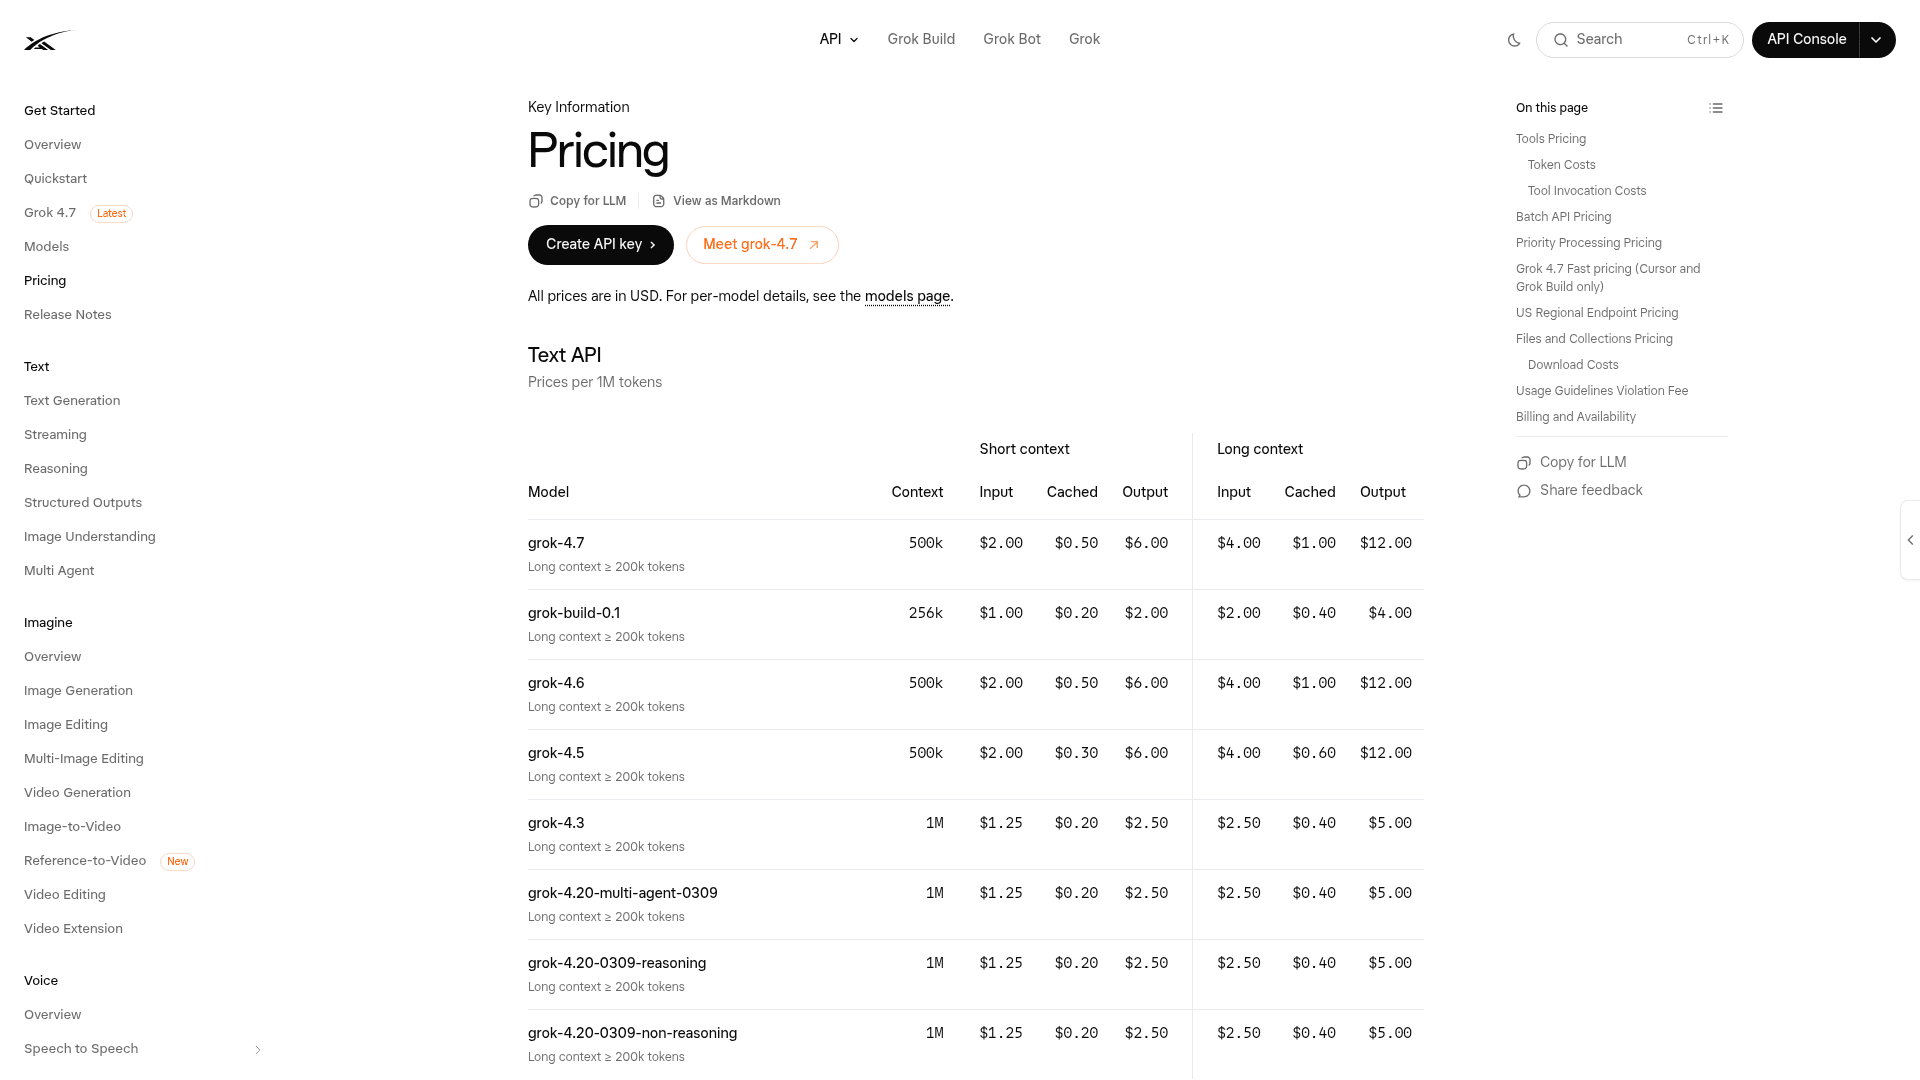
| Stufe | Input / 1 Mio. | Gecachter Input / 1 Mio. | Output / 1 Mio. |
|---|---|---|---|
grok-4.7, Prompt unter 200k | 2,00 $ | 0,50 $ | 6,00 $ |
grok-4.7, Prompt ab 200k | 4,00 $ | 1,00 $ | 12,00 $ |
| Grok 4.7 Fast (nur Cursor und Grok Build) | 2x die obigen Raten | 2x | 2x |
Das 500k-Kontextfenster und die Token-Raten sind beide unverändert gegenüber Grok 4.6, was für einen Käufer die Schlagzeile dieses Releases ist: man bekommt ein stärkeres Modell zum selben Zähler. Die Fortschritte landeten bei langwierigen agentischen Aufgaben, und der Preis hat sich nicht bewegt, um dafür zu bezahlen.
Ein netter Punkt für die API: Der Reasoning-Aufwand ist über niedrig, mittel, hoch und xhigh konfigurierbar, sodass du einstellen kannst, wie stark das Modell pro Anfrage nachdenkt. Da Output-Tokens 3x so viel kosten wie Input und Reasoning Output-Tokens verbraucht, ist der Aufwand ein echter Kostenhebel, nicht nur ein Qualitätshebel. Den Aufwand bei einfachen Aufrufen herunterzudrehen, ist die günstigste Optimierung, die du nicht machst.
Die 200k-Long-Context-Klippe
Das ist der teuerste Punkt, den man bei den Grok 4.7 Preisen übersehen kann. Sobald der Prompt einer Anfrage 200k Tokens erreicht, gelten die Long-Context-Raten für jeden Token in der Anfrage, nicht nur für den Überschuss über 200k hinaus.
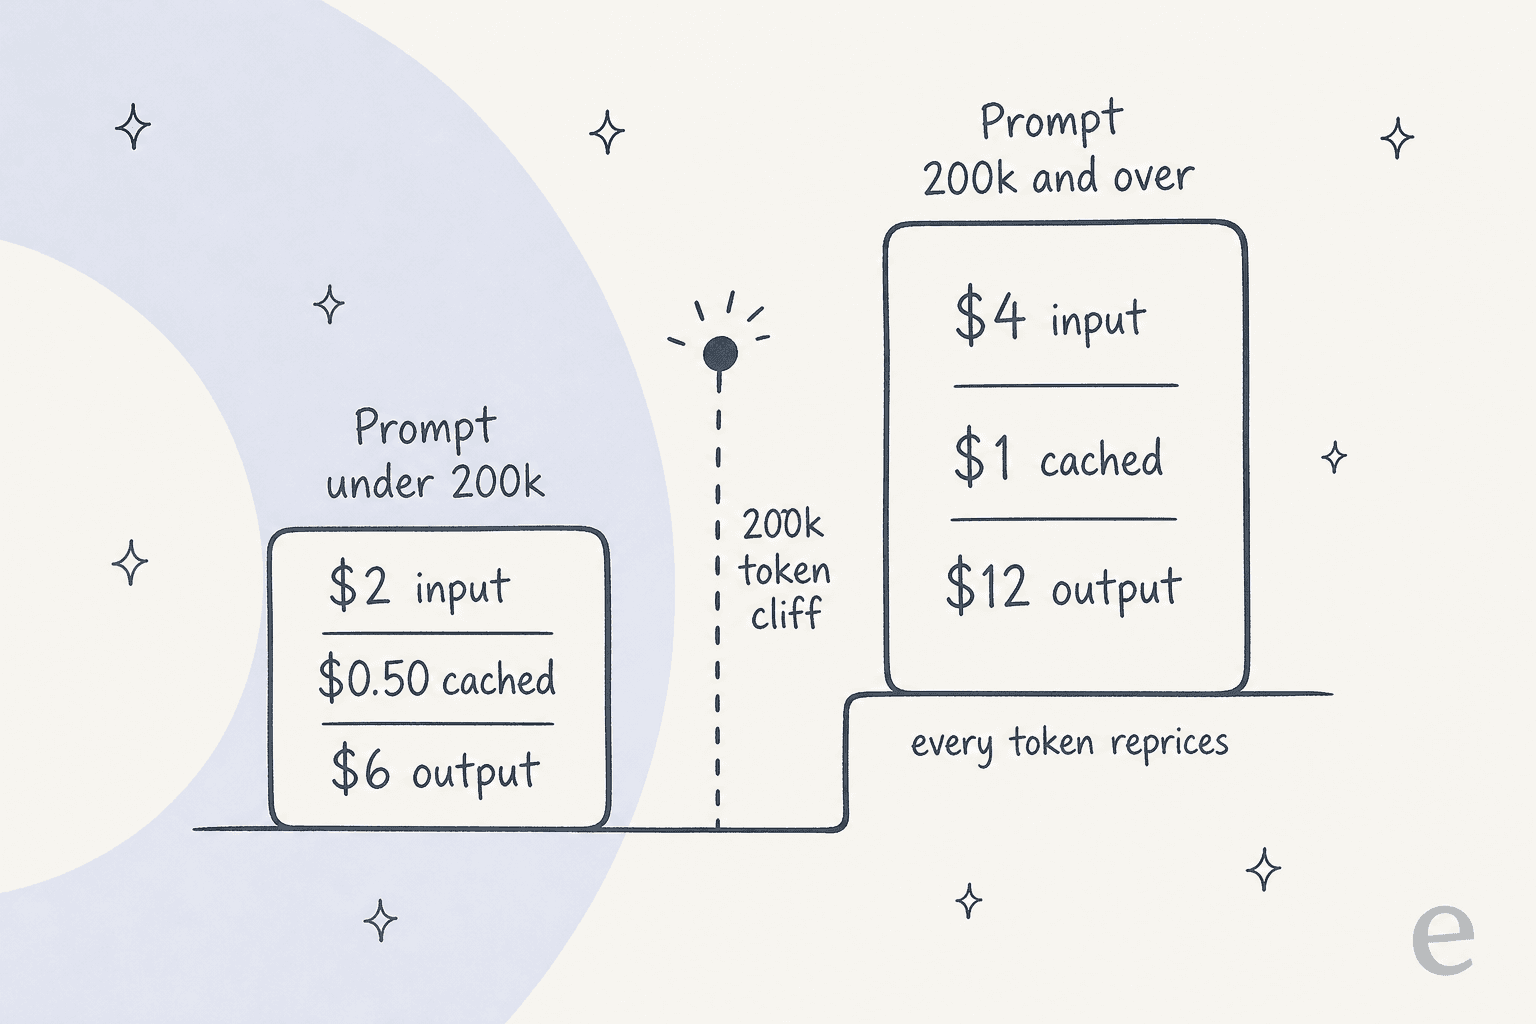
Ein 210k-Token-Prompt wird also vollständig zu 4 $ / 12 $ abgerechnet, nicht überwiegend zu 2 $ / 6 $. Das ist eine Verdopplung, ausgelöst durch die letzten 10k Tokens. Für einen langen Agenten-Loop, der Schritt für Schritt langsam Kontext ansammelt, ist die Klippe eine echte Falle: Der Lauf wird in dem Moment, in dem er kippt, leise doppelt so teuer, und nichts in den Antwort-Headern signalisiert das vorher.
xAI weiß das eindeutig, denn das Unternehmen hat eine Context Compaction API speziell dafür geschaffen, Konversationen zu verkleinern, bevor sie die Grenze überschreiten. Wenn du etwas Längeres betreibst, plane Engineering-Zeit ein, um Prompts auf der günstigen Seite von 200k zu halten, oder akzeptiere, dass manche deiner Anfragen still zum doppelten Satz abgerechnet werden. Das ist genau die Art von Detail, die Token-Preise in einer Tabelle planbar wirken lässt und auf der Rechnung unplanbar macht.
Die Zähler, die die meisten Kostenmodelle übersehen
Token-Raten sind die Schlagzeile, aber nicht die ganze Rechnung. Auf der API listet xAIs Preisseite eine Reihe von Pro-Aufruf-Zählern, die zusätzlich zu den Tokens anfallen, und sie zählen viel für Agenten, die mehr tun als chatten:
- Websuche, X-Suche und Codeausführung: je 5 $ pro 1.000 Aufrufe.
- Suche in Dateianhängen: 10 $ pro 1.000 Aufrufe.
- Collections-Suche (die RAG-artige Retrieval-Variante): 2,50 $ pro 1.000 Aufrufe.
- Priority Processing: verdoppelt alle Token-Raten und wird nur abgerechnet, wenn die Antwort bestätigt, dass sie in der Priority-Stufe lief.
- Gebühr für Verstoß gegen Nutzungsrichtlinien: 0,05 $ für eine vor der Generierung blockierte Anfrage.
Keiner dieser Posten sprengt für sich allein die Bank. Aber ein Agent, der bei jedem Ticket im Web sucht, aus einer Wissensdatenbank abruft und Code ausführt, feuert drei oder vier abrechenbare Aufrufe pro Runde ab, und das ist ein Posten, den deine Token-Rechnung nicht zeigt. Wenn du die Kosten eines KI-Agenten modellierst, verstecken sich in diesen Zählern meist die Überraschungen.
Es gibt außerdem einen Batch-Hinweis, den man kennen sollte: Der 20-%-Batch-Rabatt von xAI gilt nicht für Grok 4.7. Er deckt nur die älteren Varianten grok-4.3 und grok-4.20 ab. Wenn du also einen umfangreichen, latenztoleranten Job hast, kann das Ausführen auf Grok 4.3 im Batch pro Token günstiger sein als Grok 4.7 zu Standardraten. Das ist eine echte Weggabelung für Offline-Workloads.
Grok 4.7 Fast und der 2x-Aufschlag
Grok 4.7 Fast ist dasselbe Modell, serviert mit etwa doppelter Ausgabegeschwindigkeit für den doppelten Token-Preis. Es ist nur innerhalb von Cursor und Grok Build verfügbar, nicht über die öffentliche API.
Der Tausch ist reine Latenz gegen Geld. Du zahlst 4 $ / 12 $ (oder 8 $ / 24 $ jenseits der Klippe), um Sekunden von der Antwortzeit abzuschneiden. Das lohnt sich in einer interaktiven Coding-Session, in der du zusiehst, wie Code gestreamt wird, und jede Sekunde Wartezeit den Flow bricht. Es ist Verschwendung bei Batch-Jobs, Nachtläufen oder jeder Hintergrundaufgabe, bei der niemand auf den Cursor starrt. Meine Faustregel: Fast für den Vordergrund, Standard für alles andere.
Wo du Grok 4.7 kaufen kannst (und wo nicht)
Der Kaufweg verändert den effektiven Preis mehr, als die meisten erwarten, deshalb lohnt es sich, ihn vorher zu kartieren.
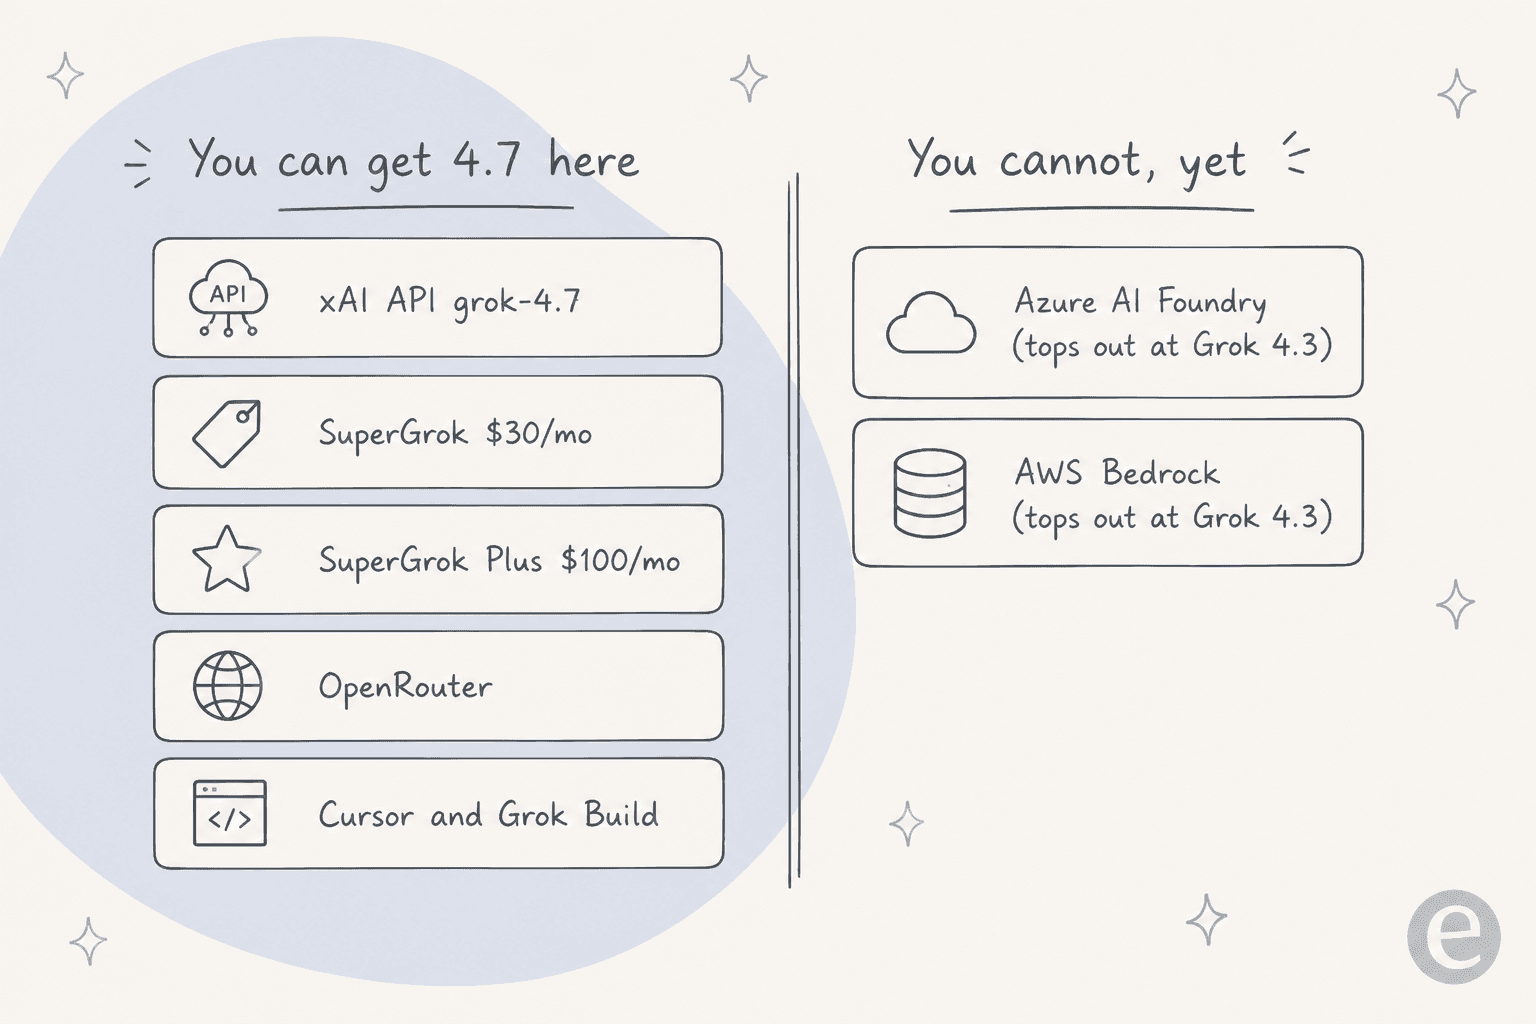
- xAI-API (
grok-4.7): der Referenzpreis, 2 $ / 6 $, und der Ort, an dem du deine Rechnung modellieren solltest. - SuperGrok und SuperGrok Plus: die Verbraucher-Abos, 30 $/Monat und 100 $/Monat. Gut für eine Person, die Grok in der App nutzt, nicht für programmatisches Volumen.
- OpenRouter: reicht Provider-Preise ohne Inferenz-Aufschlag durch, berechnet aber 5,5 % auf Guthabenkäufe (Minimum 0,80 $), und Guthaben verfallen nach einem Jahr. Sein Wert liegt in der gemessenen, realen effektiven Preisgestaltung: Bei Grok 4.6 zog starkes Caching den gewichteten Durchschnitts-Input-Preis deutlich unter den Listenpreis, ein Vorgeschmack darauf, wie 4.7 bei cache-freundlichem Traffic abgerechnet wird.
- Cursor und Grok Build: wo die Fast-Variante lebt, und ein guter Ort, um das Modell auszuprobieren, bevor man die API anbindet.
Die Lücke, die man festhalten sollte: Azure AI Foundry und AWS Bedrock bieten beide maximal Grok 4.3, zu Preisen um 1,25 $ / 2,50 $. Wenn dein Unternehmen die Beschaffung über einen Cloud-Marktplatz vorschreibt, kannst du Grok 4.7 dort überhaupt nicht kaufen, zumindest noch nicht. Das ist eine echte Einschränkung, kein Vorwurf, und genau die Art von Detail, die für Enterprise-Käufer die Modellwahl entscheidet, unabhängig von der Preistafel.
Grok 4.7 vs. GPT-6 Sol und Fable 5.1 beim Preis
Hier ist der aktuelle Vergleich, basierend auf den jeweils selbst veröffentlichten Raten der Anbieter. Zur Einordnung: xAIs eigenes Launch-Material verglich mit dem älteren GPT-5.6 Sol zu 4 $ / 20 $, aber OpenAI hat inzwischen GPT-6 Sol zum halben Preis ausgeliefert, sodass dies das aktuelle Bild ist, dem ein Käufer heute gegenübersteht.
| Modell | Input / 1 Mio. | Gecacht / 1 Mio. | Output / 1 Mio. |
|---|---|---|---|
| Grok 4.7 | 2,00 $ | 0,50 $ | 6,00 $ |
| GPT-6 Sol | 2,00 $ | 0,20 $ | 10,00 $ |
| Fable 5.1 | 10,00 $ | n/v | 50,00 $ |
Das Muster ist eindeutig. Grok 4.7 zieht bei GPT-6 Sol beim Input gleich und unterbietet es beim Output um 40 %, genau dort, wo ein gesprächiger Agent das meiste Geld ausgibt. Gegen Fable 5.1 kostet Grok pro Token nur etwa ein Fünftel. Fable führt weiterhin bei Spitzen-Coding und langwieriger Terminal-Arbeit, die eigentliche Frage ist also nie "welches ist klüger" (oft Fable), sondern "wie viel bin ich bereit, pro Grenzpunkt zu zahlen."
Umgerechnet auf einzelne Aufgaben: Eine einzelne Agenten-Runde mit 50k Input plus 10k Output kostet etwa 0,16 $ auf Grok 4.7, 0,40 $ auf GPT-6 Sol und 1,00 $ auf Fable 5.1. Führe das zehntausendmal am Tag aus, und der Unterschied ist der ganze Grund, warum Hochvolumen-Workloads standardmäßig zum günstigen Output-Modell greifen. Eine Lektion, die ich auf die harte Tour gelernt habe: Günstiger pro Token heißt nicht immer günstiger pro Aufgabe, denn ein Modell, das mehr Reasoning-Tokens ausgibt, um dieselbe Aufgabe zu erledigen, kann seinen Ratenvorteil zunichtemachen. Modelliere es an deinem eigenen Traffic mit dem Rechner oben, bevor du wechselst. Wenn du das gegen ein Premium-Modell abwägst, macht unsere Claude Opus 5.5 Preise-Analyse denselben Pro-Aufgabe-Punkt ausführlicher.
Lohnen sich die Grok 4.7 Preise?
Für alle, die Code schreiben, KI-Agenten bauen oder über die API ausliefern, wo sich Token-Kosten summieren: ja, ohne Zweifel. Die Kombination aus frontier-nahen Werten und Grok-4.6-Preisen ist der ganze Pitch, und die Fortschritte bei langwierigen Aufgaben bedeuten, dass es auch bei länger laufenden Jobs standhält, nicht nur bei One-Shot-Prompts. Wenn du den tieferen Leistungs-Blick willst, deckt unser Grok 4.7 Überblick die Benchmarks ab.
Vielnutzer bestätigen den Aspekt "ständig laufen lassen". Ein langjähriger Grok-Abonnent beschrieb, wie er es fest in alltägliche Aufgaben einbaute und dabei nie an sein Limit stieß:
"Ich lasse einen Grok-Bot meine E-Mails alle 15 Minuten überwachen und Dinge für mich ablegen. Ich habe einen weiteren Bot, der Blutbild-Ergebnisse überwacht … und ich komme nie auch nur in die Nähe, mein Kontingent auszuschöpfen."

Das ist die Form eines Modells, das für Volumen bepreist ist: Es lädt dich ein, es einfach laufen zu lassen. Wo ich die Erwartungen anpassen würde, sind die Zähler und die Klippe. Der Preis auf dem Schild ist niedrig, aber ein Agent, der bei jeder Runde sucht, abruft und Code ausführt, über Prompts, die sich Richtung 200k Tokens vorarbeiten, wird deutlich über die budgetierten "2 $ / 6 $" hinaus abgerechnet. Grok 4.7 ist günstig im Einstieg und leicht zu unterschätzen, dieselbe Falle, die jedes token-abgerechnete Modell stellt.
Token-Preise sind ein Zähler, keine planbare Rechnung
Hier ist die Neurahmung, denn das ist genau das, was ein reiner Preisvergleich übersieht. Jede Zahl in diesem Beitrag ist ein Zählerstand, keine Rechnung. Grok 4.7 ist Infrastruktur: eine brillante Maschine, die du pro Token mietest und die ohne jedes Wissen über dein Unternehmen, deine Tickets, deinen Ton oder deine Tools ankommt. Um daraus etwas zu machen, das eine echte Arbeit erledigt, muss jemand das Gerüst bauen, das Wissen anbinden, die Integrationen verdrahten, die Leitplanken schreiben, die Eskalation handhaben und dann einen Zähler im Auge behalten, der sich bei 200k Tokens selbst neu bepreist und bei jeder tausendsten Suche 5 $ hinzufügt.
Genau diese Lücke ist die ganze Idee hinter eesel. Statt eines Modells und eines leeren Gerüsts ist eesel eine Plattform für KI-Teammitglieder, bei der man einsatzbereite Teammitglieder für eine konkrete Aufgabe anheuert. Die aktuelle Besetzung umfasst ein KI-Helpdesk-Teammitglied, das sich deiner Support-Queue anschließt, und einen KI-Blog-Autor, der lange Beiträge recherchiert und entwirft. Jedes bringt bereits die Fähigkeiten, Integrationen und den Firmenkontext mit, den seine Rolle braucht, läuft dabei im Hintergrund auf Frontier-Modellen wie diesem, sodass du die Leistungsfähigkeit bekommst, ohne die Verrohrung zu besitzen, oder den Zähler.

Der Preisunterschied ist der Punkt: eesel rechnet pro gelöstem Ticket ab, nicht pro Token, sodass die Kosten der geleisteten Arbeit entsprechen, statt davon, wie gesprächig das Modell an diesem Tag war. Du prognostizierst keine Output-Tokens und umgehst keine Long-Context-Klippe, du bezahlst für Ergebnisse.
Und wenn dir Grok 4.7 gefallen hat, weil du im Terminal zu Hause bist: eesel trifft dich genau dort. Die eesel CLI bedient dasselbe Teammitglied und denselben Workspace wie das Dashboard, aber über die Kommandozeile: Eine Person kann sie ausführen, Skripte können sie automatisieren, und Coding-Agenten wie Claude Code, Codex und Cursor können sie steuern. Du kannst die Anweisungen eines Teammitglieds prüfen, eine Testnachricht senden, das JSON-Ergebnis und die Aktivität zurücklesen und eine begrenzte Änderung für die Freigabe durch einen Owner vorschlagen, alles ohne die Shell zu verlassen. Es ist derselbe Reiz von "den Agenten programmatisch bedienen", der eine rohe Modell-API attraktiv macht, nur gerichtet auf einen Mitarbeiter, der den Job schon kennt. Du kannst eesel kostenlos testen.
Häufig gestellte Fragen
Wie viel kostet Grok 4.7?
Grok 4.7 kostet 2 $ pro Million Input-Tokens, 0,50 $ pro Million gecachte Input-Tokens und 6 $ pro Million Output-Tokens für jede Anfrage, deren Prompt unter 200k Tokens liegt, laut der xAI-Preisseite. Überschreitet der Prompt 200k Tokens, verdoppeln sich die Raten auf 4 $ / 1 $ / 12 $ für jeden Token in dieser Anfrage. Das ist exakt dieselbe Preistafel wie bei Grok 4.6.
Wie hoch ist der Grok 4.7 API-Preis pro Million Tokens?
Auf der xAI-API kostet grok-4.7 2 $ Input und 6 $ Output pro Million Tokens in der Standard-Kurzkontext-Stufe. Das ist die Zahl, auf die du deine Rechnung modellieren solltest. Die Grok 4.7 Preisseite listet außerdem Tool-Call-Zähler (Web- und X-Suche, Codeausführung zu 5 $ pro 1.000 Aufrufe), die bei agentischen Workloads zusätzlich zu den Tokens anfallen.
Was ist die Grok 4.7 Long-Context-Preisklippe?
Sobald der Prompt einer Anfrage 200k Tokens oder mehr erreicht, berechnet xAI die gesamte Anfrage zum Long-Context-Satz von 4 $ / 1 $ / 12 $ pro Million, nicht nur die Tokens über 200k hinaus. Ein 210k-Token-Prompt wird vollständig zum höheren Satz abgerechnet. xAI bietet eine Context Compaction API, um Konversationen zu verkleinern, bevor sie über die Klippe kippen.
Was ist Grok 4.7 Fast und wie viel mehr kostet es?
Grok 4.7 Fast ist dasselbe Modell, serviert mit etwa doppelter Ausgabegeschwindigkeit für den doppelten Token-Preis. Es ist nur innerhalb von Cursor und Grok Build verfügbar, nicht über die öffentliche API. Es lohnt sich, wenn Latenz zählt, etwa beim Zusehen, wie Code gestreamt wird, und ist Verschwendung bei Batch- oder Hintergrundjobs.
Ist Grok 4.7 günstiger als GPT-6 Sol oder Fable 5.1?
Bei den Output-Tokens ja. Grok 4.7 kostet 2 $ / 6 $, GPT-6 Sol kostet 2 $ / 10 $, und Fable 5.1 kostet 10 $ / 50 $. Grok zieht bei GPT-6 Sol beim Input gleich und unterbietet es beim Output um 40 %, und es ist nur ein Bruchteil von Fables Satz. Für Hochvolumen-Agentenarbeit ist Grok 4.7 in der Regel die günstigste Frontier-Klasse-Option.
Wie viel kostet Grok 4.7 für Verbraucher?
Auf x.ai/pricing ist die günstigste kostenpflichtige Stufe, die den aktuellsten Grok nennt, SuperGrok für 30 $/Monat, mit SuperGrok Plus für 100 $/Monat. Es gibt eine kostenlose Stufe mit Limits. Wenn du Grok 4.7 stattdessen programmatisch aufrufen willst, ist das der 2-$-/6-$-API-Preis, nicht das Abo.
Kann ich Grok 4.7 auf Azure oder AWS Bedrock nutzen?
Noch nicht. Azure AI Foundry und AWS Bedrock bieten zum Zeitpunkt der Veröffentlichung beide maximal Grok 4.3, sodass ein Käufer mit Cloud-Vorgabe Grok 4.7 dort nicht beziehen kann. Du erreichst es über die xAI-API, über OpenRouter oder innerhalb von Cursor und Grok Build.
Lohnen sich die Grok 4.7 Preise im Vergleich zur Bezahlung pro Ergebnis?
Token-Preise belohnen dich für optimierte Prompts und bestrafen dich für langen Kontext, sodass deine Rechnung nur so planbar ist wie dein Traffic. Wenn du lieber pro gelöstem Ticket als pro Token bezahlen willst, läuft ein KI-Teammitglied wie eesel im Hintergrund auf Frontier-Modellen, rechnet aber pro Ergebnis ab, sodass die Kosten der geleisteten Arbeit entsprechen.


Article by
Kurnia Kharisma Agung Samiadjie
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.