Was Grok 4.7 ist
Grok 4.7 ist xAIs Flaggschiff-Modell für Code, Agenten und Wissensarbeit, veröffentlicht als grok-4.7 auf der xAI-API. Es behält das 500k-Token-Kontextfenster von Grok 4.6, nimmt Text und Bild entgegen und gibt Text zurück, und bietet konfigurierbaren Reasoning-Aufwand in den Stufen niedrig, mittel, hoch und xHoch. Sein Wissensstand endet im Mai 2026, und wie jedes Grok-Modell hat es keine Live-Ereignis-Kenntnis, sofern du nicht die serverseitigen Web- und X-Suchwerkzeuge aktivierst.
Der eigentlich interessante Teil ist der Bau selbst. xAI trainierte 4.7 auf einem neuen, größeren Basismodell als 4.6 und fuhr dann einen längeren Reinforcement-Learning-Durchlauf auf einem schwierigeren Aufgabenmix, der auf Probleme ausgerichtet ist, die viele Stunden dauern. Es wurde außerdem trainiert, das Grok-Bot-Harness nativ zu verstehen, weshalb es sich bei mehrstufiger, werkzeugnutzender Arbeit flüssiger anfühlt, als ein rohes Chat-Modell es normalerweise tut. Ein brandneues API-Feature erscheint zusammen damit: eine Context-Compaction-API, um lange Verläufe wieder unter die Preis-Schwelle zu drücken.
Grok 4.7 ist das Text-und-Code-Gehirn eines breiteren Lineups, und dieser Test dreht sich nur um dieses Modell. Falls du nach den anderen Teilen suchst: xAI trennt sie auf: Grok Imagine übernimmt Bild und Video, die Grok-Voice-API übernimmt Sprache, und die Agenten-Builder-Seite lebt in Grok Bot. Alles Folgende bezieht sich allein auf grok-4.7.
Was sich gegenüber Grok 4.6 tatsächlich geändert hat
Das Upgrade von Grok 4.5 auf 4.6 war inkrementell, wie der Grok-4.5-Test feststellte. Der Sprung zu 4.7 ist das nicht, zumindest nicht an einer Stelle. Am klarsten sieht man das an den von xAI veröffentlichten Benchmark-Deltas.
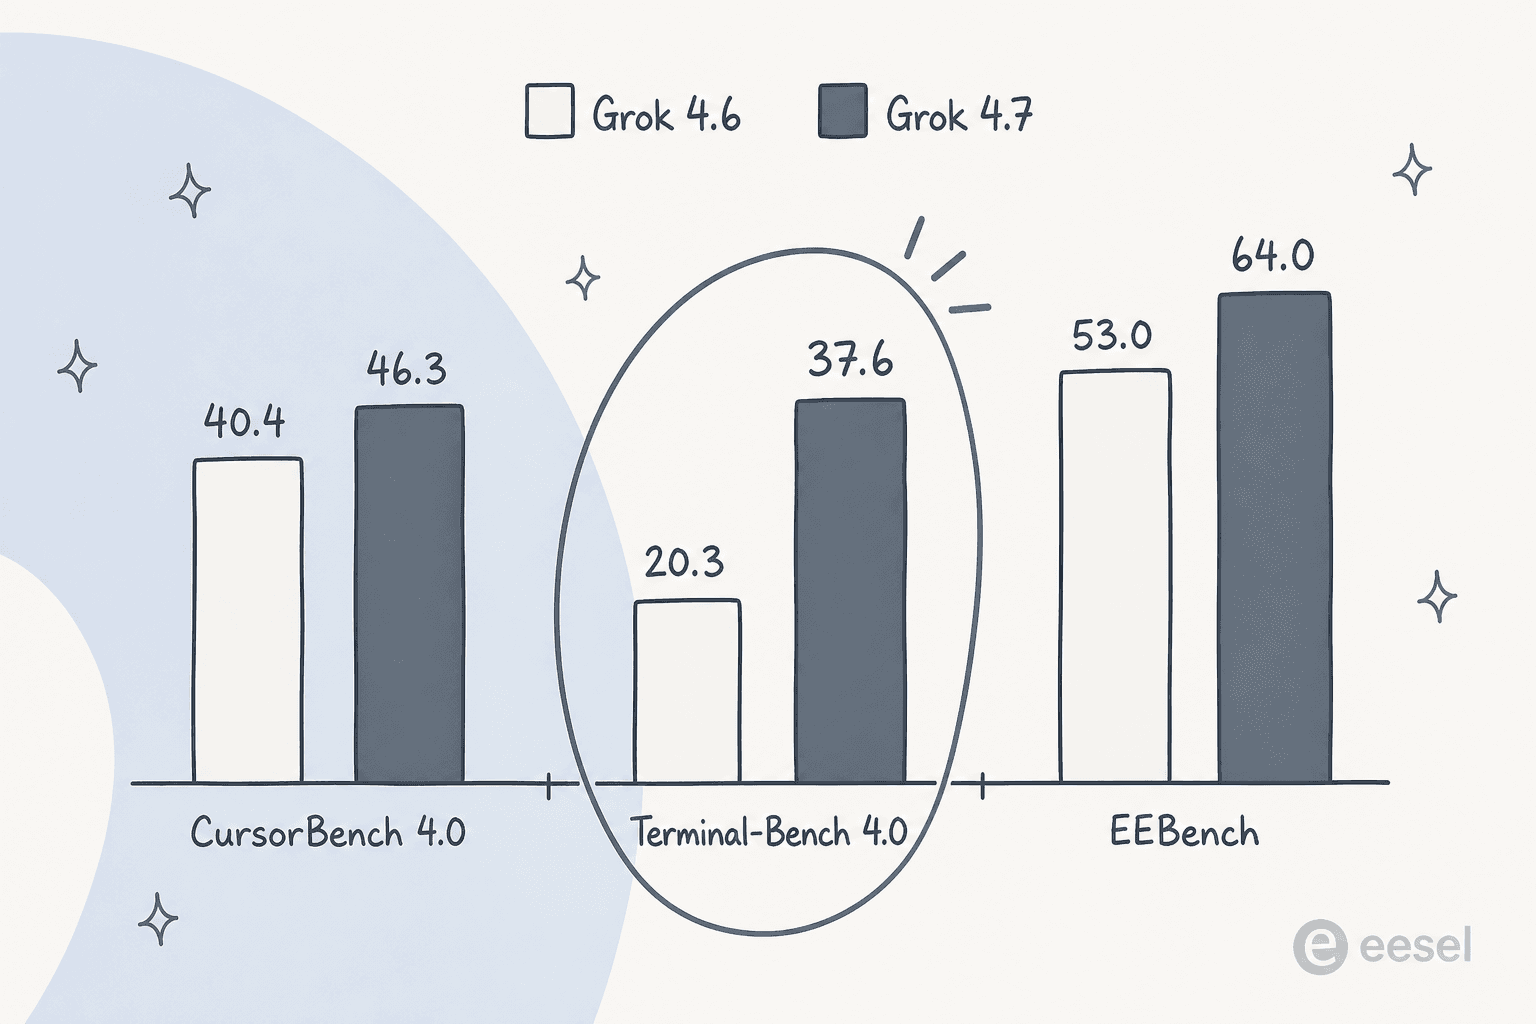
CursorBench 4.0 stieg von 40,4 auf 46,3, und EEBench (Elektrotechnik) von 53,0 auf 64,0. Das sind solide Werte. Der Ausreißer ist Terminal-Bench 4.0, das sich von 20,3 auf 37,6 nahezu verdoppelte, der größte Zuwachs von 4.6 zu 4.7 überhaupt und ein direkter Indikator dafür, wie gut das Modell lange, mehrstufige Terminal-Arbeit durchhält, ohne den Faden zu verlieren. Wenn dein Anwendungsfall ein Agent ist, der sich durch eine echte Aufgabenliste arbeitet statt nur einen Prompt zu beantworten, ist das die Zahl, die zählt, und es ist die Zahl, die der Grok-4.6-Test dir noch nicht zeigen konnte.
Die restlichen Verbesserungen sind leiser: bessere Selbstüberprüfung, stabilere Handhabung langer Kontexte und stärkere Dokument- und Präsentationsausgaben, was sich in Zuwächsen bei den Professional-Work-Benchmarks GDPval und AA Briefcase niederschlägt. Nichts davon gibt es woanders gratis, und hier kommt es zum gleichen Preis.
Die Benchmarks, ehrlich gelesen
xAI hat Grok 4.7 xHigh gegen Grok 4.6 High, GPT-5.6 Sol Max und Fable 5.1 Max gebenchmarkt. Hier ist die Haupttabelle, direkt von der Launch-Seite, damit du sehen kannst, wo 4.7 gewinnt und wo nicht.
| Benchmark | Grok 4.7 | Grok 4.6 | GPT-5.6 Sol | Fable 5.1 |
|---|---|---|---|---|
| Eingabe $/1M | $2 | $2 | $4 | $10 |
| Ausgabe $/1M | $6 | $6 | $20 | $50 |
| CursorBench 4.0 | 46.3 | 40.4 | 41.7 | 51.8 |
| DeepSWE v1.1 | 71.0* | 65.2 | 72.7 | 70.0 |
| Terminal-Bench 4.0 | 37.6 | 20.3 | 37.3 | 57.9 |
| EEBench | 64.0 | 53.0 | 39.4 | 56.4 |
| AA Briefcase v1.1 (Elo) | 1657 | 1546 | 1487 | 1678 |
| Harvey Legal Agent | 19.6 | 15.8 | 2.5 | 6.7 |
| HealthBench Professional | 56.7 | 48.5 | 60.5 | 62.1 |
*Wert bei hohem Aufwand. Quelle: xAI, Grok-4.7-Launch.
Liest man das fair, ist das Bild klar. Grok 4.7 gewinnt klar bei EEBench und dem Harvey-Legal-Agent-Benchmark, wo es Fables Wert mehr als verdoppelt, und ist überall wettbewerbsfähig. Aber Fable 5.1 führt bei CursorBench, Terminal-Bench und AA Briefcase, GPT-5.6 Sol liegt bei DeepSWE knapp vorn, und bei HealthBench Professional verliert Grok 4.7 gegen beide. Wenn dein Job also Spitzen-Coding-Genauigkeit oder klinisches Reasoning ist und Budget keine Rolle spielt, ist Grok 4.7 nicht die Wahl. Wenn dein Job darin besteht, diese Fähigkeit im großen Volumen zu betreiben, entscheidet die nächste Grafik.
Der Preis ist das ganze Argument
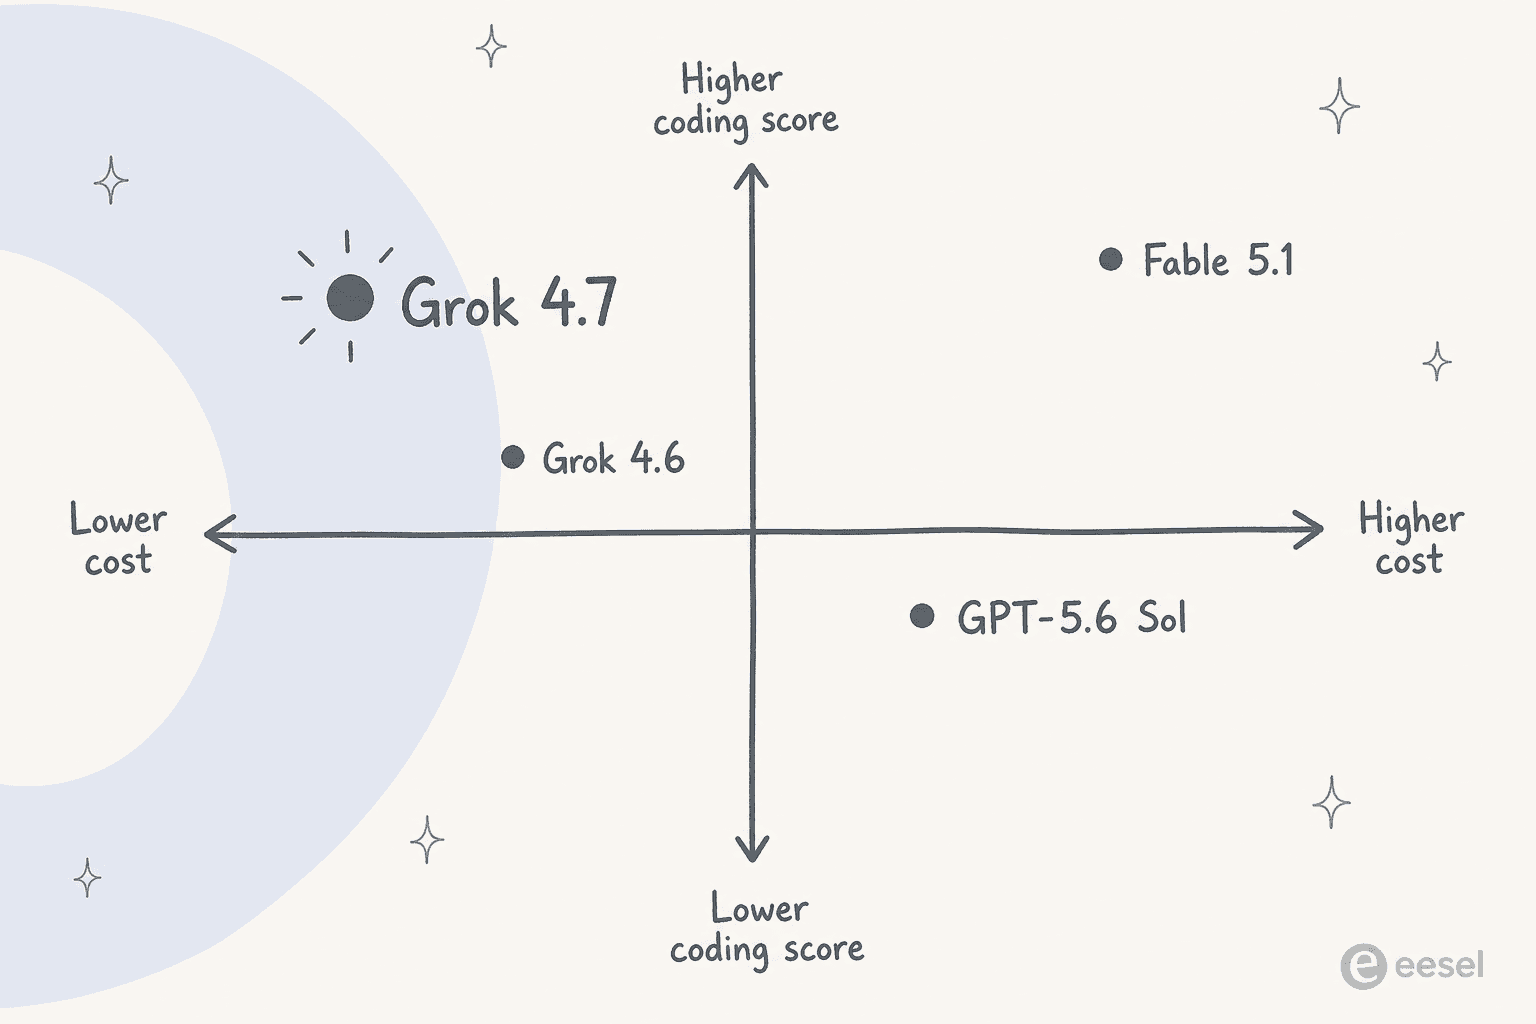
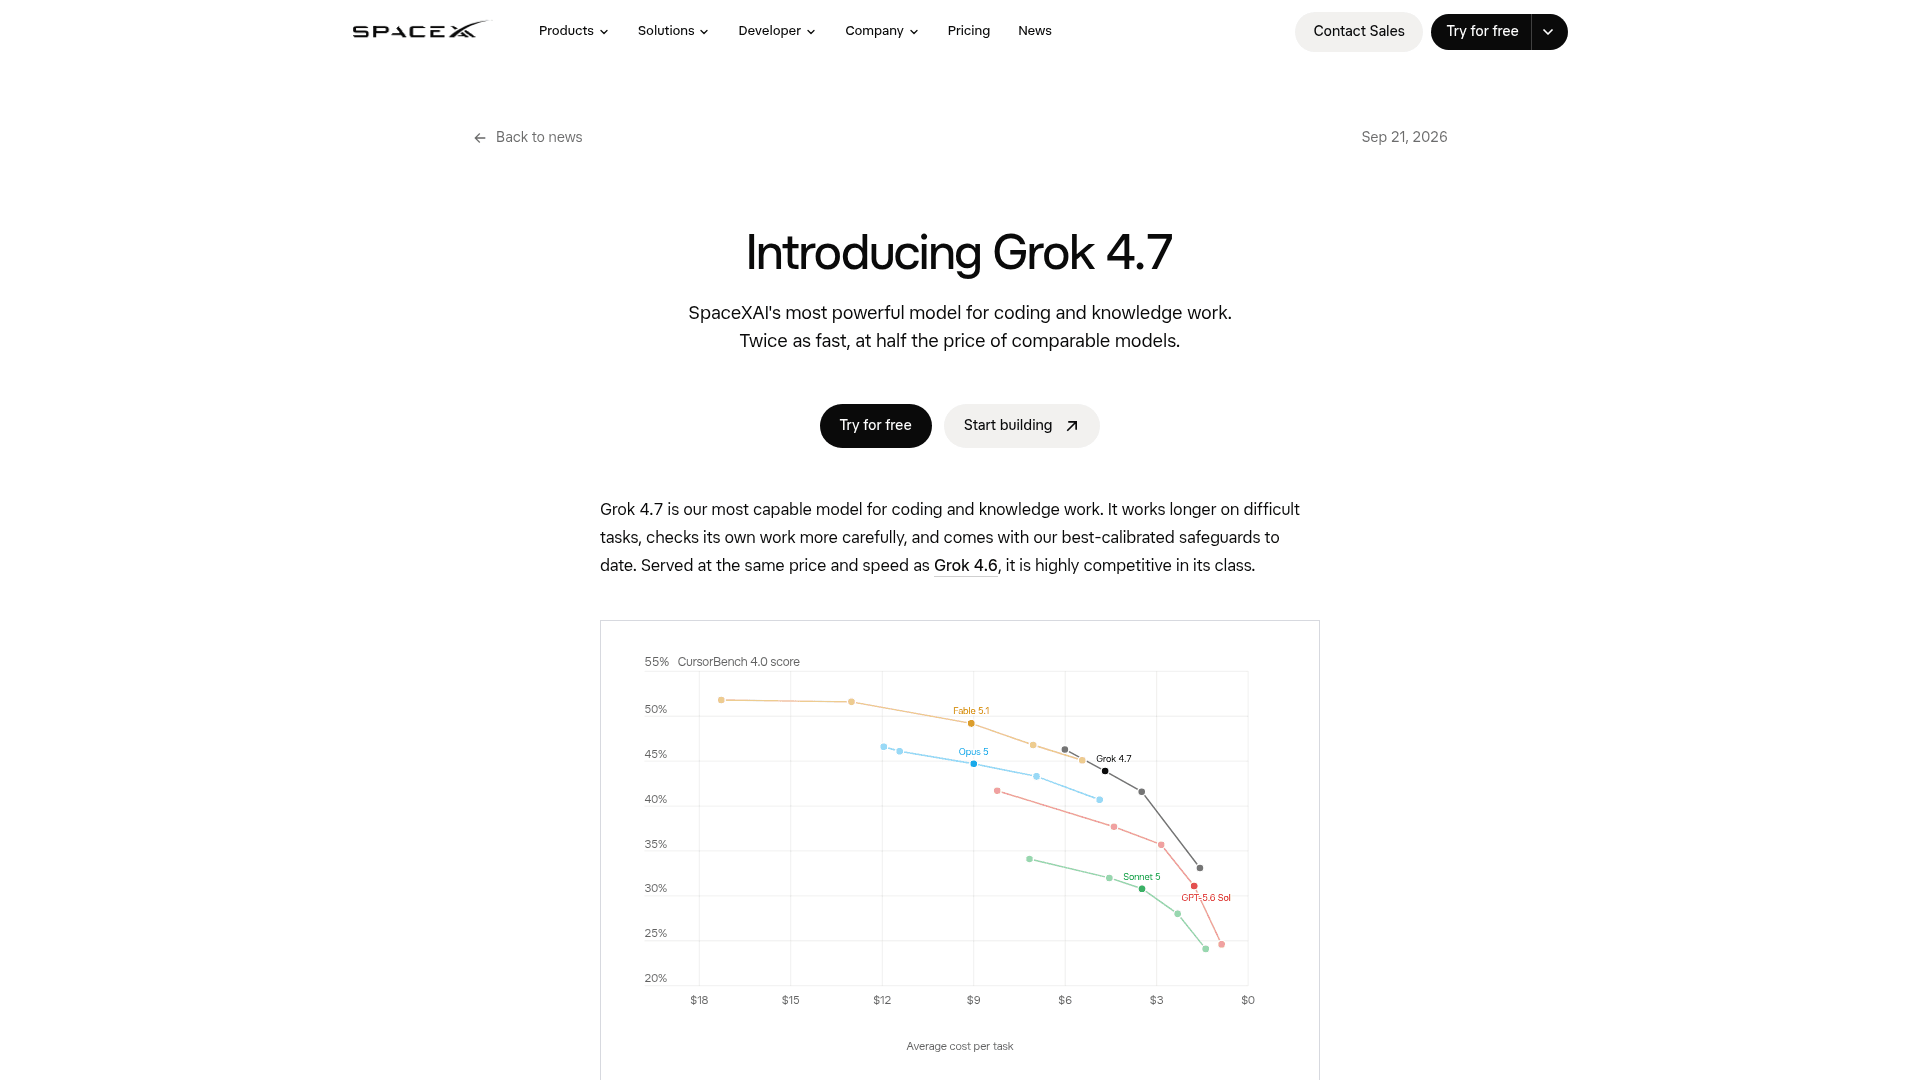
Grok 4.7 liefert in etwa Fable-nahe Fähigkeit zum Grok-4.6-Preis. Konkret kostet eine Aufgabe, die 50k Token liest und 10k schreibt, etwa 0,16 $ mit Grok 4.7 gegenüber 0,40 $ mit GPT-5.6 Sol und 1,00 $ mit Fable 5.1. Multipliziere das mit einem Agenten, der Tausende Läufe am Tag macht, und die Modellwahl hört auf, eine Frage der Benchmark-Nachkommastelle zu sein, und wird zu einer Frage deiner Rechnung.
Zwei Vorbehalte, um ehrlich zu bleiben. Erstens die 200k-Schwelle: Überschreitet man 200k Prompt-Token, verdoppelt sich die Rate auf 4 $ / 1 $ / 12 $, angewendet auf jedes Token der Anfrage, nicht nur den Überschuss, wofür genau die Context-Compaction-API existiert. Zweitens verglich die Launch-Grafik mit dem alten GPT-5.6 Sol bei 4 $ / 20 $, aber OpenAI brachte am Tag danach GPT-6 Sol für 2 $ / 10 $ heraus, sodass die aktuelle Output-Preislücke bei 40% liegt, nicht bei den 70%, die die Grafik nahelegt. Die xAI-Preise sind in ihrer Klasse trotzdem am stärksten, nur nicht mit so großem Abstand, wie die Folie suggeriert. Die vollständige Aufschlüsselung pro Zähler steht im Guide zu den Grok-4.7-Preisen.
Dann ist da noch der Fast-Variante-Aufpreis, den man kennen sollte. Grok 4.7 Fast ist dasselbe Modell mit doppelter Ausgabegeschwindigkeit zum doppelten Token-Preis, und es existiert nur innerhalb von Cursor und Grok Build, nicht in der öffentlichen API. Er lohnt sich, wenn du Code live mitverfolgst und Latenz schmerzt; er ist verbranntes Geld bei Batch- oder Nachtjobs, bei denen niemand wartet.
Ich betreibe Agenten mit hohem Volumen (Tool-Calling, Terminal-Arbeit)
Ja, wechseln. Das ist der Sweet Spot. Der Terminal-Bench-Sprung plus 2 $ / 6 $ Preise sind genau das, was eine Agenten-Schleife will. Achte auf die 200k-Schwelle und nutze Context Compaction.
Ich brauche die beste Coding-Genauigkeit, Kosten egal
Bleib für die härtesten Aufgaben bei Fable 5.1. Viele Teams routen den Großteil der Arbeit zu Grok 4.7 und eskalieren nur die Spitzenfälle an ein teureres Modell.
Ich mache klinisches oder gesundheitssensibles Reasoning
Nicht die Wahl. Grok 4.7 liegt bei HealthBench Professional hinter GPT-5.6 Sol und Fable 5.1. Entscheide anhand dieses Benchmarks, nicht des Preises.
Ich will, dass KI Support-Tickets beantwortet oder meinen Blog schreibt
Ein rohes Modell ist die falsche Ebene. Du willst einen Mitarbeiter, der dein Produkt schon kennt und sich in deine Tools einklinkt. Springe zum letzten Abschnitt.
Sicherheit, die xAI diesmal ernst genommen hat
Einen Absatz wert, weil es eine echte Verschiebung ist. Grok 4.7 kam mit einem komplett neuen Sicherheits-Stack heraus und ist, nach xAIs eigenen Tests, sein stärkstes Modell bei Verweigerungen und Jailbreak-Widerstand. Bei HackerBench v0.3 lässt es nur 3,3% riskanter Dual-Use-Prompts durch, während es legitime Sicherheitsarbeit selten blockiert, und es führt LatchBios Biosafety-Benchmark mit 62,4% an. xAI hat zudem begonnen, ausgewählten Cybersicherheits-Partnern Einladungs-Zugang zu den Red-Team-Fähigkeiten des Modells zu geben. Für ein Unternehmen, dessen frühere Modelle genau auf dieser Achse Kritik erhielten, ist das eine bedeutsame, überprüfbare Verbesserung statt einer Pressemitteilungs-Zeile.
Was Leute, die tatsächlich damit bauen, sagen
Benchmarks sind xAIs Erzählung. Hier ist, was unabhängige Entwickler berichten. Das nützlichste Signal, das ich gefunden habe, betraf den Umfang: Das Modell setzt kleine Dinge wunderbar in einem Schuss um, und die Begeisterung kühlt bei großen bestehenden Codebasen ab.
"I agree, the models keep getting better at one shotting. That's useful in a lot of situations, like for small one-off scripts that filter/transform some tool call, or make a clever bash call. For the code itself, it doesn't help me much though."

Das deckt sich mit der Benchmark-Form: stark bei begrenzten, gut spezifizierten Aufgaben, weniger magisch, wenn der Job "verstehe dieses 200k-Zeilen-Repo" lautet. Das andere wiederkehrende Thema ist, dass Vielnutzer selten an die Nutzungsgrenze stoßen, was zählt, wenn du von Credit-Obergrenzen bei anderen Tools schon einmal gebrannt wurdest.
"I use the crap out of Grok in my daily life, including to build a couple self-hosted apps as an amateur. I have a Grok bot monitor my email every 15 minutes and file things away for me... and I never even get close to using my quota."
Beide passen zum roten Faden dieses Tests: Als günstiger, durchsatzstarker Motor, auf den man sich den ganzen Tag verlassen kann, liefert Grok 4.7. Was keiner der beiden Kommentatoren beschreibt, ist ein System, das schon ihr Unternehmen kennt, wenn es auftaucht, und genau die Lücke will ich im letzten Abschnitt schließen.
Wer Grok 4.7 nutzen sollte
Greife danach, wenn du Code schreibst, Agenten betreibst oder auf der API baust und dir Kosten pro Aufgabe wichtig sind, was auf die meisten Leute zutrifft, die 2026 KI-Produkte bauen. Es ist die natürliche Standardwahl für hochvolumige Agenten-Schleifen und eine kluge Basisebene, selbst wenn du die schwierigsten 5% der Jobs an Claude Opus 5 oder Fable eskalierst. Im Vergleich zum Rest des günstigen Spitzenfelds ist es ein stärkerer Allrounder bei agentischer Arbeit als Kimi K3 oder DeepSeek V4 Flash.
Es schlägt außerdem Qwen bei Terminal-Aufgaben und unterbietet GPT-5.6 Sol beim Preis, während es beim Großteil des Codings mithält. In einem Editor läuft es in Cursor, sodass es im Alltag mit denselben Tools konkurriert, über die diese Community ohnehin schon streitet.
Überspring es, oder führe es zumindest nicht als Erstes an, wenn du unabhängig vom Budget Spitzen-Coding-Genauigkeit brauchst, wenn deine Arbeit klinisch ist, oder wenn das, was du eigentlich willst, gar kein Modell ist, sondern eine erledigte Aufgabe. Dieser letzte Fall ist häufiger, als es die Modell-Test-Rahmung zugibt, und dort will ich direkt werden.
Der Teil, den ein Modell-Test normalerweise auslässt: Ein Motor ist kein Mitarbeiter
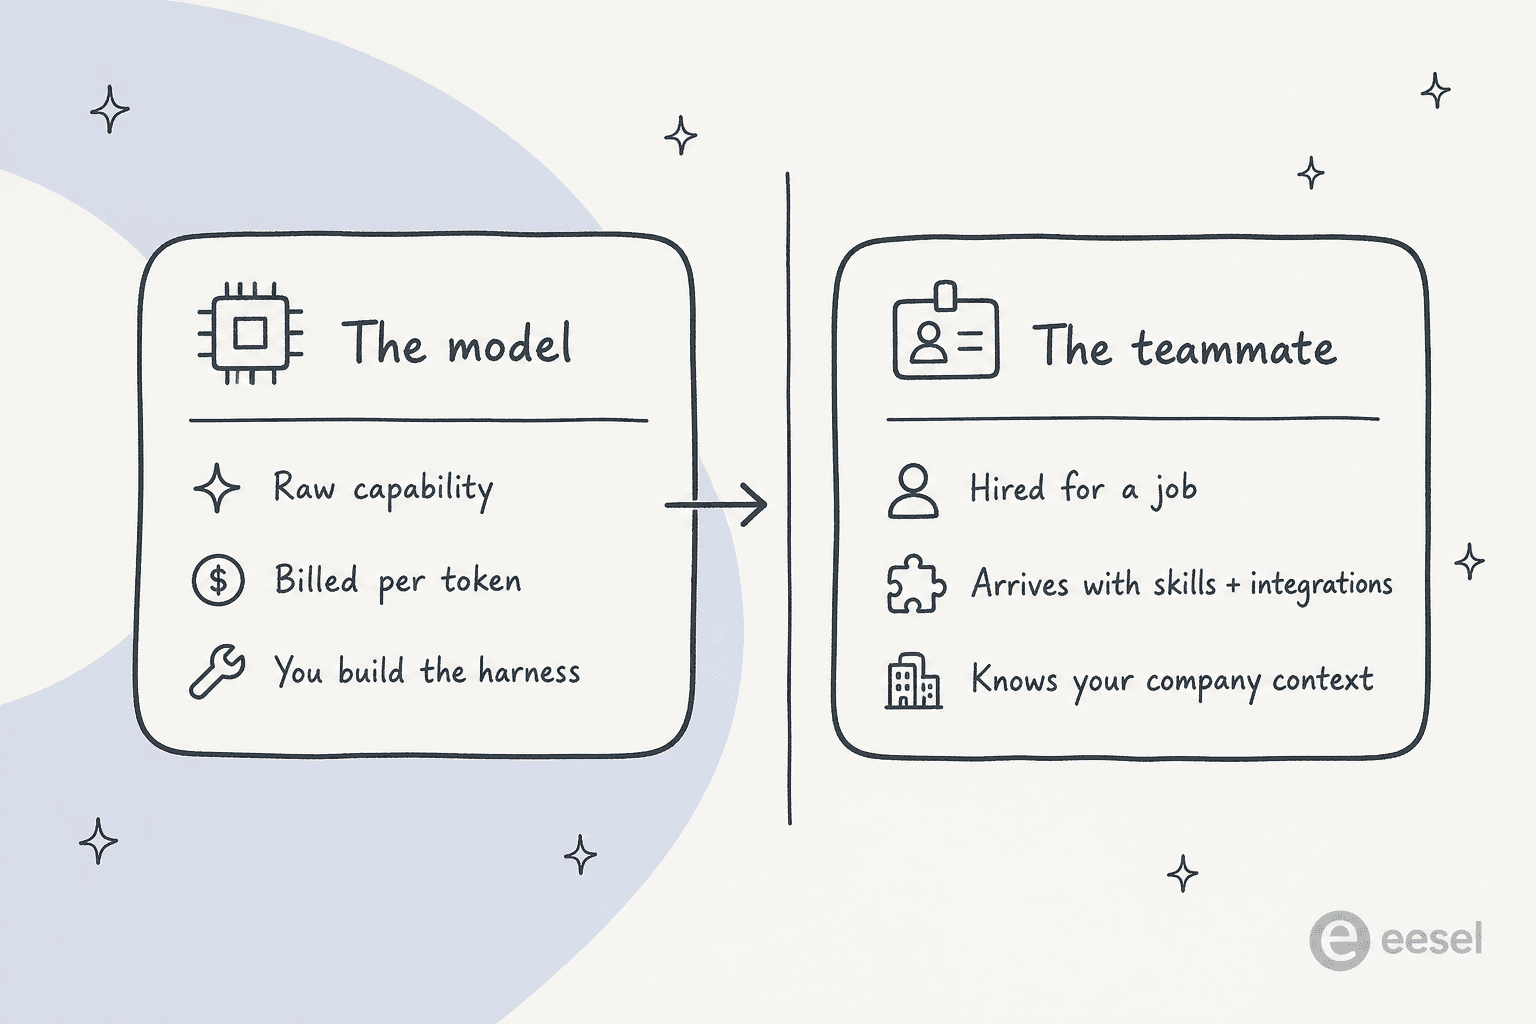
Hier ist, was mich drei Jahre KI auf echten Support-Warteschlangen gelehrt haben. Ein Spitzenmodell ist ein unglaublich fähiger Motor, und ein Motor ist nicht dasselbe wie ein Mitarbeiter. Grok 4.7 gibt dir rohe Intelligenz pro Token. Es kennt deine Rückerstattungsrichtlinie nicht, es ist nicht mit deinem Helpdesk verbunden, es hat deine früheren Tickets nie gesehen, und es wird von sich aus nicht entscheiden, welche Fragen es sicher genug beantworten kann und welche es einem Menschen überlassen sollte. All das zu verkabeln ist ein echtes Projekt, und genau dazu schweigt der Benchmark-Wert.
Das ist eine Build-versus-Buy-Entscheidung, die früher oder später bei jedem Team landet. Ein Kunde, ein Infrastrukturunternehmen, brachte es so auf den Punkt:
"We could try to write our own LLM application but we didn't want to invest our time into that. We wanted something that we would not have to maintain."
Das ist die Lücke, die eesel schließen soll. eesel ist eine Plattform für KI-Mitarbeiter, und du stellst einsatzbereite Mitarbeiter für konkrete Jobs ein, statt rohe Token zu mieten. Das aktuelle Angebot umfasst einen KI-Helpdesk-Mitarbeiter, der sich in deine bestehende Support-Warteschlange einreiht, und einen KI-Blog-Autor, der neben den besten KI-Schreibtools für recherchestarke Inhalte steht. Jeder von ihnen kommt bereits auf Spitzenmodellen aufgebaut, und bringt bereits die Fähigkeiten, Integrationen und den Unternehmenskontext für seine Rolle mit.
Der Support-Mitarbeiter trainiert auf deinen historischen Tickets, entwirft Antworten oder beantwortet vollständig in deinem Ton, und übernimmt nur, wobei er sich sicher ist, genau die Kontrolle, die dich der Modell-pro-Token-Ansatz selbst konstruieren lässt. Dieser Unterschied ist das ganze Argument in KI-Agent versus regelbasierter Chatbot, und deshalb ist KI für den Kundenservice eine Produktkategorie und nicht nur ein Prompt.
Der Beweis liegt in der Warteschlange, nicht im Benchmark. Ein Kunde, eine Mobilitätsplattform, sah, wie eesel 73% der Tier-1-Anfragen löste, im ersten Monat, und ein anderer berichtete von bis zu 80% Zeitersparnis im Support. Das sind Zahlen, die man von einem Mitarbeiter bekommt, der den Job kennt, nicht von einem Modell, das gut bei Terminal-Bench abgeschnitten hat. Wenn du noch die Kostenseite abwägst, sind die Aufschlüsselung KI-Agent versus menschliche Kosten und die breitere Landschaft KI-Kundenservice-Software die Stücke, die ich als Nächstes lesen würde.
Wenn du das Modell tatsächlich selbst steuern willst
Für die Entwickler, an die sich Grok 4.7 richtet, gibt es einen Mittelweg, den man kennen sollte. eesel bietet ein Kommandozeilen-Interface und einen MCP-Server, die denselben Mitarbeiter und Arbeitsbereich auf agentenfreundliche Weise zugänglich machen. Eine Person kann es vom Terminal aus steuern, Skripte können es automatisieren, und Coding-Agenten wie Claude Code, Codex und Cursor können es direkt bedienen. So bekommst du die programmierbare, headless Kontrolle, die dich überhaupt erst an einer rohen API interessiert hat, aber gerichtet auf einen Mitarbeiter, der dein Unternehmen schon kennt, statt ein leeres Modell, das du bei jedem Lauf neu einlernen musst. Es ist derselbe Gedanke hinter dem Automatisieren der Ticket-Triage aus dem Code heraus statt durch Klicken in einem Dashboard.
Willst du es an deinen eigenen Tickets sehen? eesel klinkt sich in Minuten in deinen Helpdesk ein, trainiert auf deiner Historie und lässt dich gegen Tausende vergangener Tickets simulieren, bevor es ein einziges echtes beantwortet. Kostenlos testbar.

Mein Fazit
Grok 4.7 lässt sich leicht empfehlen für das, was es ist: das beste Preis-Leistungs-Verhältnis an der Spitze, besonders für Agenten und hochvolumiges Coding. Es ist nicht auf jeder Achse das schlaueste Modell, und die Launch-Grafik überzeichnet die Preislücke inzwischen, da GPT-6 Sol existiert, aber für kostensensible Arbeit ist es das, wonach ich zuerst greifen würde. Behalte nur im Kopf, was du kaufst. Ein Modell gibt dir Fähigkeit pro Token. Wenn du eine zuverlässig erledigte Aufgabe brauchst, braucht es einen Mitarbeiter, und das ist ein ganz anderer Kauf.
Häufig gestellte Fragen
Ist Grok 4.7 gut?
Für Coding und agentische Arbeit zu geringen Kosten: ja. In meinem Grok-4.7-Test erzielt es den größten Sprung aller jüngeren xAI-Releases bei lang laufenden Terminal-Aufgaben und hält eine Spitzenposition beim Preis-Leistungs-Verhältnis. Es ist nicht in jeder Tabelle das schlaueste Modell, da Claudes Fable 5.1 bei Spitzen-Coding und Terminal-Arbeit weiterhin führt, aber es ist das beste Preis-Leistungs-Verhältnis in seiner Klasse.
Wie viel kostet Grok 4.7?
Grok 4.7 kostet 2 $ pro Million Input-Token, 0,50 $ für gecachte Token und 6 $ für Output unter 200k Prompt-Token, danach 4 $ / 1 $ / 12 $ sobald eine Anfrage 200k überschreitet, laut der xAI-Preisseite. Das ist identisch mit Grok 4.6. Die vollständige Aufschlüsselung, einschließlich der Zähler für Suche und Codeausführung, findest du im Guide zu den Grok-4.7-Preisen.
Ist Grok 4.7 besser als GPT-5.6 Sol?
Auf xAIs eigenem Benchmark-Set schlägt Grok 4.7 GPT-5.6 Sol bei den meisten Coding- und agentischen Aufgaben, und das für einen Bruchteil des Preises, wobei Sol beim klinischen Reasoning knapp vorne liegt. Zu beachten ist, dass OpenAI inzwischen GPT-6 Sol für 2 $ / 10 $ veröffentlicht hat, sodass die aktuelle Preislücke enger ist, als es die Launch-Grafik nahelegt.
Was ist der Unterschied zwischen Grok 4.7 und Grok 4.6?
Grok 4.7 läuft auf einem größeren Basismodell und einem längeren Reinforcement-Learning-Lauf, der auf mehrstündige Aufgaben ausgerichtet ist. Es erzielt die größten Gewinne bei Terminal-Bench 4.0 und verdoppelt dort nahezu den 4.6-Wert. Beide behalten das 500k-Kontextfenster und dieselben Preise, das ist also ein kostenloser Fähigkeitszuwachs. Der Grok-4.6-Test deckt das vorherige Release ab.
Ist Grok 4.7 gut für Coding?
Coding ist seine Hauptstärke. Es erreicht 46,3% im CursorBench 4.0 und schlägt Grok 4.6 in jedem von xAI veröffentlichten Software-Benchmark. Es läuft in Cursor und Grok Build, und Entwickler aus der Community berichten, dass es besonders stark beim One-Shot-Erstellen von Skripten ist, auch wenn es bei großen bestehenden Codebasen weniger transformativ wirkt.
Was ist Grok 4.7 Fast?
Grok 4.7 Fast ist dasselbe Modell mit doppelter Ausgabegeschwindigkeit zum doppelten Token-Preis, verfügbar nur in Cursor und Grok Build, nicht über die öffentliche API. Der Aufpreis lohnt sich, wenn Latenz zählt, etwa beim Live-Mitverfolgen von Code, und ist verzichtbar bei Batch- oder Hintergrundjobs. Siehe die Übersicht zu den xAI-Preisen.
Wie greife ich auf Grok 4.7 zu?
Du kannst es über die xAI-API als grok-4.7 aufrufen, es kostenlos in Grok Build nutzen oder es in Cursor erreichen. Wenn du diese Intelligenz lieber für eine definierte Aufgabe statt als rohe Token willst, verpackt ein KI-Mitarbeiter ein Spitzenmodell mit den Fähigkeiten, Integrationen und dem Unternehmenskontext für eine echte Rolle wie Support-Automatisierung.


Article by
Rama Adi Nugraha
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.