Der Fehler, den alle bei der ersten Integration machen
Ich baue Integrationen bei eesel, und ich kann dir sagen: Die erste Schätzung für jede KI-Agent-Integration liegt fast immer in dieselbe Richtung daneben.
Jemand liest die API-Docs eines Anbieters, sieht eine saubere Liste von Endpunkten und umreißt die Arbeit als „diesen Endpunkt aufrufen, die Antwort ans Modell füttern, fertig". Dann fängt man an, und eine ganze Woche verschwindet in Webhook-Lifecycles, doppelten Events und einem Berechtigungsmodell, das niemand vorher auf dem Whiteboard skizziert hat. Die API-Referenz war der leichte Teil. Sie ist die Landkarte eines Landes, das du trotzdem noch selbst durchqueren musst.
Ich habe Jahre damit verbracht, KI-Agenten auf Live-Systeme zu setzen, über tausende reale Integrationen hinweg, und das Muster bestätigt sich jedes Mal. Statt eines weiteren „So machst du einen POST-Request"-Tutorials geht es in diesem Beitrag deshalb um die Form der gesamten Aufgabe: woraus eine KI-Agent-API-Integration wirklich besteht, wo die Zeit tatsächlich hingeht, und die zwei oder drei Entscheidungen, die dir am meisten Schmerz ersparen.
Eine KI-Agent-Integration besteht aus drei Ebenen, nicht aus einer
Die nützlichste Neurahmung überhaupt: Eine Integration ist nicht „eine Verbindung zu einem Tool". Es sind bis zu drei getrennte Dinge, die du dem Agenten gibst, und sie sind unabhängig voneinander.
- Quellen sind das, was der Agent lesen kann: Tickets, Hilfe-Center-Artikel, vergangene Konversationen, eine Wissensdatenbank. Das ist die Retrieval-Seite, der Kontext, über den der Agent nachdenkt.
- Trigger sind die Gründe, aus denen der Agent aufwacht: ein neues Ticket kommt rein, jemand erwähnt ihn mit @, ein Webhook feuert, ein Zeitplan läuft ab.
- Aktionen sind die Dinge, die er zurück tun darf: eine Antwort entwerfen, ein Ticket taggen, eskalieren, einen Datensatz aktualisieren, eine andere API ansprechen.
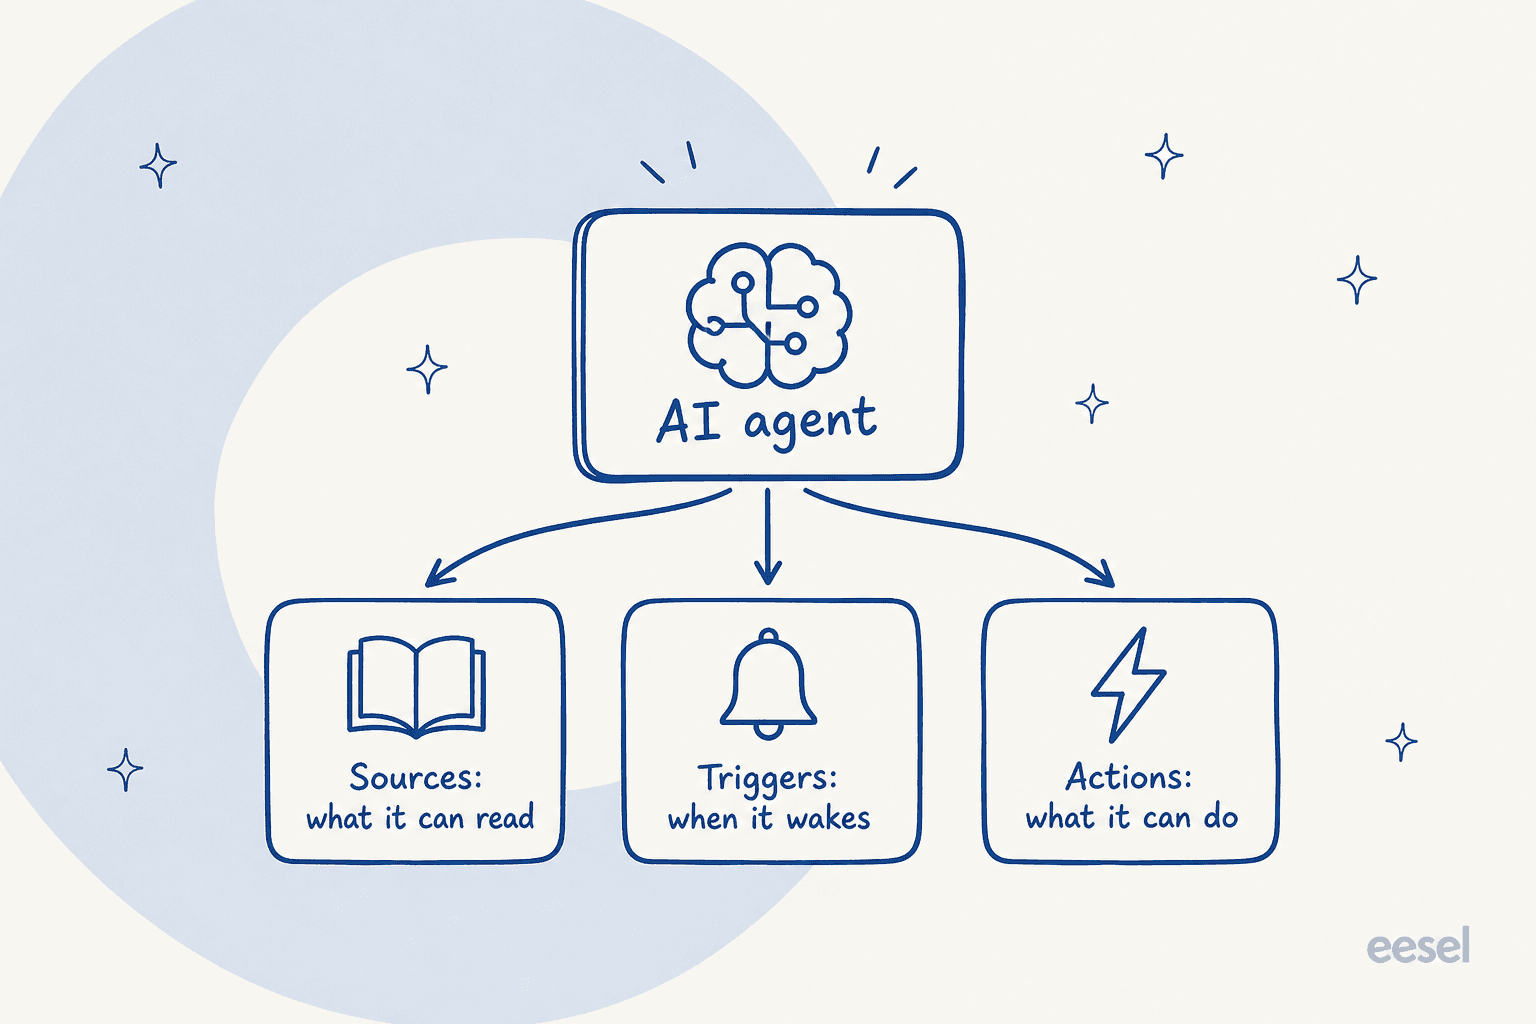
Hier ist das, was sich zu verinnerlichen lohnt: Ein System kann dir eine, zwei oder alle drei geben, und jede ist eine andere Art von Arbeit. Das Anbinden einer Doku-Seite ist meist nur Quellen. Das Anbinden eines Helpdesks ist oft alle drei. Und „X integrieren", ohne zu sagen, welche der drei du meinst, ist genau der Grund, warum Schätzungen aus dem Ruder laufen. Auf der eesel-Integrationsseite lautet der Untertitel, auf den das Team gekommen ist, wörtlich „Integrationen verbinden, um deinem Agenten Wissensquellen, Trigger und Aktionen zu geben", weil genau dieses Framing die Arbeit greifbar macht.
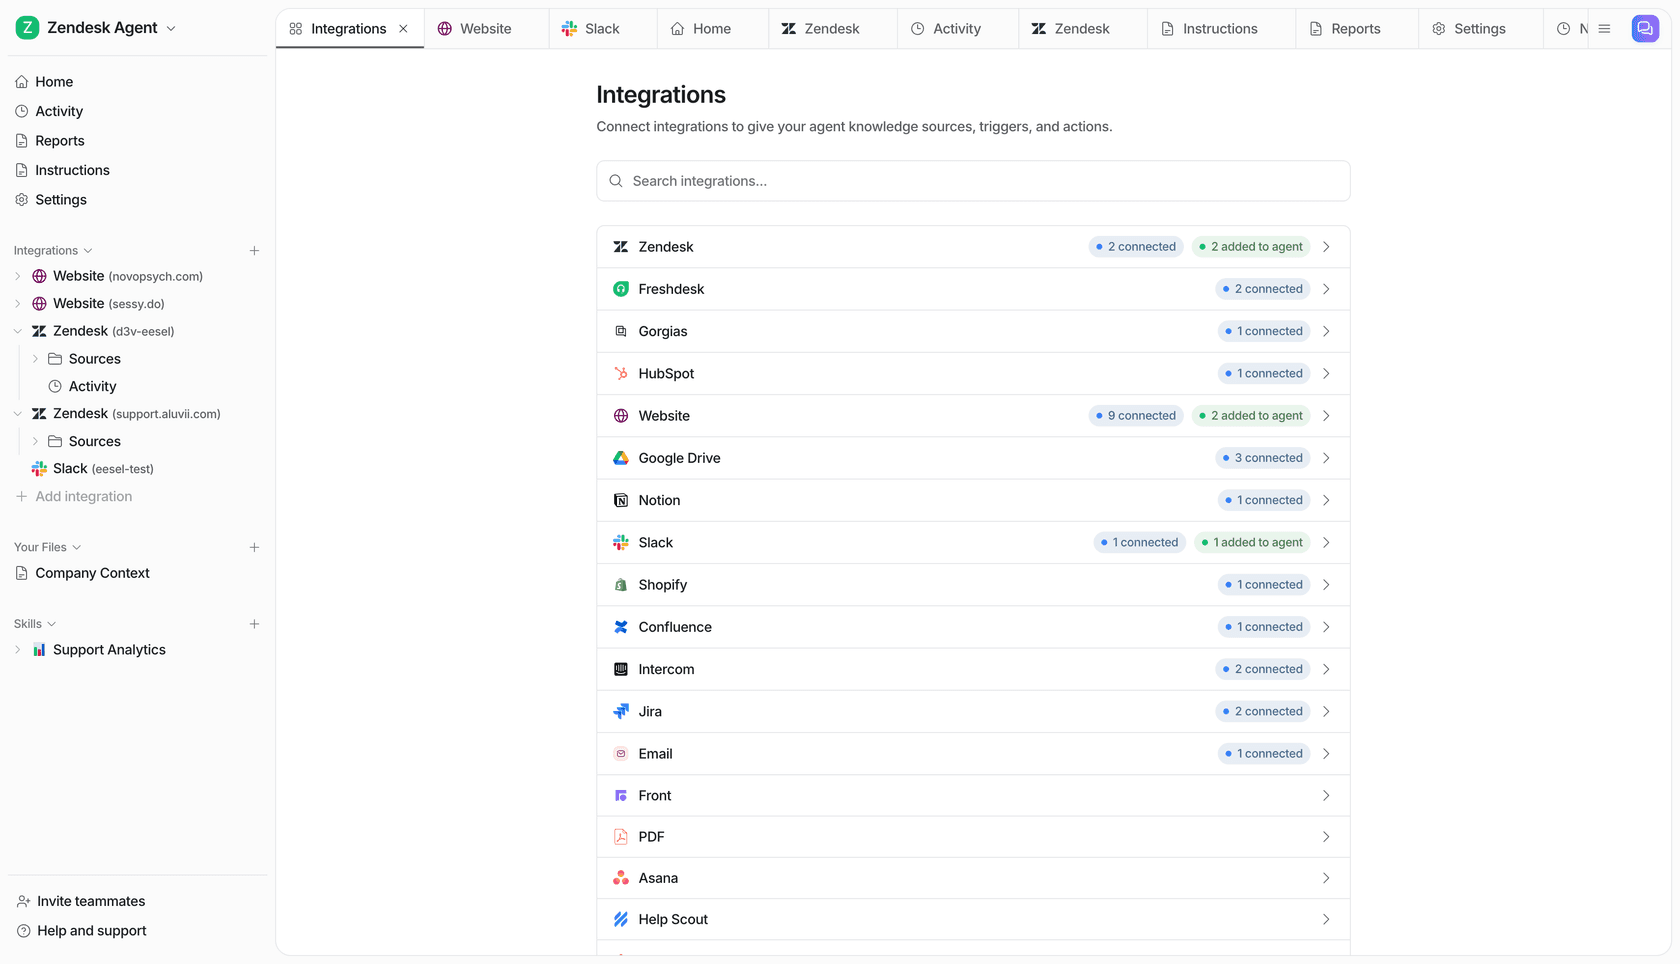
Das ist auch, warum ein KI-Agent kein regelbasierter Chatbot mit angeflanschter API ist. Ein Chatbot braucht einen Trigger und eine vorgefertigte Antwort. Ein Agent braucht alle drei Ebenen im Zusammenspiel, weil er Kontext liest, entscheidet und handelt.
Wo die Arbeit tatsächlich hingeht
Wenn du eine Zahl aus diesem Beitrag mitnimmst, dann diese: Bei einer echten Integration sind der API-Aufruf selbst ungefähr die letzten 20% des Aufwands. Trigger und Event-Verkabelung liegen näher an der Hälfte. Aktionen und Berechtigungen nehmen den größten Rest ein.
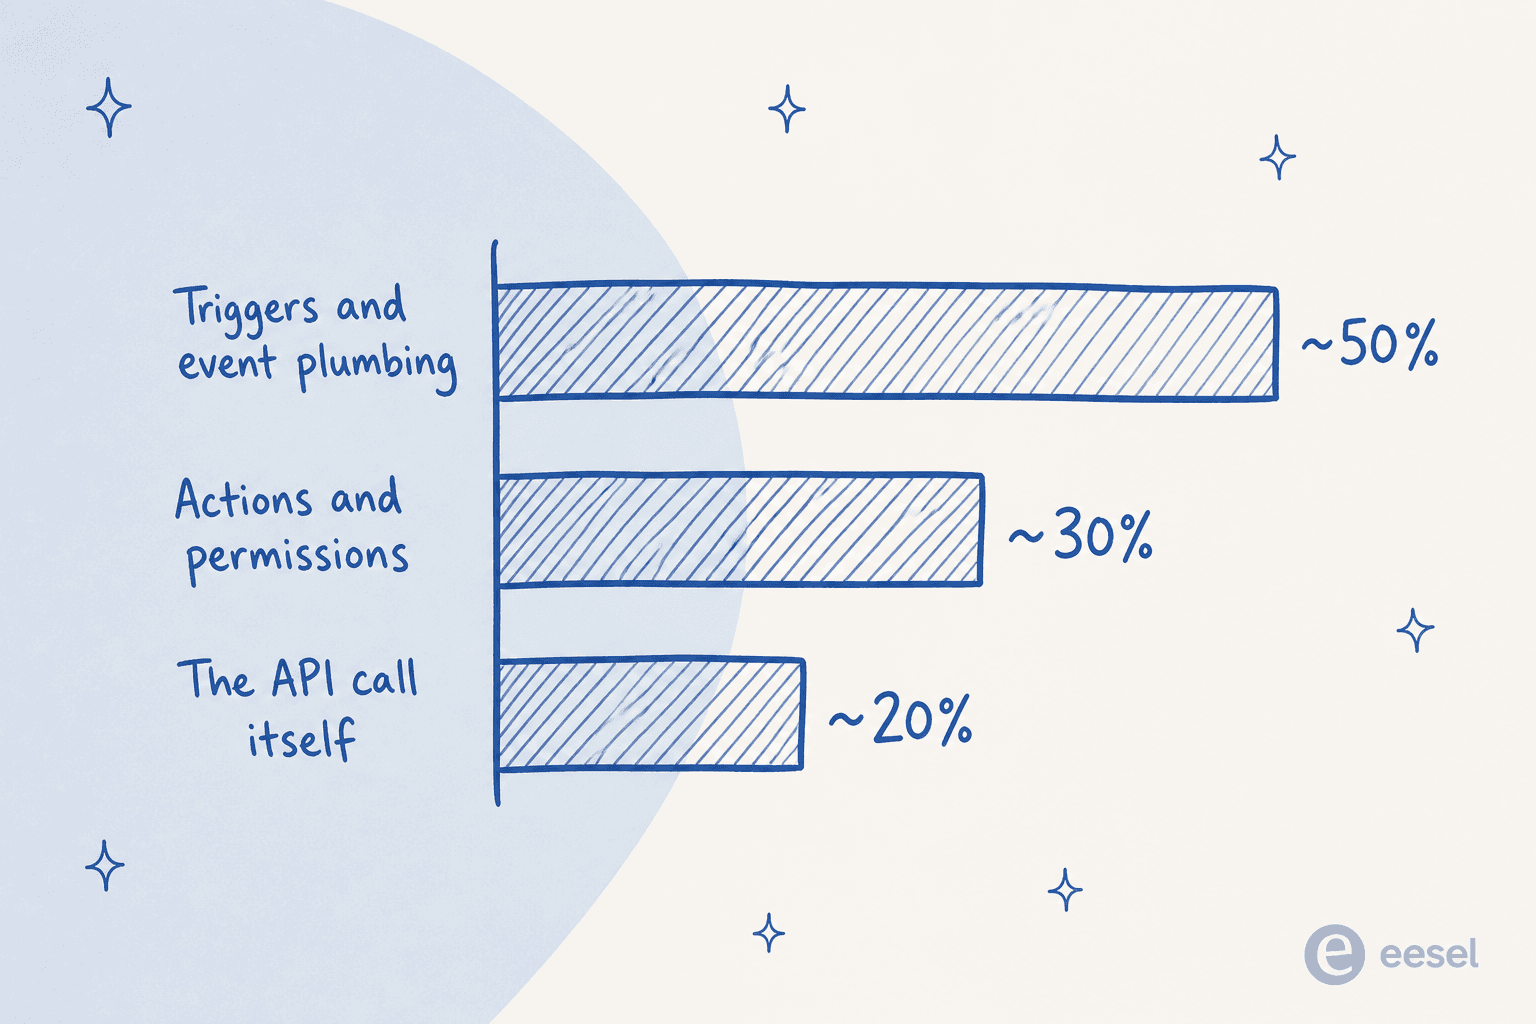
Diese Aufteilung überrascht Leute, deshalb hier, warum Trigger so schwer wiegen.
Jede Plattform macht Events anders. Manche senden saubere Webhooks. Manche zwingen dich, Automatisierungsregeln innerhalb ihrer UI zu bauen. Manche haben kein echtes Event-System, und du landest beim zeitgesteuerten Abfragen einer API. Sobald Events ankommen, musst du sie deduplizieren, weil Plattformen fröhlich dasselbe Event zweimal feuern, und ein Agent, der auf ein Ticket zweimal antwortet, ist keine gute Optik. Webhook-Abonnements haben Lebenszyklen, die pro Kunde angelegt und aufgeräumt werden müssen, sonst verwaisen sie und hören Monate später stillschweigend auf zu feuern.
Und dann gibt es die Verhaltensweisen, die niemand dokumentiert. Die kanonische, die mich echte Stunden gekostet hat: Freshdesk feuert seine Automatisierungsregeln stillschweigend nie für Tickets, die von einem Agenten erstellt wurden. Nichts in den Docs sagt das. Du beobachtest einfach, wie dein Trigger nicht feuert, und verlierst einen Nachmittag daran. Jede ausgereifte Plattform hat eine Handvoll solcher Fälle, und du findest sie nur, indem du das Ganze gegen echten Traffic laufen lässt. Genau um diese Lücke herum musste die eesel-Freshdesk-Integration gebaut werden, und deshalb simuliert eesel inzwischen jeden Rollout gegen die echte Historie eines Kunden, bevor er live geht.
Dasselbe hörst du auch von Entwicklern, die sich außerhalb des Kundensupports damit herumschlagen:
"So I've been messing around with a few AI agents trying to get them to fit into the workflow at my company. We've got a mix of legacy systems and some..."

Der Teil mit den Legacy-Systemen und dem „und einiges" ist die ganze Geschichte. Das „einiges" ist immer da, wo die Überraschungen wohnen.
Die zwei Entscheidungen, die dir am meisten Schmerz ersparen
Sobald du akzeptierst, dass die Verkabelung die eigentliche Arbeit ist, erledigen zwei Design-Entscheidungen den Großteil davon, eine Integration vernünftig zu halten.
Einen Connector bauen oder dem Agenten einen Schlüssel geben?
Nicht jede Integration verdient dieselbe Investition. Hier gibt es eine echte Weggabelung, und den falschen Zweig zu wählen ist genau, wie Teams überbauen.
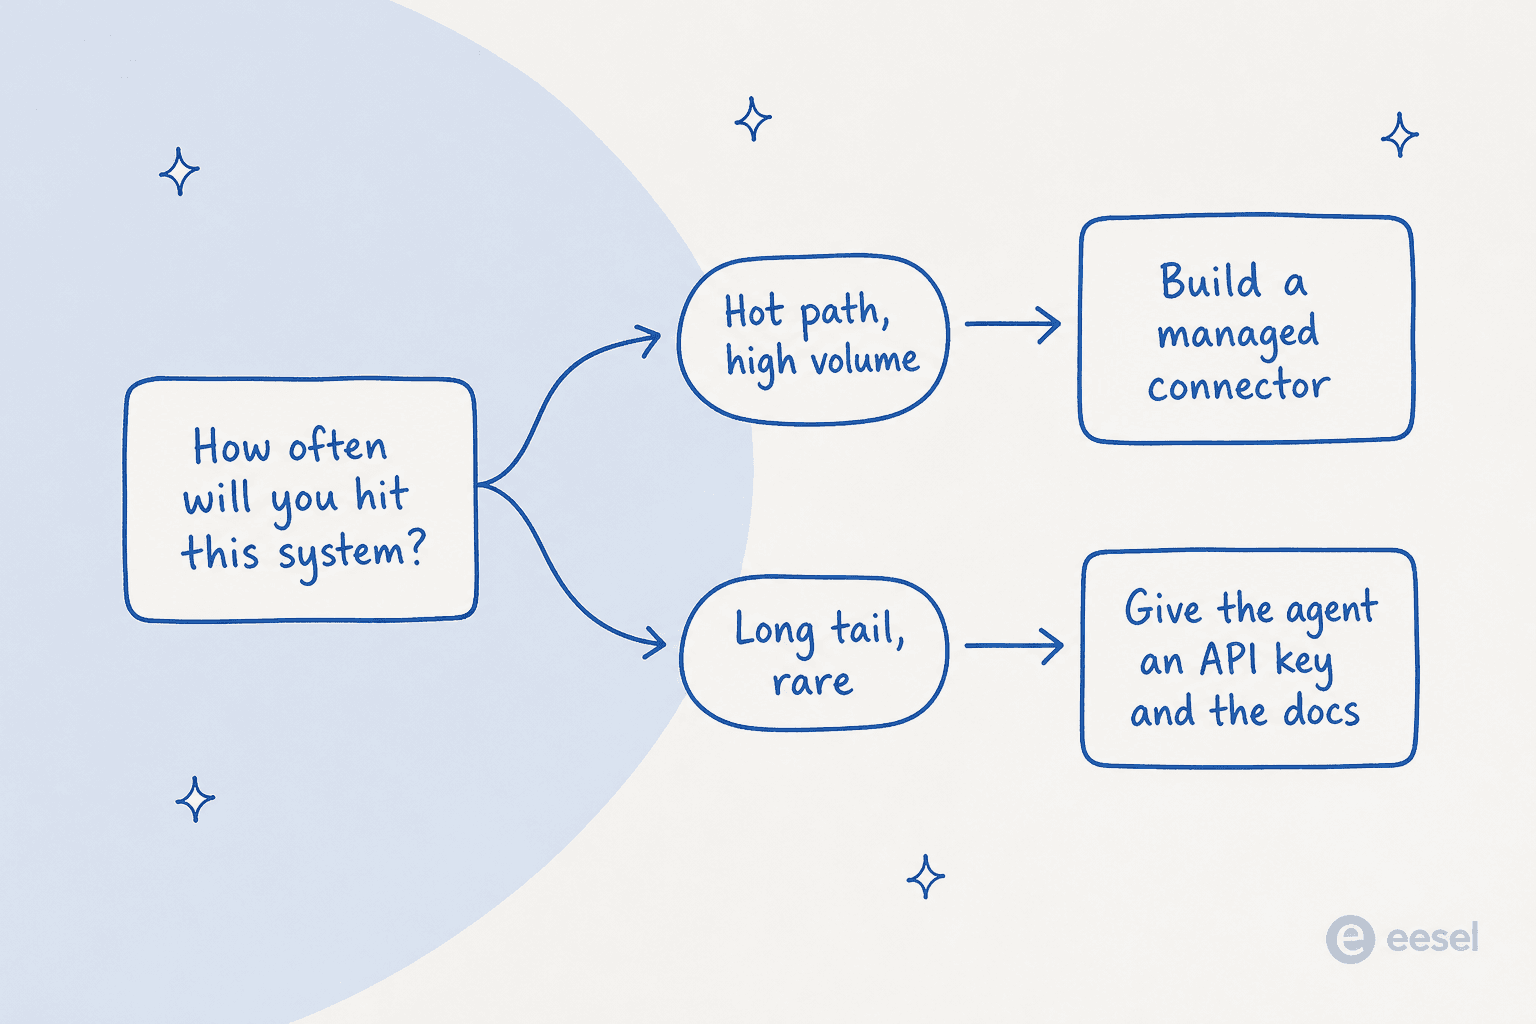
Für einen Hot Path, ein System, das dein Agent ständig ansteuert, bau einen richtigen Connector: verwaltete Authentifizierung, vorgefertigte Aktionen, Deduplizierung, Retries, das volle Programm. Die Vorabkosten zahlen sich jeden Tag aus.
Für den Long Tail, Systeme, die du selten anfasst oder die für einen einzigen Kunden einzigartig sind, ist genau diese Investition Verschwendung. Ich habe das tatsächlich getestet: Gib dem Agenten einen API-Schlüssel, die API-Docs des Anbieters und ein kurzes Referenzskript, und bei einmaligen Integrationen hat das einen polierten Vendor-Tool-Wrapper übertroffen. Moderne Agenten sind gut darin, API-Docs zu lesen und Requests zu formen. Lass sie das tun. Das ist die ganze Idee dahinter, einem Agenten Network Access zu einer erlaubten Domain zu geben, statt für jedes mögliche Tool im Voraus einen Connector zu bauen. Entwickler landen immer wieder beim selben Trade-off:
"APIs are glue, but they're messy glue. Documentation can be outdated, authentication flows differ, and error..."
Messy Glue ist genau der Long Tail. Du willst nicht für jede unordentliche Ecke einen Connector von Hand bauen. Du willst, dass der Agent die Docs liest und es selbst regelt.
An die Instanz binden, nicht an die Plattform
Das hier ist subtil, und es wird dich beißen. „Zendesk als Plattform" und „das spezifische Zendesk dieses Kunden" sind nicht dasselbe. Wenn du deine Integration um die Plattform herum modellierst, wirst du irgendwann eine Aktion für einen Kunden aktivieren und dabei zusehen, wie sie still einen anderen mitbeeinflusst, weil dein Code die Aktion an „Zendesk" gebunden hat statt an genau diesen einen Workspace.
Alles, was integrationsförmig ist – Quellen, Trigger, Aktionen, Zugangsdaten – muss an die konkrete Instanz gebunden werden. Aufgeschrieben klingt das offensichtlich. Um 2 Uhr nachts, wenn eine Berechtigung tenantübergreifend leckt, ist es das nicht. Bring das am ersten Tag im Datenmodell in Ordnung, und du denkst nie wieder darüber nach. Bring es falsch, und es wird ein Rewrite.
Die Teile der Verkabelung, die man vergisst
Über die drei Ebenen hinaus braucht eine produktive KI-Agent-API-Integration ein paar Dinge, die es nie in die Happy-Path-Demo schaffen.
Auth, die das Modell nie zu Gesicht bekommt. Zugangsdaten sollten als Header oder Secrets gespeichert werden, die die Integrationsebene anhängt, nicht als Werte, die jemals durch den Kontext des Modells laufen. Das Muster hinter eesels Network-Access-Feature ist genau das: Du erlaubst eine Domain und fügst einmal einen Auth-Header hinzu, der Agent kann diese API dann aufrufen, und die Zugangsdaten werden der KI nie gezeigt. Das ist der Unterschied zwischen einer sicheren Integration und einer, die nur einen Schlüssel-Leak von einem Vorfall entfernt ist.
Eingegrenzte Aktionen mit menschlicher Freigabe für die riskanten. Daten lesen ist wenig riskant. Daten schreiben, eine Bestellung erstatten, einen Datensatz löschen, ist es nicht. Jede Aktion, die der Agent ausführen kann, sollte auf das nötige Minimum eingegrenzt sein, und die destruktiven sollten hinter einer Freigabe verriegelt bleiben, bis du ihnen vertraust. Eine gute Customer-Support-Agent-API macht „entwerfen, aber nicht senden" und „vorschlagen, aber Freigabe erforderlich" zu erstklassigen Zuständen, nicht zu nachträglichen Einfällen.
Ein Audit-Log, das du tatsächlich lesen kannst. Wenn ein Agent etwas Überraschendes tut, und das wird passieren, lautet die erste Frage: „Was hat er gesehen, und was hat er getan?" Wenn deine Integration das nicht schnell beantworten kann, debuggst du blind. Deshalb ist Observability genauso wichtig wie die Verbindung selbst.
Deine Integrationsebene auswählen
„Per API" ist nicht der einzige Weg, einen Agenten anzubinden, und oft nicht der beste. Die Ebene, die du wählst, sollte zur Aufgabe passen. So schneiden die gängigen Optionen tatsächlich im Vergleich ab.
| Ebene | Am besten für | Was sie dir gibt | Worauf du achten musst |
|---|---|---|---|
| REST-API | Custom Apps, Service-zu-Service-Aufrufe | Volle Kontrolle, dein Code besitzt den Ablauf | Du baust Auth, Retries, Deduplizierung und Events selbst |
| Webhooks | Den Agenten bei einem Event aufwecken | Ein sauberer Trigger ohne Polling | Lifecycle-Management, Deduplizierung und verwaiste Abonnements |
| MCP-Server | Einen KI-Client deine Tools nutzen lassen | Standard-Tool-Interface, das jeder MCP-Client aufrufen kann | Neuerer Standard; noch nicht jeder Client spricht ihn |
| CLI | Skripting, CI, Ops-as-Code | Skriptfähig, JSON-Ausgabe, Dry-Run vor Schreibvorgängen | Eine Person oder ein Skript muss sie steuern |
| Vorgefertigter Connector | Hot-Path-Plattformen (Helpdesks, CRMs) | Verwaltete Auth, Aktionen und Events von Anfang an | Du hängst von der Abdeckung des Anbieters für diese Plattform ab |
Die meisten echten Setups mischen das. Du weckst den Agenten vielleicht mit einem Webhook auf, lässt ihn aus vorgefertigten Quellen lesen, führt Aktionen über einen verwalteten Connector aus und erreichst ein Long-Tail-System über rohen Network Access. Wenn du den tieferen Vergleich willst, wann welche Ebene passt, habe ich einen ganzen Beitrag über programmatischen KI-Agent-Zugriff geschrieben, und einen weiteren darüber, warum sich eine API-First-Plattform anders verhält als eine, bei der die API später angeflanscht wurde.
Die ehrliche Version des Rats: Wenn du einen Agenten in deinen Helpdesk integrierst, bau nichts davon selbst. Wenn du in etwas Maßgeschneidertes integrierst, rechne mit der Verkabelung, plane den Umfang dafür ein und verlasse dich beim Long Tail auf den Agenten selbst.
Probiere eesel für die Helpdesk-Seite aus
Wenn der Agent, den du anbindest, den Kundensupport übernehmen soll, sind die drei Ebenen oben bereits gebaut. eesel ist ein KI-Helpdesk-Teammitglied, das sich in deinen bestehenden Stack einklinkt wie eine neue Fachkraft, und behandelt jede Verbindung von Tag eins an als Quellen, Trigger und Aktionen.
Das bedeutet: Die Teile, die normalerweise deine Integrations-Timeline auffressen – Event-Handling für Zendesk oder Freshdesk, Bindung pro Instanz, eingegrenzte Aktionen mit Freigaben, ein prüfbares Aktivitätsprotokoll – sind erledigt. Und wenn du Kontrolle per Code willst, gibt es eine CLI, einen MCP-Server auf jedem Workspace, Webhooks, um den Agenten aufzuwecken, und Network Access für den Long Tail. Du kannst das Ganze simulieren gegen deine echte Ticket-Historie, bevor es einen Kunden erreicht, und die Preisgestaltung ist nutzungsbasiert, sodass du nicht pro Sitzplatz für eine Integration zahlst, die du noch testest.
Es ist der schnellste Weg, die in diesem ganzen Beitrag beschriebene Verkabelung zu überspringen, zumindest für die Helpdesk-Hälfte deines Stacks. Probiere eesel kostenlos aus.
Häufig gestellte Fragen
Was umfasst eine KI-Agent-API-Integration eigentlich?
Brauche ich eine REST-API, um einen KI-Agenten zu integrieren, oder geht es auch anders?
Warum ist es so schwer, KI-Agenten mit externen Tools und APIs zu verbinden?
Soll ich einen verwalteten Connector bauen oder dem Agenten einfach einen API-Schlüssel geben?
Wie halte ich eine KI-Agent-API-Integration sicher?


Article by
Rama Adi Nugraha
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.