

Warum mich ein Vision-Modell interessiert
Ich baue die Integrationen von eesel, also den Code, der Tickets, Anhänge und Help-Center-Artikel aus Tools wie Zendesk und Freshdesk zieht. Das meiste, was durch diese Leitungen fließt, ist Text, aber nicht alles. Eine Anfrage kam in diesem Jahr in den Sales-Calls von eesel immer wieder: Support-Teams für technische Produkte wollten, dass die KI die Diagramme in ihren PDFs und die Fotos liest, die Kunden an Tickets anhängen. Eine IT-Firma im öffentlichen Sektor mit rund 3.000 komplexen Tickets im Monat sagte uns, ihre technische Dokumentation bestehe größtenteils aus Bildern.
Als NVIDIA also ein offenes Modell veröffentlichte, dessen ganzer Pitch „ein Modell, das Diagramme, Tabellen, Seitenlayouts und Video liest und dann Tools aufruft“ lautet, habe ich die Model Card Zeile für Zeile gelesen. Hier steht, was wirklich drinsteckt, wo die Launch-Aussagen halten und wo sie eine Fußnote brauchen.
Was ist Nemotron 3.5 Super VL?
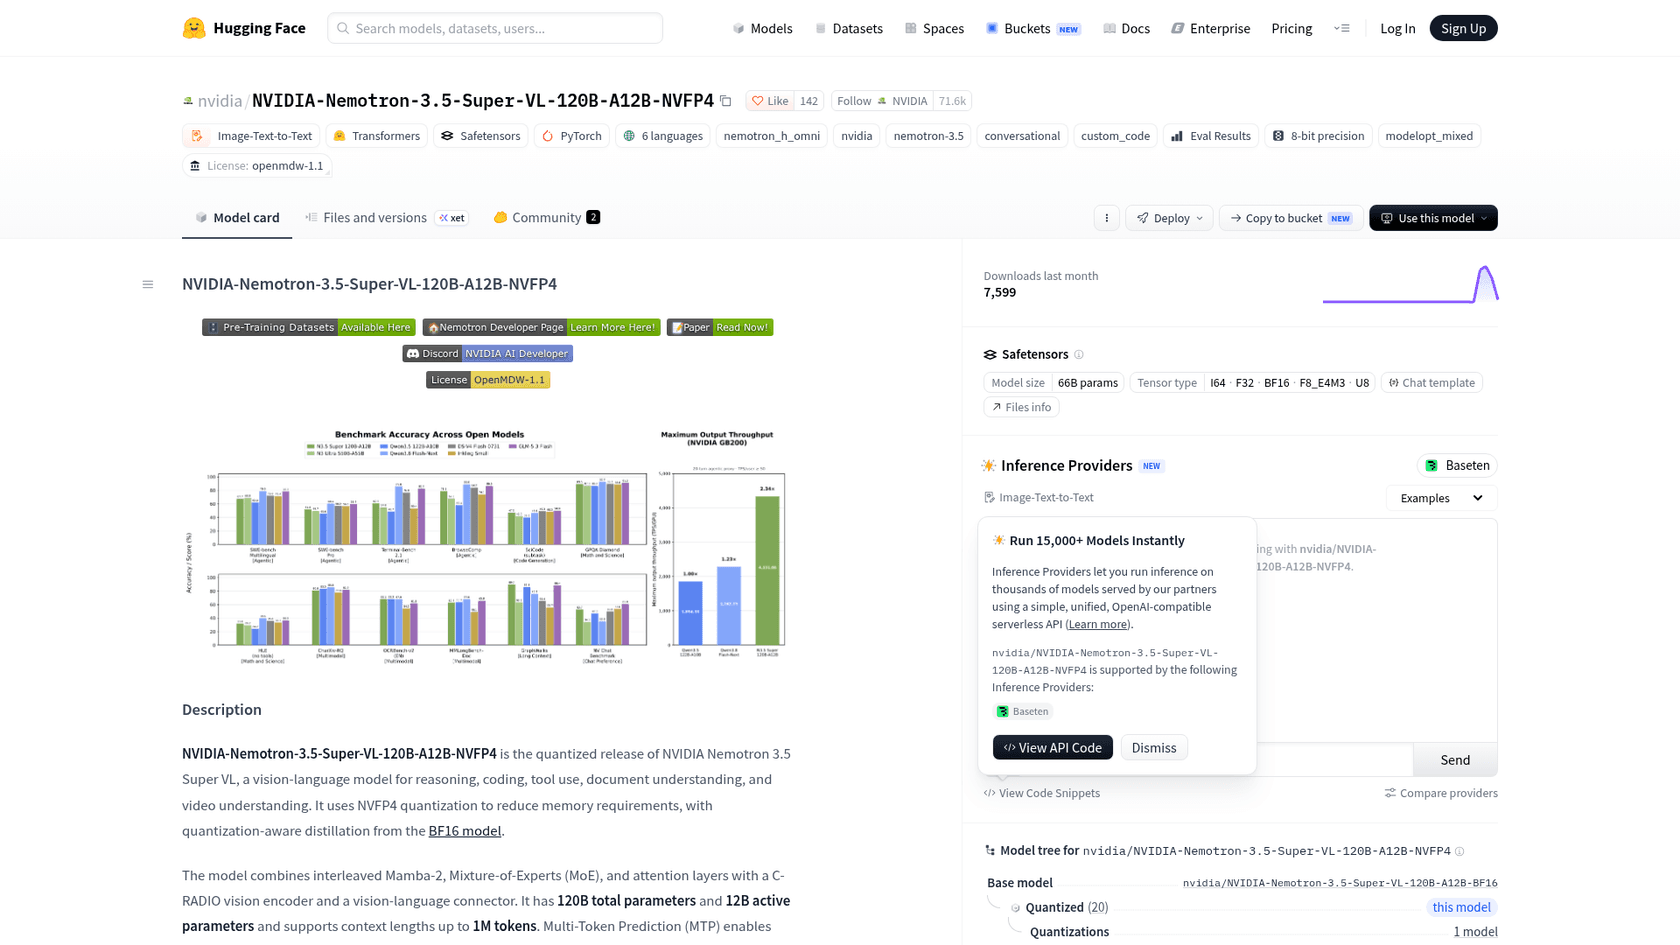
Nemotron 3.5 Super VL ist das Vision-Sprach-Mitglied von NVIDIAs Nemotron-3.5-Familie. Die BF16-Model-Card beschreibt es als Modell für „reasoning, coding, tool use, document understanding, and video understanding“, und das Schlüsselwort ist ein. Statt ein Textmodell mit einem separaten Vision-Modell zu verketten und Kontext zwischen beiden weiterzureichen, übernehmen dieselben Gewichte beides.
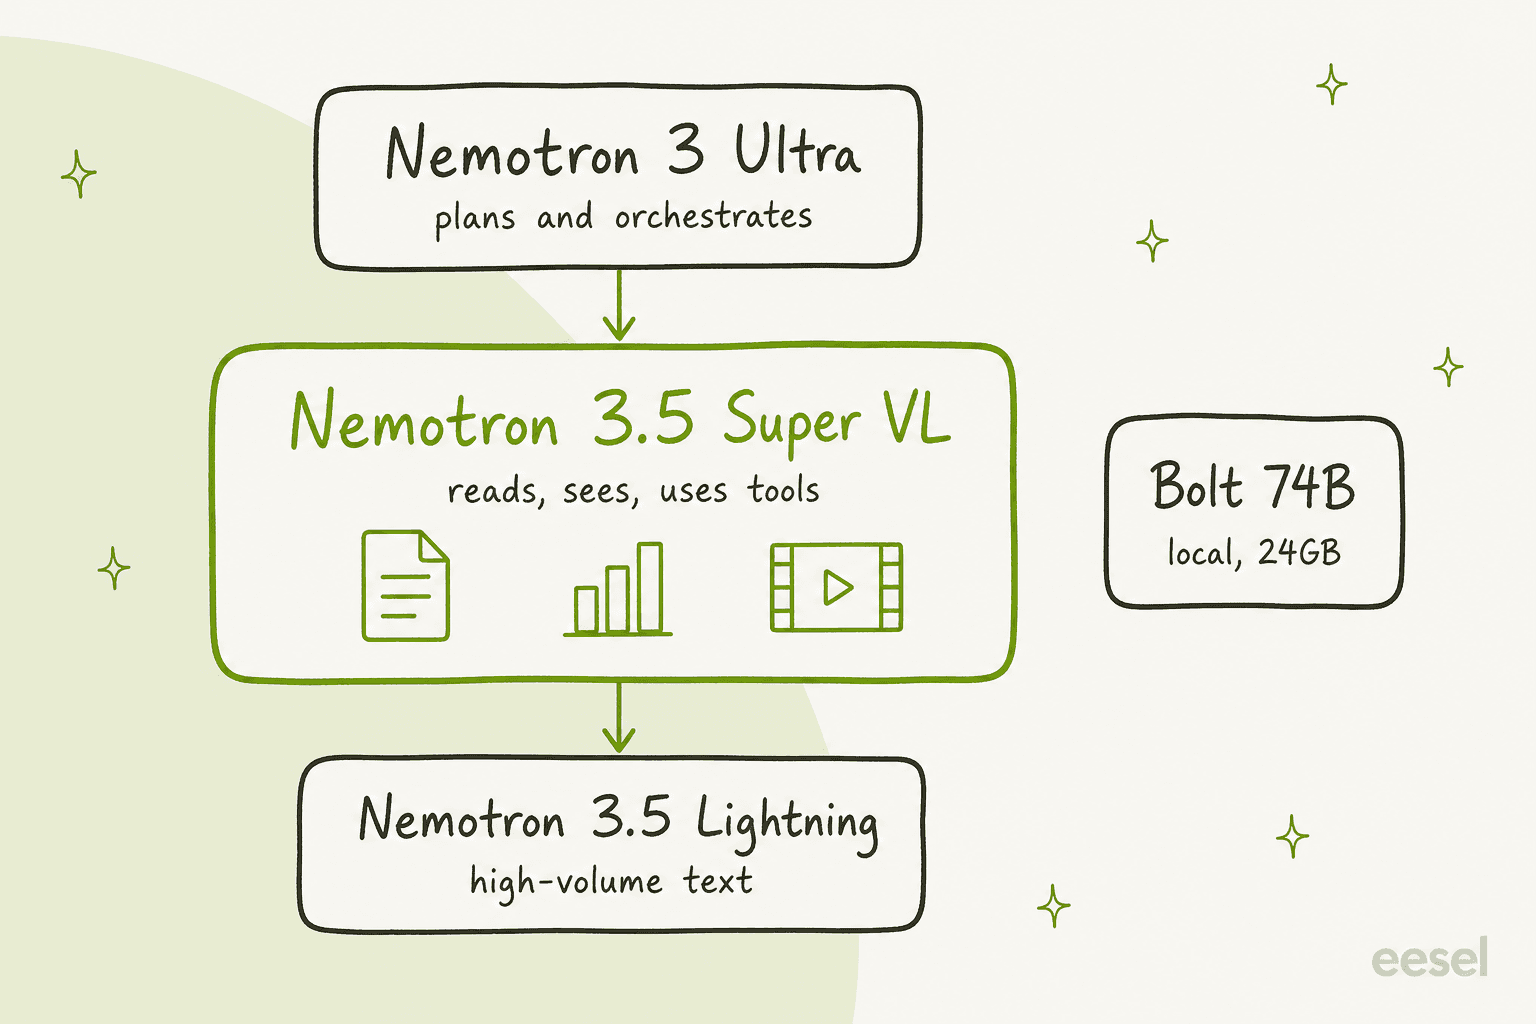
Es erschien zusammen mit zwei kleineren Geschwistern. Laut NVIDIAs Ankündigung nutzt Bolt 74B-A9B native 2-Bit-Quantisierung, um für lokale Agenten in 24GB zu passen, und Bolt E4B (4GB) erscheint am 23. Oktober für Sprache und Embedded-Einsatz.
Das sind die wichtigen Specs:
| Spec | Nemotron 3.5 Super VL |
|---|---|
| Veröffentlicht | 15. Oktober 2026 |
| Parameter | 120B gesamt, 12B aktiv pro Token |
| Architektur | Hybrides Mixture-of-Experts aus Mamba-2 und Transformer, 512 geroutete Experten pro MoE-Schicht |
| Vision | C-RADIO-Vision-Encoder plus Vision-Sprach-Connector |
| Eingaben | Text, Bilder (JPEG, PNG), Video (MP4 bis 2 Minuten) |
| Ausgabe | Text |
| Kontextfenster | Bis zu 1M Token (262,144 max. Output auf OpenRouter) |
| Reasoning | Aus, mittel oder an, gesetzt im Chat-Template |
| Checkpoints | Base, nachtrainiert BF16, NVFP4 |
| Lizenz | OpenMDW-1.1 |
Die Model Card sagt, es sei „ready for commercial or non-commercial use“, und NVIDIA veröffentlicht auch die Trainingsdaten und Rezepte. Das letzte ist wichtig, wenn Sie Fine-Tuning planen. Sie sehen, was eingeflossen ist, was bei den meisten Modellen mit offenen Gewichten nicht geht, darunter Kimi K3 und Mistral Large 4.
Wie funktioniert es unter der Haube?
Kurz gesagt: Es ist ein mittelgroßes Modell, das pro GPU viel Arbeit leisten soll. Einige Designentscheidungen erklären, warum es schnell ist.
- Hybride Schichten. Das Netz verschränkt Mamba-2-Schichten (ein State-Space-Design, das lange Sequenzen günstig verarbeitet) mit Mixture-of-Experts-Blöcken und einer kleineren Zahl von Attention-Schichten. Das hält den Speicherbedarf bei langem Kontext niedrig, wodurch eine Maschine ein 1M-Token-Fenster halten kann.
- Aus einem größeren Modell destilliert. NVIDIA sagt, das Backbone startete von Nemotron 3 Super Base und bekam dann 1T Token Destillation aus Nemotron 3 Ultra Base. So schlägt ein 120B-Modell sein 550B-Lehrermodell in einigen Agent-Benchmarks.
- Eingebautes Drafting. Ein Multi-Token-Prediction-Head schlägt mehrere Token auf einmal vor, die das Hauptmodell prüft, sodass weniger teure Durchläufe nötig sind. Auf dem DGX Spark bringt NVIDIAs separater LiLiCorr-Drafter „up to 2.3x faster token generation“.
- 4-Bit ohne großen Verlust. Der NVFP4-Checkpoint wurde so trainiert, dass er dem Modell mit voller Präzision entspricht. Artificial Analysis stellte fest, dass er im Index innerhalb von 0.1 Punkten von BF16 liegt.
Die Trainings-Pipeline erklärt auch den Agent-Fokus: 67B Token Software-Engineering-Mid-Training bei 256K Kontext, dann überwachtes Fine-Tuning auf gepackten Sequenzen von bis zu 524,288 Token, dann Reinforcement Learning und Multi-Teacher-Destillation. Wenn Sie verfolgt haben, wie KI-Agenten gebaut werden, ist das genau das Rezept, das man für ein Modell erwartet, das lange, Tool-lastige Jobs ausführen soll.
Wo es in NVIDIAs Modellpalette passt
NVIDIA stellt klar, dass Super VL nicht alles können soll. Im Developer-Post beschreibt NVIDIA ein „system of models“: Nemotron 3.5 Lightning übernimmt hochvolumige Textaufgaben, Nemotron 3 Ultra übernimmt Planung und Orchestrierung, und Super VL sitzt in der Mitte und erledigt die spezialisierte, mehrstufige Arbeit, die Vision und Tools braucht.
Diese Einordnung ist nützlich, weil sie zeigt, wie NVIDIA den Einsatz erwartet. Super VL ist der Arbeiter, dem Sie ein 40-seitiges PDF und eine Tabelle geben, nicht das günstigste Modell, um eine Million kurzer Nachrichten zu klassifizieren. Für eine solche Ticket-Klassifizierung passen Lightning oder ein kleines geschlossenes Modell wie Claude Haiku 5.5 bei den Kosten besser.
Wie gut ist es wirklich?
Hier müssen Sie zwei Ranglisten nebeneinander lesen.
Auf Artificial Analysis, der unabhängigen Benchmarking-Seite, erreicht Nemotron 3.5 Super VL 26.5 im Intelligence Index, Platz 1 von 67 Modellen mit offenen Gewichten in der Größenklasse 40B bis 150B. Das ist das Doppelte seines Vorgängers Nemotron 3 Super (13), vor Nemotron 3 Ultra (22.9) und knapp vor Inkling Small von Thinking Machines (25.7). Es lief außerdem mit 409 Output-Token pro Sekunde, am schnellsten in seiner Klasse.
Weitet man aber den Blick, ändert sich das Bild. Größere offene Modelle, die pro Token etwa gleich viel kosten, erreichen deutlich höhere Werte:
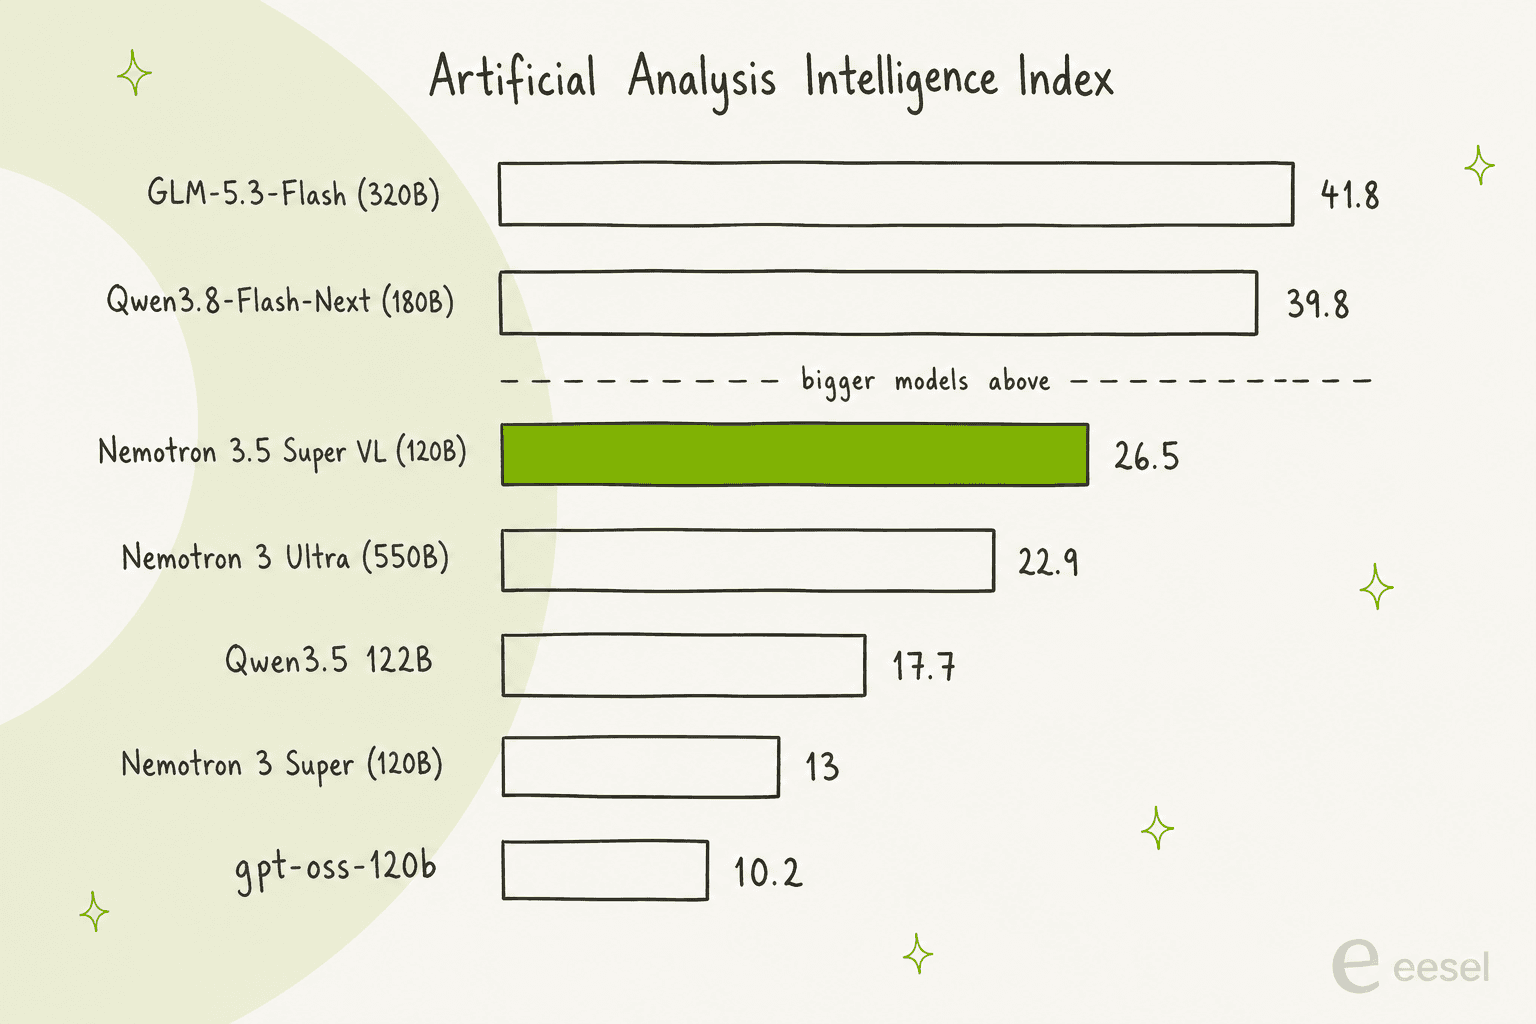
GLM-5.3-Flash (320B gesamt) erreicht 41.8 und Qwen3.8-Flash-Next (180B gesamt) 39.8. NVIDIAs eigene Tabelle in der Model Card enthält beide, und sie schlagen Super VL in den meisten Zeilen, darunter SWE-bench Verified (78.7 und 79.10 gegenüber 71.10) und Terminal-Bench 2.1 (85.80 und 82.70 gegenüber 60.67). Artificial Analysis selbst merkt an, dass die USA bei der Intelligenz offener Gewichte weiter hinter Chinas MiMo-V2.6-Pro (46) liegen.
Worin gewinnt Super VL also? Bei der Geschwindigkeit und im „attraktivsten Quadranten“ von NVIDIAs Grafik, wo Genauigkeit auf Durchsatz trifft:
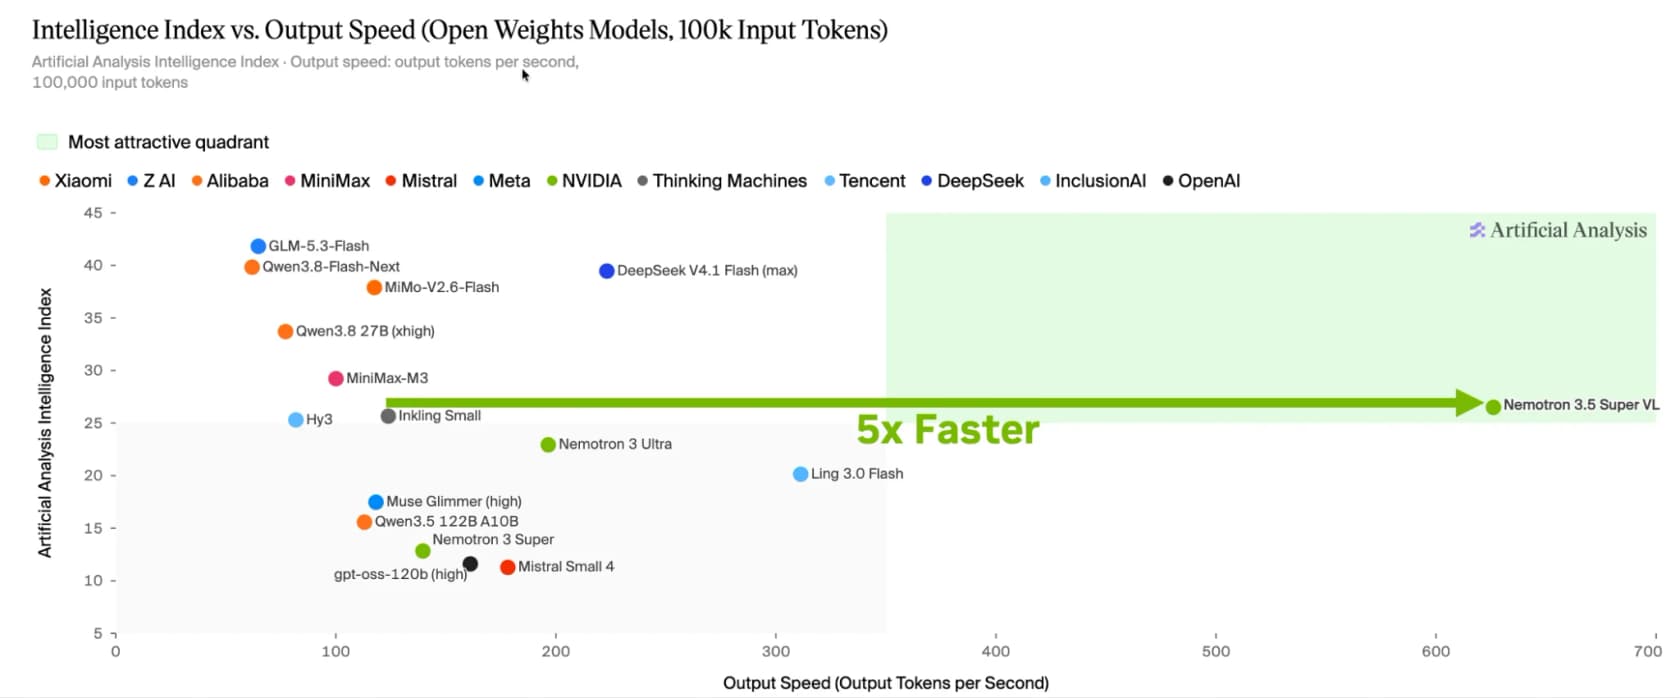
Speziell bei Agent-Frameworks schlägt es laut NVIDIA Ultra bei Hermes Bench (63.44 % gegenüber 56.33 %) und bei LangChains Behavioral Evals (87.05 % gegenüber 84.3 %). Und bei Dokumenten ist es stark: 80.8 % im Chart-Reasoning-Benchmark CharXiv (84 % mit Python-Code-Interpretation) und 68.12 bei OCRBench v2 Englisch.
Mein Fazit: Super VL ist nicht das klügste offene Modell, sondern das schnellste gute, das sehen kann. Wenn Ihr Agent hauptsächlich Code schreibt, lohnt sich der zusätzliche Speicher der größeren Flash-Modelle. Wenn er den ganzen Tag Dokumente liest und Ihnen Durchsatz pro GPU wichtig ist, testen Sie zuerst Super VL.
Die Post-Training-Geschichte, mit der NVIDIA wirbt
NVIDIAs Kernaussage, die die meisten Launch-Berichte aufgegriffen haben, lautet, dass das nachtrainierte Super VL Claude Opus 5, GPT-6.1 Sol und andere Frontier-Modelle bei spezialisierten Aufgaben schlägt. Die Grafik ist echt. Schauen Sie aber genau hin:
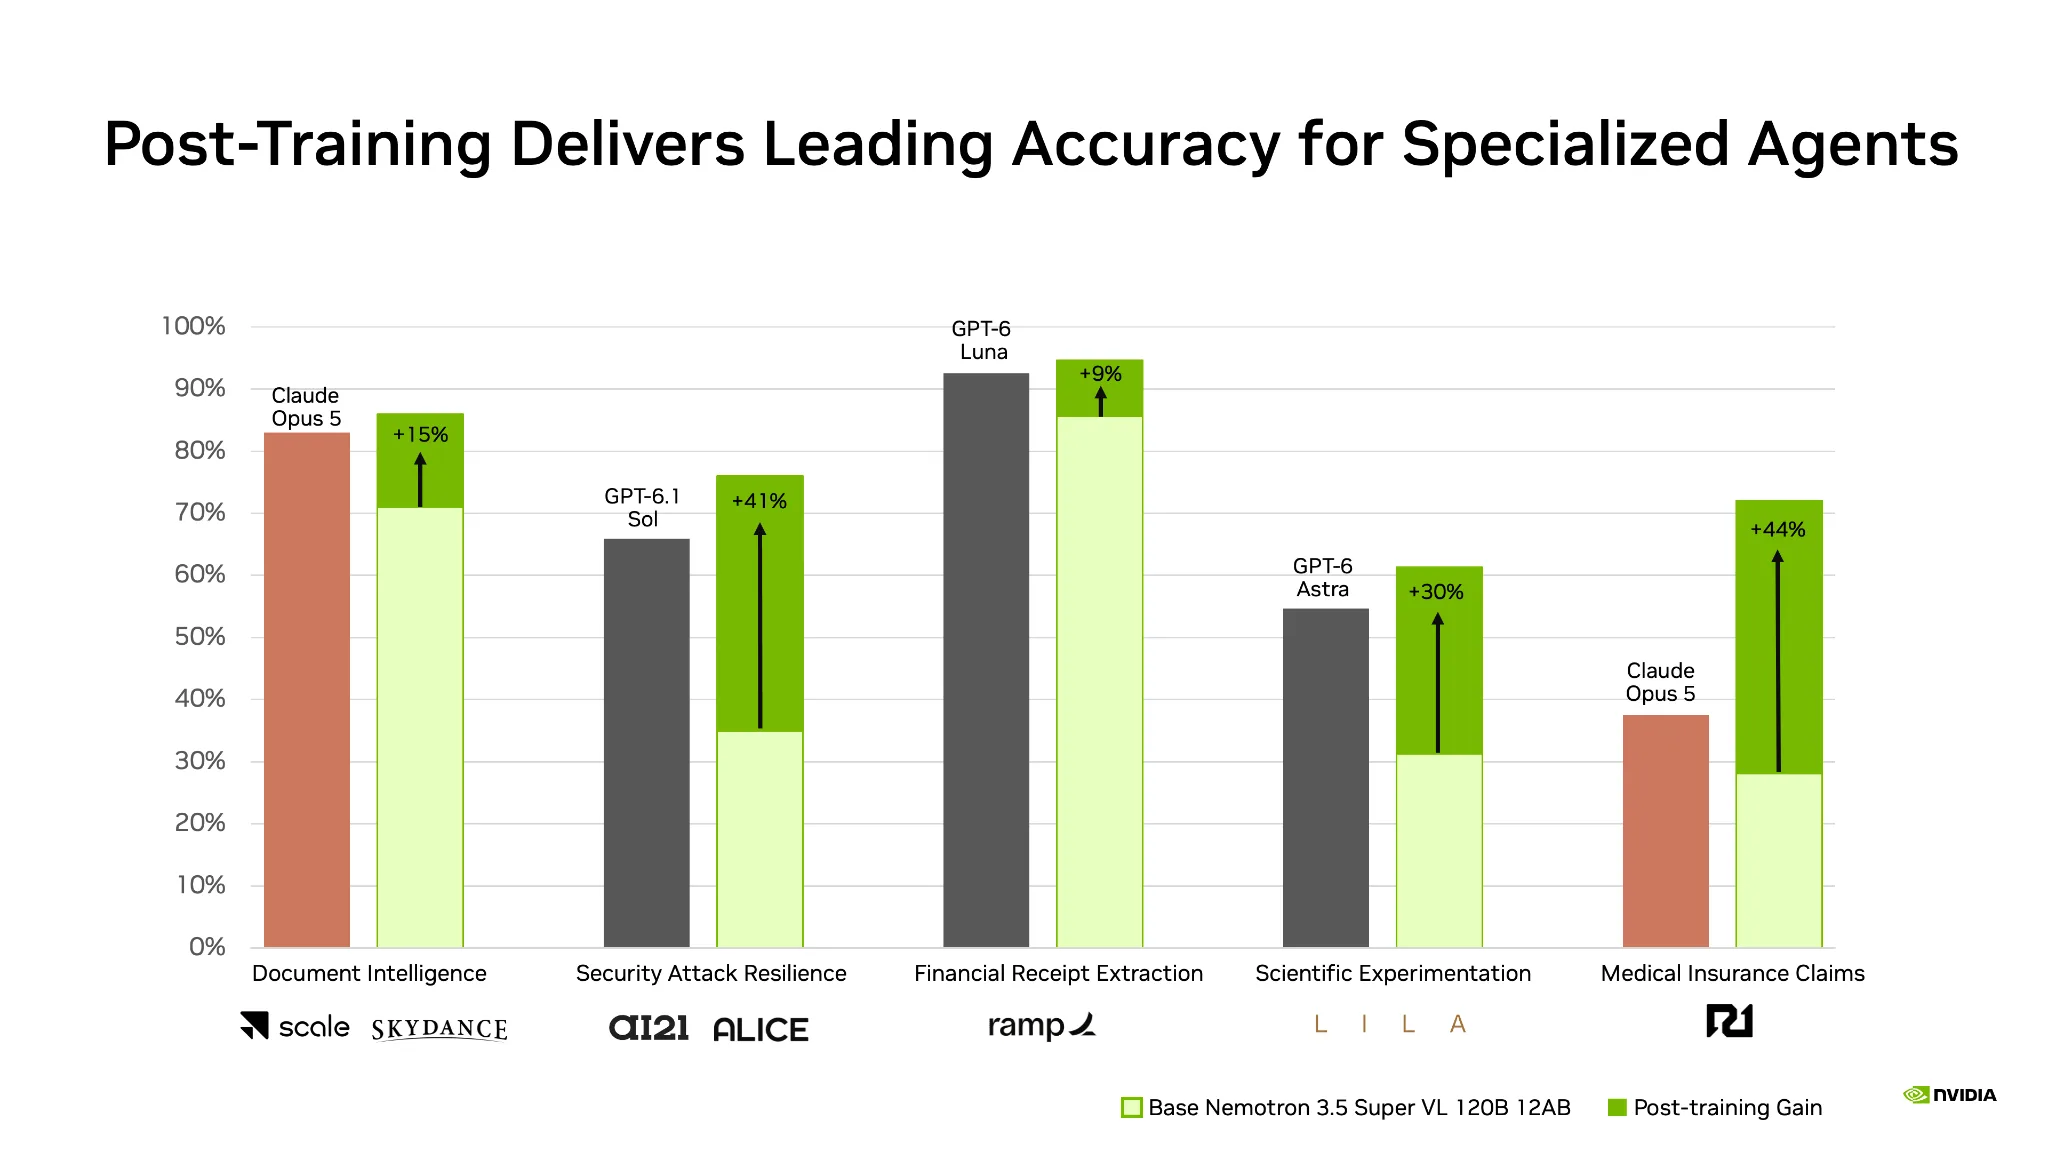
In allen fünf Aufgaben startet das hellgrüne Basismodell unter dem Frontier-Modell. Bei der Widerstandsfähigkeit gegen Sicherheitsangriffe startet es bei etwa 35 % gegenüber 66 % von GPT-6.1 Sol und überholt es erst nach einem Post-Training-Gewinn von +41 % durch AI21 und Alice. Der Sieg kommt vom Training auf Ihren eigenen Daten, genau das erlaubt ein offenes Modell mit offenen Rezepten.
Die Partnerzahlen sind konkret. Scale AI hat es für die Verarbeitung von Lieferantengutschriften bei Skydance nachtrainiert und erwartet, dass die Inferenzkosten um das 40-Fache und die Latenz um das 5-Fache sinken. Ramp verwandelt Belegbilder in strukturiertes JSON und erwartet bis zu 50 % mehr Durchsatz und 10x geringere Latenz.
Die Lehre für Käufer: Wenn Sie ein Modell von der Stange nehmen und per Prompt steuern, vergleichen Sie die Basiswerte. Wenn Sie ein Team und gelabelte Daten zum Nachtrainieren mit NVIDIA NeMo haben, ist das offene Rezept von Super VL das eigentliche Produkt.
Was kostet Nemotron 3.5 Super VL?
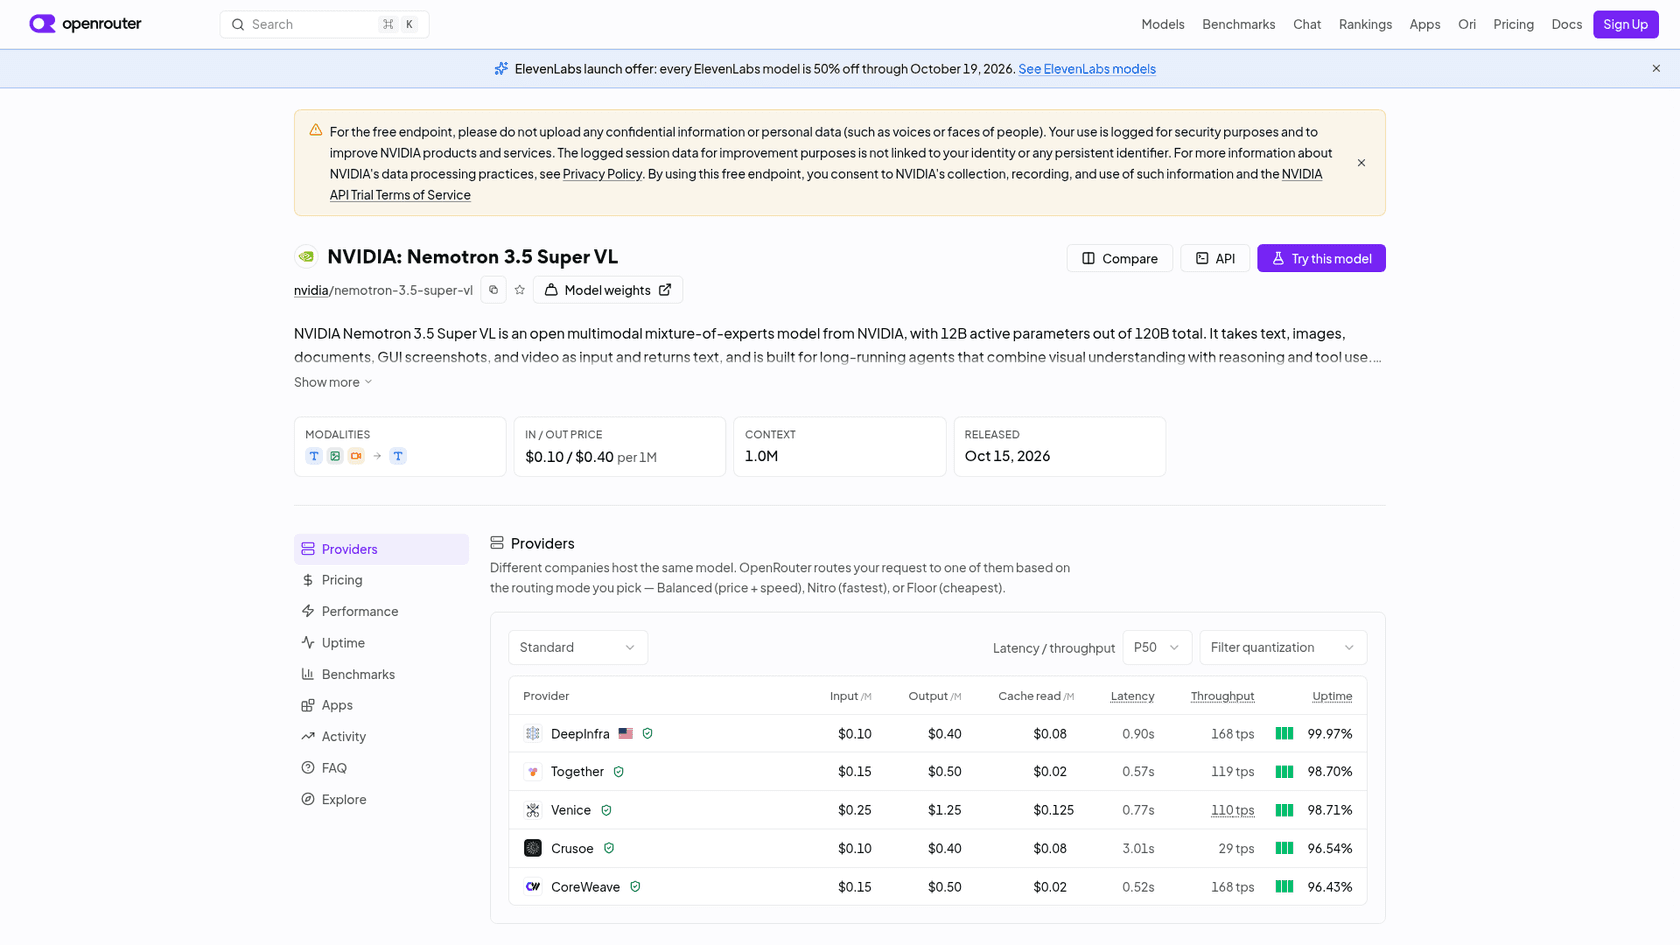
Die Gewichte sind kostenlos. Gehostet ist es eines der günstigsten leistungsfähigen Modelle am Markt:
| Anbieter | Input / 1M Token | Gecachter Input / 1M | Output / 1M |
|---|---|---|---|
| DeepInfra | $0.10 | $0.08 | $0.40 |
| Crusoe (über OpenRouter) | $0.10 | $0.08 | $0.40 |
| Together (über OpenRouter) | $0.15 | $0.02 | $0.50 |
| CoreWeave (über OpenRouter) | $0.15 | $0.02 | $0.50 |
| Venice (über OpenRouter) | $0.25 | $0.125 | $1.25 |
| NVIDIA-Gratis-Endpunkt (über OpenRouter) | Gratis | Gratis | Gratis |
Die OpenRouter-Zeilen stammen von OpenRouters Modellseite, Stand 18. Oktober. Eine Warnung zum kostenlosen Endpunkt: OpenRouters Hinweis sagt, Ihre Nutzung „is logged for security purposes and to improve NVIDIA products“, und bittet darum, keine vertraulichen oder personenbezogenen Daten hochzuladen. Das schließt ihn für echte Kundentickets aus.
Der Listenpreis ist nicht die ganze Rechnung, denn Reasoning-Modelle verbrennen Output-Token. Artificial Analysis maß $0.19 pro Aufgabe des Intelligence Index, günstiger als GLM-5.3-Flash ($0.28) und Qwen3.8-Flash-Next ($0.37) trotz ähnlicher Listenpreise, weil Super VL etwa 46,000 Output-Token pro Aufgabe nutzte. Das sind rund 60 % weniger als bei Nemotron 3 Super.
Um zu sehen, was das für eine Support-Last bedeutet, setzen Sie Ihre eigenen Zahlen ein:
Mit den Standardwerten kosten 10,000 Tickets bei DeepInfra etwa $13 im Monat an Token. Das ist die Erkenntnis, die ich einem Support-Lead mitgeben möchte: Die Modellrechnung ist die kleine Zahl. Teuer wird alles drumherum, etwa Retrieval, Eskalationsregeln, Tests und aktuelle Antworten, und zu diesem Schluss kommt mein Leitfaden zu Support-Modellen auch bei geschlossenen Modellen.
Kann man es selbst betreiben?
Ja, und hier hebt sich Super VL ab. NVIDIA hat den NVFP4-Checkpoint so gebaut, dass er auf einen einzelnen DGX Spark passt, und die Liste der Hosts war am Starttag lang: Hugging Face, ModelScope, NIM sowie LM Studio, Ollama, vLLM, SGLang und Unsloth für lokale Läufe.
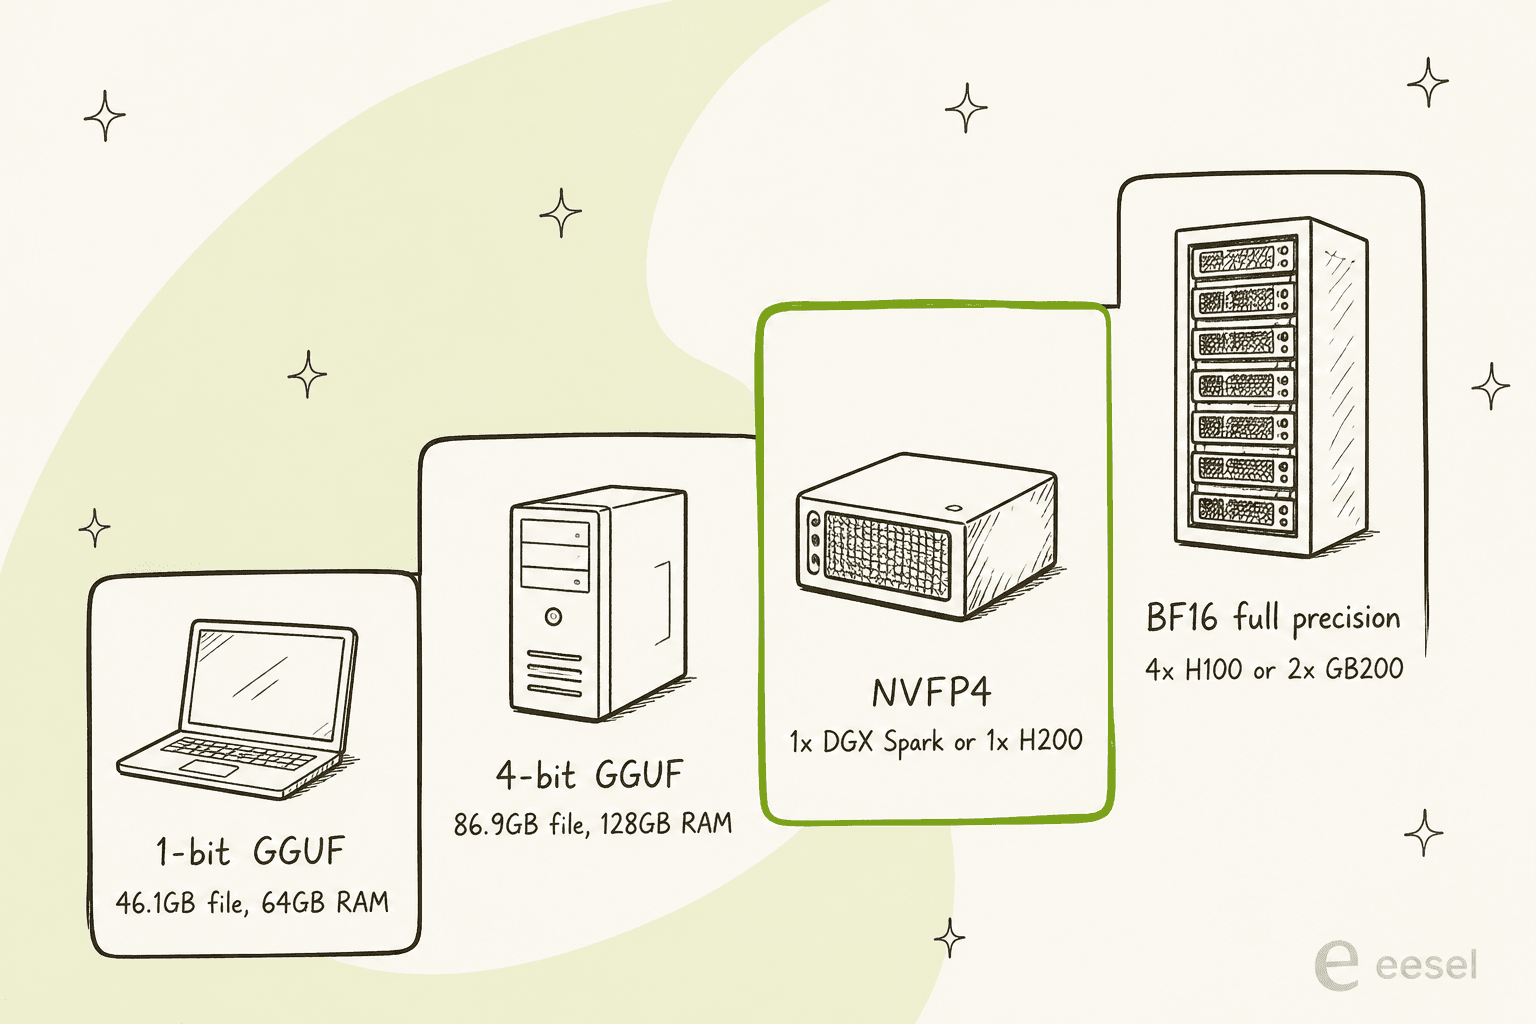
Die Zahlen stammen aus der NVFP4-Model-Card und Unsloths Anleitung, die GGUF-Builds von 46.1GB (1-Bit) bis 132GB (8-Bit) auflistet. Die Qualität hält sich in 4-Bit gut. NVIDIAs Vergleichstabelle zeigt NVFP4 bei den meisten Benchmarks innerhalb eines Punkts von BF16, wobei WebVoyager von 77.72 auf 66.31 fällt. Testen Sie Browsing-Agenten also auf dem quantisierten Build, bevor Sie ihm vertrauen.
Für die Produktion packt NVIDIA es als NIM-Microservice und sagt, das Dynamo-Serving-Rezept auf 16 B200-GPUs „serves up to 8x as many users while reducing first-token latency by 85%.“ Wenn Sie aus Gründen der Datenresidenz selbst hosten, kombinieren Sie es mit einer Sandbox wie NVIDIAs Open Agent Safety Platform oder der NemoClaw-Runtime, statt ihm rohen Tool-Zugriff zu geben.
Die Lizenz ist der sauberste Teil der Geschichte. OpenMDW-1.1 gewährt Rechte „without restriction“, verlangt nur, dass Sie bei der Weitergabe Lizenz und Hinweise behalten, und sagt, dass sie keine Einschränkungen für Ausgaben auferlegt. Es gibt keine Umsatzschwelle und keine „Built with“-Kennzeichnungspflicht, anders als bei Muse Spark Open.
Was sagen frühe Tester?
Die erste Reaktionswelle teilt sich klar: beeindruckt von der Geschwindigkeit und vom US-Ranking, vorsichtiger, sobald man es gegen Qwen laufen lässt.
Artificial Analysis stellte den Launch um sein nationales Ranking herum dar:
"Nvidia's Nemotron 3.5 Super VL is now the leading US open weight model, scoring 26 on the Artificial Analysis Intelligence Index"
Harrison Kinsley, der den Kanal Sentdex betreibt, testete es für lokales Coding:
"This one may very well be a solid choice for a speedy local coding agent model"
Der nützlichste Test, den ich fand, stammt von Peter Dedene, der Super VL und Qwen3.8-Flash-Next mit abgeschaltetem Thinking durch seinen eigenen Agent-Benchmark schickte. Tool Calling und Instruktionsbefolgung lagen nah beieinander. Prompt Injection nicht: Bei AgentDojo, wo sich eine bösartige Anweisung in der Ausgabe eines Tools versteckt, folgte Qwen ihr in 2 von 200 Läufen und Nemotron in 37.
"For an agent that touches untrusted input, I'd still pick Qwen. For long documents, Nemotron."
Er betont, dass Nemotron zum Reasoning gebaut ist und er es mit abgeschaltetem Reasoning getestet hat, es war also nicht der beste Fall des Modells, und er plant einen zweiten Lauf. Auf Hacker News fiel die Reaktion kürzer aus:
"this 3.5 Super is still below Qwen 3.8 next as they state themsleves"

Das deckt sich mit NVIDIAs eigener Tabelle, also ist es fair. NVIDIA hat nie behauptet, Qwen bei den Rohwerten zu schlagen. Es beansprucht Geschwindigkeit, Offenheit und Spielraum durch Post-Training.
Passt es zum Kundensupport?
Das ist die Frage, die mich am meisten interessiert, und die Antwort lautet: „Es kommt darauf an, was Sie unter passen verstehen.“
Die Vision passt wirklich. Kunden schicken Screenshots von Fehlermeldungen, Fotos beschädigter Produkte und PDFs von Rechnungen. Ein reines Textmodell sieht „siehe Anhang“ und sonst nichts. Super VL liest den Anhang im selben Durchlauf wie das Ticket, genau die Lücke, die diese technischen Support-Teams in den Calls von eesel immer wieder nannten. Wenn Sie Ihre eigene Pipeline etwa mit LangChain bauen, entfällt dadurch ein ganzer Zwischenschritt in Ihrer Support-RAG-Pipeline.
Die Support-Benchmarks sind mittelmäßig. NVIDIAs Model Card nennt tau2-bench, den simulierten Kundenservice-Benchmark, in dem ein Agent im Gespräch mit einem simulierten Kunden eine Unternehmensrichtlinie befolgen muss:
| Benchmark | Nemotron 3.5 Super VL | Qwen3.8-Flash-Next | GLM-5.3-Flash | Nemotron 3 Ultra |
|---|---|---|---|---|
| tau2-bench retail | 69.24 | 71.6 | 78.2 | 73.7 |
| tau2-bench airline | 76.50 | 80.8 | 81.8 | 79.8 |
| tau2-bench telecom | 73.19 | 90.4 | 98.5 | 83.0 |
| tau3-bench banking | 18.88 | 44.5 | 34.8 | 18.4 |
Super VL liegt in jeder Zeile hinter allen drei Vergleichsmodellen, außer bei Banking, wo es Ultra knapp übertrifft. Die Halluzinationsrate bei AA-Omniscience (30.0 % in NVIDIAs Lauf) ist besser als bei den meisten Modellen in der Tabelle, was im Support zählt, wo eine selbstsichere falsche Antwort das schlimmste Ergebnis ist.
Prompt Injection ist das eigentliche Risiko. Jede Kundennachricht ist nicht vertrauenswürdiger Input. Dedenes Ergebnis von 37 in 200 stammt aus einem Test mit abgeschaltetem Reasoning, passt aber zu einer Lektion, die eesel auf die harte Tour gelernt hat: Man kann keinem Modell zutrauen, sich in einer Live-Queue selbst zu kontrollieren. Deshalb simulieren wir jeden Rollout gegen historische Tickets, bevor eine KI einem echten Kunden antwortet, und deshalb liegen Aktionen wie Erstattungen hinter Freigaberegeln. Unser Leitfaden zu KI-Halluzinationen im Support geht tiefer auf die Schutzmaßnahmen ein.
Mein Urteil für Support-Teams: Super VL ist ein interessantes Modell zum Aufbauen, wenn Sie Ingenieure, NVIDIA-Hardware und einen Grund haben, Daten im Haus zu halten. Es ist nichts, das Sie am Montag auf Ihre Zendesk-AI-Agent-Queue richten. Wenn Sie stattdessen fertige Optionen vergleichen, ist meine Übersicht zu KI-Helpdesk-Software der bessere Ausgangspunkt.
Wer sollte Nemotron 3.5 Super VL nutzen?
So würde ich entscheiden:
- Sie betreiben dokumentenlastige Agenten. Rechnungen, Verträge, Belege, Diagramme in Berichten. Dafür wurde es trainiert, und Ramp und Scale AI tun das bereits.
- Sie brauchen offene Gewichte auf eigener Hardware. Regulierte Daten, ein DGX Spark unterm Schreibtisch oder ein Vertrag, der externe KI-Verarbeiter verbietet. Die Lizenz und der NVFP4-Build für eine einzelne Maschine machen es zum am leichtesten zu rechtfertigenden großen offenen Modell.
- Sie wollen nachtrainieren. Offene Daten, offene Rezepte und NeMo-Unterstützung ab Tag eins. NVIDIAs beste Zahlen kommen alle nach dem Fine-Tuning.
- Sie wollen das klügste offene Modell. Schauen Sie zuerst auf GLM-5.3-Flash oder Qwen3.8-Flash-Next, oder steigen Sie auf geschlossene Modelle wie GPT-6 Luna und Gemini 3.8 Flash um.
- Ihr Agent liest nicht vertrauenswürdigen Input mit angehängten Tools. Warten Sie auf mehr Injection-Tests mit aktiviertem Reasoning, und kapseln Sie es in beiden Fällen in einer Sandbox.
Für Vergleichskäufer ist DeepSeek V4 Flash die günstigste textorientierte Alternative, und sein Vision-Experiment ist der engste offene Konkurrent bei Bildern.
eesel ausprobieren
Nemotron 3.5 Super VL ist Infrastruktur: Gewichte, eine Lizenz und eine GPU-Rechnung. Retrieval, Eskalationsregeln, Tests und Audit-Trail müssten Sie noch selbst bauen. eesel ist der Mitarbeiter. Unser KI-Helpdesk-Teammitglied verbindet sich mit Zendesk, Freshdesk, Gorgias und dem Rest, lernt aus Ihren früheren Tickets und Ihrem Help-Center, und Sie können es gegen Hunderte Ihrer historischen Tickets laufen lassen, bevor es einem einzigen Kunden antwortet. Bei diesem Replay fangen Sie die per Prompt Injection manipulierte Antwort oder die übertrieben selbstsichere Antwort ab, bevor es ein Kunde tut, egal welches Modell darunter sitzt.
Wenn Sie es lieber aus einem Terminal steuern, so wie Sie ein selbst gehostetes Modell steuern würden, deckt die eesel CLI das ab. eesel instructions liest und bearbeitet die Standardregeln des Teammitglieds, eesel approvals listet Aktionen auf, die auf einen Menschen warten, und eesel activity zeigt jeden Lauf und warum es so gehandelt hat. Jeder Befehl gibt JSON aus und Schreibzugriffe akzeptieren --dry-run, sodass ein Coding-Agent wie Claude Code Ihr Support-Teammitglied genauso verwalten kann wie Ihr Repo. Wenn Sie Inhalte schreiben statt Tickets zu beantworten, gibt es in derselben Palette einen KI-Blog-Writer.

Der Start ist kostenlos mit 100 Credits und ohne Karte. Testen Sie eesel an den Tickets des letzten Monats und sehen Sie, was es gesagt hätte, bevor Sie auch nur einen DGX Spark einpreisen. Die Pläne finden Sie auf der Preisseite.