

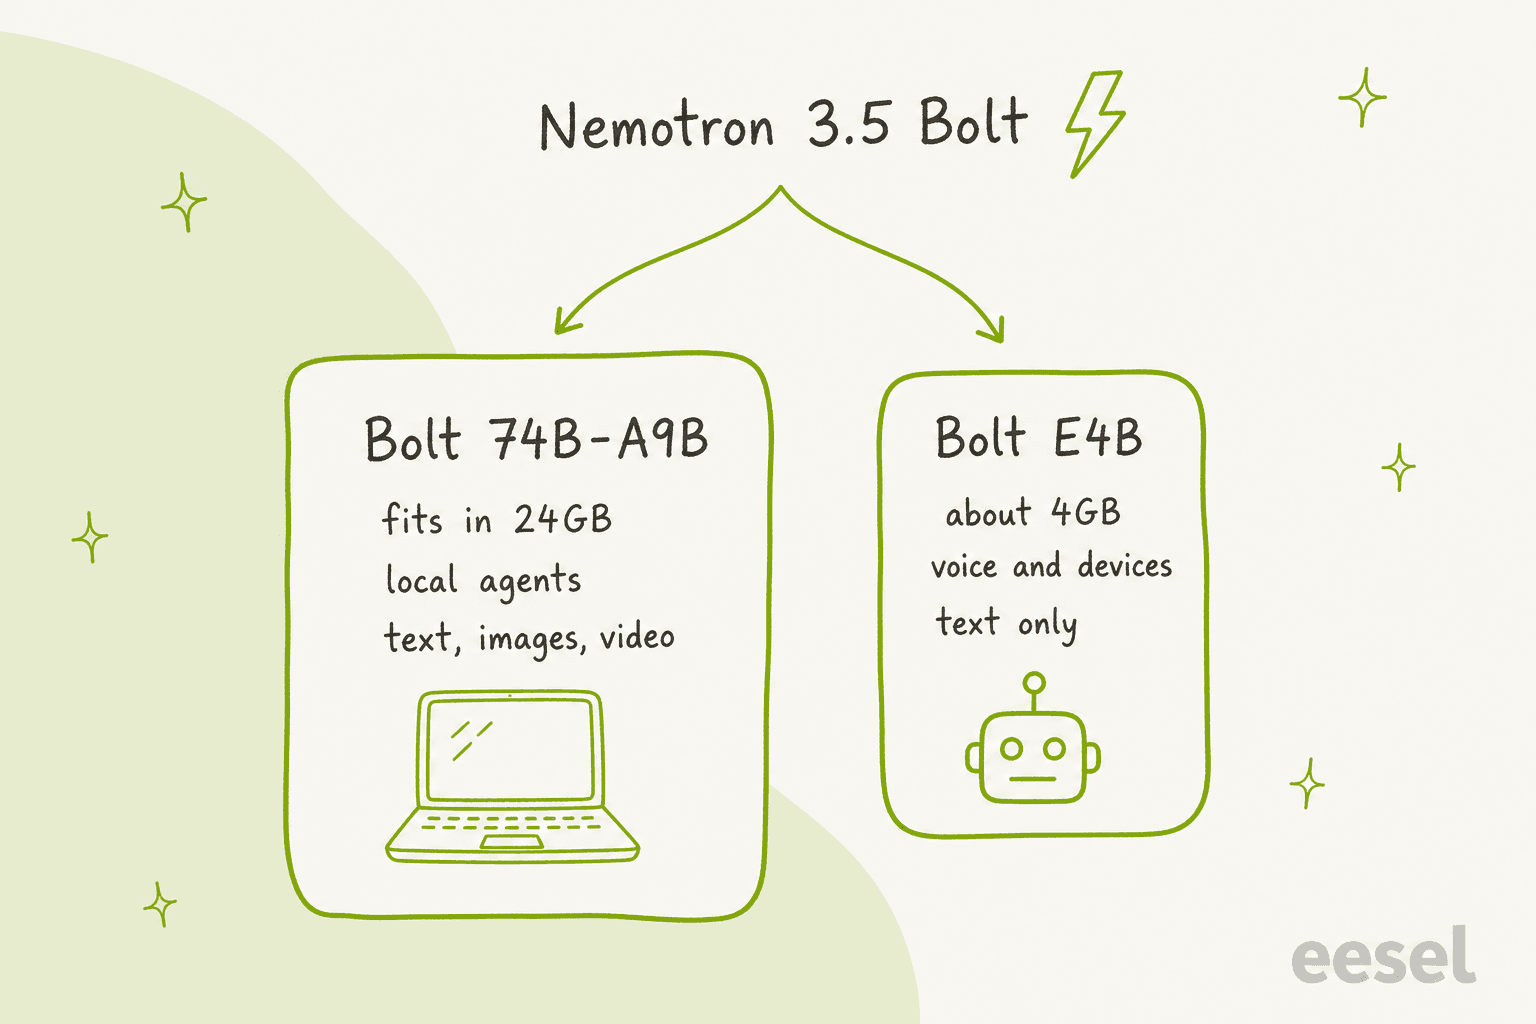
Nemotron 3.5 Bolt ist NVIDIAs neue Familie offener Modelle für den Betrieb auf Ihrem eigenen Rechner, und sie besteht aus zwei Modellen, nicht aus einem. Bolt 74B-A9B bringt ein Modell mit 74B Parametern in 24GB unter, mit 2-Bit-Gewichten, damit lokale Agenten auf einer einzigen Consumer-GPU laufen können. Bolt E4B ist ein 4GB-Modell für Sprachassistenten, Spielfiguren und Geräte.
Das 74B-Modell erreicht 21 im Artificial Analysis Intelligence Index, den vierten Platz unter Modellen mit weniger als 100B Parametern und liegt höchstens 2 Punkte hinter NVIDIAs Nemotron 3 Ultra mit 550B Parametern. Die Gewichte sind unter OpenMDW-1.1 kostenlos verfügbar, und für keines der beiden Bolt-Modelle gibt es bisher eine kostenpflichtige API. Ihre Kosten beschränken sich also auf Ihre Hardware.
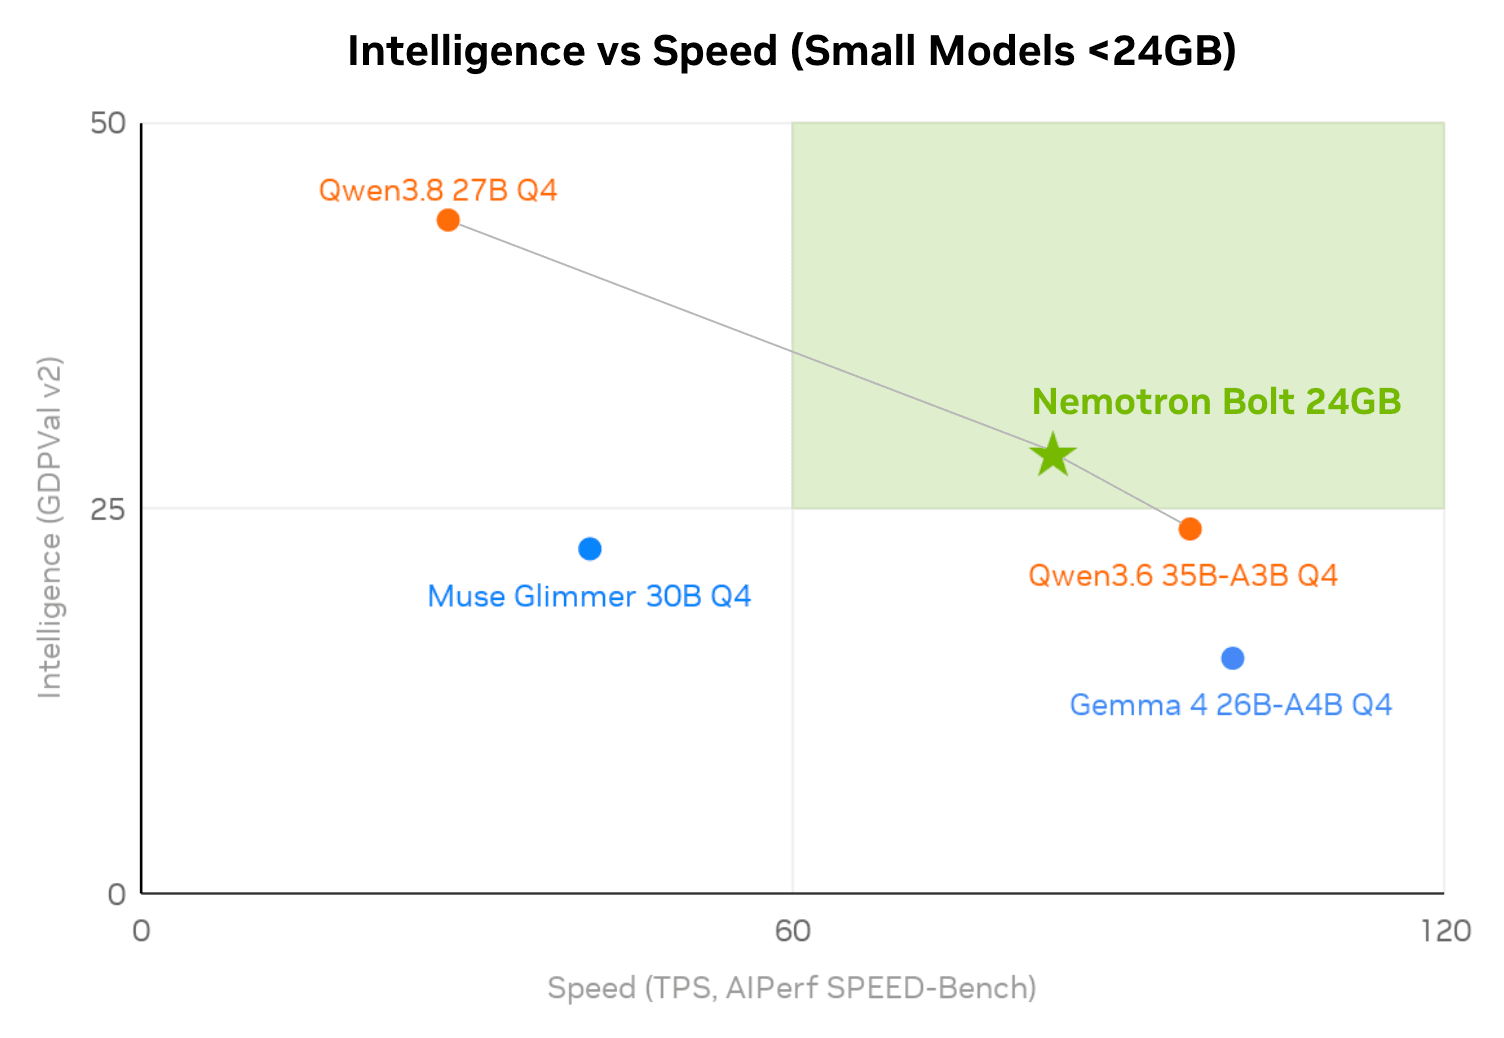
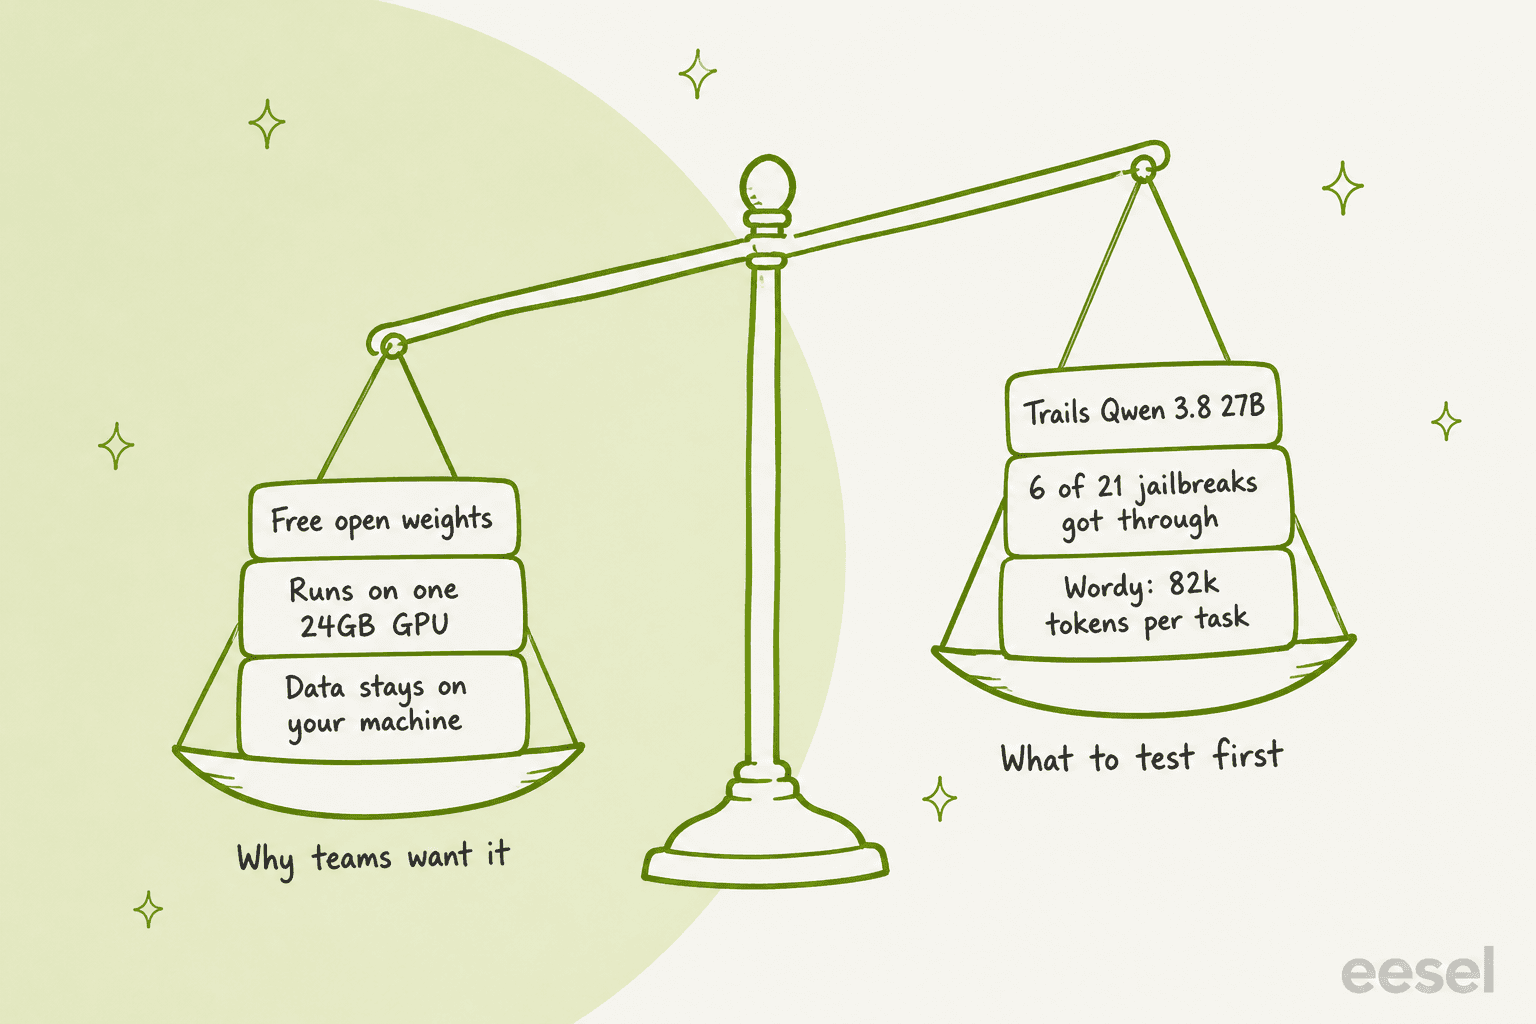
Der Haken: Das dichte Qwen3.8 27B ist immer noch intelligenter (44.5 gegenüber 28.5 in NVIDIAs eigenem GDPVal-v2-Diagramm), Bolt ist wortreich, und bei einem Tester scheiterte es an 6 von 21 Jailbreak-Tests. Für Supportteams ist es eine vielversprechende Engine für private Arbeit direkt auf dem Gerät, kein Ticketbeantworter, den Sie einfach einschalten. Wenn Sie genau das heute möchten, antwortet der KI-Helpdesk-Teamkollege von eesel ausschließlich auf Grundlage Ihrer eigenen Dokumente und wird mit Ihren bisherigen Tickets getestet, bevor er jemandem antwortet.
Warum ich den technischen Bericht zu Bolt gelesen habe
Ich entwickle Funktionen und KI-Agenten bei eesel, deshalb verbringe ich den Großteil meiner Woche mit dem unspektakulären Kern eines Agenten: Was kommt in den Kontext, welches Tool ruft er auf, und was passiert, wenn das Modell falschliegt? Die Frage, die ich von technisch versierten Käufern am häufigsten höre, lautet nicht „Wie intelligent ist es?“, sondern „Wohin gehen unsere Daten?“. In einem Verkaufsgespräch dieses Jahr fragte ein Evaluator bei einem Hardwareunternehmen, ob die KI auf "some kind of other ChatGPT" zurückgreifen würde, wenn sie eine Antwort nicht wüsste, und ob ihr Wissen auf ihre Organisation beschränkt bliebe.
Ein Modell, das Sie auf einem Rechner unter Ihrem eigenen Schreibtisch betreiben können, ist eine ehrliche Antwort auf diese Frage. Als NVIDIA also ein Modell veröffentlichte, dessen gesamtes Versprechen „ein großes Modell in 24GB unterbringen“ lautet, las ich die Modellkarte, den technischen Bericht und jeden Nutzertest, den ich finden konnte. Hier erfahren Sie, was standhält und was eine Fußnote braucht.
Was ist Nemotron 3.5 Bolt?
Nemotron 3.5 Bolt ist NVIDIAs „Edge“-Reihe innerhalb der Nemotron-3.5-Familie. NVIDIA kündigte sie am 15. Oktober 2026 gemeinsam mit Nemotron 3.5 Super VL an und beschreibt die Familie so: Lightning übernimmt Workloads mit hohem Durchsatz, Ultra übernimmt die anspruchsvollsten Schlussfolgerungen, und "Bolt brings intelligence to the edge."
Der Name umfasst zwei sehr unterschiedliche Modelle, was in vielen frühen Berichten für Verwirrung sorgt:
- Bolt 74B-A9B 24GB ist das Modell, das im Mittelpunkt steht. Laut NVIDIA ist es "designed to run everyday agentic tasks locally on NVIDIA RTX/DGX Spark, using a native 2-bit quantization to fit in 24GB of memory,".
- Bolt E4B 4GB erschien am 23. Oktober. Es ist ein 8B-Modell mit 4B effektiven Parametern, das auf Googles Gemma 4 E4B mit Nemotron-Post-Training aufbaut, für "fast local voice assistants, interactive characters and embedded interfaces."
Hier sind die Spezifikationen im direkten Vergleich:
| Spezifikation | Bolt 74B-A9B 24GB | Bolt E4B 4GB |
|---|---|---|
| Veröffentlicht | 15. Oktober 2026 | 23. Oktober 2026 |
| Parameter | 74B insgesamt, 9B aktiv pro Token | 8B insgesamt, 4B effektiv |
| Grundlage | Nemotron 3.5 Super VL (120B), komprimiert | Gemma 4 E4B, nachtrainiert |
| Architektur | Hybrides Mixture-of-Experts aus Mamba-2 und Transformer | Gemma 4 E4B |
| Gewichtsformat | 2-Bit-Experten (IQ2_XXS), 22.1GB | 4-Bit (Q4_K_M) |
| Eingaben | Text, Bilder, Video (MP4 bis zu 2 Minuten) | Text |
| Kontextfenster | Bis zu 256K Token | 64K Token |
| Zielhardware | RTX Spark, DGX Spark, GeForce RTX, RTX PRO | GeForce RTX, Jetson, RTX/DGX Spark |
| Lizenz | OpenMDW-1.1 | OpenMDW-1.1, plus Apache 2.0 für die Gemma-Basis |
Bei beiden lässt sich Reasoning ein- oder ausschalten, und das 74B-Modell unterstützt Tool-Aufrufe und JSON-Ausgabe. Wenn Sie offene Veröffentlichungen wie Meta Muse Spark Open oder Kimi K3 verfolgt haben, liegt der Unterschied hier im Einsatzziel: Bolt ist für einen einzelnen Rechner gebaut, nicht für ein Rechenzentrum.
Wie bringt NVIDIA ein 74B-Modell in 24GB unter?
Die Kurzfassung: groß anfangen, beschneiden, dann jede Zahl verkleinern. NVIDIAs Forschungsseite formuliert das Ziel klar: "fit into 24GB of memory and achieve a decoding speed of at least 80 TPS, while maximizing intelligence." Vier Schritte führen dorthin.
- Ein größeres Modell komprimieren. Bolt beginnt als Super VL, das 120B Parameter hat und 22 Experten pro Token auswählt. NVIDIAs Star Elastic-Methode beschneidet es auf 74B und legt die Expertenzahl auf 9 fest. Allein das kostet laut technischem Bericht 2.85 Punkte durchschnittliche Genauigkeit, 4,94 % im Vergleich zum Ausgangsmodell.
- Mit Training reparieren. Bolt erhält anschließend 120B Token Wiederherstellungstraining, eine erneut angebundene Bildverarbeitung, überwachtes Fine-Tuning und Reinforcement Learning. Die Bildverarbeitung braucht es am dringendsten: Die Komprimierung senkte den WebArena-Wert von 57.4 auf 1.35, und das Training brachte ihn zurück auf etwa 50.
- Die Experten auf 2 Bit quantisieren. Die Expertengewichte werden mit jeweils 2.0625 Bit gespeichert. Dabei kommt quantisierungsbewusste Destillation zum Einsatz, damit das kleine Modell lernt, bei dieser Präzision mit dem großen mitzuhalten. Die Mamba-Schichten verwenden 4-Bit-NVFP4, während Attention und Embeddings bei 8-Bit bleiben. Das reduziert das Modell von 148GB auf 22.1GB, "an 85.1% reduction in size. This quantization is lossy by design," sagt NVIDIA.
- Einen Drafter für mehr Geschwindigkeit hinzufügen. Ein separates Modell mit 1.13B Parametern namens LiLiCorr sagt mehrere Token voraus, und das Hauptmodell überprüft sie. So erreicht NVIDIA 84 Token pro Sekunde auf RTX Spark.
NVIDIA setzt darauf, dass ein großes, auf 2-Bit geschrumpftes Modell ein kleines, mit 4-Bit trainiertes Modell schlägt. Das ist das Gegenteil davon, wie die meisten lokalen Modelle gebaut werden, und die neue Idee in dieser Veröffentlichung.
Eine Fußnote zu den „24GB“ im Namen: Die Speichertabelle im technischen Bericht ergibt für reinen Text 23.83GB. Der Vision-Encoder benötigt zusätzlich 1.68GB.
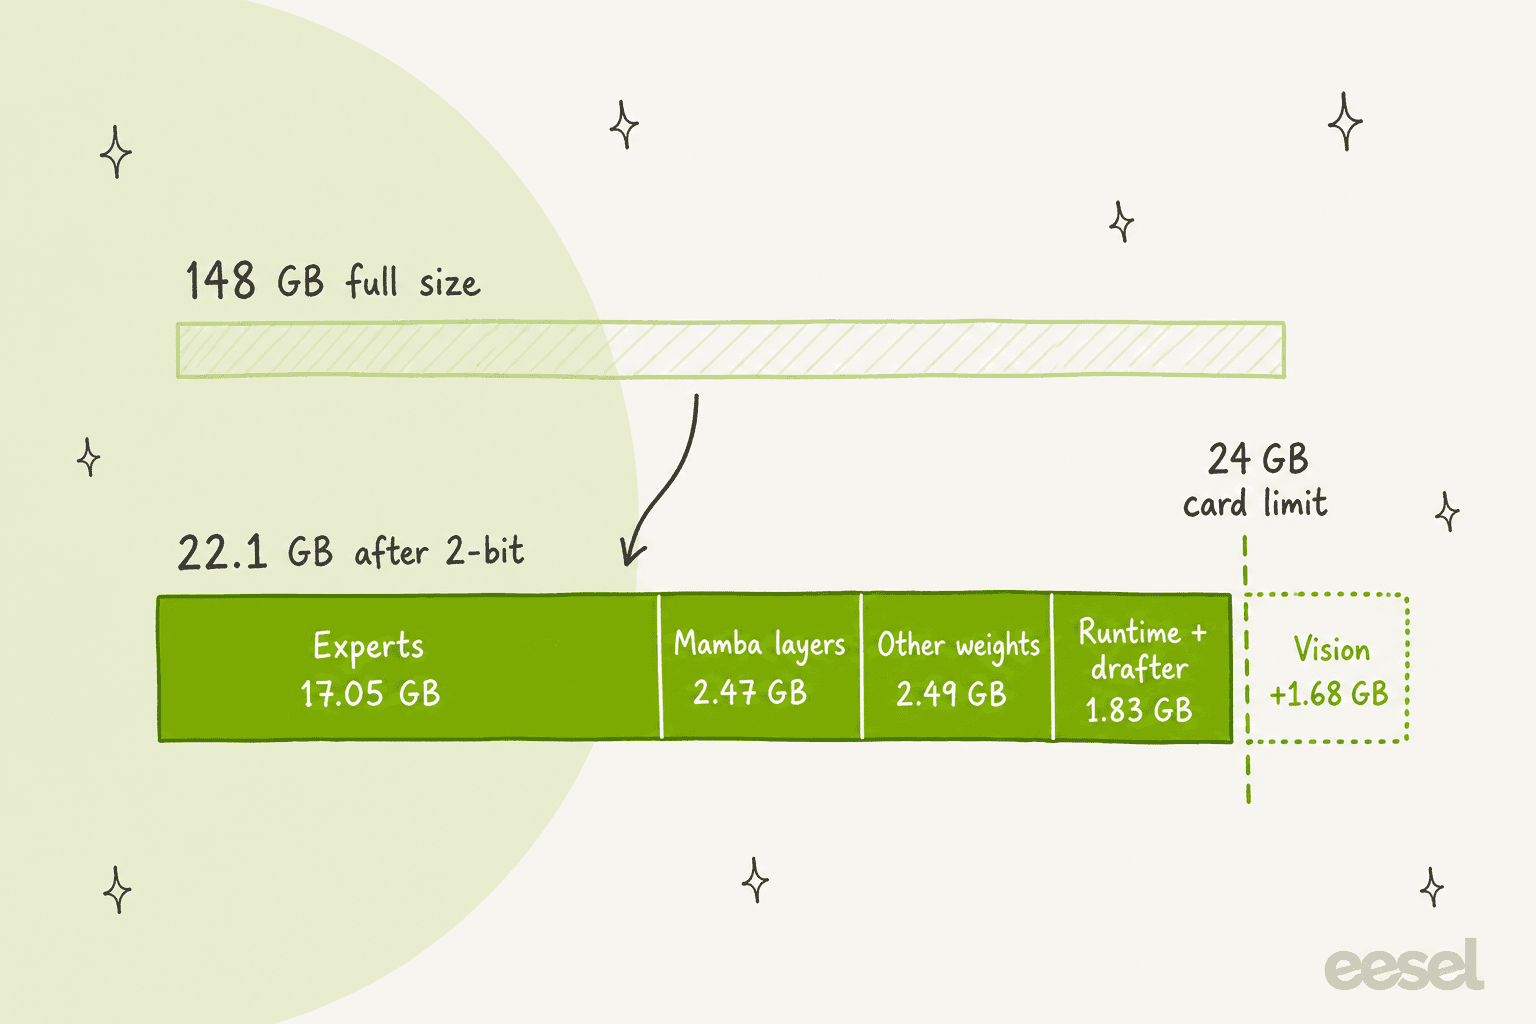
Auf einer 24GB-Karte betreiben Sie also Textagenten. Wenn Sie auch die Bild- und Videofähigkeiten nutzen möchten, planen Sie etwas mehr Spielraum ein. Unsloths Anleitung für den lokalen Betrieb empfiehlt ohnehin 24 bis 32GB Speicher.
Wie gut ist Nemotron 3.5 Bolt wirklich?
Schauen Sie sich zwei Ranglisten an: die unabhängige und NVIDIAs eigene.
Die unabhängige Bewertung. Artificial Analysis bewertet Bolt 74B mit 21.4 im Intelligence Index, "placing 4th among models under 100B parameters and first among US models in that class." Das liegt höchstens 2 Punkte hinter Nemotron 3 Ultra (23), einem Modell mit etwa siebenmal so vielen Parametern. Bolt schlägt Ultra sogar bei AutomationBench-AA (15,5 % gegenüber 3,0 %).
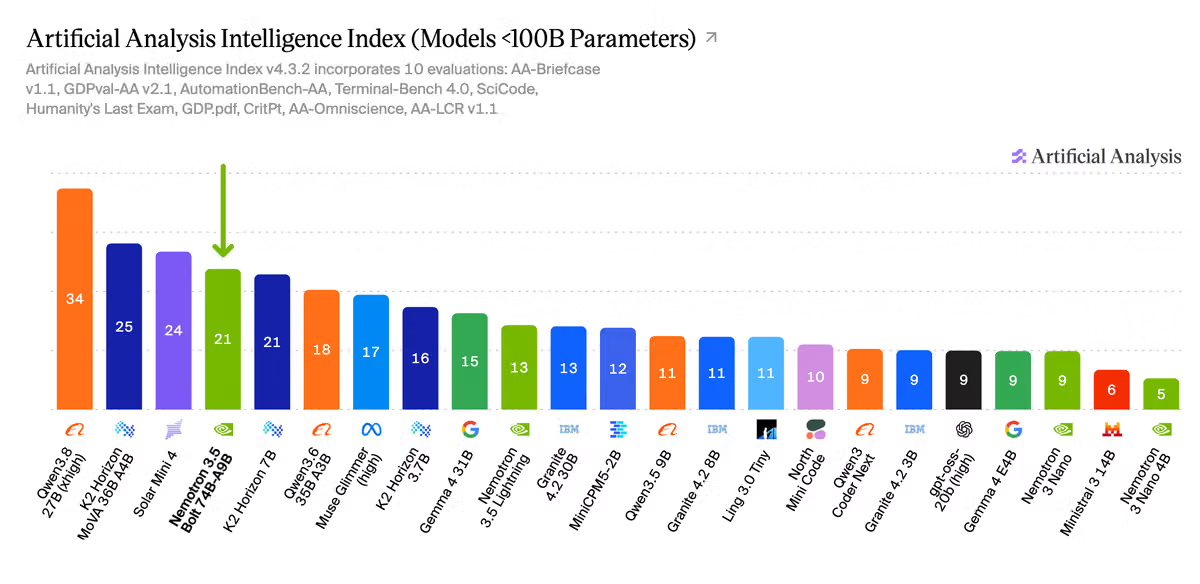
Schauen Sie aber auf die linke Seite dieses Diagramms. Qwen3.8 27B erreicht 34. Bolt ist das beste US-Modell seiner Klasse, nicht das beste Modell seiner Klasse.
NVIDIAs eigene Tabelle. Die Modellkarte lässt das 2-Bit-Bolt gegen drei vergleichbare Mixture-of-Experts-Modelle mit voller Präzision antreten:
| Benchmark | Bolt 74B 24GB (2-Bit) | Qwen3.6 35B-A3B | Gemma 4 26B-A4B | Nemotron 3.5 Lightning |
|---|---|---|---|---|
| GDPVal-AA-V2 (reale Arbeitsaufgaben) | 28.47 | 25.75 | 15.33 | 18.26 |
| Terminal-Bench 2.1 | 50.98 | 44.38 | 37.22 | 23.46 |
| Tau3 Banking (Kundenservice) | 17.01 | 10.52 | 14.02 | 9.48 |
| GPQA Diamond | 86.43 | 83.40 | 79.61 | 75.57 |
| BrowseComp | 66.75 | 48.74 | 26.30 | 36.81 |
| PinchBench | 87.82 | 88.07 | 74.70 | 83.43 |
| AA-Omniscience-Genauigkeit | 16.90 | 19.47 | 22.17 | 16.63 |
| IFBench (Befolgen von Anweisungen) | 66.17 | 63.71 | 77.25 | 72.88 |
Gegen diese drei gewinnt Bolt in den meisten Zeilen, und das mit 2-Bit zu schaffen, ist beeindruckend. Die Tabelle lässt aber das dichte Qwen3.8 27B aus. NVIDIAs eigener technischer Bericht zeigt es bei 44.5 auf GDPVal v2 gegenüber Bolts 28.5, bei ungefähr einem Drittel der Geschwindigkeit. Das ist ein fairer Kompromiss, aber Sie müssen das PDF lesen, um ihn zu sehen.
Zwei weitere Kostenpunkte sollten Sie kennen:
- 2-Bit hat seinen Preis. Gegenüber Bolts eigenen Gewichten mit voller Präzision sinkt GDPVal laut technischem Bericht von 31.13 auf 28.47 und die Omniscience-Genauigkeit von 21.80 auf 16.90.
- Es redet viel. Artificial Analysis zählte 82k Ausgabe-Token pro Index-Aufgabe, 1,8x so viele wie bei Super VL und 2,9x so viele wie bei Ultra. Lokal kostet das Zeit statt Geld, aber es bleibt Zeit.
Wie schnell ist es auf echter Hardware?
NVIDIAs eigene Geschwindigkeitstabelle ist zurückhaltender als die Beiträge zur Veröffentlichung. Auf RTX Spark mit llama.cpp läuft Bolt laut Forschungsseite mit 83.99 Token pro Sekunde, gegenüber 96.63 für Qwen3.6 35B-A3B, 100.56 für Gemma 4 26B-A4B und 28.26 für Qwen3.8 27B. Es ist also langsamer als die kleinen Mixture-of-Experts-Modelle, die es bei der Genauigkeit schlägt, und etwa 3x schneller als das dichte Modell, das es schlägt.
Nutzer mit größeren Karten sehen deutlich mehr:
"343 tok/s median with the LiLiCorr drafter (DFlash, n_max 6, about 55% of drafted tokens accepted), 166 tok/s without it. 25.0 GiB at 32K with the drafter and the projector, 22.7 GiB without the drafter."

Das ist auf einer RTX 5090. Beachten Sie die 25GB, sobald Bildverarbeitung und Drafter geladen sind. Auf einer 16GB-Karte berichtete ein Nutzer von etwa 45 Token pro Sekunde, indem er einen Teil des Modells in den Arbeitsspeicher auslagerte. Mac-Nutzer haben es derzeit schwerer:
"Nemotron Bolt appears to be really quite good but unfortunately it is quite slow on macOS/Metal in llama.cpp at the moment because of lack of support for a tensor type (or something… not sure I understand)."

Was kostet Nemotron 3.5 Bolt?
Die Gewichte sind kostenlos, und das ist die gesamte Preisliste. Stand 27. Oktober 2026 hat keines der beiden Bolt-Modelle eine kostenpflichtige gehostete API. Es ist weder auf OpenRouter noch auf DeepInfra gelistet, NVIDIAs build.nvidia.com-Seite für das 74B-Modell liefert einen 404 zurück, und Artificial Analysis gibt "No publicly available API." an.
| Zugangsweg | Bolt 74B-A9B 24GB | Bolt E4B 4GB |
|---|---|---|
| Offene Gewichte | Kostenlos, OpenMDW-1.1 | Kostenlos, OpenMDW-1.1 |
| Von NVIDIA gehostet | Nicht verfügbar | Kostenloser Testendpunkt unter NVIDIAs API Trial Terms |
| OpenRouter, DeepInfra | Nicht gelistet | Nicht gelistet |
| Lokaler Download | 22GB (2-Bit-GGUF) | 6.18GB (4-Bit-GGUF, Unsloth) |
| Speicher für den Betrieb | 24 bis 32GB | Etwa 4GB Grafikspeicher |
Wenn Sie lieber pro Token bezahlen möchten, gibt es die Geschwistermodelle als gehostete Angebote. Auf OpenRouter ist Super VL mit 0,15 $ pro Million Eingabe-Token und 0,50 $ für die Ausgabe gelistet, Lightning mit 0,07 $ und 0,20 $. Wenn Sie ein gehostetes Modell planen, vergleicht mein Leitfaden zum besten KI-Modell für Supporttickets auch die geschlossenen Optionen, etwa Claude Haiku 5.5 und Gemini 3.8 Flash.
Die Lizenz ist die andere Hälfte der Kostenfrage, und sie fällt positiv aus. OpenMDW-1.1 erlaubt die Nutzung "without restriction,", schränkt Ausgaben nicht ein und hat weder eine Nutzerobergrenze noch eine Richtlinie zur akzeptablen Nutzung. Bei der Weiterverbreitung behalten Sie die Hinweise bei, und Ihre Rechte enden, wenn Sie klagen und behaupten, das Modell verletze ein Patent oder Urheberrecht. Ein Reddit-Kommentator nannte sie "an Apache styled license,", was es ziemlich gut trifft.
Wie betreiben Sie es?
Sie haben mehr Optionen als bei den meisten Veröffentlichungen am ersten Tag. NVIDIA und seine Partner lieferten:
- Ollama:
ollama run nemotron-3.5-boltlädt den 25GB-Build mit 256K Kontext und Bildeingabe herunter. Ollama listet auch einzeilige Startbefehle für Claude Code, OpenCode, Hermes Agent und OpenClaw. - llama.cpp: NVIDIAs eigenes GGUF plus eine separate Drafter-Datei. Laut NVIDIA ist der Build "optimized for use on RTX Spark with llama.cpp and DGX Spark with vLLM."
- vLLM: benötigt einen Nightly-Build und unterstützt derzeit nur GPUs der Blackwell-Generation.
- LM Studio, Unsloth und ein Canonical-Snap runden das Angebot ab.
Der eigentliche Anwendungsfall ist die Einbindung in eine lokale Agenten-Laufzeitumgebung. NVIDIA wirbt damit, Bolt Projekte "from researching the web to writing to debugging code," zu übergeben, ohne die Arbeit in die Cloud zu schicken. Die Nutzer, denen es am besten gefällt, geben ihm eine eng umrissene Aufgabe mit einem klaren Ziel:
"I really don't hate this model. I was expecting to, it's a 2 bit quant for fucks sakes, but it seems to do really well when it's got some tools, a defined goal and a success condition such as 'compile works and tests pass'."
Was sagen die ersten Tester?
Die Reaktion auf r/LocalLLaMA ist positiv, aber mit klaren Grenzen. Vier Themen tauchten immer wieder auf.
Der 2-Bit-Trick funktioniert besser als erwartet. Ein Kommentator bezeichnete "74GB QAT coming in at 24GB on disk" als "pretty incredible" und sagte, es "has a decent chance of retiring Qwen3.6-35B for some people." Ein anderer setzt es bei der Arbeit zur Faxverarbeitung ein, wo es sein bisheriges Bildverarbeitungsmodell im direkten Vergleich schlug.
Bei echter Arbeit liegt es unter dem dichten Qwen 3.8 27B. Der sorgfältigste Test, den ich fand, führte 33 Infrastrukturaufgaben auf einer RTX 5090 aus:
"26 of 33 passed, with the LiLiCorr drafter on. On the same tasks the same day qwen3.8:27b passed 32, qwen3.6:27b 31, gemma4:31b and glm-4.7-flash 29, qwen3.6:35b and gemma4:12b 27."
Ein zweiter Tester führte 36 Aufgaben im Blindtest gegen Gemma 31B durch und fand Bolt "about 3.5 times faster, but it made up more problems that weren't there."
Es erkundet viel. Derselbe Tester mit den 33 Aufgaben stellte fest, dass 54 % seiner Tool-Aufrufe Prüfungen und Diagnosen waren, und fasste es so zusammen: "Careful, and expensive in turns." Ein anderer Nutzer beobachtete, dass es die Docker-Anweisung in seiner AGENTS.md-Datei übersprang.
Sicherheit ist ein echtes Fragezeichen. Dieser Punkt ist für alles mit direktem Kundenkontakt am wichtigsten:
"It is not safe for an agent; it failed 6/21 jailbreak tests. Qwen3.8 Flash and 27 B failed none."
Es ist der Test einer einzelnen Person, und eine Antwort im selben Thread brachte den berechtigten Einwand: "If you're relying on model weights to protect you from hostile content, you're doing it wrong." Beides stimmt.
Was ist mit Bolt E4B?
Bolt E4B sollten Sie im Auge behalten, wenn Sie Sprach- oder Geräteprodukte entwickeln. NVIDIAs E4B-Seite verspricht "~40 % higher average quality" gegenüber dem vorherigen 4B-Modell und "up to ~80% fewer tokens vs peers," und nennt "customer service" als einen seiner Einsatzbereiche für Sprachassistenten. Es hat einen Konversationsmodus, der Antworten kurz genug zum Vorlesen hält, und unterstützt 35 Sprachen.
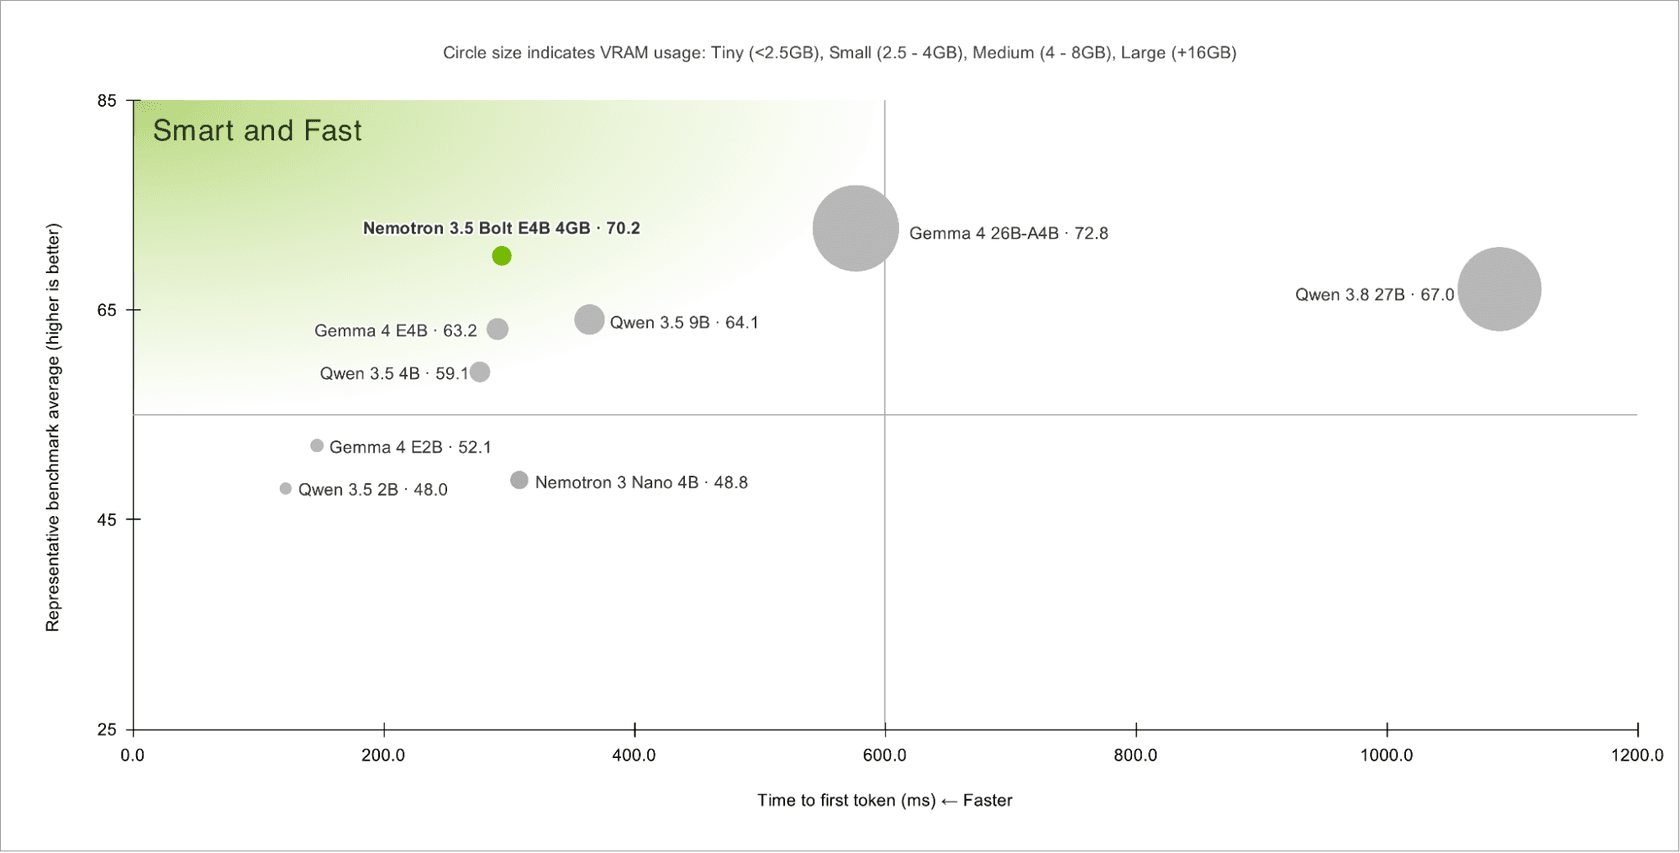
Es ist schnell. Auf einer RTX 5070 gibt es sein erstes Token nach 548 Millisekunden zurück und läuft mit 133.4 Token pro Sekunde bei 3.5GB Grafikspeicherverbrauch. Selbst ein Jetson Orin Nano schafft 15.5 Token pro Sekunde.
Die Benchmark-Tabelle zeigt überwiegend Siege, aber eine Zeile sollten Supportteams beachten:
| Benchmark | Bolt E4B | Qwen 3.5 4B | Gemma 4 E4B |
|---|---|---|---|
| IHEval (Anweisungshierarchie) | 84.8 | 60.6 | 67.0 |
| RoleMRC | 80.6 | 65.8 | 74.6 |
| RAGTruth F1 | 77.6 | 75.6 | 77.0 |
| BFCL-v3 (Tool-Aufrufe) | 68.5 | 70.9 | 66.4 |
| Tau2-Bench (Kundenaufgaben) | 55.1 | 75.1 | 38.5 |
Qwen 3.5 4B schlägt es auf Tau2-Bench um 20 Punkte, dem Benchmark, der einen Agenten simuliert, der Kundenanfragen gemäß einer Unternehmensrichtlinie bearbeitet. Wenn Sie einen Sprachagenten für den Kundensupport entwickeln, testen Sie beide.
Eignet sich Nemotron 3.5 Bolt für den Kundensupport?
Für einen Teil des Supports eignet es sich gut, und für den Teil, den die meisten meinen, ist es eine riskante Wahl.
Der gute Teil: Daten im Unternehmen behalten. Ein Modell, das auf einem einzelnen Rechner mit einer freizügigen Lizenz läuft, beantwortet die Frage „Wohin gehen unsere Daten?“ eindeutig. Für interne Arbeit, etwa Tickets zusammenzufassen, sie zu klassifizieren oder Antwortentwürfe zu erstellen, die ein Supportmitarbeiter prüft, ist ein lokales Bolt eine vernünftige Engine. Sein Tau3-Banking-Wert (17.01) schlägt jedes vergleichbare Modell in NVIDIAs Tabelle.
Der riskante Teil: Kunden direkt antworten. 17 % in einem Benchmark für Kundenservice im Bankwesen ist absolut gesehen immer noch wenig. Dazu kommen eine gemeldete Fehlerquote von 6 bei 21 Jailbreak-Tests und die Gewohnheit, mit zusätzlichen Tool-Aufrufen zu erkunden. Damit haben Sie ein Modell, das viel unterstützende Infrastruktur braucht, bevor es mit einem Kunden spricht. Jede Kundennachricht ist eine nicht vertrauenswürdige Eingabe.
Was diese unterstützende Infrastruktur leisten muss, ist der Teil, mit dem ich meine Tage verbringe. eesel hat früh gelernt, dass ein falsches Detail schlimmer ist als gar keine Antwort. Deshalb wird jede Einführung anhand historischer Tickets simuliert, bevor eine KI einem echten Kunden antwortet. Einer der Kunden, über die wir berichtet haben, ein Unternehmen für Industrieautomatisierung, betreibt einen Chat, der seinen Ingenieuren ausschließlich auf Grundlage seiner technischen Dokumente antwortet und angibt, woher jede Antwort stammt. Keine Antwort zu finden, ist dort ein akzeptables Ergebnis. Das ist eine Eigenschaft des Systems rund um das Modell, nicht der Gewichte. Unser Leitfaden zur Vermeidung von KI-Halluzinationen im Support behandelt die Schutzmechanismen ausführlicher.
Mein Fazit also: Wenn Sie Entwickler, eine NVIDIA-GPU mit 24GB+ und einen Grund haben, Daten lokal zu halten, ist Bolt ein Wochenende wert. Es ist nichts, das Sie am Montag auf Ihre Zendesk-AI-Warteschlange loslassen. Wenn Sie stattdessen fertige Tools vergleichen, beginnen Sie mit meiner Übersicht über KI-Helpdesk-Software.
Wer sollte Nemotron 3.5 Bolt nutzen?
So würde ich entscheiden:
- Sie betreiben lokale Programmier- oder Rechercheagenten auf einer GPU. Genau dafür wurde Bolt 74B gebaut. Geben Sie ihm Tools und eine klare Erfolgsbedingung.
- Sie müssen Daten von der Cloud fernhalten. Regulierte Daten, ein Vertrag, der externe KI-Verarbeiter verbietet, oder ein Laptop im Flugzeug. Die Lizenz und der Speicherbedarf von 24GB machen die Entscheidung leicht zu begründen.
- Sie entwickeln Sprach-, Spiele- oder Geräteprodukte. Bolt E4B ist bewusst schnell, klein und kurz angebunden.
- Sie möchten das intelligenteste Modell, das in 24GB passt. Schauen Sie sich zuerst Qwen3.8 27B an und akzeptieren Sie, dass es etwa 3x langsamer ist. Oder wählen Sie ein gehostetes Angebot mit Qwen3.8 Flash-Next oder DeepSeek V4 Flash.
- Sie benötigen diese Woche eine gehostete API. Bolt hat keine. Nutzen Sie stattdessen Nemotron 3.5 Super VL, das auf OpenRouter verfügbar ist.
Testen Sie eesel
Nemotron 3.5 Bolt ist Infrastruktur: kostenlose Gewichte, eine GPU und ein Wochenende Einrichtung. Den Informationsabruf, die Eskalationsregeln, die Tests und das Audit-Protokoll müssten Sie trotzdem noch bauen. eesel ist der Mitarbeiter. Unser KI-Helpdesk-Teamkollege lässt sich an Zendesk, Freshdesk, Gorgias und die übrigen Systeme anbinden, lernt aus Ihren bisherigen Tickets und Ihrem Hilfecenter und antwortet ausschließlich auf Grundlage Ihres eigenen Wissens. Bevor er auch nur einem Kunden antwortet, können Sie ihn mit Hunderten Ihrer historischen Tickets testen und sehen, was er gesagt hätte.
So setzt Dokument 24 ihn in Zendesk ein: In einem Monat bereitete der Teamkollege 680 Tickets für das Team vor und hinterließ 670 Antwortentwürfe auf Dänisch als interne Notizen, bereit zum Senden oder Bearbeiten.

Wenn Sie Agenten gern über ein Terminal steuern, so wie ein lokales Modell, bedienen Sie mit der eesel CLI denselben Teamkollegen. Sie können seine dauerhaften Anweisungen lesen und bearbeiten, Aktionen auflisten, die auf eine menschliche Genehmigung warten, und das Aktivitätsprotokoll jedes Durchlaufs prüfen. Dazu kommen JSON-Ausgabe und Testläufe für Schreibvorgänge, sodass ein Programmieragent wie Claude Code Ihren Support-Teamkollegen neben Ihrem Repository verwalten kann. Wenn Sie Inhalte schreiben, statt Tickets zu beantworten, gehört zum selben Team auch ein KI-Blogautor.
Der Einstieg ist kostenlos. Testen Sie eesel mit den Tickets des letzten Monats, bevor Sie dafür eine 24GB-Karte kaufen, und sehen Sie sich die Tarife auf der Preisseite an.