

Was Meta am 15. Oktober tatsächlich veröffentlicht hat
Metas Research-Blog nennt Muse Spark Open "das leistungsfähigste US-amerikanische Open-Weight-Modell bisher", gebaut für Coding und agentische Aufgaben. Der Beitrag des PyTorch-Teams ergänzt das wichtigste Detail: Es "teilt dasselbe Basismodell wie Muse Spark 1.3", mit zusätzlichem Safety-Post-Training, damit es "als eigenständiges Modell ohne System-Guardrails" standhält. Das ist ein großer Wandel für ein Unternehmen, das Muse Spark den Großteil des Jahres 2026 geschlossen gehalten hat.
Die Model Card auf Hugging Face listet die Spezifikationen:
| Spezifikation | Muse Spark Open |
|---|---|
| Veröffentlichung | 15. Oktober 2026 |
| Parameter | 816B insgesamt, 42B aktiv pro Token |
| Architektur | Mixture-of-Experts, 256 Experten, 8 aktiv pro Token, 62 Schichten |
| Kontext | 1M Token bei der Inferenz |
| Eingabe / Ausgabe | Text, Bild, Video, Audio rein; Text raus |
| Sprachen | Trainiert mit Daten aus über 100 Sprachen |
| Reasoning-Aufwand | low, medium, high, xhigh (Standard xhigh) |
| Gewichte | BF16 und NVFP4 |
| Lizenz | Muse Model License |
Der Launch war laut. Der Hacker-News-Thread erreichte am ersten Tag 914 Punkte und 477 Kommentare, und Apples eigener ML-Research-Beitrag über den Betrieb auf Mac Studios brachte es auf weitere 363 Punkte.
Wie 42B aktiv von 816B funktioniert
Das ist der Teil, den ich am interessantesten finde, weil er sowohl die Hardware-Geschichte als auch den Preis erklärt. Muse Spark Open ist ein Mixture-of-Experts-Modell. Jede Schicht enthält 256 kleine Expertennetze, und ein Router wählt für jedes Token 8 davon aus. Das Modell speichert also 816B Parameter, aber jedes Token läuft nur durch etwa 42B davon.
Daraus folgen zwei Konsequenzen, die oft verwechselt werden:
- Der Speicherbedarf wird von den 816B bestimmt. Jeder Experte muss im Speicher liegen, weil jedes Token jeden Experten brauchen könnte. Deshalb sind die BF16-Gewichte etwa 1,6TB groß.
- Die Geschwindigkeit wird von den 42B bestimmt. Jedes Token liest nur seinen Ausschnitt, die Generierung läuft also eher im Tempo eines 42B-Modells. Apple sagt es klar: Die 1,2 TB/s Bandbreite des M5 Ultra "reicht aus, um den kleinen Ausschnitt zu lesen, den jedes Token braucht".
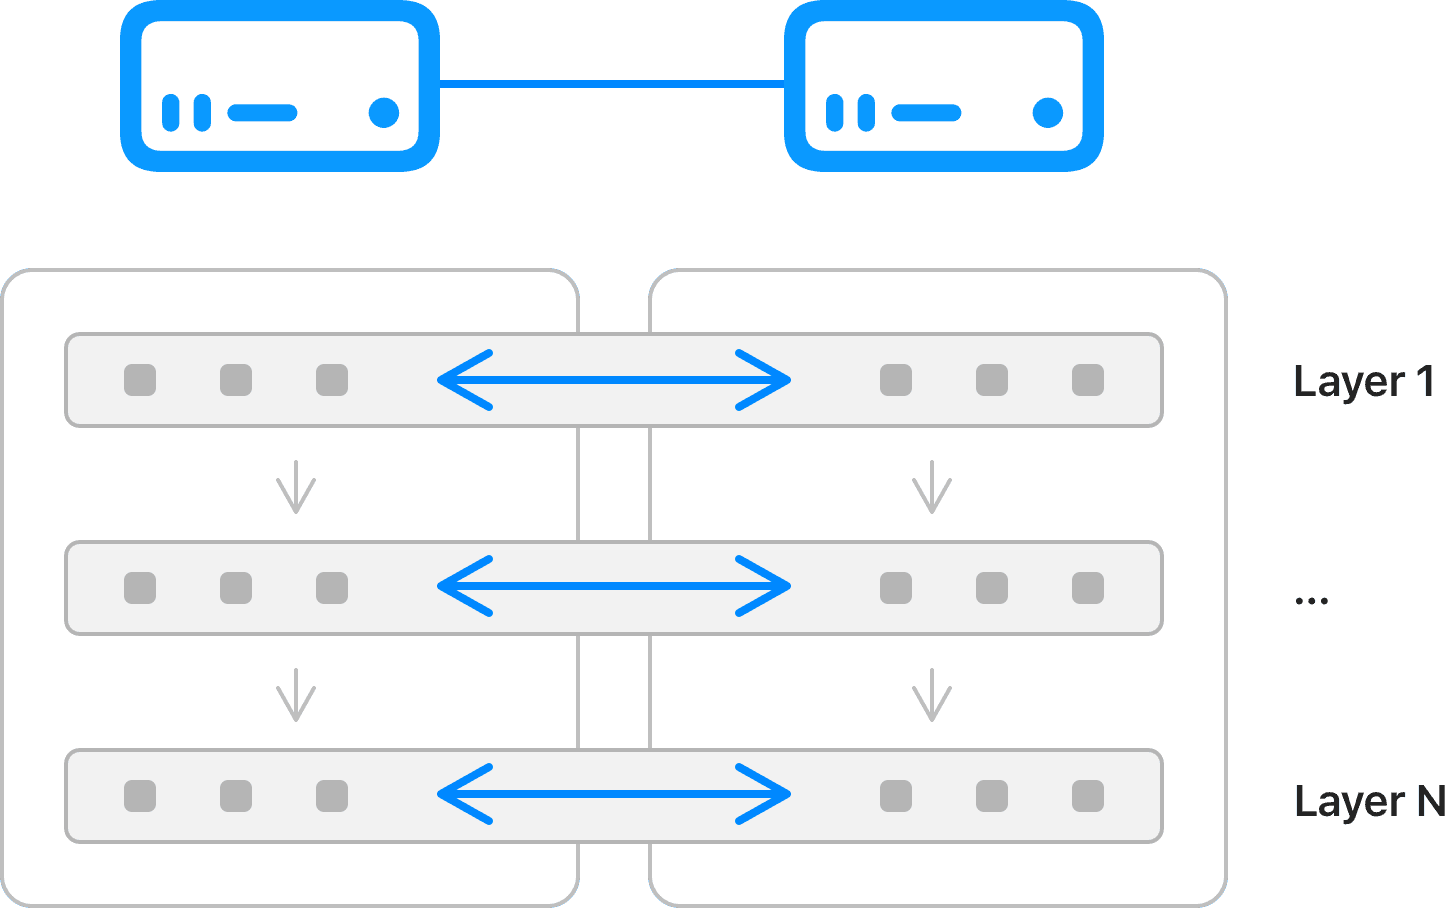
Metas Entwickler-Beitrag sagt, dass der NVFP4-Checkpoint nur die Experten quantisiert, was ihn auf etwa 530GB bringt. Das ist für jeden einzelnen Desktop immer noch zu groß, daher teilen Meta und Apple ihn mit Tensor-Parallelismus auf zwei Maschinen auf: Jeder Mac hält die Hälfte jeder Schicht und rechnet bei jedem Token die Hälfte.
Die Model Card beschreibt außerdem einen separaten Perception-Encoder mit 1,8B Parametern für Bilder und Video. In der Praxis müssen Sie also kein Vision-Modell nebenher anflanschen. Ein Checkpoint liest Screenshots, Aufzeichnungen und Dokumente, was wichtig ist, wenn Sie Agenten, die einen Computer bedienen bauen und nicht nur eine Chatbox.
Muse Spark Open Preise: dieselbe Preisliste wie beim geschlossenen Modell
Die Gewichte sind kostenlos. Die interessante Zahl ist, was das Mieten kostet. Meta betreibt Muse Spark Open nicht auf der eigenen API; die Preisseite listet nur Muse Wonder und die geschlossenen Spark-Modelle. Stattdessen hosten sieben Partner es, und diejenigen mit öffentlichen Preisen landeten alle bei derselben Preisliste.
| Wo | Eingabe / 1M | Gecacht / 1M | Ausgabe / 1M | Hinweise |
|---|---|---|---|---|
| OpenRouter | 1,25 $ | 0,15 $ | 4,25 $ | Routet über Modal, Together, Nebius, Fireworks, Baseten; 262.144 max. Ausgabe |
| Fireworks AI | 1,25 $ | 0,15 $ | 4,25 $ | Serverloses LoRA-Training per API |
| Baseten | 1,25 $ | 0,15 $ | 4,25 $ | NVFP4 mit spekulativem Drafter |
| Groq | Nicht öffentlich | Nicht öffentlich | Nicht öffentlich | Begrenzte Vorschau, 131K Kontext |
| Meta API: Muse Spark 1.3 Standard | 1,25 $ | 0,15 $ | 4,25 $ | Geschlossen, Meta-Preise |
| Meta API: Muse Spark 1.3 Contributor | 0,10 $ | 0,002 $ | 0,20 $ | Geschlossen, Meta trainiert mit Ihren Daten |
Das offene Modell kostet in der Miete genau so viel wie das geschlossene. Und das günstigste Meta-Token ist weiterhin der geschlossene Contributor-Tarif, bei etwa einem Zwanzigstel des Ausgabepreises, im Gegenzug dafür, dass Meta mit Ihrem Datenverkehr trainieren darf. Wenn Sie Muse Spark Open mit dem üblichen Open-Weights-Rabatt eingeplant haben, gibt es ihn noch nicht. Mein Beitrag zu Muse Spark 1.3 Preisen erklärt, wie dieser Zwei-Stufen-Deal funktioniert.
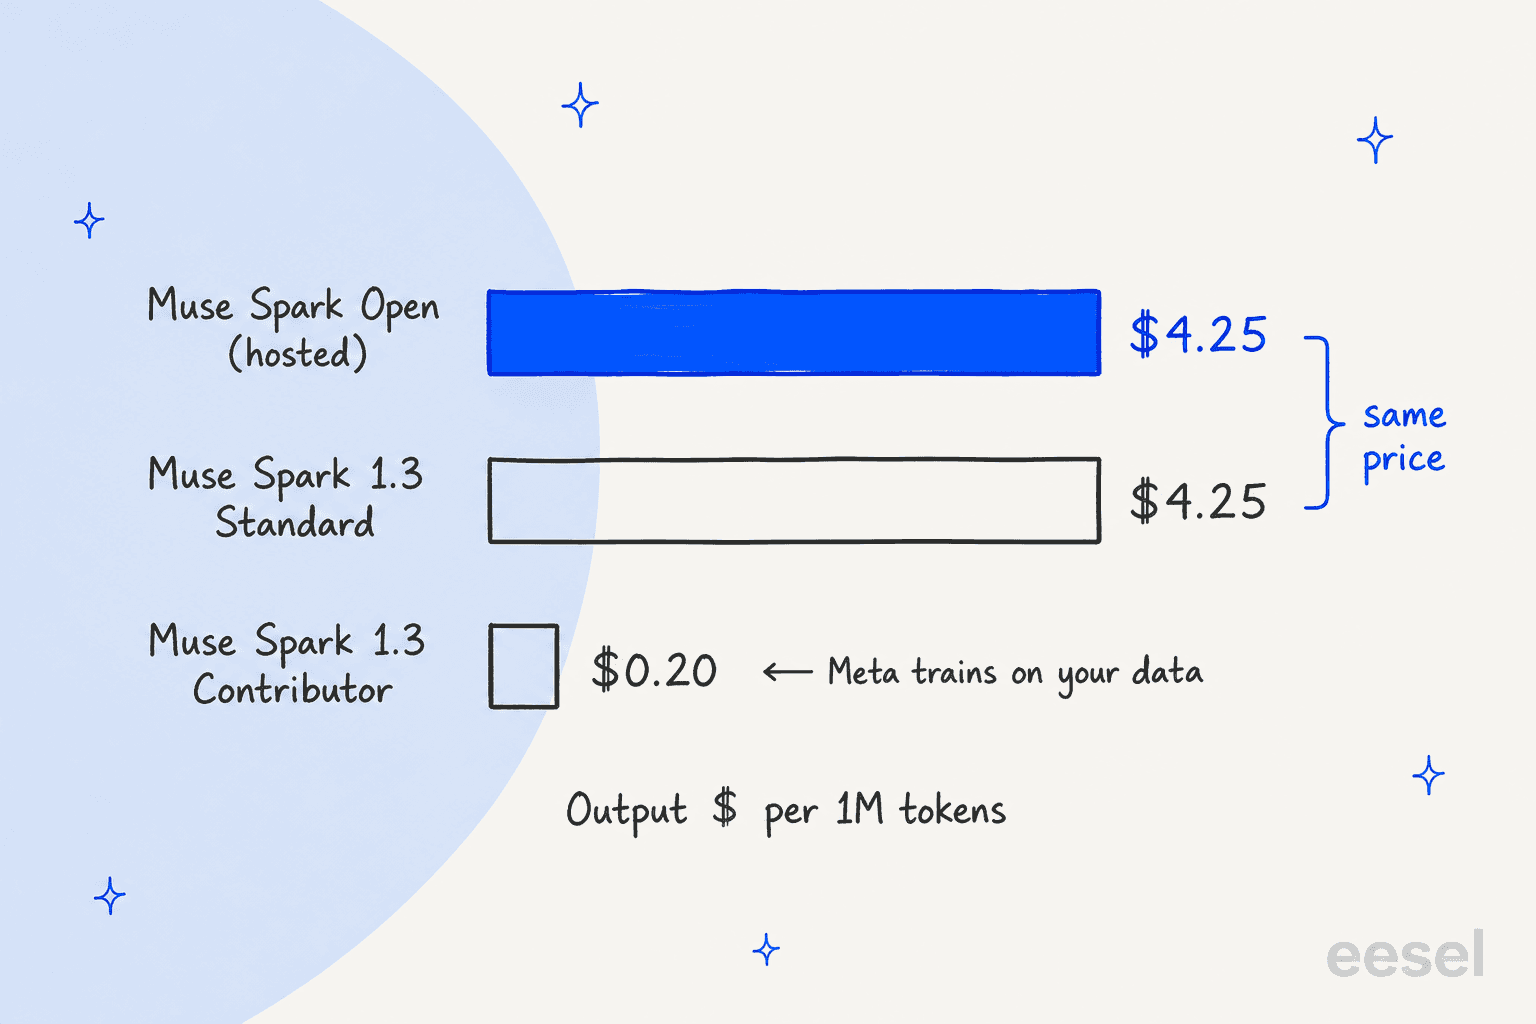
Zwei Dinge relativieren das. Caching ist aggressiv: OpenRouter meldet einen gewichteten durchschnittlichen Eingabepreis von etwa 0,35 $ pro Million über echten Datenverkehr, weil die Cache-Trefferquoten bei den meisten Anbietern über 70 % liegen. Und Artificial Analysis fand das Modell recht knapp: Es brauchte 110M Ausgabe-Token für seinen Index, gegenüber einem Median von 130M, bei etwa 0,84 $ pro Aufgabe.
Ein Hacker-News-Kommentator las die einheitlichen Preise als Nebeneffekt der Lizenz:
"The usual effect of separate licensing is decreased price competition from public providers (like we saw with Kimi K3)."

Das ist eine faire Lesart der Lizenz, auf die ich unten komme. Ob die Anbieter sich in ein paar Wochen gegenseitig unterbieten, würde ich beobachten. Zum Vergleich, wie andere Anbieter offene Modelle bepreisen, siehe Together AI Preise und Fireworks AI Preise.
Die Mac-Studio-Behauptung und der Haken
Metas Schlagzeile lautet, Muse Spark Open sei "das erste Modell seiner Klasse, das mit zwei Apple M5 Ultra Mac Studios auf Ihrem Desktop läuft". Das stimmt, und Apple hat die Zahlen veröffentlicht. In den Benchmark-Tabellen bei 8.192 Token Kontext:
| Setup | Zeit bis zum ersten Token | Decode-Geschwindigkeit |
|---|---|---|
| 2 Mac Studios, Pipeline-parallel | 8,4 s | 15,74 Tok/s |
| 2 Mac Studios, Tensor-parallel | 8,2 s | 24,99 Tok/s |
| 4 Mac Studios, Tensor-parallel | 4,8 s | 36,73 Tok/s |
Fünfundzwanzig Token pro Sekunde sind für einen Coding-Agenten, der im Hintergrund arbeitet, brauchbar. Meta sagt, es habe auf diese Weise echte iOS-Fixes für den Mastodon-Client Ice Cubes ausgeliefert und DaVinci Resolve von Anfang bis Ende gesteuert, alles auf dem Gerät über Muse Code.
Jetzt der Haken. Das Setup mit zwei Macs braucht 512GB Speicher pro Maschine, und Apples eigener Store listet die 512GB-Option für den M5 Ultra mit "Ende Oktober verfügbar". Stand heute können Sie sie nicht bestellen. Die Mac-Studio-Store-Seite startet M5-Ultra-Konfigurationen bei 5.499 $ mit 96GB Speicher, vor jedem Upgrade. Metas Entwickler-Beitrag bietet eine Variante mit vier Macs zu je 256GB an, die dieselben 1TB gebündelten Speicher erreicht.
Wenn Sie keine Apple-Hardware besitzen, hier die ganze Leiter dessen, was nötig ist:
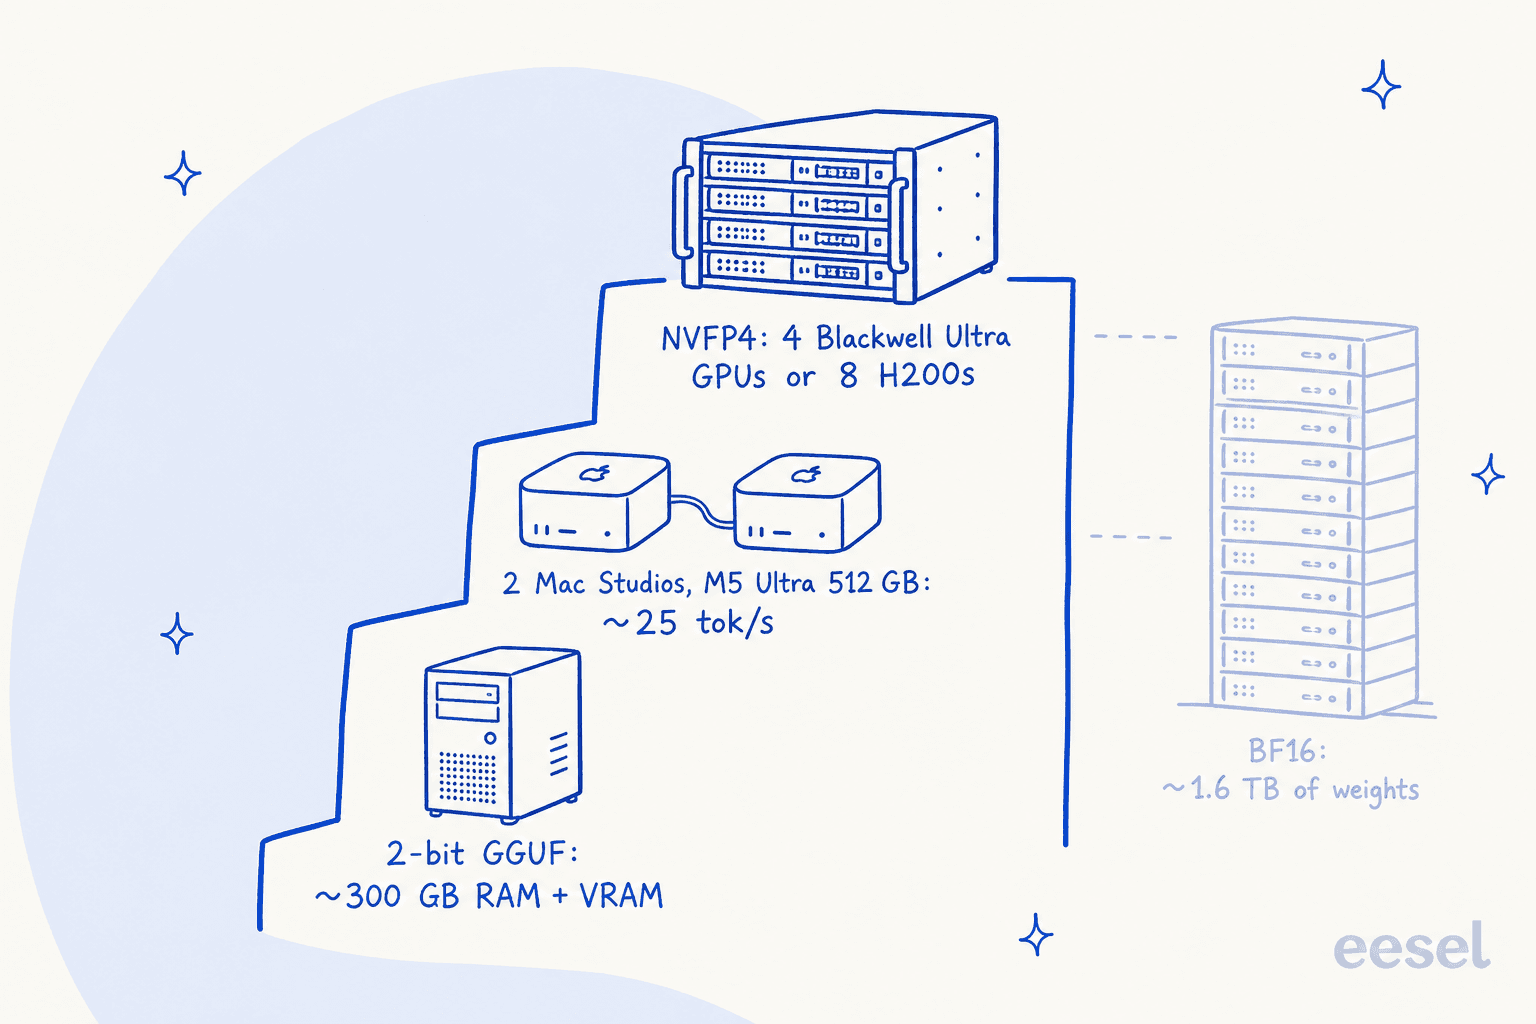
- Rechenzentrums-GPUs. Die Model Card verlangt mindestens 700GB GPU-Speicher für NVFP4 und 2TB für BF16. Metas Entwickler-Beitrag sagt, NVFP4 läuft auf vier Blackwell-Ultra-GPUs oder acht H200 über SGLang, vLLM oder TensorRT-LLM.
- Eine große Workstation. Unsloths dynamisches 2-Bit-GGUF passt in etwa 300GB kombinierten System-RAM und VRAM, ausgeführt über llama.cpp. Rechnen Sie bei dieser Kompression mit Qualitätsverlust; die Model Card selbst warnt, dass quantisierte Builds in Randfällen abweichen können.
- Cloud-Kataloge. Amazon SageMaker AI, Google Cloud Model Garden und Microsoft Foundry Models führen die Gewichte, wenn Sie eine private Instanz in Ihrem eigenen Cloud-Konto wollen.
Die ehrlichste Zusammenfassung kam von einem Kommentator, der den Unsloth-Leitfaden gelesen hatte: "You & Me won't be running this one" (spwa4, Hacker News). Für die meisten Teams wird "offen" bedeuten, bei einem Anbieter zu mieten oder es aus Datenschutzgründen in der eigenen Cloud zu betreiben.
Wie Muse Spark Open im Benchmark gegen andere offene Modelle abschneidet
Meta hat Muse Spark Open mit sieben Open-Weight-Konkurrenten verglichen, darunter Kimi K3, Mistral Large 4, Inkling und Reflections Beam. Das eigene Modell lief mit xhigh-Aufwand. Hier die veröffentlichte Tabelle:
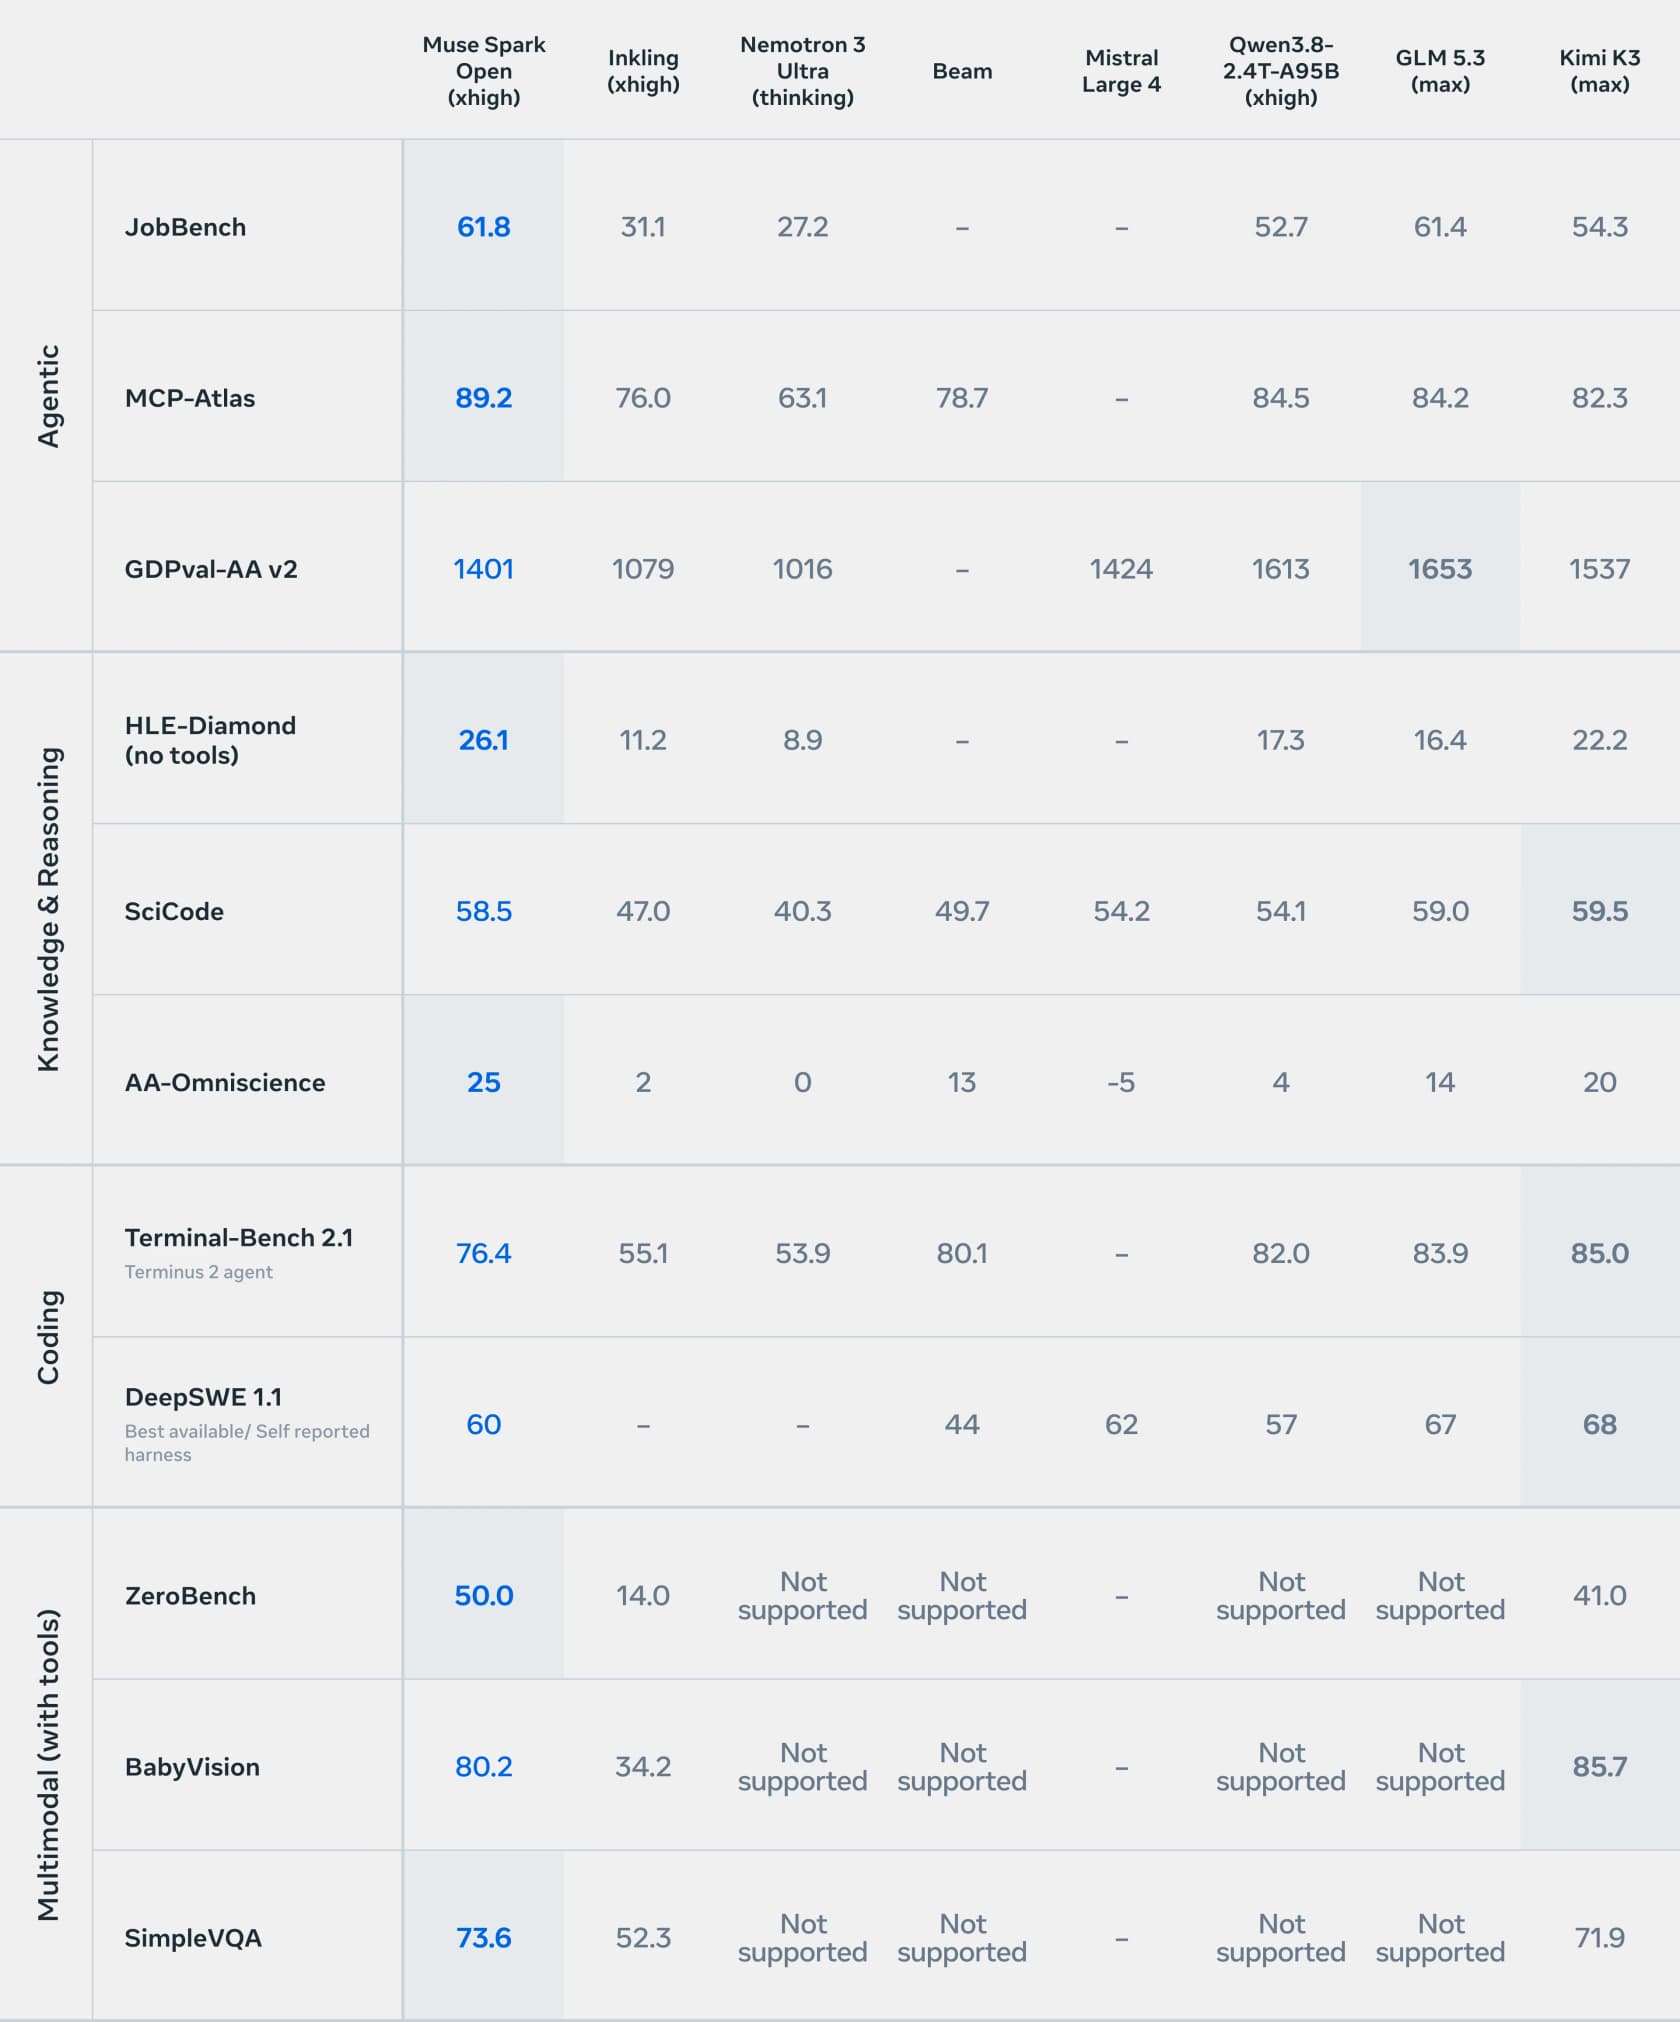
Zeile für Zeile gelesen, zeigt sich ein klares Muster:
- Wo es vorne liegt: Tool-Nutzung und Agentenaufgaben (MCP-Atlas 89,2, JobBench 61,8), Wissen ohne Tools (HLE-Diamond 26,1, AA-Omniscience 25) und mehrere multimodale Tests (ZeroBench 50,0, SimpleVQA 73,6).
- Wo es zurückliegt: beim allgemeinen Index und beim Coding. Im Artificial Analysis Index erreicht es 39, hinter GLM 5.3 (45), Kimi K3 (44) und Qwen3.8 (40). Bei Terminal-Bench 2.1 erreicht es 76,4 gegenüber 85,0 für Kimi K3; bei DeepSWE 60 gegenüber 68.
- Wo es in einer anderen Liga spielt: Sicherheit. Bei StrongREJECT, einem adaptiven Jailbreak-Test, bei dem niedriger besser ist, erreicht es 0,5. Alle anderen von Meta getesteten Modelle liegen zwischen 62,9 und 86,4.
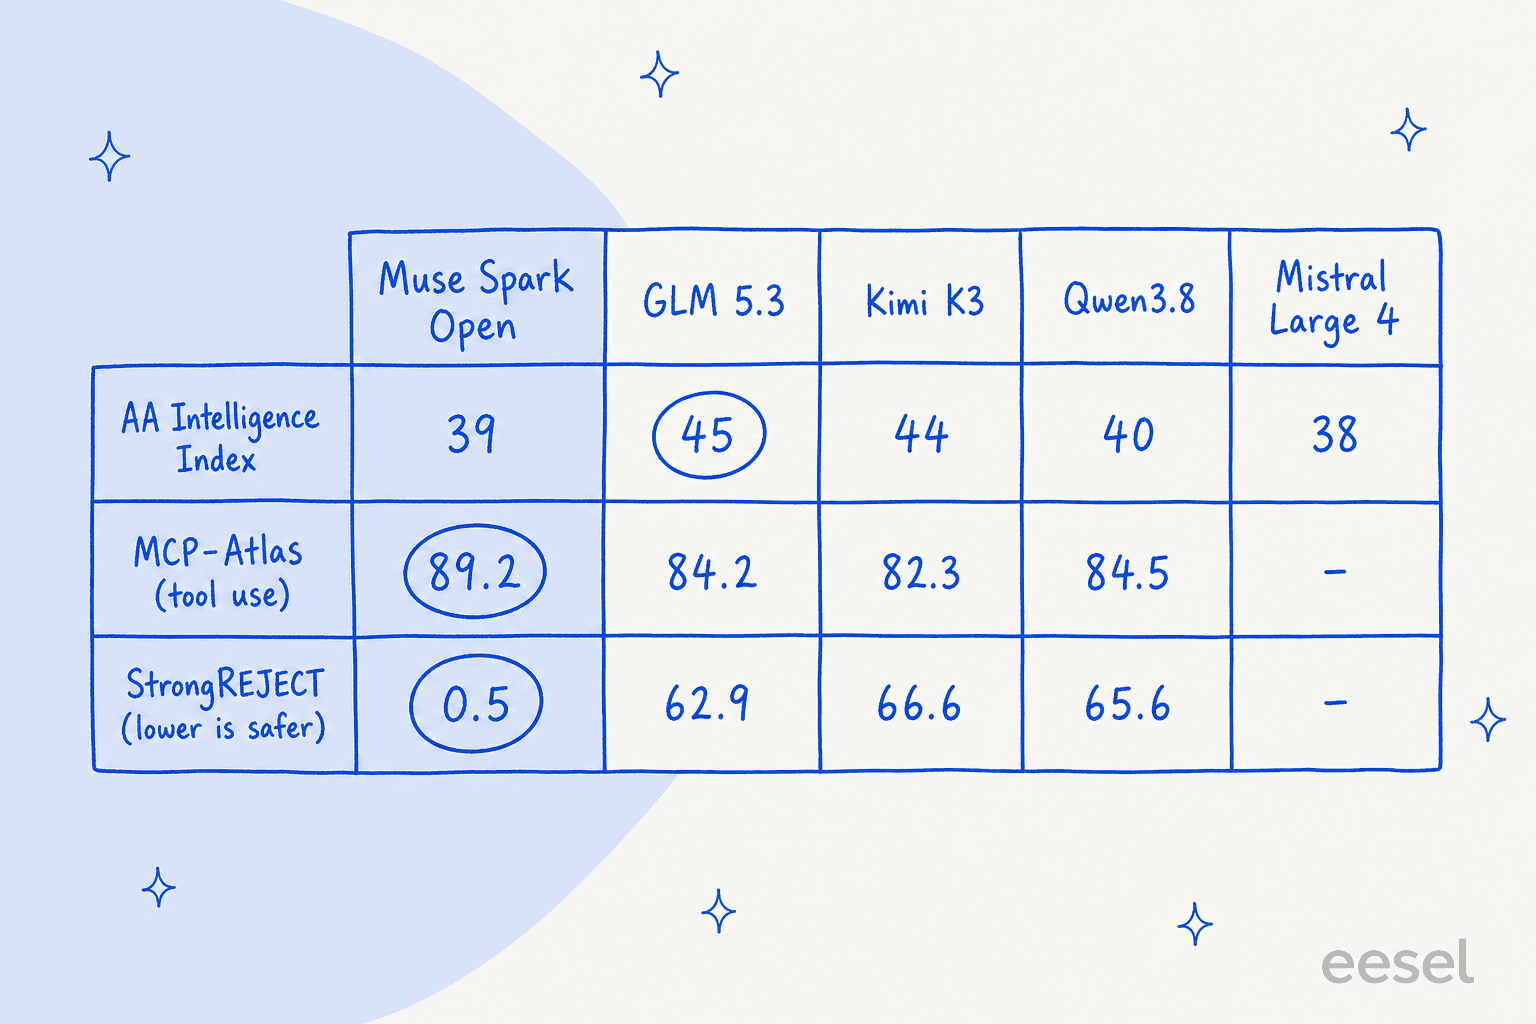
Die unabhängige Zahl deckt sich mit Metas. Artificial Analysis führt Muse Spark Open mit 39 in seinem Index, deutlich über dem Median von 19 für vergleichbare Modelle, bei 131 Token pro Sekunde. Hacker News ordnete das schnell ein:
"39 on AA, about the same as Deepseek v4.1 flash and Mimo 2.5 Flash. Behind Glm 5.3 flash and Qwen3.8-Flash-Next"
Dieser Vergleich tut weh, denn DeepSeek V4.1 Flash und GLM 5.3 Flash sind deutlich kleinere Modelle. Praxisberichte stimmen bisher im Muster überein: Ein Tester fand es "dümmer als GLM 5.3", aber "richtig schnell" auf Fireworks (eknkc, Hacker News), und ein anderer sah es bei Benchmarks "näher an 1.2" als an 1.3 (modeless, Hacker News). Meta hat keinen direkten Vergleich mit den eigenen geschlossenen Modellen veröffentlicht, sehen Sie das Letzte also als frühen Eindruck.
Mein Fazit: Das ist in erster Linie ein Modell für Tool-Aufrufe und Agenten-Schleifen mit starkem Sicherheitsverhalten, nicht der beste offene Coder. Frühe Nutzer, die in Metas Entwickler-Beitrag zitiert werden, sagen dasselbe und loben, dass es "das richtige nächste Tool" wählt und saubere strukturierte Ausgaben bei mehrstufigen und parallelen Aufrufen liefert. Wenn Ihr Agent sein Leben mit Tool-Aufrufen verbringt, zählt der Vorsprung bei MCP-Atlas mehr als die Lücke im Index. Wenn er sein Leben mit Code-Schreiben verbringt, ist Kimi K3 nach diesen Zahlen die stärkere offene Wahl.
Die Lizenz: kostenlos, mit drei Bedingungen
Meta hat die Gewichte unter der Muse Model License veröffentlicht, die es als Lizenz mit "begrenzten kommerziellen Bedingungen" beschreibt. Sie liest sich wie eine freizügige Lizenz mit angeflanschten Bedingungen. Sie dürfen es kostenlos nutzen, kopieren, verändern, feintunen, destillieren, zusammenführen, veröffentlichen und verkaufen, vorbehaltlich:
- Der Nutzungsrichtlinie. Eine lange Liste verbotener Nutzungen, von Waffen und kritischer Infrastruktur bis zu gefälschten Bewertungen und der Behauptung, Ausgaben seien von Menschen geschrieben. Sie besagt auch, dass das Modell nicht für Personen unter 18 gedacht ist.
- Namensnennung. Sie müssen die Worte "Built with Muse Spark Open" "deutlich sichtbar" in der Oberfläche, Dokumentation, Website oder im Einstellungsmenü Ihres Produkts anzeigen. Das gilt auch für jedes Modell, das Sie aus seinen Ausgaben trainieren oder destillieren.
- Die 20-Mio.-$-Dienstklausel. Wenn Sie Zugang zu KI-Modellen als Dienst per API verkaufen und Ihre Unternehmensgruppe in einem Zeitraum von 12 Monaten mehr als 20 Millionen $ einnimmt, müssen Sie Meta benachrichtigen und zuerst einen separaten Vertrag schließen.
Die dritte Klausel klingt beängstigend und ist es meist nicht. Sie schließt ausdrücklich interne Nutzung, Forschung und die Nutzung des Modells für Funktionen Ihres eigenen Produkts aus. Ein SaaS-Unternehmen, das Muse Spark Open hinter seinem Support-Postfach betreibt, schuldet Meta nichts außer der Namensnennung. Die Klausel zielt auf Inferenz-Anbieter und große Plattformen, die das Modell weiterverkaufen.
Eine weitere praktische Hürde: Der Download von Hugging Face bedeutet ein geschütztes Formular, das nach Ihrem vollständigen Namen, Geburtsdatum und dem vollständigen Organisationsnamen mit Unternehmenskennungen fragt. Meta erhebt außerdem keinen Eigentumsanspruch auf Ausgaben, das ist die Klausel, nach der Ihre Rechtsabteilung zuerst suchen wird.
Ich nutze es intern, für Forschung oder für Funktionen innerhalb meines eigenen Produkts
Kostenlos. Kein separater Vertrag, auch nicht über 20 Mio. $ Umsatz. Sie müssen trotzdem die Nutzungsrichtlinie einhalten und "Built with Muse Spark Open" dort anzeigen, wo Nutzer es finden: in der Oberfläche, der Dokumentation, auf der Website oder in einem Einstellungsmenü.
Ich verkaufe API-Zugang zu KI-Modellen, und meine Unternehmensgruppe verdient unter 20 Mio. $ im Jahr
Vorerst kostenlos, mit denselben Namensnennungs- und Nutzungsregeln. Behalten Sie den Umsatz im Blick: Maßgeblich sind beliebige 12 aufeinanderfolgende Monate, gezählt über Sie und Ihre verbundenen Unternehmen.
Ich verkaufe API-Zugang zu KI-Modellen, und meine Unternehmensgruppe verdient über 20 Mio. $ im Jahr
Sie müssen Meta benachrichtigen und einen separaten schriftlichen Vertrag schließen, bevor Sie Muse Spark Open oder etwas daraus Abgeleitetes in diesem Dienst anbieten. Die Bedingungen sind nicht öffentlich.
Ich habe daraus ein neues Modell feingetunt oder destilliert
Das zählt als Derivat. Die Namensnennung und die Nutzungsrichtlinie gelten weiter, ebenso die 20-Mio.-$-Dienstklausel, wenn Sie den Zugang dazu weiterverkaufen.
Zusammengefasst aus der Muse Model License vom 15. Oktober 2026. Keine Rechtsberatung; lesen Sie vor dem Einsatz den vollständigen Text auf Hugging Face.
Ist es "offen"? Viele Hacker-News-Kommentatoren sagten nein, weil die Lizenz nicht OSI-zertifiziert ist und nur Gewichte erscheinen, keine Trainingsdaten oder Code. Ich würde es Open Weights mit einer kommerziellen Obergrenze nennen, und für die meisten Unternehmen liegt diese Obergrenze weit über allem, was sie erreichen werden. Wenn Sie vollständig quelloffene Bausteine wollen, ist meine Übersicht zu Open-Source-KI-Agenten ein besserer Startpunkt.
Sicherheit: der stärkste Teil der Veröffentlichung
Hier hat Meta die meiste Arbeit investiert, und man sieht es. Die Model Card berichtet, ohne Sicherheitsvorkehrungen auf Systemebene:
- Cyber-Missbrauch: 99,2 % der Jailbreaks in Metas internem Benchmark abgelehnt und 94,8 % über PolyGuard, RedCode und CyberBench 2024. Kimi K3 lehnte im selben Setup 75,5 % und 70,2 % ab.
- Chemie und Biologie: über 98 % Ablehnungen bei SecureBios BioTIER, über 97 % bei Metas mehrstufigem agentischem Biologie-Test.
- Ehrlichkeit: eine Ehrlichkeitsrate von 98,1 % im MASK-Benchmark und 0 % Fehlverhalten im Agentic-Misalignment-Benchmark.
In Metas eigener Tabelle steckt ein Zielkonflikt. Beim FORTRESS-Test hat Muse Spark Open den niedrigsten adversarialen Risikowert (5,8), aber den höchsten Over-Refusal-Wert (17,4) der Gruppe, es lehnt also mehr harmlose Anfragen ab als GLM 5.3 (3,2) oder Kimi K3 (2,7). Für einen kundenorientierten Bot sind ein paar zusätzliche Antworten wie "Dabei kann ich nicht helfen" echte Kosten. Testen Sie es mit Ihrem eigenen Datenverkehr, bevor Sie den Standardeinstellungen vertrauen.
Zwei Vorbehalte von Meta selbst. Der vollständige Evaluierungsbericht ist noch "bald verfügbar". Und die Model Card warnt, dass "nachgelagerte Änderungen die Sicherheit verschlechtern könnten", sobald Sie es feintunen, gehören diese Zahlen also nicht mehr Ihnen. Metas eigener Rat ist, es in einem System mit zusätzlichen Guardrails und "Bestätigung durch einen Menschen bei nicht umkehrbaren Aktionen" einzusetzen, und das würde ich jedem sagen, der ein Modell hinter eine Support-Warteschlange setzt.
Fine-Tuning ab Tag eins
Das ist das andere, was Open Weights tatsächlich ermöglichen. Meta hat zum Launch breite Post-Training-Unterstützung organisiert, laut Entwickler-Beitrag:
- PyTorch TorchTitan: Pre-Training, mehrstufiges SFT, LoRA und Reinforcement Learning.
- Hugging Face TRL: LoRA mit SFTTrainer auf dem veröffentlichten Checkpoint.
- Fireworks AI: serverloses LoRA-Training per API, mit Sequenzen bis 262.144 Token. Die Modellseite weist darauf hin, dass verwaltetes Fine-Tuning in der Oberfläche für dieses Modell noch nicht verfügbar ist.
- Together AI: SFT oder GRPO-Reinforcement-Learning in seinem Post-Training-Dienst, danach mehrere LoRA-Adapter in einem Deployment betreiben.
- NVIDIA NeMo AutoModel und RadixArks Miles für Arbeiten mit allen Parametern.
Für ein Support-Team klingt Fine-Tuning verlockend: Es Ihren Ton, Ihre Produktnamen, Ihre Erstattungsregeln beibringen. Nach meiner Erfahrung ist es selten die erste Lösung. Die meisten falschen Antworten, die ich sehe, stammen von einem veralteten oder widersprüchlichen Help Center, nicht von einem Modell, das neu trainiert werden muss, und Retrieval behebt das schneller. Mein Beitrag RAG vs LLM erklärt, warum. Feintunen Sie erst, wenn das Retrieval stabil ist und Sie weiterhin Stil- oder Formatprobleme sehen.
Wer sollte Muse Spark Open tatsächlich nutzen?
So würde ich entscheiden:
- Sie brauchen das Modell in den eigenen vier Wänden. Regulierte Daten, eine Sicherheitsprüfung, die Drittanbieter-Verarbeiter blockiert, oder ein Kundenvertrag mit "keine externe KI". Das ist der stärkste Fall, und die Sicherheitszahlen machen ihn leichter zu verteidigen.
- Sie bauen Agenten mit vielen Tools. Die Vorsprünge bei MCP-Atlas und JobBench sind real. Kombinieren Sie es mit einem MCP-Server und sehen Sie, wie es mit Ihrem Tool-Set umgeht.
- Sie wollen ein großes multimodales Modell feintunen. Es nimmt Audio und Video nativ entgegen, und der Trainings-Stack war am Launch-Tag bereit.
- Sie wollen die günstigsten Meta-Token. Lassen Sie es. Die Contributor-Preise des geschlossenen Muse Spark 1.3 sind deutlich günstiger, wenn Sie damit leben können, dass Meta mit diesem Datenverkehr trainiert.
- Sie wollen den besten offenen Coder. Schauen Sie zuerst auf Kimi K3 oder Qwen, oder steigen Sie auf geschlossene Frontier-Modelle wie Claude Opus 5.5 und das neuere Muse Wonder um.
Speziell für den Kundensupport ist die Modellwahl die kleinere Entscheidung. Mein Leitfaden zu Support-Modellen erklärt, warum Retrieval, Eskalation und Tests die Lösungsqualität stärker beeinflussen als ein paar Indexpunkte. Eine Lücke von 6 Indexpunkten fällt in einer Warteschlange selten auf. Eine selbstsichere Antwort aus einem veralteten Artikel fällt jeden Tag auf, mit Open Weights oder ohne.
eesel ausprobieren
Muse Spark Open ist Infrastruktur. Sie bekommen Gewichte, eine Lizenz und eine Hardware-Rechnung, und dann bauen Sie Retrieval, Eskalationsregeln, Tests und Prüfpfad selbst. eesel ist der Mitarbeiter. Unser KI-Helpdesk-Teammitglied verbindet sich mit Zendesk, Freshdesk, Gorgias und dem Rest, lernt aus Ihren früheren Tickets und Ihrem Help Center, und Sie können es gegen Hunderte Ihrer historischen Tickets laufen lassen, bevor es einem einzigen Kunden antwortet. In diesem Replay fangen Sie die übermütige Antwort ab, bevor es ein Kunde tut, egal welches Modell darunter liegt.
Wenn Sie es lieber über ein Terminal steuern, so wie Sie ein selbst gehostetes Modell betreiben würden, deckt das die eesel CLI ab. eesel instructions liest und bearbeitet die dauerhaften Regeln des Teammitglieds, eesel approvals listet Aktionen, die auf einen Menschen warten, und eesel activity zeigt jeden Lauf und warum es so gehandelt hat. Jeder Befehl gibt JSON aus und Schreibzugriffe akzeptieren --dry-run, sodass ein Coding-Agent wie Claude Code Ihr Support-Teammitglied genauso verwalten kann wie Ihr Repository. Wenn Sie eher Inhalte schreiben als Tickets beantworten, hat dieselbe Riege einen KI-Blog-Autor.

Der Einstieg ist kostenlos mit 100 Credits und ohne Karte. Testen Sie eesel mit den Tickets des letzten Monats und sehen Sie, was es gesagt hätte, bevor Sie auch nur einen Mac Studio einpreisen. Die Tarife finden Sie auf der Preisseite.