

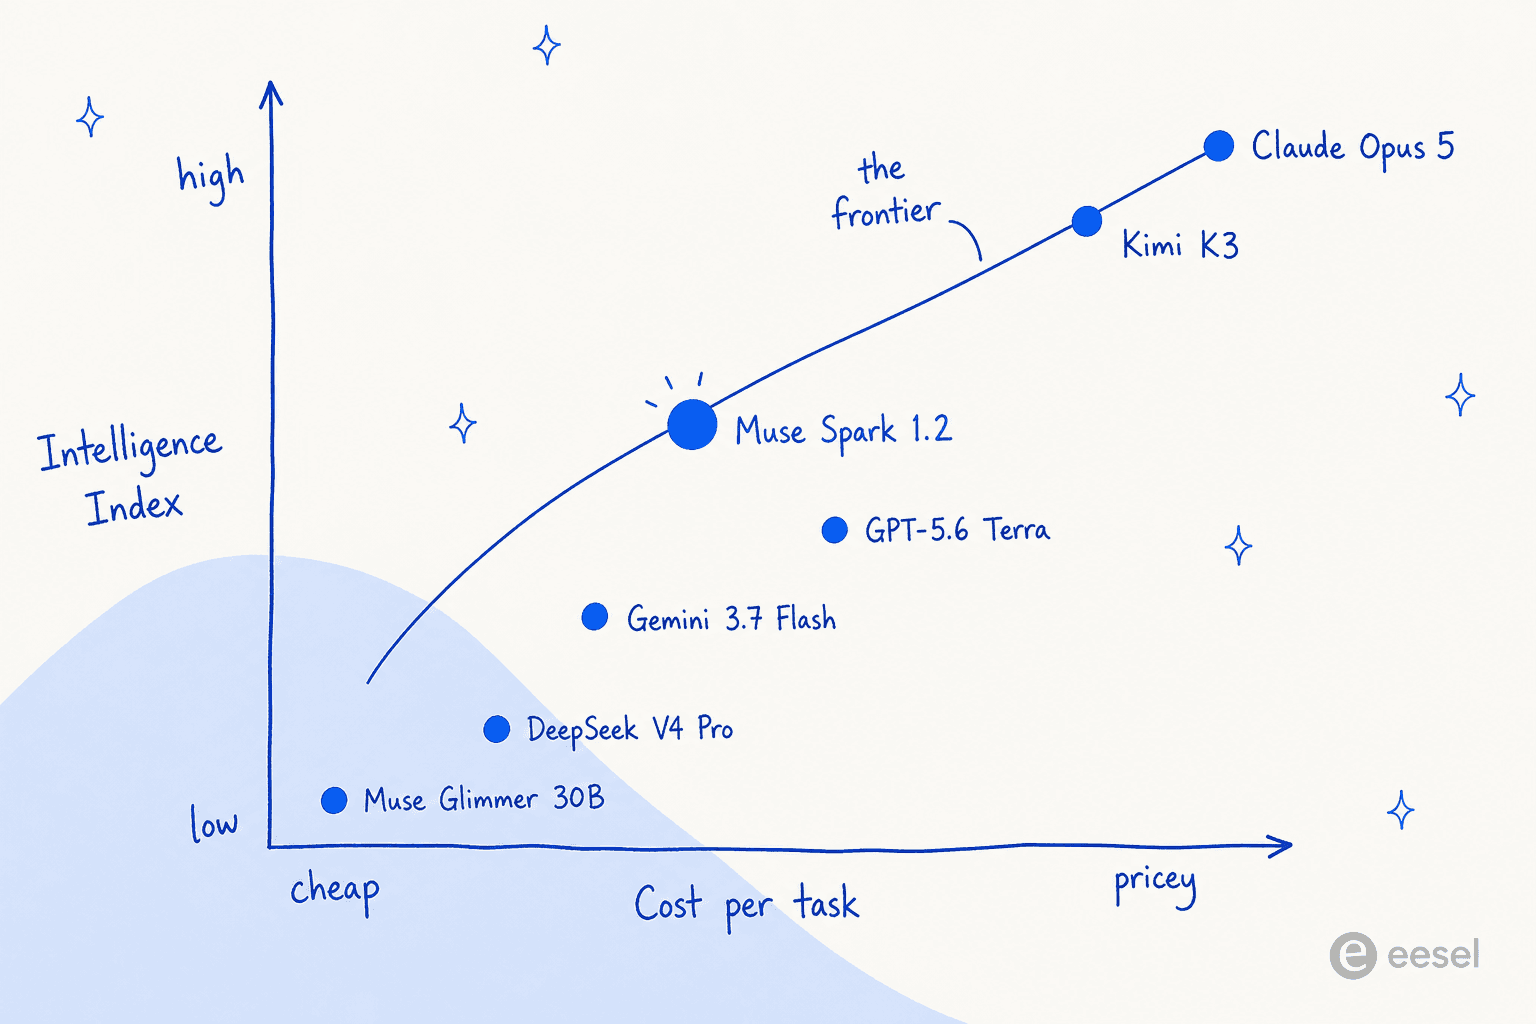
Die meisten Beiträge zu „Muse Spark 1.2 Alternativen" beginnen mit der Aussage, das Modell sei abgehängt. Das ist es nicht. Im Artificial Analysis Intelligence Index erreicht kein Modell mehr Punkte als Muse Spark 1.2 bei niedrigeren Kosten pro Aufgabe. Es liegt auf Platz 7 von 20 mit 56,76, und das für 0,3992 $ pro Aufgabe. Jedes Modell darüber im Ranking kostet Sie mehr.
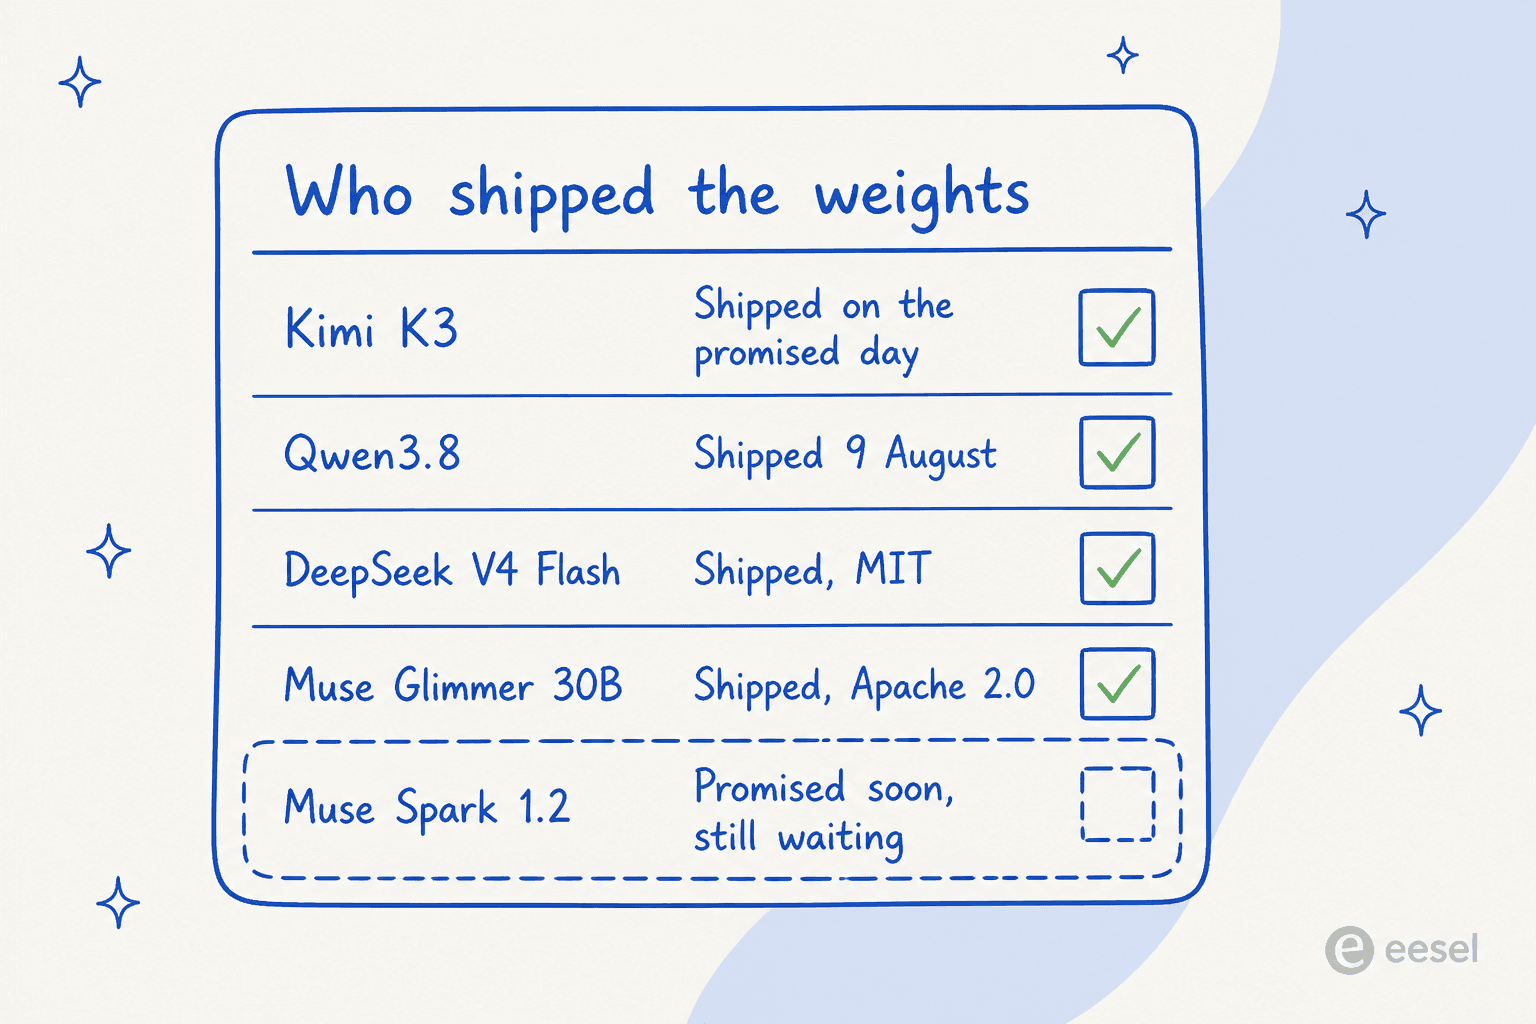
Der ehrliche Grund zu gehen hat also nichts mit Leistung zu tun. Metas Chief AI Officer hat am 10. August offene Gewichte versprochen, für Muse Spark 1.2, ohne Lizenz und ohne Datum, und acht Tage später ist nichts erschienen. Moonshot hat dagegen Kimi K3 genau an dem versprochenen Tag veröffentlicht. Qwen lieferte am 9. August, und DeepSeek ist schon seit Monaten MIT.
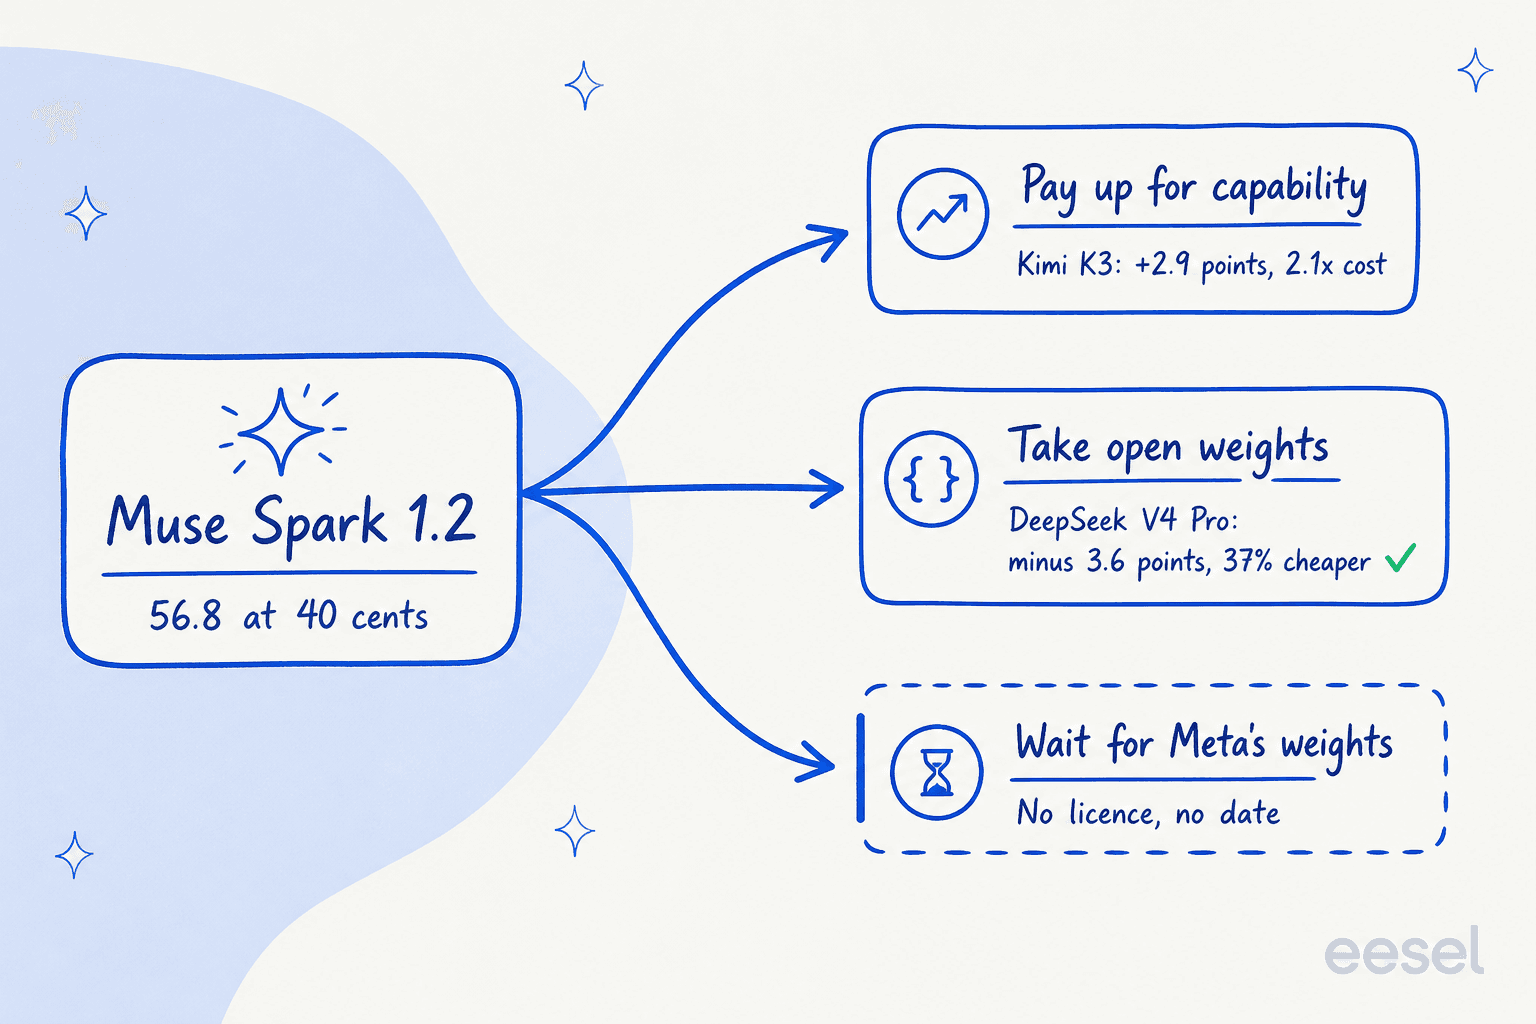
Damit teilen sich Ihre Optionen ziemlich sauber auf. Zahlen Sie mehr für einen echten Leistungssprung, oder verzichten Sie auf Index-Punkte für Gewichte, die Ihnen wirklich gehören. Die Option, die beides bietet, und das günstiger, gibt es nicht. Unten ordne ich 8 Alternativen anhand der echten Zahlen ein.
Ein Vorbehalt, bevor Sie eine Woche damit verbringen. Wenn das Modell, das Sie auswählen, Support-Tickets beantworten soll, ist das Modell selbst selten der Engpass. Ein Team, mit dem ich gearbeitet habe, hatte eine KI, die Kunden selbstsicher sagte „Ja, wir unterstützen Ihr Automodell", und zwar für Marken, die gar nicht in der Datenbank waren, weil im Help Center „wir unterstützen alle Modelle" stand. Kein Index-Wert behebt diesen einen Satz. Retrieval schon.
Warum Leute überhaupt über Muse Spark 1.2 hinausschauen
Ich baue bei eesel Integrationen und API-Infrastruktur, deshalb überspringe ich bei jedem Modellstart den Launch-Beitrag und lese die Preisliste, die Rate Limits und dann die Modellseite. Muse Spark 1.2 ist aus einem bestimmten Grund interessant: Marketing und Daten widersprechen sich hier in die umgekehrte Richtung als üblich. Die Launch-Darstellung hat sein Preis-Leistungs-Verhältnis unterschätzt und überschätzt, was man tatsächlich besitzen würde.
Es gibt drei Dinge, die Leute tatsächlich nach Alternativen suchen lassen.
Die Gewichte sind ein Versprechen, kein Download. Metas Chief AI Officer sagte, eine Open-Weight-Version komme „bald". Metas verifizierte Hugging-Face-Organisation listet derzeit vier Repositories, und alle vier gehören zu Muse Glimmer. Wer auf Hugging Face nach Muse-Spark sucht, bekommt von niemandem ein Ergebnis.
Niemand kann das Modell unabhängig prüfen. Für den Großteil des Rankings veröffentlicht Artificial Analysis Ausgabegeschwindigkeit und Latenz. Für Muse Spark 1.2 sind diese beiden Felder leer. Muse Glimmer steht in derselben Tabelle und hat sie. Sie können dieses Modell bepreisen, aber nicht messen, wie schnell es antwortet.
Die günstige Stufe kostet Sie Ihren Traffic. Die ID muse-spark-1.2-contributor ist beim Input 12,5-mal günstiger, und Metas eigene Dokumentation beschreibt das als ermäßigten Preis im Gegenzug für die Erlaubnis, auf Ihren Prompts und Completions zu trainieren. Die Rechnung zu diesem Tausch habe ich bereits in der Aufschlüsselung zu Muse Spark 1.2 Preisen behandelt.
Vier Tage vor Metas Ankündigung hat ein Hacker-News-Kommentator das Argument für die Gewichte besser formuliert als Metas eigener Beitrag:
"Meta, please go back to publishing weights. Your models aren't top-tier, this wouldn't hurt you at all at your current position in the rankings. They wouldn't have the best open-weight models, but the best western open-weight models."

Meta tat genau das vier Tage später, aber für ein 30B-Schülermodell. Das Frontier-Modell bekam ein Adjektiv.
Wie ich diese 8 ausgewählt habe
Ich habe nach drei Kriterien gerankt, in dieser Reihenfolge.
Unabhängige Punktzahl, nicht Herstellerdiagramme. Jede Index-Zahl auf dieser Seite ist der Artificial Analysis Intelligence Index v4.1.1. Er führt neun Evaluierungen durch, sodass kein Lab sein eigenes Vergleichsfeld wählen kann. Das ist hier wichtig, denn die Muse-Spark-1.2-Launch-Diagramme haben zwischen den Versionen das Agent-Harness getauscht.
Kosten pro Aufgabe, nicht Listenpreis. Verbosität ist das, was Preise pro Million Tokens verbergen. Muse Spark 1.2 verbraucht 30.430 Output-Tokens pro Index-Aufgabe, die realen Kosten liegen also deutlich über dem, was die 1,25 $ im Titel nahelegen. Die Kosten pro Aufgabe sind die Zahl, die den Kontakt mit einer echten Rechnung übersteht.
Ob die Gewichte existieren. Bei jedem Modell der Liste habe ich das Lizenzfeld im tatsächlichen Repository geprüft, statt einer Pressemitteilung zu trauen. Zwei der acht sind anders lizenziert, als sie üblicherweise beschrieben werden.
Einen offensichtlichen Namen habe ich weggelassen. In dieser Liste gibt es kein eesel-Modell, weil eesel kein Modellanbieter ist, und meinen eigenen Arbeitgeber in eine Benchmark-Tabelle zu setzen wäre genau das, was solche Beiträge nutzlos macht.
Die Vergleichstabelle
Index-Werte und Kosten pro Aufgabe stammen aus dem Artificial-Analysis-Modellranking, geprüft am 18. August 2026. Token-Preise stammen von der jeweiligen Preisseite des Anbieters, am selben Tag geprüft.
| Modell | Index | Kosten / Aufgabe | Input /1M | Output /1M | Kontext | Gewichte | Lizenz | Am besten für |
|---|---|---|---|---|---|---|---|---|
| Claude Opus 5 | 63.05 | $2.3369 | $5.00 | $25.00 | 1M | Nein | Proprietär | Höchste Obergrenze im Ranking |
| GPT-5.6 Sol | 60.93 | $1.2312 | $5.00 | $30.00 | 1.05M | Nein | Proprietär | Frontier-Arbeit mit OpenAI-Tooling |
| Grok 4.6 | 60.92 | $0.8367 | variiert | variiert | 2M | Nein | Proprietär | Nahe am Frontier bei mittleren Kosten |
| Kimi K3 | 59.70 | $0.8375 | $3.00 | $15.00 | 1.05M | Ja | Kimi K3 License | Offene Gewichte, die Muse Spark tatsächlich schlagen |
| Qwen3.8 Max | 58.08 | $1.1320 | $2.00 | $6.00 | 1M | Nur Basis | qwen3.8-max | Gehostete Leistung mit offenem Fallback |
| Muse Spark 1.2 | 56.76 | $0.3992 | $1.25 | $4.25 | 1.05M | Nein | Proprietär | Das Modell im Amt, um das es hier geht |
| GPT-5.6 Terra | 56.58 | $0.5080 | $2.00 | $12.00 | 1.05M | Nein | Proprietär | Gleichwertiger Tausch mit besserem Tooling |
| Gemini 3.7 Flash | 56.03 | $0.4022 | $0.75 | $3.75 | 1.05M | Nein | Proprietär | Geschwindigkeit bei fast gleichen Kosten |
| DeepSeek V4 Pro | 53.20 | $0.2521 | $0.66 | $1.98 | 1M | Ja | MIT | Die günstigste permissive Lizenz hier |
| GPT-5.6 Luna | 52.32 | $0.0471 | $0.20 | $1.20 | 1.05M | Nein | Proprietär | Die Preisuntergrenze für gehostete Modelle |
| Muse Glimmer 30B | 35.06 | $0.0732 | lokal | lokal | 131K | Ja | Apache 2.0 | Ein Meta-Modell auf der eigenen GPU betreiben |
Die hier gezeigten DeepSeek-Preise sind die Nebenzeit-Preise. Die gezeigten Gemini-Preise sind Einführungspreise bis zum 31. Dezember 2026.
Trägt man Kosten gegen Leistung auf, wird die Form der Entscheidung deutlich einfacher erkennbar.
Wählen Sie Ihren Ausweg
Statt alle acht zu lesen, beantworten Sie einfach die eine Frage, die das Feld wirklich teilt.
Was brauchen Sie wirklich, das Muse Spark 1.2 Ihnen nicht gibt?
Wählen Sie eines. Jede Antwort kostet etwas, und die Zahl wird angezeigt.
Spitze des Intelligence Index mit 63,05, also 6,29 Punkte vor Muse Spark 1.2. Es bietet den vollen 1M-Kontext zum Standardpreis ohne Aufschlag für langen Kontext.
Der Preis dafür: 2,3369 $ pro Aufgabe gegenüber 0,3992 $. Sie zahlen das 5,9-Fache für einen Leistungszuwachs von rund 11 %.
59,70 im Index und das einzige Open-Weights-Modell im 20-Zeilen-Ranking, das Muse Spark 1.2 schlägt. Die Gewichte erschienen an dem Tag, den Moonshot genannt hatte.
Der Preis dafür: 0,8375 $ pro Aufgabe, also das 2,1-Fache der Kosten für 2,94 Index-Punkte. Die Lizenz ist eine Sonderlizenz, nicht MIT.
MIT-lizenziert ohne Sonderbedingungen, 53,20 im Index und mit 0,2521 $ die günstigste glaubwürdige Option hier pro Aufgabe. Es gibt 662 Community-Repositories, 316 davon quantisiert.
Der Preis dafür: 3,56 Index-Punkte unter Muse Spark 1.2, und der Tarif verdoppelt sich zu den UTC-Spitzenzeiten.
Metas eigenes Apache-2.0-Modell, aus Muse Spark destilliert, mit unter 20 GB bei etwa 4 Bit. Das ist das Meta-Modell, das Sie heute tatsächlich herunterladen können.
Der Preis dafür: 35,06 im Index, also 21,70 Punkte unter Muse Spark 1.2. Ein fähiger lokaler Agent, kein Frontier-Ersatz.
1. Claude Opus 5
Am besten für: Teams, in denen eine falsche Antwort mehr kostet als die API-Rechnung.
Anthropics Flaggschiff hält mit 63,05 die Spitze des Rankings. Es ist auch das einzige Modell hier, bei dem der Abstand zu Muse Spark 1.2 groß genug ist, dass man ihn ganz ohne Benchmark-Harness bemerkt.
Wo es Muse Spark 1.2 schlägt. Sechs Index-Punkte, und in der Praxis zeigt sich das bei langen mehrstufigen Aufgaben, bei denen sich ein früher Fehler aufschaukelt. Es bietet außerdem den vollen 1M-Kontext zum Standardpreis, wobei Anthropic klar sagt, dass eine Anfrage mit 900k Tokens zum selben Preis pro Token abgerechnet wird wie eine mit 9k. Weder OpenAI noch xAI tun das.
Wo nicht. Bei den Kosten, und das deutlich. Dann das, was die meiste Berichterstattung auslässt: Die AA-Omniscience-Halluzinationsrate von Opus 5 stieg um 14 Punkte auf 50 %. Ein höherer Index-Wert ist nicht dasselbe wie ein wahrhaftigeres Modell.
Preise. 5,00 $ Input, 0,50 $ Cache-Read, 25,00 $ Output pro Million. Batch gibt es zum halben Preis. Cache-Writes kosten 6,25 $ bei 5 Minuten TTL. Wenn diese Obergrenze mehr ist, als Sie brauchen, kostet Claude Sonnet 5 jetzt dauerhaft 2,00 $ und 10,00 $, nachdem Anthropic die für den 1. September geplante Erhöhung abgesagt hat.
Fazit: die richtige Wahl, wenn ein Fehler teuer ist und die Token-Rechnung nicht. Lassen Sie es bei hochvolumiger Klassifizierung aus, denn dort würden Sie pro Aufgabe das 5,9-Fache für Leistung zahlen, die die Aufgabe nie nutzt.
2. Kimi K3
Am besten für: alle, deren eigentliche Anforderung lautet: „offene Gewichte, und besser als das, was ich habe."
Moonshots Flaggschiff ist der interessanteste Eintrag dieser Liste, und zwar weil es das einzige Modell ist, das beide Hälften dessen erfüllt, was Leute von Meta wollen. Es erreicht 59,70, liegt also über Muse Spark 1.2, und die Gewichte sind jetzt, heute, herunterladbar.
Wo es Muse Spark 1.2 schlägt. Knapp drei Index-Punkte, dazu 2,8 Billionen Parameter, die Sie selbst hosten können. Bemerkenswert ist dies: Moonshots Tech-Blog sagte, die Gewichte würden bis zum 27. Juli 2026 veröffentlicht, und der erste öffentliche Commit auf Hugging Face stammt vom 27. Juli 2026. Ein genanntes Datum, auf den Tag eingehalten.
Wo nicht. Zwei Dinge. Die Kosten pro Aufgabe liegen bei 0,8375 $, also mehr als das Doppelte. Dann die Lizenz, die nicht das ist, was die meisten Berichte behaupten: Die Repository-Metadaten lauten license: other mit license_name: "kimi-k3", eine eigene Moonshot-Lizenz. Offene Gewichte, ja. Permissive Open Source, nein. Der Openness Index liegt bei 38,89 und damit unter dem von Muse Glimmer mit 44,44.
Preise. 3,00 $ Input, 0,30 $ Cache-Hit, 15,00 $ Output pro Million, also Claude-Sonnet-Gebiet und kein Budget-Gebiet. Mein vollständiger Kimi-K3-Test geht auf das Reasoning-Effort-Verhalten ein, das sich auf keiner Stufe abschalten lässt.
Fazit: die Standardantwort für alle, die auf Metas Gewichte gewartet haben. Sie zahlen etwa das Doppelte pro Aufgabe und lesen die Lizenz sorgfältig, bevor Sie live gehen, aber das Modell existiert heute und ist messbar besser.
3. Qwen3.8 Max
Am besten für: Teams, die jetzt ein gehostetes Modell und später einen selbst gehosteten Fallback wollen.
Alibabas Flaggschiff erreicht gehostet 58,08, und bei diesem Eintrag hat mich meine eigene Recherche mitten im Entwurf korrigiert. Anfang des Monats waren die Qwen-3.8-Gewichte versprochen und noch unveröffentlicht, genau in der Position, in der Muse Spark 1.2 jetzt ist. Dann erschienen sie am 9. August.
Wo es Muse Spark 1.2 schlägt. 1,32 Index-Punkte gehostet, während die offene Basis Qwen3.8-2.4T-A95B allein noch 57,70 erreicht. Das heißt, selbst die herunterladbare Version schlägt das Modell, das Sie verlassen wollen.
Wo nicht. Die Kosten pro Aufgabe liegen bei 1,1320 $, also fast das Dreifache. Die offene Version ist außerdem nicht funktionsgleich mit dem gehosteten Produkt: Qwens eigene Modellkarte nennt, dass das gehostete Max Bildeingabe, Non-Thinking-Unterstützung, 1M Kontext als Standard und eingebaute Tools ergänzt. Und die Lizenz ist wieder eine Sonderlizenz, qwen3.8-max, nicht Apache.
Preise. 2,00 $ Input, 0,25 $ impliziter Cache-Read, 6,00 $ Output pro Million. Der explizite Cache-Read ist mit 0,17 $ günstiger, kostet aber 2,50 $ pro Million in der Erstellung und lohnt sich daher nur bei stark wiederholten Präfixen. Praktische Zugangswege habe ich unter Zugang zu Qwen3.8 Max zusammengestellt.
Fazit: die beste Absicherung auf dieser Liste, denn Sie können gehostet starten und dann auf eigene Hardware wechseln, ohne die Modellfamilie zu ändern. Der Qwen3.8-Max-Test enthält die Zahlen zur menschlichen Präferenz, und die deuten in eine freundlichere Richtung als der automatisierte Index.
4. GPT-5.6 Terra
Am besten für: einen gleichwertigen Tausch, bei dem das umgebende Tooling wichtiger ist als die Punktzahl.
OpenAIs Mittelklasse landet bei 56,58 und damit 0,18 Punkte unter Muse Spark 1.2. Praktisch sind die beiden Modelle dieselbe Leistung zu einem anderen Preis, weshalb Metas Launch-Beitrag gegen Terra verglich und nicht gegen GPT-5.6 Sol. Ein Kommentator bemerkte das damals:
"They chose to compare against Open AI's mid tier model Terra instead of Sol and still lost some benchmark against it. They left Opus in and got beat in all but one benchmark. Nothing wrong with trying to improve, but why the marketing games?"
Wo es Muse Spark 1.2 schlägt. Vor allem beim Ökosystem. Terra läuft im Tooling, das Ihr Team wahrscheinlich schon nutzt, und OpenAI veröffentlicht Geschwindigkeits- und Latenzwerte, die Meta nicht liefert.
Wo nicht. Es ist pro Aufgabe 27 % teurer, und das bei einer minimal niedrigeren Punktzahl. Dazu gibt es eine Klippe bei langem Kontext: Prompts über 272K Input-Tokens werden laut OpenAIs Modellseite für die gesamte Anfrage mit dem 2-Fachen beim Input und dem 1,5-Fachen beim Output berechnet, nicht nur für den Überhang. Muse Spark 1.2 hat überhaupt keinen Aufschlag für langen Kontext.
Preise. 2,00 $ Input, 0,20 $ gecacht, 12,00 $ Output pro Million, und das noch vor dem Multiplikator für langen Kontext. Wo genau diese Klippe zuschlägt, steht in der Aufschlüsselung zu GPT-5.6 Preisen.
Fazit: wechseln Sie wegen des Toolings und der veröffentlichten Latenzwerte, nicht wegen der Leistung. Wenn Ihre Prompts regelmäßig über 272K Tokens liegen, rechnen Sie zuerst nach, bevor Sie migrieren.
5. Gemini 3.7 Flash
Am besten für: hochvolumige Workloads, bei denen der Durchsatz der Engpass ist.
Googles Flash-Linie erreicht 56,03 bei 0,4022 $ pro Aufgabe und liegt damit auf beiden Achsen innerhalb eines Rundungsfehlers von Muse Spark 1.2. Der Unterschied: Google veröffentlicht, wie schnell das Modell ist. Artificial Analysis misst 340,1 Tokens pro Sekunde, Platz eins von 188 gemessenen Modellen.
Wo es Muse Spark 1.2 schlägt. Gemessene Geschwindigkeit, dazu ein niedrigerer Listenpreis mit 0,75 $ Input. Es ist das einzige Modell hier, bei dem Sie die Leistung auch gezielt herunterregeln können: Bei low Effort erreicht es 50,9 für 0,16 $ pro Aufgabe, und für Klassifizierungsarbeit ist das oft die richtige Wahl.
Wo nicht. Es gibt zwei echte Vorbehalte. Der aktuelle Preis ist ein Einführungspreis bis 31. Dezember 2026 und verdoppelt sich auf 1,50 $ und 7,50 $ am 1. Januar 2027, jedes Kostenmodell, das Sie heute bauen, enthält also eine Klippe. Die Halluzinationsrate ist außerdem von 55,6 % der Vorversion auf 64,5 % gestiegen, was ich im Gemini-3.7-Flash-Test genauer untersucht habe.
Preise. 0,75 $ Input, 0,075 $ gecacht, 3,75 $ Output pro Million bis Ende 2026. Die maximale Ausgabe liegt bei 65.536 Tokens, deutlich knapper als beim Rest dieser Liste.
Fazit: die beste Wahl, wenn Latenz Ihre eigentliche Beschwerde über Muse Spark 1.2 ist, zumal sich Metas Latenz nicht einmal messen lässt. Planen Sie die Preisänderung im Januar jetzt ein, statt später überrascht zu werden.
6. DeepSeek V4 Pro und V4 Flash
Am besten für: die günstigsten Gewichte, mit denen Sie machen können, was Sie wollen.
Dieser Eintrag gewinnt bei der Lizenz, nicht bei der Punktzahl. V4 Pro erreicht 53,20 bei 0,2521 $ pro Aufgabe, und sowohl es als auch DeepSeek V4 Flash tragen in den Repository-Metadaten eine schlichte mit-Lizenz. Keine Sonderbedingungen. Auch keine Nutzungsrichtlinie daneben.
Wo es Muse Spark 1.2 schlägt. Preis und Freiheit. Es ist pro Aufgabe 37 % günstiger, MIT-lizenziert und hat das tiefste Community-Ökosystem dieses Vergleichs: Eine Suche liefert 662 Repositories, davon 316 quantisiert. Dieses Ökosystem macht Self-Hosting realistisch statt theoretisch.
Wo nicht. Es gibt 3,56 Index-Punkte ab. Dazu eine Eigenheit, die man einplanen sollte: DeepSeek berechnet in der Spitzenzeit das Doppelte, definiert als 01:00 bis 04:00 und 06:00 bis 10:00 UTC. Eine europäische Support-Queue trifft dieses Fenster täglich, eine US-amerikanische meist nicht. Zur Datenpolitik: Die Bedingungen der bezahlten DeepSeek-API schweigen zur Nutzung für Training, statt sie zu erlauben, und die Infrastruktur unterliegt chinesischem Recht.
Preise. V4 Pro kostet 0,66 $ Input und 1,98 $ Output in der Nebenzeit, in der Spitzenzeit das Doppelte. V4 Flash ist mit 0,22 $ und 0,66 $ in der Nebenzeit weit günstiger und erreicht 51,77. Die Rechnung für die Spitzenzeit steht ausführlich im Beitrag zu DeepSeek V4 Flash Preisen.
Fazit: wenn Ihre Anforderung „MIT-Gewichte, günstig" lautet, ist das die Antwort, und nichts anderes auf der Liste konkurriert. Wenn der Workload regulierte Kundendaten berührt, ist der Datenstandort zuerst zu klären.
7. GPT-5.6 Luna
Am besten für: die Volumenarbeit, die Sie nie auf einem Frontier-Modell hätten laufen lassen sollen.
Luna erreicht 52,32 bei 0,0471 $ pro Aufgabe. Das ist 8,5-mal günstiger als Muse Spark 1.2 für 92 % der Index-Punktzahl, und es ist die eine Zahl hier, die jeden, der Massenklassifizierung betreibt, sein gesamtes Setup überdenken lassen sollte.
Wo es Muse Spark 1.2 schlägt. Bei den Kosten, und zwar dramatisch. Die meisten Produktions-Workloads sind überhaupt nicht Frontier-förmig: Tagging und Routing, Extraktion, Zusammenfassungen brauchen selten 56 Index-Punkte. Luna ist vollständig gehostet und hat veröffentlichte Latenz, was Metas Modell nicht hat.
Wo nicht. Es liegt 4,44 Punkte zurück, und diese Lücke zeigt sich bei allem, was wirklich mehrstufig ist. Ein Arbeitstier, kein Denker.
Preise. 0,20 $ Input, 0,02 $ gecacht, 1,20 $ Output pro Million, mit demselben Multiplikator für >272K langen Kontext wie der Rest der GPT-5.6-Familie.
Fazit: die am meisten unterschätzte Zeile der Tabelle. Bevor Sie alles auf ein teureres Modell migrieren, teilen Sie Ihren Traffic auf und prüfen Sie, wie viel davon das teure Modell wirklich braucht.
8. Muse Glimmer 30B
Am besten für: ein Meta-Modell auf eigener Hardware betreiben, heute.
Wenn Sie wegen Meta-Gewichten hier sind, ist dies das, was tatsächlich existiert. Glimmer hat 29,78 Milliarden Parameter unter Apache 2.0, aus Muse Spark destilliert, mit 131.072 Tokens Kontext und einem Wissensstand von Januar 2026.
Wo es Muse Spark 1.2 schlägt. Sie können es herunterladen. Meta quantisiert auf etwa 4 Bit, wodurch das Sprachmodell unter 20 GB bleibt und auf eine 24-GB-Karte passt. Die Kosten pro Aufgabe betragen 0,0732 $, und es ist das einzige Meta-Modell mit einem Openness Index überhaupt, nämlich 44,44. Die Community reagierte sofort: 296 Glimmer-Repositories existieren inzwischen, und unsloths GGUF-Build mit 755.125 Downloads übertrifft Metas eigenes Gewichte-Repository.
Wo nicht. 35,06 gegen 56,76 sind 21,70 Punkte Abstand, und kein lokaler Komfort schließt ihn. Eine Lizenzfußnote ist ebenfalls wissenswert: Neben dem echten Apache-2.0-Text liefert das Repository eine von Meta verfasste USAGE_POLICY.md, die die Nutzung durch Minderjährige einschränkt und militärische, Waffen- und kritische Infrastruktur-Anwendungen untersagt. Apache 2.0 stellt keine dieser Bedingungen, die praktische Fläche ist hier also Apache plus ein Richtliniendokument.
Preise. Kostenloser Download, danach Ihre eigene Rechenleistung. Ein Entwickler, der es auf einem 32-GB-Mac-mini betrieb, war offen darüber, was das praktisch bedeutet:
"I am getting good results with muse-glimmer running locally, with the caveat that everything runs slowly (e.g., give it a task and then go walk outside or do Qi Gong exercises for a while)."
Fazit: ein sehr gutes lokales Agentenmodell und ein schlechter Muse-Spark-Ersatz. Behandeln Sie es wie ein anderes Werkzeug, nicht wie einen Downgrade-Pfad.
Was die Community tatsächlich sagt
Die Stimmung zu Muse Spark 1.2 teilt sich sauber an einer Linie. Wer die Benchmarks las, greift das Ranking an. Wer es tatsächlich nutzte, lobt, wie wenige Tokens es verschwendet. Beide Seiten haben recht, und deshalb wirkt die Launch-Reaktion so widersprüchlich.
Die schärfste skeptische Einschätzung kam am Launch-Tag:
"Somewhat surprised that Meta with all their resources couldn't make a model that matches Composer on any frontier. All the Sparks are dominated by some other model everywhere along the frontier. The use traces must be crucial to functionality which is why they're keeping prices so low."
Zwei Wochen unabhängiger Messung haben das teilweise beantwortet. Im aktuellen Artificial-Analysis-Ranking wird Muse Spark 1.2 beim Preis-Leistungs-Verhältnis überhaupt nicht dominiert, es liegt an seinem Kostenpunkt auf der Frontier. Die zweite Hälfte des Kommentars, die Preisgestaltung als Datenbeschaffung, hält sich deutlich besser.
Bei den Gewichten betrifft der Einwand nicht wirklich diese Ankündigung. Er betrifft die vorherige:
"Meta in this case, started nicely with Llama, then switched to closed models, kicked out researchers to build data labeler CEO empire inside Meta. Now opening again, what's next? closing again?"
Und die Haltung, die ich am häufigsten sah, war weder „wechseln" noch „bleiben". Sie lautete: das offene Artefakt nehmen und das gehostete Produkt ablehnen:
"I'd also argue this is the case for any company releasing open weights. They're not righteous, they're marketing. That's not necessarily a bad thing! [...] I still will not use a hosted Meta product, but damn this model looks solid."
Zum Ausgleich: Die lauteste positive Stimme zur Ankündigung war der CEO von Box, und er las sie als Kategorienwechsel, nicht als Produktstart:
"Meta releasing Muse Spark 1.2 as open weights is a very big deal. America now finally has its response to the open weights AI race."
Diese Reaktion galt allerdings dem Versprechen. Acht Tage später gibt es den Download immer noch nicht.
Was keiner dieser Wechsel behebt
Das ist der Teil, der mir am wichtigsten ist, weil ich mein Arbeitsleben auf der Ebene unter diesen Modellen verbringe.
Wenn Sie sich für einen allgemeinen Coding- oder Recherche-Workload zwischen den acht entscheiden, ist die Tabelle oben das Meiste, was Sie brauchen. Aber ein großer Teil derer, die nach Muse Spark 1.2 Alternativen suchen, versucht, eine Support-Automatisierung mit falschen Antworten zu reparieren, und ein Modellwechsel ist dafür fast nie die Lösung.
Das Beispiel vom Anfang ist das sauberste, das ich kenne. Ein B2B-Technik-Support-Team hatte eine KI, die Kunden selbstsicher sagte „Ja, wir unterstützen Ihr Automodell", für Fahrzeugmarken, die nicht in der Datenbank waren. Das Modell war nicht kaputt. Das Help Center sagte „wir unterstützen alle Modelle", die KI rief diesen einen Satz ab und antwortete dann korrekt aus dem Text, den sie bekommen hatte. Der Wechsel von einem 56,8-Modell auf ein 63,1-Modell ändert daran nichts, weil der Fehler im Retrieval passierte und nicht im Reasoning.
Dasselbe sieht man in den Benchmark-Daten. Die AA-Omniscience-Genauigkeit von Muse Spark 1.2 sank gegenüber 1.1 sogar von 52,0 % auf 45,4 %, während sich die Halluzinationsrate von 50,0 % auf 33,3 % verbesserte. Es wurde nicht kenntnisreicher. Es wurde besser darin, abzulehnen. Für einen allgemeinen Assistenten ist das ein vernünftiger Tausch, für einen Support-Agenten ein schlechter, denn dort ist eine abgelehnte Antwort immer noch ein Ticket.
Drei Dinge bewegen die Support-Genauigkeit stärker als das Modell:
- Was die KI sehen kann. Vergangene gelöste Tickets, nicht nur Help-Center-Artikel. Die meisten Tools trainieren nur auf veröffentlichter Dokumentation, und genau deshalb wiederholen sie „wir unterstützen alle Modelle" zu Ihnen zurück.
- Was sie tut, wenn sie unsicher ist. Konfidenzbasiertes Routing in einen Entwurf statt in eine Live-Antwort, damit eine Antwort mit niedriger Konfidenz zu einer Eskalation wird statt zu einem Fehler vor dem Kunden.
- Ob Sie getestet haben, bevor Ihre Kunden es taten. Die Simulation gegen Ihre eigenen historischen Tickets zeigt Ihnen die reale Lösungsquote. Ein öffentlicher Index-Wert zeigt nur die von jemand anderem.
Ich gehe darauf ausführlicher in KI-Modelle für den Support ein und auf das Fehlermuster selbst in KI-Halluzinationen im Support.
eesel für die Support-Arbeit testen
Wenn Sie auf einem Modellvergleich gelandet sind, weil Ihre Support-KI ständig falsch antwortet, dann ist die Modellstufe der falsche Regler. eesel ist ein KI-Teammitglied, das sich in Zendesk, Freshdesk, Gorgias, HubSpot oder Front einklinkt und am ersten Tag aus Ihrem Verlauf gelöster Tickets lernt, nicht nur aus Ihrer öffentlichen Wissensdatenbank.
Das Entscheidende für alles oben: Bevor es je einen Kunden berührt, lassen Sie es in der Simulation über Ihre eigenen vergangenen Tickets laufen und sehen die reale Lösungsquote, aufgeschlüsselt nach Thema. Gridwise sah 73 % der Tier-1-Anfragen im ersten Monat gelöst. Abgerechnet wird ein Credit pro Ticket (Pläne ab 299 $ im Monat für 500 Credits) und nicht pro Million Tokens, die Sie nicht prognostizieren können, sodass die Spitzenzeit- und Langkontext-Rechnerei dieser Seite nicht mehr Ihr Problem ist.

Kostenlos testen, keine Karte nötig, und innerhalb eines Tages wissen Sie, ob das Modell je Ihr Problem war. eesel testen.
Welches sollten Sie also wählen
Wenn Sie von dieser Seite nur eines mitnehmen, dann dies: Muse Spark 1.2 ist bei Leistung pro Dollar kein schlechter Deal, und ein Wechsel allein wegen der Punktzahl kostet Sie mehr, als er bringt.
Gehen Sie stattdessen aus einem konkreten Grund. Wenn eine falsche Antwort teuer ist, kauft Ihnen Claude Opus 5 den größten echten Abstand. Wenn Sie Gewichte brauchen, die besser sind als das, was Sie heute haben, ist Kimi K3 das einzige Modell, das beides schafft, bei etwa den doppelten Kosten pro Aufgabe. Wenn speziell MIT die Anforderung ist, ist DeepSeek die Antwort, und die Lizenz dort ist sauber. Und wenn Geschwindigkeit die Beschwerde ist, ist Gemini 3.7 Flash von beiden das einzige, dessen Geschwindigkeit jemand veröffentlicht hat.
Und wenn Sie noch auf Metas Gewichte warten, lohnt sich die Bilanz. Moonshot nannte ein Datum und hielt es. Alibaba lieferte innerhalb einer Woche. DeepSeek ist die ganze Zeit MIT. Meta lieferte das Schülermodell und ein Adjektiv.
Häufig gestellte Fragen
Was sind die besten Alternativen zu Meta Muse Spark 1.2?
Ist Muse Spark 1.2 Open Source?
muse-spark-1.2 ein proprietäres API-Modell ohne veröffentlichte Gewichte. Meta kündigte am 10. August an, dass eine Open-Weight-Version bald kommt, ohne Lizenz oder Datum zu nennen, und seitdem ist nichts erschienen. Das Meta-Modell, das tatsächlich offen ist, ist Muse Glimmer 30B unter Apache 2.0. Für das größere Bild siehe meine Übersicht zu Open-Source-KI-Agenten.Wie schneidet die Preisgestaltung von Muse Spark 1.2 im Vergleich zu den Alternativen ab?
muse-spark-1.2 kostet 1,25 $ pro Million Input-Tokens und 4,25 $ Output, was 0,3992 $ pro Intelligence-Index-Aufgabe entspricht. Das ist pro Aufgabe günstiger als die Preise von Kimi K3 mit 0,8375 $ und günstiger als Claude Opus 5 mit 2,3369 $. Die vollständige Aufschlüsselung der Muse-Spark-1.2-Preise steht in meiner Preisanalyse.Welches Open-Weights-Modell kommt Muse Spark 1.2 am nächsten?
Sollte ich für den Kundensupport von Muse Spark 1.2 wechseln?
Was ist Muse Glimmer 30B und kann es Muse Spark 1.2 ersetzen?
Hat Muse Spark 1.2 eine kostenlose Stufe?
muse-spark-1.2-contributor kostet 0,10 $ Input und 0,20 $ Output, dafür nutzt Meta Ihren Traffic zum Training künftiger Modelle, und sie ist auf 100 Anfragen pro Minute begrenzt. Wenn eine niedrige Rechnung ohne diesen Datentausch das Ziel ist, ist GPT-5.6 Luna mit 0,0471 $ pro Aufgabe die günstigste gehostete Option im Ranking.