

Nanbeige 4.3 ist ein kostenloses, unter Apache 2.0 stehendes offenes Modell mit 33 Milliarden Parametern, das Qwen3.8-27B in 18 der 20 vom Labor veröffentlichten Benchmarks schlägt. Die deutlichsten Vorsprünge erzielt es beim agentenbasierten Programmieren: 65,5 vs. 42,5 bei DeepSWE und 23,8 vs. 6,3 bei Terminal-Bench 4.0. Es wurde am 24. Oktober 2026 auf Hugging Face veröffentlicht. Nanbeige bezeichnet es als „Lehrer“: Das eigentliche Ziel ist ein destilliertes Nanbeige4.3-3B, das bisher noch nicht erschienen ist.
Der Haken liegt im Speicherbedarf. Es handelt sich um ein gewöhnliches, dichtes Modell im Llama-Stil, sodass der Kontext-Cache etwa 0,2 MB pro Token kostet. Bei einem Kontext von 128K entspricht das ca. 28 GB Cache zusätzlich zu den ca. 21 GB für 4-Bit-Gewichte, was den Einsatz auf den meisten herkömmlichen GPUs für Endverbraucher ausschließt.
Und falls Sie es für Support-Aufgaben in Erwägung ziehen, sollten Sie das Kleingedruckte lesen: In Nanbeiges eigenem JobBench-Diagramm erreichte es bei Kundenservice-Aufgaben nur 21,1 Punkte gegenüber 31,6 bei Qwen. Ein Support-Agent steht und fällt mit Ihrer Helpdesk-Konfiguration, nicht mit einem Programmier-Score. Aus diesem Grund setzen Teams wie smava eher auf ein fertiges KI-Helpdesk-Teammitglied auf Basis solcher Modelle, anstatt selbst eines zu entwickeln.
Was ist Nanbeige 4.3?
Nanbeige 4.3 ist die vierte Generation (plus ein wenig mehr) der Modelle aus dem Nanbeige LLM Lab, dem KI-Team hinter BOSS Zhipin, der chinesischen Recruiting-Plattform von Kanzhun Limited. Die Serie umfasst bisher ein öffentliches Modell, Nanbeige4.3-33B, sowie das untrainierte Basismodell. Beide wurden am 24. Oktober 2026 hochgeladen. Das Labor kündigte es am nächsten Tag auf X an, wo der Beitrag 2.248 Likes erhielt.
Da ich bei eesel Integrationen und APIs entwickle, stelle ich mir bei einem neuen offenen Modell immer zuerst die gleiche Frage: Was wäre nötig, um dieses Modell tatsächlich hinter einem echten Produkt zu betreiben? Das ist die Perspektive dieses Artikels.
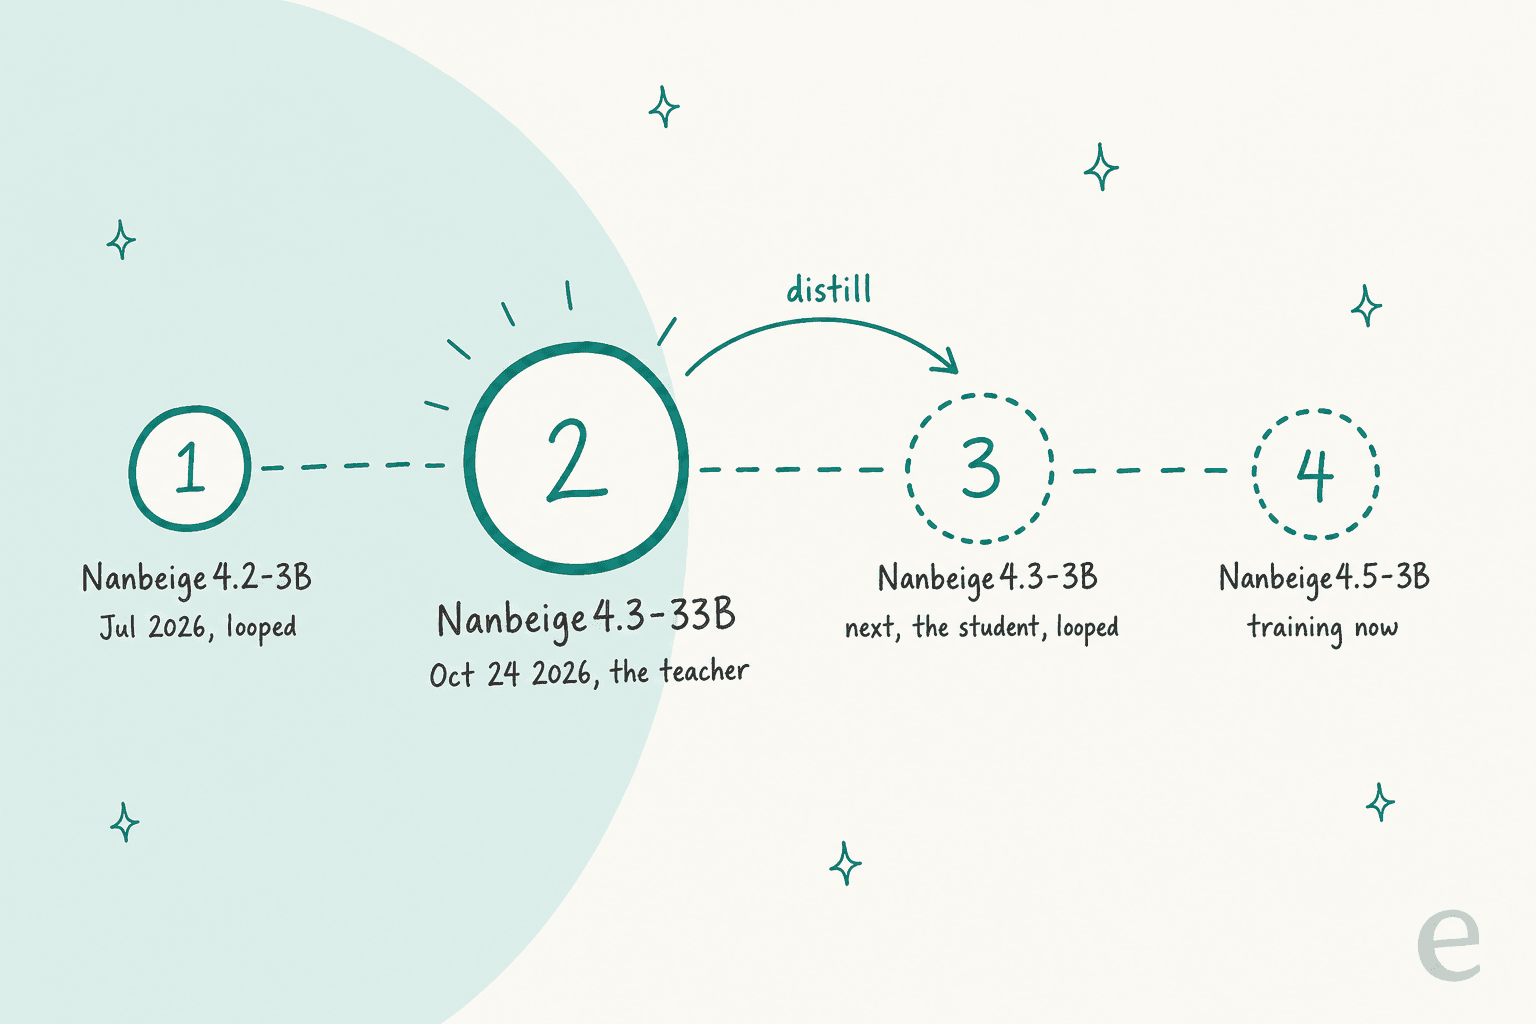
Das Interessante ist nicht die Größe. Nanbeige wurde durch Small Language Models bekannt: Nanbeige4.2-3B, ein 3B „Looped Transformer“, der seine Schichten wiederverwendet, um pro Token intensiver zu „denken“ (dieselbe Idee, die im Zusammenhang mit GPT-6 Astra Aufmerksamkeit erregte), verzeichnete im letzten Monat über 116.000 Downloads. Warum also ein 33B-Modell veröffentlichen? Die Modellkarte beantwortet dies direkt: Die Strategie besteht darin, „zuerst einen hochleistungsfähigen Lehrer-Agenten zu bauen“ und dessen Fähigkeiten dann in kleine Modelle zu destillieren, was laut dem Launch-Post „mit Nanbeige4.3-3B“ beginnen wird.
Mit anderen Worten: Das 33B-Modell ist ein Zwischenschritt. Es ist an sich nützlich, aber das Modell, das Nanbeige wirklich am Herzen liegt, ist der 3B-Schüler.
Die Spezifikationen auf einen Blick
Alle folgenden Angaben stammen aus der Modellkarte und der Konfigurationsdatei im Repository.
| Spezifikation | Nanbeige4.3-33B |
|---|---|
| Parameter | 33,1 Milliarden, dicht |
| Architektur | LlamaForCausalLM, 52 Schichten, 56 Attention-Heads, 8 Key-Value-Heads |
| Kontextfenster | 524.288 Token (512K) |
| Input / Output | Nur Text, Englisch und Chinesisch |
| Lizenz | Apache 2.0 |
| Größe der Gewichte | 66,2 GB in BF16 verteilt auf 14 Dateien |
| Varianten | Instruct-Modell und Basis-Modell |
| Thinking-Modus | Standardmäßig aktiviert, umschaltbar mit enable_thinking |
| Tool-Calling | XML empfohlen, JSON unterstützt |
| Läuft auf | Transformers, vLLM, SGLang |
Eine Antwort unter dem Launch-Beitrag ersparte vielen den Download:
„33B dicht, nur Text, keine Vision, falls das jemandem Zeit erspart“
Wie gut ist Nanbeige 4.3 in Benchmarks?
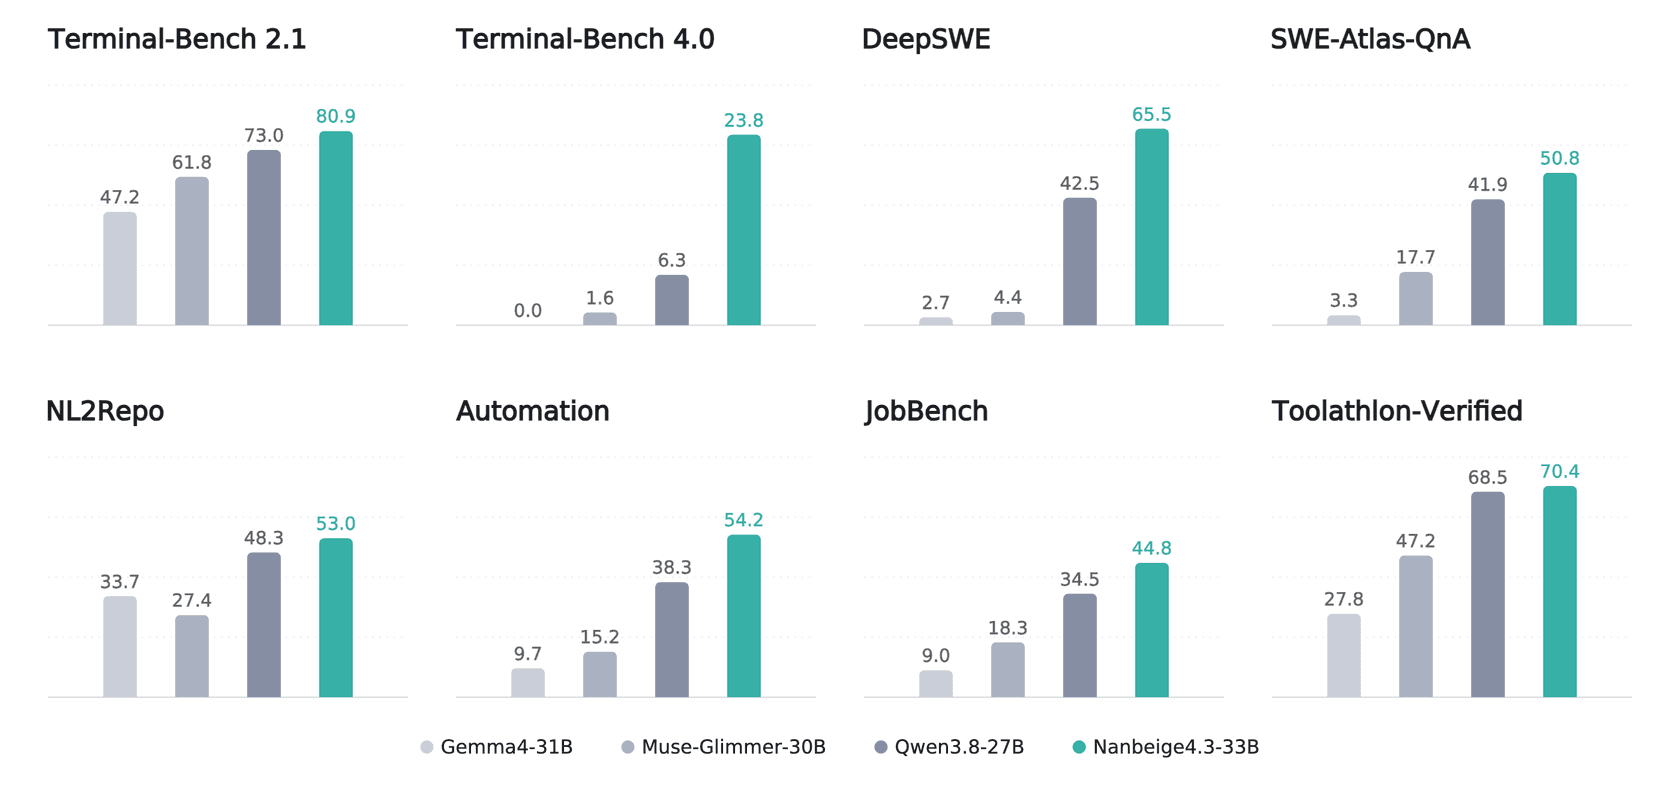
Auf dem Papier ist es sehr gut. Nanbeige hat es mit drei offenen Modellen ähnlicher Größe verglichen, alle bei maximaler Rechenleistung für den Denkprozess, und 20 Ergebnisse veröffentlicht. Nanbeige4.3-33B übertrifft alle drei Konkurrenten in 17 davon und schlägt Qwen3.8-27B, seinen engsten Wettbewerber, in 18 Fällen. Hier ist die vollständige Tabelle aus der Modellkarte:
| Benchmark | Nanbeige4.3-33B | Qwen3.8-27B | Muse-Glimmer-30B | Gemma4-31B |
|---|---|---|---|---|
| Terminal-Bench 2.1 | 80,9 | 73,0 | 61,8 | 47,2 |
| Terminal-Bench 4.0 | 23,8 | 6,3 | 1,6 | 0,0 |
| DeepSWE | 65,5 | 42,5 | 4,4 | 2,7 |
| SWE-Bench Pro | 60,3 | 61,7 | 36,9 | 51,2 |
| SWE-Atlas-QnA | 50,8 | 41,9 | 17,7 | 3,3 |
| NL2Repo | 53,0 | 48,3 | 27,4 | 33,8 |
| Scicode | 52,6 | 46,7 | 44,9 | 45,5 |
| SkillsBench | 61,1 | 56,4 | 39,7 | 28,9 |
| Automation Bench | 54,2 | 38,3 | 15,2 | 9,7 |
| JobBench | 44,8 | 34,5 | 16,6 | 9,0 |
| GDPval | 84,8 | 86,4 | 75,8 | 71,4 |
| Claw-Eval (pass^3) | 78,3 | 75,2 | 57,3 | 44,2 |
| Toolathlon-Verified | 70,4 | 68,5 | 47,2 | 27,8 |
| DeepPlanning | 63,3 | 49,2 | 21,4 | 19,4 |
| EnterpriseOps-Gym | 41,0 | 40,2 | 30,5 | 27,3 |
| YC-bench | $1.025.437 | $641.290 | $513.978 | $265.152 |
| Tau3-Bench | 48,8 | 48,5 | 33,7 | 18,6 |
| GPQA Diamond | 89,5 | 89,2 | 83,5 | 91,3 |
| AIME 2026 | 95,2 | 94,5 | 94,7 | 89,2 |
| AA-LCR | 84,0 | 82,0 | 83,3 | 72,0 |
Die Programmierwerte sind die Schlagzeile. Terminal-Bench 4.0 ist eine neuere, viel schwierigere Version des Kommandozeilen-Tests. Nanbeige erzielt hier 23,8, während das zweitbeste Modell seiner Klasse lediglich 6,3 erreicht. DeepSWE erzählt dieselbe Geschichte: 65,5 gegenüber 42,5. Wenn Sie einen Terminal-Coding-Agenten wie Claude Code oder OpenClaw mit einem lokalen Modell betreiben, ist dies der Unterschied, den Sie bemerken würden. Mein Leitfaden zum Agentic Coding CLI beschreibt, wie sich diese Umgebungen unterscheiden.
Drei ehrliche Vorbehalte, bevor Sie diese Tabelle teilen:
- Es sind die eigenen Testläufe des Labors. Nanbeige hat für jedes Modell dieselbe Testumgebung und dieselben Einstellungen verwendet, was fair ist, aber bisher hat kein unabhängiger Tester diese Ergebnisse reproduziert. Artificial Analysis führt zwar frühere Nanbeige-Modelle auf, dieses hier jedoch noch nicht.
- Die Testumgebung spielt eine Rolle. Terminal-Bench 2.1 lief auf Terminus 2, DeepSWE auf mini-swe-agent v2.4.6, NL2Repo innerhalb von Claude Code. Ihr individuelles Agenten-Setup wird diese Zahlen beeinflussen.
- Kleine Unstimmigkeiten. Das Balkendiagramm und die Tabelle widersprechen sich in zwei Zellen (der JobBench-Wert von Muse-Glimmer ist im Diagramm
18,3und in der Tabelle16,6). Das ist zwar eine Kleinigkeit, aber gut zu wissen, falls Sie die Daten zitieren.
Wo liegt Nanbeige 4.3 zurück?
Blickt man über die Programmier-Benchmarks hinaus, schrumpft der Vorsprung schnell. Speziell gegenüber Qwen3.8-27B (einem kleineren Geschwistermodell von Qwen3.8 Max) liegt es bei SWE-Bench Pro (60,3 vs. 61,7) und GDPval (84,8 vs. 86,4) zurück. Bei Tau3-Bench, dem Benchmark, der einen KI-Agenten simuliert, der Kunden einer Fluggesellschaft oder eines Einzelhändlers bedient, liegt es praktisch gleichauf (48,8 vs. 48,5).
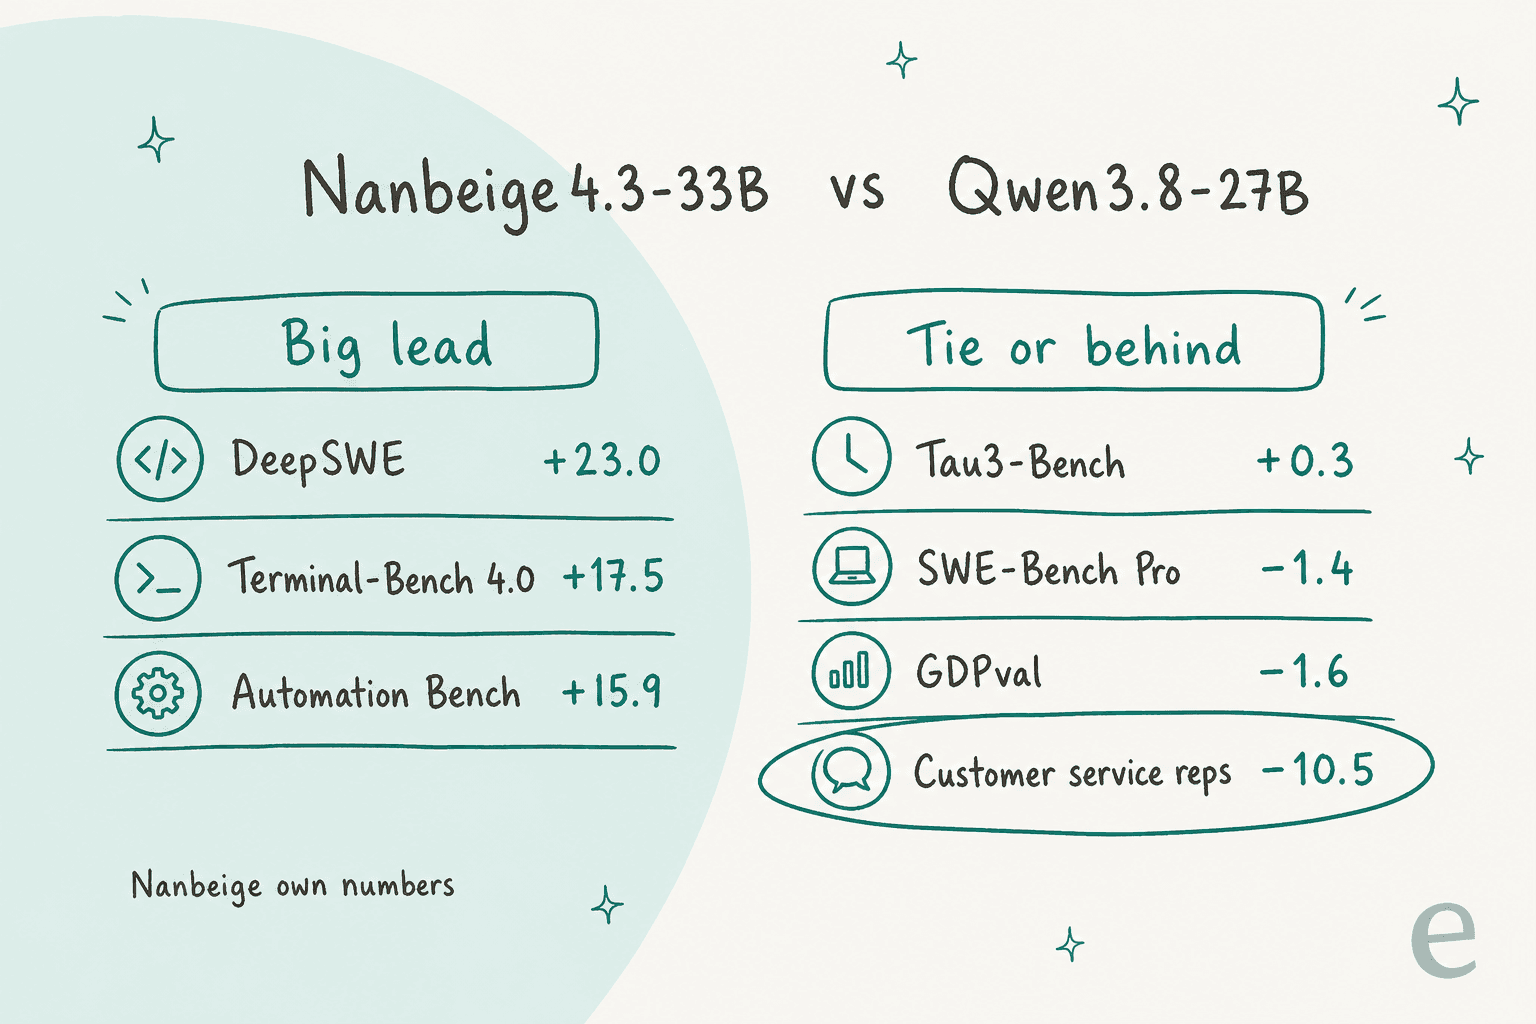
Das Detail, das ich hervorheben möchte, findet sich im JobBench-Diagramm, das die Punktzahl über 35 Berufe aufschlüsselt. Nanbeige gewinnt in den meisten Kategorien, insbesondere bei Webadministratoren (72,0 vs. 36,0) und technischen Redakteuren (72,1 vs. 53,7). Aber bei Aufgaben für Kundenservicemitarbeiter erzielt es nur 21,1 gegenüber Qwens 31,6. Auch bei Sekretariats- und Verwaltungsaufgaben unterliegt es (28,8 vs. 47,5).
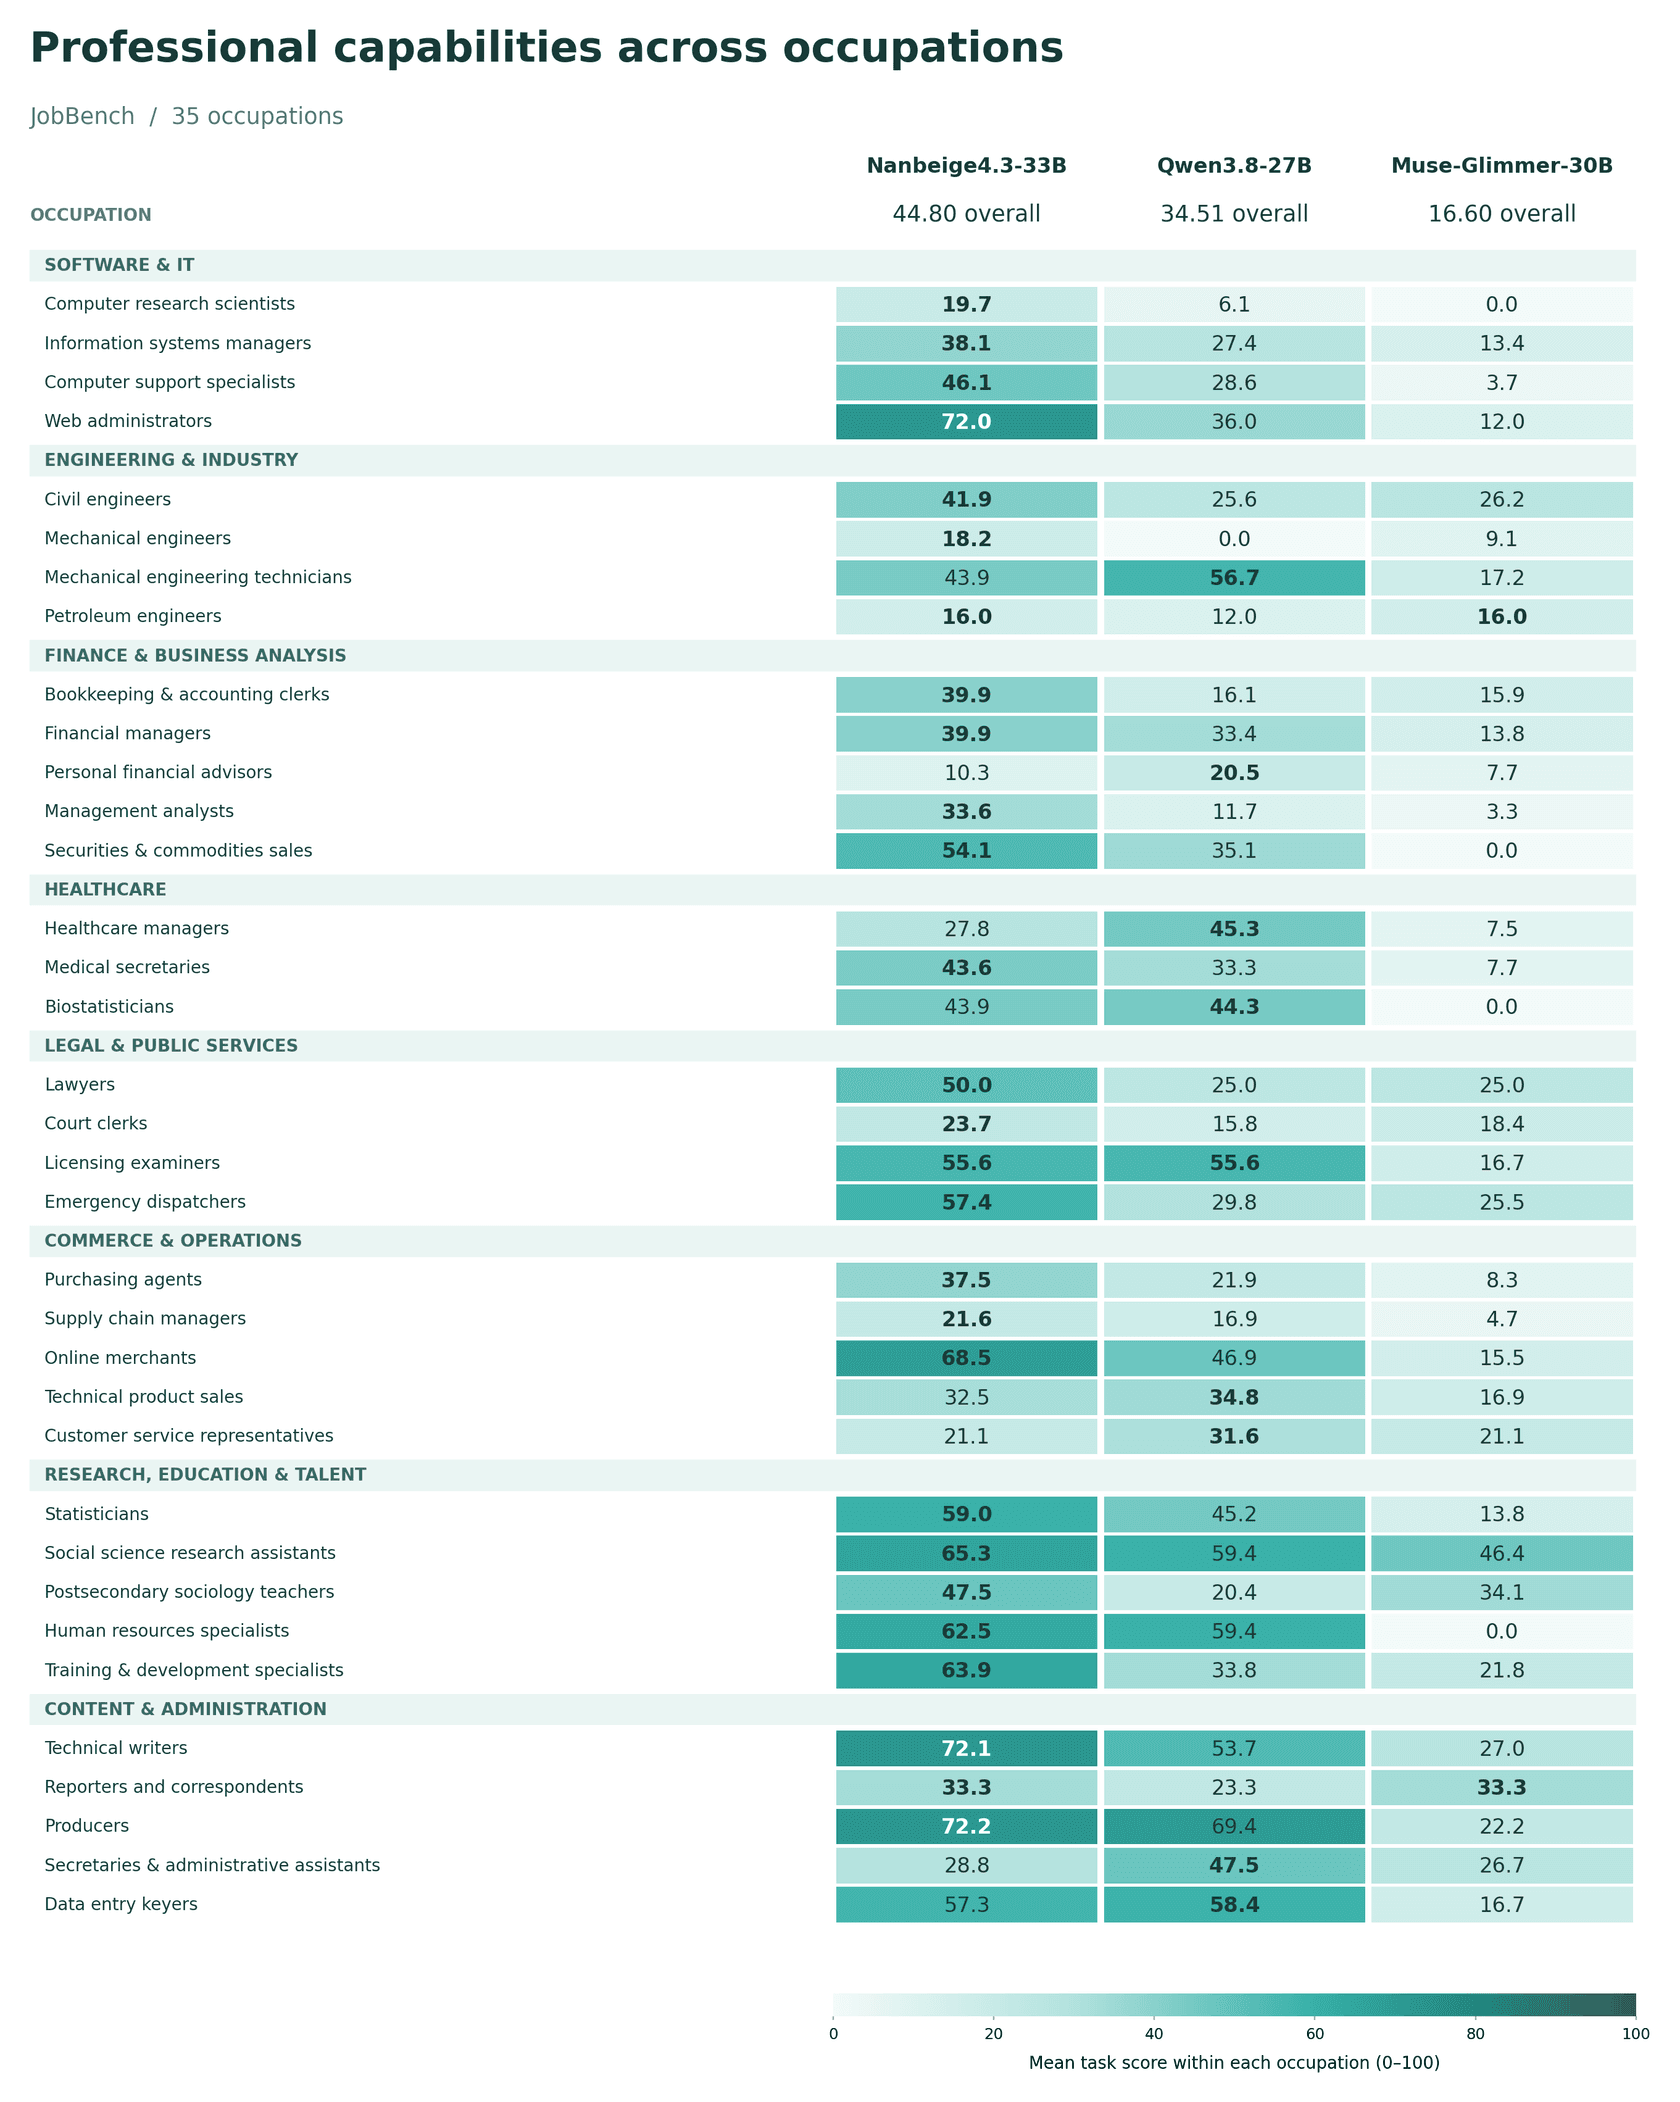
Dies deckt sich mit meinen Beobachtungen im Support-Bereich. Hervorragende Fähigkeiten beim Schreiben von Code in einem Terminal übertragen sich nicht automatisch auf die Beantwortung eines Kunden, der über eine Rückerstattung verärgert ist. Das ist auch der Grund, warum ein KI-Agent und ein Chatbot nicht dasselbe sind. Die Support-Qualität hängt weitaus stärker davon ab, was das Modell nachschlagen kann, als vom Modell selbst. In meiner Zusammenfassung der Modelle für Support-Tickets verlor dasselbe Modell im Tau-Benchmark von Sierra 68 Punkte, sobald die Antwort in Dokumenten statt in einem Tool zu finden war.
Nanbeige führte Tau3-Bench mit dem offiziellen Repository aus, aber das Ergebnis ist nicht auf Sierras öffentlichem Leaderboard zu finden. Vergleichen Sie es daher nicht direkt mit den dortigen Zahlen.
Wie viel Speicher benötigt Nanbeige 4.3?
Diesen Teil spart der Launch-Post aus. Die Gewichte sind noch handhabbar: Ein Community-GGUF (4-Bit) von bartowski belegt 20,79 GB bei Q4_K_M und 35,2 GB bei Q8_0. Das eigentliche Problem ist der Kontext.
Nanbeige4.3-33B ist ein klassischer dichter Transformer mit Grouped-Query Attention: 52 Schichten, 8 Key-Value-Heads mit je 128 Dimensionen. Jeder Token, den Sie im Kontext behalten, kostet 2 × 52 × 8 × 128 × 2 Bytes, was bei 16-Bit 212.992 Bytes pro Token entspricht. Diese Zahl entscheidet über Ihre GPU, nicht die Anzahl der Parameter.
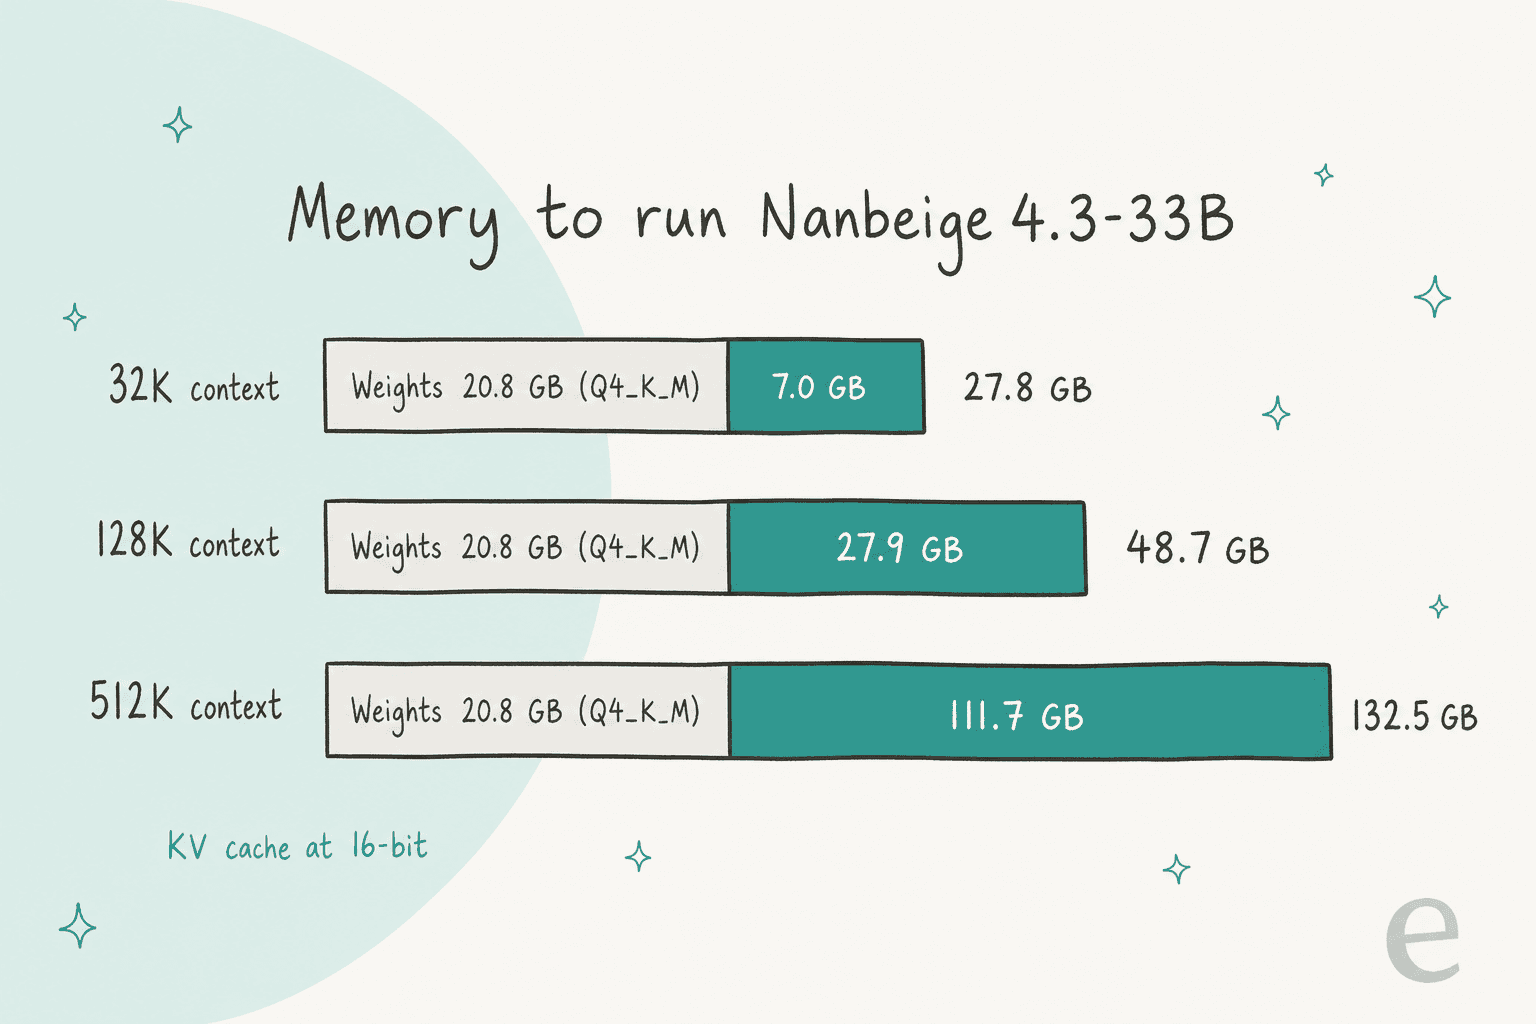
| Kontextlänge | KV-Cache (16-Bit) | KV-Cache (8-Bit) | Gesamt mit Q4_K_M Gewichten (16-Bit Cache) |
|---|---|---|---|
| 32K | 7,0 GB | 3,5 GB | ~27,8 GB |
| 128K | 27,9 GB | 14,0 GB | ~48,7 GB |
| 256K | 55,8 GB | 27,9 GB | ~76,6 GB |
| 512K | 111,7 GB | 55,8 GB | ~132,5 GB |
Die Schlagzeile „512K Kontext“ ist also real, aber die volle Nutzung erfordert Server-Hardware. Die eigenen Serving-Beispiele von Nanbeige für vLLM und SGLang setzen die Tensor-Parallelität auf 4, was bedeutet, dass vier GPUs benötigt werden.
Den Nutzern fiel das innerhalb eines Tages auf. Der am meisten diskutierte Thread im Repository ist eine Anfrage zur Optimierung des KV-Caches. Dort weisen Nutzer darauf hin, dass einige Konkurrenten in dieser Größenklasse um ein Vielfaches weniger Cache für denselben Kontext benötigen. Das ist ein berechtigter Einwand gegen die Behauptung der Modellkarte, es sei „kosteneffizient“: Bei langem Kontext ist ein dichtes 33B-Modell alles andere als günstig.
Der Vorteil des schlichten Designs ist die Kompatibilität. Da es eine Standard-Llama-Architektur nutzt, erschienen innerhalb von zwei Tagen mindestens 30 Community-Konvertierungen (GGUF, MLX für Apple Silicon, NVFP4, FP8) auf Hugging Face. Es läuft auf Standard-vLLM und SGLang mit den Reasoning- und Tool-Call-Parsern von Qwen.
Wie führen Sie Nanbeige 4.3 aus?
Es gibt keine gehostete API von Nanbeige, und OpenRouter hat das Modell zum 26. Oktober 2026 noch nicht gelistet. Sie müssen die Gewichte herunterladen und sie selbst ausführen. Die Modellkarte schlägt drei Wege vor:
- Transformers für schnelle Tests. Laden Sie
Nanbeige/Nanbeige4.3-33Bmittrust_remote_code=Trueunddevice_map='auto'. - vLLM für das Hosting. Das Beispiel in der Modellkarte nutzt
--tensor-parallel-size 4,--reasoning-parser qwen3und--tool-call-parser qwen3_coder. - SGLang mit denselben zwei Parsern und
--tp-size 4.
Zwei Schalter in der Chat-Vorlage (Chat-Template) sind wichtiger, als sie auf den ersten Blick scheinen:
enable_thinkingist standardmäßig aktiviert. Schalten Sie es für schnelle Antworten aus.preserve_thinkingbehält die Gedankengänge aus früheren Runden bei. Nanbeige empfiehltTruefür Tool-Nutzung und Programmier-Agenten undFalsefür einfachen Chat. Die Benchmark-Ergebnisse wurden mit aktiviertem Schalter erzielt.
Die empfohlenen Einstellungen unterscheiden sich ebenfalls je nach Aufgabe: Temperatur 1,0 mit bis zu 65.536 neuen Token für Agenten- und Tool-Aufgaben, und Temperatur 0,6 mit bis zu 262.144 neuen Token für Reasoning und Chat.
Wenn Sie lokale Optionen vergleichen: Andere offene Modelle, die ich kürzlich behandelt habe, wie Gemma 4, Mistral Large 4 und DeepSeek V4 Flash, gehen unterschiedliche Kompromisse zwischen Größe, Kontextkosten und gehostetem Zugang ein. Meine Liste Open-Source-KI-Agenten zeigt auf, in welche Systeme Sie diese integrieren können, und die Übersicht KI-Coding-Assistenten deckt die gehostete Seite ab. Falls Sie API-Zugriff statt Selbst-Hosting bevorzugen, sind Kimi K3 und MiniMax 3 die offensichtlichen Alternativen.
Wie geht es mit Nanbeige weiter?
Das Nanbeige-Team hat Fragen direkt auf der Hugging Face-Seite des Modells beantwortet. Drei dieser Antworten skizzieren die Roadmap. Auf die Frage, ob das 33B-Modell das Looped-Design von 4.2 wiederverwendet, verneinte ein Nanbeige-Teammitglied und erklärte den Grund:
„Basierend auf unseren Experimenten bietet die Looped-Transformer-Architektur bei kleineren Modellgrößen ein besseres Verhältnis zwischen Qualität und Rechenaufwand. Unsere kommenden kleinen Modelle, wie Nanbeige4.3-3B und Nanbeige4.5-3B, werden die Looped-Transformer-Architektur nutzen und eine verbesserte Leistung liefern.“
Dasselbe Teammitglied gab an, dass ein technischer Bericht zusammen mit Nanbeige4.3-3B veröffentlicht wird, ein DFlash2-Modul für spekulatives Decoding für eine schnellere Generierung geplant ist und FP8-Gewichte „bald kommen“. Bereits im September teilte das Labor auf X mit, dass Nanbeige 4.5 bereits trainiert wird.
Meine Einschätzung: Falls Sie kleine Agenten auf bescheidener Hardware betreiben, sollten Sie auf das Release von Nanbeige4.3-3B warten, nicht auf dieses hier. Das 33B-Modell beweist lediglich, dass der „Lehrer“ stark ist. Die eigentliche Frage ist, ob der 3B-Schüler diesen Programmiervorteil in einem Modell beibehalten kann, das auf einen Laptop passt. Das kann niemand beantworten, bis es veröffentlicht wird.
Sollten Sie Nanbeige 4.3 verwenden?
Das hängt davon ab, was Sie bauen möchten. Die Benchmark-Tabelle verrät Ihnen bereits das Meiste:
- Programmier-Agenten auf eigener Hardware: Ja, probieren Sie es aus. Der Vorsprung bei Terminal-Bench 4.0 und DeepSWE ist groß genug, um Schwankungen in der Testumgebung auszugleichen. Apache 2.0 bedeutet zudem keine rechtlichen Kopfschmerzen. Planen Sie jedoch Budget für den KV-Cache ein oder begrenzen Sie den Kontext auf 32K bis 64K.
- Arbeit mit langen Dokumenten auf einer GPU: Wahrscheinlich nicht. Ein Prompt mit 128K benötigt etwa 49 GB mit 4-Bit-Gewichten.
- Feintuning eines eigenen Agenten: Das Basismodell ist ein guter Startpunkt. Nanbeige berichtet, dass es Gemma4-31B-Base in allen acht getesteten Basis-Benchmarks schlägt, einschließlich MMLU-Pro (
66,9vs.59,3). - Kundensupport: Mit diesen Werten eher nicht. Es verliert gegen Qwen bei Kundenservice-Aufgaben und liegt bei Tau3-Bench nur gleichauf. Zudem beantwortet ein Modell allein keine Tickets. Meine Auswahl der besten KI-Agenten für den Kundenservice betrachtet stattdessen das Gesamtsystem.
KI mit echten Support-Tickets statt Benchmarks ausführen
Der letzte Punkt ist das Feld, in dem ich mich täglich bewege. Ein Modell wie Nanbeige4.3-33B ist Infrastruktur. Um ein echtes Ticket zu beantworten, muss etwas in Ihrem Helpdesk integriert sein, das Ihre Makros und vergangenen Tickets liest, weiß, welche Kunden an einen Menschen übergeben werden müssen, und die Regeln befolgt, was niemals gesagt werden darf. Das ist die Aufgabe, für die der KI-Helpdesk-Mitarbeiter von eesel entwickelt wurde: Eines der einsatzbereiten KI-Teammitglieder, die Sie für eine spezifische Rolle einstellen. Er läuft innerhalb von Tools wie Zendesk AI Umgebungen, anstatt diese zu ersetzen. Oft ist die Rechnung der Kosten pro Ticket ausschlaggebend für die Entscheidung.
smava, eine Berliner Plattform für Kreditvergleiche, zeigt, wie das in der Praxis aussieht. eesel bearbeitete bei smava und der Schwestermarke Finanzcheck etwa 27.000 Zendesk-Tickets in einem Monat. Dabei wurden rund 14.600 kategorisiert und etwa 15.300 Antwortentwürfe auf Basis von ca. 820 Makros und Help-Center-Artikeln vorbereitet. Kunden, die bereits einen Kreditberater haben, werden übersprungen, damit sie direkt von ihrem Berater hören. eesel versendet die Antworten niemals selbst: Ein menschlicher Mitarbeiter prüft und genehmigt jeden Entwurf. Nichts davon erscheint in einem Programmier-Benchmark, aber all das entscheidet darüber, ob die KI eine Hilfe oder ein Hindernis ist.

Bevor Sie live gehen, testet eesel Ihr Setup anhand hunderter Ihrer vergangenen Tickets. So sehen Sie die Antworten, bevor ein Kunde sie erhält. Das sagt Ihnen mehr als jeder Benchmark eines Anbieters. Ich habe separat beschrieben, wie dieses Testing funktioniert. SamCart ging einen ähnlichen Weg bei Freshdesk, mit einem Agenten für E-Mail-Tickets und einem weiteren für den Website-Chat. Beide beantworten Anfragen auf Basis von etwa 280 Help-Center-Artikeln. Wenn Sie lieber über das Terminal arbeiten, so wie mit einem lokalen Modell, ermöglicht Ihnen das die eesel CLI. Damit können Sie, ein Skript oder ein Coding-Agent wie Claude Code Integrationen verbinden, Anweisungen für den Agenten bearbeiten, ausstehende Aktionen genehmigen oder ablehnen und das Aktivitätsprotokoll als JSON auslesen.
Probieren Sie eesel aus
Nanbeige 4.3 ist eine leistungsstarke offene Engine für Programmier-Agenten. Wenn Sie jedoch diese Woche einen Agenten benötigen, der Ihre Support-Warteschlange bearbeitet, lässt sich der KI-Helpdesk-Mitarbeiter von eesel in wenigen Minuten in Zendesk, Freshdesk oder Gorgias integrieren. Er lernt aus Ihren vergangenen Tickets sowie Ihrem Help-Center und erstellt oder versendet Antworten innerhalb der von Ihnen gesetzten Regeln. Der Start ist mit 100 Credits kostenlos und ohne Kreditkarte möglich, sodass Sie das System an echten Tickets testen können, bevor Sie sich entscheiden. Probieren Sie eesel aus.
Häufig gestellte Fragen
Was ist Nanbeige 4.3?
Nanbeige 4.3 ist eine Modellserie des Nanbeige LLM Lab bei BOSS Zhipin (Kanzhun). Die erste Veröffentlichung, Nanbeige4.3-33B, erschien am 24. Oktober 2026 auf Hugging Face unter der Apache 2.0-Lizenz. Es ist ein dichtes Textmodell mit 33 Milliarden Parametern und einem Kontextfenster von 512K, das für agentenbasiertes Programmieren und bürospezifische Aufgaben entwickelt wurde. Es soll als „Lehrer“ für das kleinere Nanbeige4.3-3B dienen. Es reiht sich in die Riege offener Modelle wie Gemma 4 und Qwen ein.
Ist Nanbeige 4.3 kostenlos nutzbar?
Ja. Die Gewichte für Nanbeige4.3-33B und Nanbeige4.3-33B-Base sind unter Apache 2.0 veröffentlicht, was eine kommerzielle Nutzung erlaubt. Sie zahlen stattdessen für die Hardware: Allein die BF16-Gewichte belegen 66 GB, und ein 4-Bit GGUF benötigt etwa 21 GB vor Berücksichtigung des Kontextspeichers. Um einen Eindruck von den Kosten gehosteter Modelle zu bekommen, sehen Sie sich die Preise für DeepSeek V4 Flash an.
Wie viel VRAM benötigt Nanbeige 4.3 33B?
Etwa 21 GB für 4-Bit-Gewichte plus ca. 0,2 MB KV-Cache (Key-Value-Cache) pro Token bei 16-Bit. Das ergibt insgesamt etwa 28 GB bei 32K Kontext, 49 GB bei 128K und über 130 GB beim vollen 512K Kontext. Die eigenen vLLM- und SGLang-Beispiele von Nanbeige nutzen 4-fache Tensor-Parallelität. Wenn Sie etwas benötigen, das auf eine einzelne kleine Karte passt, sind die früheren Small Language Models der Nanbeige-Linie mit 3B eine Option.
Ist Nanbeige 4.3 besser als Qwen3.8-27B?
In der Tabelle von Nanbeige schlägt Nanbeige4.3-33B das Modell Qwen3.8-27B in 18 von 20 Benchmarks, wobei die größten Unterschiede bei DeepSWE (65,5 vs. 42,5) und Terminal-Bench 4.0 (23,8 vs. 6,3) liegen. Qwen gewinnt weiterhin bei SWE-Bench Pro und GDPval, und bisher hat kein unabhängiges Labor die Zahlen neu überprüft. Das größere Geschwistermodell von Qwen wird im Qwen3.8 Max Testbericht behandelt.
Kann ich Nanbeige 4.3 für den Kundensupport verwenden?
Sie können es, aber die eigenen Zahlen sprechen nicht unbedingt dafür. In JobBench erreichte es 21,1 Punkte bei Aufgaben für Kundenservicemitarbeiter gegenüber 31,6 für Qwen3.8-27B, und der Tau3-Bench-Score ist ein Unentschieden mit 48,8 zu 48,5. Ein Support-Agent benötigt zudem eine Anbindung an Ihren Helpdesk, Ihre Makros und Übergaberegeln, was ein KI-Helpdesk-Agent wie eesel für Sie übernimmt.
Verfügt Nanbeige 4.3 über eine API?
Nanbeige stellt Gewichte bereit, aber keine gehostete API. Die Modellkarte beschreibt die Selbstausführung mit Transformers, vLLM oder SGLang. OpenRouter führte es zum 26. Oktober 2026 noch nicht auf. Wenn Sie lieber ein gehostetes offenes Modell aufrufen möchten, sind Kimi K3 und GLM-5.3 Flash beide über APIs verfügbar.
Wann erscheint Nanbeige4.3-3B?
Nanbeige hat noch kein Datum genannt. Ein Teammitglied von Nanbeige gab auf der Hugging Face-Seite des Modells an, dass der technische Bericht für die 4.3-Serie zusammen mit Nanbeige4.3-3B veröffentlicht wird und dass das 3B-Modell das „Looped Transformer“-Design von Nanbeige4.2-3B nutzen wird. Hintergrundinformationen zu Looped-Modellen finden Sie im GPT-6 Astra Erklärvideo.