

Was ist Cloudflare Clef?
Clef und Clef-flash sind die ersten Modelle, die das Workers-AI-Team von Cloudflare selbst trainiert hat, angekündigt im Clef-Changelog-Eintrag und in einem Launch-Beitrag von Michelle Chen während der Birthday Week. Sie gehören zu einer Kategorie, die einen Monat zuvor kaum existierte: dem Entscheidungsmodell, das im September durch TypeSafe Jev bekannt wurde.
Ein Entscheidungsmodell ist ein Klassifikator, den du zur Anfragezeit konfigurierst. Statt ein Modell auf deinen Labels zu trainieren, beschreibst du die Labels in der Anfrage („billing: Zahlungen, Rechnungen und Erstattungen“), und das Modell bewertet jedes davon. Cloudflare beschreibt die Ausgabe als „eine Wahrscheinlichkeit für jede erlaubte Antwort“, und genau das bekommst du zurück. Kein Absatz, keine Begründungsspur, kein JSON, das du validieren müsstest. Wenn dir die Kategorie neu ist: Die Erklärung zu Entscheidungsmodellen meiner Kollegin bzw. meines Kollegen vergleicht Jev, Clef, Strands Decider und die OpenAI Decisions API direkt miteinander.
Drei Dinge unterscheiden Clef beim Start laut Cloudflares eigenem Vergleich von Jev:
- Vision. Clef hat einen Vision-Encoder und akzeptiert bis zu 4 Bilder pro Anfrage. Jev liest nur Text.
- Ein größeres Fenster. 64K Tokens gehosteter Kontext gegenüber 32K bei Jev, und die Gewichte wurden für 256K trainiert.
- Offene Gewichte. Beide Modelle liegen unter Apache 2.0 auf Hugging Face. Die Gewichte von Jev sind nicht öffentlich.
Es ist außerdem Cloudflares zweiter nennenswerter KI-Launch innerhalb von zwei Monaten, nach der Kitesurf-Browser-Engine im August.
Ich baue bei eesel Agent-Funktionen, und der Schritt, der Clef am meisten ähnelt, passiert, bevor jemand ein Wort schreibt: zu entscheiden, was ein Ticket ist und wohin es gehört. Mit diesem Schritt habe ich viel Zeit verbracht, und das hat mich überrascht: Die Routing-Fragen, die echte Teams beantwortet haben wollen, lauten selten nur „welches Team“. In einem Verkaufsgespräch bat ein Support-Leiter eines IT-Dienstleisters im öffentlichen Sektor, der etwa 3.000 Freshdesk-Tickets pro Monat bearbeitet, um eine KI, die Tickets von Konten, die in den letzten zwei Monaten angelegt wurden, als wahrscheinlich ungeschulte Nutzer markiert und alles, was voraussichtlich länger als 20 Minuten dauert, in Richtung eines kostenpflichtigen Servicepfads lenkt. Das sind drei typisierte Fragen: ein Ja/Nein, ein Ja/Nein und ein Score. Genau dafür wurde Clef gebaut, und deshalb lohnt es sich, es richtig zu verstehen.
Wie funktioniert ein Entscheidungsmodell wie Clef?
Jeder Clef-Aufruf hat dieselben zwei Eingaben. state ist das, was beurteilt werden soll: ein String oder strukturierte Daten wie ein Chatverlauf oder ein Bestelldatensatz. questions ist eine Map aus 1 bis 64 benannten Fragen, jede mit einem von drei Typen:
| Typ | Was du fragst | Was zurückkommt |
|---|---|---|
noul | Eine Ja/Nein-Frage | Die Wahrscheinlichkeit, dass die Antwort wahr ist |
choice | Wähle eine von 2 bis 26 Optionen, die du definierst | Die Wahl, eine Wahrscheinlichkeit pro Option und ein Konfidenzwert |
score | Bewerte auf einer geordneten Skala mit 2 bis 26 Stufen | Ein wahrscheinlichkeitsgewichteter Score, eine Legende und Wahrscheinlichkeiten pro Stufe |
Hier das durchgespielte Beispiel von der Ollama-Modellseite mit den echten Zahlen, die es für ein Ticket zu einer doppelten Abbuchung zurückgibt:
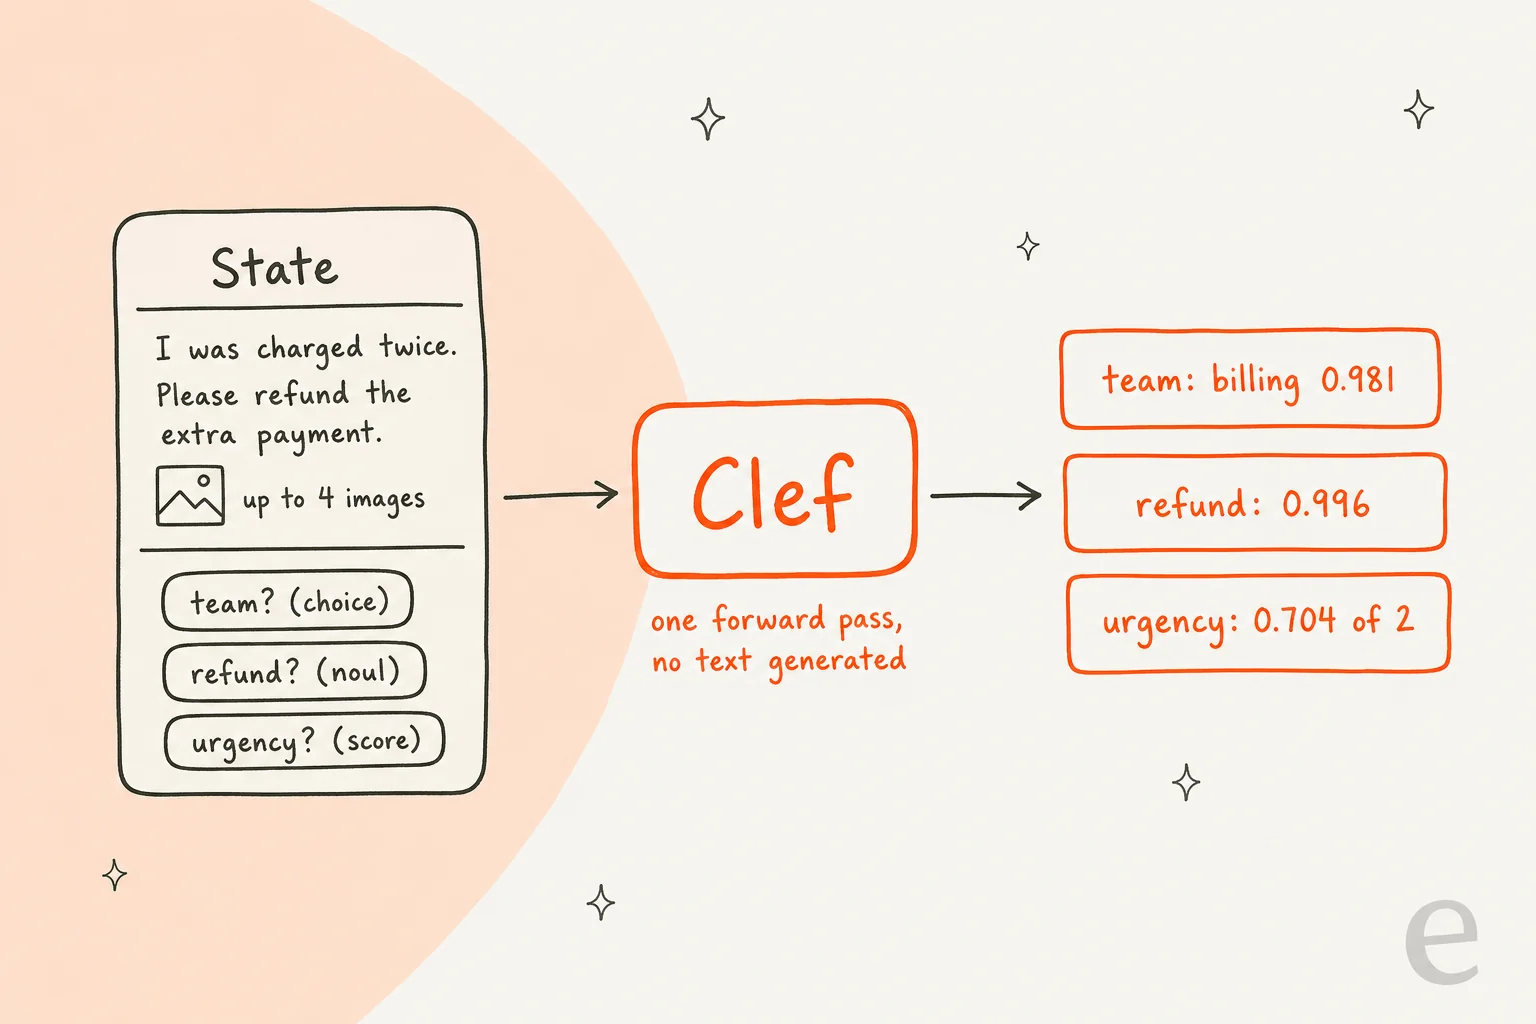
Unter der Haube erzeugt Clef diese Zahlen nicht Token für Token. Laut der Hugging-Face-Modellkarte läuft ein eingefrorenes Qwen-Backbone (Qwen3.8-27B für Clef, Qwen3.5-9B für Clef-flash) in einem einzigen Prefill-Durchgang, dann liest ein kleiner „Joint Schema Head“ die finalen Hidden States, leitet Evidenz aus dem State an jede Frage weiter und bewertet jede Option jeder Frage gleichzeitig. Cloudflare hat diesen Head zusammen mit Low-Rank-Adaptern vom Rang 256 trainiert, mit einem Brier-Loss, um die Kalibrierung der Wahrscheinlichkeiten abzustimmen, plus einem Reinforcement-Learning-Schritt namens RLCD (Reinforcement Learning for Calibrated Decisions). Da nichts autoregressiv generiert wird, kommt die Antwort in einem einzigen Forward-Pass, und daher kommt die Geschwindigkeit.
Ein Detail in der Dokumentation lohnt zweimaliges Lesen. Bei einer choice- oder score-Antwort „reicht confidence von 0 bis 1 und zeigt, wie konzentriert die Wahrscheinlichkeiten sind. Es ist nicht die Wahrscheinlichkeit, dass die Antwort richtig ist.“ Im obigen Beispiel kam der Urgency-Score mit einer Konfidenz von nur 0,071 zurück, weil die Wahrscheinlichkeiten über alle drei Stufen verteilt waren. Und wenn zwei Optionen gleichauf liegen, folgt die Antwort deiner Optionsreihenfolge, setze also den sichereren Standard an die erste Stelle.
Dieser Kalibrierungspunkt ist beim Routing alles. Ein Hacker-News-Kommentator hat es besser formuliert, als ich es kann:
„for production routing, you almost always want to threshold on confidence ('auto-handle above 0.9, route to a human below'), and that only works if the probabilities mean what they say. A 96% model with overconfident outputs is operationally worse than a 94% model with honest ones.“

Wenn du solche Schwellenwerte zum ersten Mal festlegst, gehen die Abwägungen im Leitfaden zum Festlegen von Konfidenz-Schwellenwerten durch.
Clef vs. Clef-flash: Was ist der Unterschied?
Gleiche API, gleiche Preisstruktur, gleiches gehostetes 64K-Fenster, gleiche Vision-Unterstützung. Der Unterschied ist die Größe, und nach Cloudflares eigenen Zahlen ist das kleinere Modell nicht einfach eine schlechtere Kopie des größeren.
| Clef | Clef-flash | |
|---|---|---|
| Modell-ID | @cf/cloudflare/clef | @cf/cloudflare/clef-flash |
| Parameter | 27B | 9B |
| Basismodell | Qwen3.8-27B | Qwen3.5-9B |
| Cloudflares Bezeichnung | „Highest-precision decisions“ | „Latency-critical, hot-path decisions“ |
| Latenz Median / p95 | 209,3 ms / 238,6 ms | 38,8 ms / 122,4 ms |
| Input-Preis | 0,24 $ pro M Tokens | 0,09 $ pro M Tokens |
| BANKING77 (77 Bank-Intents) | 94,2 | 90,9 |
| CLINC150 + Out-of-Scope | 97,4 | 66,8 |
| RAGTruth (Halluzinations-F1) | 79,4 | 35,6 |
| Haushaltsgeräte (Tool-Aufrufe) | 83,0 | 97,7 |
| Kundenservice-Workflow | 76,3 | 77,0 |
Zwei Zeilen sind für die Support-Arbeit am wichtigsten. CLINC150 hat 150 Intents plus Out-of-Scope-Beispiele, und Clef-flash fällt dort auf 66,8, während Clef bei 97,4 bleibt. Sobald deine Optionsliste lang wird oder „keine davon“ häufig die richtige Antwort ist, verdient sich das größere Modell seine 5-fache Latenz. RAGTruth prüft, ob eine Antwort in ihrer Quelle fundiert ist, und Clef-flash erreicht dort 35,6 gegenüber 79,4 bei Clef. Wenn du ein Modell KI-entworfene Antworten gegen dein Help Center prüfen lassen willst (einer der besseren Halluzinations-Checks, die du ergänzen kannst), nimm Clef, nicht Clef-flash.
Andererseits liegen die beiden bei TypeSafes Kundenservice-Workflow-Eval innerhalb eines Punkts voneinander, und Clef-flash gewinnt mehrere Tool-Calling-Sets klar. Für ein klassisches Triage-Schema (dringend oder nicht, fünf Teams, eine Schweregradskala) ist Clef-flash der sinnvolle Standard. Du bist nicht sicher, auf welcher Seite du stehst? Wähle, was du entscheiden willst:
Clef, Clef-flash oder keins von beiden?
Wähle die Entscheidung, die du treffen musst. Die Scores stammen aus Cloudflares eigenen Benchmark-Läufen.
Wähle eine Option, um die Empfehlung zu sehen.
Wie betreibt man Cloudflare Clef?
Es gibt vier Wege hinein, und alle akzeptieren denselben Request-Body (Cloudflares Dokumentation nennt ihn die System-One-API, die Jev eingeführt hat). Das heißt, Code, der gegen Jev geschrieben wurde, funktioniert meist unverändert.
1. Workers-AI-Binding
Wenn dein Code bereits auf Cloudflare Workers läuft, füge ein AI-Binding hinzu und rufe das Modell direkt auf. Das ist der Weg mit der niedrigsten Latenz, da die Anfrage Cloudflares Netzwerk nie verlässt:
const response = await env.AI.run("@cf/cloudflare/clef-flash", {
  model: "clef-flash",
  state: "Checkout has been failing for every customer for the last hour.",
  questions: {
    urgent: { type: "noul", instructions: "Is this support request urgent?" },
    team: {
      type: "choice",
      instructions: "Which team should handle this request?",
      criteria: {
        billing: "Payments, invoices, and refunds",
        technical: "Outages, errors, and configuration",
        sales: "Plans and upgrades",
      },
    },
  },
});
// response.answers.urgent.noul  -> probability the request is urgent
// response.answers.team.choice  -> highest-probability team
2. REST-API
Von überall sonst sendest du denselben Body per POST an https://api.cloudflare.com/client/v4/accounts/$ACCOUNT_ID/ai/run/@cf/cloudflare/clef mit einem Bearer-Token. Cloudflare unterstützt außerdem, diese Aufrufe über AI Gateway zu leiten, was dir Logging und später den Datensatz für das Fine-Tuning liefert. Wenn du Clef aus einem Helpdesk-Webhook aufrufst, ist das der Weg, den du nehmen wirst, und der Beitrag zur AI-Helpdesk-API behandelt die Anbindung auf der Helpdesk-Seite.
3. Ollama, auf deinem eigenen Rechner
Clef läuft lokal mit Ollama 0.35.1 oder neuer. ollama pull clef lädt einen 18-GB-Build mit 256K Kontextfenster herunter, viermal so viel, wie die gehostete Version erlaubt. Du rufst es unter http://localhost:11434/v1/systemone auf. Ein Haken: Entscheidungsmodelle sind noch nicht in der Ollama-CLI oder deren Python- und JavaScript-Bibliotheken enthalten, du rufst also den HTTP-Endpunkt auf oder richtest das Python-SDK von TypeSafe auf deinen lokalen Server.
4. Hugging-Face-Gewichte
Für volle Kontrolle lädst du Cloudflare/clef oder Cloudflare/clef-flash mit snapshot_download und lädst sie mit der mitgelieferten joint_schema_model.py. Cloudflare gibt an, auf einer einzelnen NVIDIA H200 mit torch 2.11 und transformers 5.10.2 getestet zu haben. Achte auf die Standardwerte: encode_record begrenzt die Eingabe auf 16.384 Tokens, solange du max_length nicht erhöhst.
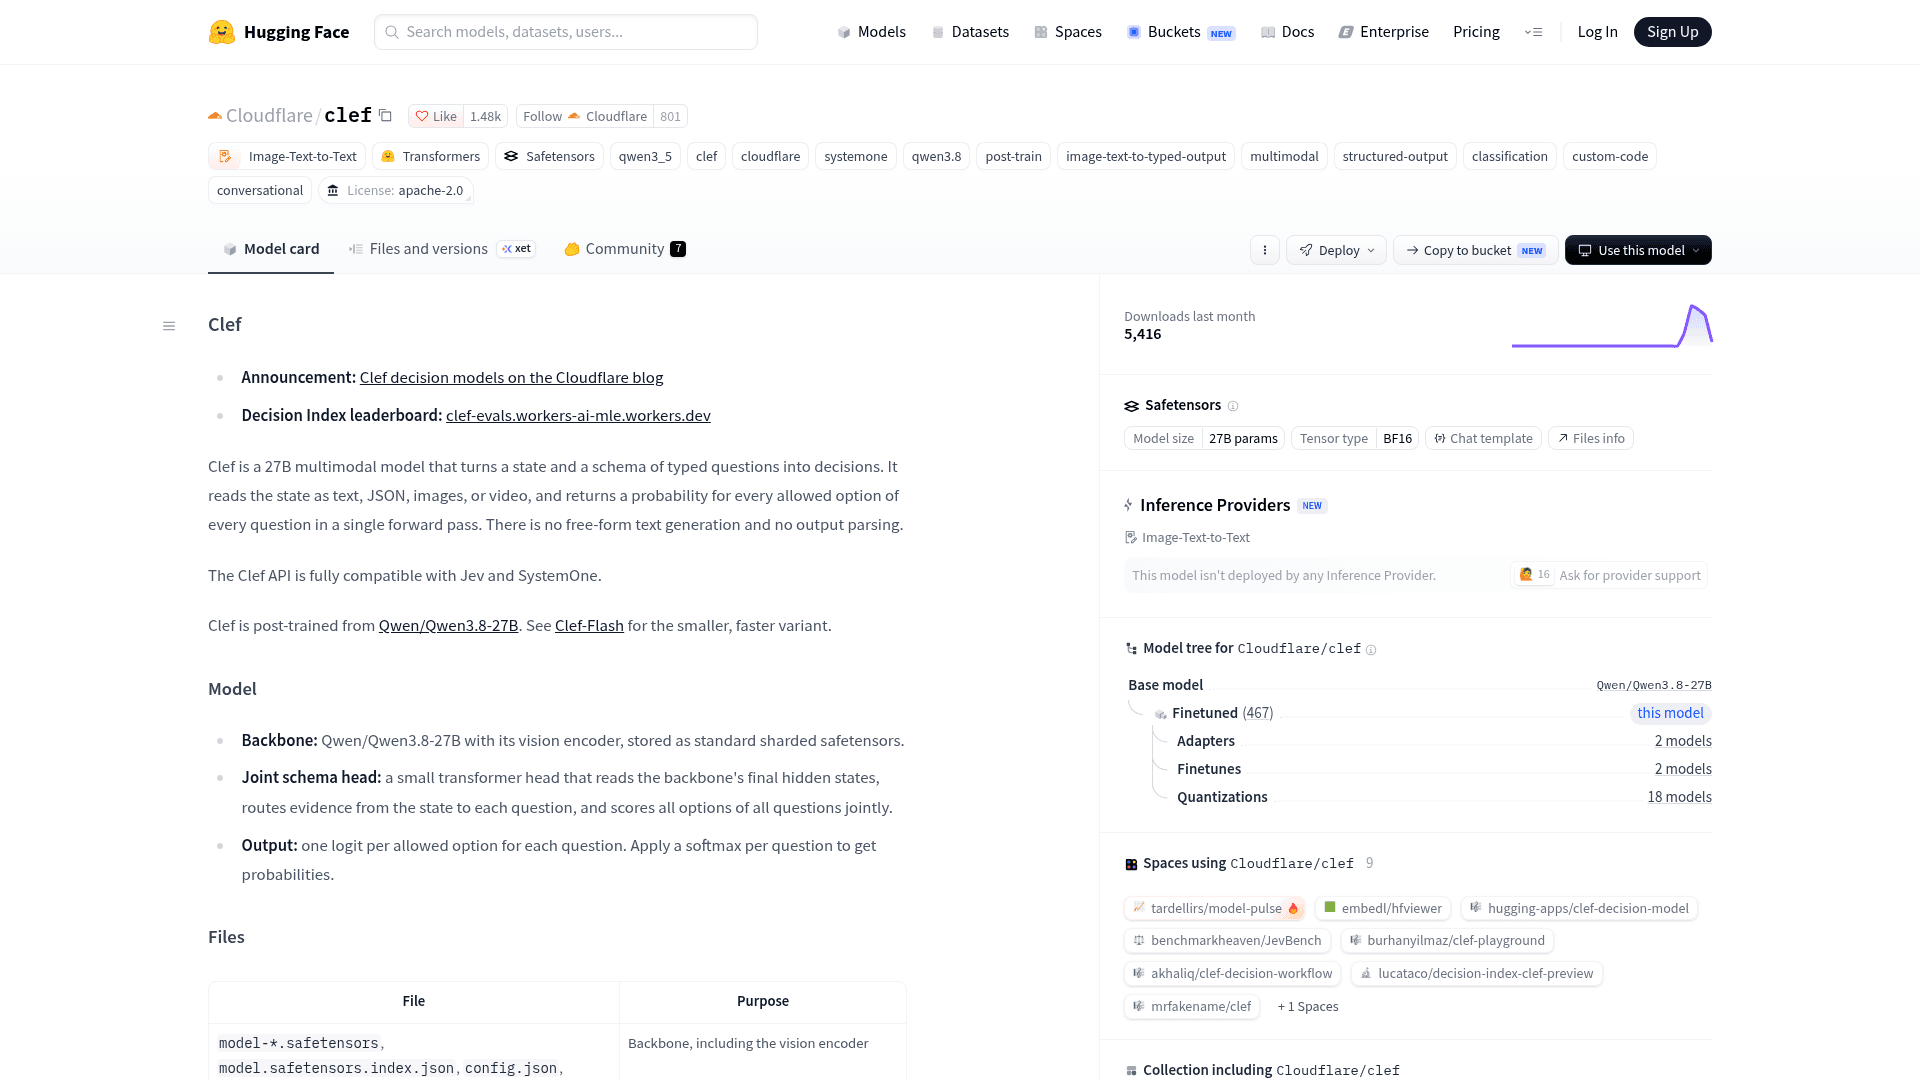
Die Karte zeigte in ihrem ersten Monat 5.416 Downloads und 18 Community-Quantisierungen, als ich nachgesehen habe. Da Clef ein Qwen-Fine-Tune ist, ist der Leitfaden zu den Qwen-Preisen ein nützlicher Kontext, wenn du gehostet gegen selbst betrieben abwägst. Und wenn du von Jev kommst, deckt die Übersicht der Jev-Alternativen die anderen offenen Optionen ab.
Wie schnell und genau ist Clef?
Die Geschwindigkeit ist das Hauptargument. Über 43 Benchmark-Läufe meldet Cloudflare Clef im Median 2,5-mal schneller als Jev und Clef-flash 13-mal schneller:
| Latenz | Clef | Clef-flash | Jev |
|---|---|---|---|
| Median | 209,3 ms | 38,8 ms | 524,1 ms |
| p95 | 238,6 ms | 122,4 ms | 536,0 ms |
Zum Vergleich: Cloudflares eigenes Threat-Intelligence-Team nutzte Clef mit Browser Run, um eine Website in 2,2 Sekunden abzurufen, zu rendern und zu klassifizieren, gegenüber 4,7 Sekunden mit gpt-oss-120b im selben Workflow. Der Jev-Ultrafast-Test geht auf Jevs Seite der Geschwindigkeitsgeschichte ein.
Bei der Genauigkeit ist das Bild auf nützliche Weise gemischt. Clef führt bei den meisten klassifikationsartigen Sets und liegt bei reasoning-lastigen hinter Jev:
| Benchmark | Clef | Clef-flash | Jev |
|---|---|---|---|
| BFCL (Tool-Aufrufe) | 98,47 | 98,76 | 95,75 |
| BANKING77 | 94,20 | 90,93 | 79,74 |
| CLINC150 + OOS | 97,43 | 66,77 | 89,27 |
| When2Call | 72,37 | 65,58 | 80,97 |
| GPQA Diamond | 48,0 | 51,0 | 78,3 |
Cloudflare sagt außerdem, Clef sei „currently the leader“ im Jev Decision Index, dem Community-Leaderboard auf Hugging Face Spaces. Lies das Kleingedruckte zu dieser Aussage. Der Wert von 61,2 (Jev: 57,9, Clef-flash: 57,1) steht auf Cloudflares eigener Kopie des Boards unter clef-evals, wo beide Clef-Einträge als selbst gemeldet und upstream nicht reproduziert markiert sind. Zwei Index-Benchmarks wurden übersprungen, die per Regel 0 Punkte bringen, und die Latenz wurde auf Cloudflares Serving-Stack gemessen, nicht auf der Referenz-GPU.
Erste Praxisberichte sind gemischt, wie man es bei einem eine Woche alten Modell erwartet. Ein Entwickler, der Jev für Chat-Moderation einsetzte, probierte Clef an derselben Stelle aus:
„Clef was 2-3x slower and worse (it caught less hate speech) than Jev. Overall disappointing.“
Ein weiterer Kommentator äußerte die allgemeinere Sorge zu jedem Jev-Herausforderer:
„most of the ones that are supposedly on jev level end up playing a terrible game, showing that they are very narrow.“
Mein Fazit: Die Benchmarks sagen dir, wo du mit dem Testen anfangen solltest, nicht, was du ausliefern sollst. Etikettiere 500 deiner eigenen Tickets, lass sie durch beide Clef-Modelle und Jev laufen und vergleiche. Bei diesen Preisen kostet der ganze Test weniger als ein Kaffee.
Was sind die Grenzen von Clef?
Keine davon ist ein Ausschlusskriterium, aber jede hat schon jemanden erwischt:
- Der gehostete Kontext beträgt 64K. Die Gewichte verkraften 256K auf Ollama, aber Workers AI begrenzt auf 65.536 Tokens, und laut Dokumentation wird langer Text-State „auf das Token-Limit des Modells gekürzt“. Das Kürzen geschieht stillschweigend, fasse lange Threads also vorher zusammen.
- Bilder müssen eingebettet sein. Bis zu 4 PNG-, JPEG- oder WebP-Bilder, je 4 MiB und 16 Megapixel, insgesamt 8 MiB dekodiert, 13 MiB pro Anfrage. Remote-URLs werden nicht akzeptiert.
- Es gibt kein „Ich weiß es nicht“. Jede Frage liefert eine Verteilung über deine Optionen. Wenn du einen Ausweg willst, füge eine explizite Option „other“ hinzu, wie es die Ollama-Beispiele tun.
- Rate Limits sind nicht benannt. Die Seite zu den Workers-AI-Limits führt Clef nicht auf. Die Modellseiten sind mit Text Generation getaggt, was standardmäßig 300 Anfragen pro Minute bedeutet, aber das ist meine Schlussfolgerung, kein angegebenes Limit. Mach einen Lasttest, bevor du es in einen Hot Path einbaust.
- Offene Gewichte, nicht Open Source. Die Lizenz ist Apache 2.0, aber Trainingsdaten und Pipeline sind nicht veröffentlicht, du kannst das Modell also nicht von Grund auf reproduzieren.
- Fine-Tuning ist noch ein Gespräch, kein Produkt. Cloudflares RL-Fine-Tuning beginnt als persönliche Zusammenarbeit mit den Forward-Deployed Engineers über ein Interessenformular. Self-Service ist für später versprochen, ohne Datum oder Preis.
Was kostet Cloudflare Clef?
Die Kurzfassung: nur Input-Tokens. Clef kostet 0,24 $ pro Million Input-Tokens, Clef-flash 0,09 $, und keines nennt einen Output-Preis, weil die Antwort aus einer Handvoll Wahrscheinlichkeiten besteht und nicht aus generiertem Text. Jedes Konto erhält 10.000 kostenlose Neurons pro Tag auf den Workers-AI-Preisen, was etwa 900 kurzen Clef-Entscheidungen oder 2.400 Clef-flash-Entscheidungen täglich entspricht.
Pro Token ist das etwa das 5,7-Fache des Jev-Preises von 0,042 $. Pro Entscheidung ist es immer noch ein Bruchteil eines Cents und weit unter einem Frontier-Modell wie denen in der Aufschlüsselung der GPT-5.6-Preise meiner Kollegin bzw. meines Kollegen. Die vollständigen Rechenbeispiele, die Stolperfallen beim kostenlosen Kontingent und ein Kostenrechner stehen im Leitfaden zu den Cloudflare-Clef-Preisen, ich wiederhole sie hier also nicht.
Wer sollte Cloudflare Clef nutzen?
Clef ist am sinnvollsten, wenn du:
- Ein Engineering-Team bist, das eine eigene Routing-Schicht baut. Wenn du den Code, der Tickets bewegt, ohnehin schreibst, liefert dir Clef-flash typisierte Labels in unter 40 ms für Cent pro tausend Aufrufe.
- Bereits auf Cloudflare bist. Das Workers-Binding hält den Aufruf in dem Netzwerk, für das du ohnehin zahlst, auf einer Rechnung.
- Bilder klassifizierst. Screenshots, Belege und Fotos beschädigter Produkte sind dort, wo Clefs Vision-Encoder das reine Text-Modell Jev schlägt, was für E-Commerce-Ticket-Tagging wichtig ist.
- Datenresidenz-Auflagen hast. Apache-2.0-Gewichte bedeuten, dass du es auf eigener Hardware betreiben und Tickets in deinem Netzwerk halten kannst. Auf der gehosteten Seite sagt Cloudflare, dass es deine Anfragen nicht liest, speichert oder darauf trainiert, es sei denn, du entscheidest dich für Fine-Tuning.
- Aktionen eines KI-Agenten absicherst. Cloudflares eigenes Beispiel ist eine Moderationsprüfung für Tool-Aufrufe, „Could this tool call cause harm?“, die in Dutzenden Millisekunden beantwortet wird, bevor das Tool läuft.
Lass es bleiben, wenn sich deine Kategorien nie ändern (ein kleiner, auf deinen eigenen Daten trainierter Klassifikator ist noch schneller), wenn die Entscheidung echtes Schlussfolgern braucht (nimm ein LLM) oder wenn niemand in deinem Team den Code besitzen will, der auf das Label reagiert. Diese letzte Gruppe ist größer, als man zugibt.
Wie Clef in Support-Ticket-Triage und -Routing passt
Support-Triage ist der erste Anwendungsfall auf Cloudflares Liste: „Decide whether a ticket is urgent and which team owns it, then route it without a human in the loop.“ So sieht diese Pipeline in der Praxis aus und hier endet die Aufgabe des Entscheidungsmodells:
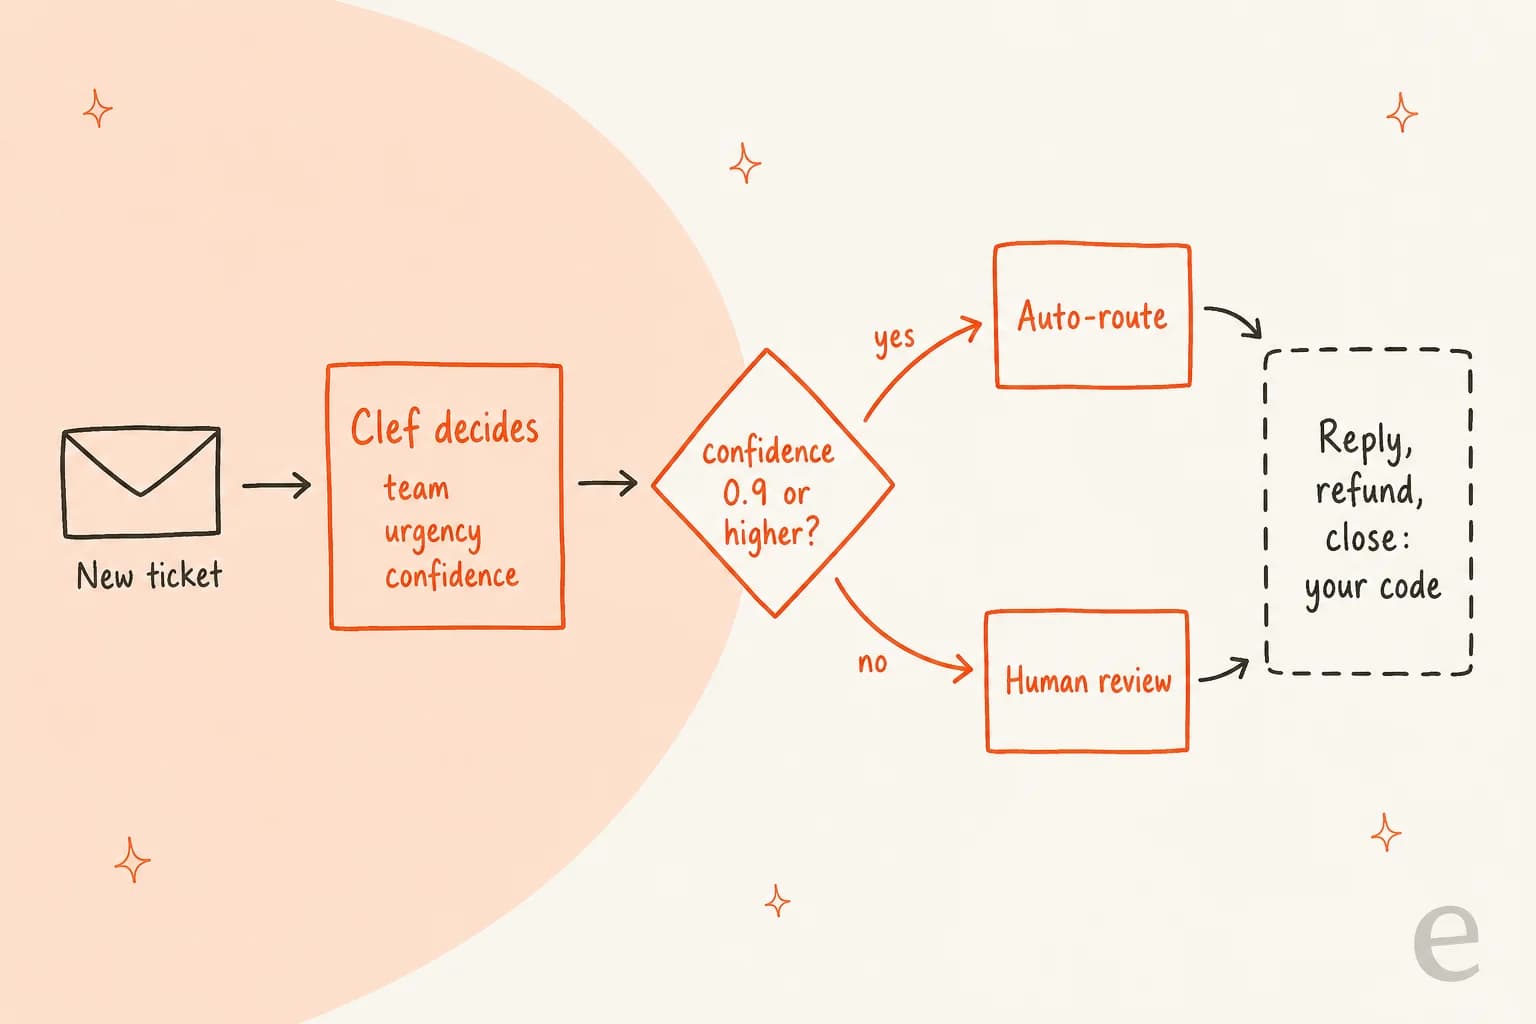
Nimm den IT-Services-Leiter von vorhin. In Clef-Begriffen lässt sich seine Anfrage sauber auf einen Aufruf abbilden: new_user als noul („Wurde dieses Konto in den letzten zwei Monaten angelegt?“, mit dem Kontoalter im state), long_job als noul („Dauert das länger als 20 Minuten?“) und team als choice. Clef kann alle drei in einem Durchgang für einen Bruchteil eines Cents beantworten. Was es nicht kann, ist alles im gestrichelten Kasten: das Ticket in Freshdesk verschieben, das Angebot für kostenpflichtige Services schreiben und den Fall behandeln, dass die Wahrscheinlichkeiten bei 0,55 landen.
In dieser Lücke steckt der Aufwand. In einem Test mit echtem Traffic auf einem E-Commerce-Zendesk-Postfach erreichte der KI-Triage-Schritt 93 % Genauigkeit und erkannte 100 % des Spams, während entworfene Antworten weiterhin eine Fehlerquote von 7 % bei Fakten hatten. Die Klassifikation war der verlässliche Teil. Ein Reddit-Kommentator in einem MSP-Thread nannte dieselbe Sorge von der anderen Seite:
„Classification demos are usually clean, but production tickets often contain missing context, conflicting details and edge cases“

Wenn du es selbst baust, helfen ein paar Gewohnheiten. Halte state kurz (Betreff plus die erste Kundennachricht reichen meist; diese Triage-Prompt-Vorlagen zeigen, wie man einen Thread eindampft). Nimm immer eine Option „other“ auf. Leite alles unter deinem Schwellenwert in eine menschliche Warteschlange statt zum wahrscheinlichsten Team. Und protokolliere jede Entscheidung, damit du sie messen kannst. Der Leitfaden zur Automatisierung der Ticket-Triage enthält die vollständige Bauanleitung.
Jeder dieser Schritte hat seine eigene Tiefe. Die Grundlagen der KI-Ticket-Klassifikation erklären, warum Labels driften, wenn sich dein Produkt ändert. Sobald die Labels gut sind, entscheidet intelligentes Routing, wer was sieht. Und der Stapel mit niedriger Konfidenz braucht einen eigenen Plan, den eine KI-Eskalation übernimmt.
Vielleicht musst du aber gar nichts bauen. Zendesk liefert eine native KI-Triage mit eigenen Intent-Konfidenz-Schwellenwerten zum Abstimmen. Freshdesk hat ebenfalls eine eingebaute Auto-Triage.
Für einen breiteren Vergleich siehe die Übersicht der besten KI für Ticket-Triage. SaaS-Teams mit produktspezifischen Warteschlangen sollten außerdem den Leitfaden zum KI-Ticket-Routing lesen. Welchen Weg du auch nimmst, vergleiche die Baukosten mit dem, was ein KI-Support-Agent kostet, wenn die Antworten dabei sind.
eesel für die Entscheidung und die Arbeit danach
Clef ist Infrastruktur. eesel ist der Mitarbeiter. eesel ist eine KI-Teammate-Plattform, und der Teammate, der hier zählt, ist der KI-Helpdesk-Teammate. Er tritt deiner Zendesk-, Freshdesk-, Gorgias- oder Front-Warteschlange bei, lernt aus deinen früheren Tickets und deinem Help Center und trifft dieselben Entscheidungen wie Clef (ist das dringend, welches Team, kann ich das sicher beantworten) als Teil der Ticketbearbeitung. Dann handelt er: taggt, routet, entwirft, löst oder übergibt. Aktionen, die du als „erst fragen“ markierst, warten in einem Aktivitätsfeed, bis jemand sie freigibt, und bevor etwas davon live geht, würde ich das Setup an deinen historischen Tickets simulieren, so beginnt jeder eesel-Rollout.

Wenn Clef dich reizt, weil es programmierbar ist, ist die eesel-CLI der Teil, den du dir ansehen solltest. Es ist derselbe Teammate wie im Dashboard, gesteuert aus einem Terminal, und jeder Befehl gibt JSON aus, sodass ein Skript oder ein Coding-Agent wie Claude Code, Cursor oder Codex ein komplettes Setup ausführen kann. Ein kurzer Überblick, wie das für die Triage aussieht:
npx @eesel/cli init chat-bubble --site <url>startet einen kostenlosen Workspace ohne Konto (Node 18.17+).eesel integrationsverbindet deinen Helpdesk und listet die Aktionen auf, die der Teammate dort ausführen kann.eesel instructionslegt dauerhafte Regeln in einfacher Sprache fest, etwa „antworte nur, wenn du sicher bist; sonst tagge und weise Tier 2 zu.“eesel automations enable <platform> <key> --instructions "..."richtet Tagging und Routing ein.eesel approvals listundeesel approvals approve <id>geben zurückgehaltene Aktionen per Skript frei, und--dry-runzeigt eine Schreibaktion vorab an.
Änderungen werden in beide Richtungen mit dem Dashboard synchronisiert, und der Workspace funktioniert auch als MCP-Server (eesel mcp token gibt die claude mcp add-Zeile aus). Der Beitrag zur AI-Agent-CLI meiner Kollegin bzw. meines Kollegen geht tiefer.
Die Preiseinheit unterscheidet sich von der von Clef, weil sie etwas anderes kauft. Die eesel-Preise beginnen mit 100 kostenlosen Credits, danach folgen feste Monatspläne ab 299 $ für 500 Credits, wobei ein Credit ein ganzes Ticket oder einen ganzen Chat abdeckt, egal wie viele Aktionen es braucht. Das macht den Vergleich der Kosten von KI und Mensch einfach. Wenn du die Triage-Schicht selbst bauen willst, ist Clef-flash eine großartige Komponente. Wenn du willst, dass Tickets noch diese Woche triagiert und beantwortet werden, probiere eesel an deiner eigenen Warteschlange aus und lies die Entwürfe, bevor du etwas bezahlst.
Häufig gestellte Fragen
Was ist Cloudflare Clef?
Cloudflare Clef ist eine Familie von Entscheidungsmodellen mit offenen Gewichten, die Cloudflare am 1. Oktober 2026 auf Workers AI veröffentlicht hat. Du schickst einen Zustand plus bis zu 64 typisierte Fragen, und es gibt für jede erlaubte Antwort eine Wahrscheinlichkeit zurück statt generierten Text. Meine Erklärung zu Entscheidungsmodellen behandelt die gesamte Kategorie.
Was ist der Unterschied zwischen Clef und Clef-flash?
Clef ist das 27B-Modell auf Basis von Qwen3.8-27B, Clef-flash ist das 9B-Modell auf Basis von Qwen3.5-9B. In Cloudflares Tests antwortet Clef-flash im Median in 38,8 ms gegenüber 209,3 ms bei Clef, während Clef bei langen Intent-Listen wie CLINC150 deutlich besser abschneidet (97,43 vs. 66,77). Für kurze Ticket-Triage-Schemata beginnst du am besten mit Clef-flash.
Ist Cloudflare Clef Open Source?
Die Gewichte beider Modelle sind auf Hugging Face unter der Apache-2.0-Lizenz veröffentlicht, du kannst sie also herunterladen, betreiben und feintunen. Trainingsdaten und Pipeline sind nicht veröffentlicht, daher ist es genauer, Cloudflare Clef als Modell mit offenen Gewichten zu bezeichnen. Wenn du selbst hostbare Optionen vergleichst, schau dir die Übersicht der Jev-Alternativen an.
Wie nutze ich Cloudflare Clef auf Workers AI?
Rufe env.AI.run("@cf/cloudflare/clef", {...}) aus einem Worker mit AI-Binding auf, oder sende einen POST an den REST-Endpunkt /ai/run/@cf/cloudflare/clef mit einem API-Token. Der Body braucht ein model, einen state und eine questions-Map. Teams, die das in einen Helpdesk einbauen, beginnen meist mit den Schritten zur Automatisierung der Ticket-Triage.
Ist Cloudflare Clef besser als Jev?
In Cloudflares eigenem Benchmark-Lauf liegt Clef bei 7 von 10 hervorgehobenen Entscheidungs-Benchmarks vorn sowie beim von Cloudflare selbst gemeldeten Decision Index (61,2 vs. 57,9 bei Jev). Jev gewinnt weiterhin bei anspruchsvolleren Reasoning-Sets wie GPQA Diamond und bei When2Call. Teste beide an deinen eigenen Labels; der Jev-Test behandelt die andere Seite.
Kann ich Cloudflare Clef lokal mit Ollama betreiben?
Ja. Führe ollama pull clef mit Ollama 0.35.1 oder neuer aus und rufe den Endpunkt /v1/systemone auf. Der Clef-Build ist ein 18-GB-Download mit 256K Kontextfenster. Entscheidungsmodelle sind noch nicht in der Ollama-CLI oder den Client-Bibliotheken enthalten, du rufst die API also direkt auf. Open-Modelle über Hugging Face zu betreiben ist die andere Möglichkeit.
Kann Cloudflare Clef Support-Tickets routen?
Ja, Support-Triage ist der erste Anwendungsfall, den Cloudflare nennt: fragen, ob ein Ticket dringend ist und welches Team zuständig ist, und dann anhand der Wahrscheinlichkeiten routen. Clef liefert nur die Entscheidung, dein Code muss also weiterhin danach handeln. Ein KI-Helpdesk-Agent wie eesel trifft die Routing-Entscheidung und entwirft, taggt oder löst dann direkt im Helpdesk.
Was kostet Cloudflare Clef?
Clef kostet 0,24 $ pro Million Input-Tokens und Clef-flash 0,09 $, ein Output-Preis ist nicht angegeben, und jedes Workers-AI-Konto erhält täglich 10.000 kostenlose Neurons. Die vollständige Aufschlüsselung samt Rechner steht im Leitfaden meiner Kollegin und meines Kollegen zu den Cloudflare-Clef-Preisen.