

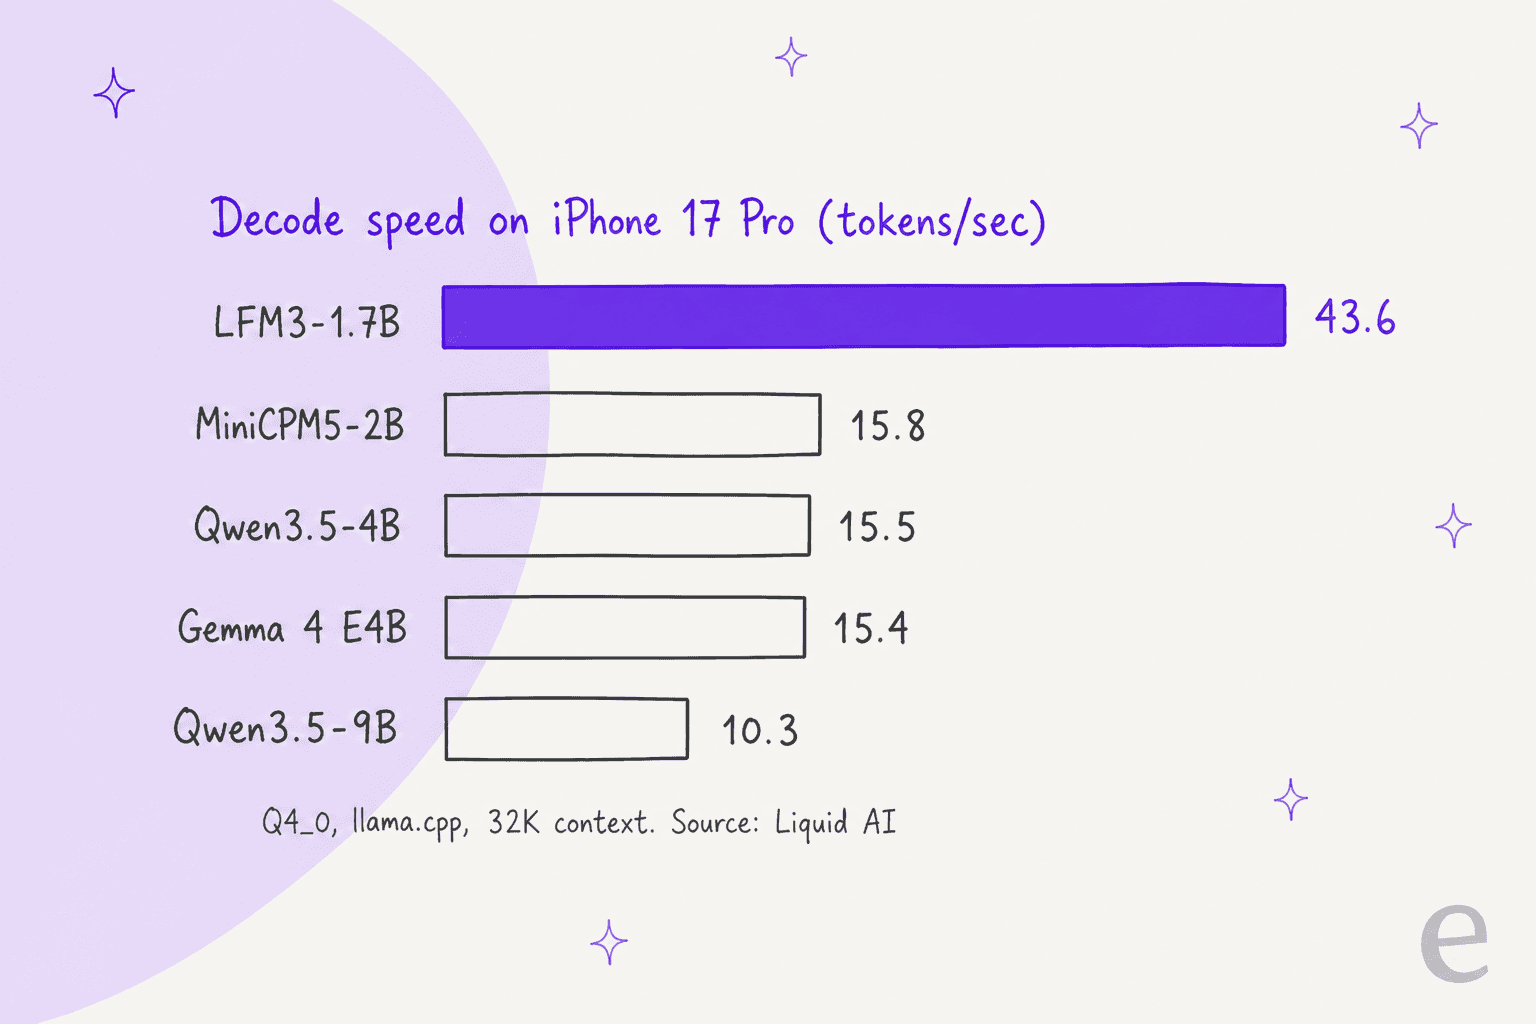
LFM3 ist die neue Familie von Liquid AI mit sechs offenen Modellen mit jeweils etwa 2B Parametern, die am 27. Oktober 2026 veröffentlicht wurde. Das Textmodell LFM3-1.7B erzielt in Liquids Tabelle mit 29 Benchmarks einen Durchschnitt von 49.37 gegenüber 47.24 für Qwen3.5-9B, ein fünfmal so großes Modell. Es ist für lokale Agenten ausgelegt: Auf einem iPhone 17 Pro dekodiert es 43.6 Tokens pro Sekunde bei einem Speicherbedarf von 1.90 GB, etwa 2,8-mal schneller als das nächstschnellste von Liquid getestete Modell.
Die Familie umfasst Text, Bild, Audio, ein „Omni“-Modell, das sieht, hört und spricht, sowie zwei Entscheidungsmodelle (d1-2B und d1-Omni-2B), die Fragen zu einem Ticket oder Dokument in Millisekunden beantworten, statt eine Antwort zu schreiben. Die Gewichte sind auf Hugging Face kostenlos verfügbar, allerdings nur für Unternehmen mit einem Jahresumsatz unter 10 Mio. $, und für LFM3 gibt es noch keinen veröffentlichten API-Preis.
Der Haken: Liquid selbst rät in der Modellkarte davon ab, LFM3-1.7B für agentisches Programmieren oder komplexes mehrstufiges Schlussfolgern einzusetzen, und alle oben genannten Zahlen stammen vom Anbieter. Für Supportteams ist d1-2B besonders interessant: Es kann ein Ticket in einem einzigen Durchlauf weiterleiten und mit Tags versehen. Ein Modell braucht trotzdem einen Helpdesk als Umfeld. Deshalb nutzen Teams wie Dokument 24 einen einsatzbereiten KI-Helpdesk-Teamkollegen, der jedes neue Zendesk-Ticket mit Tags versieht und einen Antwortentwurf erstellt, statt selbst ein Modell einzubinden.
Was ist LFM3?
LFM3 ist die dritte Generation der Liquid Foundation Models von Liquid AI, dem Unternehmen hinter kleinen Modellen, die auf Smartphones, Laptops und in Autos laufen sollen statt in einem Rechenzentrum. Liquid kündigte LFM3 am 27. Oktober 2026 als "every modality for specialized intelligence" an, und die erste Veröffentlichung umfasst Modelle "in the 2B parameter range."
Ich betrachte neue Modelle aus der Suchperspektive (was fragen die Leute tatsächlich dazu?) und habe dabei immer eine Frage aus Entwicklersicht im Hinterkopf: Was wäre nötig, um das hinter einem echten Produkt zu betreiben? Bei LFM3 ist die Antwort interessanter als bei den meisten Veröffentlichungen, denn es handelt sich nicht um ein einzelnes Modell, sondern um eine Familie.
Alle sechs nachtrainierten Modelle gehen auf eine gemeinsame Basis zurück, LFM3-1.7B-Base, die auf 22 Billionen Tokens vortrainiert wurde und ein Kontextfenster von 256K Tokens hat. Statt eines großen allgemeinen Modells empfiehlt Liquid, das kleine Modell auszuwählen, das zur Aufgabe passt, es mit Ihren eigenen Daten feinzutunen und auf dem Gerät auszuführen.
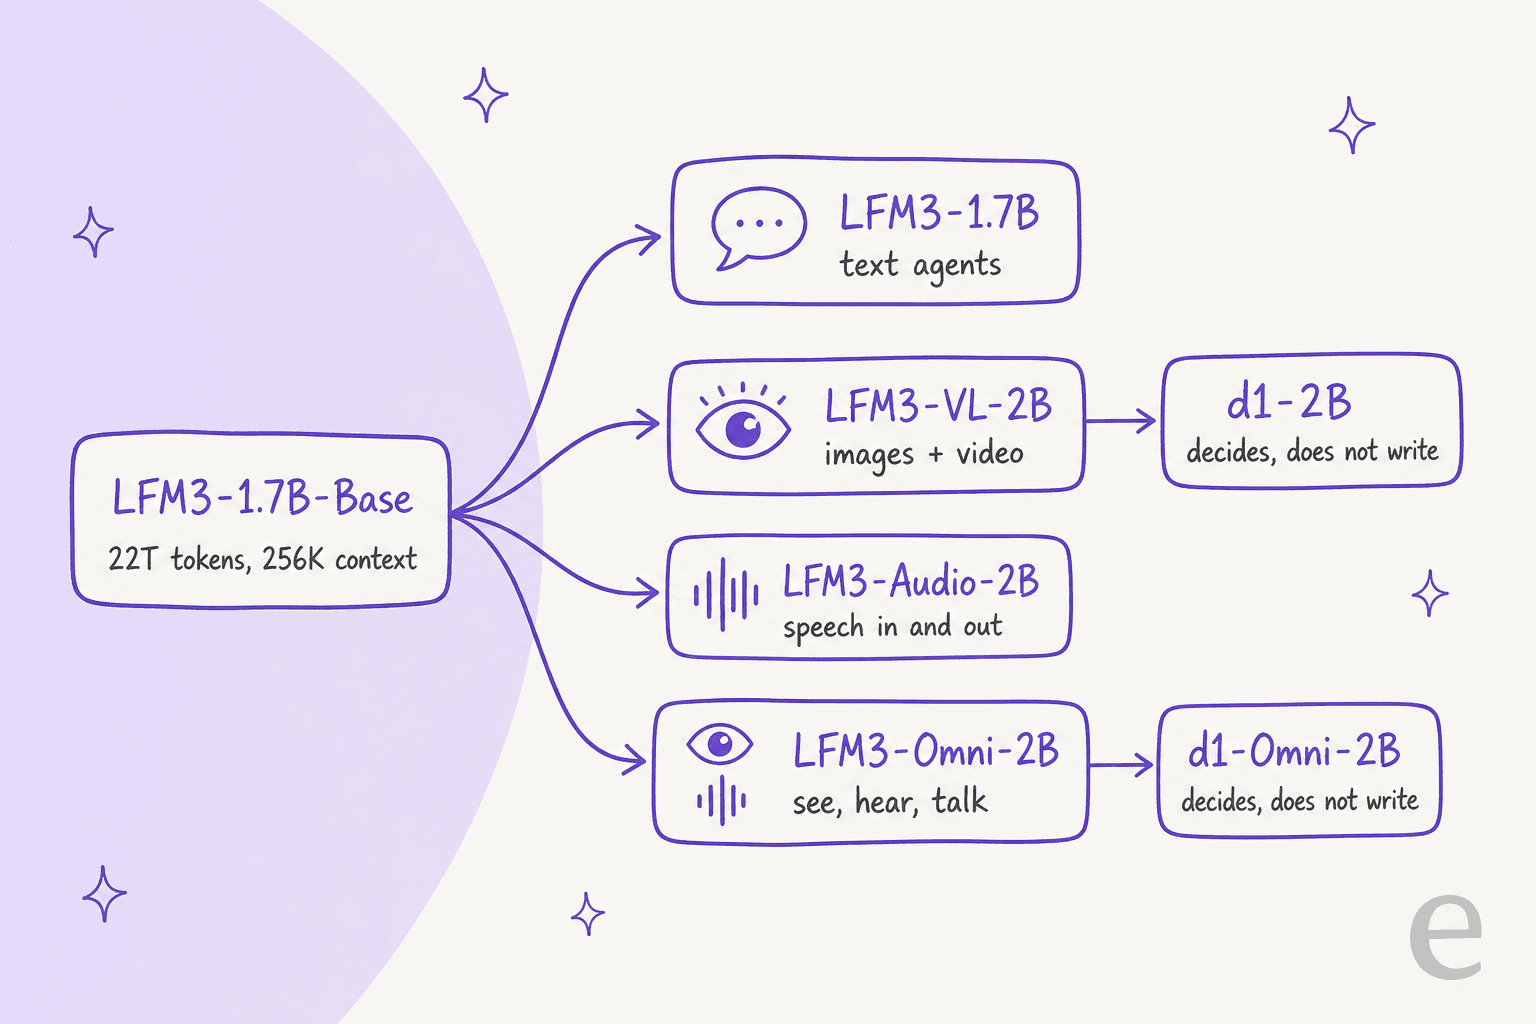
Die LFM3-Modelle auf einen Blick
Hier ist die vollständige erste Veröffentlichung mit den Zahlen aus den jeweiligen Hugging-Face-Modellkarten:
| Modell | Was es leistet | Parameter | Kontext |
|---|---|---|---|
| LFM3-1.7B | Text, Tool-Aufrufe, lokale Agenten | 1.73B | 256K |
| LFM3-VL-2B | Bilder und Videos als Eingabe, Text als Ausgabe, mit schrittweisem Nachdenken | 1.92B | 128K |
| LFM3-Audio-2B | Spracherkennung, Sprachausgabe, Sprachübersetzung | 2B | 32K |
| LFM3-Omni-2B | Text, Bild, Video und Audio als Eingabe; Text und Sprache als Ausgabe | 2.17B | 32K |
| d1-2B | Entscheidungen zu Text und Bildern, kein generierter Text | 1.92B | 128K |
| d1-Omni-2B | Entscheidungen zu Text, Bildern und Audio | 2B | Nicht angegeben |
Das Textmodell versteht laut seiner Modellkarte 16 Sprachen, darunter Englisch, Arabisch, Chinesisch, Japanisch, Hindi und Polnisch. Das ist relevant, wenn Sie mehrsprachigen Support anbieten. Das Omni-Modell spricht in 19 Sprachen und regionalen Varianten.
Was hat sich an der LFM3-Architektur geändert?
LFM2 hat gezeigt, dass eine Mischung aus kurzen Faltungen und Attention auf einem Smartphone schnell laufen kann. LFM3 behält diese Idee bei und ergänzt eine dritte Zutat. Bei seinen 24 Schichten ist vor allem bemerkenswert, dass 13 kurze Faltungen mit Gating sind, während 5 Sliding-Window-Attention mit einem Fenster von 256 Tokens und 6 globale Attention verwenden. Liquid nennt das einen "tri-hybrid."
Bei der Überarbeitung geht es vor allem um lange Kontexte. Laut dem Ankündigungsbeitrag erreicht LFM3-1.7B bei kurzen Prompts auf Edge-Geräten pro Parameter die Leistung von LFM2-1.2B und ist bei 8K Tokens im Kontext etwa 25 % schneller. Liquid fand das Design durch eine Hardware-in-the-Loop-Suche über 14 Kombinationen aus Geräten und Backends, von einem Samsung Galaxy S26 Ultra und einem Raspberry Pi 5 bis hin zu Apple-M4-Max-Laptops und der Qualcomm Hexagon NPU.
Beim Training lag diesmal ein stärkerer Schwerpunkt auf Agentenaufgaben. Die letzten 3.5 Billionen Tokens des Vortrainings bestanden aus kuratierten Daten mit "a larger share of agentic traces and diverse tool calls," und das Textmodell durchlief anschließend vier Nachtrainingsphasen: überwachtes Fine-Tuning auf 1.75 Billionen Tokens, gemischtes Reinforcement Learning, Destillation aus sechs spezialisierten Lehrermodellen und agentisches Reinforcement Learning innerhalb echter Agenten-Laufzeitumgebungen wie OpenClaw und Hermes Agent.
Wie gut schneidet LFM3-1.7B in Benchmarks ab?
In der eigenen Tabelle von Liquid AI schlägt LFM3-1.7B deutlich größere Modelle bei Agentenaufgaben und dem Befolgen von Anweisungen, verliert aber beim Programmieren und bei Wissensaufgaben. Sein Durchschnitt über 29 Benchmarks liegt bei 49.37, gegenüber 47.24 für Qwen3.5-9B, 39.27 für Qwen3.5-4B, 39.19 für MiniCPM5 2B und 31.74 für Gemma 4 E4B.
Hier ist ein Ausschnitt aus den veröffentlichten Ergebnissen:
| Benchmark | LFM3-1.7B | MiniCPM5 2B | Gemma 4 E4B | Qwen3.5-4B | Qwen3.5-9B |
|---|---|---|---|---|---|
| AutomationBench (öffentlich) | 41.29 | 4.71 | 1.92 | 8.67 | 15.10 |
| WebArena-Verified | 38.42 | 9.11 | 17.06 | 21.92 | 28.94 |
| BFCL V4 (Tool-Aufrufe) | 71.39 | 62.65 | 48.25 | 55.12 | 62.83 |
| τ³-bench | 68.01 | 69.44 | 33.53 | 65.98 | 67.11 |
| IFBench | 73.03 | 62.08 | 44.56 | 38.16 | 48.84 |
| SWE-bench Verified (OpenCode) | 43.40 | 34.80 | 0.50 | 41.20 | 51.20 |
| GPQA Diamond | 63.37 | 65.15 | 57.88 | 75.76 | 80.40 |
| RULER 128K | 65.56 | 37.96 | 18.82 | 84.63 | 87.11 |
| Durchschnitt (29 Benchmarks) | 49.37 | 39.19 | 31.74 | 39.27 | 47.24 |
Die Zeile zu τ³-bench würde ich mir zuerst ansehen, wenn Sie im Support arbeiten, denn τ-bench simuliert einen Agenten, der Kunden in Gesprächen über mehrere Runden hinweg mithilfe von Tools und Richtlinien unterstützt. LFM3-1.7B erzielt 68.01, etwa auf dem Niveau der 67.11 von Qwen3.5-9B und knapp hinter den 69.44 von MiniCPM5 2B. Für seine Größe ist das stark und durchaus gut, aber es ist nicht der enorme Vorsprung, den man bei AutomationBench sieht. (Zum Vergleich größerer gehosteter Modelle bei Supportaufgaben pflege ich eine laufend aktualisierte Auswahl des besten KI-Modells für Supporttickets.)
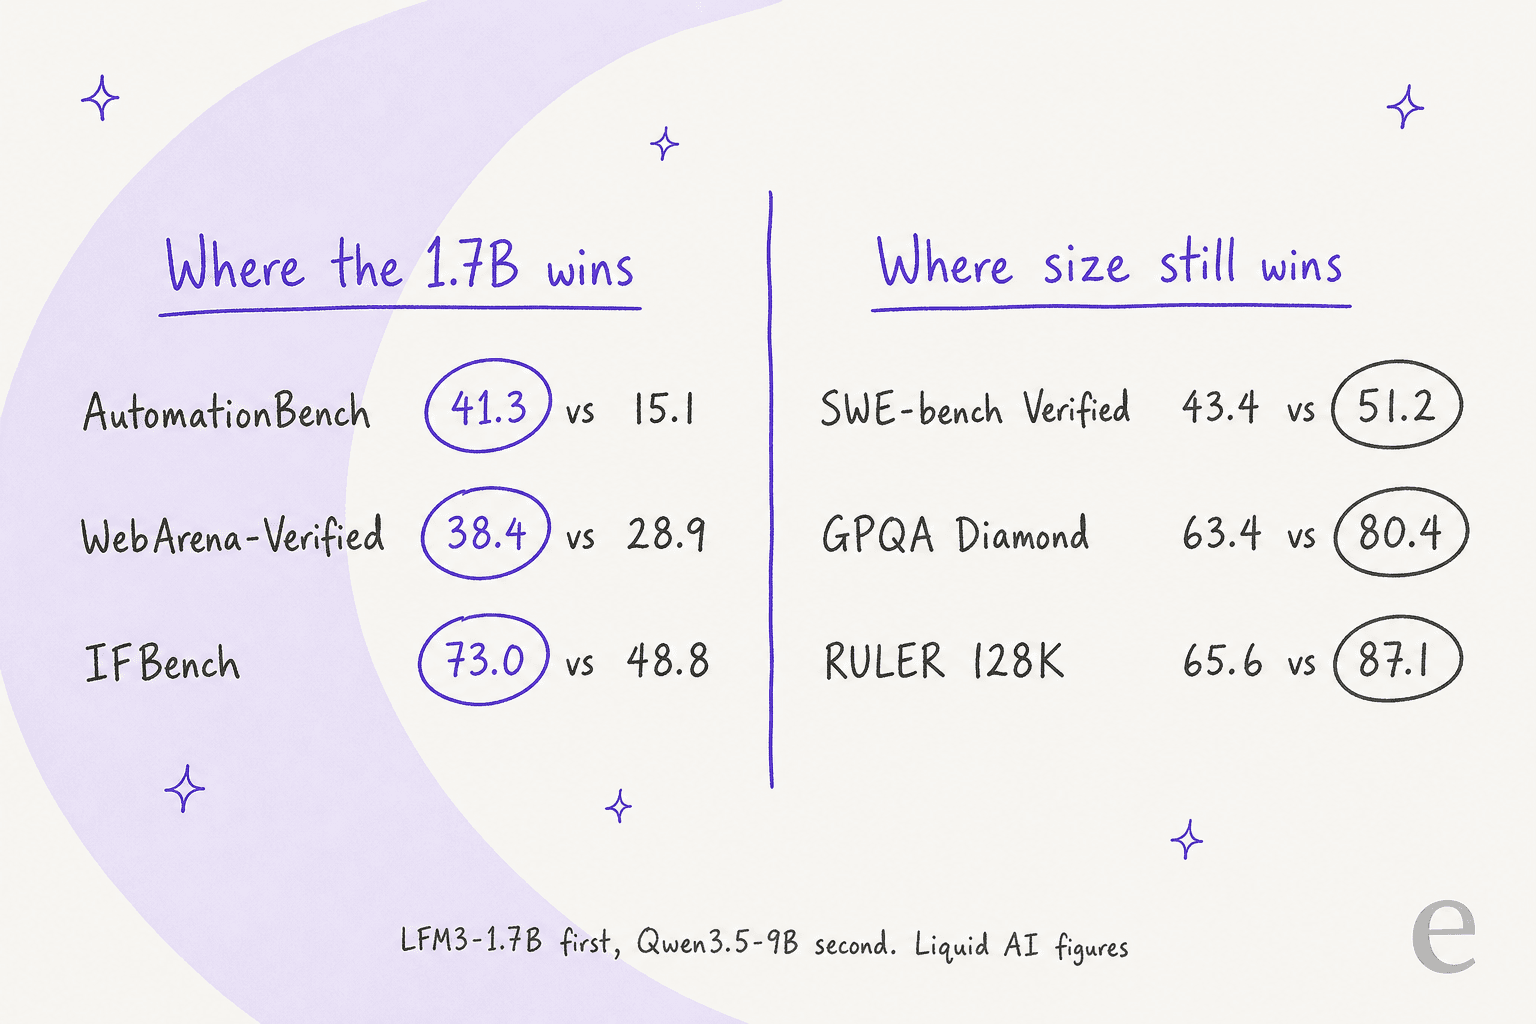
Dieser Unterschied ist der eigentliche Punkt. LFM3-1.7B ist gut darin, Anweisungen zu befolgen und Tools aufzurufen, und schwach dort, wo reines Wissen oder das Abrufen von Informationen aus langen Kontexten über die Punktzahl entscheidet. Liquid sagt im Grunde dasselbe: Suche "helps close the knowledge gap," und verdoppelt den Wert bei Humanity's Last Exam nahezu von 7.17 auf 13.90, wenn Tools erlaubt sind. Ein Leser im Diskussionsthread zur Veröffentlichung fasste die Tabelle so zusammen:
"Agentic coding numbers on par with Qwen3.5-4B, the rest of the numbers on par with Qwen3.5-9B. Most impressive for a 1.7B model!"

Eine weitere wissenswerte Zahl: Bei AA-Omniscience, einem Test, der „Ich weiß es nicht“ gegenüber Raten belohnt, erreichte LFM3-1.7B beim Vermeiden von Halluzinationen 92.93 gegenüber 13.64 für Qwen3.5-4B. Seine Genauigkeit im selben Test lag nur bei 7.07, es erreicht diesen Wert also hauptsächlich, indem es Antworten verweigert. Für ein Modell, das ohnehin eine Suche oder Wissensdatenbank aufrufen soll, ist das der richtige Instinkt. Genau diese Gewohnheit ist auch erwünscht, wenn Sie im Support KI-Halluzinationen verhindern möchten.
Wie schnell ist LFM3 auf einem Smartphone oder Laptop?
Sehr schnell für seine Klasse. Liquid testete mit llama.cpp bei Q4_0 und einem Kontext von 32K Tokens. LFM3-1.7B war auf allen drei Geräten das schnellste Modell, dekodierte 1.8- bis 2,8-mal schneller als das nächstschnellste und benötigte außerdem am wenigsten Speicher.
| Gerät | LFM3-1.7B Dekodierung | Nächstschnellstes Modell | LFM3-1.7B Speicher |
|---|---|---|---|
| iPhone 17 Pro | 43.6 tok/s | 15.8 (MiniCPM5-2B) | 1.90 GB |
| Apple M5 Max | 237.1 tok/s | 106.0 (MiniCPM5-2B) | 2.25 GB |
| AMD Ryzen AI Max+ 395 | 129.6 tok/s | 70.1 (MiniCPM5-2B) | 2.75 GB |
Auch lange Kontexte bleiben sparsam. Ein vollständiger Kontext mit 128K Tokens benötigt 1.6 GB KV-Cache, also den Speicher, den ein Modell zum Vorhalten des bisherigen Gesprächs nutzt, gegenüber 4.3 GB bei Qwen3.5-4B und 5.6 GB bei MiniCPM5-2B. Vergleichen Sie das mit einem dichten mittelgroßen Modell wie Nanbeige 4.3, das bei derselben Länge etwa 28 GB Cache benötigt.
Auf Servern werden die Zahlen fast absurd. Auf einer NVIDIA B300 erzeugte LFM3-1.7B bei 1.024 gleichzeitigen Anfragen 41,710 Ausgabe-Tokens pro Sekunde, was Liquid auf 3,6 Milliarden Tokens pro Tag rundet. Zur Demonstration ließ Liquid mehr als 300.000 LFM3-1.7B-Agenten parallel auf dem Enron-E-Mail-Archiv arbeiten. Auf dem eigenen latenzarmen Serving-Stack blieb die p95-Latenz für eine kurze Anfrage selbst bei 500 Anfragen pro Sekunde auf einer B200 bei 150 ms.
Was können die Bild-, Audio- und Omni-Modelle?
Die anderen Modelle der Familie machen LFM3 für eine Veröffentlichung in der 2B-Klasse ungewöhnlich. Jedes ist klein genug, um auf einem Smartphone zu laufen, und jedes übernimmt eine Aufgabe, die normalerweise ein größeres Cloud-Modell erfordert.
LFM3-VL-2B ist das erste Bildmodell von Liquid, das Videos verarbeitet, und es denkt vor der Antwort Schritt für Schritt nach. Über 62 Bild-Benchmarks erzielt es einen Durchschnitt von 71.4, vor Gemini 3.5 Flash Lite (70.0) und auf dem Niveau von Gemma 4 12B (71.7), einem mehr als sechsmal größeren Modell. Es liegt innerhalb von zwei Punkten hinter GPT-5.6 Luna (73.4). Seine höchsten Werte erreicht es beim Lesen von Dokumenten, OCR und Diagrammen (83.9) sowie beim Verständnis grafischer Benutzeroberflächen (83.1).
LFM3-Audio-2B transkribiert, spricht und übersetzt gesprochene Sprache, mit einem neuen Streaming-Audio-Encoder, der schon mit der Verarbeitung beginnt, während Sie noch sprechen. Laut Liquid kann die Zeit bis zum ersten Token nur 50 ms betragen.
LFM3-Omni-2B ist Liquids erstes Modell, das Sehen, Hören und Sprechen vereint: Sie können eine gesprochene Frage zu einem Bild stellen und eine gesprochene Antwort erhalten oder es zu einem Video mit Ton befragen. Es kann auch eine gesprochene Anfrage zusammen mit dem Bildschirminhalt direkt in einen strukturierten Tool-Aufruf umwandeln. In Liquids Demo bucht es per Sprache einen Flug auf einem Laptop. Wenn Sie Sprachtools für eine Supporthotline abwägen, behandelt meine Übersicht der besten KI-Sprachagenten die gehosteten Optionen, und dieser Leitfaden zu einem KI-Sprachagenten für den Support erklärt die Einrichtung.
Wofür sind die d1-Entscheidungsmodelle gedacht?
Das ist der Teil von LFM3, dem ich die meiste Aufmerksamkeit schenken würde, wenn Sie ein Supportteam leiten. d1-2B und d1-Omni-2B schreiben nichts. Sie geben ihnen eine Eingabe und eine Liste von Fragen, und sie beantworten alle in einem einzigen Vorwärtsdurchlauf, jeweils mit einer kalibrierten Wahrscheinlichkeit. Liquid nennt "a support ticket, an invoice, an app screen, a photo, a voice note" als typische Eingaben.
Die Modellkarte von d1-2B verwendet als Hauptbeispiel ein Supportticket: Einem Kunden wurde der Betrag zweimal abgebucht, und sein Paket ist nie angekommen. In einem Durchlauf wählt das Modell ein Team aus (Abrechnung, Versand oder Technik) und gibt an, ob eine Rückerstattung fällig ist. Außerdem listet es die Themen auf und bewertet die Dringlichkeit. Liquid gibt 5.7 ms pro Entscheidung auf einer H100 an. Genau so sieht Ticket-Triage aus. Deshalb halte ich dieses Modell für das praktischste der Veröffentlichung für Helpdeskteams. Die breitere Kategorie habe ich in meinem Erklärartikel zu Entscheidungsmodellen behandelt.
Neu in dieser Generation sind typisierte Antworten. Neben Ja/Nein, Multiple Choice und Bewertungen können die d1-Modelle:
- Zeigen: einen Rahmen um etwas ziehen, das Sie beschreiben, oder jedes Vorkommen zählen.
- Lesen: Text, Zahlen und Daten mit der exakten Fundstelle aus einem Dokument extrahieren oder „nicht gefunden“ angeben.
- Schätzen: eine Zahl mit einem wahrscheinlichen Bereich angeben.
- Auswählen: jede zutreffende Option auswählen, jeweils mit einer eigenen Wahrscheinlichkeit.
d1-2B ersetzt das ältere d1-3B mit einem Drittel weniger Parametern. In Liquids Test "Typed Decisions (customer service cases)" erreichte d1-Omni-2B 50.5 bei schriftlicher Eingabe und 48.0, wenn dieselben Fragen gesprochen wurden, sowie 83.4 bei DecisionBench, einem Test für geschäftliche Routing- und Triage-Aufgaben. Das sind Liquids eigene Benchmarks. Betrachten Sie sie deshalb als Ausgangspunkt für Ihre eigenen Tests. Wenn Sie zunächst die manuelle Variante derselben Aufgabe möchten, erfahren Sie hier, wie Sie Ticket-Triage mit Regeln automatisieren. Ein Liquid-Ingenieur brachte das Hardwareargument im Diskussionsthread zur Veröffentlichung auf den Punkt:
"If you want to do local classification/image processing, I think the d1-2B is amazing, it can run on 1GB of unified RAM."
Die Modellkarte benennt auch offen die Grenzen: Wissensintensive Fragen liegen größeren Modellen besser, und bei Eingaben jenseits von etwa 64K Tokens werden die Antworten weniger zuverlässig.
Wie viel kostet LFM3?
Die Gewichte sind für die meisten Unternehmen kostenlos, und es gibt noch keinen veröffentlichten API-Preis. Das steht auf Liquids Preisseite und in der Lizenz, Stand 28. Oktober 2026:
| Option | Preis | Hinweise |
|---|---|---|
| Offene Gewichte, Unternehmen mit weniger als 10 Mio. $ Umsatz | Kostenlos | LFM Open License v1.0, basierend auf Apache 2.0 |
| Offene Gewichte, Unternehmen mit 10+ Mio. $ Umsatz | Kostenpflichtige Lizenz, nur auf Anfrage | Liquid-Vertrieb kontaktieren; der Umsatz der gesamten Unternehmensgruppe zählt |
| Forschung und qualifizierte gemeinnützige Organisationen | Kostenlos | Keine Umsatzgrenze |
| Liquid API, LFM3-Modelle | Nicht veröffentlicht | Noch nicht auf der Preisseite aufgeführt |
| Liquid API, d1 | 0,02 $ pro 1M Eingabe-Tokens, 0 $ für die Ausgabe | Älteres d1, nicht das auf LFM3 basierende d1-2B |
| Liquid API, LFM2.5-24B-A2B | 0,05 $ Eingabe / 0,70 $ Ausgabe pro 1M Tokens | Liquids größeres gehostetes Modell |
| Neues Liquid-Console-Konto | 2 $ kostenloses Guthaben | Pro Organisation |
Zwei Details sind wichtiger als die Preise. Erstens gilt die Umsatzschwelle von 10 Mio. $ für Ihre gesamte Unternehmensgruppe, nicht für das Produkt, und die Anzahl der Nutzer spielt keine Rolle. Zweitens enthält die Lizenz kein Copyleft. Sie können eine feingetunte Version also privat halten, solange Sie bei einer Weiterverbreitung eine Namensnennung und eine Kopie der Lizenz beifügen.
OpenRouter wird als Partner ab dem Veröffentlichungstag genannt, doch am 28. Oktober listete seine Liquid-Seite nur ältere Liquid-Modelle und d1.1, noch kein LFM3-Modell. Wenn Sie heute ein gehostetes Modell mit öffentlicher Preisliste möchten, bietet sich zum Vergleich die Preisgestaltung von GPT-6 Luna an. Gemini 3.5 Flash Lite ist die andere günstige Option.
Wie betreiben Sie LFM3?
Sie laden es von Hugging Face herunter und führen es lokal aus oder probieren es zuerst in Liquids Browser-Playground aus. Die LFM3-Sammlung enthält jedes Modell in BF16, GGUF, MLX 4-Bit und ONNX, mit FP8- und NVFP4-Builds für Server.
Der schnellste lokale Weg führt über llama.cpp. Die Dokumentation zu LFM3-1.7B nennt diesen Befehl mit den von Liquid empfohlenen Einstellungen:
llama-cli -hf LiquidAI/LFM3-1.7B-GGUF --temp 0.1 --top-k 50 --repeat-penalty 1.1
Ein paar Dinge, die Sie vor dem Start wissen sollten:
- Sie brauchen einen aktuellen Build. Laut der GGUF-Modellkarte benötigen Sie einen LFM3-kompatiblen llama.cpp-Build. Die Q4_0-Datei ist
1.05 GBgroß, Q8_0 ist1.85 GBgroß. - vLLM und SGLang eignen sich für das Serving. Liquids eigene GPU-Benchmarks verwendeten SGLang 0.5.22 mit LFM3-Unterstützung.
- Das Nachdenken ist standardmäßig aktiviert. Die Chatvorlage öffnet einen
<think>-Block, und die Modellkarte warnt davor, dass das Abschalten zu inkonsistentem Verhalten führen kann. - Tool-Aufrufe haben ein neues Format. LFM3 verwendet ein XML-Format, das eine Obermenge des Formats von Qwen3-Coder ist, nicht das benutzerdefinierte Format von LFM2. Ältere Parser brauchen deshalb ein Update.
- Fine-Tuning ist günstig. Liquid bietet TRL-Notebooks für SFT, DPO und GRPO auf LFM3-1.7B an. In seiner Demo zur Inspektion von Windturbinen wurde LFM3-VL-2B mit etwa 3.000 Fotos in wenigen Stunden auf einer A100 feingetunt. (Bei Supportinhalten ist RAG vs. Fine-Tuning die häufigere Frage.)
Wenn Sie lieber vor dem Herunterladen testen möchten, bietet der Liquid Playground LFM3-1.7B, LFM3-VL-2B, LFM3 Omni 2B und LFM3 Audio 2B in einer Modellauswahl an.
Was sagen die ersten Nutzer über LFM3?
Es ist erst einen Tag alt, daher gibt es nur wenige praktische Erfahrungsberichte, die größtenteils aus dem Diskussionsthread zur Veröffentlichung auf Hacker News stammen. Dieser erreichte 101 Punkte und 36 Kommentare. Die ersten Hinweise liefern einen nützlichen Realitätscheck zur Benchmark-Tabelle.
Ein Leser bemerkte im Playground einen grundlegenden sachlichen Fehler und führte ihn auf die Quantisierung zurück:
"when asked “what does a cow say?”, LFM3-1.7B said that a cow can say “Oink”... I assume this is lower quant problem, though: Q8 versions I’ve played with through llama both give the correct “moo” answer."
Ein anderer stellte fest, dass sich das intensive Training zur Tool-Nutzung dort bemerkbar machte, wo es gar nicht gefragt war, bei einer Wissensfrage ohne System-Prompt:
"I am seeing the following in the reasoning trace: > However, the instructions say I must use available tools when answering questions."
Auch bei den Tools lief am ersten Tag noch nicht alles rund. Ein Leser konnte die MLX-Builds weder in LM Studio noch in zwei anderen MLX-Laufzeitumgebungen laden. Der relevanteste Kommentar für Supportaufgaben kam von jemandem, der die vorherige Generation zur Triage eingehender Nachrichten verwendet:
"The LFM annotations are basically triage... Right now LFM 2.6 gets trustworthy annotations on just over 40% of data points."
Das ist ein realistisches Bild eines kleinen Modells im Produktivbetrieb: Es übernimmt den einfachen ersten Durchlauf, und ein größeres Modell oder ein Mensch erledigt den Rest. Dieselbe Aufteilung würde ich auch für die KI-Ticketklassifizierung verwenden.
Wo liegen die Schwächen von LFM3?
Die ehrlich benannten Grenzen stehen größtenteils in Liquids eigenem Kleingedruckten:
- Nicht für agentisches Programmieren oder anspruchsvolles Schlussfolgern. In der Modellkarte von LFM3-1.7B steht "not recommended for agentic coding or complex multi-step reasoning," und für wissensintensive Aufgaben werden Retrieval oder Suche empfohlen. Die Modellkarte des Bildmodells ergänzt diese Liste um Gespräche über mehrere Runden.
- Alle Zahlen stammen vom Anbieter. Artificial Analysis hatte LFM3 am 28. Oktober noch nicht gelistet, daher gibt es noch keine unabhängige Bewertung.
- Die Lizenz ist nicht Apache 2.0. Sie kommt ihr nahe, aber die Umsatzschwelle von 10 Mio. $ bedeutet, dass größere Unternehmen vor der Auslieferung eine kostenpflichtige Vereinbarung benötigen.
- Kurzer Kontext bei den Sprachmodellen. LFM3-Audio-2B und LFM3-Omni-2B haben Fenster von 32K Tokens, ein Achtel des Textmodells.
- Die Tools müssen noch aufholen. Die Modellkarte des Bildmodells führt die llama.cpp-Unterstützung als in Prüfung auf, ohne Video, und die vLLM-Unterstützung als in Arbeit.
Sollten Sie LFM3 verwenden?
Das hängt davon ab, was Sie entwickeln:
- Assistenten auf dem Gerät und lokale Agenten: Ja, probieren Sie zuerst LFM3-1.7B aus. Kein anderes von Liquid verglichenes Modell läuft so schnell mit so wenig Speicher, und es wurde in echten Agenten-Laufzeitumgebungen trainiert. Es gehört auf jede Liste von Open-Source-KI-Agenten, die Sie testen sollten.
- Klassifizierung, Routing und Extraktion in großem Maßstab: Sehen Sie sich d1-2B an. Ein Durchlauf, viele Fragen, Millisekunden pro Entscheidung und etwa 1 GB RAM. Es passt ideal zu Ticket-Routing und Tagging.
- Sprach- und Kamera-Apps: LFM3-Omni-2B ist eines der seltenen kleinen Modelle, die hören und sprechen. Beachten Sie den Kontext von 32K.
- Programmieragenten: Nein. Liquid sagt das selbst, und Modelle wie Nanbeige 4.3 oder das Nemotron 3.5 Bolt-Duo sind bessere Ausgangspunkte.
- Ein Kundensupport-Agent: LFM3 ist eine leistungsfähige Grundlage für Teile der Aufgabe, insbesondere Triage, aber für sich genommen kein Agent. Im nächsten Abschnitt geht es darum, was fehlt.
Kleine Modelle in einer echten Supportwarteschlange betreiben
Ein Modell wie d1-2B kann Ihnen sagen, dass ein Ticket die Abrechnung betrifft und dringend ist. Um tatsächlich zu helfen, muss aber immer noch etwas in Ihrem Helpdesk sitzen, das Ticket beim Eingang lesen, Informationen in Ihrem Hilfecenter und früheren Tickets nachschlagen, das Tag zurückschreiben, einen Antwortentwurf erstellen und wissen, welche Tickets ein Mensch übernehmen sollte. Dafür wurde der KI-Helpdesk-Teamkollege von eesel entwickelt: einer der einsatzbereiten KI-Teamkollegen, die Sie für eine bestimmte Rolle einstellen, statt ein Modell selbst einzubinden.

Dokument 24, ein dänisches Online-Unternehmen für Rechtsdokumente, ist ein gutes Beispiel für Triage in der Praxis. Zwischen dem 8. August und dem 8. September 2026 bereitete eesel etwa 680 Zendesk-Tickets vor, versah etwa 430 davon mit Produkt-Tags (Testament, Ehevertrag, Vorsorgevollmacht oder Unternehmensgründung) und hinterlegte etwa 670 dänische Antwortentwürfe als interne Notizen, die das Team versenden konnte. Die Antworten basieren auf etwa 2.600 Webseiten und Zendesk-Einträgen. Qontro, ein ERP-Softwareunternehmen in Auckland, lässt für jedes Freshdesk-Ticket einen Entwurf erstellen, aber Ausfälle, Datenverlust, Migrationen und Abrechnungsfragen gehen direkt an einen Menschen. Diese Routing-Regeln sind der Teil, den ein Benchmark nie testet, der aber auch über die tatsächlichen Kosten pro Ticket entscheidet.
Vor dem Livegang testet eesel Ihre Konfiguration anhand Ihrer früheren Tickets, damit Sie die Antworten sehen können, bevor ein Kunde sie sieht. Wie diese Tests funktionieren, habe ich separat beschrieben. Und wenn Sie wie bei einem lokalen Modell gern im Terminal arbeiten, können Sie, ein Skript oder ein Programmieragent wie Claude Code über die eesel CLI Integrationen verbinden, die dauerhaft geltenden Anweisungen des Agenten bearbeiten, seine ausstehenden Aktionen genehmigen oder ablehnen und sein Aktivitätsprotokoll lesen, alles als JSON.
eesel ausprobieren
LFM3 ist eine schnelle, günstige Grundlage für Agenten auf dem Gerät und Entscheidungen in einem einzigen Durchlauf, etwa beim Weiterleiten eines Tickets. Wenn Sie diese Woche Tickets in Ihrer Zendesk-AI- oder Freshdesk-Umgebung mit Tags versehen, weiterleiten und mit Antwortentwürfen vorbereiten möchten, kommt der KI-Helpdesk-Teamkollege von eesel in wenigen Minuten in Ihren Helpdesk, lernt aus Ihren früheren Tickets und Ihrem Hilfecenter und arbeitet innerhalb der Regeln, die Sie festlegen. Der Einstieg ist mit 100 Credits und ohne Kreditkarte kostenlos, sodass Sie ihn vor Ihrer Entscheidung an echten Tickets testen können. Probieren Sie eesel aus.
Häufig gestellte Fragen
Was ist LFM3?
LFM3 ist die dritte Generation der Liquid Foundation Models von Liquid AI, veröffentlicht am 27. Oktober 2026. Die erste Veröffentlichung umfasst sechs Modelle mit offenen Gewichten und jeweils etwa 2B Parametern, die alle auf derselben Basis namens LFM3-1.7B-Base aufbauen: ein Textmodell, ein Bildmodell, ein Audiomodell, ein Omni-Modell und zwei Entscheidungsmodelle. Sie gehören zur selben Gruppe kleiner Sprachmodelle wie MiniCPM5 2B und die kleinen Varianten von Gemma 4.
Ist LFM3 kostenlos nutzbar?
Die Gewichte können Sie kostenlos von Hugging Face unter der LFM Open License v1.0 herunterladen, die auf Apache 2.0 basiert. Die kommerzielle Nutzung ist nur kostenlos, solange Ihre Unternehmensgruppe weniger als 10 $ Millionen Jahresumsatz erzielt; darüber benötigen Sie eine kostenpflichtige Lizenz von Liquid AI. Für Forschung und qualifizierte gemeinnützige Nutzung gibt es keine Umsatzgrenze. Vergleichen Sie das mit vollständig unter Apache 2.0 lizenzierten Modellen wie Nanbeige 4.3.
Wie viel kostet die LFM3-API?
Liquid AI hat noch für kein LFM3-Modell einen Preis pro Token veröffentlicht. Auf der Preisseite stehen nur d1 (0,02 $ pro Million Eingabe-Token, 0 $ für die Ausgabe), d1-ultra (0,042 $ / 0 $) und LFM2.5-24B-A2B (0,05 $ / 0,70 $), und neue Organisationen erhalten 2 $ kostenloses Guthaben. LFM3 ist auch noch nicht auf OpenRouter verfügbar. Zur Einordnung der Preise gehosteter Modelle finden Sie hier die Preise von GPT-6 Luna.
Wie viel Speicher benötigt LFM3-1.7B?
Etwa 1 GB bei 4-Bit. Die Q4_0-GGUF-Datei ist 1.05 GB groß, Q8_0 ist 1.85 GB groß. In den Tests von Liquid AI belegte es auf einem iPhone 17 Pro bei 32K Kontext 1.90 GB, und ein voller 128K-Kontext benötigt 1.6 GB KV-Cache, gegenüber 4.3 GB bei Qwen3.5-4B. Deshalb ist es eines der wenigen kleinen Modelle, die mit langem Kontext auf einem Handy laufen.
Ist LFM3-1.7B besser als Qwen3.5?
In Liquid AIs eigener Tabelle erreicht LFM3-1.7B über 29 Benchmarks hinweg einen Durchschnitt von 49.37, gegenüber 47.24 für Qwen3.5-9B, ein etwa fünfmal größeres Modell. Bei der Automatisierung von Geschäftsprozessen und Browseraufgaben gewinnt es deutlich (AutomationBench 41.29 gegenüber 15.10), bei Programmierung und Wissen verliert es (GPQA Diamond 63.37 gegenüber 80.40). Das sind Herstellerangaben, keine unabhängigen Tests. Die andere Seite finden Sie in der Qwen-Übersicht.
Kann LFM3 zur Triage von Kundensupport-Tickets verwendet werden?
Das Entscheidungsmodell d1-2B eignet sich dafür am besten. Seine Modellkarte zeigt, wie es in einem Durchlauf ein Ticket an die Abrechnung, den Versand oder den technischen Support weiterleitet, Rückerstattungen kennzeichnet und die Dringlichkeit bewertet. Sie müssten es trotzdem noch mit Ihrem Helpdesk verbinden und mit Ihren eigenen Tickets testen. Fertige Optionen finden Sie unter die beste KI für die Triage von Support-Tickets.
Was sind die LFM3 d1-Entscheidungsmodelle?
d1-2B und d1-Omni-2B sind Modelle, die keinen Text schreiben. Sie geben ihnen eine Eingabe, etwa ein Ticket, eine Rechnung, ein Foto oder eine Sprachnotiz, sowie eine Liste von Fragen, und sie beantworten alle in einem einzigen Durchlauf mit einer Wahrscheinlichkeit für jede Antwort. d1-2B verarbeitet Text und Bilder, d1-Omni-2B zusätzlich Audio. Lesen Sie mehr über Entscheidungsmodelle.