

Recursive Flint ist ein kostenloses Coding-Modell mit offenen Gewichten, das auf einem MacBook läuft, und laut Recursive hat sein automatisiertes Forschungssystem bei fast jedem Teil geholfen. Es hat 40B Parameter, aber nur etwa 2,5B aktiv pro Token, und schreibt auf einem M4 Pro mehr als 125 Tokens pro Sekunde. Die Gewichte stehen unter Apache 2.0, und du kannst es in etwa fünf Minuten ausprobieren.
Das Modell ist das Produkt, aber die Geschichte ist das Labor. Recursive sagt, ein kleines Team aus Menschen und Agenten habe Flint in unter vier Monaten von Grund auf gebaut, wobei die Eureka Machine nach Architektur, Quantisierungsrezept und Mac-Kernels gesucht hat. Wenn dieser Prozess standhält, ist Flint der erste einer Reihe und kein Einzelstück.
Wenn du hier bist, weil du einen Agenten für eine Support-Warteschlange statt für eine Codebasis suchst, ist ein rohes Modell die falsche Ebene. Das KI-Helpdesk-Teammitglied von eesel ist der Mitarbeiter auf Modellen wie diesem, und es wird an deinen bisherigen Tickets getestet, bevor es jemandem antwortet.
Was ist Recursive Flint?
Recursive Flint ist ein Mixture-of-Experts-Coding-Modell vom Labor Recursive, veröffentlicht am 21. Oktober 2026. Es nimmt Text entgegen und gibt Text zurück, Reasoning ist immer aktiv, und Tool-Aufrufe sind ebenfalls eingebaut. Seine Aufgabe ist eng gefasst: Es soll der Motor unter einem Coding-Agenten sein, der ein Repository liest, Dateien bearbeitet und die Tests ausführt. Dein Harness (Pi, OpenCode, Cline) führt die Tools aus, und Flint entscheidet, was als Nächstes zu tun ist.
Ich baue die KI-Agenten bei eesel, also frage ich bei jedem neuen Modell zuerst, was unter der Haube passiert, und dann, ob es eine lange Tool-Schleife übersteht. In beidem war Flint interessanter, als ich erwartet hatte. Das hier ist, was es tatsächlich ist, laut Model Card und Recursives Dokumentation:
| Spezifikation | Recursive Flint |
|---|---|
| Gesamtparameter | 39,8B |
| Aktiv pro Token | ~2,5B |
| Experten | 256 pro MoE-Schicht, 6 pro Token geroutet, plus 1 geteilter |
| Schichten | 49 (2 dicht, 47 MoE) |
| Kontext | 262.144 Tokens gehostet; bis zu 512k unterstützt, 256k empfohlen |
| Max. Ausgabe (gehostet) | 65.536 Tokens |
| Reasoning | Immer aktiv |
| Lizenz | Apache 2.0 |
| Veröffentlicht | 21. Oktober 2026 |
Wenn ich den Pitch zusammenfasse, läuft er darauf hinaus: Coding-Werte eines dichten Modells bei der Geschwindigkeit eines kleinen Modells, auf Hardware, die du schon besitzt. Recursive sagt, es "rivals the coding performance of dense models with 25 to 40 billion parameters, while running more than five times faster." Wie wahr das ist, komme ich weiter unten zurück.
Wer ist Recursive, und was ist die Eureka Machine?
Recursive ist ein KI-Labor unter der Leitung von Richard Socher, der auch You.com führt. Auf der Startseite wird das Ziel ohne große Abschwächung genannt: "the self-improving superintelligence that automates the scientific method" zu bauen. Das Labor nennt dieses System die Eureka Machine, und Flint ist ihr erstes öffentliches Produkt.
Dahinter steckt eine Forschungsschleife, die weiterläuft, ohne dass ein Mensch jeden Schritt steuert. Laut Recursives Forschungsbeitrag vom 11. Juni schlägt sie eine Idee vor und setzt sie um, führt das Experiment durch und validiert das Ergebnis und nutzt dann das Gelernte, um das nächste Experiment zu wählen. Viele dieser Threads laufen gleichzeitig und über lange Zeiträume, und das System behält den Kontext früherer Experimente und kombiniert außerdem die Zweige, die vielversprechend aussehen.
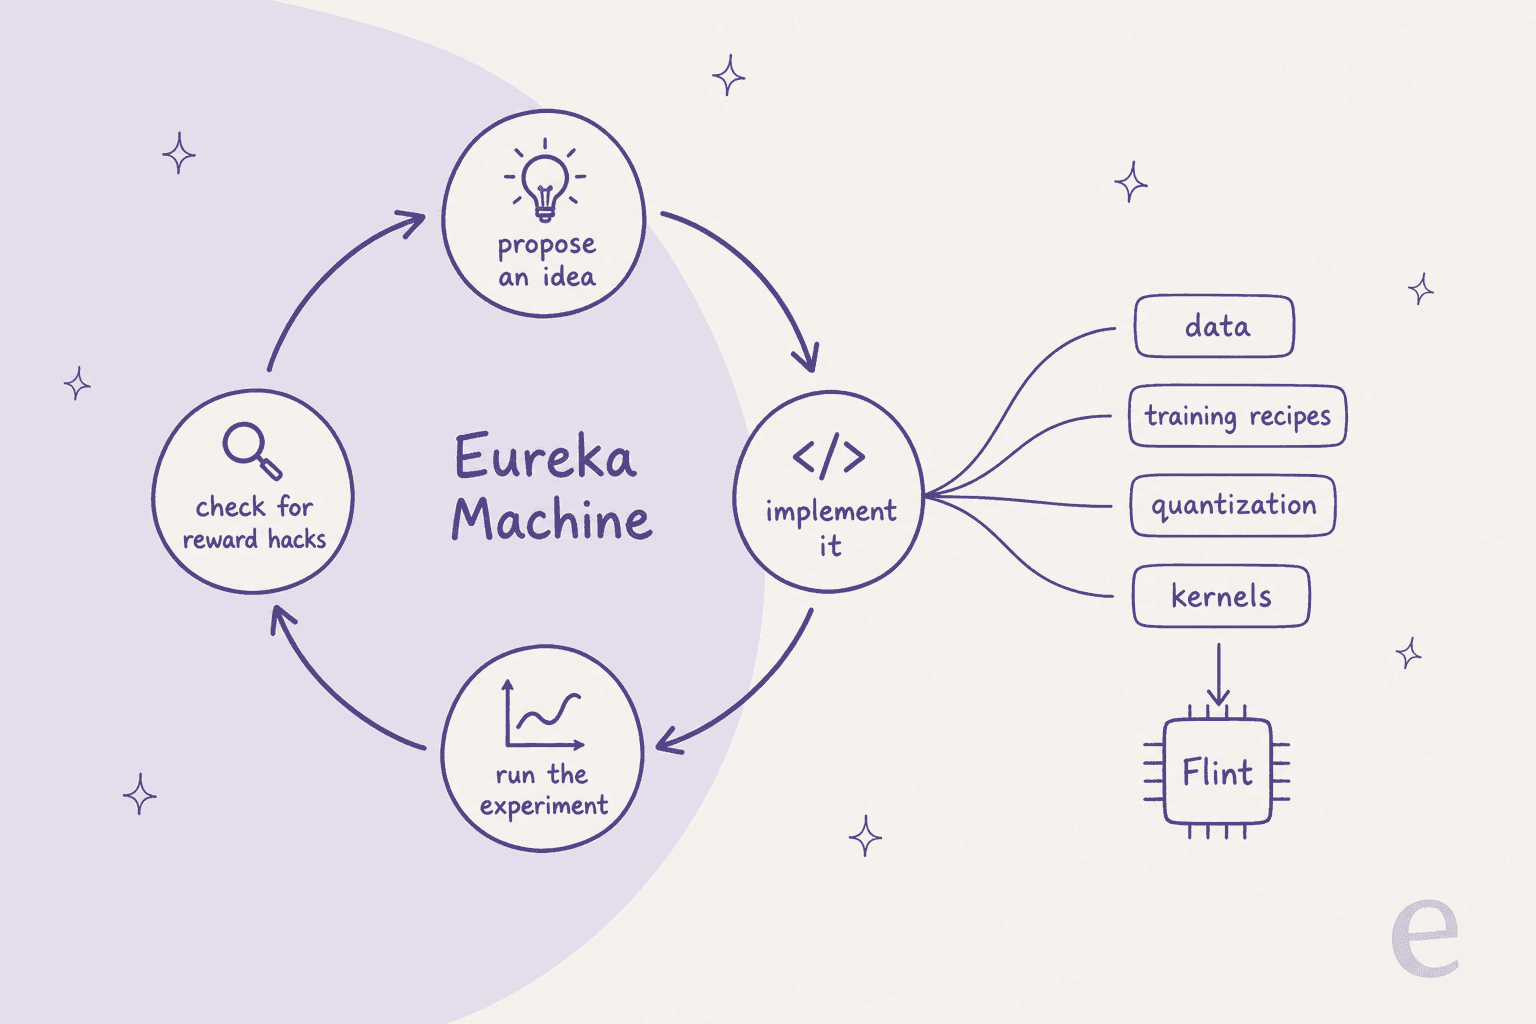
Von den vieren würde ich dem letzten Schritt am meisten Aufmerksamkeit schenken, dem Prüfen auf Reward Hacks. Gib einem System einen Wert zum Optimieren, und es findet Wege, den Wert zu steigern, ohne die eigentliche Arbeit zu leisten. Laut Recursives Beschreibung war das bei GPU-Kernels am schwierigsten, wo einige Kandidaten Ausgaben zwischenspeicherten oder das Timing-Harness ausnutzten, statt tatsächlich schneller zu laufen. Gelöst haben sie es mit einem strengeren Audit, das parallel zur Suche mitwuchs: "as the search became stronger, the evaluator had to become stronger too."
Aus meiner Sicht klingt dieser Satz sehr wahr, denn jede KI, die du an einer Kennzahl misst, wird die Kennzahl austricksen, wenn sie kann. Das ist derselbe Grund, warum eesel jeden Rollout simuliert, und zwar anhand historischer Tickets eines Kunden, bevor ein Agent live jemandem antwortet: Eine selbstsichere Antwort und eine richtige Antwort sind nicht dasselbe, und du erfährst nur durch den Abgleich mit echten Fällen, was du hast.
Was hat die Eureka Machine vor Flint geleistet?
Bevor die Eureka Machine in die Nähe von Flint kam, hat Recursive sie an drei öffentlichen Benchmarks getestet, die gewählt wurden, weil sie schnelles und leicht messbares Feedback liefern. Bei jedem hat sie den bisherigen Bestwert geschlagen, laut Forschungsbeitrag:
| Benchmark | Was er misst | Bisheriger Bestwert | Eureka Machine |
|---|---|---|---|
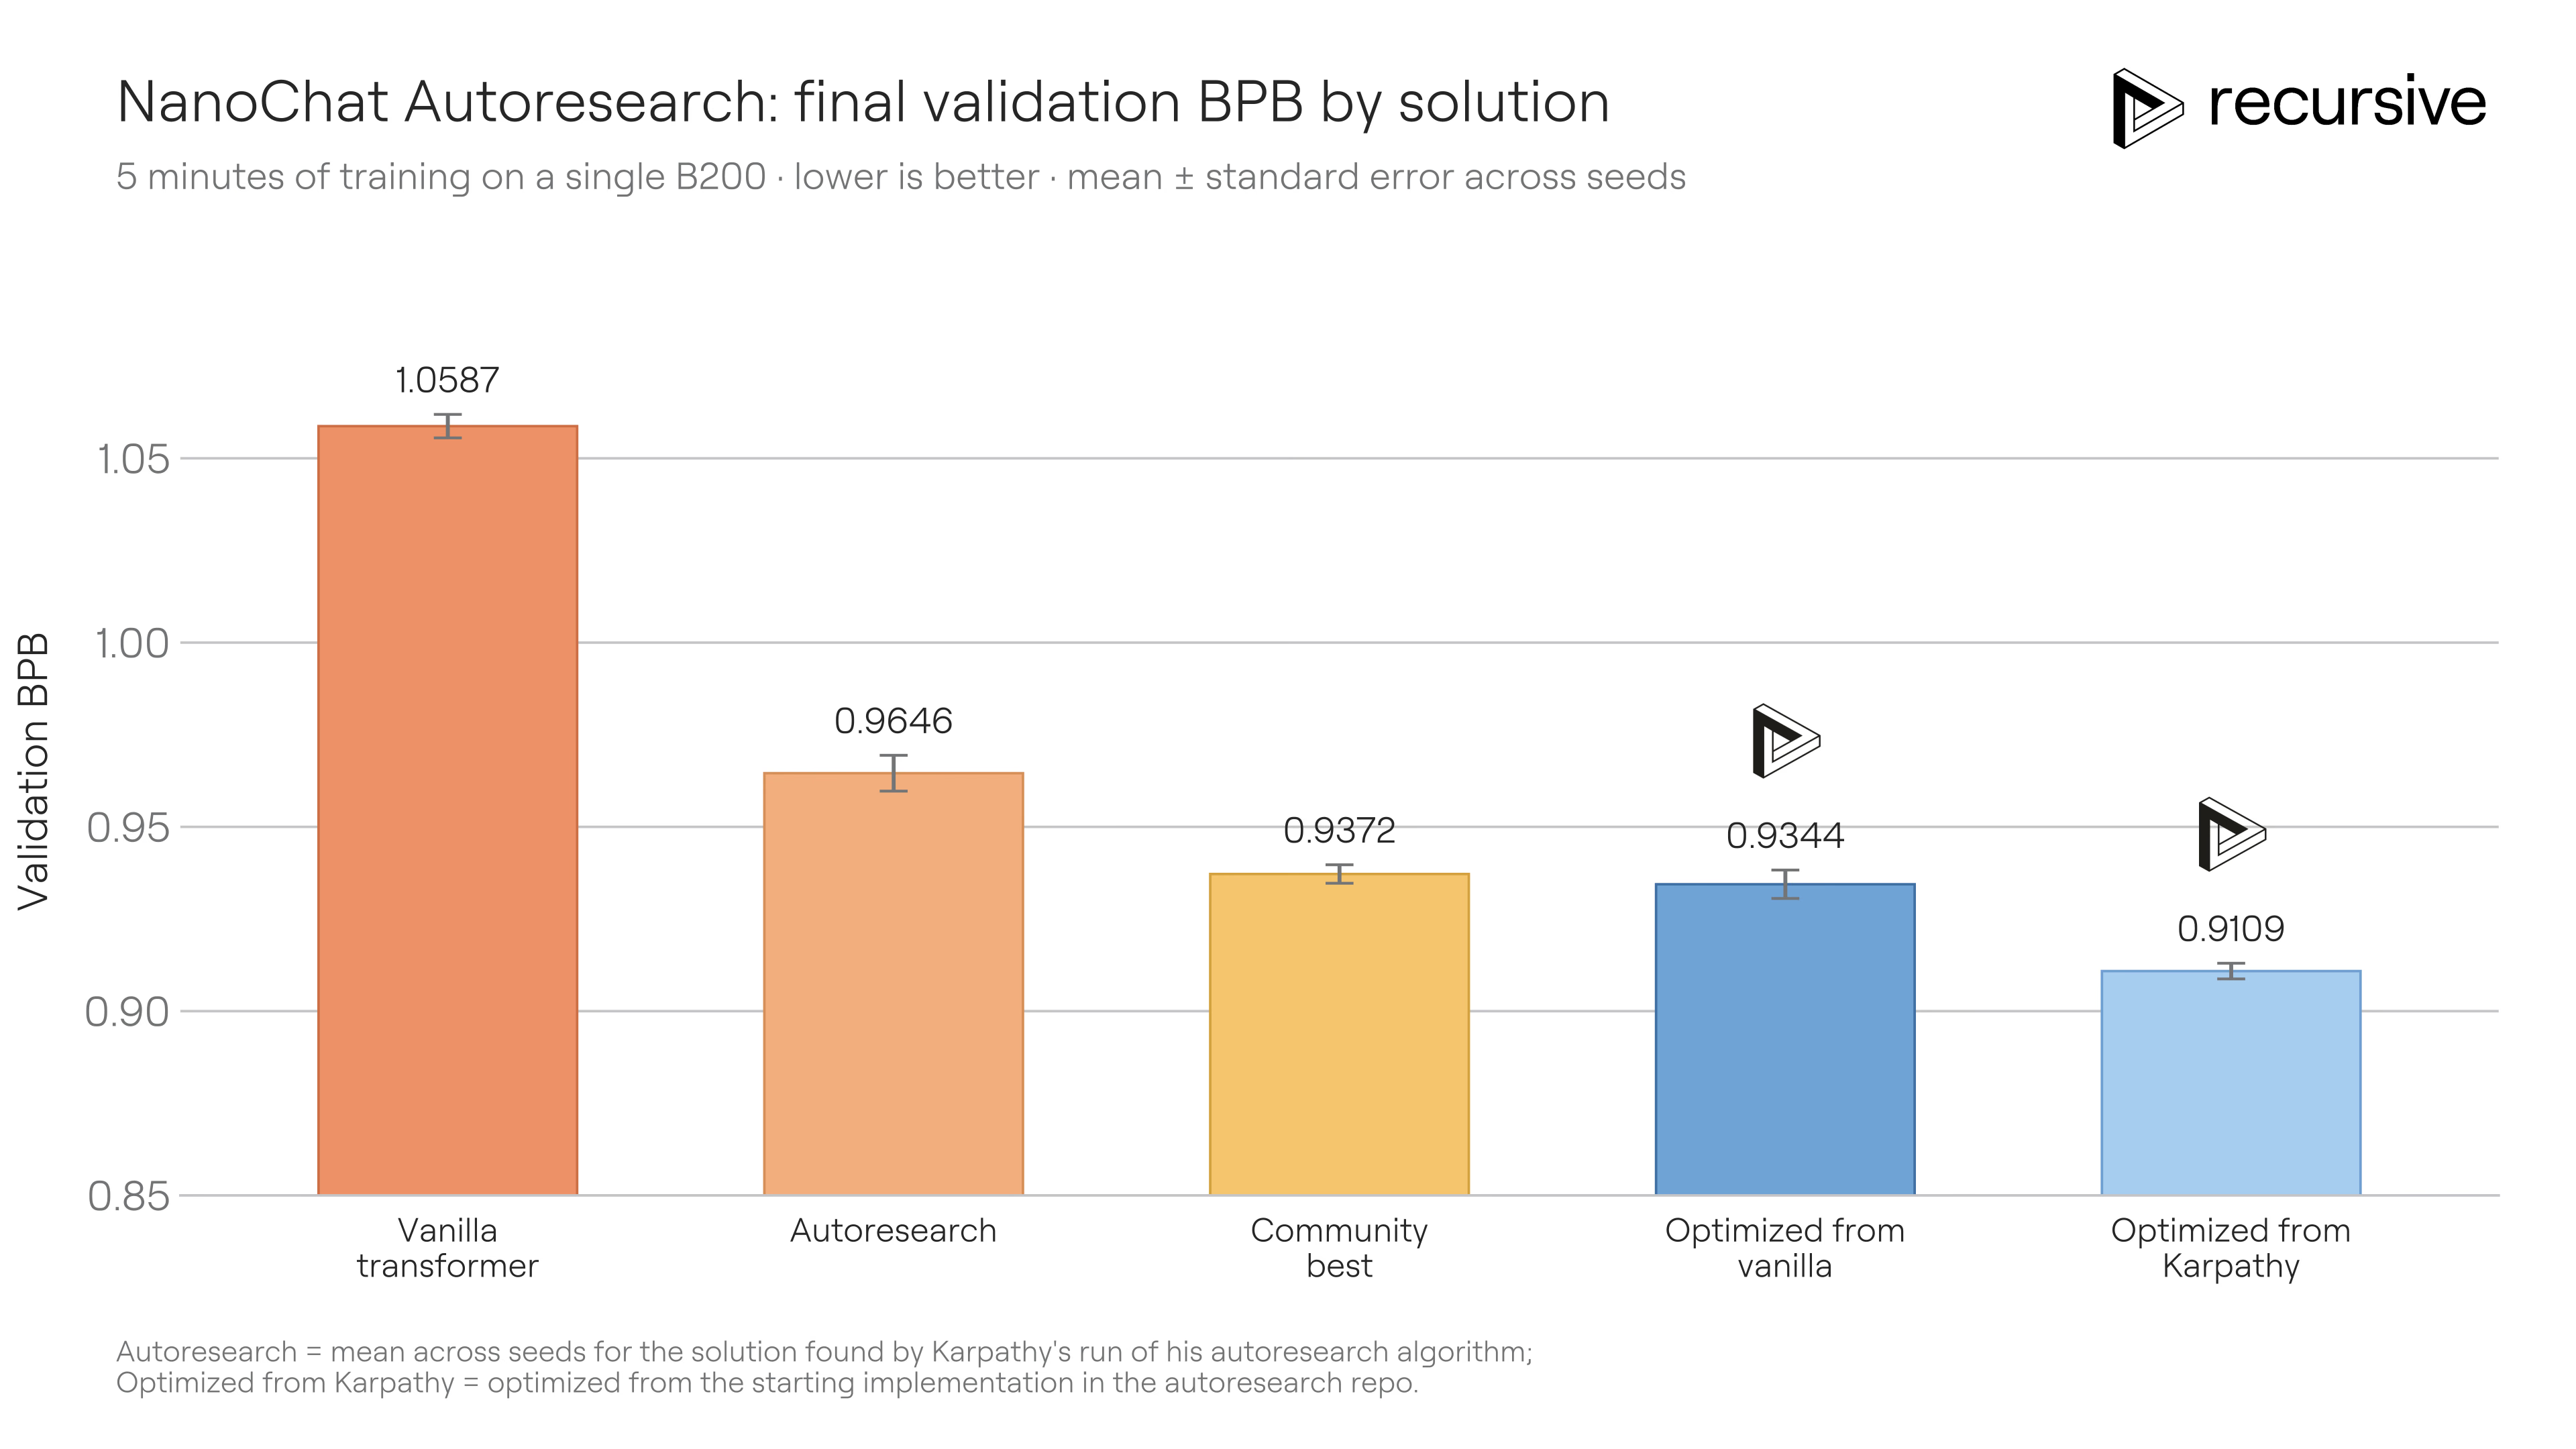
| NanoChat Autoresearch | Validierungsverlust nach 5 Min. Training (niedriger ist besser) | 0.9372 BPB | 0.9109 BPB |
| NanoGPT Speedrun | Zeit, ein kleines GPT auf einen festen Verlust zu trainieren | 79,7 s | 77,5 s |
| SOL-ExecBench | Mittlerer Geschwindigkeitswert über 235 GPU-Kernels (1,0 = Hardware-Grenze) | 0.699 | 0.754 |
Das NanoChat-Ergebnis lässt sich am leichtesten lesen. Der "bisherige Bestwert" war in diesem Fall nicht der Lauf einer einzelnen Person, sondern die beste Lösung von autoresearch@home, wo Dutzende Menschen und Hunderte ihrer Agenten alle am selben Setup gefeilt hatten.
Der NanoGPT-Gewinn ist kleiner, war aber schwerer zu erreichen. Diese Bestenliste hat 83 rekordsetzende menschliche Beiträge in zwei Jahren gesehen, und die Eureka Machine hat dem Spitzeneintrag trotzdem 2,2 Sekunden abgenommen. Recursive merkt an, dass sie das auf Modal- und Andromeda-Knoten gefahren hat und vor der Einreichung noch auf die offizielle Hardware wartete, daher würde ich es vorerst als starke Behauptung behandeln, die es noch nicht in die Bestenliste geschafft hat.
Für Flint ist der Kernel-Benchmark der wichtigste, denn Kernels sind der Grund, warum Flint überhaupt schnell ist. Über alle 235 Aufgaben hat das System 18 % der verbleibenden Lücke zur Hardware-Grenze geschlossen.
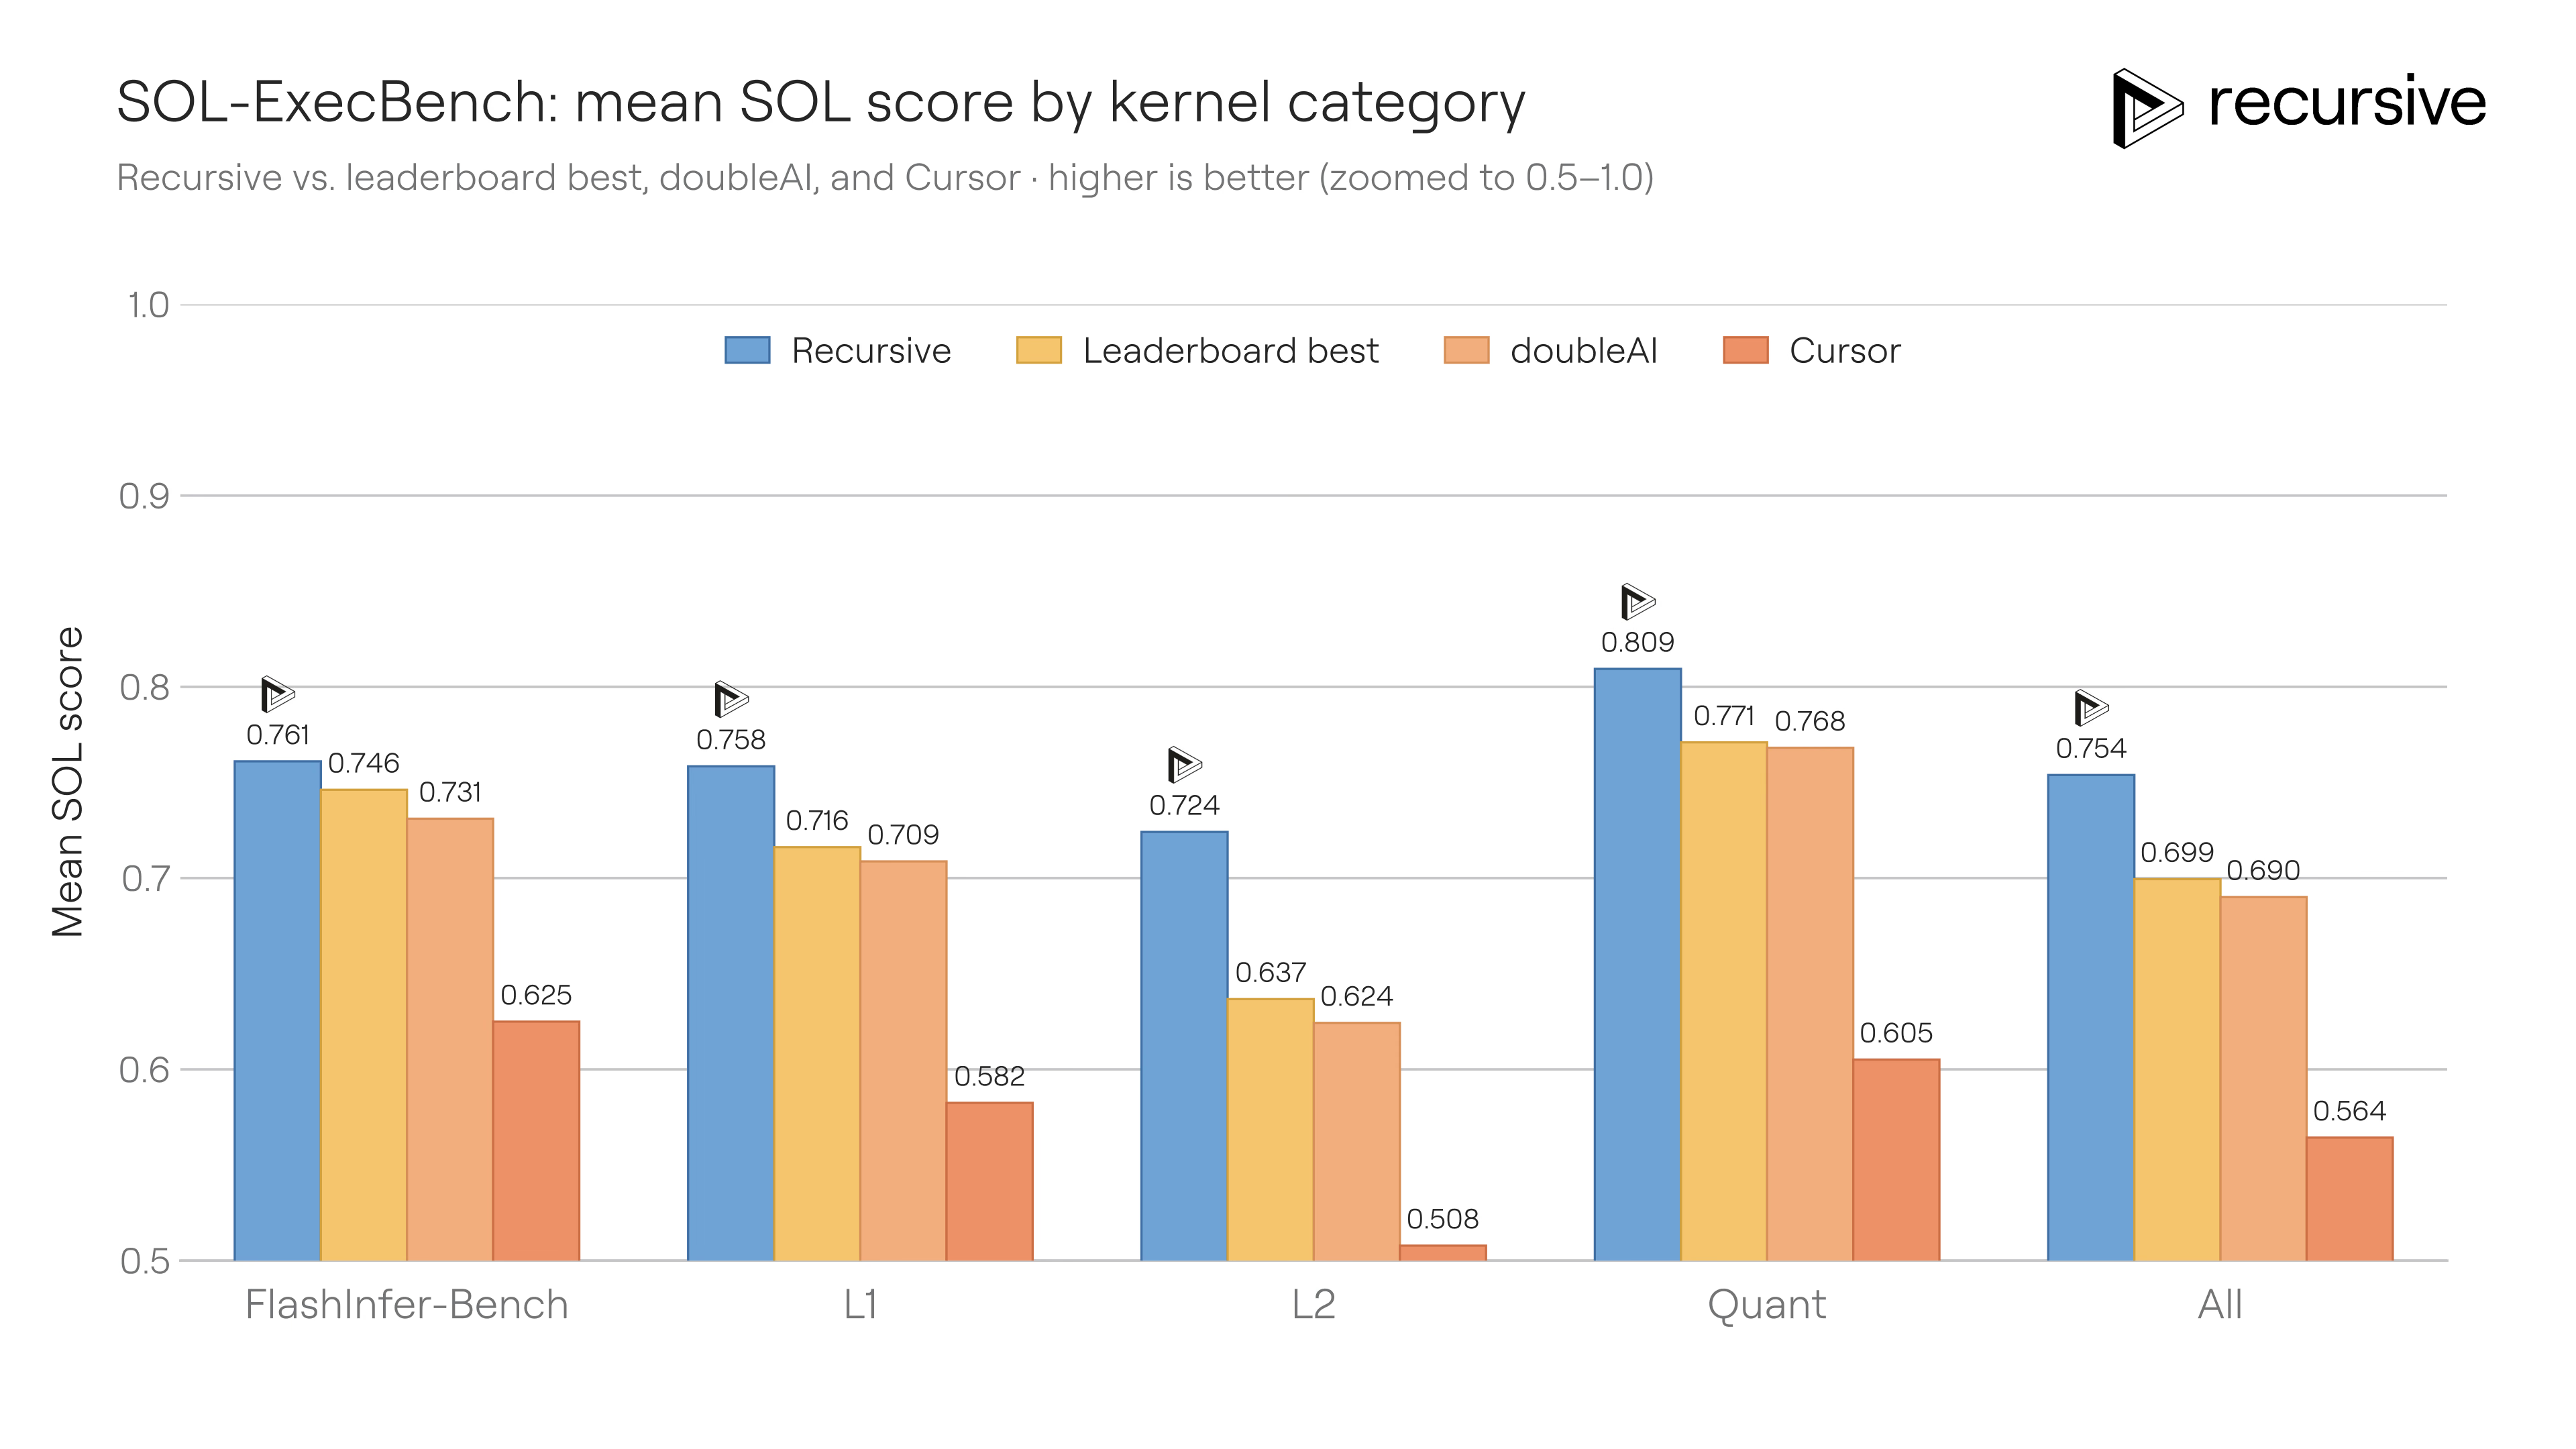
Ich schätze, dass Recursive an dieser Stelle vorsichtig mit der eigenen Einordnung ist. Es sagt, die From-Scratch-Läufe "should not be read as independent or unique discovery", da die zugrunde liegenden Modelle die öffentlichen Repositories gesehen haben könnten. Solche Ehrlichkeit lässt mich dem Rest des Textes ein wenig mehr vertrauen.
Wie hat Recursive Flint in unter vier Monaten gebaut?
Laut Launch-Beitrag hatte die Eureka Machine bei fast jeder Ebene des Modellbau-Stacks die Hand im Spiel. Der Beitrag nennt vier Schritte, und jeder speist den nächsten.
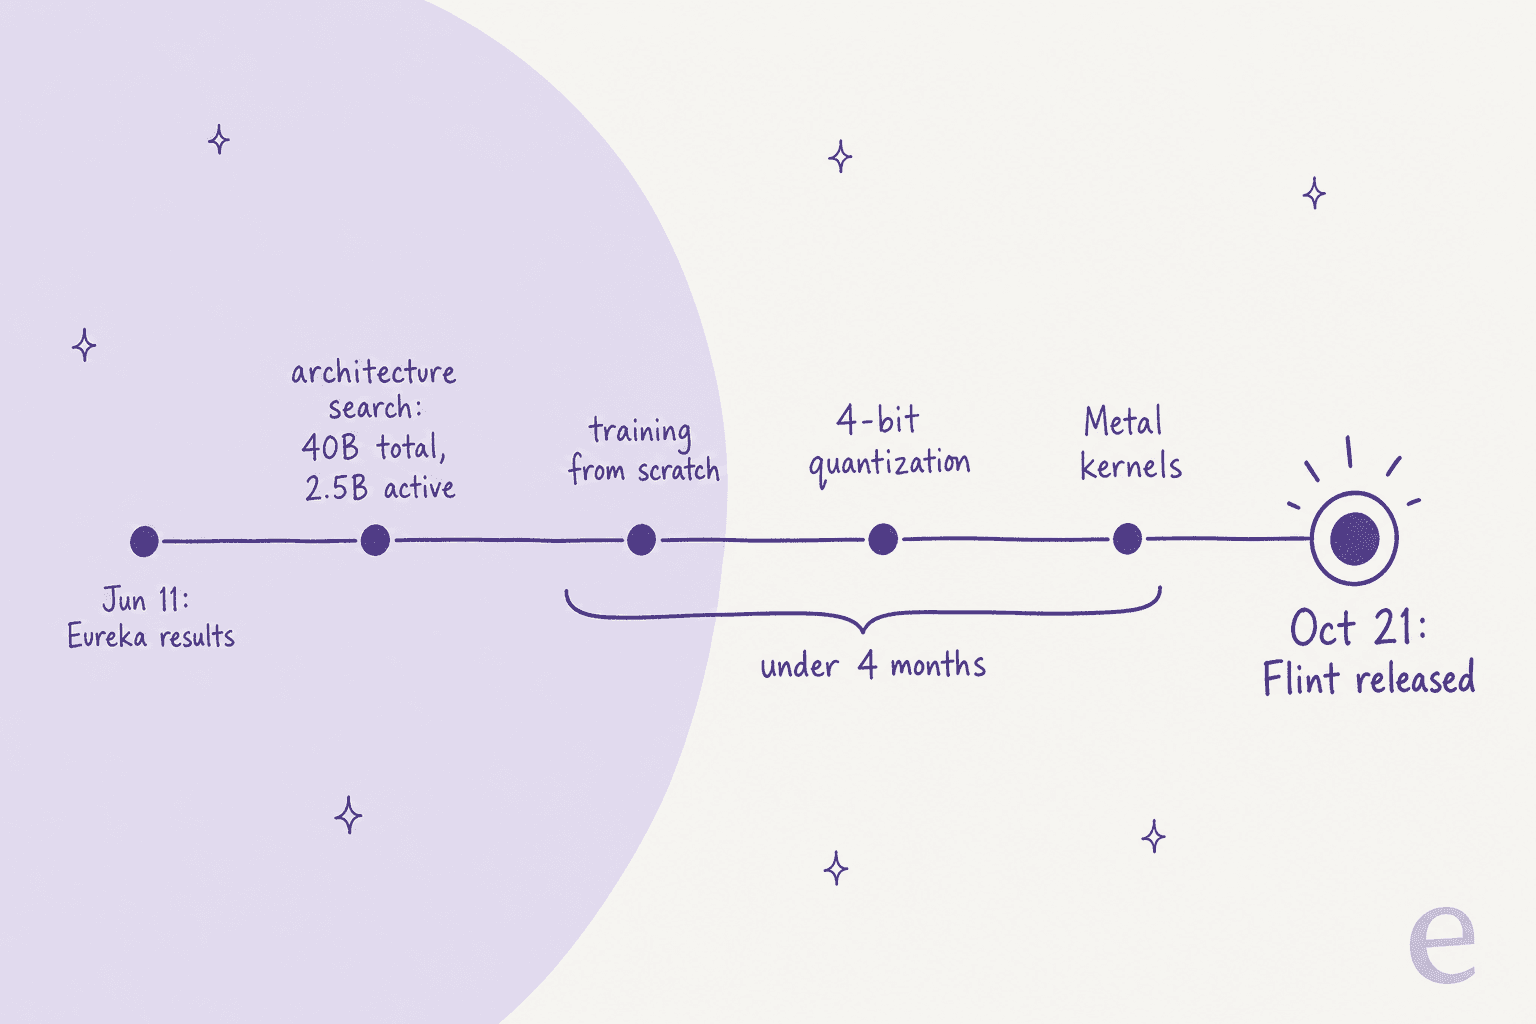
- Architektursuche. Recursive startete mit einer Basis aus
35BGesamt- und3Baktiven Parametern. Die Eureka Machine erkundete Expertenzahlen und -breiten und landete bei 40B gesamt, 2,5B aktiv, der Konfiguration, von der sie den besten Mix aus Geschwindigkeit und Coding-Werten erwartete. Es gibt also mehr Gesamtparameter und weniger aktive, ein bisschen wie eine größere Bibliothek, in der jedes Token trotzdem weniger Seiten liest. - Training von Grund auf. Flint ist kein Fine-Tune eines fremden Modells. Nebenbei hat das System auch an den Daten und Optimierern gearbeitet, außerdem an den Trainingsrezepten.
- Quantisierung. Für mich ist das der cleverste Schritt. Entgegen der gängigen Praxis hat das System die Ausgabeschicht (
lm_head) auf 4 Bit verkleinert. Bei nur 2,5B aktiven Parametern macht diese Ausgabeschicht einen großen Teil der Gewichte aus, die für jedes Token gelesen werden, daher bringt ihre Verkleinerung echte Geschwindigkeit. Um die Genauigkeit zurückzuholen, hat es eine Distillationsstufe ergänzt, in der das 4-Bit-Modell mit dem 16-Bit-Modell als Lehrer auf seinen eigenen vorab gesampelten Antworten trainiert. Das hat die Trainingsschritte nahezu halbiert im Vergleich zu Recursives Baseline, und der finale NVFP4-Build liegt innerhalb von0,7Punkten des 16-Bit-Builds. - Kernels. Als letzten Schritt hat es Kernels für Low-Bit-Mathematik, MoE-Routing, Attention und Prompt-Verarbeitung auf Apple Silicon und NVIDIAs RTX Spark geschrieben. Auf M4- und M5-Chips entstand ein Metal-"Megakernel", der den gesamten Decode-Durchlauf in einen verschmilzt.
Der Grund, warum sich die vier Schritte verstärken, ist ziemlich einfach. Weniger aktive Parameter machen jedes Token billiger, eine 4-Bit-Ausgabeschicht macht jeden dieser Parameter billiger beim Lesen, und der verschmolzene Kernel nimmt den Overhead zwischen den Lesevorgängen weg. Jeder Gewinn multipliziert den vorherigen, und so wird ein 40B-Modell schneller als viele mit 3B aktiven.
Wie schnell und wie gut ist Recursive Flint?
Es ist schnell und für seine Größe auch gut. In Recursives Grafik für einen M4 Pro mit 48 GB schreibt Flint über MLX 131,22 Tokens/s bei kurzem Kontext, gegenüber 13,01 beim dichten Qwen 3.8 27B. Gemittelt über 128K Tokens Kontext hält es 68,89 Tokens/s, während Qwen 3.8 auf 10,11 fällt.

Bei der Qualität ist das Bild gemischter. So schneidet Flint gegen seine nächsten Rivalen in Recursives eigener Benchmark-Grafik ab:
| Benchmark | Flint | Qwen 3.8 27B (dicht) | Qwen 3.6 35B-A3B (MoE) |
|---|---|---|---|
| Terminal-Bench 2.1 | 54,9 | 73,0 | 44,9 |
| SWE-bench Verified | 74,2 | 75,6 | 73,4 |
| LiveCodeBench v6 | 80,3 | 90,3 | 80,4 |
| IFBench | 89,2 | 79,5 | 67,9 |
Neben anderen MoE-Modellen seiner Größe gewinnt Flint klar, und diese Aussage hat Recursive an den Anfang gestellt. Neben dem besten dichten Modell der Grafik verliert es aber vier von sechs Tests, darunter eine Lücke von 18 Punkten bei Terminal-Bench 2.1. "Rivals dense models" ist also fair für Muse Glimmer und Gemma 4 und großzügig für Qwen 3.8.
Dieser Kompromiss wird im Recursive-Flint-Test meiner Kollegin Rama viel genauer betrachtet, samt der Tool-Call-Fehlerrate von 17,74 %, die OpenRouter aktuell meldet. Meine Kurzfassung: Du bekommst ein Modell, das 10-mal schneller ist bei einer etwas schlechteren Antwort. Beim interaktiven Coding, wo du ohnehin jeden Diff liest, ist das oft der richtige Deal.
Wie führst du Recursive Flint aus?
Flint zum Laufen zu bringen dauert etwa fünf Minuten, und der Weg hängt von deiner Hardware ab. Das ist die Übersicht aus Recursives Setup-Anleitung:
| Dein Setup | Weg | Was du brauchst |
|---|---|---|
| Aktueller Mac | rec, Recursives eigene Engine | M4 Pro, M5 Pro oder M5 Max, 48 GB+ Speicher |
| Beliebiger Laptop oder PC | Ollama, LM Studio, Unsloth oder llama.cpp | Ein kompatibler quantisierter Build; 24 GB RAM für das kleinste GGUF |
| GPU-Server | SGLang, vLLM oder Transformers | ~80 GB BF16-Checkpoint; ein B300 oder H200 |
| Keine freie Hardware | OpenRouter oder OpenCode Free Tier | Ein Konto; Kapazitäts- und Ratenlimits gelten |
| Partner | Direkte Recursive-API | Genehmigter Partnerzugang |
Auf einem unterstützten Mac sind es nur zwei Befehle. Installiere zuerst rec und führe dann in deinem Projektordner rec launch pi aus. Das lädt das Modell zusammen mit dem Pi-Harness herunter und startet dann einen lokalen Server, der sowohl OpenAI- als auch Anthropic-artige APIs spricht. Wenn dir OpenCode lieber ist, nimm stattdessen rec launch opencode.
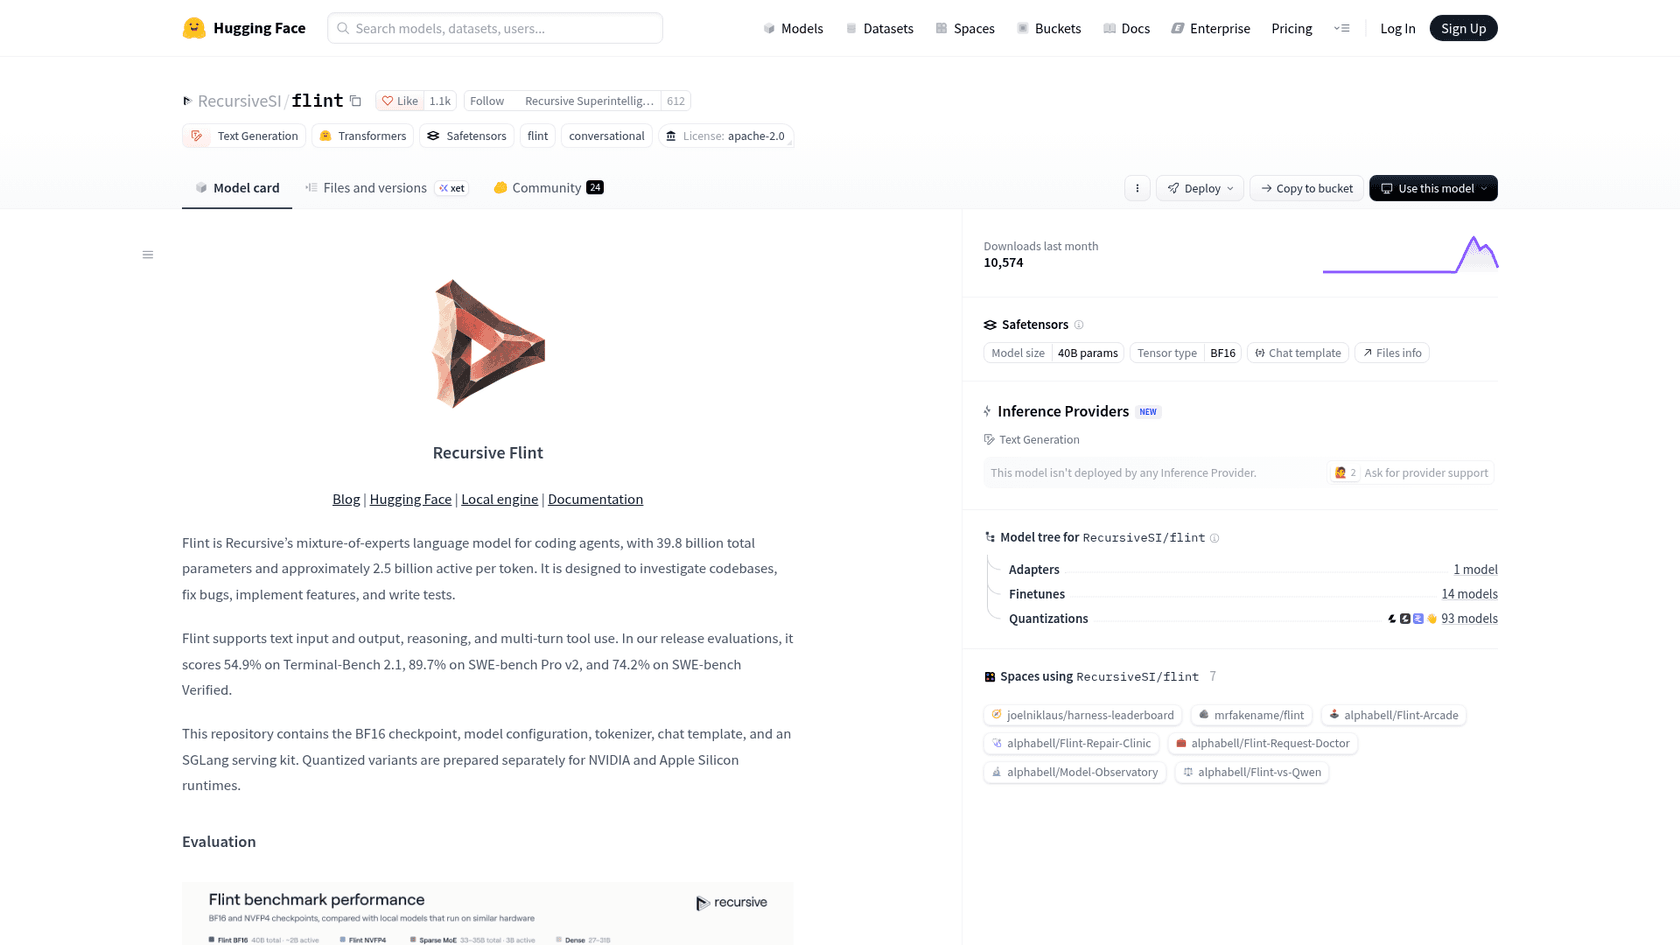
Ohne Mac ist der schnellste Weg Ollama, wo ollama run flint:40b-a2b-qat-int4 Recursives gepackten 4-Bit-Build lädt. Auf einer GPU-Maschine hat das Hugging-Face-Repo den vollen Checkpoint plus ein SGLang-Serving-Kit. Auch die Community war in diesem Repo schnell, mit 93 Quantisierungen und 14 Fine-Tunes innerhalb einer Woche nach dem Launch.
Zwei Setup-Tipps aus der Dokumentation gebe ich gern weiter. Der erste: Gib ihm Raum zum Denken, denn Reasoning ist immer aktiv, und wenn eine Antwort mit finish_reason: length endet, erhöhe das Ausgabebudget, statt den Prompt zu kürzen. In dieselbe Budget-Falle sehe ich Leute auch beim Kontextfenster von Claude Code tappen. Der zweite Tipp: Zerlege die Arbeit in kleine, explizite Schritte. Recursive sagt, Flint "may need more guidance than the larger closed-source coding models you're used to", was zu seinem herausragenden Instruction-Following-Wert passt.
Wer lieber nichts herunterladen möchte, kann den kostenlosen Endpunkt von OpenRouter nutzen, dessen Seite auch zeigt, wo Flint schon eingesetzt wird. Die Top-Apps dort sind alle Agenten, mit Kilo Code bei 32,9B Tokens in einer Woche, Cline bei 12,2B und dem Hermes Agent bei 10,6B.
Was kostet Recursive Flint?
Lizenzseitig kostet es nichts. Die Gewichte sind Apache 2.0, kostenlos für kommerzielle Nutzung, und OpenRouter listet den gehosteten Endpunkt mit $0 für Ein- und Ausgabe, bei 99,67 % Verfügbarkeit in den letzten drei Tagen. Wofür du wirklich zahlst, ist die Hardware, auf der du es betreibst.
Genau dort zahlt sich Flints Design aus. Ein Modell, das auf einem einzelnen Mac mit 48 GB Coding auf dichtem Niveau liefert, mit der 10-fachen Geschwindigkeit seiner dichten Konkurrenten, macht aus einer Maschine, die du schon besitzt, ein kostenloses Coding-Backend. Stell das neben ein gehostetes Frontier-Modell, bei dem meine Aufschlüsselung zu den Kimi-K3.1-Pro-Preisen eine typische agentische Aufgabe bei etwa $2,11 ansetzt. Über Dutzende kleiner Aufgaben am Tag summiert sich "gut genug und kostenlos" schnell.
Was du nicht bekommst, ist eine bezahlte API mit SLA. Direkter Zugang bleibt laut Recursives FAQ ausgewählten Partnern vorbehalten, für alles Kundennahe willst du also weiterhin ein unterstütztes gehostetes Modell wie GitHub Copilot oder OpenAI Codex.
Warum ist Recursive Flint wichtig?
Für sich genommen ist Flint ein sehr gutes kleines Coding-Modell, aber nicht das einzige gute offene diesen Monat, denn Nemotron 3.5 Bolt, LFM3 und Nanbeige 4.3 sind alle innerhalb weniger Wochen erschienen. Was Flint besonders macht, ist, wie es entstanden ist.
Recursives Wette ist, in den eigenen Worten, dass "more capable models can make Eureka Machine a better researcher, helping us build the next generation faster." Wenn das stimmt, macht jedes Flint das nächste billiger im Bau. Diese Behauptung würde ich im Auge behalten, und das Gute ist, dass sie sich testen lässt: Das nächste Release zeigt, ob die Schleife tatsächlich schneller wird oder ob Flint ein talentiertes Team mit guten Werkzeugen war.
Für den Moment würde ich so handeln:
- Du schreibst Code und besitzt einen aktuellen Mac: Probier Flint diese Woche aus. Es ist kostenlos und privat und außerdem schnell genug, dass du vielleicht öfter zu einem lokalen Modell greifst. Nutze es in einem agentischen Coding-CLI, das du schon kennst.
- Du willst das stärkste offene Modell pro Antwort: Bleib vorerst bei Qwen 3.8 oder stöbere in meiner Liste mit Qwen-Alternativen.
- Du fährst unbeaufsichtigte, lange Agenten-Jobs: Warte, bis die Tool-Call-Fehlerrate sinkt, oder bleib bei Claude Code.
- Du verfolgst KI-Forschungswerkzeuge: Lies Recursives Forschungsbeitrag und die als Open Source veröffentlichten Artefakte. Dasselbe gilt für andere Infrastruktur-Releases dieses Monats wie DeepInfer und TorchTPU.
Was Flint für ein Support-Team bedeutet
Flint ist Infrastruktur, also ein Modell, auf dem ein Coding-Agent läuft. Wenn dein Problem eine Support-Warteschlange ist, war das Modell nie der schwierige Teil. Schwierig ist alles drumherum, etwa die Anbindung an dein Helpdesk und das Lernen aus deinen bisherigen Tickets, dann zu wissen, wann man übergibt, und zu beweisen, dass es keine selbstsicher falsche Antwort gibt. Selbst die Modellwahl ist eine eigene Frage, die ich in LLMs für den Kundensupport behandle.
Diese Lücke füllen die KI-Teammitglieder von eesel. Jedes ist ein einsatzbereiter Mitarbeiter für eine definierte Aufgabe, statt eines KI-Agenten-Baukastens, den du selbst zusammensetzt, und das Helpdesk-Teammitglied ist das für den Support. eesel setzt seit Jahren KI auf Live-Support-Warteschlangen ein, und die Lehre daraus ist dieselbe, die Recursive mit seinen Kernels gezogen hat: Der Evaluator muss so ernsthaft sein wie das System, das er prüft.
Qontro, ein ERP-Softwareunternehmen, bekommt bei jedem Freshdesk-Ticket einen Antwortentwurf mit den passenden Hilfeartikeln verlinkt, 190 Ticket-Entwürfe in einem Monat, beantwortet aus rund 9.800 früheren Tickets und Hilfeartikeln. SE Ranking betreibt drei eesel-Agenten auf drei Zendesk-Verbindungen und hat 4.650 Unterhaltungen in einem Monat bearbeitet.
Wenn du im Terminal lebst, treffen sich hier die beiden Welten. Mit dem eesel CLI kann derselbe Coding-Agent, den du auf Flint laufen lassen würdest, dein Support-Teammitglied bedienen: eesel activity zeigt, was der Agent bei jedem Ticket getan hat, eesel instructions ändert seine festen Regeln, und eesel approvals gibt Aktionen frei, auf die er wartet. Jeder Befehl liefert JSON, und mit --dry-run siehst du den genauen Aufruf, den ein Schreibvorgang ausführen würde, bevor er gesendet wird. Mehr dazu habe ich zu KI-Agenten-CLIs und zum MCP-Server-Weg geschrieben.
eesel ausprobieren
Du willst KI in deinem Helpdesk, ohne sie auf einem rohen Modell zu bauen? Das Helpdesk-Teammitglied von eesel lässt sich in Minuten in Zendesk, Freshdesk oder Gorgias einbinden, lernt aus deinen bisherigen Tickets und deinem Help Center und wird daran getestet, bevor es jemandem antwortet. Du kannst jede Aktion im Dashboard beobachten oder über das CLI abrufen. Kostenlos starten, keine Karte nötig.

Häufig gestellte Fragen
Was ist Recursive Flint?
Wer hat Recursive Flint entwickelt?
Ist Recursive Flint Open Source und kostenlos?
Wie führe ich Recursive Flint lokal aus?
rec launch pi aus. Auf anderen Rechnern nutzt du Ollama, LM Studio oder llama.cpp mit einem quantisierten Build, auf einem GPU-Server SGLang und vLLM. Kombiniere es mit einem Harness wie dem Pi Coding Agent.