

Kimi K3.1 Pro ist das bislang stärkste angekündigte Open-Weight-Modell und erreicht 55 im Artificial Analysis Intelligence Index, 2.5 Punkte hinter Claude Opus 5.5, bei 2 $ für Eingabe- und 10 $ für Ausgabetokens pro Million Tokens. Moonshot hat es am 23. Oktober 2026 als umfassend nachtrainierte Version von Kimi K3 veröffentlicht, und der Sprung ist deutlich: Bei Terminal-Bench 4.0 stieg das Ergebnis auf Artificial Analysis von 12.6% auf 67.2%.
Der Haken ist alles rund um die Ergebnisse. Es läuft mit etwa 50 Tokens pro Sekunde und liegt damit fast am unteren Ende seiner Klasse. Die Gewichte sind „bis zum 4. November“ versprochen, daher ist es heute nur per API verfügbar. Und erste Kimi-Code-Abonnenten berichten, dass sie ein 5-Stunden-Limit in weniger als einer Stunde aufbrauchen. Die Preissenkung gilt pro Token, nicht pro Antwort: Es schreibt viel, sodass ein Durchlauf des gesamten Benchmark-Index $3,117 kostet, gegenüber $3,658 bei K3. Das ist eine Ersparnis von 15 %, nicht 33 %.
Wenn Sie ein Modell für einen KI-Support-Agenten auswählen, ist das Modell der kleinere Teil der Aufgabe. Ich habe bei eesel jahrelang KI in laufende Helpdesk-Warteschlangen eingebunden, und der schwierige Teil ist nie der Motor. Es sind die Helpdesk-Anbindung, die Übergaberegeln und das Testen anhand echter früherer Tickets. SE Ranking nutzt diese Ebene für drei Produkte auf Zendesk, mit etwa 4,650 Gesprächen im Monat.
Was ist Kimi K3.1 Pro?
Kimi K3.1 Pro ist das neue Flaggschiffmodell von Moonshot AI und zugleich die erste Veröffentlichung seiner K3.1-Serie. Moonshot bezeichnet es als "our most capable 3T-class open-weight model to date", mit einem Kontextfenster von 1 Million Tokens. Unter der Haube steckt ein Mixture-of-Experts-Modell mit insgesamt 2.8T und 104B aktiven Parametern, laut dem Ankündigungsbeitrag auf X.
Es gibt zwei Varianten: Kimi K3.1 Pro ist die Standardversion, und Kimi K3.1 Pro Highspeed ist dasselbe Modell, wird aber zum doppelten Preis "2-3× faster" bereitgestellt. Beide gingen am selben Tag auf kimi.ai, in den Kimi-Apps, in Kimi Work, Kimi Code und der Kimi API live.
Moonshot hebt vier Bereiche hervor, in denen es Verbesserungen gibt: Programmierung, 3D-Erstellung, Finanzrecherche und lang laufende Agentenaufgaben. Wenn Sie den Start von Kimi K3 im Juli verfolgt haben, lautet die Kurzfassung: Bei Agentenaufgaben ist K3.1 Pro das Modell, das K3 eigentlich sein sollte.
Was hat sich gegenüber Kimi K3 geändert?
Um das klarzustellen: Kimi K3.1 Pro ist kein neues Basismodell. Moonshot beschreibt es als "a post-trained version of Kimi K3, with substantially larger post-training compute", das Reinforcement Learning über "hundreds of downstream domains" hinweg nutzt. Die 2.8T Gewichte sind also dieselben. Geändert hat sich, wie viel Training in ihre Nutzung geflossen ist.
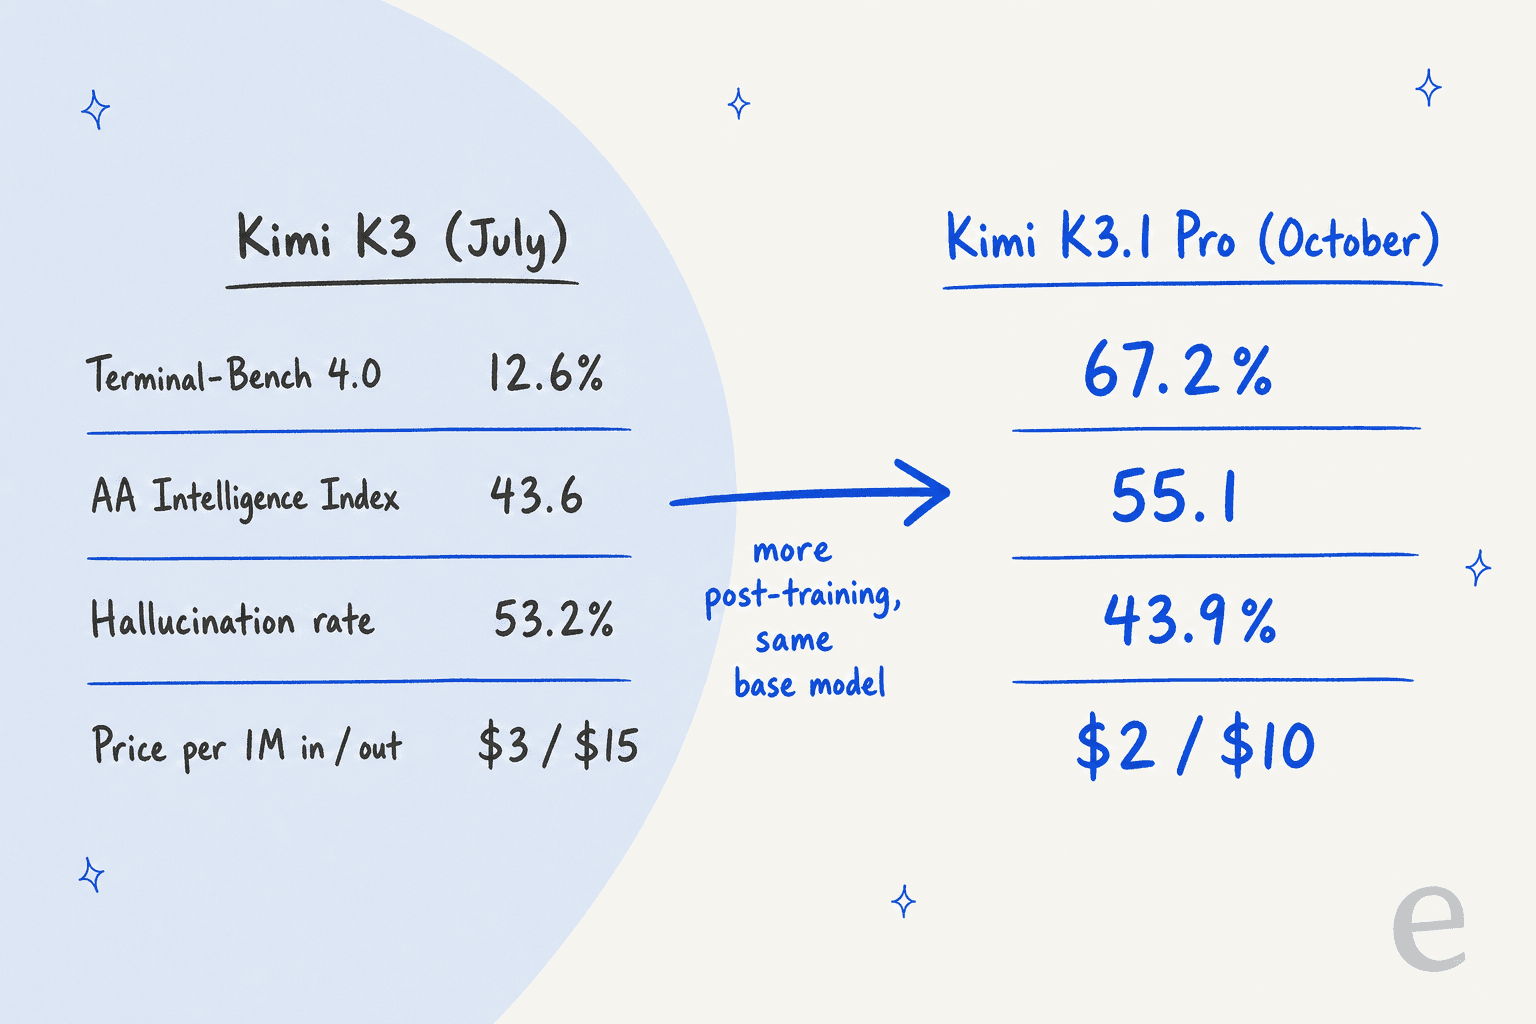
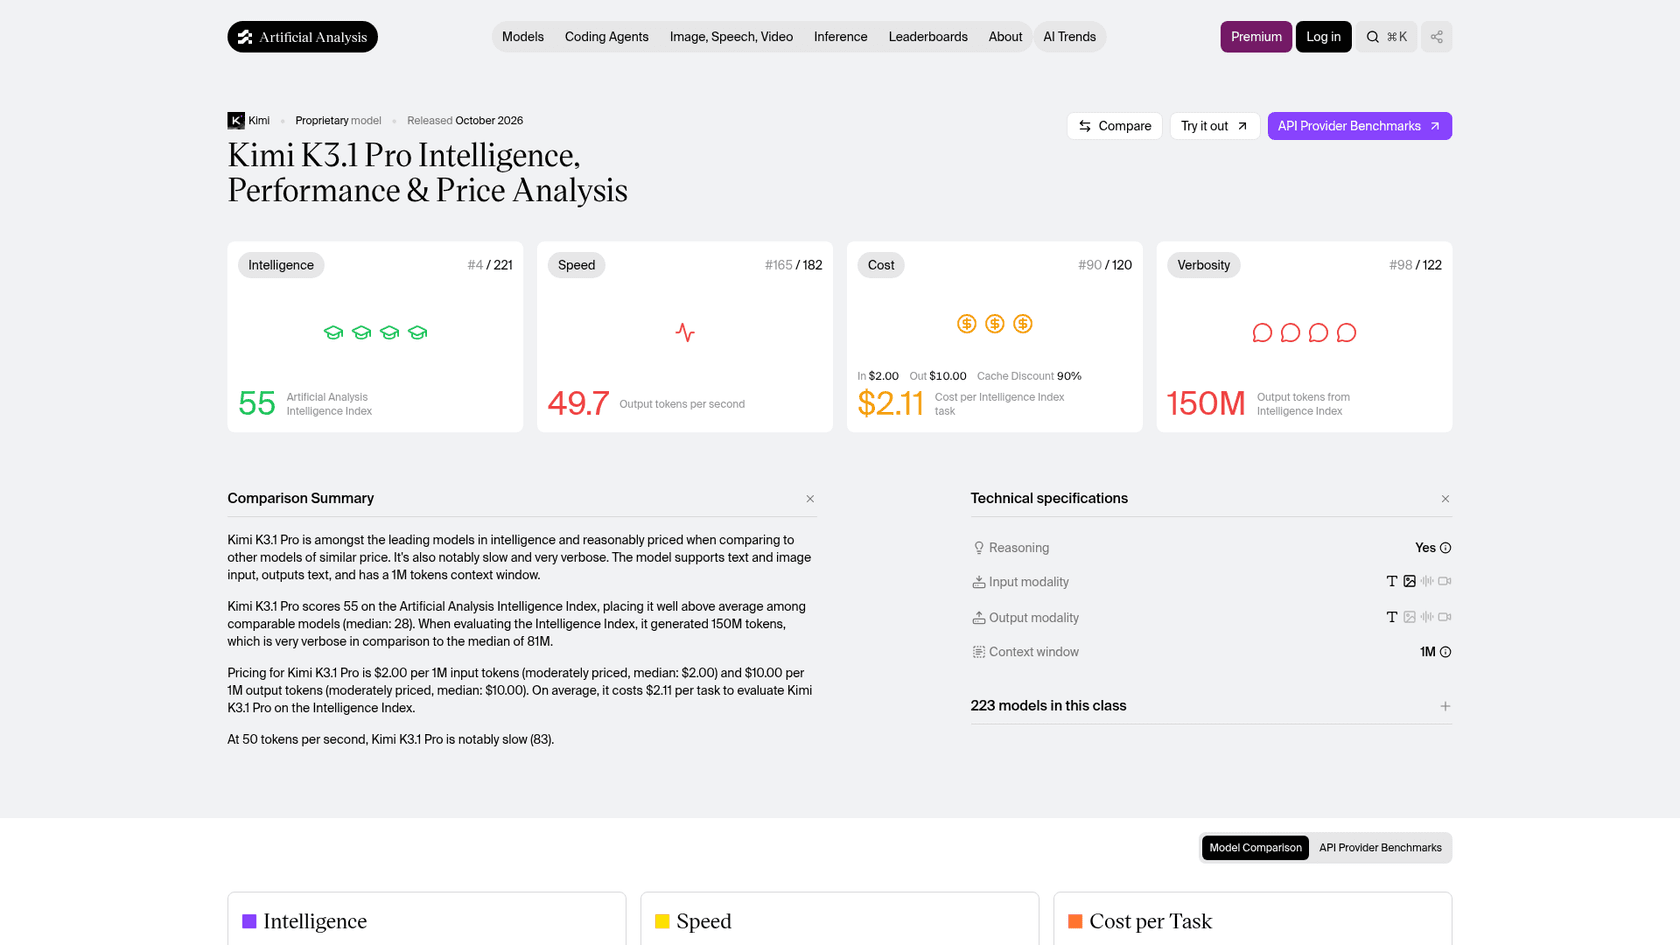
Auf dem Papier klingt das nach einer schrittweisen Verbesserung, aber die Zahlen erzählen eine andere Geschichte. Auf der Artificial-Analysis-Seite zu K3.1 Pro, gemessen mit derselben Indexversion wie Kimi K3:
| Kimi K3 (Max) | Kimi K3.1 Pro | |
|---|---|---|
| Veröffentlicht | 16. Juli 2026 | 23. Oktober 2026 |
| Intelligence Index (v4.3.2) | 43.6 | 55.1 |
| Terminal-Bench 4.0 | 12.6% | 67.2% |
| Halluzinationsrate (AA-Omniscience) | 53.2% | 43.9% |
| GDPval-AA (Elo) | 1,534 | 1,846 |
| API-Preis pro 1M (Eingabe / Ausgabe) | $3 / $15 | $2 / $10 |
| Ausgabegeschwindigkeit | 54.5 Tokens/s | 49.7 Tokens/s |
| Gewichte | Offen | Bis zum 4. November angekündigt |
Der Sprung bei Terminal-Bench von 12,6 % auf 67,2 % ist die wichtigste Nachricht. Dieser Benchmark prüft, ob ein Modell mehrstufige Aufgaben in einem Terminal tatsächlich abschließen kann, und genau das tun Coding-Agenten den ganzen Tag. K3 war ein intelligentes Modell, das Schwierigkeiten hatte, diese Intelligenz in Handlungen umzusetzen. K3.1 Pro setzt sie dagegen um.
Beim Vergleich mit älteren Artikeln sollten Sie auf eine Falle achten: K3 erreichte im August 57 auf Artificial Analysis, aber der Index wurde seither neu skaliert. In der heutigen Version liegt K3 bei 43.6, K3.1 Pro macht also einen Sprung um 11.5 Punkte und fällt nicht um 2 Punkte ab. Ich habe diesen Vergleich damals auch in meinem Kimi-K3-Test angestellt. Betrachten Sie diese älteren Zahlen daher bitte als Werte auf einer anderen Skala.
Moonshot hat außerdem etwas Ungewöhnliches getan: Es hat cyberbezogene Trainingsdaten bewusst aus der Open-Weight-Veröffentlichung entfernt. Im eigenen internen Exploit-Benchmark erreicht das finale Modell 81.0, gegenüber 90.5 für dasselbe Modell, das ohne diese Kürzung trainiert wurde. Die von Moonshot formulierte Regel lautet, keine offenen Gewichte zu veröffentlichen, auf die "release open weights that would extend the absolute frontier of cyber capability." zutreffen würde.
Wie gut schneidet Kimi K3.1 Pro in Benchmarks ab?
In Moonshots eigenem Diagramm mit 14 Tests belegt Kimi K3.1 Pro 6-mal den ersten und 5-mal den zweiten Platz, im Vergleich mit Claude Opus 5.5, GPT-6 Astra, Claude Fable 5.1, DeepSeek V4.1 Flash und GLM-5.3. Alle Modelle wurden mit maximalem Denkaufwand ausgeführt.
Hier sind die wichtigsten Ergebnisse, direkt aus dem Moonshot-Blogbeitrag zur Veröffentlichung:
| Benchmark | Kimi K3.1 Pro | Opus 5.5 | GPT-6 Astra | Fable 5.1 |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 65.7 | 66.4 | 58.2 | 57.9 |
| SWE Marathon | 51.7 | 46.3 | 42.5 | 45.6 |
| OfficeQA Pro v2 | 64.4 | 62.2 | 54.4 | 54.5 |
| Humanity's Last Exam (mit Tools) | 70.0 | 67.7 | 57.2 | 65.6 |
| OSWorld V2.1 | 79.6 | 81.8 | 75.8 | 80.7 |
| GDPval-AA v2.1 (Elo) | 1846 | 1866 | 1573 | 1754 |
| BenchCAD (mit Tools) | 92.7 | 96.2 | 95.9 | 92.6 |
| Terminal-Bench-Science 0.1 | 38.1 | 63.3 | 68.1 | 40.0 |
Zwei Dinge sollten Sie wissen, bevor Sie irgendetwas davon zitieren.
Erstens liefen die Coding-Benchmarks in der Ausführungsumgebung von Claude Code und nicht in Moonshots eigener. Das ist eine nachvollziehbare Wahl, da die meisten Entwickler diese Umgebung nutzen. Es bedeutet aber auch, dass die Ergebnisse zeigen, wie Kimi abschneidet, wenn es wie Claude gesteuert wird. Ein Beitrag von Lisan al Gaib warf am Veröffentlichungstag genau diese Frage auf.
Zweitens stimmen die Zahlen von Drittanbietern und die des Herstellers nicht genau überein. Artificial Analysis sieht K3.1 Pro bei 67.2% in Terminal-Bench 4.0 und Opus 5.5 (Max) bei 59.6%, ein viel deutlicherer Sieg als Moonshots eigene 65.7 gegenüber 66.4. Mehrere andere hervorgehobene Ergebnisse (Kimi Code Bench, die Finanztests, Kimi Hallu Bench) stammen aus internen Benchmarks von Moonshot selbst. Auf den unabhängigen Index würde ich mich stützen: 55.1, Platz vier von 215 Modellen.
Programmierung und lang laufende Agenten
Bei der Programmierung geht es im Leistungsversprechen um ganze Projekte statt nur um Patches. Laut Moonshot kann K3.1 Pro Spiele in Unity, Unreal Engine und Godot entwickeln. Als Vorzeigeprojekt hat Moonshot einen langen Durchlauf am quelloffenen human-atlas-Projekt gewählt: 167 Missionen und 420 unabhängige Überprüfungen, um einen Gehsimulator für ein Körpermodell mit 296 Skelett- und 402 Muskelkomponenten zu bauen. Am Ende ging der simulierte Mensch 11.2 Sekunden lang, statt innerhalb von Sekunden zusammenzubrechen.
Bei SWE Marathon, einem Coding-Benchmark für langfristige Aufgaben, erreicht es 51.7 gegenüber 46.3 bei Opus 5.5. Wenn ich nur ein Ergebnis im Auge behalten könnte, wäre es dieses, denn bei langen Aufgaben summiert sich der Preisunterschied zu Claude immer weiter.
3D-Modellierung und Design
Dieser Teil ist das markanteste Merkmal der Veröffentlichung. K3.1 Pro schreibt Skripte für Blender und CAD-Software und führt sie direkt aus, "without MCP connectors". Moonshot hat darum eine Funktion für Endnutzer namens 3D Make entwickelt.
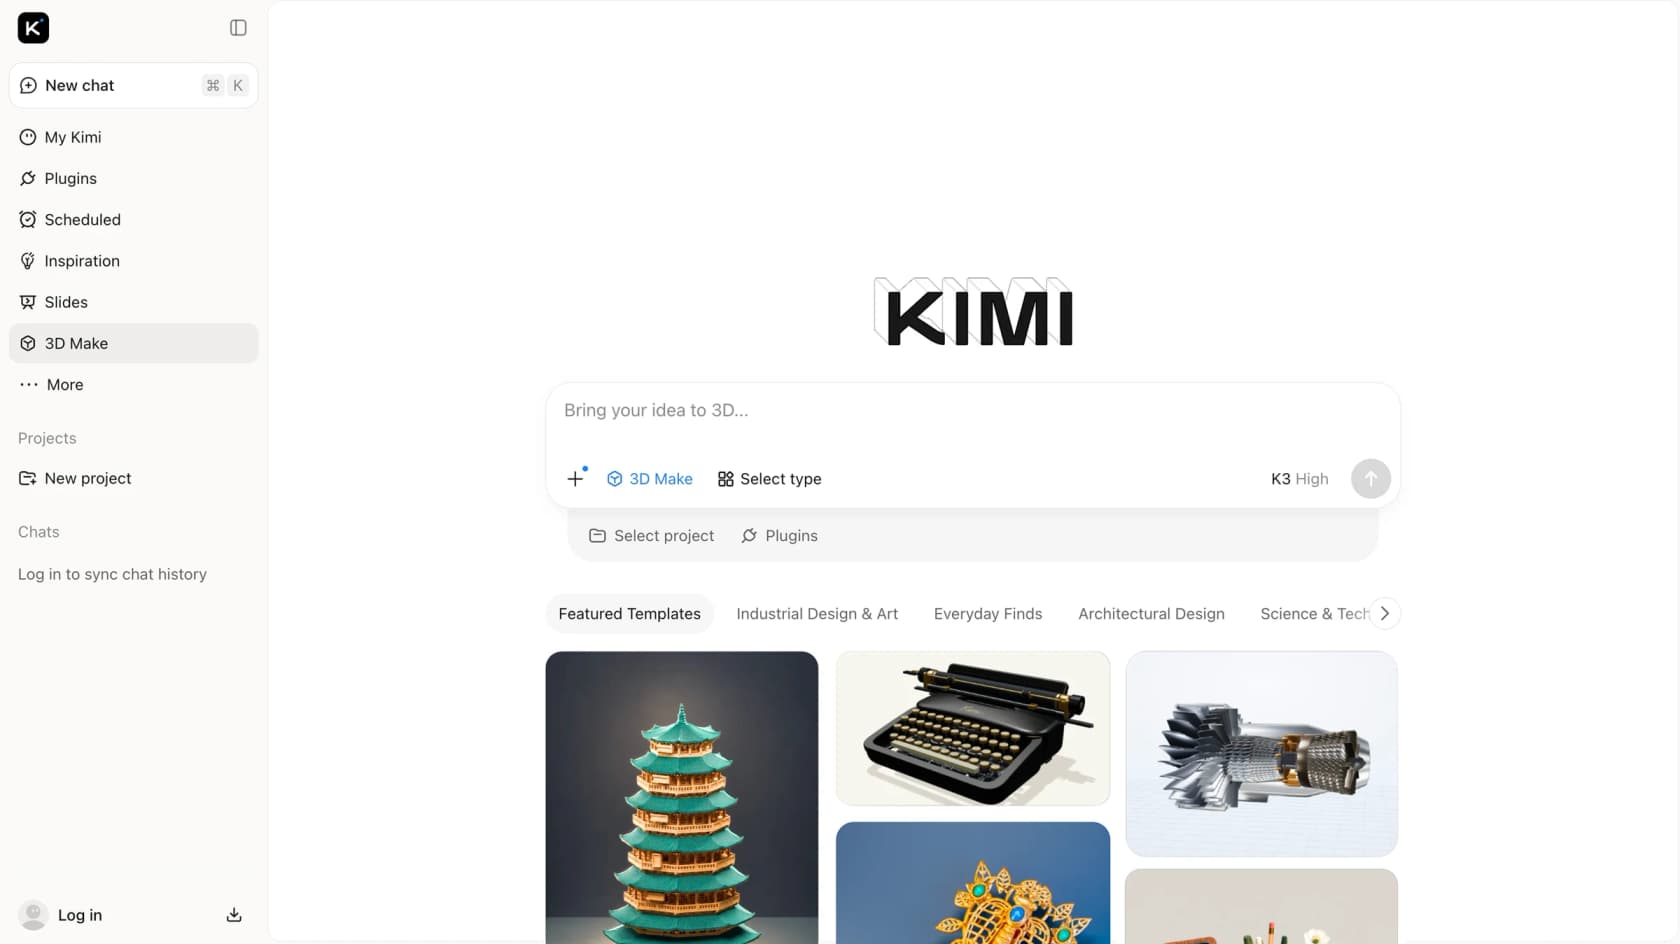
Bei BenchCAD mit Tools erreicht es 92.7, hinter Opus 5.5 (96.2) und GPT-6 Astra (95.9). Ohne Tools liegt es fast genau gleichauf mit Opus: 72.8 gegenüber 73.0. Laut Moonshot ist es bei parametrischen Aufgaben am stärksten, also bei mechanischen Teilen und Architekturmodellen sowie konfigurierbaren Produkten und Möbeln.
Finanzaufgaben und Faktentreue
Moonshots Aussage zum Finanzbereich lautet "hallucination down by 65%". Das entspricht ungefähr dem internen Kimi Hallu Bench, bei dem der Anteil falscher Behauptungen in einem anspruchsvollen Test mit Tools von 23.4% (K3) auf 8.3% sank.
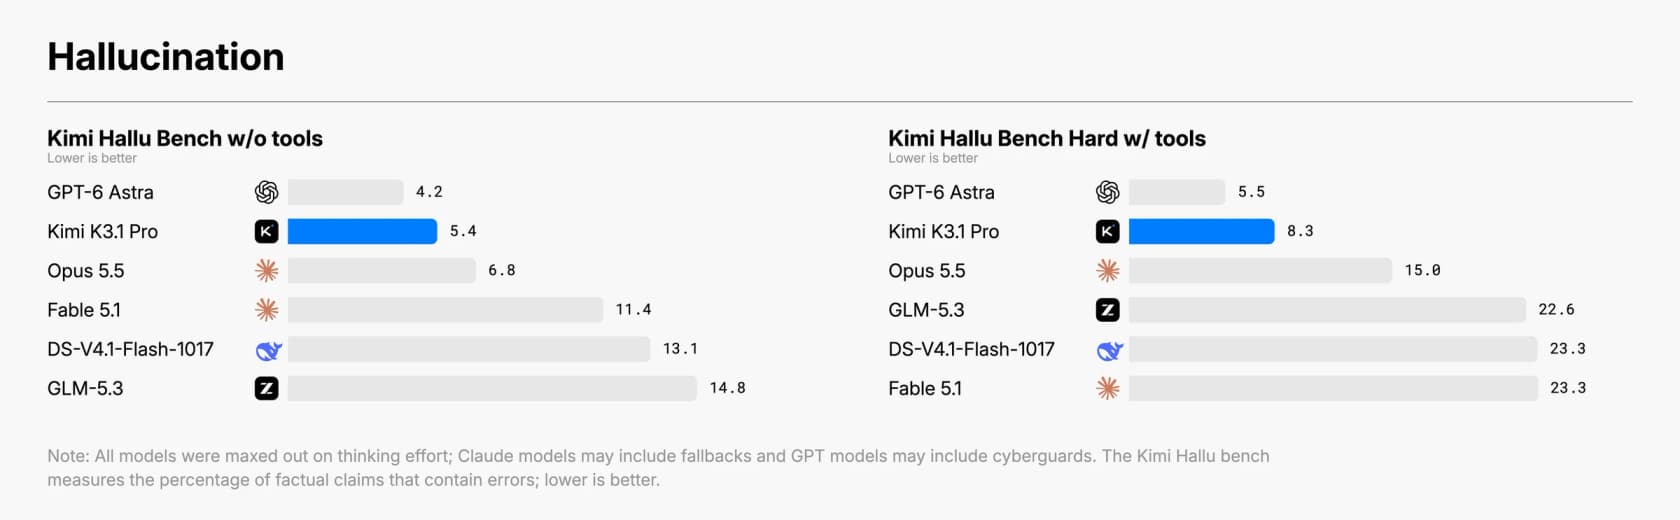
Fairerweise ergänzt Moonshot auch, dass diese Raten "do not represent overall error rates in daily use." Im unabhängigen AA-Omniscience-Test liegt die Halluzinationsrate von K3.1 Pro bei 43.9%. Das ist besser als Opus 5.5 Max (58.6%), aber deutlich hinter Gemini 4 Argon (15.1%). Wenn eine falsche Zahl in einer Tabelle Sie Geld kostet, sollten Sie seine Arbeit weiterhin überprüfen.
Wie viel kostet Kimi K3.1 Pro?
Kimi K3.1 Pro kostet auf der Kimi API 2 $ pro Million Eingabetokens, 0,20 $ pro Million zwischengespeicherter Eingabetokens und 10 $ pro Million Ausgabetokens, bei Highspeed verdoppelt sich das. Die Preise bleiben über den gesamten 1M-Kontext hinweg gleich, mit "no tiering by context length", laut dem K3.1-Pro-Schnellstart.
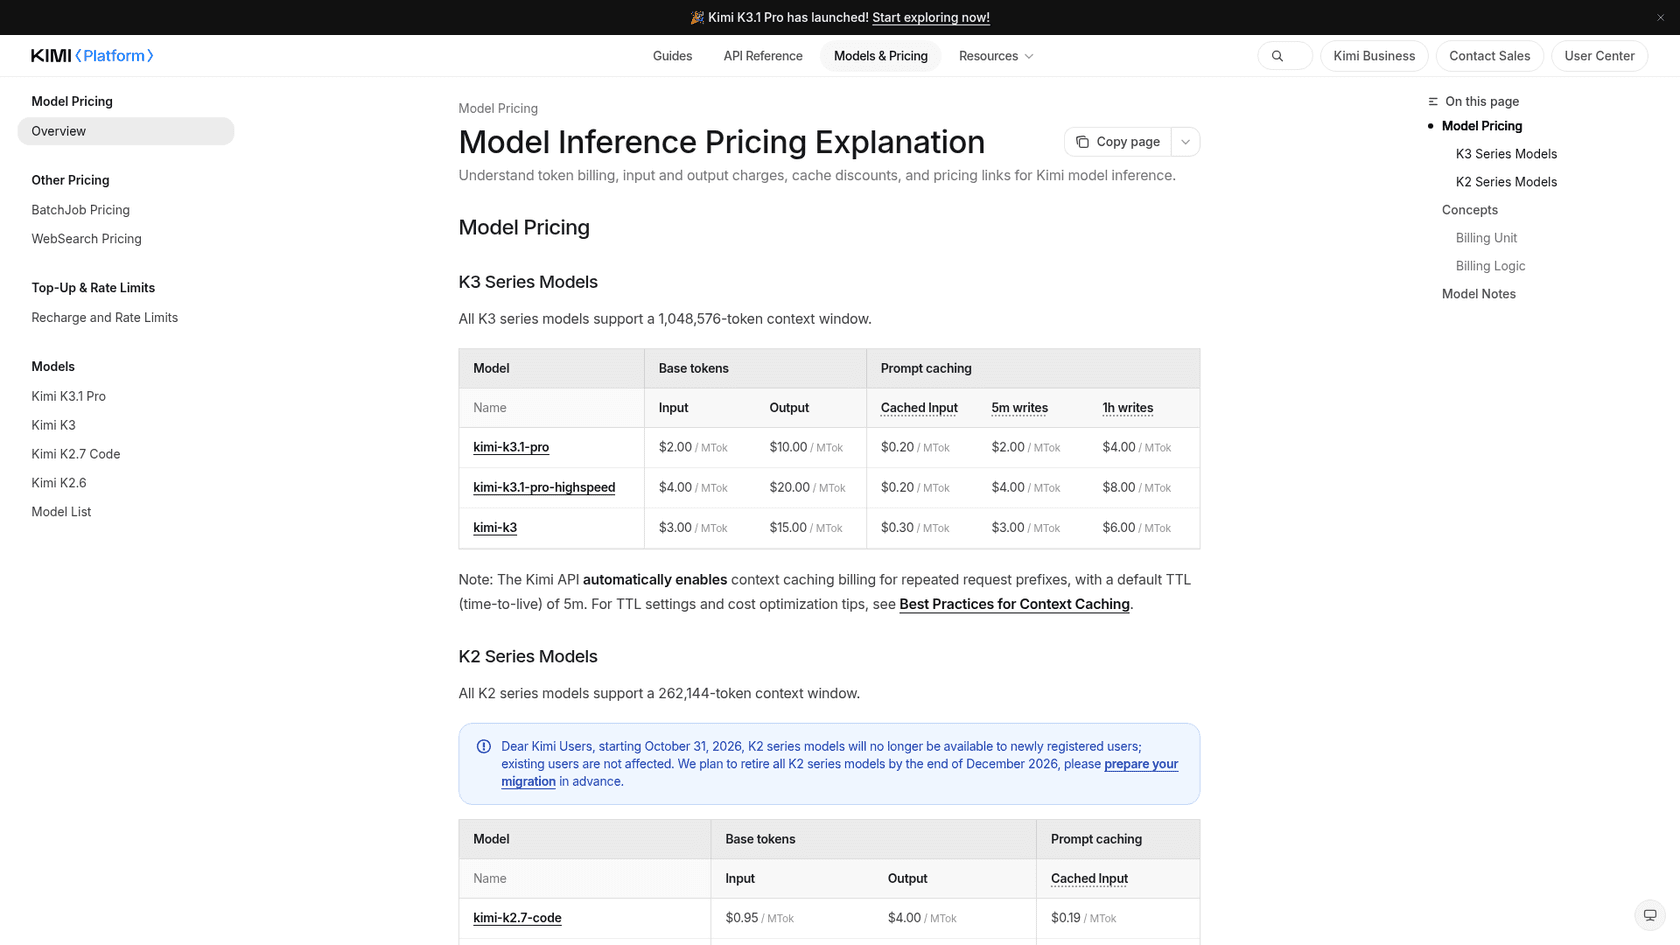
Von der Kimi-Preisseite, pro Million Tokens:
| Modell-ID | Eingabe | Zwischengespeicherte Eingabe | Ausgabe | Cache-Schreibvorgang (5 Min.) | Cache-Schreibvorgang (1 Stunde) |
|---|---|---|---|---|---|
kimi-k3.1-pro | $2.00 | $0.20 | $10.00 | $2.00 | $4.00 |
kimi-k3.1-pro-highspeed | $4.00 | $0.20 | $20.00 | $4.00 | $8.00 |
kimi-k3 | $3.00 | $0.30 | $15.00 | $3.00 | $6.00 |
Einige Abrechnungsdetails, die beeinflussen, was Sie tatsächlich zahlen:
- Caching erfolgt automatisch bei wiederholten Prompt-Präfixen, standardmäßig mit einem 5-Minuten-Fenster. Cache-Treffer kosten 90 % weniger. Wenn Ihr Agent einen langen System-Prompt wiederverwendet, ist das letztlich wichtiger als der beworbene Tarif.
- Sie müssen 1 $ aufladen, bevor K3.1 Pro freigeschaltet wird. Die Summe Ihrer Aufladungen bestimmt Ihre Rate-Limit-Stufe.
- Noch kein Batch-Rabatt. Der Batch-Preis von 60 % gilt nur für die älteren K2-Modelle, die ab dem 31. Oktober 2026 für neue Nutzer geschlossen werden.
- K3 kostet weiterhin 3 $ / 15 $, für neue Aufgaben gibt es also wenig Grund, dabei zu bleiben.
Bei den von Artificial Analysis erfassten Listenpreisen liegt es genau gleichauf mit den Preisen für Claude Sonnet 5.5, den Preisen für Gemini 4 Argon und GPT-6.1 Sol. Es kostet die Hälfte der Preise für Claude Opus 5.5 von 4 $ / 20 $.
Tarife für die Kimi-App und Kimi Code
Wenn Sie lieber ein Abonnement statt pro Token bezahlen, ist K3.1 Pro in den Mitgliedschaftstarifen von Kimi enthalten. Die folgenden Preise stammen von der Kimi-Code-Seite:
| Tarif | Monatlich | Jährliche Abrechnung (pro Monat) | Zugriff auf K3.1 Pro |
|---|---|---|---|
| Plus | $19 | $15 | Standard |
| Pro | $39 | $31 | Standard und Highspeed |
| Max | $99 | $79 | Standard und Highspeed |
| Ultra | $199 | $159 | Standard und Highspeed |
Highspeed verbraucht Credits mit der 2x Rate. Kimi hat die Tarife kürzlich umbenannt, "with pricing unchanged", und Kimi Code teilt sich weiterhin ein Kontingent mit dem Rest der Mitgliedschaft. Mit den neuen Tarifen entfällt das wöchentliche Kimi-Code-Limit, das rollierende 5-Stunden-Limit bleibt jedoch bestehen. Dieses Limit ist bislang der lauteste Kritikpunkt (mehr dazu weiter unten).
Günstiger pro Token, nicht immer pro Aufgabe
Hier ist der Teil, den die meisten Berichte zur Veröffentlichung auslassen. Pro Token ist K3.1 Pro ein Drittel günstiger als K3, aber es denkt viel und schreibt viel. Artificial Analysis stuft es als "very verbose" ein: Für den Index verbrauchte es etwa 150M Ausgabetokens, gegenüber einem Median von 87M bei ähnlichen Modellen.
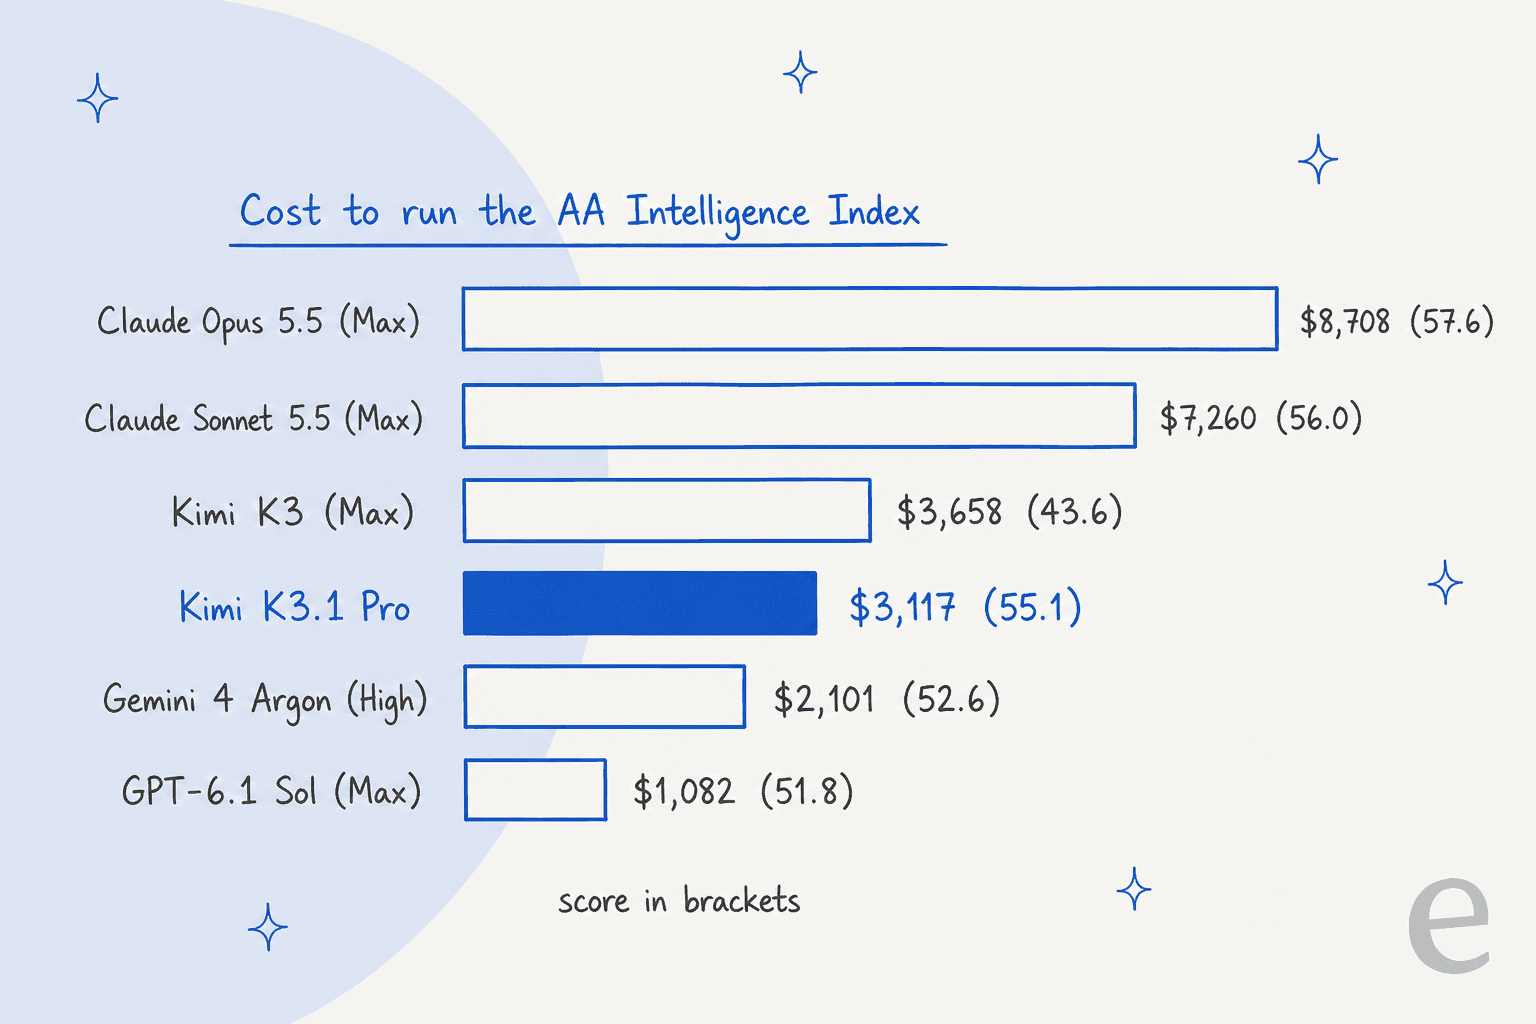
Der ehrlichere Vergleich sind daher die Kosten pro Aufgabe:
- Gegenüber Claude ist es wirklich günstig. Es liegt innerhalb von 2.5 Punkten von Opus 5.5 (Max), bei
36%der Kosten für einen Indexdurchlauf, und kostet deutlich weniger als die Hälfte von Sonnet 5.5 (Max), das416MTokens verbrauchte. - Gegenüber K3 ist die Ersparnis kleiner, als sie aussieht.
$3,117gegenüber$3,658sind etwa 15 % weniger, und Sie erhalten dafür ein deutlich besseres Modell. - Gegenüber den günstigen Optionen ist es kein Schnäppchen. GPT-6.1 Sol (Max) absolvierte den Index für
$1,082und Gemini 4 Argon (High) für$2,101, bei 3.3 beziehungsweise 2.5 Punkten weniger.
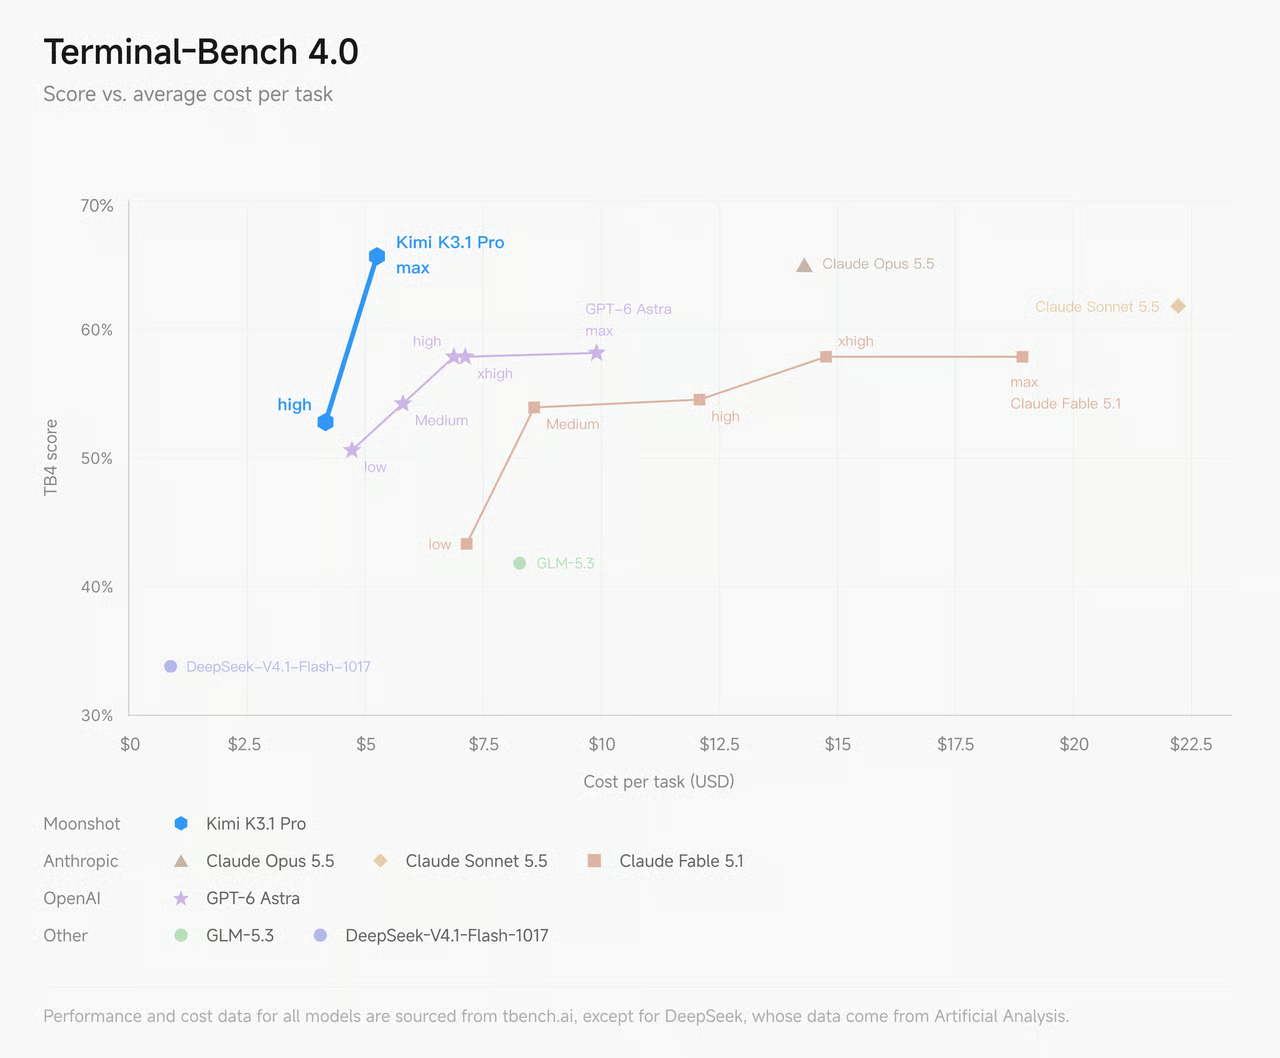
Moonshots eigenes Diagramm stellt den Claude-Vergleich anhand von Terminal-Bench an. Dort kommt K3.1 Pro bei maximalem Denkaufwand auf etwa 5 $ pro Aufgabe, gegenüber ungefähr 14 $ für Opus 5.5:
Nathan Lambert, ein Forscher bei Ai2, wies am Veröffentlichungstag auf denselben Zielkonflikt hin:
"K3.1 is also cheaper than K3 per token, but some benchmarks in the blog show it uses meaningfully more tokens per answer, so it may be about the same price."
Ist Kimi K3.1 Pro Open Source?
Noch nicht. Moonshot sagt "Full model weights will be released by Nov 4, 2026", und mit Stand vom 27. Oktober gibt es noch kein Hugging-Face-Repository dafür. Vorerst führt Artificial Analysis es als proprietäres Modell, und die API wird von 5 Anbietern bereitgestellt, gegenüber 20 bei K3.
Moonshot hat hier allerdings bereits geliefert: Die Gewichte von K3 wurden tatsächlich auf Hugging Face veröffentlicht, und das K3-Repository zeigt etwa 2.78T Parameter in 8-Bit. Sie können erwarten, dass K3.1 Pro ähnlich ausfällt. Es selbst zu betreiben ist also eine Aufgabe für einen Servercluster, nicht für einen Laptop.
"a 3T parameter model is still a bit beyond even many enthusiasts for running locally."

Die Lizenzbedingungen für K3.1 Pro sind noch nicht veröffentlicht. Die Lizenz von K3 erlaubte die kommerzielle Nutzung mit einigen Einschränkungen. Lesen Sie daher die neue Lizenz, bevor Sie darauf aufbauen. Wenn Sie ein offenes Modell brauchen, das Sie heute bereitstellen können, erreicht DeepSeek V4.1 Flash 45.1 im selben Index, zu einem Bruchteil der Kosten.
Wie schnell ist Kimi K3.1 Pro?
Langsam. Artificial Analysis misst 49.7 Ausgabetokens pro Sekunde auf der Kimi API. Damit liegt es auf Platz #165 von 182 Modellen, gegenüber einem Median vergleichbarer Modelle von etwa 83. Die Zeit bis zum ersten Token ist mit 2.95 Sekunden in Ordnung. Problematisch ist, wie lange es weiterschreibt: Eine durchschnittliche Indexaufgabe dauerte etwa 17 Minuten.
In der Praxis ist es trotzdem eine Verbesserung gegenüber K3, weil K3.1 Pro weniger Zeit mit Denken verschwendet. Ein Entwickler hat Folgendes gemessen:
"Biggest gripe with K3 was slow responses, partly due to inefficient thinking. So far K3.1 pro is almost twice as fast as k3 on our benchmark."
Moonshots Antwort darauf ist Highspeed: "2-3× the speed" zum doppelten Preis. Artificial Analysis hat es bislang nicht getestet, und die Reaktion am Veröffentlichungstag war verhalten:
"I'll wait for the openweight... btw double the price for 67 TPS... Hardly 'nitro'."
Meine Einschätzung: Bei Hintergrundagenten, die eine Stunde laufen, während Sie etwas anderes tun, spielt Geschwindigkeit kaum eine Rolle. Dafür ist das Standardmodell die richtige Wahl. Bei allem, wo eine Person wartet, etwa in einem Chatfenster, sollten Sie entweder für Highspeed bezahlen oder ein schnelleres Modell wählen.
Was sagen Entwickler über Kimi K3.1 Pro?
Der Thread zur Veröffentlichung auf Hacker News erhielt 1,089 Punkte und 674 Kommentare, und die Reaktionen teilten sich ziemlich klar auf. Fast alle sind sich einig, dass es ein großer Fortschritt gegenüber K3 und zugleich das bislang beste angekündigte Open-Weight-Modell ist. Die meisten, die täglich programmieren, sagen allerdings weiterhin, dass Claude Opus 5.5 in der Praxis vorne liegt.
Der positivste der unabhängigen Tests verglich es anhand von 180 per Code erzeugten Gemälden:
"It also does this while thinking less (~6.5k reasoning tokens vs ~8k for K3). Kimi K3.1 is roughly 2/3 the cost of Kimi K3 and ~1/3 the cost of Opus 5.5."
Am negativen Ende ließ ein Tester es gegen 105 absichtlich eingebaute Fehler in zwei echten Repositories antreten. Dort erreichte es 36 gegenüber 41.7 bei Opus 5.5:
"I'm sorry. Considering the cost, I see no reason to use this model."
Die Hobby-Benchmarks liegen irgendwo dazwischen, etwa auf dem Niveau von Fable 5.1 und Gemini 4 Argon:
"Ran it on my adversarial programming language (KillSwitch) benchmark[1]. Very significant improvement over K3. On par with Gemini 4 Argon and Fable 5.1. Much slower than both though."
Und dann sind da die Nutzungslimits, die den Thread stärker dominierten als die Modellqualität:
"Bought the $100/month subscription and hit my 5-hour limit with one prompt on default settings (max effort) in their CLI harness. It might be smart but it's unusable compared to other subscriptions right now."
Wenn Sie es über ein Kimi-Code-Abonnement nutzen möchten, reduzieren Sie den Denkaufwand, bevor Sie den Tarif beurteilen. Die API unterstützt low, high und max, wobei max die Standardeinstellung ist. Ein Kommentator, der es mit weniger aufwendigen Unteragenten betreibt, berichtete, während einer 8-Stunden-Sitzung nur 22 % eines Wochenkontingents verbraucht zu haben. Die Konfiguration verändert das Bild also erheblich.
Wie erhalten Sie Zugriff auf Kimi K3.1 Pro?
Insgesamt gibt es vier Wege. Welcher passt, hängt davon ab, was Sie entwickeln.
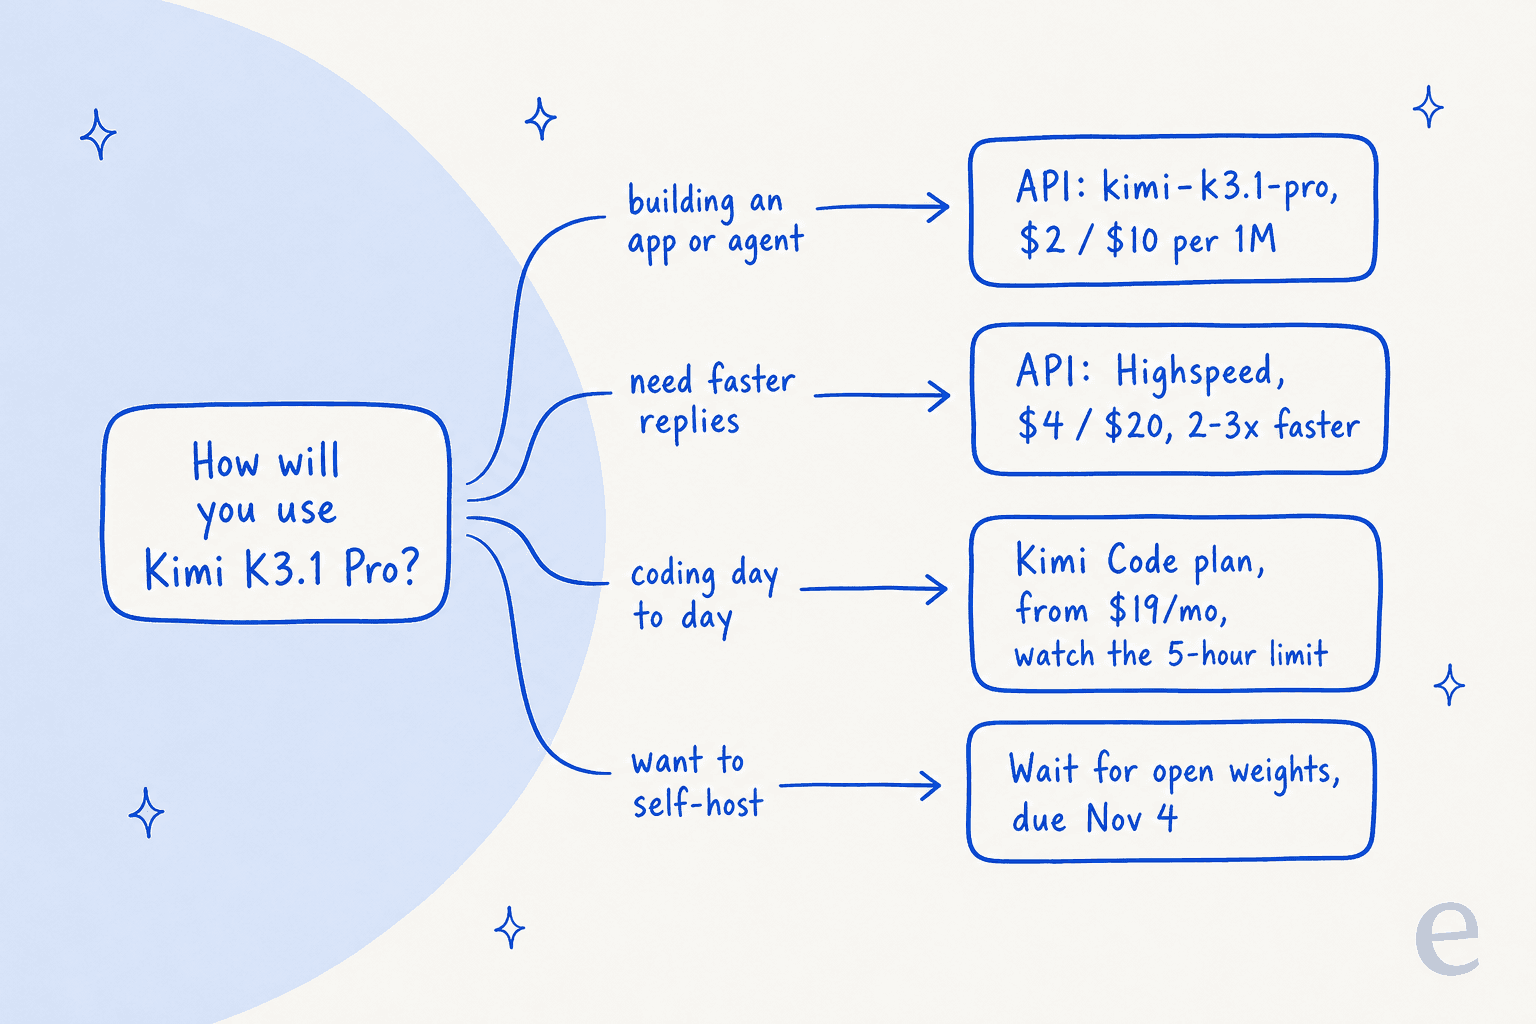
- Kimi API. Verwenden Sie die Modell-IDs
kimi-k3.1-prooderkimi-k3.1-pro-highspeedauf der Kimi API Platform. Reasoning ist immer aktiviert,reasoning_effortakzeptiertlow,highodermax, und die Ausgabe ist standardmäßig auf131,072Tokens eingestellt (einstellbar bis zu den vollen 1M). Zero Data Retention ist für API-Kunden verfügbar. - OpenRouter. Dort ist es als
moonshotai/kimi-k3.1-progelistet, vorerst mit Moonshot als einzigem Anbieter. Das ist praktisch, wenn Sie bereits zwischen Modellen routen, und auch nützlich, wenn Sie es mit einem kostenlosen KI-API-Tarif vergleichen. - Kimi Code. Sie wählen es mit
/modelaus. Das ist Moonshots eigener Coding-Agent, der auf dem Desktop, in der CLI und über IDE-Plugins läuft. Er konkurriert direkt mit Claude Code und mit Moonshots früherem Modell Kimi K2.7 Code. - Kimi-Apps und Kimi Work. Das ist der Weg für Endnutzer, einschließlich 3D Make. Kimi Work benötigt die Desktop-Version
3.1.0oder neuer. Bei Kimi Enterprise ist K3.1 Pro standardmäßig deaktiviert, Administratoren müssen es also einschalten.
Wer sollte Kimi K3.1 Pro nutzen?
Zu diesem Fazit komme ich, nachdem ich die Dokumentation, die Benchmarks und die ersten paar Hundert Entwicklerreaktionen durchgesehen habe.
Wählen Sie es, wenn Sie lange, unbeaufsichtigte Agentenaufgaben ausführen (Programmierung, Recherche, tabellenlastige Finanzaufgaben), für die Sie sonst Claude-Preise bezahlen würden, und auf die Ergebnisse warten können. Die Qualität liegt nahe an Opus, bei ungefähr einem Drittel der Ausführungskosten, und es gibt keinen Aufschlag für lange Prompts im 1M-Kontext. Es ist auch das Modell, das Sie im Auge behalten sollten, wenn Sie ein Modell der Spitzenklasse benötigen, das Sie irgendwann selbst hosten können.
Verzichten Sie darauf, wenn bei jeder Antwort eine Person wartet, denn mit 50 Tokens pro Sekunde wirken Live-Chat und schnelle Wechsel beim Programmieren träge. Sie können es auch überspringen, wenn Kosten für Sie wichtiger sind als Qualität: GPT-6.1 Sol und Gemini 4 Argon erledigen dieselben Benchmark-Aufgaben günstiger. Und wenn Sie es gegen andere offene Modelle abwägen, gelten mein Vergleich Qwen 3.8 Max vs. K3 und die Liste der Kimi-K3-Alternativen weiterhin für das breitere Feld.
Entscheidend ist, ob Ihre Aufgaben lang sind und Zeit lassen oder kurz und interaktiv sind. K3.1 Pro ist für die erste Art gebaut.
Was Kimi K3.1 Pro für Supportteams bedeutet
Viele Menschen, die Beiträge zu Veröffentlichungen wie diesen lesen, haben eine konkretere Frage im Kopf: Sollte mein Support-Agent darauf laufen? Ich halte das für die falsche erste Frage. Ein Modell wie Kimi K3.1 Pro ist ein Motor. Um damit Tickets zu beantworten, müssten Sie es weiterhin mit Ihrem Helpdesk verbinden, Ihr Hilfecenter und frühere Tickets synchronisieren, dann entscheiden, was es selbstständig tun darf und was es an einen Menschen übergibt, und es außerdem testen, bevor Kunden es jemals zu sehen bekommen. Ich habe erlebt, wie selbstsicher klingende Bots in laufenden Warteschlangen falsche Antworten gaben. Deshalb simuliert eesel jede Einführung zuerst anhand der eigenen historischen Tickets eines Teams.
Genau diese Ebene ist eesel. Sie stellen ein einsatzbereites KI-Teammitglied für den Helpdesk ein, das sich in Ihre bestehende Warteschlange in Zendesk, Freshdesk oder Gorgias einfügt, aus Ihrer Dokumentation und früheren Tickets lernt und dann den Übergaberegeln folgt, die Sie in einfachem Englisch formulieren. Wenn Sie die übergeordnete Kategorie vergleichen, erklärt mein Beitrag zu KI-Mitarbeitern den Unterschied zwischen dem Einstellen und dem Entwickeln eines Teammitglieds.

SE Ranking zeigt gut, wie das im Produktivbetrieb aussieht. Das Unternehmen betreut drei Produkte (SE Ranking, Planable und SE Visible) mit einem Zendesk-Team und einem eesel-Agenten pro Produkt. Jeder Agent durchsucht vor seiner Antwort etwa 16,800 Seiten mit Hilfecenter- und Website-Inhalten, antwortet im Live-Chat in der Sprache des Kunden und übergibt Erstattungen, Testverlängerungen und Tier-2-Fragen zusammen mit den Kundendaten an einen Menschen. Zwischen dem 8. August und dem 8. September 2026 bearbeitete es etwa 4,650 Gespräche. Nichts davon hängt davon ab, welches Modell letzte Woche zufällig am besten abgeschnitten hat.
Wenn Kimis agentenzentrierter Ansatz Sie anspricht, bringt die eesel CLI ihn in den Support. Sie können dasselbe Teammitglied über ein Terminal ausführen, zum Beispiel um seine jüngsten Aktivitäten mit eesel activity zu prüfen oder ausstehende Aktionen mit eesel approvals zu genehmigen und abzulehnen. Seine dauerhaft geltenden Regeln können Sie außerdem mit eesel instructions bearbeiten. Die Befehle geben JSON aus, und die Schreibbefehle unterstützen --dry-run. Dadurch können Skripte und Coding-Agenten wie Claude Code es steuern. Einen MCP-Server gibt es ebenfalls. Das übergeordnete Muster behandle ich in meinem Leitfaden zur KI-Agenten-CLI.
Möchten Sie das Ergebnis ohne die Modellsuche? Testen Sie eesel kostenlos mit Ihrem eigenen Helpdesk und sehen Sie, wie es mit den Tickets der letzten Woche umgeht. Oder stöbern Sie zuerst in den besten KI-Teammitgliedern, um die Optionen zu vergleichen.
Häufig gestellte Fragen
Was ist Kimi K3.1 Pro?
Kimi K3.1 Pro ist das Flaggschiff-Modell von Moonshot AI, das am 23. Oktober 2026 veröffentlicht wurde. Es nutzt dieselbe Basis mit 2.8T Parametern wie Kimi K3, mit deutlich mehr Nachtraining, einem Kontextfenster von 1M Tokens und einer schnelleren Highspeed-Variante. Es erreicht 55 Punkte im Artificial Analysis Intelligence Index und liegt damit nahe an Claude Opus 5.5.
Wie viel kostet Kimi K3.1 Pro?
Über die Kimi API kostet Kimi K3.1 Pro 2 $ pro Million Eingabe-Tokens, 0,20 $ für zwischengespeicherte Eingaben und 10 $ pro Million Ausgabe-Tokens. Die Highspeed-Version kostet 4 $ und 20 $. Das ist ein Drittel günstiger als die Preise von Kimi K3 und entspricht dem Listenpreis von Claude Sonnet 5.5.
Ist Kimi K3.1 Pro Open Source?
Noch nicht. Laut Moonshot werden die vollständigen Modellgewichte von Kimi K3.1 Pro bis zum 4. November 2026 veröffentlicht. Bis dahin ist es nur per API und App verfügbar. Bei 2.8T Parametern wird es einen Servercluster benötigen, keinen Laptop. Wenn Sie ein offenes Modell möchten, das Sie heute schon betreiben können, finden Sie die Optionen in meiner Übersicht zu Open-Source-KI-Agenten.
Ist Kimi K3.1 Pro besser als Claude Opus 5.5?
In Moonshots eigener Vergleichstabelle gewinnt Kimi K3.1 Pro 6 von 14 Benchmarks und liegt bei Terminal-Bench 4.0 um 0.7 Punkte hinter Opus 5.5. Bei Artificial Analysis erreicht es 55.1 gegenüber 57.6 Punkten. Unabhängige Tester sagen überwiegend, dass Opus im Alltag weiterhin vorne liegt, aber Kimi im Betrieb nur etwa ein Drittel so viel kostet. Mein Testbericht zu Claude Opus 5.5 beleuchtet die andere Seite.
Was ist Kimi K3.1 Pro Highspeed?
Kimi K3.1 Pro Highspeed ist dasselbe Modell, das 2 bis 3 Mal schneller bereitgestellt wird, zum doppelten Preis: 4 $ für Eingaben und 20 $ für Ausgaben pro Million Tokens. Bei Kimis Privatkundentarifen ist dafür mindestens der Pro-Tarif nötig, und das Guthaben wird doppelt so schnell verbraucht. Es ist vor allem für Chats und iterative Programmierarbeit relevant, bei denen Wartezeiten stören, etwa bei der Arbeit mit Claude Code.
Wie nutze ich Kimi K3.1 Pro in Kimi Code?
Kimi K3.1 Pro ist in Kimi Code ab dem Plus-Tarif (19 $/Monat) verfügbar. Starten Sie Kimi Code und wechseln Sie mit dem Befehl /model das Modell. Achten Sie auf das rollierende 5-Stunden-Nutzungslimit, das Tester bei maximalem Denkaufwand schnell erreichen. Weitere Optionen finden Sie in meiner Liste der KI-Programmierassistenten.
Kann ich Kimi K3.1 Pro für den Kundensupport nutzen?
Das können Sie, aber Kimi K3.1 Pro ist ein reines Modell. Die Helpdesk-Anbindung, Wissenssynchronisierung, Übergaberegeln und Tests müssten Sie also weiterhin selbst aufbauen. Seine 50 Tokens pro Sekunde sind außerdem langsam für Live-Chat. Ein einsatzbereiter Teamkollege für den KI-Kundensupport wie eesel übernimmt diese Ebene, und mein Leitfaden zum besten KI-Modell für Support-Tickets vergleicht die zugrunde liegenden Modelle.