

Ich bewerte Kimi K3.1 Pro mit 3,5 von 5: Es denkt fast so gut wie Claude Opus 5.5, erreicht 55.1 im Artificial Analysis Intelligence Index (Platz #4 von 215) und kostet 2 $ für Eingabe und 10 $ für Ausgabe pro Million Tokens. Für lange, unbeaufsichtigte Agentenaufgaben, die Sie einfach laufen lassen können, bietet es derzeit das beste Preis-Leistungs-Verhältnis nahe der Spitze der Rangliste.
Punkte verliert es dafür, wie es arbeitet, nicht dafür, wie intelligent es ist. Es ist mit etwa 50 Tokens pro Sekunde langsam, schreibt lange Antworten, die den niedrigen Preis relativieren, die offenen Modellgewichte sind "by Nov 4" versprochen, aber noch nicht verfügbar, und Kimi Code-Abonnenten berichten, dass sie ein 5-Stunden-Limit in weniger als einer Stunde aufbrauchen. Nutzen Sie es über die API für Aufgaben, die Zeit haben; verzichten Sie darauf, wenn ein Mensch auf das Ergebnis wartet.
Wenn Sie hier gelandet sind, weil Sie ein Modell für einen Support-Agenten auswählen, ist das Modell der kleinere Teil der Entscheidung. Ich entwickle die Integrationen und APIs von eesel, und nach Jahren mit KI im laufenden Helpdesk-Betrieb weiß ich: Entscheidend für die Qualität ist das Setup rund um das Modell. SamCart nutzt eesel für Freshdesk-Tickets und den Website-Chat, mit Antworten aus 280 Helpcenter-Artikeln, ohne sich jemals darum zu kümmern, welches Modell in der jeweiligen Woche eine Rangliste anführte.
Was ist Kimi K3.1 Pro?
Kimi K3.1 Pro ist das Flaggschiff-Modell von Moonshot AI und wurde am 23. Oktober 2026 veröffentlicht. Moonshot bezeichnet es in seinem Ankündigungsbeitrag als "a post-trained version of Kimi K3, with substantially larger post-training compute". Es basiert also auf derselben Grundlage mit 2.8T Parametern wie Kimi K3 (104B aktiv, Mixture of Experts), mit deutlich mehr zusätzlichem Training und einem Kontextfenster von 1M Tokens.
Es ist in der Kimi-App, Kimi Work, Kimi Code und der Kimi API verfügbar und ist jetzt das Standardmodell im Chatfenster auf kimi.com. Wenn Sie den vollständigen Überblick zur Veröffentlichung suchen (Benchmarks, den Vergleich mit K3, Zugangswege), finden Sie ihn in meiner Übersicht zu Kimi K3.1 Pro. Dieser Beitrag ist mein Urteil, im selben Format wie mein früherer Testbericht zu Kimi K3.
Wie habe ich Kimi K3.1 Pro getestet und bewertet?
Ich habe Moonshots Ankündigungsbeitrag, die API-Schnellstartanleitung und die Preisseite gelesen und anschließend die unabhängigen Ergebnisse von Artificial Analysis sowie die ersten Praxistests durchgearbeitet, einschließlich des Hacker News-Threads mit 674 Kommentaren. Das Modell ist vier Tage alt, also werde ich nicht so tun, als hätte ich es monatelang im Produktivbetrieb eingesetzt. Was ich tun kann: Es anhand der Dinge bewerten, die darüber entscheiden, ob es sich lohnt, darauf aufzubauen.
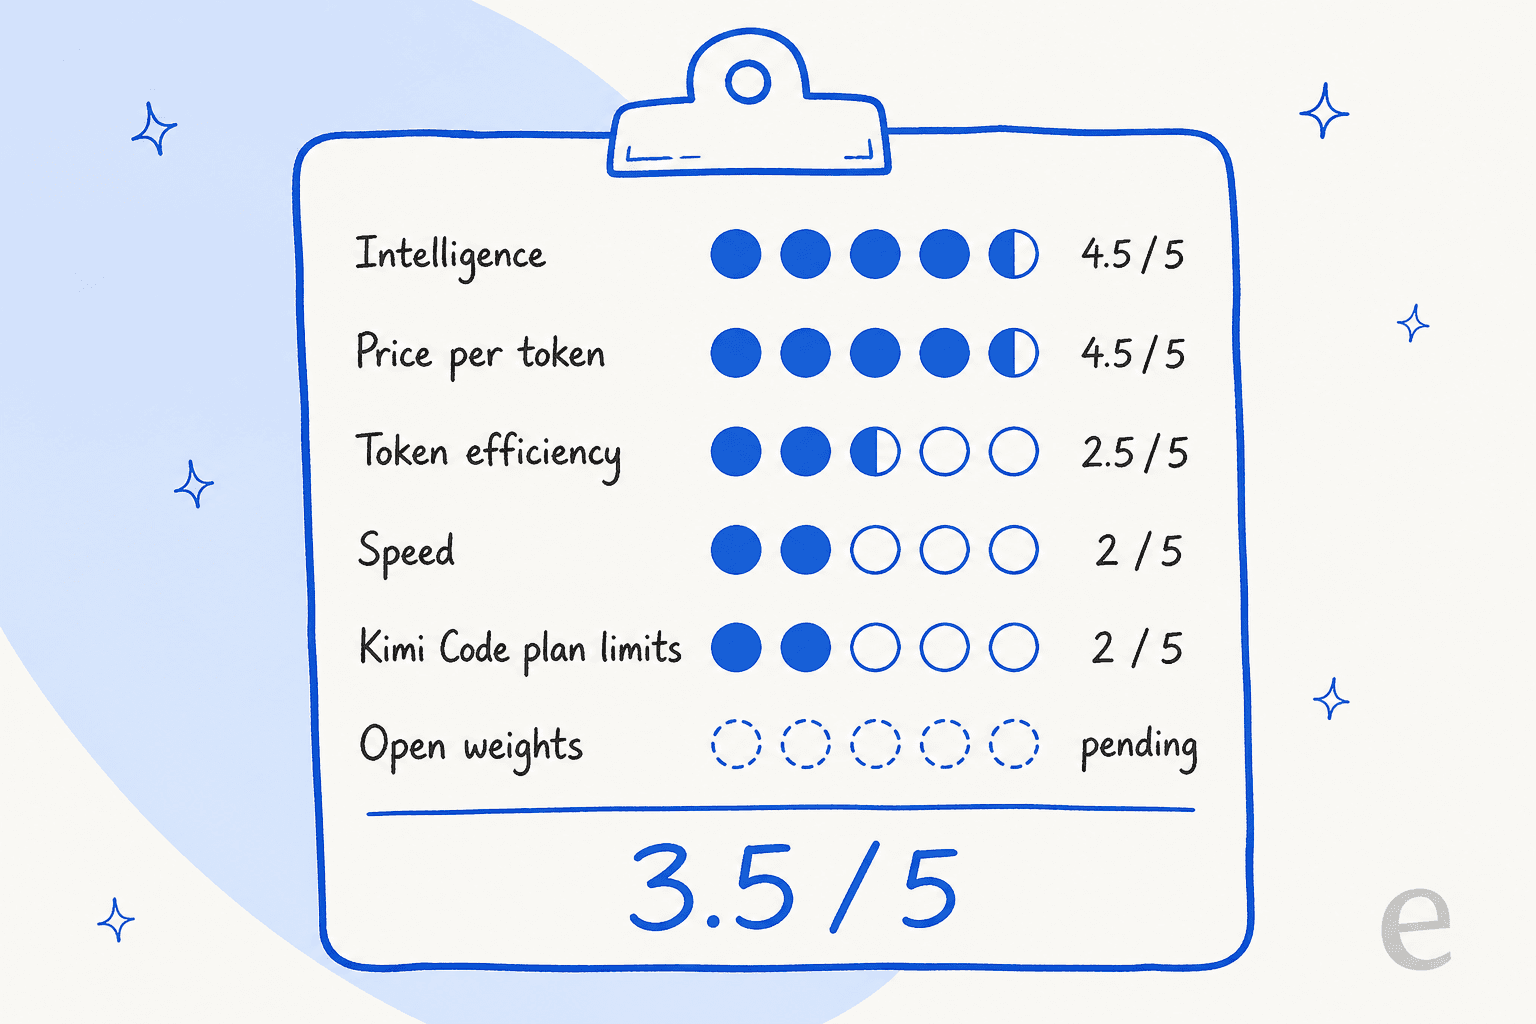
| Kategorie | Bewertung | Begründung |
|---|---|---|
| Intelligenz | 4,5/5 | 55.1 im AA-Index, 2.5 Punkte hinter Opus 5.5 (Max) |
| Preis pro Token | 4,5/5 | 2 $ / 10 $, ein Drittel günstiger als K3, kein Aufpreis für lange Kontexte |
| Token-Effizienz | 2,5/5 | 150M Ausgabe-Tokens für den AA-Index gegenüber einem Median vergleichbarer Modelle von 87M |
| Geschwindigkeit | 2/5 | 49.7 Tokens pro Sekunde, Rang 165 von 182 |
| Tariflimits von Kimi Code | 2/5 | Mehrere Abonnenten berichten, dass sie das 5-Stunden-Limit in weniger als einer Stunde erreichen |
| Offene Modellgewichte | Ausstehend | Bis zum 4. November versprochen, am 27. Oktober noch nicht veröffentlicht |
| Gesamt | 3,5/5 | Starker Motor, aber einige Ecken und Kanten bei der Nutzung |
Wo liegen die Stärken von Kimi K3.1 Pro?
Die Kurzfassung: Noch nie ist ein Labor außerhalb der USA der Spitze der Rangliste so nahe gekommen, und das zu einem Preis im Mittelfeld. Hier zeigt sich das.
Reasoning fast auf Spitzenniveau für 2 $ und 10 $
Bei Artificial Analysis erreicht K3.1 Pro 55.1, gegenüber 57.6 für Claude Opus 5.5 (Max) und 56.0 für Claude Sonnet 5.5 (Max). Es liegt vor GPT-6 Astra (Max) mit 52.7 und Gemini 4 Argon (High) mit 52.6. In derselben Version des Index erreicht Kimi K3 43.6. Diese Veröffentlichung bedeutet also einen Sprung um mehr als 11 Punkte auf Basis desselben Grundmodells.
Interessant wird das durch den Preis. K3.1 Pro kostet laut Kimi API 2 $ für Eingabe, 0,20 $ für zwischengespeicherte Eingabe und 10 $ für Ausgabe pro Million Tokens. Das ist ein Drittel weniger als die Preise von Kimi K3 und derselbe Listenpreis wie bei Sonnet 5.5. Es durchlief den vollständigen Artificial Analysis-Index für $3,117, gegenüber $8,708 für Opus 5.5 (Max).
Lange Agentenaufgaben und Büroarbeit
Hier zeigt sich das zusätzliche Training. Artificial Analysis maß 67.2% bei Terminal-Bench 4.0, den höchsten Wert aller auf seiner K3.1 Pro-Seite dargestellten Modelle, gegenüber 12.6% für K3. In Moonshots eigenen Tests liegt es bei SWE Marathon (51.7 gegenüber 46.3 für Opus 5.5) und OfficeQA Pro v2 (64.4 gegenüber 62.2), einem Benchmark für Finanz- und Bürodokumente, vorn.
Es erfindet auch weniger als K3. In Moonshots internem Hallu Bench sank die Halluzinationsrate auf Aussageebene bei schwierigen Fragen mit Tools von 23.4% auf 8.3%. Das ist Moonshots eigener Test, deshalb gewichte ich ihn nicht stark, aber der unabhängige Wert weist in dieselbe Richtung: Die Halluzinationsrate von AA beträgt 43.9% für K3.1 Pro gegenüber 53.2% für K3 und 58.6% für Opus 5.5 (Max).
Die ersten Praxisberichte passen dazu. Ein Entwickler wechselte direkt von K3:
"Using it now via API (3.1 Pro on Open Router) in a HITL setup (Cline in VSCode). Off-hand it's quite good. I've been using K3 for the past few months almost exclusively for coding work and have been stunned by how good it is. Excited to see how far 3.1 Pro can be pushed."

Ein Kontextfenster von 1M mit einheitlichen Preisen
Laut Schnellstartanleitung hat K3.1 Pro einheitliche nutzungsbasierte Preise ohne Staffelung nach Kontextlänge. Ein Prompt mit 900.000 Tokens kostet pro Token also genauso viel wie ein kurzer. Zwischengespeicherte Eingaben werden mit 0,20 $ pro Million abgerechnet, einem Rabatt von 90 %, mit einem standardmäßigen 5-Minuten-Cache und einer optionalen 1-Stunden-Stufe. Für Agenten, die bei jedem Durchgang eine große Codebasis oder einen langen Vertrag erneut lesen, summiert sich das zu einer echten Ersparnis.
Wo hat Kimi K3.1 Pro Schwächen?
Alles, was Punkte gekostet hat, liegt rund um das Modell, nicht im Modell selbst. Diese fünf Probleme würden beeinflussen, ob ich heute darauf aufbauen würde.
Es ist langsam
Artificial Analysis maß 49.7 Ausgabe-Tokens pro Sekunde über Moonshots eigene API, Rang 165 von 182, und bezeichnete es als "notably slow". Die durchschnittliche Aufgabe im Benchmark-Index dauerte 1,011 Sekunden, etwa 17 Minuten. Moonshots Lösung ist Kimi K3.1 Pro Highspeed, das laut Anbieter mit "2-3× the speed" zum exakt doppelten Preis (4 $ / 20 $) läuft.
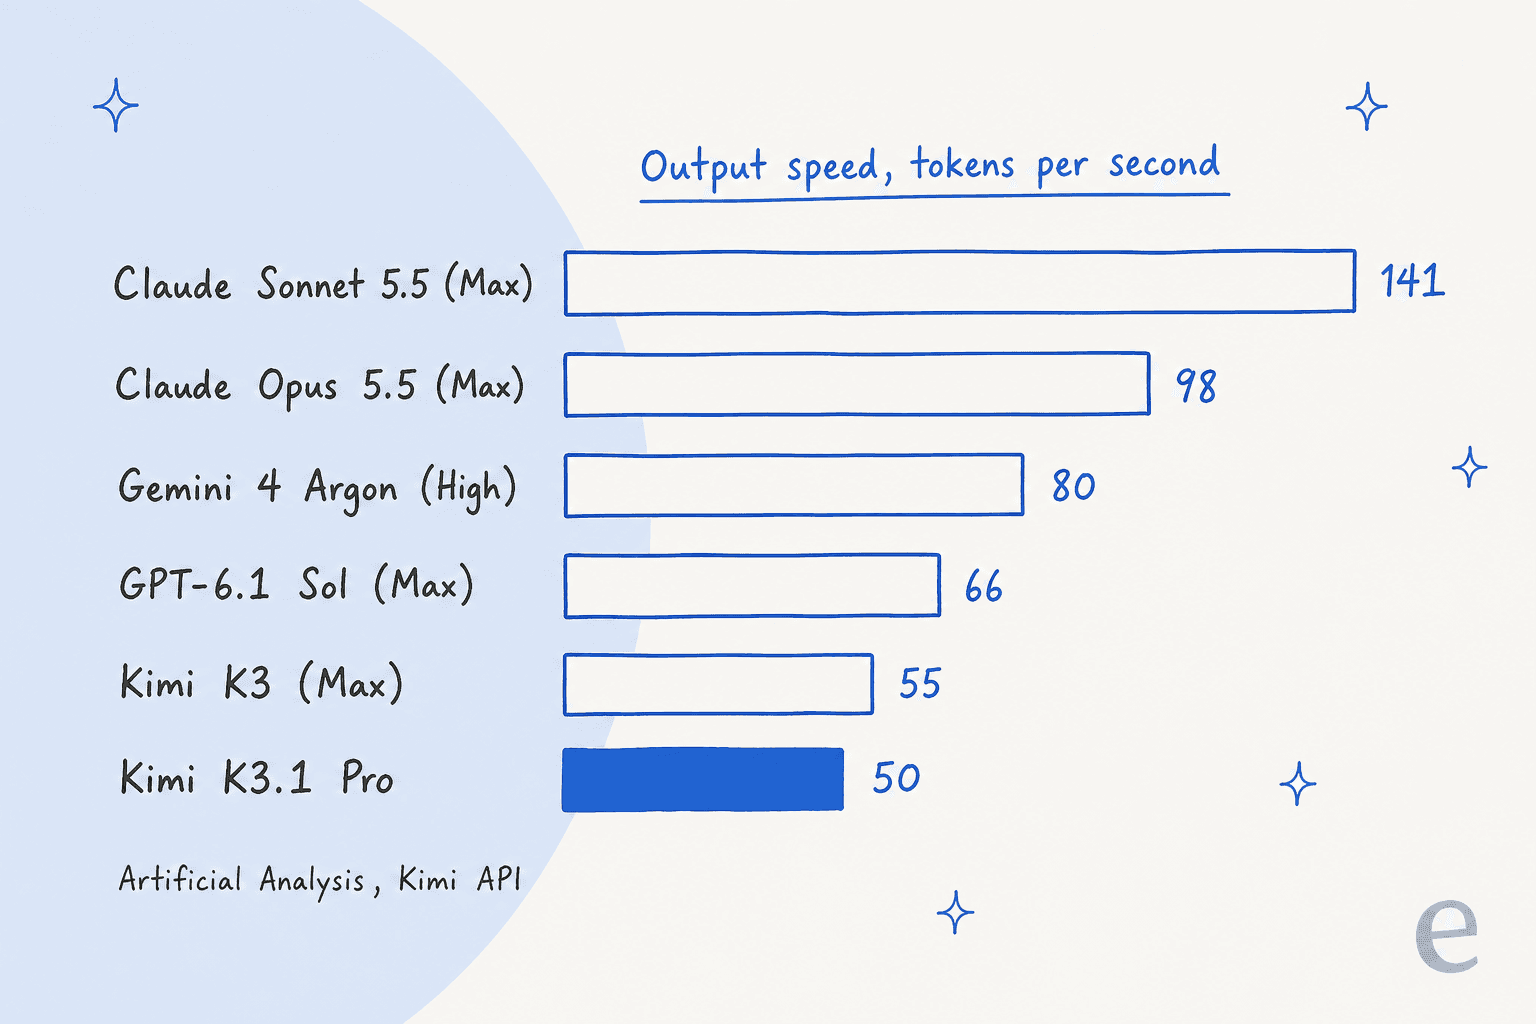
Sonnet 5.5 kostet pro Token genauso viel und streamt fast dreimal schneller. Bei einem Batch-Job, der über Nacht läuft, spielen 50 Tokens pro Sekunde keine Rolle. Bei einem Chatfenster, auf das ein Mensch starrt, schon.
Es schreibt viel
K3.1 Pro benötigte 150M Ausgabe-Tokens für den Artificial Analysis-Index, gegenüber einem Median vergleichbarer Modelle von 87M. Der Großteil davon entfällt auf Reasoning: durchschnittlich 34,883 Reasoning-Tokens pro Aufgabe. Der Rabatt pro Token schlägt sich daher nicht vollständig in der Rechnung nieder. Pro Aufgabe lag der Durchschnitt bei $2.11 gegenüber $2.00 für K3, obwohl K3 laut Liste 3 $ / 15 $ kostet. Diese Rechnung schlüssle ich im Beitrag zu den Preisen von Kimi K3.1 Pro auf.
"So their base price is 1/5th of Opus 5.5 per token, but if you want "highspeed" it's 2x that and then I guess it generates 2x the number of tokens as well? That might suggest that Opus is competitively priced after all."
Ihr Stellhebel ist reasoning_effort. Die API unterstützt low, high und max, und die API-Schlüsselseite nennt max als Standard. Jeder oben genannte Benchmark-Wert wurde mit max ermittelt. Wenn Sie den Aufwand reduzieren, tauschen Sie also Bewertungspunkte gegen weniger Tokens.
Die Limits von Kimi Code sind schnell aufgebraucht
Die lauteste Beschwerde im Thread zur Veröffentlichung betrifft nicht die Qualität, sondern das Kontingent. Kimis Kimi Code-Seite nennt Plus für 19 $, Pro für 39 $, Max für 99 $ und Ultra für 199 $ pro Monat. Highspeed erfordert Pro oder höher und verbraucht doppelt so viele Credits. Die neuen Tarife behalten ein rollierendes 5-Stunden-Fenster sowie einen monatlichen Credit-Pool bei, der mit der Kimi-App geteilt wird.
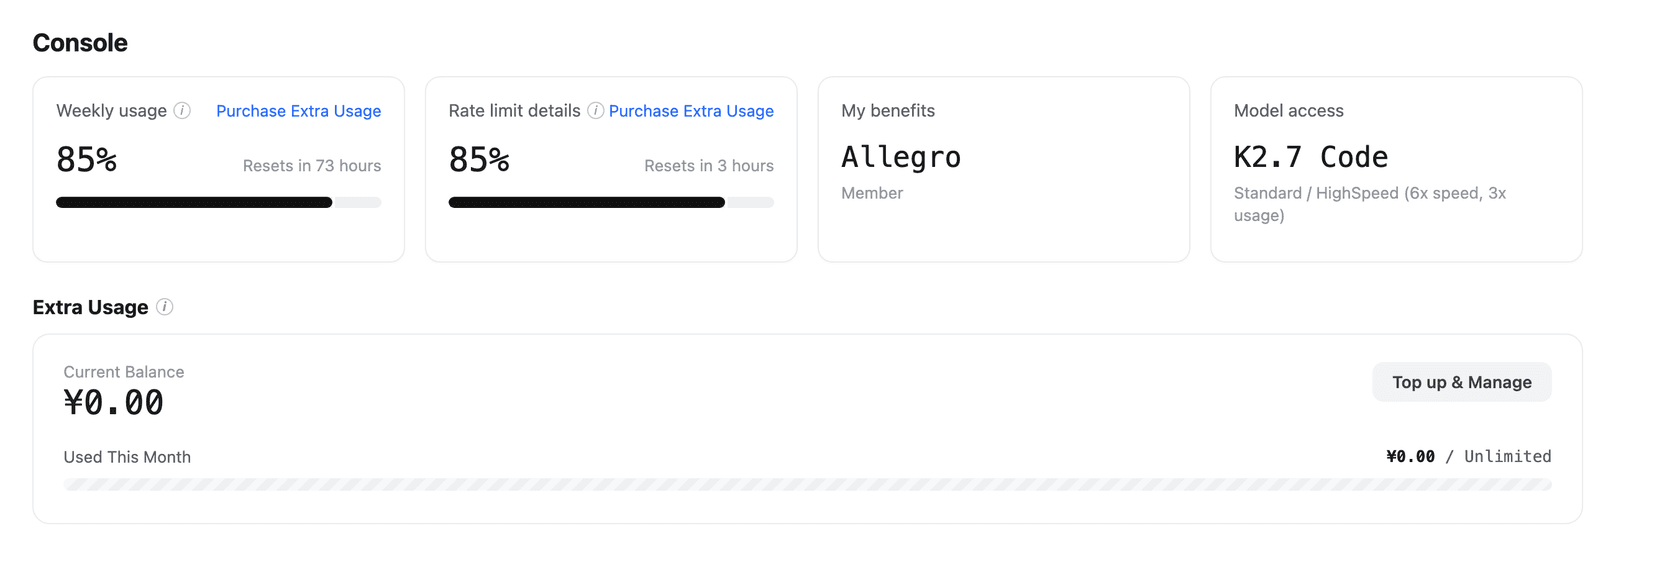
"If you are expecting any sort of usable limits on their subscription plan I suggest adjusting your expectations. I subscribed to $99 a month plan and within 47 minutes with one session (not asking for swarms or anything) was limited by 5-hour quota."
Nicht alle stießen an die Grenze, und der standardmäßig maximale Reasoning-Aufwand trägt dazu bei, weil er Tokens schneller verbraucht. Wenn Sie aber von Claude Code kommen und denselben Spielraum pro Dollar erwarten, testen Sie den Monatstarif eine Woche lang, bevor Sie für ein Jahr bezahlen.
Die Modellgewichte sind noch nicht verfügbar
Moonshot nennt K3.1 Pro sein "most capable 3T-class open-weight model", und sowohl der Blog als auch die Schnellstartanleitung sagen, dass die vollständigen Modellgewichte bis zum 4. November veröffentlicht werden. Am 27. Oktober lieferte die Hugging Face-Modell-API kein K3.1-Repository unter Moonshots Konto zurück, und Artificial Analysis führt die Lizenz vorerst als proprietär.
Das ist aus zwei Gründen wichtig. Sie können es noch nicht selbst hosten oder feinabstimmen, und nur Moonshot stellt es bereit: Der OpenRouter-Eintrag zeigt zwei Endpunkte, beide von Moonshot selbst. Artificial Analysis zählt 5 API-Anbieter für K3.1 Pro gegenüber 20 für K3. Selbst wenn die Modellgewichte verfügbar sind, braucht ein Modell mit 2.8T Parametern einen Servercluster, keine Workstation.
Einige besonders hervorgehobene Benchmarks sind intern
Mehrere der stärksten Aussagen von Moonshot stammen aus internen Tests: Kimi Code Bench, Hallu Bench, die Finanz-Benchmarks und die Cyber-Evaluierung. Die Coding-Benchmarks wurden in der Claude Code-Testumgebung durchgeführt, was ein X-Konto mit großer Reichweite am Tag der Veröffentlichung hinterfragte. Die unabhängigen Zahlen von Artificial Analysis sind weiterhin stark, deshalb halte ich die Benchmarks nicht für substanzlos. Ich würde nur zuerst den unabhängigen vertrauen.
Wie schneidet Kimi K3.1 Pro im Vergleich mit Claude, GPT und Gemini ab?
Alle folgenden Zahlen stammen von der K3.1 Pro-Seite von Artificial Analysis, gemessen über die jeweilige API des Herstellers. Sie lassen sich also direkt miteinander vergleichen.
| Modell | AA-Index | Preis Eingabe / Ausgabe (pro 1M) | Geschwindigkeit (Tokens/s) | Kosten pro Aufgabe | Kosten für den Index-Durchlauf | Terminal-Bench 4.0 |
|---|---|---|---|---|---|---|
| Claude Opus 5.5 (Max) | 57.6 | 4 $ / 20 $ | 98.1 | $5.98 | $8,708 | 59.6% |
| Claude Sonnet 5.5 (Max) | 56.0 | 2 $ / 10 $ | 141.3 | $5.46 | $7,260 | 63.6% |
| Kimi K3.1 Pro | 55.1 | 2 $ / 10 $ | 49.7 | $2.11 | $3,117 | 67.2% |
| Claude Fable 5.1 (Max) | 53.4 | 10 $ / 50 $ | 69.8 | $7.63 | $13,129 | 52.0% |
| GPT-6 Astra (Max) | 52.7 | 10 $ / 50 $ | 66.7 | $3.26 | $5,324 | 59.1% |
| Gemini 4 Argon (High) | 52.6 | 2 $ / 10 $ | 79.7 | $1.62 | $2,101 | 57.1% |
| GPT-6.1 Sol (Max) | 51.8 | 2 $ / 10 $ | 65.9 | $0.72 | $1,082 | 56.1% |
| DeepSeek V4.1 Flash 1017 (Max) | 45.1 | 0,30 $ / 1,20 $ | 169.3 | $0.26 | $445 | 33.8% |
| Kimi K3 (Max) | 43.6 | 3 $ / 15 $ | 54.5 | $2.00 | $3,658 | 12.6% |
Zwei Dinge fallen auf. Erstens ist K3.1 Pro unter den Modellen mit 55 oder mehr Punkten im Betrieb mit Abstand am günstigsten. Zweitens ist es insgesamt nicht das günstigste intelligente Modell: GPT-6.1 Sol und Gemini 4 Argon liegen nur drei oder vier Punkte dahinter, bei einem Bruchteil der Kosten pro Aufgabe. Die Stärke von K3.1 Pro ist „fast auf Claude-Niveau, bei einem Drittel der Claude-Rechnung“, nicht „das günstigste Modell, das funktioniert“.
Was den subjektiven Eindruck betrifft, sind sich die Praxistester weitgehend einig, dass Opus noch einen Vorsprung hat, den die Benchmarks nicht erfassen:
"I feel Opus still nails the subtle details better, like in the tractor example below. But I wonder if it matters when you can run Kimi 3x before it costs the same as one Opus?"
"TLDR: Kimi is a good model, especially for visual work, but I still find Opus 5.5 more useful for general-purpose tasks and white-collar work."
Wenn Sie es gezielt gegen andere offene Modelle abwägen, beschreiben meine Vergleiche Qwen 3.8 Max vs. K3 und DeepSeek V4 Flash vs. K3 weiterhin das breitere Feld. Die Liste der Alternativen zu Kimi K3 ist eine gute erste Vorauswahl.
Wie lässt es sich mit der Kimi K3.1 Pro API entwickeln?
Aus Integrationssicht, also dem Bereich, mit dem ich mich täglich beschäftige, ist es eine saubere API mit ein paar Stolperfallen. Die Modell-IDs sind kimi-k3.1-pro und kimi-k3.1-pro-highspeed, und die Dokumentation behandelt Streaming, Bildeingaben, Tool-Aufrufe, strukturierte Ausgaben und eine Funktion namens "Dynamic tool loading".
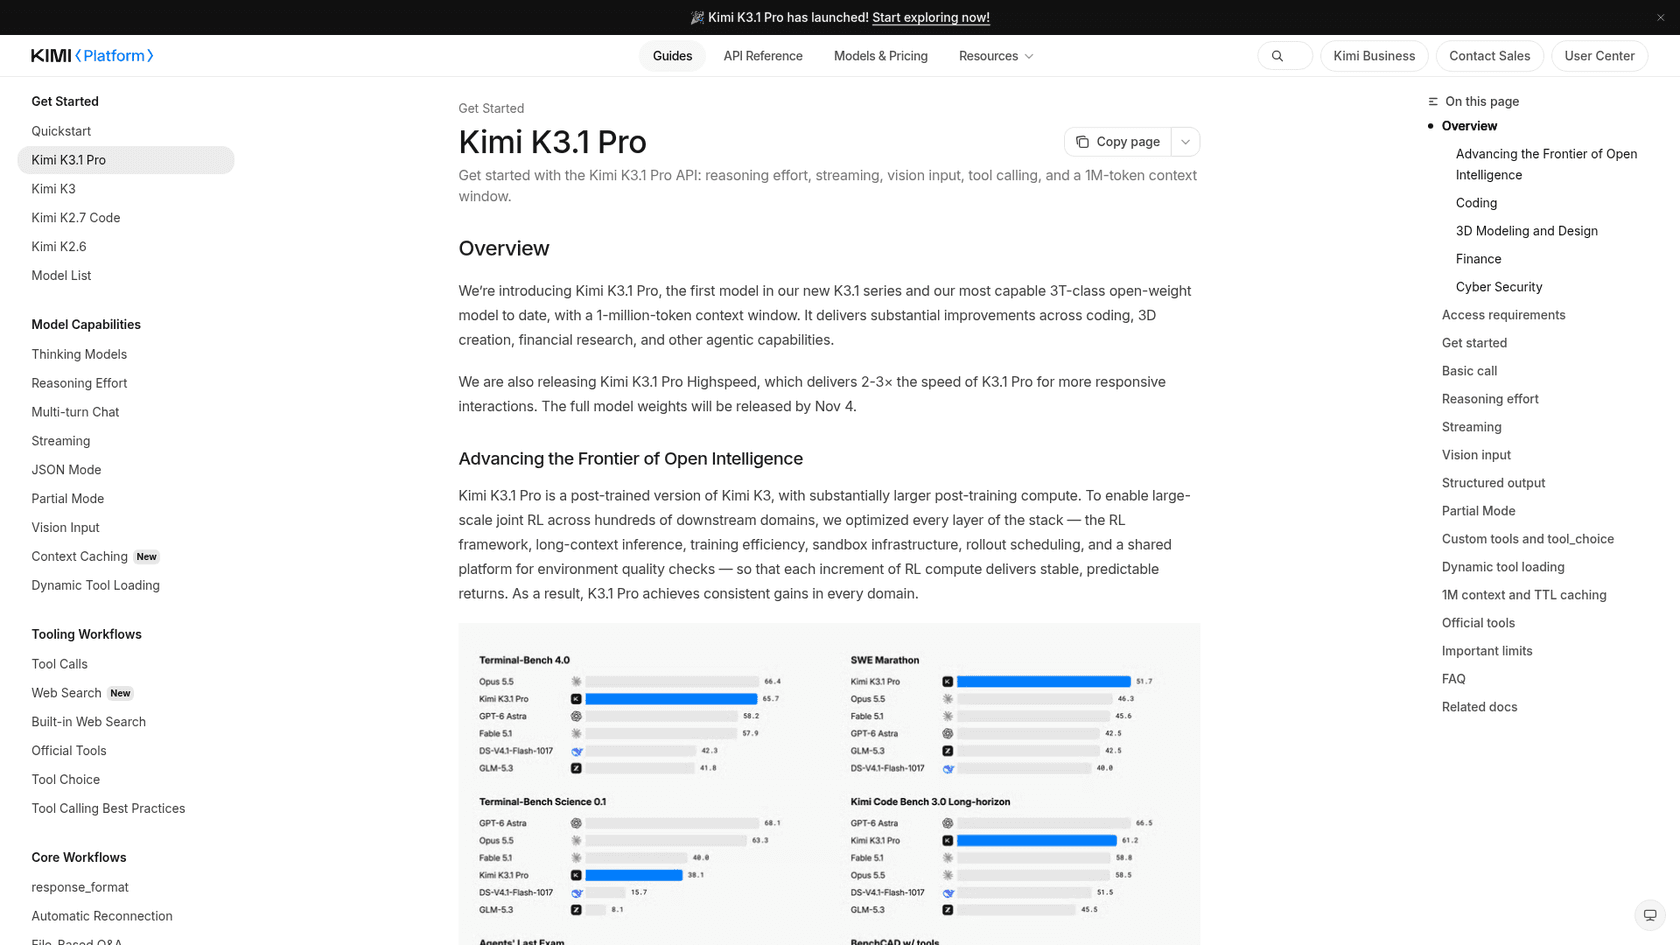
Was ich wissen möchte, bevor ich eine Zeile Code schreibe:
- Der Zugang wird nach einer Aufladung von 1 $ freigeschaltet, und Ihr Ratenlimit hängt davon ab, wie viel Sie insgesamt aufgeladen haben. Auf der 1 $-Stufe erhalten Sie
3Anfragen pro Minute; laut Seite zu den Ratenlimits benötigen Sie insgesamt$10, um100RPM zu erreichen. - Für K3.1 Pro gibt es keinen Batch-Rabatt. Kimis Batch-API kostet 60 % des Standardpreises, gilt aber nur für Modelle der K2-Serie.
- Reasoning ist immer aktiviert, und
max_completion_tokenssteht standardmäßig auf131,072. Planen Sie Budget für lange Antworten ein. - Zero Data Retention ist verfügbar, laut Ankündigungsbeitrag für API-Kunden.
- Die K2-Modelle werden eingestellt. Neue Nutzer verlieren ab dem 31. Oktober 2026 den Zugang zu K2, und alle K2-Modelle sollen bis Ende Dezember abgeschaltet werden. Wenn Sie also Kimi K2.7 Code nutzen, steht ohnehin ein Wechsel an.
Wenn Sie vor allem ein leistungsfähiges Modell suchen, um für wenig Geld Prototypen zu entwickeln, lohnt sich ein Blick auf meine Übersicht kostenloser KI-APIs, bevor Sie irgendwo Guthaben aufladen.
Wer sollte Kimi K3.1 Pro nutzen?
Wählen Sie es, wenn Sie lange, unbeaufsichtigte Aufgaben ausführen, bei denen Qualität zählt und niemand wartet: agentengestützte Coding-Durchläufe, Rechercheberichte, tabellenlastige Finanzarbeit, Dokumentenverarbeitung über riesige Kontexte hinweg. Sie erhalten nahezu Opus-Qualität für etwa ein Drittel der Ausführungskosten, ohne Aufpreis für lange Kontexte.
Verzichten Sie darauf, wenn ein Mensch auf jede Antwort wartet. Bei 50 Tokens pro Sekunde fühlen sich Live-Chat und schnelle Coding-Dialoge träge an, und Highspeed verdoppelt den Preis, um das zu beheben. Verzichten Sie auch darauf, wenn Kosten Ihre oberste Priorität sind: GPT-6.1 Sol und Gemini 4 Argon erledigen dieselben Benchmark-Aufgaben günstiger. Und wenn Sie Modellgewichte brauchen, die Sie heute selbst betreiben können, bleiben Sie bei K3, bis der 4. November zeigt, dass Moonshot sein Versprechen hält.
Der entscheidende Faktor ist Geduld. K3.1 Pro ist für Arbeit gebaut, die Sie starten und dann sich selbst überlassen.
Sollte ein Support-Team seinen KI-Agenten mit Kimi K3.1 Pro betreiben?
Diese Frage kommt jedes Mal auf, wenn ein neues Modell eine Rangliste anführt, und ich halte sie für die falsche erste Frage. Kimi K3.1 Pro ist Infrastruktur. Um damit ein einziges Ticket zu beantworten, müssten Sie es immer noch mit Ihrem Helpdesk verbinden, Ihr Helpcenter und frühere Tickets synchronisieren, entscheiden, was es allein erledigt und was es an einen Menschen übergibt, und es testen, bevor ein Kunde eine Antwort sieht. eesel ist der Mitarbeiter, der auf solchen Modellen aufsetzt.
Das Geschwindigkeitsproblem trifft den Support außerdem härter als die meisten anderen Anwendungsfälle. Ein Kunde im Chat wartet nicht, während ein Modell 35.000 Reasoning-Tokens schreibt. Im Support schlägt ein schnelles Modell mit gutem Informationsabruf meist ein intelligenteres, langsameres.
Und falsche Antworten im Support kommen meistens nicht vom Modell. Ein Beispiel aus den eigenen Vertriebsgesprächen von eesel: Ein Support-Team für Fahrzeugtelematik auf Zendesk beobachtete, wie sein Bot Kunden für nicht unterstützte Marken "yes, we support your car model" sagte, weil in der Wissensdatenbank "we support all models" stand. Kein Sprung in einer Rangliste behebt das. Was hilft, ist, Halluzinationen zu stoppen, und zwar auf der Wissensebene, sowie den Agenten vor dem Start anhand echter früherer Tickets zu simulieren. Deshalb prüft eesel jede Einführung zuerst anhand der bisherigen Tickets eines Teams.
Um diese Ebene kümmert sich der KI-Helpdesk-Teamkollege von eesel. SamCart zeigt, wie das in der Praxis aussieht. Das Unternehmen nutzt eesel für seine Freshdesk-Tickets und seinen Website-Chat, mit einem separaten Agenten für jeden Kanal. Beide antworten auf Grundlage derselben 280 Artikel im Helpcenter. In Freshdesk sendet der Agent die erste Antwort nur, solange kein Mensch zugewiesen ist, zieht sich zurück, sobald ein Teammitglied das Ticket übernimmt, und markiert das Ticket für die Übergabe, wenn ein Verkäufer nach einem Menschen fragt. Im Workspace laufen inzwischen 4 Agenten, darunter einer für ein zweites Produkt, das SamCart 2026 eingeführt hat.
Wenn Sie an Tools wie Kimi Code der Ansatz anspricht, bei dem Agenten und Terminal im Mittelpunkt stehen, bringt die eesel CLI genau das in den Support. Sie steuern denselben Teamkollegen über ein Terminal: eesel activity, um zu prüfen, was er getan hat, eesel approvals, um ausstehende Aktionen zu genehmigen oder abzulehnen, eesel instructions, um seine dauerhaften Regeln zu bearbeiten. Die Befehle geben JSON aus, und schreibende Befehle unterstützen --dry-run, sodass Skripte und Coding-Agenten ihn sicher steuern können. Außerdem gibt es einen MCP-Server. In meinem Leitfaden zur KI-Agenten-CLI gehe ich näher darauf ein.
Testen Sie eesel
Wenn Sie nach einem Modell suchen, weil KI die Anfragen in Ihrem Helpdesk beantworten soll, überspringen Sie einen Schritt. Der KI-Helpdesk-Teamkollege von eesel lässt sich mit Freshdesk, Zendesk oder Gorgias verbinden, lernt aus Ihrem Helpcenter und früheren Tickets und zeigt Ihnen, wie er die Tickets des letzten Monats beantwortet hätte, bevor er ein laufendes Ticket anfasst.
Testen Sie eesel kostenlos mit Ihren eigenen eingehenden Tickets, oder vergleichen Sie es zuerst mit den anderen besten KI-Teamkollegen. Wenn Sie noch überlegen, ob Sie eine KI einstellen oder selbst entwickeln sollen, erklärt mein Beitrag zum KI-Mitarbeiter den Unterschied.
Häufig gestellte Fragen
Ist Kimi K3.1 Pro gut?
Ja, für die richtige Aufgabe. In meinem Test von Kimi K3.1 Pro vergebe ich 3,5 von 5: Es erreicht 55.1 im Artificial Analysis Intelligence Index, nahe an Claude Opus 5.5, für 2 $/10 $ pro Million Tokens. Punktabzug gibt es für die langsame Ausgabe, lange Antworten und Tariflimits in Kimi Code. Der Überblick zu Kimi K3.1 Pro behandelt die Veröffentlichung ausführlich.
Ist Kimi K3.1 Pro besser als Claude Opus 5.5?
Insgesamt nicht. Opus 5.5 (Max) erreicht bei Artificial Analysis 57.6 gegenüber 55.1 und läuft etwa doppelt so schnell. Kimi K3.1 Pro punktet bei den Kosten: Es durchlief den gesamten Benchmark-Index für 3.117 $ gegenüber 8.708 $ für Opus 5.5 (Max). Mein Test von Claude Opus 5.5 beleuchtet die andere Seite dieses Vergleichs.
Wie viel kostet Kimi K3.1 Pro?
Über die Kimi API kostet es 2 $ pro Million Eingabe-Tokens, 0,20 $ für zwischengespeicherte Eingaben und 10 $ pro Million Ausgabe-Tokens. Die Highspeed-Version kostet 4 $ und 20 $. Die Tarife der Kimi-App reichen von 19 $ bis 199 $ pro Monat. Die vollständige Aufschlüsselung finden Sie in meinem Preisleitfaden zu Kimi K3.1 Pro.
Warum ist Kimi K3.1 Pro so langsam?
Artificial Analysis hat über die Kimi API 49.7 Ausgabe-Tokens pro Sekunde gemessen, Rang 165 von 182. Außerdem schreibt es lange Gedankengänge, bevor es antwortet. Eine durchschnittliche Benchmark-Aufgabe dauerte etwa 17 Minuten. Kimi K3.1 Pro Highspeed ist 2-3x schneller zum doppelten Preis. Wenn Geschwindigkeit am wichtigsten ist, liefert Claude Sonnet 5.5 141 Tokens pro Sekunde zum gleichen Listenpreis.
Ist Kimi K3.1 Pro Open Source?
Noch nicht. Laut Moonshot werden die vollständigen Gewichte bis zum 4. November 2026 veröffentlicht, aber am 27. Oktober gab es weder ein Hugging Face-Repository noch eine Lizenz. Kimi K3 ist das offene Modell, das Sie heute herunterladen können, und meine Liste der Open-Source-KI-Agenten stellt weitere Optionen vor.
Lohnt sich Kimi K3.1 Pro fürs Programmieren?
Für lange, unbeaufsichtigte Programmieraufgaben ja: Es erreichte 67,2 % auf Terminal-Bench 4.0 bei Artificial Analysis und 51.7 auf SWE Marathon in den Tests von Moonshot. Beim Live-Pair-Programming steht die langsame Ausgabe im Weg, und Nutzer von Kimi Code berichten, dass sie schnell an das 5-Stunden-Limit stoßen. Vergleichen Sie es mit Claude Code, bevor Sie ein Abo abschließen.
Kann ich Kimi K3.1 Pro für einen KI-Agenten im Kundensupport verwenden?
Das können Sie, aber das Modell ist der kleinere Teil der Arbeit. Sie brauchen weiterhin eine Helpdesk-Anbindung, Übergaberegeln und Tests anhand bisheriger Tickets, und bei 50 Tokens pro Sekunde würden sich Antworten im Live-Chat langsam anfühlen. Ein fertiger KI-Helpdesk-Agent wie eesel übernimmt diese Ebene für Sie. So setzt SamCart erste Antworten auf Freshdesk um.