

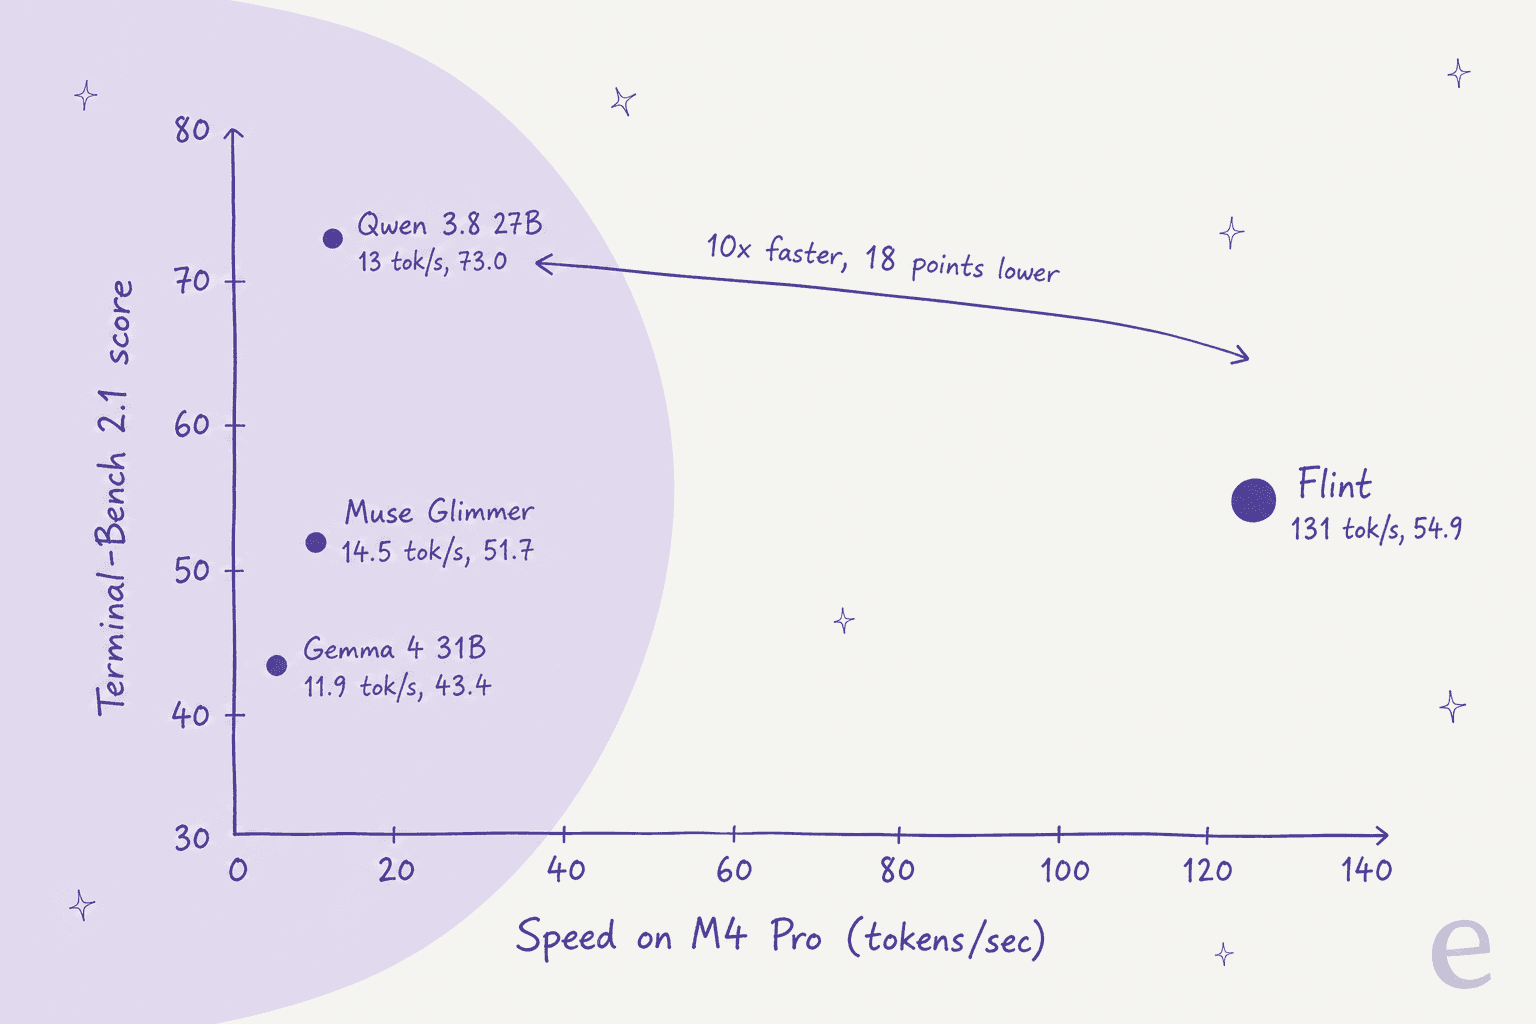
Recursive Flint ist das schnellste Coding-Modell, das du heute auf einem Laptop laufen lassen kannst, und es ist kostenlos, aber es ist nicht das beste. Auf einem M4-Pro-MacBook schreibt es 131 Tokens pro Sekunde, ungefähr 10x so viel wie das dichte Qwen 3.8 27B, während Qwen 3.8 es in Recursives eigenem Diagramm bei vier von sechs Coding-Benchmarks trotzdem schlägt, bei Terminal-Bench 2.1 um 18 Punkte.
Meine Bewertung: 3,5/5. Nimm Flint, wenn du einen Offline-Coding-Agenten unter Apache 2.0 willst, der mit dir Schritt hält, und bereit bist, Arbeit in kleine, explizite Schritte zu zerlegen. Lass es, wenn du das stärkste lokale Modell pro Antwort brauchst oder eine Tool-Schleife, die nie hakt: Auf dem kostenlosen Endpunkt von OpenRouter schlagen derzeit 17,74 % der Tool-Aufrufe fehl.
Wenn du eigentlich einen Agenten brauchst, der eine Support-Queue abarbeitet statt eine Codebasis, ist ein rohes Modell die falsche Ebene. Der KI-Helpdesk-Teammate von eesel ist der Mitarbeiter über Modellen wie diesem, und dein Coding-Agent kann ihn mit der eesel CLI vom Terminal aus steuern.
Was ist Recursive Flint?
Recursive Flint ist ein Mixture-of-Experts-Coding-Modell mit 40B Parametern, das pro Token etwa 2,5B Parameter aktiviert und am 21. Oktober 2026 von Recursive veröffentlicht wurde. Es nimmt Text entgegen, gibt Text aus, hat dauerhaft aktives Reasoning und Tool-Aufrufe und ist für eine einzige Aufgabe gebaut: einen Coding-Agenten antreiben, der ein Repo liest, Dateien bearbeitet und Tests ausführt. Stell es dir als Motor unter einer agentischen Coding-CLI vor, nicht als Chat-App.
Recursive ist das Labor von Richard Socher, der auch CEO von You.com ist. Sein erklärtes Ziel ist „rekursiv selbstverbessernde Superintelligenz", und Flint ist der erste öffentliche Test des Systems, das dorthin führen soll: die Eureka Machine, eine automatisierte Forschungsschleife, die Ideen vorschlägt, umsetzt, testet und auswählt, was als Nächstes probiert wird. Recursive sagt, ein kleines Team aus Menschen und Agenten habe Flint in unter vier Monaten von Grund auf gebaut, wobei die Eureka Machine an Daten, Trainingsrezepten, Quantisierung und Kernels gearbeitet habe.
Ich baue die Integrationen und APIs hinter den Agenten von eesel, das heißt, ich verbringe die meiste Woche damit, Modelle in Tool-Schleifen einzubinden und zu beobachten, wo sie brechen. Das ist die Brille für diesen Test. Ich habe die Model Card, Recursives Docs, das rec-Engine-Repo und die Live-Statistiken von OpenRouter gelesen und Flint an dem gemessen, was ein Coding-Modell tatsächlich leisten muss: eine mehrstufige Aufgabe abschließen, ohne dass du daneben sitzen musst.
Die wichtigsten Spezifikationen direkt aus der Model Card:
| Spezifikation | Recursive Flint |
|---|---|
| Gesamtparameter | 39,8B |
| Aktiv pro Token | ~2,5B (etwa 2,2B ohne den Output-Head) |
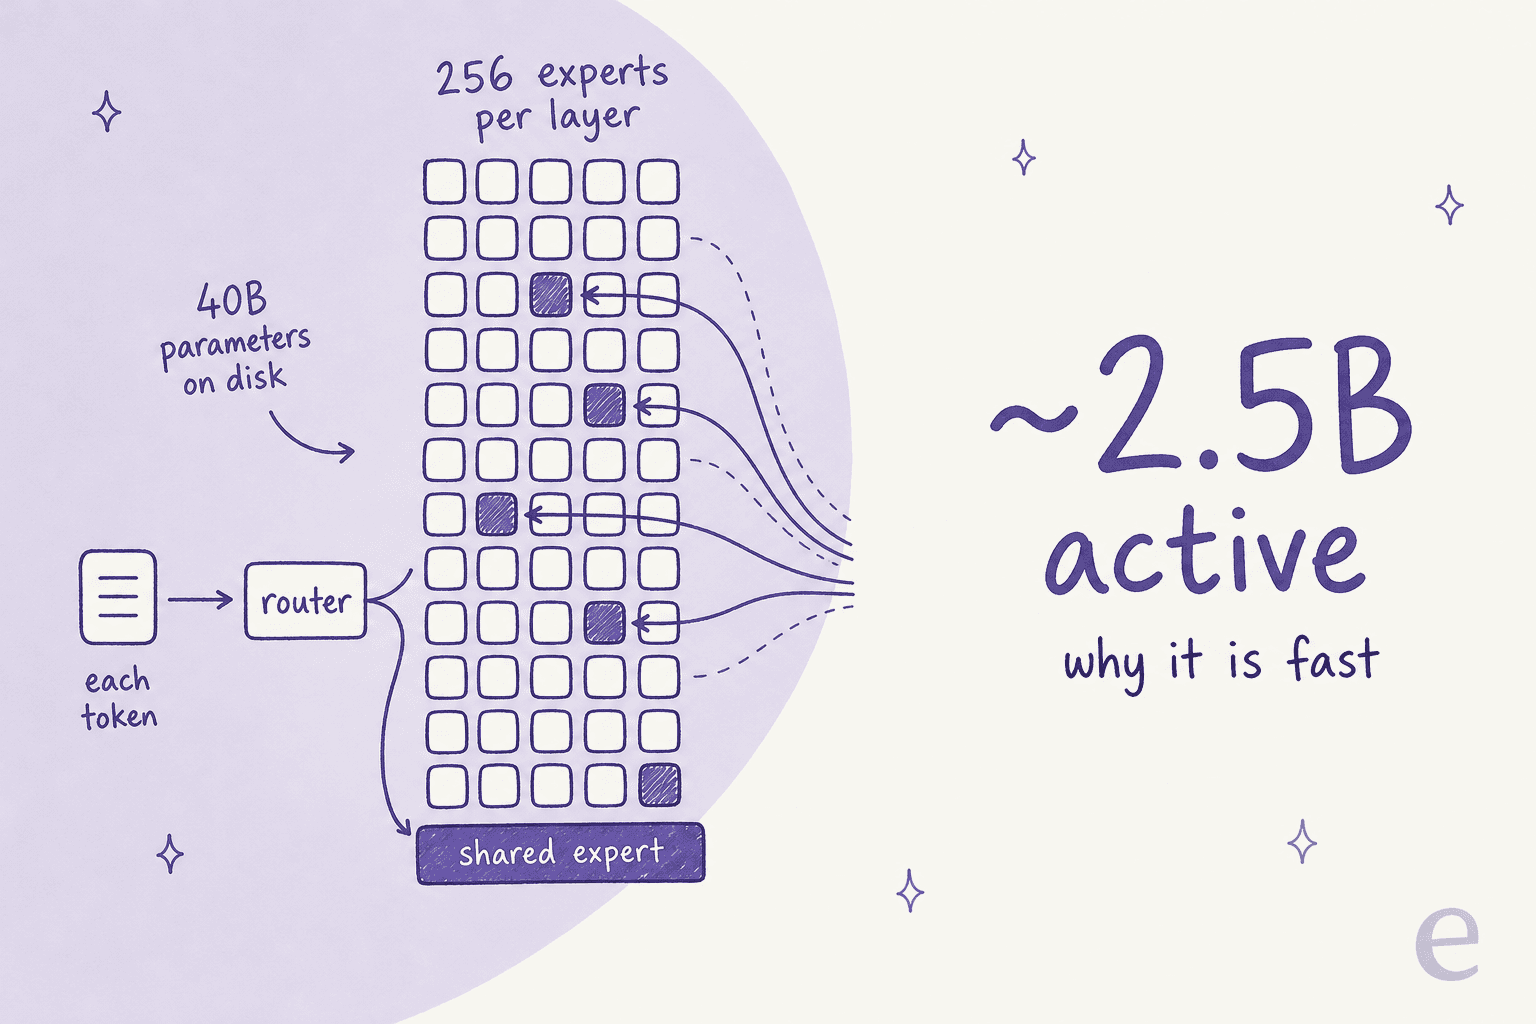
| Experten | 256 pro MoE-Schicht, 6 geroutet pro Token, plus 1 geteilter |
| Schichten | 49 (2 dicht, 47 MoE; 35 Sliding-Window, 14 Full Attention) |
| Kontext | 262.144 Tokens dokumentiert; bis zu 512k unterstützt, 256k empfohlen |
| Max. Ausgabe (gehostet) | 65.536 Tokens |
| Wissensstand | Juni 2026 |
| Lizenz | Apache 2.0 |
| Eingabe / Ausgabe | Text / Text |
Wie läuft ein 40B-Modell auf einem Laptop so schnell?
Es läuft schnell, weil fast alles davon untätig bleibt. Jedes Token durchläuft einen Router, der in jeder Schicht 6 der 256 Experten auswählt, plus einen geteilten Experten, der immer feuert, sodass der Chip pro Token nur Gewichte im Umfang von etwa 2,5B Parametern liest. Ein dichtes 27B-Modell liest bei jedem Token alle 27B.
Interessant ist, dass Recursive nicht bei der Architektur aufgehört hat. Laut Launch-Post hat die Eureka Machine auch nach Quantisierungsrezepten gesucht und entgegen der gängigen Praxis die Ausgabeschicht auf 4 Bit gepresst. Bei nur 2,5B aktiven Parametern macht diese Ausgabeschicht einen großen Anteil der pro Token gelesenen Gewichte aus, daher bringt ihr Schrumpfen echtes Tempo. Das finale NVFP4-Modell liegt in Recursives Benchmarks innerhalb von 0,7 Punkten des 16-Bit-Modells, und das LM-Studio-Listing zeigt die Lücke pro Test: 53,7 vs. 54,9 bei Terminal-Bench, 74,1 vs. 74,2 bei SWE-bench Verified.
Dann schrieb es eigene Kernels, darunter einen Metal-„Megakernel", der den gesamten Decode-Durchlauf auf M4- und M5-Chips verschmilzt. Deshalb liefert Recursive eine eigene Engine, rec, statt dich einfach auf llama.cpp zu verweisen. Mehr dazu weiter unten.
Wie schnell ist Recursive Flint in der Praxis?
Sehr. In Recursives eigenem Diagramm für einen Apple M4 Pro mit 48 GB läuft Flint mit 131,22 Tokens/Sek. über MLX bei 1K-Token-Kontext und 87,98 über llama.cpp. Die nächsten dünn besetzten Konkurrenten sind Laguna XS 2.1 mit 68,84 und Qwen 3.6 35B-A3B mit 65,55. Die dichten Modelle mit vergleichbaren Coding-Werten bewegen sich kaum: Muse Glimmer mit 14,54, Qwen 3.8 27B mit 13,01, Gemma 4 31B mit 11,92.

Die Langkontext-Zahlen überzeugen mich, dass das kein Kurz-Prompt-Partytrick ist. Gemittelt über Kontexte bis 128K hält Flint auf dem M4 Pro 68,89 Tokens/Sek., während Qwen 3.8 27B auf 10,11 fällt. Ein Coding-Agent verbringt den Großteil seines Lebens tief in einem langen Kontext (Dateiinhalte, Testausgaben, die eigenen früheren Überlegungen), daher zählt der Durchschnitt mehr als die Schlagzeile. Auf NVIDIAs RTX Spark erreicht der NVFP4-Build 155,82 Tokens/Sek. bei kurzem Kontext und 101,95 im Durchschnitt.
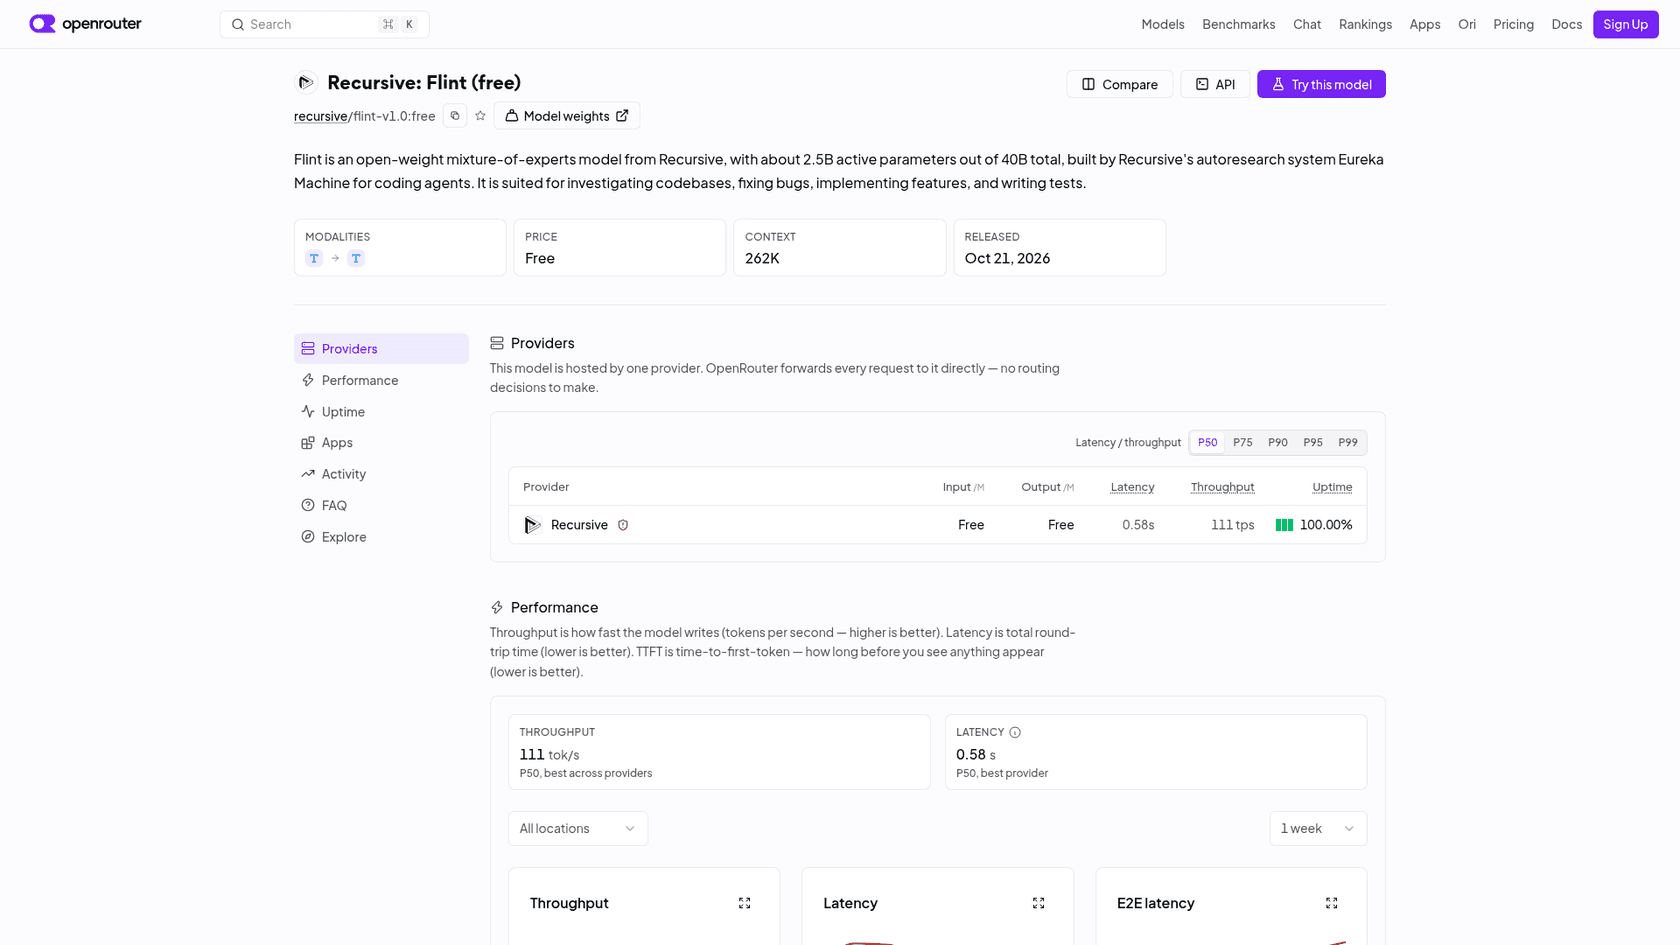
Auch gehostet ist es flott. Die Live-Statistiken von OpenRouter zeigen vom einzigen Provider-Endpunkt von Recursive einen P50-Durchsatz von 111 Tokens/Sek. und 0,58 s Latenz.
Zwei Vorbehalte. Das sind Recursives Messungen, ohne Prefill, daher fühlt sich die Zeit bis zum ersten Token bei einem dicken Prompt langsamer an, als die Balken vermuten lassen. Und das Tempo zeigt sich nur, wenn du eine Runtime nutzt, die Flint richtig unterstützt; die Troubleshooting-Seite widmet CPU-Offload und Memory-Swapping einen ganzen Eintrag.
Wie schneidet Flint gegen Qwen 3.8, Gemma 4 und Muse Glimmer ab?
Hier gehen Launch-Text und Diagramm auseinander. Recursive sagt, Flint „rivalisiere mit der Coding-Leistung dichter Modelle mit 25 bis 40 Milliarden Parametern". In seinem eigenen Diagramm liegt es hinter dem stärksten davon, Qwen 3.8 27B, bei den meisten Tests, die für agentisches Coding zählen.
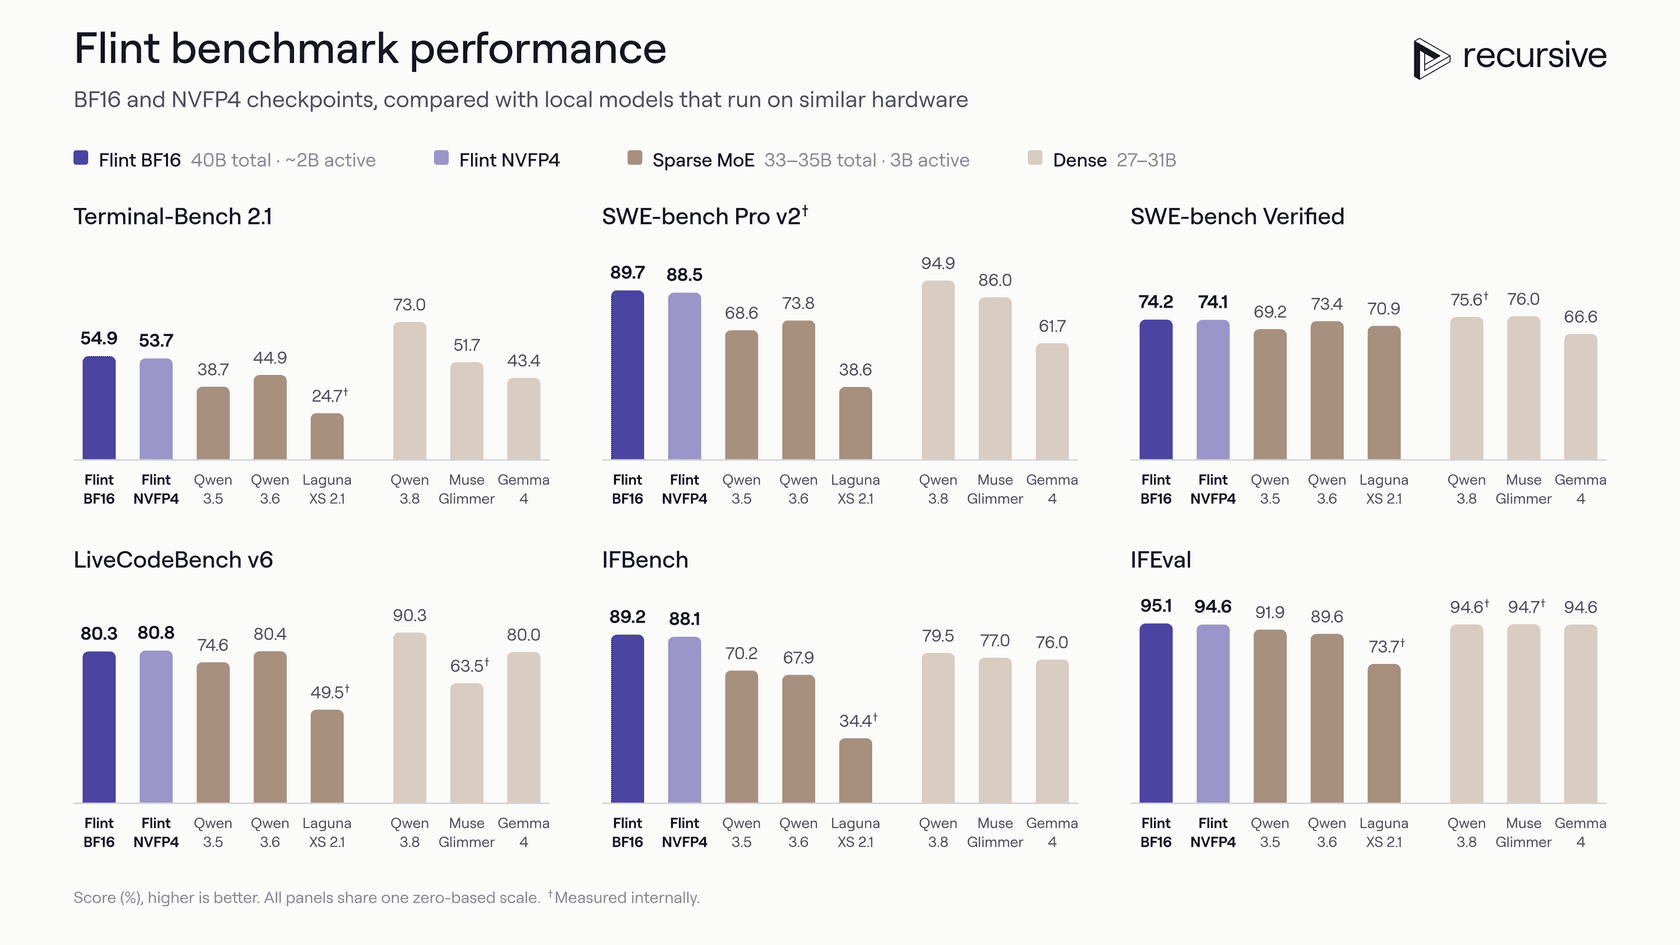
| Benchmark | Flint BF16 | Qwen 3.8 27B (dicht) | Muse Glimmer (dicht) | Gemma 4 (dicht) | Qwen 3.6 35B-A3B (MoE) |
|---|---|---|---|---|---|
| Terminal-Bench 2.1 | 54.9 | 73.0 | 51.7 | 43.4 | 44.9 |
| SWE-bench Pro v2 | 89.7 | 94.9 | 86.0 | 61.7 | 73.8 |
| SWE-bench Verified | 74.2 | 75.6 | 76.0 | 66.6 | 73.4 |
| LiveCodeBench v6 | 80.3 | 90.3 | 63.5 | 80.0 | 80.4 |
| IFBench | 89.2 | 79.5 | 77.0 | 76.0 | 67.9 |
| IFEval | 95.1 | 94.6 | 94.7 | 94.6 | 89.6 |
Ehrlich gelesen fallen drei Dinge auf:
- Gegen andere MoE-Modelle seiner Größe gewinnt Flint klar. Es schlägt Qwen 3.6 35B-A3B in fünf von sechs Zeilen (LiveCodeBench ist mit 0,1 Punkten ein Gleichstand) und bei Terminal-Bench um
10Punkte. Das ist die Behauptung, mit der Recursive wirbt, und sie hält. - Gegen Qwen 3.8 27B verliert es vier von sechs. Die Lücke von
18,1Punkten bei Terminal-Bench 2.1 würde ich am stärksten gewichten, da dieser Test am nächsten an „bediene eine Shell, bis die Aufgabe erledigt ist" liegt. - Seine Stärke ist das Befolgen von Anweisungen.
89,2bei IFBench liegt fast10Punkte vor jedem dichten Modell im Diagramm, was zum Rat der Docs passt, ihm explizite, schrittweise Anweisungen zu geben.
Recursive ist bei der Methodik offen, was ich schätze. Laut Model Card wertet der Terminal-Bench-Lauf Lösungen, die per Web-Abruf gefunden wurden, als Fehlschläge, und die Karte merkt an, dass von Entwicklern gemeldete Werte anderer Modelle diese Anpassung womöglich nicht anwenden. Ein Teil der Lücke könnte also ein strengerer Bewerter sein. Ein Teil ist aber schlicht ein dichtes 27B-Modell, das pro Token mehr nachdenkt.
Das ist der eigentliche Tausch. Flint ist 10x schneller bei einer etwas schlechteren Antwort. Für eine interaktive Coding-Schleife, in der du ohnehin jeden Diff liest, würde ich diesen Deal oft nehmen. Für einen unbeaufsichtigten Agenten über Nacht nicht.
Wo schwächelt Flint?
Die Grenzen sind größtenteils solche, die Recursive selbst dokumentiert, was ein gutes Zeichen für das Labor ist, wenn auch nicht für das Modell.
Es braucht eine kürzere Leine als Frontier-Modelle. Der Launch-Post sagt es klar: „es braucht möglicherweise mehr Anleitung als die größeren proprietären Coding-Modelle, die du gewohnt bist", und empfiehlt, Arbeit in kleinere Teilaufgaben mit expliziten Anweisungen zu zerlegen. Wenn du gewohnt bist, Claude Code oder Cursor ein vages Ticket zu geben und wegzugehen, rechne mit mehr Hin und Her.
Tool-Aufrufe haken öfter, als dir lieb ist. OpenRouter meldet für den kostenlosen Endpunkt eine Fehlerquote von 17,74 % bei Tool-Aufrufen. In einer Agentenschleife mit 30 Schritten sind das mehrere kaputte Aufrufe pro Aufgabe, die dein Harness abfangen muss. Die Docs nennen als übliche Ursache nicht passende Chat-Templates und Parser, und die Model Card bittet dich, reasoning_content im Verlauf zu erhalten, einiges davon lässt sich also auf deiner Seite beheben. Trotzdem ist es die erste Zahl, die ich im Auge behalten würde.
Langes Reasoning frisst das Budget. Reasoning ist immer aktiv. Die Model Card empfiehlt mindestens 32.768 Ausgabe-Tokens für schwierige Probleme, und die OpenCode-Anleitung schlägt 65.536 vor. Wenn dein Harness die Ausgabe niedriger begrenzt, enden Antworten mitten im Gedanken mit finish_reason: length, dasselbe Budgetproblem, das ich bei Claude Codes Kontextfenster durchgehe.
Der schnelle Weg gibt es nur auf dem Mac, und nicht auf jedem. rec braucht laut README einen M4 Pro, M4 Max, M5 Pro oder M5 Max mit mindestens 48 GB Unified Memory. Ein Rechner mit 24 GB kann über LM Studio das kleinste GGUF laden, aber LM Studios eigenes Listing warnt, dass der volle 262K-Kontext nicht unbedingt passt.
Es gibt noch keine bezahlte API mit SLA. Direkter Zugriff auf die Recursive-API ist laut Releases-Seite „auf ausgewählte Partner beschränkt". Die kostenlosen Tarife bei OpenRouter und OpenCode unterliegen Kapazitäts- und Ratenlimits. Das reicht für einen Test, nicht für etwas, womit du Kunden Geld berechnest.
Die Reaktion der Community deckt sich mit dem Diagramm. Der Hacker-News-Launch-Thread war beeindruckt vom Tempo eines von Grund auf trainierten Modells, mit einer Prise „zeig's mir":
"Pretty amazing for being trained from scratch, to have ~Qwen 3.8 27b quality with such an increase in tok/s performance. Excited to try it out and see how snappy it is."

"not as good as qwen3.8 yet, even the chart says good numbers"
Beide haben recht. Ich würde es dazwischen einordnen: nah genug an Qwen 3.8, dass das Tempo bei interaktiver Arbeit entscheidet, aber nicht nah genug, dass es für alles entscheidet.
Wie führt man Recursive Flint aus?
Du hast vier Wege, und deine Hardware wählt einen für dich aus.
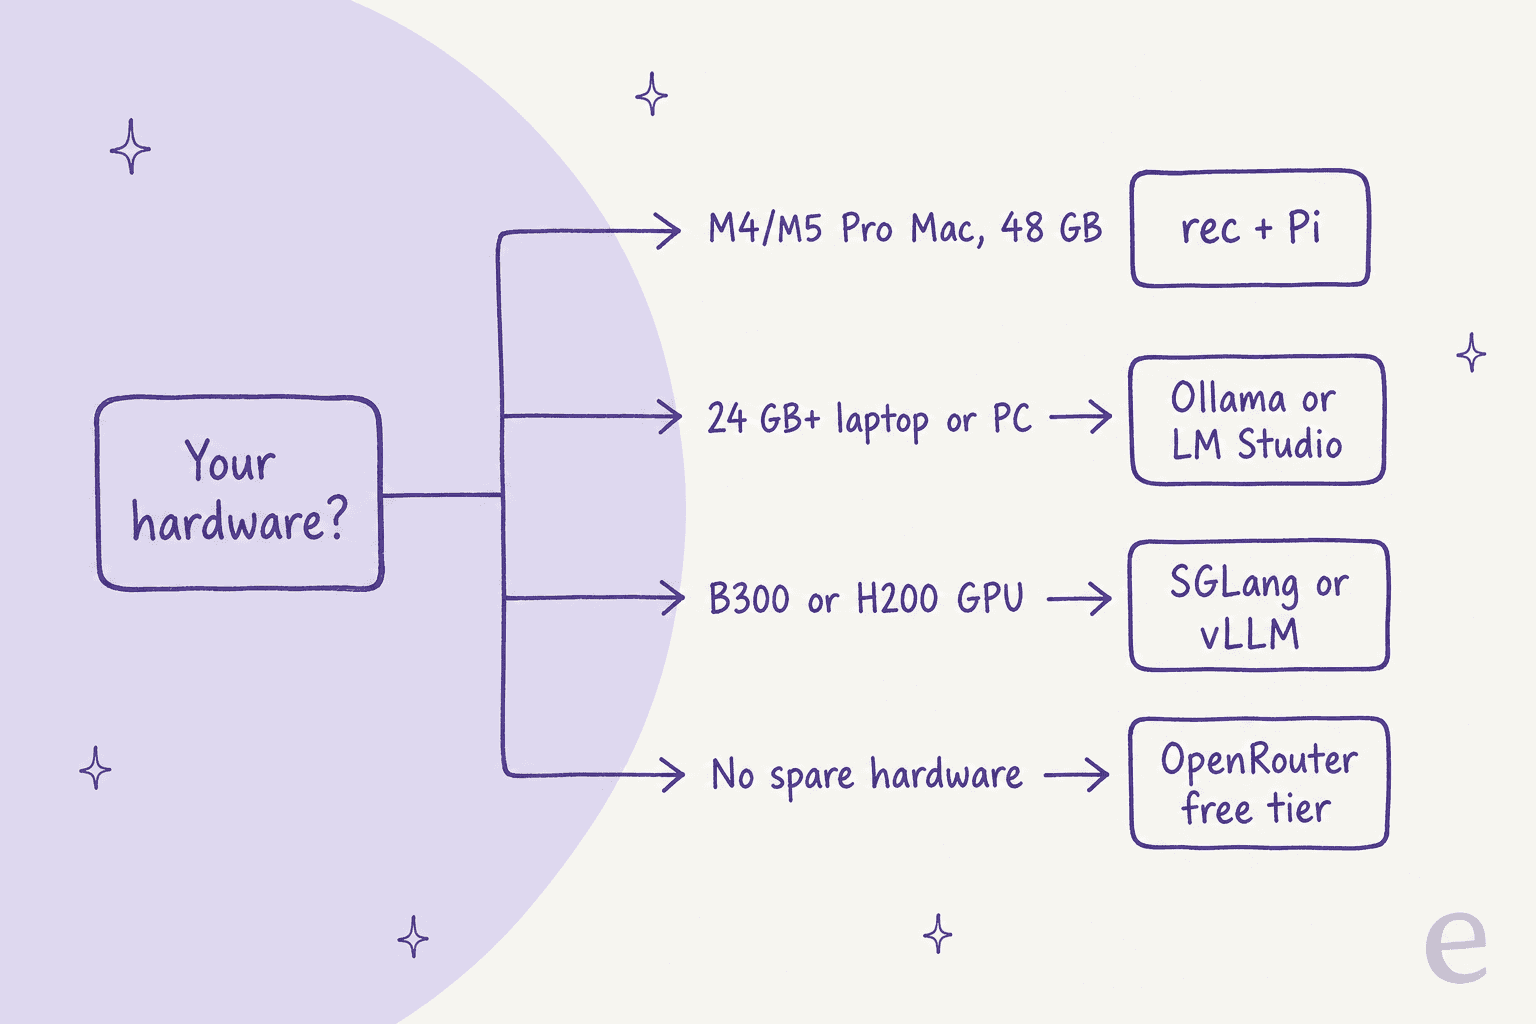
1. Ein unterstützter Mac: nutze rec. Das ist Recursives eigene Engine, und ihr README verspricht auf einem M4 Pro das 1,4- bis 2,6-Fache des Durchsatzes von llama.cpp. Installiere sie mit einem curl-Befehl und führe dann in deinem Projektordner rec launch pi aus. Es lädt das Modell (etwa 30 GB Speicherplatz) und das Pi-Harness herunter und startet einen lokalen Server, der sowohl OpenAI- als auch Anthropic-kompatible APIs spricht. Recursive sagt, Flint funktioniere am besten mit Pi; rec launch opencode ist die Alternative. Ein Haken: rec ist für eine einzelne Sitzung gebaut, mehrere Agenten gleichzeitig erfordern also eine andere Runtime.
2. Jeder brauchbare Laptop oder PC: Ollama oder LM Studio. ollama run flint:40b-a2b-qat-int4 zieht Recursives paketierten 4-Bit-Build, und ollama launch opencode, pi, codex oder vscode bindet ihn laut Ollama-Anleitung in ein Harness ein. LM Studio hat ein 24,20-GB-GGUF mit 24 GB RAM als Minimum. Rechne mit Geschwindigkeiten, die näher an den llama.cpp-Balken liegen als an den MLX-Balken.
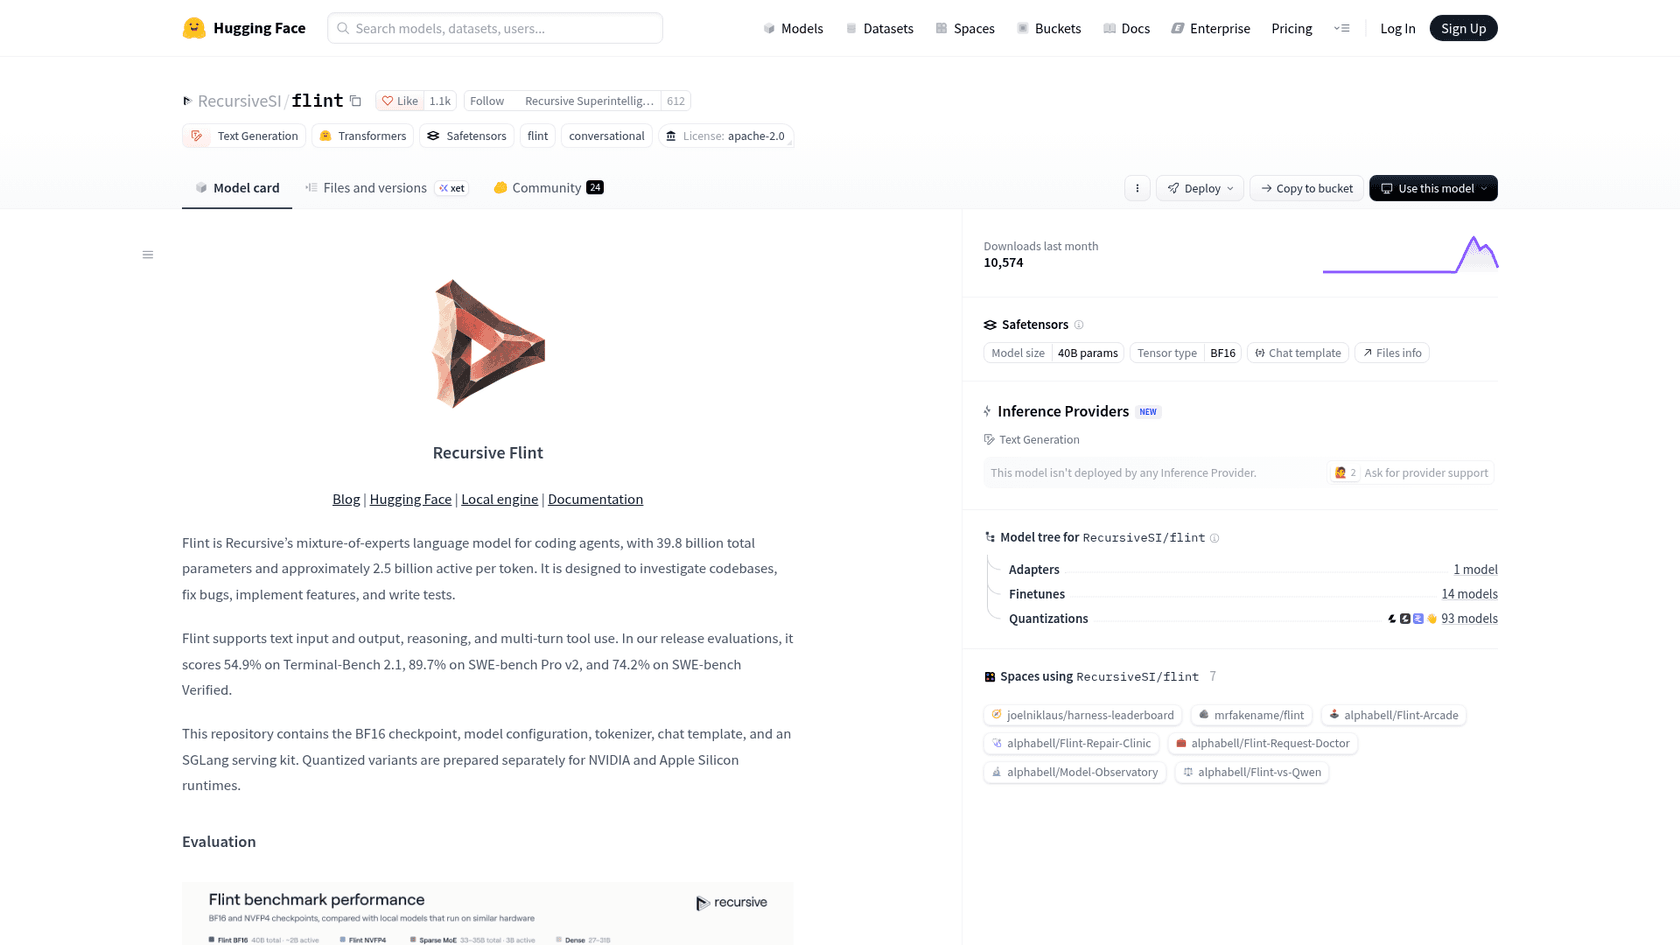
3. Ein GPU-Server: SGLang oder vLLM. Das Hugging-Face-Repo enthält den rund 80 GB großen BF16-Checkpoint plus ein SGLang-Serving-Kit, das ein Replikat auf einer einzelnen B300 oder H200 betreibt. Das Repo hat bereits 93 Community-Quantisierungen und 14 Finetunes gesammelt, es gibt also viel Auswahl, falls Recursives eigene Builds nicht zu deinem Stack passen.
4. Keine freie Hardware: die kostenlosen gehosteten Tarife. OpenRouter listet recursive/flint-v1.0:free ohne Kosten, und OpenCodes Modellauswahl hat Flint-40B im kostenlosen Tarif. Die aktivsten Apps auf OpenRouters Seite sind Coding-Agenten: Kilo Code hat in einer Woche 32,9B Tokens durchgeschickt, Cline 12,2B. Wenn du nur sehen willst, ob Flints Stil zu dir passt, ist das der Fünf-Minuten-Test.
Welchen Weg du auch nimmst, Recursives vorgeschlagene erste Aufgabe ist gut: ein kleines Repo öffnen, das du kennst, Flint eine Funktion erklären lassen, einen Test hinzufügen und dann beheben, was der Test aufdeckt. Prüfe den Diff nach jedem Schritt.
Was kostet Recursive Flint?
Nichts, lizenzrechtlich gesehen. Die Gewichte stehen unter Apache 2.0, kostenlos für die kommerzielle Nutzung, und beide gehosteten Wege sind heute kostenlos. Die echten Kosten sind Hardware und Strom, und genau da spart Flint leise Geld: Ein Modell, das einen 48-GB-Mac statt eines GPU-Racks braucht und auf diesem Mac mit dem 10-Fachen der Geschwindigkeit seiner dichten Konkurrenten läuft, erledigt pro Stunde einer Maschine, die du schon besitzt, mehr Arbeit.
| Weg | Preis | Limits |
|---|---|---|
| Gewichte auf Hugging Face | Kostenlos (Apache 2.0) | ~80 GB BF16; quantisierte Builds für Mac und NVIDIA |
| rec auf einem Mac | Kostenlos | M4/M5 Pro oder Max, 48 GB+, einzelne Sitzung |
| Ollama / LM Studio | Kostenlos | 24 GB RAM Minimum für das kleinste GGUF |
OpenRouter flint-v1.0:free | $0 Eingabe, $0 Ausgabe | Ein Provider, Kapazitäts- und Ratenlimits gelten |
| OpenCode-Gratistarif | $0 | Kapazitäts- und Ratenlimits gelten |
| Direkte Recursive-API | Nicht öffentlich | Nur ausgewählte Partner |
Vergleiche das mit gehosteten Frontier-Modellen, bei denen eine lange agentische Coding-Sitzung pro Aufgabe in die Dollars gehen kann. Meine Aufschlüsselung der Kimi-K3.1-Pro-Preise beziffert die Kosten pro Aufgabe auf etwa $2,11. Wenn du täglich Dutzende kleiner, klar umrissener Aufgaben erledigst, verändert ein kostenloses lokales Modell, das gut genug ist, die Rechnung schnell.
Wer sollte Recursive Flint nutzen, und wer sollte darauf verzichten?
Hier mein Urteil, und der entscheidende Faktor ist, wie viel vom Denken du selbst übernehmen willst.
Nutze Flint, wenn:
- Du einen Coding-Agenten willst, der offline arbeitet und deinen Code auf deinem Rechner lässt, und einen Mac mit M4 oder M5 Pro/Max und 48 GB besitzt.
- Du interaktiv arbeitest, jeden Diff liest und ein Modell schätzt, das in Sekunden antwortet, statt eines, das in einer Minute etwas besser antwortet.
- Du auf offenen Gewichten aufbaust und eine kommerziell großzügige Lizenz für Finetuning oder Weitergabe brauchst, derselbe Grund, aus dem Teams zu Open-Source-KI-Agenten greifen.
Lass es vorerst, wenn:
- Du das stärkste lokale Modell pro Antwort willst. Qwen 3.8 mit 27B dicht gewinnt weiterhin die meisten Coding-Tests, bei einem Zehntel des Tempos; meine Liste der Qwen-Alternativen deckt die übrigen Konkurrenten dieser Familie ab.
- Du lange, unbeaufsichtigte Agenten betreibst, bei denen ein kaputter Tool-Aufruf dich einen ganzen Lauf kostet.
- Du eine unterstützte, bezahlte API mit SLA brauchst. Die gibt es noch nicht, daher ist ein gehostetes Tool wie GitHub Copilot oder Windsurf der sicherere Kauf.
Wenn du Flint gegen gehostete Optionen abwägst, decken mein Test zu Kimi K3.1 Pro und mein Test zu DeepSeek V4 Flash die naheliegenden Alternativen ab, und KI-Coding-Assistenten behandelt die Harnesses, in denen du sie betreiben würdest.
Weitere offene Modelle, die sich diesen Monat lohnen, sind Nemotron 3.5 Bolt, LFM3 und Nanbeige 4.3.
Die größere Geschichte ist das Labor, nicht das Modell. Ein von Grund auf gebautes 40B-Modell in unter vier Monaten, bei dem ein automatisiertes System einen Großteil der Forschung übernimmt, ist die Behauptung, die man im Auge behalten sollte. Recursives Wette ist, dass jedes Modell die Eureka Machine zu einem besseren Forscher macht. Wenn Flint 2 die Lücke zu Qwen bei gleichem Tempo schließt, fällt dieser Test deutlich positiver aus.
Was Flint bedeutet, wenn du ein Support-Team leitest
Flint ist Infrastruktur: ein Modell, auf dem ein Coding-Agent läuft. Schon die Modellwahl für den Support ist eine eigene Frage, die ich in meinem Leitfaden zu LLMs für den Kundensupport behandle. Wenn dein Problem eine Support-Queue ist und keine Codebasis, war das Modell nie der schwere Teil. Schwer ist alles drumherum: die Anbindung an Zendesk oder Freshdesk, das Lernen aus deinen bisherigen Tickets, das Wissen, wann man übergibt, und der Beweis, dass es keine selbstsicher falsche Antwort gibt, bevor ein Kunde sie sieht. eesel setzt seit Jahren KI-Agenten auf Live-Support-Queues, und die Lektion, die ich am häufigsten neu gelernt sehe, lautet: Jeder Rollout muss vor dem Livegang an historischen Tickets simuliert werden.
Genau das sind die KI-Teammates von eesel, und deshalb würde ich eine Support-Leitung vor jedem KI-Agenten-Baukasten darauf verweisen: einsatzbereite Mitarbeiter für eine klar umrissene Aufgabe, kein Modell, um das man ein Produkt zusammenbaut. Der KI-Helpdesk-Teammate ist der für den Support.
SE Ranking zum Beispiel betreibt drei eesel-Agenten auf drei Zendesk-Verbindungen, einen pro Produkt, und bearbeitete 4.650 Gespräche in einem Monat, darunter etwa 2.100 Live-Chats, die zuerst von eesel beantwortet wurden. SamCart betreibt einen Agenten auf Freshdesk-Tickets und einen weiteren im Website-Chat und antwortet aus 280 Help-Center-Artikeln.
Und hier treffen sich die beiden Welten. eesel hat eine CLI, sodass derselbe Coding-Agent, den du auf Flint, Claude Code oder Codex laufen lässt, deinen Support-Teammate vom Terminal aus bedienen kann: eesel activity, um zu lesen, was der Agent bei jedem Ticket getan hat, eesel instructions, um seine festen Regeln zu ändern, eesel approvals, um Aktionen freizugeben, auf die er wartet. Jeder Befehl gibt JSON aus, und --dry-run zeigt den genauen Aufruf, den ein Schreibvorgang ausführen würde, bevor er gesendet wird. Die Docs gehen so weit, KI-Agenten anzuweisen, die CLI zu nutzen, statt sich durch das Dashboard zu klicken. Wenn dich interessiert, wie das im Vergleich zum Selbstbau abschneidet, habe ich KI-Agenten-CLIs und den MCP-Server-Weg separat beschrieben.
eesel ausprobieren
Du willst eine KI für deinen Helpdesk, ohne sie auf einem rohen Modell zu bauen? eesels Helpdesk-Teammate verbindet sich in Minuten mit Zendesk, Freshdesk oder Gorgias, lernt aus deinen bisherigen Tickets und deinem Help Center und wird daran getestet, bevor er irgendjemandem antwortet. Jede Aktion erscheint in einem Aktivitätsprotokoll, das du im Dashboard lesen oder per CLI abrufen kannst. Der Start ist kostenlos, keine Karte nötig.
