

Gemini 3.7 Flash ist ein sehr gutes Modell, das still und leise aufgehört hat, günstig zu sein. Schnell ist es, ja. Artificial Analysis misst 340.1 Tokens pro Sekunde, das schnellste Modell, das sie aktuell erfassen. Es ist am 13. August 2026 allgemein verfügbar geworden. Der Preis zum Start lag bei $0.75 pro 1 Mio. Input-Tokens und $3.75 pro 1 Mio. Output-Tokens.
Dann der Haken, und der steht auf der Preisliste, nicht in irgendeinem Benchmark-Diagramm. Dieser Preis ist ein Einführungspreis. Am 1. Januar 2027 verdoppelt er sich auf $1.50 und $7.50. Außerdem ist die Denkstufe minimal weg, genau die, die ältere Flash-Modelle für Klassifizierung in hohem Volumen überhaupt tragfähig gemacht hat. Jetzt ist low Ihre günstigste Untergrenze. Und Denk-Tokens werden zum Output-Preis abgerechnet, obwohl bei Ihnen nur eine Zusammenfassung davon ankommt.
Ich baue bei eesel Integrationen und die Modell-Infrastruktur. Unsere Agenten laufen auf Live-Helpdesks mit echtem Volumen, ein Kunde schleust über 100.000 deutschsprachige Tickets pro Monat durch Zendesk. Diese Arbeit hat mich allergisch dagegen gemacht, Modelle anhand einer Benchmark-Tabelle auszuwählen. Also: Für Coding, Agenten- und Dokumentenarbeit ist 3.7 ein echtes Upgrade. Aber wenn Sie Flash ursprünglich gewählt haben, weil es die günstige Stufe war, ist 3.7 nicht Ihr Upgrade-Pfad, und Googles eigene Preistabelle sieht das stillschweigend genauso.
Was Gemini 3.7 Flash eigentlich ist
Gemini 3.7 Flash ist das neueste Arbeitstier in der Gemini-AI-Reihe. Es erscheint als gemini-3.7-flash und ist als GA statt Preview gekennzeichnet. Googles Formulierung ist unmissverständlich: "our most intelligent workhorse model yet for coding and agents."
Es bietet ein Kontextfenster von 1 Mio. Tokens mit einer Output-Obergrenze von 64k. Als Input sind Text, Bild, Video, Audio und PDF möglich, der Output bleibt aber reiner Text. Sechs Oberflächen haben es live, darunter AI Studio und die Gemini API sowie Google Antigravity, wo es jetzt das Standardmodell hinter dem Antigravity-Agenten ist.
Ein Stück Kontext ist wichtig, um alles Folgende einzuordnen. Aktuell gibt es kein stabiles Gemini 3 Pro. gemini-3-pro-preview ist als abgeschaltet markiert, und das einzige Pro in der Liste ist 3.1 Pro als Preview, was sich deutlich vom Zuschnitt des Gemini-3-Launches unterscheidet. Flash trägt damit mehr Gewicht im Line-up, als ein Modell mit "Flash" im Namen normalerweise tut, und das erklärt viel über Positionierung und Preisgestaltung.
Die API hat sich stärker verändert als das Modell
Das ist der Teil, der Sie einen Nachmittag kosten wird, und fast niemand stellt ihn an den Anfang.
Wenn Sie von Gemini 3.5 Flash, Gemini 3 Flash Preview oder Gemini 3.1 Pro migrieren, sagt Ihnen Googles Migrations-Checkliste, Sie sollen temperature, top_p, top_k und candidate_count entfernen, das numerische thinking_budget durch einen thinking_level-String ersetzen, vorausgefüllte Modell-Turns entfernen und den Verlauf bei mehreren Turns auf eine serverseitige previous_interaction_id umstellen. Gemini 3.6 Flash hatte die Sampling-Parameter bereits gestrichen, der Wechsel von 3.6 auf 3.7 ist also fast gratis. Alle anderen müssen komplett aufräumen.
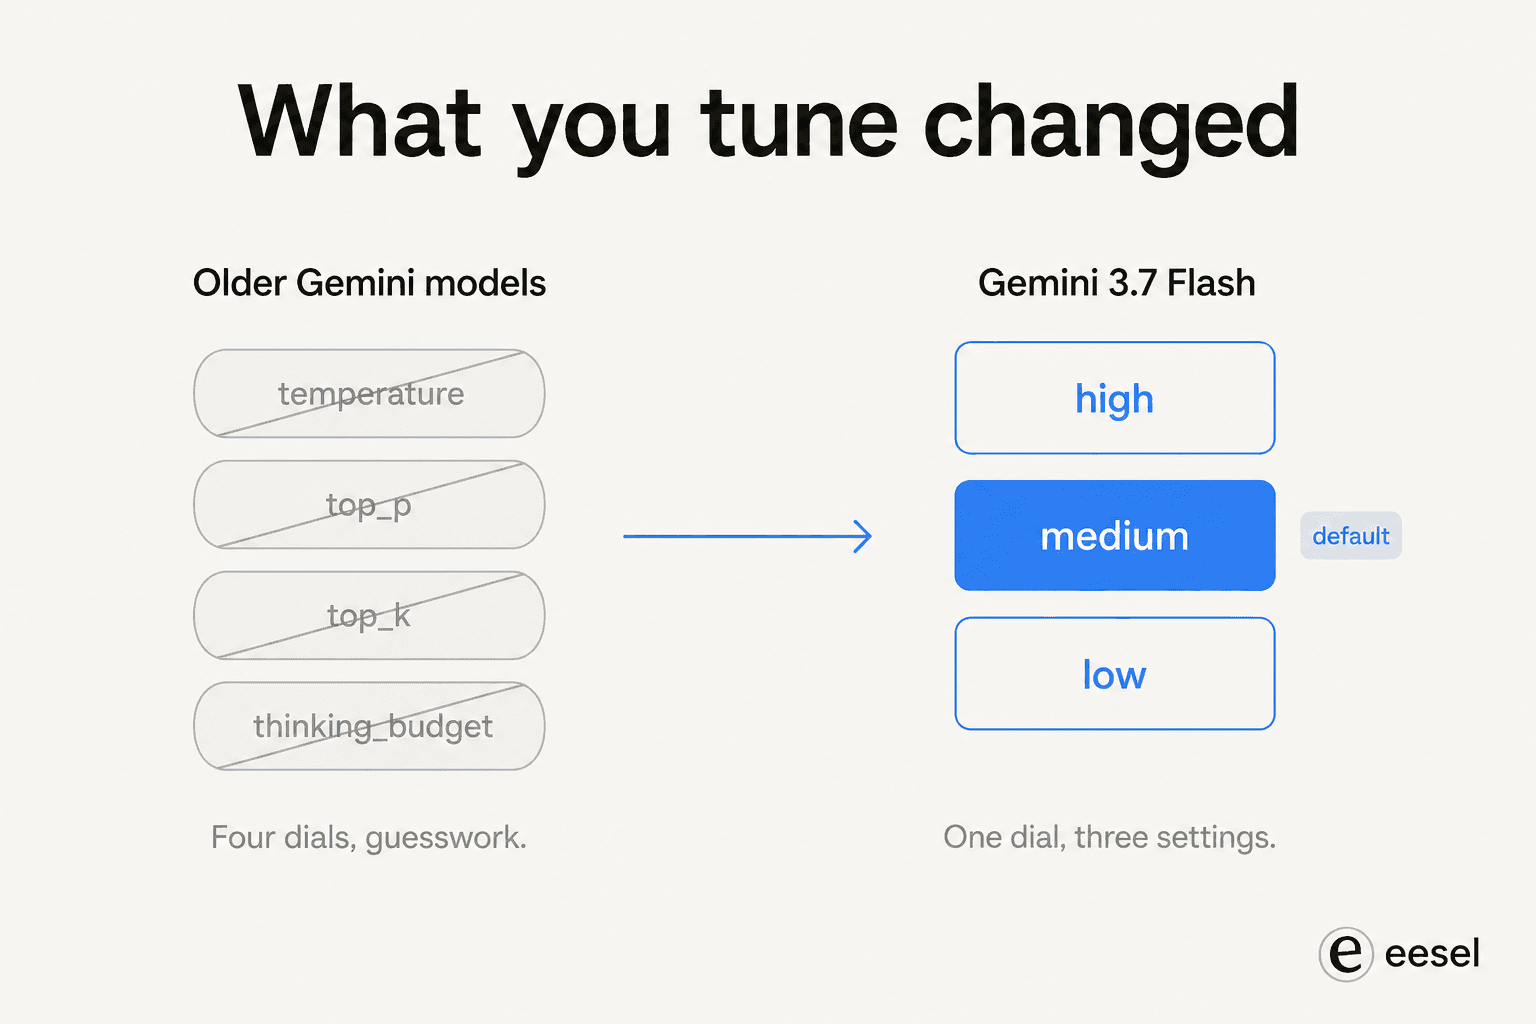
Statt vier Reglern gibt es jetzt einen mit drei Einstellungen, und er wird innerhalb von generation_config gesetzt:
| Stufe | Wofür Google sie vorsieht | Kostenprofil |
|---|---|---|
low | Latenzkritische Arbeit: Incident Response, Echtzeit-Chat, Entwürfe, schnelle Datenanalyse | Günstigste verfügbare Untergrenze |
medium (Standard) | Komplexer Code und agentische Nutzung, mit höherer Genauigkeit im ersten Durchlauf | Standard, wenn Sie nichts setzen |
high | Schwierige Mathematik, die härtesten Coding- und Agenten-Aufgaben, ausgedehnte Tool-Nutzung | "Higher token consumption and cost" |
Hier ist die Regression, die niemand in eine Pressemitteilung geschrieben hat. Gemini 3.6 Flash, 3.5 Flash, 3.5 Flash-Lite und 3 Flash Preview akzeptieren alle eine vierte Stufe, minimal. Gemini 3.7 Flash tut das nicht. In einem Launch-Thread mit 347 Kommentaren hat nur Simon Willison darauf hingewiesen:
"The 'introductory pricing' for this 3.7 Flash model is really weird.
It's scheduled to double in price on December 31, 2026, but who would anticipate still using this model five months from now? Especially since 3.6 Flash came out just three weeks ago!"

Der Wegfall von minimal wiegt schwerer, als es klingt. Wenn Sie Flash für OCR und Tagging oder für die Ticket-Klassifizierung eingesetzt haben, war minimal die Einstellung, mit der die Wirtschaftlichkeit aufging. low ist eine echte Untergrenze. Aber es ist nicht dieselbe Untergrenze.
Die andere stille Änderung: Jedes Codebeispiel auf der Seite nutzt jetzt die Interactions API, die zusammen mit dem Modell GA gegangen ist, statt generateContent. Das sollten Sie wissen, bevor Sie ein Snippet in eine Codebasis kopieren, die auf der alten Form aufgebaut ist.
Wie schnell es ist und wie sich diese Geschwindigkeit verteilt
Bei der Geschwindigkeit bleibt 3.7 Flash unangefochten. Artificial Analysis misst 340.1 Output-Tokens pro Sekunde, Platz eins von 188 beobachteten Modellen, bei einem Klassenmedian von 68.6. Der Intelligence Index liegt bei 56, Platz siebzehn von 188 und deutlich über dem Klassenmedian von 34.
Die Zahlen aus der Praxis sind weniger schmeichelhaft, aber nützlicher. OpenRouter zeigt einen P50 von 93 Tokens pro Sekunde bei 1.85 Sekunden Latenz. Die Aufteilung nach Anbieter ist hier deutlich: Google AI Studio liefert 124 Tokens pro Sekunde bei 1.74 Sekunden, Vertex schafft 84 bei 2.02 Sekunden.
Die Zeit bis zum ersten Token ist die Schwachstelle, und sie hängt ganz von der gewählten Denkstufe ab. Artificial Analysis misst bei high einen Median von 9.83 Sekunden bis zum ersten Token, mit einem p95 von 49.5 Sekunden, gegenüber einem Klassenmedian von 2.88. Bei low sinkt er auf 0.74 Sekunden. Das ist der Unterschied zwischen einer brauchbaren interaktiven Latenz und einer, über die sich Ihre Nutzer beschweren werden.
Das bringt den praktischsten Befund des gesamten Datensatzes zutage:
| Denkstufe | Intelligence Index | Zeit bis zum ersten Token | Kosten pro Benchmark-Aufgabe |
|---|---|---|---|
high | 56.0 | 9.83s | $0.40 |
medium | 53.5 | 4.22s | $0.26 |
low | 50.9 | 0.74s | $0.16 |
Bei low erreicht es immer noch 50.9, einen Punkt entfernt von Gemini 3.6 Flash auf voller high-Stufe, bei 40 % der Kosten pro Aufgabe und etwa einem Dreizehntel der Wartezeit. Wenn Sie also von 3.6 Flash migrieren und den Standard auf medium lassen, zahlen Sie wahrscheinlich für Reasoning, das Sie gar nicht gebraucht haben.
Das Merkwürdige ist, dass 93.1 % des OpenRouter-Traffics zu Vertex gehen, dem langsameren Endpunkt, weil dieser einen Plattformrabatt von 50 % trägt. Die Leute tauschen Latenz gegen Preis, und das verrät, wofür sie dieses Modell tatsächlich kaufen.
Es gibt auch ein starkes Gegenargument zur ganzen Geschwindigkeitsgeschichte, und es kommt mit Zahlen. Artificial Analysis hat gemessen, dass 3.7 Flash bei hohem Reasoning etwa 40 % mehr Tokens als 3.6 Flash verbraucht, im Schnitt 37k Output-Tokens pro Aufgabe. Tokens pro Sekunde und Zeit bis zur Antwort sind nicht dasselbe:
"Sol high is almost the same speed if you take into account drastically lower token use. Look at the artificial analysis speed vs token use. Gemini is 7x faster but 5x more tokens. And that's with Sol high being a substantially better model."
Diese 40 % mehr Tokens sind eine Preiserhöhung im Geschwindigkeits-Kostüm. Die Preisliste hat sich nicht bewegt. Bewegt hat sich die Zahl der abrechenbaren Output-Tokens pro Aufgabe, und Denk-Tokens laufen dort ebenfalls zum Output-Preis mit. Behalten Sie das für den Rechner weiter unten im Kopf.
Die Benchmarks, auch die, mit denen Google nicht geworben hat
Google hat einen Vergleich mit 21 Zeilen gegen Gemini 3.6 Flash, Claude Sonnet 5, GPT-5.6 Terra und Muse Spark 1.2 veröffentlicht. Zu ihren Gunsten: Sie haben auch die Niederlagen veröffentlicht. Hier die wichtigsten Zeilen:
| Benchmark | Gemini 3.7 Flash | Gemini 3.6 Flash | Claude Sonnet 5 | GPT-5.6 Terra | Muse Spark 1.2 |
|---|---|---|---|---|---|
| Input-Preis, $/1M | $0.75 | $0.75 | $2.00 | $2.00 | $1.25 |
| Output-Preis, $/1M | $3.75 | $3.75 | $10.00 | $12.00 | $4.25 |
| AA Intelligence Index | 56 | 52 | 55 | 57 | 57 |
| FrontierCode 1.1 Main | 43.6% | 34.4% | 42.7% | 41.3% | - |
| DeepSWE v1.1 | 65.3% | 48.6% | 53.8% | 69.6% | 54.9% |
| Code Arena (Elo) | 1588 | 1538 | 1541 | 1523 | 1535 |
| Terminal-bench 2.1 | 85.8% | 78.0% | 80.4% | 87.4% | 82.9% |
| Terminal-bench 3.0 | 14.9% | 5.4% | 14.6% | 20.8% | - |
| AutomationBench (privat) | 30.4% | 17.0% | 10.7% | 23.6% | - |
| GDPVal-AA v2 (Elo) | 1525 | 1422 | 1598 | 1578 | 1628 |
| Harvey LAB-AA (Recht) | 90.7% | 85.1% | 90.1% | 85.2% | - |
| GDP.pdf (PDF-Verständnis) | 34.0% | 22.0% | 28.0% | 24.7% | 16.0% |
| CharXiv Reasoning (ohne Tools) | 84.5% | 85.2% | 77.0% | 85.9% | - |
| CharXiv Reasoning (mit Tools) | 88.7% | 89.4% | 88.3% | - | - |
| LVBench (langes Video) | 85.4% | 84.2% | 68.5% | 78.9% | - |
| GDM-MRCR v2 @128k | 97.0% | 91.8% | 81.5% | 93.5% | - |
| OSWorld-2.0 (Computer-Nutzung) | 47.9% | 33.8% | - | 50.2% | - |
| HLE-Verified | 53.6% | 51.2% | 31.0% | 51.1% | - |
Einige ehrliche Lesarten dieser Tabelle.
Die Sprünge gegenüber dem eigenen Vorgänger sind groß und echt. DeepSWE von 48.6 % auf 65.3 % und AutomationBench von 17.0 % auf 30.4 % sind keine Rundungsfehler. Googles eigener Fließtext nennt für DeepSWE bei 3.6 Flash 49.0 % statt 48.6 %, eine kleine Abweichung zwischen Text und Diagramm, wobei die Richtung nicht in Zweifel steht.
GPT-5.6 Terra beherrscht weiterhin agentische Terminal-Arbeit. Terminal-bench 2.1, Terminal-bench 3.0, DeepSWE und OSWorld-2.0 gehen alle an Terra. Wenn Ihr Workload ein Coding-Agent mit langem Horizont ist, der sich durch ein echtes Repo arbeitet, sind das vier von vier relevanten Benchmarks, und deshalb haben mehrere Leute auf Hacker News dieses Modell als Terra-Konkurrenten gelesen und nicht als Budget-Wahl.
Es hat zwei Zeilen an Gemini 3.6 Flash verloren. Beide sind CharXiv-Diagramm-Reasoning, 84.5 gegen 85.2 ohne Tools und 88.7 gegen 89.4 mit Tools. Klein. Aber es heißt, dass "3.7 schlägt 3.6 in allem" keine wahre Aussage ist, und wenn Diagramme Ihr Workload sind, sollten Sie das vor der Migration prüfen.
Es gibt noch eine Zahl, die nur in unabhängigen Tests auftaucht. Artificial Analysis misst eine Halluzinationsrate von 64.5 % bei 3.7 Flash gegenüber 55.6 % bei 3.6 Flash. Die Genauigkeit ist gestiegen, und die Halluzination ist mit gestiegen.
Fairerweise gegenüber Google: Diese Zahl sieht je nach Vergleichsbasis sehr unterschiedlich aus. Ein Leser, der auf Reddit dieselben Daten durchgegangen ist, hat sie in einen größeren Zusammenhang gestellt:
"Flash 3 had 93 % hallucination but also very good world knowledge. 3.7 Flash has 65 %. This is a considerable improvement but it still lacks behind 3.1 Pro. […] Both Gemini Flash and GPT Sol are very good at getting the right answer, better than all other models except Claude Fable and Opus. It's just that when they don't get it right hallucination is likely or almost guaranteed."

Also: deutlich besser als Flash 3. Etwas schlechter als das Modell, das es direkt ablöst, und immer noch hinter 3.1 Pro. Dieser letzte Punkt ist der, der zählt, und weiter unten komme ich darauf zurück, warum er mich nicht schlafen lässt.
Zwei Vorbehalte zur Quellenlage. Artificial Analysis hat keinen 3.7-Flash-Wert für SWE-Bench Verified, AIME, LiveCodeBench oder MMLU-Pro, jede Zahl, die dazu kursiert, stammt also aus Googles eigenem Diagramm und nicht aus einem unabhängigen Lauf. Außerdem widersprechen sich die Quellen beim Kontextfenster: Artificial Analysis nennt 1,000,000, Googles Vertex-Karte 1,048,576.
Was es kostet und das Datum, an dem dieser Preis endet
Die Schlagzeile lautet $0.75 pro 1 Mio. Input-Tokens und $3.75 pro 1 Mio. Output-Tokens. Das Sternchen ist die ganze Geschichte.
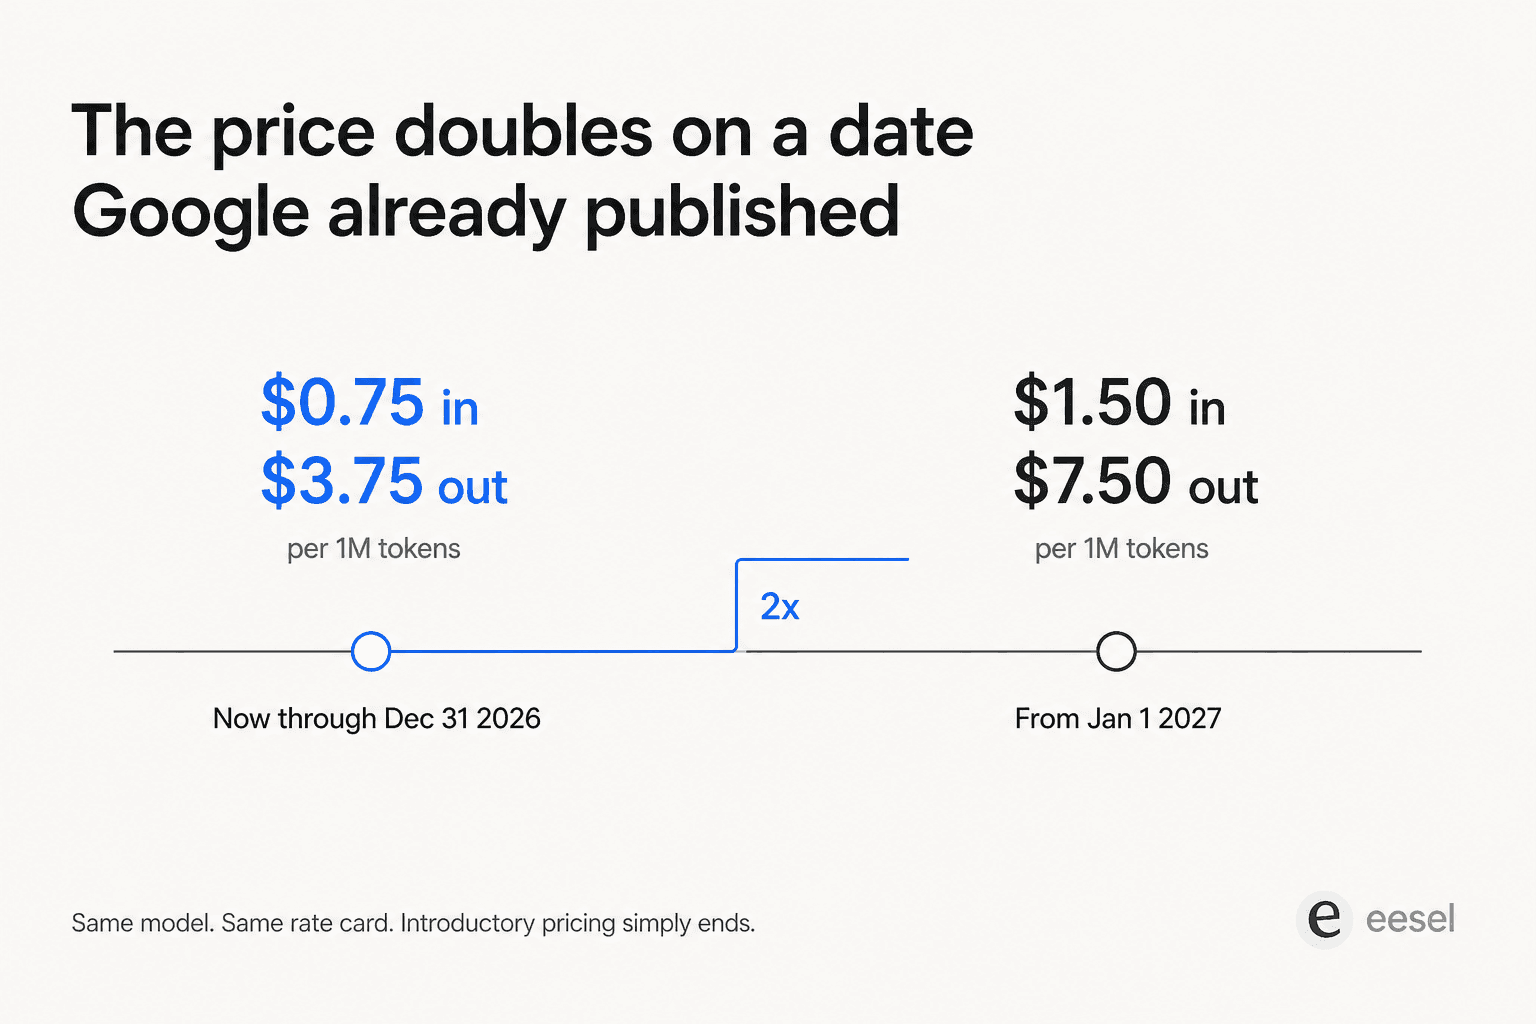
Hier die vollständige Preisliste von Googles Preisseite:
| Posten | Bis 31. Dez. 2026 | Ab 1. Jan. 2027 |
|---|---|---|
| Input, pro 1 Mio. Tokens | $0.75 | $1.50 |
| Output (inklusive Denken), pro 1 Mio. | $3.75 | $7.50 |
| Batch-Modus Input / Output | $0.375 / $1.875 | $0.75 / $3.75 |
| Flex-Modus | Wie Batch | Wie Batch |
| Priority-Modus | $1.35 / $6.75 | $2.70 / $13.50 |
| Context-Cache-Lesezugriff, pro 1 Mio. | $0.075 | $0.15 |
| Context-Cache-Speicherung, pro 1 Mio. pro Stunde | $0.50 | $1.00 |
| Google-Search-Grounding | 5,000 kostenlose Anfragen/Monat über alle 3.x-Modelle, danach $14 pro 1,000 | Gleich |
Einige Punkte lohnen sich herauszugreifen. Es gibt keine Preisstufe nach Kontextlänge, ein Prompt mit 900k Tokens kostet pro Token also dasselbe wie einer mit 900 Tokens, anders als bei 3.1 Pro Preview. Es gibt auch keinen Modalitätsaufschlag, Audio- und Video-Input werden zum gleichen Satz wie Text abgerechnet, während 3 Flash Preview für Audio das Doppelte verlangt. Und Grounding wurde über die 3.x-Generation deutlich günstiger und fiel von $35 pro 1,000 Anfragen auf $14.
Merkwürdig ist, dass Gemini 3.6 Flash jetzt identisch wie 3.7 Flash bepreist ist, mit demselben Einführungspreis, demselben Ablaufdatum und auch demselben Standardpreis danach. Googles Fließtext beschreibt 3.7 Flash als etwa halb so teuer wie das ursprüngliche 3.6 Flash, was gegenüber dem Listenpreis stimmt, aber nicht gegenüber dem, was 3.6 Flash Sie heute kostet. Das neuere Modell hat keinen Aufpreis, was vor allem bedeutet: Es gibt keinen Grund, bei 3.6 zu bleiben, außer CharXiv oder minimal sind für Sie tragend. Unsere Preisaufschlüsselung zu 3.6 Flash gilt weiterhin, denn jetzt ist es dieselbe Preisliste.
Setzen Sie hier Ihr eigenes Volumen ein:
Sie zahlen für Denken, das Sie nie sehen
Das ist der Posten, der Leute überrascht, und er steht klar in Googles Thinking-Dokumentation: "When thinking is turned on, response pricing is the sum of output tokens and thinking tokens."
Dann der schärfere Satz, ein paar Absätze weiter unten: "Pricing is based on the full thought tokens the model needs to generate, despite only the summary being output from the API."
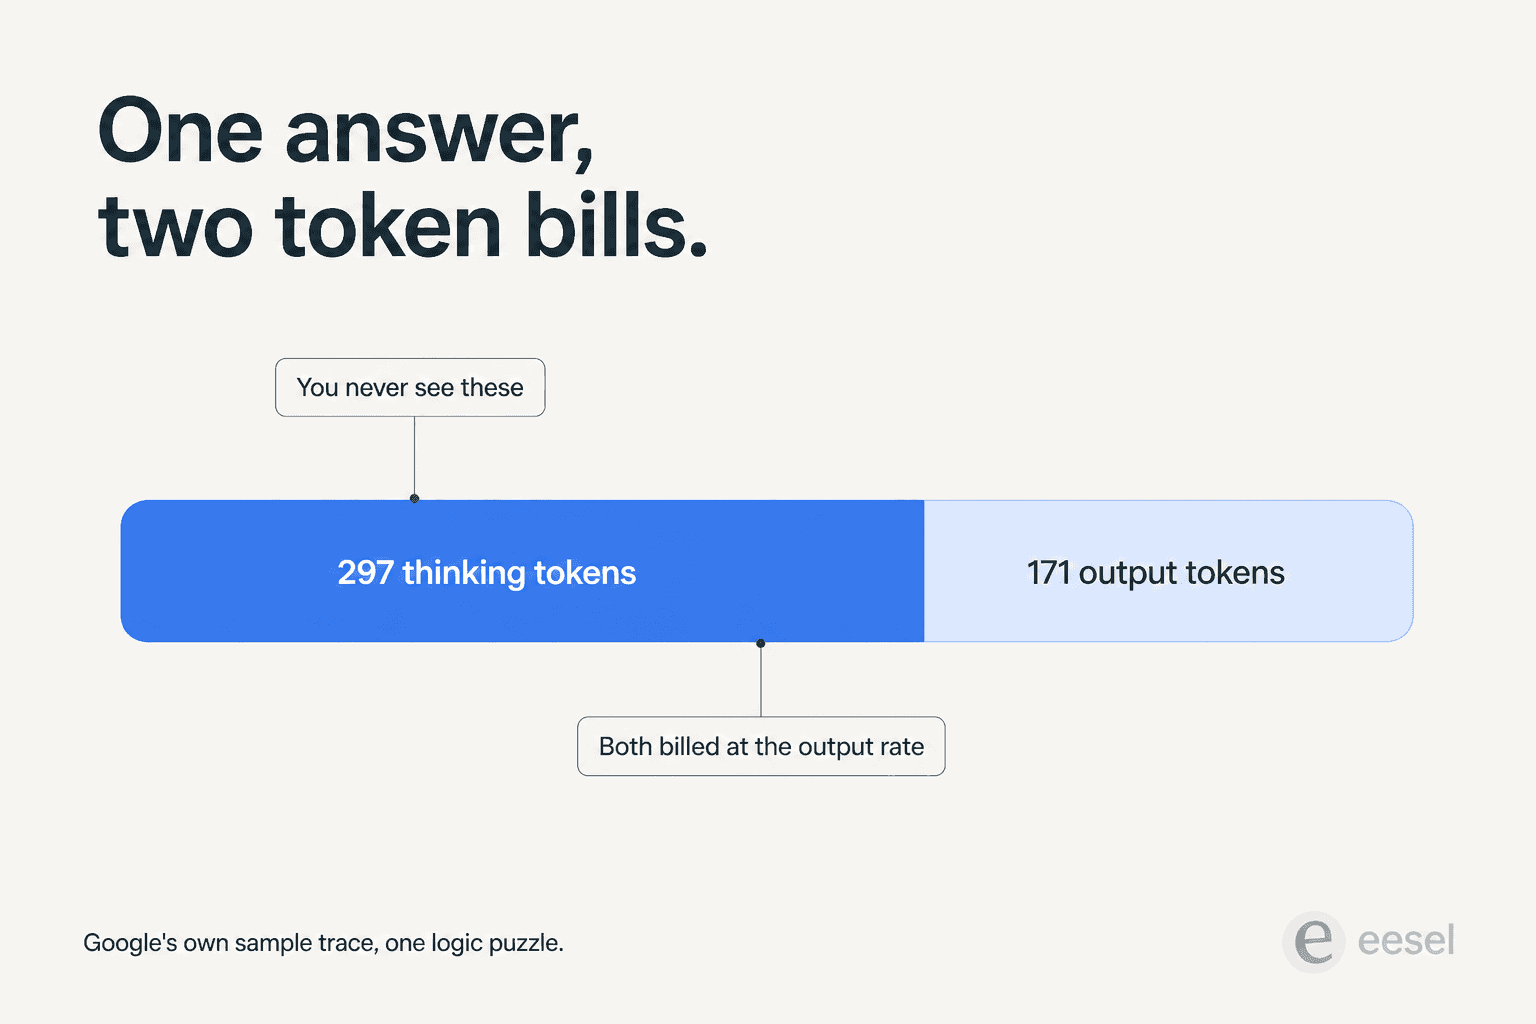
Googles eigener Beispiel-Trace zu einem Logikrätsel mit drei Hinweisen verbraucht 297 Denk-Tokens gegenüber 171 Output-Tokens. Fast zwei Drittel der Output-Rechnung dieser Antwort entfielen also auf Reasoning, das der Aufrufer nie erhält, nur eine Zusammenfassung davon. Die Zahl wird als usage.total_thought_tokens ausgegeben, Messen ist also möglich, aber man muss danach suchen. Wenn Sie mehrere Modelle nebeneinander betreiben, ist das genau die Art von Sache, die LLM-Tracking-Tools auffangen sollen.
Auf einen Produktions-Workload hochgerechnet wird medium als Standard zu einer echten Entscheidung statt zu einem Achselzucken. Es ist auch der Grund, warum der Regler für den Denk-Overhead im Rechner oben auf 75 % steht und nicht auf null.
Manche Entwickler halten den zusammengefassten Ansatz für schlimmer als nutzlos. Aus dem Launch-Thread:
"I really, really like DSv4 Flash because you see the full, real thinking text. That's been so useful for helping steer the model; as well as seeing its thoughts and correcting any errors, or expanding on it. It's so difficult for me to use closed models with no or summarised thinking now."
Was Entwickler tatsächlich sagen
Der Launch-Thread erreichte in etwa acht Stunden 621 Punkte und 347 Kommentare, und seine Form ist interessanter als der Punktestand.
Die am häufigsten zitierte Zahl im ganzen Thread ist der Preis eines Konkurrenten:
"Ever since the insane discount with GPT-5.6 Luna, not much excites me anymore. I mean just look at the benchmarks, even though Gemini 3.7 Flash performs well on the DeepSWE 1.1, Luna (Max) still performs way better.
> Starting January 1, 2027, $1.50/1M input tokens and $7.50/1M output tokens will apply.
Compare this to Luna which is at $0.2/1M input ($0.02 cached) and $1.2/1M output."
Die Korrektur der Positionierung kam ein paar Kommentare später, und sie ist das Nützlichste im ganzen Thread:
"They need to release benchmarks against Luna/Terra. Luna is much cheaper which feels like it undercuts the need for Flash.
I've always considered the Flash series of models to be for low-cost, high-volume, mostly text-based use cases (e.g. summarization, parsing, formatting), emphasis on low-cost."
Das ist die Neurahmung. Flash konkurriert nicht mehr am unteren Ende des Marktes; dort steht jetzt Flash-Lite. Wenn Sie Flash geliebt haben, weil es günstig war, liegt das Modell, das Sie als Nächstes wollen, eine Stufe darunter oder ganz außerhalb der Google-Familie.
Die naheliegenden Anlaufstellen sind Qwen und Kimi. Wenn Sie einen westlichen Anbieter mit ähnlichem Budget suchen, ist Mistral der engste Vergleich.
Das schärfste Urteil aus der Praxis kam aus einem Image-to-HTML-Test über opencode, der 3.7 Flash gegen Claude Opus 5 und Grok antreten ließ:
"It's not a bad model by any means, but I just don't know what situation I'd reach for 3.7 Flash first for. Google really needs a differentiator, especially given how hard it is to get an API key from them. They can't be high friction and non-pareto."
Dieser letzte Halbsatz eröffnete den größten Unter-Thread des Tages, und das Modell war gar nicht sein Thema. Das Thema war, ob man bei Google überhaupt kaufen kann. Ein Kommentator berichtete von der Fehlermeldung "Failed to create project, The request is suspicious. Please try again" bei einem frischen Key, ein anderer von demselben Problem bei einem zehn Jahre alten Cloud-Konto, das erst zwei Tage später funktionierte. Der operativ schmerzhafteste Bericht:
"There are places where you CAN set a limit. This seems great until you are at the center of a huge traffic spike because of good pr and so you try to change it to a larger number only to be told you need to wait 24 hours for the setting to change.
Biggest traffic day of the decade and our site was down because of google."
Fairerweise wird das weiter unten im Thread bestritten. Ein Kommentator hat auf einem frischen Konto in zwei Klicks und ohne die Seite zu verlassen einen Key erstellt, und Google liefert inzwischen Ausgabenlimits für die Gemini API. Die Reibung ist also für manche real und für andere kein Thema, was ein eigenes Problem ist. Zum Vergleich: OpenAI-Ratenlimits und die Preise der GPT-5-Pro-API sind so dokumentiert, dass die meisten ohne ein einziges Support-Ticket durchkommen.
Wo Flash eindeutig gewinnt
Bei Vision und Dokumenten. Das ist die eine Achse, bei der selbst die Kritiker im Thread zustimmen mussten.
Schauen Sie noch einmal in die Benchmark-Tabelle: GDP.pdf mit 34.0 % gegenüber Terras 24.7 %, LVBench mit 85.4 % gegenüber 68.5 % bei Sonnet 5, dazu der Needle-Test mit 128k Kontext bei 97.0 %. Das ergibt ein stimmiges Bild und nicht drei glückliche Zeilen. Ein Kommentator hat die praktische Version besser beschrieben, als es ein Benchmark könnte: Gemini diagnostizierte ein Pflanzenproblem anhand eines Fotos richtig, nachdem ein textorientiertes Modell danebengelegen hatte.
"That's been my association as well. I see Flash get brought up a lot in relation to things like OCR and PDF processing frequently, and a lot of other routine multimodal workloads."
Es gibt auch ein Skalierungsargument, und es hat mich überrascht:
"did you try to ingest 1M documents per hour with any provider except GCP with Flash? None work at scale. Deepseek, Luna, Mistral all fail. 1 in 3 requests is a fail. I stopped trying. The only thing that works at scale is gemini flash."
Günstig pro Token und zuverlässig im Volumen sind zwei verschiedene Dinge, und diese Unterscheidung überspringen die Preisvergleichs-Threads meistens.
Googles genannte Kunden landen am selben Punkt. Browser Use-Mitgründer Gregor Zunic berichtet, der Agent sei "35% cheaper than 3.6 Flash, with a +8% observed prompt-cache hit rate and fewer tool errors." Lesen Sie das als Gesamtausgaben und nicht als Preisliste, denn beide Modelle werden heute identisch abgerechnet; die Ersparnis kommt aus Cache-Treffern und weniger wiederholten Tool-Aufrufen. Harveys Niko Grupen berichtet von +2.6 Punkten All-Pass im Legal Agent Bench. Kyrill Hux von Nunu.ai nennt es gleichauf mit GPT-5.6 Terra "at around half the cost." Das sind vom Anbieter gelieferte Zitate auf einer Launch-Seite, gewichten Sie sie entsprechend.
Die nützlichste Einschätzung von dritter Seite kam von Cognition, die es in Devin eingebaut haben und dann genau sagten, wo es passt:
"On FrontierCode 1.1, it reaches Claude Sonnet 5-level performance at less than half the cost, with the low latency the Flash series is known for. […] Within Devin, Gemini 3.7 Flash performs particularly well on tightly scoped refactors, where it delivers minimal diffs that match repo conventions."
"Tightly scoped refactors" ist eine präzise und ehrliche Grenze, und sie deckt sich mit dem, was die Terminal-Agenten-Benchmarks über das Ende mit langem Horizont sagen.
Wer Gemini 3.7 Flash nutzen sollte und wer nicht
Greifen Sie zu, wenn Sie Dokumentenextraktion, PDF- und Diagrammarbeit, Retrieval über langen Kontext, Videoverständnis oder Web- und UI-Code-Generierung aus Mockups betreiben. Code Arenas 1588 Elo ist der Spitzenwert in Googles Tabelle, und bei den Dokument-Benchmarks ist der Abstand nicht knapp. Es ist auch die richtige Wahl, wenn Sie bereits auf Antigravity sind, denn dort ist es jetzt der Standard.
Lassen Sie es aus, wenn Ihr Workload ein Terminal-Coding-Agent mit langem Horizont ist, denn dort gewinnt GPT-5.6 Terra genau jene vier Benchmarks, die das messen. Lassen Sie es auch aus, wenn Sie wegen der Preisuntergrenze zu Flash gekommen sind. Zwischen dem Wegfall von minimal, Denk-Tokens, die als Output abgerechnet werden, und einem Preis, der sich im Januar verdoppelt, ist das Argument der günstigen Stufe still zu Flash-Lite und zu Wettbewerbern gewandert, die beim Output eine Größenordnung darunter liegen.
Warten Sie, wenn Sie auf 3.6 Flash sind und CharXiv-artiges Diagramm-Reasoning für Sie tragend ist. Sie würden das gleiche Geld für zwei Benchmark-Zeilen zahlen, die etwas schlechter werden.
Wenn Sie das Feld weiter abwägen, lohnen sich diese Übersichten: Gemini-Alternativen, Gemini-3-Alternativen und Claude-Alternativen.
Beim Tooling zählt das Modell weniger als das Harness, in dem Sie es betreiben. Die meisten, die das hier lesen, begegnen 3.7 Flash über einen Editor und nicht über einen rohen API-Aufruf, und unsere Notizen zu den besten KI-Coding-Assistenten, zu agentischen Coding-CLIs und zu den Cursor-Preisen decken diese Ebene ab.
Was das bedeutet, wenn Sie ein Modell auf eine Support-Queue setzen
Zurück zur Halluzinationszahl, denn hier beginnt mein Tagesjob.
Artificial Analysis misst bei Gemini 3.7 Flash eine Halluzinationsrate von 64.5 %, gegenüber 55.6 % bei 3.6 Flash. Die Genauigkeit hat sich verbessert, und die Halluzination ist gleichzeitig schlechter geworden. Diese Kombination ist kein Widerspruch; es ist die normale Form eines Modells, das darauf getrimmt wurde, sich auf Antworten festzulegen, statt sich abzusichern. Großartig für einen Coding-Agenten, den ein Compiler korrigieren kann. Ein Risiko, wenn die Ausgabe direkt zum Kunden geht.
Jemand, der genau diesen Workload in Produktion betreibt, hat die Grenze besser gezogen, als ich es könnte:
"Yeah we use it for auto-triage of incidents, attempts to auto-remediate, and escalation to human. But for actual development, it's not a viable option for us."
Triage, dann Versuch, dann Eskalation. Das ist die richtige Form, und beachten Sie, dass der Mensch dort der letzte Schritt ist und kein nachträglicher Einfall.
Wir betreiben seit Jahren KI-Agenten auf Live-Helpdesks mit echtem Volumen, darunter ein Kreditgeber, der über 100.000 deutschsprachige Tickets pro Monat durch Zendesk schleust, und ein E-Commerce-Team mit über 50.000 pro Monat in Freshdesk. Diese Erfahrung lehrt, dass ein Benchmark-Wert fast nichts darüber sagt, wie sich ein Modell bei Ihren Tickets verhält. Zwei Teams mit demselben Modell, demselben Helpdesk und derselben Branche bekommen unterschiedliche Antworten, weil ihre Wissensdatenbanken unterschiedlich geformt sind.
Die Modellwahl zählt also weniger als das, was drumherum sitzt. Retrieval, das tatsächlich das richtige Dokument findet, und das ist ein RAG-Problem und kein Modellproblem. Confidence-Routing, damit eine Antwort mit geringer Sicherheit zum Entwurf wird statt zum Versand. Und dann ein Probelauf gegen Ihren eigenen Ticketverlauf, bevor ein Kunde auch nur ein Wort davon sieht, der Schritt, den die meisten Einführungen von Support-Automatisierung auslassen.
Beachten Sie, dass keiner davon das Modell selbst ist. Die meisten Gründe, warum ein KI-Chatbot falsch antwortet, sind Inhalts- und Retrieval-Fehler und nicht, dass das Modell nicht klug genug wäre, und die Pflege der Wissensdatenbank bewegt die Zahl meist weiter als der Wechsel auf das, was diese Woche gelauncht wurde.
Dieser letzte Punkt ist das ganze Argument. Eine Halluzinationsrate von 64.5 % lässt sich nicht von einer Rangliste ablesen und dann auf das übertragen, was Ihre Kunden bekommen. Was Sie tun können: den Agenten über 500 Ihrer geschlossenen Tickets laufen lassen und die Antworten selbst lesen. Es ist auch der einzige ehrliche Weg, Ticket-Automatisierungstools zu vergleichen oder zwischen KI-Helpdesk-Plattformen zu wählen, denn jede Demo eines Anbieters basiert auf dessen Daten und nicht auf Ihren.

Wenn der Grund, warum Sie überhaupt Tokens bepreisen, ein Support-Budget ist, dann ist der günstigere Vergleich, den Sie zuerst anstellen sollten, KI-Agent vs. menschliche Kosten, der den Unterschied zwischen $3.75 und $7.50 pro Million tendenziell in den Schatten stellt. Wir haben das in KI-Einsparungen im Support mit Zahlen unterlegt.
eesel ausprobieren
Wenn Sie hier sind, weil Sie Gemini 3.7 Flash für den Support evaluieren, lautet der ehrliche Rat: Hören Sie auf, Modellkarten zu vergleichen, und fangen Sie an, an Ihren eigenen Tickets zu testen. Dafür ist eesel gebaut: Es verbindet sich in wenigen Minuten mit Zendesk, Freshdesk, Gorgias, HubSpot, Front oder Slack, lernt aus den Tickets, die Sie bereits gelöst haben, und nicht nur aus Ihrem Help Center, und führt dann eine Simulation über Ihren Ticketverlauf durch, sodass Sie die exakten Antworten sehen, die es gesendet hätte, pro Thema, bevor irgendetwas live geht.
Es ist ein fester Monatspreis, ab $299/Monat für 500 Credits (1 Credit pro Ticket oder Chat) ohne Gebühr pro Platz, sodass sich die Rechnung leichter mit einer Token-Rechnung vergleichen lässt, als es die meisten Anbieter ermöglichen. Ein Kunde hat im ersten Monat 73 % der Tier-1-Anfragen gelöst, und die Ergebnisse waren innerhalb einer siebentägigen Testphase sichtbar.
Testen Sie eesel kostenlos, lassen Sie es über Ihre letzten paar hundert Tickets laufen und lassen Sie dann die Simulation entscheiden, ob das Modell gut genug ist oder nicht. Diese Antwort ist mehr wert als jede Benchmark-Tabelle auf dieser Seite, meine eingeschlossen.