Wie ich getestet habe
Ich verbringe meine Tage mit Suchintention und dem Blick eines Builders auf das Produkt hinter dem Marketing, deshalb ist mein Vorgehen bei einem Launch wie diesem bewusst unspektakulär. Ich habe Xiaomis Pressetext übersprungen und bin direkt zu den Modellkarten auf Hugging Face gegangen, habe die Werte mit dem unabhängigen Artificial Analysis Index abgeglichen und dann rund 670 Kommentare in den Launch-, Trainings-Dashboard- und Preisanalyse-Threads auf Hacker News gelesen, um zu sehen, was Leute, die das Modell im Ernstfall einsetzen, tatsächlich berichten.
Ich habe nicht wie bei den Tools, die ich täglich baue, ein Jahr lang mit MiMo gelebt, deshalb mache ich klar, wo ich Recherche wiedergebe und wo ich aus eigener Nutzung berichte. Dieser Unterschied ist bei einem erst wenige Tage alten Modell wichtig, und die meisten „Reviews“, die Stunden nach einem Launch erscheinen, lassen ihn stillschweigend weg.
Was MiMo V2.6 wirklich ist
MiMo V2.6 ist eine Familie offener, nativ omnimodaler Sprachmodelle von Xiaomis MiMo-Team, veröffentlicht am 22. September 2026. „Nativ omnimodal“ ist hier berechtigt: Dasselbe Modell verarbeitet Text, Bilder, Video und Audio, statt einem Textmodell nachträglich einen Vision-Adapter aufzusetzen. Jeder Checkpoint bietet ein 1M-Token-Kontextfenster unter MIT-Lizenz.
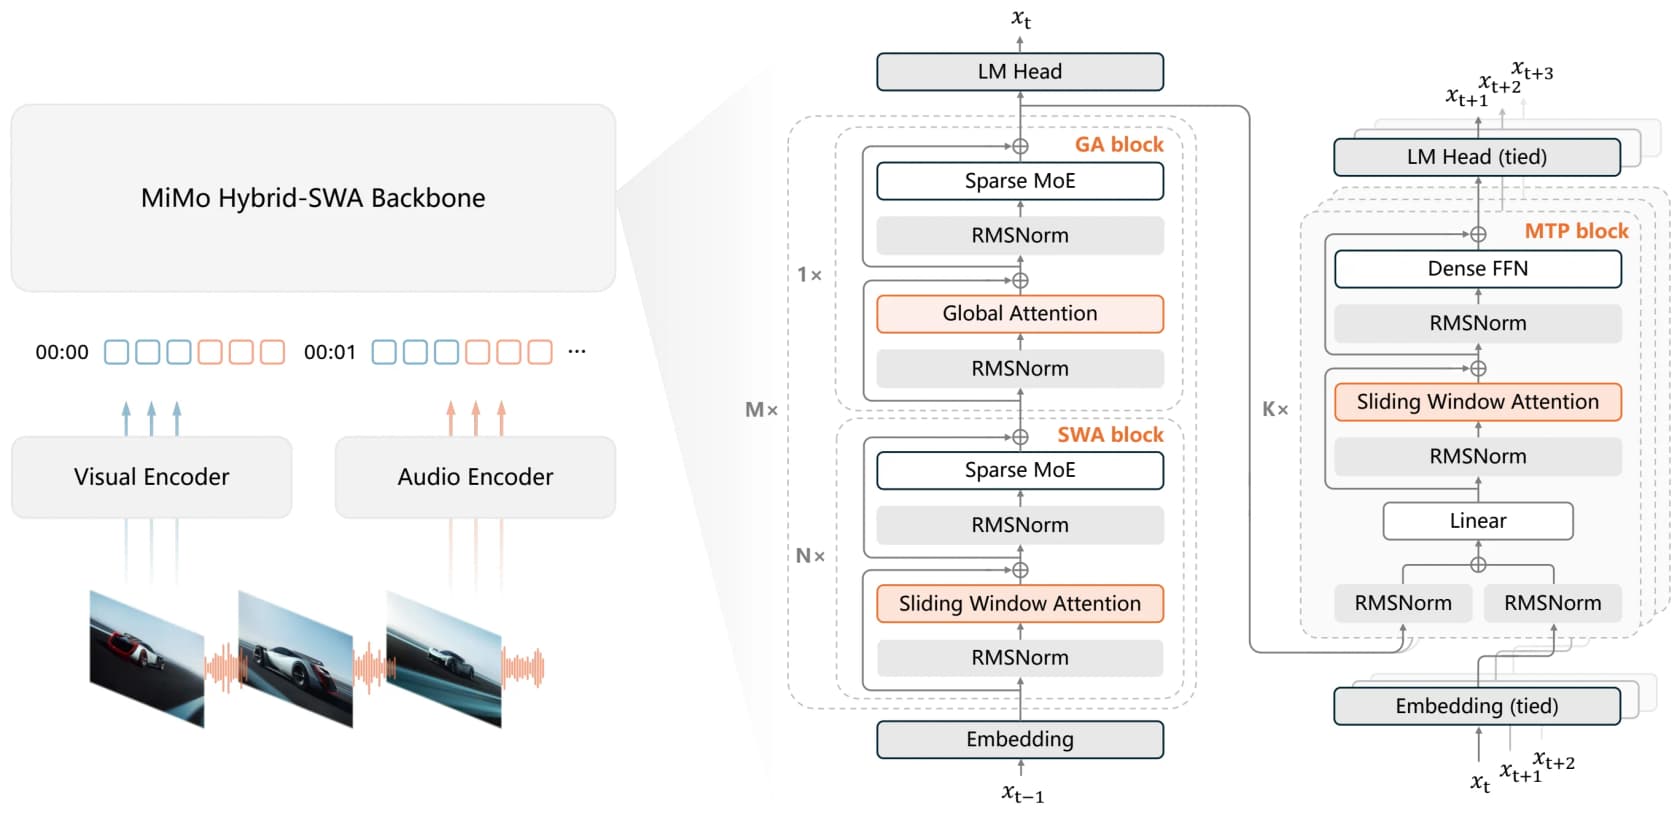
Der Builder-Blick in einem Absatz: Pro ist ein Sparse-Mixture-of-Experts mit 1,02 Billionen Parametern insgesamt, aber nur 42B aktiven pro Token, mit einem hybriden Attention-Backbone (70 Schichten, die lokales Sliding-Window und globale Attention abwechseln), 384 routbaren Experten, von denen 8 pro Token feuern, einem 681M-Vision-Encoder, Audio-Encodern und einem fünfschichtigen Multi-Token-Prediction-Decoder. Das musst du nicht wissen, um es zu nutzen, aber es erklärt, warum ein „1-Billionen-Parameter“-Modell günstig bleibt: Bezahlt wird die Zahl der aktiven Parameter, nicht die Gesamtzahl.
Es erscheint in vier Checkpoints, und genau daher kommt ein Großteil der Verwirrung im Netz:
| Modell | Parameter gesamt | Aktive Parameter | Kontext | Am besten für |
|---|---|---|---|---|
| MiMo V2.6 Pro | 1,02T | 42B | 1M | Die anspruchsvollsten Agentenaufgaben mit langem Zeithorizont |
| MiMo V2.6 Flash | 309B | 15B | 1M | Die beste Balance aus Intelligenz, Geschwindigkeit und Kosten |
| MiMo V2.6 Pro UltraSpeed | ~1T | 42B | 1M | Pro-Qualität, wenn du schnelle Ausgabe brauchst |
| MiMo V2.6 Distill-Qwen-9B | 9B | 9B | n/a | Einzelne GPU und offene Agenten-RL-Forschung |
Flash ist das Modell, zu dem die meisten greifen werden. UltraSpeed ist derselbe Pro-Checkpoint, nur rund 10x schneller ausgeliefert zum 10-fachen Preis – also ein Latenz-Aufpreis, kein intelligenteres Modell. Die 9B-Distill-Variante ist ein Supervised-Fine-Tune von Qwen3.5-9B auf MiMo-generierten Daten, ein Ausgangspunkt für Forschung statt für den Produktivbetrieb.
Die Benchmarks, ehrlich gelesen
Jeder Launch pickt sich seine Charts heraus, deshalb bin ich zur Bewertungstabelle auf der Modellkarte gegangen und habe sie in Gewinne und Verluste aufgeteilt. Xiaomi muss man zugutehalten, dass beides veröffentlicht wird.
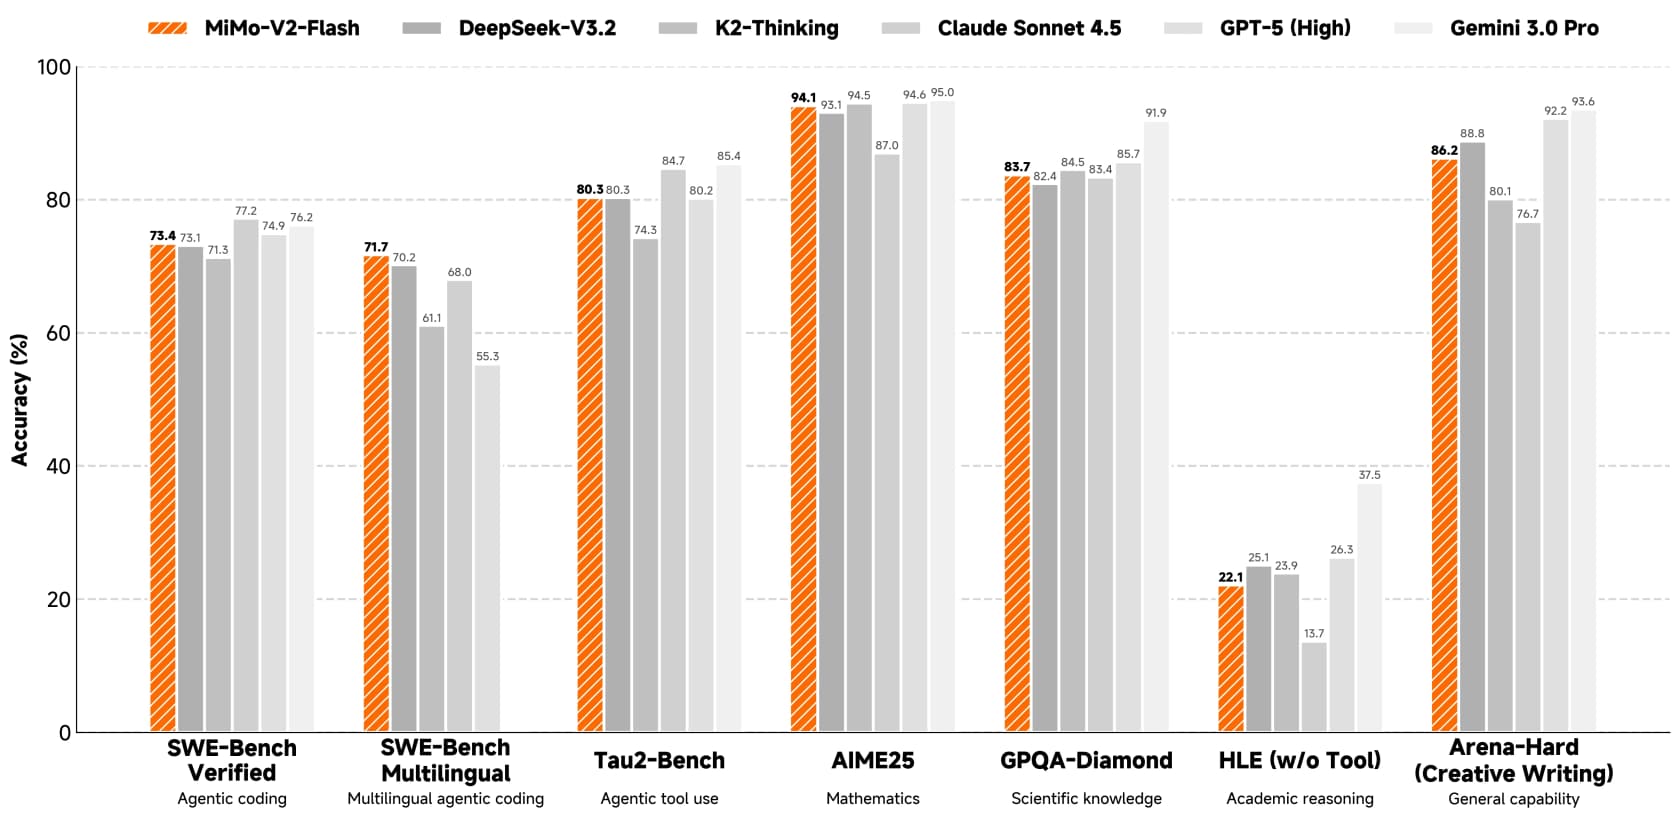
Wo Pro laut Xiaomis Zahlen vor der geschlossenen Spitze liegt:
| Benchmark | MiMo V2.6 Pro | Claude Opus 5 | GPT-5.6 Sol |
|---|---|---|---|
| AutomationBench v1.0.6 | 53,1 | 50,3 | 45,8 |
| Terminal Bench 2.1 | 89,9 | 89,1 | 88,8 |
| Agents' Last Exam | 31,6 | 31,6 | 30,8 |
| CyberGym | 94,0 | - | - |
Und wo es zurückbleibt, was das Terminal Bench 4.0 Board deutlich zeigt:
| Benchmark | MiMo V2.6 Pro | Claude Opus 5 | GPT-5.6 Sol |
|---|---|---|---|
| DeepSWE v1.1 | 71,9 | 74,0 | 73,0 |
| ProgramBench | 26,5 | 37,0 | 25,0 |
| Terminal Bench 4.0 | 34,9 | 49,0 | 39,9 |
| ExploitBench | 47,9 | 70,0 | 78,5 |
Das Muster ist konsistent und, wie ich finde, glaubwürdig: Bei allgemeinen Agenten- und Tool-Use-Aufgaben liegt Pro direkt auf Augenhöhe mit der Spitze, bei den härtesten Coding- und Exploit-Benchmarks mit langem Zeithorizont fällt es zurück. Als Xiaomi den Vergleich um GPT-6 Astra erweiterte, blieb das Muster gleich: Pro landet bei AutomationBench und Terminal Bench 2.1 nahe der Spitze und hinter Astra bei Terminal Bench 4.0 (59,6).
Der Generationssprung ist das, was mich tatsächlich beeindruckt hat. Das vorherige MiMo V2.5 Pro erreichte 19,0 bei DeepSWE v1.1; V2.6 Pro erreicht 71,9. Bei Terminal Bench 4.0 ging es von 1,5 auf 34,9. Das ist kein inkrementeller Fortschritt, sondern die Art von Sprung, die man nur sieht, wenn ein Labor seinen Trainingsansatz ändert.
Eine Zahl verdient eher ein Warnsignal als Applaus. Pro erreicht bei CyberGym 94,0, wo V2.5 nur auf 40,0 kam, doch das kompromisslosere ExploitBench zeigt mit 47,9 ein bescheideneres Bild. Ich würde das CyberGym-Ergebnis als beeindruckend lesen, nicht als ausgemacht.
Die Preis-Leistungs-Rechnung ist die eigentliche Geschichte
Einzelne Benchmarks sind verrauscht. Die Zahl, auf die ich wirklich achte, ist der aggregierte Index von Artificial Analysis, weil er viele Evaluierungen zu einem vergleichbaren Score zusammenfasst und ihn gegen die Kosten aufträgt.
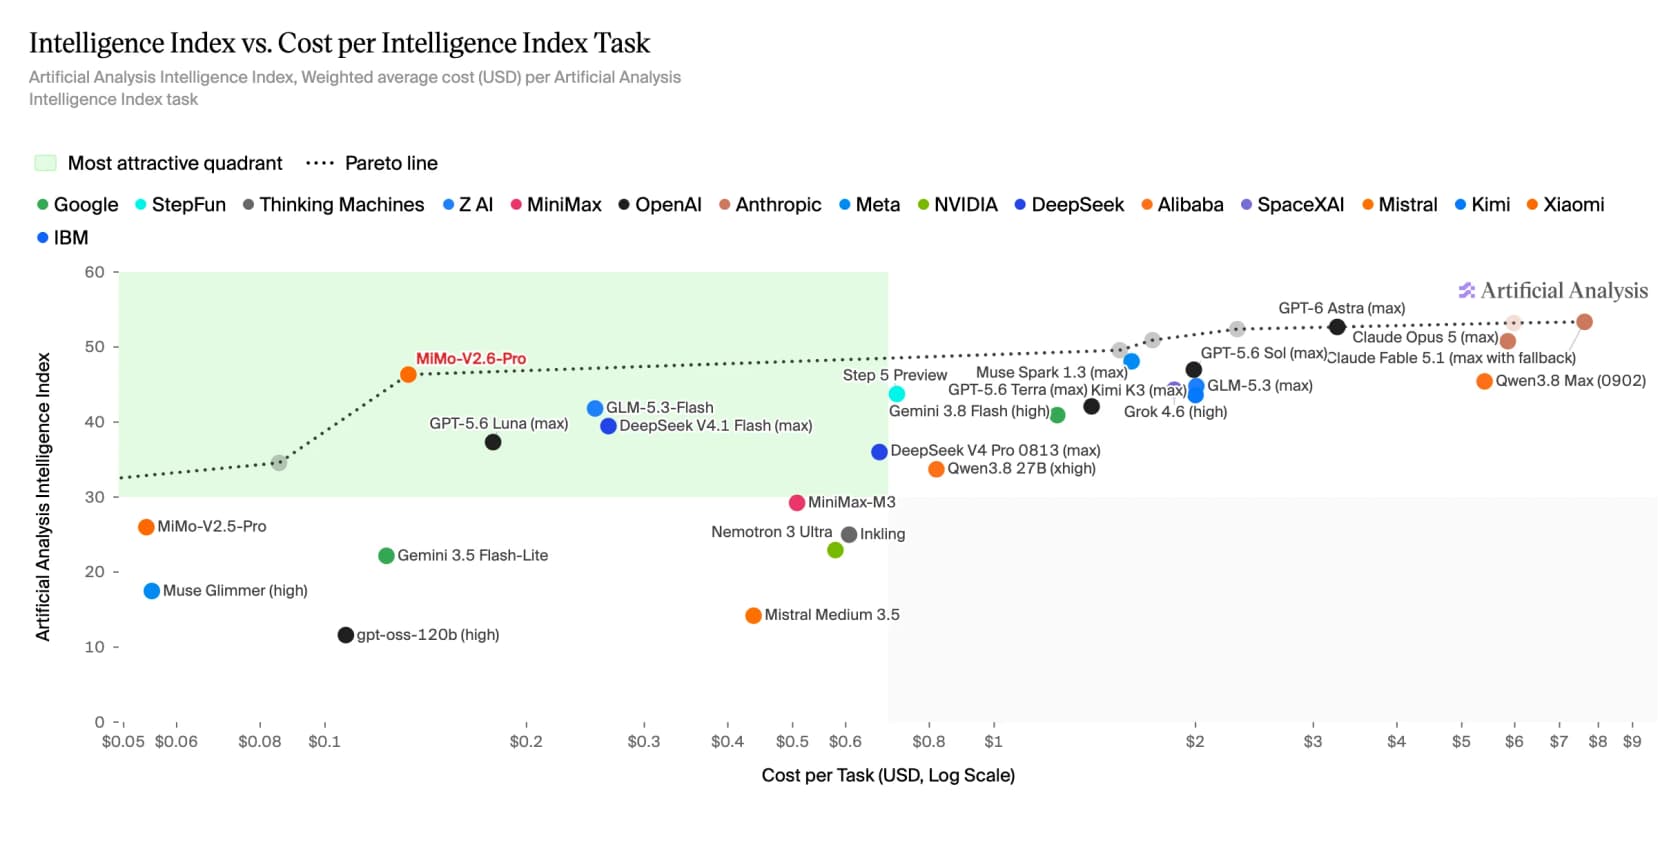
MiMo V2.6 Pro landet bei einem Intelligence Index von 46, dem besten offenen Modell im Feld, und zwar genau in dem, was Artificial Analysis wörtlich den „attraktivsten Quadranten“ nennt. Die geschlossene Spitze erreicht bei der reinen Intelligenz höhere Werte (Astra, Opus 5 und Fable 5.1 liegen im niedrigen bis mittleren 50er-Bereich), aber zu $3 bis $8 pro Aufgabe. MiMo schafft seine 46 für etwa $0,13.
Dieses Preis-Intelligenz-Verhältnis ist das gesamte Argument. Hier die gehosteten OpenRouter-Preise pro Million Tokens, geprüft in der Launch-Woche:
| Modell | Input / 1M | Output / 1M | Kontext |
|---|---|---|---|
| MiMo V2.6 Flash | $0,14 | $0,28 | 1M |
| MiMo V2.6 Pro | $0,435 | $0,87 | 1M |
| MiMo V2.6 Pro UltraSpeed | $4,35 | $8,70 | 1M |
Flash ist mit $0,14 Input / $0,28 Output bemerkenswert günstig für ein omnimodales Modell mit 1M Kontext. Für die meisten Teams ist Flash die Standardwahl, und Pro ist die Eskalationsstufe.
Welcher MiMo-V2.6-Checkpoint passt zu dir
Die vier Checkpoints sind das mit Abstand verwirrendste an diesem Launch, deshalb hier ein schnelles Entscheidungstool. Beantworte die drei Fragen, und es zeigt dir den passenden Checkpoint (oder rät ganz von MiMo ab).
Was Leute, die es tatsächlich genutzt haben, sagen
Benchmarks sind Xiaomis Geschichte; ich wollte die Geschichte der Nutzer. Die dominierende Reaktion im Launch-Thread drehte sich überhaupt nicht um die Scores. Es ging darum, wie offen Xiaomi das Ding trainiert hat.
"I really like how transparent they've been about the training of this model. The realtime dashboard they shared during training was an incredible learning and teaching tool for me, and they've been unusually comprehensive in sharing details about their methodology... and benchmark scores (even the stuff they didn't do well on)."

"The best thing they did is being open about all the setbacks they had to deal with. They logged every restart with a reason, talked about dropping a cyber dataset after it degraded coding benchmarks. Also published real time training loss, benchmark scores after every checkpoint and running cost estimates."
Dieses Detail, einen Cyber-Datensatz fallengelassen zu haben, weil er die Coding-Scores verschlechterte, ist die Art von Ding, die Labore fast nie zugeben, und es trägt maßgeblich dazu bei, dass der Launch selbst bei Skeptikern Sympathien gewonnen hat. Die schärfste einzelne technische Einschätzung kam von einem langjährigen MiMo-Nutzer, der die Benchmarks von Hand durchgezählt hat:
"Mimo 2.6 pro, the 1T model leads Kimi K3, a 2.8T param model in 14 out of 15 benchmarks (and the last one is near tie)!! Good to see they also kept the price the same, and landed in the greenest quadrant of the intelligence vs speed of AA."
Es war nicht nur Lob. Die Sorge, die jedes starke offene Modell aus China begleitet, ist Benchmaxxing – großartige Scores und enttäuschende Ergebnisse in der echten Arbeit:
"No chinese lab has caught up yet. They've tried to fake it by distilling and overfitting on benchmarks to make their models look better than they are, the 'best' models available from chinese labs right now (GLM 5.3 and Kimi K3) fall apart completely when you try to do real work with them."
Das Gegengewicht kam von Leuten, die die Modellreihe bereits produktiv einsetzen. Die Preis-Leistungs-Einschätzung geht mir am meisten im Kopf herum, wobei sie sich auf das vorherige V2.5 bezieht, das mehrere Leute bei schweren Aufgaben auch als schnell, aber dumm bezeichneten:
"I been using MiMo-V2.5 to do most of my work as software engineer... I been VERY happy with ROI. The model is very powerful!... The cost is unbelievably low, and the quality of intelligence I get is equivalent to when I was working mostly with Anthropic models... but when I add cost of M-token in the ROI math, Jeez! MiMo is an order of magnitude better."
Auf X wurde der Launch größtenteils als Seitenhieb gegen Grok 4.7 gelesen, das am selben Tag erschien, mit Reaktionen von „Better than Grok 4.7“ bis zu einem abgewogenen „let's wait for real-world test performance first.“ Diese Mahnung zur Praxis ist die richtige, und genau deshalb ist V2.5s Ruf als „schnell, aber dumm bei schweren Aufgaben“ die Messlatte, die V2.6 im Alltagseinsatz überspringen muss, nicht nur in den Charts.
Mein Fazit: das beste Preis-Leistungs-Verhältnis unter offenen Modellen, nicht das intelligenteste Modell
Hier lande ich nach einer Woche mit der Recherche.
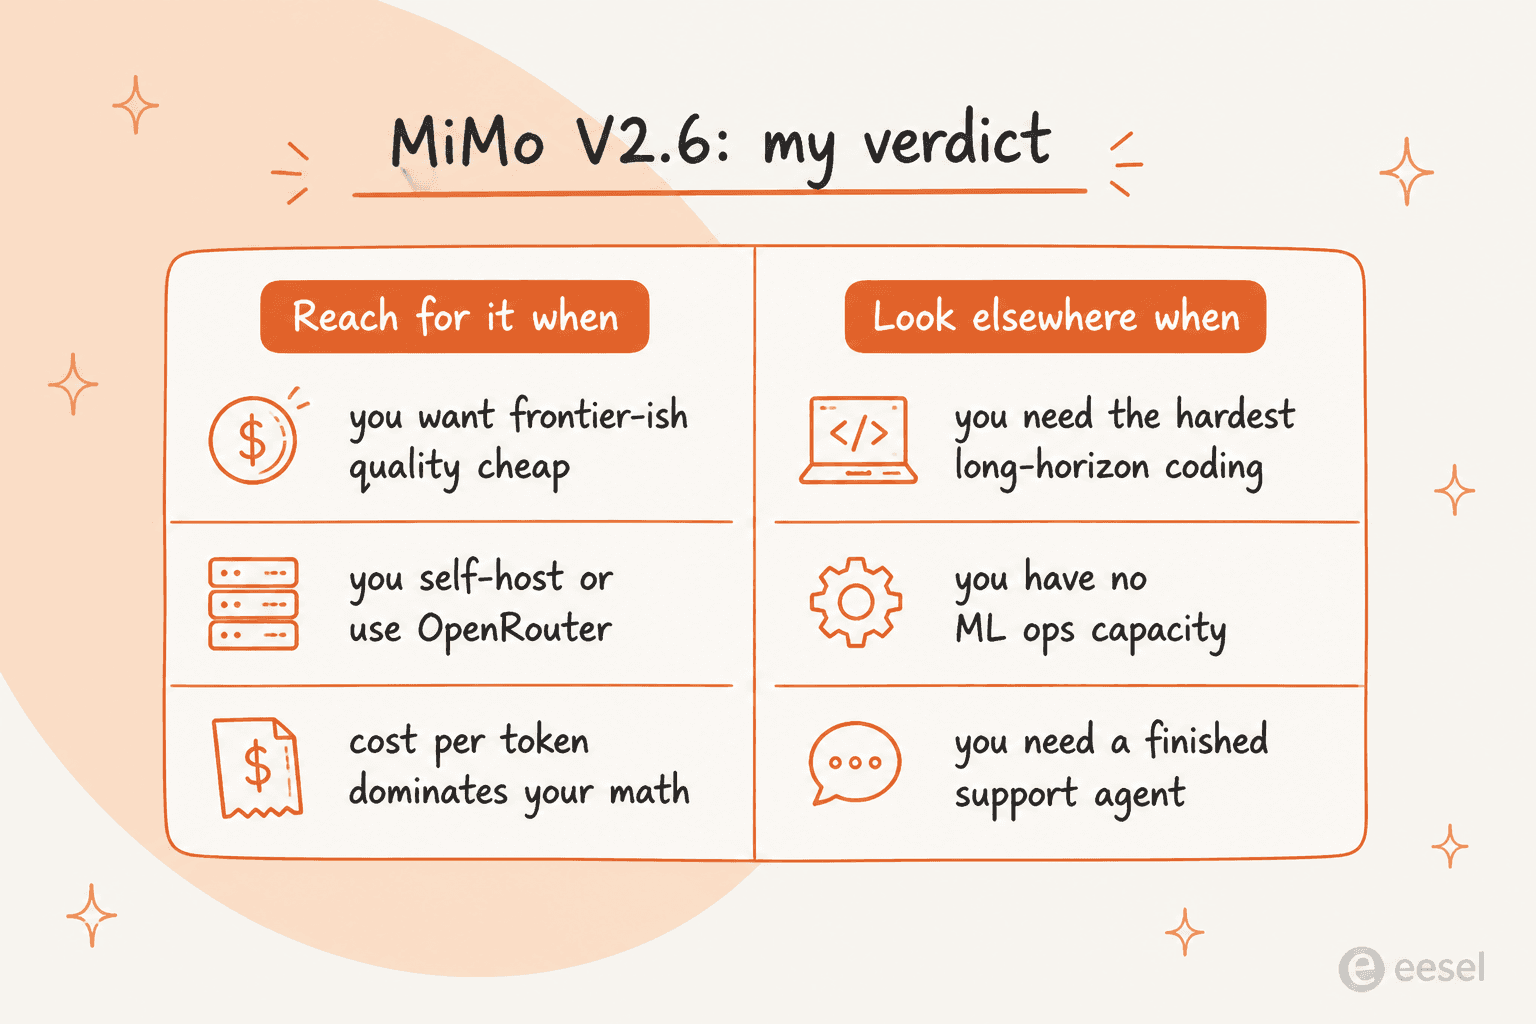
Greif zu MiMo V2.6, wenn die Kosten pro Token deine Rechnung dominieren, du dich mit Self-Hosting oder OpenRouter wohlfühlst und du bei allgemeinen Agenten- und Tool-Use-Aufgaben eine Qualität nahe der Spitze willst. Vor allem Flash ist eine starke Standardwahl für hochvolumige Alltagsaufgaben, bei denen der Preis pro Token der geschlossenen Spitze wehtun würde.
Schau dich anderswo um, wenn deine Aufgaben das härteste Coding oder Exploit-Arbeiten mit langem Zeithorizont sind, wo Pro messbar hinter Astra und Opus 5 zurückbleibt; wenn du keine Kapazität hast, Modell-Infrastruktur zu betreiben, und keinen Plan für die Serving-Rechnung; oder wenn du eigentlich einen fertigen Agenten brauchst, der einen Job erledigt, kein rohes Modell. Bei diesem letzten Punkt ist MiMo nicht das richtige Werkzeug – und auch kein anderes Modell für sich allein.
Von der Bewertung her würde ich es als Preis-Leistungs-Tipp unter offenen Modellen ganz vorne im aktuellen Feld einordnen, neben DeepSeek V4.1 Flash und Qwen 3.8 Max. Bei der Behauptung, „die geschlossene Spitze zu schlagen“, lautet die ehrliche Antwort: beim Preis ja, bei den härtesten Benchmarks noch nicht. Für einen breiteren Überblick ist unsere Übersicht der besten Open-Source-KI-Agenten eine gute nächste Lektüre.
Der Teil, den ein Modell-Test meist auslässt: ein Motor ist kein Mitarbeiter
Ich habe die letzten Jahre damit verbracht, KI auf echte Support-Warteschlangen zu bringen, und der MiMo-V2.6-Launch bestätigt, was wir auf die harte Tour gelernt haben: das Modell ist nicht mehr der Flaschenhals.
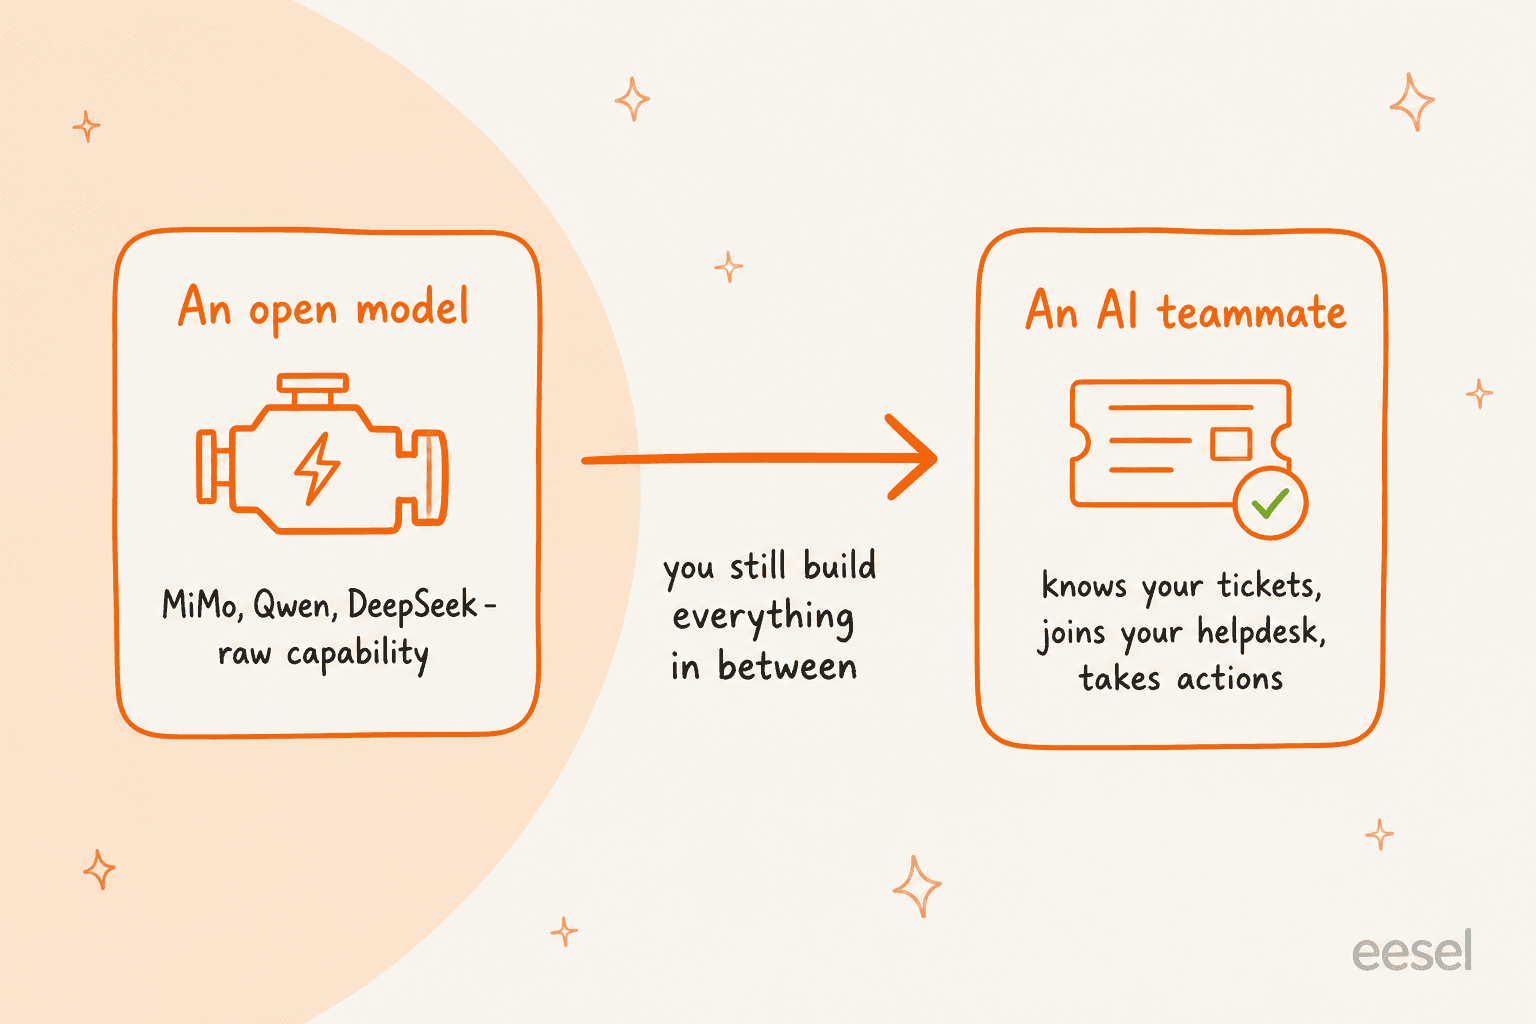
MiMo V2.6, DeepSeek, Qwen, Claude, GPT: Jedes davon kann eine flüssige, plausibel klingende Antwort auf eine Kundenfrage schreiben. Das war vor zwei Jahren der beängstigende Teil. Er ist gelöst. Was keines davon von Haus aus kann, ist die eigentliche Arbeit: dein spezifisches Helpcenter und vergangene Tickets lesen, deine Rückerstattungsrichtlinie befolgen statt eine plausibel erfundene, eine Bestellung nachschlagen, das Ticket taggen und routen, wissen, wann eskaliert werden muss, und getestet werden, bevor es einem echten Kunden antwortet.
Bei diesem letzten Punkt würde ich keine Kompromisse eingehen. Wir haben erlebt, wie selbstbewusst klingende Modelle auf echten Warteschlangen falsche Antworten gegeben haben, weshalb jeder Rollout zuerst gegen historische Tickets simuliert wird. Eine 46 im AA-Index sagt dir nichts darüber, wie ein Modell mit deiner kuriosen Rückgabe-Ausnahme umgeht. Eine Simulation über deine letzten 5.000 Tickets schon. Wenn du speziell ein Modell für den Support auswählst, sind unser Leitfaden zum besten KI-Modell für Support-Tickets und die Aufschlüsselung KI-Agent vs. menschlicher Agent Kosten die beiden, die ich als Nächstes lesen würde.
eesel ausprobieren
Der ganze Punkt dieses Tests ist: Ein offenes Modell wie MiMo V2.6 ist Infrastruktur, rohe Fähigkeit, die du erst noch in etwas verwandeln musst, das einen Job erledigt. eesel ist die Schicht, die aus einem Modell einen funktionierenden Kollegen macht. Du stellst einen einsatzbereiten KI-Helpdesk-Agenten ein, der sich in den Helpdesk einklinkt, den du bereits nutzt (Zendesk, Freshdesk, Gorgias, Help Scout und 1000+ Integrationen), auf deinen vergangenen Tickets und deiner Wissensdatenbank trainiert und ohne Modell-Ops damit beginnt, Antworten zu entwerfen oder zu senden.

Das Unterscheidungsmerkmal ist das, was MiMos eigene Benchmarks dir nicht geben können: Bevor ein eesel-Agent einem einzigen echten Kunden antwortet, simulierst du ihn anhand deiner echten Ticket-Historie und siehst die genaue Lösungsquote und die Antworten, die du bekommen hättest. Und weil eesel eine Kollegen-Plattform ist, betreibt derselbe Account auch einen KI-Blog-Autor. Für Entwickler, denen MiMos Terminal-Freundlichkeit gefallen hat: eesel stellt denselben Kollegen über ein öffentliches CLI, API und MCP bereit, sodass ihn eine Person, ein Skript oder ein Coding-Agent gleichermaßen vom Terminal aus steuern können.
Du kannst kostenlos starten, ohne Kreditkarte und ohne Vertriebsgespräch, und in Minuten einen Kollegen live haben. Das Modell ist günstig geworden. Es tatsächlich den Job machen zu lassen, ist immer noch der interessante Teil.
Häufig gestellte Fragen
Ist Xiaomi MiMo V2.6 gut?
Was kostet der Betrieb von Xiaomi MiMo V2.6?
Ist Xiaomi MiMo V2.6 besser als Kimi K3 oder DeepSeek?
Kann ich Xiaomi MiMo V2.6 selbst hosten?
Welches MiMo-V2.6-Modell sollte ich nutzen?
Sollte ich Xiaomi MiMo V2.6 für den Kundensupport nutzen?
Ist die Benchmark-Transparenz von Xiaomi MiMo V2.6 echt?


Article by
Kurnia Kharisma Agung Samiadjie
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.