Die kurze Antwort: Was Xiaomi MiMo V2.6 tatsächlich kostet
Ich beobachte seit zwei Jahren KI-Preisseiten, und bei den meisten Modell-Launches wird die Zahl, wegen der man eigentlich kommt, verschleiert. Xiaomi hat das Gegenteil gemacht: Am 22. September 2026 wurde die gesamte MiMo-V2.6-Familie unter MIT open-sourced, und die API-Preise blieben gegenüber der Vorgängergeneration unverändert.
Es gibt also eigentlich zwei Preise, über die man nachdenken sollte. Da ist null, wenn du die Gewichte herunterlädst und auf eigener Hardware betreibst. Und es gibt einen Preis pro Token über die API, wenn lieber jemand anderes die GPUs hostet. Hier die vollständige gehostete Preisliste von OpenRouter, geprüft am Launch-Tag:
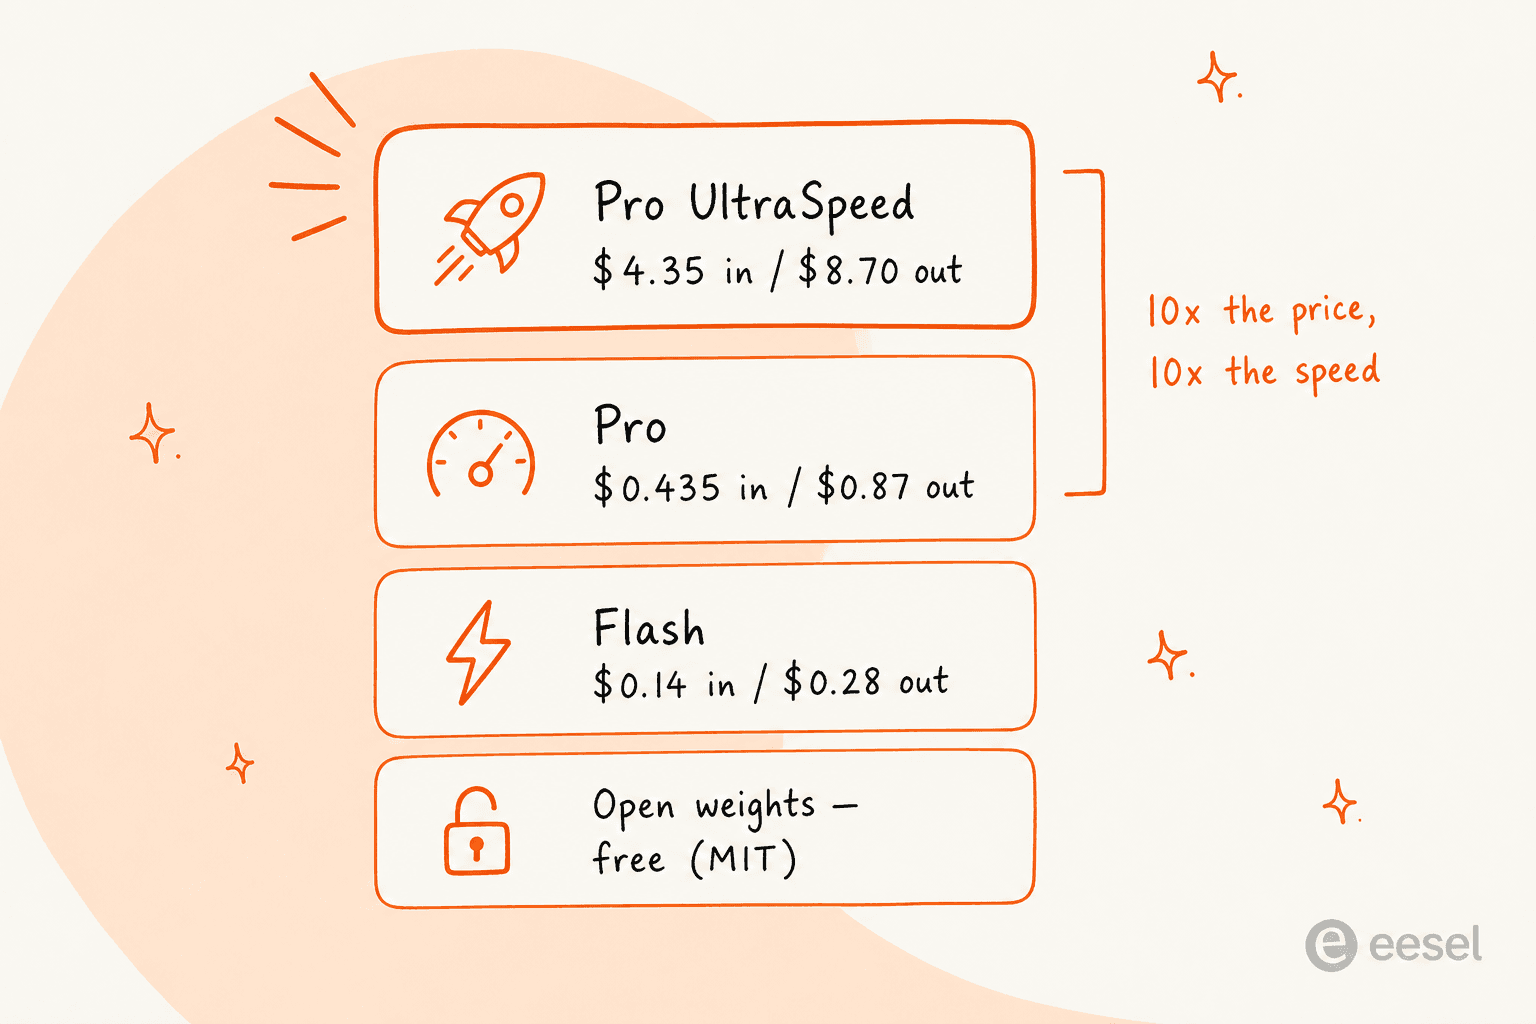
Jede Variante bietet dasselbe 1M-Token-Kontextfenster und ist nativ omnimodal (Text, Bild, Video, Audio), sodass du für den langen Kontext oder die zusätzlichen Modalitäten keinen Aufpreis zahlst. Das ist ungewöhnlich und ein großer Grund dafür, warum die Preise so aggressiv wirken.
Die vier Varianten und wofür sie jeweils gedacht sind
MiMo V2.6 ist nicht ein Modell mit einem Preis. Es ist eine Familie aus vier Checkpoints, und die falsche Wahl ist der schnellste Weg, zu viel zu zahlen. So ordnen sie sich ein.
MiMo V2.6 Pro ($0,435 Eingabe / $0,87 Ausgabe)
Pro ist das Flaggschiff: ein Sparse-Mixture-of-Experts-Modell mit 1,02 Billionen Gesamtparametern und 42B aktiven Parametern. Es steht an der Spitze der Open-Weight-Benchmarks und ist die richtige Wahl für echte agentische Aufgaben, langfristiges Coding, mehrstufige Tool-Nutzung. Mit $0,435 Eingabe / $0,87 Ausgabe ist es günstiger als die meisten Frontier-Closed-Source-Modelle, mit denen es sich misst — das ist die ganze Geschichte dieses Releases.
MiMo V2.6 Flash ($0,14 Eingabe / $0,28 Ausgabe)
Flash ist der Effizienz-Checkpoint: 309B gesamt, 15B aktiv, von Xiaomi als die beste Balance aus Intelligenz, Effizienz und Kosten beschrieben. Mit $0,14 Eingabe / $0,28 Ausgabe kostet es ein Drittel von Pro und gibt, nach Xiaomis eigenen Zahlen, erstaunlich wenig auf. Bei AutomationBench erreicht es 52,3 gegenüber 53,1 von Pro. Für die meisten hochvolumigen, gut abgegrenzten Aufgaben ist Flash die Preis-Leistungs-Wahl.
MiMo V2.6 Pro UltraSpeed ($4,35 Eingabe / $8,70 Ausgabe)
UltraSpeed ist verwirrend, bis man merkt: Man kauft hier keine zusätzliche Intelligenz. Es ist genau derselbe Pro-Checkpoint, nur mit etwa 10-facher Ausgabegeschwindigkeit (rund 116 Tokens pro Sekunde). Xiaomi berechnet dafür das 10-Fache des Pro-Preises. Es ist also eine reine Latenz-Steuer: Nur zahlen, wenn Geschwindigkeit tatsächlich der Flaschenhals ist, etwa bei einem Live-Chat-Agenten, dem ein Kunde beim Tippen zusieht. Für einen Batch-Job über Nacht ist das 10-fach verschwendetes Geld.
MiMo V2.6 Distill-Qwen-9B (nur kostenlose Gewichte)
Der 9B-Distill ist ein dichtes, überwacht feinabgestimmtes Modell auf Basis von Qwen3.5-9B, trainiert mit von MiMo generierten Daten. Es ist nicht über die kostenpflichtige API verfügbar; es existiert als kleiner Einstiegspunkt für lokale Inferenz und offene Forschung auf einer einzelnen GPU. Community-GGUF-Quants existieren bereits für llama.cpp, LM Studio und Ollama, sodass es das Modell ist, das auf einer Workstation läuft.
Der Cache-Rabatt, den die meisten übersehen
Die oben genannten Listenpreise sind nicht das, was Vielnutzer tatsächlich zahlen. MiMo V2.6 Pro listet Cache-Read-Tokens mit etwa $0,0036 pro Million, ein 99%-Rabatt auf den Eingabepreis von $0,435. Der Benchmark-Partner von Xiaomi bringt es auf den Punkt:
"Despite the improvement, it retains the same attractive pricing at $0.435 per 1M input tokens (with a 99% cache-hit discount) and $0.87 per 1M output tokens."
Warum ist das für die Preisgestaltung wichtig? Weil jeder echte Workload denselben Kontext immer wieder sendet. Ein Coding-Agent liest immer wieder dasselbe Repository. Ein Support-Agent liest bei jedem einzelnen Ticket dieselben Richtlinien und Makros. Sobald dieser Kontext gecacht ist, zahlst du für die Eingabe-Tokens nur noch Cent-Beträge. Wenn dein Anwendungsfall Prompts wiederverwendet, liegt dein effektiver Eingabepreis weit unter dem Listenpreis, und genau in dieser Lücke zieht MiMos Gesamtkosten wirklich am Frontier-Feld vorbei.
Wie sich die MiMo V2.6 Preise im Vergleich zum Frontier-Feld schlagen
Das ist der Vergleich, für den dieser Launch gemacht wurde. Im Artificial Analysis Intelligence Index erreichte MiMo V2.6 Pro 46 Punkte, das beste Open-Weight-Modell, gleichauf mit dem am selben Tag veröffentlichten Grok 4.7, und knapp hinter den Closed-Source-Spitzenreitern.
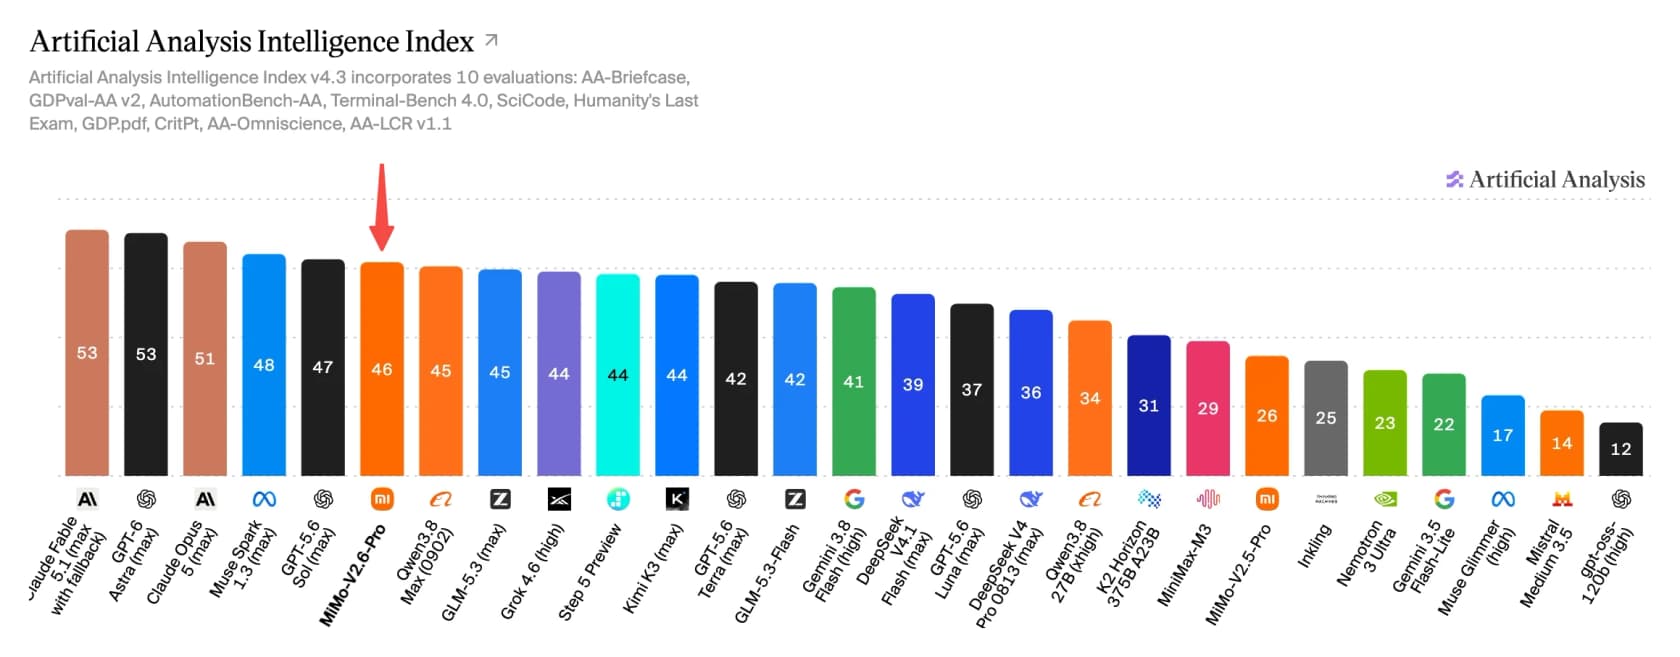
Der Score allein erzählt aber nicht die ganze Preisgeschichte. Entscheidend für die Kosten ist die Grafik Intelligenz-versus-Kosten-pro-Aufgabe, in der MiMo V2.6 Pro bei etwa $0,13 pro Aufgabe im grünen "attraktivsten Quadranten" landet, während Claude Opus 5 und GPT-6 Astra am $3-bis-$8-Ende derselben Achse liegen.
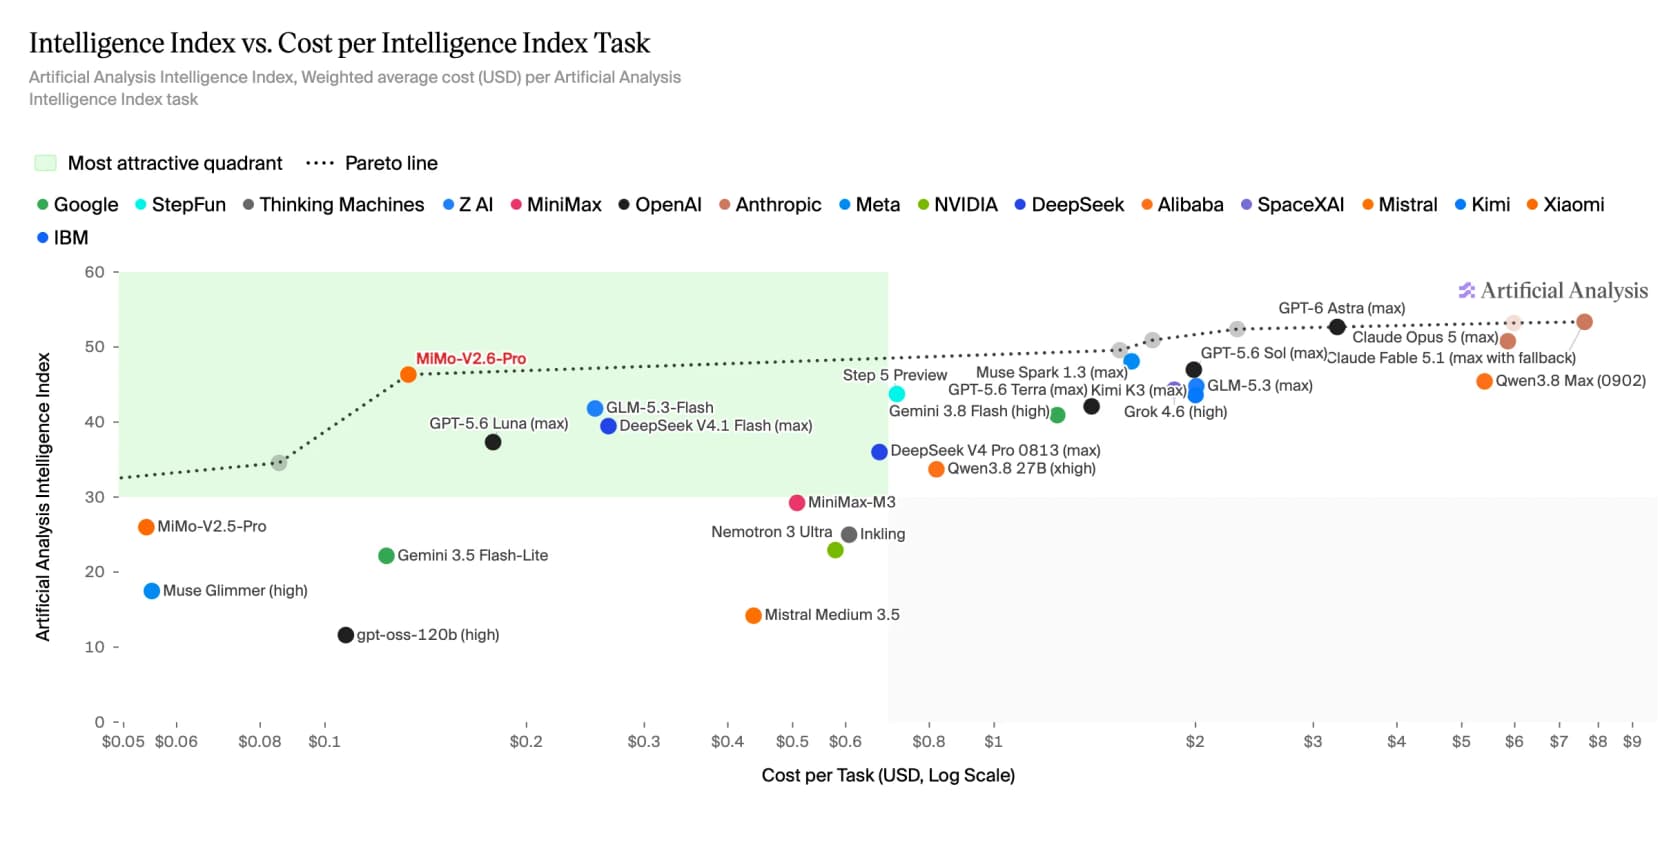
Auch im offenen Feld ist es genauso scharf. Flash liegt gleichauf mit den günstigsten Stufen wie DeepSeek V4.1 Flash, und das 1,02T-Pro unterbietet das weitaus größere 2,8T-Kimi K3, während es auf den meisten Boards vorne liegt. Ein Hacker-News-Kommentator, der das Modell intensiv genutzt hatte, brachte die Kostenrechnung auf den Punkt:
"Mimo 2.6 pro, the 1T model leads Kimi K3, a 2.8T param model in 14 out of 15 benchmarks (and the last one is near tie)!! Good to see they also kept the price the same, and landed in the greenest quadrant of the intelligence vs speed of AA."

Zur Ehrlichkeit gehört auch die Grenze: MiMo hinkt den besten Closed-Source-Modellen bei den schwierigsten Boards hinterher. Bei Terminal Bench 4.0 erreicht es 34,9 gegenüber 59,6 von GPT-6 Astra, und bei ExploitBench landet es bei 47,9 gegenüber über 70 bei GPT-5.6 Sol und Claude. Wenn deine Arbeit an diesen Grenzen stattfindet, ist der günstige Tokenpreis nicht die ganze Entscheidung. Für alles andere ist das Preis-Leistungs-Verhältnis schwer zu widerlegen.
Durchgerechnete Beispiele: Was man tatsächlich zahlen würde
Listenpreise pro Million Tokens sind abstrakt. Hier, was drei realistische Workloads bei MiMo V2.6 kosten, damit die Zahlen greifbar werden.
- Ein Solo-Entwickler auf Flash. Angenommen, du verbrauchst monatlich 20M Eingabe- und 5M Ausgabe-Tokens beim Coding mit Flash. Das ergibt 20 × $0,14 + 5 × $0,28 = $4,20 im Monat. Ein Rundungsfehler.
- Ein kleines Team, das einen Coding-Agenten auf Pro betreibt. 300M Eingabe-, 80M Ausgabe-Tokens im Monat auf Pro: 300 × $0,435 + 80 × $0,87 = $200,10 im Monat, vor jedem Cache-Rabatt. Bei intensiver Prompt-Wiederverwendung liegt die tatsächliche Rechnung deutlich darunter.
- Ein hochvolumiger Support-Workload auf Flash. 10.000 Tickets im Monat, jeweils etwa 8K Eingabe- und 1K Ausgabe-Tokens, also 80M Eingabe und 10M Ausgabe: 80 × $0,14 + 10 × $0,28 = $14 im Monat an reinen Token-Kosten.
Bei dieser letzten Zahl lohnt es sich, kurz innezuhalten. Zehntausend Support-Gespräche für $14 an Modell-Tokens. Wäre das der wahre Preis für KI-Support, hätten alle das schon vor Jahren ausgerollt. Ist es nicht, und die Lücke zwischen "$14 an Tokens" und "einem funktionierenden Support-Agenten" ist genau der Punkt des nächsten Abschnitts.
Kostenlose Gewichte sind nicht kostenlos zu betreiben
MiMo V2.6 ist wirklich offen unter MIT, also ist "einfach selbst hosten" echter Rat, kein Marketing. Aber dass die Gewichte kostenlos sind, macht den Betrieb nicht kostenlos. Die Hardware-Rechnung ist der versteckte Posten.
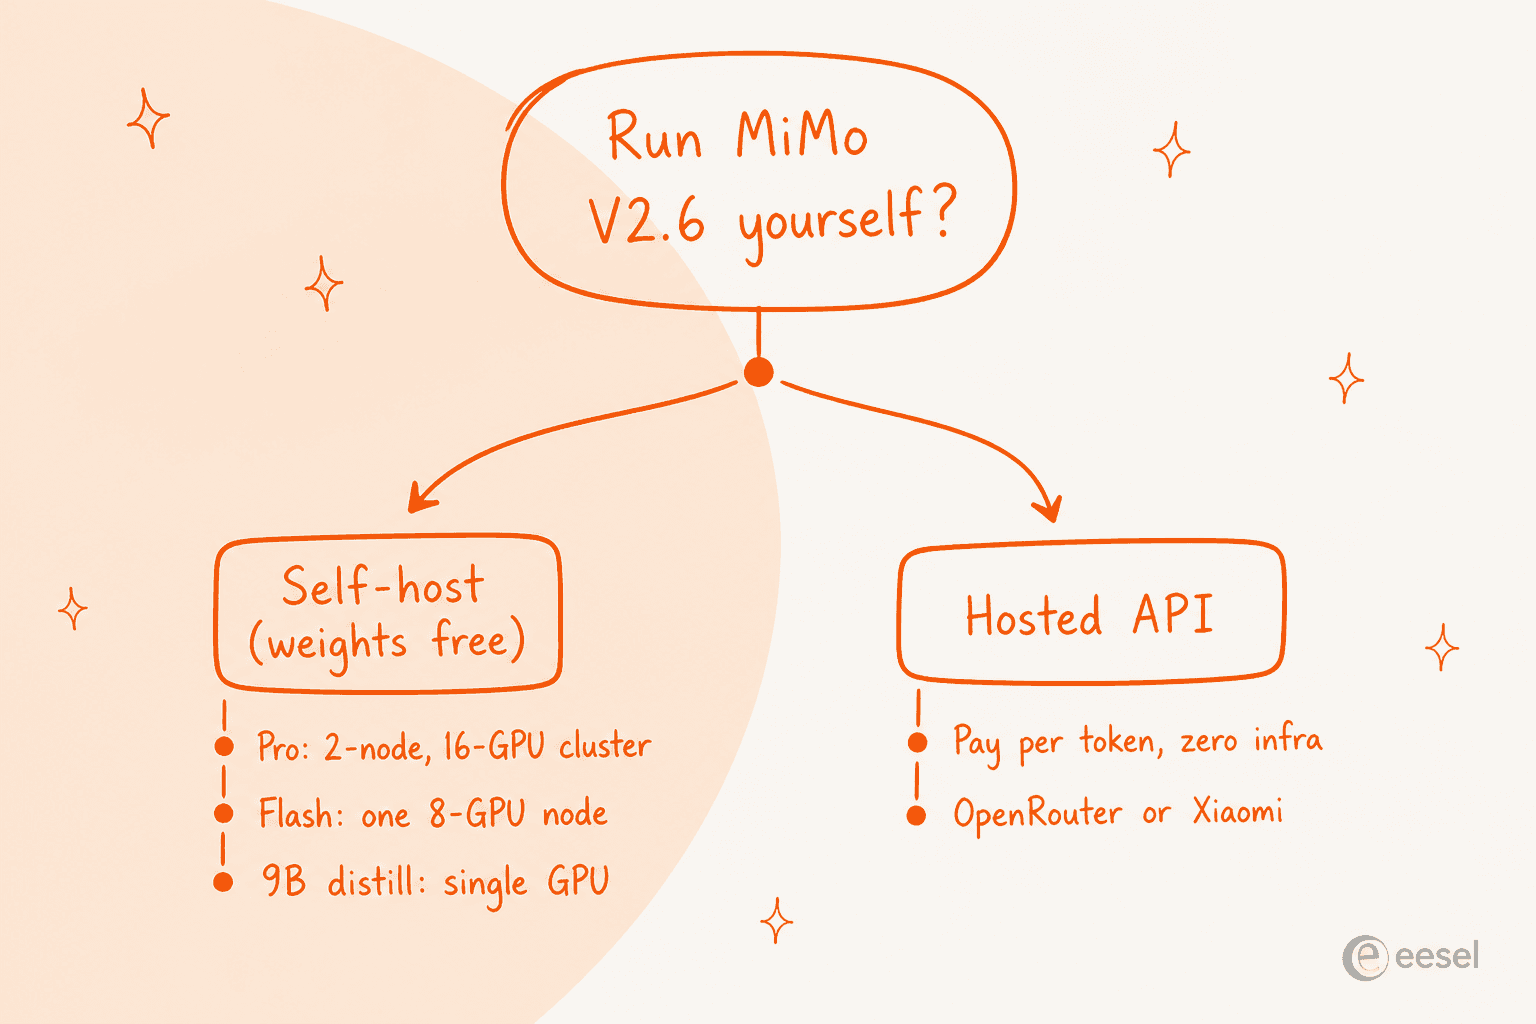
Hier, was jede Variante laut Model Cards benötigt:
- Pro (1,02T / 42B aktiv): Der Referenz-SGLang-Launch nutzt ein 2-Node-Cluster mit 16 GPUs (Tensor-Parallel 16). Das ist eine ernsthafte Hardware-Investition.
- Flash (309B / 15B aktiv): läuft auf einem einzelnen 8-GPU-Node.
- Distill-Qwen-9B: klein genug für eine einzelne GPU, und es gibt GGUF-Quants für lokale Tools.
Alle Checkpoints werden als FP8 ausgeliefert, was den Speicherbedarf im Rahmen hält, aber die ehrliche Einschätzung lautet: Self-Hosting schlägt die API nur bei konstantem, hohem Volumen und ungenutzten GPUs, die gefüllt werden können. Bei unregelmäßigem oder geringem Volumen ist die gehostete API mit $0,14 bis $0,87 pro Million Tokens fast immer günstiger, als einen Cluster warmzuhalten. Rechne die eigene Auslastung durch, bevor du annimmst, dass "kostenlose Gewichte" auch "kostenloser Betrieb" bedeutet.
Der Teil, den der Preisschild nie zeigt
Hier muss ich einen Schritt zurücktreten, denn ich baue und betreibe KI für den Helpdesk beruflich, und beim Thema Preise wird fast immer die eigentliche Rechnung übersehen.
Die Tokenkosten von MiMo V2.6, oder DeepSeek, oder Qwen, oder irgendeinem von ihnen, sind der kleinste Posten im Budget eines Produktivsystems. Der teure Teil ist alles, was um das Modell herum aufgebaut wird.
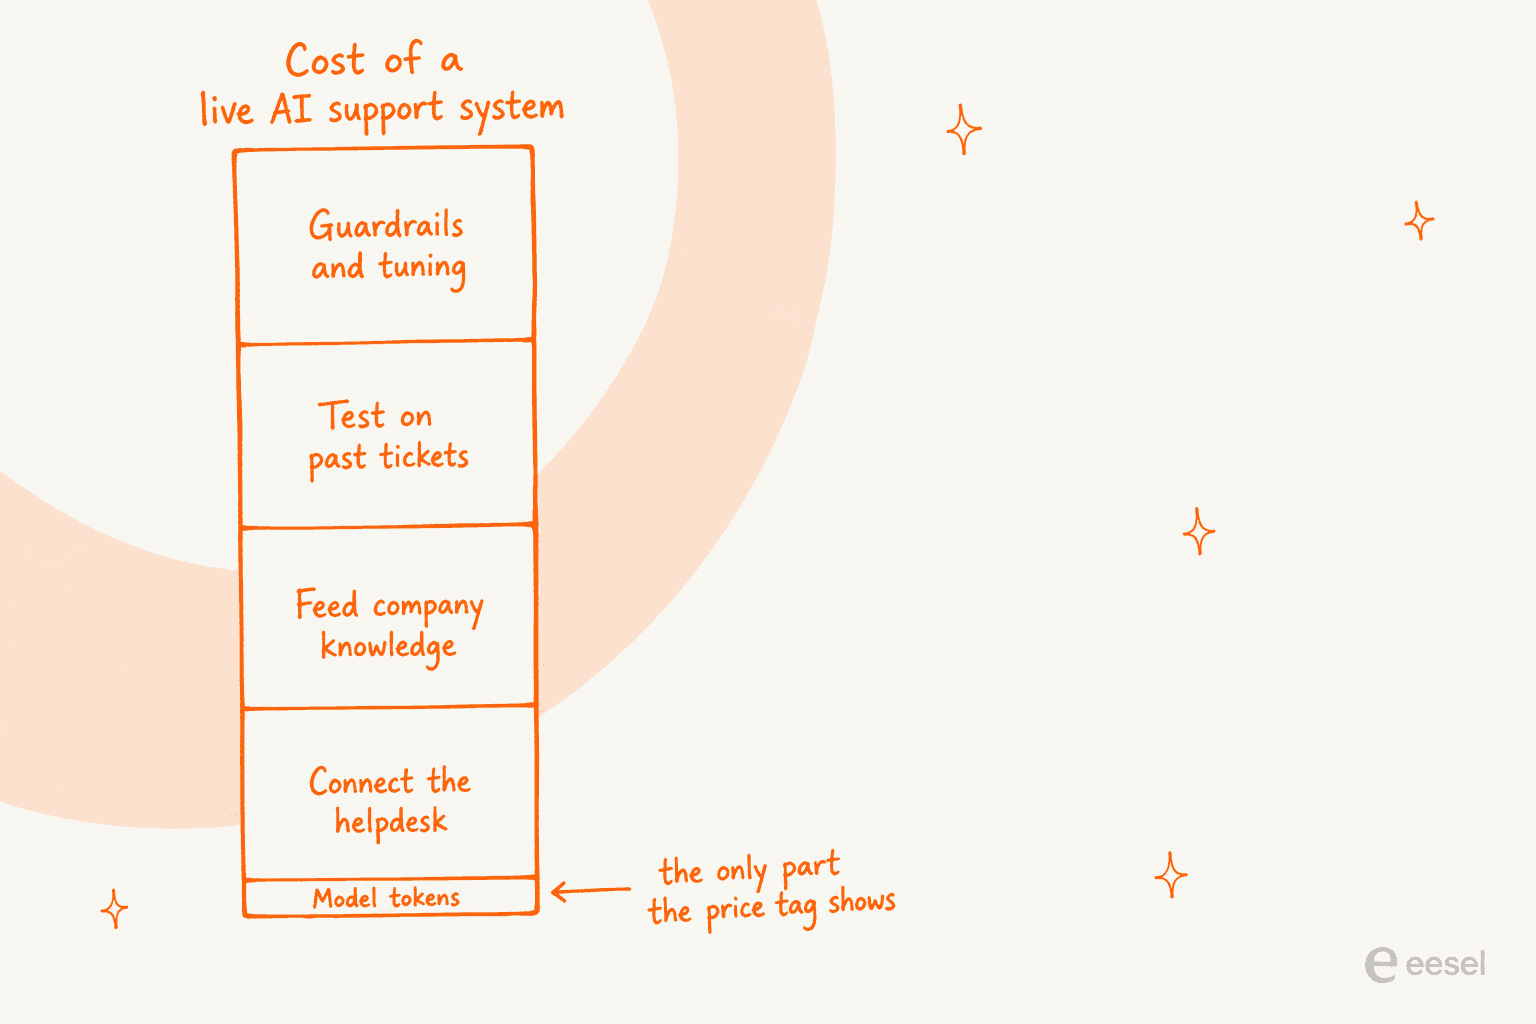
Wir setzen seit einigen Jahren KI-Agenten in Live-Support-Warteschlangen ein, und die wiederkehrende Lektion lautet: Ein reines Modell, so günstig und klug es auch ist, ist kein Support-Agent. Um von "$14 an Tokens" zu "einem Agenten, dem ich einen Kunden anvertraue" zu kommen, musst du es an deinen Helpdesk anbinden, mit deiner Wissensdatenbank und vergangenen Tickets füttern, ihm deine Richtlinien beibringen, ihm sicher ausführbare Aktionen geben und, vor allem, es testen, bevor es live geht. Wir haben selbstbewusst klingende Bots erlebt, die still falsche Antworten gaben, weshalb jeder Rollout zuerst an historischen Tickets simuliert werden sollte.
Nichts davon taucht auf einer OpenRouter-Preisseite auf. Es ist der Unterschied zwischen einem Modell und einem funktionierenden Teammitglied, und genau dort liegen die tatsächlichen Kosten für KI-Support.
eesel ausprobieren
Ein Modell wie MiMo V2.6 ist ein Motor. eesel ist das Teammitglied, das du engagierst, um ihn zu steuern. eesel ist eine KI-Teammitglied-Plattform, und der KI-Helpdesk-Agent ist ein einsatzbereites Support-Teammitglied: Er bindet sich in Minuten an deinen Helpdesk an, liest bereits deine vergangenen Tickets und deine Wissensdatenbank, und du kannst ihn an Tausenden deiner echten historischen Konversationen simulieren, bevor er einem einzigen echten Kunden antwortet. Statt pauschal pro Sitzplatz zu zahlen, rechnet eesel nach Nutzung ab, sodass die Kosten der tatsächlich geleisteten Arbeit folgen.

Und wer im Terminal zuhause ist: eesel bietet eine öffentliche CLI plus einen MCP-Server, sodass dasselbe Teammitglied und derselbe Workspace, den du im Dashboard verwaltest, auch aus Skripten heraus oder von Coding-Agenten wie Claude Code, Codex und Cursor gesteuert werden kann. Das ist der agentenfreundliche Weg, eesel zu betreiben: Eine Person bedient es manuell, ein Skript automatisiert es, oder ein KI-Agent ruft es auf, alles gegen dasselbe Helpdesk-Teammitglied. Das ist die Ebene, die aus einem günstigen, leistungsfähigen Modell etwas macht, das tatsächlich Tickets löst. Jetzt kostenlos testen.
Häufig gestellte Fragen
Wie viel kostet Xiaomi MiMo V2.6?
Was ist der günstigste Weg, Xiaomi MiMo V2.6 zu betreiben?
Ist Xiaomi MiMo V2.6 kostenlos?
Wie schneiden die Xiaomi MiMo V2.6 Preise im Vergleich zu DeepSeek und Kimi K3 ab?
Was ist MiMo V2.6 Pro UltraSpeed, und warum kostet es 10x mehr?
Bietet Xiaomi MiMo V2.6 einen Cache-Rabatt?
Sollte ich Xiaomi MiMo V2.6 für den Kundensupport verwenden?


Article by
Kurnia Kharisma Agung Samiadjie
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.