

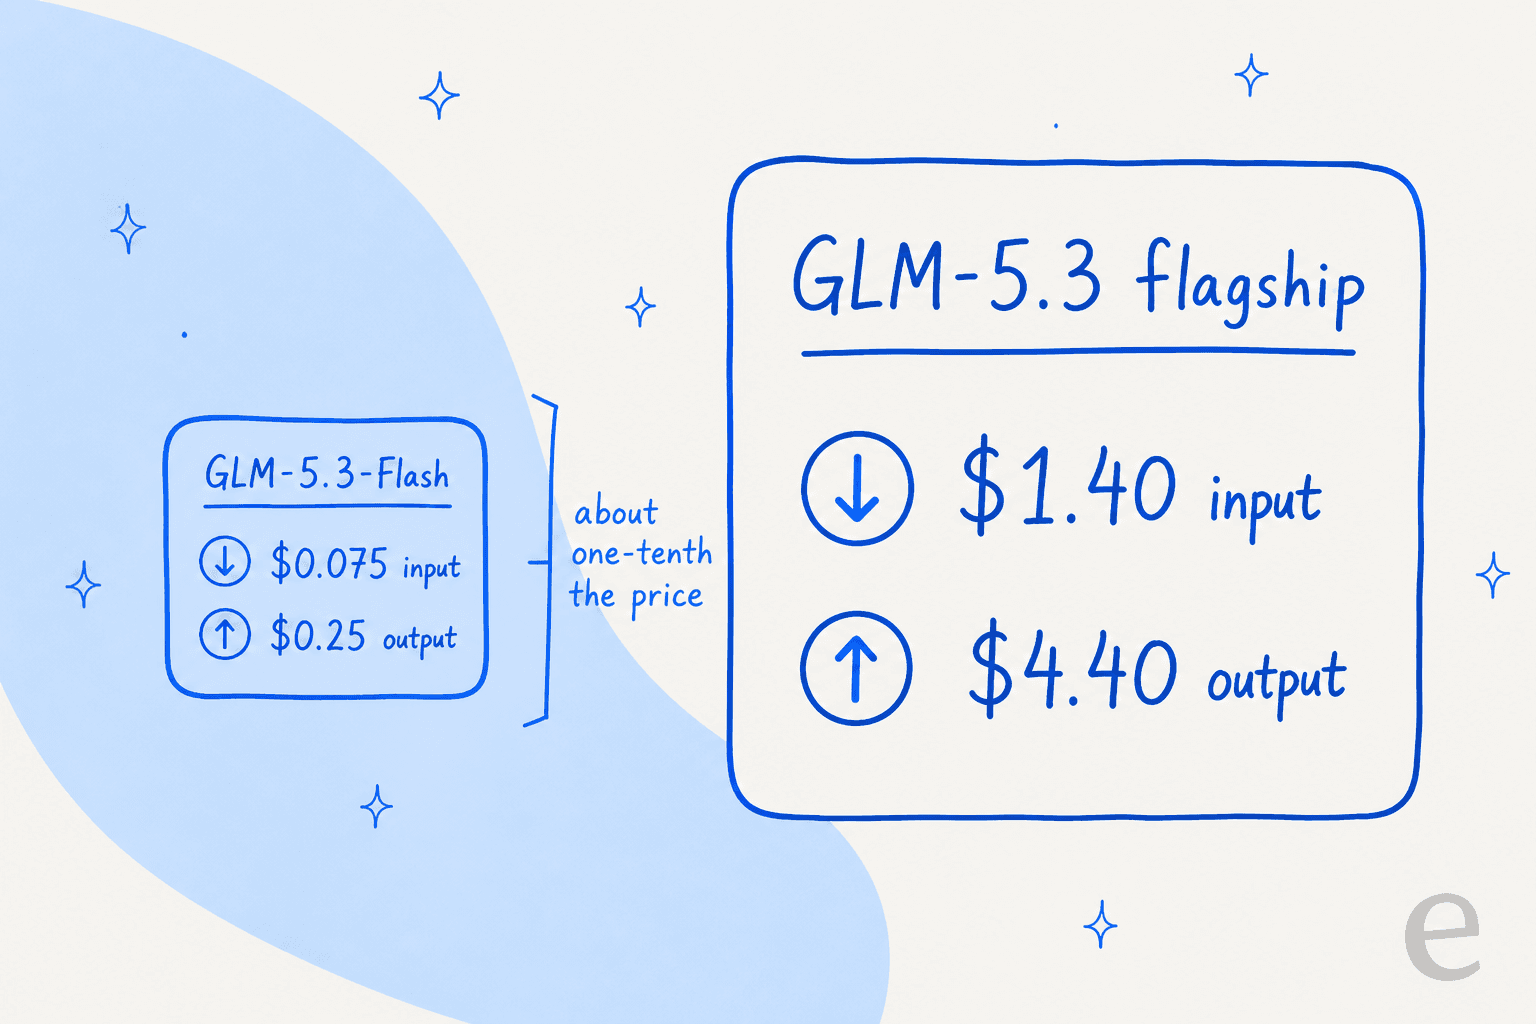
GLM-5.3-Flash ist das günstigste GLM-5-Modell von Z.ai, und der Preis ist die Schlagzeile. Mit 50 % Launch-Rabatt kostet es $0.075 pro Million Eingabe-Token und $0.25 pro Million Ausgabe-Token, zwischengespeicherte Eingabe $0.015. Abgerechnet werden schlichte Token, also keine Überraschungen pro Lösung oder pro Platz. Zwei Dinge verwirren oft: Die Promo endet am 9. September 2026, danach verdoppeln sich alle Tarife auf den Listenpreis von $0.15/$0.50, und GLM-5.3-Flash ist nicht das Flaggschiff. Das reine Text-Flaggschiff GLM-5.3 ist ein eigenes Modell für $1.40/$4.40, etwa das Zehnfache.
Wenn Sie lieber abonnieren, als Token zu messen: Der GLM Coding Plan startet bei $18/Monat (Lite) und reicht bis $168/Monat (Max) für die Nutzung in Claude Code, Cursor und ähnlichen Tools.
Ein Haken, der nicht auf dem Preisschild steht: Über die API von Z.ai selbst ist das Modell langsam (~49 Token/Sek.). Drittanbieter wie Databricks liefern dieselben Gewichte mit 273 Token/Sek., der Ort, an dem Sie es betreiben, verändert Ihre echten Kosten also genauso stark wie die Preisliste. Und denken Sie daran: Eine Preisliste kauft Token, kein funktionierendes System. Wenn Sie eine KI möchten, die tatsächlich Tickets beantwortet oder Blogbeiträge in Ihren eigenen Tools schreibt, ist das die Teammate-Ebene von eesel, die auf Modellen wie diesem aufsetzt.
Der Rest dieses Beitrags geht die vollständige Preisliste, die Promo-Klippe, die Coding Plans und ein paar durchgerechnete Beispiele durch, damit Sie sehen, was eine echte Arbeitslast kostet.
GLM-5.3-Flash erschien im August 2026 als erstes nativ multimodales Modell in der GLM-5-Reihe von Z.ai (Zhipu AI), und die Reaktion im Netz drehte sich vor allem um eines: Unglaube über die Kosten. Artificial Analysis bezifferte es auf rund $0.045 pro Aufgabe, und Reddit-Threads verglichen es immer wieder positiv mit Modellen, die ein Vielfaches kosten. Also tun wir, was die Launch-Beiträge nicht getan haben, und legen genau dar, was Sie zahlen, wo die Fallstricke liegen und was die Zahl wirklich bedeutet.
Hier ist die tatsächliche Preisliste, wie sie in den Preisdokumenten von Z.ai steht.
GLM-5.3-Flash Preise auf einen Blick
Das Modell wird nutzungsbasiert pro Million Token abgerechnet, aufgeteilt in Eingabe, zwischengespeicherte Eingabe und Ausgabe. Hier das Gesamtbild, Promo-Tarife zuerst, Listenpreise daneben.
| Posten | Promo-Tarif | Listenpreis | Hinweise |
|---|---|---|---|
| Eingabe | $0.075 / M | $0.15 / M | Standard-Prompt-Token |
| Zwischengespeicherte Eingabe | $0.015 / M | $0.03 / M | ~80 % unter der Standard-Eingabe |
| Speicherung zwischengespeicherter Eingabe | Kostenlos | Kostenlos | "Limited-time free" |
| Ausgabe | $0.25 / M | $0.50 / M | Enthält Reasoning-Token |
| Websuche | $0.01 / Nutzung | $0.01 / Nutzung | Integriertes Tool als Zusatz |
Quelle: die Z.ai-API-Preisdokumente.
Einige Punkte verdienen Hervorhebung. Ausgabe-Token kosten etwa 3,3-mal mehr als Eingabe, und weil GLM-5.3-Flash ein reines Thinking-Modell ist (das Reasoning lässt sich nicht abschalten), verbraucht jede Anfrage Ausgabe-Token für das interne Nachdenken, bevor sie antwortet. Das ist bei einem Reasoning-Modell normal, bedeutet aber, dass Ihre Rechnung vor allem aus der Ausgabe entsteht. Kalkulieren Sie mit dem Ausgabetarif, nicht mit dem Eingabetarif aus der Schlagzeile.
Das andere Detail ist, was GLM-5.3-Flash ist: ein Mixture-of-Experts-Modell mit 320B Gesamt- und 18B aktiven Parametern, einem Kontextfenster von 1M Token und nativer Bildverarbeitung. Für ein Modell, das Bilder liest und eine Million Token Kontext hält, ist ein Viertel Dollar pro Million Ausgabe-Token erstaunlich niedrig.
Flash ist nicht das Flaggschiff (und die Preislücke ist riesig)
Das ist die häufigste Verwechslung, daher sei es deutlich gesagt. GLM-5.3 und GLM-5.3-Flash sind zwei verschiedene Modelle, die zufällig dieselbe Versionsnummer tragen.
- GLM-5.3-Flash ist das günstige, multimodale Geschwister mit hohem Durchsatz. Es ist das Modell zu $0.075/$0.25.
- GLM-5.3 (das Flaggschiff) ist ein reines Text-Modell für Coding und Cyber und kostet $1.40 Eingabe / $4.40 Ausgabe pro Million.
Das ist etwa ein Zehnfaches an Unterschied. Wenn Sie einen "GLM-5.3"-Preis von einer Stelle und eine Token-Schätzung von einer anderen übernehmen, können Sie um eine Größenordnung danebenliegen. Cloudflares Beschreibung von Flash ist die klarste Zusammenfassung: Es "outperforms GLM-5.2 across benchmarks and real-world workloads at one-tenth the price."
Wenn Sie also eine Arbeitslast kalkulieren, lautet die erste Frage nicht "Wie viele Token?", sondern "Welches GLM-5.3 rufe ich tatsächlich auf?" Für die meisten Aufgaben außerhalb des Codings (Chat, Extraktion, Bildverarbeitung, Zusammenfassung) ist Flash das richtige Modell, und um dieses geht es in diesem Beitrag. Für Coding an der Spitze oder Sicherheitsforschung gibt es das Flaggschiff, aber dann zahlen Sie Flaggschiff-Tarife.
Die Promo-Klippe: Die Preise verdoppeln sich am 9. September
Die Zahlen $0.075/$0.25 sind ein Launch-Rabatt von 50 %, nicht der Dauerpreis. Laut den Preisdokumenten von Z.ai endet die Aktion am 9. September 2026 um 24:00 Uhr (UTC+8, Singapur-Zeit). Danach kehrt die Preisliste zu $0.15 Eingabe / $0.50 Ausgabe zurück.
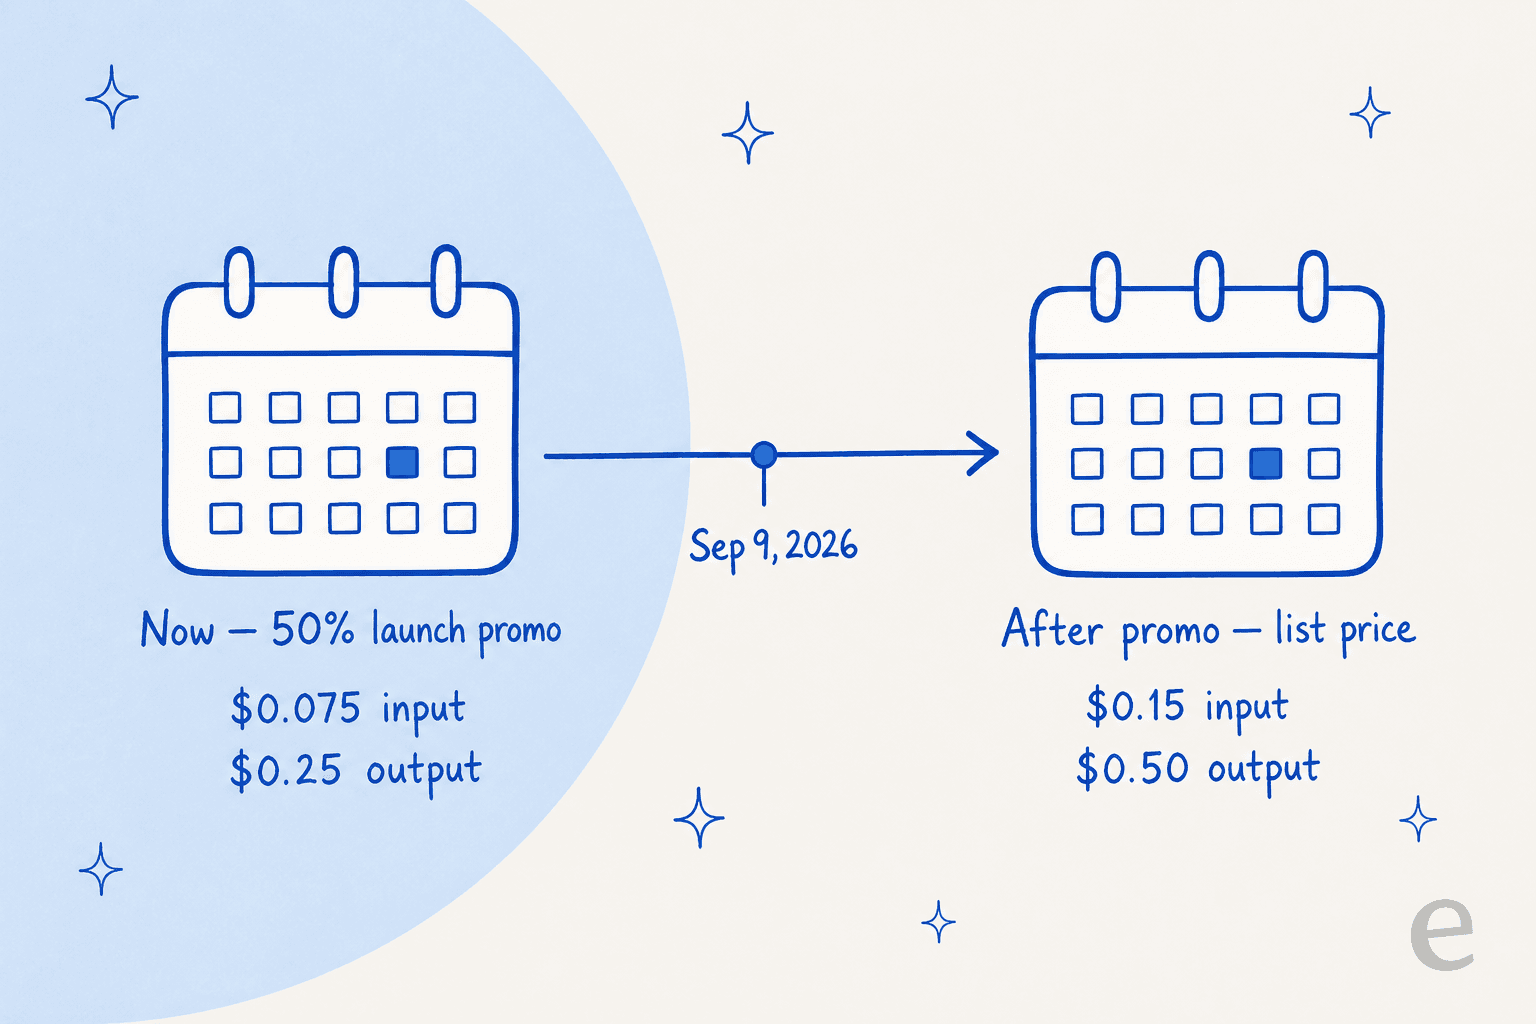
Selbst verdoppelt bleibt GLM-5.3-Flash nach jedem vernünftigen Maßstab günstig, Panik ist also unnötig. Aber wenn Sie ein Kostenmodell für ein Produkt bauen, das nach September startet, nehmen Sie die Listenpreise, nicht die Promo-Preise. Ein Budget, das auf $0.075 basiert und leise $0.15 braucht, sieht in der Tabelle gut aus und schmerzt bei der ersten Rechnung nach der Promo.
Zwischengespeicherte Eingabe und das Websuche-Zusatzangebot
Zwei kleinere Hebel verändern Ihren effektiven Tarif.
Zwischengespeicherte Eingabe ist der große. Wenn Ihre Prompts ein großes, stabiles Präfix teilen (einen System-Prompt, eine Wissensdatenbank, ein langes Dokument, zu dem Sie viele Fragen stellen), wird der wiederholte Teil während der Promo zum Cache-Tarif von $0.015/M abgerechnet, etwa 80 % unter dem Standard-Eingabetarif. Bei Arbeitslasten mit viel Prompt-Wiederverwendung ist das der Unterschied zwischen einer guten und einer großartigen Rechnung. Auch die Speicherung zwischengespeicherter Eingabe ist vorerst kostenlos.
Websuche ist ein integriertes Tool, das separat mit $0.01 pro Nutzung abgerechnet wird. Es ist günstig, wird aber pro Aufruf gemessen, sodass ein Agent, der in jedem Schritt sucht, sich auf eine Weise summiert, die die Token-Tarife nicht zeigen. Das lohnt sich im Blick zu behalten, wenn Sie es in eine Schleife einbauen.
Der GLM Coding Plan: ein Abo statt Token-Messung
Wenn Sie GLM vor allem in einem Coding-Tool nutzen, verkauft Z.ai ein Pauschalabo, das die Token-Messung ganz umgeht. Der GLM Coding Plan führt GLM-5.3 und GLM-5.3-Flash in Claude Code, Cline, OpenCode, Cursor, Roo Code, Kilo Code und über 20 weiteren Agent-Tools aus.
Hier die Einzelstufen, mit dem effektiven Monatspreis bei jährlicher Zahlung.
| Plan | Monatlich | Jährlich (effektiv /Monat) | Wöchentliche Credits | Relative Nutzung |
|---|---|---|---|---|
| Lite | $18/Monat | $12.60/Monat | 10,000 | 1x |
| Pro | $80/Monat | $56.00/Monat | ~60,000 | 6x Lite |
| Max | $168/Monat | $117.60/Monat | ~140,000 | 14x Lite |
Es gibt außerdem zwei Team-Stufen: einen Standard Seat für $88/Platz/Monat (66,000 wöchentliche Credits) und einen Premium Seat für $188/Platz/Monat (155,000 wöchentliche Credits, plus frühen Zugang zu Modellen), laut Z.ai-Abo-Seite.
Die Mechanik belohnt Geduld. Credits werden über einen Multiplikator pro Modell verbraucht (GLM-5.3-Flash kostet pro Token weit weniger als das Flaggschiff), und die Nutzung außerhalb der Stoßzeiten wird mit 50 % des Standard-Credit-Satzes berechnet. Die Stoßzeit ist nur Montag bis Freitag, 14:00-18:00 Uhr Singapur-Zeit, die meiste Zeit der Woche ist also Nebenzeit. Z.ai behauptet, dass man durch die Nutzung außerhalb der Stoßzeiten bis zu 92 % gegenüber nutzungsbasierten Flaggschiff-API-Aufrufen sparen kann. Das ist eine Herstellerangabe, also eher eine Obergrenze als ein Versprechen, aber die Richtung stimmt: Das Abo zielt klar auf intensive, tägliche Coding-Nutzung.
Die Coding Plans sind das, was die meisten meinen, wenn sie sich GLM in Aktion vorstellen: ein Modell, das sich in einem Agenten durch Refactorings und Migrationen arbeitet.
Die versteckten Kosten: welchen Host Sie wählen
Hier der Teil, den die Preisliste nicht verrät. GLM-5.3-Flash hat offene Gewichte, Sie können es also an vielen Orten betreiben, und der Durchsatz schwankt stark. Über die First-Party-API von Z.ai liefert die Ausgabe etwa 49 Token pro Sekunde, was ein Reddit-Thread als "one of the slowest models AA has ever" bezeichnete. Bei Drittanbietern sieht es anders aus.
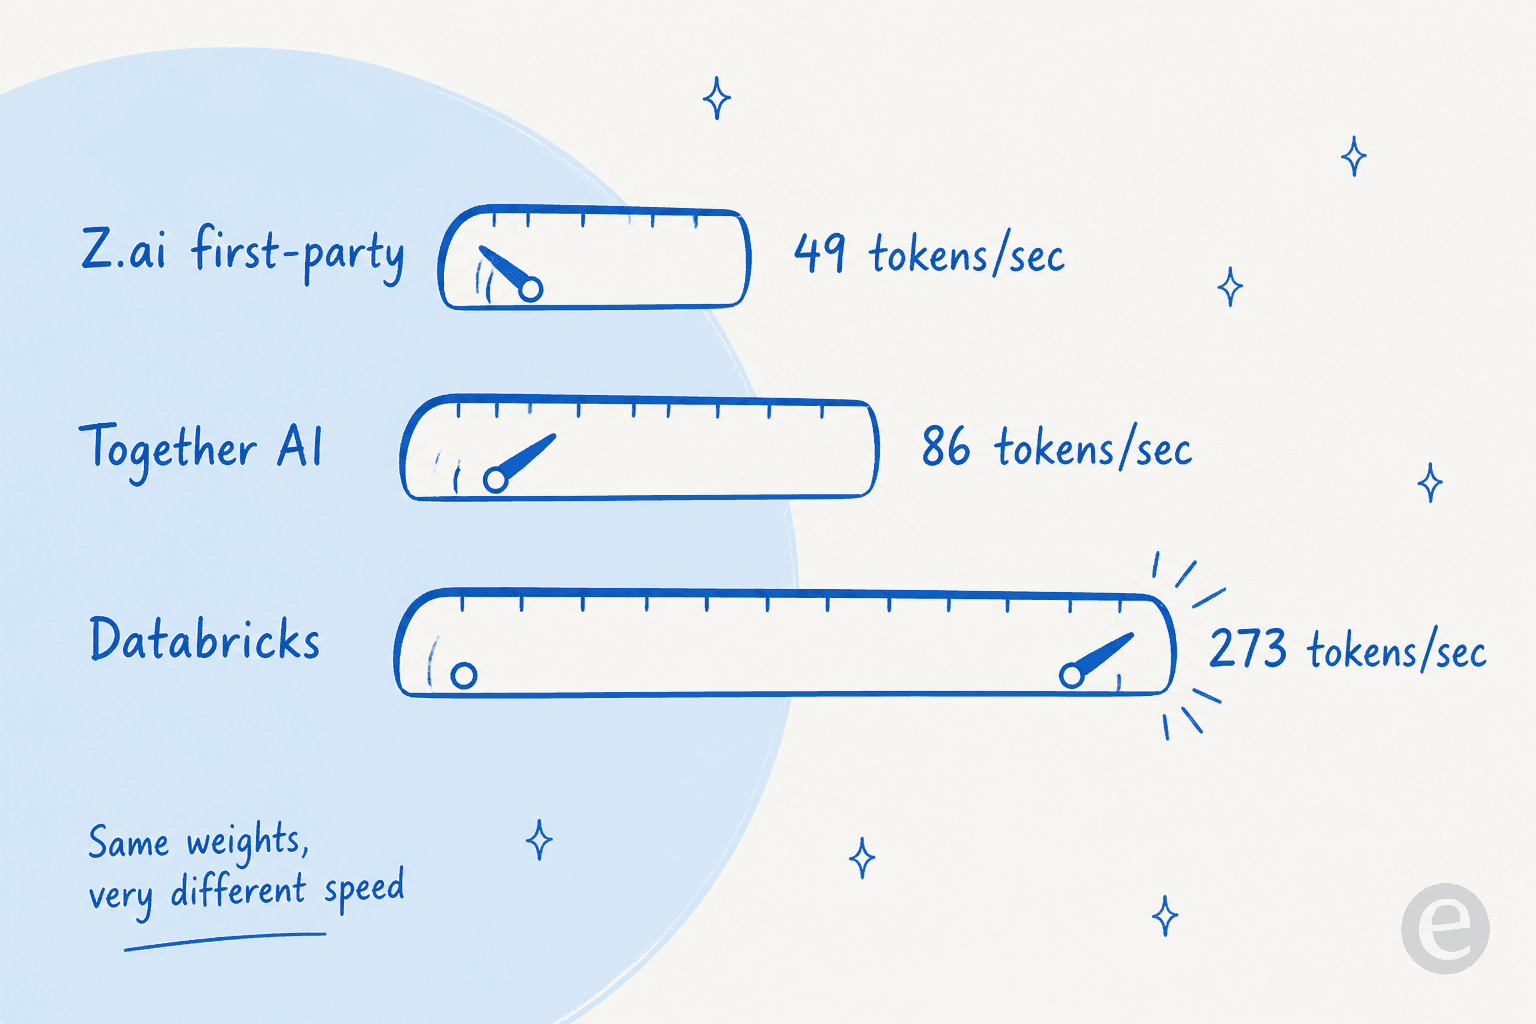
Laut Artificial Analysis liefert Databricks unter elf API-Anbietern GLM-5.3-Flash mit 272.9 Token/Sek. und der niedrigsten Latenz (8 Sekunden bis zum ersten Token), während die niedrigsten Listenpreise von GMI und Bitdeer mit etwa $0.05 kommen. Es geht nicht darum, dass ein bestimmter Host der beste wäre. Es geht darum, dass "GLM-5.3-Flash Preise" in Wahrheit eine Matrix aus Preis und Geschwindigkeit sind, und bei allem, was Nutzer sehen, ist Durchsatz ebenfalls ein Kostenfaktor. Ein Modell, das halb so teuer, aber fünfmal langsamer ist, kann am Ende teurer werden, wenn man die Wartezeit Ihrer Nutzer (oder Ihrer Agenten) mitrechnet.
Wenn Sie den reinen Preisboden wollen: First-Party oder GMI. Wenn Sie Geschwindigkeit zu einem vernünftigen Tarif wollen: ein Host wie Databricks. Wählen Sie den Host danach, ob Ihr Engpass Dollar oder Sekunden sind.
Was der niedrige Preis tatsächlich bringt
Billig ist nur gut, wenn die Ausgabe brauchbar ist, daher lohnt es sich, die Zahl an den Fähigkeiten des Modells zu messen. Im Artificial Analysis Intelligence Index erreicht GLM-5.3-Flash 57, gegenüber 60 für das volle GLM-5.3, was es direkt an die Preis-Intelligenz-Grenze rückt. Tester bestätigten das in konkreten Fällen.
"We benchmarked the new GLM-5.3 Flash on VulnPR-100. It found 34/100 vulnerabilities at a total model-review cost of just $4.21. That makes it the strongest sub-$10 model we've tested."
Zur neuen Bildfähigkeit ließ ein Tester 1,500 Stichproben laufen und meldete 81 % Genauigkeit, für eine erste multimodale Version ein vernünftiger Wert. Und die Reaktion im Preisvergleich mit anderen war das lauteste Thema von allen.
"Noticeably cheaper even than Gemini Flash 3.7, while being only slightly worse performing. That's actually really impressive."

Für einen vollständigeren Blick auf die Fähigkeiten geht unsere GLM-5.3-Flash Übersicht tiefer in Architektur und Benchmarks, und wenn Sie nach Kosten vorauswählen, lohnt es sich, sie neben unseren Aufschlüsselungen zu DeepSeek Preisen und Kimi K2.5 Preisen zu lesen. Für die Preisfrage ist die Erkenntnis aber einfach: Das Modell ist nicht günstig, weil es schwach ist. Es ist günstig, weil Z.ai ein MoE-Modell mit 18B aktiven Parametern aggressiv bepreist hat und den Launch obendrein subventioniert.
Ein durchgerechnetes Beispiel: was eine echte Arbeitslast kostet
Tarife pro Million Token lassen sich schwer greifen, setzen Sie also Ihre eigenen Zahlen ein. Dieser Rechner nutzt die Promo-Tarife ($0.075 Eingabe, $0.25 Ausgabe); mit dem Schalter sehen Sie den Listenpreis nach September.
Zur Einordnung der Standardwerte: Ein mittelgroßer Assistent mit 500M Eingabe- und 150M Ausgabe-Token pro Monat landet bei etwa $75/Monat zu Promo-Tarifen oder etwa $150/Monat, sobald der Listenpreis greift. Selbst zum Listenpreis ist das ein Rundungsfehler neben KI-Tools pro Platz, und genau deshalb hat das Modell Aufsehen erregt. Wichtig ist: Ihr Ausgabevolumen, durch das reine Thinking-Reasoning in die Höhe getrieben, ist der Regler, der die Zahl wirklich bewegt. Wenn Ihr Ziel Inhalte statt roher Token sind, wägt unser Beitrag zum besten LLM für Blogbeiträge Qualität gegen Kosten auf dieselbe Weise ab.
eesel testen: Das Modell ist der Motor, eesel ist der Teamkollege
Hier die ehrliche Einordnung. GLM-5.3-Flash ist fantastische Infrastruktur. Aber eine Preisliste von $0.075 pro Million Token ist keine Antwort auf ein Support-Ticket oder ein fertiger Blogbeitrag, genauso wenig wie ein Fass Öl eine Reise ist. Rohzugriff auf ein Modell lässt Sie weiterhin Retrieval, Leitplanken, Integrationen, Tests und die Mechanik für den Fall "Was passiert, wenn es falsch liegt" selbst bauen.
eesel sitzt eine Ebene darüber. Statt Token stellen Sie einsatzbereite KI-Teamkollegen ein: einen KI-Helpdesk-Teamkollegen, der in Ihre bestehende Zendesk-, Freshdesk- oder Gorgias-Warteschlange einsteigt und Antworten entwirft oder sendet, und einen KI-Blog-Autor, der SEO-Beiträge von Anfang bis Ende recherchiert und schreibt. Jeder kennt bereits Ihr Help Center und frühere Tickets und geht in Minuten statt nach einem Sprint voller Glue-Code live.
Der wichtigste Unterschied für alle, die Bedenken haben, Tickets einer KI zu überlassen: eesel lässt Sie einen Teamkollegen anhand Ihrer echten historischen Tickets simulieren, bevor er je einen Live-Kunden berührt, sodass Sie Lösungsquote und Antworten vorab sehen, statt einen Schalter umzulegen und zu hoffen. Modelle wie GLM-5.3-Flash machen die Token günstig; eesel macht daraus einen Teamkollegen, dem Sie in der Warteschlange wirklich vertrauen können. Es ist kostenlos testbar, ohne Kreditkarte und ohne Verkaufsgespräch zum Start.