

Kurzfassung
Mistral Large 4 ist der größte Einzelsprung, den ich von Mistral bisher gesehen habe: 38,4 im Artificial Analysis Intelligence Index, nach 9,3 bei Large 3. Es ist außerdem schnell, pro Token günstig während des Preview-Angebots zum halben Preis, und das einzige Frontier-Modell, von dem ich weiß, dass sein Hersteller im selben Monat europäisches Hosting und offene Gewichte verspricht.
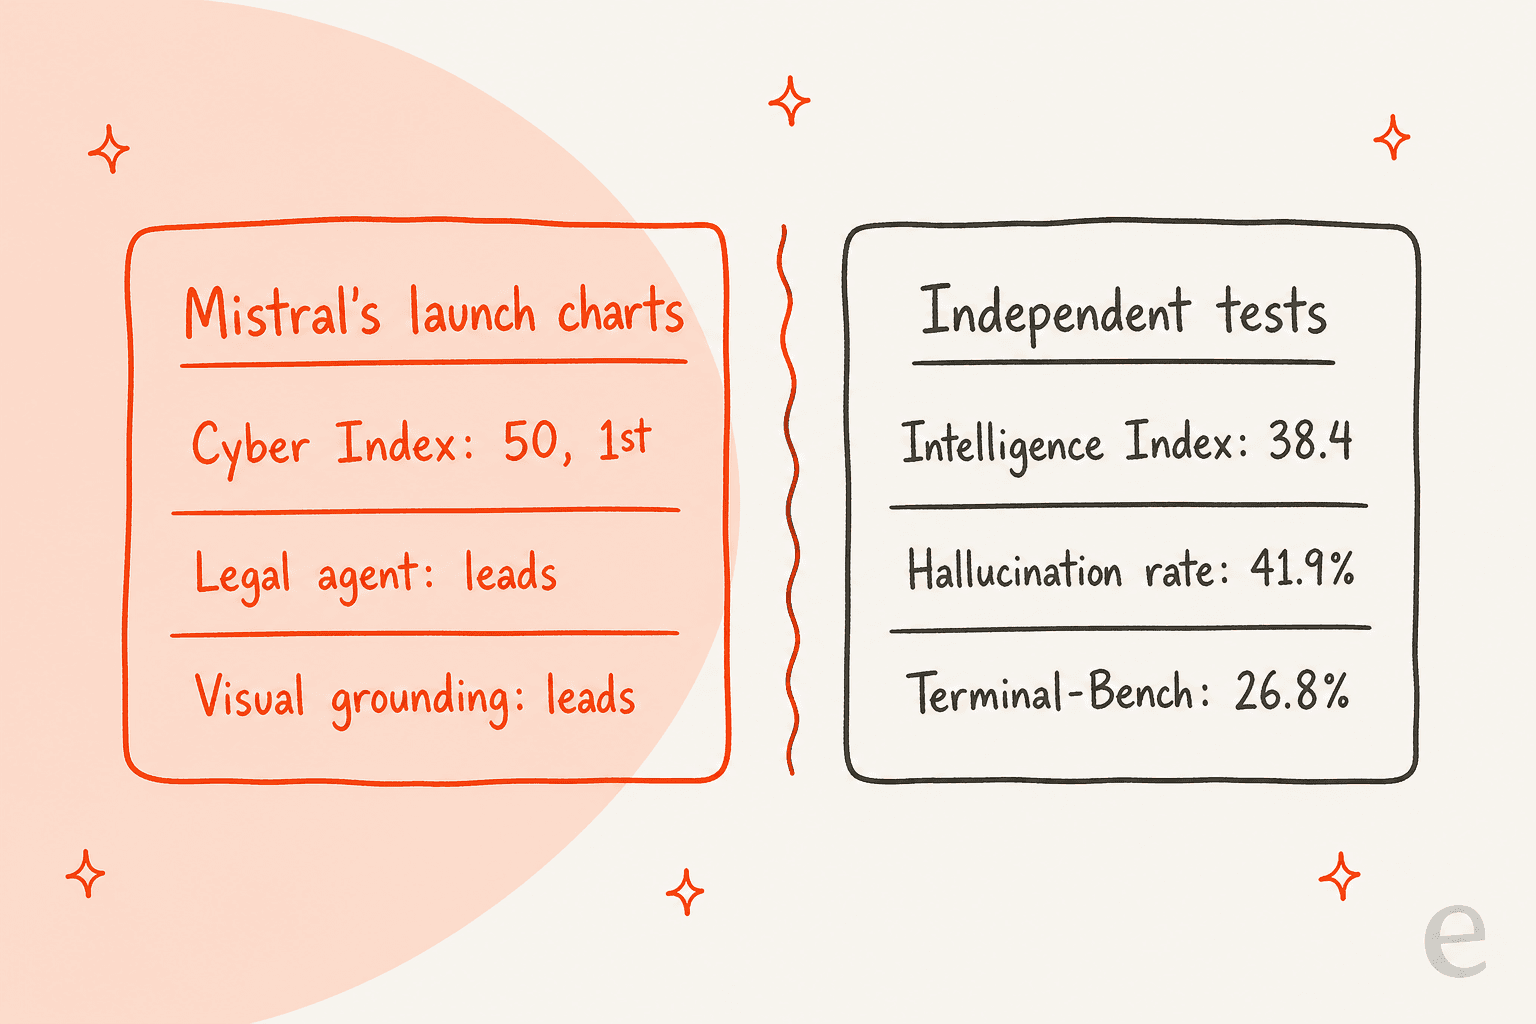
Die unabhängigen Zahlen sehen es aber im Mittelfeld, nicht an der Spitze. Es liegt hinter Kimi K3 und Qwen 3.8 Max, erreicht etwa dieselbe Punktzahl wie Modelle, die pro Aufgabe ein Viertel kosten, und es halluzinierte bei 41,9 % der Fragen, die es falsch beantwortete, im Wissenstest von Artificial Analysis. Mistrals Launch-Grafiken stellen Cyber- und Rechtstests in den Vordergrund, und diese Erfolge wirken echt, aber begrenzt.
Mein Fazit: Nehmen Sie es, wenn Sie einen EU-Anbieter brauchen oder Sicherheitsarbeit ohne Verweigerungen. Lassen Sie es sein, wenn Sie einfach die beste Antwort pro Dollar wollen. Und wenn Sie erwägen, es vor Kunden zu setzen, zählen die Schutzmechanismen drumherum mehr als die Modellwahl. Genau das leistet der KI-Helpdesk-Teammate von eesel bereits in Zendesk, Freshdesk und Gorgias.
Was ist Mistral Large 4?
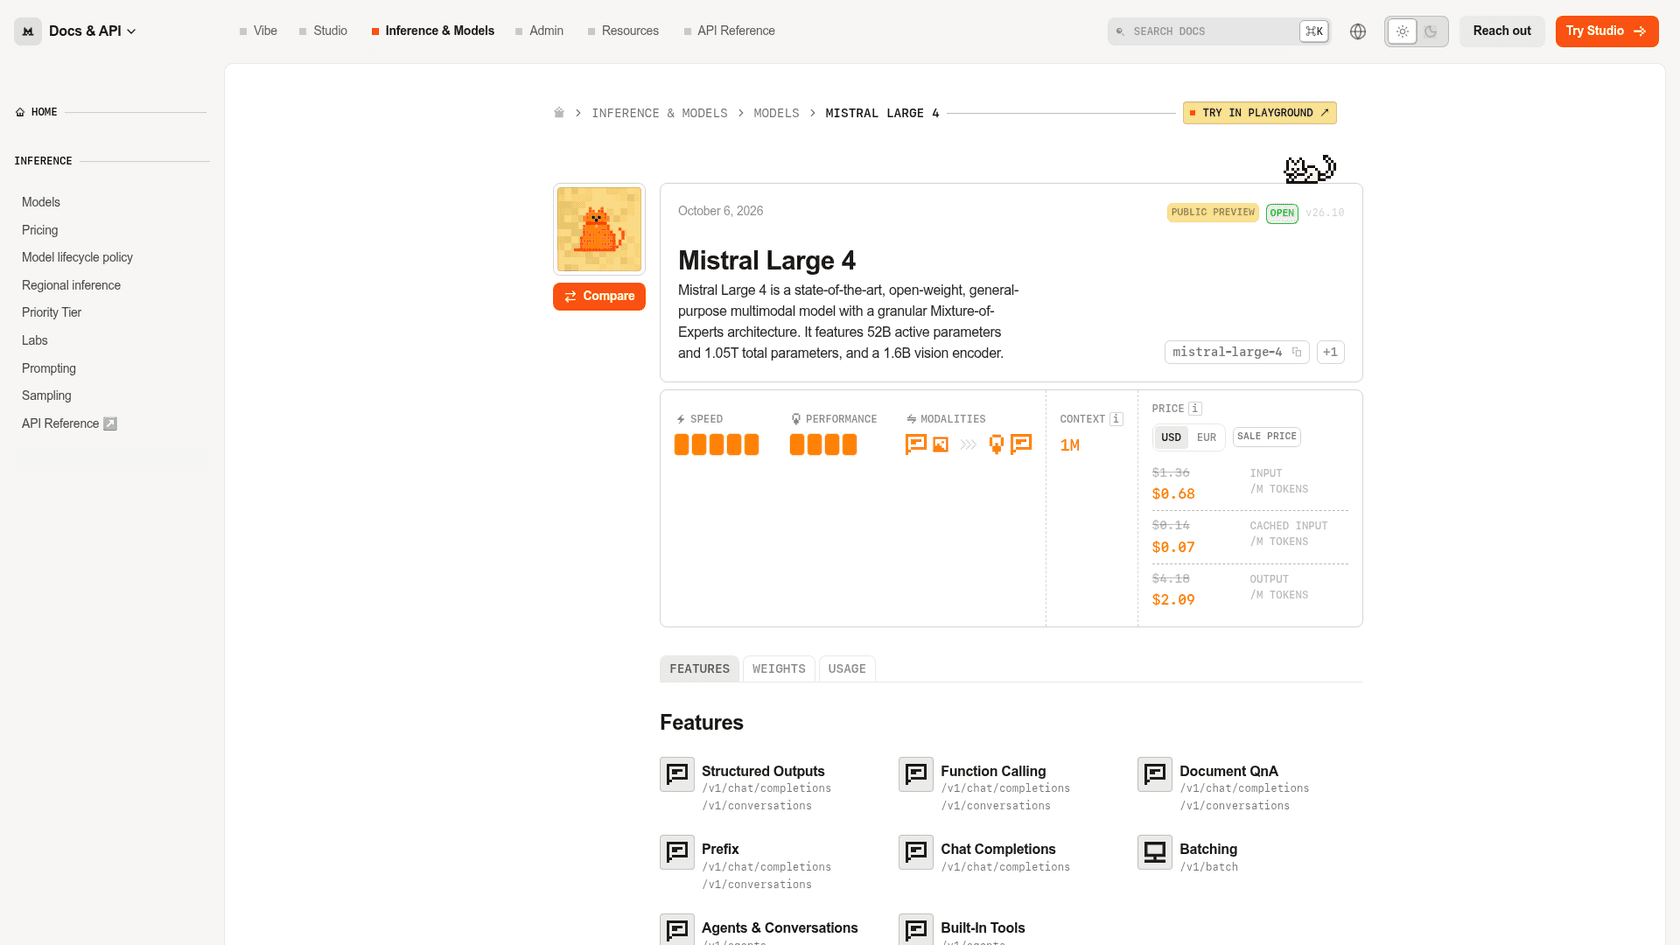
Mistral Large 4 ist Mistrals neues Flaggschiff, am 6. Oktober 2026 als öffentliche Preview gestartet und "Le Chonk" genannt. Laut Modellkarte ist es ein Mixture-of-Experts-LLM mit 1,05 Bio. Gesamtparametern, 52 Mrd. aktiven pro Token, einem 1,6-Mrd.-Vision-Encoder und einem Kontextfenster von 1 Mio. Tokens. Es ist ein Hybridmodell: Mit der Einstellung reasoning_effort lässt es sich zuerst nachdenken oder sofort antworten.
Kurz zu meinem Hintergrund: Ich schreibe und betreue das SEO für den eesel-Blog, und wer nach "Mistral Large 4 Test" sucht, interessiert sich selten für Parameterzahlen. Die Frage ist enger: Ist es gut genug für einen Wechsel, und wofür? Diese Frage beantwortet dieser Test. Das vollständige Datenblatt finden Sie in meiner Mistral-Large-4-Übersicht, alle Preisstufen in meiner Aufschlüsselung der Mistral-Large-4-Preise.
Ich habe das Modell nicht selbst betrieben, daher stütze ich mich auf diejenigen, die es getan haben: die unabhängigen Tests von Artificial Analysis, Mistrals eigene Docs und die Praxisberichte auf Hacker News, Reddit und X in den ersten drei Tagen.
Mistral Large 4 im Test auf einen Blick
Hier die Kurzfassung, vor den Details.
| Was ich geprüft habe | Ergebnis | Quelle |
|---|---|---|
| Allgemeine Intelligenz | 38,4 im AA Intelligence Index (Median seiner Preisklasse: 26) | Artificial Analysis |
| Sprung gegenüber Large 3 | 9,3 auf 38,4, etwa 4,1x | AA: Large 3 |
| Rang unter engen Konkurrenten | Hinter Kimi K3 (43,6) und Qwen 3.8 Max (45,4) | AA |
| Preis (Preview-Angebot) | 0,68 $ Input / 2,09 $ Output pro 1 Mio. Tokens | Mistral-Preise |
| Kosten pro AA-Aufgabe | 1,13 $ zum Listenpreis, etwa 0,57 $ im Angebot | Artificial Analysis |
| Halluzinationsrate | 41,9 % bei AA-Omniscience | Artificial Analysis |
| Ausgabegeschwindigkeit | 116,1 Tokens/s; ~18,7 s bis zum ersten Antwort-Token | Artificial Analysis |
| Ausführlichkeit | 200 Mio. Tokens für den Index vs. 81 Mio. Median | Artificial Analysis |
| Offene Gewichte | Für Ende Oktober 2026 versprochen, noch nicht verfügbar | Mistral |
| Am besten bei | Cyber-Aufgaben ohne Verweigerungen, Legal-Agenten, visuelle Verankerung | Mistrals Launch-Grafiken |
Was hat Mistral tatsächlich behoben?
Die ehrliche Schlagzeile: Mistral ist zurück im Rennen. Im vergangenen Dezember erzielte Mistral Large 3 im selben Index 9,3 Punkte, weit weg von der Spitze. Large 4 erreicht 38,4. Das ist der Unterschied zwischen einem Modell für günstige Zusammenfassungen und einem, auf dem man einen KI-Agenten betreiben könnte.
Das Team von Plotly ließ es am Launch-Tag durch seinen Data-Analytics-Benchmark laufen und sah denselben Sprung aus anderer Perspektive:
"Es ist 10x günstiger als Mistral Medium 3.5 vom April und steigt von 58 % auf 74 % richtige Antworten. Definitiv ein Generationssprung."

Der Haken ist, woher dieser Sprung kommt. Large 4 ist ein Reasoning-Modell, Large 3 war es nicht, also wurde ein großer Teil des Gewinns mit Denk-Tokens erkauft.
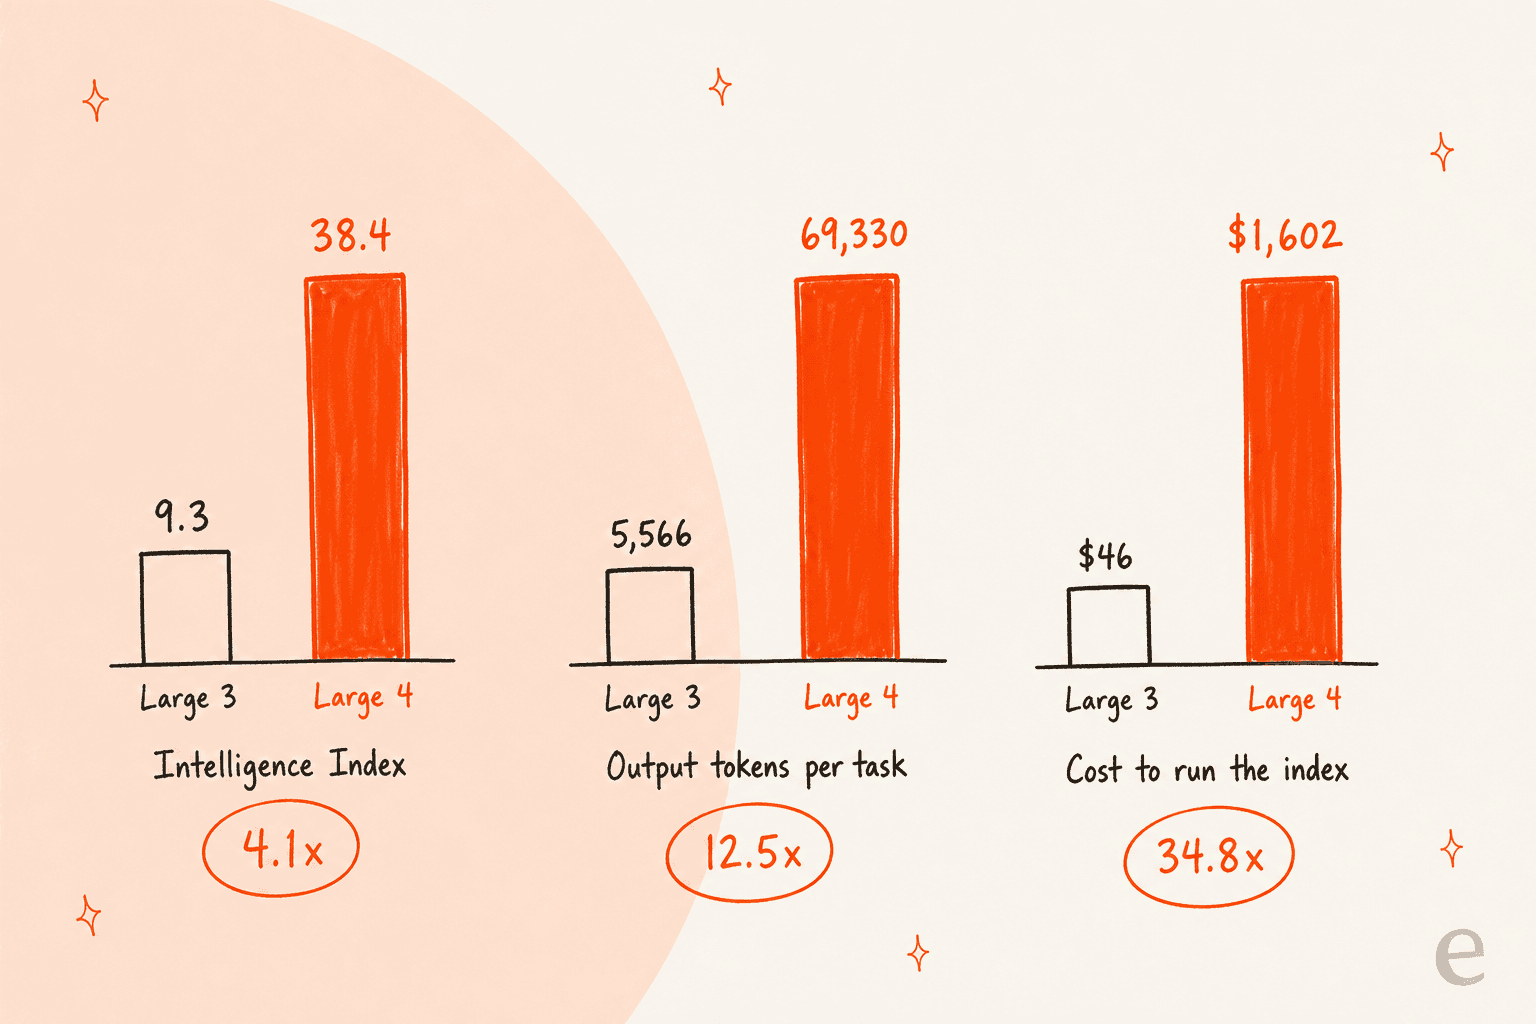
Die Punktzahl stieg um etwa das 4,1-Fache. Die Tokens pro Aufgabe stiegen um das 12,5-Fache, und die Kosten für den vollständigen Index zum Listenpreis um das 34,8-Fache, von 46 $ auf 1.602 $, laut Artificial Analysis. Das ist keine Kritik am Modell; jedes Labor hat denselben Preis für Reasoning gezahlt. Es bedeutet aber, dass der Preis pro Token ein schlechter Anhaltspunkt dafür ist, was Large 4 Sie kosten wird. Artificial Analysis nennt es "sehr ausführlich": 200 Mio. Tokens für den Index gegenüber einem Median von 81 Mio.
Wie sich Mistral Large 4 in unabhängigen Benchmarks schlägt
Hier wird der Test weniger schmeichelhaft. Mistrals Launch-Beitrag ist voller Grafiken, und die meisten zeigen Large 4 als Sieger. Das unabhängige Bild ist gemischter.
Im v4.3.2-Index von Artificial Analysis, der 10 Evaluierungen kombiniert, steht Large 4 unter den Modellen, mit denen es verglichen wird, so da:
| Modell | AA-Index | Preis Input / Output pro 1 Mio. (Liste) | Kosten pro AA-Aufgabe | Ausgabegeschwindigkeit |
|---|---|---|---|---|
| Claude Sonnet 5.5 (Xhigh) | 51,9 | 2 $ / 10 $ | 2,01 $ | 100,7 t/s |
| Qwen 3.8 Max | 45,4 | 2 $ / 6 $ | 5,41 $ | 37,6 t/s |
| Kimi K3 | 43,6 | 3 $ / 15 $ | 2,00 $ | 41,7 t/s |
| Gemini 3.8 Flash | 40,9 | 0,75 $ / 3,75 $ | 1,24 $ | 125,2 t/s |
| DeepSeek V4.1 Flash | 39,5 | 0,30 $ / 1,20 $ | 0,27 $ | 216,1 t/s |
| Mistral Large 4 Preview | 38,4 | 1,36 $ / 4,18 $ | 1,13 $ | 116,1 t/s |
| GPT-5.6 Luna | 37,3 | 0,20 $ / 1,20 $ | 0,18 $ | 117,0 t/s |
Alle Zahlen von den Modellseiten bei Artificial Analysis, abgerufen am 8. Oktober 2026. Die Kosten pro Aufgabe von Large 4 halbieren sich beim aktuellen Angebotspreis ungefähr.
Zwei Dinge fallen auf. Erstens ist Large 4 pro Aufgabe günstiger als jedes Modell darüber und streamt schneller als Kimi K3 und Qwen 3.8 Max. Zweitens liegen DeepSeek V4.1 Flash und GPT-5.6 Luna etwa einen Punkt daneben und kosten pro Aufgabe nur einen Bruchteil, selbst nach Mistrals 50-%-Angebot. Wenn Ihre Aufgabe "ordentliche Antworten, sehr viele" lautet, sind diese beiden die härtere Konkurrenz.
Mistrals eigene Terminal-Bench-4.0-Grafik zeigt gut, wie sehr die Darstellung zählt. Sie zeigt Large 4 bei 28, vor Qwen 3.8 Max und Kimi K3, aber deutlich hinter GLM-5.3 mit 40.
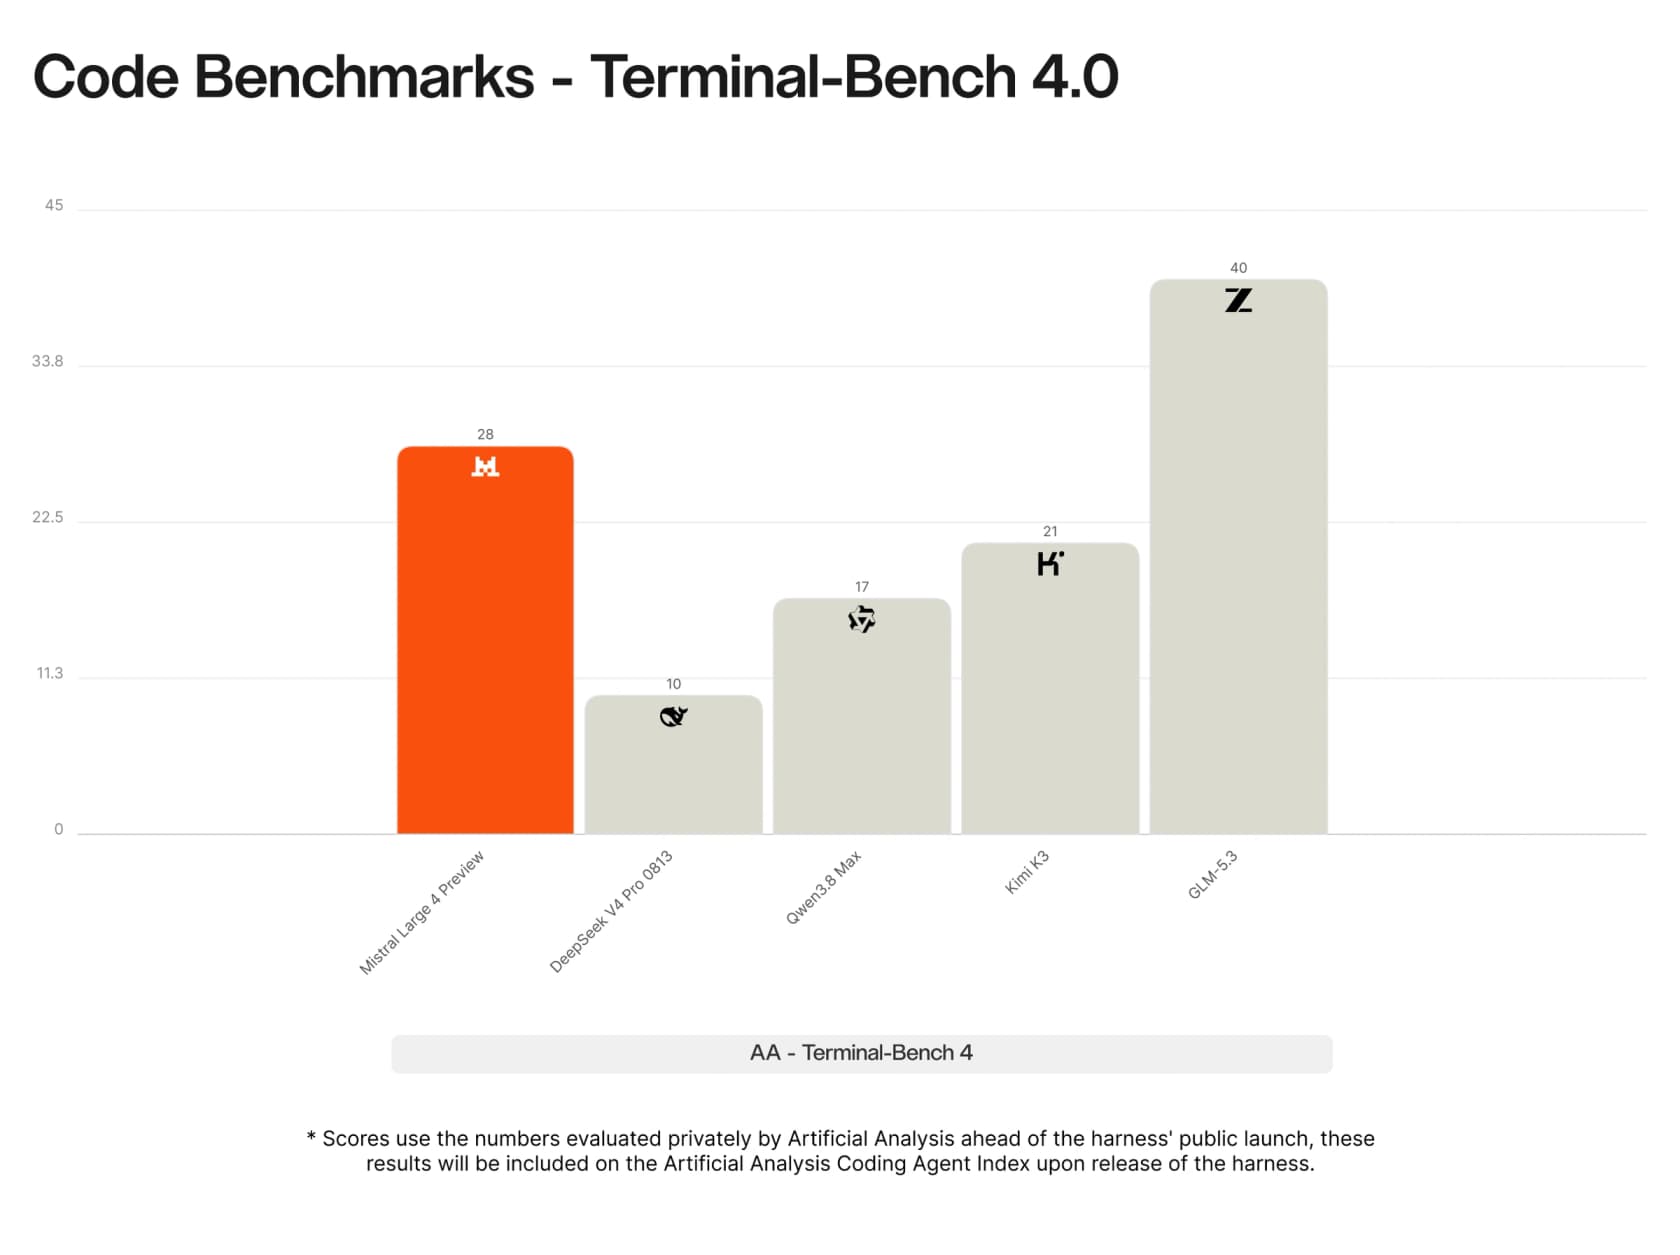
Einige Hacker-News-Leser wurden bei der Wahl der Grafiken deutlicher. Ein Kommentator verglich eine multimodale Grafik mit den öffentlichen Zahlen von Artificial Analysis und fand eine Lücke:
"Ich kenne diesen Benchmark nicht, aber AAs GDP.pdf-Liste hat Sol 5.6 Max bei 27, selbst ohne Reasoning schlägt es die 12,8. Es ist extrem seltsam, Sol 5.6 herauszupicken und dann auch noch beim veröffentlichten Drittanbieter-Benchmark-Wert zu lügen."
Ich würde nicht so weit gehen, von "Lüge" zu sprechen. Benchmark-Versionen und Einstellungen unterscheiden sich, und Mistrals Grafiken können einen anderen Lauf nutzen. Aber es ist ein guter Grund, Herstellergrafiken als Bestfall zu lesen und die Seite von Artificial Analysis als Basis zu nehmen.
Wo Mistral Large 4 wirklich stark ist
Insgesamt Mittelfeld heißt nicht, überall Mittelfeld zu sein. Drei Bereiche halten der Prüfung stand.
Sicherheitsarbeit ohne Verweigerungen. Im Cyber Index von Artificial Analysis, wie von Mistral dargestellt, erzielt Large 4 50 Punkte, vor Kimi K3 und DeepSeek V4.1 Flash bei 41. Interessanter sind die grauen Balken: Bei anderen Frontier-Modellen wurde ein großer Teil der Versuche durch Sicherheitsblockaden gestoppt.
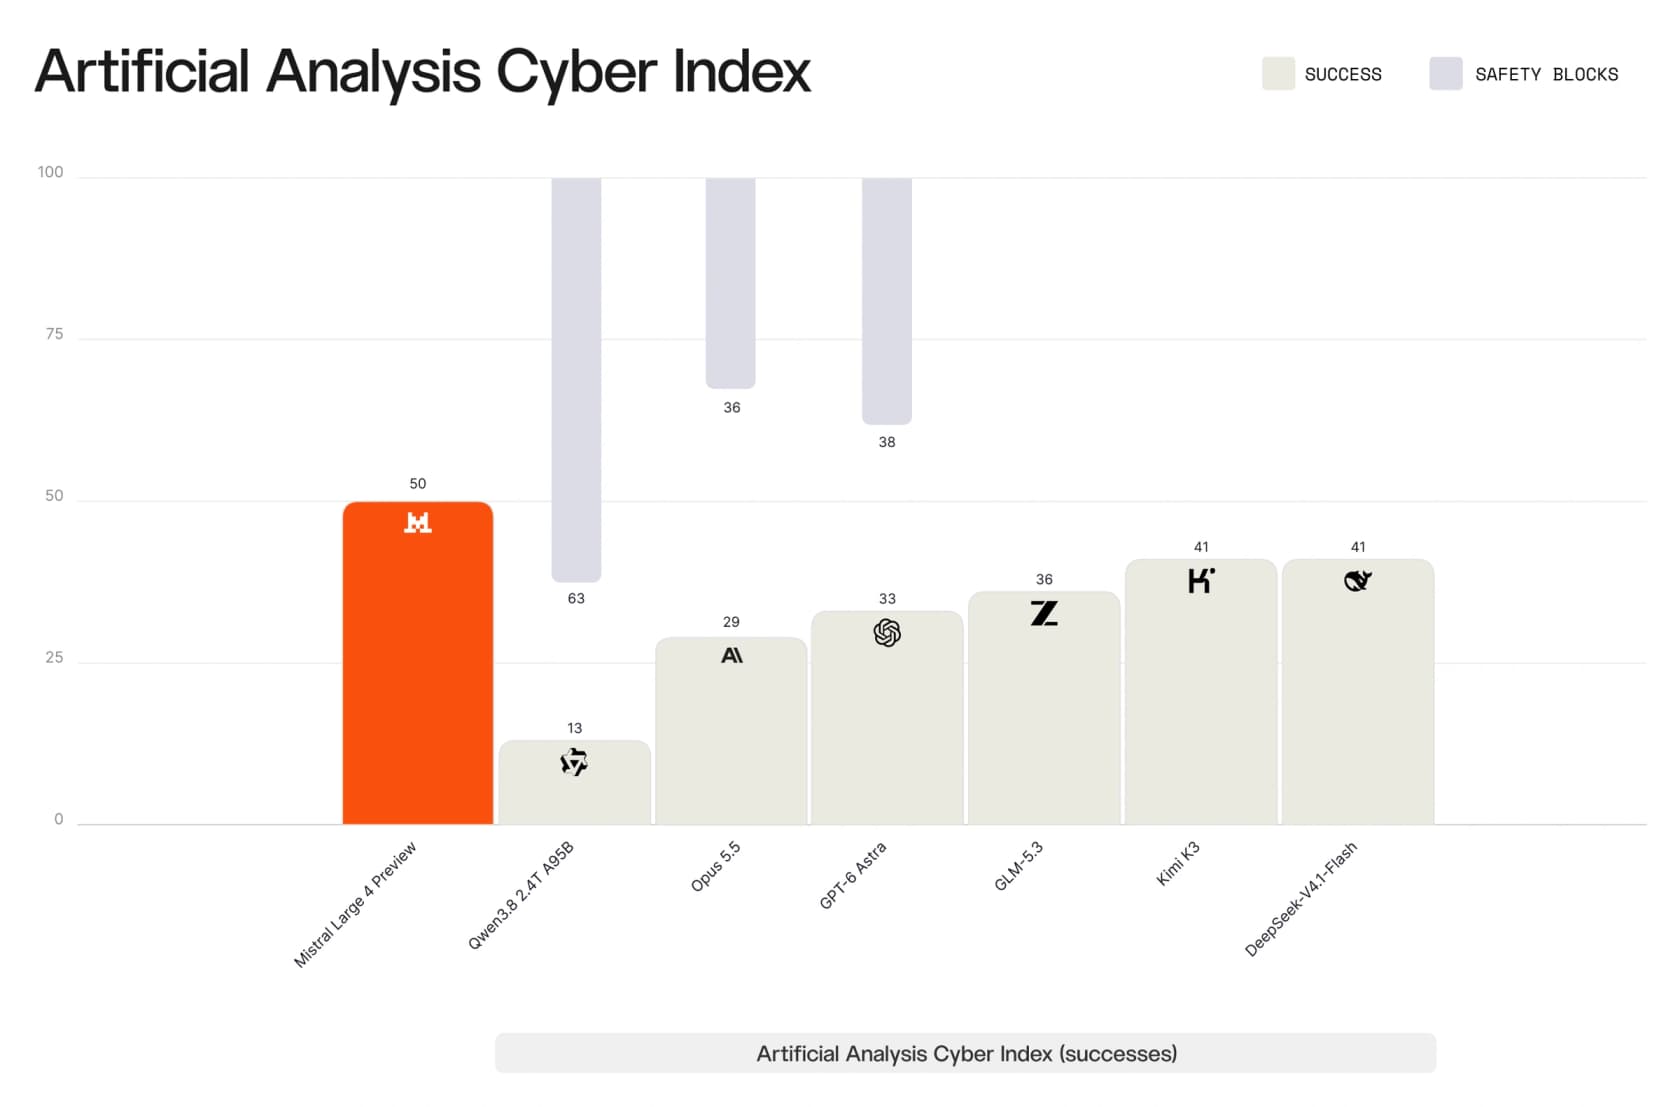
Mistral-Mitgründer Guillaume Lample warb am Launch-Tag genau mit diesem Argument und sagte, offene Modelle "verweigern keine Hilfe". Wenn Sie ein Security-Team leiten und Ihr aktuelles Modell sich weigert, Exploit-Code in Ihrem eigenen Stack anzusehen, ist das ein echter Grund, Large 4 zu testen.
Rechts- und Dokumentenarbeit. Mistrals Grafik von Vals.ai zeigt Large 4 an der Spitze von Harveys Legal-Agent-Benchmark, und Artificial Analysis gibt ihm 81,3 % bei AA-LCR, seinem Test für Langkontext-Reasoning. Lange Verträge passen gut zu einem 1-Mio.-Token-Fenster.
Tempo, sobald es spricht. Mit 116,1 Tokens pro Sekunde über Mistrals API streamt es deutlich schneller als Kimi K3 und Qwen 3.8 Max. Ein früher Tester auf Hacker News mochte es deshalb als täglichen Begleiter:
"Über OpenRouter ist es sehr schnell (deutlich besser als Kimi K3) im WebUI. Sehr ausführlich und scheint nach einer Weile Anweisungen zu vergessen, aber in einem halbstündigen Chat über C und Embedded-Programmierung gab es mir viele gute Infos."
Beachten Sie die Mitte dieses Zitats. "Vergisst Anweisungen" ist in der Produktion viel wichtiger als in einem Chatfenster.
Wo Mistral Large 4 schwächelt
Die Schwächen sind genauso konkret.
Faktenwissen und Halluzinationen. Diese Zahl würde ich rot markieren, wenn ich es für Kundenkontakt bewerten würde. Bei AA-Omniscience, das Wissensfragen stellt und ein Modell dafür belohnt, "Ich weiß es nicht" zu sagen statt zu raten, kam Large 4 auf 25,8 % richtige Antworten und hatte eine Halluzinationsrate von 41,9 %, für einen Gesamtwert von -5,3, laut Artificial Analysis. Ein Hacker-News-Tester sah dasselbe in einem Ratespiel:
"Mistral Large 4 ist nicht sehr gut. Es löst manchmal ein Spiel mit ~40 Versuchen, während die Spitzenmodelle wie Gemini 3.8 Flash oder Grok 4.7 die meisten Rätsel im ersten Anlauf lösen. Mein Benchmark deckt sich mit AA Omniscience."
Zeit bis zur ersten Antwort. Es ist ein Reasoning-Modell, also denkt es, bevor es spricht. Artificial Analysis maß rund 18,7 Sekunden bis zum ersten Antwort-Token bei einem langen Prompt und 28,4 Sekunden bei 100.000 Tokens. Das ist für einen Back-Office-Agenten in Ordnung, für ein Live-Chat-Widget aber quälend.
Agentisches Coding. Es liegt bei Terminal-Bench hinter GLM-5.3 und erzielte im eigenen Lauf von Artificial Analysis 26,8 %. Manche Praxisberichte waren noch härter:
"Habe ein bisschen damit herumgespielt, für Code-Analyse, Bildklassifizierung und Schachfähigkeit. Fühlt sich ziemlich veraltet an und weit hinter dem, was ich normalerweise nutze."

Fairerweise gegenüber Mistral: Das ist eine Preview. Lample sagte auf X, dass der Reinforcement-Learning-Lauf "noch läuft", und eine finale Version soll mit den Gewichten erscheinen. Die Werte können sich vor Ende Oktober noch ändern.
Ist "offene Gewichte" heute ein Grund, es zu wählen?
Noch nicht. Die Modellkarte trägt ein "Open"-Badge, aber das Lizenzfeld ist leer, und Stand 9. Oktober gibt es auf der Mistral-Hugging-Face-Seite kein Large-4-Repository. Artificial Analysis führt es als proprietär, bis die Gewichte erscheinen.
Selbst wenn sie erscheinen, ist ein Modell mit 1,05 Bio. Parametern nichts, was die meisten Teams auf einer freien GPU betreiben. Die am häufigsten gelikte Antwort auf Mistrals Launch-Tweet sagte es am besten:
"ich mit 12 GB VRAM beim Lesen von 'offene Gewichte, 1,05T Parameter'"
Der praktische Wert offener Gewichte liegt hier bei großen Unternehmen und Regierungen, die ein leistungsfähiges Modell auf eigener Hardware in Europa hosten wollen. Für alle anderen bleibt die API, und die API ist eine Preview mit einer Abkündigungsfrist von einem Monat, nicht den sechs Monaten, die ein allgemein verfügbares Modell bekommt. Einen Produktions-Workflow auf eine Preview zu bauen heißt, hinzunehmen, dass sie sich mit vier Wochen Vorwarnung ändern kann.
Wer sollte Mistral Large 4 nutzen?
Nach all dem läuft meine Antwort auf zwei Fragen hinaus: Müssen Ihre Daten in Europa (oder auf Ihren eigenen Servern) bleiben, und zählt rohe Genauigkeit für Ihren Anwendungsfall am meisten?
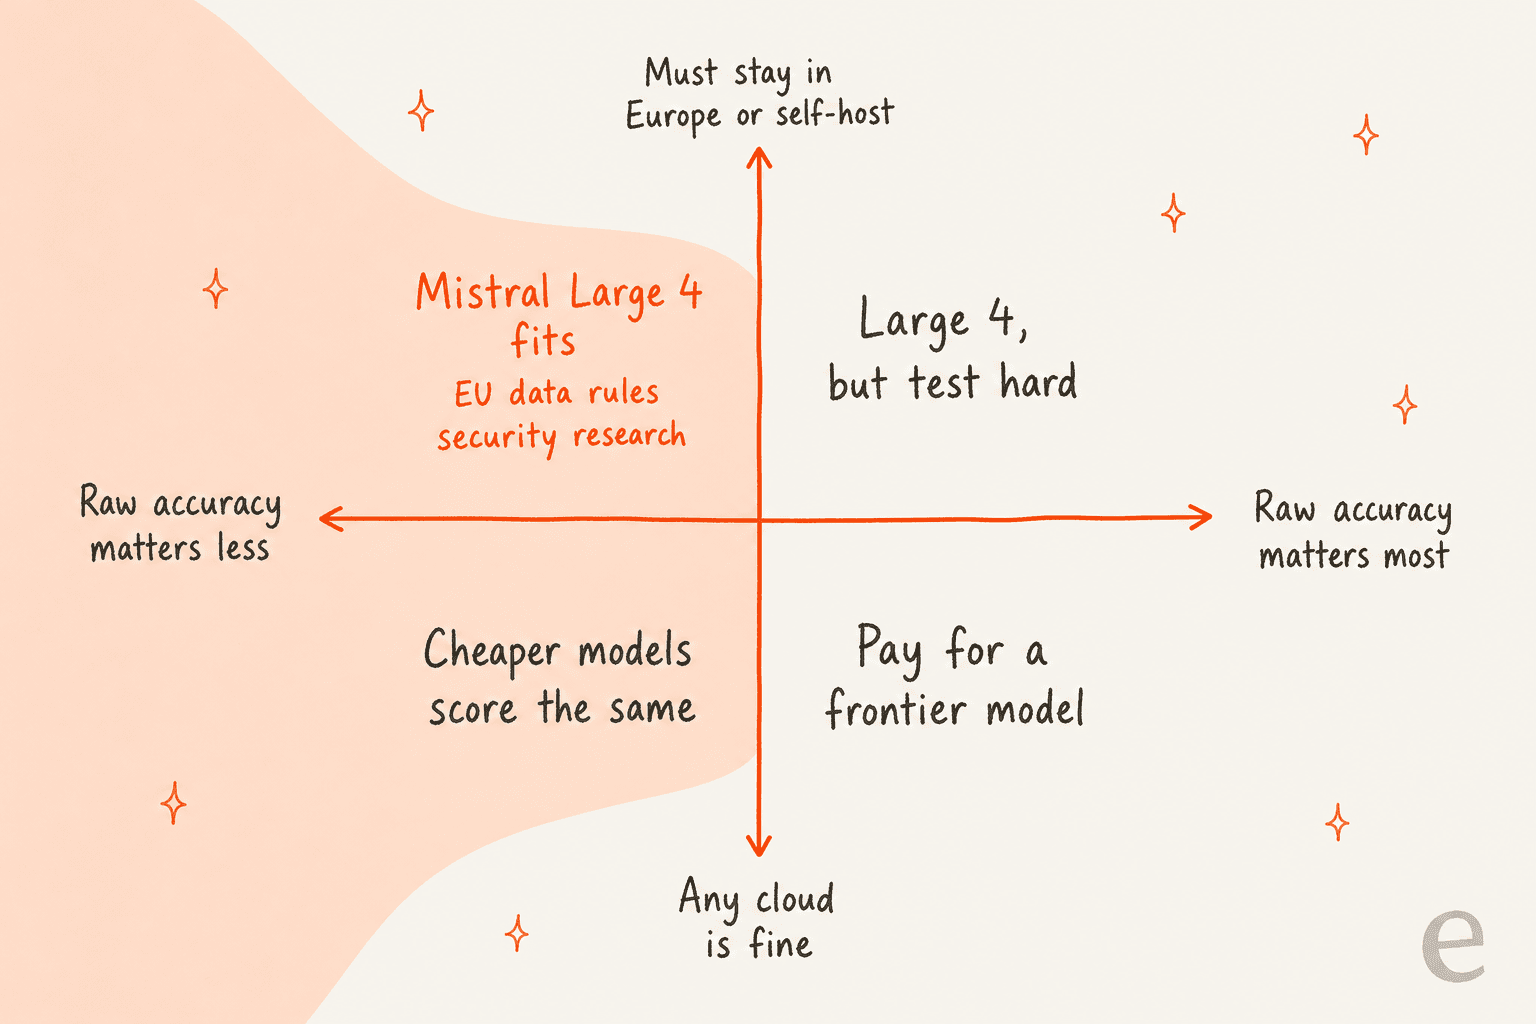
Der Souveränitätspunkt ist echt, und viele Kommentatoren sagten das deutlich:
"In den meisten Unternehmens-Workflows ist es wahrscheinlich gut genug. Und man muss nicht seine Seele an Xi oder Trump verkaufen. Als Europäer hatte ich viel Schlimmeres befürchtet."
Probieren Sie den Eignungs-Check unten aus, um zu sehen, wo Ihr Anwendungsfall landet.
Was ist für Ihre Arbeitslast am wichtigsten?
Wählen Sie eine Option, um mein Urteil zu sehen.
Was das für ein Support-Team bedeutet
Viele Leser von Modelltests fragen sich gerade, ob ein günstigeres europäisches Modell ihren Bot antreiben könnte. Ich verstehe das. Aber die Halluzinationszahl ist die, über die ich länger nachdenken würde.
Ich habe gesehen, was passiert, wenn ein Support-Bot aus dem Gedächtnis des Modells statt aus Ihren Dokumenten antwortet. Anfang des Jahres hatten ein paar zahlende eesel-Kunden einen Bot, der, wenn die Suche in der Wissensdatenbank leer blieb, die Lücke aus seinen Trainingsdaten füllte, statt zu übergeben. Einer schickte erfundene Abo-Details an echte Kunden. Ein anderer beantwortete eine Supportfrage mit "Sauerstoff", dem Element aus dem Periodensystem. Das war ein Fallback-Problem, kein Modellproblem, und ein größeres Modell hätte es nicht behoben. Deshalb wird jeder eesel-Rollout heute an vergangenen Tickets simuliert, bevor er einen Kunden berührt.
Ein CX-Leiter einer Nahrungsergänzungsmarke mit rund 7.000 Tickets formulierte die eigentliche Anforderung besser als jeder Benchmark:
"Ich brauche eine KI, die nur die Tickets bearbeitet, bei denen sie sicher ist, und alle anderen in Ruhe lässt."
Das ist zuerst ein Routing- und Konfidenzwert-Problem und erst danach ein Modellproblem. Ein Modell mit 41,9 % Halluzinationsrate macht diese Ebene wichtiger, nicht unwichtiger. Wenn Sie auf Large 4 selbst bauen, sind meine Leitfäden zu RAG für den Support, zum Stoppen von Halluzinationen und zum besten LLM für den Support ein guter Anfang. Und wenn Ihr Grund für Mistral die EU-Datenregeln sind, prüfen Sie zuerst, was SOC 2 und DSGVO vom Anbieter tatsächlich verlangen; das Herkunftsland des Modells ist nur ein Teil davon.
Mistral-Large-4-Alternativen, die einen Test wert sind
Wenn Sie nach dem Test zögern, würde ich je nach Bedarf hier suchen:
| Sie wollen | Schauen Sie auf | Warum |
|---|---|---|
| Mehr Genauigkeit, weiterhin bezahlbar | Sonnet 5.5 oder Kimi K3 | 51,9 und 43,6 im AA-Index |
| Gleiche Punktzahl, geringere Kosten | DeepSeek-V4-Flash-Familie, GPT-5.6 Luna | 39,5 und 37,3 bei 0,18 $ bis 0,27 $ pro Aufgabe |
| Offene Gewichte, die Sie heute betreiben können | DeepSeek V4.1 Flash, GLM-5.3 | Beide sind in diesem AA-Vergleich neben Large 4 als Open-Weight gelistet |
| Ein günstigeres Mistral | Large 3 oder Small 4 (siehe Mistral-AI-Preise) | 0,50 $/1,50 $ und 0,15 $/0,60 $ pro 1 Mio. |
Für eine längere Liste gehen meine Übersicht der Mistral-Alternativen und die Vergleiche Claude vs. Mistral und ChatGPT vs. Mistral tiefer.
Das Fazit
Mistral Large 4 ist ein echtes Comeback eines Labors, das ins Stocken geraten schien. Der Punktesprung ist real, der Preis ist fair, solange das Angebot läuft, und die Geschwindigkeit ist gut. Wenn Sie einen europäischen Anbieter brauchen oder ein Modell, das bei Sicherheitsarbeit tatsächlich hilft, würde ich es zuerst testen.
Für alle anderen rechtfertigen die Zahlen einen Wechsel noch nicht. Es liegt etwa gleichauf mit Modellen, die pro Aufgabe ein Viertel kosten, es halluziniert mehr, als ich für kundennahe Arbeit akzeptieren würde, und die Version, die Sie heute testen, ist eine Preview, die sich mit einem Monat Vorlauf ändern kann. Ich würde nach der finalen Version und den Gewichten Ende Oktober wieder nachsehen und dann entscheiden.
eesel ausprobieren
Wenn Sie hier sind, weil Sie ein Modell für einen Support-Bot auswählen, hier die Abkürzung: Das Modell ist Infrastruktur, und eesel ist der Mitarbeiter. Der KI-Helpdesk-Teammate von eesel arbeitet in Zendesk, Freshdesk oder Gorgias, lernt aus Ihren bisherigen Tickets und Ihrem Help Center und simuliert Hunderte Ihrer echten Tickets, damit Sie seine Antworten sehen, bevor es ein Kunde tut. Modellwahl, Verankerung und der Fallback "Ich weiß es nicht, ich übergebe an einen Menschen" sind erledigt, und Sie zahlen pro bearbeitetem Ticket, sodass ein ausführliches Modell nie auf Ihrer Rechnung auftaucht. Pläne beginnen kostenlos auf der Preisseite.

eesel testen und den letzten Monat Ihrer Tickets durchspielen, bevor Sie irgendetwas entscheiden.