

Google hat Gemini 3.8 Flash am 2. September 2026 veröffentlicht – das dritte Flash-Release in sechs Wochen. Nachdem ich es durch meinen üblichen Modell-Test-Parcours geschickt habe, hier die ehrliche Einschätzung: Für lange, agentische Coding-Aufgaben ist es zum exakt gleichen Preis ein wirklich besseres Modell als 3.7 Flash – aber die falsche Wahl für alles, worauf ein Mensch wartet.
Die Schlagzeile lautet Geschwindigkeit, und das ist nur halb wahr. Es ist das #3 schnellste Modell von 195 beim Output-Durchsatz, braucht aber 13,30 Sekunden, um das erste Token zu erzeugen – gegenüber einem Median von 2,99 Sekunden. Durchsatz ist nicht gleich Reaktionsfähigkeit, und für ein Chat-Widget oder eine Support-Antwort ist diese Lücke ein Ausschlusskriterium.
Zwei weitere Dinge, die in der Launch-Berichterstattung untergegangen sind. Es ist kein neues Basismodell – Googles eigene Modellkarte schreibt viermal, dass es "based on Gemini 3.7 Flash" ist. Und es ist absichtlich wortreich: 120 Millionen Output-Token verbrennt es, wo das Median-Modell 71 Millionen braucht – wichtig, weil Output-Token auch Denk-Token umfassen und mit 3,75 $/1M abgerechnet werden. Google selbst rät, für effizienzorientierte Arbeit bei 3.7 Flash zu bleiben.
Wenn du auf Modell-Shopping bist, um etwas zu bauen, ist es ein solides, fair bepreistes Coding-Arbeitstier. Wenn du aber willst, dass KI Support-Tickets beantwortet, ist ein rohes Modell die falsche Ebene – warum, erkläre ich am Ende.
Was Gemini 3.8 Flash eigentlich ist
Gemini 3.8 Flash ist Googles neuestes schnelles, günstiges, multimodales Modell, verfügbar als gemini-3.8-flash in der Gemini API und als Standardmodell in Googles agentischer Entwicklungsumgebung Antigravity. Es nimmt Text, Bilder, Audio, Video und PDFs entgegen und gibt Text aus, mit einem Input-Fenster von 1 Million Token und 64K Output. Den vollständigen Launch-Überblick habe ich in meinem Gemini 3.8 Flash Überblick behandelt, und die Kostenseite steht im Beitrag zu den Gemini 3.8 Flash Preisen. Dieser Beitrag hier ist der Test: Lohnt sich die Zeit, und wo passt es tatsächlich hin.
Die für einen Test nützlichste Tatsache hat niemand in eine Schlagzeile gepackt: Das ist kein frisches Modell. Die Modellkarte schreibt wortwörtlich und in vier separaten Abschnitten, dass "Gemini 3.8 Flash is based on Gemini 3.7 Flash." Architektur, Trainingsdaten, Hardware und Sicherheitsrichtlinie verweisen alle auf die 3.7 Flash Karte. 3.8 ist also ein Post-Training-Durchgang auf der Basis von 3.7. Das erklärt den Drei-Wochen-Rhythmus, und es erklärt, warum sich der Preis um keinen Cent bewegt hat. Lies diesen Test also als Antwort auf die Frage "lohnt sich der Wechsel wegen des zusätzlichen Post-Trainings", denn das ist die eigentliche Frage.
Die eine Zahl, die diesen Test entscheidet
Jeder Launch-Beitrag stellte die Geschwindigkeit voran. Hier ist die Zahl, die das relativiert. Artificial Analysis misst bei Gemini 3.8 Flash 305,1 Token pro Sekunde, Platz 3 von 195 Modellen. Das ist real und beeindruckend. Aber dieselbe Messseite gibt auch eine Time-to-First-Token von 13,30 Sekunden an, während das Median-Reasoning-Modell seiner Preisklasse bei 2,99 Sekunden liegt.
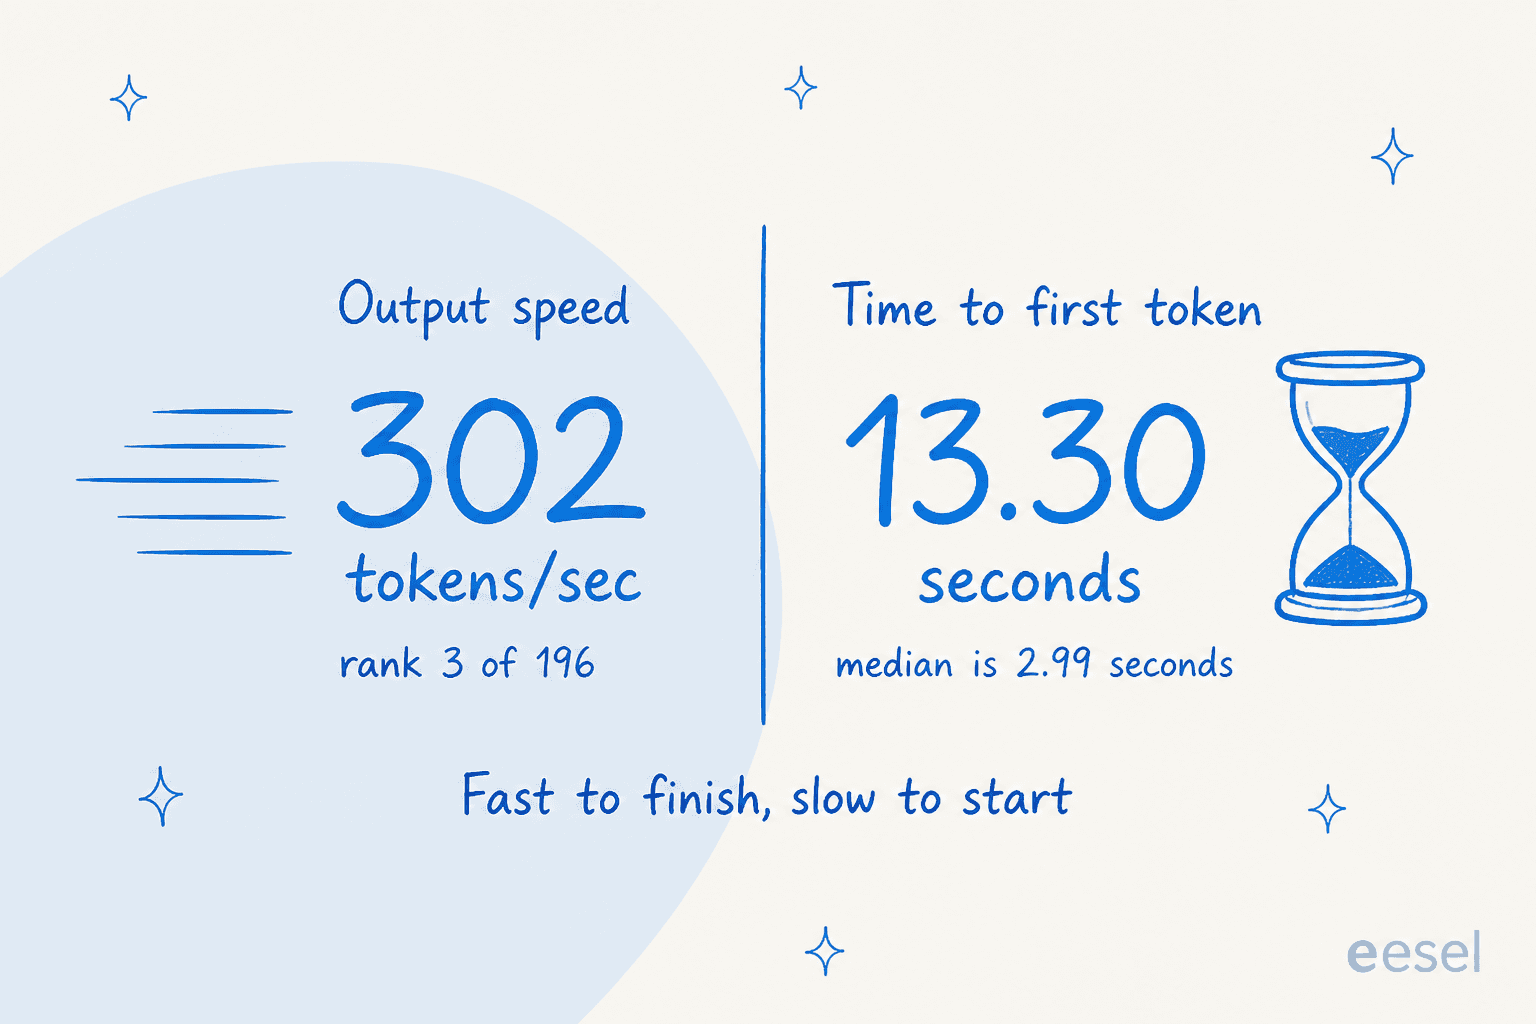
Diese beiden Zahlen beschreiben völlig unterschiedliche Erlebnisse. Durchsatz ist, wie schnell der Text fließt, sobald er einmal losgeht. Time-to-First-Token ist, wie lange die lesende Person auf ein leeres Feld starrt, bevor überhaupt etwas erscheint. Für einen nächtlichen Batch-Agenten, der sich durch ein Repo arbeitet, sind 13 Sekunden Vorab-Denken unsichtbar, und der Durchsatz ist alles. Für einen Menschen, der auf ein Chat-Widget schaut, oder einen Support-Mitarbeitenden, der auf einen Antwortvorschlag wartet, sind 13 Sekunden toter Luft das gesamte Erlebnis, und keine nachgelagerte Geschwindigkeit rettet das noch.
Deshalb widerspreche ich immer wieder dem Satz "3.8 Flash is the fast one". Es ist das schnelle Modell für Maschinen und das langsame für Menschen. Diese eine Unterscheidung sortiert fast jeden Anwendungsfall, den ich mir vorstellen kann, und deshalb zählen die Benchmarks unten weniger, als sie aussehen.
Wo es wirklich gut ist
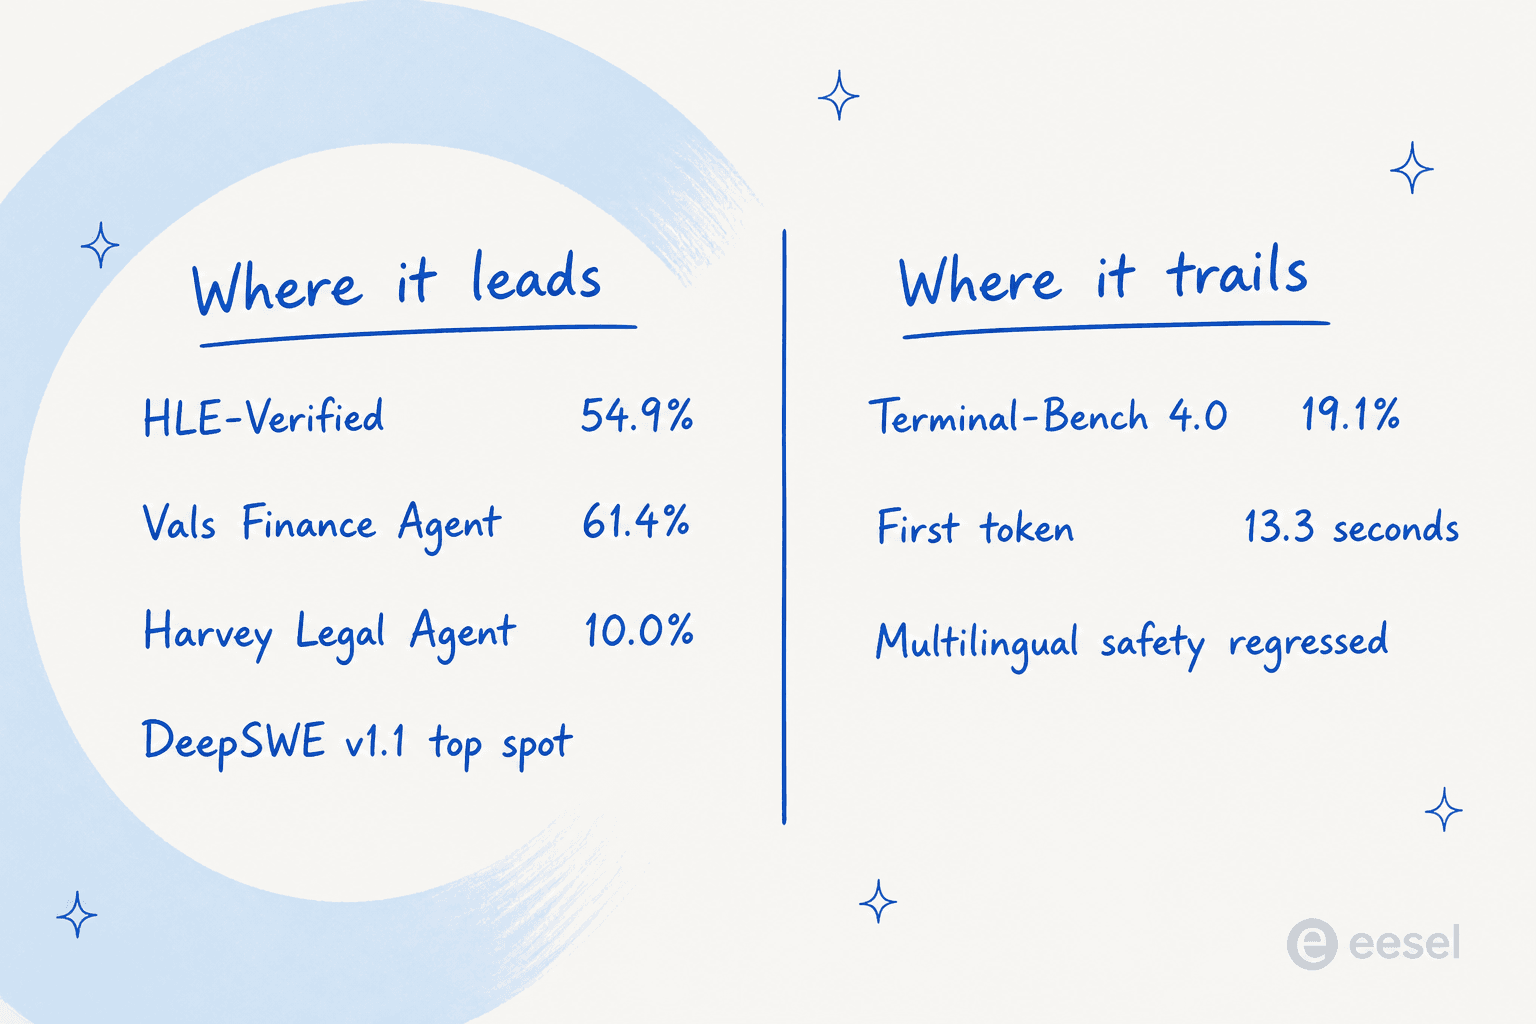
Gib ihm eine lange, agentische Coding-Aufgabe, und 3.8 Flash verdient sich seinen Platz. Nach Googles eigenen Zahlen führt es bei HLE-Verified mit 54,9 % (vor GPT-5.6 Sol, Claude Opus 5 und seinem eigenen Vorgänger), gewinnt den Vals Finance Agent v2 Benchmark mit 61,4 % und steht bei DeepSWE für langwierige Software-Arbeit an der Spitze. Benchmark-Anbieter david bringt den Reiz auf den Punkt: "5x cheaper and 2x faster than Opus 5 for similar intelligence."
Der Intelligence Index stützt die Coding-Geschichte: 59 Punkte bei Artificial Analysis, gleichauf mit Claude Opus 5 bei mittlerem Aufwand – für ein Modell der Flash-Klasse ein starkes Ergebnis. Und das Verhalten bei langwierigen Aufgaben ist real, kein Benchmark-Artefakt. Design-Partner Thai Tran von Glean berichtete, dass es bei dokumentenintensiven Workflows "completing more than three times as many tasks as Gemini 3.7 Flash in our evaluations" schafft. Auf Hacker News erzeugte simonw eine HTML-Visualisierung in 13 Sekunden für 1,8 Cent und nannte die Kombination aus Geschwindigkeit und Frontend-Qualität "pretty exciting."
Mein Lieblings-Praxismuster stammt von panarky, der Flash eher als Prüfer statt als Builder einsetzt:
"I've been using 3.7 Flash to audit the work of Opus High, and Flash finds lots of subtle and insidious defects even while all the unit tests are green... it is blazing fast in Antigravity CLI. Easily 10x faster than Opus. Can't wait to try 3.8 Flash. If it's good enough, maybe I'll switch Flash to primary and make Opus the auditor."

Das ist genau die Art von Workload, für die 3.8 Flash gebaut ist: günstig, schnell, unermüdlich, bereit, sich durch eine lange Aufgabe zu arbeiten. Wenn das auf dich zutrifft, gehört es auf deine Shortlist neben die anderen besten KI-Coding-Assistenten.
Wo es schwächelt
Genau das "works harder"-Design, das die Coding-Benchmarks gewinnt, macht es überall sonst unhandlich. Google ist im Launch-Beitrag ungewöhnlich offen darüber: 3.8 Flash "exhibits greater diligence, executing extra reasoning steps, and calling tools iteratively. At times, the model might use more tokens to maximize performance." Übersetzt heißt das: Es denkt viel, und du bezahlst für dieses Denken.
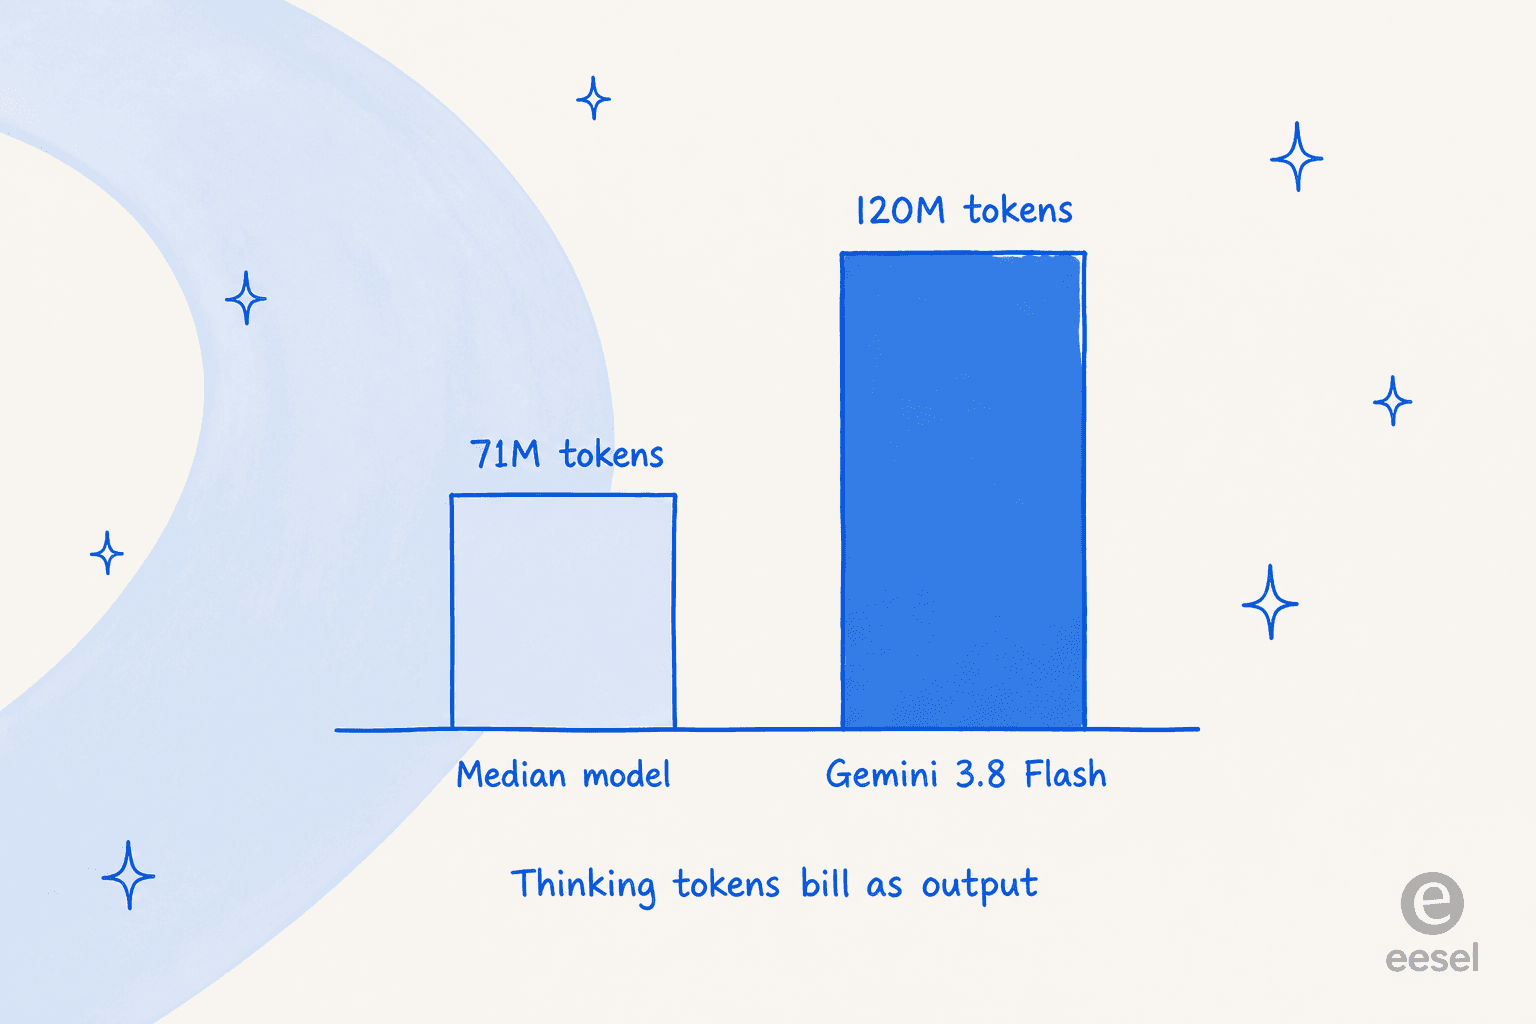
Artificial Analysis markierte es als "very verbose": 120 Millionen Output-Token, um den Index zu durchlaufen, gegenüber einem Median von 71 Millionen. Da Gemini Denk-Token zum Output-Tarif von 3,75 $ abrechnet, ist diese Wortfülle ein direkter Kostenmultiplikator, den der Listenpreis verschleiert. HN-Nutzer bermudi hat das mit einer Zahl belegt: rund 11.000 Token mehr pro Aufgabe als bei 3.7 im gleichen Benchmark, "making it more expensive and slower in practice than the headline rate suggests." Mein Beitrag zu den Gemini 3.8 Flash Preisen enthält die vollständige Rechnung, aber kurz gesagt: Ein Preis pro 1 Million lügt, wenn das Modell entscheidet, mehr dieser Millionen auszugeben.
Dann gibt es noch das Babysitten. mythz bringt einen Frust auf den Punkt, den ich teile:
"Whilst it's a fast model, having to baby sit through and approve prompts every few seconds ends up making it slower than the Auto approve modes of Claude/ChatGPT."
Und es kann bei einfachen Prompts übers Ziel hinausschießen. refulgentis berichtete, dass er "Hi" schrieb und dafür eine App mit vier Bereichen bekam, inklusive eines fiktiven Wetter-Widgets und einer To-Do-Liste. Das ist eine Kleinigkeit, aber sie verrät ein Modell, das auf maximale Arbeit getrimmt ist – genau das Gegenteil von dem, was du bei einer engen, klar umrissenen Aufgabe willst.
Noch zwei ehrliche Vorbehalte. Bei Terminal-Bench 4.0 erreicht es 19,1 % gegenüber 51,8 % bei Opus 5, sodass "matches Opus 5" nur für die Benchmarks stimmt, die Google zeigen wollte. Und die Modellkarte verzeichnet zwei Sicherheitsmetriken, die sich verschlechtert haben: mehrsprachige Sicherheit um 5,4 Prozentpunkte und unbegründete Verweigerungen um 1,1 Prozentpunkte, wobei Google unverblümt feststellt: "safety performance across non-English languages regressed slightly." Die vollständige Frontier-Safety-Bewertung wurde nicht einmal neu durchgeführt, sondern per Rückschluss von 3.7 übernommen. Keines dieser Details ist für sich allein ein Dealbreaker, aber genau die Art von Detail, die ein fairer Test benennen muss.
Was die Leute nach dem Testen tatsächlich gesagt haben
Die Community-Meinung ist auf eine nützliche Weise gespalten, und sie deckt sich fast genau mit der oben beschriebenen Trennung zwischen Maschine und Mensch.
Wer lange Coding-Aufgaben laufen lässt, war größtenteils angetan. Selta nannte es "quite a big update" und verwies auf die Fortschritte beim Coding-Reasoning und weniger Halluzinationen bei gleichbleibender Geschwindigkeit. Conor Dart sagte "Google is back... this model takes its time to think and work through the tasks." Und scrlk brachte einen Punkt zur Sprache, den Benchmarks komplett übersehen: "Gemini's speed and quality doesn't degrade badly during weekday working hours compared to OAI, and especially Anthropic." Konstanz unter Last ist ein echter Vorteil.
Wer einen großen Sprung erwartet hatte, war kühler. markasoftware merkte an, dass es bei Artificial Analysis nur mit "opus 5 medium effort" gleichzieht, und dass "opus 5 medium outputs 4x fewer tokens to achieve the same result, negating a lot of the speed difference." zuzululu kam zum gleichen Schluss wie ich: "i might consider 3.8 flash for simple side hobby projects or quick scaffolding but would not trust it for long agentic tasks." Und pkos98 brachte die gesündeste Skepsis gegenüber jedem Launch-Tag-Benchmark ins Spiel: "Wait a week with your judgement, most likely, Google is just bench-maxing very hard."
Es gibt auch einen strukturellen Kritikpunkt, den man erwähnen sollte. Kol Tregaskes wies darauf hin, dass dies bereits das vierte Flash-Modell in Folge ist "with no Pro model." Das ist keine Kritik an 3.8 Flash selbst, aber es ist der Kontext: Berichten zufolge wird 3.5 Pro komplett ausgelassen, sodass Flash die Flaggschiff-Last trägt, während ein Modell der Pro-Klasse in der Reihe fehlt. Wenn du herstellerübergreifend vergleichst, sind ChatGPT vs. Gemini und mein Überblick zu Gemini-Alternativen die zwei nützlichsten Ausgangspunkte.
Das Fazit: Solltest du von 3.7 Flash wechseln?
Weil der Preis identisch ist, ist das der einzige Vergleich, der zählt – und er ist klarer als die meisten Upgrade-Entscheidungen.
| Wenn dein Workload... ist | Die Wahl | Warum |
|---|---|---|
| Langwierige agentische Coding-Aufgaben, dokumentenintensive Tätigkeiten, ein nächtlicher Batch-Agent | Gemini 3.8 Flash | Auf den hier relevanten Benchmarks wirklich besser, zum gleichen Preis; das zusätzliche Denken zahlt sich aus |
| Latenzkritisch, mit Mensch im Loop (Chat, Live-Support) | Gemini 3.7 Flash | Die 13,30 Sekunden für das erste Token treffen eine Person direkt; zusätzliche Wortfülle ist reiner Overhead |
| Kostenorientiert, hohes Volumen, einfache Aufrufe (Klassifizierung, OCR, Extraktion) | Gemini 3.7 Flash | Google sagt es direkt: es "remains fully supported for efficiency-first workloads" |
| Ein Prüfer, der die Arbeit eines größeren Modells doppelt checkt | Beide Flash-Modelle | Günstig und schnell genug, dass der Einsatz als Reviewer ein cleveres Muster ist |
Das Fazit lautet: 3.8 Flash ist für genau eine Art von Arbeit ein echtes Upgrade und für eine andere ein verkapptes Downgrade. Dass Google dir beide zum gleichen Preis gibt, ist keine Großzügigkeit, sondern ein Eingeständnis, dass das neuere Modell Effizienz gegen Sorgfalt eintauscht – und nur du weißt, auf welcher Seite dieses Trades dein Workload steht. Noch etwas, das du einpreisen solltest: Der Tarif von 0,75 $ ist eine Promo, die sich am 1. Januar 2027 auf 1,50 $ verdoppelt. Wer mit der heutigen Zahl kalkuliert, kalkuliert mit einem Rabatt.
Was das bedeutet, wenn du KI auf eine Support-Queue ansetzen willst
Hier muss ich ehrlich sein, denn ich teste diese Modelle genau, um die Frage zu beantworten, die Support-Teams mir immer wieder stellen: "which model should we point at our tickets?"
Die ehrliche Antwort ist, dass das Modell die falsche Sache zum Einkaufen ist. Ein Support-Workload ist fast das perfekte Gegenteil von dem, was 3.8 Flash gut kann. Tickets sind kurzkontextig, nicht langwierig. Das Volumen ist hoch, also summiert sich die Latenz, und eine Verzögerung von 13 Sekunden bis zum ersten Token, multipliziert mit Tausenden von Konversationen, ist ein echter Kostenfaktor. Und ein rohes Modell liefert dir keinen der Bausteine, die Support-Automatisierung tatsächlich funktionieren lassen: Es kennt dein Help Center nicht, kann deine vergangenen Tickets nicht lesen, sitzt nicht in Zendesk oder Freshdesk, und hat keine Möglichkeit, dir zu zeigen, was es gesagt hätte, bevor es das einem Kunden sagt.
Ich habe schon selbstbewusst klingende Bots gesehen, die in Live-Queues leise falsche Antworten gegeben haben – ein Versagen, vor dem ein Benchmark-Score dich nie warnen kann. Deshalb interessiert mich nicht der Intelligence Index eines Modells, sondern ob das System dahinter zuerst gegen deine echten Tickets simuliert werden kann. Ein Modell ist Infrastruktur. Was ein Support-Team wirklich braucht, ist die Mitarbeiterin, die bereits mit Kontext und Guardrails in dein Helpdesk eingebunden ist. Die Modellwahl darunter ist ein Detail, das die Plattform übernehmen sollte – keine Entscheidung, die du anhand von Launch-Benchmarks treffen solltest.
eesel ausprobieren
Wenn du eigentlich willst, dass KI Tickets beantwortet, statt selbst ein Modell zu verdrahten, würde ich bei eesel anfangen. eesel verkauft einsatzbereite KI-Teammitglieder statt roher Infrastruktur, und das KI-Helpdesk-Teammitglied reiht sich in wenigen Minuten in deine bestehende Queue in Zendesk, Freshdesk oder Gorgias ein, trainiert auf dein Help Center und deine vergangenen Tickets.

Der Unterschied ist der Teil, den dir Modell-Benchmarks nicht geben können. Jedes eesel-Rollout wird zuerst gegen deine echten historischen Tickets simuliert, damit du siehst, was die KI Kunden gesagt hätte, die du bereits betreut hast, bevor sie irgendetwas zu einem Live-Kunden sagt. Es übernimmt auch die unglamouröse Handarbeit wie Ticket-Klassifizierung und Support-Tagging, und es ist kostenlos zum Ausprobieren. Das Teammitglied KI-Blog-Autor läuft auf derselben Plattform, wenn Content statt Support dein Flaschenhals ist.
Auf der Zahlenseite hat KI-Support-Kosteneinsparungen die Rechnung, und Agent vs. Mensch: Kostenvergleich ist der Vergleich, den Finance-Teams tatsächlich sehen wollen. Und wenn du immer noch nach Modellen statt nach Produkten shoppst, sind Top-KI-Agenten und Die besten KI-Agenten für kleine Unternehmen die zwei Überblicke, die ich als Nächstes lesen würde.