Was Gemini 3.8 Flash eigentlich ist
Gemini 3.8 Flash ist Googles Arbeitspferd-Modell, veröffentlicht als gemini-3.8-flash und klar auf langfristiges Coding und autonome Agenten ausgerichtet, nicht auf Chat.
Die Spezifikationen sind gegenüber der letzten Generation unverändert. Es nimmt Text, Bild, Audio, Video und PDF auf, gibt Text aus und hält ein 1-Mio.-Token-Kontextfenster mit einer Obergrenze von 64K Output. Es kann Function Calling, Search als Tool und Computer Use. Google veröffentlicht das alles auf der Modellkarte.
Wo man es tatsächlich erreichen kann, unterscheidet sich je nach Zielgruppe. Entwickler bekommen es in Google AI Studio, der Gemini API, Android Studio und Google Antigravity, wo es jetzt das Standardmodell ist. Letzteres ist relevant, wenn man nach KI-Coding-Assistenten sucht, denn es bedeutet, dass man 3.8 unter Umständen schon nutzt, ohne es bewusst gewählt zu haben.
Unternehmen bekommen es über Gemini Enterprise. Verbraucher bekommen es in der Gemini-App, im AI Mode der Suche und in Google Sheets, aber nur mit Google AI Pro oder Ultra. Wer diese Verbraucher-Stufen abwägt, findet meine Einordnung im Google AI Plus-Beitrag, und es gibt eine eigene Anleitung zum Abschalten von Gemini in Workspace, falls es sich für dein Team selbst eingeschaltet hat.
Es gibt ein zweites Modell in derselben Ankündigung, und die meiste Berichterstattung hat es unter den Tisch fallen lassen. Gemini 3.8 Flash Cyber ist eine Sicherheitsvariante mit bewusst lockereren Schutzmaßnahmen für Cyber-Arbeit, und sie ist über das neue Fairwind Program auf vertrauenswürdige Verteidiger beschränkt. Mehr dazu weiter unten, denn die Zahlen sind der beeindruckendste Teil des gesamten Launches.
Der Teil, den Google laut ausspricht, und den fast niemand zitiert hat
Hier ist der Satz, der die Veröffentlichung neu einordnet. Aus der Modellkarte, wiederholt in vier separaten Abschnitten:
"Gemini 3.8 Flash is based on Gemini 3.7 Flash."
Das ist keine Nebensächlichkeit. Die Abschnitte Architecture, Training Dataset, Hardware, Software, Safety Policies und Acceptable Usage verweisen alle auf die Gemini 3.7 Flash Modellkarte, statt etwas Neues zu beschreiben. 3.8 Flash ist weiter trainiertes 3.7 Flash, kein neues Basismodell.
Sobald man das weiß, wirkt der Rest der Veröffentlichung nicht mehr überraschend. Es erklärt den Drei-Wochen-Rhythmus. Es erklärt, warum sich der Preis nicht um einen Cent bewegt hat. Und es setzt eine realistische Erwartung: Das ist eine Iteration, und sie verhält sich auch so.
Googles Blog ist ebenso direkt über den Mechanismus hinter den Verbesserungen. Die Formulierung lohnt genaues Lesen, denn sie ist ein als Feature verkleideter Trade-off:
"These performance gains stem from a core design choice: 3.8 Flash works harder. On complex tasks, it exhibits greater diligence, executing extra reasoning steps, and calling tools iteratively. At times, the model might use more tokens to maximize performance, especially at higher effort levels."
Dann der Satz, der über deinen Umstieg entscheiden sollte: Google empfiehlt Entwicklern, denen Rechen-Effizienz wichtig ist, "continue to rely on Gemini 3.7 Flash, which remains fully supported for efficiency-first workloads." Dass ein Anbieter sagt, sein altes Modell sei immer noch die richtige Wahl, ist selten genug, um es wörtlich zu nehmen.
Preise: identisch zu 3.7 Flash, und im Januar verdoppelt
Es gibt keinen Aufpreis für das neuere Modell. Die Gemini API Preisseite listet 3.8 Flash und 3.7 Flash zu denselben Sätzen, Zeile für Zeile.
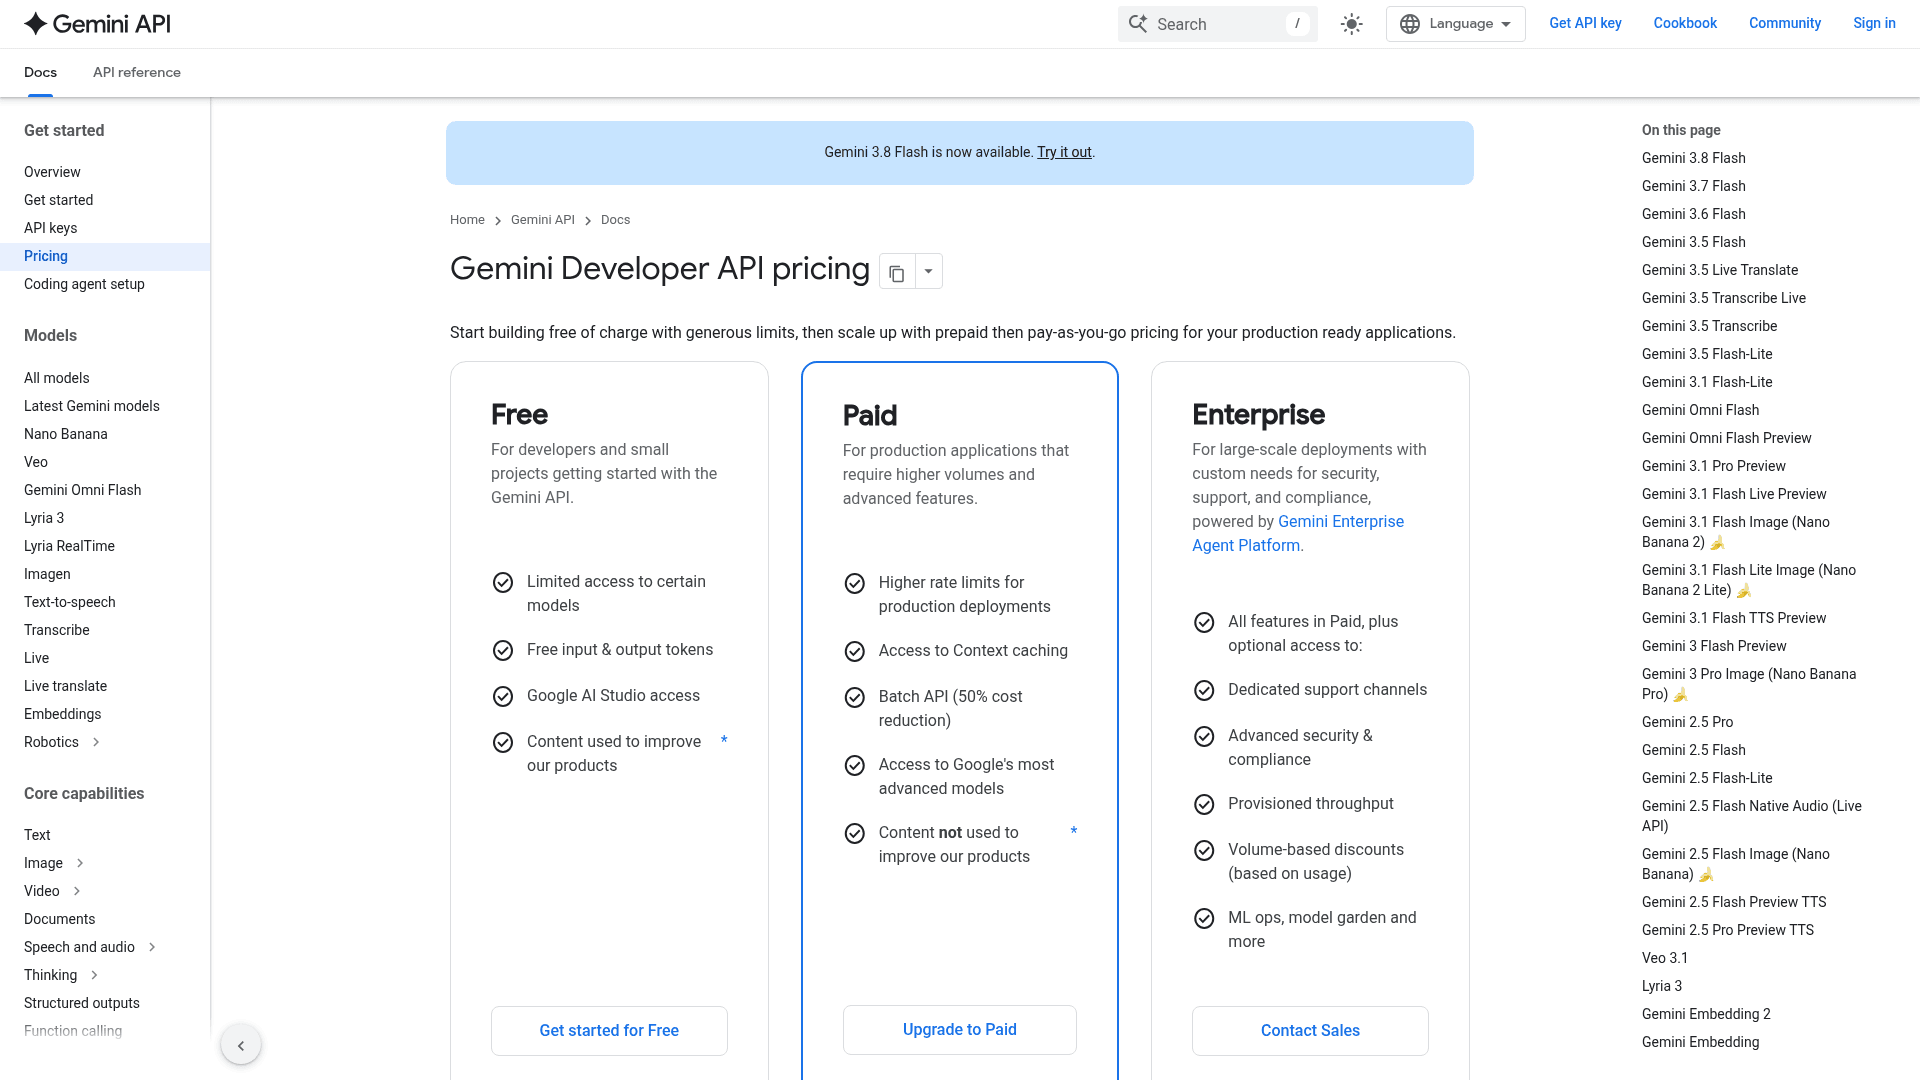
| Stufe | Input / 1M | Output / 1M (inkl. Denken) | Cache-Lesen / 1M | Ab 1. Jan. 2027 |
|---|---|---|---|---|
| Free | $0 | $0 | $0 | unverändert |
| Standard | $0.75 | $3.75 | $0.075 | $1.50 / $7.50 |
| Batch | $0.375 | $1.875 | $0.0375 | $0.75 / $3.75 |
| Flex | $0.375 | $1.875 | $0.0375 | $0.75 / $3.75 |
| Priority | $1.35 | $6.75 | $0.135 | $2.70 / $13.50 |
Drei Dinge in dieser Tabelle verdienen mehr Aufmerksamkeit, als sie meist bekommen.
Der Output-Preis schließt Denk-Token ein. Du zahlst 3,75 $ pro Million für Überlegungen, die du nie zu sehen bekommst, nur eine Zusammenfassung davon. Bei einem Modell, dessen Hauptmerkmal ist, dass es härter nachdenkt, ist das der Zähler, der sich dreht.
Cache-Speicherung wird separat abgerechnet. Lesevorgänge kosten 0,075 $ pro Million, aber Speicherung kostet 0,50 $ pro 1 Mio. Token pro Stunde, sich ebenfalls im Januar verdoppelnd.
Grounding wird geteilt, nicht pro Modell abgerechnet. Du bekommst 5.000 kostenlose Google-Search-Anfragen pro Monat über alle Gemini-3.x-Modelle zusammen, danach 14 $ pro 1.000. Gleiches Kontingent für Google-Maps-Grounding.
Und die Schlagzeilen-Zahl ist eine Aktion. Jeder Satz hier verdoppelt sich am 1. Januar 2027. Wer ein 2027er-Budget auf Basis von 0,75 $ kalkuliert, kalkuliert mit der falschen Zahl – ein Fehler, den ich Teams bei LLM-Kosten schon mehrfach machen sah. Lohnt sich, mit echten LLM-Tracking-Tools statt einer Tabelle zu kombinieren, denn der Denk-Token-Overhead ist der Teil, den niemand richtig vorausberechnet.
Zum Vergleich, was die Konkurrenz verlangt: Claude Opus Preise und OpenAI Rate Limits sind die beiden Vergleiche, die am häufigsten auftauchen, wenn Teams einen Wechsel durchrechnen.
Die Benchmarks, mit denen Google vorangeht
Google hat vier Top-Ergebnisse veröffentlicht, und 3.8 Flash führt bei allen vieren. Hier die vollständige Übersicht von der DeepMind Modellseite, also der Primärquelle statt einer Presse-Zusammenfassung.
| Benchmark | Gemini 3.8 Flash | Gemini 3.7 Flash | Claude Opus 5 | GPT-5.6 Sol | GPT-5.6 Terra | Claude Sonnet 5 |
|---|---|---|---|---|---|---|
| HLE-Verified | 54.9% | 53.6% | 54.4% | 54.5% | 51.1% | 31.0% |
| Vals Finance Agent v2 | 61.4% | 59.0% | 58.6% | 53.8% | 54.4% | 53.9% |
| Harvey's Legal Agent | 10.0% | 8.8% | 6.7% | 2.5% | 0.8% | 5.0% |
| DeepSWE v1.1 | Spitzenplatz | niedriger | niedriger | n/a | n/a | n/a |
Zwei ehrliche Vorbehalte, bevor jemand diese Tabelle als Screenshot verschickt.
Die Harvey Legal Agent-Zeile sieht nach einem klaren Sieg aus, aber der Gewinner-Wert liegt bei 10,0 %. Jedes Modell in dieser Spalte scheitert am Benchmark; 3.8 Flash scheitert am wenigsten. Opus 5 um 3,3 Punkte bei einem Test zu schlagen, den niemand besteht, ist ein echtes, aber kleines Ergebnis.
Und bei HLE-Verified beträgt der Vorsprung gegenüber Opus 5 einen halben Punkt. Google behauptet ein Unentschieden mit einem Frontier-Modell zu einem Bruchteil des Preises – das ist die eigentliche Geschichte, kein K.o. Wer die Generation-über-Generation-Version dieses Arguments will: Gemini vs. Claude Opus und ChatGPT vs. Gemini halten beide stand.
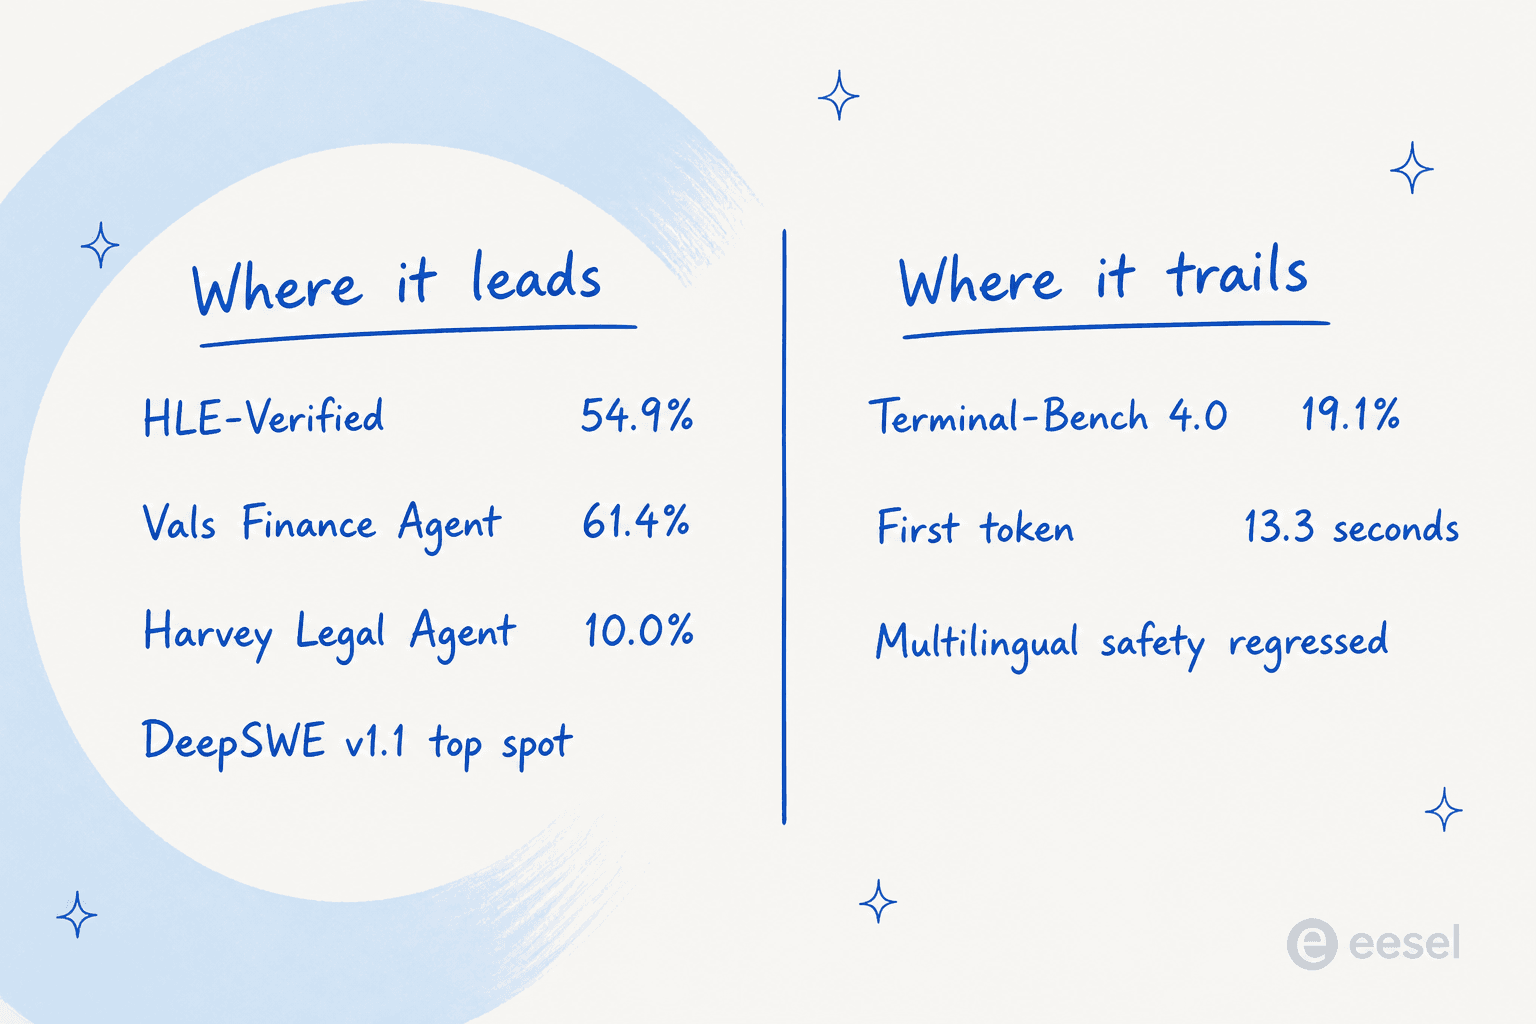
Die rechte Spalte ist der Teil, den Googles Beitrag nicht abdeckt, und er stammt von Leuten, die das Modell tatsächlich ausgeführt haben, statt es nur anzukündigen.
Die unabhängigen Zahlen erzählen eine nützlichere Geschichte
Artificial Analysis hat 3.8 Flash mit hohem Effort-Level über seinen neun Benchmarks umfassenden Intelligence Index laufen lassen, und die vier Zusammenfassungskarten sind entscheidungsrelevanter als alles im Launch-Beitrag.
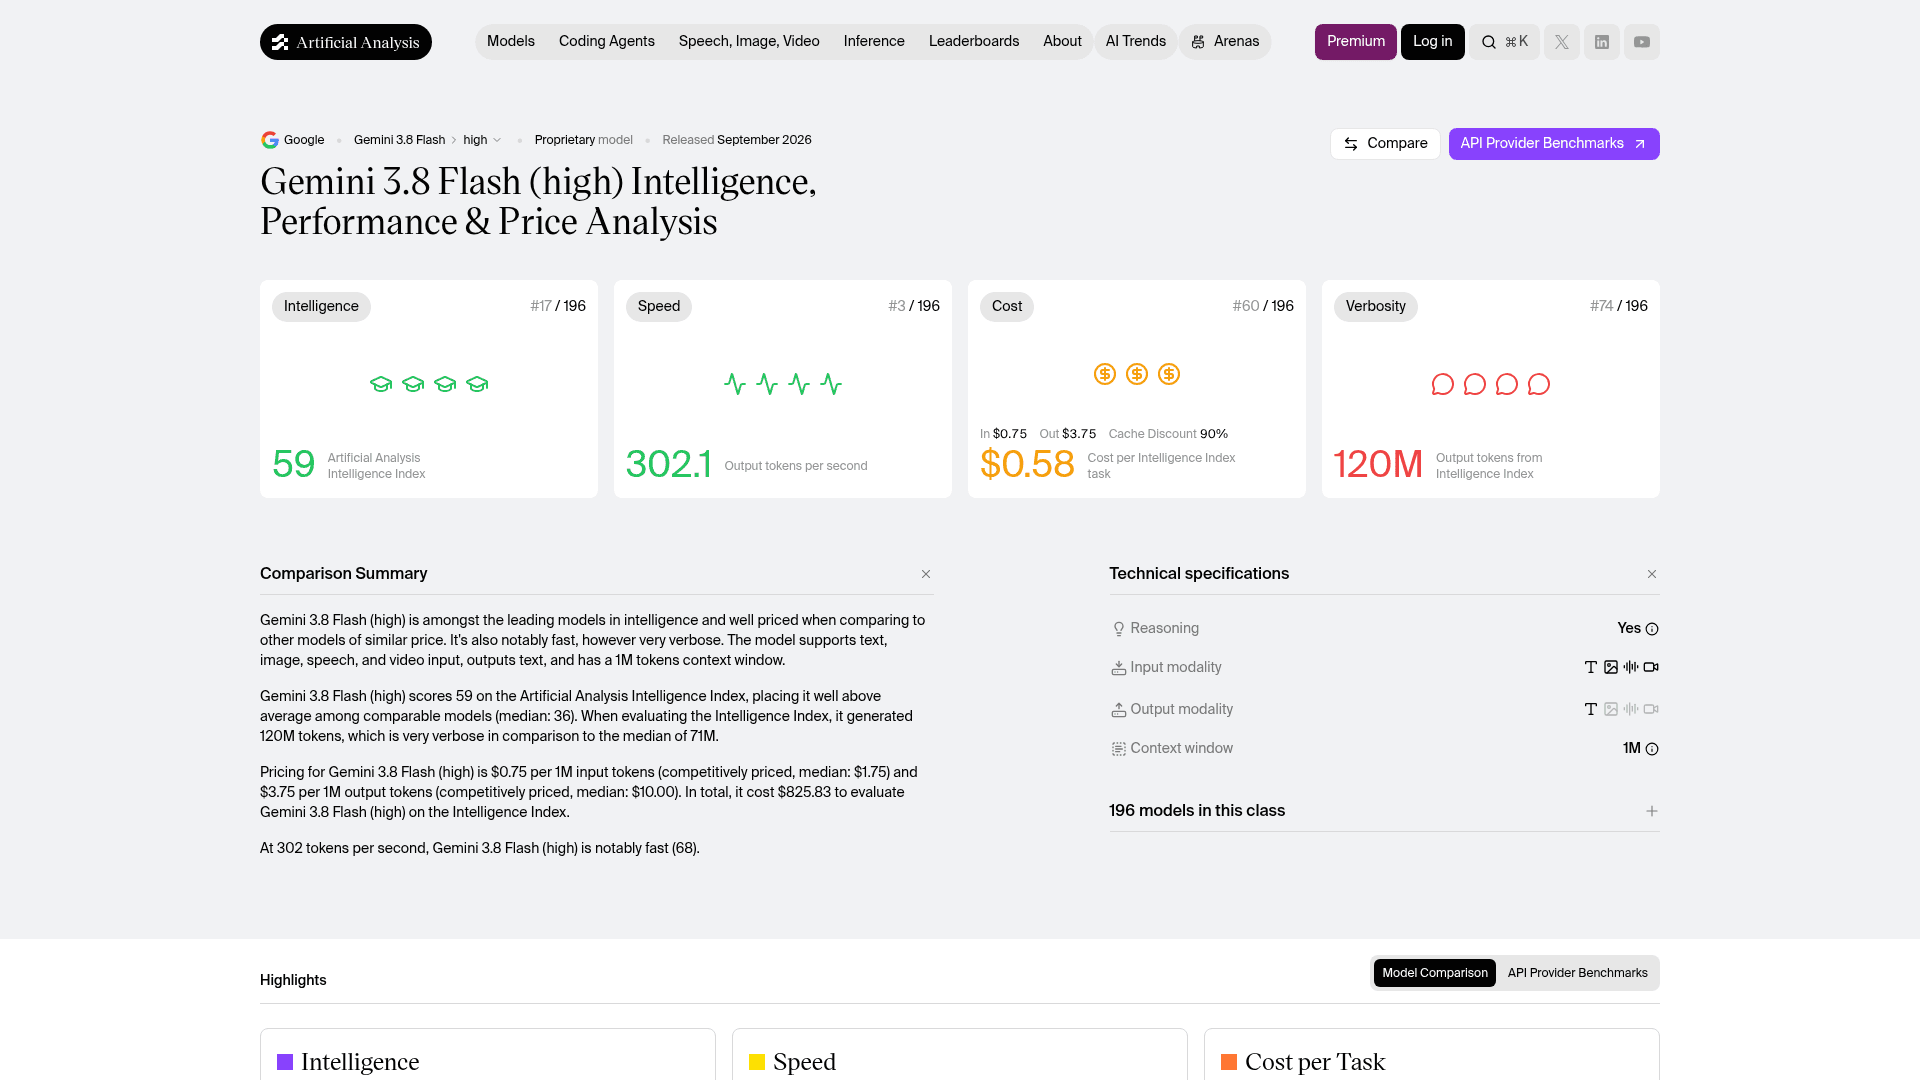
Intelligenz von 59, Rang 17 von 196, gegenüber einem Klassen-Median von 36. Kosten von 0,58 $ pro Index-Aufgabe, Rang 60. Geschwindigkeit von 302,1 Output-Token pro Sekunde, Rang 3. Und Verbosität von 120 Mio. Output-Token, um den Index abzuschließen, Rang 74, gegenüber einem Median von 71 Mio. Artificial Analysis nennt es in seiner eigenen Zusammenfassung "very verbose". Den gesamten Index damit durchzurechnen kostete 825,83 $.
Diese Verbositäts-Zahl ist die Preisgeschichte in einer einzigen Zahl.
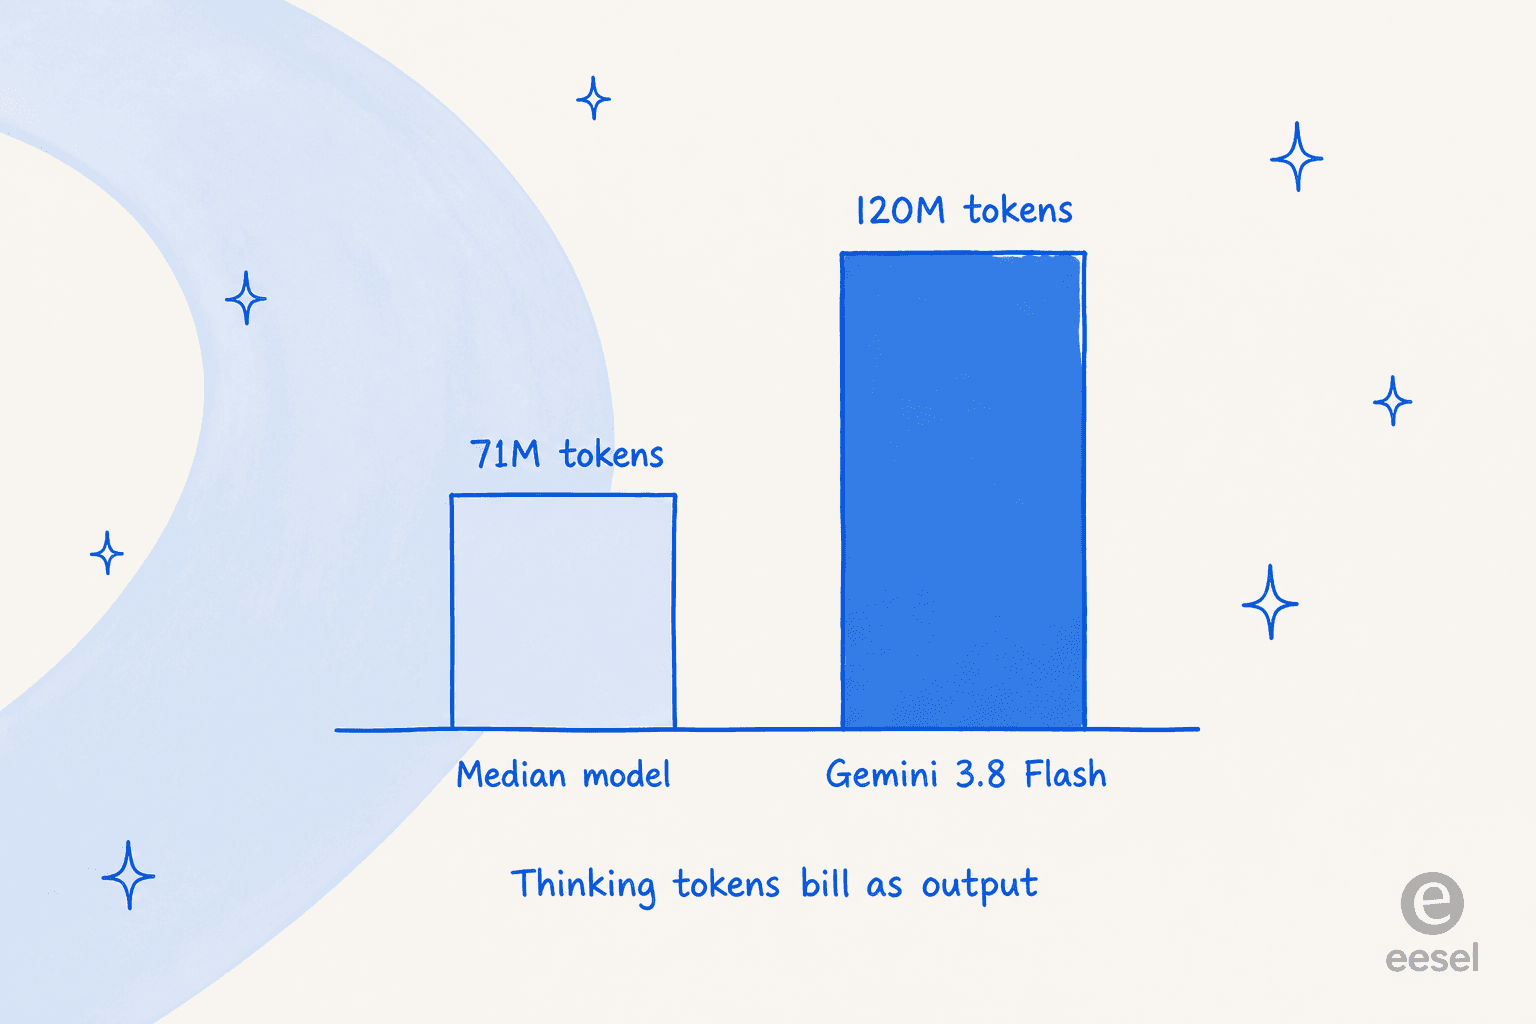
Ein Modell, das 70 % mehr Output-Token als der Median verbraucht, bei 3,75 $ pro Million, ist nicht so günstig, wie es die Preiskarte suggeriert. Das war die schärfste Korrektur im Hacker-News-Thread, der am Launch-Tag auf 775 Punkte kam:
"On artificial analysis it's only equal to opus 5 medium effort. Opus 5 max scores 63. Further, opus 5 medium outputs 4x fewer tokens to achieve the same result, negating a lot of the speed difference."

Dann gibt es die Zahl, die meiner Meinung nach fast jeder übersehen hat, und es ist die, die meine eigene Architekturentscheidung ändern würde.
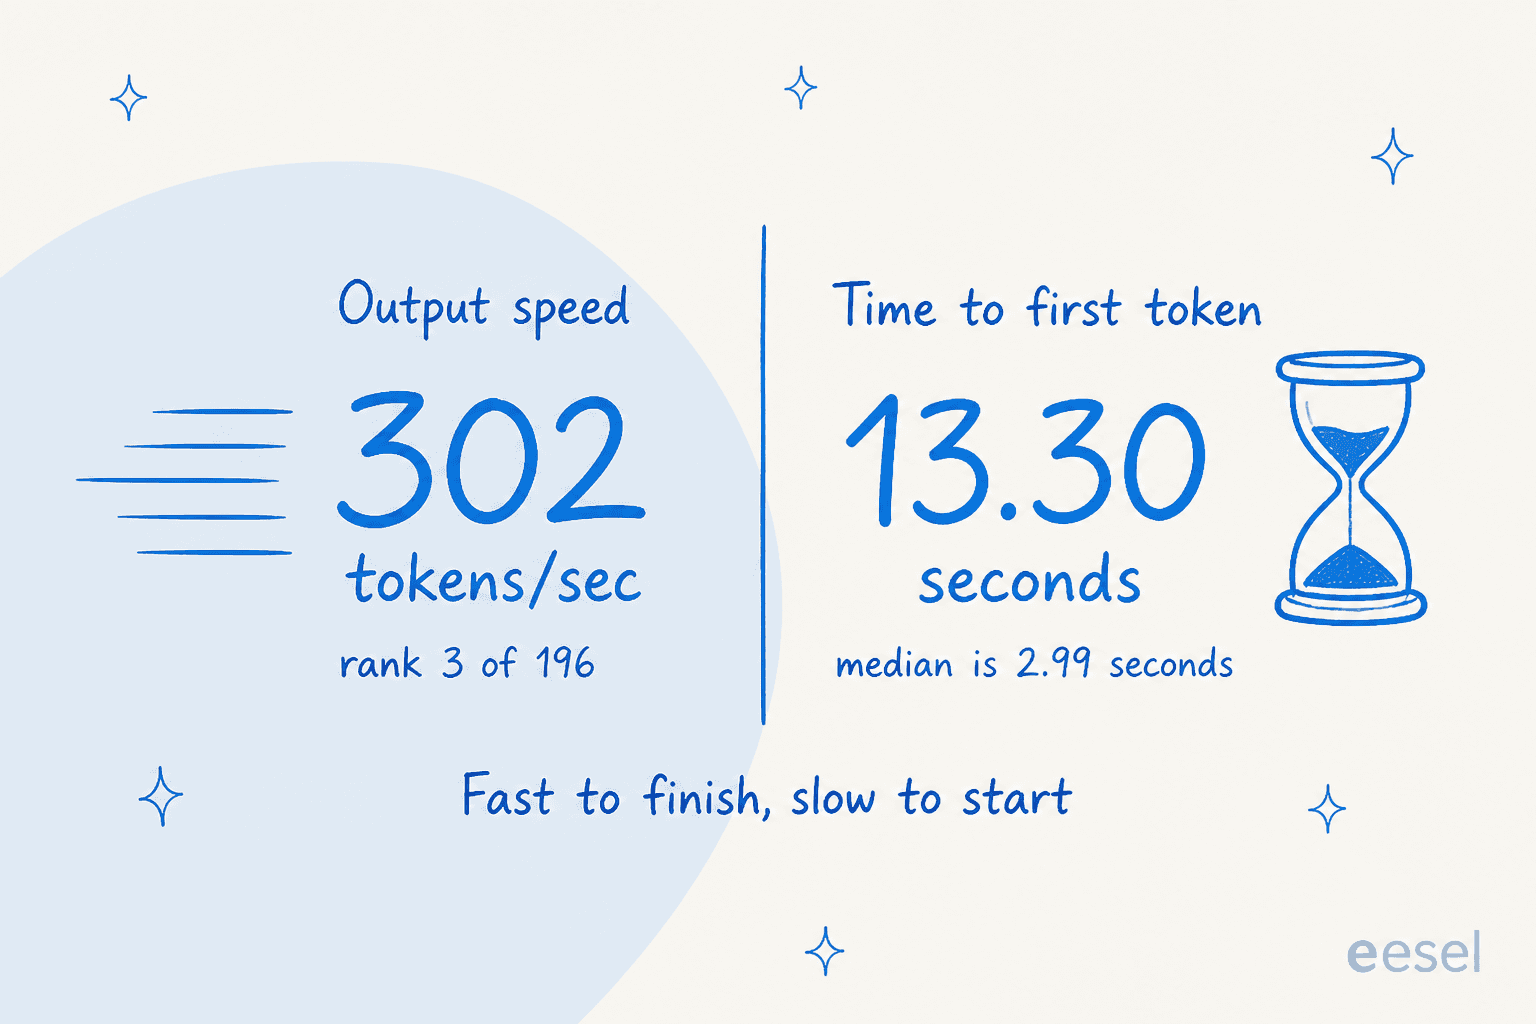
Artificial Analysis misst die Zeit bis zum ersten Token mit 13,30 Sekunden, gegenüber einem Klassen-Median von 2,99 Sekunden. Das drittschnellste Modell der Welt nach Durchsatz ist beim ersten Wort etwa viereinhalbmal langsamer als typisch, weil es zuerst nachdenkt.
Dieser Unterschied ist enorm wichtig und wird ständig plattgemacht. Durchsatz sagt aus, wie schnell ein langer Job fertig wird. Zeit bis zum ersten Token sagt aus, wie lange ein Mensch auf einen leeren Bildschirm starrt. Für einen Batch-Agenten, der über Nacht ein Repo durcharbeitet, gewinnt der Durchsatz, und TTFT ist irrelevant. Bei allem, worauf ein Mensch wartet – eine Support-Antwort oder ein Chat-Widget – sind diese 13 Sekunden die gesamte Nutzererfahrung.
Was Leute sagten, nachdem sie es tatsächlich ausprobiert hatten
Die Reaktionen am Launch-Tag gingen klar in zwei Richtungen, und die Trennlinie folgt genau dieser Durchsatz-gegen-Latenz-Kluft.
Googles eigener Developer Advocate rahmte den Token-Verbrauch als Feature statt als Kosten – die ehrlichste Version des Anbieter-Standpunkts:
"It takes smaller steps and verifies its work more often. This can leads to higher token usage but it uses those extra tokens effectively to run tests and verify changes, giving you much higher quality work overall, especially for more complex and long-running goals."
Bemerkenswert: Er arbeitet bei Google DeepMind, also sollte man das als Anbieter-Framing statt als unabhängigen Test behandeln. Sein Beitrag bekam 308 Likes und, zwei Antworten weiter unten, einen glatten Widerspruch von jemandem, der es an echter Arbeit ausprobiert hatte:
"Do not want to be negative, but it is absolutely not usable for SWE. Same very negative experience as it is with Gemini 3.7 Flash. Cost more than Fable on a really simple SWE tasks."
Die nützlichste Bewertung, die ich gefunden habe, kam von einem Entwickler, der einen langen Benchmark-Prompt durchlaufen ließ und noch am selben Abend eine übersichtliche Pro-und-Contra-Liste postete:
"This model takes its time to think and work through the tasks you have given it, at a really great price and speed. Plus - long thinking, not a airhead model anymore there is subsistence here. Cons - I want to be able to have a better chat with the model before it begins it work, can't test its own work, and cant run and view in its own browser in antigravity."
Für Chat statt Code fiel die Einschätzung positiver aus, und zwar genau bei dem, worin Flash-Modelle historisch schlecht waren:
"The context window remains the same at 1 million tokens, but its coding reasoning ability has improved significantly, and hallucinations have been greatly reduced, so the issues where it would hallucinate or make grammatical missteps have decreased a lot."
Auf Hacker News war die praktischste Workflow-Idee im Thread nicht der Ersatz von irgendetwas, sondern das Zusammenspiel:
"I've been using 3.7 Flash to audit the work of Opus High, and Flash finds lots of subtle and insidious defects even while all the unit tests are green. Then I tell Opus to read the audit report and implement what it agrees with. Flash is really good at this, and it is blazing fast in Antigravity CLI."
Die Skeptiker hatten einen konkreten, überprüfbaren Einwand statt eines Bauchgefühls. Ein Kommentator wies auf den Benchmark hin, den Google ausgelassen hat:
"There are important gaps in that hot take. For example, it's not even close to Opus 5 on Terminal-bench 4.0, 19.1% vs. 51.8%."
Und mehrere sprachen von Benchmark-Sättigung bei DeepSWE, was fair ist angesichts der Geschwindigkeit, mit der inzwischen jedes Labor die Spitze erreicht. Wie es einer formulierte, sei der Benchmark bereits "clearly been 'dealt with'". Mein eigener Rat ist derselbe wie der von zuzululu in diesem Thread: Führe dein eigenes Eval-Set, denn öffentliche Leaderboards trennen diese Modelle schon seit einiger Zeit nicht mehr sinnvoll.
Zwei Dinge in der Modellkarte, die niemand zitiert
Ich habe die Modellkarte gründlich gelesen, und zwei Details darin haben es in keine Berichterstattung geschafft, die ich gesehen habe.
Zwei Sicherheitsmetriken haben sich verschlechtert. Googles eigene Tabelle listet Multilingual Safety mit +5,4 Prozentpunkten, wobei niedriger besser ist, und Unjustified-refusals mit +1,1 Prozentpunkten, ebenfalls niedriger-ist-besser. Google sagt es klar, statt es zu verstecken: "Safety performance across non-English languages regressed slightly relative to 3.7 Flash." Wer nicht-englischsprachige Nutzer bedient, für den ist das eine echte Überlegung, und es ist genau die Art von Sache, die erst im Produktivbetrieb sichtbar wird.
Damit verbunden, und wissenswert: Google hat die vollständige Frontier-Safety-Bewertung für 3.8 Flash nicht erneut durchgeführt. Die Karte sagt, das Team habe 3.7 Flash bewertet und dann geschlossen, dass die 3.7-Ergebnisse übernommen werden, weil 3.8 Flash keine "meaningful new capabilities" habe. Angesichts der geteilten Basis nachvollziehbar, aber es ist Ableitung, keine Messung.
Die Vergleichstabelle hat eine falsch beschriftete Basislinie. Die Sicherheitstabelle trägt die Überschrift "Gemini 3.8 Flash vs. Gemini 3.7 Flash", aber Fußnote 1 besagt, dass die Tone-Zeile "compared to Gemini 3 Flash" gemessen wurde. Das ist ein anderes, älteres Modell in einer Spalte, die behauptet, ein 3.7-Vergleich zu sein. Ein Hacker-News-Leser hat es zuerst entdeckt und es "Chartcrime, the major AI lab tradition" genannt. Ich habe die aktuelle Karte geprüft, und die Fußnote steht immer noch so da.
Keines von beidem ist ein Skandal. Beides sind die Art von Details, die den Unterschied zwischen dem Lesen der Primärquelle und dem Umschreiben der Pressemitteilung ausmachen.
Gemini 3.8 Flash Cyber, der beeindruckendere Launch
Die Sicherheitsvariante bekam einen Bruchteil der Aufmerksamkeit und hat die stärkeren Zahlen.
Bei CyberGym, dem Standard-Benchmark für autonome Schwachstellenerkennung, sagt Google, dass 3.8 Flash Cyber sowohl 3.5 Flash Cyber als auch "significantly larger frontier models" übertrifft. Bei einem internen Benchmark über 20 Programmiersprachen erreicht es eine Erfolgsquote von über 70 %. Bei CWE-Bench, einem externen Patching-Benchmark von Collinear, erzielt es 47,2 % pass@1 gegenüber 47,8 % eines führenden Frontier-Modells, zu deutlich niedrigeren Kosten.
Die Einsatzzahlen sind besser als die Benchmarks. Googles Chrome-Security-Team stellte fest, dass es 2,6-mal mehr korrekte Patches für Chrome-Schwachstellen produzierte als die besten, deutlich größeren kommerziellen Modelle. Wiz maß +7,5 bis +9,7 % höhere Recall-Werte bei seinem internen Penetrationstest-Benchmark, bei 2,3- bis 5,2-fach niedrigeren Kosten. Und Googles Cloud Vulnerability Research Team nutzte es, um in unter zwei Stunden eine kritische Grundschwachstelle zu finden – Arbeit, die normalerweise Monate dauert, wie sie selbst sagen.
Der Haken ist der Zugang. Man kann es nicht kaufen. Es geht nur an vertrauenswürdige Verteidiger über das Fairwind Program – also Regierungsbehörden, Betreiber kritischer Infrastruktur und Software-Maintainer, die sich bewerben und genehmigt werden. Alle anderen bekommen das Standardmodell mit intakten CBRN- und Cyber-Offense-Schutzmaßnahmen.
Solltest du also wirklich wechseln?
Da der Preis identisch ist, ist das reine eine Frage der Workload-Form.
Wechsle zu 3.8 Flash, wenn du langfristige agentische Coding-Aufgaben, mehrstufige Recherche oder dokumentenintensive Arbeit fährst, bei der Qualität wichtiger ist als Token-Zahl. Glean's KI-Produktleiter berichtete, es habe "completing more than three times as many tasks as Gemini 3.7 Flash" bei langlaufenden Dokument-Workflows in ihren Auswertungen erreicht. Es ist inzwischen der Standard in Antigravity, also nutzt du es vielleicht schon.
Bleib bei 3.7 Flash, wenn dein Workload hochvolumig, kurzkontextig oder latenzsensibel ist. Google sagt das selbst. Die Verbositätslücke bedeutet, dass 3.8 trotz identischem Satz pro abgeschlossener Aufgabe mehr kosten kann, und die 13,30 Sekunden TTFT sind für alles Interaktive ein Ausschlusskriterium.
Erwäge keines von beiden, wenn du ein Modell für ein Produktfeature auswählst statt zum Coden. Das ist es wert, ausgesprochen zu werden, und es ist dieselbe Schlussfolgerung, zu der ich beim Schreiben über die besten KI-Agenten und KI-Agenten für kleine Unternehmen gekommen bin: Das Modell entscheidet selten über das Ergebnis.
Was das bedeutet, wenn du KI in einer Support-Warteschlange einsetzen willst
Hier will ich direkt sein, denn es ist der Fehler, den ich am häufigsten sehe.
Teams, die KI für den Kundensupport bewerten, verbringen Wochen mit dem Vergleich von Modell-Benchmarks und liefern dann trotzdem etwas aus, das selbstbewusst falsche Antworten gibt. Ein Support-Team, mit dem ich gearbeitet habe, traf genau das. Ihr Bot sagte Kunden "yes, we support your car model" für Fahrzeugmarken, die gar nicht in ihrer Datenbank waren, weil ihre Wissensdatenbank sagte "we support all models". Kein Benchmark-Wert behebt das. Es war nie ein Modellversagen. Es war ein Retrieval- und Scoping-Versagen, und ein klügeres Modell hätte die falsche Antwort nur flüssiger formuliert.
Das Muster wiederholt sich. Ein Kunde formulierte die Anforderung so klar wie kaum jemand:
"The AI will never be able to answer 100% of the questions. I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
a DTC supplements CX lead, eesel customer research
Das ist eine Produktanforderung, keine Modellanforderung. Confidence-Gating, Eskalationsregeln, begrenzte Themenabdeckung und ein Testlauf gegen bereits beantwortete Tickets entscheiden, ob KI-Support funktioniert. Nichts davon taucht in einem Leaderboard auf. Wer die längere Version will: Ich habe separat aufgeschrieben, warum KI-Chatbots falsch antworten.
Die vorgelagerte Arbeit zählt genauso viel. Ticket-Klassifizierung und Support-Tagging richtig hinzubekommen, ist das, was einem Bot sagt, welche Tickets er nicht anfassen sollte, und eine gut gepflegte Wissensdatenbank ist das, was ihn davon abhält, überhaupt erst eine Antwort zu erfinden.
Die Build-versus-Buy-Version davon kommt ebenfalls ständig auf:
"We could try to write our own LLM application but we didn't want to invest our time into that. We wanted something that we would not have to maintain."
Karel, GENERAL BYTES
Modelle wie 3.8 Flash sind Infrastruktur. Sie sind der Motor, nicht der Mitarbeiter. Eines in einen Helpdesk einzubauen bedeutet, Retrieval über deine Dokumente und vergangenen Tickets aufzubauen, Tool-Aufrufe in dein Ticketing-System, Confidence-Schwellenwerte, Eskalationspfade und einen Weg, das alles zu testen, bevor es ein Kunde sieht. Das ist das eigentliche Projekt, und es ist dasselbe Projekt, egal ob das Modell darunter Gemini, Claude oder ein OpenAI-Modell ist.
eesel ausprobieren
Wenn du eigentlich willst, dass KI Tickets beantwortet, statt selbst ein Modell zu verdrahten, ist eesel der Ort, an dem ich anfangen würde. eesel verkauft einsatzbereite KI-Teammitglieder statt roher Infrastruktur, und der KI-Helpdesk-Mitarbeiter reiht sich in wenigen Minuten in deine bestehende Warteschlange in Zendesk, Freshdesk oder Gorgias ein, trainiert auf deinem Help Center und deinen vergangenen Tickets.

Der Unterschied ist der Teil, den Modell-Benchmarks dir nicht geben können. Jedes eesel-Rollout wird zuerst gegen deine echten historischen Tickets simuliert, sodass du siehst, was die KI Kunden, die du schon bedient hast, gesagt hätte, bevor sie irgendetwas zu einem echten Kunden sagt. Das ist der Check, der den "we support all models"-Fehler abfängt, und er existiert, weil eesel seit Jahren beobachtet, wie selbstbewusste Bots auf echten Warteschlangen Fehler machen. Es ist kostenlos zu testen, und das KI-Blog-Schreiber-Teammitglied läuft auf derselben Plattform, falls Content dein Flaschenhals ist statt Support.
Für mehr zu den umliegenden Entscheidungen deckt mein KI-Helpdesk-Software-Überblick den Markt ab, und Ticket-Automatisierung deckt die darunterliegende Workflow-Ebene ab.
Auf der Kostenseite hat KI-Support-Kosteneinsparungen die Rechnung, und Agent-versus-Mensch-Kosten ist der Vergleich, den Finanzteams tatsächlich nachfragen.
Und wenn du noch beim Modell-Shopping statt beim Produkt-Shopping bist: Gemini-Alternativen und Top-KI-Agenten sind die beiden nützlichsten Startpunkte.
Häufig gestellte Fragen
Was ist Gemini 3.8 Flash?
gemini-3.8-flash. Es verarbeitet Text-, Bild-, Audio-, Video- und PDF-Eingaben mit einem 1-Mio.-Token-Kontextfenster und 64K Output und ist auf langfristige Coding-Aufgaben und autonome Agenten ausgelegt. Googles eigene Modellkarte gibt an, dass es auf Gemini 3.7 Flash aufbaut statt auf einem neuen Basismodell. Wer es mit dem breiteren Feld vergleichen will, findet in meiner Übersicht zu Gemini-Alternativen den Rest.Wie viel kostet Gemini 3.8 Flash?
Ist Gemini 3.8 Flash besser als Gemini 3.7 Flash?
Ist Gemini 3.8 Flash besser als Claude Opus 5?
Was ist Gemini 3.8 Flash Cyber und kann ich es nutzen?
Ist Gemini 3.8 Flash gut für den Kundensupport?
Wo kann ich Gemini 3.8 Flash kostenlos testen?


Article by
Alicia Kirana Utomo
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.