Gemini 3.8 Flash Preise im Überblick
Hier sind alle veröffentlichten Preise für gemini-3.8-flash auf der Gemini API, bezahlte Standard-Stufe, pro 1 Million Token. Ich habe die Spalte für 2027 direkt neben die heutige gesetzt, damit die Promo nicht zu übersehen ist.
| Kennzahl | Bis 31. Dez. 2026 | Ab 1. Jan. 2027 |
|---|---|---|
| Input | $0.75 | $1.50 |
| Output (inkl. Denk-Token) | $3.75 | $7.50 |
| Context-Cache, Lesen | $0.075 | $0.15 |
| Context-Cache, Speicherung (pro 1 Mio./Std.) | $0.50 | $1.00 |
| Batch und Flex, Input | $0.375 | $0.75 |
| Batch und Flex, Output | $1.875 | $3.75 |
| Priority, Input | $1.35 | $2.70 |
| Priority, Output | $6.75 | $13.50 |
Ein paar Dinge, die man leicht übersieht, wenn man Googles Seite von oben nach unten liest:
- Der Output-Preis umfasst Denk-Token. Du zahlst den 3,75-$-Satz für das Nachdenken des Modells, auch wenn die API dir nur eine Zusammenfassung davon zurückgibt. Bei einem Modell, das auf mehr Nachdenken ausgelegt ist, ist das die Zeile, die deine Rechnung nach oben treibt.
- Batch und Flex kosten genau die Hälfte. Wenn deine Arbeit nicht interaktiv ist, halbiert ein nächtlicher Batch-Job jeden Token, den du ausgibst.
- Grounding wird separat abgerechnet. Google Search als Tool gibt dir 5.000 kostenlose Anfragen pro Monat, geteilt über alle Gemini-3.x-Modelle, die du nutzt, danach 14 $ pro 1.000. Google Maps Grounding nutzt das gleiche Kontingent.
- Es gibt eine echte kostenlose Stufe. Input, Output und Caching sind bei Standardnutzung kostenlos, was reicht, um zu prototypisieren, bevor du überhaupt etwas ausgibst.
Probiere die Zahlen an deinem eigenen Workload aus
Der Schlagzeilen-Preis sagt nur begrenzt viel aus. Entscheidend sind dein monatliches Volumen, dein Input-zu-Output-Verhältnis und die Stufe, auf der du läufst. Gib unten deine eigenen Zahlen ein, um die monatlichen Kosten heute mit den Kosten nach der Preiserhöhung im Januar 2027 zu vergleichen.
Die versteckten Kosten: 3.8 Flash ist absichtlich geschwätzig
Die Zahl, die die Kaufentscheidung verändert, steht nicht auf der Preisseite. Sie steckt darin, wie viele Token das Modell für eine Aufgabe verbraucht.
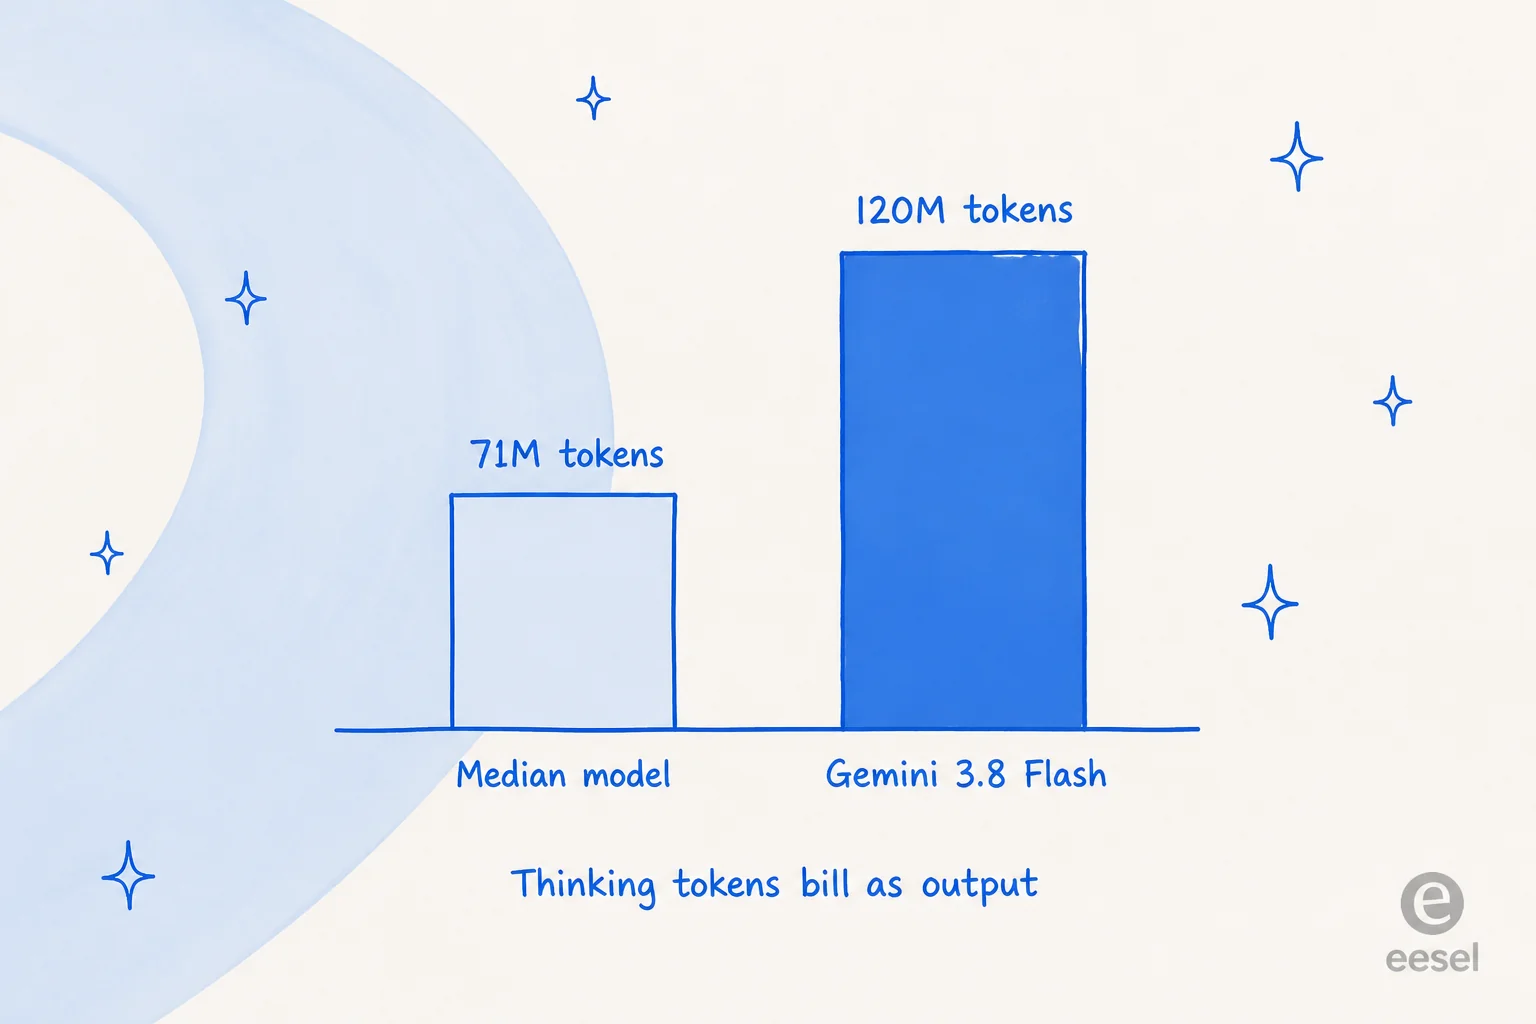
Google benennt diesen Trade-off offen im Launch-Post: 3.8 Flash „arbeitet härter", führt zusätzliche Denkschritte aus und ruft Tools iterativ auf, und „manchmal nutzt das Modell mehr Token, um die Leistung zu maximieren." Das ist ein Feature für die Qualität und ein Kostenpunkt auf deiner Rechnung, weil Denk-Token zum Output-Preis von 3,75 $ abgerechnet werden.
Die unabhängige Messung bestätigt das. Artificial Analysis brauchte 120 Millionen Output-Token, um seinen gesamten Intelligence Index gegen 3.8 Flash laufen zu lassen, gegenüber einem Median von 71 Millionen für die Modellklasse. AAs eigenes Ein-Wort-Urteil lautete „very verbose" (sehr geschwätzig).
Auf Hacker News brachte ein Kommentator eine schärfere Zahl ins Spiel, als es das Marketing tat:
"On artificial analysis it's only equal to opus 5 medium effort. Opus 5 max scores 63. Further, opus 5 medium outputs 4x fewer tokens to achieve the same result, negating a lot of the speed difference."

Die tatsächlichen Kosten pro Arbeitseinheit sind also höher, als 3,75 $ pro 1 Million vermuten lassen, weil 3.8 Flash mehr Einheiten pro Aufgabe verbraucht. Artificial Analysis setzte die Mischkosten in seinem Index auf 0,58 $ pro Aufgabe an, was das Modell bei der Kosteneffizienz auf Platz 59 von 195 landen lässt, nicht in der Nähe der Spitze, wie es der reine Token-Preis vermuten ließe. Wenn du das bei deinem eigenen Traffic im Blick behalten willst, genau dafür gibt es LLM-Tracking-Tools.
Gleicher Preis wie 3.7 Flash, welches kaufst du also?
Das ist die eigentliche Entscheidung, und Google beantwortet sie für dich. Da 3.8 und 3.7 Flash bis auf den Cent gleich viel kosten, kann der Preis den Ausschlag nicht geben. Googles eigene Empfehlung tut das: Für Workloads, „bei denen Compute-Effizienz die primäre Einschränkung ist", sollten Entwickler „weiterhin auf Gemini 3.7 Flash setzen, das für effizienzorientierte Workloads vollständig unterstützt bleibt."
Ganz konkret:
- Lange agentische Coding-Aufgaben, Qualität vor Kosten: 3.8 Flash. Es schlägt 3.7 in jedem von Google veröffentlichten Benchmark, und der Wechsel kostet nichts extra. Wenn du dich in der breiteren Kategorie umschaust, findest du in meinem Überblick zu KI-Coding-Assistenten das gesamte Feld.
- Hohes Volumen, latenzkritisch, Kosten zuerst: Bleib bei 3.7 Flash. Es verbraucht bei gleichem Preis weniger Token, und ein Google-Mitarbeiter hat im Launch-Thread bestätigt, dass der höhere Token-Verbrauch von 3.8 gewolltes Verhalten ist, kein Bug.
Es gibt auch eine Latenz-Falle. 3.8 Flash liegt bei der reinen Output-Geschwindigkeit auf Platz 3 von 195, aber seine Time to First Token beträgt 13,30 Sekunden gegenüber einem Median von 2,99 Sekunden. Bei allem, worauf ein Mensch wartet, ist das „schnelle" Modell dasjenige, das am langsamsten mit dem Antworten beginnt. Das ist Durchsatz, nicht Reaktionsfähigkeit, und aus der Geschwindigkeits-Schlagzeile lässt sich das leicht missverstehen.
Wie der Preis im Vergleich zu anderen Frontier-Modellen abschneidet
Wenn du vergleichst, hier siehst du, wo Gemini 3.8 Flash preislich im Vergleich zu den Modellen steht, mit denen es tatsächlich konkurriert, pro 1 Million Token, Standard-Stufe, heute.
| Modell | Input | Output | Hinweis |
|---|---|---|---|
| Gemini 3.8 Flash | $0.75 | $3.75 | Verdoppelt sich Jan. 2027 |
| Gemini 3.7 Flash | $0.75 | $3.75 | Identisch, weniger Token pro Aufgabe |
| Claude Opus 5 | ~$5.00 | ~$25.00 | 4-mal weniger Output-Token pro Aufgabe |
| Claude Sonnet 5 | niedriger als Opus | niedriger als Opus | Günstigere Claude-Stufe |
Die ehrliche Einordnung aus demselben HN-Thread: Ein Entwickler merkte an, dass Gemini Flash, neben ein paar anderen günstigen Modellen, „90 % der Leistung für einen kleinen Bruchteil der Kosten" der Frontier-Stufe liefert. Das ist das eigentliche Verkaufsargument, und es ist ein faires. Denk nur daran, dass der Bruchteil am rohen Preis gemessen wird, bevor du die Verbositäts-Steuer und die Januar-Erhöhung dazurechnest. Mein Überblick zu Gemini-Alternativen deckt den Rest des Feldes ab, und wenn du Google gegen OpenAI abwägst, ist der Vergleich ChatGPT vs. Gemini der richtige Startpunkt, mit der vollständigen OpenAI-Modellliste für die andere Seite davon.
Wo du es tatsächlich nutzen kannst
- Kostenlose Stufe: Input, Output und Caching kostenlos über Google AI Studio. Reicht zum Prototypisieren.
- Standard in Antigravity: 3.8 Flash ist das Standardmodell in Google Antigravity, mit großzügigen Kontingenten, was mehrere Entwickler auf HN als den günstigsten Weg bezeichneten, es echter Arbeit zu unterziehen.
- Consumer-Apps: die Gemini-App, AI Mode in der Suche und Gemini in Sheets, aber nur mit Google AI Pro oder Ultra. Wenn du dich zwischen diesen entscheidest, sieh dir die Google AI Pläne an.
- Wie man es an- oder ausschaltet: Wenn du den Gemini-Zugriff in einem Workspace verwaltest, hier ist, wie man Gemini aktiviert und deaktiviert.
Was das für dich bedeutet, wenn du einen Support-Bot kalkulierst
Ich verbringe den größten Teil meiner Zeit damit, darüber nachzudenken, wie Käufer nach KI für den Helpdesk suchen und sie kalkulieren – hier also der Teil, der zählt, wenn du eine Modell-Preisseite liest, um Kundensupport zu automatisieren.
Ein Token-Preis von 0,75 $ wirkt neben einem Helpdesk-Add-on mit Preis pro Lösung unwiderstehlich. Aber drei Dinge zerstören diesen Vergleich. Ein Support-Modell beantwortet kurze, hochvolumige Tickets, bei denen die Time-to-First-Token von 13,30 Sekunden bei jeder Antwort spürbar ist. Die Geschwätzigkeit, die 3.8 Flash bei langen Coding-Aufgaben gut macht, ist die falsche Form für Ticket-Deflection, und sie wird zum Output-Preis abgerechnet. Und der Token-Preis ist nur ein kleiner Teil der tatsächlichen Kosten für den Betrieb von Support-Automatisierung, die von der Retrieval- und Testing-Arbeit rund um das Modell dominiert wird, nicht vom Modellaufruf selbst.
Ich beobachte seit über drei Jahren, wie KI-Agenten auf echten Support-Warteschlangen laufen, und das Muster ist immer gleich: Ein selbstsicher wirkendes Modell kann still und heimlich falsche Antworten geben, und kein Preis pro Token behebt das. Deshalb wird jedes eesel-Rollout gegen deine echten, vergangenen Tickets simuliert, bevor es je einem Kunden antwortet, damit du die Lösungsrate und die Kosten pro Ticket vorab siehst, statt beides erst auf der Rechnung zu entdecken.
Wenn du selbst ein Modell für den Aufbau von Support-Automatisierung auswählst, kalkuliere es ehrlich mit eingerechneter Verbositäts-Steuer und dem Preis von 2027. Wenn du lieber gar kein Modell selbst an deinen Helpdesk verdrahten willst: eesel bietet ein KI-Helpdesk-Teammitglied, das sich in deine bestehenden Tools einklinkt, aus deinen vergangenen Tickets lernt und kostenlos zum Testen ist, ganz ohne Token-Rechnerei. Das ist der Unterschied zwischen dem Kauf eines Motors und der Anstellung von jemandem, der schon fahren kann.
Häufig gestellte Fragen
Wie viel kostet Gemini 3.8 Flash?
Sind die Preise von Gemini 3.8 Flash identisch mit 3.7 Flash?
Warum verdoppelt sich der Preis von Gemini 3.8 Flash im Januar 2027?
Wie hoch sind die Batch- und Priority-Preise für Gemini 3.8 Flash?
Ist Gemini 3.8 Flash günstiger als Claude Opus 5?
Gibt es eine kostenlose Stufe für Gemini 3.8 Flash?
Sind die Preise von Gemini 3.8 Flash gut für den Kundensupport?


Article by
Kurnia Kharisma Agung Samiadjie
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.