

Was ist Mistral Large 4?
Ich baue bei eesel beruflich AI-Agents, also landet jeder Frontier-Launch auf meinem Schreibtisch, mit derselben Frage: Sollten die Agents von eesel darauf laufen? Bei Mistral Large 4 lautet die ehrliche Antwort "noch nicht, aber beobachten", und die Gründe sind interessanter als das, was die Benchmark-Grafik nahelegt.
Mistral nennt es sein "largest and most capable model to date". Laut Launch-Beitrag wurde es auf 3.800 NVIDIA Grace Blackwell GPUs in Mistrals eigenen europäischen Rechenzentren trainiert und ist zugleich der erste Meilenstein auf der Roadmap, die Mistrals Series D über €3 Milliarden finanziert. Wenn du eine Auffrischung zum Unternehmen selbst brauchst, behandelt meine Mistral-AI-Übersicht die Geschichte, und die Sammlung der Mistral-AI-Bewertungen zeigt, was Nutzer von den älteren Modellen halten.
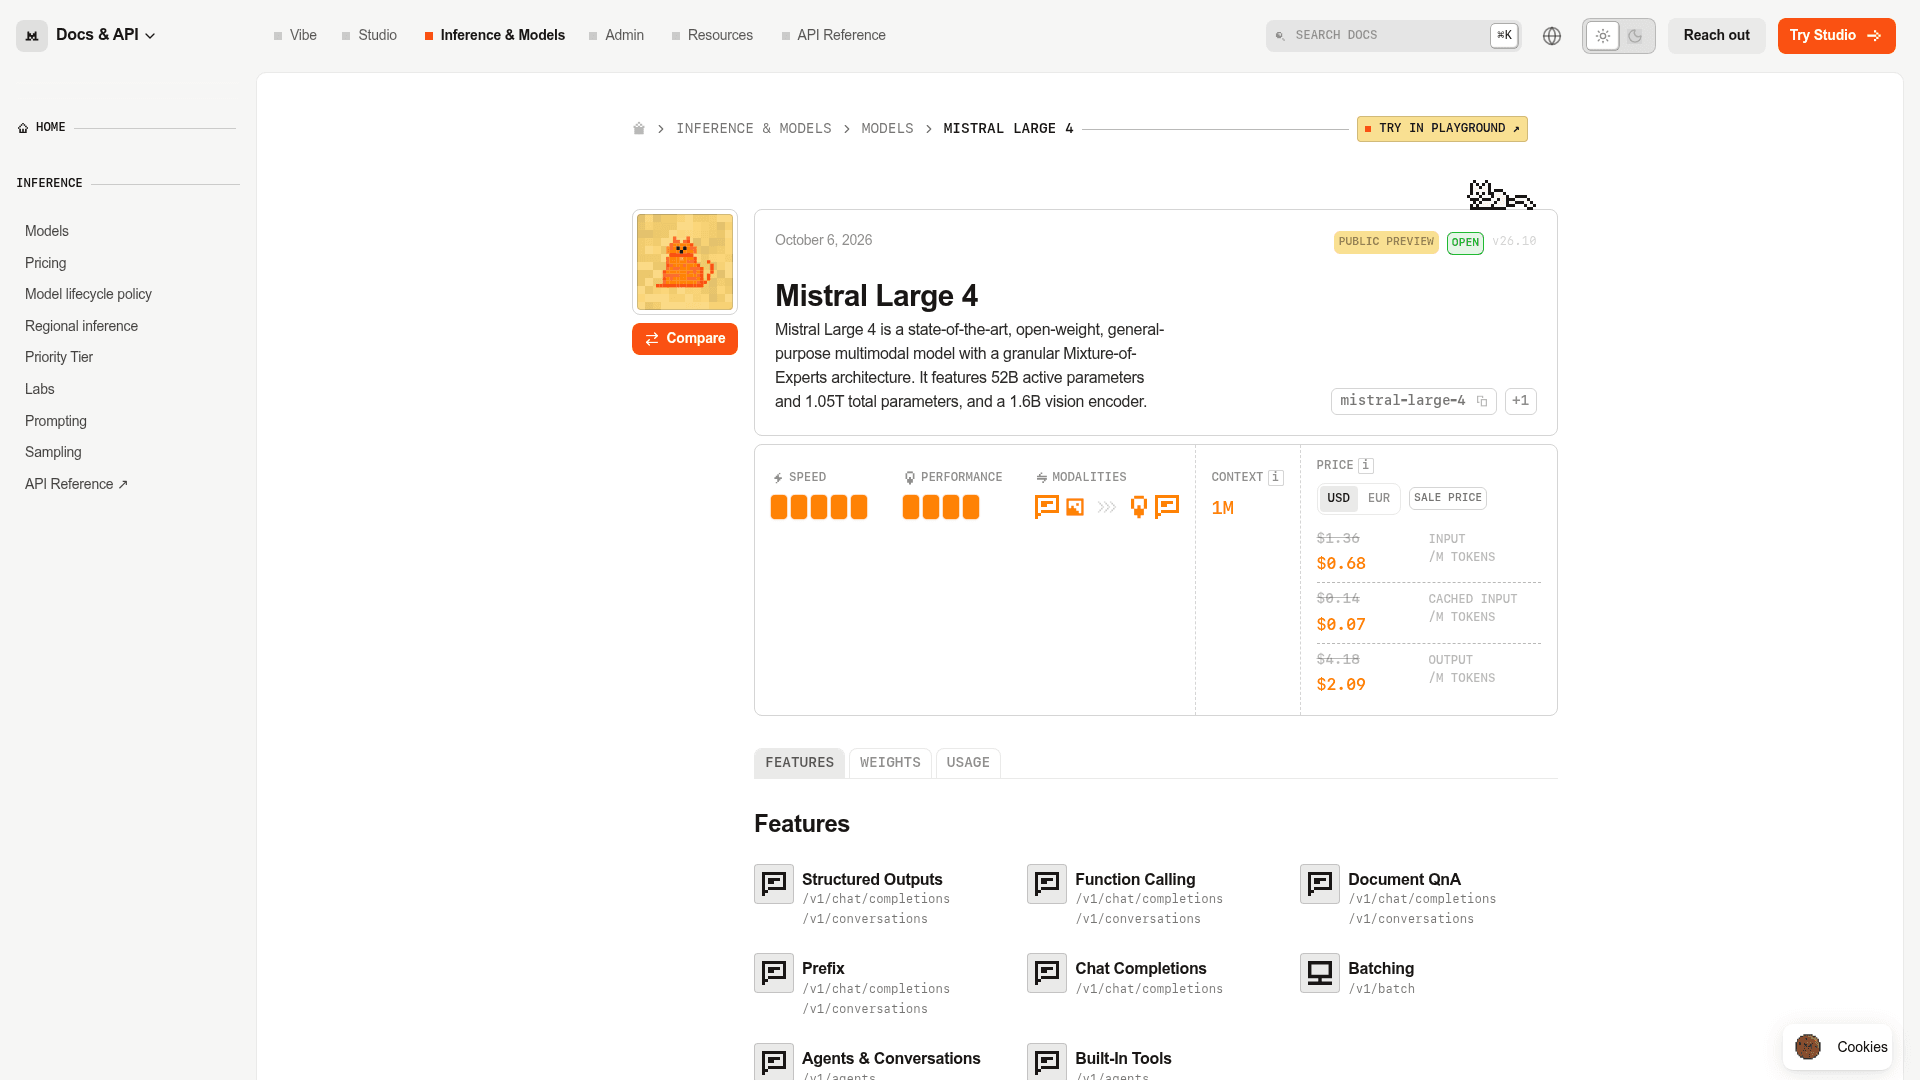
Hier die wichtigsten Spezifikationen, direkt von der Modellkarte in den Docs:
| Spezifikation | Mistral Large 4 |
|---|---|
| Release | 6. Oktober 2026, öffentliche Preview (v26.10) |
| Architektur | Granulares Mixture-of-Experts, hybrid aus Instruct und Reasoning |
| Parameter | 1,05T gesamt, 52B aktiv, plus 1,6B Vision-Encoder |
| Kontextfenster | 1M Tokens |
| Eingabe | Text und Bilder |
| API-Modell-ID | mistral-large-4 |
| Funktionen | Function Calling, strukturierte Ausgaben, Document QnA, Batching, Agents API, integrierte Tools |
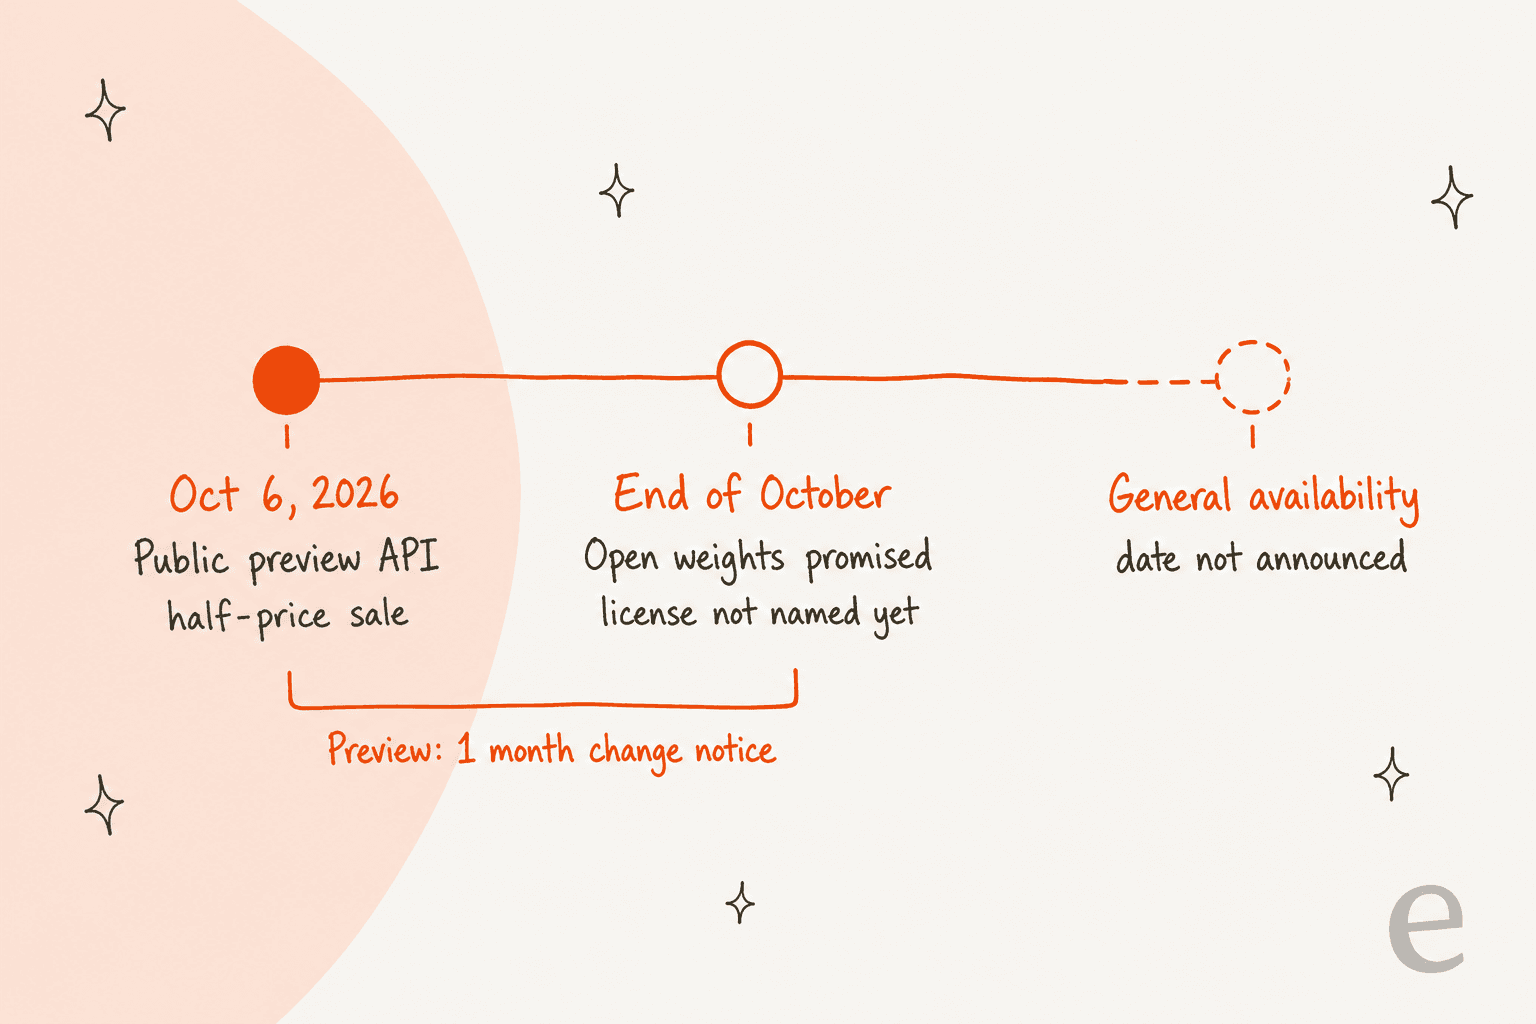
| Gewichte | Bis Ende Oktober 2026 versprochen, Lizenz noch nicht genannt |
| Trainingssprachen | 160+, darunter jede offizielle EU-Sprache |
Bei den Zahlen gibt es einen kleinen Haken: Die Karte in den Docs nennt 52B aktive Parameter, Mistrals eigener Launch-Beitrag auf X dagegen 49B. Artificial Analysis führt das Kontextfenster außerdem mit 524.288 Tokens, die Hälfte der 1M auf der Karte. Ich würde also mit der kleineren Zahl planen, bis Mistral das klärt.
Wie Mistral Large 4 unter der Haube funktioniert
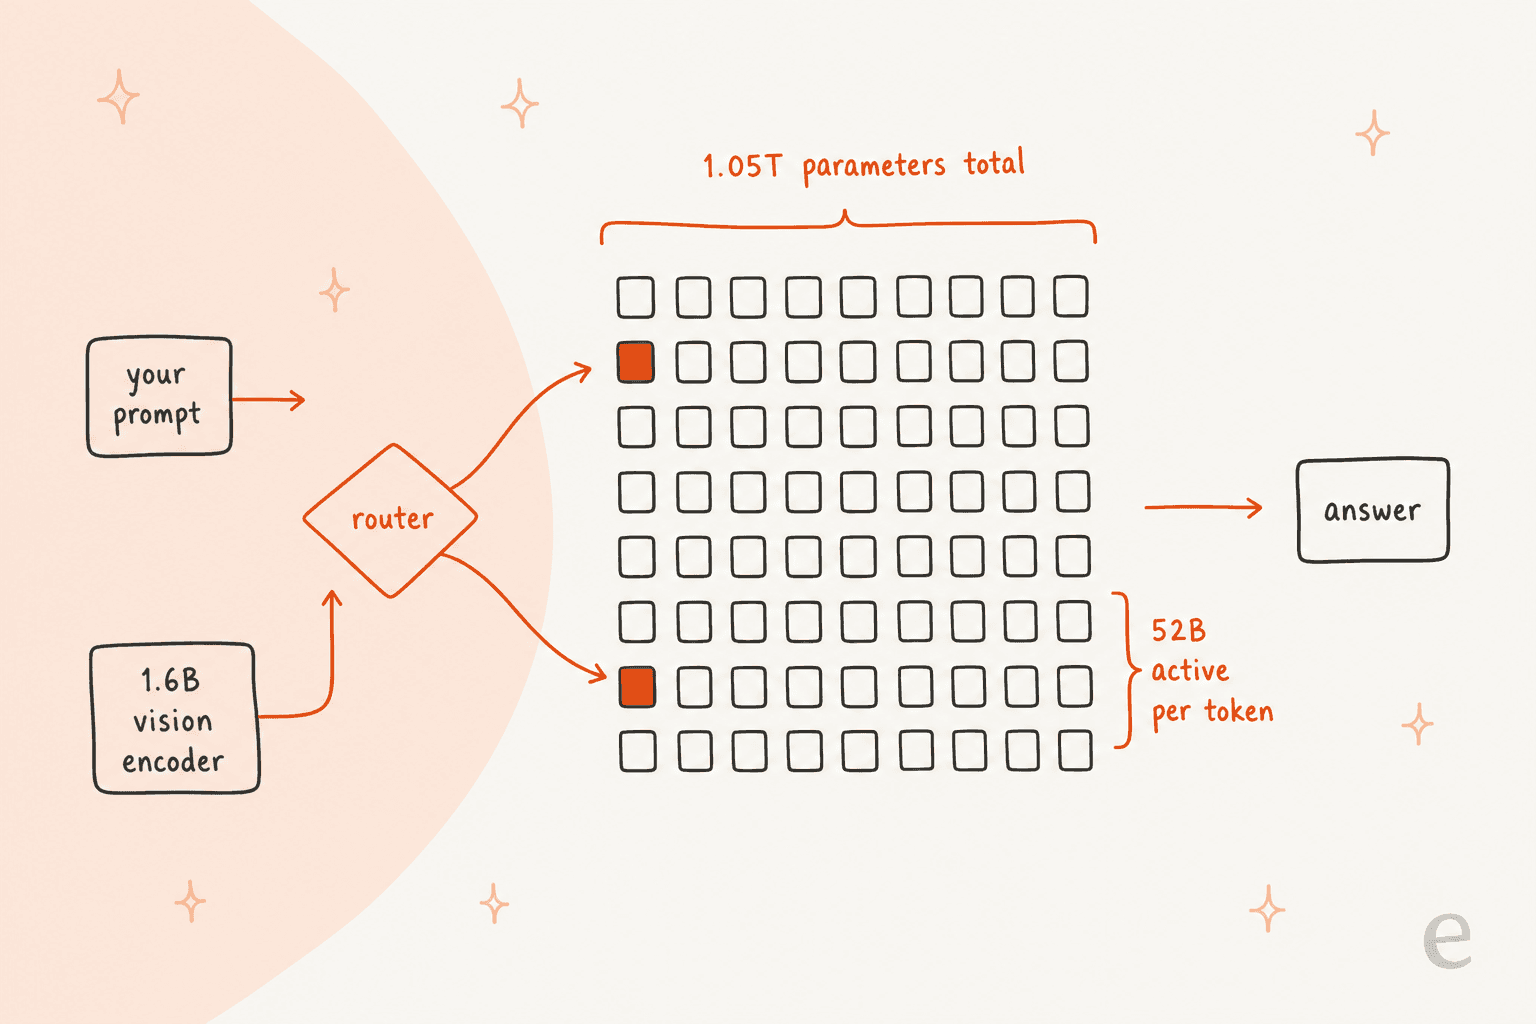
Die Schlagzeilenzahl, 1,05T Parameter, ist für sich allein ein bisschen irreführend. Mistral Large 4 ist ein Mixture-of-Experts-Modell: Ein Router wählt für jedes Token einen kleinen Teil des Netzes aus, sodass nur etwa 5% der Gewichte (52B) bei einem Token tatsächlich arbeiten. Deshalb kann das Modell riesig und trotzdem ziemlich schnell sein. Artificial Analysis maß 116,1 Output-Tokens pro Sekunde auf Mistrals API, deutlich über dem Median von 77,0 für Reasoning-Modelle in ähnlicher Preisklasse.
Es ist außerdem ein Hybridmodell: Du kannst es als reines Instruct-Modell nutzen oder Reasoning mit dem Parameter reasoning_effort aktivieren, wie im Docs-Beispiel gezeigt. Beim Reasoning verstecken sich Kosten und Latenz (jeder Denkschritt wird als Output-Tokens abgerechnet). Darauf komme ich später zurück, denn es ist das Wichtigste, was man verstehen sollte, bevor man es vor Kunden einsetzt.
Die andere Designentscheidung, die ich für wissenswert halte: Mistral hat es auf eigener Infrastruktur trainiert und betreibt die Preview am selben Ort, einschließlich "a European deployment that Mistral operates end-to-end". Für Teams, die unter EU-Datenrecht arbeiten, ist das wichtiger als jeder Benchmark. Es spielt auch bei Prüfungen zu SOC 2 und DSGVO eine Rolle, wo eine der ersten Fragen meist lautet, wo genau das Modell läuft.
Mistral Large 4 Preise
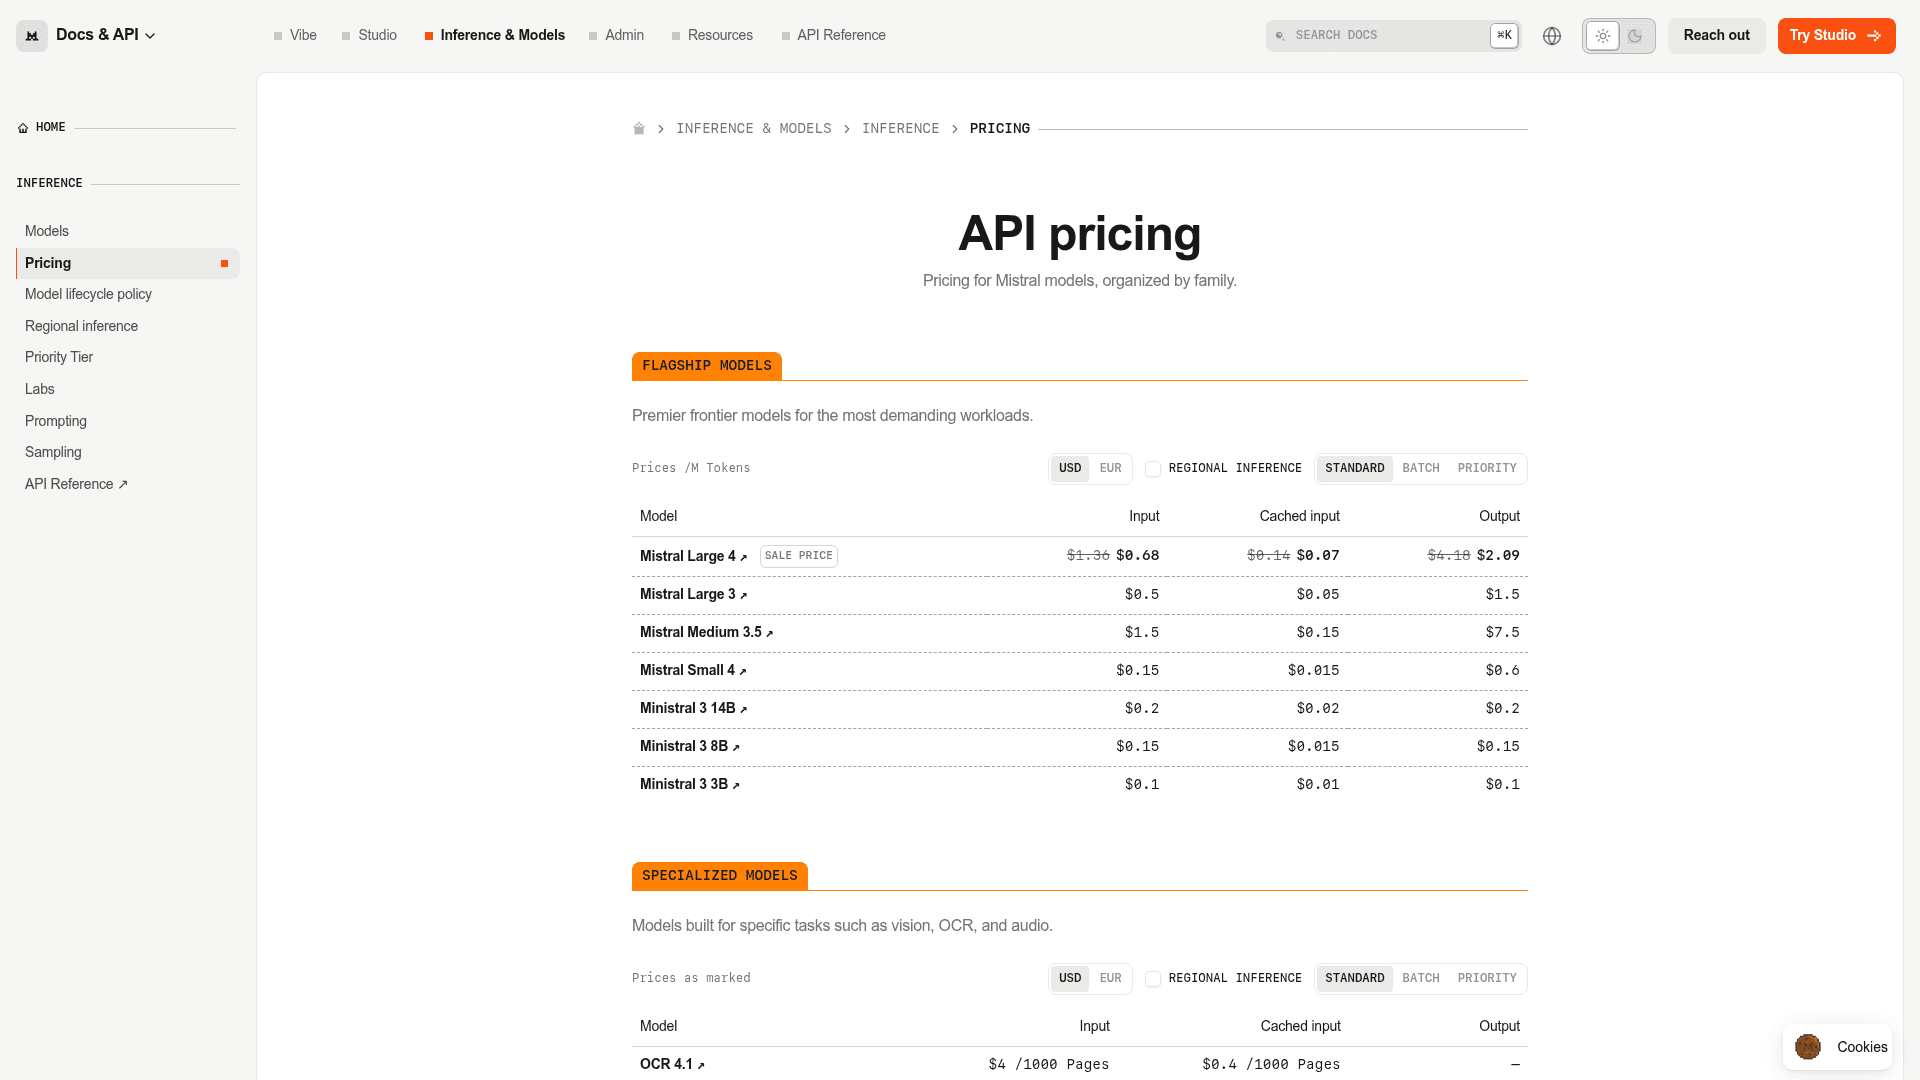
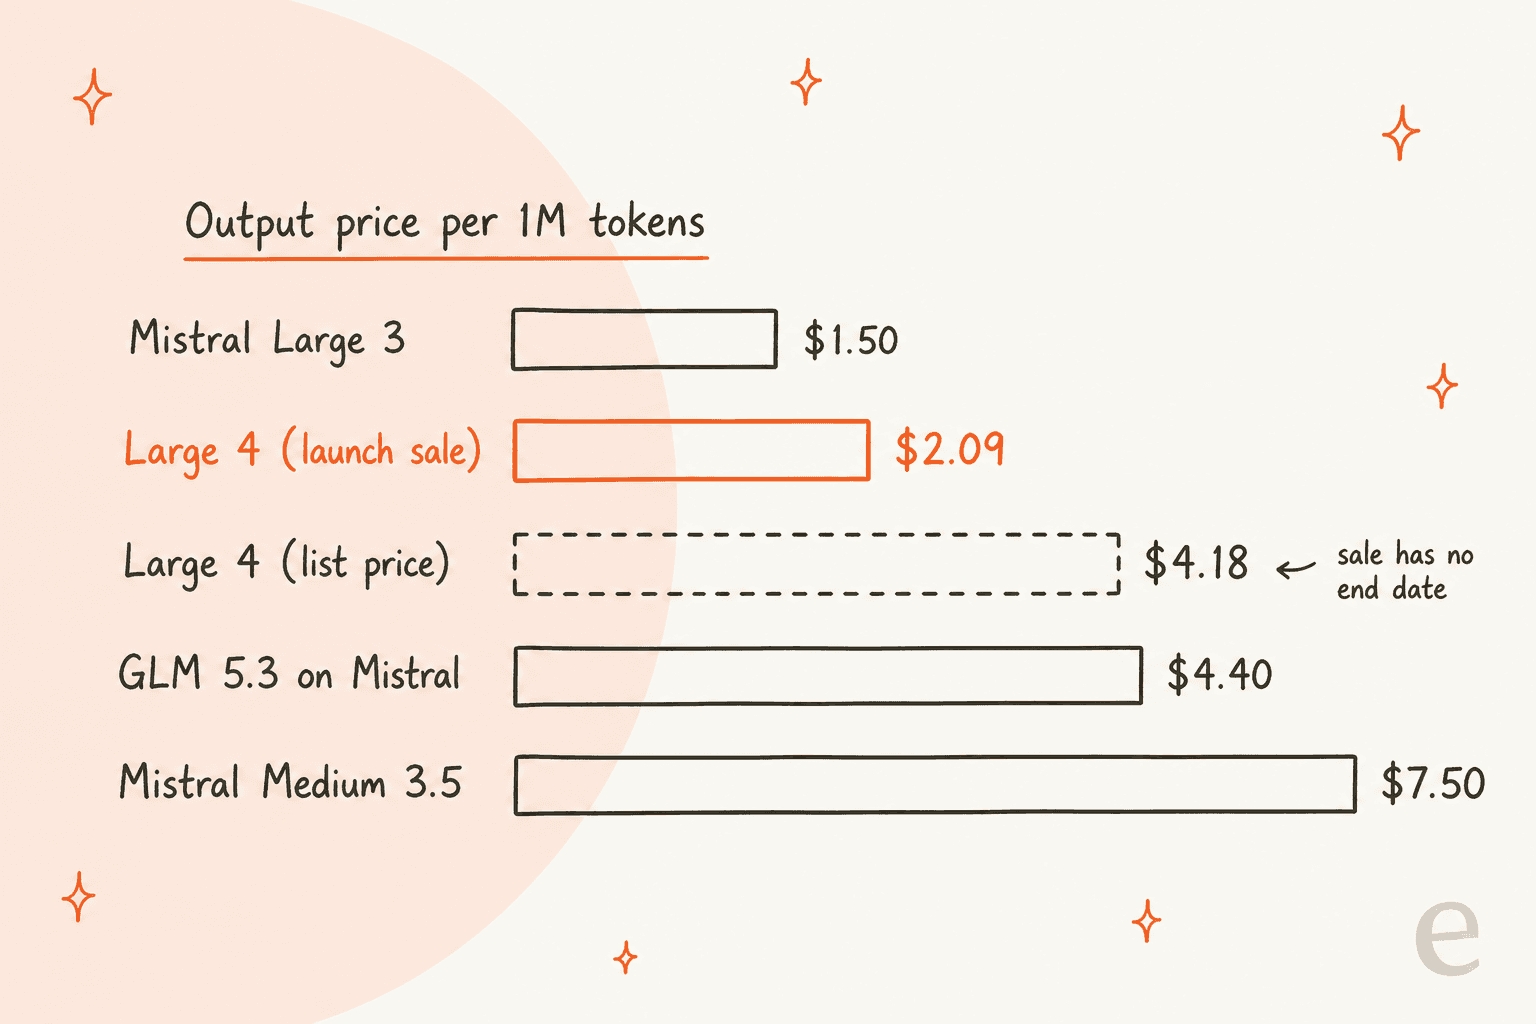
Mistral Large 4 wird über die API pro Token abgerechnet, und derzeit läuft eine Launch-Aktion zum genau halben Listenpreis. Die API-Preisseite zeigt beides:
| Modell (pro 1M Tokens) | Input | Gecachter Input | Output |
|---|---|---|---|
| Mistral Large 4 (Launch-Aktion) | $0.68 | $0.07 | $2.09 |
| Mistral Large 4 (Listenpreis) | $1.36 | $0.14 | $4.18 |
| Mistral Large 3 | $0.50 | $0.05 | $1.50 |
| Mistral Medium 3.5 | $1.50 | $0.15 | $7.50 |
| Mistral Small 4 | $0.15 | $0.015 | $0.60 |
| GLM 5.3 (von Mistral gehostet) | $1.40 | $0.14 | $4.40 |
Drei Dinge fallen mir auf:
- Die Aktion hat kein Enddatum. Zum Listenpreis ist der Output 2,8-mal so teuer wie bei Large 3. Plane mit $1.36 / $4.18 und betrachte die Aktion als Bonus obendrauf.
- Es unterbietet Mistrals eigenes Medium 3.5. In der Aktion kostet der Output von Large 4 $2.09 gegenüber $7.50 bei Medium 3.5, es gibt also kaum einen Grund, für neue Arbeit bei Medium zu bleiben.
- Batch ist noch günstiger. Laut Mistrals Preis-FAQ kosten Batch-Anfragen 50% weniger und gecachter Input bis zu 90% weniger.
Wenn du es lieber als Chat-App statt über eine API nutzen willst: Es steckt in Mistrals Endkundenprodukt, das jetzt Vibe heißt (früher Le Chat): Free für $0, Pro für $14.99/Monat, Team für $24.99/Nutzer/Monat und Enterprise auf Anfrage. Die Preisseite nennt nicht, welche Vibe-Tarife Large 4 enthalten, prüfe das also, bevor du einen Platz dafür kaufst. Mein vollständiger Leitfaden zu den Mistral-AI-Preisen schlüsselt die Tarife auf.
Was eine Support-Antwort mit Large 4 kostet
Token-Preise lassen sich leichter beurteilen, wenn eine echte Arbeitslast daran hängt. Angenommen, eine Support-Antwort liest 8.000 Input-Tokens (den Ticketverlauf plus ein paar per RAG geholte Help-Center-Artikel) und schreibt 3.000 Output-Tokens, Reasoning eingeschlossen. Zum Aktionspreis sind das etwa $0.012 pro Antwort, zum Listenpreis etwa $0.023.
Das ist günstig, und deshalb würde ich den meisten Support-Teams sagen, dass der Token-Preis selten der Posten ist, der über einen AI-Support-Rollout entscheidet. Falsche Antworten und die Stunden, die man mit dem Beaufsichtigen des Bots verbringt, kosten weit mehr, was auch das Thema meiner Aufschlüsselung zu den Kosten eines AI-Support-Agents ist.
Mistral Large 4 Benchmarks: Mistrals Grafiken vs. unabhängige Tests
Mistral hat für diesen Launch viele Grafiken veröffentlicht, und sie lohnen sich, genau gelesen zu werden, denn sie sind auf eine etwas ungewöhnliche Art ehrlich. Mistrals eigene Grafiken zeigen, dass Konkurrenten Large 4 bei vier der sechs Benchmarks schlagen, die ich lesen konnte.
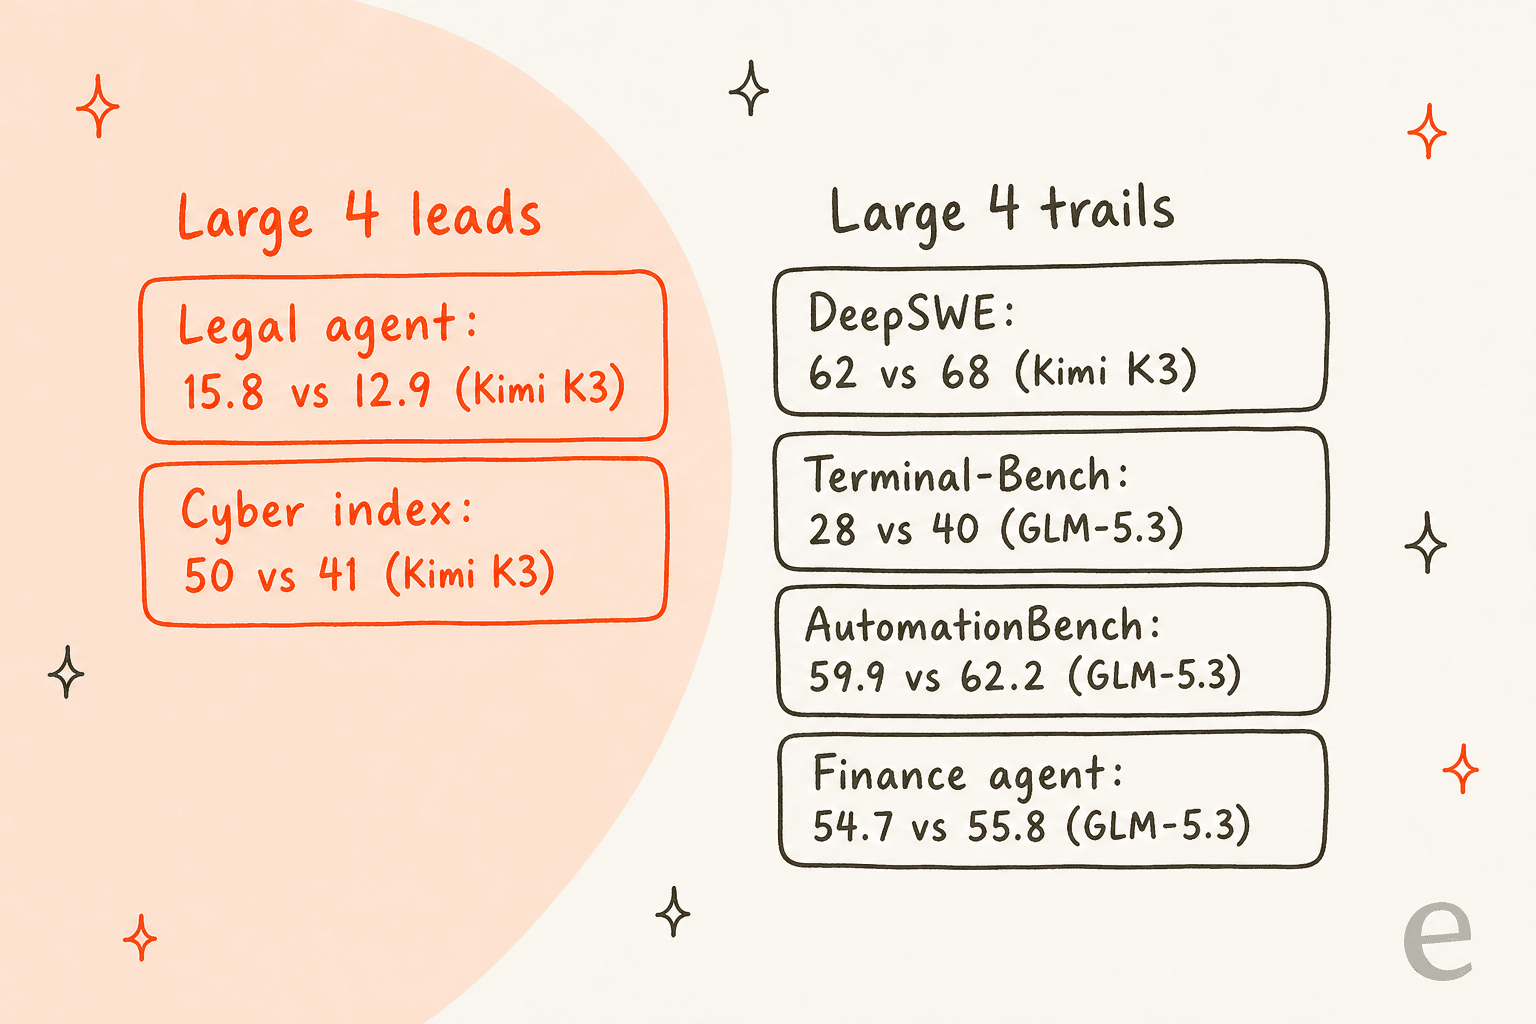
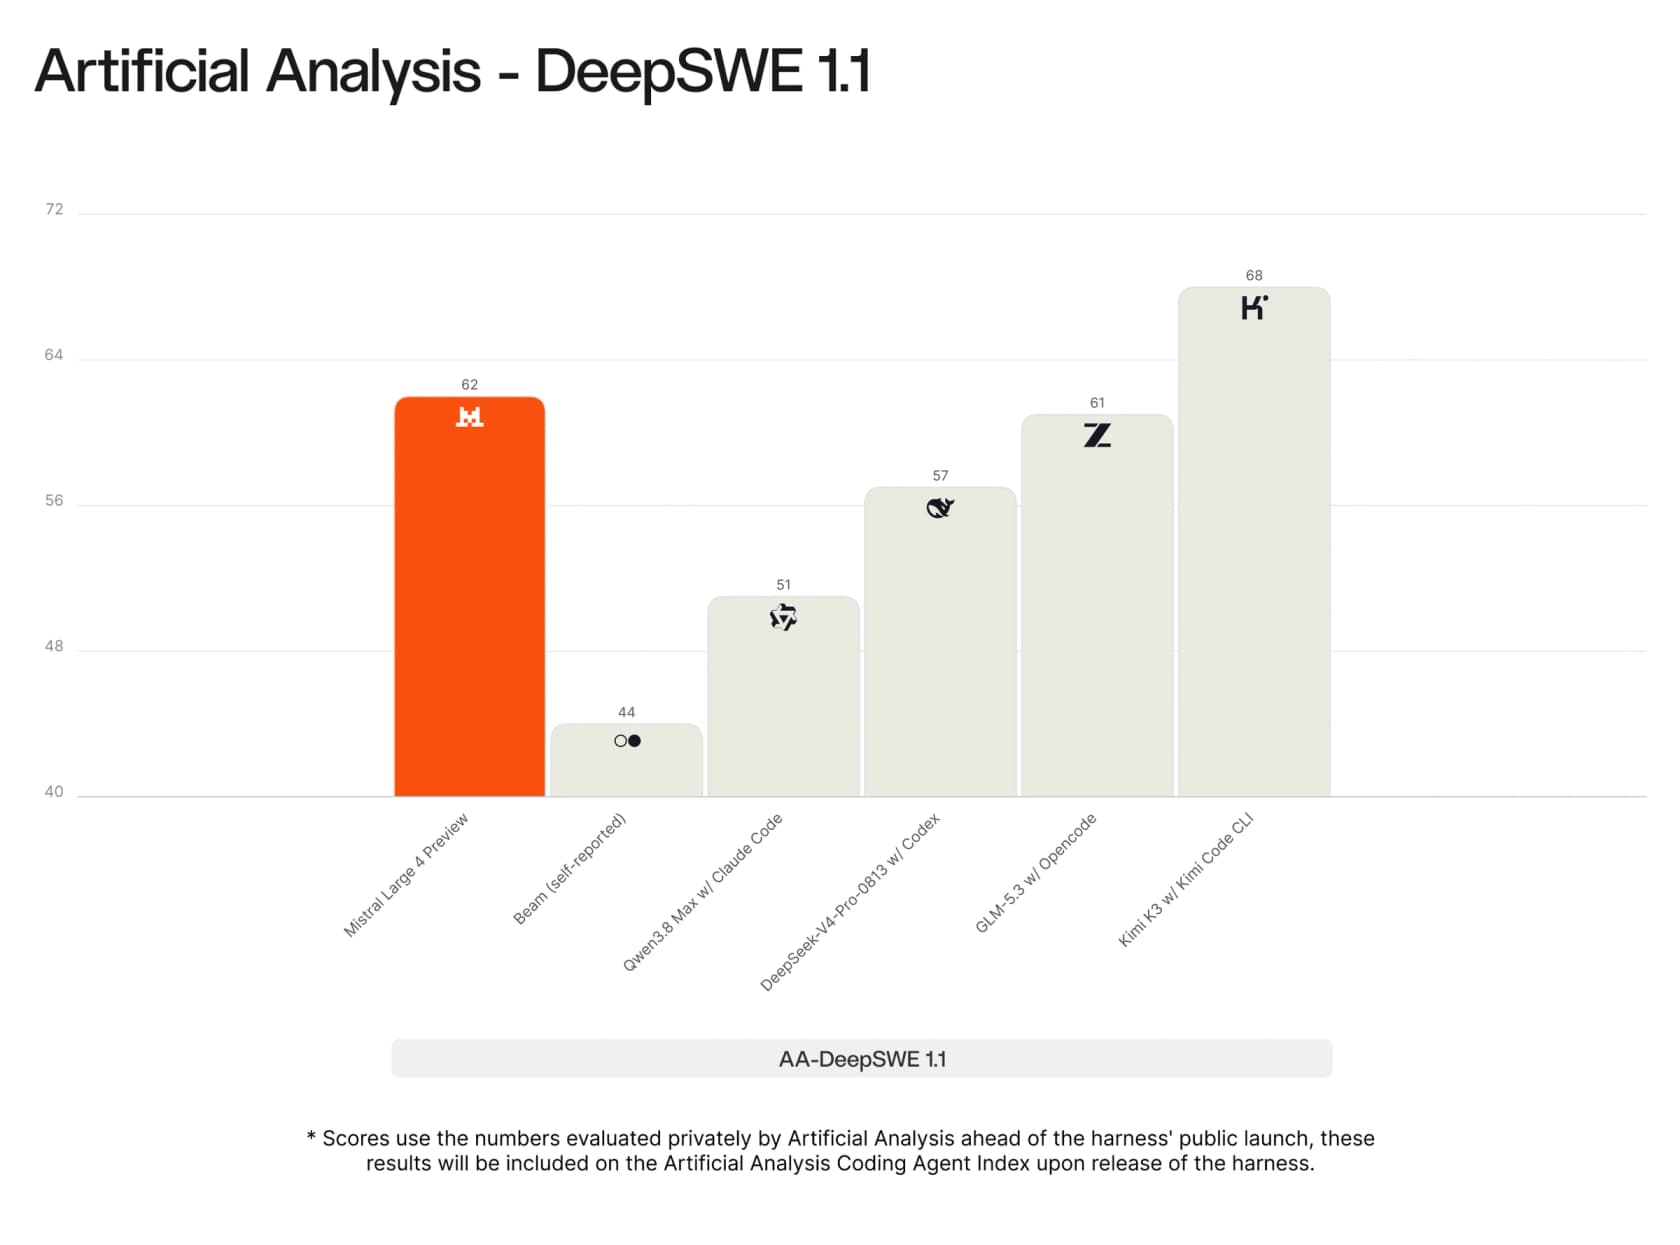
Beim Coding erreicht es 61.7% auf DeepSWE v1.1 und 28.3% auf Terminal-Bench 4. Kimi K3 liegt bei DeepSWE höher (68), und GLM-5.3 bei Terminal-Bench (40), beides laut Mistrals eigenen Grafiken.
Das unabhängige Bild von Artificial Analysis passt dazu. Hier steht Large 4 in ihrem Intelligence Index, mit den Kosten für eine Benchmark-Aufgabe:
| Modell | AA Intelligence Index | Preis Input / Output pro 1M | Kosten pro Aufgabe |
|---|---|---|---|
| Claude Sonnet 5.5 (Max) | 56.0 | $2 / $10 | $5.46 |
| Qwen 3.8 Max | 45.4 | $2 / $6 | $5.41 |
| Kimi K3 (Max) | 43.6 | $3 / $15 | $2.00 |
| Claude Haiku 5.5 (Max) | 43.4 | $0.10 / $0.50 | $0.21 |
| Gemini 3.8 Flash (High) | 40.9 | $0.75 / $3.75 | $1.24 |
| DeepSeek V4.1 Flash (Max) | 39.5 | $0.30 / $1.20 | $0.27 |
| Mistral Large 4 Preview | 38.4 | $1.36 / $4.18 | $1.13 |
| GPT-5.6 Luna (Max) | 37.3 | $0.20 / $1.20 | $0.18 |
| DeepSeek V4 Pro (Max) | 36.0 | $1.32 / $3.96 | $0.67 |
| Mistral Large 3 | 9.3 | $0.50 / $1.50 | $0.03 |
Diese Tabelle lässt zwei Lesarten zu, und beide stimmen. Gemessen an Mistrals Vergangenheit ist Large 4 ein Generationssprung: das 4,1-Fache des Scores von Large 3. Gemessen am heutigen Feld liegt es hinter Kimi K3 und Qwen 3.8 Max, knapp unter DeepSeek V4.1 Flash und knapp über GPT-5.6 Luna, die beide pro Aufgabe nur einen Bruchteil kosten.
Der Grund ist der Token-Hunger. Artificial Analysis zählte bei Large 4 69.330 Output-Tokens pro Aufgabe, davon 52.011 Reasoning. Large 3 brauchte 5.566. Ein Reasoning-Modell, das so intensiv nachdenkt, macht aus einem moderaten Preis pro Token einen hohen Preis pro Aufgabe.
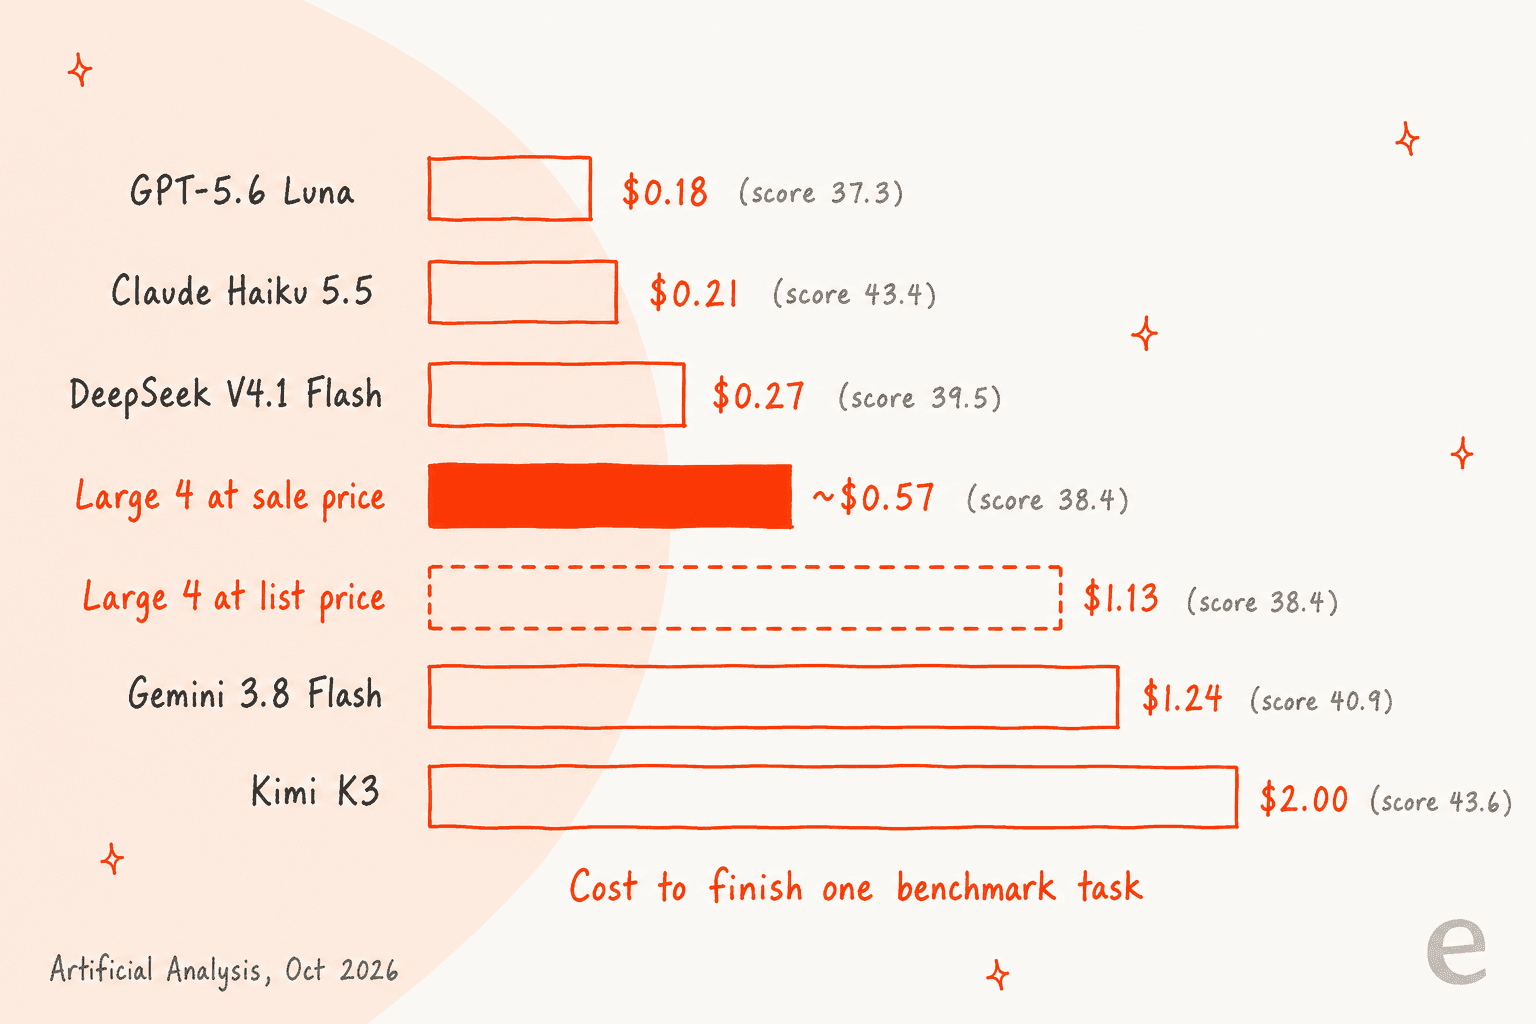
Artificial Analysis rechnet seine Läufe zu Listenpreisen ab, und da die Aktion jeden Satz halbiert, auch den für gecachten Input, ergeben sich zum Aktionspreis etwa $0.57 pro Aufgabe. Das ist immer noch rund das Doppelte von DeepSeek V4.1 Flash bei etwas niedrigerem Score. Wenn du offene Modelle nach Kosten vergleichst, findest du in meinen Beiträgen zu den DeepSeek-V4-Flash-Preisen und den Kimi-K3-Preisen die vollständigen Preislisten.
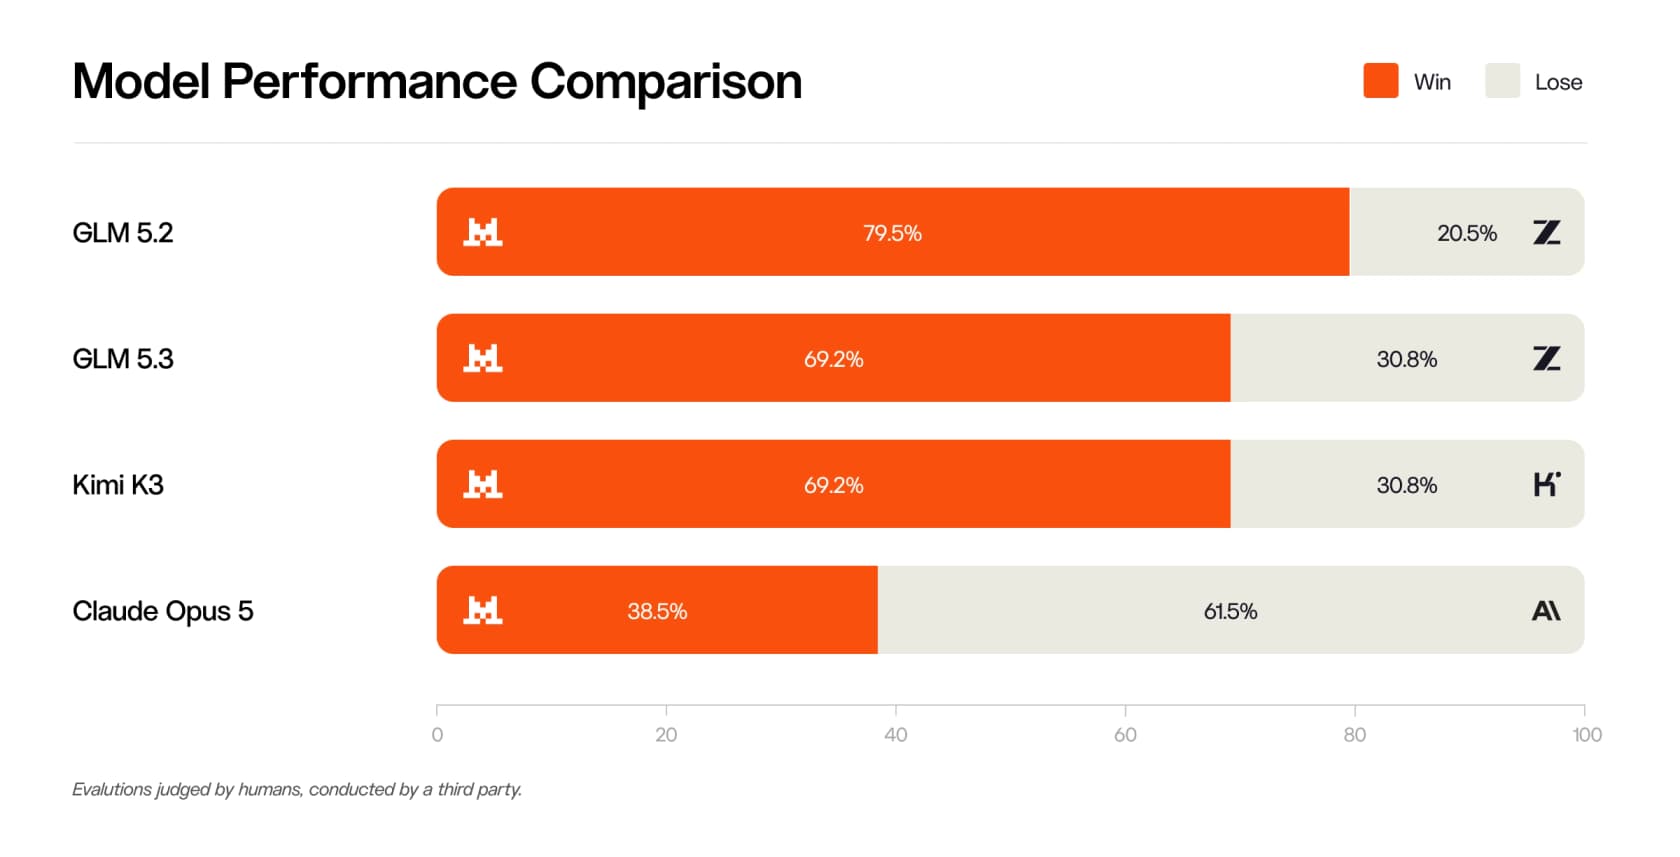
Menschliche Bewerter zeichnen ein freundlicheres Bild als der Index. In Mistrals Humanevaluierungen, die ein Dritter durchgeführt hat, gewann Large 4 69.2% der direkten Vergleiche sowohl gegen GLM-5.3 als auch gegen Kimi K3 und 38.5% gegen Claude Opus 5.
Wo Mistral Large 4 am stärksten ist
Lässt man den Gesamtindex weg, zeichnet sich ein klares Profil ab: Large 4 ist nicht der beste Allrounder, liegt aber an ein paar bestimmten Stellen vorn.
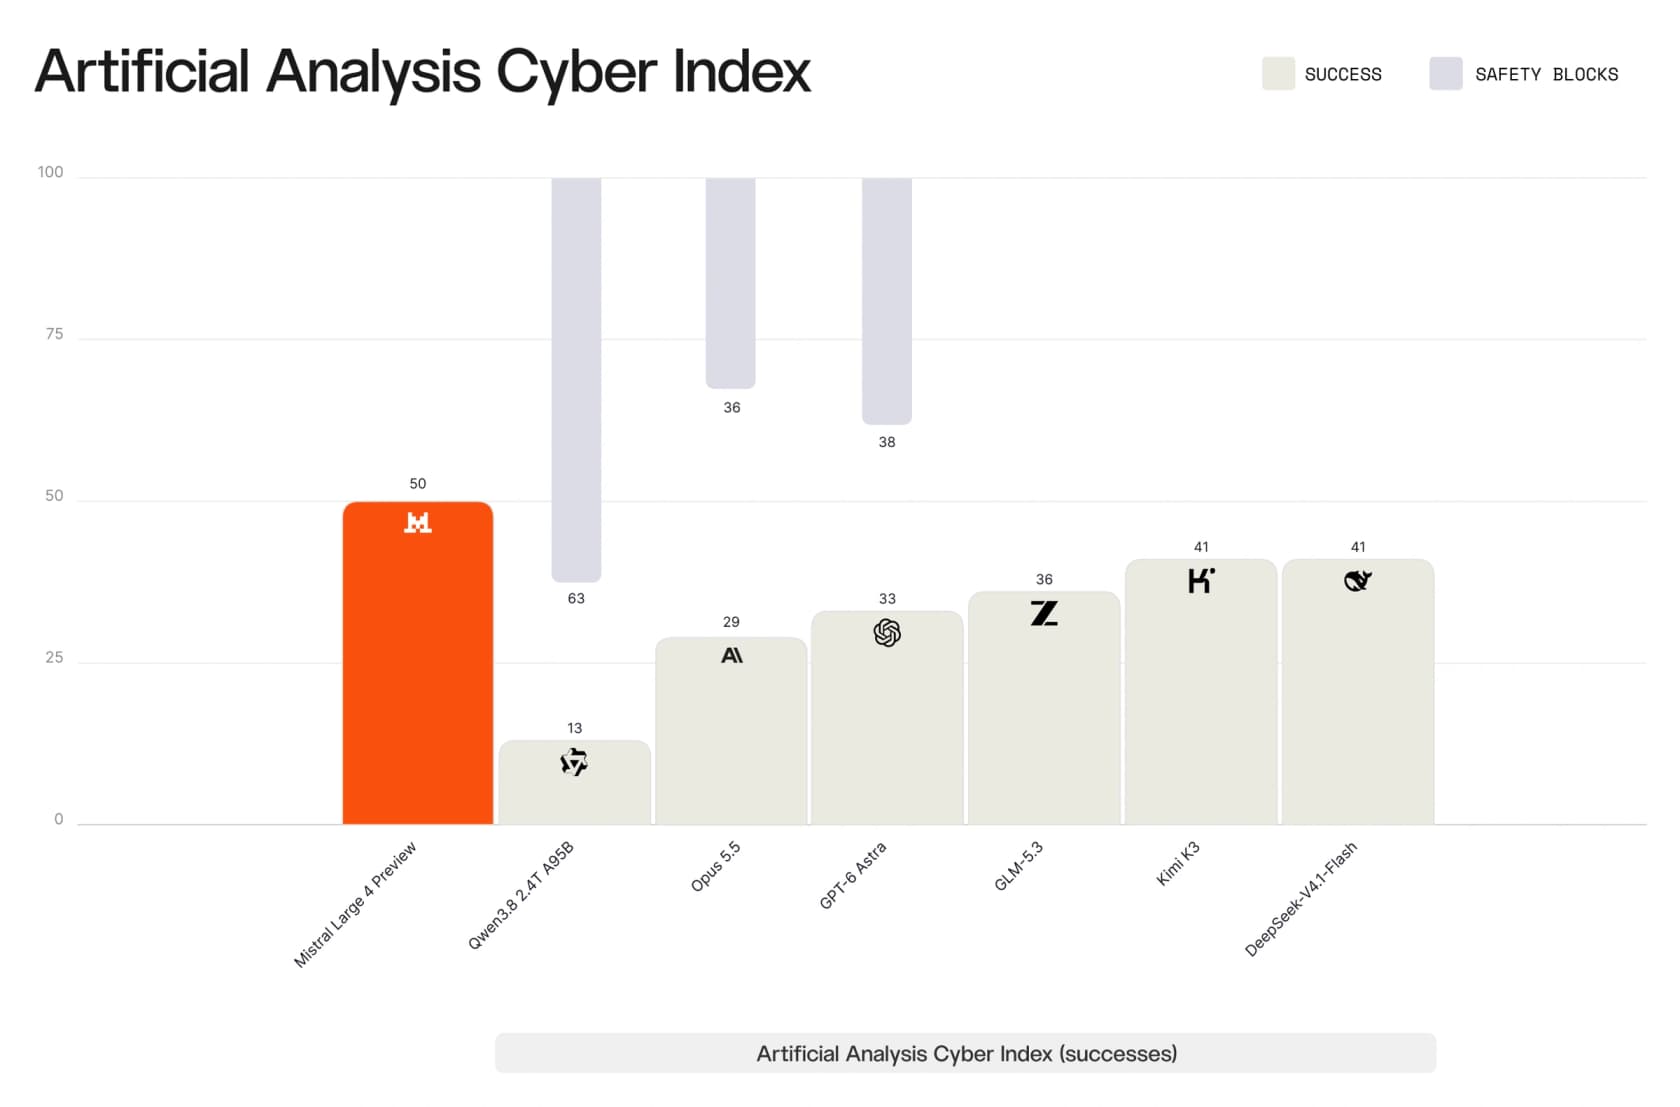
Cyber-Abwehr. Das ist die Hauptbehauptung, und die Zahlen belegen sie. Large 4 erreichte im Artificial Analysis Cyber Index 50 Punkte, vor Kimi K3 mit 41, GPT-6 Astra mit 33 und Claude Opus 5.5 mit 29, laut Mistrals Launch-Beitrag. Es schaffte 82% bei einem Reproduce-then-Patch-Test und 93% bei Cybench. Zum Patch-Test merkt Mistral an, dass die geschlossenen Frontier-Modelle "score near zero on the same test because they refuse", ein Teil des Vorsprungs hat also mit Bereitschaft zu tun, nicht mit Können.
Mistral-Mitgründer Guillaume Lample hat das direkt begründet:
"Open models are the best defense for enterprises today: capable, auditable, self-hosted and governed under enterprise policies -- and more importantly, they do not refuse to help."
Juristische Agentenarbeit. Im Vals.ai-Benchmark Harvey Legal Agent erreichte es 15.8, vor Kimi K3 mit 12.9 und GPT-6 Astra mit 5.4. Die absoluten Werte sind niedrig, der Vorsprung ist aber klar.
Lange Dokumente und Diagramme. Es erreichte 81.3% im Long-Context-Reasoning-Test von Artificial Analysis (AA-LCR) und 42% bei Dense 200 Visual Grounding und liegt damit knapp vor den 41% von GPT-6 Astra. Das Daten-Team von Plotly sah in der Praxis dasselbe (mehr dazu unten).
Sicherheit unter Angriff. Es wehrte 93.3% der Angriffe im Agent-Security-Benchmark Lakera B3 ab, der höchste Wert, den Mistral unter Wettbewerbern angab.
Was die Community zu Mistral Large 4 sagt
Der Launch-Thread auf Hacker News erreichte 1.990 Punkte und 1.144 Kommentare, und die Stimmung ist ungefähr so geteilt, wie es die Benchmark-Tabelle nahelegt: Die Leute sind vom Sprung beeindruckt, aber nicht überzeugt, dass es das Feld schlägt.
Der nützlichste Praxistest kam von jemandem bei Plotly, der es auf dem eigenen Data-Analytics-Benchmark laufen ließ:
"It's 10x cheaper than Mistral Medium 3.5 from April and goes from 58% to 74% correct. Definitely a generational shift. It's not on the Pareto curve yet, but it's good enough for data analytics"

Der Preis kam in den Antworten oft zur Sprache. Ein Kommentator stellte es neben die günstigeren "Flash"-Modelle:
"So, I think it would have to be significantly better than GLM 5.3-flash to be worth it. GLM 5.3-flash is already very good."
Für den direkten Vergleich mit geschlossenen Modellen sind meine Vergleiche Claude vs Mistral und ChatGPT vs Mistral eine gute nächste Lektüre.
Reddit war härter. Auf r/LocalLLaMA schrieb ein Nutzer, der seinen eigenen Schach-Benchmark betreibt:
"Played around with it a bit, for code analysis, image classifications, and chess capability. Feels quite dated and far behind what I usually utilize."

Und doch kehrt das Souveränitätsargument immer wieder, das ich bei Geschäftskunden am ernstesten nehmen würde:
"In most corporate workflows, it is probably good enough. And you don't have to sell your soul to Xi or Trump. As a european, I had feared much worse."
Die meistgelikte Antwort auf Mistrals Launch-Beitrag auf X war ein Witz, der viel über das Framing "Open Weights" verrät: "me with 12 GB of VRAM reading 'open weights, 1.05T parameters'" (An Xuan auf X). Damit komme ich zum Teil, der vorerst nur ein Versprechen ist.
Open Weights: Was "offen" heute bedeutet
Mistral kennzeichnet Large 4 als Open-Weight, aber Stand 8. Oktober 2026 kannst du es nicht herunterladen. Auf Mistrals Hugging-Face-Seite gibt es kein Mistral-Large-4-Repo, und es wurde keine Lizenz genannt. Lample sagt, der RL-Lauf "is still in flight" und eine finale Version erscheine vor Monatsende zusammen mit den Gewichten.
Das hat zwei praktische Folgen für dich:
- Benchmarks können sich verschieben. Das Modell, das du heute testest, ist eine Preview, und Mistrals Lifecycle-Richtlinie räumt Public-Preview-Modellen nur einen Monat Vorlauf vor Änderungen ein, gegenüber sechs Monaten bei General Availability. Führe deine Evals erneut aus, wenn die finale Version erscheint.
- Die Lizenz entscheidet alles. Large 3 erschien unter Apache 2.0, Medium 3.5 nutzt eine modifizierte MIT-Lizenz. Solange Mistral für Large 4 keine nennt, ist "offen" eine Richtung, kein Vertrag.
Selbst mit Gewichten werden die meisten Teams es nicht selbst betreiben, denn bei 1,05T Parametern bist du im Bereich von Multi-GPU-Servern. Realistische Wege sind also Mistrals API, ein europäisches Deployment über Mistral oder ein Hosting-Anbieter, sobald es solche gibt. Wenn du etwas willst, das du heute auf eigener Hardware betreiben kannst, enthält meine Liste mit Mistral-Alternativen kleinere offene Modelle.
Solltest du Mistral Large 4 für den Kundensupport nutzen?
Das ist die Frage, die ich am häufigsten gestellt bekomme, hier meine direkte Antwort: Large 4 kann eine gute Support-Antwort schreiben, sollte aber nie aus dem eigenen Gedächtnis antworten.
Im Wissenstest von Artificial Analysis (AA-Omniscience) beantwortete es 25.8% der Fragen richtig und hatte eine Halluzinationsrate von 41.9%. Das heißt: Wenn es die Antwort nicht wusste, hat es oft einfach geraten. In einem Helpdesk ist ein selbstsicherer Rateversuch zu deiner Erstattungsrichtlinie oder zur Kompatibilität deines Produkts die schlechteste denkbare Antwort.
Diesen Fehlermodus habe ich selbst aus der Nähe erlebt. In einem eesel-Sales-Call fürchtete ein dänisches B2B-Telematik-Team für Fahrzeuge, das Zendesk mit etwa 200 Tickets im Monat nutzt, dass sein Bot nicht unterstützte Automodelle bestätigen würde, weil in der Wissensdatenbank stand "we support all models". Ein besseres Modell hätte das nicht behoben, denn das Modell las die Dokumente richtig, und die Dokumente waren falsch. Deshalb wird jeder Rollout, an dem ich arbeite, vor dem Livegang gegen historische Tickets getestet, und deshalb beginnen die Leitfäden dazu, wie man Halluzinationen stoppt, bei der Wissensdatenbank und nicht beim Modell.
Ein CX-Lead einer DTC-Supplement-Marke mit rund 7.000 Tickets formulierte die eigentliche Anforderung besser, als es ein Benchmark kann:
"I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
Die Latenz ist der zweite Punkt, der geprüft werden muss. Mit aktiviertem Reasoning maß Artificial Analysis bei einem langen Prompt etwa 18,7 Sekunden bis zum ersten Antwort-Token. Das ist für E-Mail- und Ticket-Antworten in Ordnung, für Live-Chat aber langsam, wo du ein niedrigeres reasoning_effort oder ein schnelleres Modell wollen würdest. Mein Vergleich zum besten AI-Modell für Tickets geht tiefer auf diesen Zielkonflikt ein.
So würde ich es für ein Support-Team zusammenfassen:
| Anwendungsfall | Eignung von Large 4 | Warum |
|---|---|---|
| Antwortentwürfe, die Agenten prüfen | Gut | Starkes Schreiben, günstig pro Antwort, ein Human in the Loop prüft das Ergebnis |
| Autonome E-Mail- oder Ticket-Antworten | Nur mit Leitplanken | Braucht Verankerung in deinen Dokumenten, einen Confidence Score und einen menschlichen Fallback |
| Live-Chat | Schwach mit aktiviertem Reasoning | ~18,7 s bis zum ersten Antwort-Token |
| Anforderungen an EU-Datenresidenz | Stark | Von Mistral in Europa gebaut und betrieben |
| Screenshots und PDFs lesen, die Kunden anhängen | Stark | Native Bildeingabe, gute Dokument- und Diagrammwerte |
Wenn du dich für den Support-Stack zwischen Modellen entscheiden musst, vergleicht mein Leitfaden zum besten LLM für den Support die wichtigsten Optionen, und RAG vs Fine-Tuning erklärt, warum Grounding bei Help Centern das Training schlägt.
Das Modell ist Infrastruktur, eesel ist der Mitarbeiter
Hier ist der Perspektivwechsel, den ich dir nahelegen würde. Ein Modell wie Mistral Large 4 ist Infrastruktur: eine Maschine, die Text vorhersagt. Was ein Support-Team wirklich braucht, ist ein Teammitglied, das das Produkt kennt, im Helpdesk arbeitet, weiß, wann es übergeben muss, und das man prüfen kann, bevor es mit Kunden spricht. Die Wahl der Maschine ist die leichtere Hälfte der Aufgabe.
Karel von GENERAL BYTES sagte es klar, als er erklärte, warum sein Team keine eigene Lösung gebaut hat:
"We could try to write our own LLM application but we didn't want to invest our time into that. We wanted something that we would not have to maintain."
Das ist die Aufgabe von eesel, einer AI-Teammate-Plattform, auf der du einsatzbereite Teammates für bestimmte Aufgaben einstellst.
Für den Support ist das der AI-Helpdesk-Teammate: Er lässt sich in Zendesk, Freshdesk oder Gorgias einbinden, lernt aus deinen bisherigen Tickets und deinem Help Center und fährt eine Simulation über Hunderte deiner früheren Tickets, damit du siehst, wie er geantwortet hätte, bevor du ihn einschaltest. Für Content-Teams leistet der AI-Blog-Writer dasselbe für Longform-Beiträge.
Wenn du ihn mit der eingebauten AI deines Helpdesks vergleichst: eesel vs Zendesk AI habe ich separat verglichen.
Um die Grenzen klar zu benennen: eesel läuft laut Sicherheitsseite auf Modellen von OpenAI, Anthropic und Google, Mistral Large 4 ist in eesel heute also keine wählbare Option. Wenn deine Anforderung konkret "ein Mistral-Modell, in Europa gehostet" lautet, ist der direkte Aufruf von Mistrals API der geradere Weg.
Wenn du zu Large 4 gekommen bist, weil du Kontrolle auf API-Ebene willst, bietet dir die eesel CLI genau das für den Teammate selbst. npx @eesel/cli init chat-bubble --site <your-site> startet eine auf deine Website trainierte Chat-Bubble ohne Account, jeder Befehl liefert JSON, sodass Claude Code, Cursor oder Codex das Setup steuern können, und eesel mcp token macht aus deinem Workspace einen MCP-Server. Es ist derselbe Agent wie im Dashboard, alles, was du im Terminal einrichtest, erscheint also auch dort. Mein Beitrag zu AI-Agent-CLIs erklärt, warum das wichtig ist.
eesel ausprobieren
Wenn du Mistral Large 4 prüfst, weil du eine AI willst, die Support-Tickets beantwortet, würde ich eine Stufe höher ansetzen. Der Helpdesk-Teammate von eesel kommt in Minuten in deine Zendesk-, Freshdesk- oder Gorgias-Queue, lernt aus Tickets, die dein Team bereits beantwortet hat, und zeigt dir eine bewertete Simulation an diesen früheren Tickets, bevor er jemandem antwortet. Falsche Antworten siehst du in einem Bericht, nicht im Posteingang eines Kunden.

Der Free-Tarif enthält 100 Credits ohne Karte, und die bezahlten Tarife beginnen laut eesel-Preisen bei $299/Monat für 500 Tickets oder Chats. Probiere eesel an einem Ausschnitt der Tickets des letzten Monats aus und sieh, wie es abschneidet.
Häufig gestellte Fragen
Was ist Mistral Large 4?
Was kostet Mistral Large 4?
Ist Mistral Large 4 Open Source?
Ist Mistral Large 4 besser als Kimi K3 oder Qwen 3.8 Max?
Eignet sich Mistral Large 4 für den Kundensupport?
Wie lautet der API-Modellname von Mistral Large 4?
mistral-large-4, und sie akzeptiert den Parameter reasoning_effort. Unterstützt werden Function Calling, strukturierte Ausgaben, Batching und die Agents API. Bei Preview-Modellen wird einen Monat vor Änderungen informiert, teste also vorab gegen diese ID, bevor du einen AI-Agent darauf aufbaust.