

Claude Fable 5.2 kam am 9. November 2026 auf den Markt, zu 8 $ pro Million Input-Tokens und 40 $ pro Million Output-Tokens, eine Senkung um 20% gegenüber Fable 5.1 mit 10 $ und 50 $. Wenn Sie Fable 5.1 nutzen, wechseln Sie: Es ist günstiger, schneller und erzielt bei jedem von Anthropic veröffentlichten Benchmark höhere Werte. Wenn Sie Opus 5.5 zu 4 $ und 20 $ nutzen, bleiben Sie dabei, bis Ihre eigenen Evals mit hohem Effort nicht mehr ausreichen, denn Fable 5.2 kostet pro Token doppelt so viel, und frühe Nutzer berichten, dass es pro Aufgabe deutlich mehr Tokens verbraucht.
Das ist das Muster, um das ich planen würde: Ein Spitzenmodell ist Infrastruktur, und die eigentliche Arbeit passiert in der Schicht darüber. Für Support- oder Content-Aufgaben ist eesel diese Schicht, mit einem KI-Helpdesk-Teammitglied und einem KI-Blog-Autor, die auf dem jeweils besten Modell des Monats laufen. Die eesel CLI lässt außerdem einen Coding-Agenten genehmigtes Wissen hochladen und Testfragen stellen, bevor etwas live geht, wobei die Helpdesk-Verbindung selbst weiterhin die Freigabe eines Admins braucht.
Was hat Anthropic tatsächlich veröffentlicht?
Anthropic brachte am 9. November zwei Modelle heraus, Fable 5.2 und Mythos 5.2, und bezeichnet sie als "dasselbe zugrunde liegende Modell". Fable trägt starke Cybersicherheits- und Biologie-Schutzmechanismen, damit es für alle verfügbar sein kann. Mythos ist die Version mit leichteren Schutzmechanismen, offen für Organisationen in den Cyber- und Life-Sciences-Verification-Programmen. Ich habe Mythos 5.1 bereits früher behandelt, und Mythos 5.2 hat seinen eigenen Beitrag.
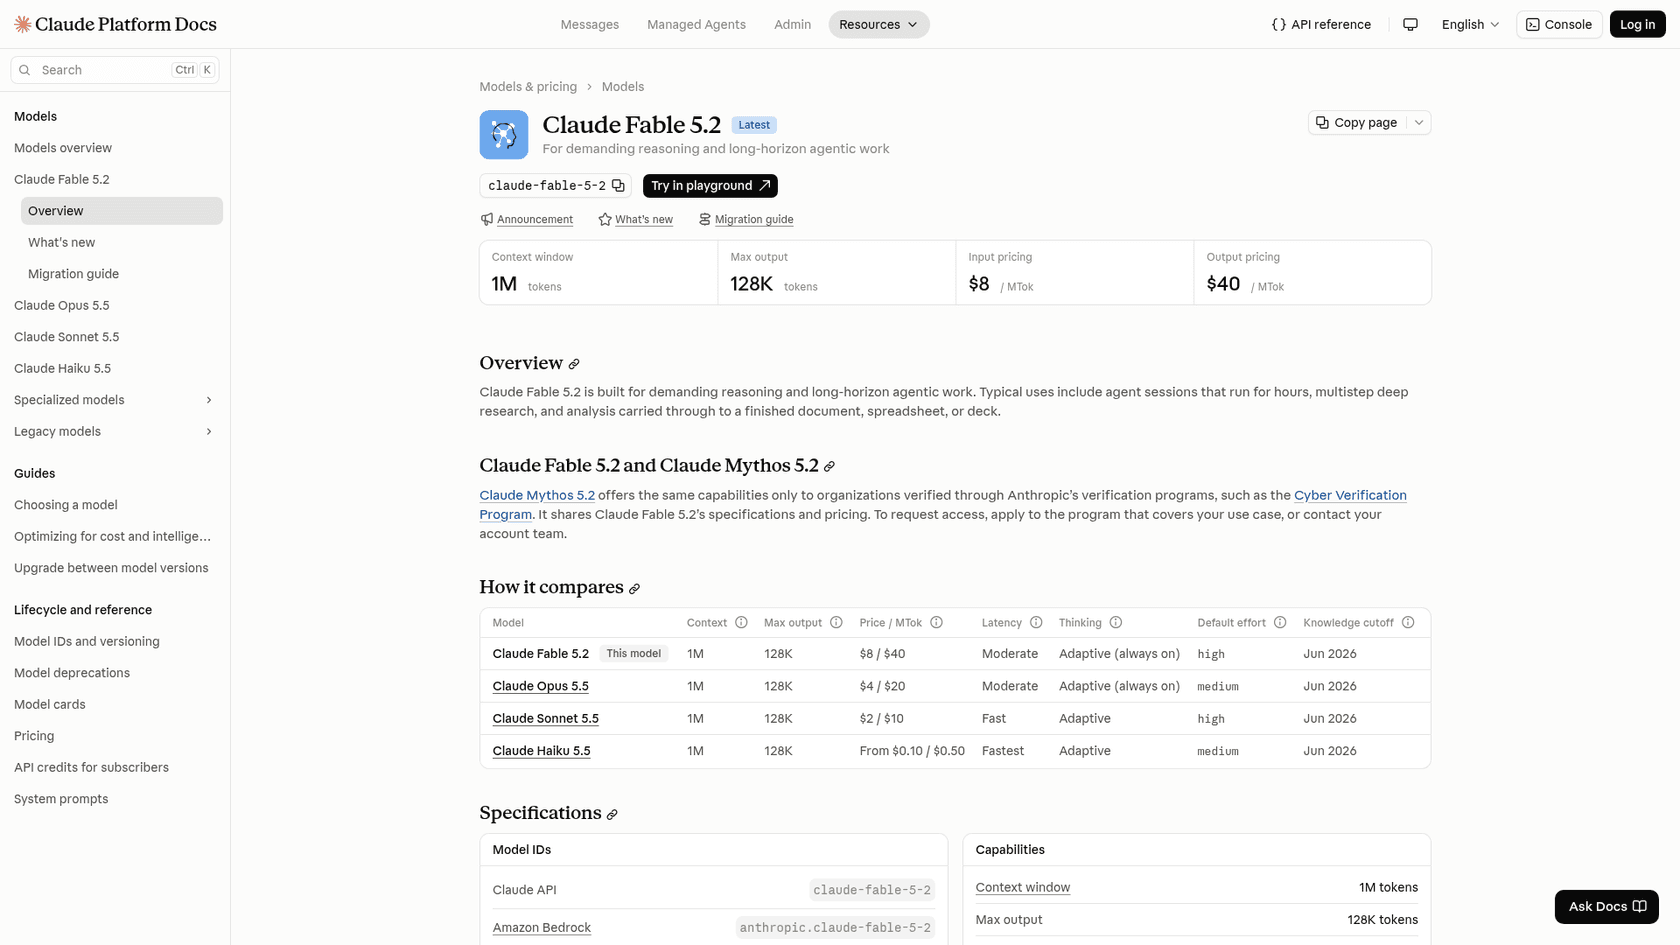
Die Spezifikationen, von der Modellseite:
| Spezifikation | Claude Fable 5.2 |
|---|---|
| API-Modell-ID | claude-fable-5-2 (anthropic.claude-fable-5-2 auf Bedrock) |
| Veröffentlicht | 9. November 2026 |
| Preis pro MTok | 8 $ Input, 40 $ Output |
| Cache-Read / 5-Min.-Write / 1-Std.-Write | 0,20 $ / 10 $ / 16 $ |
| Batch API | 50% Rabatt auf Input und Output |
| Fast-Modus | 16 $ Input, 80 $ Output, bis zu 2,5x schnellere Ausgabe |
| Kontextfenster | 1M Tokens |
| Maximale Ausgabe | 128K Tokens |
| Thinking | Adaptiv, immer aktiv |
| Standard-Effort | high über die API |
| Wissensstand | Juni 2026 |
Zwei weitere Fakten, die fürs Budget wichtig sind. Fable 5.2 erfordert eine 30-tägige Datenaufbewahrung und ist unter Zero Data Retention nicht verfügbar, sofern Anthropic das nicht ausdrücklich genehmigt. Und es wird nicht auf Priority Tier unterstützt. Die vollständige Preisaufschlüsselung finden Sie in meinem Fable-5.2-Preisleitfaden.
Ist Fable 5.2 wirklich günstiger als Fable 5.1?
Pro Token, ja. Pro Aufgabe kommt es auf den Effort-Regler an. Hier der Preisvergleich laut Anthropics Preisseite und Migrationsleitfaden:
| Kennzahl (pro MTok) | Fable 5.2 | Fable 5.1 | Opus 5.5 |
|---|---|---|---|
| Input | 8 $ | 10 $ | 4 $ |
| Output | 40 $ | 50 $ | 20 $ |
| Cache-Read | 0,20 $ | 0,25 $ | 0,20 $ |
| Batch Input / Output | 4 $ / 20 $ | 5 $ / 25 $ | 2 $ / 10 $ |
Meine Rechnung für eine beispielhafte Aufgabe mit 1M Input-Tokens und 200K Output-Tokens ohne Caching: Fable 5.1 kostet 20 $, Fable 5.2 kostet 16 $, Opus 5.5 kostet 8 $. Auf dem Papier liegt Fable 5.2 damit 20% unter Fable 5.1, und Opus 5.5 liegt wiederum bei der Hälfte von Fable 5.2.
Der Haken sind die Tokens pro Aufgabe. Anthropics eigene Grafik zeigt, dass Fable 5.2 bei niedrigerem Effort mit jedem Token mehr leistet, aber ein Hacker-News-Leser hat sich die Zahlen von Artificial Analysis, einem Drittanbieter, genauer angesehen und bei maximalem Effort das Gegenteil gefunden:
"Forget about the scores... look at the Cost Per Task. Fable 5.1 was already the most expensive by a good margin, and now Fable 5.2 doubles it! This is with the price cut. The output tokens per task just exploded. From 118k tokens (46k Answer/71k Reasoning) in 5.1 to 274k tokens (81k Answer/192k Reasoning) in 5.2."

Ein anderer Kommentator antwortete mit dem fairen Gegenargument, das sich mit Anthropics eigener Einordnung des Modells deckt:
"The Artificial Analysis charts are great, but be warned that they show max effort by default. [...] Fable 5.2 on medium looks quite attractive compared to Opus 5.5 high/xhigh. Fable 5.2 on max (the default) looks like a good way to light your money on fire."
Mein Fazit: Fable 5.2 ist ein Modell, das Sie über die Effort-Einstellung steuern müssen, statt es auf Maximum laufen zu lassen. Der Launch-Beitrag sagt, dass Medium in den Claude-Apps und in Claude Code der Standard ist, die Rechnung, die Sie dort sehen, ist also nicht die Max-Effort-Rechnung aus einer Grafik.
Was sagen die Benchmarks, und wie weit vertraue ich ihnen?
Anthropic hat eine lange Tabelle veröffentlicht. Hier die Zeilen, die für die meisten Käufer relevant sind, alle aus dem Launch-Beitrag, jeweils beim höchsten verfügbaren Effort mit aktivierten Schutzmechanismen:
| Benchmark | Fable 5.2 | Fable 5.1 | Opus 5.5 | GPT-6 Astra |
|---|---|---|---|---|
| FrontierCode 2.0 (agentisches Coding) | 49,1% (Xhigh) | 32,4% | 45,5% | 42,8% |
| FrontierSWE v2 (agentisches Coding) | 69,9% | 56,3% | 62,3% | 65,5% |
| AutomationBench (Geschäftsprozesse) | 51,4% | 31,4% | 42,5% | 41,4% |
| Terminal-Bench-Science 0.1 | 74,6% | 52,6% | 58,7% | 68,1% |
| Remote Labor Index | 41,3% | 17,9% | 21,3% | 20,8% |
| Humanity's Last Exam (mit Tools) | 74,2% | 65,6% | 67,7% | 57,2% |
| OSWorld 2.1 (Computer-Nutzung, partiell) | 89,3% | 83,5% | 87,2% | 79,5% |
Die größten Sprünge gegenüber Fable 5.1 gibt es bei Robotik (RoboDojo Sim, von 27,6% auf 64,9%) und beim Remote Labor Index, einem Test für bezahlte freiberufliche Arbeit. AutomationBench ist die Zeile, die ich im Blick hätte, wenn Sie Geschäftsprozesse automatisieren: von 31,4% auf 51,4%. Eine Zeile spricht gegen Fable: Gemini 4 Carbon liegt bei AutomationBench mit 53,9% knapp vorn.
Die nützlichere Grafik ist die, die Score und Kosten gegenüberstellt. Bei High Effort liegt Fable 5.2 etwa auf Höhe von Opus 5.5 in Bestform, für rund die Hälfte der Kosten pro Aufgabe, und bei Xhigh erreicht es den besten Wert, den Anthropic getestet hat.
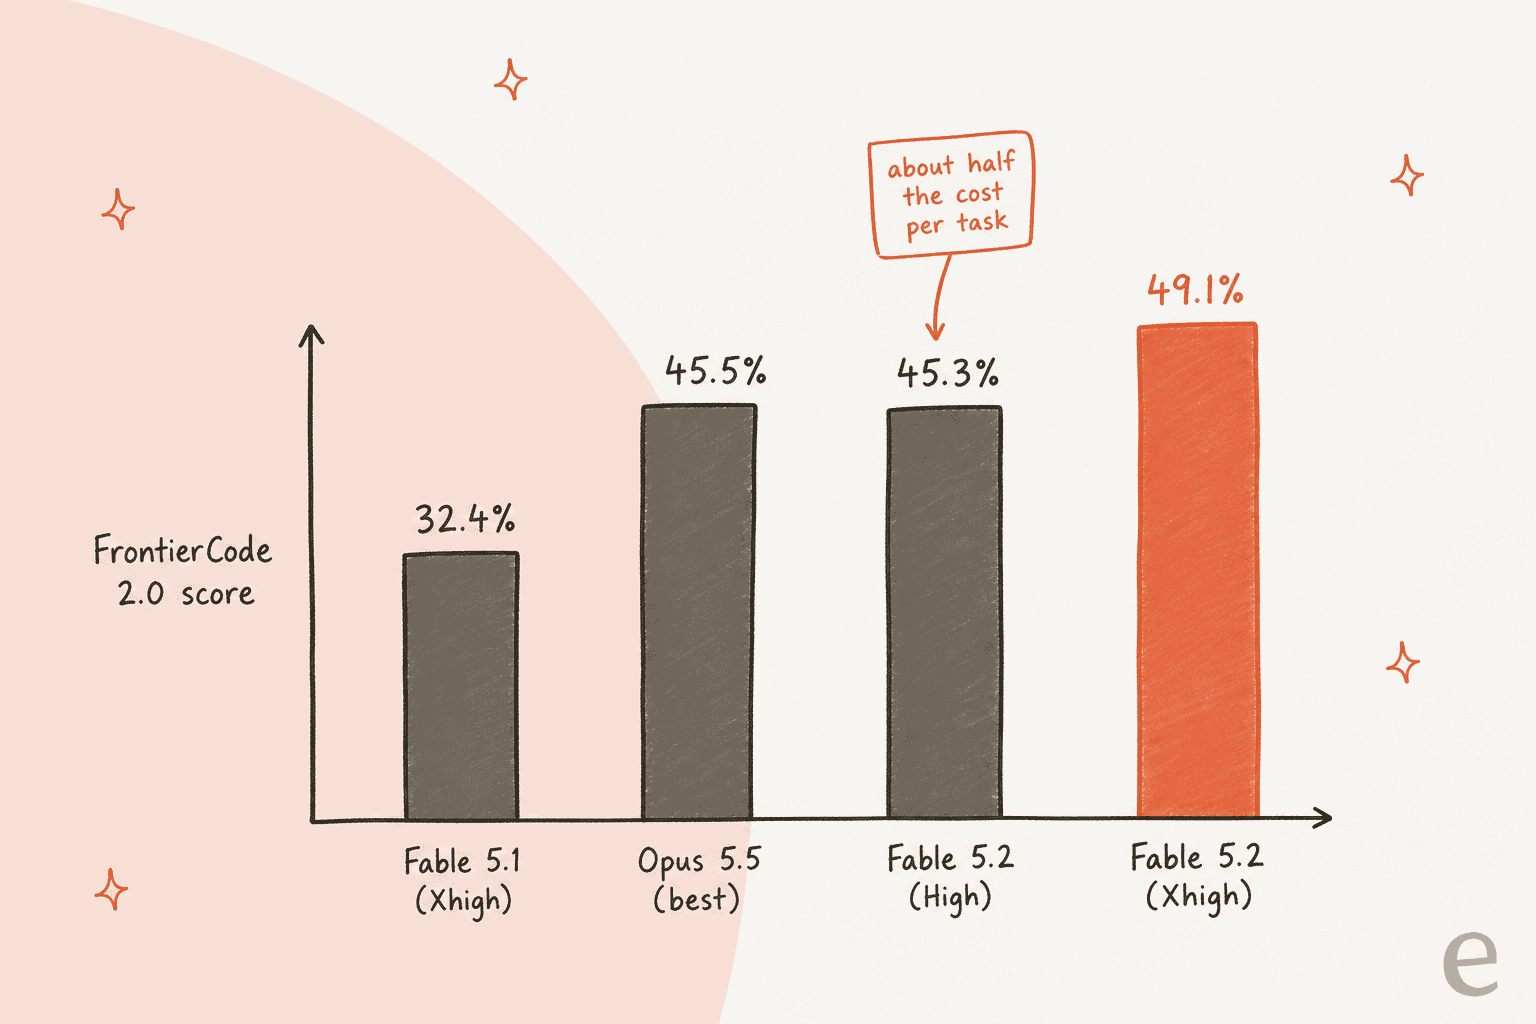
Beachten Sie, was das aussagt. Fable 5.2 schlägt Opus 5.5 bei diesem Coding-Test nicht meilenweit, bis Sie für Xhigh zahlen. Die ehrliche Zusammenfassung ist, dass es die Obergrenze anhebt und den Weg zum Opus-Niveau verbilligt, statt die alltägliche Arbeit radikal zu verbessern. Behandeln Sie all das als vom Anbieter selbst erhobene Zahlen: Anthropic hat sie mit aktivierten Schutzmechanismen erstellt, und ein skeptischer Kommentator wies darauf hin, dass die konkurrierenden Gemini-Werte ein anderes Testgerüst verwenden. Deshalb gewichte ich die Nutzerberichte unten stärker als die Tabelle.
Was sagen die Menschen, die es nutzen?
Der Launch-Thread auf Hacker News kam innerhalb eines Tages auf über 750 Punkte und 400 Kommentare. Die nützlichste Einschätzung, die ich gelesen habe, kam von jemandem, der es bereits genutzt hatte:
"Fable is good, but you really have to push the ambition of your prompt in order to see proper separation from Opus 5.5. I personally have a hard time telling the difference between Fable 5.2 and Opus 5.5 for ordinary coding tasks."
Derselbe Kommentator sagte, Fable 5.2 sei "way faster and more reliable" als 5.1, das früher an Max-Output-Token-Überläufen scheiterte. Das passt zu Anthropics Behauptung von bis zu 30% schnelleren Ausgaben und zum Zitat eines Cognition-Ingenieurs, dass es "says it doesn't know things instead of hallucinating."
Die schärfste Warnung betrifft Subagenten. Anthropics eigene Migrationshinweise sagen, dass Fable 5.2 bei xhigh- und max-Effort beobachtet wurde, wie es Subagenten einsetzt, um seine eigene Arbeit zu überprüfen, was Fable 5.1 nicht tat, und dass Subagenten einen großen Anteil der Kosten einer Session ausmachen können. Ein Nutzer hat das erlebt:
"Asked it to review a 80 kLoC codebase, something Opus does just fine, while asking it "max 4 subagents". Fable 5.2, like the well-aligned model it supposedly is, decided to spawn 6+ nested subagents, because these aren't subagents, apparently - resulting in 100% of 5hr usage being drained in less than 20min (on $100)."
Wenn Sie mit Claude-Code-Subagenten oder Multi-Agenten-Setups arbeiten, setzen Sie klare Grenzen und beobachten Sie die ersten Läufe genau. Anthropics eigene namentlich genannte Tester stehen am anderen Ende: Uber ließ ein 10- bis 12-stündiges Sicherheitsaudit laufen, das rund 170 Reviewer-Agenten einsetzte, und Oracle berichtete, dass es korrektes SQL erzeugte, wo zwei andere Modelle Beträge 5- bis 8-fach zu hoch summierten. Am Launch-Tag konnte ich keine brauchbaren Erstinformationen aus X- oder Reddit-Threads finden, daher ist das Community-Signal hier nur Hacker News.
Was bricht, wenn ich von Fable 5.1 migriere?
Anthropic nennt den Umstieg "weitgehend drop-in" und listet vier Breaking Changes:
- Die Präfixprüfung für Thinking-Blöcke gilt jetzt für jedes Konto. Wenn Ihr Code den System-Prompt, Tools oder frühere Nachrichten bearbeitet und dann alte Thinking-Blöcke zurücksendet, erhalten Sie einen 400er-Fehler. Bei Fable 5.1 betraf das nur Konten, die am oder nach dem 31. August 2026 erstellt wurden, ältere Konten haben das also möglicherweise nie erlebt.
- Fable 5.1 kann die Thinking-Blöcke von Fable 5.2 nicht lesen. Fable 5.2 liest die von 5.1, aber nicht umgekehrt, sodass ein Fallback von 5.2 auf 5.1 mitten im Gespräch dieses Reasoning verwirft und die Kosten erhöhen kann.
- Das alte Computer-Use-Tool,
computer_20251124, liefert überall außer bei Amazon Bedrock einen 400er-Fehler. Wechseln Sie zucomputer_toolset_20260801. - Ein Fable-5.2-Executor braucht einen Fable-5.2- oder Mythos-5.2-Advisor im Advisor-Tool. Ein 5.1-Advisor liefert einen 400er-Fehler.
Unverändert gegenüber 5.1 und wichtig zu wissen: Adaptives Thinking ist immer aktiv, Prefill und erzwungene Tool-Nutzung (tool_choice von any oder tool) liefern einen 400er-Fehler, und Sie sollten temperature, top_p und top_k weglassen. Fable 5.2 hat außerdem sein eigenes Rate-Limit, getrennt vom Pool, den sich Fable 5 und 5.1 teilen, prüfen Sie das also, bevor Sie Produktionstraffic umstellen. Eine weitere Verhaltensänderung: Prompt-Zeilen wie "answer directly without thinking" hindern es bei mittlerem Effort und höher nicht mehr am Denken, senken Sie stattdessen die Effort-Einstellung. Wenn Ihr max_tokens klein ist, kann Thinking alles davon aufbrauchen, bevor überhaupt Text erscheint.
Welches Modell sollte ich tatsächlich nutzen?
Anthropics eigener Rat ist, mit Opus 5.5 zu starten und je nach Umfang und Komplexität der Aufgabe zu Fable oder Mythos hochzugehen oder zu Sonnet 5.5 oder Haiku 5.5 herunterzugehen. Dem stimme ich zu, und ein HN-Kommentator hat zusammengefasst, warum sich der Standard verschoben hat:
"Anthropic is finally well balanced across models. Meaning: Opus 5.5 is so good that I do not feel Fable FOMO as I did when it was Fable 5/5.1 vs Opus 4.8/5."
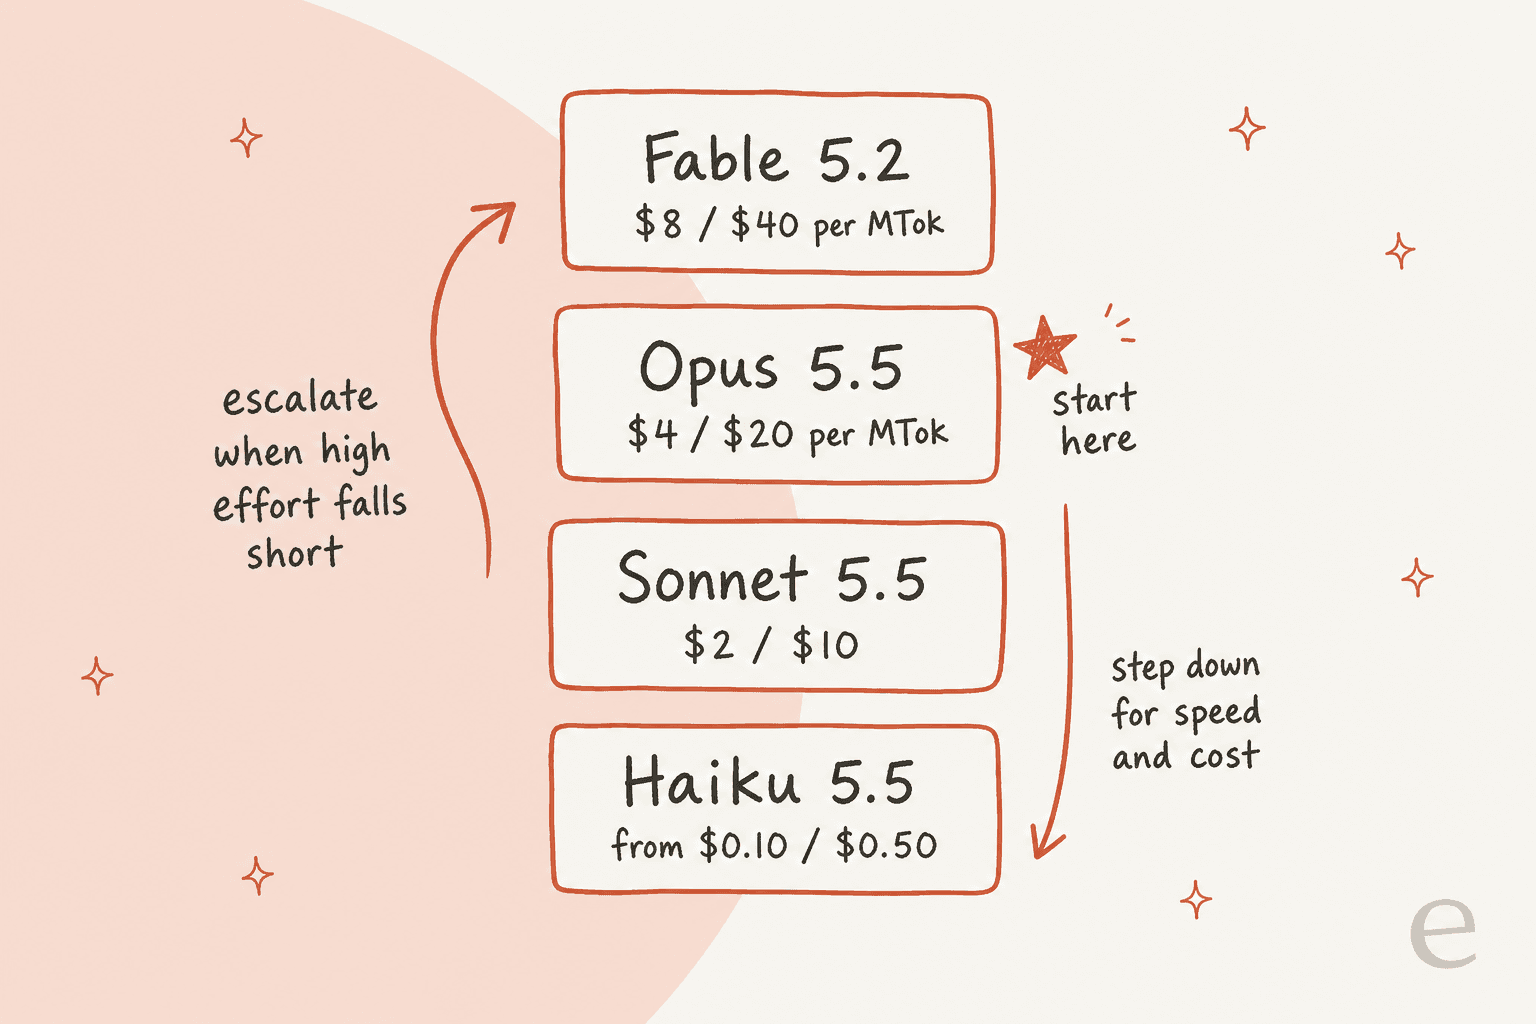
So würde ich es aufteilen:
- Sie nutzen heute Fable 5.1. Wechseln Sie, nachdem Sie den Präfixprüfungstest an Ihrem eigenen Request-Builder durchgeführt haben. Sie erhalten eine niedrigere Rechnung pro Token, schnellere Ausgaben und bessere Werte für eine einzige Modell-ID-Änderung.
- Sie nutzen Opus 5.5, und es funktioniert. Bleiben Sie dabei. Die Preislücke beträgt das 2-Fache pro Token, und Opus 5.5 wurde gut bewertet, auch für sich genommen. Im Opus-5.5-Preisleitfaden erfahren Sie, wie sich der Effort-Regler auf die Rechnung auswirkt.
- Ihre Opus-5.5-Evals mit hohem Effort reichen immer noch nicht aus. Das ist genau der Fall, für den Fable 5.2 gebaut wurde: mehrstündige Agentenläufe, Tiefenrecherche, Arbeit, die bis zum fertigen Dokument, zur Tabelle oder zur Präsentation getragen wird.
- Sie nutzen Claude Code im Abo. Probieren Sie Fable 5.2 mit mittlerem Effort und beobachten Sie Ihre Nutzung. Meine Hinweise zur Claude-Code-Modellauswahl decken die Trade-offs ab.
- Sie entscheiden sich zwischen Anbietern. Vergleichen Sie mit GPT-6 Sol und GPT-6 Astra an Ihren eigenen Aufgaben, und lesen Sie den früheren Vergleich Opus 5 versus Fable 5 dazu, wie sich die Familie verschoben hat.
- Sie wollen einen Support-Agenten oder Content-Autor. Sie kaufen auf der falschen Ebene ein, was der nächste Abschnitt behandelt.
Ich sollte offen sagen, was diese Rezension ist: Ich habe Anthropics Launch-Beitrag, Modellseite, Preis- und Migrationsdokumentation gelesen, plus die öffentliche Diskussion auf Hacker News. Ich habe keine eigene Produktionslast damit gefahren, wo ich also eine Empfehlung gebe, stammt sie aus diesen Quellen, nicht aus einem eigenen Benchmark.
Ist ein Modell dasselbe wie ein Teammitglied?
Nein, und das ist der Blickwinkel, den die meiste Berichterstattung über Fable 5.2 ausspart. Das Modell ist Infrastruktur. eesel ist der Mitarbeiter. Ein Spitzenmodell hat keine Ahnung, was Ihr Produkt macht, kann Ihr Help Center oder Ihre letzten 10.000 Tickets nicht sehen und hat keine Integration in Ihren Helpdesk. Sie stellen kein Modell ein, Sie stellen ein einsatzbereites Teammitglied für eine bestimmte Aufgabe ein.
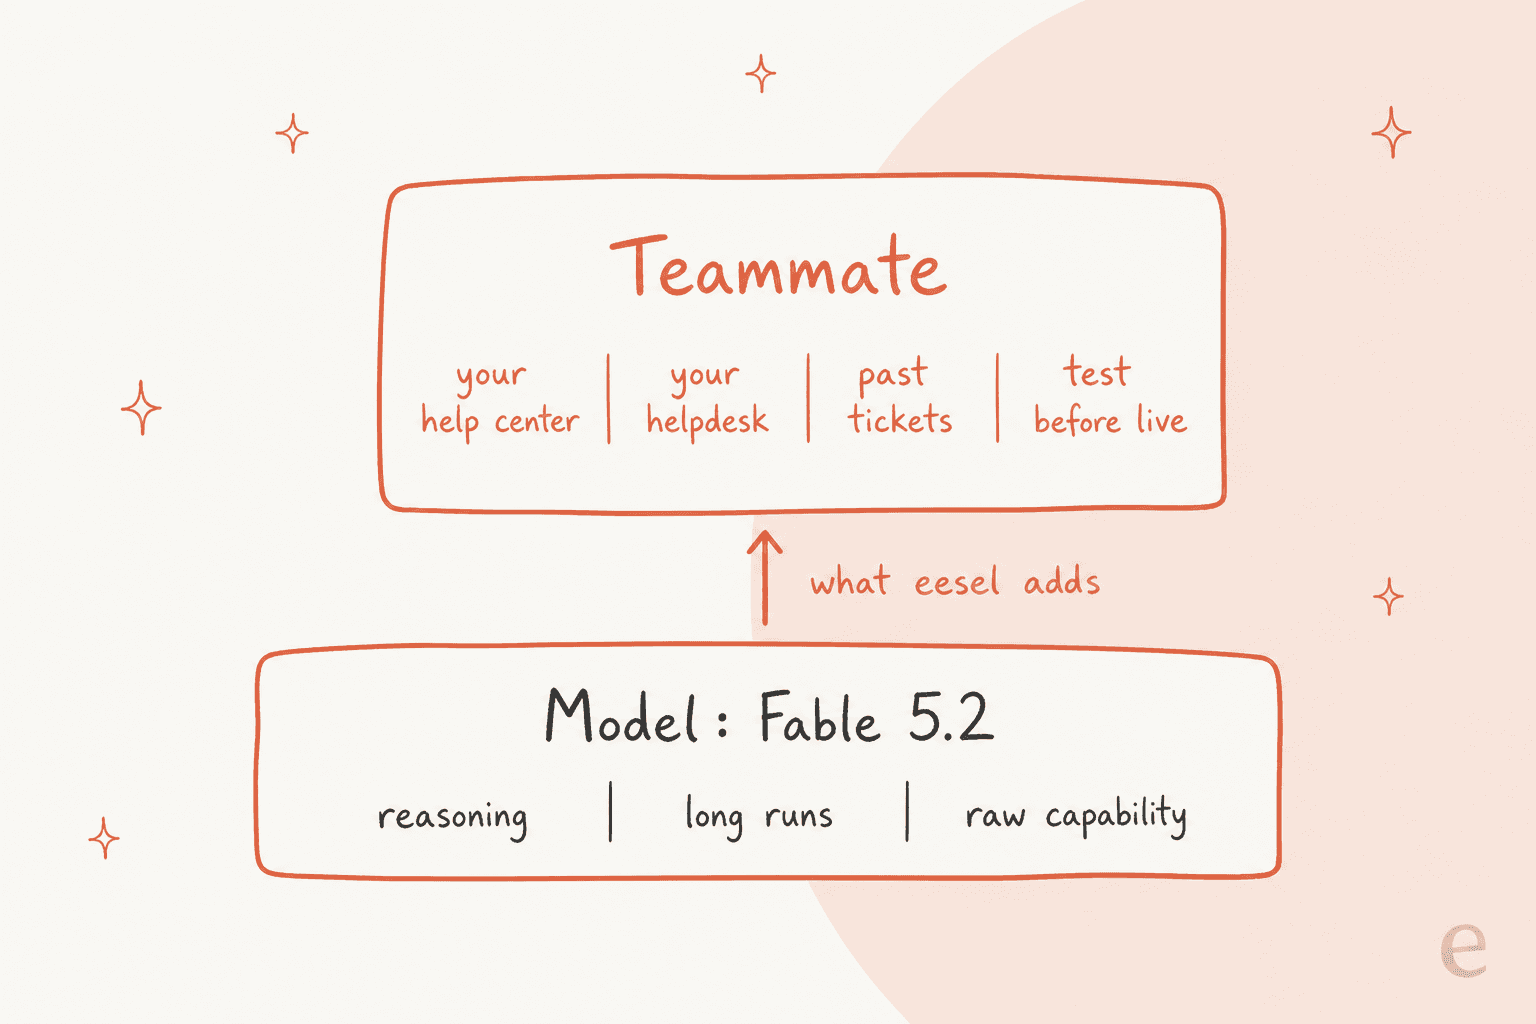
eesels aktuelles Aufgebot ist ein KI-Helpdesk-Teammitglied, das sich in Ihre bestehende Support-Warteschlange einfügt, und ein KI-Blog-Autor für Content. Jedes kommt mit den Fähigkeiten, Integrationen und dem Unternehmenskontext, den seine Aufgabe braucht. Leser, die der breiteren Idee der KI-Teammitglieder folgen, werden die Aufteilung wiedererkennen: Das Modell ändert sich jedes Quartal, die Stellenbeschreibung nicht.
Der Beweis liegt darin, wie echte Teams es betreiben. SE Ranking betreibt drei Produkte auf Zendesk mit je einem eesel-Agenten pro Produkt, und in einem Monat (8. August bis 8. September 2026) bearbeiteten die Agenten 4.650 Unterhaltungen: 2.554 Zendesk-Tickets und 2.102 Live-Chats, mit Antworten aus rund 16.800 Seiten an Wissen. SamCart nutzt separate Agenten für Freshdesk-Tickets und Website-Chat, jeweils mit eigenem Tonfall. Keines davon hing davon ab, Fable statt Opus zu wählen. Es hing davon ab, dass der Agent zuerst im Help Center sucht, Rückerstattungen und schwierige Fälle an eine Person weitergibt und im Helpdesk messbar ist. Genau das hält auch die KI-Lösungsrate ehrlich und verhindert KI-Halluzinationen im Support.
Die eesel CLI ist dort, wo ein Spitzenmodell wie Fable 5.2 für dieses Teammitglied nützlich wird. Ein Coding-Agent wie Claude Code kann denselben Workspace vom Terminal aus steuern: exportierte Hilfeartikel und Makros hochladen, die Anweisungen des Agenten anpassen und Testfragen stellen, um die Antworten zu prüfen, bevor sie einen Kunden erreichen. Die Helpdesk-Verbindung selbst braucht weiterhin die Freigabe einer Person mit Admin-Zugriff, und hochgeladenes Wissen ist erst "bereit", wenn die Testantworten richtig aussehen. Wenn Sie das größere Bild sehen möchten, lesen Sie Claude für den Kundensupport, die besten KI-Kundensupport-Agenten und die Kostenperspektive in KI-Kundenservice-Kosten.
eesel testen
Wenn die eigentliche Frage hinter Ihrer Fable-5.2-Recherche lautet "welches Modell sollte meinen Support betreiben", ist die bessere Frage, welches Teammitglied Sie einstellen sollten. eesel klinkt ein KI-Helpdesk-Teammitglied in Ihre Zendesk-, Freshdesk- oder Gorgias-Warteschlange ein, lernt aus Ihrem Help Center und vergangenen Tickets und lässt Sie es an historischen Tickets simulieren, bevor es einem echten Kunden antwortet. Entwickler, die das aus dem Code heraus steuern möchten, können die eesel CLI nutzen, und das darunterliegende Modell kann sich ändern, ohne dass Sie irgendetwas neu bauen müssen. Sie können eesel kostenlos testen.
Häufig gestellte Fragen
Lohnt sich Claude Fable 5.2?
Wie viel kostet Claude Fable 5.2?
Was ist die Claude Fable 5.2 Modell-ID?
claude-fable-5-2 auf der Claude API, Microsoft Foundry und Google Cloud, und anthropic.claude-fable-5-2 auf Amazon Bedrock. Claude Mythos 5.2 ist dasselbe Modell mit leichteren Schutzmechanismen, unter der ID claude-mythos-5-2.