

IBM Granite 4.2 ist IBMs offene Reasoning-Modellfamilie, erschienen am 25. August 2026 in drei Größen (3B, 8B, 30B), alle unter der freizügigen Apache-2.0-Lizenz. Die größte Änderung gegenüber Granite 4.0 ist natives „Thinking“-Reasoning direkt im Modell, mit drei umschaltbaren Modi (volles Thinking, Non-Thinking und Low-Effort) und deutlich stärkerem Tool-Calling.
Lohnt es sich? Das hängt davon ab, was Ihnen wichtig ist:
- Sie wollen vertrauenswürdige, lizenzierbare On-Prem-KI: ja. Signierte Gewichte, eine Top-Bewertung beim Stanford-Transparenzindex und Apache 2.0 machen Granite zur sicheren Enterprise-Wahl, und die kleinen Modelle laufen schnell auf Standardhardware.
- Sie wollen den besten Rohwert für Coding oder Agenten: wahrscheinlich nicht. Die Local-LLM-Szene greift bei reiner Leistung weiterhin zu Qwen, und IBM vergleicht sich meist mit sich selbst.
- Sie wollen einen fertigen Support-Agenten: das ist die falsche Ebene. Granite ist eine Engine, kein KI-Helpdesk-Teammate. Retrieval, Guardrails und Tests müssen Sie selbst darauf aufbauen.
Der günstigste Weg zum Ausprobieren: Es ist kostenlos selbst hostbar unter Apache 2.0 (das 3B-Modell ist ein 2,2-GB-Download über Ollama). Als gehostete API betreibt Replicate das 8B-Modell für $0.06/$0.25 pro Million Tokens.
Worauf ich bei einem offenen Modell wie Granite 4.2 achte
Kurz zum Kontext, aus dem ich komme. Ich baue bei eesel KI-Agenten, und wir bringen seit Jahren KI in echte Support-Warteschlangen. Deshalb lese ich einen Modell-Launch anders als jemand, der Benchmarks jagt. Ein hoher AIME-Wert ist schön. Mich interessiert, ob ein Modell Anweisungen befolgt, die es nicht mag, das richtige Tool aufruft, ohne eines zu erfinden, bei einer Wissensdatenbank bleibt und sich bei Ticket Nr. 4.000 genauso verhält wie in der Demo. Wir haben erlebt, wie überzeugend klingende Modelle stillschweigend falsche Antworten geben. Genau deshalb simulieren wir jeden Rollout anhand historischer Tickets, bevor er einen Kunden erreicht.
Dieser Test betrachtet Granite 4.2 also durch diese Brille: was sich tatsächlich geändert hat, wo die Benchmarks ehrlich liegen, was der Betrieb kostet und für wen es passt.
Was sich in Granite 4.2 geändert hat
Die Kurzfassung: Granite 4.2 bringt natives Reasoning. Während Granite 4.0 ein schnelles, effizientes Instruct-Modell war, kann 4.2 planen, sich selbst korrigieren und vor der Antwort in <think>...</think>-Tags Schritt für Schritt nachdenken. Das hilft am meisten bei Mathematik, mehrstufiger Logik und, was mich besonders interessiert, bei der Entscheidung, welches Tool aufgerufen wird und warum.
Das Clevere daran: Das Reasoning lässt sich in einem einzigen Modell umschalten, sodass Sie nicht für Chain-of-Thought bei Fragen zahlen, die es nicht brauchen:
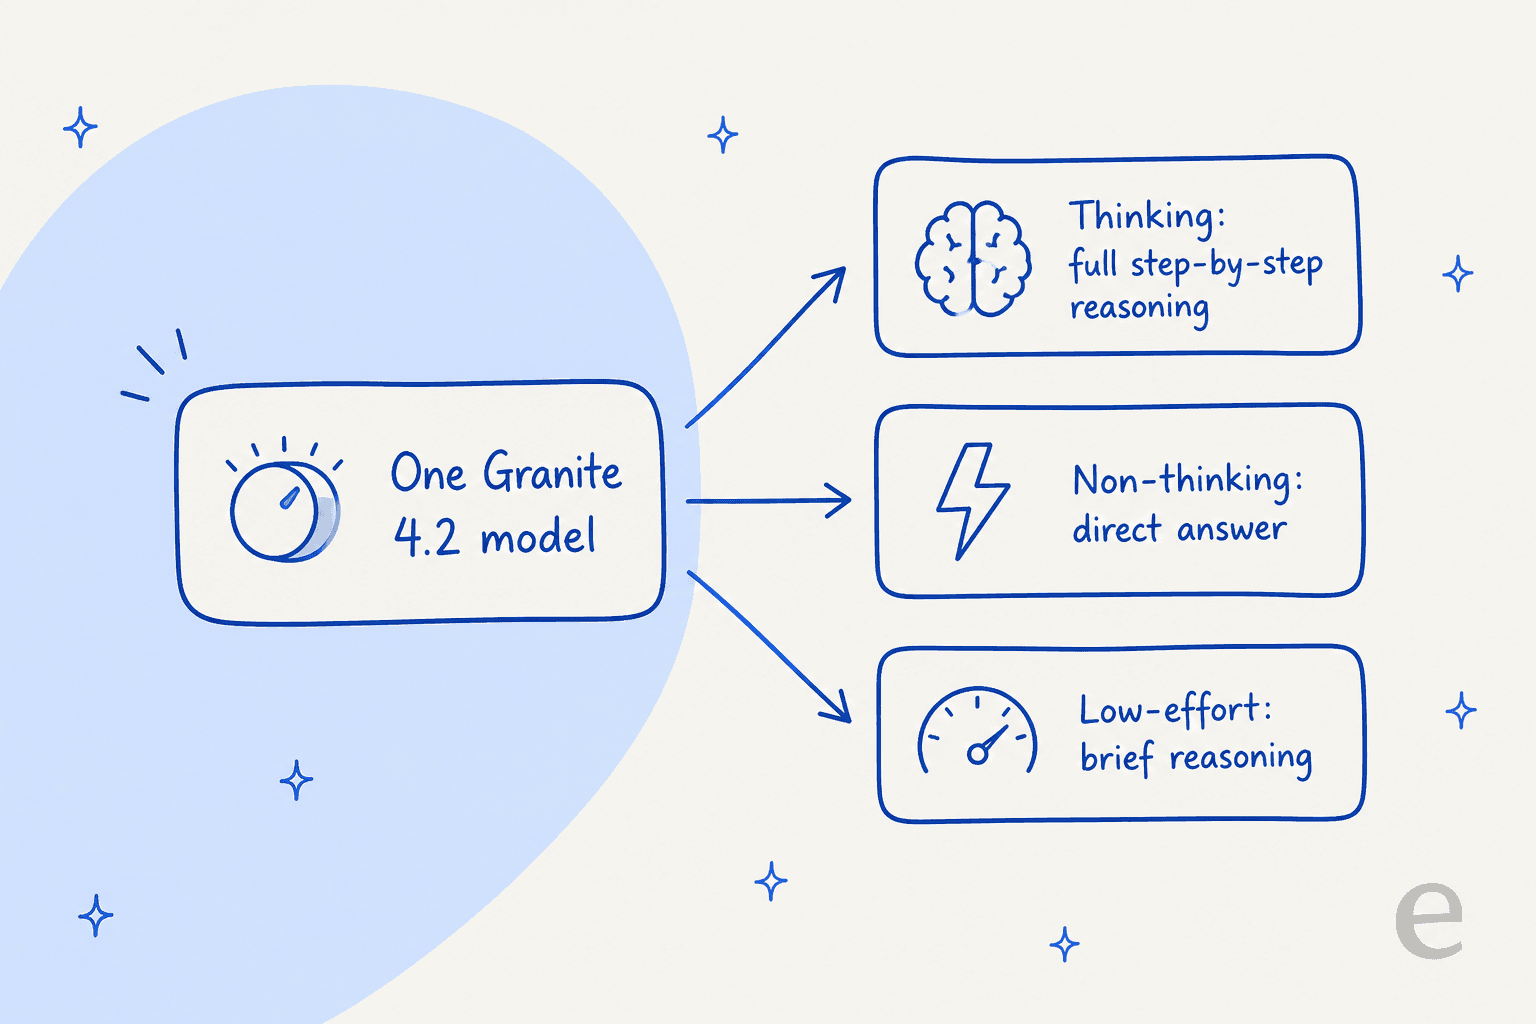
- Thinking (Standard) liefert volles Chain-of-Thought.
- Non-Thinking überspringt das Reasoning komplett für eine direkte Antwort, was bei hohem Volumen zählt, wenn Sie Latenz oder Token-Kosten sparen wollen.
- Low-Effort denkt kurz nach, für einfachere Anfragen, ein mittlerer Gang.
In Ollama wechseln Sie mit /set think und /set nothink zwischen den Modi, ein schöner Zug für alle, die Kosten und Qualität je Anwendungsfall abstimmen.
Auch bei der Architektur gibt es etwas zu erzählen, und es lohnt sich, darauf hinzuweisen, weil es gegen den Trend läuft. Granite 4.0 nutzte ein hybrides Mamba-2/Transformer-Design mit einem Mixture-of-Experts für Speichereffizienz. Granite 4.2 ist ein schlichter dichter Decoder-only-Transformer. IBMs Begründung lautet: „its dense architecture supports broad compatibility“, was ein echtes Argument ist, wenn Sie auf gemischter Hardware und unterschiedlichen Serving-Stacks einsetzen. Es heißt auch, dass die Parameterzahl in der Überschrift das ganze Modell ist, ohne Taschenspielertrick bei aktiv gegenüber gesamt.
Zum Abschluss der Veröffentlichung: Der mehrsprachige Dialog wurde in 12 Sprachen getestet, und IBM hat zwei winzige Granite Speech 5.0 Turbo-Transkriptionsmodelle (470M Parameter) neben den LLMs für Audio am Edge veröffentlicht.
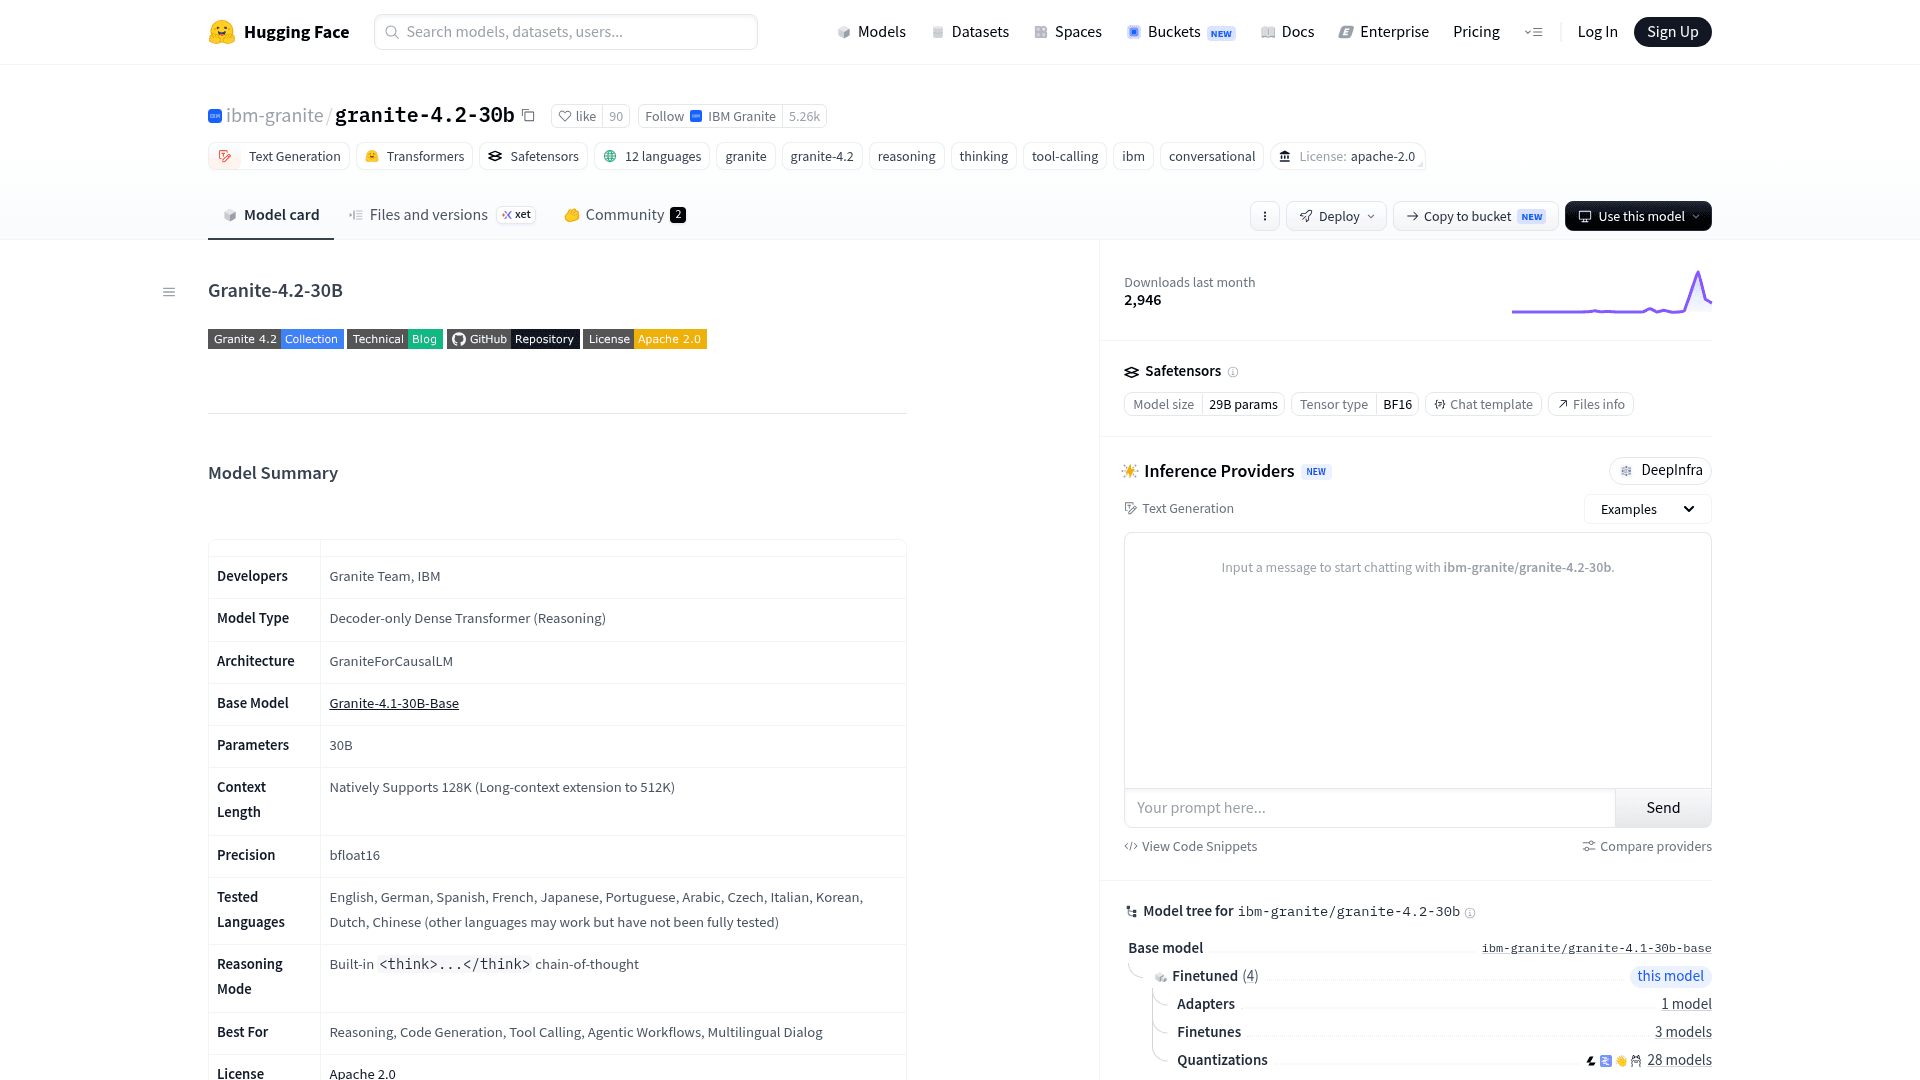
Die drei Modelle: 3B, 8B und 30B
Granite 4.2 besteht aus genau drei dichten Modellen, jeweils nachtrainiert aus der passenden Granite-4.1-Basis. Alle verarbeiten nativ einen Kontext von 128K Tokens, das 30B-Modell erweitert auf 512K.
| Modell | Parameter | Schichten | Kontext | Ollama-Download | Am besten für |
|---|---|---|---|---|---|
| granite-4.2-3b | 3B dicht | 40 | 128K / 512K | 2,2 GB | Edge, Laptops, günstige Aufgaben mit hohem Volumen |
| granite-4.2-8b | 8B dicht | 40 | 128K / 512K | 5,3 GB | Ausgewogenes Allzweck-Arbeitspferd |
| granite-4.2-30b | 30B dicht | 64 | 128K / 512K | 18 GB | Flaggschiff für Reasoning und agentische Aufgaben |
IBM liefert zudem offizielle Quantisierungen (fp8, mxfp4, nvfp4) für jede Größe, dazu Community-GGUF-Builds für llama.cpp und LM Studio. Gut zu wissen: Die Modellkarten empfehlen ausdrücklich, Granite zusammen mit Granite Guardian 4.1 8B zu betreiben, einem separaten Sicherheitsmodell zur Risikoerkennung. Das Label „4.2“ gilt nur für die drei Sprachmodelle; Vision, Guardian und Speech haben eigene Versionslinien.
Benchmarks: Wo Granite 4.2 tatsächlich liegt
Hier IBMs eigener Kernvergleich, das 30B-Modell gegen Nvidias Nemotron 3 Super 120B und Googles Gemma 4 31B:
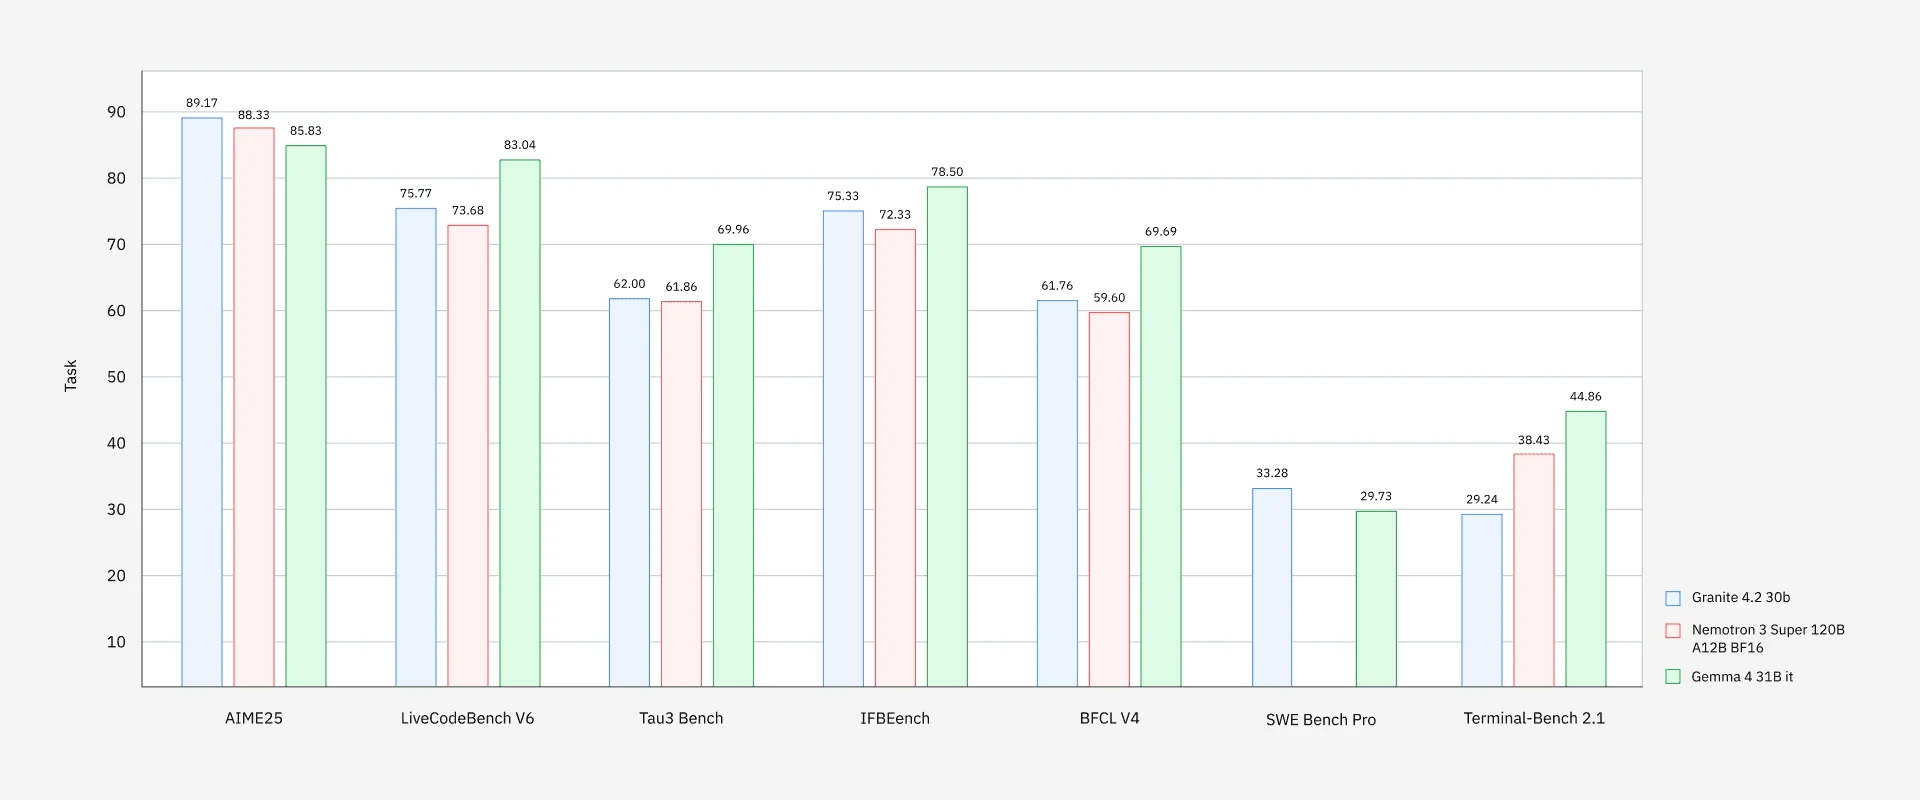
Die Geschichte, die IBM erzählen will, stimmt: Bei AIME25 erreicht das 30B-Modell 89.17 und übertrifft knapp ein Nemotron-Modell mit 120B Parametern; auch bei LiveCodeBench, IFBench und BFCL liegt es vorn. „Konkurrenzfähig mit größeren Thinking-Modellen zu einem Bruchteil der Kosten“ ist eine faire Zusammenfassung dieser Grafik.
Die ehrlichen Einschränkungen sind genauso wichtig:
- Beim anspruchsvollsten agentischen Coding kippt das Bild. Gemma 4 31B schlägt Granite sowohl bei SWE-Bench Pro als auch bei Terminal-Bench 2.1. Die rohen Coding-Agent-Werte (33.29 bei SWE-Bench Pro, 29.24 bei Terminal-Bench) sind für die Größe ordentlich, aber nicht kategorieführend.
- IBM vergleicht sich mit einer sorgfältig gewählten Gruppe. Es ist trotzdem IBM, das den Vergleich auswählt. Wie es ein Hacker-News-Kommentator beim 4.1-Launch ausdrückte:
"No comparison with competitor models other than the previous granite version strongly implies that it does not compete well with other comparable models. At least this is the most reasonable assumption until data comes out to the contrary."

Bei den Zahlen, die mir für die Support-Automatisierung wichtig sind, fällt das Bild ermutigend aus: Das 30B-Modell erreicht 62.00 bei tau3-bench (agentische Tool-Nutzung), 61.39 bei BFCL v4 (Function Calling) und 77.60 bei MMLU-Pro. Das sind die Muskeln für Tool-Calling und Anweisungsbefolgung, auf die sich ein Support-Agent tatsächlich stützt, und das 8B-Modell liegt nah genug (52.39 BFCL, 74.04 MMLU-Pro), um für kostensensible Einsätze interessant zu sein.
Wie die Schleife aus Reasoning und Tool-Calling funktioniert
Das nützlichste Upgrade für alle, die Agenten bauen: Granite 4.2 überlegt sich Tools, bevor es sie aufruft. Statt nur einen Funktionsnamen per Mustervergleich zu treffen, denkt das Modell durch, welches Tool passt und warum, und führt dann den Aufruf aus. Das ist der Unterschied zwischen einem Agenten, der zuverlässig eine Bestellung nachschlägt, und einem, der eine nicht existierende Funktion erfindet.
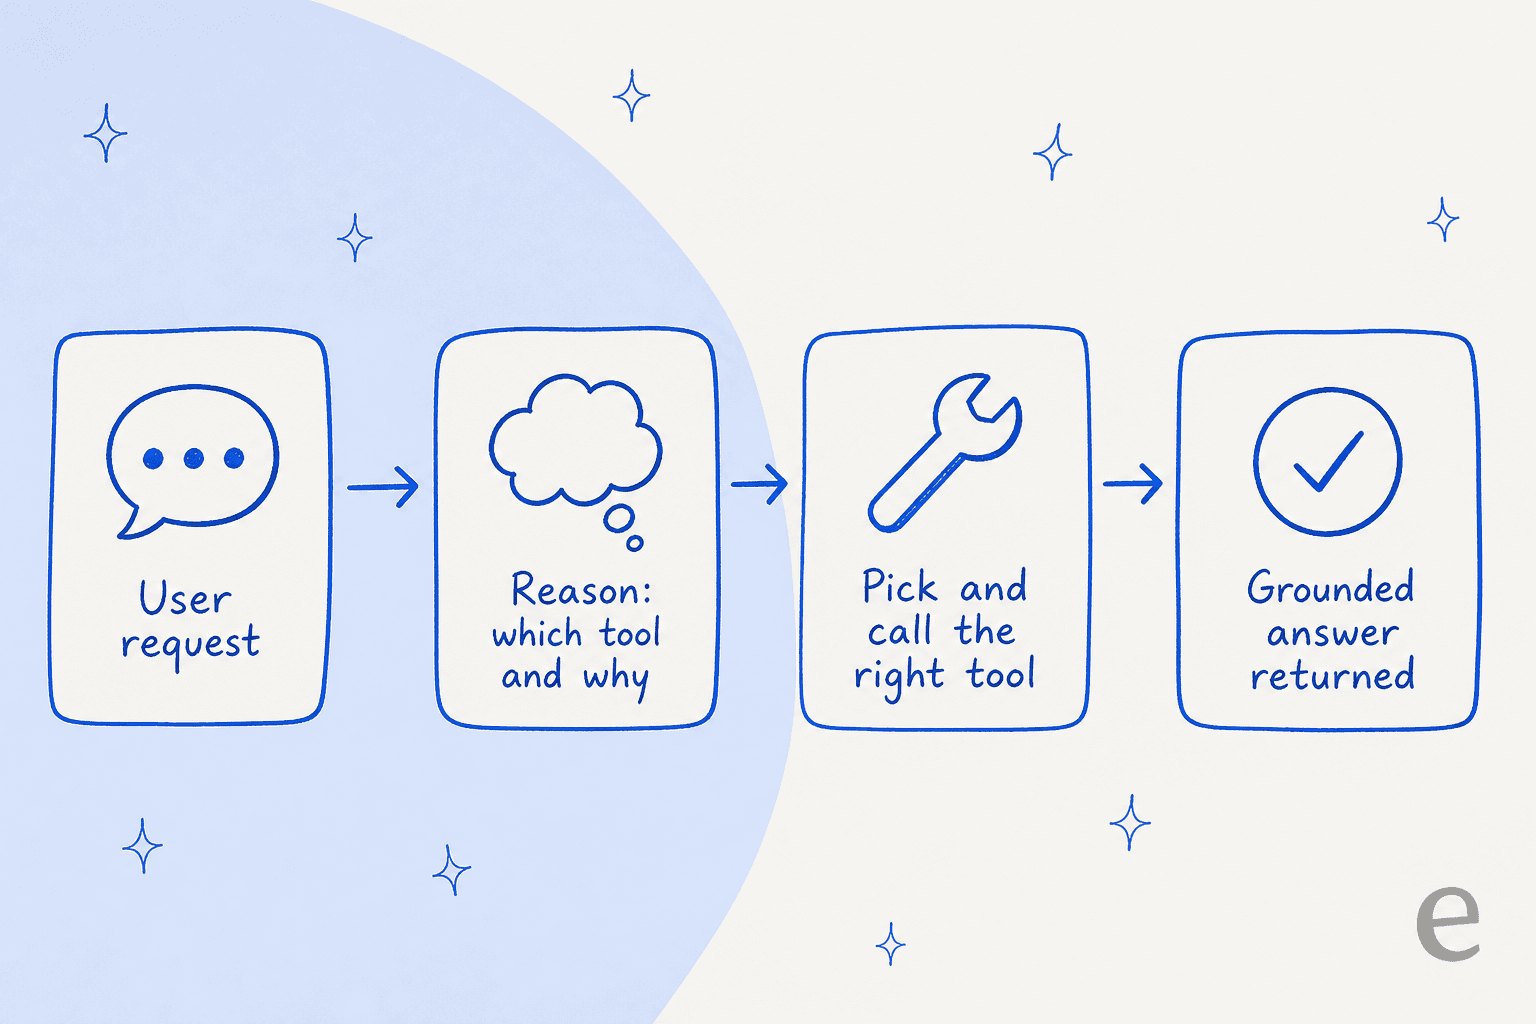
Es wird über eine OpenAI-kompatible API bereitgestellt und funktioniert sofort mit agentischen Coding-Harnesses wie OpenCode und OpenHands. Die Community-Einschätzung stützt das Design: Granites kleine Modelle sind bei strukturierter Arbeit still und leise gut.
"IBM Granite 4H-Small, it's very good with tool calls. most tool-calling issues come from the model not sticking to the exact structure you"

Auf dieser Ebene trifft die Modellwahl auf ein echtes Produkt. Zuverlässiges Tool-Calling unterscheidet einen KI-Agenten von einem regelbasierten Chatbot, und es lässt einen Agenten eine Bestellung nachschlagen, ein Ticket taggen oder eine Erstattung auslösen, statt nur einen plausiblen Satz darüber zu tippen.
Zugang und Preise
Hier wird Granite attraktiv: Weil es Apache 2.0 ist, liegt die Untergrenze bei null. Sie können es herunterladen, feintunen und produktiv einsetzen, ohne Lizenzgebühr und ohne Kosten pro Token über die Rechenleistung hinaus, auf der Sie es betreiben. Es gibt drei praktische Wege, die an Komfort und Kosten zunehmen:
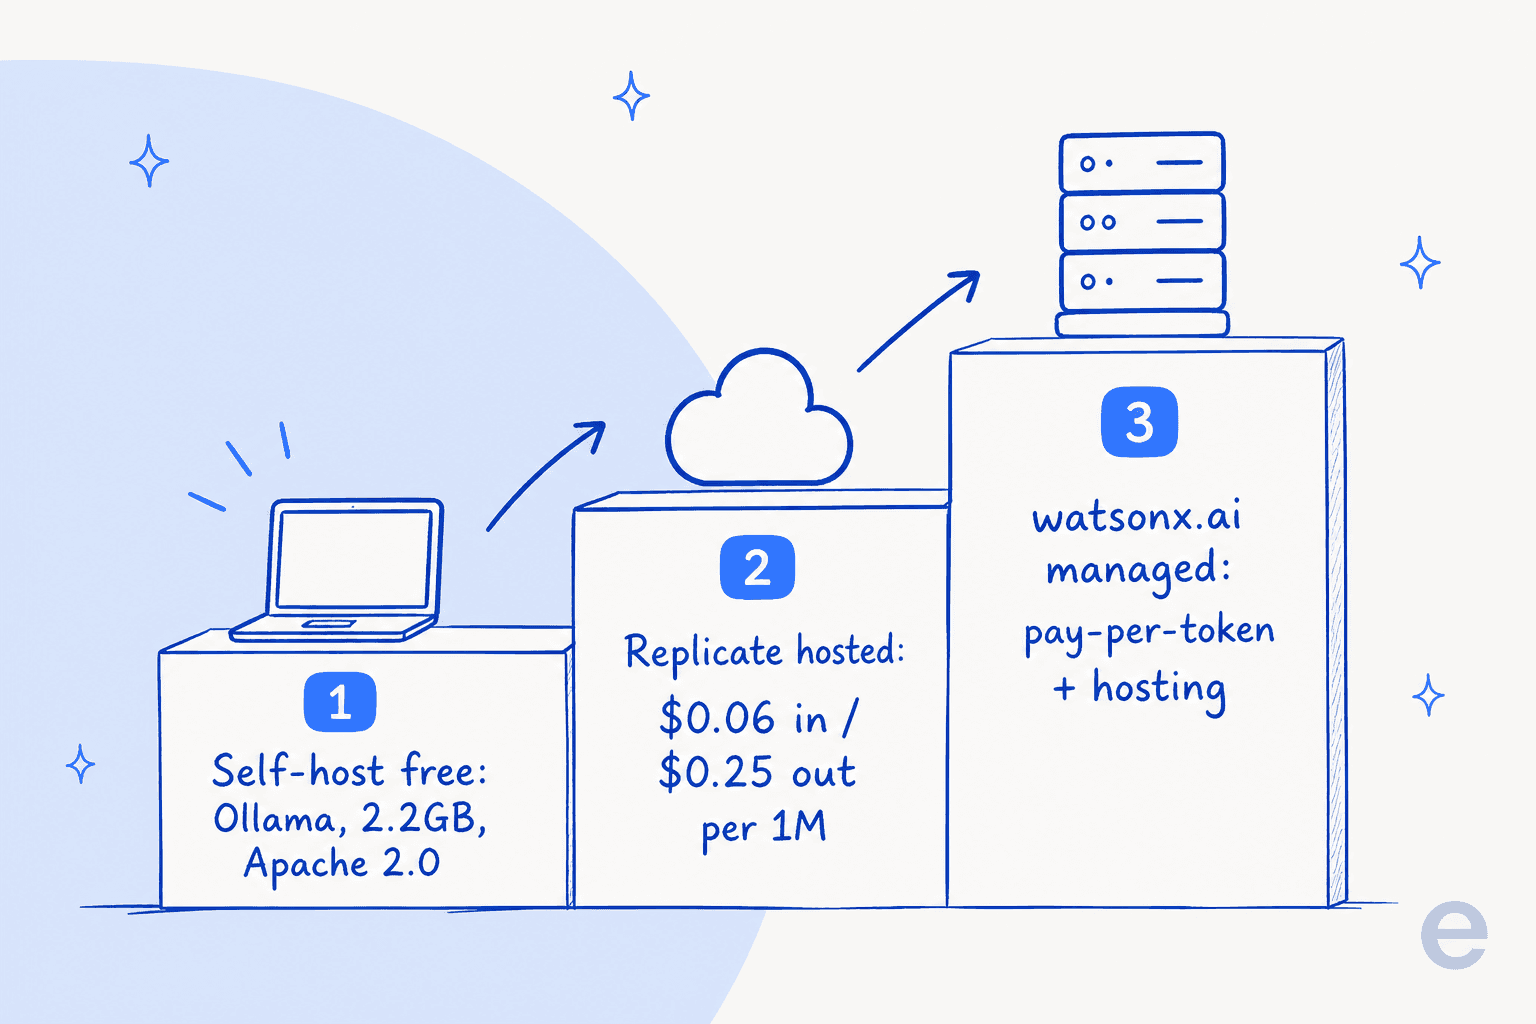
| Weg | Preis | Hinweise |
|---|---|---|
| Self-Hosting (Ollama, vLLM, llama.cpp) | Kostenlos (Ihre Rechenleistung) | 3B läuft auf einem Laptop; 30B braucht ~18 GB+ VRAM |
| Replicate gehostete API | $0.06 / 1M Input, $0.25 / 1M Output | ~$0.0014 pro typischem Lauf; nur 8B, bestätigt |
| watsonx.ai | Pay-per-1M-Tokens + stündliches Hosting | Standard-Plan ~$1,050/Monat; IBMs verwaltete Plattform |
Zwei ehrliche Anmerkungen. Erstens ist IBMs eigenes watsonx.ai der Enterprise-Weg, und sein Preismodell (Pay-as-you-go pro Million Tokens, wobei historisch 1 Resource Unit = 1.000 Tokens, plus stündliches On-Demand-Hosting) ist bestätigt, aber die Preistabelle in der Live-Dokumentation lieferte beim Prüfen einen 500-Fehler, sodass ich die genaue Granite-4.2-Position nicht festnageln konnte. Der nächste bestätigte Granite-4-Tarif liegt bei etwa $0.06 pro Million Input und $0.27 Output. Zweitens waren die 4.2-Modelle zum Zeitpunkt des Schreibens noch nicht auf OpenRouter gelistet, das weiterhin nur Granite 4.1 8B und 4.0 Micro zeigte.
Hier der kostenlose Weg in Aktion auf Ollama, womit die meisten es ausprobieren werden:
Eine Falle, die die Community schnell entdeckte: Die Download-Größe verschleiert den Speicherbedarf. Ein Thread auf r/LocalLLaMA meldete, dass das 8B-Modell über seinen Footprint hinaus anwächst:
"I downloaded the 5.3 GB Granite 4 8b model from Ollama library, but when I run the model, it bloats up to 27 GB, and won't fit onto the GPU VRAM"
Das ist die Zuweisung von KV-Cache und Kontext, und man sollte sie normal einplanen. Wer aber eine GPU nach der Download-Größe dimensioniert, steht zu knapp da. Planen Sie Reserve ein, besonders bei langem Kontext.
Was die Community wirklich denkt
Die Stimmung zu Granite 4.x ist einheitlich und, wie ich finde, richtig. Das Lob konzentriert sich genau auf das, wofür IBM es gebaut hat: Die kleinen Modelle laufen schnell auf Standardhardware, haben aktuelle Trainingsdaten und eine uneingeschränkte kommerzielle Lizenz.
"I test drove it yesterday. It's pretty impressive at 8b. Runs on commodity hardware quickly... Granite has recent training data which is nice."
Die Kritik ist ebenso einheitlich: Bei der Rohleistung, besonders beim Coding, greifen die Leute weiterhin zu Qwen.
"Granite 8B is impressive, but Qwen still wins on raw capability, especially for coding."
Und ein Kommentator auf X traf die Positionierung besser als IBMs eigenes Marketing: Granite konkurriert über Vertrauen, statt eine Bestenliste anzuführen.
"IBM just released a model built to need less of your trust, not more of your capability. Granite 4.2 ships in 3, 8, and 30 billion parameter sizes, fully open under Apache 2.0. It's trained specifically for tool use, terminal work, and multistep agent tasks."
Das ist ehrlich gesagt der ganze Test in einem Absatz. Granite 4.2 will nicht das klügste Modell sein, das Sie betreiben können. Es will das sein, das Ihre Security- und Rechtsabteilung freigibt: signierte Gewichte, ISO-Zertifizierung, eine Top-Bewertung beim Stanford-Transparenzindex und eine Lizenz, die Sie nicht einengt. Für ein reguliertes Unternehmen, das domänenspezifische Modelle On-Prem aufsetzt, ist diese Kombination mehr wert als zwei Punkte bei einem Coding-Benchmark.
Wo Granite 4.2 für Support- und KI-Teams passt
Sollte sich ein Support- oder Ops-Team dafür interessieren? Ja, aber man sollte klar sein, was man da in der Hand hält. Granite 4.2 ist Infrastruktur, eine Engine. Für sich allein ist es kein Kundenservice-Agent, so wenig wie ein V8 ein Auto ist.
Wenn Sie ein ML-Team haben und maximale Kontrolle wollen (Daten, die Ihre VPC nie verlassen, ein auf Ihren Tickets feingetuntes Modell, keine Token-Rechnung im großen Maßstab), ist Self-Hosting eines offenen Modells wie Granite ein echter und zunehmend beliebter Weg. Das 8B-Modell ist ein sinnvoller Startpunkt für die Kundenservice-Automatisierung: gutes Tool-Calling, günstig im Betrieb, lizenzierbar. Den Rest bauen Sie dann selbst: Retrieval über Ihr Help Center, Eskalationslogik, Guardrails gegen Halluzinationen, eine Möglichkeit zur Messung der Lösungsquote und einen sicheren Weg zum Testen vor dem Go-live.
Dieses „Den Rest selbst bauen“ ist die ganze Arbeit, und es ist der Teil, den Modelltests überspringen. Das Modell auszuwählen sind vielleicht 10 % dessen, was nötig ist, um einen Support-Agenten auszuliefern, der Tier-1-Tickets tatsächlich abfängt, ohne alles schlimmer zu machen. Die anderen 90 % sind Infrastruktur, Tests und operative Sicherheit, woran die meisten Eigenprojekte scheitern.
eesel testen: die Schicht, die Granite nicht liefert
Wenn Ihr Ziel ein funktionierender Support-Agent ist und kein Modell zum Draufbauen, füllt eesel genau diese Lücke. Granite gibt Ihnen eine Engine. eesel ist der einsatzbereite KI-Helpdesk-Teammate, der die Engine bereits hat, plus alles drumherum: Er lernt aus Ihren vergangenen Tickets und Ihrem Help Center, bindet sich in den Helpdesk ein, den Sie bereits nutzen (Zendesk, Freshdesk, Gorgias und über 1.000 weitere Integrationen), und steigt in Minuten statt Quartalen in die Warteschlange ein.

Der Unterschied ist das, was ich eingangs als wichtig bezeichnet habe: Bevor eesel einem einzigen echten Kunden antwortet, können Sie es an Tausenden Ihrer historischen Tickets simulieren, um genau zu sehen, wie es geantwortet und was es gelöst hätte. Das ist das Sicherheitsnetz, das ein reines Modell, ob Granite oder ein anderes, nicht mitbringt. Ein Kunde, Global Pay, berichtete von bis zu 80 % Zeitersparnis damit.
Nutzen Sie Granite 4.2, wenn Sie bauen. Nutzen Sie einen KI-Helpdesk-Teammate, wenn Sie Tickets beantworten wollen. Sie können eesel testen kostenlos, ohne Kreditkarte und ohne Verkaufsgespräch zum Start.