

IBMs Granite 4.2 ist eine wirklich gute Open-Weight-Familie: drei kleine Reasoning-Modelle (3B, 8B, 30B), Apache 2.0, umschaltbares Thinking und günstig im Betrieb. Die meisten suchen aus einem von drei Gründen nach einer Alternative: Sie wollen mehr reine Leistung (meist fürs Coding), sie wollen es im großen Maßstab noch günstiger, oder sie brauchen ein Modell mit freundlicherer Lizenz oder eine gehostete, verwaltete API.
Hier die Kurzfassung, wen Sie wählen sollten:
- Qwen 3.8, wenn Sie die stärkste Rohleistung wollen, besonders beim Coding. Offener 27B-Checkpoint, Apache 2.0.
- DeepSeek V4 Flash, wenn es im großen Maßstab ganz um die Kosten geht. MIT-Lizenz, die günstigste ernsthafte Option hier.
- GLM 5.3 Flash, wenn Sie günstige, multimodale, tool-freudige Agenten auf offenen Gewichten wollen.
- Kimi K3, wenn Sie langfristige agentische Aufgaben fahren und dafür einen Aufpreis zahlen.
- Mistral (Large 3 + offene Modelle), wenn Ihnen ein europäischer Anbieter und saubere On-Prem-Lizenzierung wichtig sind.
- Google Gemini 3.6 Flash, wenn Sie lieber eine verwaltete, gehostete API haben, statt irgendetwas selbst zu hosten.
- NVIDIA Nemotron 3, wenn Sie auf NVIDIA-Hardware arbeiten oder Gewichte und offene Trainingsrezepte wollen.
Eines vorab, weil der Bau von Support-KI mein Tagesgeschäft ist: Jedes Modell auf dieser Liste ist ein Motor, kein Produkt. Wenn Sie eigentlich einen KI-Agenten wollen, der Tickets löst, sind das Modell die einfachen 10 %; Wissen, Integrationen und Guardrails sind die anderen 90 %. Mehr dazu am Ende.
Warum Leute nach einer Granite-4.2-Alternative suchen
Zuerst muss ich fair zu Granite sein, denn es hat es verdient (die Familie habe ich in meinem ausführlichen Granite-4.2-Test genau unter die Lupe genommen). Granite 4.2 erschien am 25. August 2026 als drei dichte Reasoning-Modelle unter einer Apache-2.0-Lizenz. Die kleinen laufen schnell auf Standardhardware (das 3B ist ein Download von 2,2 GB), die Trainingsdaten sind aktuell, und die Community ist sich einig, dass Granite bei strukturierter, fundierter Arbeit still und leise hervorragend ist: Tool Calling, Zusammenfassungen sowie Dokument-Tagging und Extraktion. Wer ein On-Prem-fähiges, lizenzierbares Modell braucht, das sich in einer Agenten-Schleife gut benimmt, hat damit einen starken Standard.
Warum also wechseln? Es tauchen immer wieder ein paar echte Gründe auf, und keiner davon ist Marketing-Gerede.
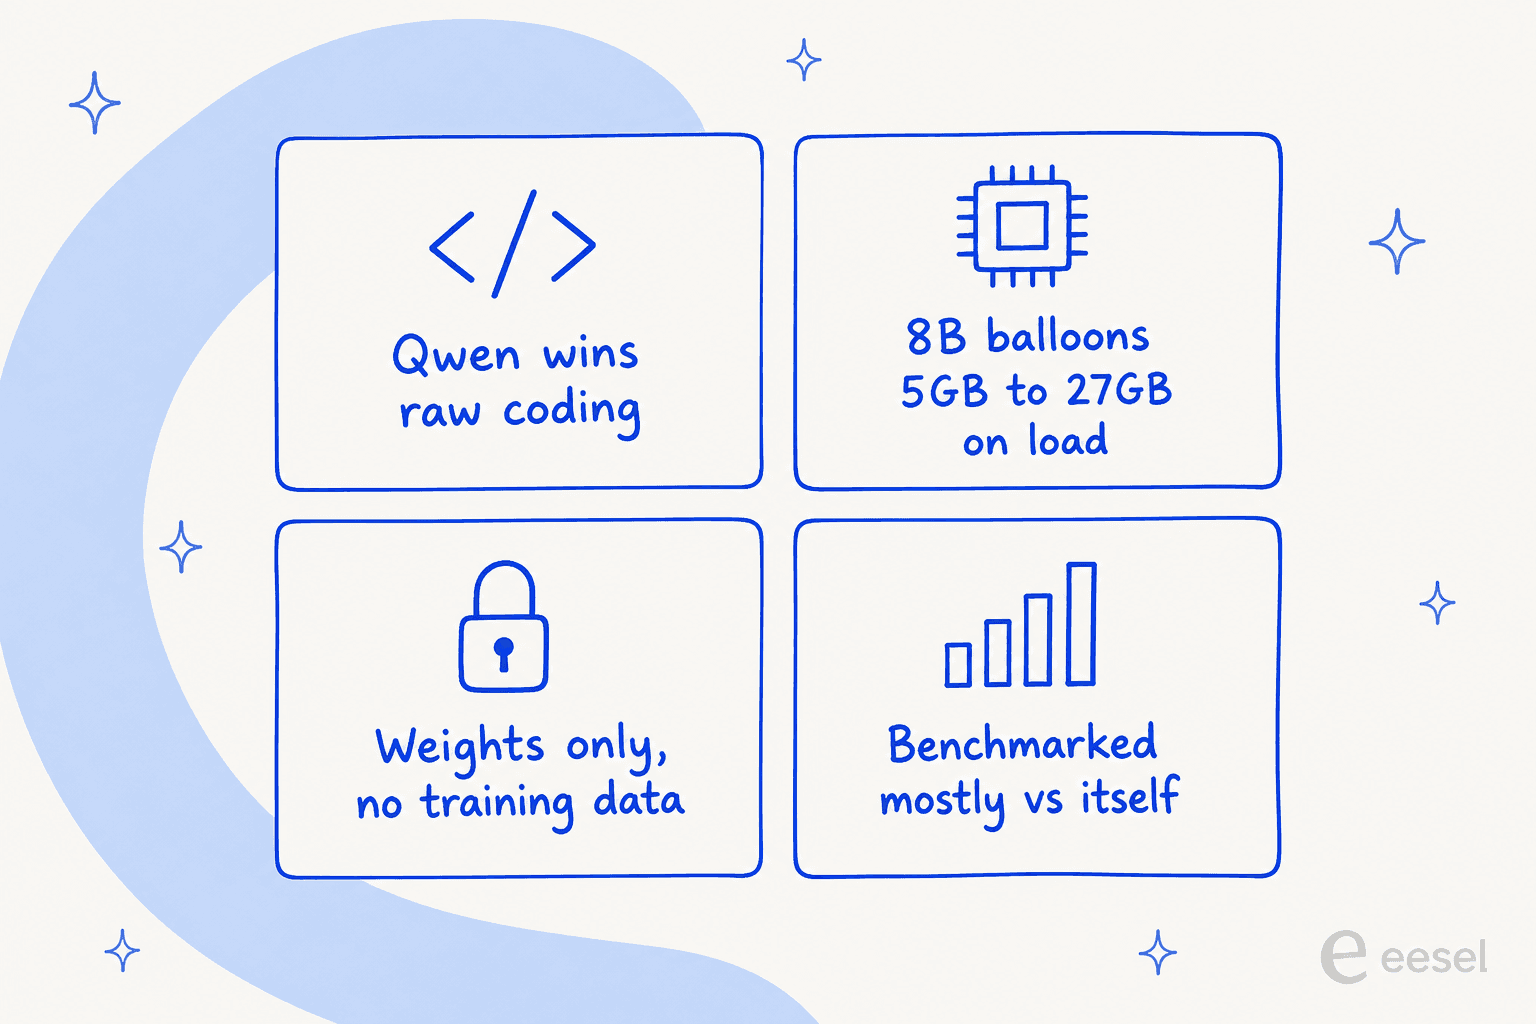
Rohleistung, besonders beim Coding. Das ist der lauteste Grund. Auf Hacker News lautet die wiederkehrende Aussage unverblümt:
"Granite 8B is impressive, but Qwen still wins on raw capability, especially for coding."

Selbst Leute, denen Granite gefiel, blieben bei ihrem alten Favoriten für das Schwere:
"I test drove it yesterday. It's pretty impressive at 8b. Runs on commodity hardware quickly. Qwen3.6 35b a3b is still my local champion but I may use this for auto complete and small tasks."
IBM vergleicht sich meist mit sich selbst. Die Model Cards von Granite vergleichen es mit früheren Granite-Versionen und einer schmalen Auswahl an Konkurrenten wie NVIDIAs Nemotron und Googles Gemma, nicht mit Qwen. Das nährt eine ganz bestimmte Skepsis:
"No comparison with competitor models other than the previous granite version strongly implies that it does not compete well with other comparable models."
Ein echter betrieblicher Haken. Das 8B-Modell ist ein Download von 5,3 GB, doch ein vielgeteilter r/LocalLLaMA-Thread wies darauf hin, dass es beim Laden im Speicher auf 27 GB anwachsen kann, sobald der KV-Cache allokiert ist, was reicht, um es von einer Consumer-GPU zu werfen. Das sollten Sie prüfen, bevor Sie sich festlegen.
"Nur Gewichte sind nicht wirklich Open Source." Granite liefert Gewichte unter Apache 2.0, aber nicht die Trainingsdaten oder das Rezept, und ein Teil der Community vertritt eine strengere Auffassung davon, was "offen" bedeuten sollte. Wenn Ihnen Reproduzierbarkeit wichtig ist, ist diese Lücke ein Grund, sich Modelle anzusehen, die mehr veröffentlichen.
Auch der praktische Kostenaspekt: Angenommen, Sie fahren eine Support-Last von 5 Millionen Output-Tokens im Monat. Beim günstigsten bestätigten gehosteten Tarif von Granite 4.2 sind das etwa $1.25; bei Kimi K3 kosten dieselben Tokens $75. Dieser Faktor 60 ist genau der Grund, warum es sich lohnt, die Frage "welche Alternative" sorgfältig zu beantworten, statt zu nehmen, was letzte Woche die Bestenliste anführte.
Wie ich diese Alternativen ausgewählt habe
Ich habe die Liste auf das ausgerichtet, was Granite tatsächlich ist: ein offenes, kleines bis mittelgroßes, reasoning-fähiges Modell, das Sie günstig selbst hosten können. Die Messlatte war also:
- Zuerst offene Gewichte. Sechs der sieben veröffentlichen herunterladbare Gewichte, denn genau deshalb betreiben Leute Granite statt einer geschlossenen API. Gemini 3.6 Flash ist die einzige rein gehostete Wahl, aufgenommen, weil viele Teams Offenheit gern gegen einen verwalteten Endpunkt eintauschen würden.
- Reasoning und Tool-Nutzung. Das Hauptmerkmal von Granite ist umschaltbares Thinking und durch Reasoning gestütztes Tool Calling, daher kann jedes Modell hier in einer Agenten-Schleife schlussfolgern und Tools aufrufen.
- Echte, prüfbare Preise. Kein "Kontaktieren Sie den Vertrieb". Jeder Preis unten lässt sich auf eine Anbieterseite zurückführen. (Wenn Ihre eigentliche Frage ist, welchen Motor Sie hinter einen Support-Bot setzen, habe ich das separat verglichen in bestes KI-Modell für Support-Tickets.)
- Nur Primärquellen. Spezifikationen stammen aus Model Cards und Preisseiten; Stimmungsbilder von Hacker News, Reddit und X, nicht aus Aggregator-Listicles.
Hier das ganze Feld auf einen Blick, bevor wir die Tools einzeln durchgehen.
| Modell | Am besten für | Offene Gewichte | Lizenz | Kontext | Gehostet In/Out pro 1M | Reasoning |
|---|---|---|---|---|---|---|
| Granite 4.2 (Platzhirsch) | On-Prem-Unternehmensagenten | Ja | Apache 2.0 | 128K–512K | $0.06 / $0.25 | Umschaltbar |
| Qwen 3.8 | Rohe Coding-Leistung | Ja (27B Apache) | Gemischt | 1M | $2 / $6 (Max) | An (xhigh) |
| DeepSeek V4 Flash | Kosten im großen Maßstab | Ja | MIT | 1M | $0.22 / $0.66 (Off-Peak) | An (high) |
| GLM 5.3 Flash | Günstige multimodale Agenten | Ja | Offen | 1M | $0.075 / $0.25 (Aktion) | Nur Thinking |
| Kimi K3 | Langfristige Agenten | Ja | Modifiziert | 1M | $3 / $15 | Immer an |
| Mistral Large 3 | Europäisch / On-Prem | Teilweise (kleine Modelle Apache) | Gemischt | 128K+ | $0.50 / $1.50 | Optional |
| Gemini 3.6 Flash | Verwaltete gehostete API | Nein | Proprietär | 1M | $1.50 / $7.50 | Optional |
| NVIDIA Nemotron 3 | NVIDIA-Stack, offene Rezepte | Ja | Offen | bis zu 1M | Kostenlose Endpunkte / Rechenleistung | Ja |
Die 7 besten Granite-4.2-Alternativen im Jahr 2026
1. Qwen 3.8 - am besten für Rohleistung und Coding
Am besten für: Teams, die Granite wegen der Lizenz gewählt haben, aber bei schwierigen Coding- und Reasoning-Aufgaben ständig an seine Grenze stoßen.
Wenn es ein einzelnes Modell gibt, zu dem die Local-LLM-Szene statt Granite greift, dann ist es Qwen. Der Vergleich ist so reflexhaft, dass beim Start von Granite 4.2 die häufigste Frage auf X buchstäblich lautete, wie es sich schlägt:
"Anyone tested Granite 4.2 30B from IBM yet? How does it compare to Qwen-3.8-27B?"
Qwen 3.8 gibt es in zwei Ausprägungen. Das Flaggschiff Qwen 3.8 Max ist ein Mixture-of-Experts-Modell mit 2,4T Parametern (95B aktiv) und 1M-Token-Kontext, verkauft als gehostete API. Darunter sitzt der offene Checkpoint Qwen3.8-27B unter einer echten Apache-2.0-Lizenz, der direkte Vergleichspartner zu Granites offenen Größen. Wichtig zu wissen: Die offenen Max-Basisgewichte nutzen Alibabas eigene restriktive Lizenz, nicht Apache; "offenes Qwen" mit kommerzieller Freiheit bedeutet also das 27B, nicht den Riesen.
Wo es Granite schlägt: bei der Rohleistung, Punkt. Auf LMArena liegt Qwen 3.8 Max bei Text und Webentwicklung nahe der Spitze, und das Urteil der Community beim Coding steht fest. Der 1M-Kontext stellt zudem Granites nativen 128K in den Schatten.
Wo es zurückbleibt: Die Apache-saubere Option ist das 27B, nicht das Aushängeschild Max, die Offenheits-Story ist also enger, als sie zunächst wirkt. Und Qwens eigenes Coding-Harness ist auf eine Output-Obergrenze von 64K konfiguriert, die "1M Kontext"-Zahl ist also theoretischer, als es die meisten Workloads je ausreizen werden.
Preise: Das offene 27B ist kostenlos selbst zu hosten. Qwen 3.8 Max kostet in Alibabas Cloud $2 pro Million Input-Tokens und $6 pro Million Output, gecachte Input-Lesezugriffe $0.25.
Fazit: Wenn Sie Granite verlassen haben, weil es beim Coding oder bei schwerem Reasoning nicht mithielt, ist Qwen die erste Anlaufstelle. Nehmen Sie das 27B, wenn eine saubere Lizenz zählt, oder das gehostete Max, wenn Sie die stärkste Version wollen und Alibabas Bedingungen nicht stören.
2. DeepSeek V4 Flash - am besten für Kosten im großen Maßstab
Am besten für: Workloads mit hohem Volumen, bei denen die Rechnung pro Token tatsächlich die Architektur bestimmt.
DeepSeek V4 Flash ist der Budget-Champion dieser Liste und, anders als Qwens Aushängeschild, wirklich MIT-lizenziert, eine der freizügigsten Lizenzen überhaupt.
Es ist ein Mixture-of-Experts-Modell mit 284B Parametern (13B aktiv) und 1M-Token-Kontext, veröffentlicht als rund 167 GB offene Gewichte. Reasoning ist standardmäßig auf "high" aktiv, und hier liegt die Besonderheit: Die günstige und die gute Konfiguration sind buchstäblich unterschiedliche Läufe derselben Gewichte (der Zielkonflikt RAG versus rohes LLM taucht auch hier auf, denn mehr Denken bedeutet mehr abgerechnete Tokens). DeepSeeks eigene Zahlen zeigen für Flash 8.1 auf HLE ohne Thinking gegenüber 34.8 bei maximalem Aufwand. Sie bestimmen, wie hart es nachdenkt, und zahlen die Reasoning-Tokens zum Output-Tarif.
Wo es Granite schlägt: beim Preis und mit einer saubereren Lizenz. Es ist außerdem ein viel größeres Modell als Granites 30B und erreicht bei maximalem Aufwand Fähigkeiten, die Granites kleine Größen nicht erreichen.
Wo es zurückbleibt: Es verarbeitet nur Text (keine dokumentierte Bildeingabe), kann ausschweifend sein, und es gibt einen echten Haken bei der Daten-Governance. DeepSeeks Bedingungen für die kostenpflichtige API schweigen dazu, ob mit Ihren Eingaben trainiert wird, und der Dienst unterliegt chinesischem Recht, ist also kein Drop-in für regulierte Kundendaten (bei Support-Daten spielt der Aspekt SOC 2 und DSGVO hier eine Rolle). Beachten Sie auch die Preis-Uhr: Die Tarife verdoppeln sich in Spitzenzeiten (01:00–04:00 und 06:00–10:00 UTC), die für die meisten westlichen Queues zufällig Randzeiten sind.
Preise: Off-Peak kostet Cache-Miss-Input $0.22 pro Million und Output $0.66; Spitzentarife sind genau doppelt so hoch. Das Selbst-Hosting der MIT-Gewichte ist kostenlos.
Fazit: Wenn Ihr Workload groß und Ihre Daten nicht reguliert sind, schlägt hier nichts DeepSeek bei den Kosten pro Leistungseinheit. Kalkulieren Sie nur mit dem Spitzen-Tarif, damit Sie keine Zeitzonenverschiebung überrascht, und halten Sie personenbezogene Kundendaten aus der First-Party-API heraus.
3. GLM 5.3 Flash - am besten für günstige multimodale Agenten
Am besten für: Entwickler, die tool-freudige, multimodale Agenten auf offenen Gewichten wollen, ohne Frontier-Preise zu zahlen.
GLM 5.3 Flash von Z.ai (Zhipu) ist das neueste Modell hier und zielt genau auf die agentische, Tool-Calling-Nische, in der Granite am stärksten ist, und unterbietet es dann.
Es ist ein MoE mit 320B Parametern (18B aktiv), das erste nativ multimodale Modell der GLM-5-Linie, mit 1M Kontext und offenen Gewichten auf Hugging Face. Es erreicht einen Artificial Analysis Intelligence Index von 57, auf Augenhöhe mit weit teureren Modellen, bei einem Bruchteil der Kosten pro Aufgabe.
Wo es Granite schlägt: Es ist nativ multimodal (Granite 4.2 hat keine Vision-Variante), der Kontext ist 8-mal größer, und der Aktionspreis liegt nahe bei null. Es führte zudem eine Zeit lang die Nutzungscharts von OpenRouter an und ist damit im großen Volumen erprobt.
Wo es zurückbleibt: Reasoning ist immer an und lässt sich nicht abschalten, einen echten "schnellen, günstigen Modus ohne Thinking" wie bei Granite gibt es also nicht. Die First-Party-API ist außerdem langsam (~49 Tokens/Sekunde); für latenzkritische Arbeit sollten Sie einen schnelleren Host wie Databricks nutzen.
Preise: Aktionstarife von $0.075 pro Million Input und $0.25 pro Million Output (Liste $0.15/$0.50), die Aktion läuft bis zum 9. September 2026, gecachter Input kostet $0.015. Ein separater GLM Coding Plan kostet $18/$80/$168 pro Monat. Offene Gewichte lassen sich kostenlos selbst hosten.
Fazit: Für günstige Agenten, die Bilder sehen und Tools aufrufen müssen, ist GLM 5.3 Flash der direkteste Tausch nach dem Motto "Granite, aber größer und multimodal" auf dieser Liste. Planen Sie nur ein, dass es immer nachdenkt.
4. Kimi K3 - am besten für langfristige agentische Arbeit
Am besten für: komplexe, mehrstufige Agentenläufe, bei denen Sie lieber mehr zahlen, als ein schwächeres Modell zu bemuttern.
Kimi K3 von Moonshot AI ist die Premium-Open-Weight-Option: größer, teurer und auf anhaltendes agentisches Reasoning statt auf günstigen Durchsatz getrimmt.
Es ist ein MoE mit 2,8T Parametern (104B aktiv), 1M-Token-Kontext und nativer Vision, und Moonshot hat die offenen Gewichte planmäßig veröffentlicht. Im Artificial Analysis Intelligence Index landet es bei etwa 57 (Platz 4 insgesamt) und schlägt bei vielen Aufgaben manche Frontier-Modelle.
Wo es Granite schlägt: Es ist bei schweren, lang laufenden Aufgaben ein deutlich stärkeres Modell und ein ernstzunehmender agentischer Reasoner, wo Granites kleine Größen an Grenzen stoßen.
Wo es zurückbleibt: der Preis. Mit $3 In / $15 Out pro Million Tokens liegt es im selben Bereich wie Claude Sonnet, rund das 50-Fache von DeepSeeks Output-Tarif, es ist also das Gegenteil einer Budget-Wahl. Reasoning lässt sich außerdem auf keiner Stufe abschalten (die Effort-Einstellung steuert die Latenz, keine Kostenstufe), und die offenen Gewichte sind ein Download von 1.561 GB, "Self-Hosting" bedeutet hier also ernsthafte Infrastruktur.
Preise: $3 pro Million Input, $0.30 bei Cache-Treffer, $15 pro Million Output. Die Tarife der Consumer-App sind Free / $19 / $39 / $99 / $199 pro Monat.
Fazit: Kimi K3 wählen Sie, wenn die Aufgabe so schwer ist, dass ein günstigeres Modell scheitern würde und die Kosten des Scheiterns die Kosten der Tokens übersteigen. Für Routinearbeit mit hohem Volumen ist es neben Granite oder DeepSeek überdimensioniert.
5. Mistral (Large 3 + offene Modelle) - am besten für europäische Teams und saubere On-Prem-Nutzung
Am besten für: Teams, die einen nicht-US-amerikanischen Anbieter, EU-Datenresidenz und wirklich freizügige Lizenzierung kleiner Modelle wollen.
Mistral ist die europäische Antwort auf das Versprechen "offen, lizenzierbar, On-Prem", das Leute überhaupt erst zu Granite zieht, und seine kleinen Modelle erscheinen unter Apache 2.0.
Das Angebot teilt sich sauber auf: Mistral Large 3 ist das gehostete Flaggschiff, Codestral und Devstral decken Coding und agentische Arbeit ab, und eine Familie kleinerer offener Modelle deckt den Self-Hosting-Fall ab. Mistrals Consumer-Assistent, früher Le Chat genannt, heißt jetzt Vibe.
Wo es Granite schlägt: europäische Rechtshoheit und eine ausgereifte Enterprise-Story (EU-Datenresidenz, On-Prem-Deployment). Die kleinen offenen Modelle bieten einen Apache-lizenzierten Self-Hosting-Pfad mit einem westlichen Anbieter im Rücken, was für die Beschaffung eine Rolle spielt, die der Lizenztext allein nicht erfasst.
Wo es zurückbleibt: Die größten und besten Mistral-Modelle sind die gehosteten kostenpflichtigen, die offene Stufe ist also nicht die Spitze. Und bei reiner Benchmark-Leistung liegen derzeit tendenziell die chinesischen offenen Modelle (Qwen, DeepSeek, GLM) vorn.
Preise: Mistral Large 3 kostet etwa $0.50 pro Million Input und $1.50 pro Million Output; Codestral ungefähr $0.30/$0.90. Die Vibe-Consumer-Tarife sind Free / $14.99 / $24.99 pro Nutzer und Monat. Die kleinen offenen Modelle lassen sich kostenlos selbst hosten.
Fazit: Wenn Ihr Grund für Open Source Governance und Anbieter-Rechtsraum war und nicht das Herauspressen des letzten Cents aus einem Benchmark, ist Mistral hier die bequemste Wahl. War es die Rohleistung, schauen Sie zuerst auf Qwen oder DeepSeek.
6. Google Gemini 3.6 Flash - am besten für eine verwaltete gehostete API
Am besten für: Teams, die lieber nie Gewichte anfassen und einfach einen schnellen, günstigen, zuverlässigen gehosteten Endpunkt wollen.
Nicht jeder Granite-Nutzer will tatsächlich selbst hosten; manche wollen nur ein halbwegs offenes, günstiges Arbeitstier und haben Granite gewählt, weil es billig war. Für sie ist Gemini 3.6 Flash die geschlossene, aber einfache Alternative.
Es ist Googles "Arbeitstier"-Flash-Stufe, gestartet am 21. Juli 2026, mit ~1M-Token-Kontext, integrierter Computernutzung und Wissensstand März 2026. Google gibt an, dass es bei denselben Aufgaben rund 17 % weniger Output-Tokens als das vorherige Flash verbraucht, was die echte Rechnung unauffällig senkt.
Wo es Granite schlägt: null Betriebsaufwand. Keine GPUs, keine vLLM-Konfiguration, keine KV-Cache-Überraschungen. Es ist stark bei Computernutzung und Langkontext-Aufgaben und wirklich schnell.
Wo es zurückbleibt: Es ist proprietär und nur gehostet, also kein Self-Hosting, kein On-Prem und keine Lizenzfreiheit, genau das, weswegen die meisten zu Granite kamen. Und der Output-Preis ist für diese Liste hoch.
Preise: $1.50 pro Million Input und $7.50 pro Million Output, Batch-Anfragen mit 50 % Rabatt ($0.75/$3.75).
Fazit: Wenn Ihnen offene Gewichte nie wichtig waren und Sie nur eine günstige, leistungsfähige API wollten, ist Gemini 3.6 Flash ein bequemeres Leben als Granite selbst zu betreiben. Wenn Offenheit oder On-Prem der Punkt waren, ist es die falsche Richtung.
7. NVIDIA Nemotron 3 - am besten für den NVIDIA-Stack und wirklich offene Rezepte
Am besten für: Teams, die bereits auf NVIDIA-Hardware sind, und alle, die die Reproduzierbarkeit wollen, die Granite nicht liefert.
NVIDIAs Nemotron-Familie ist einer der Konkurrenten, gegen die IBM Granite tatsächlich vergleicht, was sie zu einem natürlichen Direktvergleich macht, und sie beantwortet die Beschwerde "nur Gewichte sind nicht offen" direkt.
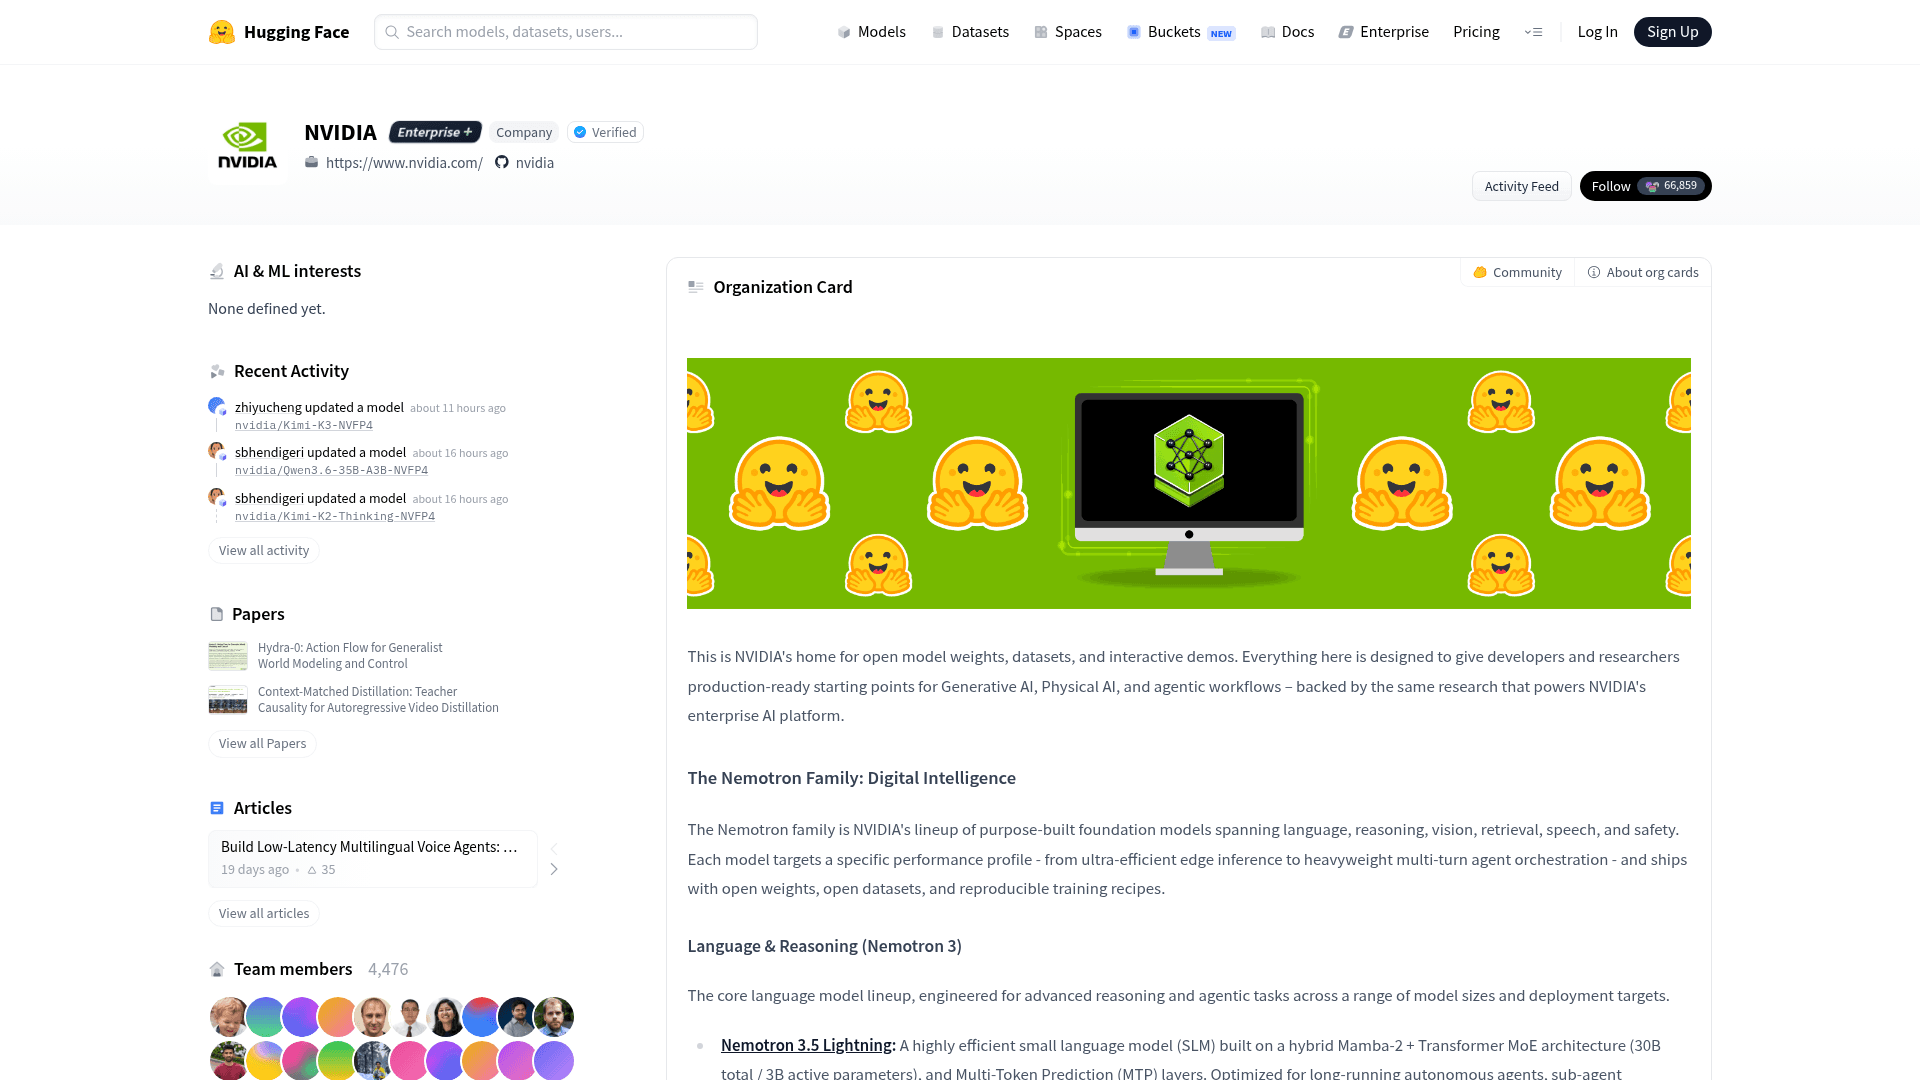
Nemotron ist NVIDIAs Reihe speziell gebauter Foundation-Modelle für Sprache, Reasoning, Vision und Retrieval. Die aktuellen Sprachmodelle reichen von nemotron-3.5-lightning-30b-a3b (ein MoE mit 30B gesamt / 3B aktiv, abgestimmt auf lang laufende autonome Agenten) bis zu nemotron-3-ultra-550b-a55b (ein offenes hybrides Mamba-Transformer-MoE mit 1M Kontext, gebaut für agentisches Reasoning, Coding und Tool Calling). Entscheidend: NVIDIA sagt, die Familie komme mit "open weights, open datasets, and reproducible training recipes."
Wo es Granite schlägt: Diese Reproduzierbarkeitszeile ist der ganze Pitch. Wo Granite Gewichte liefert, liefert Nemotron Gewichte, Daten und Rezept, also die strengere Definition von offen, auf die ein Teil der Community pocht. Es ist außerdem auf NVIDIA-Silizium optimiert, und Sie können die Modelle vor einer Festlegung kostenlos auf build.nvidia.com aufrufen.
Wo es zurückbleibt: Die stärksten Nemotron-Modelle sind groß (das Ultra hat 550B), die "läuft auf dem Laptop"-Geschichte, die Granites 3B so liebenswert macht, gilt am oberen Ende also nicht wirklich. Und die Endkundenpreise pro Token sind weniger klar als bei den anderen hier; Produktions-Hosting läuft über NVIDIA NIM oder Cloud-Partner und wird nach Rechenleistung abgerechnet.
Preise: Offene Gewichte sind kostenlos herunterladbar, und NVIDIA bietet kostenlose gehostete Endpunkte auf build.nvidia.com. Produktions-Hosting über NVIDIA NIM oder einen Cloud-Partner wird nach der zugrunde liegenden Rechenleistung statt nach einem öffentlichen Preis pro Token abgerechnet.
Fazit: Wenn Sie bereits auf NVIDIA-Infrastruktur sind oder die Frage "ist es wirklich offen" der Grund ist, Granite zu verlassen, ist Nemotron der prinzipientreueste Tausch auf der Liste. Dimensionieren Sie es nur passend zu Ihrer Hardware.
Was jedes Modell auf dieser Liste gemeinsam hat
Hier der Teil, der in Benchmark-Threads untergeht. Ob Sie Granite, Qwen, DeepSeek oder Nemotron wählen, Sie haben einen Motor gewählt. Ein Modell allein kennt Ihre Erstattungsrichtlinie nicht, kann Ihre Zendesk-Tickets nicht sehen und weiß nicht, ob die gerade generierte Antwort sicher an einen echten Kunden gehen kann. Genau deshalb ist KI für den Kundenservice eine Produktkategorie und nicht nur ein API-Schlüssel.
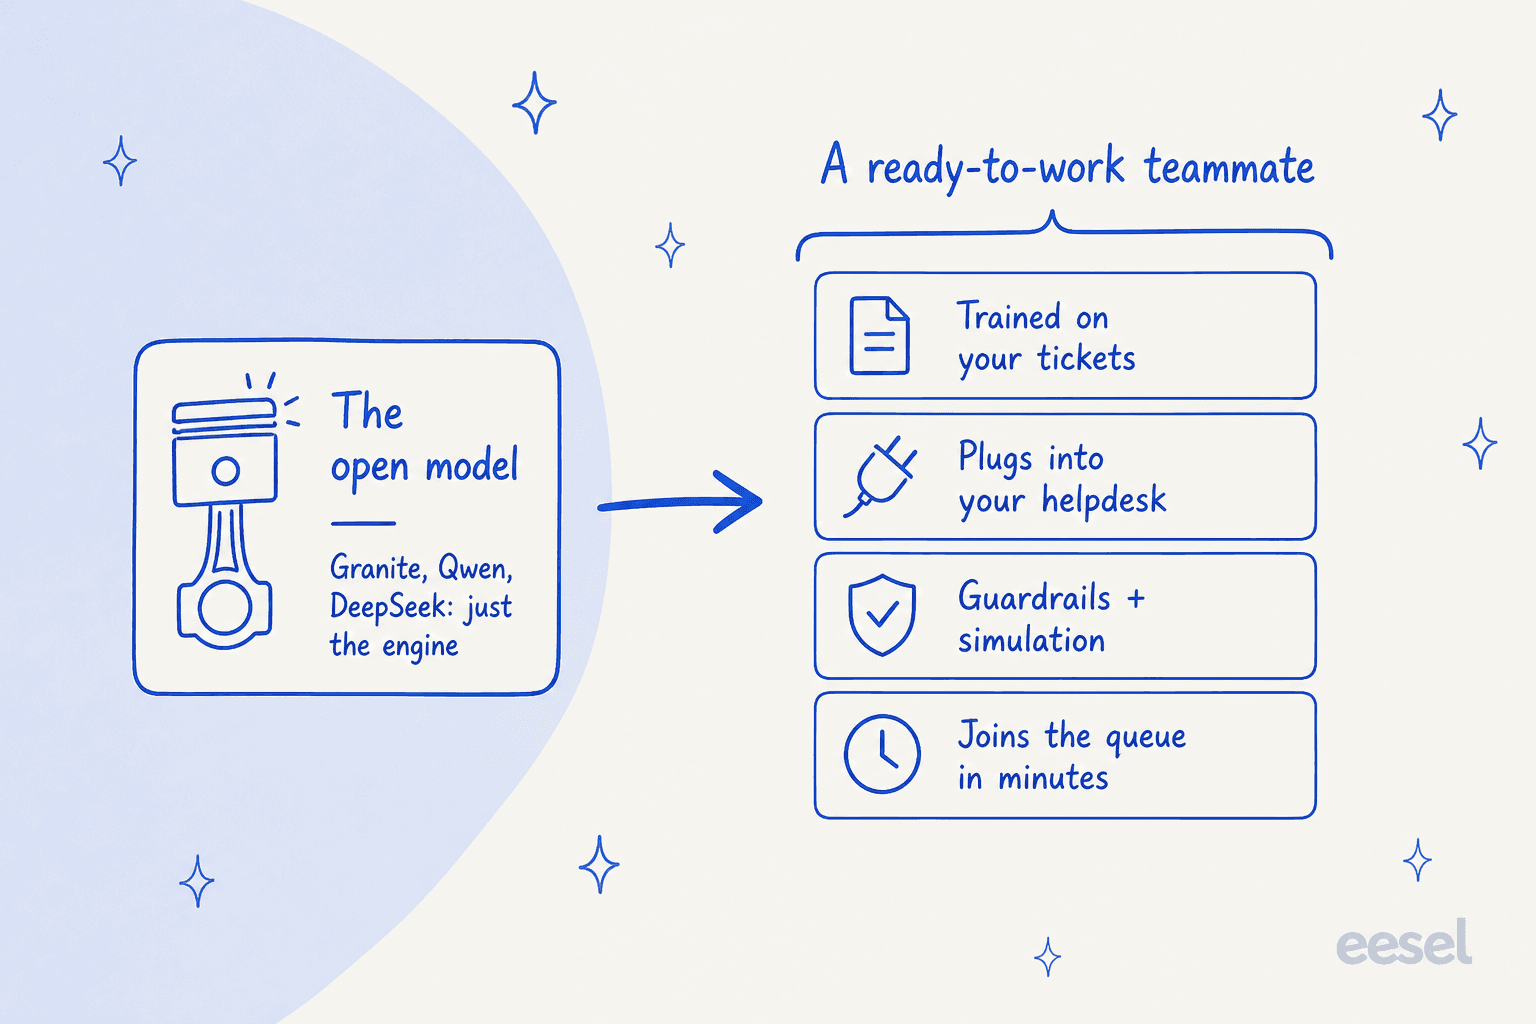
Wenn Sie zwischen diesen Modellen wählen, um etwas zu bauen, großartig; nehmen Sie den passenden Motor und legen Sie los. Ist das eigentliche Ziel aber ein funktionierender KI-Agent, der Support-Tickets löst, ändert der Tausch von Granite gegen Qwen die einfachen 10 % und lässt die schweren 90 % unberührt: die Anbindung an Ihre Wissensdatenbank, die Integration in den Helpdesk, das Schreiben der Guardrails und der Nachweis, dass es sicher ist, bevor es live geht. Das ist der Unterschied zwischen einem KI-Agenten und einem regelbasierten Chatbot, und dort steckt die eigentliche Arbeit.
Probieren Sie eesel: die Schicht, die kein Modell auf dieser Liste liefert
Wenn Ihr Ziel ist, Tickets zu beantworten, statt ein Modell zum Bauen auszuwählen, schließt eesel genau diese Lücke. Jedes Modell oben gibt Ihnen einen Motor. eesel ist das einsatzbereite KI-Helpdesk-Teammitglied, das bereits einen Motor hat, plus alles drumherum: Es trainiert auf Ihren bisherigen Tickets und Ihrem Help Center, klinkt sich in den Helpdesk ein, den Sie bereits nutzen (Zendesk, Freshdesk, Gorgias und über 1.000 weitere Integrationen), und steigt in Minuten statt in Quartalen in die Queue ein.

Der Unterschied ist das Sicherheitsnetz, das ein nacktes Modell, Granite oder ein anderes, nicht mitbringt: Bevor eesel einem einzigen echten Kunden antwortet, können Sie es an Tausenden historischer Tickets simulieren, um genau zu sehen, wie es geantwortet und was es gelöst hätte. Nutzen Sie jedes Modell dieser Liste, wenn Sie bauen. Nutzen Sie ein KI-Helpdesk-Teammitglied, wenn Sie Tickets beantworten wollen. Sie können eesel kostenlos testen, ohne Kreditkarte und ohne Verkaufsgespräch.
Häufig gestellte Fragen
Was ist die beste Open-Weight-Alternative zu IBM Granite 4.2?
Bei der reinen Leistungsfähigkeit verweist die Local-LLM-Community immer wieder auf Qwen: Der offene 27B-Checkpoint steht unter Apache 2.0 und schlägt Granite beim Coding. Wenn die Kosten den Ausschlag geben, ist DeepSeek V4 Flash unter MIT-Lizenz und im großen Maßstab günstiger zu betreiben. Beide werden oben ausführlich behandelt, zusammen mit unserer verwandten Übersicht zu Granite 4.2.
Gibt es eine günstigere Alternative zu Granite 4.2?
Granite liegt bereits nahe an der Untergrenze: Die Gewichte stehen unter Apache 2.0, Self-Hosting ist also kostenlos, und das 8B-Modell von Replicate kostet $0.06/$0.25 pro Million Tokens. Bei gehosteten Tarifen ist der Aktionspreis von GLM 5.3 Flash ($0.075/$0.25) vergleichbar, und der Off-Peak-Output von DeepSeek V4 Flash kostet $0.66. Das Modell ist bei einem KI-Agenten allerdings selten der teure Teil; teuer sind Wissensbasis, Integrationen und Guardrails.
Welche Granite-4.2-Alternative eignet sich am besten fürs Coding?
Qwen ist unter Leuten, die Modelle lokal betreiben, die einhellige Wahl fürs Coding, und auch DeepSeek V4 Flash schneidet gut ab. Das 30B-Modell von Granite 4.2 ist glaubwürdig (57.0 auf SWE-Bench Verified), doch für reine Codegenerierung greifen die meisten Tester weiterhin zu Qwen. Wenn Sie ein Modell für Support-Automatisierung statt für ein Coding-Tool auswählen, lesen Sie unseren Leitfaden zum besten KI-Modell für Support-Tickets.
Laufen Granite-4.2-Alternativen auf eigener Hardware?
Die meisten schon. Qwen, DeepSeek V4 Flash, GLM 5.3 Flash, Kimi K3, die kleinen Modelle von Mistral und NVIDIA Nemotron veröffentlichen alle offene Gewichte, die Sie herunterladen und über Ollama, vLLM oder llama.cpp betreiben können. Googles Gemini 3.6 Flash ist die Ausnahme; es gibt es nur gehostet. Für echte Kundenarbeit brauchen Sie bei jedem davon trotzdem Retrieval und Guardrails rund um das Modell.
Was sollte ich statt Granite 4.2 nutzen, um einen Support-Agenten zu bauen?
Wenn das Ziel ist, Tickets zu lösen, statt Infrastruktur aufzubauen, brauchen Sie gar kein rohes Modell, sondern die Schicht darüber. eesel ist ein KI-Helpdesk-Teammitglied, das auf Ihren bisherigen Tickets und Ihrem Help Center trainiert, sich in Ihren bestehenden Helpdesk einklinkt und vorab an historischen Tickets simuliert werden kann, bevor es einem einzigen Live-Kunden antwortet. Das Modell darunter ist der einfache Teil.